首页 文章 精选 留言 我的

精选列表

搜索[socket编程],共10000篇文章
优秀的个人博客,低调大师

Hadoop里如何Mysql编程

mysql数据库读写 hadoop技术推出一度曾遭到关系数据库研究者的挑衅和批评,认为MapReduce不具有关系数据库中的结构化数据存储和处理能力。为此,hadoop社区和研究人员做了多的努力,在hadoop0.19版支持MapReduce访问关系数据库,如:MySQL、Mongodb、PostgreSQL、Oracle等几个数据库系统。Hadoop 访问关系数据库主要通过DBInputFormat类实现的,包的位置在 org.apache.hadoop.mapred.lib.db。以 Mysql为例来学习 MapReduce读写数据。 MySQL是一个关系型数据库管理系统,由瑞典MySQL AB 公司开发,目前属于Oracle旗下公司。MySQL 最流行的关系型数据库管理系统,在 WEB 应用方面MySQL是最好的 RDBMS (Relational Database Management System,关系数据库管理系统) 应用软件之一。 Mongodb百度百科: http://baike.baidu.com/subview/3385614/9338180.htm PostgreSQL百度百科: http://baike.baidu.com/view/28196.htm Oracle百度百科: 读数据 DBInputFormat 在 Hadoop 应用程序中通过数据库供应商提供的 JDBC接口来与数据库进行交互,并且可以使用标准的 SQL 来读取数据库中的记录。学习DBInputFormat首先必须知道二个条件。 第一、在使用 DBInputFormat 之前,必须将要使用的JDBC驱动拷贝到分布式系统各个节点的$HADOOP_HOME/lib/目录下。 第二、MapReduce访问关系数据库时,大量频繁的从MapReduce程序中查询和读取数据,这大大的增加了数据库的访问负载,因此,DBInputFormat接口仅仅适合读取小数据量的数据,而不适合处理数据仓库。 提示处理数据仓库的方法有:利用数据库的 Dump 工具将大量待分析的数据输出为文本,并上传到 HDFS 中进行处理。 http://baike.baidu.com/view/22424.htm?fromtitle=Oracle&fromid=301207&type=syn 下面我们来看看 DBInputFormat类的内部结构,DBInputFormat 类中包含以下三个内置类。 1、protected class DBRecordReader implements RecordReader< LongWritable, T>:用来从一张数据库表中读取一条条元组记录。 2、public static class NullDBWritable implements DBWritable,Writable:主要用来实现 DBWritable 接口。DBWritable接口要实现二个函数,第一是write,第二是readFileds,这二个函数都不难理解,一个是写,一个是读出所有字段。原型如下: public void write(PreparedStatement statement) throwsSQLException; public void readFields(ResultSet result); 3、protected static class DBInputSplit implements InputSplit:主要用来描述输入元组集合的范围,包括 start 和 end 两个属性,start 用来表示第一条记录的索引号,end 表示最后一条记录的索引号。 下面对怎样使用 DBInputFormat 读取数据库记录进行详细的介绍,具体步骤如下: 步骤一 、配置 JDBC 驱动、数据源和数据库访问的用户名和密码。代码如下。 DBConfiguration.configureDB(Job job, StringdriverClass, String dbUrl, String userName, String passwd) MySQL 数据库的 JDBC 的驱动为“com.mysql.jdbc.Driver”, 数据源为“jdbc:mysql://localhost/testDB”, 其中testDB为访问的数据库。useName一般为“root”,passwd是你数据库的密码。 步骤二、使用 setInput 方法操作 MySQL 中的表,setInput 方法的参数如下。 DBInputFormat.setInput(Job job, Class< extends DBWritable> inputClass, String tableName, String conditions,String orderBy, String... fieldNames) 这个方法的参数很容易看懂,inputClass实现DBWritable接口。string tableName表名, conditions表示查询的条件,orderby表示排序的条件,fieldNames是字段,这相当与把sql语句拆分的结果。当然也可以用sql语句进行重载,代码如下。 setInput(Job job, Class< extends DBWritable> inputClass, String inputQuery, StringinputCountQuery)。 步骤三、编写MapReduce函数,包括Mapper 类、Reducer 类、输入输出文件格式等,然后调用job.waitForCompletion(true)。 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5659460.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop MapReduce(FlowCount) Java编程

编写PhoneFlow程序,计算手机上行流量、下行流量以及总流量,数据如下: 13685295623 122 201 13985295600 102 11 13885295622 22 101 13785295633 120 20 1、FlowMapper: package com.hadoop.flow; import java.io.IOException; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Mapper; import org.apache.commons.lang.StringUtils; public class FlowMapper extends Mapper<LongWritable, Text, Text, FlowBean>{ /** * 数据格式: * 13685295623 122 201 * 13985295600 102 11 * 13885295622 22 101 * 13785295633 120 20 */ @Override protected void map(LongWritable key, Text value,Context context) throws IOException, InterruptedException { String line=value.toString(); String [] fields=StringUtils.split(line,"\t"); String phoneNB=fields[0]; long up_flow=Long.valueOf(fields[1]); long d_flow=Long.valueOf(fields[2]); context.write(new Text(phoneNB), new FlowBean(phoneNB,up_flow,d_flow)); } } 2、FlowReducer: package com.hadoop.flow; import java.io.IOException; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Reducer; public class FlowReducer extends Reducer<Text, FlowBean,Text, FlowBean> { @Override protected void reduce(Text key, Iterable<FlowBean> values,Context context) throws IOException, InterruptedException { long upflowC=0; long dflowD=0; for(FlowBean bean:values){ upflowC+=bean.getUp_flow(); dflowD+=bean.getD_flow(); } context.write(key,new FlowBean(key.toString(),upflowC,dflowD)); } } 3、FlowRunner package com.hadoop.flow; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.conf.Configured; import org.apache.hadoop.fs.Path; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.util.Tool; import org.apache.hadoop.util.ToolRunner; import org.apache.hadoop.io.Text; public class FlowRunner extends Configured implements Tool{ public int run(String[] args) throws Exception { Configuration conf=new Configuration(); Job job=Job.getInstance(conf); job.setJarByClass(FlowRunner.class); job.setMapperClass(FlowMapper.class); job.setReducerClass(FlowReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(FlowBean.class); job.setMapOutputKeyClass(Text.class); job.setMapOutputValueClass(FlowBean.class); FileInputFormat.setInputPaths(job,new Path(args[0])); FileOutputFormat.setOutputPath(job,new Path(args[1])); return job.waitForCompletion(true)?0:1; } public static void main(String[] args) throws Exception { ToolRunner.run(new Configuration(), new FlowRunner(), args); } } 4、FlowBean : package com.hadoop.flow; import java.io.DataInput; import java.io.DataOutput; import java.io.IOException; import org.apache.hadoop.io.Writable; public class FlowBean implements Writable{ private String phoneNB; private long up_flow; private long d_flow; private long s_flow; public FlowBean(){ } public FlowBean (String phoneNB,long up_flow,long d_flow){ this.phoneNB=phoneNB; this.up_flow=up_flow; this.d_flow=d_flow; this.s_flow=up_flow+d_flow; } public String getPhoneNB() { return phoneNB; } public void setPhoneNB(String phoneNB) { this.phoneNB = phoneNB; } public long getUp_flow() { return up_flow; } public void setUp_flow(long up_flow) { this.up_flow = up_flow; } public long getD_flow() { return d_flow; } public void setD_flow(long d_flow) { this.d_flow = d_flow; } public long getS_flow() { return s_flow; } public void setS_flow(long s_flow) { this.s_flow = s_flow; } // public void write(DataOutput out) throws IOException { out.writeUTF(phoneNB); out.writeLong(up_flow); out.writeLong(d_flow); out.writeLong(s_flow); } public void readFields(DataInput in) throws IOException { phoneNB= in.readUTF(); up_flow=in.readLong(); d_flow=in.readLong(); s_flow=in.readLong(); } @Override public String toString() { return up_flow+" "+d_flow+" "+" "+s_flow; } } 本文转自lzf0530377451CTO博客,原文链接:http://blog.51cto.com/8757576/1839299,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop MapReduce(WordCount) Java编程

编写WordCount程序数据如下: hello beijing hello shanghai hello chongqing hello tianjin hello guangzhou hello shenzhen ... 1、WCMapper: package com.hadoop.testHadoop; import java.io.IOException; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Mapper; //4个泛型中,前两个是指定mapper输入数据的类型,KEYIN是输入的key的类型,VALUEIN是输入的value的类型 //map 和 reduce 的数据输入输出都是以 key-value对的形式封装的 //默认情况下,框架传递给我们的mapper的输入数据中,key是要处理的文本中一行的起始偏移量,value为这一行的内容 //LongWritable Text 是hadoop为了序列化 定义的数据类型 public class WCMapper extends Mapper<LongWritable,Text,Text,LongWritable>{ //mapreduce框架每读一行数据就调用一次该方法 @Override protected void map(LongWritable key, Text value,Context context) throws IOException, InterruptedException { String line=value.toString(); String [] words = line.split(" "); for(String word:words){ context.write(new Text(word), new LongWritable(1)); } } } 2、WCReducer: package com.hadoop.testHadoop; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Reducer; public class WCReducer extends Reducer<Text, LongWritable, Text, LongWritable>{ //框架在map处理完成之后,将所有kv对缓存起来,进行分组,然后传递一个组<key,valus{}>,调用一次reduce方法 //<hello,{1,1,1,1,1,1.....}> @Override protected void reduce(Text key, Iterable<LongWritable> values, Context context) throws java.io.IOException ,InterruptedException { long count=0; for(LongWritable value:values){ count+=value.get(); } context.write(key, new LongWritable(count)); } } 3、WCRunner: package com.hadoop.testHadoop; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; public class WCRunner { public static void main(String[] args) throws Exception { Configuration conf=new Configuration(); Job job = Job.getInstance(conf); //设置整个job所用的那些类在哪个jar包 job.setJarByClass(WCRunner.class); job.setMapperClass(WCMapper.class); job.setReducerClass(WCReducer.class); //map输出数据kv类型 job.setMapOutputKeyClass(Text.class); job.setMapOutputValueClass(LongWritable.class); //reduce输出数据kv类型 job.setOutputKeyClass(Text.class); job.setOutputValueClass(LongWritable.class); //执行输入数据的路径 FileInputFormat.setInputPaths(job, new Path("/wordcount/inpput")); //执行输出数据的路径 FileOutputFormat.setOutputPath(job, new Path("/wordcount/outputmy")); //将job提交给集群运行 job.waitForCompletion(true); } } 本文转自lzf0530377451CTO博客,原文链接:http://blog.51cto.com/8757576/1839294,如需转载请自行联系原作者

优秀的个人博客,低调大师

android网络编程——http post

前一篇给出了HttpGet的实例,这一篇给出HttpPost的实例。 public class HttpPostDemo extends Activity { /** Called when the activity is first created. */ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); BufferedReader in = null; try { HttpClient client = new DefaultHttpClient(); HttpPost request = new HttpPost("http://mysomewebsite.com/services/doSomething.do"); List<NameValuePair> postParameters = new ArrayList<NameValuePair>(); postParameters.add(new BasicNameValuePair("username", "test")); postParameters.add(new BasicNameValuePair("password", "test1234")); UrlEncodedFormEntity formEntity = new UrlEncodedFormEntity( postParameters); request.setEntity(formEntity); HttpResponse response = client.execute(request); in = new BufferedReader( new InputStreamReader( response.getEntity().getContent())); StringBuffer sb = new StringBuffer(""); String line = ""; String NL = System.getProperty("line.separator"); while ((line = in.readLine()) != null) { sb.append(line + NL); } in.close(); String result = sb.toString(); System.out.println(result); } catch(Exception e) { // Do something about exceptions } finally { if (in != null) { try { in.close(); } catch (IOException e) { e.printStackTrace(); } } } } } 本文转自xyz_lmn51CTO博客,原文链接:http://blog.51cto.com/xyzlmn/1230791,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android: NDK编程入门笔记

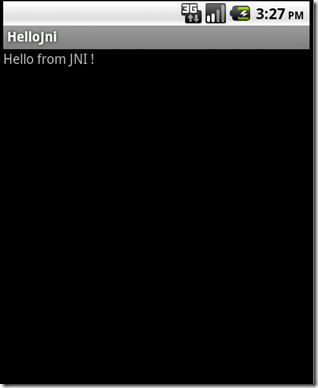
为何要用到NDK? 概括来说主要分为以下几种情况: 1. 代码的保护,由于apk的java层代码很容易被反编译,而C/C++库反汇难度较大。 2. 在NDK中调用第三方C/C++库,因为大部分的开源库都是用C/C++代码编写的。 3. 便于移植,用C/C++写得库可以方便在其他的嵌入式平台上再次使用。 下面就介绍下Android NDK的入门学习过程: 入门的最好办法就是学习Android自带的例子, 这里就通过学习Android的NDK自带的demo程序:hello-jni来达到这个目的。 一、 开发环境的搭建 android的NDK开发需要在linux下进行: 因为需要把C/C++编写的代码生成能在arm上运行的.so文件,这就需要用到交叉编译环境,而交叉编译需要在linux系统下才能完成。 安装android-ndk开发包,这个开发包可以在google android 官网下载: 通过这个开发包的工具才能将android jni 的C/C++的代码编译成库 android应用程序开发环境: 包括eclipse、java、 android sdk、 adt等。 如何下载和安装android-ndk我这里就不啰嗦了,安装完之后,需要将android-ndk的路劲加到环境变量PATH中: sudo gedit /etc/environment 在environment的PATH环境变量中添加你的android-ndk的安装路劲,然后再让这个更改的环境变量立即生效: source /etc/environment 经过了上述步骤,在命令行下敲: ndk-bulid 弹出如下的错误,而不是说ndk-build not found,就说明ndk环境已经安装成功了。 Android NDK: Could not find application project directory ! Android NDK: Please define the NDK_PROJECT_PATH variable to point to it. /home/braincol/workspace/android/android-ndk-r5/build/core/build-local.mk:85: *** Android NDK: Aborting . Stop. 二、代码的编写 1.首先是写java代码 建立一个Android应用工程HelloJni,创建HelloJni.java文件: HelloJni.java : /* * Copyright (C) 2009 The Android Open Source Project * * Licensed under the Apache License, Version 2.0 (the "License"); * you may not use this file except in compliance with the License. * You may obtain a copy of the License at * * http://www.apache.org/licenses/LICENSE-2.0 * * Unless required by applicable law or agreed to in writing, software * distributed under the License is distributed on an "AS IS" BASIS, * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied. * See the License for the specific language governing permissions and * limitations under the License. */package com.example.hellojni;import android.app.Activity;import android.widget.TextView;import android.os.Bundle;public class HelloJni extends Activity {/** Called when the activity is first created. */ @Overridepublic void onCreate(Bundle savedInstanceState) {super.onCreate(savedInstanceState);/* Create a TextView and set its content. * the text is retrieved by calling a native * function. */ TextView tv = new TextView(this); tv.setText( stringFromJNI() ); setContentView(tv); }/* A native method that is implemented by the * 'hello-jni' native library, which is packaged * with this application. */public native String stringFromJNI();/* This is another native method declaration that is *not* * implemented by 'hello-jni'. This is simply to show that * you can declare as many native methods in your Java code * as you want, their implementation is searched in the * currently loaded native libraries only the first time * you call them. * * Trying to call this function will result in a * java.lang.UnsatisfiedLinkError exception ! */public native String unimplementedStringFromJNI();/* this is used to load the 'hello-jni' library on application * startup. The library has already been unpacked into * /data/data/com.example.HelloJni/lib/libhello-jni.so at * installation time by the package manager. */static { System.loadLibrary("hello-jni"); } } 这段代码很简单,注释也很清晰,这里只提两点:: static{ System.loadLibrary("hello-jni"); } 表明程序开始运行的时候会加载hello-jni, static区声明的代码会先于onCreate方法执行。如果你的程序中有多个类,而且如果HelloJni这个类不是你应用程序的入口,那么hello-jni(完整的名字是libhello-jni.so)这个库会在第一次使用HelloJni这个类的时候加载。 public native String stringFromJNI(); public native String unimplementedStringFromJNI(); 可以看到这两个方法的声明中有 native 关键字, 这个关键字表示这两个方法是本地方法,也就是说这两个方法是通过本地代码(C/C++)实现的,在java代码中仅仅是声明。 用eclipse编译该工程,生成相应的.class文件,这步必须在下一步之前完成,因为生成.h文件需要用到相应的.class文件。 2. 编写相应的C/C++代码 刚开始学的时候,有个问题会让人很困惑,相应的C/C++代码如何编写,函数名如何定义? 这里讲一个方法,利用javah这个工具生成相应的.h文件,然后根据这个.h文件编写相应的C/C++代码。 2.1 生成相应.h文件: 就拿我这的环境来说,首先在终端下进入刚刚建立的HelloJni工程的目录: braincol@ubuntu:~$ cd workspace/android/NDK/hello-jni/ ls查看工程文件 braincol@ubuntu:~/workspace/android/NDK/hello-jni$ ls AndroidManifest.xml assets bin default.properties gen res src 可以看到目前仅仅有几个标准的android应用程序的文件(夹)。 首先我们在工程目录下建立一个jni文件夹: braincol@ubuntu:~/workspace/android/NDK/hello-jni$ mkdir jni braincol@ubuntu:~/workspace/android/NDK/hello-jni$ ls AndroidManifest.xml assets bin default.properties gen jni res src 下面就可以生成相应的.h文件了: braincol@ubuntu:~/workspace/android/NDK/hello-jni$ javah -classpath bin -d jni com.example.hellojni.HelloJni -classpath bin:表示类的路劲 -d jni: 表示生成的头文件存放的目录 com.example.hellojni.HelloJni 则是完整类名 这一步的成功要建立在已经在 bin/com/example/hellojni/ 目录下生成了 HelloJni.class的基础之上。 现在可以看到jni目录下多了个.h文件: braincol@ubuntu:~/workspace/android/NDK/hello-jni$ cd jni/ braincol@ubuntu:~/workspace/android/NDK/hello-jni/jni$ ls com_example_hellojni_HelloJni.h 我们来看看com_example_hellojni_HelloJni.h的内容: com_example_hellojni_HelloJni.h : /* DO NOT EDIT THIS FILE - it is machine generated */#include <jni.h>/* Header for class com_example_hellojni_HelloJni */#ifndef _Included_com_example_hellojni_HelloJni#define _Included_com_example_hellojni_HelloJni#ifdef __cplusplusextern "C" {#endif/* * Class: com_example_hellojni_HelloJni * Method: stringFromJNI * Signature: ()Ljava/lang/String; */ JNIEXPORT jstring JNICALL Java_com_example_hellojni_HelloJni_stringFromJNI (JNIEnv *, jobject);/* * Class: com_example_hellojni_HelloJni * Method: unimplementedStringFromJNI * Signature: ()Ljava/lang/String; */ JNIEXPORT jstring JNICALL Java_com_example_hellojni_HelloJni_unimplementedStringFromJNI (JNIEnv *, jobject);#ifdef __cplusplus }#endif#endif 上面代码中的JNIEXPORT 和 JNICALL 是jni的宏,在android的jni中不需要,当然写上去也不会有错。 从上面的源码中可以看出这个函数名那是相当的长啊。。。。 不过还是很有规律的, 完全按照:java_pacakege_class_mathod 形式来命名。 也就是说: Hello.java中 stringFromJNI() 方法对应于 C/C++中的 Java_com_example_hellojni_HelloJni_stringFromJNI() 方法 HelloJni.java中的 unimplementedStringFromJNI() 方法对应于 C/C++中的 Java_com_example_hellojni_HelloJni_unimplementedStringFromJNI() 方法 注意下其中的注释: Signature: ()Ljava/lang/String; ()Ljava/lang/String; ()表示函数的参数为空(这里为空是指除了JNIEnv *, jobject 这两个参数之外没有其他参数,JNIEnv*, jobject是所有jni函数必有的两个参数,分别表示jni环境和对应的java类(或对象)本身), Ljava/lang/String; 表示函数的返回值是java的String对象。 2.2 编写相应的.c文件: hello-jni.c : /* * Copyright (C) 2009 The Android Open Source Project * * Licensed under the Apache License, Version 2.0 (the "License"); * you may not use this file except in compliance with the License. * You may obtain a copy of the License at * * http://www.apache.org/licenses/LICENSE-2.0 * * Unless required by applicable law or agreed to in writing, software * distributed under the License is distributed on an "AS IS" BASIS, * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied. * See the License for the specific language governing permissions and * limitations under the License. * */#include <string.h>#include <jni.h>/* This is a trivial JNI example where we use a native method * to return a new VM String. See the corresponding Java source * file located at: * * apps/samples/hello-jni/project/src/com/example/HelloJni/HelloJni.java */ jstring Java_com_example_hellojni_HelloJni_stringFromJNI( JNIEnv* env, jobject thiz ) {return (*env)->NewStringUTF(env, "Hello from JNI !"); } 这里只是实现了Java_com_example_hellojni_HelloJni_stringFromJNI方法,而 Java_com_example_hellojni_HelloJni_unimplementedStringFromJNI 方法并没有实现,因为在HelloJni.java中只调用了stringFromJNI()方法,所以unimplementedStringFromJNI()方法没有实现也没关系,不过建议最好还是把所有java中定义的本地方法都实现了,写个空函数也行啊。。。有总比没有好。 Java_com_example_hellojni_HelloJni_stringFromJNI() 函数只是简单的返回了一个内容为 "Hello from JNI !" 的jstring对象(对应于java中的String对象)。 hello-jni.c文件已经编写好了,现在可以把com_example_hellojni_HelloJni.h文件给删了,当然留着也行,只是我还是习惯把不需要的文件给清理干净了。 3. 编译hello-jni.c 生成相应的库 3.1 编写Android.mk文件 在jni目录下(即hello-jni.c 同级目录下)新建一个Android.mk文件,Android.mk文件是Android 的 makefile文件,内容如下: # Copyright (C) 2009 The Android Open Source Project## Licensed under the Apache License, Version 2.0 (the "License");# you may not use this file except in compliance with the License.# You may obtain a copy of the License at## http://www.apache.org/licenses/LICENSE-2.0## Unless required by applicable law or agreed to in writing, software# distributed under the License is distributed on an "AS IS" BASIS,# WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.# See the License for the specific language governing permissions and# limitations under the License.# LOCAL_PATH := $(call my-dir)include $(CLEAR_VARS) LOCAL_MODULE := hello-jni LOCAL_SRC_FILES := hello-jni.cinclude $(BUILD_SHARED_LIBRARY) 这个Androd.mk文件很短,下面我们来逐行解释下: LOCAL_PATH := $(call my-dir) 一个Android.mk 文件首先必须定义好LOCAL_PATH变量。它用于在开发树中查找源文件。在这个例子中,宏函数’my-dir’, 由编译系统提供,用于返回当前路径(即包含Android.mk file文件的目录)。 include $( CLEAR_VARS) CLEAR_VARS由编译系统提供,指定让GNU MAKEFILE为你清除许多LOCAL_XXX变量(例如 LOCAL_MODULE, LOCAL_SRC_FILES, LOCAL_STATIC_LIBRARIES, 等等...), 除LOCAL_PATH 。这是必要的,因为所有的编译控制文件都在同一个GNU MAKE执行环境中,所有的变量都是全局的。 LOCAL_MODULE := hello-jni 编译的目标对象,LOCAL_MODULE变量必须定义,以标识你在Android.mk文件中描述的每个模块。名称必须是唯一的,而且不包含任何空格。 注意:编译系统会自动产生合适的前缀和后缀,换句话说,一个被命名为'hello-jni'的共享库模块,将会生成'libhello-jni.so'文件。 重要注意事项: 如果你把库命名为‘libhello-jni’,编译系统将不会添加任何的lib前缀,也会生成 'libhello-jni.so',这是为了支持来源于Android平台的源代码的Android.mk文件,如果你确实需要这么做的话。 LOCAL_SRC_FILES := hello-jni.c LOCAL_SRC_FILES变量必须包含将要编译打包进模块中的C或C++源代码文件。注意,你不用在这里列出头文件和包含文件,因为编译系统将会自动为你找出依赖型的文件;仅仅列出直接传递给编译器的源代码文件就好。 注意,默认的C++源码文件的扩展名是’.cpp’. 指定一个不同的扩展名也是可能的,只要定义LOCAL_DEFAULT_CPP_EXTENSION变量,不要忘记开始的小圆点(也就是’.cxx’,而不是’cxx’) include $(BUILD_SHARED_LIBRARY) BUILD_SHARED_LIBRARY表示编译生成共享库,是编译系统提供的变量,指向一个GNU Makefile脚本,负责收集自从上次调用'include $(CLEAR_VARS)'以来,定义在LOCAL_XXX变量中的所有信息,并且决定编译什么,如何正确地去做。还有 BUILD_STATIC_LIBRARY变量表示生成静态库:lib$(LOCAL_MODULE).a, BUILD_EXECUTABLE 表示生成可执行文件。 3.2 生成.so共享库文件 Andro文件已经编写好了,现在可以用android NDK开发包中的 ndk-build脚本生成对应的.so共享库了,方法如下: braincol@ubuntu:~/workspace/android/NDK/hello-jni/jni$ cd .. braincol@ubuntu:~/workspace/android/NDK/hello-jni$ ls AndroidManifest.xml assets bin default.properties gen jni libs obj res src braincol@ubuntu:~/workspace/android/NDK/hello-jni$ ndk-build Gdbserver : [arm-linux-androideabi-4.4.3] libs/armeabi/gdbserver Gdbsetup : libs/armeabi/gdb.setup Install : libhello-jni.so => libs/armeabi/libhello-jni.so 可以看到已经正确的生成了libhello-jni.so共享库了, 我们去 libs/armeabi/ 目录下看看: braincol@ubuntu:~/workspace/android/NDK/hello-jni$ cd libs/ braincol@ubuntu:~/workspace/android/NDK/hello-jni/libs$ ls armeabi braincol@ubuntu:~/workspace/android/NDK/hello-jni/libs$ cd armeabi/ braincol@ubuntu:~/workspace/android/NDK/hello-jni/libs/armeabi$ ls gdbserver gdb.setup libhello-jni.so 4. 在eclipse重新编译HelloJni工程,生成apk eclipse中刷新下HelloJni工程,重新编译生成apk,libhello-jni.so共享库会一起打包在apk文件内。 在模拟器中看看运行结果:

优秀的个人博客,低调大师

MapReduce编程job概念原理

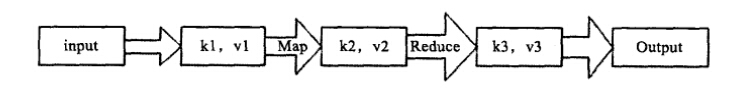
在Hadoop中,每个MapReduce任务都被初始化为一个job,每个job又可分为两个阶段:map阶段和reduce阶段。这两个阶段分别用两个函数来表示。Map函数接收一个<key,value>形式的输入,然后同样产生一个<ey,value>形式的中间输出,Hadoop会负责将所有具有相同中间key值的value集合在一起传递给reduce函数,reduce函数接收一个如<key,(list of values)>形式的输入,然后对这个value集合进行处理,每个reduce产生0或1个输出,reduce的输出也是<key,value>形式。 简易代码: public static class Map extends MapReduceBase implments Mapper<LongWritable,Text,Text,IntWritable>{ //设置常量1,用来形成<word,1>形式的输出 private fianll static IntWritable one = new IntWritable(1) private Text word = new Text(); public void map(LongWritable key,Text value,OutputCollector<Text,output,Reporter reporter) throws IOException{ //hadoop执行map函数时为是一行一行的读取数据处理,有多少行,就会执行多少次map函数 String line = value.toString(); //进行单词的分割,可以多传入进行分割的参数 StringTokenizer tokenizer = new StringTokenizer(line); //遍历单词 while(tokenizer.hasMoreTokens()){ //往Text中写入<word,1> word.set(tokenizer.nextToken()); output.collect(word,one); } } } //需要注意的是,reduce将相同key值(这里是word)的value值收集起来,形成<word,list of 1>的形式,再将这些1累加 public static class Reduce extends MapReduceBase implements Reducer<Text IntWritable,Text,IntWritable>{ public void reduce(Text key,Iterator<IntWritable> values,OutputCollector<Text,IntWritable> output,Reporter reporter) throws IOException{ //初始word个数设置 int sum = 0; while(values,hasNext()){ //单词个数相加 sum += value.next().get(); } output.collect(key,new IntWritbale(sum)); } } 执行概念总结: job.setInputFormatClass(TextInputFormat.class); 1.InputFormat()和inputSplit inputSplit是Hadoop定义的用来传送给每个单独的map的数据,InputSplit存储的并非数据本身,而是一个分片长度和一个记录数据位置的数组,生成InputSplit的方法可以通过InputFormat(I)来设置。当数据传送给map时,map会将输入分片传送到inputFormat上,InputFormat则调用getREcordReduer()方法生成RecordReader,RecordReader再通过createKey()、createValue()方法创建可供map处理的<key,value>对,即<k1,v1>,简而言之InputFormat方法是用来生成可供map处理的<key,value>对的。 在这里如果不设置的话,TextInputFormat会是Hadoop默认的输入方法,在TextInputFormat中,每个人间(或其一部分)都会单独地作为map的输入,继承自FileInputFormat,之后,每行数据都会生成一条记录,每条记录则表示成<key,value>形式: 其中,key值是每个数据的记录在数据分片中的字节偏移量,数据类型是LongWritable. value值是每行的内容,数据类型是Text。 job.setOutputValueClass(TextInputFormat.class); 2、OutputFormat 每一种输入格式都有一种输出格式与其对应。同样,默认的输出格式是TextOutputFormat,这种输出方式与输入类似,会将每条记录以一行的形式存入文本文件。不过它的键和值都可以以任意形式的,因为程序内部会调用toString()方法将键和值转换为String类型再输出。 3、map和reduce map函数接收经过inputFormat处理产生的<k1,v1>,然后输出<k2,v2>,map函数老的版本写法是继承MapReduceBase然后实现Mapper接口,但是现在可以直接继承Mapper接口,此接口是一个泛型类型,有4种形式的参数,分别用来指定map的输入key值类型(LongWritable key),输入value值类型(Text value)、输出key值类型和(Text)输出value值类型(IntWritable,本例是reporter)。 reduce函数以map的输出作为输入,因此reduce的输入类型是<Text,IntWritable>.而reduce的输出是单词和它的数目,因此,它的输出类型是<Text,IntWritable> 4、任务调度 计算方面:Hadoop总会有限将任务分配给空闲的机器,使所有的任务能公平地分享系统资源,I/O方面:Hadoop会尽量将map任务分配给InputSplit所在机器,以减少网络I/O的消耗。 5、数据预处理与InputSplit的大小。 Hadoop会在处理每个block后将其作为一个InputSplit,因此合理地甚至block块大小是很重要的。也可通过合理地设置map任务的数量来调节map任务的数据输入。 6、map和reduce任务的数量 设置map任务槽和reduce任务槽,map/reduce任务槽是这个集群能够同时运行的map/reduce任务的最大数量。可以通过hadoop的配置文件设置每台机器最多可以同时运行map任务和reduce任务的个数,比如有10台机器,设置每台最多可以同时运行10个map任务和5个reduce任务,那么这个集群的map任务槽就是1000,reduce任务槽就是500.一般来说,设置的reduce任务数量应该是reduce任务槽的0.95或是1.75倍 7、combine函数 combine函数是用于在本地合并数据的函数,从wordcount程序中,词频是一个接近于zipf分布的,每个map任务可能会产生成千上万个<the,i>记录,若将这些记录一一传给reduce任务是很耗时的,所以可以设置一个combine函数,用于本地合并,大大减少网络I/O操作的消耗。 job.setCombinerClass(combine.class); //指定reduce函数为combine函数 job.setReducerClass(Reduce.class); 8、Hadoop流的工作原理 当一个可执行文件作为Mapper时,每个map任务会以一个独立的进程启动这个可执行文件,然后在map任务运行时,会把输入切分成行提供给可执行文件,并作为它的标准输入(stdin)内容。当可执行文件运行处结果时,map从标准输出(stdout)中手机数据,并将其转化为<key,value>对,作为map的输出。 参考:<Hadoop实战>

优秀的个人博客,低调大师

MapReduce编程实现学习

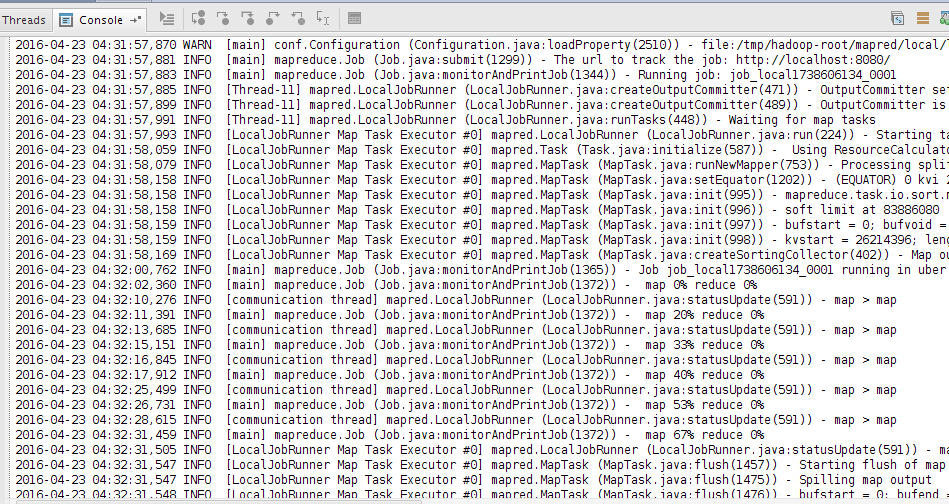
MapReduce主要包括两个阶段:一个是Map,一个是Reduce. 每一步都有key-value对作为输入和输出。 Map阶段的key-value对的格式是由输入的格式决定的,如果是默认的TextInputFormat,则每行作为一个记录进程处理,其中key为此行的开头相对文件的起始位置,value就是此行的字符文本。Map阶段的输出的key-value对的格式必须同reduce阶段的输入key-value对的格式相对应。 下面开始尝试,假设我们需要处理一批有关天气的数据,其格式如下:按照ASCII码存储,每行一条记录每一行字符从0开始计数,第15个到第18个字符为年第25个到第29个字符为温度,其中第25位是符号+/- Text文本样例: 0067011990999991950051507+0000+ 0043011990999991950051512+0022+ 0043011990999991950051518-0011+ 0043012650999991949032412+0111+ 0043012650999991949032418+0078+ 0067011990999991937051507+0001+ 0043011990999991937051512-0002+ 0043011990999991945051518+0001+ 0043012650999991945032412+0002+ 0043012650999991945032418+0078+ 上代码啦: package Hadoop; import java.io.IOException; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configured; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.Reducer.Context; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.input.TextInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat; import org.apache.hadoop.util.Tool; import org.apache.hadoop.util.ToolRunner; import java.io.IOException; import java.util.StringTokenizer; /** * Created by root on 4/23/16. */ public class hadoopTest extends Configured implements Tool{ //map将输入中的value复制到输出数据的key上,并直接输出 public static class Map extends Mapper<LongWritable, Text, Text, IntWritable> { //实现map函数 @Override public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String year = line.substring(15, 19); int airTemperature; if (line.charAt(25) == '+') { airTemperature = Integer.parseInt(line.substring(26, 30)); } else { airTemperature = Integer.parseInt(line.substring(25, 30)); } context.write(new Text(year), new IntWritable(airTemperature)); } } //reduce将输入中的key复制到输出数据的key上,并直接输出 public static class Reduce extends Reducer<Text, IntWritable, Text, IntWritable> { public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException { int maxValue = Integer.MIN_VALUE; for (IntWritable sorce : values) { maxValue = Math.max(maxValue, sorce.get()); } context.write(key, new IntWritable(maxValue)); } } @Override public int run(String[] arg0) throws Exception { //这里测试用,传入的路径直接赋值 String InputParths = "/usr/local/hadooptext.txt"; String OutputPath = "/usr/local/hadoopOut"; //声明一个job对象,这里的getConf是获取hadoop的配置信息,需要继承Configured. Job job = new Job(getConf()); //设置job名称 job.setJobName("AvgSorce"); //设置mapper输出的key-value对的格式 job.setOutputKeyClass(Text.class); //设置Mapper,默认为IdentityMapper,这里设置的代码中的Mapper job.setMapperClass(hadoopTest.Map.class); //Combiner可以理解为小的Reducer,为了降低网络传输负载和后续Reducer的计算压力 可以单独写一个方法进行调用 job.setCombinerClass(Reduce.class); //设置reduce输出的key-value对的格式 job.setOutputValueClass(IntWritable.class); //设置输入格式 job.setInputFormatClass(TextInputFormat.class); //设置输入输出目录 FileInputFormat.setInputPaths(job, new Path(InputParths)); FileOutputFormat.setOutputPath(job, new Path(OutputPath)); boolean success = job.waitForCompletion(true); return success ? 0 : 1; } public static void main(String[] args) throws Exception { int ret = ToolRunner.run(new hadoopTest(), args); System.exit(ret); } } Map函数继承自MapReduceBase,它实现了Mapper接口,此接口是一个范型类型,它有4种形式的参数,分别用来指定map的输入key值类型、输入value值类型、输出key值类型和输出value值类型。这里使用的是TextInputFormat,它的输出key值是LongWritable类型,输出value是Text类型。因为需要输出<word,1>形式,因此输出的key值类型是Text,输出的value值类型是IntWritable InputFormat()和inputSplit InputSplit是Hadoop定义的用来传输给每个单独的map的数据,InputSplit存储的并非数据本身,而是一个分片长度和一个记录数据位置的数组。生成InputSplit的方法可以通过InputFormat()来设置。当数据传输给map时,map会将输入分片传送到InputFormat上,InputFormat调用getRecordReader()方法生成RecordReader,RecordReader再通过creatKey()、creatValue()方法创建可供map处理的<key,value>对,即<k1,v1>,InputFormat()方法是用来生成可供map处理的<key,value>对的。 TextInputFormat是Hadoop默认的输入方法,在TextInputFormat中,每个文件都会单独地作为map的输入,而这是继承自FileInputFormat的,之后,每行数据都会生成一条记录,每条记录则表示成<key,value>形式。 这里的key是每个数据的记录在数据分片中的字节偏移量,数据类型是LongWritable. value值是每行的内容,数据类型是Text. 执行结果:

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册