首页 文章 精选 留言 我的

精选列表

搜索[codex],共2040篇文章
优秀的个人博客,低调大师

Codex赋能AI一人公司OPC:从内容理解到用户兴趣的工程化路径

## 一、为什么推荐是短视频的胜负手 短视频产品的用户体验,本质上由一条信息流决定。用户打开 App,看到的第一屏内容,决定了他会不会继续看第二屏。这条信息流的组织方式,就是推荐系统。 短视频和长视频、图文的最大区别在于**消费节奏极快**。一条内容 15 秒,用户 3 秒内决定划走还是留下。这意味着推荐系统必须在极短时间内完成"理解内容、判断兴趣、排序呈现"的全过程,而且每一次判断都有明确的反馈信号——完播、点赞、评论、划走、停留时长。 这种高频、强反馈的特性,让短视频推荐成为一个典型的**大规模实时机器学习系统**。它的难点不在单个模型多先进,而在整条链路的工程化:内容如何被理解、用户兴趣如何被刻画、候选如何被高效召回、排序如何平衡多目标、系统如何应对冷启动与实时变化。 本文试图给出一个分层、可落地的推荐系统设计思路,重点在工程结构而非模型细节。 ## 二、推荐系统的核心问题模型 抛开具体算法,推荐系统要回答三个问题: **用户是谁?** 兴趣、行为历史、活跃时段、消费偏好。这是用户画像要解决的。 **内容是什么?** 主题、风格、质量、时长、新鲜度。这是内容理解要解决的。 **此刻该给什么?** 在特定上下文(时间、场景、设备、当前 session 行为)下,从海量候选里选出最可能被消费的若干条。这是召回、排序、重排要解决的。 三者构成一个经典的三元组:**User × Item × Context → Score**。推荐系统的全部工程,都是围绕如何高效、准确地计算这个 Score 展开的。 一个重要的认知是:**推荐不是预测"用户喜欢什么",而是优化"用户接下来会消费什么"**。这两者不同——用户可能喜欢高质纪录片,但此刻在地铁上只想刷轻松的段子。上下文权重往往比长期兴趣更大。 ## 三、分层架构:从数据到呈现 一个生产级短视频推荐系统,通常按五层组织,自下而上依次是: **数据层**:行为日志采集、内容元数据、用户画像、特征存储。这一层解决"数据从哪来、如何实时更新"。 **召回层**:从百万级内容池中快速筛出千级候选。多路召回并行,每路负责一种信号(协同过滤、向量召回、热门、关注、地域等)。 **排序层**:对候选做精细打分。通常分粗排(轻量模型,千级→百级)和精排(复杂模型,百级→十级)。 **重排层**:在精排结果上做多样性、新鲜度、去重、业务规则调整。解决"排序最优但列表不好看"的问题。 **策略与呈现层**:最终列表组装、频控、探索与利用、A/B 实验、实时反馈回流。 这五层的核心设计原则是**逐层收敛**:每一层都在上一层的基础上缩小候选集、提升精度,同时控制计算成本。召回追求"不漏",排序追求"精准",重排追求"体验"。 ## 四、核心组件设计要点 ### 4.1 内容理解 短视频的内容理解是多模态的:视频帧(画面)、音频(语音、音乐)、文本(标题、字幕、评论)。工程上要解决三件事: **结构化打标**:主题分类、实体识别、场景标签、质量分。标签体系要稳定、可扩展,避免"标签爆炸"。 **向量化**:把内容映射为 embedding,供向量召回使用。多模态融合是关键——纯文本 embedding 会丢失画面信息,纯视觉 embedding 又抓不住语义。 **质量与安全**:低质、重复、违规内容要在入库时过滤,而不是等到推荐时再处理。这是推荐系统的"负样本治理"。 ### 4.2 用户画像与实时兴趣 用户画像分两层:**长期画像**(稳定偏好、人口属性)和**实时兴趣**(当前 session 的行为序列)。 短视频的实时性要求极高。用户刚看完三条宠物视频,下一条就应该倾向宠物内容。这要求系统具备**流式特征更新**能力:行为发生→特征更新→下一轮推荐生效,延迟要控制在秒级。 实时兴趣建模的核心是**行为序列建模**:把用户最近的点击、完播、划走序列编码成向量,作为排序模型的重要输入。序列的长度、时间衰减、行为类型权重,都是需要调优的设计点。 ### 4.3 多路召回 单路召回一定不够。生产系统通常并行跑 5–10 路召回,每路覆盖不同信号: - **协同过滤**:相似用户喜欢的内容。 - **向量召回**:用户 embedding 与内容 embedding 的近邻。 - **热门/趋势**:平台级热度,保证基础体验。 - **关注/社交**:已关注创作者的新内容。 - **地域/时间**:本地化与时段性内容。 - **探索召回**:给新内容、新创作者曝光机会。 多路召回的关键工程问题是**融合与配额**:每路召回多少条、如何合并去重、如何保证各路都有机会。常见做法是按路分配配额,再统一送入排序。 ### 4.4 排序模型 排序是推荐系统的精度核心。典型结构是**粗排 + 精排**两级: 粗排用轻量模型(双塔、浅层网络)快速过滤,目标是"不丢好内容";精排用复杂模型(深度交叉、序列建模)精细打分,目标是"排得准"。 短视频排序的特殊性在于**多目标**:完播率、点赞率、评论率、分享率、负反馈率。这些目标往往冲突——标题党能拉高点击但拉低完播。工程上常用多任务学习(MMoE、PLE)共享底层、分目标输出,再用融合公式加权。融合权重不是固定的,要按场景、用户、内容类型动态调整。 ### 4.5 重排与体验优化 精排给出的是"单条内容的分",但用户看到的是"一个列表"。重排要解决列表级问题: **多样性**:避免连续同类内容导致审美疲劳。常用打散策略(按标签、创作者、主题做间隔约束)。 **新鲜度**:控制重复推荐,保证内容更新。 **探索与利用**:给新内容、新创作者一定曝光配额,避免马太效应。 **业务规则**:频控、置顶、广告插入、合规过滤。 重排的本质是**在个体最优与列表最优之间做权衡**。纯按分数排序,列表往往同质化严重。 ## 五、少量代码:一个最小推荐 pipeline 理论讲完,用一个精简示例展示五层架构如何串起来。代码只保留结构,省略模型细节与工程优化: ``` class Recommender: def __init__(self, recallers, ranker, reranker, feature_store): self.recallers = recallers # 多路召回 self.ranker = ranker # 粗排 + 精排 self.reranker = reranker # 重排 self.fs = feature_store # 特征存储 def recommend(self, user_id, context, n=10): # 1. 取用户特征与实时兴趣 user_feat = self.fs.user(user_id) seq_feat = self.fs.recent_behavior(user_id, window="1h") # 2. 多路召回,按配额合并去重 candidates = [] for rec, quota in self.recallers: candidates += rec.recall(user_feat, context, topk=quota) candidates = dedup(candidates) # 3. 排序:粗排过滤 -> 精排打分 coarse = self.ranker.coarse(candidates, user_feat, topk=200) scored = self.ranker.fine(coarse, user_feat, seq_feat) # 4. 重排:多样性 + 新鲜度 + 业务规则 final = self.reranker.adjust(scored, rules=context.rules, topk=n) return final ``` 这段代码的价值不在实现,而在它显式化了推荐系统的四个关键环节:**特征准备、多路召回、分级排序、列表重排**。真实系统无非是在每个环节加缓存、加并发、加降级、加实验分流。看懂这个骨架,再看任何工业级推荐架构,都能快速定位它在哪一层做了取舍。 ## 六、工程挑战:冷启动、实时性、多样性 推荐系统的工程难度,集中体现在几个"永远绕不开"的问题上。 **冷启动**。新用户没有行为,新内容没有曝光。常见解法:新用户用热门 + 探索 + 少量画像补全;新内容给保量曝光 + 快速反馈学习。冷启动的核心是**用先验知识换时间**,而不是等数据积累。 **实时性**。短视频的反馈周期以秒计,推荐系统要能在秒级完成"行为→特征→模型→排序"的闭环。这要求流式计算、在线特征存储、模型热更新三者配合。实时性做不好,系统永远慢半拍。 **多样性**。纯优化点击率会导致内容同质化、创作者马太效应、用户长期兴趣窄化。多样性不是"锦上添花",而是**长期留存的关键**。工程上要在排序目标里显式加入多样性约束,而不是靠重排打补丁。 **可解释与可控**。推荐系统要能回答"为什么推这条",也要能被业务干预(置顶、屏蔽、配额)。黑盒系统在运营和合规上都会遇到麻烦。 ## 七、评测体系 推荐系统的评测,远比传统软件复杂,因为它优化的是"长期用户价值",而可观测的只有短期行为。实践中通常三层评测: **离线评测**:用历史数据评估召回率、排序 AUC、NDCG 等指标。快、便宜,但和线上效果有偏差。 **在线 A/B**:分流实验,对比人均消费时长、完播率、留存、负反馈率。这是最终裁判。 **长期指标**:留存、活跃、创作者生态健康度。短期指标涨、长期指标跌,是推荐系统最常见的陷阱。 评测的关键是**指标体系要平衡**。只看点击率会催生标题党,只看时长会催生沉迷设计。健康的评测体系要同时看消费、互动、负反馈、留存、生态。 ## 八、常见误区 **误区一:唯模型论。** 以为换个更强的排序模型就能提升效果,忽视特征、召回、数据质量。实际上特征工程和召回覆盖往往比模型结构影响更大。 **误区二:只看短期指标。** 点击率、时长涨了,留存跌了,长期是亏的。 **误区三:召回单路。** 只靠一路召回,覆盖不足,排序再强也巧妇难为无米之炊。 **误区四:忽视负反馈。** 划走、不感兴趣、举报,这些信号比正反馈更稀缺也更宝贵,处理不好会持续推用户讨厌的内容。 **误区五:多样性靠重排硬打散。** 治标不治本,应该在召回和排序阶段就考虑内容分布。 **误区六:冷启动靠等。** 不主动设计探索机制,新内容永远起不来,生态会僵化。 ## 九、结语 短视频推荐系统的本质,是**在极短时间、极大候选、极强反馈的条件下,把"用户此刻想看什么"工程化地算出来**。它的难点不在单个模型,而在五层链路的协同:内容理解决定召回上限,召回决定排序空间,排序决定精度,重排决定体验,策略决定长期健康。 一句话总结:**好的短视频推荐系统,不是把最可能点击的内容排在前面,而是在用户、内容、上下文三者之间,持续找到"当下最合适"的平衡——并且让这个平衡可度量、可干预、可演进。**

优秀的个人博客,低调大师

Codex、WorkBuddy能够承载起企业AI转型的任务吗?企业应该如何打造属于自己的AI能力?

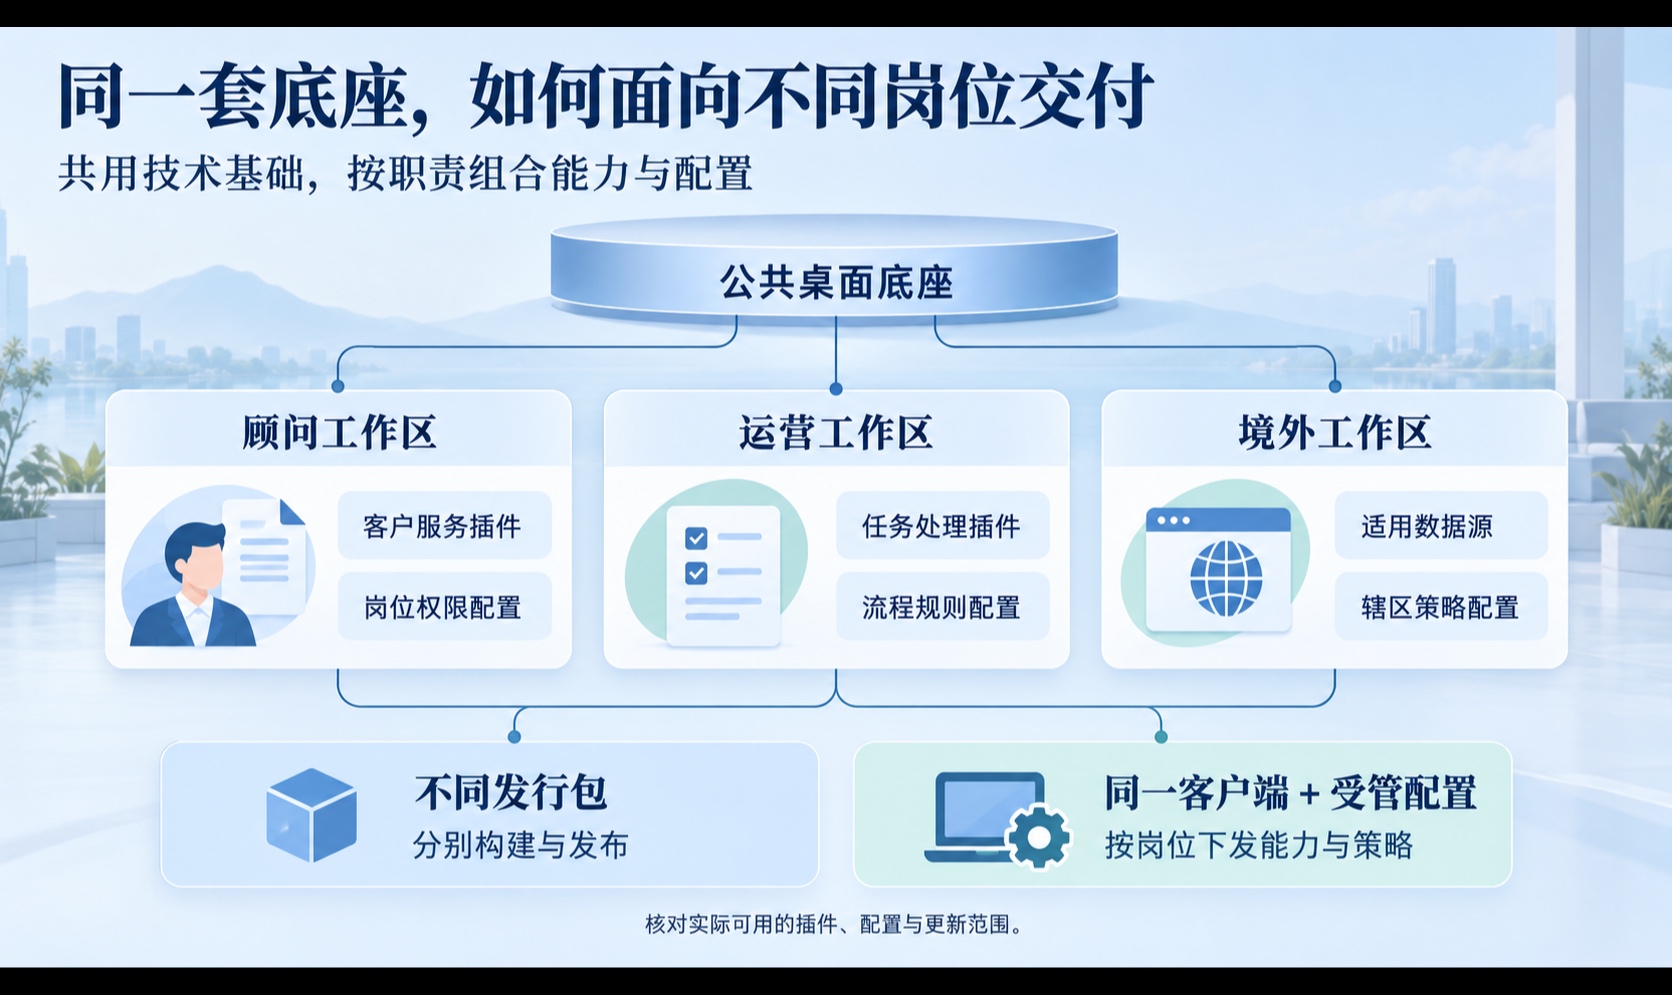
> 企业 AI 落地,除了模型能力,还需要一套共享的运行与管理机制:谁能代表哪个租户行动、代码在什么边界里跑、对存量系统的写操作谁说了算、员工用的入口是不是企业自己的。本系列讲清这些层,并用可核对的工程事实说话——企业 AI 操作系统。 设想一场数字化例会:安全把前四层都勾过了——请求进得了认证、运行时按租户落盘、主机上套了隔离、核心写接口前面有闸门。 IT 经理补了一句:“员工周一打开的,是别人家的桌面。”台下有人点头。 若各部门各自安装未经 IT 统一管理的桌面 Agent,网关日志仍可能干干净净,但员工每天点开的图标,写的往往是供应商的名字。下文说的“现场”,都是这类可对照的检查场景,不是某一家客户的内部工单。 前四篇分别讲了连接面、常驻运行时、主机沙箱、行动面。四层都成立,仍回答不了:员工每天打开的那扇 AI 办公门,品牌、插件和安装包归谁。 入口替不了沙箱,也替不了写接口治理。入口缺位,企业还需要确认:员工从不同桌面发起的操作,是否都经过了既定的控制。 **入口主权说的不是“员工能不能用 AI”。它说的是:默认入口由谁分发、窗口长什么样、里面能装哪些插件、安装包按谁的策略打出来。** 买到桌面产品的使用权,并不自动意味着企业掌握了这些决定权。 ![cover_2.35x1](https://developer.qcloudimg.com/http-save/yehe-11973325/358f35e06969b1e530287da4c920bf77.png) ## 别人家的桌面,正在变成默认入口 桌面 Agent 会读授权目录、改文件、接企业邮箱和网盘,关了浏览器也还能继续工作。员工把它当成办公壳,不是当成网页书签。 微软将未经 IT 知悉或批准的消费级 AI 应用和独立 Agent 纳入 Shadow AI(影子 AI)的范畴。其预览文档列出了 ChatGPT Desktop、Claude Desktop、Ollama Desktop 等检测对象,并对 OpenClaw 提供检测与拦截;拦截目前仅覆盖已加入 Intune 的托管 Windows 设备。 能看见、能拦一部分,不等于企业已经有了自己的入口。 Defender 的本地 Agent 发现说明写道,这些程序以用户权限运行,能接触文件、工具和服务;看不见在哪台机器、以谁的身份运行,就难以评估暴露面。发现解决的是盘点问题。 腾讯 WorkBuddy 产品页与 Anthropic 的 Cowork 企业指南,都描述了“桌面里办事”:下任务、读写授权本地文件。Cowork 的本地文件与桌面应用操作需要 Claude Desktop,客户端可通过 MDM 推送,也可由员工自行安装。 这些产品同样可以提供企业管理能力。例如,Claude Desktop 支持用 Jamf、Intune 下发配置,Cowork 提供企业插件管理与分发策略。但在供应商提供的窗口中管理策略,与企业自行定义和发行一套桌面,仍是不同的事情。 **盘点清了,还要继续问:品牌、插件接口和发布节奏,企业分别能决定到哪一步?** ## 入口也能像浏览器那样分层 浏览器早就拆过这件事。Chromium 提供共用的技术基础;Chrome、Edge 则是不同的浏览器产品,有各自的界面、扩展管理和发行安排。共用底座,不意味着交付的是同一个产品。 桌面 AI 入口可以按同一组问题切开。 **启动层(Host):谁来启动程序,插件走哪套接口。** 它负责程序启动、注册,以及给上层使用的软件接口。换品牌、换插件集,都不该逼着开发团队重写这一层。 **窗口壳(Shell):员工看见哪套导航和品牌。** 侧栏、顶栏、导航,构成员工看见的办公外壳。它决定界面如何组织,不负责回答代码在哪组主机隔离机制里运行。 **插件(Plugin):这扇门里允许办哪些事。** 插件承载具体办事的界面和能力,应通过启动层公开的接口使用底座能力,避免各自依赖桌面主进程的私有通道。至于对核心系统的写操作该不该发生,仍需由对应的权限和行动治理机制判断。 **发行单元(Distribution):员工真正拿到哪套组合。** 哪一套壳、哪些插件、什么品牌、什么策略,需要落实到最终交付的版本中。它回答的是软件交付内容,和席位账单是否已付是两件事。 还可以再叠配置档案(Profile):按版本、辖区或条线组合,而不必为每个地区重写启动层。 白牌在这里才有具体的工程含义:企业能决定交付给员工的壳、插件和策略如何组合,开始菜单里出现的是自己的办公入口。 Rocket.Chat 的白牌文档举例说明了如何修改图标、托盘图、关于页版权,以及在 electron-builder 中修改 productName,也就是安装程序与系统应用列表里显示的名字。 图标和产品名能改,只证明品牌表面可换;插件谁能上架、共享界面走哪套接口、正式包打进哪一个发行单元,还需要分别核对。 **判断入口是否由企业掌握,要看企业能否指出:员工拿到的壳、插件和策略,属于哪一个由自己管理的发行组合。** ## 常见错法与更短的对照 容易混淆的,是把席位、换皮和入口主权当成一件事。 ![diagram_02_role_distribution](https://developer.qcloudimg.com/http-save/yehe-11973325/d572657cb3e10e78fd53221044bbd940.png) **只禁不替。** 能在部分托管设备上拦截某类桌面 Agent,不等于员工不再找别的安装包。禁令没有配套可用的替代入口,实际工作就可能转向尚未被盘点的工具。 **买了席位就当有了企业入口。** 管理控制台可以管账号、额度、账单,也可能管理插件和策略;窗口叫什么、导航如何组织、版本怎么发布,仍取决于产品开放的范围。需要逐项核对,不能仅凭购买了企业版来判断。 **只换图标和关于页。** 品牌表面换了,插件仍依赖供应商私有通道,壳仍是固定导航,机构自己的能力也没有独立维护的位置。此时换掉的是外观,后续定制仍可能牵动整套客户端。 **把入口当成沙箱或行动网关。** 入口回答“员工打开谁的门”;主机隔离回答代码在哪跑;行动面回答对存量系统的写该不该发生。把三件事混进同一个安装包叙事,评审时就容易忽略各自的控制边界。 **忽略不同岗位的交付差异。** 辖区和条线不同,威胁模型和能办的事也不同。可以使用不同发行单元,也可以通过同一安装包的受管配置来区分。关键是避免把不该出现的插件发到不该出现的工位。 更好的做法很短:承认员工会从桌面办事;把启动层保持稳定,让壳、插件和发行组合可以分别管理;插件依赖公开接口;正式交付对应明确的版本与配置;桌面接上已有的运行时和主机隔离。 四层分开画,评审才问得清楚:买的是使用权,改的是外观,还是已经具备了自主发行和维护的能力。 ![diagram_01_entry_architecture](https://developer.qcloudimg.com/http-save/yehe-11973325/1931d7f8f6e0c02ec055ad8400d83601.png) ## 一条可核对的入口层 分层讲到这里,已经不依赖任何一家供应商。需要核对的是:入口能不能写成可组合、可维护、可发行的软件结构。 例如,凡泰 FinDesk 的公开材料描述了桌面 SDK 与独立发行仓的分工,由壳、插件、配置档案和发行单元组成不同的桌面版本。这个例子说明,入口定制可以落实为工程组合,而不只是在界面上换一个图标。 入口层能核对的,是这些部分有没有被拆开、由谁维护。它本身不证明代码已经进入隔离环境,也不证明对核心系统的写操作已被批准。 读者可以带走四个问题:员工打开的窗口叫谁的名字;插件走谁的接口;安装包对应哪一个发行单元;这扇门有没有被误当成沙箱或写入治理。 ## 下周就能做的五件事 不必先换桌面产品。先对着员工已经在用的那几个 AI 桌面,拉上 IT、安全和一条业务线,回答同一组问题。 **1. 点名默认入口。** 员工周一最常打开的是哪一个安装包,从哪里安装,由谁管理。写不出名字,就先补盘点。 **2. 分开席位和发行单元。** 管理控制台里的席位、额度、账单,与安装包里的品牌、插件、策略,列成两列。分别写清企业能控制哪些内容。 **3. 画出四层。** 启动层、窗口壳、插件、发行单元,各写一句它回答什么。如果把桌面入口直接当作沙箱或写入治理,需要重新划清职责。 **4. 核对接线。** 插件是否通过启动层公开的接口使用底座能力。如果共享界面直连桌面主进程的私有通道,换壳就可能牵动插件,后续维护也会更困难。 **5. 按条线看交付。** 顾问、柜台、境外团队,是否应该拿到相同的插件与配置。若只能全部禁止或全部开放,就先补齐按岗位组合和管理的能力,再谈推广。 这些问题答不清时,可以先把入口的决定权和维护责任理清,再评估是否需要新增一款桌面 Agent。 ## 讨论 你们线上那扇“员工已经用得很顺”的 AI 桌面,安装包里的壳、插件和策略,是由企业自主组合、维护和发布,还是在供应商提供的范围内配置? ## 参考资料 1. Microsoft Learn:《Understand Shadow AI in Microsoft 365 admin center》。 2. Microsoft Learn:《Local AI agent discovery with Microsoft Defender for Endpoint》。 3. 腾讯云:《WorkBuddy》产品说明。 4. Anthropic:《Claude Cowork Enterprise Admin Guide》。 5. Anthropic Help Center:《Enterprise configuration for Claude Desktop》。 6. Rocket.Chat:《White-label Your Desktop App》。 7. electron-builder:《Configuration》中的 productName 配置说明。 8. 凡泰极客:《FinDesk 端云一体方案,让企业掌控自己的 AI 终端》。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

用户登录
用户注册