首页 文章 精选 留言 我的

精选列表

搜索[递归超智能],共10000篇文章
优秀的个人博客,低调大师

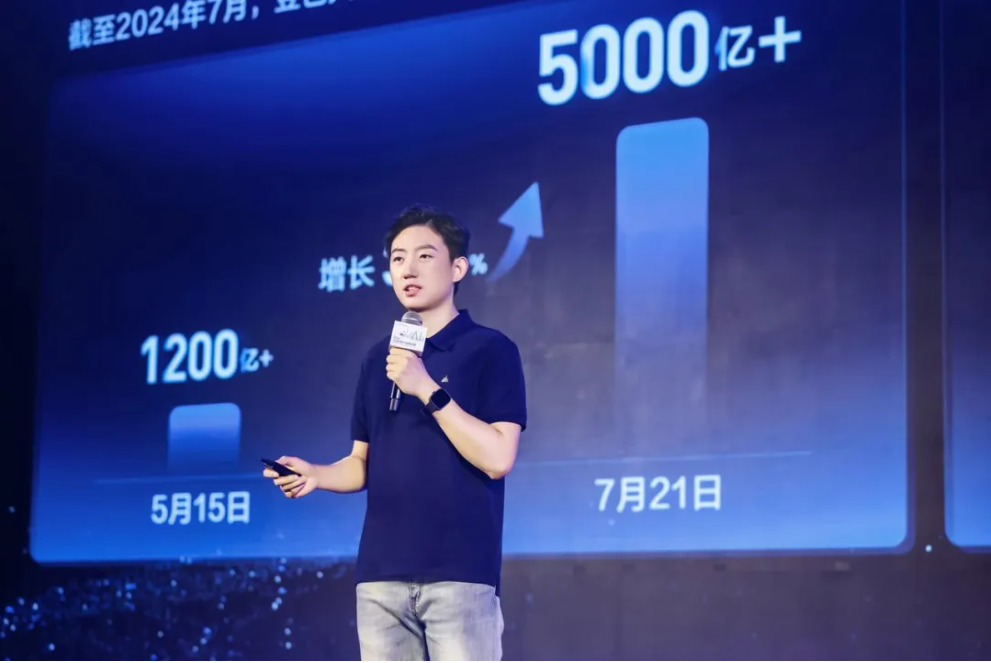
豆包大模型日均 tokens 使用量超 5000 亿

在 2024火山引擎 AI 创新巡展·成都站上,火山引擎方面透露,截至今年7月,豆包大模型日均 tokens 使用量超过5000亿。 火山引擎在今年5月发布豆包大模型,提供包含大语言模型、语音模型、视觉模型的豆包模型家族,以满足不同场景的关键需求。自今年5月15日豆包大模型发布的2个月内,平均每家企业客户日均 tokens 使用量增长了22倍。 火山引擎副总裁张鑫在会上介绍,在字节内部,有50多个业务在使用豆包大模型,覆盖了协同办公、数据分析、文案创作、辅助编程、内容审核、客服、游戏NPC、角色对话、教育等各种场景,基于豆包大模型打造的新技术引擎正在加速业务创新。 此外,豆包大模型的外部客户已覆盖手机、汽车、金融、消费、互娱等30多个行业。

优秀的个人博客,低调大师

技术解密Java Chassis 3超实用的可观测性

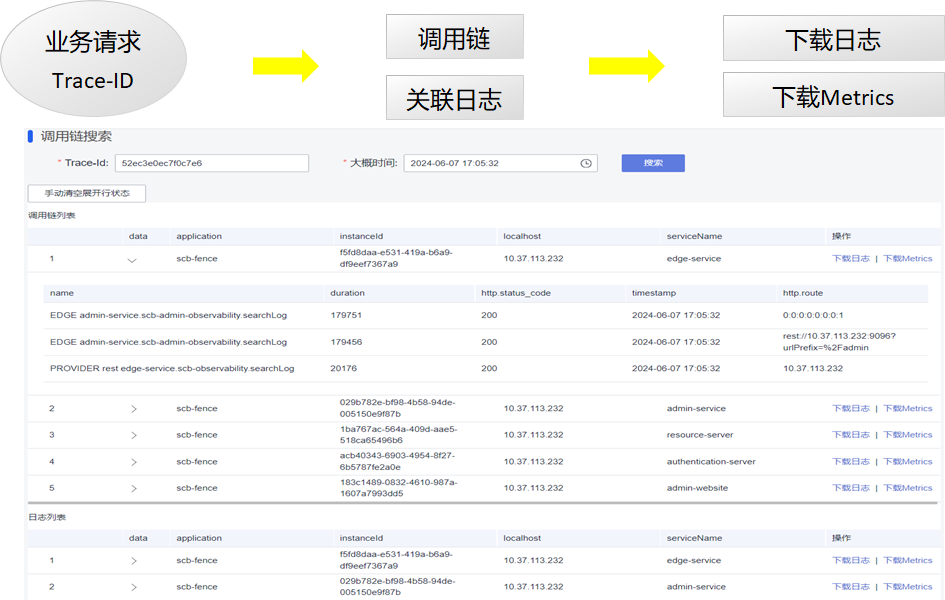
本文分享自华为云社区《Java Chassis 3技术解密:实用的可观测性》,作者:liubao68。 狭义的可观测性,指日志、调用链和指标,广义的可观测性则包含更多的内容,一般的,应用程序暴露出来的便于理解其运行状态、运行轨迹、内部结构和功能集合的信息,都是可观测性的范围,本文只讨论狭义的可观测性。日志揭露了应用程序内部运行的轨迹,通过异常日志,可以理解错误产生的原因;调用链反映的是一次业务操作经过的关键处理节点,可以帮助快速确定问题发生的边界;指标反映错误发生时应用程序的当前或者历史状态,帮助分析需要一定的时间或者流量积累才会发生的问题,比如过载问题、性能问题等。可以看出,为了分析故障,具备可观测性能力非常重要。 微服务系统具备复杂的调用关系和分布式部署特征,为了更好的分析和处理日志、调用链和指标,通常会部署ELK、SkyWalking和Prometheus等外部系统。 这些系统完全搭建起来,会花费数十万每年的计算成本,而且很可能并没有显著提升日常问题定位的效率,不恰当的使用还可能会引入性能问题。针对问题定位难的情况,Java Chassis 3提供了非常简单高效,而且低成本的解决方案。由于采集的数据,都是和Java Chassis运行过程和系统架构强相关的,也避免了采集海量无关数据,使得数据对于问题分析更具有针对性,能够更加快速识别问题根因。 在下面的部分,我们首先解密如何使用可观测能力来快速定位问题,然后再解密这个能力是如何构建起来的。 问题定位流程 在很多组织里面,问题定位都是由不太熟悉系统结构和技术细节的运维人员开始的,或者是由工作交接后刚刚接触系统的新人开始的,这给快速定界问题,收集和问题相关的信息带来了巨大的挑战。一个问题从发现到传递给责任模块,数个小时的时间就过去了。 设计一个简单的问题定位流程,快速定界问题和收集关联信息,是可观测系统搭建的起点。 当用户识别到一个故障,比如交易失败,在系统层面,会对应到一次系统请求的失败。在系统设计之初,会采用一个请求标识将用户故障和系统请求关联起来,即 TraceId, 这个是所有调用链系统设计的基础。 通常建议前端在发送请求的时候,都携带 TraceId, 便于将前后端请求进行关联。在前端未按照要求携带 TraceId 的情况下,Java Chassis会在应用网关 Edge Service生成 TraceId, 并在给前端响应的HTTP头中携带 TraceId。 当用户识别到一个故障,可以通过浏览器等前端工具获取到 TraceId。 问题定位的起点是获取TraceId。 在管理控制台,输入TraceId 和问题发生大概时间,可以检索出关键的调用链信息和关键日志信息。 通过调用链信息,可以知道请求的执行轨迹和发生问题的节点,通过关键日志信息,能够快速确定问题根因。 对于一些简单常见的问题,经过这个简单的步骤,就能够确定问题根因。 对于一些复杂的问题,需要获取上下文日志或者指标来进行深入的分析,运维人员可以在检索结果里面将完整的日志文件和指标信息下载下来,提供给故障服务的技术人员。 从上面的过程可以看出,运维人员在不理解系统实现细节的情况下,也能快速定界和定位一些简单问题,并能够快速收集详细的和问题强相关的信息提供给技术人员做进一步处理。 实现原理 Java Chassis在设计之初,就内置了大量的可观测能力。使用上述流程,无需部署ELK、SkyWalking和Prometheus去采集数据,也不需要集成这些工具的SDK或者Agent。 通过一些开发规范约束和可观测API就能够实现一个简单高效和易用的定位系统。 动手试试: 可以通过下载和运行fence项目,体验上述问题定位流程和了解本章节介绍的实现原理。 也可以在实际的业务系统中,参考该项目构筑业务需要的可观测能力。 Java Chassis通过集成 应用性能监控(https://servicecomb.apache.org/references/java-chassis/zh_CN/general-development/metrics.html) 、 微服务调用链(https://servicecomb.apache.org/references/java-chassis/zh_CN/general-development/microservice-invocation-chain.html) 来生成调用链和指标,日志则使用 slf4j 来记录。 这些数据构成了可观测的基础, 接下来就是如何存储和采集这些数据。 通过配置 log4j2 , 可以将日志、调用链和指标都输出到日志文件。 特别的,该日志配置约束了数据存储的规则、路径,为可观测API提供了简单的实现方案。 <Configuration> <Properties> <property name="FILE_PATH" value="./logs/admin-website"/> </Properties> <Appenders> <Console name="Console" target="SYSTEM_OUT"> <PatternLayout pattern="%-d{yyyy-MM-dd HH:mm:ss} [%X{SERVICECOMB_TRACE_ID}][%p][%t][%c:%L] %m%n"/> </Console> <RollingFile name="RootLog" fileName="${FILE_PATH}/root.log" filePattern="${FILE_PATH}/root-%d{yyyy-MM-dd-HH}.log"> <PatternLayout pattern="%-d{yyyy-MM-dd-HH:mm:ss} [%X{SERVICECOMB_TRACE_ID}][%p][%t][%c:%L] %m%n"/> <Policies> <TimeBasedTriggeringPolicy interval="3"/> </Policies> <DefaultRolloverStrategy max="100"/> </RollingFile> <RollingFile name="TraceLog" fileName="${FILE_PATH}/trace.log" filePattern="${FILE_PATH}/trace-%d{yyyy-MM-dd-HH}.log"> <PatternLayout pattern="%-d{yyyy-MM-dd HH:mm:ss} %m%n"/> <Policies> <TimeBasedTriggeringPolicy interval="3"/> </Policies> <DefaultRolloverStrategy max="100"/> </RollingFile> <RollingFile name="MetricsLog" fileName="${FILE_PATH}/metrics.log" filePattern="${FILE_PATH}/metrics-%d{yyyy-MM-dd-HH}.log"> <PatternLayout pattern="%-d{yyyy-MM-dd HH:mm:ss} %m%n"/> <Policies> <TimeBasedTriggeringPolicy interval="3"/> </Policies> <DefaultRolloverStrategy max="100"/> </RollingFile> </Appenders> <Loggers> <Logger name="scb-trace" level="INFO" additivity="false"> <AppenderRef ref="TraceLog"/> </Logger> <Logger name="scb-metrics" level="INFO" additivity="false"> <AppenderRef ref="MetricsLog"/> </Logger> <Root level="INFO"> <AppenderRef ref="Console"/> <AppenderRef ref="RootLog"/> </Root> </Loggers> </Configuration> 每个微服务都集成和实现可观测API。 @Path("/v1/scb/observability") public interface ObservabilityService { String NAME = "scb-observability"; @Path("/searchTrace") @GET SearchTraceResponse searchTrace(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/searchLog") @GET SearchLogResponse searchLog(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/downloadLog") @GET Part downloadLog(@NotNull @QueryParam("timestamp") String timestamp); @Path("/downloadMetrics") @GET Part downloadMetrics(@NotNull @QueryParam("timestamp") String timestamp); } 最后,我们可以开发一个管理控制服务,实现管理面可观测API, 就完成了可观测能力的构建: @Path("/v1/scb/admin/observability") public interface AdminObservabilityService { String NAME = "scb-admin-observability"; @Path("/searchTrace") @GET List<SearchTraceResponse> searchTrace(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/searchLog") @GET List<SearchLogResponse> searchLog(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("traceId") String traceId); @Path("/downloadLog") @GET Part downloadLog(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("serviceName") String serviceName, @NotNull @QueryParam("instanceId") String instanceId); @Path("/downloadMetrics") @GET Part downloadMetrics(@NotNull @QueryParam("timestamp") String timestamp, @NotNull @QueryParam("serviceName") String serviceName, @NotNull @QueryParam("instanceId") String instanceId); } 和传统方案的对比分析 与部署ELK、SkyWalking和Prometheus去采集数据的传统方案对比,上述方案非常简单和实用,能够帮助实时在线分析问题,该方案也无需将日志、调用链和指标等数据集中存储下来,可以节省大量的存储设备空间。 当然它的缺点也是显而易见的,对于已经下线的服务,或者对于历史问题需要追溯的情况,则采集不到相关的信息。 站在问题定位的角度,存储海量的日志、调用链和指标数据,大量数据都是和问题无关的,并且多数情况是要在第一时间完成问题定界和信息收集,因此上述方案相比于传统方案就有了非常大的竞争力优势。 客户故事:很多客户花了大量成本构建可观测能力,依然无法指导运维人员快速定界和定位问题。通过建立一个简单实用的问题定界流程和采集数据的手段,可以帮助提升问题定位效率。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

AMD 开源 GPU 内核驱动的代码行数超 500 万

科技媒体 Phoronix 对 AMD 的 Linux 内核图形驱动程序代码进行了一些 cloc 统计,尤其是drivers/gpu/drm/amd/模块,这些模块包含了围绕 AMDGPU DRM 驱动程序的现代代码,其中包括 AMDKFD 计算、用于显示的代码、通用头文件等(但不包括 drivers/gpu/drm/radeon/中的旧版 "Radeon" 驱动程序)。 据统计,开源 AMD Linux 内核图形驱动程序的代码行数超过 500 万: 当然,大部分是自动生成的头文件,其中很大一部分是 AMD 在每一代/每一个给定区块的新版本中不断引入新的自动生成头文件。这些冗长的头文件已成为 AMD 为其 GPU 创建详尽的公共文档的替代方案。 与此同时,英伟达的开源"Nouveau"驱动程序大约有 20 多万行(2 万多空行、2.4 万行注释和 15.5 万行代码)。英特尔 i915 DRM 内核图形驱动程序通过相同的 cloc 统计,约为 38.1 万行。 上面提到的只是内核图形驱动程序代码,还不包括 Mesa 中用于提供 OpenGL 和 Vulkan 驱动程序支持或其他用户空间组件的所有代码。 截至现在,整个 Linux 内核源代码树大约有 3480 万行,包括文档、各种树内实用程序/工具、其他辅助工具等。

优秀的个人博客,低调大师

日下载量超 88 TB,Flathub 公布 2023 规划

Endless OS 基金会的 CEO 和 GNOME 董事会主席 Robert McQueen 日前发布了一篇博客文章,分享了 Flathub 的发展状况,以及在 2023 年的一些规划,让我们可以提前预览到 Flatpak 在 Linux 桌面上的变化。 根据介绍,Flathub 目前提供了超过 2000 个 Flatpak 格式的应用程序,共有超过 1500 个合作对象,每天大约有 70 万个应用程序通过 Flathub 被用户下载,CDN 每天处理的 HTTP 请求达到 8.98 亿次,总计 88.3 TB,如今这一数字还在持续增长。 看看这些数字,Flathub 如今已经不再仅仅是一个专门下载 Flatpak 应用程序的商店了,可以说 Flathub 都要成为 Linux 事实上的应用商店了。 Robert McQueen 表示: 在我看来,Flatpak 解决了过去 25 年来阻碍 Linux 在桌面(或其他个人计算设备)上发展和提升接受程度的最大技术问题:即应用程序开发者难以用一种让人们很容易发现、下载(或侧载)、安装和使用的方式来发布他们开发的作品。 正如《GNOME 和 KDE 联手将 Flathub 打造成供应商中立的应用商店》这篇文章中的介绍,今年他们将会对 Flathub 好好改造一番,并且将会增加直接上传应用和验证的功能。 在博客文章中 Robert McQueen 表示,目前直接上传应用程序的功能已经接近准备就绪,允许开发者在 flatpak-builder 之外构建 Electron 应用程序,或者从 GitHub actions 或 GitLab CI 中自动上传。 Flathub 也在推进支付设置,目前已经实现了对一次性付款的支持,与此同时也在开发订阅服务「这将使我们能够在用户和开发者之间建立一种关系,为持续的工作提供资金」。 将 Flathub 打造为应用商店离不开安全性,为此,他们正计划建立基础设施以在 Flathub 的后端设置自动提示和安全扫描,以帮助开发者发现不良的做法、不必要的沙盒权限、过时的依赖等,成为一个能够让用户对提供的应用程序的质量和安全有信心的平台。 Flathub 在今年已经收到了金额为 10 万美元的资助,但他们希望今年的可用资金能增加到 25 万美元,以支付下一轮的软件开发费用、为更高的运营成本做准备,并为 Flathub 的发展提供资金支持。 除了 Bartłomiej Piotrowski 之外,Flathub 还希望再增加一名全职工作人员,以处理咨询、审查、文件和合作伙伴的外联工作。 Flathub 在今年的其他主要目标还包括: 建立一个独立的法律实体来拥有和运营 Flathub 建立管理机构来监督项目 启动 Flathub Focus Groups,以获得开发者、各个 Linux 发行版和用户的反馈 关于目标的更多详情,可访问官网进一步了解。

优秀的个人博客,低调大师

【建议收藏】超详细的Canal入门,看这篇就够了!!!

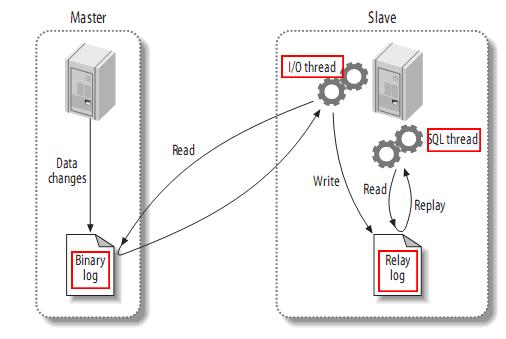
概述 canal是阿里巴巴旗下的一款开源项目,纯Java开发。基于数据库增量日志解析,提供增量数据订阅&消费,目前主要支持了MySQL(也支持mariaDB)。 背景 早期,阿里巴巴B2B公司因为存在杭州和美国双机房部署,存在跨机房同步的业务需求。不过早期的数据库同步业务,主要是基于trigger的方式获取增量变更,不过从2010年开始,阿里系公司开始逐步的尝试基于数据库的日志解析,获取增量变更进行同步,由此衍生出了增量订阅&消费的业务,从此开启了一段新纪元。ps. 目前内部使用的同步,已经支持mysql5.x和oracle部分版本的日志解析 基于日志增量订阅&消费支持的业务: 数据库镜像 数据库实时备份 多级索引 (卖家和买家各自分库索引) search build 业务cache刷新 价格变化等重要业务消息 当前的 canal 支持源端 MySQL 版本包括 5.1.x , 5.5.x , 5.6.x , 5.7.x , 8.0.x 工作原理 Mysql的BinLog 它记录了所有的DDL和DML(除了数据查询语句)语句,以事件形式记录,还包含语句所执行的消耗的时间。主要用来备份和数据同步。 binlog 有三种模式:STATEMENT、ROW、MIXED STATEMENT 记录的是执行的sql语句 ROW 记录的是真实的行数据记录 MIXED 记录的是1+2,优先按照1的模式记录 举例说明 举例来说,下面的sql COPYupdate user set age=20 对应STATEMENT模式只有一条记录,对应ROW模式则有可能有成千上万条记录(取决数据库中的记录数)。 MySQL主备复制原理 Slave 上面的IO线程连接上 Master,并请求从指定日志文件的指定位置(或者从最开始的日志)之后的日志内容; Master 接收到来自 Slave 的 IO 线程的请求后,通过负责复制的 IO 线程根据请求信息读取指定日志指定位置之后的日志信息,返回给 Slave 端的 IO 线程。返回信息中除了日志所包含的信息之外,还包括本次返回的信息在 Master 端的 Binary Log 文件的名称以及在 Binary Log 中的位置; Slave 的 IO 线程接收到信息后,将接收到的日志内容依次写入到 Slave 端的Relay Log文件(mysql-relay-bin.xxxxxx)的最末端,并将读取到的Master端的bin-log的文件名和位置记录到master- info文件中,以便在下一次读取的时候能够清楚的高速Master“我需要从某个bin-log的哪个位置开始往后的日志内容,请发给我” Slave 的 SQL 线程检测到 Relay Log 中新增加了内容后,会马上解析该 Log 文件中的内容成为在 Master 端真实执行时候的那些可执行的 Query 语句,并在自身执行这些 Query。这样,实际上就是在 Master 端和 Slave 端执行了同样的 Query,所以两端的数据是完全一样的。 当然这个过程本质上还是存在一定的延迟的。 mysql的binlog文件长这个样子。 COPYmysql-bin.003831 mysql-bin.003840 mysql-bin.003849 mysql-bin.003858 启用Binlog注意以下几点: Master主库一般会有多台Slave订阅,且Master主库要支持业务系统实时变更操作,服务器资源会有瓶颈; 需要同步的数据表一定要有主键; canal能够同步数据的原理 理解了mysql的主从同步的机制再来看canal就比较清晰了,canal主要是听过伪装成mysql从server来向主server拉取数据。 canal模拟mysql slave的交互协议,伪装自己为mysql slave,向mysql master发送dump协议 mysql master收到dump请求,开始推送binary log给slave(也就是canal) canal解析binary log对象(原始为byte流) Canal架构 canal的设计理念 canal的组件化设计非常好,有点类似于tomcat的设计。使用组合设计,依赖倒置,面向接口的设计。 canal的组件 canal server 这个代表了我们部署的一个canal 应用 canal instance 这个代表了一个canal server中的多个 mysql instance ,从这一点说明一个canal server可以搜集多个库的数据,在canal中叫 destionation。 每个canal instance 有多个组件构成。在conf/spring/default-instance.xml中配置了这些组件。他其实是使用了spring的容器来进行这些组件管理的。 instance 包含的组件 这里是一个cannalInstance工作所包含的大组件。截取自 conf/spring/default-instance.xml COPY<bean id="instance" class="com.alibaba.otter.canal.instance.spring.CanalInstanceWithSpring"> <property name="destination" value="${canal.instance.destination}" /> <property name="eventParser"> <ref local="eventParser" /> </property> <property name="eventSink"> <ref local="eventSink" /> </property> <property name="eventStore"> <ref local="eventStore" /> </property> <property name="metaManager"> <ref local="metaManager" /> </property> <property name="alarmHandler"> <ref local="alarmHandler" /> </property> </bean> EventParser设计 eventParser 最基本的组件,类似于mysql从库的dump线程,负责从master中获取bin_log 整个parser过程大致可分为几步: Connection获取上一次解析成功的位置 (如果第一次启动,则获取初始指定的位置或者是当前数据库的binlog位点) Connection建立链接,发送BINLOG_DUMP指令 // 0. write command number // 1. write 4 bytes bin-log position to start at // 2. write 2 bytes bin-log flags // 3. write 4 bytes server id of the slave // 4. write bin-log file name Mysql开始推送Binaly Log 接收到的Binaly Log的通过Binlog parser进行协议解析,补充一些特定信息 // 补充字段名字,字段类型,主键信息,unsigned类型处理 传递给EventSink模块进行数据存储,是一个阻塞操作,直到存储成功 存储成功后,定时记录Binaly Log位置 EventSink设计 eventSink 数据的归集,使用设置的filter对bin log进行过滤,工作的过程如下。 说明: 数据过滤:支持通配符的过滤模式,表名,字段内容等 数据路由/分发:解决1:n (1个parser对应多个store的模式) 数据归并:解决n:1 (多个parser对应1个store) 数据加工:在进入store之前进行额外的处理,比如join 数据1:n业务 为了合理的利用数据库资源, 一般常见的业务都是按照schema进行隔离,然后在mysql上层或者dao这一层面上,进行一个数据源路由,屏蔽数据库物理位置对开发的影响,阿里系主要是通过cobar/tddl来解决数据源路由问题。 所以,一般一个数据库实例上,会部署多个schema,每个schema会有由1个或者多个业务方关注 数据n:1业务 同样,当一个业务的数据规模达到一定的量级后,必然会涉及到水平拆分和垂直拆分的问题,针对这些拆分的数据需要处理时,就需要链接多个store进行处理,消费的位点就会变成多份,而且数据消费的进度无法得到尽可能有序的保证。 所以,在一定业务场景下,需要将拆分后的增量数据进行归并处理,比如按照时间戳/全局id进行排序归并. EventStore设计 eventStore 用来存储filter过滤后的数据,canal目前的数据只在这里存储,工作流程如下 目前仅实现了Memory内存模式,后续计划增加本地file存储,mixed混合模式 借鉴了Disruptor的RingBuffer的实现思路 定义了3个cursor Put : Sink模块进行数据存储的最后一次写入位置 Get : 数据订阅获取的最后一次提取位置 Ack : 数据消费成功的最后一次消费位置 借鉴Disruptor的RingBuffer的实现,将RingBuffer拉直来看: 实现说明: Put/Get/Ack cursor用于递增,采用long型存储 buffer的get操作,通过取余或者与操作。(与操作: cusor & (size - 1) , size需要为2的指数,效率比较高) metaManager metaManager 用来存储一些原数据,比如消费到的游标,当前活动的server等信息 alarmHandler alarmHandler 报警,这个一般情况下就是错误日志,理论上应该是可以定制成邮件等形式,但是目前不支持 各个组件目前支持的类型 canal采用了spring bean container的方式来组装一个canal instance ,目的是为了能够更加灵活。 canal通过这些组件的选取可以达到不同使用场景的效果,比如单机的话,一般使用file来存储metadata就行了,HA的话一般使用zookeeper来存储metadata。 eventParser eventParser 目前只有三种 MysqlEventParser 用于解析mysql的日志 GroupEventParser 多个eventParser的集合,理论上是对应了分表的情况,可以通过这个合并到一起 RdsLocalBinlogEventParser 基于rds的binlog 的复制 eventSink eventSink 目前只有EntryEventSink 就是基于mysql的binlog数据对象的处理操作 eventStore eventStore 目前只有一种 MemoryEventStoreWithBuffer,内部使用了一个ringbuffer 也就是说canal解析的数据都是存在内存中的,并没有到zookeeper当中。 metaManager metaManager 这个比较多,其实根据元数据存放的位置可以分为三大类,memory,file,zookeeper Canal-HA机制 canal是支持HA的,其实现机制也是依赖zookeeper来实现的,用到的特性有watcher和EPHEMERAL节点(和session生命周期绑定),与HDFS的HA类似。 canal的ha分为两部分,canal server和canal client分别有对应的ha实现 canal server: 为了减少对mysql dump的请求,不同server上的instance(不同server上的相同instance)要求同一时间只能有一个处于running,其他的处于standby状态(standby是instance的状态)。 canal client: 为了保证有序性,一份instance同一时间只能由一个canal client进行get/ack/rollback操作,否则客户端接收无法保证有序。 server ha的架构图如下 大致步骤: canal server要启动某个canal instance时都先向zookeeper_进行一次尝试启动判断_(实现:创建EPHEMERAL节点,谁创建成功就允许谁启动) 创建zookeeper节点成功后,对应的canal server就启动对应的canal instance,没有创建成功的canal instance就会处于standby状态。 一旦zookeeper发现canal server A创建的instance节点消失后,立即通知其他的canal server再次进行步骤1的操作,重新选出一个canal server启动instance。 canal client每次进行connect时,会首先向zookeeper询问当前是谁启动了canal instance,然后和其建立链接,一旦链接不可用,会重新尝试connect。 Canal Client的方式和canal server方式类似,也是利用zookeeper的抢占EPHEMERAL节点的方式进行控制. canal的工作过程 dump日志 启动时去MySQL 进行dump操作的binlog 位置确定 工作的过程。在启动一个canal instance 的时候,首先启动一个eventParser 线程来进行数据的dump 当他去master拉取binlog的时候需要binlog的位置,这个位置的确定是按照如下的顺序来确定的(这个地方讲述的是HA模式哈)。 在启动的时候判断是否使用zookeeper,如果是zookeeper,看能否拿到 cursor (也就是binlog的信息),如果能够拿到,把这个信息存到内存中(MemoryLogPositionManager),然后拿这个信息去mysql中dump binlog 通过1拿不到的话(一般是zookeeper当中每一,比如第一次搭建的时候,或者因为某些原因zk中的数据被删除了),就去配置文件配置当中的去拿,把这个信息存到内存中(MemoryLogPositionManager),然后拿这个信息去mysql中dump binlog 通过2依然没有拿到的话,就去mysql 中执行一个sql show master status 这个语句会显示当前mysql binlog最后位置的信息,也就是刚写入的binlog所在的位置信息。把这个信息存到内存中(MemoryLogPositionManager),然后拿这个信息去mysql中dump binlog。 后面的eventParser的操作就会以内存中(MemoryLogPositionManager)存储的binlog位置去master进行dump操作了。 mysql的show master status 操作 COPYmysql> show master status\G *************************** 1. row *************************** File: mysql-bin.000028 Position: 635762367 Binlog_Do_DB: Binlog_Ignore_DB: Executed_Gtid_Set: 18db0532-6a08-11e8-a13e-52540042a113:1-2784514, 318556ef-4e47-11e6-81b6-52540097a9a8:1-30002, ac5a3780-63ad-11e8-a9ac-52540042a113:1-5, be44d87c-4f25-11e6-a0a8-525400de9ffd:1-156349782 1 row in set (0.00 sec 归集(sink)和存储(store) 数据在dump回来之后进行的归集(sink)和存储(store) sink操作是可以支撑将多个eventParser的数据进行过滤filter filter使用的是instance.properties中配置的filter,当然这个filter也可以由canal的client端在进行subscribe的时候进行设置。如果在client端进行了设置,那么服务端配置文件instance.properties的配置都会失效 sink 之后将过滤后的数据存储到eventStore当中去。 目前eventStore的实现只有一个MemoryEventStoreWithBuffer,也就是基于内存的ringbuffer,使用这个store有一个特点,这个ringbuffer是基于内存的,大小是有限制的(bufferSize = 16 * 1024 也就是16M),所以,当canal的客户端消费比较慢的时候,ringbuffer中存满了就会阻塞sink操作,那么正读取mysql binlog的eventParser线程也会受阻。 这种设计其实也是有道理的。 因为canal的操作是pull 模型,不是producer push的模型,所以他没必要存储太多数据,这样就可以避免了数据存储和持久化管理的一些问题。使数据管理的复杂度大大降低。 上面这些整个是canal的parser 线程的工作流程,主要对应的就是将数据从mysql搞下来,做一些基本的归集和过滤,然后存储到内存中。 binlog的消费者 canal从mysql订阅了binlog以后主要还是想要给消费者使用。那么binlog是在什么时候被消费呢。这就是另一条主线了。就像咱们做一个toC的系统,管理系统是必须的,用户使用的app或者web又是一套,eventParser 线程就像是管理系统,往里面录入基础数据。canal的client就像是app端一样,是这些数据的消费方。 binlog的主要消费者就是canal的client端。使用的协议是基于tcp的google.protobuf,当然tcp的模式是io多路复用,也就是nio。当我们的client发起请求之后,canal的server端就会从eventStore中将数据传输给客户端。根据客户端的ack机制,将binlog的元数据信息定期同步到zookeeper当中。 canal的目录结构 配置父目录: 在下面可以看到 COPYcanal ├── bin │ ├── canal.pid │ ├── startup.bat │ ├── startup.sh │ └── stop.sh └── conf ├── canal.properties ├── gamer ---目录 ├── ww_social ---目录 ├── wother ---目录 ├── nihao ---目录 ├── liveim ---目录 ├── logback.xml ├── spring ---目录 ├── ym ---目录 └── xrm_ppp ---目录 这里是全部展开的目录 COPYcanal ├── bin │ ├── canal.pid │ ├── startup.bat │ ├── startup.sh │ └── stop.sh └── conf ├── canal.properties ├── game_center │ └── instance.properties ├── ww_social │ ├── h2.mv.db │ ├── h2.trace.db │ └── instance.properties ├── wwother │ ├── h2.mv.db │ └── instance.properties ├── nihao │ ├── h2.mv.db │ ├── h2.trace.db │ └── instance.properties ├── movie │ ├── h2.mv.db │ └── instance.properties ├── logback.xml ├── spring │ ├── default-instance.xml │ ├── file-instance.xml │ ├── group-instance.xml │ ├── local-instance.xml │ ├── memory-instance.xml │ └── tsdb │ ├── h2-tsdb.xml │ ├── mysql-tsdb.xml │ ├── sql │ └── sql-map └── ym └── instance.properties Canal应用场景 同步缓存redis/全文搜索ES canal一个常见应用场景是同步缓存/全文搜索,当数据库变更后通过binlog进行缓存/ES的增量更新。当缓存/ES更新出现问题时,应该回退binlog到过去某个位置进行重新同步,并提供全量刷新缓存/ES的方法,如下图所示。 下发任务 另一种常见应用场景是下发任务,当数据变更时需要通知其他依赖系统。其原理是任务系统监听数据库变更,然后将变更的数据写入MQ/kafka进行任务下发,比如商品数据变更后需要通知商品详情页、列表页、搜索页等先关系统。这种方式可以保证数据下发的精确性,通过MQ发送消息通知变更缓存是无法做到这一点的,而且业务系统中不会散落着各种下发MQ的代码,从而实现了下发归集,如下图所示。 数据异构 在大型网站架构中,DB都会采用分库分表来解决容量和性能问题,但分库分表之后带来的新问题。比如不同维度的查询或者聚合查询,此时就会非常棘手。一般我们会通过数据异构机制来解决此问题。 所谓的数据异构,那就是将需要join查询的多表按照某一个维度又聚合在一个DB中。让你去查询。canal就是实现数据异构的手段之一。 本文由传智教育博学谷狂野架构师教研团队发布。 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。 转载请注明出处!

优秀的个人博客,低调大师

每日一博 | 超详细的 Angular 国际化方案

第一次在 Angular 框架上落地国际化方案,将 Eoapi 的经验分享给大家~ 1. 项目背景 需要支持 Web 和 Electron 桌面端 技术栈 Angular 14 Electron 19 NG-ZORR 13.0.6 2. 可能遇到的困难 各语言下样式不统一,例如阿拉伯文字展示从右到左,英文比中文长等等 变量本地化,例如初始化 API 数据、日志、时间戳、金额等单位 翻译成本高 协作流程复杂 技术标准的制定、落地 3. 调研 3.1 结论 先上表格看结论,满分三颗星,最终选定 I18n 方案。 一直在运行时语言包和编译手段两种方案徘徊,最后还是选定了使用 I18n 方案,有以下几点考虑: 对代码侵入性低,不影响现有开发模式 方案成熟,经过 angular 团队/社区验证,提前考虑到了各种条件 生成的文件 xlf 遵循国际规范 XLIFF,较通用,即使技术变迁,语言包仍通用 虽然无法支持同一个 URL 动态切换语言包,多套代码方案在桌面端实现不常规(可能需要把各种语言的安装包打进去),但考虑需求上切换语言包是一个超低频的操作以及使用编译手段可以提高良好的开发体验,还是为 i18n 方案所折服。 其实无论是运行时方案和编译手段,只要官方支持,完全可以实现相互转换,期待后续 Angular 支持将语言包反向编译成代码后支持动态切换语言包,那就是我理想中的完美方案了。 3.2 分析 3.2.1 在线翻译 API切换语言包的时候再调用 OpenAPI 翻译当前页面,类似于 google 翻译。 实现难度一般,只要实现了此工具,可以兼容各种语言。 翻译 API 不一定稳定,同时免费的有次数限制,适合表达精确度要求不高,需要支持多语言的静态页。 3.2.2 自研语言编译器 使用编译手段提取,例如识别到代码中的中文,提取出来成为语言包,打包的时候 感兴趣可以看这篇,原理类似:https://juejin.cn/post/6844904042489970695#heading-3 不改变原有开发的模式,没有学习成本。 对代码有一定的侵入性,同时针对不同母语的代码有不同的语言匹配规则。 自研的实现成本较高,可能无法配合市面上热门翻译平台打通流程,工具生态成熟需要时间沉淀。 3.2.3 Angular I18n 方案https://angular.cn/guide/i18n-overview 和自研编译提取语言文本类似,使用一些标识符标记哪些字段需要翻译,同时提供一些额外的附加规则,例如同词不同含义的标记。 较为成熟,代码侵入性低,有一定的开发学习成本。 官方文档推荐的实践都是不同的语言包打包成不同的代码,然后通过 nginx 映射到不同的代码,这适合 web,但在桌面端实现比较麻烦,无法动态加载文件。 理想情况是 angular 方案下支持一套代码加载语言包的国际化方案(one bundle for all languages),官方关于动态切换语言包的讨论: https://github.com/angular/angular/issues/24549#issuecomment-398371120 https://github.com/angular/angular/issues/38953#issuecomment-862492065 截至本方案完成,Angular 只支持打包成多种语言包文件,动态切换语言包目前处于提案通过阶段,未来可期。 3.2.4 运行时语言包 支持 Angular 的方案有: http://www.ngx-translate.com/ https://ngneat.github.io/transloco/docs/translation-in-the-template https://github.com/lokalise/i18n-ally 我认为这种方案最大的问题是开发体验较差,虽然很多工具可以使用 VSCode 插件显示【默认语言文本】抹平差异,但源码仍然是各种变量。 其次是切换语言包是一个低频操作,一般用户长期只会选择一种语言包,运行时方案也会增加不必要的内存占用(当然你要说可以忽略不计那我也不和你辩,算你赢)。 3.2.5 多套代码 没什么技术难点,同步成本高,灵活性高。 4. 技术实现 以下代码配置的源码都在这个仓库,有需要可以拉下来部署看看具体效果。 https://github.com/eolinker/eoapi 国际化主要分为几个流程: 4.1 语言包 4.1.1 语言包配置 4.1.1.1 命令行配置 使用 angular 提供的指令 ng extract-i18n ,同时制定语言包生成的目录 src/locale ng extract-i18n --output-path src/locale 运行后就会生成一个默认语言包 message.xlf 建议使用如下 npm 命令封装,运行 npm run lang:gen 即可生成语言包文件 "scripts": { "lang:gen": "ng extract-i18n --output-path src/locale", .... **4.1.1.2 angular.json ** 配置想要加其他语言包,从默认语言包 message.xlf 复制一个文件,然后配置一下就可以支持多语言。 文件名语言 ID 命名请参考(en-US、zh-Hans) 在 angular.json 中告诉构建工具你语言包叫啥,位置在哪 { ... "projects": { "eoapi": { ... "i18n": { "sourceLocale": "zh-Hans",//中文语言包 "locales": { "en-US": "src/locale/messages.en-US.xlf"//英文语言包 } }, 4.1.1.3 Ant-Design 配置 https://ng.ant.design/docs/i18n/zh /** 导入需要使用的语言包 **/ import { LOCALE_ID } from '@angular/core'; import { registerLocaleData } from '@angular/common'; import en from '@angular/common/locales/en'; import zh from '@angular/common/locales/zh'; registerLocaleData(en); registerLocaleData(zh); /** 配置 ng-zorro-antd 国际化 **/ import { en_US, NZ_I18N, zh_CN } from 'ng-zorro-antd/i18n'; ... { provide: NZ_I18N, useFactory: (localId: string) => { switch (localId) { case 'zh': return zh_CN; default: return en_US; } }, deps: [LOCALE_ID], } 4.1.2 调试 官方原话:由于 i18n 的部署复杂性和最小化重建时间的需要,开发服务器一次仅支持本地化单个语言环境 我来翻译一下:你这需求也不常见,实现太麻烦了,你调试麻烦点就麻烦点吧,构建时间多快呀,我是为你好。 总而言之就是 Angular 调试时只会支持一种语言包,同时意味着你没法直接运行时测试切换语言包的效果(当然可以通过运行两个服务间接实现),关系不大。 你可以使用下面两种配置进行调试: 调试时可以通过设置 "localize":false 在调试时禁用本地化 "architect": { "build": { "builder": "@angular-builders/custom-webpack:browser", "options": { "localize":false, "aot":true,//本地化一定要开启 AOT ... angular.json指定使用某种语言包 { ... "projects": { "eoapi": { ... "architect": { "build": { "options": { "localize":true,//开启本地化 "aot": true, ... }, "configurations": { "web": { //指定某个运行环境下的语言包,传入上面 i18n 定义的语言包名称 "localize": ["zh-Hans"], ... } } }, "serve": { ... "configurations": { "web": { "browserTarget": "eoapi:build:web" } ... 运行时使用命令制定使用 --configuration web 即可 ng serve -c web -o 4.1.3 构建 Angular i18n 方案会打包成两个文件夹,所以需要注意资源在代码里面的相对地址。 4.1.3.1 web 和之前区别不大,主要是通过 index.html 里面的 <base> 标签来指定基础路径,打包后的代码结果如图: 英语语言包的 href="en-US" !DOCTYPE html><html lang="en-US" dir="ltr"><head> <meta charset="utf-8"> <title>Eoapi</title> <base href="/en-US/"> <meta name="viewport" content="width=device-width, initial-scale=1"> <script src="https://lf1-cdn-tos.bytegoofy.com/obj/iconpark/icons_12799_18.e98aaa4d03d4378a3a2c18bfd1670872.js"></script> ... 4.1.3.2 桌面端 Electron 启动需要指定语言 https://github.com/electron/electron/issues/5649 桌面端使用 file 协议,需要将 base href 改成相对路径 ./。 即使使用 ng build --base-href ./,打包后还是会自动在 href 前加语言标识 <base href="./en-US/"> 所以需要在 angular.json 18n 指定 baseHref 为空字符串 "projects": { "eoapi": { "root": "", "i18n": { "sourceLocale": { "code": "zh-Hans", "baseHref": ""//. }, "locales": { "en-US": { "baseHref": "", "translation": "src/locale/messages.en-US.xlf" } } }, 4.1.3.3 Build.js 命令 一般情况下 Angular 框架会帮我们处理好,但是我们产品涉及到 Web 和桌面端,有两套打包逻辑,所以使用了 Node 脚本去执行 Build 命令,在执行 ng build 命令前修改 angular.json 文件。 //change angular.json const fs = require('fs'); const { execSync } = require('child_process'); class webPlatformBuilder { resetBuildConfig(json) { delete json.projects.eoapi.i18n.sourceLocale.baseHref; Object.keys(json.projects.eoapi.i18n.locales).forEach((val) => { delete json.projects.eoapi.i18n.locales[val].baseHref; }); return json; } executeBuild() { execSync('ng build -c production', { stdio: 'inherit' }); } } class appPlatformBuilder { resetBuildConfig(json) { ... } executeBuild() { ... } } class PlatformBuilder { constructor(platForm) { switch (platForm) { case 'web': { this.instance = new webPlatformBuilder(); break; } case 'app': { this.instance = new appPlatformBuilder(); break; } } } build() { const filePath = '../angular.json'; let buildConfigJson = require(filePath); buildConfigJson = this.instance.resetBuildConfig(buildConfigJson); let that=this; fs.writeFile(filePath, JSON.stringify(buildConfigJson), function (err) { if (err) { console.error('build/beforeBuild.js:', err); } that.instance.executeBuild(); }); } } 4.1.4 部署 4.1.4.1 Vercel vercel 不支持多项目配置,所以只能重定向到固定 Language 而不是用户配置的 Language。 { "rewrites": [ { "source": "/:path((?!en/).*)", "destination": "/en/:path*" }, { "source": "/:path((?!zh/).*)", "destination": "/zh/:path*" } ] } 这个方案表现还是不好,拿不到一些初始化的路由信息,所以我手动写了个脚本生产空白 HTML,再手动重定向到相应位置。 fs.writeFile( './dist/index.html', `<!DOCTYPE html> <html> <head> <meta charset="utf-8" /> <title>Eoapi - Easy &amp; Open Source API Ecosystem</title> <script> let lang=window.location.href.includes("/en")?'en':'zh'; try{ lang=JSON.parse(window.localStorage.getItem("LOCAL_SETTINGS_KEY"))["eoapi-language"]=='en-US'?'en':'zh'; }catch(e){ } let baseDir="/"+lang+'/' let search={}; if(window.location.search){ window.location.href=baseDir+window.location.search; }else{ window.location.href=baseDir; } </script> </head> <body></body> </html> `, () => {} ); 4.1.4.2 Nginx 如果使用 Nginx 部署,可以按照官方提供的文件配置。 https://angular.cn/guide/i18n-common-deploy#configure-a-server 4.2 翻译流程工具调研 https://github.com/alibaba/kiwi https://github.com/mozilla/pontoon/(开源) https://www.volcengine.com/product/i18ntranslate 4.2.1 Poeditor https://poeditor.com 免费,体验一般,数据没有丢失,协作流程不够清晰,自动翻译用不了 4.2.2 Crowdin(electron 官方使用) https://zh.crowdin.com/ 体验好,协作清晰,但未来可能付费 5. 结语 整个 Angular 落地国际化的方案讲完了,国际化不止涉及到技术实现,还包括翻译协作流程,如图是一个常见的翻译流程: 以及整个技术团队的国际化技术规范,毕竟翻译不止涉及到 UI,还有各种时间数据储存的格式等等数据规范。 感谢你的阅读,上面实践都落地到开源项目 Eoapi,欢迎关注~[在线体验功能] (https://www.eoapi.io/?utm_source=OS0903) Github:https://github.com/eolinker/eoapi Gitee: https://gitee.com/eolink_admin/eoapi 6. 资料 Angular 项目 国际化方案设计以人为本的国际化(i18n) 工程方案 国际化与本地化 前端国际化 Angular internationalization (i18n) tutorial - Localizely https://cloud.tencent.com/developer/section/1489559 Taobao FED | 淘系前端团队

优秀的个人博客,低调大师

超详细maven的卸载、重新安装与配置

镜像下载、域名解析、时间同步请点击 阿里巴巴开源镜像站 一、maven的卸载 maven在使用时只是配置了环境变量和本地仓库,我们只需要删除本地仓库,在环境变量中移除maven的环境变量。 1.删除解压的maven文件夹; 在之前的安装中,我将本地仓库和maven解压后的文件放在同一个文件夹下。 此时删除Maven文件夹即可 2.删除设置的环境变量MAVEN_HOME,删除path里添加的 “ %MAVEN_HOME%\bin; ”; 删除Path中的 %MAVEN_HOME%\bin; 后面的窗口全部点:确定!!!(否则可能会不生效,删除不成功) 3.删除本地仓库; 我们在第一步已经删除了本地仓库,根据之前的配置的本地仓库的位置删除即可,若没有配置,则默认在:C:\Users\Administrator.m2\repository路径下,将名为:repository的文件夹删除即可。 删除repository 至此,maven已经全部删除成功!!! 接下来开始maven的重新安装和配置。 二、maven的下载 1.进入官网下载:maven官网下载 2.下翻找到Download,如果是需要最新版,选择apache-maven-3.8.4-bin.zip点击就可以下载。 (出于稳定性考虑,不推荐下载最新版,若选择下载最新版,就可以点击等待下载完成,后面的小步骤不再看) (若需要下载其他的版本,则继续看以下的小步骤) ① 下翻找到如下界面,点击: archives ② 下翻找到自己要下载的版本,点击即可 ③ 点击:binaries/ ④ 点击:apache-maven-3.8.1-bin.zip ,等待下载完成。 三、配置maven环境变量 1.解压到指定的文件夹下,解压完成是这样: 2.配置环境变量 ① 此电脑—>属性—>高级系统设置—>环境变量 ② 选择系统变量,点击:新建 ③ 输入变量名和变量值 变量名:MAVEN_HOME 变量值:D:\Environment\maven-3.8.1\apache-maven-3.8.1 (变量名为MAVEN_HOME,变量值就是安装路径,就是第一步时的路径) ④ 配置Path,双击打开Path—>新建 ⑤ 输入:%MAVEN_HOME%\bin 3.测试环境变量配置是否成功 ① 打开cmd,以管理员身份运行 ② 输入:mvn -v 若出现maven的版本信息,证明配置成功。若不成功,仔细检查一下上述环境变量的配置是否正确。 四、配置maven本地仓库 1.在maven的安装目录下,创建一个名为myRepository的文件夹。 2.修改settings.xml配置文件,位置在\conf目录下。 ① 使用记事本打开settings.xml,将文件中的所有信息替换为如下,并保存后退出: (注意: D:/Environment/maven-3.8.1/myRepository中间的路径是之前创建的本地仓库的位置,根据实际改成自己的仓库位置,路径的分隔符改为/ ) <?xml version="1.0" encoding="UTF-8"?> <settings xmlns="http://maven.apache.org/SETTINGS/1.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/SETTINGS/1.0.0 http://maven.apache.org/xsd/settings-1.0.0.xsd"> <!-- <localRepository>/Users/Fred/Downloads/apache-maven-3.5.4/repository</localRepository> --> <localRepository>D:/Environment/maven-3.8.1/myRepository</localRepository> <pluginGroups> </pluginGroups> <proxies> </proxies> <servers> </servers> <mirrors> <mirror> <id>alimaven</id> <name>aliyun maven</name> <url>http://maven.aliyun.com/nexus/content/groups/public/</url> <mirrorOf>central</mirrorOf> </mirror> <mirror> <id>aliyun</id> <mirrorOf>central</mirrorOf> <name>aliyun-public</name> <url>https://maven.aliyun.com/repository/public/</url> </mirror> <mirror> <id>aliyun-spring</id> <mirrorOf>spring</mirrorOf> <name>aliyun-spring</name> <url>https://maven.aliyun.com/repository/spring</url> </mirror> <!-- 中央仓库在中国的镜像 --> <mirror> <id>maven.net.cn</id> <name>one of the central mirrors in china</name> <url>http://maven.net.cn/content/groups/public/</url> <mirrorOf>central</mirrorOf> </mirror> <!-- 中央仓库1 --> <mirror> <id>repo1</id> <mirrorOf>central</mirrorOf> <name>Human Readable Name for this Mirror.</name> <url>https://repo1.maven.org/maven2/</url> </mirror> </mirrors> <profiles> <profile> <id>jdk-1.8</id> <activation> <activeByDefault>true</activeByDefault> <jdk>1.8</jdk> </activation> <properties> <maven.compiler.source>1.8</maven.compiler.source> <maven.compiler.target>1.8</maven.compiler.target> <maven.compiler.compilerVersion>1.8</maven.compiler.compilerVersion> </properties> </profile> </profiles> <activeProfiles> <activeProfile>jdk-1.8</activeProfile> </activeProfiles> </settings> 修改完记得保存,然后退出!!! 3.打开cmd,执行:mvn help:system 此时本地仓库就会从中央仓库下载需要的文件。 下载过程根据网速会有所不同,耐心等待即可,直至出现BUILD SUCCESS则证明下载完成!!! 打开本地仓库可以看查看,已经下载了一些文件。 本文转自:https://blog.csdn.net/weixin_46081857/article/details/121719684

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册