首页 文章 精选 留言 我的

精选列表

搜索[字节级],共10000篇文章
优秀的个人博客,低调大师

百亿级存储+毫秒级写入:TDengine 在得物 APP 的落地实践

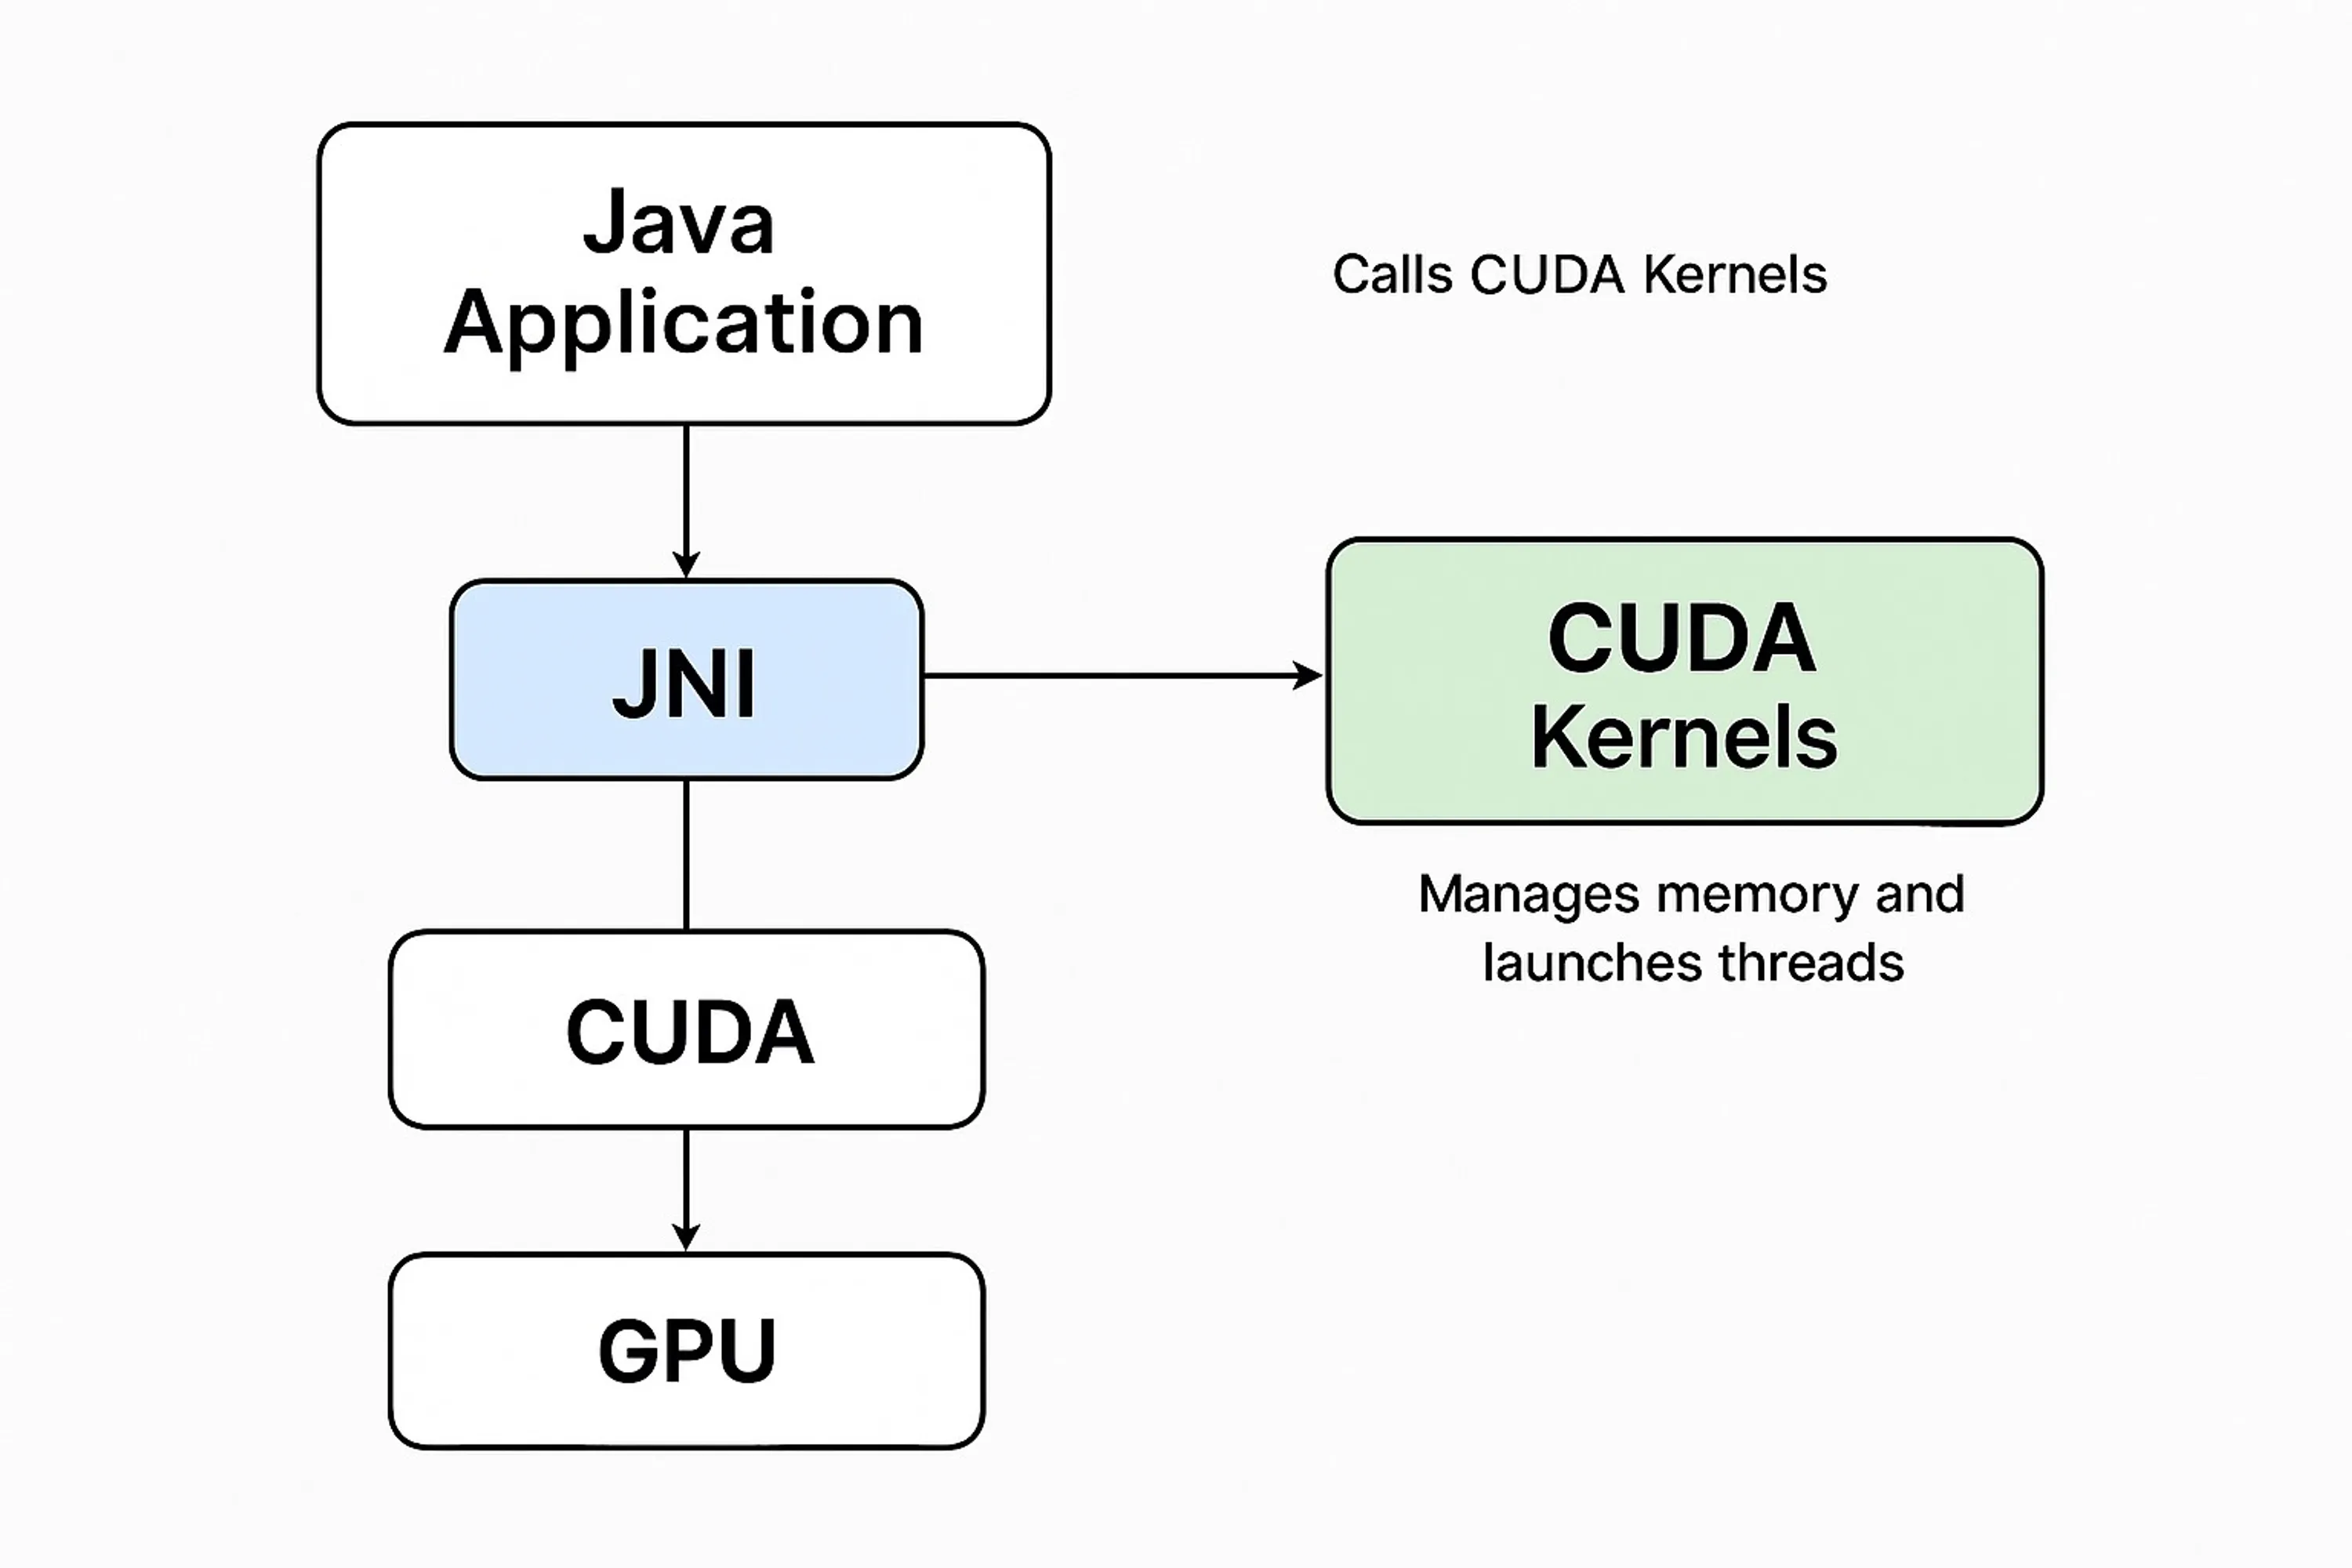
作者|Lynx 导语 :得物许多系统和场景都需要做流量的监控和防护,一天就能够产生数亿数据,写入速度达到万TPS,该数据量级无法用传统的关系型数据库处理。在对比了InfluxDB, OpenTSDB, Cassandra等时序数据库的性能后,最终选择 TDengine。 背景 作为一家互联网电商公司,得物有许多系统和场景都需要做流量的监控和防护,所以在深度定制化开源流控防护组件Sentinel时我们加入了许多功能,帮助提升各业务系统的流控防护。 备注:Sentinel组件地址: https://github.com/alibaba/Sentinel 在开发过程中,我们发现开源版本的Sentinel不支持流控数据持久化,而我们非常需要这样的功能:我们需要一款数据库,它能够承载大量的流量监控数据,并能对数据进行存储和高效查询。 目前在生产环境中,我们有数百个业务系统、数千台服务器接入了Sentinel,如此产生的流控数据无疑非常庞大。那么对于这个需求来说,选择一款适合的数据库无疑极为重要,一个好的选择就能够达到事半功倍的效果。 01 数据库选型 首先粗略估算一下当前数据量的理论上限: 目前生产环境拥有数千Sentinel Resources,而Sentinel的监控数据时间粒度按照秒来统计,那么一天理论上就能够产生 数亿 的数据, 理论写入数据的速度也将达到万TPS ,而且业务还在快速发展,可以预见的是数据量将会进一步爆炸,显而易见这个数据量级是无法使用传统关系数据库的。 因为内部有一些应用在使用TiDB,所以首先看了一下使用TiDB的可行性,但很快就放弃了,毕竟它作为一款分布式数据库,瞄准的完全不是监控数据这种时序特点非常强的场景。 排除之后我们就将调研重心放在了时序数据库上。 主流时序数据库里面都各有优缺点: InfluxDB,可能是应用范围最广的时序数据库,场景也合适;但集群功能需要商业版。 OpenTSDB,基于HBase,对于目前简单的需求来说太重了。 Cassandra,从找到的几份对比报告来看性能不太满足要求。 当准备继续了解Clickhouse时,被同事安利了一款 国产物联网大数据平台——TDengine 简单在网上了解了一下,发现风评不错,社区活跃度也高,后来就到官网上查阅了TDengine和其它数据库的对比报告,发现从性能上看也非常优秀。 于是我们就写了一个demo,简单使用了一下TDengine,整个过程中,在清晰的文档的帮助之下,学习成本尚可,所以我们最终决定使用TDengine。 02 数据结构与建模方式数据结构 数据结构 首先我们看一下Sentinel的流量数据是如何呈现的。 从上图中可以看出,左侧是应用列表,在每个应用的菜单中有独立的监控面板,在监控面板中又以资源的粒度,统计了所有资源的流量数据,例如通过QPS、拒绝QPS、响应时间等。 所以从前端呈现的角度来看,数据的唯一键应当是应用-资源。 然后我们在从内部实现角度看看数据的结构是怎么样的。 Sentinel客户端在每台服务器上统计了所有资源的流量数据,以秒的维度进行聚合,再记录到本地日志中。控制台通过调用客户端暴露的接口,获取采集的流量数据,再以服务的维度,将所有单机的流量数据进行聚合,存储在内存中。 所以我们需要存储的数据即是以应用-资源为唯一属性落入数据库中的。 数据建模 TDengine官方文档中建议的数据建模方式如下: 为充分利用其数据的时序性和其他数据特点,TDengine要求对 每个数据采集点单独建表 。 采用一个数据采集点一张表的方式,能最大程度的保证单个数据采集点的插入和查询的性能是最优的。 在TDengine的设计里, 表用来代表一个具体的数据采集点,超级表用来代表一组相同类型的数据采集点集合 。当为某个具体数据采集点创建表时,用户使用超级表的定义做模板,同时指定该具体采集点(表)的标签值。与传统的关系型数据库相比,表(一个数据采集点)是带有静态标签的,而且这些标签可以事后增加、删除、修改。 一张超级表包含有多张表,这些表具有相同的时序数据schema,但带有不同的标签值。 可以看到官方文档中建议的数据建模方式完全契合本场景的数据特点:一个应用-资源即为一张表,所有的应用-资源放在一张超级表中以便做聚合查询。所以在表结构的设计上,就使用了官方文档推荐的这种方式。 另外,在标签的选择上,虽然目前还没有聚合操作的需求,但是考虑到未来的聚合操作非常可能会以应用的维度来做,所以我们决定将一些应用的信息作为标签记录在表中。 03 整体架构 目前的整体架构图如上,各个接入了Sentinel的业务系统会向控制台定时发送心跳请求维持本机器的健康状态。 而控制台会定时轮询所有机器,拉取Sentinel客户端在业务系统中记录的监控数据,经过聚合处理后再向TDengine集群批量写入。 由于场景简单且并非作为主要的监控系统,且数据目前是可以接受少量丢失,故没有设计过多的失败处理机制。 04 技术选型 Connector 在Connector选择上,公司的主要开发语言就是Java,相关生态也都更完善,所以很自然地选择了 JDBC形式的Connector 。 另外JDBC的性能相较于HTTP方式也会更好一些,同时JDBC驱动还 支持节点不可用时自动切换节点 。 唯一不方便的是JDBC的方式则会 强依赖本地库函数 ,需要在客户端的机器上也安装TDengine,这样在项目部署阶段会稍微麻烦一些,不过整体来说是利大于弊的。 最近,官方更新了JDBC-RESTful的方式, 支持了跨平台功能。 由于公司服务器的操作系统都是Linux,没有跨平台的需求,所以还是继续使用JDBC-JNI的Connector。 数据库连接池与ORM 数据库连接池及ORM框架也选择了在公司内部主流的 Druid+Mybatis ,根据官网的Demo代码也能高效地完成接入。不过在Mybatis的使用上,只是在查询时使用了Mybatis,将ResultSet转为更方便处理的实体,而写入数据时则没有使用Mybatis,为了方便所以直接在内存中拼接好sql后进行执行。 总体来说,TDengine在适配主流框架方面很友好了,支持了 HikariCP、Druid、Spring JdbcTemplate、Mybatis 等,并且根据官网提供的Demo能够很快地实现接入,节省了大量时间,一些注意事项文档中都有清晰列出。 集群搭建 目前TDengine集群有三个物理节点,均为16核/64G内存/1T存储。 官方的集群搭建文档写的还是非常详尽的,直接按照文档进行傻瓜式操作就可以搭建起TDengine集群。 建库 在前期调研时发现,假定集群只有三台机器,如果数据量过大,副本数为3,相当于在每台机器上都存储了一份完整数据,以可能的数据量推测,存储和内存的压力都会较大,所以在建库时副本数选择设置为1。后续若集群规模扩大,TDengine也支持动态修改副本数,可以很轻松地完成到高可用集群的切换。 另外考虑到查询性能,将 blocks 设置为16, cache 设置为64MB。 CREATE DATABASE sentinel KEEP 365 DAYS 1 blocks 16 cache 64; 05 性能表现 目前TDengine承载了数百亿数据,在生产环境运行平稳,CPU使用率日常不到1%,内存使用率稳定在25%以下。 下图为集群中的一台机器的监控图表: 在使用早期TDengine版本(2.0.7.0)做调研时,内存方面是存在一些缺陷的,但是随着版本迭代,目前看内存问题已经得到了较好的解决。 写入性能 控制台的机器配置为4核16G,批量写入线程池设置的最大核心线程数为16,数据库连接池的最大线程数为20,实际使用约14。 写入流程如下: 对批量写入设置的最大写入条数为400,写入耗时如下: 可以看到,大批量的写入,耗时基本也能保持在10ms,属于比较理想的范围。目前还没有调整SQL语句最大长度,后续可能通过增加SQL语句长度的方式进一步优化写入性能。 查询性能 以下的耗时均未包含网络开销等,数据来自在客户端上进行指定SQL语句的查询。查询的超级表数据量级在百亿,以下给出了几个典型场景的耗时情况: last_row函数:8.6ms 8.8ms 5.6ms select last_row(*) from stable; 查询单个应用+资源某五分钟的所有数据:3.4ms 3.3ms 3.3ms select * from table where ts >= '2021-01-01 19:00:00' and ts < '2021-01-01 19:05:00'; 查询单个应用+资源某3小时内每2分钟的平均通过qps:1.4ms 1.3ms 1.4ms select avg(pass_qps) from table where ts >= '2021-01-01 19:00:00' and ts < '2021-01-01 22:00:00' interval (2m); 以服务维度分组查询一天内每两分钟的平均通过qps:2.34s 2.34s 2.35s select avg(pass_qps) from stable where ts >= '2021-01-01 00:00:00' and ts < '2021-01-02 00:00:00' interval (2m) group by appid; 值得一提的是,在2.0.7.0版本的TDengine中进行该查询效率在十几秒左右,当时认为是不可接受的,经过几个版本后优化效果显著; 以服务维度分组查询三天内每一小时的平均通过qps:2.17s 2.16s 2.17s select avg(pass_qps) from stable where ts >= '2021-01-01 00:00:00' and ts < '2021-01-03 00:00:00' interval (60m) group by appid; 不管是在大数据量范围的聚合查询,还是指定查询某一小区间内的全部数据,查询效率还是非常优异的。 并且与前期调研时的数据相比,新版本的查询性能优化了非常多,相信在未来的版本迭代中,会更进一步。 存储容量 目前Sentinel的数据没有使用副本,全量数据分散在三台机器中,根据计算得知TDengine对于Sentinel监控数据的压缩率达10%,相当可观。 06 总结 目前TDengine在得物暂时只是作为一款时序数据库小范围试点来使用,没有用到如流计算、内置查询函数等一些高级功能,其作为时序数据库的读写性能、存储表现都是令人满意的。 除此之外在运维难度和学习成本上也是意想不到的低,很轻松就能搭好一套可用的集群,这也是非常巨大的一个优势。另外TDengine的版本迭代非常快,一些在旧版本遇到的问题很快就得到了修复,并且在性能优化方面效果也是十分显著。 在调研、使用TDengine的这段时间,还有一个很重要的感受就是官方文档真的非常详尽,技术部分的文章深入浅出地讲解了TDengine的技术架构、技术设计等,能够学习到非常多东西;指南类的文章则步骤清晰简单,极大地降低了学习成本,让开发人员能够很快地完成框架适配、集群搭建、SQL编写等。 后续我们也会持续跟进TDengine的release notes,了解有哪些新featrue、优化点、bug fix等,在有必要的时候会进行版本升级。 期待TDengine的性能表现和稳定性能够不断提升,未来也会在其他合适的业务场景中作为技术选型的备选项之一,例如未来可能不仅需要存储聚合后的数据,可能还需要存储单机维度的流控数据。 注:本文数据基于2.0.7.0和2.0.12.1版本的TDengine。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册