首页 文章 精选 留言 我的

精选列表

搜索[workbuddy],共4516篇文章
优秀的个人博客,低调大师

在hy4preview免费这个阶段,我用WorkBuddy给我和我的朋友打造一款记录饮食的app端口界面,这篇文章将介绍的创作记录

**大家好,我是一名agent开发工程师,同时也是一名AI视觉营销设计者** 一直想认真管管饮食,但市面上的 App 要么广告多、要么记个热量要翻半天。 于是我自己捣鼓了一个网页版小工具,主打一个"打开就能记、记完有人管"。 🌟 **它能干什么** ✅ **拍照就能记**:拍张饭菜照片,自动识别食物和热量,一键加入当日饮食 ✅ **187 种食物库**:日常菜、水果、还有 KFC / 麦当劳都能直接搜,不用自己输 ✅ **热量环 + 营养条**:首页一眼看到今天吃了多少、蛋白/碳水/脂肪够不够 ✅ **按餐段记录**:早 / 午 / 晚 / 加餐分组,界面清爽不杂乱 ✅ **AI 教练「小霜」**:根据你的真实数据给建议("今晚还剩 2000 大卡,可以吃火锅但要聪明吃 🍲"),还能随时打断 ✅ **打卡仪式感**:连续打卡天数、累计、本周 7 天视图,坚持更有动力 ✅ **跨设备同步**:数据上云,换手机 / 发给家人朋友,靠一条链接就能同步 🎨 整体是浅色简约风 + 翡翠绿点缀,看着舒服,不花哨。 📲 **怎么用** 网页版,手机浏览器打开 → 点"添加到主屏幕",就能像 App 一样用。 (目前先用链接访问,后续绑了域名体验更顺滑) 💡 做这个的初衷很简单:管理饮食最难的不是"懂",是"懒得记"。 把记录这件事变轻、变快,才能真的坚持下来。 有同样在管理身材、想一起打卡的朋友,链接甩你 👇;下面几张图是 ![](https://developer.qcloudimg.com/http-save/audit-12728622/588f111c0bf58b3d15f269323c2f006f.jpg) ![](https://developer.qcloudimg.com/http-save/audit-12728622/b4421f90044e2c5e3645e0c457045f67.jpg) ![](https://developer.qcloudimg.com/http-save/audit-12728622/a0af53e0ebe7e21564fd10215200e7ff.jpg) ![](https://developer.qcloudimg.com/http-save/audit-12728622/58587ce7c595ad2f7601283277162557.jpg) 关于具体制作流程:我分为以下几个阶段介绍: ### 阶段 1 · 框架搭建 我们现用一张图来整体概括整体的网页框架,这也是我创作的习惯,先理清楚框架,再干活,以下是我整个网页的框架图: ![](https://developer.qcloudimg.com/http-save/audit-12728622/982943e7086075aed5760acfa66851cc.png) **App 升级**:新建 `fitness-app`(uni-app Vue3 + Pinia),把原 3 Tab 扩成 **4 Tab**(新增 AI 建议),视觉从暗色玻璃拟态**重做为浅色简约 + 翡翠绿 #10b981**,加了数字滚动、Canvas 环形、错峰入场等动效。 - **食物库重建**:原 `food-db.js` 缺失,重建 60+ 食物 / 11 分类,并全量移植原库 103 种。 - **HTML 预览版**:为了不装 HBuilderX 也能看效果,产出单文件 `fitness-app-preview.html`(4 Tab + 食物弹层 + AI 对话 + localStorage)。 - **首版部署**:HTTP 云函数 `fitness-web` 直出页面 + 静态托管放图,因为根路径 `/` 被小账本占用,**改用子路径 **`/fitness`,路由 + 权限两套机制都配齐。 - **接真 AI**:复用环境里已配好的 TokenHub `ledger-ai` 通道(Key 一字不动),前端改流式调用。 - **三大能力补齐**:BMI 计算(Mifflin-St Jeor)、目标按体重动态生成、用户空间隔离(随机 `fitness-xxxxxx` + URL 同步)。 - - **品牌数据**:新增 KFC / 麦当劳各 12 条(→ 127 种),统一 `brand/level/meat` 字段,写 `check_foods.py` 体检脚本双端校验。 ![](https://developer.qcloudimg.com/http-save/audit-12728622/54e16ccee74ed94a3449ee2385176c7c.png) ![](https://developer.qcloudimg.com/http-save/audit-12728622/376e76cdff038a97017b43916f6817e4.png) ### 阶段 2 · 体验打磨(09-09) - **UI 素材**:即梦生成 5 张素材(教练头像、默认头像、空状态插画、打卡徽章、健康背景)。 - **图片高清化**:发现原 103 张食物图都是 200×200 低清(5-7KB),全量调用dreaminaCLI.SKII重生成 600×600 高清(127 张、7.6MB)。 - ![](https://developer.qcloudimg.com/http-save/audit-12728622/cb2b15a99b2254e3c03250bd8e8ce314.png) ![](https://developer.qcloudimg.com/http-save/audit-12728622/a813361cf8101f042767b83a06e41949.png) - **记录页改版**:按早 / 午 / 晚 / 加餐**餐段分组**,配餐段插画,更贴近真实饮食场景。 - **首页弹框改造**:加底部抽屉手势(下滑关闭)、餐段选择 chips。 - **修"品牌不见了"**:品牌分类排在最末要横滑 928px 才看到,加「品牌专区」入口置顶 + 渐变提示 + emoji 图标。 ### 阶段 3 · 能力扩展 - **拍照识图(fitness-vision)**:调用hy vision视觉模型,新增拍照识别食物功能前端 `>4MB` 先 canvas 压缩、限制 ≤6MB、后端容错解析。 - **视觉模型坑**:用的推理模型 `max_tokens` 不够时 content 为空(token 耗在 reasoning),提到 4000 并回退 `reasoning_content` 才稳定。 - - **品牌早餐大补**:结合更过我和朋友的生活饮食的习惯,添加其它品牌食物,如: **KFC 44 类+ 麦当劳 40类**,总数达到 **187 种**。 ![](https://developer.qcloudimg.com/http-save/audit-12728622/d6748d3d2019b02fb880193bfbfbd1e7.jpg) ### 阶段 4 · 顽疾根治 - **AI 串味事件**:发现健身 AI 一直复用小账本的 `/ledger-ai` 通道,后端写死"账本管家" system 会覆盖角色,导致问火锅却回"我是管你账本的、时薪0、支出0"。 - **彻底解决**:弃用 `/ledger-ai`,在已通的 `fitness-api` 加 `chat` action,后端加**身份护栏**(明确"只答健身、禁止提账本/记账/时薪"),角色移回真正生效的 `system`。 - 验证:问火锅 → "可以吃但要聪明吃 🍲 今晚你还有 2000 大卡余额…",含财务字样 false,且引用真实数据。 ## 技术架构总览 |层|方案| | --- | --- | |前端|单文件 `fitness-app-preview.html`(浏览器直开)+ `fitness-app/` uni-app 工程,4 Tab(首页 / 记录 / AI 教练 / 我的)| |静态服务|云函数 `fitness-web`(HTTP 直出,避开 CDN 缓存)| |数据上云|云函数 `fitness-api` + `fitness_state` 集合,按 `space` 隔离,localStorage + 云端双向同步| |拍照识图|云函数 `fitness-vision`(TokenHub 视觉通道 + base64 压缩)| |AI 教练|TokenHub `deepseek-v4-flash or hy3`,后端一次性返回 + **前端打字机**模拟流式,可打断| |部署|CloudBase 同一环境多项目,子路径 `/fitness`,PWA 可"添加到主屏幕"| ![](https://developer.qcloudimg.com/http-save/audit-12728622/adae8f1ff008919924fa940643cf13ee.png) ![](https://developer.qcloudimg.com/http-save/audit-12728622/f57a1c2635a5b86cad914fb3bb8eb211.png) 最后,大家还有什么问题,都可以在评论区打出哈哈

优秀的个人博客,低调大师

#WorkBuddy# #AI办公# 七篇归因线结案后的第一次巡检:把手工探测固化成五类清单,13 组命令一轮跑完

上一篇《卷影追踪第四天》给持续十一天的「C 盘消耗归因」线画了句号:真凶是 System Volume Information 里的卷影差异区,淘汰兑现后水位止跌回升。但结案不等于完事——归因线里用过的十几组只读探测命令散落在七篇文章里,下次水位再掉,难道还要从第一篇翻起?今天做的事很朴素:把七篇的手工探测固化成一份五类巡检清单,并实战跑一轮,验证清单本身好不好用。

优秀的个人博客,低调大师

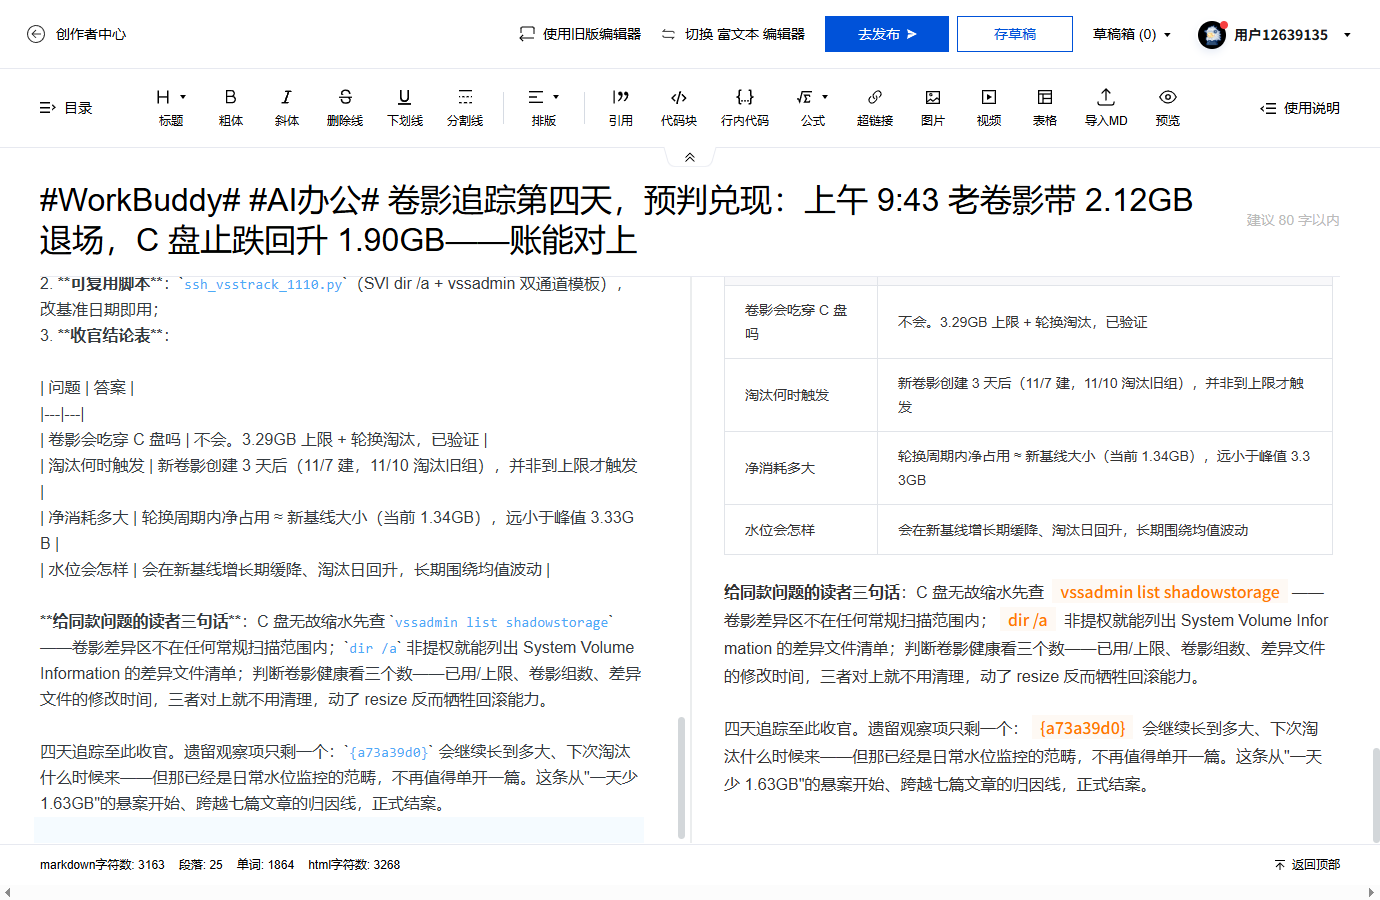
#WorkBuddy# #AI办公# 卷影追踪第四天,预判兑现:上午 9:43 老卷影带 2.12GB 退场,C 盘止跌回升 1.90GB——账能对上

本文是「C 盘消耗归因」系列的第七篇,也是卷影追踪的第四日,收官篇。前情:11/07 破案(一天少 1.63GB 的真凶是 System Volume Information 里的卷影差异区);11/08 第二日(水位再掉 0.80GB 与卷影增量 0.71GB 对上,vssadmin 显示 3.29GB 上限封顶,我预判它"不会无限涨");11/09 第三日(水位只掉 0.17GB 显著收敛,但预判的"轮换释放"没有发生,留下悬念:已用 2.77GB 距 3.29GB 上限只剩 0.5GB,逼近时会不会淘汰?)。

优秀的个人博客,低调大师

#WorkBuddy# 实战三:给数据流水线加一层"预测—回测"闭环——每天落盘一份可验证清单,次日自动对账,附 5 个新坑

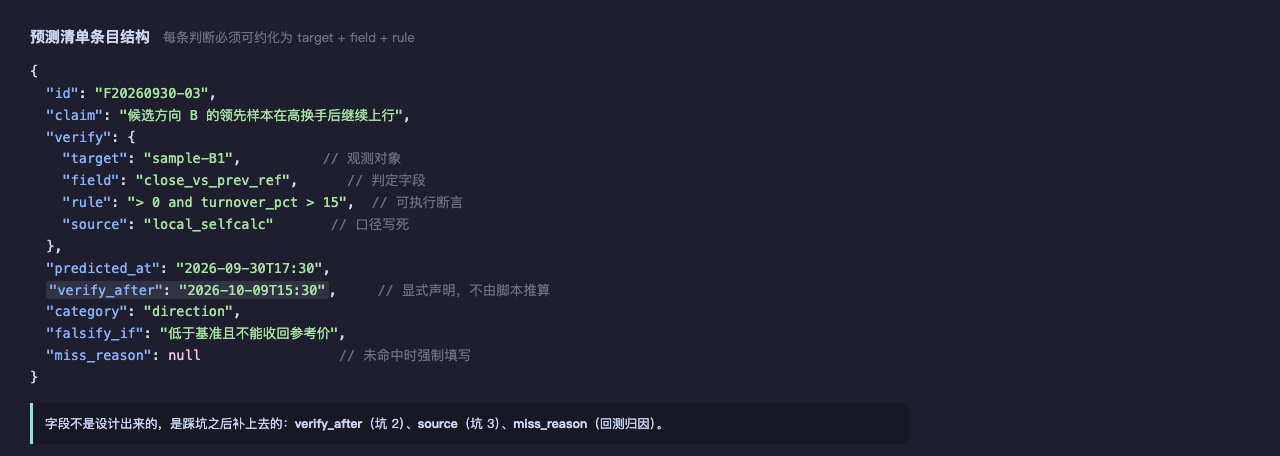
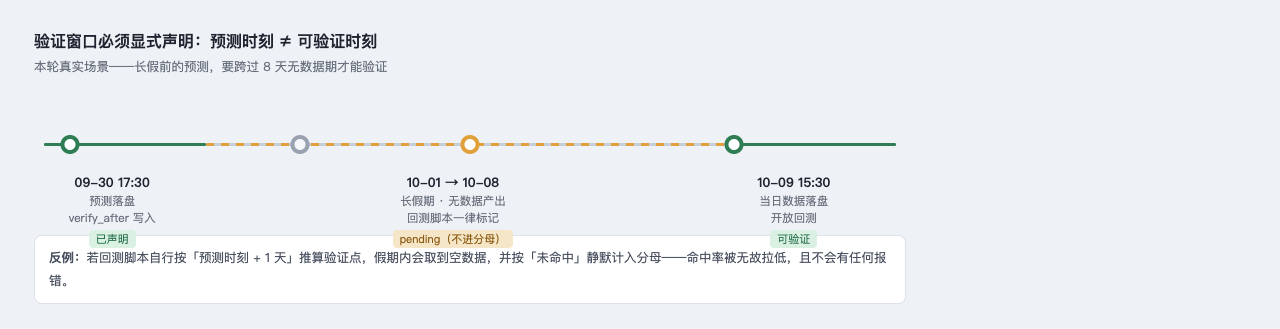
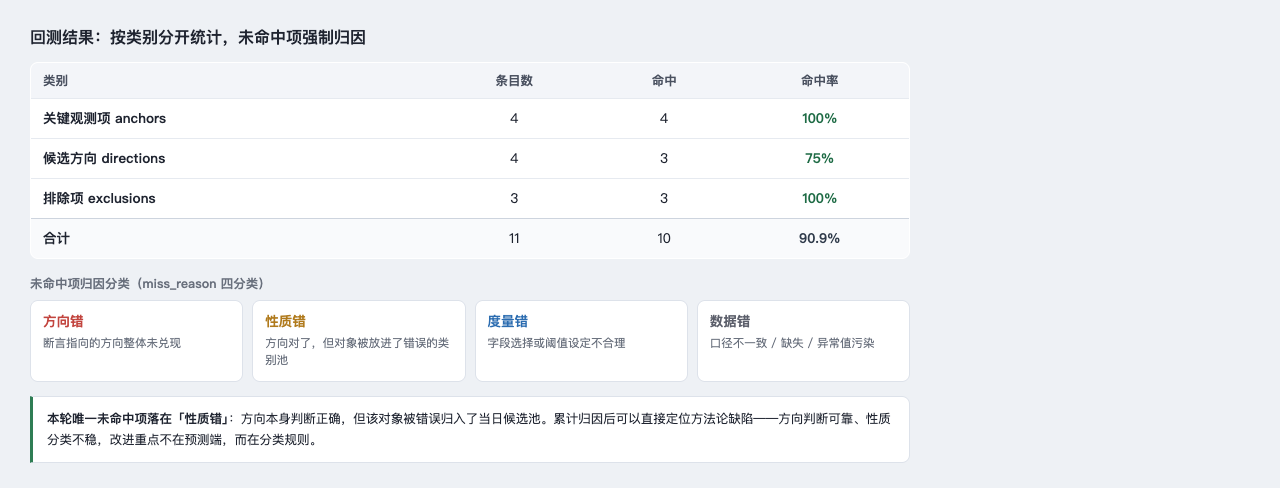
> 前两篇讲了怎么把每日数据流水线搭起来(实战一)、以及断档 11 天后怎么补齐(实战二)。这篇解决一个更隐蔽的问题:**报告每天在写,结论每天在给,但从来没有人回头验证过对错。** > 本文所有示例数据均已脱敏抽象为通用观测数据,讨论的是数据工程方法,不涉及任何具体标的。 ## 一、问题:日报有结论,但没有"可追责"的结论 流水线跑顺之后,会进入一个很舒服的状态:每天按时产出一份分析报告,里面有数据、有结构、有结论。问题恰恰出在这里—— 报告的结论是**自然语言**:写得漂亮,读起来有逻辑,但无法被机器验证。一个月后回头看,你只会记得"当时判断对了几个",真要对账,得一篇篇人肉读回去,根本做不完。 更要命的是心理学层面的:**人只会记住自己判断对的那些**。没有结构化回测,流水线其实是在生产"自我感觉良好",而不是在生产"校准过的判断力"。 于是我给流水线加了第二层产物:**预测清单(forecast ledger)**。报告依然是给人读的,但清单是给机器读的——它把报告里的每一条判断,翻译成"可验证的断言"。 ## 二、清单设计:每条判断都要落成"可验证断言" 一份清单的基本单元长这样: ``` { "id": "F20260930-03", "claim": "候选方向 B 的领先样本在高开换手达标后继续上行", "verify": { "target": "sample-B1", "field": "close_vs_prev_open", "rule": "> 0 and turnover_pct > 15", "source": "local_selfcalc" }, "predicted_at": "2026-09-30T17:30", "verify_after": "2026-10-09T15:30", "category": "direction", "falsify_if": "低于基准且不能收回参考价" } ``` 几个字段是踩坑之后才补上的,每一个都对应一次真实教训。 ![](https://developer.qcloudimg.com/http-save/yehe-12742991/990ed4589ba92e47407ce56fe2632cf5.png) ### 坑 1:自然语言的判断,回测不了 第一版清单直接抄报告里的句子,比如"某方向可能走强"。结果回测脚本拿到这句话完全没法执行——"可能"是概率词,"走强"没有度量。 **修法:每条断言必须能约化成 ****`target + field + rule**`**。** 写不出来的,说明这条判断本身就没想清楚——这反而是清单最大的附带价值:**它逼你把模糊判断变成明确断言**,写不出来的判断,等于没有判断。 ### 坑 2:验证窗口和数据的可得性会错位 这一条是本轮踩得最典型的。9/30 是长假前最后一个工作日,清单里当天落盘的预测,**要等 8 天假期结束、下一个工作日的当日数据落盘后才有数据可验**。 如果回测脚本的默认假设是"次日验证"(`verify_after = predicted_at + 1 day`),那么假期里跑回测会拿到空数据——然后要么报错刷屏,要么更糟:静默判定为"未命中"。 **修法:****`verify_after**`** 必须是显式字段,由清单生成方写死,不由回测脚本推算。** 回测脚本对"还没到验证时间"的条目只做一件事:跳过并标记 `pending`,绝不参与命中率计算。 一个直观的时间轴: ![](https://developer.qcloudimg.com/http-save/yehe-12742991/54784644014b65e2304902fe5965f3fb.png) 同样的问题还会出现在数据暂停样本、非工作日、数据源当日延迟等场景——**只要"预测时刻"和"可验证时刻"之间可能夹着非工作日,就必须显式声明验证窗口。** ### 坑 3:回测前必须先统一口径,否则命中的是幻觉 同一件事,本地自算和第三方口径经常不一致。本轮就出现了: |指标|本地自算|第三方口径|差异来源| | --- | --- | --- | --- | |触限家数|55|56|特殊类别样本是否计入| |反向触限家数|12|13|同上| |延续率|23.1%|60.0%|分子分母定义不同(各自自洽,但不可混用)| 注意第三行:两个数字差的不是 3 个百分点,是倍数级——因为一方用"日内接力样本数 / 当日新增样本数",另一方用"延续样本数 / 前一日新增样本数"。**两个口径各自都没错,混用就一定错。** **修法:清单条目里的 ****`source**`** 字段写死用哪个口径,回测时严格按该口径取数。** 回测脚本里加一道断言:如果一条断言的判定依赖的口径与清单声明不一致,直接抛错,而不是"算出一个数"。 ### 坑 4:异常值不能直接进判定函数 资金类字段会出现极端值。本轮有样本单日资金净额为全市场成交额的 36% 量级——**这个数字本身大概不是真实可解释的,它多半是统计口径边界上的产物**。 如果判定规则是 `net_amount > 0`,把这种异常值当正常值用,回测出来的"命中"是假的。 **修法:给字段加异常值策略,并在清单里显式标注。** 本轮的实践是:**这类极端字段只采信方向(正/负),不采信数值大小**,清单里用 `direction_only: true` 标出来。判定函数读到这个标记,就只比符号。 ### 坑 5:数据缺失要显式标源,绝不静默填充 有一个样本在本地数据源里查不到,但第三方数据源显示它有数据。第一反应是"用第三方补上就行"——但如果补上之后不标注,这份清单和回测结果就变成了**混合口径的缝合怪**,将来谁都不知道某一格的数字来自哪里。 **修法:****`source**`** 字段每格必填,缺失就写 ****`null**`** 并附 ****`note**`,绝不静默默认值填充。本轮的实际处理是:该样本的判定标注为"第三方口径"并单独列出,命中率统计时单独成组,不混入本地自算组。 ![](https://developer.qcloudimg.com/http-save/yehe-12742991/3bfa521a5b67a05d5d694208ccb6d90d.png) ## 三、回测结果:把"感觉对了"变成可量化数字 一轮完整回测跑出来的结果,按三类分开统计(数字为本轮真实回测,已脱敏): |类别|条目数|命中|命中率|说明| | --- | --- | --- | --- | --- | |关键观测项(anchors)|4|4|100%|全部兑现| |候选方向(directions)|4|3|75%|唯一未命中项见下| |排除项(exclusions)|3|3|100%|全部正确排除| 比命中率更有价值的是**未命中项的归因**,这才是回测的真正产出: > 唯一未命中的候选方向,错在**性质判断**而非方向判断——该方向确实在当日显著走弱(方向判对了),但我在清单里把它写成了"候选方向"(应当参与),而它当日的资金结构显示仍有大额资金在左侧承接,性质上属于"被反复介入的过渡样本",不该放进当日候选池。 > **结论:命中率之外,要给每条未命中项强制填写归因字段(****`miss_reason**`**),并区分"方向错 / 性质错 / 度量错 / 数据错"四类。** 归因累积到一定量级后,能直接暴露方法论的系统性缺陷——本例暴露的是:方向判断的准确率明显高于性质判断,那么改进重点就该放在"性质分类规则"上,而不是继续优化方向预测。 ## 四、工程启示 1. **判断必须断言化**:写不成 `target + field + rule` 的判断,等于没有判断; 1. **验证窗口显式声明**:`verify_after` 由生成方写死,回测脚本不许自行推算;未到验证时间的条目一律 `pending`,不进分母; 1. **口径写进清单**:每条断言自带 `source`,口径不一致直接抛错,不做"善意推断"; 1. **异常值有策略**:极端字段用 `direction_only` 标记,只比符号不比数值; 1. **缺失即标注**:宁可为 `null` + `note`,也不静默填充; 1. **未命中必归因**:命中率是结果,归因才是资产。 这层"预测—回测"闭环的价值,不在于让命中率变好看(第一轮跑出来是 10/11,看着很高,但样本量太小说明不了什么),而在于**它把流水线从"日报机器"变成了"判断力校准器"**。跑上几个月之后,你得到的不再是几十份报告,而是一份关于自己判断边界的实证记录——哪类判断可靠、哪类判断系统性偏差,全都有据可查。 下一篇准备讲这条流水线在**极端分布日**的表现:当上涨/下跌样本比达到 1:42 量级时,哪些统计指标会整体失真(本轮已有初步数据),以及为什么比率类指标在这种日子里几乎不可用。
资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册
修改密码
忘记密码