首页 文章 精选 留言 我的

精选列表

搜索[面试],共5087篇文章
优秀的个人博客,低调大师

几道高级前端面试题解析

为什么 0.1 + 0.2 != 0.3,请详述理由 因为 JS 采用 IEEE 754 双精度版本(64位),并且只要采用 IEEE 754 的语言都有该问题。 我们都知道计算机表示十进制是采用二进制表示的,所以 0.1 在二进制表示为 // (0011) 表示循环 0.1 = 2^-4 * 1.10011(0011) 复制代码 那么如何得到这个二进制的呢,我们可以来演算下 小数算二进制和整数不同。乘法计算时,只计算小数位,整数位用作每一位的二进制,并且得到的第一位为最高位。所以我们得出 0.1 = 2^-4 * 1.10011(0011),那么 0.2 的演算也基本如上所示,只需要去掉第一步乘法,所以得出 0.2 = 2^-3 * 1.10011(0011)。 回来继续说 IEEE 754 双精度。六十四位中符号位占一位,整数位占十一位,其余五十二位都为小数位。因为 0.1 和 0.2 都是无限循环的二进制了,所以在小数位末尾处需要判断是否进位(就和十进制的四舍五入一样)。 所以 2^-4 * 1.10011...001 进位后就变成了 2^-4 * 1.10011(0011 * 12次)010 。那么把这两个二进制加起来会得出 2^-2 * 1.0011(0011 * 11次)0100 , 这个值算成十进制就是 0.30000000000000004 下面说一下原生解决办法,如下代码所示 parseFloat((0.1 + 0.2).toFixed(10)) 复制代码 10 个 Ajax 同时发起请求,全部返回展示结果,并且至多允许三次失败,说出设计思路 这个问题相信很多人会第一时间想到 Promise.all ,但是这个函数有一个局限在于如果失败一次就返回了,直接这样实现会有点问题,需要变通下。以下是两种实现思路 // 以下是不完整代码,着重于思路 非 Promise 写法 let successCount = 0 let errorCount = 0 let datas = [] ajax(url, (res) => { if (success) { success++ if (success + errorCount === 10) { console.log(datas) } else { datas.push(res.data) } } else { errorCount++ if (errorCount > 3) { // 失败次数大于3次就应该报错了 throw Error('失败三次') } } }) // Promise 写法 let errorCount = 0 let p = new Promise((resolve, reject) => { if (success) { resolve(res.data) } else { errorCount++ if (errorCount > 3) { // 失败次数大于3次就应该报错了 reject(error) } else { resolve(error) } } }) Promise.all([p]).then(v => { console.log(v); }); 复制代码 基于 Localstorage 设计一个 1M 的缓存系统,需要实现缓存淘汰机制 设计思路如下: 存储的每个对象需要添加两个属性:分别是过期时间和存储时间。 利用一个属性保存系统中目前所占空间大小,每次存储都增加该属性。当该属性值大于 1M 时,需要按照时间排序系统中的数据,删除一定量的数据保证能够存储下目前需要存储的数据。 每次取数据时,需要判断该缓存数据是否过期,如果过期就删除。 以下是代码实现,实现了思路,但是可能会存在 Bug,但是这种设计题一般是给出设计思路和部分代码,不会需要写出一个无问题的代码 class Store { constructor() { let store = localStorage.getItem('cache') if (!store) { store = { maxSize: 1024 * 1024, size: 0 } this.store = store } else { this.store = JSON.parse(store) } } set(key, value, expire) { this.store[key] = { date: Date.now(), expire, value } let size = this.sizeOf(JSON.stringify(this.store[key])) if (this.store.maxSize < size + this.store.size) { console.log('超了-----------'); var keys = Object.keys(this.store); // 时间排序 keys = keys.sort((a, b) => { let item1 = this.store[a], item2 = this.store[b]; return item2.date - item1.date; }); while (size + this.store.size > this.store.maxSize) { let index = keys[keys.length - 1] this.store.size -= this.sizeOf(JSON.stringify(this.store[index])) delete this.store[index] } } this.store.size += size localStorage.setItem('cache', JSON.stringify(this.store)) } get(key) { let d = this.store[key] if (!d) { console.log('找不到该属性'); return } if (d.expire > Date.now) { console.log('过期删除'); delete this.store[key] localStorage.setItem('cache', JSON.stringify(this.store)) } else { return d.value } } sizeOf(str, charset) { var total = 0, charCode, i, len; charset = charset ? charset.toLowerCase() : ''; if (charset === 'utf-16' || charset === 'utf16') { for (i = 0, len = str.length; i < len; i++) { charCode = str.charCodeAt(i); if (charCode <= 0xffff) { total += 2; } else { total += 4; } } } else { for (i = 0, len = str.length; i < len; i++) { charCode = str.charCodeAt(i); if (charCode <= 0x007f) { total += 1; } else if (charCode <= 0x07ff) { total += 2; } else if (charCode <= 0xffff) { total += 3; } else { total += 4; } } } return total; } } 复制代码 详细说明 Event loop 众所周知 JS 是门非阻塞单线程语言,因为在最初 JS 就是为了和浏览器交互而诞生的。如果 JS 是门多线程的语言话,我们在多个线程中处理 DOM 就可能会发生问题(一个线程中新加节点,另一个线程中删除节点),当然可以引入读写锁解决这个问题。 JS 在执行的过程中会产生执行环境,这些执行环境会被顺序的加入到执行栈中。如果遇到异步的代码,会被挂起并加入到 Task(有多种 task) 队列中。一旦执行栈为空,Event Loop 就会从 Task 队列中拿出需要执行的代码并放入执行栈中执行,所以本质上来说 JS 中的异步还是同步行为。 console.log('script start'); setTimeout(function() { console.log('setTimeout'); }, 0); console.log('script end'); 复制代码 以上代码虽然 setTimeout 延时为 0,其实还是异步。这是因为 HTML5 标准规定这个函数第二个参数不得小于 4 毫秒,不足会自动增加。所以 setTimeout 还是会在 script end 之后打印。 不同的任务源会被分配到不同的 Task 队列中,任务源可以分为 微任务(microtask) 和 宏任务(macrotask)。在 ES6 规范中,microtask 称为 jobs,macrotask 称为 task。 console.log('script start'); setTimeout(function() { console.log('setTimeout'); }, 0); new Promise((resolve) => { console.log('Promise') resolve() }).then(function() { console.log('promise1'); }).then(function() { console.log('promise2'); }); console.log('script end'); // script start => Promise => script end => promise1 => promise2 => setTimeout 复制代码 以上代码虽然 setTimeout 写在 Promise 之前,但是因为 Promise 属于微任务而 setTimeout 属于宏任务,所以会有以上的打印。 微任务包括 process.nextTick ,promise ,Object.observe ,MutationObserver 宏任务包括 script , setTimeout ,setInterval ,setImmediate ,I/O ,UI rendering 很多人有个误区,认为微任务快于宏任务,其实是错误的。因为宏任务中包括了 script ,浏览器会先执行一个宏任务,接下来有异步代码的话就先执行微任务。 所以正确的一次 Event loop 顺序是这样的 执行同步代码,这属于宏任务 执行栈为空,查询是否有微任务需要执行 执行所有微任务 必要的话渲染 UI 然后开始下一轮 Event loop,执行宏任务中的异步代码 通过上述的 Event loop 顺序可知,如果宏任务中的异步代码有大量的计算并且需要操作 DOM 的话,为了更快的 界面响应,我们可以把操作 DOM 放入微任务中。 Node 中的 Event loop Node 中的 Event loop 和浏览器中的不相同。 Node 的 Event loop 分为6个阶段,它们会按照顺序反复运行 ┌───────────────────────┐ ┌─>│ timers │ │ └──────────┬────────────┘ │ ┌──────────┴────────────┐ │ │ I/O callbacks │ │ └──────────┬────────────┘ │ ┌──────────┴────────────┐ │ │ idle, prepare │ │ └──────────┬────────────┘ ┌───────────────┐ │ ┌──────────┴────────────┐ │ incoming: │ │ │ poll │<──connections─── │ │ └──────────┬────────────┘ │ data, etc. │ │ ┌──────────┴────────────┐ └───────────────┘ │ │ check │ │ └──────────┬────────────┘ │ ┌──────────┴────────────┐ └──┤ close callbacks │ └───────────────────────┘ 复制代码 timer timers 阶段会执行 setTimeout 和 setInterval 一个 timer 指定的时间并不是准确时间,而是在达到这个时间后尽快执行回调,可能会因为系统正在执行别的事务而延迟。 下限的时间有一个范围:[1, 2147483647] ,如果设定的时间不在这个范围,将被设置为1。 I/O I/O 阶段会执行除了 close 事件,定时器和 setImmediate 的回调 idle, prepare idle, prepare 阶段内部实现 poll poll 阶段很重要,这一阶段中,系统会做两件事情 执行到点的定时器 执行 poll 队列中的事件 并且当 poll 中没有定时器的情况下,会发现以下两件事情 如果 poll 队列不为空,会遍历回调队列并同步执行,直到队列为空或者系统限制 如果 poll 队列为空,会有两件事发生 如果有 setImmediate 需要执行,poll 阶段会停止并且进入到 check 阶段执行 setImmediate 如果没有 setImmediate 需要执行,会等待回调被加入到队列中并立即执行回调 如果有别的定时器需要被执行,会回到 timer 阶段执行回调。 check check 阶段执行 setImmediate close callbacks close callbacks 阶段执行 close 事件 并且在 Node 中,有些情况下的定时器执行顺序是随机的 setTimeout(() => { console.log('setTimeout'); }, 0); setImmediate(() => { console.log('setImmediate'); }) // 这里可能会输出 setTimeout,setImmediate // 可能也会相反的输出,这取决于性能 // 因为可能进入 event loop 用了不到 1 毫秒,这时候会执行 setImmediate // 否则会执行 setTimeout 复制代码 当然在这种情况下,执行顺序是相同的 var fs = require('fs') fs.readFile(__filename, () => { setTimeout(() => { console.log('timeout'); }, 0); setImmediate(() => { console.log('immediate'); }); }); // 因为 readFile 的回调在 poll 中执行 // 发现有 setImmediate ,所以会立即跳到 check 阶段执行回调 // 再去 timer 阶段执行 setTimeout // 所以以上输出一定是 setImmediate,setTimeout 复制代码 上面介绍的都是 macrotask 的执行情况,microtask 会在以上每个阶段完成后立即执行。 setTimeout(()=>{ console.log('timer1') Promise.resolve().then(function() { console.log('promise1') }) }, 0) setTimeout(()=>{ console.log('timer2') Promise.resolve().then(function() { console.log('promise2') }) }, 0) // 以上代码在浏览器和 node 中打印情况是不同的 // 浏览器中打印 timer1, promise1, timer2, promise2 // node 中打印 timer1, timer2, promise1, promise2 复制代码 Node 中的 process.nextTick 会先于其他 microtask 执行。 setTimeout(() => { console.log("timer1"); Promise.resolve().then(function() { console.log("promise1"); }); }, 0); process.nextTick(() => { console.log("nextTick"); }); // nextTick, timer1, promise1 1.如果觉得这篇文章还不错,来个分享、点赞吧,让更多的人也看到 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源世界 ” ,链接: https://ym.baisou.ltd/post/754.html ,如需转载,请注明出处,否则将追究法律责任。

优秀的个人博客,低调大师

11道浏览器原理面试题

浏览器与新技术 这是一篇很长的文章,可以算上一本小书了,有精力的非常建议阅读。 常见的浏览器内核有哪些? 浏览器/RunTime 内核(渲染引擎) JavaScript 引擎 Chrome Blink(28~) Webkit(Chrome 27) V8 FireFox Gecko SpiderMonkey Safari Webkit JavaScriptCore Edge EdgeHTML Chakra(for JavaScript) IE Trident Chakra(for JScript) PhantomJS Webkit JavaScriptCore Node.js - V8 浏览器的主要组成部分是什么? 用户界面- 包括地址栏、前进/后退按钮、书签菜单等。除了浏览器主窗口显示的您请求的页面外,其他显示的各个部分都属于用户界面。 浏览器引擎- 在用户界面和呈现引擎之间传送指令。 呈现引擎- 负责显示请求的内容。如果请求的内容是 HTML,它就负责解析 HTML 和 CSS 内容,并将解析后的内容显示在屏幕上。 网络- 用于网络调用,比如 HTTP 请求。其接口与平台无关,并为所有平台提供底层实现。 用户界面后端- 用于绘制基本的窗口小部件,比如组合框和窗口。其公开了与平台无关的通用接口,而在底层使用操作系统的用户界面方法。 JavaScript 解释器。用于解析和执行 JavaScript 代码。 数据存储。这是持久层。浏览器需要在硬盘上保存各种数据,例如 Cookie。新的 HTML 规范 (HTML5) 定义了“网络数据库”,这是一个完整(但是轻便)的浏览器内数据库。 图:浏览器的主要组件。 值得注意的是,和大多数浏览器不同,Chrome 浏览器的每个标签页都分别对应一个呈现引擎实例。每个标签页都是一个独立的进程。 浏览器是如何渲染UI的? 浏览器获取HTML文件,然后对文件进行解析,形成DOM Tree 与此同时,进行CSS解析,生成Style Rules 接着将DOM Tree与Style Rules合成为 Render Tree 接着进入布局(Layout)阶段,也就是为每个节点分配一个应出现在屏幕上的确切坐标 随后调用GPU进行绘制(Paint),遍历Render Tree的节点,并将元素呈现出来 浏览器如何解析css选择器? 浏览器会『从右往左』解析CSS选择器。 我们知道DOM Tree与Style Rules合成为 Render Tree,实际上是需要将Style Rules附着到DOM Tree上,因此需要根据选择器提供的信息对DOM Tree进行遍历,才能将样式附着到对应的DOM元素上。 以下这段css为例 .mod-nav h3 span {font-size: 16px;} 复制代码 我们对应的DOM Tree 如下 若从左向右的匹配,过程是: 从 .mod-nav 开始,遍历子节点 header 和子节点 div 然后各自向子节点遍历。在右侧 div 的分支中 最后遍历到叶子节点 a ,发现不符合规则,需要回溯到 ul 节点,再遍历下一个 li-a,一颗DOM树的节点动不动上千,这种效率很低。 如果从右至左的匹配: 先找到所有的最右节点 span,对于每一个 span,向上寻找节点 h3 由 h3再向上寻找 class=mod-nav 的节点 最后找到根元素 html 则结束这个分支的遍历。 后者匹配性能更好,是因为从右向左的匹配在第一步就筛选掉了大量的不符合条件的最右节点(叶子节点);而从左向右的匹配规则的性能都浪费在了失败的查找上面。 DOM Tree是如何构建的? 转码: 浏览器将接收到的二进制数据按照指定编码格式转化为HTML字符串 生成Tokens: 之后开始parser,浏览器会将HTML字符串解析成Tokens 构建Nodes: 对Node添加特定的属性,通过指针确定 Node 的父、子、兄弟关系和所属 treeScope 生成DOM Tree: 通过node包含的指针确定的关系构建出DOM Tree 浏览器重绘与重排的区别? 重排: 部分渲染树(或者整个渲染树)需要重新分析并且节点尺寸需要重新计算,表现为重新生成布局,重新排列元素 重绘: 由于节点的几何属性发生改变或者由于样式发生改变,例如改变元素背景色时,屏幕上的部分内容需要更新,表现为某些元素的外观被改变 单单改变元素的外观,肯定不会引起网页重新生成布局,但当浏览器完成重排之后,将会重新绘制受到此次重排影响的部分 重排和重绘代价是高昂的,它们会破坏用户体验,并且让UI展示非常迟缓,而相比之下重排的性能影响更大,在两者无法避免的情况下,一般我们宁可选择代价更小的重绘。 『重绘』不一定会出现『重排』,『重排』必然会出现『重绘』。 如何触发重排和重绘? 任何改变用来构建渲染树的信息都会导致一次重排或重绘: 添加、删除、更新DOM节点 通过display: none隐藏一个DOM节点-触发重排和重绘 通过visibility: hidden隐藏一个DOM节点-只触发重绘,因为没有几何变化 移动或者给页面中的DOM节点添加动画 添加一个样式表,调整样式属性 用户行为,例如调整窗口大小,改变字号,或者滚动。 如何避免重绘或者重排? 集中改变样式 我们往往通过改变class的方式来集中改变样式 // 判断是否是黑色系样式 const theme = isDark ? 'dark' : 'light' // 根据判断来设置不同的class ele.setAttribute('className', theme) 复制代码 使用DocumentFragment 我们可以通过createDocumentFragment创建一个游离于DOM树之外的节点,然后在此节点上批量操作,最后插入DOM树中,因此只触发一次重排 var fragment = document.createDocumentFragment(); for (let i = 0;i<10;i++){ let node = document.createElement("p"); node.innerHTML = i; fragment.appendChild(node); } document.body.appendChild(fragment); 复制代码 提升为合成层 将元素提升为合成层有以下优点: 合成层的位图,会交由 GPU 合成,比 CPU 处理要快 当需要 repaint 时,只需要 repaint 本身,不会影响到其他的层 对于 transform 和 opacity 效果,不会触发 layout 和 paint 提升合成层的最好方式是使用 CSS 的 will-change 属性: #target { will-change: transform; } 复制代码 前端如何实现即时通讯? 短轮询 短轮询的原理很简单,每隔一段时间客户端就发出一个请求,去获取服务器最新的数据,一定程度上模拟实现了即时通讯。 优点:兼容性强,实现非常简单 缺点:延迟性高,非常消耗请求资源,影响性能 comet comet有两种主要实现手段,一种是基于 AJAX 的长轮询(long-polling)方式,另一种是基于 Iframe 及 htmlfile 的流(streaming)方式,通常被叫做长连接。 长轮询优缺点: 优点:兼容性好,资源浪费较小 缺点:服务器hold连接会消耗资源,返回数据顺序无保证,难于管理维护 长连接优缺点: 优点:兼容性好,消息即时到达,不发无用请求 缺点:服务器维护长连接消耗资源 SSE SSE(Server-Sent Event,服务端推送事件)是一种允许服务端向客户端推送新数据的HTML5技术。 优点:基于HTTP而生,因此不需要太多改造就能使用,使用方便,而websocket非常复杂,必须借助成熟的库或框架 缺点:基于文本传输效率没有websocket高,不是严格的双向通信,客户端向服务端发送请求无法复用之前的连接,需要重新发出独立的请求 Websocket Websocket是一个全新的、独立的协议,基于TCP协议,与http协议兼容、却不会融入http协议,仅仅作为html5的一部分,其作用就是在服务器和客户端之间建立实时的双向通信。 优点:真正意义上的实时双向通信,性能好,低延迟 缺点:独立与http的协议,因此需要额外的项目改造,使用复杂度高,必须引入成熟的库,无法兼容低版本浏览器 Web Worker 后面性能优化部分会用到,先做了解 Web Worker 的作用,就是为 JavaScript 创造多线程环境,允许主线程创建 Worker 线程,将一些任务分配给后者运行 Service workers 后面性能优化部分会用到,先做了解 Service workers 本质上充当Web应用程序与浏览器之间的代理服务器,也可以在网络可用时作为浏览器和网络间的代理,创建有效的离线体验。 什么是浏览器同源策略? 同源策略限制了从同一个源加载的文档或脚本如何与来自另一个源的资源进行交互。这是一个用于隔离潜在恶意文件的重要安全机制。 同源是指"协议+域名+端口"三者相同,即便两个不同的域名指向同一个ip地址,也非同源。 下表给出了相对http://store.company.com/dir/page.html同源检测的示例: 浏览器中的大部分内容都是受同源策略限制的,但是以下三个标签可以不受限制: <img src=XXX> <link href=XXX> <script src=XXX> 如何实现跨域? 跨域是个比较古老的命题了,历史上跨域的实现手段有很多,我们现在主要介绍三种比较主流的跨域方案,其余的方案我们就不深入讨论了,因为使用场景很少,也没必要记这么多奇技淫巧。 最经典的跨域方案jsonp jsonp本质上是一个Hack,它利用<script>标签不受同源策略限制的特性进行跨域操作。 jsonp优点: 实现简单 兼容性非常好 jsonp的缺点: 只支持get请求(因为<script>标签只能get) 有安全性问题,容易遭受xss攻击 需要服务端配合jsonp进行一定程度的改造 jsonp的实现: function JSONP({ url, params, callbackKey, callback }) { // 在参数里制定 callback 的名字 params = params || {} params[callbackKey] = 'jsonpCallback' // 预留 callback window.jsonpCallback = callback // 拼接参数字符串 const paramKeys = Object.keys(params) const paramString = paramKeys .map(key => `${key}=${params[key]}`) .join('&') // 插入 DOM 元素 const script = document.createElement('script') script.setAttribute('src', `${url}?${paramString}`) document.body.appendChild(script) } JSONP({ url: 'http://s.weibo.com/ajax/jsonp/suggestion', params: { key: 'test', }, callbackKey: '_cb', callback(result) { console.log(result.data) } }) 复制代码 最流行的跨域方案cors cors是目前主流的跨域解决方案,跨域资源共享(CORS) 是一种机制,它使用额外的 HTTP 头来告诉浏览器 让运行在一个 origin (domain) 上的Web应用被准许访问来自不同源服务器上的指定的资源。当一个资源从与该资源本身所在的服务器不同的域、协议或端口请求一个资源时,资源会发起一个跨域 HTTP 请求。 如果你用express,可以这样在后端设置 //CORS middleware var allowCrossDomain = function(req, res, next) { res.header('Access-Control-Allow-Origin', 'http://example.com'); res.header('Access-Control-Allow-Methods', 'GET,PUT,POST,DELETE'); res.header('Access-Control-Allow-Headers', 'Content-Type'); next(); } //... app.configure(function() { app.use(express.bodyParser()); app.use(express.cookieParser()); app.use(express.session({ secret: 'cool beans' })); app.use(express.methodOverride()); app.use(allowCrossDomain); app.use(app.router); app.use(express.static(__dirname + '/public')); }); 复制代码 在生产环境中建议用成熟的开源中间件解决问题。 最方便的跨域方案Nginx nginx是一款极其强大的web服务器,其优点就是轻量级、启动快、高并发。 现在的新项目中nginx几乎是首选,我们用node或者java开发的服务通常都需要经过nginx的反向代理。 反向代理的原理很简单,即所有客户端的请求都必须先经过nginx的处理,nginx作为代理服务器再讲请求转发给node或者java服务,这样就规避了同源策略。 #进程, 可更具cpu数量调整 worker_processes 1; events { #连接数 worker_connections 1024; } http { include mime.types; default_type application/octet-stream; sendfile on; #连接超时时间,服务器会在这个时间过后关闭连接。 keepalive_timeout 10; # gizp压缩 gzip on; # 直接请求nginx也是会报跨域错误的这里设置允许跨域 # 如果代理地址已经允许跨域则不需要这些, 否则报错(虽然这样nginx跨域就没意义了) add_header Access-Control-Allow-Origin *; add_header Access-Control-Allow-Headers X-Requested-With; add_header Access-Control-Allow-Methods GET,POST,OPTIONS; # srever模块配置是http模块中的一个子模块,用来定义一个虚拟访问主机 server { listen 80; server_name localhost; # 根路径指到index.html location / { root html; index index.html index.htm; } # localhost/api 的请求会被转发到192.168.0.103:8080 location /api { rewrite ^/b/(.*)$ /$1 break; # 去除本地接口/api前缀, 否则会出现404 proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_pass http://192.168.0.103:8080; # 转发地址 } # 重定向错误页面到/50x.html error_page 500 502 503 504 /50x.html; location = /50x.html { root html; } } } 复制代码 其它跨域方案 HTML5 XMLHttpRequest 有一个API,postMessage()方法允许来自不同源的脚本采用异步方式进行有限的通信,可以实现跨文本档、多窗口、跨域消息传递。 WebSocket 是一种双向通信协议,在建立连接之后,WebSocket 的 server 与 client 都能主动向对方发送或接收数据,连接建立好了之后 client 与 server 之间的双向通信就与 HTTP 无关了,因此可以跨域。 window.name + iframe:window.name属性值在不同的页面(甚至不同域名)加载后依旧存在,并且可以支持非常长的 name 值,我们可以利用这个特点进行跨域。 location.hash + iframe:a.html欲与c.html跨域相互通信,通过中间页b.html来实现。 三个页面,不同域之间利用iframe的location.hash传值,相同域之间直接js访问来通信。 document.domain + iframe: 该方式只能用于二级域名相同的情况下,比如 a.test.com 和 b.test.com 适用于该方式,我们只需要给页面添加 document.domain ='test.com' 表示二级域名都相同就可以实现跨域,两个页面都通过js强制设置document.domain为基础主域,就实现了同域。 1.如果觉得这篇文章还不错,来个分享、点赞吧,让更多的人也看到 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源世界 ” ,链接: https://ym.baisou.ltd/post/753.html ,如需转载,请注明出处,否则将追究法律责任。

优秀的个人博客,低调大师

面试系列六 之 用户行为数据分析

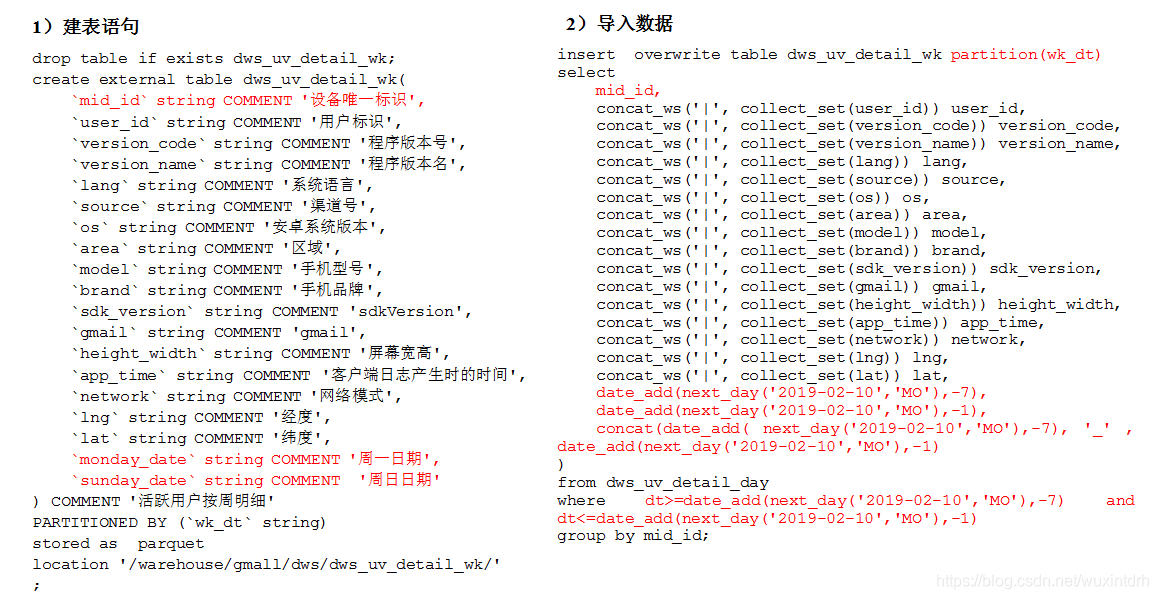
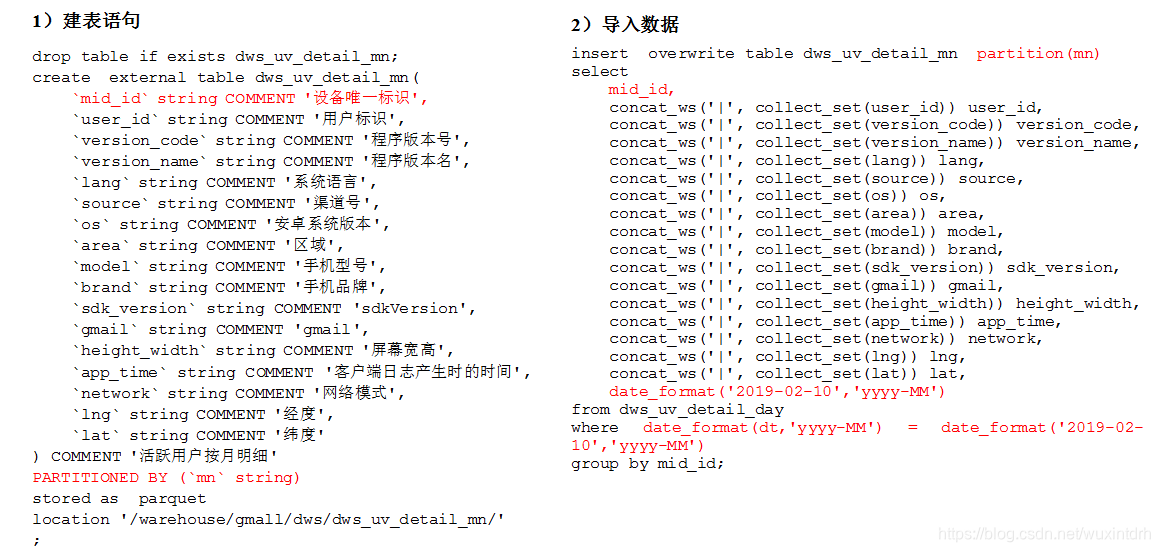
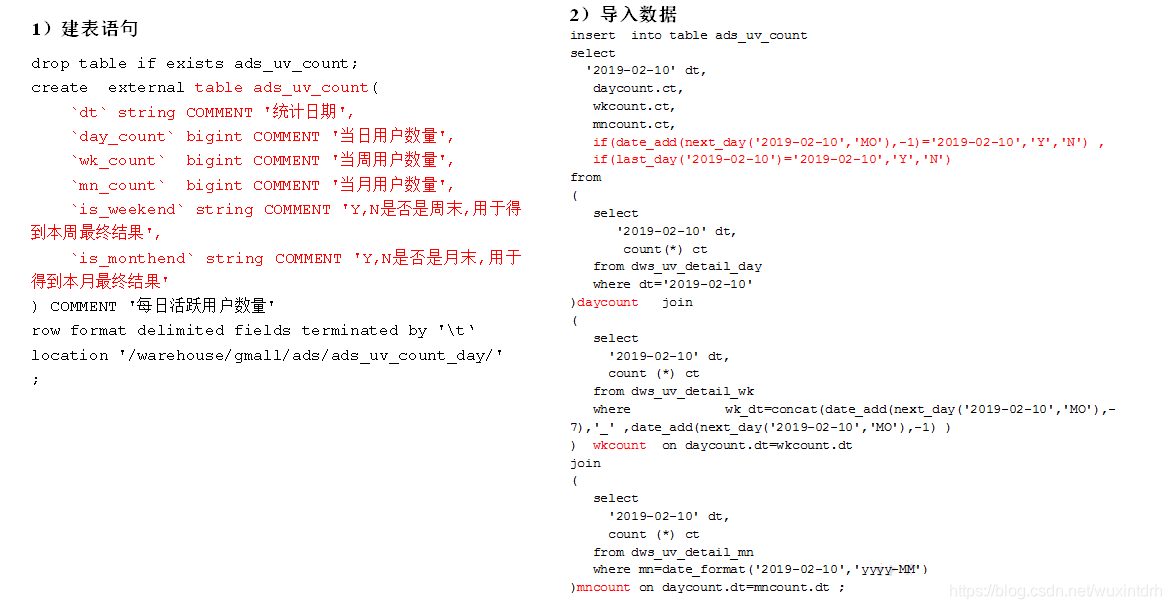
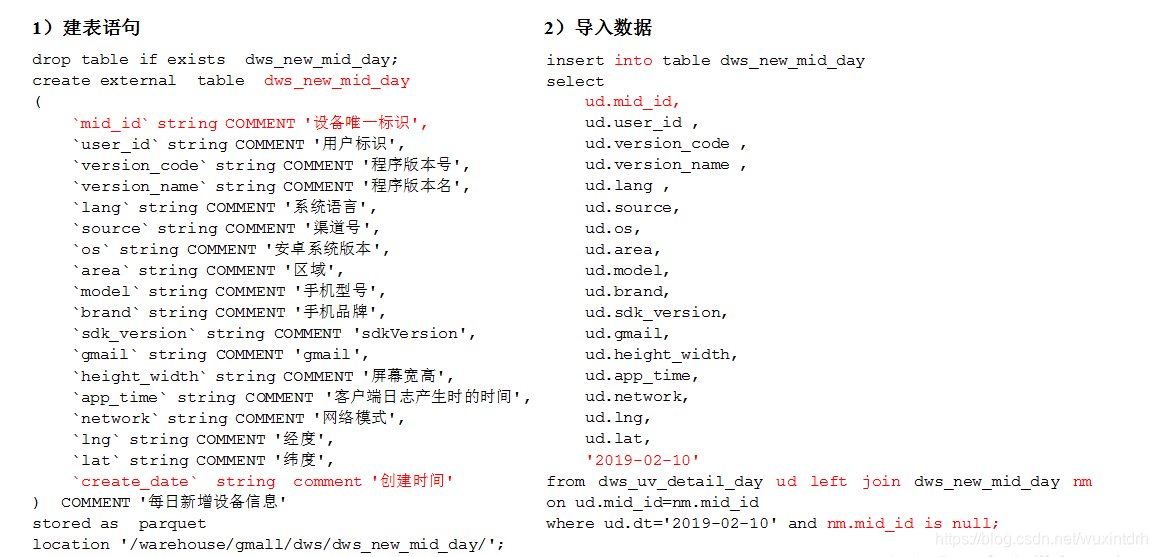
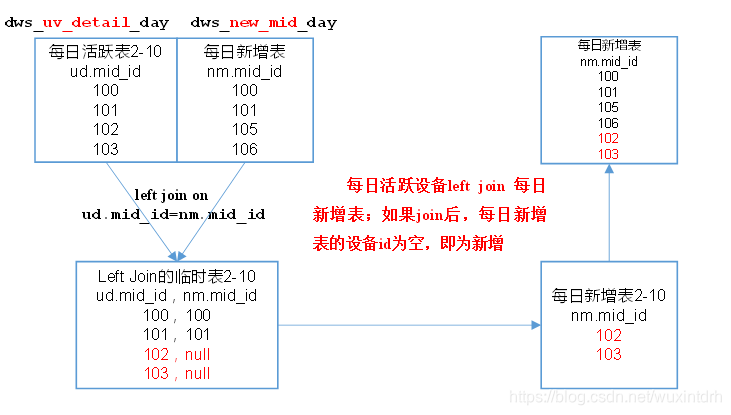
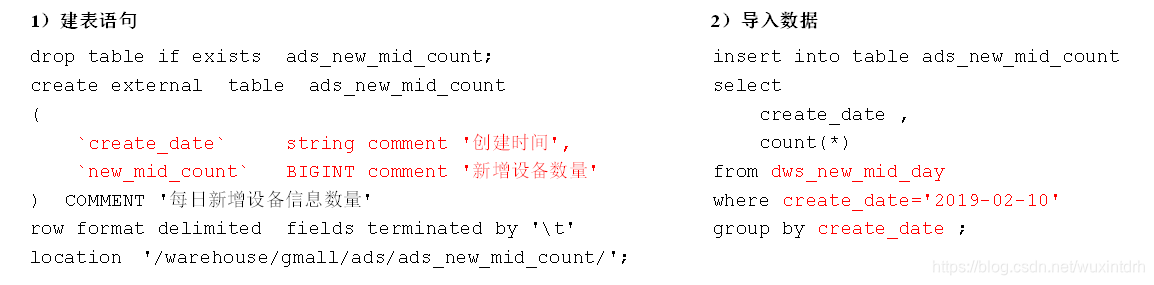
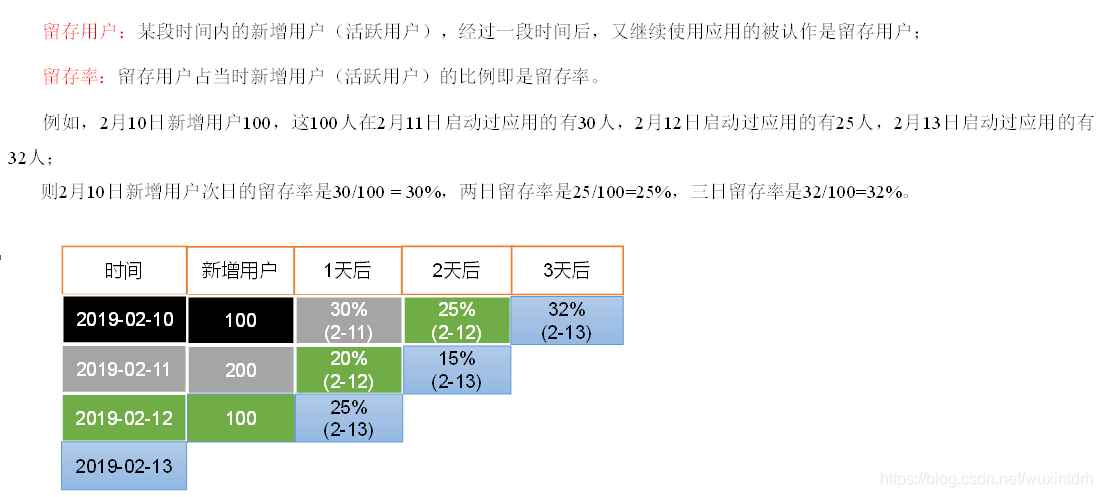
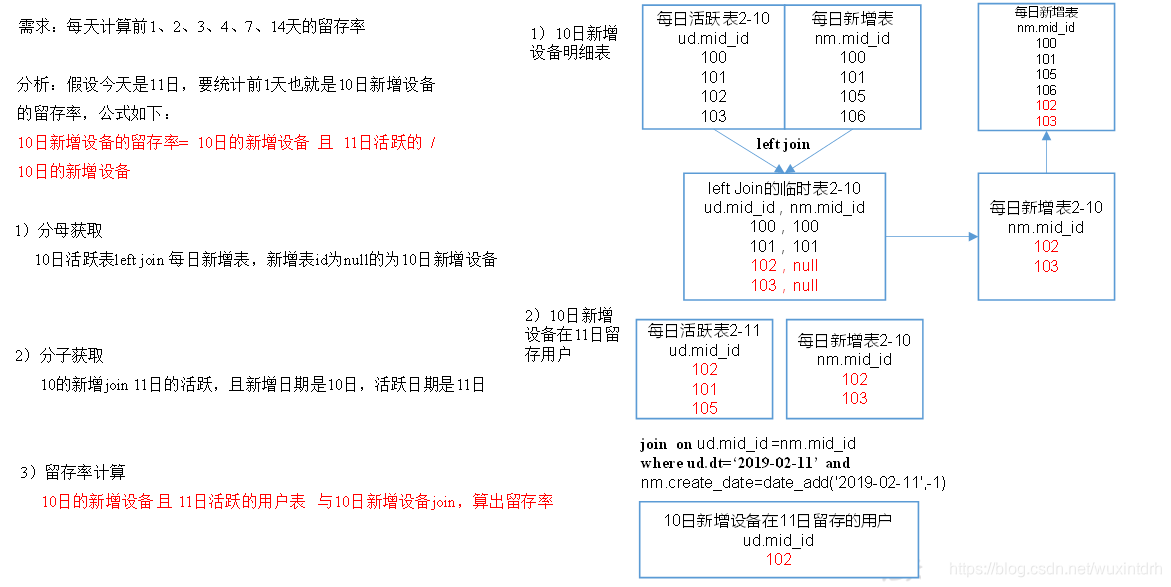
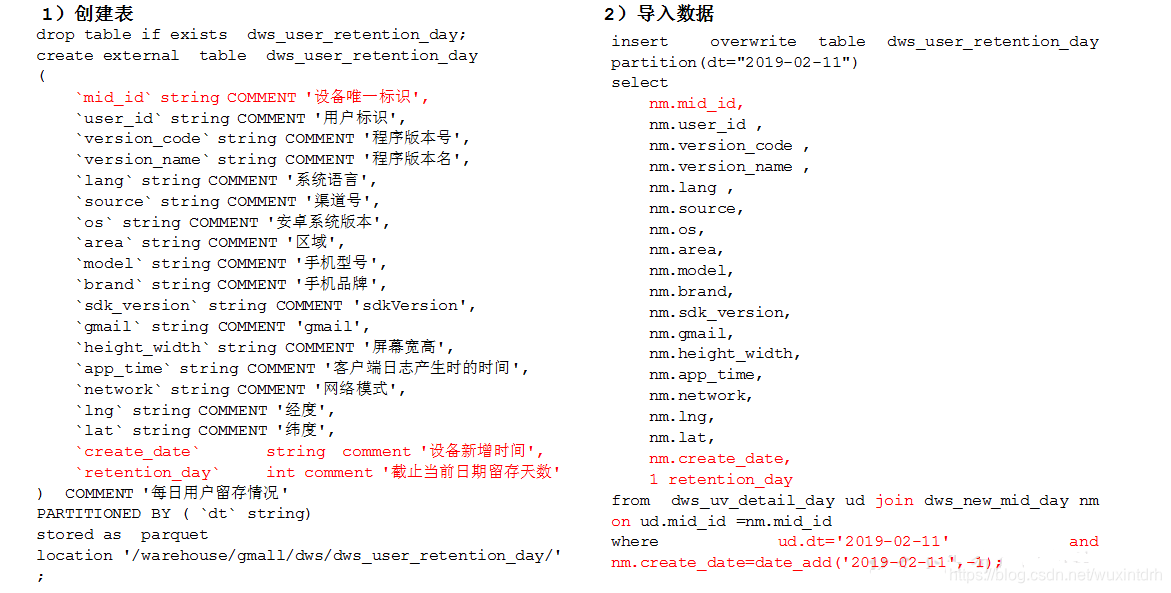
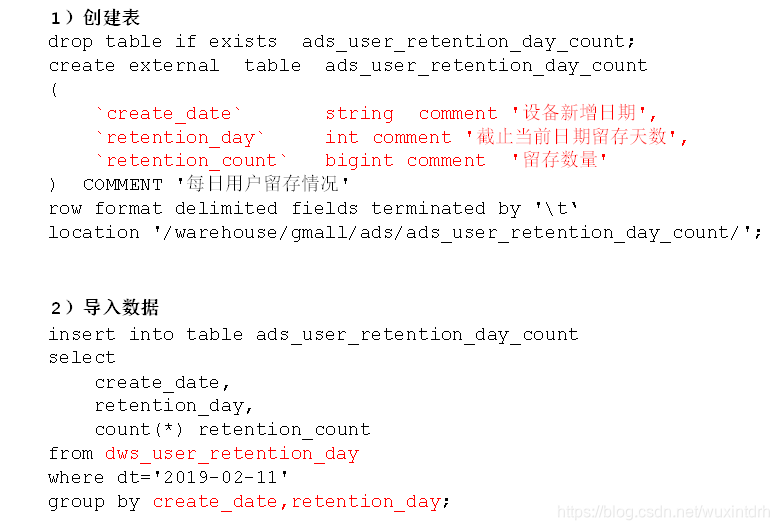
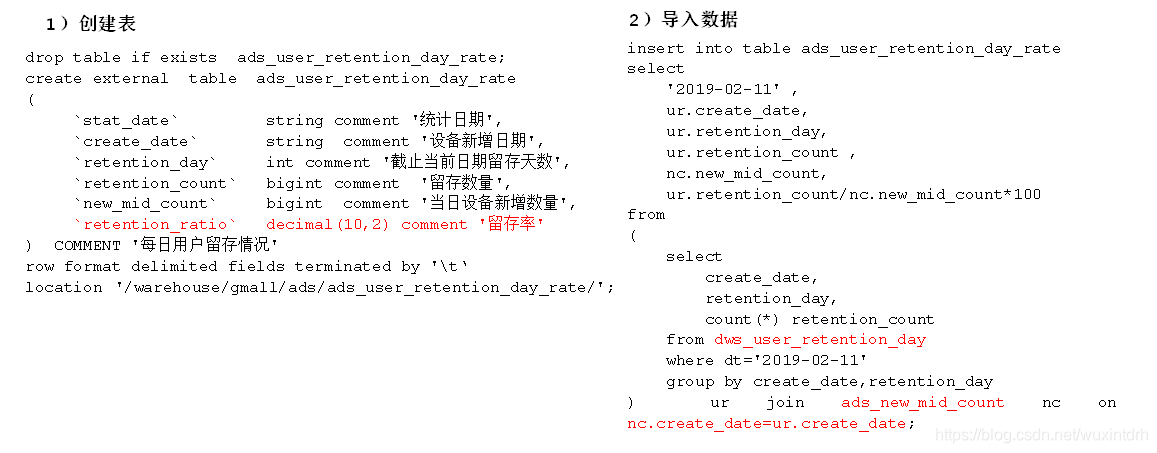
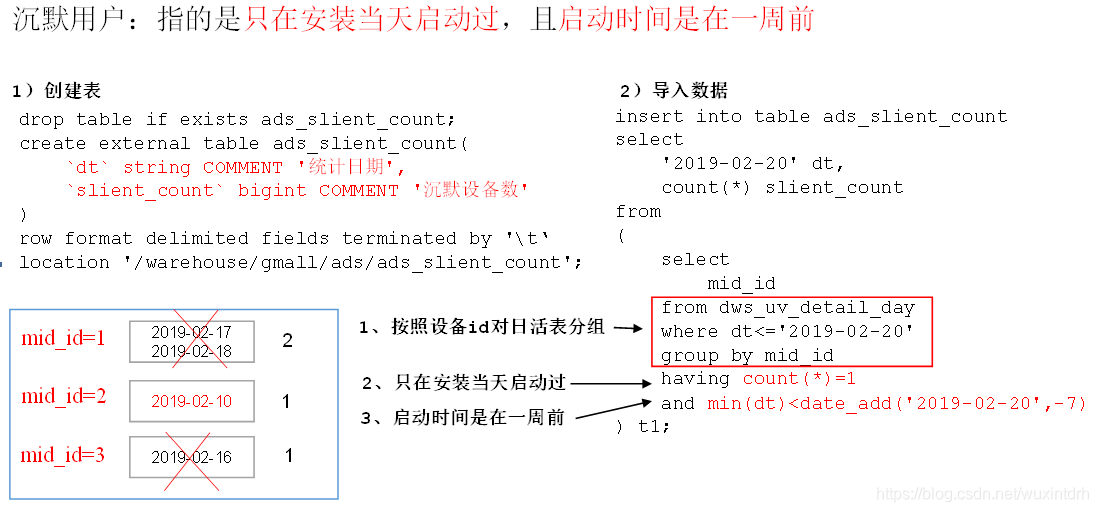
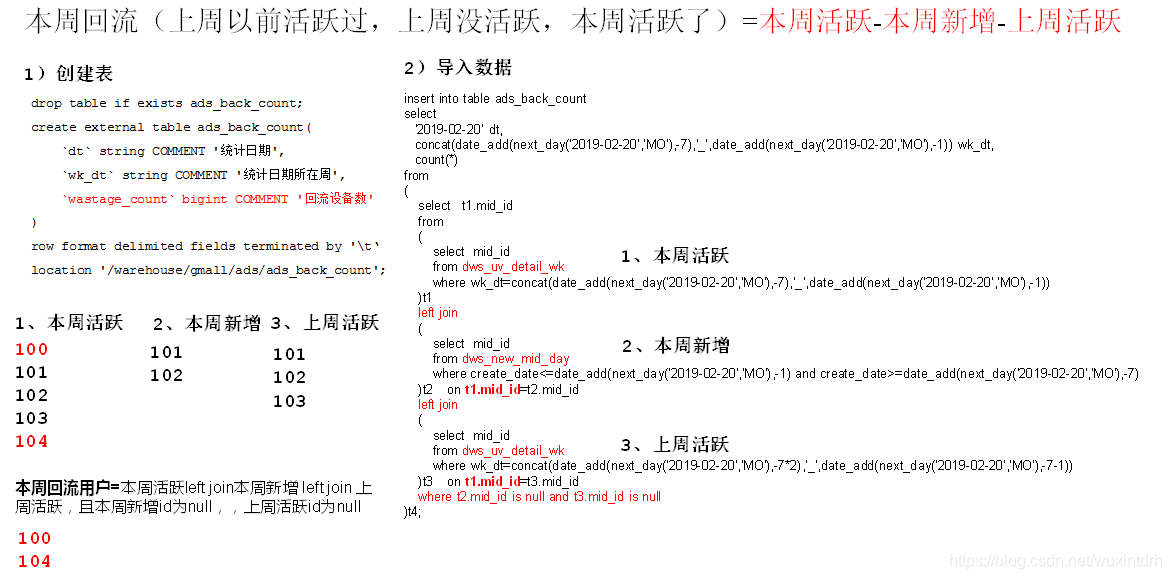
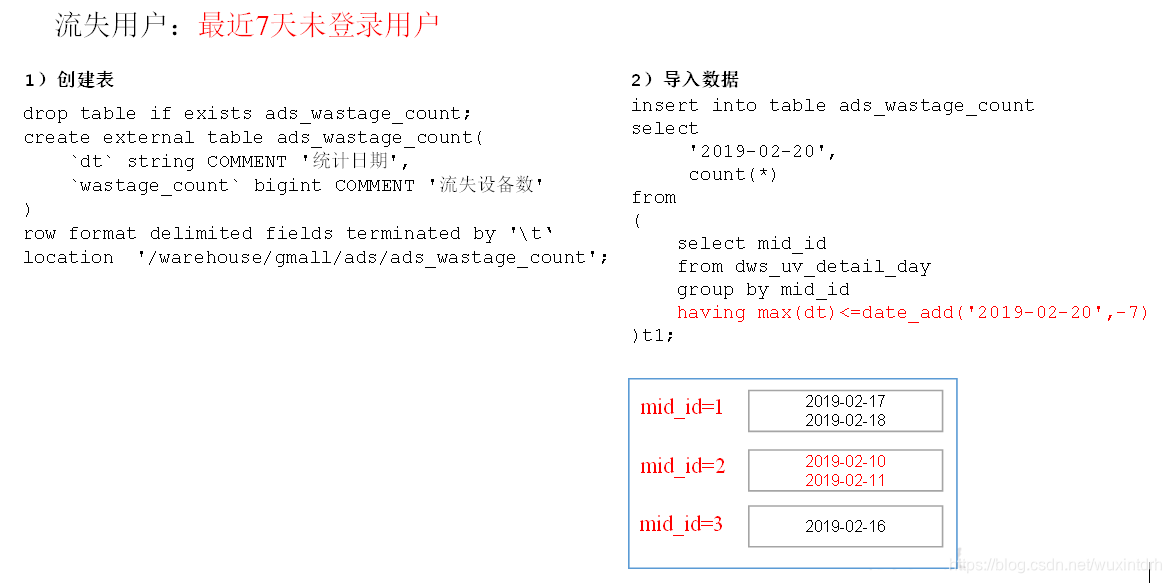
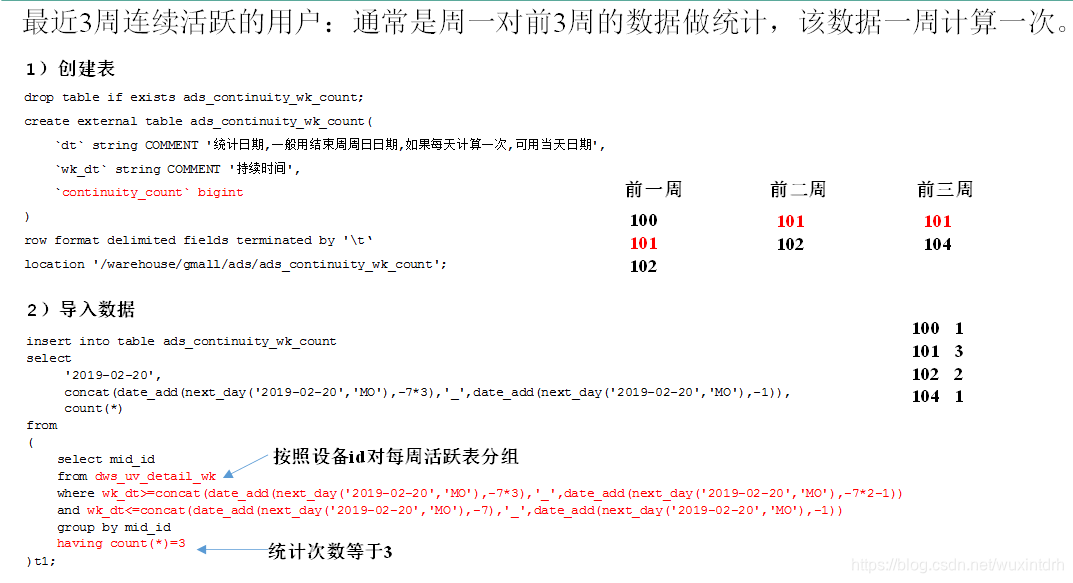
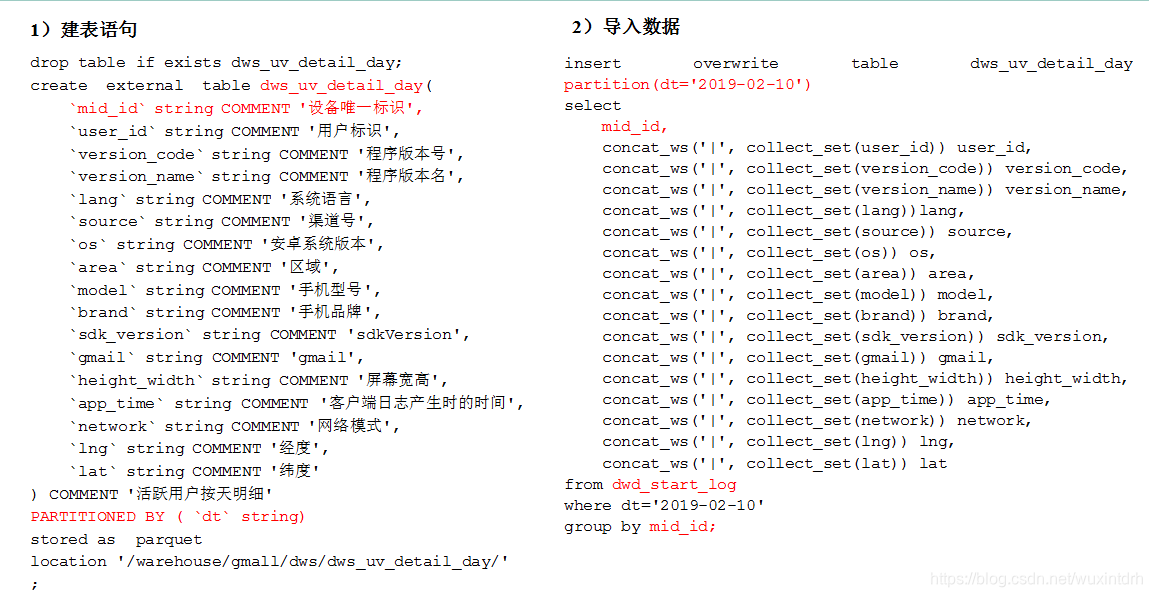
# 关注我的公众号【宝哥大数据】,更多干货等着你 ![在这里插入图片描述](https://img-blog.csdnimg.cn/2021062208300594.png) ## 1.1、数仓分层架构 ![在这里插入图片描述](https://img-blog.csdnimg.cn/2021062105583461.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) **分层优点:复杂问题简单化、清晰数据结构(方便管理)、增加数据的复用性、隔离原始数据(解耦)** 层级 | 功能 ---|--- ods | 原始数据层 存放原始数据,保持原貌不做处理 dwd | 明细数据层 对ods层数据清洗(去除空值,脏数据,超过极限范围的数据) dws | 服务数据层 轻度聚合 ads | 应用数据层 具体需求 数仓中各层建的表都是外部表 ## 1.2、埋点行为数据基本格式(基本字段) 公共字段:基本所有安卓手机都包含的字段 业务字段:埋点上报的字段,有具体的业务类型 下面就是一个示例,表示业务字段的上传。 行为数据启动日志/事件日志表关键字段: ```json { "ap":"xxxxx",//项目数据来源 app pc "cm": { //公共字段 "mid": "", // (String) 设备唯一标识 "uid": "", // (String) 用户标识 "vc": "1", // (String) versionCode,程序版本号 "vn": "1.0", // (String) versionName,程序版本名 "l": "zh", // (String) 系统语言 "sr": "", // (String) 渠道号,应用从哪个渠道来的。 "os": "7.1.1", // (String) Android系统版本 "ar": "CN", // (String) 区域 "md": "BBB100-1", // (String) 手机型号 "ba": "blackberry", // (String) 手机品牌 "sv": "V2.2.1", // (String) sdkVersion "g": "", // (String) gmail "hw": "1620x1080", // (String) heightXwidth,屏幕宽高 "t": "1506047606608", // (String) 客户端日志产生时的时间 "nw": "WIFI", // (String) 网络模式 "ln": 0, // (double) lng经度 "la": 0 // (double) lat 纬度 }, "et": [ //事件 { "ett": "1506047605364", //客户端事件产生时间 "en": "display", //事件名称 启动和事件日志是根据事件名称的不同 "kv": { //事件结果,以key-value形式自行定义 "goodsid": "236", "action": "1", "extend1": "1", "place": "2", "category": "75" } } ] } ``` 根据事件标签的不同可以分成不同的日志表 ## 1.3、各个层的表介绍 ### 1.3.1、ods层 1)ods_start_log 启动日志表 - 只有一个字段 line(保存着json),按照日期dt分区,表的格式:lzo 2)ods_event_log 事件日志表(格式同启动日志表) - 只有一个字段 line ,按照日期dt 分区,表的格式:lzo ### 1.3.2、dwd层 1)dwd_start_log 启动表 - 关键字段:mid_id,user_id,dt(分区字段,按照日期分区) (其实这是启动表和事件表的公共字段) - 从ods_start_log中的line用`get_json_object(line,'$.mid') mid_id`的方式获取字段 #### 1.3.2.1、自定义UDF/UDTF(项目中的应用) - 自定义UDF函数(解析公共字段,一进一出) - 自定义UDTF函数(解析具体事件字段,一进多出) - 自定义UDF:继承UDF,重写evaluate方法 - 自定义UDTF:继承自GenericUDTF,重写3个方法:initialize(自定义输出的列名和类型),process(将结果返回forward(result)),close - 为什么要自定义UDF/UDTF,因为自定义函数,可以自己埋点Log打印日志,出错或者数据异常,方便调试。 #### 1.3.2.2、事件日志基础明细表 dwd_base_event_log 事件日志基础明细表 - 1)关键字段: - 公共字段:mid_id,user_id,dt(分区字段)以及event_name、event_json、server_time - 2)从 ods_event_log的line 中用 UDF 获取 公共字段 和 server_time,用UDTF 获取 event_name , event_json。 #### 1.3.2.3、商品点击表 dwd_display_log 商品点击表 - 关键字段:公共字段 + 特有字段 - 从dwd_base_event_log中直接获取公共字段和server_time,从 dwd_base_event_log的 event_json中获取特有字段,`where event_name = "display"` - `get_json_object(event_json,'$.kv.action') action` #### 1.3.2.4、其他的具体事件明细表 类似 表明|表注释 --|-- dwd_newsdetail_log | 商品详情页表 dwd_loading_log |商品列表页表 dwd_ad_log| 广告表 dwd_notification_log |消息通知表 dwd_active_foreground_log |用户前台活跃表 dwd_active_background_log |用户后台活跃表 dwd_comment_log |评论表 dwd_favorites_log| 收藏表 dwd_praise_log |点赞表 dwd_error_log |错误日志表 从一张事件基础明细表dwd_base_event_log一共可以获得11张具体事件明细表 # 二、需求解析 ## 2.1、用户活跃主题 ### 2.1.1、DWS层日活明细表 每日活跃设备分析 ![每日活跃设备分析](https://img-blog.csdnimg.cn/20210621062330155.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.1.2、DWS层周活明细表 每周活跃设备分析 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621062730526.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.1.3、DWS层月活明细表 每月活跃设备分析 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621062811618.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.1.4、ADS层日周月活跃设备数表 活跃设备分析 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621062950502.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.2、用户新增主题 ### 2.2.1、DWS层日新增明细表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621063135426.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621063334946.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.2.2、ADS层每日新增设备数表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621063456915.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.3、用户留存主题 ### 2.3.1、用户留存介绍 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621063556386.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.3.2、用户留存率分析 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621063733813.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.3.3、DWS层日留存明细表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621065046609.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.3.4、ADS层留存用户数表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621064917726.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 2.3.5、ADS层留存用户率表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210621064854479.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.4、沉默用户 ![ 指的是](https://img-blog.csdnimg.cn/20210622054004280.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.5、本周回流用户数 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210622054518176.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.6、流失用户数 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210622055430202.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.7、最近连续3周活跃用户数 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210622055638418.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.8、最近七天内连续三天活跃用户数 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210622055801435.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 2.9、需求逻辑 ### 2.9.1 如何分析用户活跃? 在启动日志中统计不同设备id出现次数。 ### 2.9.2 如何分析用户新增? 用活跃用户表 left join 用户新增表,用户新增表中mid为空的即为用户新增。 ### 2.9.3 如何分析用户1天留存? 留存用户=前一天新增 join 今天活跃 用户留存率=留存用户/前一天新增 ### 2.9.4 如何分析沉默用户? (登录时间为7天前,且只出现过一次) 按照设备id对日活表分组,登录次数为1,且是在一周前登录。 ### 2.9.5 如何分析本周回流用户? 本周活跃left join本周新增 left join上周活跃,且本周新增id和上周活跃id都为null ### 2.9.6 如何分析流失用户? (登录时间为7天前) 按照设备id对日活表分组,且七天内没有登录过。 ### 2.9.7 如何分析最近连续3周活跃用户数? 按照设备id对周活进行分组,统计次数大于3次。 ### 2.9.8 如何分析最近七天内连续三天活跃用户数? - 1)查询出最近7天的活跃用户,并对用户活跃日期进行排名 - 2)计算用户活跃日期及排名之间的差值 - 3)对同用户及差值分组,统计差值个数 - 4)将差值相同个数大于等于3的数据取出,然后去重(去的是什么重???),即为连续3天及以上活跃的用户
优秀的个人博客,低调大师

面试系列七 之 业务交互数据分析

## 6.1 电商常识 `SKU`:一台银色、128G内存的、支持联通网络的iPhoneX `SPU`:iPhoneX `Tm_id`:品牌Id苹果,包括IPHONE,耳机,mac等 ## 6.2 电商业务流程 ![在这里插入图片描述](https://img-blog.csdnimg.cn/2021062616304691.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 6.3 业务表关键字段 ### 6.3.1 订单表(order_info) 标签 |含义 ---|-- id |订单编号 total_amount |订单金额 order_status |订单状态 user_id |用户id payment_way| 支付方式 out_trade_no |支付流水号 create_time |创建时间 operate_time |操作时间 ### 6.3.2 订单详情表(order_detail) ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626163233947.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 6.3.3 商品表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626163308927.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 6.3.4 用户表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626163342477.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 6.3.5 商品一级分类表 标签| 含义 --|-- id| id name |名称 ### 6.3.6 商品二级分类表 标签 |含义 --|-- id |id name |名称 category1_id |一级品类id ### 6.3.7 商品三级分类表 标签| 含义 --|-- id| id name |名称 Category2_id | 二级品类id ### 6.3.8 支付流水表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626163759536.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) **订单表跟订单详情表有什么区别?** - 订单表的订单状态会变化,订单详情表不会,因为没有**订单状态**。 - **订单表**记录user_id,订单id订单编号,订单的总金额order_status,支付方式,订单状态等。 - **订单详情表**记录user_id,商品sku_id ,具体的商品信息(商品名称sku_name,价格order_price,数量sku_num) ## 6.4 MySql中表的分类 **实体表,维度表,事务型事实表,周期性事实表** 其实最终可以把**事务型事实表**,**周期性事实表**统称**实体表**,实体表,维度表统称维度表 订单表(order_info)(周期型事实表) 订单详情表(order_detail)(事务型事实表) 商品表(实体表) 用户表(实体表) 商品一级分类表(维度表) 商品二级分类表(维度表) 商品三级分类表(维度表) 支付流水表(事务型实体表) ## 6.5 同步策略 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626164305405.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 实体表,维度表统称维度表,每日全量或者每月(更长时间)全量 事务型事实表:每日增量 周期性事实表:拉链表 ## 6.6 关系型数据库范式理论 `1NF`:**属性不可再分割**(例如不能存在5台电脑的属性,坏处:表都没法用) `2NF`:**不能存在部分函数依赖**(例如主键(学号+课名)-->成绩,姓名,但学号 -->姓名,所以姓名部分依赖于主键(学号+课名),所以要去除,坏处:数据冗余) `3NF`:**不能存在传递函数依赖**(学号 --> 宿舍种类 --> 价钱,坏处:数据冗余和增删异常) **Mysql关系模型**:关系模型主要应用与**OLTP**系统中,为了保证数据的一致性以及避免冗余,所以大部分业务系统的表都是遵循第三范式的。 **Hive 维度模型**:维度模型主要应用于**OLAP**系统中,因为关系模型虽然冗余少, 但是在大规模数据,跨表分析统计查询过程中,会造成多表关联,这会大大降低执行效率。 所以HIVE把相关各种表整理成两种:**事实表和维度表**两种。所有维度表围绕着事实表进行解释。 ## 6.7 数据模型 雪花模型、星型模型和星座模型 (在维度建模的基础上又分为三种模型:星型模型、雪花模型、星座模型。) 星型模型(一级维度表),雪花(多级维度),星座模型(星型模型+多个事实表) ## 6.8 业务数据数仓搭建 sqoop 导数据的原理是mapreduce, import 把数据从关系型数据库 导到 数据仓库,自定义InputFormat, export 把数据从数据仓库 导到 关系型数据库,自定义OutputFormat, 用sqoop从mysql中将八张表的数据导入数仓的ods原始数据层 全量无条件,增量按照创建时间,增量+变化按照创建时间或操作时间。 origin_data sku_info商品表(每日导全量) user_info用户表(每日导全量) base_category1商品一级分类表(每日导全量) base_category2商品二级分类表(每日导全量) base_category3商品三级分类表(每日导全量) order_detail订单详情表(每日导增量) payment_info支付流水表(每日导增量) order_info订单表(每日导增量+变化) ### 6.8.1 ods层 (八张表,表名,字段跟mysql完全相同) 从origin\_data把数据导入到ods层,表名在原表名前加`ods_` ### 6.8.2 dwd层 对ODS层数据进行判空过滤。对商品分类表进行**维度退化**(降维)。其他数据跟ods层一模一样 订单表 `dwd_order_info` 订单详情表 `dwd_order_detail` 用户表 `dwd_user_info` 支付流水表 `dwd_payment_info` 商品表 `dwd_sku_info` 其他表字段不变,唯独商品表,通过关联3张分类表,增加了 ``` category2_id` string COMMENT '2id', `category1_id` string COMMENT '3id', `category3_name` string COMMENT '3', `category2_name` string COMMENT '2', `category1_name` string COMMENT '1', ``` 小结: 1)**维度退化要付出什么代价**?或者说会造成什么样的需求处理不了? - 如果被退化的维度,还有其他业务表使用,退化后处理起来就麻烦些。 - 还有如果要**删除数据,对应的维度可能也会被永久删除。** 2)想想在实际业务中还有**那些维度表可以退化** - 城市的三级分类(省、市、县)等 ### 6.8.3 dws层 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626165905760.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 从订单表 `dwd_order_info` 中获取 下单次数 和 下单总金额 从支付流水表 `dwd_payment_info` 中获取 支付次数 和 支付总金额 从事件日志评论表 `dwd_comment_log` 中获取评论次数 最终按照`user_id`聚合,获得明细,跟之前的`mid_id`聚合不同 ## 6.9、需求 ### 6.9.1 需求一:GMV成交总额 从用户行为宽表中`dws_user_action`,根据统计日期分组,聚合,直接sum就可以了。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626171209574.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 6.9.2、 需求二:转化率 #### 6.9.2.1 新增用户占日活跃用户比率表 从日活跃数表 `ads_uv_count` 和 日新增设备数表 `ads_new_mid_count` 中取即可。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626171652151.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) #### 6.9.2.2 用户行为转化率表 从用户行为宽表`dws_user_action`中取,**下单人数(只要下单次数>0),支付人数(只要支付次数>0)** 从日活跃数表 `ads_uv_count` 中取活跃人数,然后对应的相除就可以了。 ![在这里插入图片描述](https://img-blog.csdnimg.cn/2021062617191173.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ### 6.9.3、 需求三:品牌复购率 需求:以月为单位统计,购买2次以上商品的用户 #### 6.9.3.1 用户购买商品明细表(宽表) ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626172216239.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) #### 6.9.3.2 品牌复购率表 从用户购买商品明细宽表`dws_sale_detail_daycount`中,根据品牌`id--sku_tm_id`聚合,计算每个品牌购买的总次数,购买人数a=购买次数>=1,两次及以上购买人数b=购买次数>=2,三次及以上购买人数c=购买次数>=3, 单次复购率=b/a,多次复购率=c/a ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626172304727.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) ## 6.10、 项目中有多少张宽表 宽表要3-5张,用户行为宽表,用户购买商品明细行为宽表,商品宽表,购物车宽表,物流宽表、登录注册、售后等。 **1)为什么要建宽表** 需求目标,把每个用户单日的行为聚合起来组成一张多列宽表,以便之后关联用户维度信息后进行,不同角度的统计分析。 ## 6.11、 拉链表 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626172911727.png?x-oss-process=image/watermark,type_ZmFuZ3poZW5naGVpdGk,shadow_10,text_aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3d1eGludGRyaA==,size_16,color_FFFFFF,t_70) 订单表拉链表 `dwd_order_info_his` ``` `id` string COMMENT '订单编号', `total_amount` decimal(10,2) COMMENT '订单金额', `order_status` string COMMENT '订单状态', `user_id` string COMMENT '用户id' , `payment_way` string COMMENT '支付方式', `out_trade_no` string COMMENT '支付流水号', `create_time` string COMMENT '创建时间', `operate_time` string COMMENT '操作时间' , `start_date` string COMMENT '有效开始日期', `end_date` string COMMENT '有效结束日期' ``` 1)创建订单表拉链表,字段跟拉链表一样,只增加了有效开始日期和有效结束日期 初始日期,从订单变化表`ods_order_info`导入数据,且让有效开始时间=当前日期,有效结束日期=`9999-99-99` (从mysql导入数仓的时候就只导了新增的和变化的数据`ods_order_info`,`dwd_order_info`跟`ods_order_info`基本一样,只多了一个id的判空处理) 2)建一张拉链临时表`dwd_order_info_his_tmp`,字段跟拉链表完全一致 3)新的拉链表中应该有这几部分数据, - (1)增加订单变化表`dwd_order_info`的全部数据 - (2)更新旧的拉链表左关联订单变化表`dwd_order_info`,关联字段:订单id, where 过滤出`end_date`只等于`9999-99-99`的数据,如果旧的拉链表中的`end_date`不等于`9999-99-99`,说明已经是终态了,不需要再更新 - 如果`dwd_order_info.id is null` , 没关联上,说明数据状态没变,让`end_date`还等于旧的`end_date` - 如果`dwd_order_info.id is not null `, 关联上了,说明数据状态变了,让`end_date`等于当前日期`-1` - 把查询结果插入到拉链临时表中 4)把拉链临时表覆盖到旧的拉链表中 # 关注我的公众号【宝哥大数据】, 更多干货 ![在这里插入图片描述](https://img-blog.csdnimg.cn/20210626173520752.png)

优秀的个人博客,低调大师

面试被问MySQL 主从复制,怎么破?

一、前言 随着应用业务数据不断的增大,应用的响应速度不断下降,在检测过程中我们不难发现大多数的请求都是查询操作。 此时,我们可以将数据库扩展成主从复制模式,将读操作和写操作分离开来,多台数据库分摊请求,从而减少单库的访问压力,进而应用得到优化。整理了一份328页MySQLPDF文档 本次测试使用两个虚拟机:ip:192.168.2.21(主) ip:192.168.2.22(从) 二、主从复制原理 同步操作通过 3 个线程实现,其基本步骤如下: 主服务器将数据的更新记录到二进制日志中(记录被称作二进制日志事件)-- 主库线程; 从库将主库的二进制日志复制到本地的中继日志(relay log)-- 从库 I/O 线程; 从库读取中继日志中的事件,将其重放到数据中 -- 从库 SQL 线程。 三、配置主库 # 3.1 创建用户 为了安全起见,准备创建一个新用户用于从库连接主库。 # 创建用户 create user 'repl'@'%' identified by 'repl'; # 授权,只授予复制和客户端访问权限 grant replication slave,replication client on *.* to 'repl'@'%' identified by 'repl'; # 3.2 修改配置文件 1)vim /etc/my.cnf 在[mysqld]下添加: log-bin = mysql-bin log-bin-index = mysql-bin.index binlog_format = mixed server-id = 21 sync-binlog = 1 character-set-server = utf8 2)保存文件并重启主库: service mysqld restart 配置说明: log-bin:设置二进制日志文件的基本名; log-bin-index:设置二进制日志索引文件名; binlog_format:控制二进制日志格式,进而控制了复制类型,三个可选值 -STATEMENT:语句复制 -ROW:行复制 -MIXED:混和复制,默认选项 server-id:服务器设置唯一ID,默认为1,推荐取IP最后部分; sync-binlog:默认为0,为保证不会丢失数据,需设置为1,用于强制每次提交事务时,同步二进制日志到磁盘上。 # 3.3 备份主数据库数据 若主从数据库都是刚刚装好且数据都是一致的,直接执行 show master status 查看日志坐标。 若主库可以停机,则直接拷贝所有数据库文件。 若主库是在线生产库,可采用 mysqldump 备份数据,因为它对所有存储引擎均可使用。 1)为了获取一个一致性的快照,需对所有表设置读锁: flush tables with read lock; 2)获取二进制日志的坐标: show master status; 返回结果: +------------------+----------+--------------+------------------+-------------------+ | File | Position | Binlog_Do_DB | Binlog_Ignore_DB | Executed_Gtid_Set | +------------------+----------+--------------+------------------+-------------------+ | mysql-bin.000001 | 120 | | | | +------------------+----------+--------------+------------------+-------------------+ 1 row in set (0.00 sec) 3)备份数据: # 针对事务性引擎 mysqldump -uroot -ptiger --all-database -e --single-transaction --flush-logs --max_allowed_packet=1048576 --net_buffer_length=16384 > /data/all_db.sql # 针对 MyISAM 引擎,或多引擎混合的数据库 mysqldump -uroot --all-database -e -l --flush-logs --max_allowed_packet=1048576 --net_buffer_length=16384 > /data/all_db.sql 1 row in set (0.00 sec) 4)恢复主库的写操作: unlock tables; 四、配置从库 # 4.1 修改配置文件 1)vim /etc/my.cnf 在[mysqld]下添加: log-bin = mysql-bin binlog_format = mixed log-slave-updates = 0 server-id = 22 relay-log = mysql-relay-bin relay-log-index = mysql-relay-bin.index read-only = 1 slave_net_timeout = 10 2)保存文件并重启从库: service mysqld restart 配置说明: log-slave-updates:控制 slave 上的更新是否写入二进制日志,默认为0;若 slave 只作为从服务器,则不必启用;若 slave 作为其他服务器的 master,则需启用,启用时需和 log-bin、binlog-format 一起使用,这样 slave 从主库读取日志并重做,然后记录到自己的二进制日志中; relay-log:设置中继日志文件基本名; relay-log-index:设置中继日志索引文件名; read-only:设置 slave 为只读,但具有super权限的用户仍然可写; slave_net_timeout:设置网络超时时间,即多长时间测试一下主从是否连接,默认为3600秒,即1小时,这个值在生产环境过大,我们将其修改为10秒,即若主从中断10秒,则触发重新连接动作。 # 4.2 导入备份数据 如果 3.3 步骤中没进行备份,忽略此步骤。 mysql -uroot -p < /data/all_db.sql # 4.3 统一二进制日志的坐标 根据 3.3 步骤获取的坐标,统一到从库中: change master to master_host='192.168.2.21', master_user='repl', master_password='repl', master_port=3306, master_log_file='mysql-bin.000001', master_log_pos=120; 注意:此处使用的是新创建的账户。 # 4.4 启动主从复制 1)启动从库 slave 线程: start slave; 2)查看从服务器复制功能状态: show slave status\G; 返回结果: *************************** 1. row *************************** Slave_IO_State: Waiting for master to send event Master_Host: 192.168.2.21 Master_User: repl Master_Port: 3306 Connect_Retry: 60 Master_Log_File: mysql-bin.000001 Read_Master_Log_Pos: 120 Relay_Log_File: mysql-relay-bin.000002 Relay_Log_Pos: 283 Relay_Master_Log_File: mysql-bin.000001 Slave_IO_Running: Yes Slave_SQL_Running: Yes Replicate_Do_DB: Replicate_Ignore_DB: Replicate_Do_Table: Replicate_Ignore_Table: Replicate_Wild_Do_Table: Replicate_Wild_Ignore_Table: Last_Errno: 0 Last_Error: Skip_Counter: 0 Exec_Master_Log_Pos: 120 此处只张贴部分返回结果。 结果说明: Slave_IO_Running:此进程负责 slave 从 master 上读取 binlog 日志,并写入 slave 上的中继日志。 Slave_SQL_Running:此进程负责读取并执行中继日志中的 binlog 日志。 这两个进程的状态需全部为 YES,只要有一个为 NO,则复制就会停止。 当 Relay_Master_Log_File = Master_Log_File 且 Read_Master_Log_Pos = Exec_Master_Log_Pos 时,则表明 slave 和 master 处于完全同步的状态。 五、验证 使用一个简单的例子: 在主库创建名为 mysql_test 的数据库,如果同步成功,那么在从库中也能查询出名为 mysql_test 数据库。 六、参考资料 MySQL 官网整理了一份328页MySQLPDF文档 dev.mysql.com/doc/refman/…

优秀的个人博客,低调大师

面试官: ShardingSphere 学一下吧

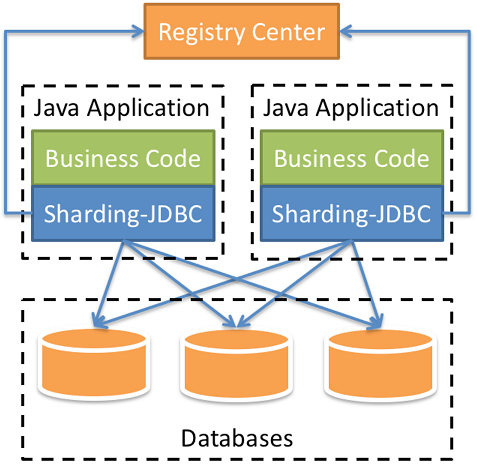
文章目录 [toc] 学习之前先了解下分库分表概念:https://spiritmark.blog.csdn.net/article/details/109524713 一、ShardingSphere简介 在数据库设计时候考虑垂直分库和垂直分表。随着数据库数据量增加,不要马上考虑做水平切分,首先考虑缓存处理,读写分离,使 用索引等等方式,如果这些方式不能根本解决问题了,再考虑做水平分库和水平分表。 分库分表导致的问题: 跨节点连接查询问题(分页、排序) 多数据源管理问题 Apache ShardingSphere是一套开源的分布式数据库中间件解决方案组成的生态圈,它由 JDBC、 Proxy和 Sidecar(规划中)这 3 款相互独立,却又能够混合部署配合使用的产品组成。 它们均提供标准化的数据分片、分布式事务和数据库治理功能,可适用于如 Java同构、异构语言、云原生等各种多样化的应用场景。 Apache ShardingSphere定位为关系型数据库中间件,旨在充分合理地在分布式的场 景下利用关系型数据库的计算和存储能力,而并非实现一个全新的关系型数据库。 它通过关注不变,进而抓住事物本质。关系型数据库当今依然占有巨大市场,是各个公司核心业务的基石,未来也难于撼动,我们目前阶段更加关注在原有基础上的增量,而非颠覆。 二、Sharding-JDBC Sharding-JDBC 是轻量级的 java 框架,是增强版的 JDBC 驱动,简化对分库分表之后数据相关操作。 新建项目并添加依赖: <parent> <groupId>org.springframework.bootgroupId> <artifactId>spring-boot-parentartifactId> <version>2.2.1.RELEASEversion> parent> <dependencies> <dependency> <groupId>org.springframework.bootgroupId> <artifactId>spring-boot-starterartifactId> dependency> <dependency> <groupId>org.springframework.bootgroupId> <artifactId>spring-boot-starter-testartifactId> dependency> <dependency> <groupId>com.alibabagroupId> <artifactId>druid-spring-boot-starterartifactId> <version>1.1.20version> dependency> <dependency> <groupId>mysqlgroupId> <artifactId>mysql-connector-javaartifactId> dependency> <dependency> <groupId>org.apache.shardingspheregroupId> <artifactId>sharding-jdbc-spring-boot-starterartifactId> <version>4.0.0-RC1version> dependency> <dependency> <groupId>com.baomidougroupId> <artifactId>mybatis-plus-boot-starterartifactId> <version>3.0.5version> dependency> <dependency> <groupId>org.projectlombokgroupId> <artifactId>lombokartifactId> dependency> dependencies> 2.1 Sharding-JDBC实现水平分表 ① 按照水平分表的方式,创建数据库和数据库表 水平分表规则:如果添加 cid是偶数把数据添加 course_1,如果是奇数添加到 course_2 CREATE TABLE `course_1` ( `cid` bigint(16) NOT NULL, `cname` varchar(255) , `userId` bigint(16), `cstatus` varchar(16) , PRIMARY KEY (`cid`) ) ② 编写实体和 Mapper 类 @Data public class Course { private Long cid; private String cname; private Long userId; private String cstatus; } @Repository public interface CourseMapper extends BaseMapper<Course> { } ③ 详细配置文件 spring: main: allow-bean-definition-overriding: true shardingsphere: datasource: names: m1 m1: type: com.alibaba.druid.pool.DruidDataSource driver-class-name: com.mysql.cj.jdbc.Driver url: jdbc:mysql://192.168.182.200:3306/course_db?serverTimezone=GMT%2B8 username: root password: 1234 sharding: tables: course: actual-data-nodes: m1.course_$->{1..2} key-generator: column: cid type: SNOWFLAKE table-strategy: inline: shardingcolumn: cid algorithm-expression: course_$->{cid%2+1} props: sql: show: true mybatis-plus: configuration: map-underscore-to-camel-case: false ④ 测试 @RunWith(SpringRunner.class) @SpringBootTest public class ShardingSphereTestApplication { @Autowired CourseMapper courseMapper; @Test public void addCourse() { for (int i = 1; i 10; i++) { Course course = new Course(); course.setCname("java" + i); course.setUserId(100L); course.setCstatus("Normal" + i); courseMapper.insert(course); } } @Test public void queryCourse() { QueryWrapper<Course> wrapper = new QueryWrapper<>(); wrapper.eq("cid",493001315358605313L); Course course = courseMapper.selectOne(wrapper); System.out.println(course); } } 2.2 Sharding-JDBC实现水平分库 ① 需求分析 ② 创建数据库和表 ③ 详细配置文件 spring: main: allow-bean-definition-overriding: true shardingsphere: datasource: names: m1,m2 m1: type: com.alibaba.druid.pool.DruidDataSource driver-class-name: com.mysql.cj.jdbc.Driver url: jdbc:mysql://192.168.182.200:3306/course_db_2?serverTimezone=GMT%2B8 username: root password: 1234 m2: type: com.alibaba.druid.pool.DruidDataSource driver-class-name: com.mysql.cj.jdbc.Driver url: jdbc:mysql://192.168.182.200:3306/course_db_3?serverTimezone=GMT%2B8 username: root password: 1234 sharding: tables: course: actual-data-nodes: m$->{1..2}.course_$->{1..2} key-generator: column: cid type: SNOWFLAKE database-strategy: inline: sharding-column: userId algorithm-expression: m$->{userId%2+1} table-strategy: inline: sharding-column: cid algorithm-expression: course_$->{cid%2+1} props: sql: show: true mybatis-plus: configuration: map-underscore-to-camel-case: false ④ 测试代码 @RunWith(SpringRunner.class) @SpringBootTest public class ShardingSphereTestApplication { @Autowired CourseMapper courseMapper; @Test public void addCourse() { for (int i = 1; i 20; i++) { Course course = new Course(); course.setCname("java" + i); int random = (int) (Math.random() * 10); course.setUserId(100L + random); course.setCstatus("Normal" + i); courseMapper.insert(course); } } @Test public void queryCourse() { QueryWrapper<Course> wrapper = new QueryWrapper<>(); wrapper.eq("cid", 493001315358605313L); Course course = courseMapper.selectOne(wrapper); System.out.println(course); } } 查询实际对应的 SQL: 2.3 Sharding-JDBC操作公共表 公共表 : 存储固定数据的表,表数据很少发生变化,查询时候经常进行关联 在每个数据库中创建出相同结构公共表 ① 思路分析 ② 在对应数据库创建公共表 t_udict&#xFF0C;&#x5E76;&#x521B;&#x5EFA;&#x5BF9;&#x5E94;&#x5B9E;&#x4F53;&#x548C; Mapper`` CREATE TABLE `t_udict` ( `dict_id` bigint(16) NOT NULL, `ustatus` varchar(16) , `uvalue` varchar(255), PRIMARY KEY (`dict_id`) ) ③ 详细配置文件 spring: main: allow-bean-definition-overriding: true shardingsphere: datasource: names: m1,m2 m1: type: com.alibaba.druid.pool.DruidDataSource driver-class-name: com.mysql.cj.jdbc.Driver url: jdbc:mysql://192.168.182.200:3306/course_db_2?serverTimezone=GMT%2B8 username: root password: 1234 m2: type: com.alibaba.druid.pool.DruidDataSource driver-class-name: com.mysql.cj.jdbc.Driver url: jdbc:mysql://192.168.182.200:3306/course_db_3?serverTimezone=GMT%2B8 username: root password: 1234 sharding: tables: course: actual-data-nodes: m$->{1..2}.course_$->{1..2} key-generator: column: cid type: SNOWFLAKE database-strategy: inline: sharding-column: userId algorithm-expression: m$->{userId%2+1} table-strategy: inline: sharding-column: cid algorithm-expression: course_$->{cid%2+1} t_udict: key-generator: column: dict_id type: SNOWFLAKE broadcast-tables: t_udict props: sql: show: true mybatis-plus: configuration: map-underscore-to-camel-case: false ④ 进行测试 经测试:数据插入时会在每个库的每张表中插入,删除时也会删除所有数据。 @RunWith(SpringRunner.class) @SpringBootTest public class ShardingSphereTestApplication { @Autowired UdictMapper udictMapper; @Test public void addUdict() { Udict udict = new Udict(); udict.setUstatus("a"); udict.setUvalue("已启用"); udictMapper.insert(udict); } @Test public void deleteUdict() { QueryWrapper<Udict> wrapper = new QueryWrapper<>(); wrapper.eq("dict_id", 493080009351626753L); udictMapper.delete(wrapper); } } 2.4 Sharding-JDBC实现读写分离 为了确保数据库产品的稳定性,很多数据库拥有双机热备功能。也就是,第一台数据库服务器是对外提供增删改业务的生产服务器;第二台数据库服务器主要进行读的操作。 Sharding-JDBC通过 sql语句语义分析,实现读写分离过程,不会做数据同步,数据同步通常数据库集群间会自动同步。 详细配置文件: spring: main: allow-bean-definition-overriding: true shardingsphere: datasource: names: m0,s0 m0: type: com.alibaba.druid.pool.DruidDataSource driver-class-name: com.mysql.cj.jdbc.Driver url: jdbc:mysql://192.168.182.200:3306/course_db?serverTimezone=GMT%2B8 username: root password: 1234 s0: type: com.alibaba.druid.pool.DruidDataSource driver-class-name: com.mysql.cj.jdbc.Driver url: jdbc:mysql://192.168.182.200:3307/course_db?serverTimezone=GMT%2B8 username: root password: 1234 masterslave: master-data-source-name: m0 slave-data-source-names: s0 props: sql: show: true mybatis-plus: configuration: map-underscore-to-camel-case: false 经过测试:增删改操作都是会通过 master数据库,同时 master数据库会同步数据给 slave数据库;查操作都是通过 slave数据库. 三、Sharding-Proxy Sharding-Proxy定位为 透明化的数据库代理端,提供封装了数据库二进制协议的服务端版本,用于完成对异构语言的支持, 目前仅 MySQL和 PostgreSQL版本。 Sharding-Proxy是独立应用,需要安装服务,进行分库分表或者读写分离配置,启动使用。 <br> Sharding-proxy的使用参考:Sharding-Proxy的基本使用。 微信搜一搜:全栈小刘

优秀的个人博客,低调大师

面试命中率90%的点 —— MySQL锁

一、对MySQL的锁的了解 当数据库有并发事务的时候,可能会产生数据的不一致,这时候需要一些机制来保证访问的次序,锁机制就是这样的一个机制。 就像酒店的房间,如果大家随意进出,就会出现多人抢夺同一个房间的情况,而在房间上装上锁,申请到钥匙的人才可以入住并且将房间锁起来,其他人只有等他使用完毕才可以再次使用。 二、隔离级别与锁的关系 在Read Uncommitted级别下,读取数据不需要加共享锁,这样就不会跟被修改的数据上的排他锁冲突 在Read Committed级别下,读操作需要加共享锁,但是在语句执行完以后释放共享锁。 在Repeatable Read级别下,读操作需要加共享锁,但是在事务提交之前并不释放共享锁,也就是必须等待事务执行完毕以后才释放共享锁。 SERIALIZABLE 是限制性最强的隔离级别,因为该级别锁定整个范围的键,并一直持有锁,直到事务完成。 三、按照锁的粒度分数据库锁有哪些?锁机制与InnoDB锁算法 在关系型数据库中,可以按照锁的粒度把数据库锁分为行级锁(INNODB引擎)、表级锁(MYISAM引擎)和页级锁(BDB引擎 )。 MyISAM和InnoDB存储引擎使用的锁: MyISAM采用表级锁(table-level locking)。 InnoDB支持行级锁(row-level locking)和表级锁,默认为行级锁。 行级锁,表级锁和页级锁对比 行级锁:MySQL中锁定粒度最细的一种锁,表示只针对当前操作的行进行加锁。行级锁能大大减少数据库操作的冲突。其加锁粒度最小,但加锁的开销也最大。行级锁分为共享锁和排他锁。 特点:开销大,加锁慢;会出现死锁;锁定粒度最小,发生锁冲突的概率最低,并发度也最高。 表级锁:MySQL中锁定粒度最大的一种锁,表示对当前操作的整张表加锁,它实现简单,资源消耗较少,被大部分MySQL引擎支持。最常使用的MyISAM与InnoDB都支持表级锁定。表级锁定分为表共享读锁(共享锁)与表独占写锁(排他锁)。 特点:开销小,加锁快;不会出现死锁;锁定粒度大,发出锁冲突的概率最高,并发度最低。 页级锁:是MySQL中锁定粒度介于行级锁和表级锁中间的一种锁。表级锁速度快,但冲突多,行级冲突少,但速度慢。所以取了折衷的页级,一次锁定相邻的一组记录。 特点:开销和加锁时间界于表锁和行锁之间;会出现死锁;锁定粒度界于表锁和行锁之间,并发度一般 四、从锁的类别上分MySQL都有哪些锁呢?像上面那样子进行锁定岂不是有点阻碍并发效率了 从锁的类别上来讲,有共享锁和排他锁。 共享锁: 又叫做读锁。当用户要进行数据的读取时,对数据加上共享锁。共享锁可以同时加上多个。 排他锁: 又叫做写锁,当用户要进行数据的写入时,对数据加上排他锁。排他锁只可以加一个,他和其他的排他锁,共享锁都相斥。 用上面的例子来说就是用户的行为有两种,一种是来看房,多个用户一起看房是可以接受的。一种是真正的入住一晚,在这期间,无论是想入住的还是想看房的都不可以。 锁的粒度取决于具体的存储引擎,InnoDB实现了行级锁,页级锁,表级锁。 他们的加锁开销从大到小,并发能力也是从大到小。 五、MySQL中InnoDB引擎的行锁是怎么实现的? InnoDB是基于索引来完成行锁 例: select * from tab_with_index where id = 1 for update; for update 可以根据条件来完成行锁锁定,并且 ID 是有索引键的列,如果 ID不是索引键那么InnoDB将完成表锁,并发将无从谈起 六、InnoDB存储引擎的锁的算法有三种 1.Record lock:单个行记录上的锁 2.Gap lock:间隙锁,锁定一个范围,不包括记录本身 3.Next-key lock:record+gap 锁定一个范围,包含记录本身 七、相关知识点: Innodb对于行的查询使用next-key lock Next-locking keying为了解决Phantom Problem幻读问题 当查询的索引含有唯一属性时,将next-key lock降级为record key Gap锁设计的目的是为了阻止多个事务将记录插入到同一范围内,而这会导致幻读问题的产生 有两种方式显式关闭gap锁:(除了外键约束和唯一性检查外,其余情况仅使用record lock) A. 将事务隔离级别设置为RC B. 将参数innodb_locks_unsafe_for_binlog设置为1 八、什么是死锁?怎么解决? 死锁是指两个或多个事务在同一资源上相互占用,并请求锁定对方的资源,从而导致恶性循环的现象。 常见的解决死锁的方法 1、如果不同程序会并发存取多个表,尽量约定以相同的顺序访问表,可以大大降低死锁机会。 2、在同一个事务中,尽可能做到一次锁定所需要的所有资源,减少死锁产生概率; 3、对于非常容易产生死锁的业务部分,可以尝试使用升级锁定颗粒度,通过表级锁定来减少死锁产生的概率; 如果业务处理不好可以用分布式事务锁或者使用乐观锁 九、数据库的乐观锁和悲观锁是什么?怎么实现的? 数据库管理系统(DBMS)中的并发控制的任务是确保在多个事务同时存取数据库中同一数据时不破坏事务的隔离性和统一性以及数据库的统一性。乐观并发控制(乐观锁)和悲观并发控制(悲观锁)是并发控制主要采用的技术手段。 悲观锁:假定会发生并发冲突,屏蔽一切可能违反数据完整性的操作。在查询完数据的时候就把事务锁起来,直到提交事务。 实现方式:使用数据库中的锁机制 乐观锁:假设不会发生并发冲突,只在提交操作时检查是否违反数据完整性。在修改数据的时候把事务锁起来,通过Version的方式来进行锁定。 实现方式:一般会使用版本号机制或CAS算法实现。 两种锁的使用场景 从上面对两种锁的介绍,我们知道两种锁各有优缺点,不可认为一种好于另一种,像乐观锁适用于写比较少的情况下(多读场景),即冲突真的很少发生的时候,这样可以省去了锁的开销,加大了系统的整个吞吐量。 但如果是多写的情况,一般会经常产生冲突,这就会导致上层应用会不断的进行Retry,这样反倒是降低了性能,所以一般多写的场景下用悲观锁就比较合适。 最后 感谢大家看到这里,文章有不足,欢迎大家指出;如果你觉得写得不错,那就给我一个赞吧。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册