首页 文章 精选 留言 我的

精选列表

搜索[接口文档],共10000篇文章
优秀的个人博客,低调大师

Apache Storm 官方文档 —— 容错性

本文通过问答的形式解释了 Storm 的容错性原理。 工作进程(worker)死亡时会发生什么? 工作进程死亡的时候,supervisor 会重新启动这个进程。如果在启动过程中仍然一直失败,并且无法向 Nimbus 发送心跳,Nimbus 就会将这个 worker 重新分配到其他机器上去。 节点故障时会发生什么? 一个节点(集群中的工作节点,非 Nimbus 所在服务器)故障时,该节点上所有的任务(tasks)都会超时,然后 Nimbus 在检测到超时后会将所有的这些任务重新分配到其他机器上去。 Nimbus 或者 Supervisor 的后台进程挂掉时会发生什么 Nimbus 和 Supervisor 的后台进程本身是设计为快速失败(无论何时发生了异常情况之后都会启动自毁操作)和无状态(所有的状态由 ZooKeeper 负责管理)的。正如配置 Storm 集群这篇文章中所述,Nimbus 和 Supervisor 的后台进程实际上是在后台监控工具的监控之下运行的。所以,如果 Nimbus 或者 Supervisor 进程挂掉,他们就会静默地自动重启。 值得一提的是,Nimbus 和 Supervisor 的故障不会影响任何工作进程。这一点与 Hadoop 形成了鲜明对比,在 Hadoop 中 JobTracker 的故障会导致所有正在运行的 job 运行失败(Hadoop 2.x 中引入的 Yarn 架构已经提升了 Hadoop 系统的稳定性,目前的架构并不会如这里所说的那么不堪——译者注)。 Nimbus 是系统的单故障点1吗? 如果你的 Nimbus 节点出现故障无法访问,集群中的 worker 仍然会继续保持运行。另外,此时 Supervisor 也仍然会正常工作,在 worker 挂掉时自动重启挂掉的进程。但是,由于缺少 Nimbus 的协调,worker 就不会在必要的时候重新分配到不同的机器中(看上去好像你丢失了一个 worker)。 所以这个问题的答案是,Nimbus 确实稍微有一点像 SPOF(单故障点,Single Point of Failure)。不过在实际应用中,Nimbus 的故障从来就不是什么问题。未来的开发计划中还会考虑让 Nimbus 具备更好的可用性。 Storm 是如何保障消息的完全处理的? 对于节点故障或者消息丢失的情况,Storm 提供了一套完善的机制保障所有的消息都能够得到正确处理。消息的可靠性保障一文中解释了这方面更多的技术细节。 1单故障点是指在一个系统中的某个在失效或停止运转后会导致整个系统不能工作的部件,具体概念可以参考维基百科。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 本地模式

本地模式是一种在本地进程中模拟 Storm 集群的工作模式,对于开发和测试拓扑很有帮助。在本地模式下运行拓扑与在集群模式下运行拓扑的方式很相似。 创建一个进程内的“集群”只需要使用LocalCluster类即可,例如: import backtype.storm.LocalCluster; LocalCluster cluster = new LocalCluster(); 随后,你就可以使用LocalCluster中的submitTopology方法来提交拓扑了。与StormSubmitter中相应的方法相似,submitTopology接收一个拓扑名称、拓扑配置以及拓扑对象作为输入参数。你也可以以拓扑名称为参数,使用killTopology方法来 kill 掉对应的拓扑。 使用以下语句关闭本地模式集群运行: cluster.shutdown(); 本地模式的常用配置 你可以在这里找到完整的配置项列表。以下是几个比较有用的配置项说明: Config.TOPOLOGY_MAX_TASK_PARALLELISM:该配置项设置了单个组件(bolt/spout)的线程数上限。生产环境下的拓扑往往含有很高的并行度(数百个线程),导致在本地模式下测试拓扑时会有较大的负载。这个配置项可以让你很容易地控制并行度。 Config.TOPOLOGY_DEBUG:此配置项设置为 true 时 Storm 会打印出 spout 或者 bolt 每一次发送消息的日志记录。这个功能对于调试拓扑很有用。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark配置(二)

内存管理 属性名 默认值 含义 spark.memory.fraction 0.75 堆内存中用于执行、混洗和存储(缓存)的比例。这个值越低,则执行中溢出到磁盘越频繁,同时缓存被逐出内存也更频繁。这个配置的目的,是为了留出用户自定义数据结构、内部元数据使用的内存。推荐使用默认值。请参考this description. spark.memory.storageFraction 0.5 不会被逐出内存的总量,表示一个相对于 spark.memory.fraction的比例。这个越高,那么执行混洗等操作用的内存就越少,从而溢出磁盘就越频繁。推荐使用默认值。更详细请参考this description. spark.memory.offHeap.enabled true 如果true,Spark会尝试使用堆外内存。启用 后,spark.memory.offHeap.size必须为正数。 spark.memory.offHeap.size 0 堆外内存分配的大小(绝对值)。这个设置不会影响堆内存的使用,所以你的执行器总内存必须适应JVM的堆内存大小。必须要设为正数。并且前提是 spark.memory.offHeap.enabled=true. spark.memory.useLegacyMode false 是否使用老式的内存管理模式(1.5以及之前)。老模式在堆内存管理上更死板,使用固定划分的区域做不同功能,潜在的会导致过多的数据溢出到磁盘(如果不小心调整性能)。必须启用本参数,以下选项才可用:spark.shuffle.memoryFractionspark.storage.memoryFractionspark.storage.unrollFraction spark.shuffle.memoryFraction 0.2 (废弃)必须先启用spark.memory.useLegacyMode这个才有用。 混洗阶段用于聚合和协同分组的JVM堆内存比例。在任何指定的时间,所有用于混洗的内存总和不会超过这个上限,超出的部分会溢出到磁盘上。如果溢出台频繁,考虑增加spark.storage.memoryFraction的大小。 spark.storage.memoryFraction 0.6 (废弃)必须先启用spark.memory.useLegacyMode这个才有用。 Spark用于缓存数据的对内存比例。这个值不应该比JVM 老生代(old generation)对象所占用的内存大,默认是60%的堆内存,当然你可以增加这个值,同时配置你所用的老生代对象占用内存大小。 spark.storage.unrollFraction 0.2 (废弃)必须先启用spark.memory.useLegacyMode这个才有用。 Spark块展开的内存占用比例。如果没有足够的内存来完整展开新的块,那么老的块将被抛弃。 执行行为 属性名 默认值 含义 spark.broadcast.blockSize 4m TorrentBroadcastFactory每个分片大小。太大会减少广播时候的并发数(更慢了);如果太小,BlockManager可能会给出性能提示。 spark.broadcast.factory org.apache.spark.broadcast. TorrentBroadcastFactory 广播算法的实现。 spark.cleaner.ttl (infinite) Spark记住任意元数据的保留时间(秒)。周期性的清理能保证比这个更老的元数据将被遗忘(删除)。这对于长期运行的Spark作业非常有用(如,一些7*24运行)。注意,RDD持久化到内存中后,过了这么长时间以后,也会被清理掉(这。。。是不是有点坑!)。 spark.executor.cores YARN模式下默认1;如果是独立部署,则是worker节点上所有可用的core。 单个执行器可用的core数。仅针对YARN和独立部署模式。独立部署时,单个worker节点上会运行多个执行器(executor),只要worker上有足够的core。否则,每个应用在单个worker上只会启动一个执行器。 spark.default.parallelism 对于reduceByKey和join这样的分布式混洗(shuffle)算子,等于父RDD中最大的分区。对于parallelize这样没有父RDD的算子,则取决于集群管理器: Local mode: number of cores on the local machine — 本地模式:机器的core数 Mesos fine grained mode: 8 — Mesos细粒度模式:8 Others: total number of cores on all executor nodes or 2, whichever is larger — 其他:所有执行器节点上core的数量 或者 2,这两数取较大的 如果用户没有在参数里指定,这个属性是默认的RDD transformation算子分区数,如:join,reduceByKey,parallelize等。 spark.executor.heartbeatInterval 10s 执行器心跳间隔(报告心跳给驱动器)。心跳机制使驱动器了解哪些执行器还活着,并且可以从心跳数据中获得执行器的度量数据。 spark.files.fetchTimeout 60s 获取文件的通讯超时,所获取的文件是通过在驱动器上调用SparkContext.addFile()添加的。 spark.files.useFetchCache true 如果设为true(默认),则同一个spark应用的不同执行器之间,会使用一二共享缓存来拉取文件,这样可以提升同一主机上运行多个执行器时候,任务启动的性能。如果设为false,这个优化就被禁用,各个执行器将使用自己独有的缓存,他们拉取的文件也是各自有一份拷贝。如果在NFS文件系统上使用本地文件系统,可以禁用掉这个优化(参考SPARK-6313) spark.files.overwrite false SparkContext.addFile()添加的文件已经存在,且内容不匹配的情况下,是否覆盖。 spark.hadoop.cloneConf false 如设为true,对每个任务复制一份Hadoop Configuration对象。启用这个可以绕过Configuration线程安全问题(SPARK-2546)。默认这个是禁用的,很多job并不会受这个issue的影响。 spark.hadoop.validateOutputSpecs true 如设为true,在saveAsHadoopFile及其变体的时候,将会验证输出(例如,检查输出目录是否存在)。对于已经验证过或确认存在输出目录的情况,可以禁用这个。我们建议不要禁用,除非你确定需要和之前的spark版本兼容。可以简单的利用Hadoop 文件系统API手动删掉已存在的输出目录。这个设置会被Spark Streaming StreamingContext生成的job忽略,因为Streaming需要在回复检查点的时候,覆盖已有的输出目录。 spark.storage.memoryMapThreshold 2m spark从磁盘上读取一个块后,映射到内存块的最小大小。这阻止了spark映射过小的内存块。通常,内存映射块是有开销的,应该比接近或小于操作系统的页大小。 spark.externalBlockStore.blockManager org.apache.spark.storage.TachyonBlockManager 用于存储RDD的外部块管理器(文件系统)的实现。 文件系统URL由spark.externalBlockStore.url决定。 spark.externalBlockStore.baseDir System.getProperty(“java.io.tmpdir”) 外部块存储存放RDD的目录。文件系统URL由spark.externalBlockStore.url决定。也可以是逗号分隔的目录列表(Tachyon文件系统) spark.externalBlockStore.url tachyon://localhost:19998 for Tachyon 所使用的外部块存储文件系统URL。 网络 属性名 默认值 含义 spark.akka.frameSize 128 “control plane” 通讯中所允许的最大消息大小(MB)。通常,只应用于map输出数据的大小信息,这些信息会在执行器和驱动器之间传递。如果你的job包含几千个map和reduce任务,你可能需要增大这个设置。 spark.akka.heartbeat.interval 1000s 设这么大的值,是为了禁用Akka传输失败检测器。也可以重新启用,如果你想用这个特性(但不建议)。设成较大的值可以减少网络开销,而较小的值(1秒左右)可能会对Akka的失败检测更有用。如有需要,可以调整这个值和spark.akka.heartbeat.pauses的组合。一种可能需要使用失败检测的情形是:用一个敏感的失败检测,可以快速识别并逐出不稳定的执行器。然而,在真实的spark集群中,这通常不是GC暂停或网络延迟造成的。除此之外,启用这个还会导致过多的心跳数据交换,从而造成网络洪峰。 spark.akka.heartbeat.pauses 6000s 设这么大的值,是为了禁用Akka传输失败检测器。也可以重新启用,如果你想用这个特性(但不建议)。这个是可接受的Akka心跳暂停时间。这个可以用来控制对GC暂停敏感程度。如有需要,可以调整这个值和spark.akka.heartbeat.interval的组合。 spark.akka.threads 4 用于通讯的actor线程数。如果驱动器机器上有很多CPU core,你可以适当增大这个值。 spark.akka.timeout 100s Spark节点之间通讯超时。 spark.blockManager.port (random) 块管理器(block manager)监听端口。在驱动器和执行器上都有。 spark.broadcast.port (random) 驱动器HTTP广播server监听端口。这和torrent广播没有关系。 spark.driver.host (local hostname) 驱动器主机名。用于和执行器以及独立部署时集群master通讯。 spark.driver.port (random) 驱动器端口。用于和执行器以及独立部署时集群master通讯。 spark.executor.port (random) 执行器端口。用于和驱动器通讯。 spark.fileserver.port (random) 驱动器HTTP文件server监听端口。 spark.network.timeout 120s 所有网络交互的默认超时。这个配置是以下属性的默认值:spark.core.connection.ack.wait.timeout,spark.akka.timeout,spark.storage.blockManagerSlaveTimeoutMs,spark.shuffle.io.connectionTimeout,spark.rpc.askTimeoutorspark.rpc.lookupTimeout spark.port.maxRetries 16 绑定一个端口的最大重试次数。如果指定了一个端口(非0),每个后续重试会在之前尝试的端口基础上加1,然后再重试绑定。本质上,这确定了一个绑定端口的范围,就是 [start port, start port + maxRetries] spark.replClassServer.port (random) 驱动器HTTP class server的监听端口。只和spark shell相关。 spark.rpc.numRetries 3 RPC任务最大重试次数。RPC任务最多重试这么多次。 spark.rpc.retry.wait 3s RPC请求操作重试前等待时间。 spark.rpc.askTimeout 120s RPC请求操作超时等待时间。 spark.rpc.lookupTimeout 120s RPC远程端点查询超时。 调度 属性名 默认值 含义 spark.cores.max (not set) 如果运行在独立部署集群模式(standalone deploy cluster)或者Mesos集群粗粒度共享模式(Mesos cluster in “coarse-grained” sharing mode),这个值决定了spark应用可以使用的最大CPU总数(应用在整个集群中可用CPU总数,而不是单个机器)。如果不设置,那么独立部署时默认为spark.deploy.defaultCores,Mesos集群则默认无限制(即所有可用的CPU)。 spark.locality.wait 3s 为了数据本地性最长等待时间(spark会根据数据所在位置,尽量让任务也启动于相同的节点,然而可能因为该节点上资源不足等原因,无法满足这个任务分配,spark最多等待这么多时间,然后放弃数据本地性)。数据本地性有多个级别,每一级别都是等待这么多时间(同一进程、同一节点、同一机架、任意)。你也可以为每个级别定义不同的等待时间,需要设置spark.locality.wait.node等。如果你发现任务数据本地性不佳,可以增加这个值,但通常默认值是ok的。 spark.locality.wait.node spark.locality.wait 单独定义同一节点数据本地性任务等待时间。你可以设为0,表示忽略节点本地性,直接跳到下一级别,即机架本地性(如果你的集群有机架信息)。 spark.locality.wait.process spark.locality.wait 单独定义同一进程数据本地性任务等待时间。这个参数影响试图访问特定执行器上的缓存数据的任务。 spark.locality.wait.rack spark.locality.wait 单独定义同一机架数据本地性等待时间。 spark.scheduler.maxRegisteredResourcesWaitingTime 30s 调度开始前,向集群管理器注册使用资源的最大等待时间。 spark.scheduler.minRegisteredResourcesRatio 0.8 for YARN mode; 0.0 for standalone mode and Mesos coarse-grained mode 调度启动前,需要注册得到资源的最小比例(注册到的资源数 / 需要资源总数)(YARN模式下,资源是执行器;独立部署和Mesos粗粒度模式下时资源是CPU core【spark.cores.max是期望得到的资源总数】)。可以设为0.0~1.0的一个浮点数。不管job是否得到了最小资源比例,最大等待时间都是由spark.scheduler.maxRegisteredResourcesWaitingTime控制的。 spark.scheduler.mode FIFO 提交到同一个SparkContext上job的调度模式(scheduling mode)。另一个可接受的值是FAIR,而FIFO只是简单的把job按先来后到排队。对于多用户服务很有用。 spark.scheduler.revive.interval 1s 调度器复活worker的间隔时间。 spark.speculation false 如果设为true,将会启动推测执行任务。这意味着,如果stage中有任务执行较慢,他们会被重新调度到别的节点上执行。 spark.speculation.interval 100ms Spark检查慢任务的时间间隔。 spark.speculation.multiplier 1.5 比任务平均执行时间慢多少倍的任务会被认为是慢任务。 spark.speculation.quantile 0.75 对于一个stage来说,完成多少百分比才开始检查慢任务,并启动推测执行任务。 spark.task.cpus 1 每个任务分配的CPU core。 spark.task.maxFailures 4 单个任务最大失败次数。应该>=1。最大重试次数 =spark.task.maxFailures – 1 动态分配 属性名 默认值 含义 spark.dynamicAllocation.enabled false 是否启用动态资源分配特性,启用后,执行器的个数会根据工作负载动态的调整(增加或减少)。注意,目前在YARN模式下不用。更详细信息,请参考:here该特性依赖于 spark.shuffle.service.enabled 的启用。同时还和以下配置相关:spark.dynamicAllocation.minExecutors, spark.dynamicAllocation.maxExecutors以及spark.dynamicAllocation.initialExecutors spark.dynamicAllocation .executorIdleTimeout 60s 动态分配特性启用后,空闲时间超过该配置时间的执行器都会被移除。更详细请参考这里:description spark.dynamicAllocation.cachedExecutorIdleTimeout infinity 动态分配特性启用后,包含缓存数据的执行器如果空闲时间超过该配置设置的时间,则被移除。更详细请参考:description spark.dynamicAllocation.initialExecutors spark .dynamicAllocation .minExecutors 动态分配开启后,执行器的初始个数 spark.dynamicAllocation.maxExecutors infinity 动态分配开启后,执行器个数的上限 spark.dynamicAllocation.minExecutors 0 动态分配开启后,执行器个数的下限 spark.dynamicAllocation.schedulerBacklogTimeout 1s 动态分配启用后,如果有任务积压的持续时间长于该配置设置的时间,则申请新的执行器。更详细请参考:description spark.dynamicAllocation.sustainedSchedulerBacklogTimeout schedulerBacklogTimeout 和spark.dynamicAllocation.schedulerBacklogTimeout类似,只不过该配置对应于随后持续的执行器申请。更详细请参考:description 安全 属性名 默认值 含义 spark.acls.enable false 是否启用Spark acls(访问控制列表)。如果启用,那么将会检查用户是否有权限查看或修改某个作业(job)。注意,检查的前提是需要知道用户是谁,所以如果用户是null,则不会做任何检查。你可以在Spark UI上设置过滤器(Filters)来做用户认证,并设置用户名。 spark.admin.acls Empty 逗号分隔的用户列表,在该列表中的用户/管理员将能够访问和修改所有的Spark作业(job)。如果你的集群是共享的,并且有集群管理员,还有需要调试的开发人员,那么这个配置会很有用。如果想让所有人都有管理员权限,只需把该配置设置为”*” spark.authenticate false 设置Spark是否认证集群内部连接。如果不是在YARN上运行,请参考 spark.authenticate.secret spark.authenticate.secret None 设置Spark用于内部组件认证的秘钥。如果不是在YARN上运行,且启用了 spark.authenticate,那么该配置必须设置 spark.authenticate.enableSaslEncryption false 是否对Spark内部组件认证使用加密通信。该配置目前只有 block transfer service 使用。 spark.network.sasl.serverAlwaysEncrypt false 是否对支持SASL认证的service禁用非加密通信。该配置目前只有 external shuffle service 支持。 spark.core.connection.ack.wait.timeout 60s 网络连接等待应答信号的超时时间。为了避免由于GC等导致的意外超时,你可以设置一个较大的值。 spark.core.connection.auth.wait.timeout 30s 网络连接等待认证的超时时间。 spark.modify.acls Empty 逗号分隔的用户列表,在改列表中的用户可以修改Spark作业。默认情况下,只有启动该Spark作业的用户可以修改之(比如杀死该作业)。如果想要任何用户都可以修改作业,请将该配置设置为”*” spark.ui.filters None 逗号分隔的过滤器class列表,这些过滤器将用于Spark web UI。这里的过滤器应该是一个标准的javax servlet Filter。每个过滤器的参数可以通过java系统属性来设置,如下: spark.<class name of filer>.params=’param1=value1,param2=value2’例如: -Dspark.ui.filters=com.test.filter1 -Dspark.com.test.filter1.params=’param1=foo,param2=testing’ spark.ui.view.acls Empty 逗号分隔的用户列表,在该列表中的用户可以查看Spark web UI。默认,只有启动该Spark作业的用户可以查看之。如果需要让所有用户都能查看,只需将该配置设为”*” 加密 属性名 默认值 含义 spark.ssl.enabled false 是否启用SSL连接(在所有所支持的协议上)。所有SSL相关配置(spark.ssl.xxx,其中xxx是一个特定的配置属性),都是全局的。如果需要在某些协议上覆盖全局设置,那么需要在该协议命名空间上进行单独配置。使用 spark.ssl.YYY.XXX 来为协议YYY覆盖全局配置XXX。目前YYY的可选值有 akka(用于基于AKKA框架的网络连接) 和 fs(用于应广播和文件服务器) spark.ssl.enabledAlgorithms Empty 逗号分隔的加密算法列表。这些加密算法必须是JVM所支持的。这里有个可用加密算法参考列表:this spark.ssl.keyPassword None 在key-store中私匙对应的密码。 spark.ssl.keyStore None key-store文件路径。可以是绝对路径,或者以本组件启动的工作目录为基础的相对路径。 spark.ssl.keyStorePassword None key-store的密码。 spark.ssl.protocol None 协议名称。该协议必须是JVM所支持的。这里有JVM支持的协议参考列表:this spark.ssl.trustStore None trust-store文件路径。可以是绝对路径,或者以本组件启动的工作目录为基础的相对路径。 spark.ssl.trustStorePassword None trust-store的密码 Spark Streaming [流式] 属性名 默认值 含义 spark.streaming.backpressure.enabled false 是否启用Spark Streaming 的内部反压机制(spark 1.5以上支持)。启用后,Spark Streaming会根据当前批次的调度延迟和处理时长来控制接收速率,这样一来,系统的接收速度会和处理速度相匹配。该特性会在内部动态地设置接收速率。该速率的上限将由 spark.streaming.receiver.maxRate 和 spark.streaming.kafka.maxRatePerPartition 决定(如果它们设置了的话)。 spark.streaming.blockInterval 200ms 在将数据保存到Spark之前,Spark Streaming接收器组装数据块的时间间隔。建议不少于50ms。关于Spark Streaming编程指南细节,请参考performance tuning这一节。 spark.streaming.receiver.maxRate not set 接收速度的最大速率(每秒记录条数)。实际上,每个流每秒将消费这么多条记录。设置为0或者负数表示不限制速率。更多细节请参考:deployment guide spark.streaming.receiver.writeAheadLog.enable false 是否启用接收器预写日志。所有的输入数据都会保存到预写日志中,这样在驱动器失败后,可以基于预写日志来恢复数据。更详细请参考:deployment guide spark.streaming.unpersist true 是否强制Spark Streaming自动从内存中清理掉所生成并持久化的RDD。同时,Spark Streaming收到的原始数据也将会被自动清理掉。如果设置为false,那么原始数据以及持久化的RDD将不会被自动清理,以便外部程序可以访问这些数据。当然,这将导致Spark消耗更多的内存。 spark.streaming.stopGracefullyOnShutdown false 如果设为true,Spark将会在JVM关闭时,优雅地关停StreamingContext,而不是立即关闭之。 spark.streaming.kafka.maxRatePerPartition not set 在使用Kafka direct stream API时,从每个Kafka数据分区读取数据的最大速率(每秒记录条数)。更详细请参考:Kafka Integration guide spark.streaming.kafka.maxRetries 1 驱动器连续重试的最大次数,这个配置是为了让驱动器找出每个Kafka分区上的最大offset(默认值为1,意味着驱动器将最多尝试2次)。只对新的Kafka direct stream API有效。 spark.streaming.ui.retainedBatches 1000 Spark Streaming UI 以及 status API 中保留的最大批次个数。 SparkR 属性名 默认值 含义 spark.r.numRBackendThreads 2 SparkR RBackEnd处理RPC调用的后台线程数 spark.r.command Rscript 集群模式下,驱动器和worker上执行的R脚本可执行文件 spark.r.driver.command spark.r.command client模式的驱动器执行的R脚本。集群模式下会忽略 集群管理器 每个集群管理器都有一些额外的配置选项。详细请参考这里: YARN Mesos Standalone Mode 环境变量 有些Spark设置需要通过环境变量来设定,这些环境变量可以在${SPARK_HOME}/conf/spark-env.sh脚本(Windows下是conf/spark-env.cmd)中设置。如果是独立部署或者Mesos模式,这个文件可以指定机器相关信息(如hostname)。运行本地Spark应用或者submit脚本时,也会引用这个文件。 注意,conf/spark-env.sh默认是不存在的。你需要复制conf/spark-env.sh.template这个模板来创建,还有注意给这个文件附上可执行权限。 以下变量可以在spark-env.sh中设置: 环境变量 含义 JAVA_HOME Java安装目录(如果没有在PATH变量中指定) PYSPARK_PYTHON 驱动器和worker上使用的Python二进制可执行文件(默认是python) PYSPARK_DRIVER_PYTHON 仅在驱动上使用的Python二进制可执行文件(默认同PYSPARK_PYTHON) SPARKR_DRIVER_R SparkR shell使用的R二进制可执行文件(默认是R) SPARK_LOCAL_IP 本地绑定的IP SPARK_PUBLIC_DNS Spark程序公布给其他机器的hostname 另外,还有一些选项需要在Sparkstandalone cluster scripts里设置,如:每台机器上使用的core数量,和最大内存占用量。 spark-env.sh是一个shell脚本,因此一些参数可以通过编程方式来设定 – 例如,你可以获取本机IP来设置SPARK_LOCAL_IP。 日志配置 Spark使用log4j打日志。你可以在conf目录下用log4j.properties来配置。复制该目录下已有的log4j.properties.template并改名为log4j.properties即可。 覆盖配置目录 默认Spark配置目录是”${SPARK_HOME}/conf”,你也可以通过 ${SPARK_CONF_DIR}指定其他目录。Spark会从这个目录下读取配置文件(spark-defaults.conf,spark-env.sh,log4j.properties等) 继承Hadoop集群配置 如果你打算用Spark从HDFS读取数据,那么有2个Hadoop配置文件必须放到Spark的classpath下: hdfs-site.xml,配置HDFS客户端的默认行为 core-site.xml,默认文件系统名 这些配置文件的路径在不同发布版本中不太一样(如CDH和HDP版本),但通常都能在 ${HADOOP_HOME}/etc/hadoop/conf目录下找到。一些工具,如Cloudera Manager,可以动态修改配置,而且提供了下载一份拷贝的机制。 要想让这些配置对Spark可见,请在${SPARK_HOME}/spark-env.sh中设置HADOOP_CONF_DIR变量。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark独立模式

Spark独立模式 Spark除了可以在Mesos和YARN集群上运行之外,还支持一种简单的独立部署模式。独立部署模式下,你既可以手工启动(手动运行master和workers),也可以利用我们提供的启动脚本(launch scripts)。同时,独立部署模式下,你可以在单机上运行这些程序,以方便测试。 Spark集群独立安装 要独立安装Spark,你只需要将编译好的Spark包复制到集群中每一个节点上即可。你可以下载一个编译好的Spark版本,也可以在这里自己编译一个版本(build it yourself)。 手动启动集群 执行以下命令,启动独立部署的master server: ./sbin/start-master.sh 一旦启动完成,master会打印出master URL(spark://HOST:PORT),后续worker需要用这个URL来连接master,写代码的时候SparkContext中的master参数也需要设置成这个master URL。你还可以在master的web UI(默认为http://localhost:8080)上查看master URL。 类似地,你可以通过以下命令,启动一个或多个worker节点,并将其连接到master: ./sbin/start-slave.sh <master-spark-URL> 启动一个worker以后,刷新一下master的web UI(默认为http://localhost:8080),你应该可以在这里看到一个新的节点。 最后,以下配置选项将会被传给master和worker: 参数 含义 -h HOST,--host HOST 监听的主机名 -i HOST,--ip HOST 监听的主机名(已经废弃,请使用-h 或者 –host) -p PORT,--port PORT 服务监听的端口(master节点默认7077,worker节点随机) --webui-port PORT web UI端口(master节点默认8080,worker节点默认8081) -c CORES,--cores CORES 单节点上,Spark应用能够使用的CPU core数上限(默认,等于CPU core的个数);仅worker节点有效 -m MEM,--memory MEM 单节点上,Spark应用能够使用的内存上限,格式为1000M 或者 2G(默认为,机器上所有内存减去1G);仅worker节点有效 -d DIR,--work-dir DIR 工作目录,同时job的日志也输出到该目录(默认:${SPAKR_HOME}/work);仅worker节点有效 --properties-file FILE 自定义Spark属性文件的加载路径(默认:conf/spark-defaults.conf) 集群启动脚本 要使用启动脚本,来启动一个Spark独立部署集群,首先你需要在Spark目录下创建一个文件conf/slaves,并且在文件中写入你需要作为worker节点启动的每一台机器主机名(或IP),每行一台机器。如果conf/slaves文件不存在,启动脚本会默认会用单机方式启动,这种方式对测试很有帮助。注意,master节点访问各个worker时使用ssh。默认情况下,你需要配置ssh免密码登陆(使用秘钥文件)。如果你没有设置免密码登陆,那么你也可以通过环境变量SPARK_SSH_FOREGROUND来一个一个地设置每个worker的密码。 设置好conf/slaves文件以后,你就可以用一下shell脚本来启动或停止集群了,类似于Hadoop的部署,这些脚本都在${SPARK_HOME}/sbin目录下: sbin/start-master.sh– 在本机启动一个master实例 sbin/start-slaves.sh– 在conf/slaves文件所指定的每一台机器上都启动一个slave实例 sbin/start-slave.sh– 在本机启动一个slave实例 sbin/start-all.sh– 启动一个master和多个slave实例,详细见上面的描述。 sbin/stop-master.sh– 停止 start-master.sh所启动的master实例 sbin/stop-slaves.sh– 停止所有在conf/slaves中指定的slave实例 sbin/stop-all.sh– 停止master节点和所有slave节点,详细见上面的描述 注意,这些脚本都需要在你启动Spark master的机器上运行,而不是你的本地机器。 Spark独立部署集群的其他可选的环境变量见conf/spark-env.sh。你可以通过复制conf/spark-env.sh.template来创建这个文件,同时你还需要将配置好的文件复制到所有的worker节点上。以下是可用的设置: 环境变量 含义 SPARK_MASTER_IP master实例绑定的IP地址,例如,绑定到一个公网IP SPARK_MASTER_PORT mater实例绑定的端口(默认7077) SPARK_MASTER_WEBUI_PORT master web UI的端口(默认8080) SPARK_MASTER_OPTS master专用配置属性,格式如”-Dx=y” (默认空),可能的选项请参考下面的列表。 SPARK_LOCAL_DIRS Spark的本地工作目录,包括:映射输出的临时文件和RDD保存到磁盘上的临时数据。这个目录需要快速访问,最好设成本地磁盘上的目录。也可以通过使用逗号分隔列表,将其设成多个磁盘上的不同路径。 SPARK_WORKER_CORES 本机上Spark应用可以使用的CPU core上限(默认所有CPU core) SPARK_WORKER_MEMORY 本机上Spark应用可以使用的内存上限,如:1000m,2g(默认为本机所有内存减去1GB);注意每个应用单独使用的内存大小要用 spark.executor.memory 属性配置的。 SPARK_WORKER_PORT Spark worker绑定的端口(默认随机) SPARK_WORKER_WEBUI_PORT worker web UI端口(默认8081) SPARK_WORKER_INSTANCES 每个slave机器上启动的worker实例个数(默认:1)。如果你的slave机器非常强劲,可以把这个值设为大于1;相应的,你需要设置SPARK_WORKER_CORES参数来显式地限制每个worker实例使用的CPU个数,否则每个worker实例都会使用所有的CPU。 SPARK_WORKER_DIR Spark worker的工作目录,包括worker的日志以及临时存储空间(默认:${SPARK_HOME}/work) SPARK_WORKER_OPTS worker的专用配置属性,格式为:”-Dx=y”,可能的选项请参考下面的列表。 SPARK_DAEMON_MEMORY Spark master和worker后台进程所使用的内存(默认:1g) SPARK_DAEMON_JAVA_OPTS Spark master和workers后台进程所使用的JVM选项,格式为:”-Dx=y”(默认空) SPARK_PUBLIC_DNS Spark master和workers使用的公共DNS(默认空) 注意:启动脚本目前不支持Windows。如需在Windows上运行,请手工启动master和workers。 SPARK_MASTER_OPTS支持以下属性: 属性名 默认值 含义 spark.deploy.retainedApplications 200 web UI上最多展示几个已结束应用。更早的应用的数将被删除。 spark.deploy.retainedDrivers 200 web UI上最多展示几个已结束的驱动器。更早的驱动器进程数据将被删除。 spark.deploy.spreadOut true 独立部署集群的master是否应该尽可能将应用分布到更多的节点上;设为true,对数据本地性支持较好;设为false,计算会收缩到少数几台机器上,这对计算密集型任务比较有利。 spark.deploy.defaultCores (无限制) Spark独立模式下应用程序默认使用的CPU个数(没有设置spark.cores.max的情况下)。如果不设置,则为所有可用CPU个数(除非设置了spark.cores.max)。如果集群是共享的,最好将此值设小一些,以避免用户占满整个集群。 spark.worker.timeout 60 如果master没有收到worker的心跳,那么将在这么多秒之后,master将丢弃该worker。 SPARK_WORKER_OPTS支持以下属性: 属性名 默认值 含义 spark.worker.cleanup.enabled false 是否定期清理 worker 和应用的工作目录。注意,该设置仅在独立模式下有效,YARN有自己的清理方式;同时,只会清理已经结束的应用对应的目录。 spark.worker.cleanup.interval 1800 (30 minutes) worker清理本地应用工作目录的时间间隔(秒) spark.worker.cleanup.appDataTtl 7 * 24 * 3600 (7 days) 清理多久以前的应用的工作目录。这个选项值将取决于你的磁盘总量。spark应用会将日志和jar包都放在其对应的工作目录下。随着时间流逝,应用的工作目录很快会占满磁盘,尤其是在你的应用提交比较频繁的情况下。 连接到集群 要在Spark集群上运行一个应用,只需把spark://IP:PORT这个master URL传给SparkContext(参考SparkContextconstructor) 如需要运行交互式的spark shell,运行如下命令: ./bin/spark-shell --master spark://IP:PORT 你也可以通过设置选线 –total-executor-cores <numCores> 来控制spark-shell在集群上使用的CPU总数。 启动Spark应用 spark-submit脚本(spark-submitscript)是提交spark应用最简洁的方式。对于独立安装的集群来说,spark目前支持两种运行模式。客户端(client)模式下,驱动器进程(driver)将在提交应用的机器上启动。而在集群(cluster)模式下,驱动器(driver)将会在集群中的某一台worker上启动,同时提交应用的客户端在提交动作完成之后立即退出,而不会等到Spark应用运行结束。 如果你的应用时通过spark-submit提交启动的,那么应用对应的jar包会自动发布到所有的worker节点上。任何额外的依赖项jar包,都必须在–jars参数中指明,并以逗号分隔(如:–jars jar1,jar2)。 另外,独立安装的集群还支持异常退出(返回值非0)时自动重启。要启用这个特性,你需要在spark-submit时指定–supervise参数。其后,如果你需要杀掉一个重复失败的应用,你可能需要运行如下指令: ./bin/spark-class org.apache.spark.deploy.Client kill <master url> <driver ID> 你可以在master web UI(http://<master url>:8080)上查看驱动器ID。 资源调度 独立安装集群目前只支持简单的先进先出(FIFO)调度器。这个调度器可以支持多用户,你可以控制每个应用所使用的最大资源。默认情况下,Spark应用会申请集群中所有的CPU,这不太合理,除非你的进群同一时刻只运行一个应用。你可以通过SparkConf中的spark.cores.max,来设置一个CPU帽子以限制其使用的CPU总数。例如: val conf = new SparkConf() .setMaster(...) .setAppName(...) .set("spark.cores.max", "10") val sc = new SparkContext(conf) 另外,你也可以通过conf/spark-env.sh中的spark.deploy.defaultCores设置应用默认使用的CPU个数(特别针对没有设置spark.cores.max的应用)。 export SPARK_MASTER_OPTS="-Dspark.deploy.defaultCores=<value>" 在一些共享的集群上,用户很可能忘记单独设置一个最大CPU限制,那么这个参数将很有用。 监控和日志 Spark独立安装模式提供了一个基于web的集群监控用户界面。master和每个worker都有其对应的web UI,展示集群和Spark作业的统计数据。默认情况下,你可以在master机器的8080端口上访问到这个web UI。这个端口可以通过配置文件或者命令行来设置。 另外,每个作业的详细日志,将被输出到每个slave节点上的工作目录下(默认为:${SPARK_HOME}/work)。每个Spark作业下都至少有两个日志文件,stdout和stderr,这里将包含所有的输出到控制台的信息。 和Hadoop同时运行 你可以让Spark和已有的Hadoop在同一集群上同时运行,只需要将Spark作为独立的服务启动即可。这样Spark可以通过hdfs:// URL来访问Hadoop上的数据(通常情况下是,hdfs://<namenode>:9000/path,你可以在Hadoop Namenode的web UI上找到正确的链接)。当然,你也可以为Spark部署一个独立的集群,这时候Spark仍然可以通过网络访问HDFS上的数据;这会比访问本地磁盘慢一些,但如果Spark和Hadoop集群都在同一个本地局域网内的话,问题不大(例如,你可以在Hadoop集群的每个机架上新增一些部署Spark的机器)。 网络安全端口配置 Spark会大量使用网络资源,而有些环境会设置严密的防火墙设置,以严格限制网络访问。完整的端口列表,请参考这里:security page. 高可用性 默认情况下,独立调度的集群能够容忍worker节点的失败(在Spark本身来说,它能够将失败的工作移到其他worker节点上)。然而,调度器需要master做出调度决策,而这(默认行为)会造成单点失败:如果master挂了,任何应用都不能提交和调度。为了绕过这个单点问题,我们有两种高可用方案,具体如下: 基于Zookeeper的热备master 概要 利用Zookeeper来提供领导节点选举以及一些状态数据的存储,你可以在集群中启动多个master并连接到同一个Zookeeper。其中一个将被选举为“领导”,而另一个将处于备用(standby)状态。如果“领导”挂了,则另一个master会立即被选举,并从Zookeeper恢复已挂“领导”的状态,并继续调度。整个恢复流程(从“领导”挂开始计时)可能需要1到2分钟的时间。注意,整个延时只会影响新增应用 – 已经运行的应用不会受到影响。 更多关于Zookeeper信息请参考这里:here 配置 要启用这种恢复模式,你可以在spark-env中设置SPARK_DAEMON_JAVA_OPTS,可用的属性如下: 系统属性 含义 spark.deploy.recoveryMode 设为ZOOKEEPER以启用热备master恢复模式(默认空) spark.deploy.zookeeper.url Zookeeper集群URL(如:192.168.1.100:2181,192.168.1.101:2181) spark.deploy.zookeeper.dir 用于存储可恢复状态的Zookeeper目录(默认 /spark) 可能的问题:如果你有多个master,但没有正确设置好master使用Zookeeper的配置,那么这些master彼此都不可见,并且每个master都认为自己是“领导”。这件会导致整个集群处于不稳定状态(多个master都会独立地进行调度) 详细 如果你已经有一个Zookeeper集群,那么启动高可用特性是很简单的。只需要在不同节点上启动多个master,并且配置相同的Zookeeper(包括Zookeeper URL和目录)即可。masters可以随时添加和删除。 在调度新提交的Spark应用或者新增worker节点时,需要知道当前”领导“的IP地址。你只需要将以前单个的master地址替换成多个master地址即可。例如,你可以在SparkContext中设置master URL为spark://host1:port1.host2:port2。这会导致SparkContext在两个master中都进行登记 – 那么这时候,如果host1挂了,这个应用的配置同样可以在新”领导“(host2)中找到。 ”在master注册“和普通操作有一个显著的区别。在Spark应用或worker启动时,它们需要找当前的”领导“master,并在该master上注册。一旦注册成功,它们的状态将被存储到Zookeeper上。如果”老领导“挂了,”新领导“将会联系所有之前注册过的Spark应用和worker并通知它们领导权的变更,所以Spark应用和worker在启动时甚至没有必要知道”新领导“的存在。 由于这一特性,新的master可以在任何时间添加进来,你唯一需要关注的就是,新的应用或worker能够访问到这个master。总之,只要应用和worker注册成功,其他的你都不用管了。 基于本地文件系统的单点恢复 概要 利用Zookeeper当然是生成环境下高可用的最佳选择,但有时候你仍然希望在master挂了的时候能够重启之,FILESYSTEM模式能帮你实现这一需求。当应用和worker注册到master的时候,他们的状态都将被写入文件系统目录中,一旦master挂了,你只需要重启master,这些状态都能够恢复。 配置 要使用这种恢复模式,你需要在spark-env中设置SPARK_DAEMON_JAVA_OPTS,可用的属性如下: 系统属性 含义 spark.deploy.recoveryMode 设为FILESYSTEM以启用单点恢复模式(默认空) spark.deploy.recoveryDirectory 用于存储可恢复状态数据的目录,master进程必须有访问权限 Details(详细) 这个解决方案可以用于和一些监控、管理系统进行串联(如:monit),或者与手动重启相结合。 至少,基于文件系统工单恢复总比不能恢复强;同时,这种恢复模式也会是开发或者实验场景下的不错的选择。在某些情况下,通过stop-master.sh杀死master可能不会清理其状态恢复目录下的数据,那么这时候你启动或重启master,将会进入恢复模式。这可能导致master的启动时间长达一分钟(master可能要等待之前注册的worker和客户端超时)。 你也可以使用NFS目录来作为数据恢复目录(虽然这不是官方声明支持的)。如果老的master挂了,你可以在另一个节点上启动master,这个master只要能访问同一个NFS目录,它就能够正确地恢复状态数据,包括之前注册的worker和应用(等价于Zookeeper模式)。后续的应用必须使用新的master来进行注册。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》监控和工具

监控和工具 监控Spark应用有很多种方式:web UI,metrics 以及外部工具。 Web界面 每个SparkContext都会启动一个web UI,其默认端口为4040,并且这个web UI能展示很多有用的Spark应用相关信息。包括: 一个stage和task的调度列表 一个关于RDD大小以及内存占用的概览 运行环境相关信息 运行中的执行器相关信息 你只需打开浏览器,输入 http://<driver-node>:4040 即可访问该web界面。如果有多个SparkContext在同时运行中,那么它们会从4040开始,按顺序依次绑定端口(4041,4042,等)。 注意,默认情况下,这些信息只有在Spark应用运行期内才可用。如果需要在Spark应用退出后仍然能在web UI上查看这些信息,则需要在应用启动前,将 spark.eventLog.enabled 设为 true。这项配置将会把Spark事件日志都记录到持久化存储中。 事后查看 Spark独立部署时,其对应的集群管理器也有其对应的web UI。如果Spark应用将其运行期事件日志保留下来了,那么独立部署集群管理器对应的web UI将会根据这些日志自动展示已经结束的Spark应用。 如果Spark是运行于Mesos或者YARN上的话,那么你需要开启Spark的history server,开启event log。开启history server需要如下指令: ./sbin/start-history-server.sh 如果使用file-system provider class(参考下面的 spark.history.provider),那么日志目录将会基于 spark.history.fs.logDirectory 配置项,并且在表达Spark应用的事件日志路径时,应该带上子目录。history server对应的web界面默认在这里 http://<server-url>:18080。同时,history server有一些可用的配置如下: 环境变量 含义 SPARK_DAEMON_MEMORY history server分配多少内存(默认: 1g) SPARK_DAEMON_JAVA_OPTS history server的 JVM参数(默认:none) SPARK_PUBLIC_DNS history server的外部访问地址,如果不配置,那么history server有可能会绑定server的内部地址,这可能会导致外部不能访问(默认:none) SPARK_HISTORY_OPTS history server配置项(默认:none):spark.history.* 属性名称 默认值 含义 spark.history.provider org.apache.spark.deploy .history.FsHistoryProvider Spark应用历史后台实现的类名。目前可用的只有spark自带的一个实现,支持在本地文件系统中查询应用日志。 spark.history.fs.logDirectory file:/tmp/spark-events history server加载应用日志的目录 spark.history.fs.update.interval 10s history server更新信息的时间间隔。每次更新将会检查磁盘上的日志是否有更新。 spark.history.retainedApplications 50 UI上保留的spark应用历史个数。超出的将按时间排序,删除最老的。 spark.history.ui.port 18080 history server绑定的端口 spark.history.kerberos.enabled false history server是否启用kerberos验证登陆。如果history server需要访问一个需要安全保证的hadoop集群,则需要开启这个功能。该配置设为true以后,需要同时配置 spark.history.kerberos.principal 和 spark.history.kerberos.keytab spark.history.kerberos.principal (none) 登陆history server的kerberos 主体名称 spark.history.kerberos.keytab (none) history server对应的kerberos keytab文件路径 spark.history.ui.acls.enable false 指定是否启用ACL以控制用户访问验证。如果启用,那么不管某个应用是否设置了 spark.ui.acls.enabled,访问控制都将检查用户是否有权限。Spark应用的owner始终有查看的权限,而其他用户则需要通过 spark.ui.view.acls 配置其访问权限。如果禁用,则不会检查访问权限。 spark.history.fs.cleaner.enabled false 指定history server是否周期性清理磁盘上的event log spark.history.fs.cleaner.interval 1d history server清理磁盘文件的时间间隔。只会清理比 spark.history.fs.cleaner.maxAge 时间长的磁盘文件。 spark.history.fs.cleaner.maxAge 7d 如果启用了history server周期性清理,比这个时间长的Spark作业历史文件将会被清理掉 注意,所有web界面上的 table 都可以点击其表头来排序,这样可以帮助用户做一些简单分析,如:发现跑的最慢的任务、数据倾斜等。 注意history server 只展示已经结束的Spark作业。一种通知Spark作业结束的方法是,显式地关闭SparkContext(通过调用 sc.stop(),或者在 使用 SparkContext() 处理其 setup 和 tear down 事件(适用于python),然后作业历史就会出现在web UI上了。 REST API 度量信息除了可以在UI上查看之外,还可以以JSON格式访问。这能使开发人员很容易构建新的Spark可视化和监控工具。JSON格式的度量信息对运行中的Spark应用和history server中的历史作业均有效。其访问端点挂载在 /api/v1 路径下。例如,对于history server,一般你可以通过 http://<server-url>:18080/api/v1 来访问,而对于运行中的应用,可以通过 http://localhost:4040/api/v1 来访问。 端点 含义 /applications 所有应用的列表 /applications/[app-id]/jobs 给定应用的全部作业列表 /applications/[app-id]/jobs/[job-id] 给定作业的细节 /applications/[app-id]/stages 给定应用的stage列表 /applications/[app-id]/stages/[stage-id] 给定stage的所有attempt列表 /applications/[app-id]/stages/[stage-id]/[stage-attempt-id] 给定attempt的详细信息 /applications/[app-id]/stages/[stage-id]/[stage-attempt-id]/taskSummary 指定attempt对应的所有task的概要度量信息 /applications/[app-id]/stages/[stage-id]/[stage-attempt-id]/taskList 指定的attempt的所有task的列表 /applications/[app-id]/executors 给定应用的所有执行器 /applications/[app-id]/storage/rdd 给定应用的已保存的RDD列表 /applications/[app-id]/storage/rdd/[rdd-id] 给定的RDD的存储详细信息 /applications/[app-id]/logs 将给定应用的所有attempt对应的event log以zip格式打包下载 /applications/[app-id]/[attempt-id]/logs 将给定attempt的所有attempt对应的event log以zip格式打包下载 如果在YARN上运行,每个应用都由多个attempts,所以 [app-id] 实际上是 [app-id]/[attempt-id]。 这些API端点都有版本号,所以基于这些API开发程序就比较容易。Spark将保证: 端点一旦添加进来,就不会删除 某个端点支持的字段永不删除 未来可能会增加新的端点 已有端点可能会增加新的字段 未来可能会增加新的API版本,但会使用不同的端点(如:api/v2 )。但新版本不保证向后兼容。 API版本可能会整个丢弃掉,但在丢弃前,一定会和新版本API共存至少一个小版本。 注意,在UI上检查运行中的应用时,虽然每次只能查看一个应用, 但applicatoins/[app-id] 这部分路径仍然是必须的。例如,你需要查看运行中应用的作业列表时,你需要输入 http://localhost:4040/api/v1/applications/[app-id]/jobs。虽然麻烦点,但这能保证两种模式下访问路径的一致性。 度量 Spark的度量子系统是可配置的,其功能是基于Coda Hale Metrics Library开发的。这套度量子系统允许用户以多种形式的汇报槽(sink)汇报Spark度量信息,包括:HTTP、JMX和CSV文件等。其对应的配置文件路径为:${SPARK_HOME}/conf/metrics.properties。当然,你可以通过spark.metrics.conf 这个Spark属性来自定义配置文件路径(详见configuration property)。Spark的各个组件都有其对应的度量实例,且这些度量实例之间是解耦的。这些度量实例中,你都可以配置一系列不同的汇报槽来汇报度量信息。以下是目前支持的度量实例: master: 对应Spark独立部署时的master进程。 applications: master进程中的一个组件,专门汇报各个Spark应用的度量信息。 worker: 对应Spark独立部署时的worker进程。 executor: 对应Spark执行器。 driver: 对应Spark驱动器进程(即创建SparkContext对象的进程)。 每个度量实例可以汇报给0~n个槽。以下是目前 org.apache.spark.metrics.sink 包中包含的几种汇报槽(sink): ConsoleSink:将度量信息打印到控制台。 CSVSink: 以特定的间隔,将度量信息输出到CSV文件。 JmxSink: 将度量信息注册到JMX控制台。 MetricsServlet: 在已有的Spark UI中增加一个servlet,对外提供JSON格式的度量数据。 GraphiteSink: 将度量数据发到Graphite节点。 Slf4jSink: 将度量数据发送给slf4j 打成日志。 Spark同样也支持Ganglia,但因为license限制的原因没有包含在默认的发布包中: GangliaSink: 将度量信息发送给一个Ganglia节点或者多播组。 如果需要支持GangliaSink的话,你需要自定义Spark构建包。注意,如果你包含了GangliaSink代码包的话,就必须同时将LGPL-licensed 协议包含进你的Spark包中。对于sbt用户,只需要在编译打包前设置好环境变量:SPARK_GANGLIA_LGPL即可。对于maven用户,启用 -Pspark-ganglia-lgpl 即可。另外,除了修改集群的Spark之外,用户程序还需要链接 spark-ganglia-lgpl 工件。 度量系统配置文件语法可以参考这个配置文件示例:${SPARK_HOME}/conf/metrics.properties.template 高级工具 以下是几个可以用以分析Spark性能的外部工具: 集群整体监控工具,如:Ganglia,可以提供集群整体的使用率和资源瓶颈视图。比如,Ganglia的仪表盘可以迅速揭示出整个集群的工作负载是否达到磁盘、网络或CPU限制。 操作系统分析工具,如:dstat,iostat, 以及iotop,可以提供单个节点上细粒度的分析剖面。 JVM工具可以帮助你分析JVM虚拟机,如:jstack可以提供调用栈信息,jmap可以转储堆内存数据,jstat可以汇报时序统计信息,jconsole可以直观的探索各种JVM属性,这对于熟悉JVM内部机制非常有用。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark快速入门

快速入门 本教程是对Spark的一个快速简介。首先,我们通过Spark的交互式shell介绍一下API(主要是Python或Scala),然后展示一下如何用Java、Scala、Python写一个Spark应用。更完整参考看这里:programming guide 首先,请到Spark website下载一个Spark发布版本,以便后续方便学习。我们暂时还不会用到HDFS,所以你可以使用任何版本的Hadoop。 使用Spark shell交互式分析 基础 利用Spark shell 很容易学习Spark API,同时也Spark shell也是强大的交互式数据分析工具。Spark shell既支持Scala(Scala版本的shell在Java虚拟机中运行,所以在这个shell中可以引用现有的Java库),也支持Python。在Spark目录下运行下面的命令可以启动一个Spark shell: Scala Python ./bin/spark-shell Spark最主要的抽象概念是个分布式集合,也叫作弹性分布式数据集(Resilient Distributed Dataset –RDD)。RDD可以由Hadoop InputFormats读取HDFS文件创建得来,或者从其他RDD转换得到。下面我们就先利用Spark源代码目录下的README文件来新建一个RDD: scala> val textFile = sc.textFile("README.md") textFile: spark.RDD[String] = spark.MappedRDD@2ee9b6e3 RDD有两种算子,action算子(actions)返回结果,transformation算子(transformations)返回一个新RDD。我们先来看一下action算子: scala> textFile.count() // Number of items in this RDD res0: Long = 126 scala> textFile.first() // First item in this RDD res1: String = # Apache Spark 再来看下如何使用transformation算子。我们利用filter这个transformation算子返回一个只包含原始文件子集的新RDD。 scala> val linesWithSpark = textFile.filter(line => line.contains("Spark")) linesWithSpark: spark.RDD[String] = spark.FilteredRDD@7dd4af09 把这两个例子串起来,我们可以这样写: scala> textFile.filter(line => line.contains("Spark")).count() // How many lines contain "Spark"? res3: Long = 15 更多RDD算子 RDD action 和 transformation 算子可以做更加复杂的计算。下面的代码中,我们将找出文件中包含单词数最多的行有多少个单词: Scala Python scala> textFile.map(line => line.split(" ").size).reduce((a, b) => if (a > b) a else b) res4: Long = 15 首先,用一个map算子将每一行映射为一个整数,返回一个新RDD。然后,用reduce算子找出这个RDD中最大的单词数。map和reduce算组的参数都是scala 函数体(闭包),且函数体内可以使用任意的语言特性,或引用scala/java库。例如,我们可以调用其他函数。为了好理解,下面我们用Math.max作为例子: scala> import java.lang.Math import java.lang.Math scala> textFile.map(line => line.split(" ").size).reduce((a, b) => Math.max(a, b)) res5: Int = 15 Hadoop上的MapReduce是大家耳熟能详的一种通用数据流模式。而Spark能够轻松地实现MapReduce流程: scala> val wordCounts = textFile.flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey((a, b) => a + b) wordCounts: spark.RDD[(String, Int)] = spark.ShuffledAggregatedRDD@71f027b8 这个例子里,我使用了flatMap,map, andreduceByKey这几个transformation算子,把每个单词及其在文件中出现的次数转成一个包含(String,int)键值对的RDD,计算出每个单词在文件中出现的次数 scala> wordCounts.collect() res6: Array[(String, Int)] = Array((means,1), (under,2), (this,3), (Because,1), (Python,2), (agree,1), (cluster.,1), ...) 缓存 Spark同样支持把数据集拉到集群范围的内存缓存中。这对于需要重复访问的数据非常有用,比如:查询一些小而”热“(频繁访问)的数据集 或者 运行一些迭代算法(如 PageRank)。作为一个简单的示例,我们把 linesWithSpark 这个数据集缓存一下: Scala Python scala> linesWithSpark.cache() res7: spark.RDD[String] = spark.FilteredRDD@17e51082 scala> linesWithSpark.count() res8: Long = 19 scala> linesWithSpark.count() res9: Long = 19 用Spark来缓存一个100行左右的文件,看起来确实有点傻。但有趣的是,同样的代码可以用于缓存非常大的数据集,即使这些数据集可能分布在数十或数百个节点,也是一样。你可以用 bin/spark-shell 连到一个集群上来验证一下,更详细的请参考:programming guide. 独立的应用程序 假设我们想写一个独立的Spark应用程序。我们将快速的过一下一个简单的应用程序,分别用Scala(sbt编译),Java(maven编译)和Python。 Scala Java Python 首先用Scala新建一个简单的Spark应用 – 简单到连名字都叫SimpleApp.scala /* SimpleApp.scala */ import org.apache.spark.SparkContext import org.apache.spark.SparkContext._ import org.apache.spark.SparkConf object SimpleApp { def main(args: Array[String]) { val logFile = "YOUR_SPARK_HOME/README.md" // Should be some file on your system val conf = new SparkConf().setAppName("Simple Application") val sc = new SparkContext(conf) val logData = sc.textFile(logFile, 2).cache() val numAs = logData.filter(line => line.contains("a")).count() val numBs = logData.filter(line => line.contains("b")).count() println("Lines with a: %s, Lines with b: %s".format(numAs, numBs)) } } 注意,应用程序需要定义一个main方法,而不是继承scala.App。scala.App的子类可能不能正常工作。 这个程序,统计了Spark README文件中分别包含‘a’和’b’的行数。注意,你需要把YOUR_SPARK_HOME换成你的Spark安装目录。与之前用spark-shell不同,这个程序有一个单独的SparkContext对象,我们初始化了这个SparkContext对象并将其作为程序的一部分。 我们把一个SparkConf对象传给SparkContext的构造函数,SparkConf对象包含了我们这个应用程序的基本信息和配置。 我们的程序需要依赖Spark API,所以我们需要包含一个sbt配置文件,simple.sbt,在这个文件里,我们可以配置Spark依赖项。这个文件同时也添加了Spark本身的依赖库: name := "Simple Project" version := "1.0" scalaVersion := "2.10.5" libraryDependencies += "org.apache.spark" %% "spark-core" % "1.6.0" 为了让sbt能正常工作,我们需要一个典型的目录结构来放SimpleApp.scala和simple.sbt程序。一旦建立好目录,我们就可以创建一个jar包,然后用spark-submit脚本运行我们的代码。 # Your directory layout should look like this $ find . . ./simple.sbt ./src ./src/main ./src/main/scala ./src/main/scala/SimpleApp.scala # Package a jar containing your application $ sbt package ... [info] Packaging {..}/{..}/target/scala-2.10/simple-project_2.10-1.0.jar # Use spark-submit to run your application $ YOUR_SPARK_HOME/bin/spark-submit \ --class "SimpleApp" \ --master local[4] \ target/scala-2.10/simple-project_2.10-1.0.jar ... Lines with a: 46, Lines with b: 23 下一步 恭喜你!你的首个Spark应用已经跑起来了! 进一步的API参考,请看这里:Spark programming guide,或者在其他页面上点击“Programming Guides”菜单 如果想了解集群上运行应用程序,请前往:deployment overview 最后,Spark examples子目录下包含了多个示例,你可以这样来运行这些例子: # For Scala and Java, use run-example: ./bin/run-example SparkPi # For Python examples, use spark-submit directly: ./bin/spark-submit examples/src/main/python/pi.py # For R examples, use spark-submit directly: ./bin/spark-submit examples/src/main/r/dataframe.R 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark作业调度

Spark作业调度 概览 Spark有好几种计算资源调度的方式。首先,回忆一下集群模式概览(cluster mode overview)中每个Spark应用(包含一个SparkContext实例)中运行了一些其独占的执行器(executor)进程。集群管理器提供了Spark应用之间的资源调度(scheduling across applications)。其次,在各个Spark应用内部,各个线程可能并发地通过action算子提交多个Spark作业(job)。如果你的应用服务于网络请求,那这种情况是很常见的。在Spark应用内部(对应同一个SparkContext)各个作业之间,Spark默认FIFO调度,同时也可以支持公平调度(fair scheduler)。 Spark应用之间的资源调度 如果在集群上运行,每个Spark应用都会获得一批独占的执行器JVM,来运行其任务并存储数据。如果有多个用户共享集群,那么会有很多资源分配相关的选项,如何设置还取决于具体的集群管理器。 对Spark所支持的各个集群管理器而言,最简单的资源分配,就是对资源静态划分。这种方式就意味着,每个Spark应用都是设定一个最大可用资源总量,并且该应用在整个生命周期内都会占住这些资源。这种方式在Spark独立部署(standalone)和YARN调度,以及Mesos粗粒度模式(coarse-grained Mesos mode)下都可用。 Standalone mode:默认情况下,Spark应用在独立部署的集群中都会以FIFO(first-in-first-out)模式顺序提交运行,并且每个Spark应用都会占用集群中所有可用节点。不过你可以通过设置spark.cores.max或者spark.deploy.defaultCores 来限制单个应用所占用的节点个数。最后,除了可以控制对CPU的使用数量之外,还可以通过 spark.executor.memory 来控制各个应用的内存占用量。 Mesos:在Mesos中要使用静态划分的话,需要将 spark.mesos.coarse 设为true,同样,你也需要设置 spark.cores.max 来控制各个应用的CPU总数,以及 spark.executor.memory 来控制各个应用的内存占用。 YARN:在YARN中需要使用 –num-executors 选项来控制Spark应用在集群中分配的执行器的个数,对于单个执行器(executor)所占用的资源,可以使用 –executor-memory 和 –executor-cores 来控制。 Mesos上另一种可用的方式是动态共享CPU。在这种模式下,每个Spark应用的内存占用仍然是固定且独占的(仍由spark.executor.memory决定),但是如果该Spark应用没有在某个机器上执行任务的话,那么其他应用可以占用该机器上的CPU。这种模式对集群中有大量不是很活跃应用的场景非常有效,例如:集群中有很多不同用户的Spark shell session。但这种模式不适用于低延迟的场景,因为当Spark应用需要使用CPU的时候,可能需要等待一段时间才能取得CPU的使用权。要使用这种模式,只需要在 mesos:// URL 上设置 spark.mesos.coarse 属性为flase即可。 注意,目前还没有任何一种资源分配模式能支持跨Spark应用的内存共享。如果你需要跨Spark应用共享内存,我们建议你用单独用一个server来计算和保留同一个RDD查询的结果,这样就能在多个请求(request)之间共享同一个RDD的数据。在未来的发布版本中,一些内存存储系统(如:Tachyon)或许能够提供这种跨Spark应用共享RDD的能力。 动态资源分配 Spark还提供了一种基于负载来动态调节Spark应用资源占用的机制。这意味着,你的应用会在资源空闲的时候将其释放给集群,而后续用到的时候再重新申请。这一特性在多个应用共享Spark集群资源的情况下特别有用。 注意,这个特性默认是禁用的,但是在所有的粗粒度集群管理器上都是可用的,如:独立部署模式(standalone mode),YARN模式(YARN mode)以及Mesos粗粒度模式(Mesos coarse-grained mode)。 配置和部署 要使用这一特性有两个前提条件。首先,你的应用必须设置 spark.dynamicAllocation.enabled 为 true。其次,你必须在每个节点上启动一个外部混洗服务(external shuffle service),并在你的应用中将 spark.shuffle.service.enabled 设为true。外部混洗服务的目的就是为了在删除执行器的时候,能够保留其输出的混洗文件(本文后续有更详细的描述)。启用外部混洗的方式在各个集群管理器上各不相同: 在Spark独立部署的集群中,你只需要在worker启动前设置 spark.shuffle.server.enabled 为true即可。 在Mesos粗粒度模式下,你需要在各个节点上运行 ${SPARK_HOME}/sbin/start-mesos-shuffle-service.sh 并设置 spark.shuffle.service.enabled 为true 即可。例如,你可以用Marathon来启用这一功能。 在YARN模式下,混洗服务需要按以下步骤在各个NodeManager上启动: 首先按照YARN profile构建Spark。如果你已经有打好包的Spark,可以忽略这一步。 找到 spark-<version>-yarn-shuffle.jar。如果你是自定义编译,其位置应该在 ${SPARK_HOME}/network/yarn/target/scala-<version>,否则应该可以在 lib 目录下找到这个jar包。 将该jar包添加到NodeManager的classpath路径中。 配置各个节点上的yarn-site.xml,将 spark_shuffle 添加到 yarn.nodemanager.aux-services 中,然后将 yarn.nodemanager.aux-services.spark_shuffle.class 设为 org.apache.spark.network.yarn.YarnShuffleService,并将 spark.shuffle.service.enabled 设为 true。 最后重启各节点上的NodeManager。 所有相关的配置都是可选的,并且都在 spark.dynamicAllocation.* 和 spark.shuffle.service.* 命名空间下。更详细请参考:configurations page。 资源分配策略 总体上来说,Spark应该在执行器空闲时将其关闭,而在后续要用时再次申请。因为没有一个固定的方法,可以预测一个执行器在后续是否马上回被分配去执行任务,或者一个新分配的执行器实际上是空闲的,所以我们需要一些试探性的方法,来决定是否申请或移除一个执行器。 请求策略 一个启用了动态分配的Spark应用会在有等待任务需要调度的时候,申请额外的执行器。这种情况下,必定意味着已有的执行器已经不足以同时执行所有未完成的任务。 Spark会分轮次来申请执行器。实际的资源申请,会在任务挂起 spark.dynamicAllocation.schedulerBacklogTimeout 秒后首次触发,其后如果等待队列中仍有挂起的任务,则每过 spark.dynamicAlloction.sustainedSchedulerBacklogTimeout 秒触发一次资源申请。另外,每一轮所申请的执行器个数以指数形式增长。例如,一个Spark应用可能在首轮申请1个执行器,后续的轮次申请个数可能是2个、4个、8个… … 。 采用指数级增长策略的原因有两个:第一,对于任何一个Spark应用如果只是需要多申请少数几个执行器的话,那么必须非常谨慎地启动资源申请,这和TCP慢启动有些类似;第二,如果一旦Spark应用确实需要申请很多个执行器的话,那么可以确保其所需的计算资源及时地增长。 移除策略 移除执行器的策略就简单多了。Spark应用会在某个执行器空闲超过 spark.dynamicAllocation.executorIdleTimeout 秒后将其删除。在绝大多数情况下,执行器的移除条件和申请条件都是互斥的,也就是说,执行器在有待执行任务挂起时,不应该空闲。 优雅地关闭执行器 非动态分配模式下,执行器可能的退出原因有执行失败或者相关Spark应用已经退出。不管是那种原因,执行器的所有状态都已经不再需要,可以丢弃掉。但在动态分配的情形下,执行器有可能在Spark应用运行期间被移除。这时候,如果Spark应用尝试去访问该执行器存储的状态,就必须重算这一部分数据。因此,Spark需要一种机制,能够优雅地关闭执行器,同时还保留其状态数据。 这种需求对于混洗操作尤其重要。混洗过程中,Spark执行器首先将map输出写到本地磁盘,同时执行器本身又是一个文件服务器,这样其他执行器就能够通过该执行器获得对应的map结果数据。一旦有某些任务执行时间过长,动态分配有可能在混洗结束前移除任务异常的执行器,而这些被移除的执行器对应的数据将会被重新计算,但这些重算其实是不必要的。 要解决这一问题,就需要用到一个外部混洗服务(external shuffle service),该服务在Spark 1.2引入。该服务在每个节点上都会启动一个不依赖于任何Spark应用或执行器的独立进程。一旦该服务启用,Spark执行器不再从各个执行器上获取shuffle文件,转而从这个service获取。这意味着,任何执行器输出的混洗状态数据都可能存留时间比对应的执行器进程还长。 除了混洗文件之外,执行器也会在磁盘或者内存中缓存数。一旦执行器被移除,其缓存数据将无法访问。这个问题目前还没有解决。或许在未来的版本中,可能会采用外部混洗服务类似的方法,将缓存数据保存在堆外存储中以解决这一问题。 Spark应用内部的资源调度 在指定的Spark应用内部(对应同一SparkContext实例),多个线程可能并发地提交Spark作业(job)。在本节中,作业(job)是指,由Spark action算子(如:collect)触发的一系列计算任务的集合。Spark调度器是完全线程安全的,并且能够支持Spark应用同时处理多个请求(比如:来自不同用户的查询)。 默认,Spark应用内部使用FIFO调度策略。每个作业被划分为多个阶段(stage)(例如:map阶段和reduce阶段),第一个作业在其启动后会优先获取所有的可用资源,然后是第二个作业再申请,再第三个……。如果前面的作业没有把集群资源占满,则后续的作业可以立即启动运行,否则,后提交的作业会有明显的延迟等待。 不过从Spark 0.8开始,Spark也能支持各个作业间的公平(Fair)调度。公平调度时,Spark以轮询的方式给每个作业分配资源,因此所有的作业获得的资源大体上是平均分配。这意味着,即使有大作业在运行,小的作业再提交也能立即获得计算资源而不是等待前面的作业结束,大大减少了延迟时间。这种模式特别适合于多用户配置。 要启用公平调度器,只需设置一下 SparkContext中spark.scheduler.mode 属性为 FAIR即可: val conf = new SparkConf().setMaster(...).setAppName(...) conf.set("spark.scheduler.mode", "FAIR") val sc = new SparkContext(conf) 公平调度资源池 公平调度器还可以支持将作业分组放入资源池(pool),然后给每个资源池配置不同的选项(如:权重)。这样你就可以给一些比较重要的作业创建一个“高优先级”资源池,或者你也可以把每个用户的作业分到一组,这样一来就是各个用户平均分享集群资源,而不是各个作业平分集群资源。Spark公平调度的实现方式基本都是模仿Hadoop Fair Scheduler来实现的。 默认情况下,新提交的作业都会进入到默认资源池中,不过作业对应于哪个资源池,可以在提交作业的线程中用SparkContext.setLocalProperty 设定 spark.scheduler.pool 属性。示例代码如下: // Assuming sc is your SparkContext variable sc.setLocalProperty("spark.scheduler.pool", "pool1") 一旦设好了局部属性,所有该线程所提交的作业(即:在该线程中调用action算子,如:RDD.save/count/collect 等)都会使用这个资源池。这个设置是以线程为单位保存的,你很容易实现用同一线程来提交同一用户的所有作业到同一个资源池中。同样,如果需要清除资源池设置,只需在对应线程中调用如下代码: sc.setLocalProperty("spark.scheduler.pool", null) 资源池默认行为 默认地,各个资源池之间平分整个集群的资源(包括default资源池),但在资源池内部,默认情况下,作业是FIFO顺序执行的。举例来说,如果你为每个用户创建了一个资源池,那么久意味着各个用户之间共享整个集群的资源,但每个用户自己提交的作业是按顺序执行的,而不会出现后提交的作业抢占前面作业的资源。 配置资源池属性 资源池的属性需要通过配置文件来指定。每个资源池都支持以下3个属性: schedulingMode:可以是FIFO或FAIR,控制资源池内部的作业是如何调度的。 weight:控制资源池相对其他资源池,可以分配到资源的比例。默认所有资源池的weight都是1。如果你将某个资源池的weight设为2,那么该资源池中的资源将是其他池子的2倍。如果将weight设得很高,如1000,可以实现资源池之间的调度优先级 – 也就是说,weight=1000的资源池总能立即启动其对应的作业。 minShare:除了整体weight之外,每个资源池还能指定一个最小资源分配值(CPU个数),管理员可能会需要这个设置。公平调度器总是会尝试优先满足所有活跃(active)资源池的最小资源分配值,然后再根据各个池子的weight来分配剩下的资源。因此,minShare属性能够确保每个资源池都能至少获得一定量的集群资源。minShare的默认值是0。 资源池属性是一个XML文件,可以基于 conf/fairscheduler.xml.template 修改,然后在SparkConf的 spark.scheduler.allocation.file 属性指定文件路径: conf.set("spark.scheduler.allocation.file", "/path/to/file") 资源池XML配置文件格式如下,其中每个池子对应一个<pool>元素,每个资源池可以有其独立的配置: <?xml version="1.0"?> <allocations> <pool name="production"> <schedulingMode>FAIR</schedulingMode> <weight>1</weight> <minShare>2</minShare> </pool> <pool name="test"> <schedulingMode>FIFO</schedulingMode> <weight>2</weight> <minShare>3</minShare> </pool> </allocations> 完整的例子可以参考 conf/fairscheduler.xml.template。注意,没有在配置文件中配置的资源池都会使用默认配置(schedulingMode:FIFO,weight:1,minShare:0)。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》集群模式概览

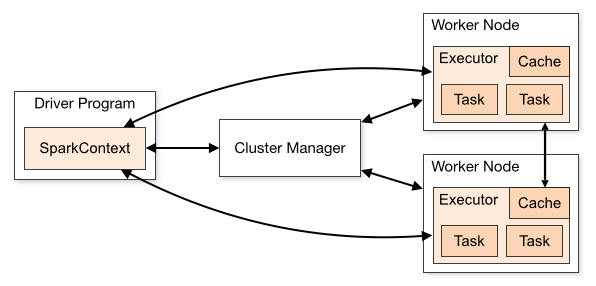
集群模式概览 本文简要描述了Spark在集群中各个组件如何运行。想了解如何在集群中启动Spark应用,请参考application submission guide。 组件 Spark应用在集群上运行时,包括了多个独立的进程,这些进程之间通过你的主程序(也叫作驱动器,即:driver)中的SparkContext对象来进行协调。 特别要指出的是,SparkContext能与多种集群管理器通信(包括:Spark独立部署时自带的集群管理器,Mesos或者YARN)。一旦连接上集群管理器,Spark会为该应用在各个集群节点上申请执行器(executor),用于执行计算任务和存储数据。接下来,Spark将应用程序代码(JAR包或者Python文件)发送给所申请到的执行器。最后SparkContext将分割出的任务(task)发送给各个执行器去运行。 这个架构中有几个值得注意的地方: 每个Spark应用程序都有其对应的多个执行器进程,执行器进程在整个应用程序生命周期内,都保持运行状态,并以多线程方式运行所收到的任务。这样的好处是,可以隔离各个Spark应用,从调度角度来看,每个驱动器可以独立调度本应用程序内部的任务,从执行器角度来看,不同的Spark应用对应的任务将会在不同的JVM中运行。然而这种架构同样也有其劣势,多个Spark应用程序之间无法共享数据,除非把数据写到外部存储中。 Spark对底层的集群管理器一无所知。只要Spark能申请到执行器进程,并且能与之通信即可。这种实现方式可以使Spark相对比较容易在一个支持多种应用的集群管理器上运行(如:Mesos或YARN) 驱动器(driver)程序在整个生命周期内必须监听并接受其对应的各个执行器的连接请求(参考:spark.driver.port and spark.fileserver.port in the network config section)。因此,驱动器程序必须能够被所有worker节点访问到。 因为集群上的任务是由驱动器来调度的,所以驱动器应该和worker节点距离近一些,最好在同一个本地局域网中。如果你需要远程对集群发起请求,最好还是在驱动器节点上启动RPC服务,来响应这些远程请求,同时把驱动器本身放在集群worker节点比较近的机器上。 集群管理器类型 Spark支持以下3中集群管理器: Standalone– Spark自带的一个简单的集群管理器,这使得启动一个Spark集群变得非常简单。 Apache Mesos– 一种可以运行Hadoop MapReduce或者服务型应用的通用集群管理器。 Hadoop YARN– Hadoop 2的集群管理器。 另外,使用Spark的EC2 launch scripts可以轻松地在Amazon EC2上启动一个独立集群。 提交Spark应用 利用spark-submit脚本,可以向Spark所支持的任意一种集群提交应用。详见:application submission guide 监控 每一个驱动器(driver)都有其对应的web UI,默认会绑定4040端口(多个并存会按顺序绑定4041、4042…),这个web UI会展示该Spark应用正在运行的任务(task)、执行器(executor)以及所使用的存储信息。只需在浏览器种打开http://<driver-node>:4040即可访问。monitoring guide详细描述了其他监控选项。 作业调度 Spark可以在应用程序之间(集群管理器这一层面)和之内(如:同一个SparkContext对象运行了多个计算作业)控制资源分配。job scheduling overview描述了更详细的信息。 概念和术语 下表简要说明了集群模式下的一些概念和术语: 术语 含义 Application(应用) Spark上运行的应用。包含了驱动器(driver)进程(一个)和集群上的执行器(executor)进程(多个) Application jar(应用jar包) 包含Spark应用程序的jar包。有时候,用户会想要把应用程序代码及其依赖打到一起,形成一个“uber jar”(包含自身以及所有依赖库的jar包),注意这时候不要把Spark或Hadoop的库打进来,这些库会在运行时加载 Driver program(驱动器) 运行main函数并创建SparkContext的进程。 Cluster manager(集群管理器) 用于在集群上申请资源的 外部服务(如:独立部署的集群管理器、Mesos或者YARN) Deploy mode(部署模式) 用于区分驱动器进程在哪里运行。在”cluster”模式下,驱动器将运行在集群上某个节点;在”client“模式下,驱动器在集群之外的客户端运行。 Worker node(工作节点) 集群上运行应用程序代码的任意一个节点。 Executor(执行器) 在集群工作节点上,为某个应用启动的工作进程;专门用于运行计算任务,并在内存或磁盘上保存数据。每个应用都独享其对应的多个执行器。 Task(任务) 下发给执行器的工作单元。 Job(作业) 一个并行计算作业,由一组任务(Task)组成,并由Spark的行动(action)算子(如:save、collect)触发启动;你会在驱动器日志中看到这个术语。 Stage(步骤) 每个作业(Job)可以划分为更小的任务(Task)集合,这就是步骤(Stage),这些步骤彼此依赖形成一个有向无环图(类似于MapReduce中的map和reduce);你会在驱动器日志中看到这个术语。 转载自并发编程网 - ifeve.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册