首页 文章 精选 留言 我的

精选列表

搜索[workbuddy],共4520篇文章
优秀的个人博客,低调大师

用 WorkBuddy 从零做一个 PWA 黄金记账 App:62 笔备忘录数据、三种盈亏算法与 8 个真实踩坑

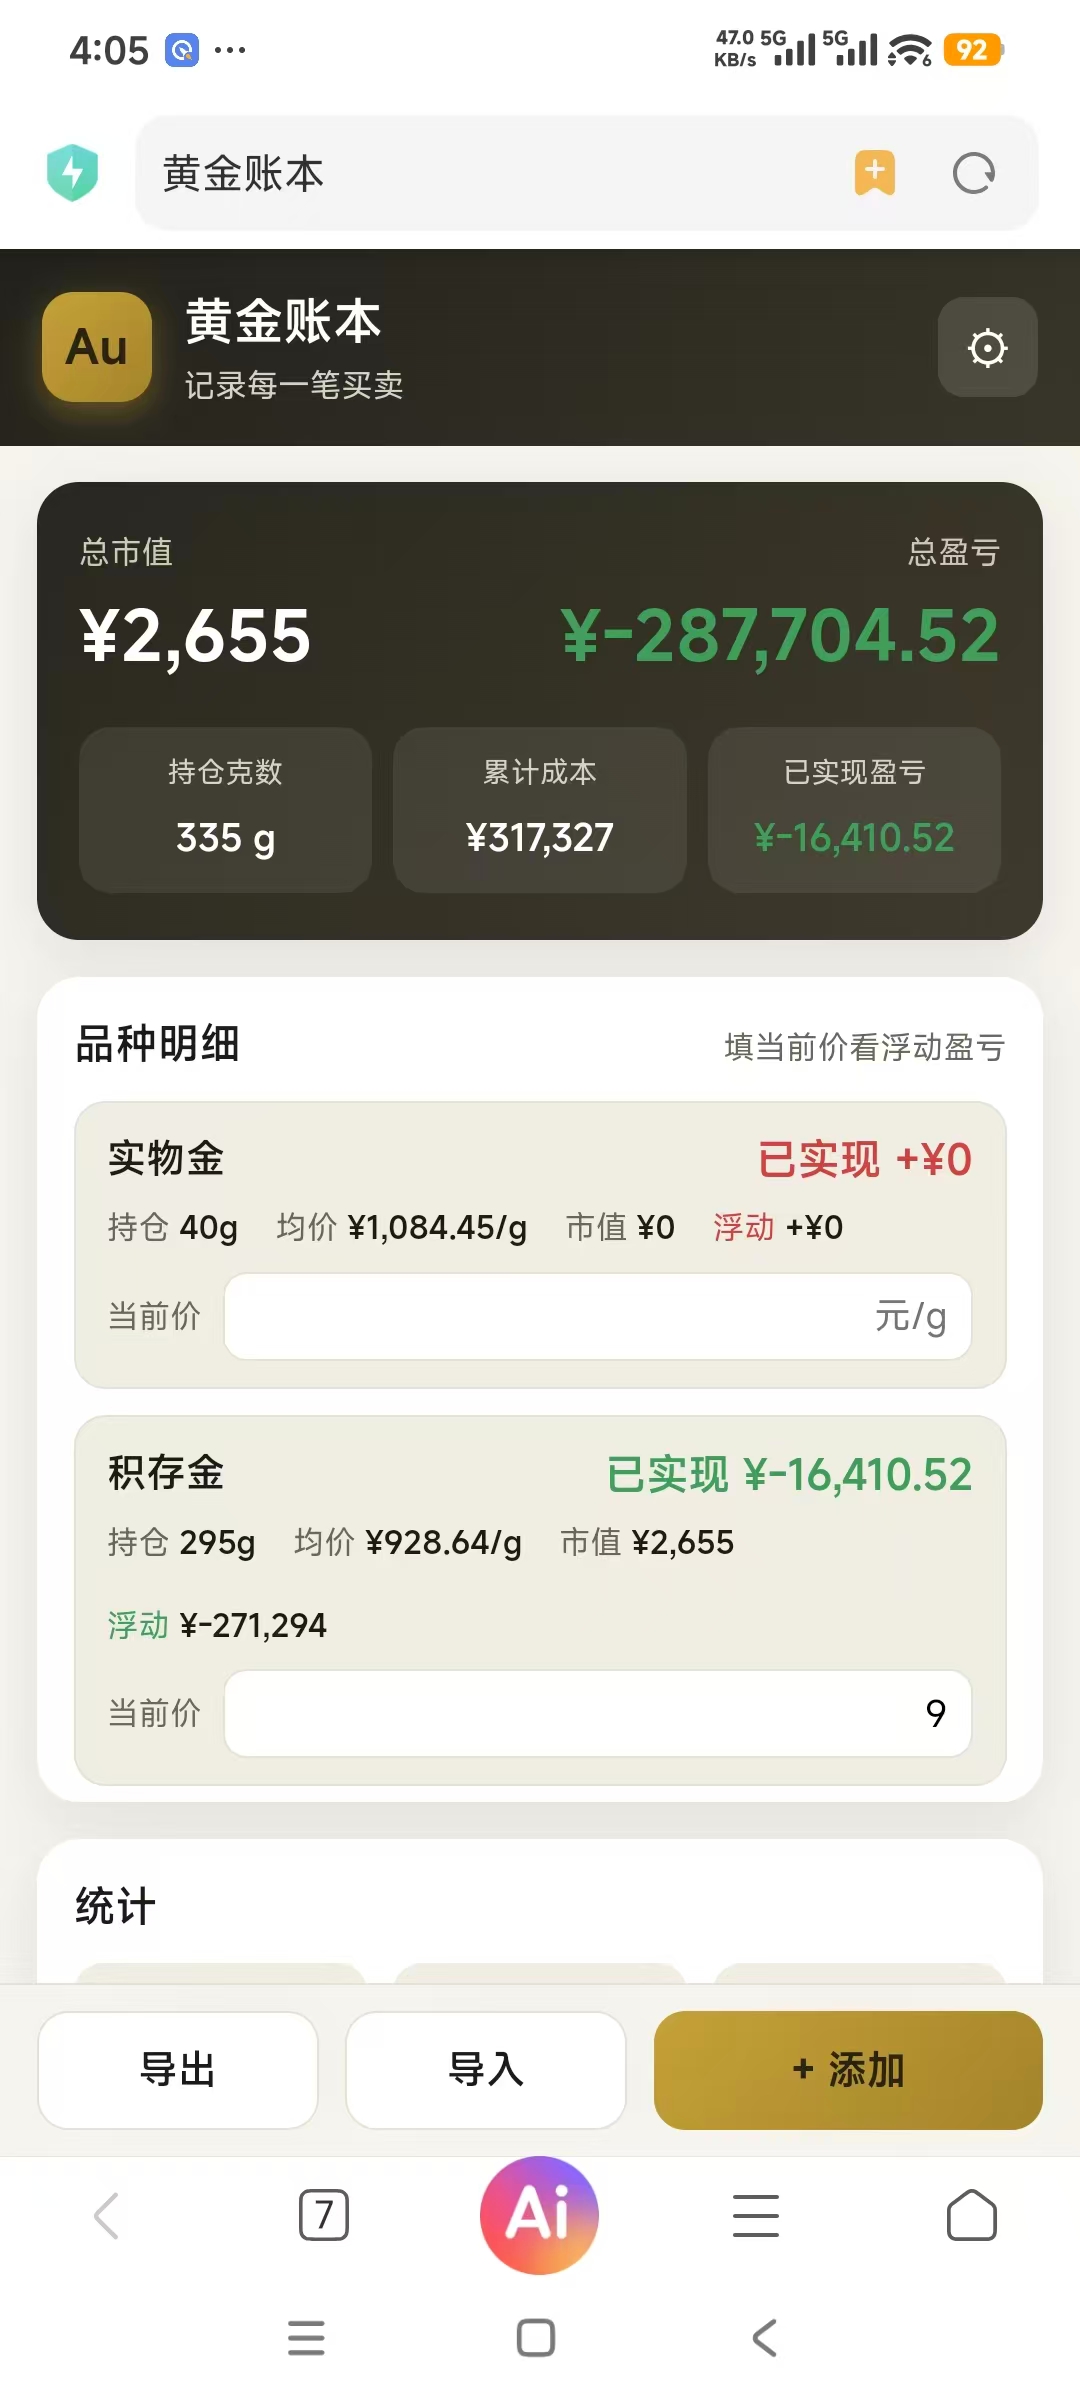
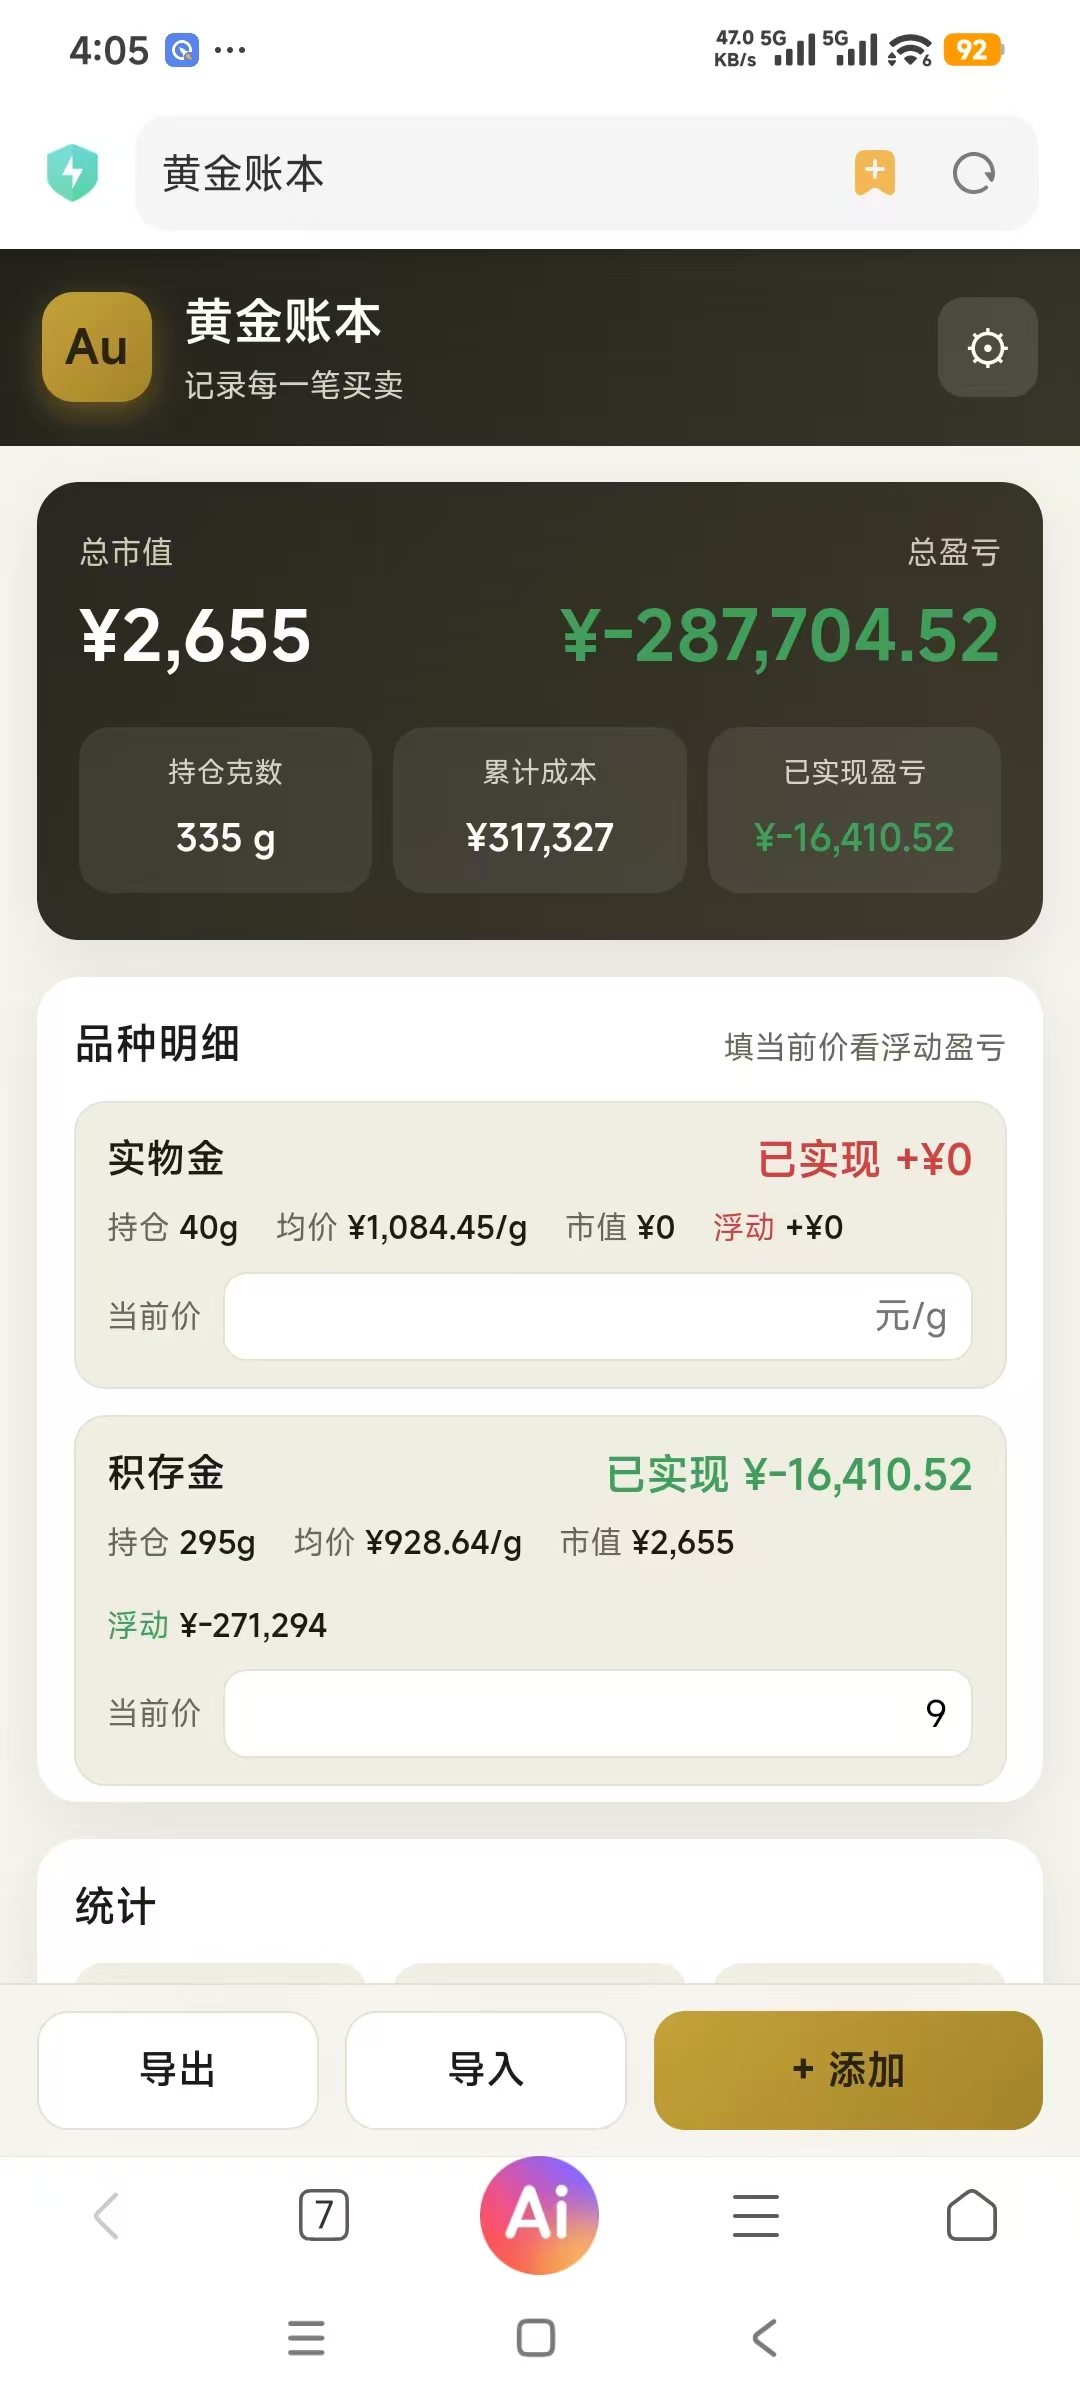
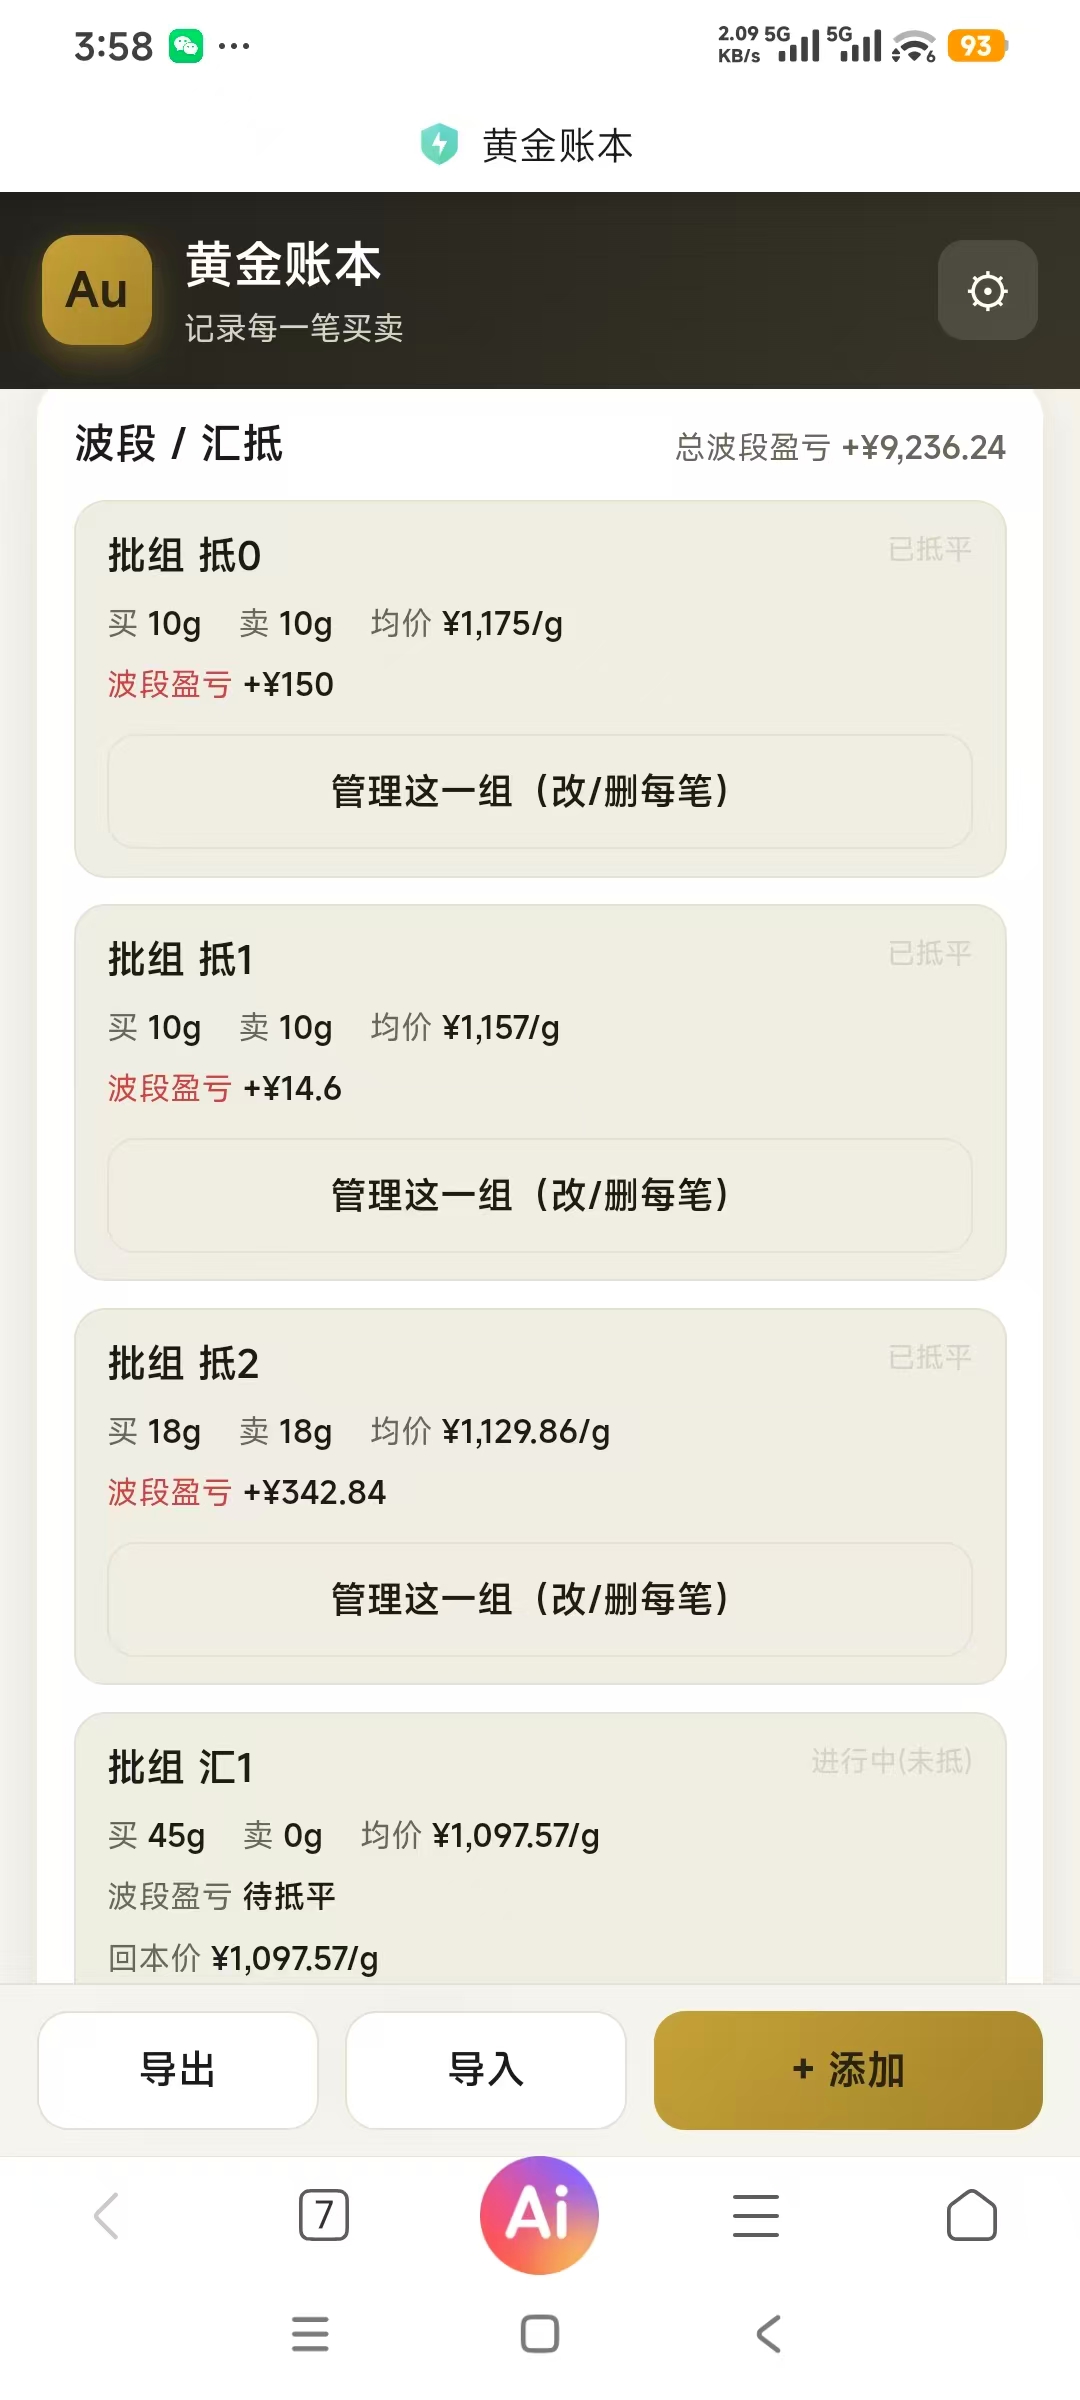
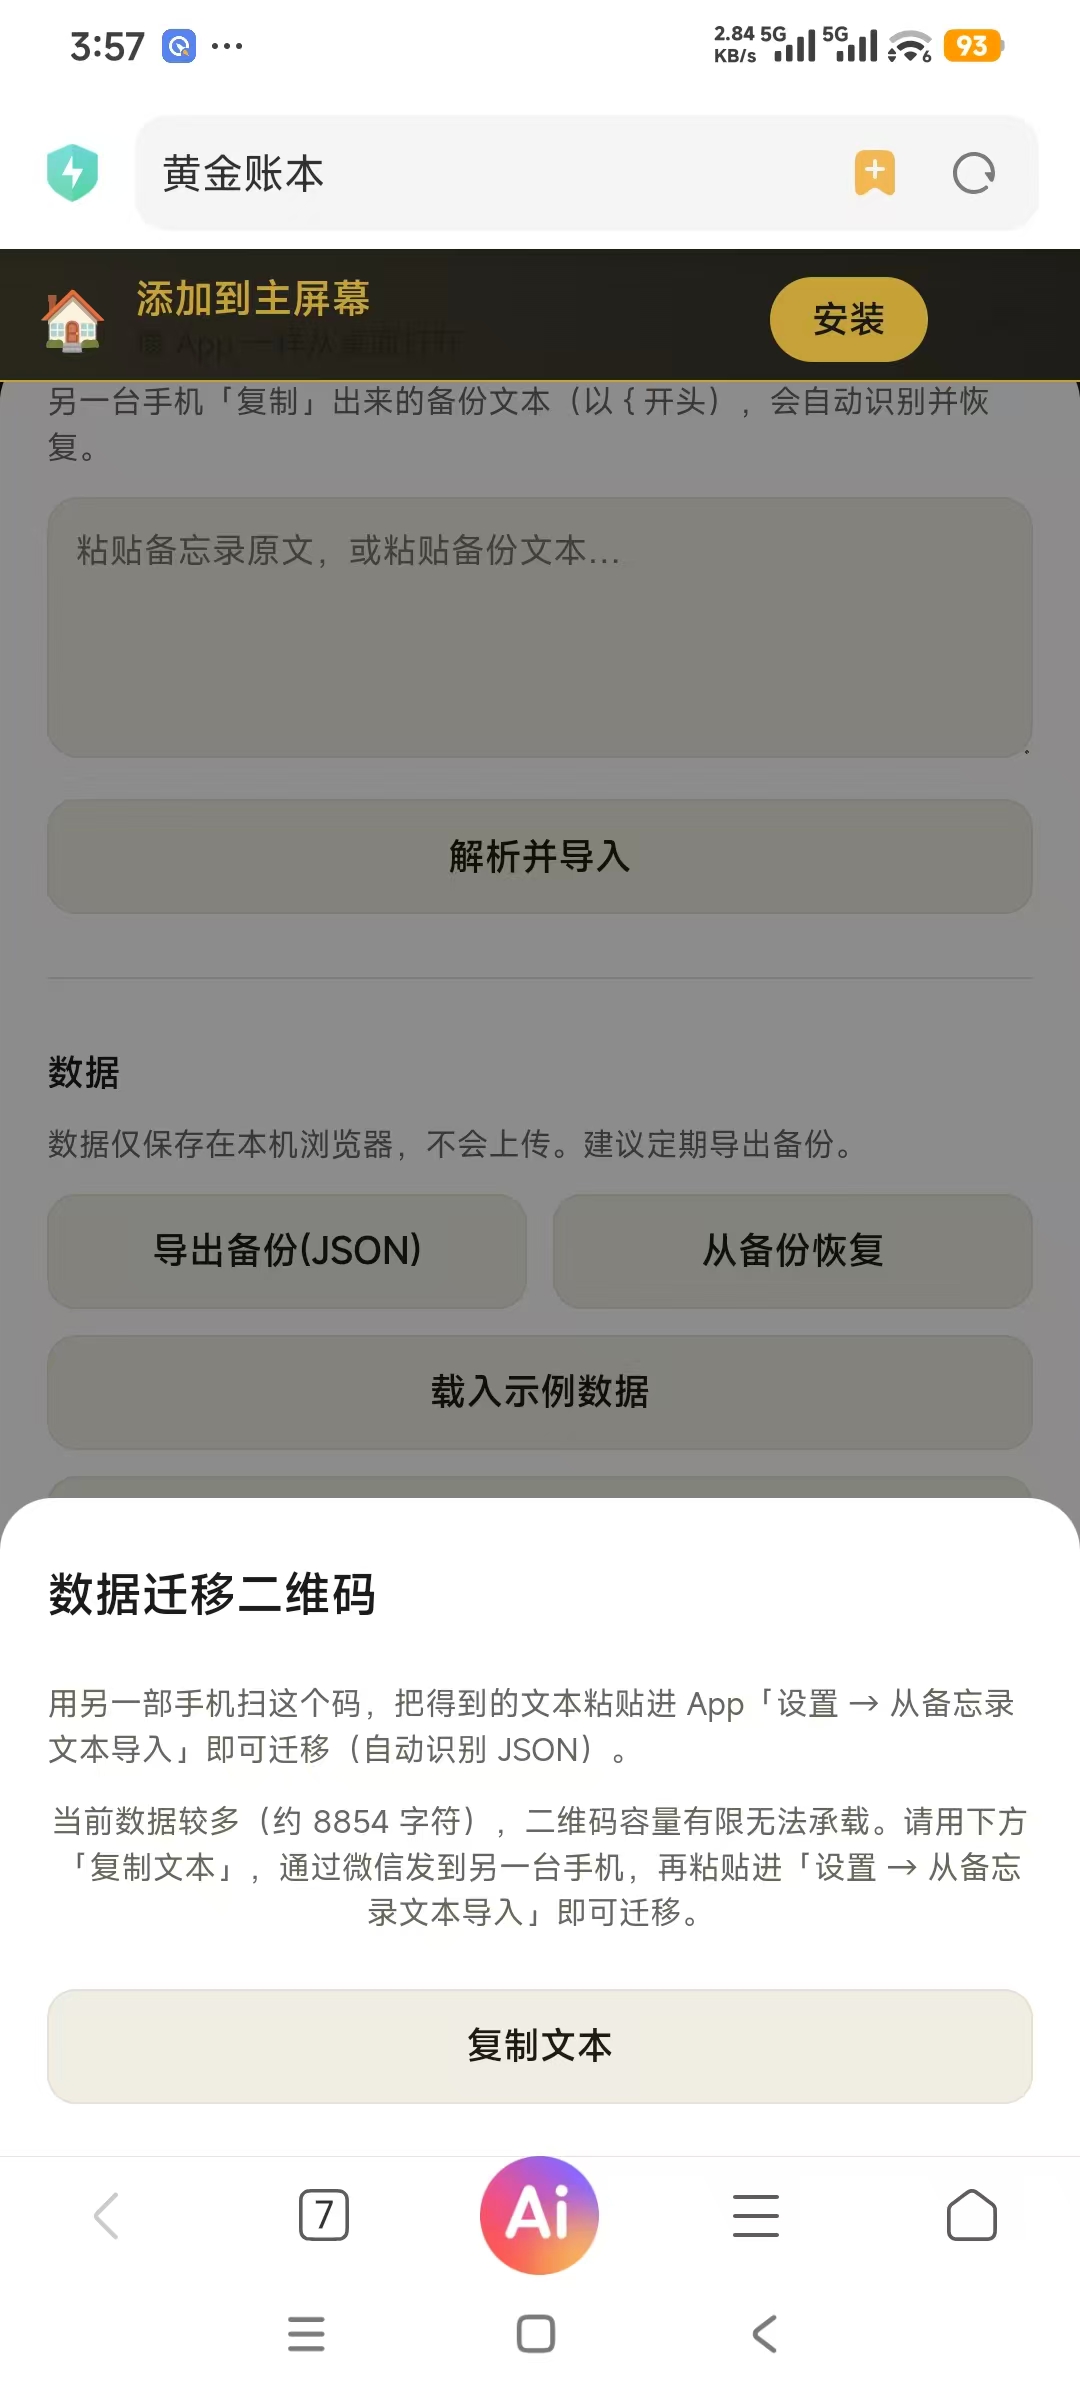
一切的起点,是手机备忘录里一份密密麻麻的黄金买卖记录。 ![](https://developer.qcloudimg.com/http-save/yehe-12825227/2eaa6251051bfe2114af903606635dc2.jpg) ## 一、起因:一份读不懂的备忘录 朋友手机备忘录里记了两年多的黄金买卖,长这样: 有日期、有价格、有克数、有自己手算的盈亏,还有一堆看不懂的「抵3」「汇1」。 需求很朴素:**做个手机 App 专门记这个**。但要真做成,得先把三件事聊明白。 ### 1.1 盈亏到底怎么算? 这是第一个分歧点。同样一批买卖,算法不同,数字能差出几千块。最终做了**三种并存、可随时切换**: |算法|逻辑|适合谁| | --- | --- | --- | |移动加权平均|每次买入后重算持仓均价,卖出按当前均价算盈亏|长期持有、看整体成本| |先进先出 FIFO|卖出时按最早的买入批次配对|波段、想知道"这波赚了多少"| |手动对应批次|卖出时自己指定对应哪几笔买入|精细化核对| ### 1.2 手续费要不要单独记? 答案是**不记**。因为记录时手续费已经折算进金价了,再单列一个字段只会造成重复计算。**需求里看起来"应该有"的功能,有时候恰恰不该做。** ### 1.3 「汇」和「抵」是什么? 这是整个项目最有意思的部分。朋友做波段有自己的一套黑话: - **汇 N**:把连续几天买入的黄金汇总,算出一个均价 - **抵 N**:后面卖出把这组抵平,算出这一波的短期盈利 - **未抵**:买入价太高被挂住了,还没卖出去 比如「汇1」汇总出 45 克、均价 1097.57;「抵3」卖掉后盈利 300。这些是**人家的真实工作流**,不是通用的金融概念。App 要好用,就得把这个习惯做进去,而不是让人来适应软件。 --- ## 二、技术选型:为什么是 PWA 需求里有两个硬约束:**手机上要像 App 一样打开**、**数据不能上传**。 原生 App 开发成本高、还要装包;纯网页又没法"添加到桌面"。PWA 正好卡在中间: - `manifest.webmanifest` + `sw.js`,安卓和 iOS 都能添加到主屏幕 - 数据全在 `localStorage`,没有服务器,天然不上传 - 静态文件部署,改一行代码刷新就能看到 --- ## 三、核心实现 ### 3.1 数据模型 一笔交易长这样: `group` 字段是整个「汇/抵」功能的支点——有了它,才能按组算均价、算波段盈亏、判断抵没抵平。 ### 3.2 三种算法的统一抽象 三种算法共用一套 `lots`(批次)模型,区别只在于**卖出时怎么挑批次**: 按品种各自维护 lots,所以「积存金」和「实物金」的盈亏互不干扰。 ### 3.3 批组(汇/抵)的自动计算 对每一组,算四件事: 再加两个实用提示:**回本价**(= 组均价),以及按当前金价算的**浮亏/浮盈**。 ### 3.4 从备忘录文本解析数据 62 笔手工录入不现实,所以写了个解析器,把备忘录原文直接变成结构化数据: 解析完做了交叉验证——**App 算出来的盈亏和朋友自己手算的逐条对上了**: |批组|手算|App 计算| | --- | --- | --- | |抵0|150|150.00| |抵3|300|300.00| |抵5|397.4|397.40| |汇1(45克)|均价 1097|1097.57| ![](https://developer.qcloudimg.com/http-save/yehe-12825227/5ccbc90f26a650af6fa646cd6de5ddd6.jpg) --- ## 四、8 个真实踩坑(重点) 这部分比实现本身值钱。 ### 坑 1:`String.replace` 把 `$'` 当成了特殊符号 为了生成一个"双击就能打开"的单文件 HTML,需要把 CSS/JS 内联进去。最初这么写: 结果整页 JS 报错。原因是 **JS 的 `String.replace` 里,`$'` 表示"匹配之后的所有内容"**——脚本里恰好有这个字符组合,于是 `` 被注入进了 `` 里。 修法是**永远用函数式替换**: ### 坑 2:Service Worker 让用户永远看到旧版本 最早 `sw.js` 用的是「缓存优先」+ 固定缓存名 `gold-ledger-v1`。改完代码重新部署,用户打开**还是旧页面**。 三处整改: 1. 缓存名升级到 `v2`,fetch 策略改成**在线优先、失败回退缓存** 1. `activate` 时给页面发消息,检测到新 SW 就**自动重载一次**(用 `sessionStorage` 防抖,避免刷新死循环) 1. 设置里加一个**「强制刷新 / 检查更新」**按钮,注销 SW + 清空缓存 + 带时间戳重载 ### 坑 3:红米手机上价格只能输入个位数 用户反馈"金价怎么可能只有个位数"。真机截图里那个输入框带着 `type="number"` 的上下箭头——**小米浏览器对 `type="number"` 有兼容 bug**,会限制位数或吞掉后续输入。 改成文本类型 + 数字键盘,问题解决: ### 坑 4:红米浏览器里找不到「添加到主屏幕」 小米自带浏览器把这个功能叫「添加到桌面」「添加书签 → 桌面快捷方式」,藏在「工具箱」里,名字和 Chrome 完全不一样。 加了**主动安装提示条**:捕获 `beforeinstallprompt` 事件显示一键安装按钮;不支持的浏览器则弹出针对红米的图文路径。 ### 坑 5:小数批组号被吞 备忘录里有「抵4.5」这个组,但正则 `([汇抵])\s*(\d+)` 只认整数,`.5` 被丢掉,**抵4.5 的两笔并进了抵4**。加上小数匹配才修好: ### 坑 6:批组号写在下一行 有些记录长这样——交易行没写组号,组号写在后面的「盈利」行里: 解法是**延迟回填**:解析时把缺组号的交易记进 `pending`,遇到「盈利…抵N」行再回填上去。 ### 坑 7:导入去重导致改过的数据同步不过来 原逻辑是「id 已存在就跳过」。问题来了:在电脑上改了一笔,再同步到手机,**改动丢了**。 改成**同 id 覆盖更新**。但备忘录解析出的 id 是 `memo_1`、`memo_2`… 会互相覆盖,所以备忘录路径改用**内容指纹**去重(时间+买卖+价格+克数+品种),同一段粘两次不会翻倍,不同段也不会打架。 ### 坑 8:jsdom 测试自己去线上拉了旧代码 写自动化测试时用 `resources: 'usable'` + 真实线上 URL,结果 jsdom 把**已部署的旧版 app.js** 拉下来覆盖了本地内联代码,断言莫名其妙失败。 改成只用本地内联脚本后稳定了。**测试环境不要联网拉被测对象。** --- ## 五、上线与数据迁移 部署的是**不含任何数据的空壳**,用户数据始终在设备本地。换手机迁移走这条路: 1. 电脑上导出备份 JSON(或生成迁移二维码) 1. 微信发到手机 1. 手机端「设置 → 导入」粘贴 这里还有个意外:二维码最大容量约 2.9 KB,而 62 笔数据有 12 KB,**装不下**。所以做了降级——大数据自动切换成「复制文本」,走微信转发再粘贴,体验一样顺。 ![](https://developer.qcloudimg.com/http-save/yehe-12825227/2ab7607e1d9fc1ffe227bf58b42b9f02.jpg) --- ## 六、写在最后 几个复盘: 1. **先问清楚再动手**。光"盈亏怎么算"就聊了三轮,如果直接按自己的想法做,做完一定是错的。 1. **尊重用户原有的工作流**。「汇/抵」不是标准金融术语,但那是人家多年习惯,做进去了 App 才有人用。 1. **"应该有"的功能未必该做**。手续费字段看着合理,实际会造成重复计算。 1. **真机比什么都重要**。前面 8 个坑,有 4 个只有在真手机上才会暴露。 ![](https://developer.qcloudimg.com/http-save/yehe-12825227/6c47b9b856fc82f2e08d525af0d9be8a.jpg) 最终交付:一个能添加到手机桌面的离线 App,62 笔真实数据(2025-12-22 至 2026-09-11),三种盈亏算法可切换,本地存储不上传。 --- **附录:技术栈** - 纯原生 HTML/CSS/JS,无框架无构建工具 - Canvas 手绘盈亏走势图(红涨绿跌,符合国内习惯) - localStorage 持久化,键 `gold_ledger_v1` - PWA:manifest + service worker - 测试:jsdom 无头测试,覆盖解析、编辑、迁移、批组四个模块
优秀的个人博客,低调大师

不用 Gradle ,用WorkBuddy手搓一个无广告安卓万年历 App:数据生成、APK 打包、在线热更新全记录

手机上的万年历 App 广告满天飞,滑动两下弹一个,误触就下载。一气之下自己做了一个:**零广告、离线可用、内置 1990–2049 完整农历黄历,还带在线热更新**。本文记录全部制作过程和踩坑,源码在文末打包下载。 📢 **本项目持续更新中**:黄历详情、纪念日提醒、天气等更多功能正在陆续上线,已安装的用户点 App 内的「检查更新」即可自动升级,无需重新下载安装包。 ## 零、如何安装使用 **方式一:安卓直接装 APK(推荐)** 1. 下载文末打包里的 `万年历.apk` 到安卓手机(微信「文件传输助手」即可); 1. 点击安装,系统提示「未知来源」时点「设置」→ 允许该来源安装; 1. 桌面出现图标,点开即用——**离线可用、全程零广告**。 **方式二:网页版 + 添加到主屏幕(iPhone 也能用)** 用手机浏览器打开 `万年历.html`(或分享的在线链接)→ 点浏览器菜单里的「添加到主屏幕」,即可像 App 一样全屏使用,同样零广告。 **更新说明**:App 内置「检查更新」按钮,新功能上线后点一下自动下载最新版,热更新无需重装。 ## 一、成品功能 - 公历/农历双历对照,初一自动显示月名(正月、冬月、腊月…) - 每日黄历:宜/忌、干支(年柱+日柱)、生肖、星座、值星、冲煞 - 24 节气标绿、传统节日+公历节日标红 - 法定节假日「休/班」角标(内置国务院 2024–2026 官方安排,含调休上班日) - 周末整列标红、长节日名自动两行显示 - 农历转公历查询(含闰月处理) - 在线热更新:新增功能后点「检查更新」自动升级,不用重装 APK - 全程离线可用,安装包仅 652KB ## 二、总体架构 整个项目分三层,每一层都可以独立替换: ``` ```这个架构最大的好处:**以后加新功能只改 HTML,版本号 +1,用户点一下「检查更新」就完成升级,完全不用重新发安装包**。 ## 三、第一步:生成 60 年黄历数据 黄历宜忌自己算不现实(涉及建除十二神、神煞等复杂规则),直接用现成的历法库 `lunar-python`(作者 6tail,和主流万年历 App 同源算法): ``` ```写个脚本从 1990 年 1 月 1 日循环到 2049 年 12 月 31 日,每天提取 9 个字段,压成紧凑 JSON(约 3.5MB)。两个细节: 1. **闰月**:`l.getMonth()` 返回负数表示闰月,比如 -2 = 闰二月; 1. **年干支/生肖**单独存一张年表,避免每天重复存。 生成 21915 天数据,内存里排序后一次性输出: ``` ```## 四、第二步:单文件 HTML 万年历 界面上是纯手写的月历:CSS Grid 七列布局,每天一个格子,上行公历大字(周末红)、下行农历(初一显示月名、节气绿色、节日红色)。点格子下方卡片显示完整黄历。 几个值得说的点: - **法定节假日「休/班」角标**:官方每年 11 月才公布次年安排,所以把国务院通知的放假区间 + 调休上班日写成数据,启动时展开成按天的字典: ``` ```- **长节日名两行显示**:`-webkit-line-clamp: 2`,像「万圣节前夕」「世界住房日」不会被截断; - **农历转公历**:直接在数据数组里反查 `lm/ld` 匹配项,索引 + 1 就是公历一年中的第几天。 ## 五、第三步:不用 Gradle,手动打包 APK 环境里没有 Android Studio,也不想拉几百 MB 的 Gradle 依赖。发现 build-tools 里那几个命令行工具就是打包的全部,于是纯手工: ``` ```完整命令(SDK 从腾讯云镜像下载,见踩坑一): ``` ```壳的 Java 代码只有一个 Activity,核心就十几行: ``` ```**注意事项**:zipalign 必须在签名之前(v2/v3 签名会锁定文件布局);`resources.arsc` 必须保持未压缩存储(targetSdk 30+ 的硬性要求,zipalign -c 4 可以自检)。 ## 六、第四步:在线热更新 原理简单到离谱——找一个稳定的 HTTPS 地址放两个文件: ``` ```App 启动 2 秒后(避开启动竞争)静默请求 version.json,远程版本号 > 本地内置版本号就下载新 HTML 覆盖到 `getFilesDir()`,下次启动(或点「检查更新」立即)加载新版: ``` ```网页底部再放一个「检查更新」按钮,通过 `addJavascriptInterface` 反调 Native,用户可以手动触发。**从此改功能 = 改 HTML + version.json 加一,全平台用户一键升级。** ## 七、踩坑实录(全是真金白银的时间) **坑 1:dl.google.com / github 全被墙。** Android SDK 官方源拉不动,最后从腾讯云镜像 `mirrors.cloud.tencent.com/AndroidSDK/` 拿的 platform-33 和 build-tools。注意镜像目录名是 `android-13`(Android 13 = API 33),不是 `android-33`。 **坑 2:Gradle 9.3 与 AGP 版本互斥。** 环境里自带的 Gradle 太新,而镜像只有 SDK 33 组件,AGP 版本对不上。索性放弃 Gradle,直接命令行工具链手搓——反而更透明可控。 **坑 3:图标中文变乱码小点。** PIL 画图标时默认字体不支持中文,「历」字画成了一个小方块。找到系统里的 NotoSansCJK-Bold.ttc 才正常,图标是渐变红底 + 挂历双环 + 竖排「万年历」。 **坑 4:覆盖安装失败,桌面图标永远不变。** 重新打包时无意中重新生成了签名密钥,新旧签名不同 → 系统静默拒绝覆盖安装。**教训:keystore 从第一天就要固定保存**,每版必须同一个。 **坑 5:闪退却拿不到日志。** 没接真机调试,最后在 Application.attachBaseContext 里装了全局 UncaughtExceptionHandler:崩溃时把异常写到屏幕 Toast 6 秒 + 落盘 crash.log,录屏即可拿到现场。这才定位到是旧版本号的问题。 **坑 6:新旧 APK 混淆。** 多次迭代后手机里存了三个同名 APK,装错文件排查半天。MT 管理器看「版本号」一眼辨别,比文件名靠谱。 ## 八、附件清单 | | | |:-:|:-:| |文件|说明| |万年历.apk|安装包(Android 7.0+,652KB)| |万年历.html|单文件网页版,浏览器直接打开| |src/|WebView 壳源码(MainActivity / App / Manifest)| |tools/gen_data.py|黄历数据生成脚本| |万年历制作过程-社区帖.md|本文档| ## 九、持续更新中 本项目还在持续迭代,规划中的功能包括: - 黄历详情页加吉神方位、彭祖百忌 - 纪念日/生日农历提醒 - 天气与穿衣建议 - 2027 年国务院放假安排公布后自动跟进(就是改一版数据的事) 所有更新都通过 App 内「检查更新」热更新下发,老用户点一下按钮即可获得新功能。

优秀的个人博客,低调大师

#WorkBuddy# AI 从一个人用变成一群人用,最先炸的从来不是模型,是权限和额度

![](https://developer.qcloudimg.com/http-save/yehe-12690655/d3cc681453b517eaf076cfbd9017d35c.png) 9 月 17 日,腾讯云把 Octop 开源到了 1.0 正式版:一条 `octop run` 就能起一套多用户、多智能体的 AI 助手,带 RAG 知识库和知识库专家,给了 Mac/Windows/Linux 桌面客户端,做了页面级和功能级的权限控制、Token 额度管控,每个专家还跑在沙箱隔离里,官方镜像直接挂在 Lighthouse 和 CVM 上。 我把这条新闻从头看到尾,真正让我停下来的是三个词:**权限、额度、沙箱**。 因为这三个词,恰好是我把 AI 从「自己一个人用」变成「一堆人一起用」之后,最先挨的三个耳光。 一个人用 AI 的时候,你压根不会想到权限。账号就一个,资料就一份,账单只有你在看。等你要把它交出去给同事一起用,问题当场就变样了:有人只是想查个文档,你却把整套内部资料都挂上去了;有人丢了个「帮我整理下这几千条记录」的任务进去,一晚上把月度额度烧穿;最麻烦的是第三种——agent 是能自己动手执行的,它误操作的那一下,没有人拦得住。 我自己的做法,是从「共享一个账号」退回到「按用途拆账号」的。这中间踩的坑挺值钱:共享账号那阵子,有一份还没定稿的资料被另一个人的助手当成了正式版本拿去回答问题,答案是错的,语气还特别笃定——因为对模型来说,它拿到的就是「知识库里的文件」,它分不出草稿和定稿的区别。后来我把知识库按用途切开,每个账号只挂自己那一份,问题当场消失了。额度也一样,以前是全组共用一条线,现在是按人按用途设上限,谁快烧完了提前知道,而不是月底看账单发懵。 再多说一句,这条建议先收藏:给团队上 AI 助手,选哪个模型永远是最后一步;前三个问题一定是——**谁能用、能用多少、出事谁负责**。这三条没定,工具再顺手也会出事。 我的判断是:自托管的门槛,早就不是「装不装得上」了。一条命令能部署的东西,真正难的从来不是部署,而是部署完之后那套规矩。开源把能力铺平了,也顺手把「权限治理」这件事从企业专属下降到了小团队的日常——这是好事,但也意味着你没法再拿「我们小,不讲究这些」当借口。 所以我不建议一上来就上自托管全家桶。理由不是它不好,是先上工具会把「规矩」这件事一直往后拖,直到出事那天才被迫补。顺序应该反过来:先把白名单、额度上限、危险动作的二次确认写在纸上,再挑工具。你觉得这三条里,哪一条最容易被团队忽略?还是说你们压根就没定过?

优秀的个人博客,低调大师

#WorkBuddy# 不能开 Excel、不能用 COM,怎么改 .xlsm 里的 VBA 宏?一次 MS-OVBA 二进制级修补实战

## 一、先说这是个什么坑 需求很朴素:一份带宏的业务模板 `.xlsm`,宏里有缺陷,要改。 难点在于环境给了三道锁: 1. **不能用 Excel/WPS 的 COM 自动化**。`New-Object -ComObject Excel.Application` 直接被安全策略拦截,报 `COM object instantiation can run arbitrary code`。也就是说"用脚本驱动 Excel 打开→改 VBA→保存"这条最省事的路,一开始就断了。 2. **没有 Visual Studio**,没有 VBA 编辑器可用。 3. **不能让用户手动改**。用户不是开发,指望他打开 VBE 粘贴代码不现实,而且几十份模板手改必错。 于是问题变成:**在完全不让 Excel 参与的前提下,直接改写文件里的 VBA 源码,并且不能碰坏表格数据、不能让 Excel 打开时报格式错误。** 这篇文章记录的就是这件事怎么做成,以及中间两条看起来"校验全绿"、实则把 Excel 搞崩的错误路线。 ## 二、VBA 到底存在文件的哪个位置 动手前必须搞清楚存储结构,否则后面全是瞎试。 `.xlsm` 本质是一个 zip。宏不在工作表里,而在一个独立部件: ```text xl/vbaProject.bin → 这是一个 MS-CFB 复合文档(OLE2 结构,和老式 .doc 同宗) ├── VBA/dir (目录流,记录各模块元信息) ├── VBA/ThisWorkbook ├── VBA/模块1 └── …每个模块一条流 ``` 每条**模块流**的布局是: ```text [ PerformanceCache 前缀 ] [ MS-OVBA 压缩后的源码 ] ↑ 这个分界点叫 textoffset ``` 两个关键点: - **PerformanceCache 是 Excel 的编译产物缓存**(p-code),规格上规定读取时忽略、保存时重建,实测前缀能长达 46 KB,**必须原样保留**。 - **源码段是 MS-OVBA 压缩的**,这是一种带 CopyToken 的 RLE/LZ 混合编码,不是 zip、不是 deflate,得按 `[MS-OVBA]` 规范自己解。 用 Python 把它读出来的骨架: ```python import sys; sys.path.insert(0, r"C:\ProgramData\wb_tmp\pylibs") import olefile, zipfile from oletools import olevba vba = zipfile.ZipFile(XLSM).read("xl/vbaProject.bin") open(TMP, "wb").write(vba) ole = olefile.OleFileIO(TMP) proj = olevba.VBA_Project(ole, "", "PROJECT", "VBA/dir") proj.parse_project_stream() # 不调用这句,modules 会是空的 mods = {fn: code for _cp, fn, code in proj.parse_modules()} offsets = {m.streamname: m.textoffset for m in proj.modules} ``` `parse_project_stream()` 这一句不能省——直接调 `parse_modules()` 会什么都不返回,这是新手第一个卡点。 另外两个容易忽略的事实: - 中文环境下**模块源码是 GBK 编码**,读写都要按 GBK 处理; - 源码换行是 **`\r\n`**,后面做字符串匹配时 old/new 串里必须写字面的 `\r\n`,写成 `\n` 会匹配不到,而且它不报错,只是"静静没生效"。 ## 三、三条路线,两条把 Excel 搞崩了 改源码说起来就是"换掉压缩段再写回去",但怎么换,差别巨大。我一共试了三条路,**只有第三条是安全的**。 ### 路线 1:完整重建 CFB(Excel 拒收) 思路:解析出所有流,改完源码后用 `olefile`/自写代码重新构建一个 CFB 复合文档,再重打 zip。 结果:**olefile、olevba 的所有校验全部通过**,结构自洽、源码回读一致。但双击打开时 Excel 直接报: > 文件格式或文件扩展名无效 结论:**校验库通过 ≠ Excel 认账**。Excel 对 CFB 的解析比开源库严格得多,红黑树拓扑、名称编码、时间戳这些细节,只要有一处不是它熟悉的样子,它就拒收整个文件。 ### 路线 2:整流替换 + dir 流重压缩 + FAT 链截断(Excel 原生闪退) 这条更阴。做法是把整个模块流换成"纯压缩容器",同时把 dir 流里该模块的 `MODULEOFFSET` 改成 0(PerformanceCache 可省略,Excel 会自动重编译),再手工截断 FAT 链、把多余扇区标 `FREESECT`,最后把改动过的扇区原位写回。 结果:**所有静态校验依然全绿**——olefile 打得开、源码回读一致、zip 比对也只有 `vbaProject.bin` 变了。 但用户一输入触发 VBA,Excel **直接原生闪退**。事件日志:`0xC0000005`(访问违例),出错模块 unknown,**重试 3 次必崩**。 推定原因是 dir 流重压缩或 FAT 手术产生了 Excel 严格解析器不认的编码——**olevba 的解码器太宽容,验证不出这类问题**。 ### 路线 3:等长原位替换(唯一可用) 核心约束:**新压缩体的字节长度必须等于原压缩体长度,dir 流和 FAT 链一个字节都不动。** - textoffset 前缀(PerformanceCache)原样保留; - 只在压缩段做原位覆写,按 FAT 链写回原扇区; - 目录表、dir 流、MiniFAT 全部零改动。 这条路之所以稳,是因为它**不触发 Excel 对结构变更的任何敏感路径**——文件大小、扇区布局、目录信息全部不变,Excel 感知到的只是"这段 p-code 缓存好像和源码对不上了",而它会自动重编译。 ## 四、等长替换里最难的部分:字节预算怎么凑 "等长"三个字,做起来是整个流程里最磨人的一步。 新源码压缩后如果比原来长,就填不进原位;短了也不行,会破坏后续结构。所以要主动把源码**凑到字节级等长**,手法是: 1. **精简**:去掉全行注释和行尾注释,把源码压到**小于**原长度。注意判断注释不能简单 `split("'")`——字符串字面量里的单引号不是注释,得用一个引号状态机扫描 `"…"` 区域。 2. **配平**:去注释前后统计关键字数量(`Sub/End Sub`、`Function/End Function`、`For/Next`、`Do/Loop`)必须一致,防止注释里混进了代码。 3. **填充**:压缩后若还差几十字节,用**无重复 3-gram 的随机注释**补齐。为什么要求无重复 3-gram?因为 MS-OVBA 压缩靠 CopyToken 复用前面出现过的串,重复模式太多会让压缩率变高、长度缩水,凑不准。 4. **回补 banner**:如果预算富余很大,在源码头部补一段精简的说明注释。 还有个兜底细节:`proj.modules` 有时为空,拿不到 `textoffset`。这时改用**暴力定位**——扫描流内每个 `0x01` 的位置,逐个尝试 `decompress_stream(stream[i:])`,与已知源码逐字节相等的那一处就是正确的 textoffset。 ## 五、MS-OVBA 压缩自己实现的三个坑 既然要原位改写压缩段,就得自己实现 MS-OVBA 压缩器。规范读起来不复杂,但这三个点各卡了一轮: 1. **`bit_count` 用的是"块内位置",不是全局位置。** 编码 CopyToken 时,`difference = 解压当前位置 − 本块起点`(不是文件全局偏移),`bit_count = max(ceil(log2(difference)), 4)`;`difference == 0` 时只发字面量。用全局位置算,解压必失败。 2. **CopyToken 的 offset 差 1。** 编码和解码都是 `offset − 1`,少减一个就直接错位。 3. **单块跨度上限是 3584,不是 4096。** 全字面量时块体最大 4608 字节,超过 4096 会溢出,实测取 3584 才安全。 CFB 层面还有两个偏移要记牢:**MiniFAT 起始扇区在 CFB 头 `0x3C`,扇区数在 `0x40`**(`0x38` 那个是 mini-stream 截断阈值 4096)。另外缩流有个坑:模块流若被缩到 **< 4096 字节**会留在常规扇区,而 olefile/Excel 会按 ministream 语义去读,直接读到垃圾。要么保证替换后流长 ≥ 4096(在压缩体内加注释内容凑,**不能**在容器尾部垫零——严格解析器会把尾部当新 chunk 报 `InvalidChunkSignature`),要么把它搬进 ministream。 ## 六、最阴的一层:改了源码,Excel 跑的还是旧的 这是整件事里最反直觉的一点,也是最容易让人"明明改对了却以为没改"的地方。 拼接完的新文件,源码回读是对的,但**宏的行为完全没变**。原因是:Excel 实际执行的不是流尾部的明文源码,而是**流前缀 PerformanceCache 里的旧编译 p-code**。源码和缓存不一致时,Excel 未必会重新编译——它可能就一直跑缓存里的旧版本。 验证方式(E2E,别省):用 COM 开宏后 `Application.Run "模块名.PublicSub"`,观察行为特征是否符合新版。 让新代码**可靠生效的唯一办法是 VBOM 重建模块**: ```text 1. 打开 AccessVBOM 信任项(注册表) 2. VBComponents.Remove 旧模块 3. VBComponents.Add(1) 新建,改回原模块名 4. CodeModule.AddFromString(新源码) 5. Run 一次触发编译 6. SaveAs 另存 ``` 两个必须注意的点: - **`AddFromString` 的源码里必须剥掉 `Attribute VB_Name` 行**,重复的属性行会导致编译失败,`Run` 时报"宏不可用"; - **只往里塞一两行注释不能让缓存失效**,必须整个模块重建。 顺带说一句:如果环境允许用 COM 做 VBOM 重建,那其实还有一条更省事的路线——直接以只读打开工作簿、改完 `SaveAs` 新文件名,**Excel 自己会重写 `vbaProject.bin`**,p-code 残留风险直接清零。能走这条路就别手工改二进制。 ## 七、交付前的验证清单(不验证不许交付) 静态校验工具和 Excel 的严格度差距巨大,所以我把验证固化成 7 条,逐条过: 1. **压缩往返**:`decompress_container(compress_container(src)) == src`,并用 `olevba.decompress_stream` 交叉验证(两套独立实现); 2. **流比对**:新旧 `vbaProject.bin` 逐流比对,除目标模块外**其余流必须逐字节一致**; 3. **源码回读**:对新的 `vbaProject.bin` 再跑一遍解析,确认源码与预期字符串**完全相同**; 4. **zip 比对**:新旧 xlsm 的 zip 条目**只有 `xl/vbaProject.bin` 不同**,其余逐字节一致(证明表格本体没被碰); 5. **表格回读**:`openpyxl` 以 `keep_vba=True` 加载,比对单元格值、行高、合并区、打印区域; 6. **CFB 结构**:新目录表前 116 字节应与原始逐字节相同,只有 offset 116/120 的 start/size 变化; 7. **关键字配平**:`Sub/End Sub`、`Function/End Function`、`For/Next`、`Do/Loop` 计数相等;`If/End If` 的口径是 `^(If|ElseIf)…Then$` 条数 **减去** `ElseIf` 条数 == `End If` 条数。 最后一步交付:先 `Copy-Item` 备份原文件再就地替换,并把备份路径明确告诉使用者。 ## 八、几个方法论层面的教训 **1. "能通过解析器校验"和"能被宿主程序接受"是两回事。** 这套流程里两次翻车都栽在同一个认知上:olefile/olevba 全绿,Excel 要么拒收、要么原生闪退。开源解析器的容错度远高于 Excel 的严格度,**最终裁判只有 Excel 本人**。所以任何二进制级修改,最后一环必须是"真机打开跑一遍",静态校验只能用来缩小范围,不能用来宣布成功。 **2. 改数据前先留快照,别信"一律删除/一律清空"式修法。** 这次的缺陷报告里,最初的修法建议是"把单元格里的 `Chr(10)` 全删掉"。但那份模板的正文**本身就用 `Chr(10)` 分行**——照做会直接毁掉内容。正确做法是改动前留原文快照,还原时按快照回写。同理,修一个缺陷前,先确认这条触发路径上还有谁在改同一份数据。 **3. 诊断前先确认"实际运行的是哪一版"。** 这次中途出现过一个很坑的情况:交付的 v4 文件,用户测出来的症状全是 v3 的行为。原因是他此前打开的旧版工作簿还留在 Excel 内存里,随手保存就把补丁覆盖回旧版了。**诊断前先提取目标文件的宏源码、比对版本特征**(比如某版独有的函数名),确认眼前跑的到底是哪一版,否则整套推理都建立在错误前提上。 **4. 别碰结构,只碰内容。** 所有成功的方案都遵循同一条原则:目录表、dir 流、FAT 链、其余模块流,一律零改动,只在压缩段做等长原位覆写。反过来,凡是动到结构(重建 CFB、改 dir 流、截断 FAT)的方案,全都在 Excel 面前翻车了。 ## 小结 | 环节 | 结论 | |---|---| | VBA 存储位置 | `xl/vbaProject.bin` → MS-CFB → 模块流 = PerformanceCache + MS-OVBA 压缩源码 | | 重建 CFB | Excel 报"文件格式或文件扩展名无效" | | 整流替换 + FAT 截断 | 校验全绿但 Excel 原生闪退(0xC0000005) | | 等长原位替换 | 唯一已验证安全路径 | | 改了不生效 | 执行的是旧 p-code,需 VBOM 重建模块(`AddFromString` 要剥 `Attribute VB_Name`) | | 最终裁判 | Excel 真机打开跑一遍,解析器校验不能替代 | 整个过程的门槛不在算法,而在**对宿主程序脾气的理解**:它比文档严格、比解析库挑剔,而且它认的是缓存不是源码。想明白这三点,剩下的就是工程耐心。

优秀的个人博客,低调大师

从 0 到上线:我用微信小程序云开发做了个"批改作业"工具(4 云函数 + 4 集合踩坑实录)#WorkBuddy#

# 从 0 到上线:我用微信小程序云开发做了个"批改作业"工具(4 云函数 + 4 集合踩坑实录) > 一句话说清这个项目:**学生拍照上传作业 → AI 自动批改 → 错题自动归档 → 家长/老师看统计**,全程后端零服务器、零成本,全部跑在微信小程序云开发上。 ## 目录 - 一、为什么要做这个工具 - 二、整体架构设计 - 三、数据库集合设计(4 个) - 四、云函数实现(4 个) - 五、踩坑记录(重点,含解决方案) - 六、上线部署流程 - 七、总结与数据 --- ## 一、为什么要做这个工具 核心痛点很直接:**老师批改作业太费时,学生订正后错题又容易散落各处、无法追溯。** 我希望用一个小程序把这些环节串起来: 1. 学生拍照上传作业图片; 1. 后端调用 AI 完成批改,返回分数 + 逐题对错; 1. 错题自动写入错题本(按知识点归类); 1. 老师/家长随时看提交统计。 选微信小程序云开发的原因只有两个:**不用买服务器、不用配域名和 HTTPS**,写完直接部署上线。 --- ## 二、整体架构设计 整个项目由 **4 个云函数 + 4 个数据库集合**构成,职责划分如下: |云函数|职责| | --- | --- | |login|静默登录,拿 openid,初始化用户| |gradeAI|核心:接收作业图片,调用 AI 批改,返回分数与逐题结果| |notify|批改完成后给用户推订阅消息| |stats|聚合提交数、平均分、错题分布,返回给前端图表| |数据库集合|存什么| | --- | --- | |users|用户资料(openid、昵称、角色:学生/老师/家长)| |assignments|作业任务(题目、截止时间、发布人)| |submissions|提交记录(图片、AI 批改结果、分数)| |mistakes|错题本(按用户 + 知识点归档)| 数据流一句话概括: 这套结构的好处是**职责单一**:每个云函数只干一件事,改起来互不影响,也方便单独调超时和权限。 --- ## 三、数据库集合设计(4 个) 以 `submissions`(提交记录)为例,字段设计如下: `mistakes`(错题本)的关键设计是**冗余存储知识点标签**,方便后面 `stats` 直接按标签聚合: > 设计原则:**读多写少的场景下,宁可冗余字段,也不要频繁跨集合 join。** 小程序端查错题本一次 `get` 就够了。 --- ## 四、云函数实现(4 个) ### 4.1 `login` —— 静默登录 ### 4.2 `gradeAI` —— 核心批改(重点) 这里是整个项目最容易踩坑的地方,先说结论:**AI 调用一定要放到云函数里做,且要处理超时**。 ### 4.3 `notify` —— 订阅消息 批改完成后推一条「批改已完成」的订阅消息,核心是**提前让用户授权**,否则 `subscribeMessage.send` 会静默失败。 ### 4.4 `stats` —— 数据统计 --- ## 五、踩坑记录(重点,含解决方案) > 这一节是我全程最值钱的部分——下面 6 个坑,每一个都踩过、都耗了我至少半小时。 ### 坑 1:本地调试报「找不到云函数」 **现象**:开发者工具里右键云函数「上传并部署」成功后,本地运行还是报 function not found。 **原因**:`project.config.json` 里 `cloudfunctionRoot` 没指向正确的函数目录,或者上传的是别的目录。 **解决**: 确认函数目录名和「云开发控制台」里显示的名字**完全一致**。 ### 坑 2:数据库权限默认「仅创建者可读写」,别人读不到 **现象**:学生 A 提交后,老师端查不到数据。 **原因**:集合默认权限是「仅创建者可读写」,跨用户读取直接返回空。 **解决**:在云开发控制台 → 数据库 → 对应集合 → 权限设置,改成**自定义安全规则**,例如提交记录允许同一条记录被指定角色读取: ### 坑 3:AI 批改接口超时 **现象**:批改图片稍微大一点就报错,前端一直转圈。 **原因**:云函数默认超时时间只有 **3 秒**,AI 批改通常要 5~15 秒。 **解决**:在云开发控制台把 `gradeAI` 函数的超时时间调到 **20 秒**(可在 `config.json` 里配 `"timeout": 20`)。 ### 坑 4:多个云环境,环境 ID 写错 **现象**:代码明明对,数据却总写到另一个环境去了。 **原因**:开发环境 / 生产环境 ID 混淆,`wx.cloud.init({ env: 'xxx' })` 传了错的 env。 **解决**:云函数里统一用 `cloud.DYNAMIC_CURRENT_ENV`(当前环境),小程序端用 `wx.cloud.init({ env: '真实环境ID' })`,并在 `.env` 或常量里集中管理,别散落硬编码。 ### 坑 5:图片不压缩,上传又慢又费流量 **现象**:手机原图 3~5 MB,上传慢、AI 识别也慢。 **解决**:上传前用 `wx.compressImage` 压缩到 1 MB 以内,再 `wx.cloud.uploadFile`。质量和速度兼得。 ### 坑 6:订阅消息静默失败,一条都发不出去 **现象**:代码没报错,但用户就是收不到通知。 **原因**:`subscribeMessage.send` 前用户没有授权订阅,或者模板字段类型对不上。 **解决**:提交流程里先 `wx.requestSubscribeMessage` 让用户点同意;模板字段类型要严格按模板(`thing` / `number` / `date` 等)填,不能混。 --- ## 六、上线部署流程 1. 微信开发者工具 → 右上角「上传」,填版本号和备注; 1. 去 [mp.weixin.qq.com](https://mp.weixin.qq.com/) 小程序后台 → 版本管理 → 把刚上传的版本设为「体验版」; 1. 邀请几个真实用户(老师/学生/家长)扫码体验,走一遍完整流程; 1. 确认无误后点「提交审核」,等审核通过再「发布」。 --- ## 七、总结与数据 这个小程序从想法到上线,全程我一个人完成,后端**零服务器成本**,只靠微信云开发就撑起了完整闭环: - **4 个云函数**:登录、AI 批改、通知、统计,职责清晰; - **4 个集合**:用户、作业、提交、错题,读写分离; - 最核心的体会有两句:**一是 AI 调用放云函数、超时务必调大;二是数据库权限别用默认值。** 如果你也在做类似的小工具,强烈建议从「先跑通一个最小闭环(上传 → 批改 → 入库)」开始,再逐步加通知和统计,能少走很多弯路。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码