首页 文章 精选 留言 我的

精选列表

搜索[data],共10000篇文章
优秀的个人博客,低调大师

阿里云大数据ACP认证知识点梳理9——产品特点(DATA WORKS)

DataWorks(数据工场,原大数据开发套件)是阿里云数加重要的PaaS平台产品,它提供全面托管的工作流服务,一站式开发管理的界面,帮助企业专注于数据价值的挖掘和探索。 DataWorks(数据工场)基于MaxCompute作为核心的计算、存储引擎,提供了海量数据的离线加工分析、数据挖掘的能力. 使用DataWorks(数据工场),可对数据进行数据传输、数据转换等相关操作,从不同的数据存储引入数据,对数据进行转化处理,最后将数据提取到其他数据系统。 提供强大的调度能力,支持按照时间、依赖关系的任务触发机制,支持每日千万级别的任务按照DAG关系准确、准时运行。支持分钟、小时、天、周和月多种调度周期配置。(分钟的最小单位是5分钟) 完全托管的服务,无需关心调度服务器资源问题。租户之间提供隔离,保证不同租户之间的任务不会相互影响。 支持数据同步

优秀的个人博客,低调大师

Streaming System 第二章:The What- Where- When- and How of Data Processing

本文由《Streaming System》一书第二章的提炼翻译而来,译者才疏学浅,如有错误,欢迎指正。转载请注明出处,侵权必究。 本章主要介绍鲁棒的处理乱序数据的核心概念,这些概念的运用使流处理系统超越批处理系统的关键所在。 路线图 上一章中,我们介绍了两个非常关键的概念: 事件时间和处理时间,只有在事件时间维度对数据进行处理,才能保证计算结果的准确性 窗口:窗口是处理无界数据流的通用方法,目前共有4类窗口。接下来我们介绍其他三个同样非常重要的概念: 触发器(Triggers)触发器是决定某个窗口何时输出的一种机制。作用跟照相机的快门相同,按下去,就能拿到某个时间点计算结果的快照。通过触发器,也能多次看到某个窗口的输出结果。因此可以实现迟到数据(late event)的处理。 Watermark(水印)Watermark是描述事件时间上数据完整

优秀的个人博客,低调大师

思科发布Analytics Data Center一体机 加速客户采用新技术

科将发布一款分析平台,让渠道合作伙伴可以更多地实时洞察客户的整个数据中心,另外,计划加速软件定义网络等新技术的采用。 Enterprise Networking Solutions Group of World Wide Technology是一家位于马里兰Maryland Heights的解决方案提供商,同时也是思科金牌合作伙伴,该公司实践负责人David Chandler表示:“这将客户迁移到更为现代化的技术,从这些传统的基于硬件的系统,到基于云和软件定义网络的系统。如果一位客户希望从传统网络迁移到基于策略的ACI网络,那么我们现在就拥有了成功实现这一点的信息和知识。” 思科花费两年时间开发这个Cisco Tetration Analytic平台,它可以安装在采用任何服务器、任何网络交换机的数据中心内,思科产品管理高级总监Yogesh Kaushik这样表示。 “这是一个完全开放的平台,旨在兼容客户使用的任何设备,”Kaushik在接受采访时表示。“它设计兼容第三方工具、平台、以及我们自己的一些产品,例如思科的安全产品组合、CliQr、ACI、其他SDN控制器——工具以调用[如AWS]公有云中的工作流。” 这与HPE采用的方法形成鲜明对比,HPE新的Internet of Thins Edgeline融合系统,实时收集网络边缘的数据。HPE高管将这种数据中心物联网模式定义为是有缺陷的,因为他们已经看到无法实时地收集数据和对数据进行操作。 据思科称,Tetration设计旨在为企业机构提供对数据中心所有方面的全方位实时可见性,收集来自硬件和软件传感器的数据。然后它会使用机器学习技术分析信息,解决关键数据中心运营的问题——例如策略法规遵从和应用取证——,提供应用洞察、自动化策略推荐和网络流量取证,该公司称。 一个Tetration一体机每秒可以监控最多1百万独立流量,可以在数秒内搜索数十亿个事件,该公司表示。 “此外它非常非常易于操作……这个一体机内的所有方面都是由我们的软件管理的,”Kaushik表示,他补充说Tetration的部署只需要几个小时。“我们以一种给合作伙伴带来便捷性的方式架构它……你不需要很多数据中心科学家和大数据工程师来部署这个平台。” Tetration是一款“一触式”的一体机,其中预装了服务器、交换机和软件。7月合作伙伴将开始售卖Tetration平台,这将是一款全堆栈的一体机,部署在客户数据中心内部。 有合作伙伴表示,Tetration允许企业在他们的网络内实现软件定义网络或者更多软件流程,因为手机了更多可见性和洞察。这款平台让IT经理对数据中心有了新的理解,将简化运营可靠性,简化数据向软件定义网络解决方案和云的迁移,据思科称。 “它加速了客户对这些新技术的采用,”WWT的Chandler说,“因为这与你为每个经过带有传感器的网络的包所收集、吸收和分析的元数据是不可比拟的。” 解决方案提供商看到了把Tetration作为简单硬件、专业和咨询服务售卖的机会,帮助企业机构改善他们的网络,简化业务流程以变得更快速和更敏捷。 Sirius Computer Solutions是一家在德克萨斯州San Antonio的思科合作伙伴,该公司网络解决方案副总裁Brian Finzen表示:“数据中心是客户环境‘皇冠上的宝石’。流入和流出数据中心的传输流量是任务关键的,这让客户第一次能够看到数据中心发生内的一切——很多拥有大量金融资产的客户已经做到了这一点。管理这些资产是很巨大的工程。” Finzen表示,思科正在构建自己的渠道社区,为物联网相关的经常性收入服务。“有一个收集来自传感器的机器数据集群,所以这是以物联网为核心的打法,”他说, Tetration是思科向软件、分析和合作伙伴经常性收入商机发展的一个部分,思科美洲合作伙伴部门高级总监Nirav Sheth表示。Sheth表示,所有思科的传统盈利项目例如VIP都将运用Tetration。 “这对于合作伙伴附加更多咨询和专业服务来说是一个机会,而且为客户提供了端到端洞察,让他们有信心迁移到下一代基础设施——不管是基于ACI,还是Nexus 9K单机或者计算升级,”Sheth说。“这对于渠道来说是一个巨大的机会。” 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

优秀的个人博客,低调大师

openstack 云主机关机:ournal: End of file while reading data: Input/output e...

问题现象描述: 某个集群环境每天出现一台机器关机现象,随机发生,经过排查解决问题,为大家提供方便 环境: 集群环境:openstack + ceph 融合集群,版本:Mitaka+jewel 网络环境:网卡10G+bond0(主备模式) 版 本:centos7.3 message 错误日志: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 Aug3016:45:14lxx-4-5journal:internalerror:Endof file frommonitor Aug3016:45:14lxx-4-5avahi-daemon[2412]:Withdrawingaddressrecord for fe80::fc16:3eff:fef3:5076onvnet5. Aug3016:45:14lxx-4-5kernel:vlan206:port3(vnet5)entereddisabledstate Aug3016:45:14lxx-4-5kvm:10guestsnowactive Aug3016:45:14lxx-4-5avahi-daemon[2412]:Withdrawingworkstationservice for vnet5. Aug3016:45:14lxx-4-5kernel:devicevnet5leftpromiscuousmode Aug3016:45:14lxx-4-5kernel:vlan206:port3(vnet5)entereddisabledstate Aug3016:45:14lxx-4-5systemd:autolog.serviceholdoff time over,schedulingrestart. Aug3016:45:14lxx-4-5systemd:StartedAutolog. Aug3016:45:14lxx-4-5systemd:StartingAutolog... Aug3016:45:14lxx-4-5systemd-machined:Machineqemu-22-instance-000002c9terminated. Aug3016:45:14lxx-4-5autolog:Don'thavemasterprocess. Aug3016:45:15l22-4-5journal:Endof file while readingdata:Input /output error Aug3016:45:15lxx-4-5systemd:autolog.serviceholdoff time over,schedulingrestart. Aug3016:45:15lxx-4-5systemd:StartedAutolog. Aug3016:45:15lxx-4-5systemd:StartingAutolog... Aug3016:45:15lxx-4-5autolog:Don'thavemasterprocess. Aug3016:45:15lxx-4-5systemd:autolog.serviceholdoff time over,schedulingrestart. Aug3016:45:15lxx-4-5systemd:StartedAutolog. Aug3016:45:15lxx-4-5systemd:StartingAutolog... openstack-compute 关键日志: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 2017 - 08 - 30 16 : 45 : 20.952 110867 DEBUGnova.compute.manager[req-0602316d-944c-42b4-9d3c-7d1b0e513765-----][instance:26f48b2e-f648-42e2- 8133 -7ebc060fd7ae]Updatedthenetworkinfo_cache for instance_heal_instance_info_cache/usr/lib/python2. 7 /site-packages/nova/compute/manager.py: 5803 2017 - 08 - 30 16 : 45 : 30.033 110867 DEBUGnova.virt.driver[-]Emittingevent<LifecycleEvent: 1504082715.03 ,08330b10-f106- 4737 -b9db-0e45c84abb2e=>Stopped>emit_event/usr/lib/python2. 7 /site-packages/nova/virt/driver.py: 1443 2017 - 08 - 30 16 : 45 : 30.034 110867 INFOnova.compute.manager[-][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]VMStopped(LifecycleEvent) 2017 - 08 - 30 16 : 45 : 30.076 110867 DEBUGnova.compute.manager[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Checkingstate_get_power_state/usr/lib/python2. 7 /site-packages/nova/compute/manager.py: 1347 2017 - 08 - 30 16 : 45 : 30.079 110867 DEBUGnova.compute.manager[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Synchronizinginstancepowerstateafterlifecycleevent "Stopped" ;currentvm_state:active,currenttask_state:None,currentDBpower_state: 1 ,VMpower_state: 4 handle_lifecycle_event/usr/lib/python2. 7 /site-packages/nova/compute/manager.py: 1276 2017 - 08 - 30 16 : 45 : 30.119 110867 INFOnova.compute.manager[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]During_sync_instance_power_statetheDBpower_state( 1 )doesnotmatchthevm_power_statefromthehypervisor( 4 ).Updatingpower_state in theDBtomatchthehypervisor. 2017 - 08 - 30 16 : 45 : 30.177 110867 WARNINGnova.compute.manager[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Instanceshutdownbyitself.CallingthestopAPI.Currentvm_state:active,currenttask_state:None,originalDBpower_state: 1 ,currentVMpower_state: 4 2017 - 08 - 30 16 : 45 : 30.178 110867 DEBUGnova.compute.api[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Goingto try tostopinstanceforce_stop/usr/lib/python2. 7 /site-packages/nova/compute/api.py: 1954 2017 - 08 - 30 16 : 45 : 30.267 110867 DEBUGoslo_concurrency.lockutils[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----]Lock "08330b10-f106-4737-b9db-0e45c84abb2e" acquiredby "nova.compute.manager.do_stop_instance" ::waited 0 .000sinner/usr/lib/python2. 7 /site-packages/oslo_concurrency/lockutils.py: 270 2017 - 08 - 30 16 : 45 : 30.268 110867 DEBUGnova.compute.manager[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Checkingstate_get_power_state/usr/lib/python2. 7 /site-packages/nova/compute/manager.py: 1347 2017 - 08 - 30 16 : 45 : 30.270 110867 DEBUGnova.compute.manager[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Stoppinginstance;currentvm_state:active,currenttask_state:powering-off,currentDBpower_state: 4 ,currentVMpower_state: 4 do_stop_instance/usr/lib/python2. 7 /site-packages/nova/compute/manager.py: 2545 2017 - 08 - 30 16 : 45 : 30.270 110867 INFOnova.compute.manager[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Instance is alreadypoweredoff in thehypervisorwhenstop is called. 2017 - 08 - 30 16 : 45 : 30.271 110867 DEBUGnova.objects.instance[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----]Lazy-loading 'metadata' onInstanceuuid08330b10-f106- 4737 -b9db-0e45c84abb2eobj_load_attr/usr/lib/python2. 7 /site-packages/nova/objects/instance.py: 895 2017 - 08 - 30 16 : 45 : 30.314 110867 INFOnova.virt.libvirt.driver[req-5998b542-495c-41f2- 8010 -7f1c426f0127-----][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Instancealreadyshutdown. 2017 - 08 - 30 16 : 45 : 30.318 110867 INFOnova.virt.libvirt.driver[-][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]Instancedestroyedsuccessfully. 关键日志: 1 2 3 message:Aug 30 16 : 45 : 15 l22- 4 - 5 journal:Endoffile while readingdata:Input/outputerror Openstack-compute: 2017 - 08 - 30 16 : 45 : 30.034 110867 INFOnova.compute.manager[-][instance:08330b10-f106- 4737 -b9db-0e45c84abb2e]VMStopped(LifecycleEvent) 解决办法: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 升级libvirt版本: libvirt-daemon-driver-secret- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-lxc- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-driver-lxc- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-python- 2.0 . 0 - 2 .el7.x86_64 libvirt-daemon- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-lock-sanlock- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-driver-storage- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-gobject- 0.2 . 3 - 1 .el7.x86_64 libvirt-nss- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-driver-nwfilter- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-gconfig- 0.2 . 3 - 1 .el7.x86_64 libvirt-snmp- 0.0 . 3 - 5 .el7.x86_64 libvirt-daemon-driver-nodedev- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-glib-devel- 0.2 . 3 - 1 .el7.x86_64 libvirt-gobject-devel- 0.2 . 3 - 1 .el7.x86_64 libvirt-java-javadoc- 0.4 . 9 - 4 .el7.noarch libvirt-daemon-driver-qemu- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-kvm- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-gconfig-devel- 0.2 . 3 - 1 .el7.x86_64 libvirt-login-shell- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-client- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-driver- interface - 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-devel- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-cim- 0.6 . 3 - 19 .el7.x86_64 libvirt-glib- 0.2 . 3 - 1 .el7.x86_64 libvirt-java-devel- 0.4 . 9 - 4 .el7.noarch libvirt-daemon-driver-network- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-docs- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-config-nwfilter- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-daemon-config-network- 2.0 . 0 - 10 .el7_3. 9 .x86_64 libvirt-java- 0.4 . 9 - 4 .el7.noarch 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 升级qemu版本 qemu-system-lm32- 2.0 . 0 - 1 .el7. 6 .x86_64 ipxe-roms-qemu- 20160127 - 5 .git6366fa7a.el7.noarch qemu-system-cris- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-x86- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-kvm-tools- 1.5 . 3 - 126 .el7_3. 10 .x86_64 qemu-system-xtensa- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-arm- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-s390x- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-sh4- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-kvm-common- 1.5 . 3 - 126 .el7_3. 10 .x86_64 qemu-user- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-unicore32- 2.0 . 0 - 1 .el7. 6 .x86_64 libvirt-daemon-driver-qemu- 2.0 . 0 - 10 .el7_3. 9 .x86_64 qemu-guest-agent- 2.5 . 0 - 3 .el7.x86_64 qemu-common- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-or32- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-kvm- 1.5 . 3 - 126 .el7_3. 10 .x86_64 qemu-system-moxie- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-img- 1.5 . 3 - 126 .el7_3. 10 .x86_64 qemu-system-m68k- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-alpha- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-microblaze- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu-system-mips- 2.0 . 0 - 1 .el7. 6 .x86_64 qemu- 2.0 . 0 - 1 .el7. 6 .x86_64 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 升级kernel [root@~]#rpm-qa|grepkernel kernel- 3.10 . 0 - 514.26 . 2 .el7.x86_64 kernel-tools-libs- 3.10 . 0 - 514.26 . 2 .el7.x86_64 kernel-devel- 3.10 . 0 - 327.36 . 3 .el7.x86_64 kernel-tools- 3.10 . 0 - 514.26 . 2 .el7.x86_64 kernel-devel- 3.10 . 0 - 123 .el7.x86_64 kernel- 3.10 . 0 - 327.36 . 3 .el7.x86_64 abrt-addon-kerneloops- 2.1 . 11 - 45 .el7.centos.x86_64 kernel- 3.10 . 0 - 514.2 . 2 .el7.x86_64 kernel- 3.10 . 0 - 123 .el7.x86_64 kernel- 3.10 . 0 - 327.22 . 2 .el7.x86_64 kernel-devel- 3.10 . 0 - 327.22 . 2 .el7.x86_64 kernel-devel- 3.10 . 0 - 514.26 . 2 .el7.x86_64 kernel-devel- 3.10 . 0 - 514.2 . 2 .el7.x86_64 kernel-headers- 3.10 . 0 - 514.26 . 2 .el7.x86_64 [root@~]#uname-r 3.10 . 0 - 514.26 . 2 .el7.x86_64 注意:升级版本之后一定要重启,才能成功,重启服务无效!!! 本文转自 swq499809608 51CTO博客,原文链接:http://blog.51cto.com/swq499809608/1962081

优秀的个人博客,低调大师

腾讯云大数据接入 WorkBuddy:为 Agent 平台引入 Data+AI 专业智能体

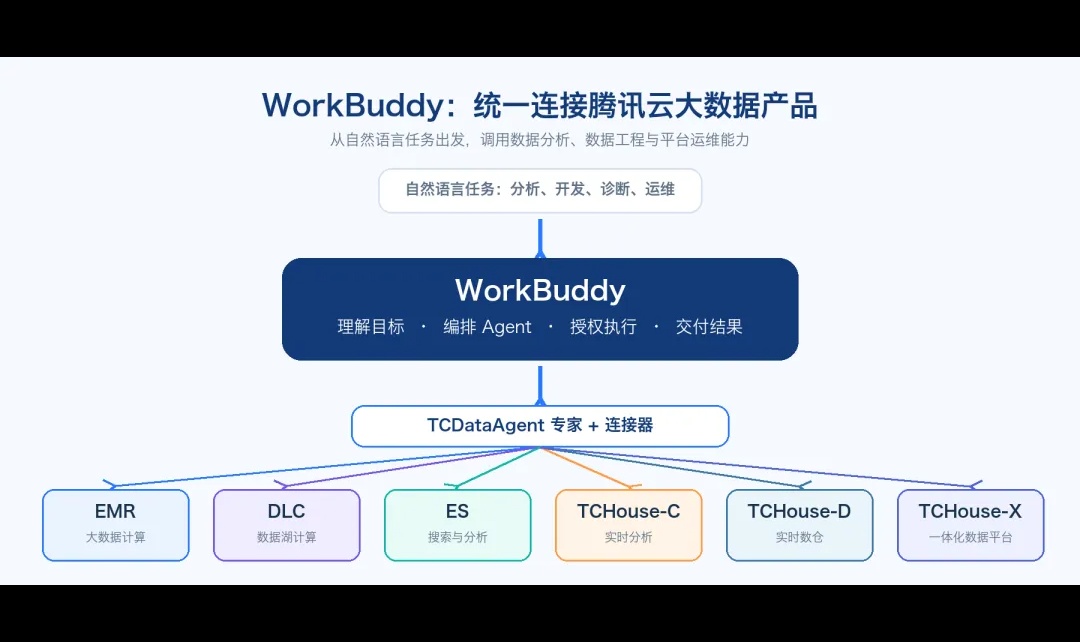
业务人员想查看经营指标,需要提交需求、等待数据团队排期;数据工程师遇到任务问题,需要在日志、配置和监控之间反复定位;运维人员面对集群告警,则要逐一检查实例状态、节点指标和服务日志,再判断是否需要调整配置或重启服务。 随着数据平台日益复杂,不同角色都在面对同一个问题:大数据引擎能力越来越强,但使用这些能力所需的专业知识、操作步骤和协作投入也在增加。 与此同时,以 WorkBuddy 为代表的泛生产力 Agent 平台,正在覆盖越来越广的办公人群。当越来越多的人习惯用对话完成工作,一个现实的问题浮现出来:泛 Agent 平台能聊天、能写文档,但要做真正企业级的数据分析,还需要专业的东西——专业的数据引擎,和懂数据的专业 Agent。 现在,**腾讯云大数据接入 WorkBuddy,将大数据引擎能力和专业数据 Agent 带入日常工作界面**。 # **全面接入:六款引擎,两种形态** 腾讯云大数据接入 WorkBuddy,覆盖弹性 MapReduce(EMR)、数据湖计算(DLC)、腾讯云 Elasticsearch Service(ES)、云数据仓库 TCHouse-C、TCHouse-D、TCHouse-X 六款大数据引擎,提供"连接器"与"专家"两种形态。 ![](https://developer.qcloudimg.com/http-save/audit-1920198/f5c6ddd5c7f3186b4c0ba420c48fd17c.webp) ## **形态一:连接器——WorkBuddy 的 Agent,获得了操作引擎的工具。** 各引擎的控制面与数据面能力被封装为标准工具与技能,接入 WorkBuddy 连接器模块。用户面对的是 WorkBuddy 的 Agent,但它手中多了操作数据引擎的真实工具:查询集群、分析日志、执行 SQL、诊断任务。用户只需描述目标,WorkBuddy 的 Agent 会选择合适的引擎工具,配合专业技能完成执行。 ## **形态二:专家与专家团——腾讯云大数据的专业 Agent,进驻 WorkBuddy。** 三位内置专家由腾讯云大数据基于微调模型打造,自带大数据领域知识与任务方法。用户召唤的不是 WorkBuddy 的通用助手,而是懂数据的专业 Agent 本人。对于同时涉及分析、工程、运维多个角色的复杂任务,三位专家可组成"大数据专家团队"分工协作——专家团是专家的协作组合,而非独立于两者之外的第三种形态。 简单来说:**连接器解决"调用什么引擎能力",专家解决"如何更好地完成任务",专家团解决"如何协作完成复杂任务"。** 对 WorkBuddy 的用户而言,这次接入意味着在日常工作的平台上,可以直接获得企业级数据引擎和专业数据 Agent 的支持——数据分析不再必须切换到另一套系统、另一套语言。 # **三个场景:从一次查询到一个完整任务** 数据是一座金矿,但过去挖矿的工具只掌握在少数人手里。现在,通过 WorkBuddy,这些工具以对话的方式递到更多人面前。 ![](https://developer.qcloudimg.com/http-save/audit-1920198/7744ba6aab5ff89ad8cb27c14565fa1c.png) ## **场景一:业务人员通过对话自助完成数据分析** 传统业务查数通常从提交需求开始。业务人员描述问题,数据团队确认指标口径、寻找数据、编写 SQL,再将查询结果整理后返回。即使是常规分析,也可能涉及多轮沟通。 接入 WorkBuddy 后,业务人员可以直接向大数据分析专家提出: > 分析过去七天各渠道的新增用户和付费转化情况,找出异常变化,并给出可能原因。 大数据分析专家会先确认指标定义、时间范围和分析维度,再调用已授权的数据引擎探查表结构、生成并执行 SQL,对查询结果进行比较、归纳和解释。 用户还可以继续追问:"按地区进一步拆分,重点分析华南地区转化下降的原因。"整个分析过程都在同一段对话中连续完成。业务人员不需要预先掌握数据表结构、SQL 语法或引擎操作路径,即可从业务问题出发获得数据结果和分析结论。 ![](https://developer.qcloudimg.com/http-save/audit-1920198/5b1fd48071808fd9ac695283506dea3b.png) ## **场景二:工程和运维人员通过对话完成问题诊断** 数据任务异常通常不只需要查看一项信息。工程师和运维人员可能要依次检查任务状态、运行日志、集群负载、服务健康度和配置参数,才能逐步缩小问题范围。 现在,用户可以直接向大数据工程专家或大数据智能管家描述问题: > 昨晚的 Spark 任务耗时明显增加,请检查任务和集群状态,定位可能的性能瓶颈。 以 EMR 为例,专家可以查询集群实例、运行日志和健康状态,进一步诊断 HDFS、YARN、ZooKeeper 等服务,并分析 Spark 数据倾斜或 StarRocks 引擎错误。以 TCHouse 为例,专家可以查询集群监控指标、节点状态、任务进度、告警事件、配置参数和 SQL 执行统计,判断异常来自资源负载、查询执行还是集群状态。 专家不仅返回分散的指标和日志,还会围绕问题组织诊断步骤、归纳关键线索,并给出处理顺序。在用户授权和确认后,还可以继续执行服务重启、配置下发等管控操作。 ## **场景三:专家团队在统一平台内完成跨流程复杂任务** 复杂任务不一定意味着跨越多个引擎。更常见的情况是:在同一个平台内,一个目标同时涉及数据分析、数据工程和平台运维等多个流程。 例如,用户可以围绕 EMR 平台提出: > 昨天核心业务报表产出延迟,请分析影响范围,定位数据任务问题,检查平台运行状态,并给出修复和优化方案。 这是一个完整任务,而不是一次简单查询。它可能同时包含:分析报表和关键指标的延迟情况,判断业务影响范围;检查相关 Spark、Hive 等数据任务的运行记录与处理链路;分析是否存在数据倾斜、任务失败或执行效率下降;检查 HDFS、YARN、ZooKeeper 等服务及集群资源状态;汇总问题原因,制定修复顺序和后续优化方案。 面对这类任务,用户可以召唤"大数据专家团队":大数据分析专家负责分析数据产出情况和业务影响;大数据工程专家负责检查任务链路、作业逻辑和性能问题;大数据智能管家负责检查集群健康、资源负载和服务状态。三位专家围绕同一个平台、同一个任务目标分工协作,最终形成统一的诊断结论和处置建议。 这一场景的核心,不是把多个系统简单连接起来,而是在统一平台内打通不同角色和工作流程,让 Agent 专家团队从"回答一个问题"进一步升级为"交付一个完整任务"。 ![](https://developer.qcloudimg.com/http-save/audit-1920198/3088b66aa90be8fadcd4f22787bcea8d.webp) # **从功能操作,到目标驱动** 腾讯云大数据接入 WorkBuddy,带来的不只是使用链路缩短,而是大数据引擎使用方式的一次升级。 ![](https://developer.qcloudimg.com/http-save/audit-1920198/3ab9d1332131dd28cad1a8ed5fe06089.png) 过去,用户需要进入不同引擎的控制台,理解产品概念和功能路径,再通过 SQL、配置或运维工具完成操作。现在,用户可以从任务目标出发,用自然语言直接调用引擎能力或专业专家。 **大数据引擎的使用方式,由此从"人理解系统、寻找功能",升级为"Agent 理解目标、组织能力并执行任务"。** 这个变化带来三个直接结果: 业务人员可以自助完成部分数据分析,不必再把每个取数需求提交给数据开发排期;工程师可以更快完成信息收集和问题定位,从反复切换系统、复制信息、手工串联分析过程中解放出来;原本依赖专家经验的集群诊断、SQL 优化、执行计划分析等能力,被沉淀进 Agent,覆盖到组织里更多需要数据的角色。 # **为什么是"专业"的:微调模型与专家团队** WorkBuddy 上的 Agent 很多,数据分析这件事为什么要强调"专业"? 因为数据分析不是通用对话。它需要理解指标口径和业务语义,需要熟悉引擎的特性和脾气,需要知道一次诊断该先查什么、后查什么。通用大模型可以聊天,但面对"Spark 任务变慢"这样的问题,专业与否直接决定结论是否可用。 腾讯云大数据在 WorkBuddy 中提供的专家 Agent,基于腾讯云数据分析智能体 TCDataAgent-AVA 打造,将大数据领域知识、增强工具、任务方法和场景经验注入专家,并对通用模型进行专业增强: - **大数据分析专家**:对文件和腾讯云大数据引擎中的数据进行分析,从海量数据提取关键洞察,提供业务决策支持 - **大数据工程专家**:负责数据建模、调优执行,将原始数据转化为可分析的高质量数据资产 - **大数据智能管家**:负责集群监控、性能监测、故障排查与容量规划,保障数据平台高可用 三者组成的"大数据专家团队",面向同时涉及多个角色或引擎的复杂任务,拆解目标、分工执行、统一汇总结果。 无论通过连接器还是专家,数据访问都在用户授权的账号和权限边界内进行——权限机制与原有体系一致,变化的只是使用方式。 # **六款引擎接入能力总览** 六款引擎覆盖数据湖、开源大数据、搜索分析和实时数仓等核心场景。用户既可以单独调用某一引擎,也可以根据任务需要组合多个引擎能力。 ![](https://developer.qcloudimg.com/http-save/audit-1920198/5e1aaab0352a1e416021032e6b9f227f.png) ![](https://developer.qcloudimg.com/http-save/audit-1920198/e607acb7a56644596ca591d8bf6dc162.webp) # **怎么开始使用** 腾讯云大数据各引擎的连接器正陆续上架 WorkBuddy,可在 WorkBuddy 的「专家·技能·连接器」中找到连接器。 ![](https://developer.qcloudimg.com/http-save/audit-1920198/498fa06b7421776bf3cb5e5474cd187d.png) 腾讯云大数据专家与连接器上线灰度测试中,申请试用请提交相应产品工单进行申请。 接下来,腾讯云大数据还将围绕 EMR、DLC、ES、TCHouse-C、TCHouse-D 和 TCHouse-X,陆续推出 WorkBuddy 最佳实践系列,深入介绍各引擎的典型任务、操作方式与场景案例。 # **从 WorkBuddy 出发,到更多 Agent 平台** WorkBuddy 是这套专业数据能力率先接入的泛生产力平台。对 WorkBuddy 而言,专业数据引擎与数据 Agent 的加入,让平台的能力版图从通用办公延伸到企业数据分析这一核心场景;对腾讯云大数据的用户而言,已有的引擎资产从此多了一个自然语言的入口。 这次接入基于标准化的接口形式(MCP 等)完成。这意味着同一套引擎能力与专家能力,并不绑定单一平台——除 WorkBuddy 外,更多其他第三方 Agent 平台同样可以调用。 腾讯云大数据要做的,是专业数据能力的提供方:引擎在这里,专家在这里,各类 Agent 平台都可以接入。 从一个问题出发,直接调用一款引擎、一位专家,或一支完整的大数据专家团队。

优秀的个人博客,低调大师

Spring Data开发手册|Java持久化API(JPA)需要了解到什么程度呢?

JPA,Java Persistence API是Sun官方提出的Java持久化规范。它为Java开发人员提供了一种对象/关联映射工具来管理Java应用中的关系数据。它的出现主要是为了简化现有的持久化开发工作和整合ORM技术 ORM:通过使用描述对象和数据库之间映射的元数据,将程序中的对象自动持久化到关系数据库中。本质就是将数据从一种形式转换到另外一种形式。 同时也结束了Hibernate、TopLink等ORM框架各自为营的局面。JPA充分吸收了Hibernate、TopLink等ORM框架的基础上发展起来的,使用方便,伸缩性强 注意: JPA不是一种新的ORM框架,它的出现只是用于规范现有的ORM技术,它不能取代现有的Hibernate等ORM框架,相反,采用JPA开发时,我们仍将使用这些ORM框架,只是此时开发出来的应用不在依赖于某个持久化提供商。应用可以在不修改代码的情况下载任何JPA环境下运行,真正做到低耦合,可扩展的程序设计。类似于JDBC,在JDBC出现以前,我们的程序针对特性的数据库API进行编程,但是现在我们只需要针对JDBC API编程,这样能够在不改变代码的情况下就能换成其他的数据库。 JPA是一套规范,不是一套产品。Hibernate是一套产品,如果这些产品实现了JPA规范,那么我们可以叫它们为JPA的实现产品。使用JPA,就可以把我们的应用从Hibernate中解脱出来,那么现在问题来了::如何使用JPA来开发呢? 准备好了吗,进入正题,起飞! 首先,先带大家看一下本篇文章的大致介绍。 没目录怎么知道这篇到底有多少干货呢? 以前的开发模式 JPA是什么 JPA解决了什么问题 JPA的第一个HelloWord程序 详解配置文件 常用的注解 一对一的问题 一对多的问题 多对多的问题 JPA中常见的方法 JPA中对象的状态 注意事项 是不是很清晰呢,什么?还不进入正文,来了,安排上,一个一个来: 回顾以前的开发模式 以前开发的时候我们的DAO层,要么使用Hibernate、要么使用iBatis、dbutils、toplink 需求:假设现在的产品的1.0版本的DAO的实现使用的是Hibernate、现在老板要求将DAO层换成TopLink 按照现在的解决方案整个DAO层都是需要重写的,很耗费人力和物力,增加了成本 有没有一种方案?这种方案就是如果我们需要换ORM框架,我们的整个DAO层都不需要改变只是需要改变配置文件就可以了呢? JPA技术技术因此而生 JPA是什么 JPA实际上是sun公司出的一套规范、这套规范的作用是为了解决市场上ORM框架一家独大的问题 JPA是一套规范,只要我们的ORM框架实现了这套规范,那么在使用这个ORM框架的时候,就不需要面对于某一种ORM产品的API来进行编程,而是统一的面向于JPA来进行编程,这个时候即使你的ORM产品改变了,那么你的DAO层面向于JPA编程的代码是不用变的 JPA解决了什么问题 JPA统一了ORM框架访问数据库的API JPA解决了ORM框架一家独大的问题 JPA的第一个HelloWorld程序 导包 编写配置文件 <?xmlversion="1.0"encoding="UTF-8"?> <persistencexmlns="http://xmlns.jcp.org/xml/ns/persistence" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://xmlns.jcp.org/xml/ns/persistence http://xmlns.jcp.org/xml/ns/persistence/persistence_2_1.xsd" version="2.1"> <persistence-unitname="hibernateJPA"transaction-type="RESOURCE_LOCAL"> <properties> <propertyname="hibernate.hbm2ddl.auto"value="update"></property> <propertyname="hibernate.show_sql"value="true"></property> <propertyname="hibernate.format_sql"value="true"></property> <propertyname="hibernate.dialect"value="org.hibernate.dialect.MySQL5Dialect"></property> <propertyname="hibernate.connection.url"value="jdbc:mysql:///qianyu"></property> <propertyname="hibernate.connection.driver_class"value="com.mysql.jdbc.Driver"></property> <propertyname="hibernate.connection.username"value="root"></property> <propertyname="hibernate.connection.password"value="root"></property> </properties> </persistence-unit> </persistence> 编写Java实体和注解 @Table(name="t_user")//设置当前的类的对象对应的表名字 @Entity//表示当前的这个类是一个持久化的实体 publicclassUser{ @Id//这个表示的是当前的字段是主键 @GeneratedValue(strategy=GenerationType.IDENTITY)//这个表示的是主键的生成策略(自增长) @Column(name="uId") privateintuId; @Column(name="userName")//列的名字 privateStringuserName; @Column(name="password") privateStringpassword; } 测试 @Test publicvoidtestHelloWorld()throwsException{ //第一步:创建实体管理的工厂 EntityManagerFactoryef=Persistence.createEntityManagerFactory("hibernateJPA"); //通过工厂创建实体的管理器 EntityManagerem=ef.createEntityManager(); //第三步:开启事务 em.getTransaction().begin(); //操作业务逻辑 Useruser=newUser(); user.setUserName("浅羽"); user.setPassword("123"); //保存用户实体到数据库 em.persist(user); //提交事务 em.getTransaction().commit(); //关闭管理器 em.close(); ef.close(); } 详解配置文件 <?xmlversion="1.0"encoding="UTF-8"?> <persistencexmlns="http://xmlns.jcp.org/xml/ns/persistence" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://xmlns.jcp.org/xml/ns/persistence http://xmlns.jcp.org/xml/ns/persistence/persistence_2_1.xsd" version="2.1"> <!-- persistence-unit:这个叫做持久化的单元这个的作用就是配置访问数据库的信息 name:逻辑意义上可以随便写但是一般情况下见名之意这个一般情况下写JPA的实现产品的名字 transaction-type:事务的类型 RESOURCE_LOCAL:局部事务 事务的分类 全局事务 举例:张三给李四转账(建设银行----中国银行) 局部事务 举例:所有的操作在同一个库里头执行 粗粒度事务 举例:能够对整个类或者方法体进行事务的管理 细粒度事务 举例:就是能够对某几行代码进行事务的管理 --> <persistence-unitname="hibernateJPA"transaction-type="RESOURCE_LOCAL"> <properties> <propertyname="hibernate.hbm2ddl.auto"value="update"></property> <propertyname="hibernate.show_sql"value="true"></property> <propertyname="hibernate.format_sql"value="true"></property> <propertyname="hibernate.dialect"value="org.hibernate.dialect.MySQL5Dialect"></property> <propertyname="hibernate.connection.url"value="jdbc:mysql:///qianyu"></property> <propertyname="hibernate.connection.driver_class"value="com.mysql.jdbc.Driver"></property> <propertyname="hibernate.connection.username"value="root"></property> <propertyname="hibernate.connection.password"value="root"></property> </properties> </persistence-unit> </persistence> 常用的注解线程池技术 @Table:表示的是当前的实体对应的数据库中的表名字 @Entity:表示的是当前的实体是一个持久化的实体 @Id:这个表示当前的属性是一个主键 @GeneratedValue:主键的生成策略 strategy=GenerationType.IDENTITY:这个表示的是主键自增长 strategy=GenerationType.AUTO:使用表来生成目标表的主键 strategy=GenerationType.SEQUENCE:使用序列来生成主键 @Column:jAVA的属性对应的数据库表的列的名字 Name:名字 Length:表示的是字段的长度 nullable=false:这个表示的是不能为null unique=true:是否是唯一的 @Transient:当前字段在数据库中不对应列 @Enumerated:表示的是枚举在数据库中的映射使用下标还是字符串 EnumType.STRING:表示的是以字符串的形式显示 EnumType.ORDINAL:表示枚举在数据中以下标的形式显示 @Lob:修饰String类型的时候表示的大文本 修饰byte[]的时候表示存储的是二进制 一对一的问题 需求:一个人对应了一个身份证、一个身份证也唯一对应了一个人 身份证----->人 一对一的关系 代码演示: 声明IdCard类: @Entity @Table publicclassIdCard{ @Id privateStringcardNum; privateDatestartTime; privateDateendTime; //一个身份证唯一的对应了一个人 @OneToOne(cascade=CascadeType.ALL,fetch=FetchType.LAZY) @JoinColumn(name="pId")//这个表示的是添加一个列这个列映射下面对象中的这个Id privatePeoplepeople; } 声明People类: @Entity @Table publicclassPeople{ @Id @GeneratedValue(strategy=GenerationType.IDENTITY) privateintpId; privateStringpName; privateStringpTel; //一个人对应了一个身份证 //在关联关系中配置了mappedBy的哪一方没有权限维护另外一方 //mappedBy的值就是当前的类在下面对象中声明的这个名字 @OneToOne(mappedBy="people",cascade=CascadeType.ALL) privateIdCardidCard; } 测试: @Test publicvoidtestHelloWorld()throwsException{ EntityManagerentityManager=JPAUtils.getEntityManager(); IdCardidCard=newIdCard(); idCard.setCardNum("510...x"); idCard.setStartTime(newDate()); idCard.setEndTime(newDate()); Peoplepeople=newPeople(); people.setpName("小羽"); people.setpTel("1234566"); idCard.setPeople(people); entityManager.persist(idCard); JPAUtils.close(); } 一对多的问题 需求:部门和员工的对应 部门----->员工 一对多的关联关系 代码演示: 声明部门对象: @Entity @Table publicclassDept{ @Id @GeneratedValue(strategy=GenerationType.IDENTITY) privateintdId; privateStringdName; privateStringdDes; //一个部门有多个员工 @OneToMany(cascade=CascadeType.ALL,fetch=FetchType.LAZY,mappedBy="dept") privateSet<Employee>emps; } 声明员工对象: @Entity @Table publicclassEmployee{ @Id @GeneratedValue(strategy=GenerationType.IDENTITY) privateintempId; privateStringempName; @ManyToOne(cascade=CascadeType.ALL,fetch=FetchType.LAZY) @JoinColumn(name="dId") privateDeptdept; } 测试: @Test publicvoidtestOne2Many()throwsException{ EntityManagerentityManager=JPAUtils.getEntityManager(); Employeeemp=newEmployee(); emp.setEmpName("小娜"); Deptdept=newDept(); dept.setdName("研发部"); dept.setdDes("专门搞开发的"); emp.setDept(dept); entityManager.persist(emp); JPAUtils.close(); } 多对多的问题 需求:一个学生可以被多个老师教,一个老师也可以教多个学生 学生----->老师一对多 老师----->学生一对多 老师和学生的最终关系多对多的关联关系 代码演示: 编写老师实体: @Entity @Table publicclassTeacher{ @Id privateStringtNum; privateStringtName; @ManyToMany(cascade=CascadeType.ALL,fetch=FetchType.LAZY) @JoinTable(name="t_teacher_student", joinColumns=@JoinColumn(name="tNum"),//映射的是当前这个类的主键 inverseJoinColumns={@JoinColumn(name="stuNum")})//映射的是对方表的主键 privateSet<Student>students; } 编写学生实体: @Entity @Table publicclassStudent{ @Id privateintstuNum; privateStringstuName; privateintage; @ManyToMany(cascade=CascadeType.ALL,fetch=FetchType.LAZY,mappedBy="students") privateSet<Teacher>teachers; } 测试: @Test publicvoidtestMany2Many()throwsException{ EntityManagerem=JPAUtils.getEntityManager(); Teacherteacher=newTeacher(); teacher.settName("小羽"); teacher.settNum("007"); Set<Student>students=newHashSet<Student>(); Studentstudent=newStudent(); student.setAge(18); student.setStuName("小白"); student.setStuNum(100); Studentstudent1=newStudent(); student1.setAge(19); student1.setStuName("小娜"); student1.setStuNum(1000); Studentstudent2=newStudent(); student2.setAge(20); student2.setStuName("小黑"); student2.setStuNum(10000); students.add(student); students.add(student1); students.add(student2); teacher.setStudents(students); em.persist(teacher); JPAUtils.close(); } JPA中常见的方法 代码演示: 常见方法: publicvoidtestMethod()throwsException{ EntityManagerentityManager=JPAUtils.getEntityManager(); Useruser=newUser(); user.setUserName("小灰"); user.setuId(1); //添加数据的方法 //entityManager.persist(user); //查询数据 //Useruser2=entityManager.find(User.class,1); //这个写的是HQL语句 //Queryquery=entityManager.createQuery("fromUser"); //Listlist=query.getResultList(); //下面这个方法有主键值那么就修改没有主键值就插入 //entityManager.merge(user); /*创建的是本地SQL的查询 Queryquery=entityManager.createNativeQuery("select*fromuser"); Listlist=query.getResultList();*/ //一般用在查询中获取最新的这个数据 //entityManager.refresh(user); Useruser2=entityManager.find(User.class,1); entityManager.remove(user2); //System.out.println(list); JPAUtils.close(); } JPA中对象的状态 对象的状态: 新建状态: User user = new User();和数据库以及内存没有任何关联,对象仅仅是被new出来之后的这种状态 托管状态:对象调用了find persist refresh merge或者查询之后的这个对象状态就叫做托管状态,托管状态的数据是被entityManager管理的,并且内存和数据库的数据是对应了,这个时候如果你改变了内存的这个数据的话,并且进行提交的话,那么这个数据会和数据库进行同步 游离状态: 当前的对象调用了clear方法之后在close方法之前的这段时间,这个对象处于游离状态。clear:表示的是清楚内存和数据库数据的对应的关系 删除状态:当前对象close之后的对象的这种状态,就称为删除状态 注意事项 表名不写默认就是类作为表名 column不写,表的列名就是类的属性名 @GeneratedValue后面值不写默认是auto 结语 JPA是我们开发中离不开的经常用到的技术,其涉及的技术和知识面其实远不止上面列出的这些。 后续浅羽会继续更新关于JPA的开发知识,只希望能对大家有所帮助,谢谢大家的支持! 点点点,一键三连都在这儿!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

用户登录
用户注册