首页 文章 精选 留言 我的

精选列表

搜索[脑洞落地],共10000篇文章
优秀的个人博客,低调大师

东方通信基于 KubeSphere 的云计算落地经验

作者:周峰 吴昌泰 公司简介 东方通信股份有限公司(以下简称“东方通信”)创立于 1958 年,是一家集硬件设备、软件、服务为一体的整体解决方案提供商。公司于 1996 年成功改制上市,成为上海证交所同时发行 A 股和 B 股的国有控股上市公司。公司业务主要包括:专网通信及信息安全产品和解决方案、公网通信相关产品及 ICT 服务、金融电子设备及软件产品、智能制造业务。 十四五期间,公司主责主业聚焦在以专网通信、公网通信、ICT 服务为基础的“信息通信产业”,金融电子为基础的“金融科技产业”和“智能制造产业”三大产业,围绕主责主业不断创新与转型升级。 肩负“科技创造价值,共筑美好生活”的使命,东方通信坚持“诚信、务实、创新、共赢”的理念,致力于为客户提供优质的产品、便利的体验、完美的方案和满意的服务,努力成为在国际市场中拥有优势品牌、持续创新和发展的领先企业! 技术现状 在使用 KubeSphere 之前,公司已经开始研究云原生和探索应用上云的道路。但是由于每个团队接触和学习云原生技术的时间不同,原生 Kubernetes 的使用还是存在一定的门槛。并且随着公司云的基础设施和使用团队的的增加,也提高了云平台团队对云的管理难度。 项目的交付方式还是传统的瀑布式开发模式,没有高效的流程,不同的环境下需要对应的开发或运维人员手动部署,增大出现差异性和错误的几率。 团队规模 公司拥有国家级企业技术中心和博士后工作站,承担着多项国家重点研发项目,并多次荣获国家科技进步奖,现有员工 2500 余名,其中 75% 以上为技术专业人才。 背景介绍 近几年,云原生技术已经不再是一个新鲜词汇,根据权威 IT 研究公司 Gartner 预测,到 2025 年,云原生平台将成为 95%以上的新数字化计划的基础,而在 2021 年这一比例只有不到 40%。云原生技术在效率上的巨大优势,使其逐渐成为 IT 发展的主流趋势。 针对用户在业务上提出的一些需求,云原生技术能够为我们提供更多的选择。以我司最近的一个项目为例,用户要求为每条业务线路提供主备实例,同时还需要提供容灾备份。在传统部署方式下,需要采购的服务器数量是业务线路数量的 4 倍。但是使用云原生技术,通过容器的方式来实现业务线路之间的隔离,可以大大降低基础设施部署的成本,使用 Kubernetes 作为编排引擎,以声明式脚本的方式部署业务,规范并简化了部署流程,提高了可重复性和一致性。 上面举例中提到的只是云原生技术带来的其中一部分改变,随着业务更加深入的进行云化改造,还可以在业务的弹性和高可用,敏捷开发等方面带来更多的价值。 选型说明 工具选型的过程 公司与 KubeSphere 的相遇始于针对 Kubernetes 的 Dashboard 的选型。在使用 KubeSphere 之前,我们也研究和试用了许多其他的项目,比如 Kubernetes 官方的 Dashboard 和其他市场同类型产品。Kubernetes 官方的 Dashboard 的功能比较单一,只是提供了对集群资源的管理,市场同类型产品虽然功能更丰富,但还是无法完全满足我们的需求。 选择 KubeSphere 的原因 最终选择 KubeSphere 的原因有以下几点: 首先,KubeSphere 不仅仅只是单纯的 Dashboard ,除了针对 Kubernetes 资源管理之外,还提供了统一的集群管理、包含日志、审计、监控在内的强大的可观测性等许多附加功能。同时提供可插拔组件的部署方式,既满足了功能多样性,又满足了部署的灵活性需求。 其次,KubeSphere 很好的集成了 DevOps 自动化流程,而 DevOps 自动化流程是提高软件交付速度、保障质量和可靠性的最佳实践方法。 最后,我们看重的是 KubeSphere 活跃的开源社区。最为一款开源产品,一个充满活力的开放性开源社区,才能提供充分的能力和技术知识支持,让大家能共享开源模式所带来的红利。 实践过程 基础设施与部署架构 在使用 KubeSphere 的过程中,我们首先是借助 KubeSphere 提供的多集群和多租户功能对现有的集群资源和云上的组织整体架构做了调整,下图所示是我们现在基于 KubeSphere 的东信云组织架构。 利用多集群管理功能,对现有的集群资源进行了统一管理。既实现了隔离不同环境,又实现了跨集群的统一管理。通过统一的控制平面,将应用程序及其副本分发到不同集群,实现了集中监控、日志系统、事件和审计日志。 其次,借助多租户管理功能,为不同的事业部创建各自的企业空间(WorkSpace),在企业空间中控制资源访问权限。每个企业空间下按开发、测试、运维小组划分为不同的部门,同时为每个项目创建项目空间(NameSpace)。部门作为权限管理的逻辑单元,通过设置项目角色使部门拥有项目的对应权限,再将用户分配至部门后,简化对新加入成员的权限分配过程。 引入 DevOps 工作流,利用 S2I、B2I 实现镜像的快速交付,借助 Jenkins 流水线实现 CI/CD,帮助团队实现软件的快速、安全、可靠地交付。 借助 KubeSphere 的应用商店功能来管理应用程序的整个生命周期(提交、审核、测试、发布、升级和下架),同时我们还部署了 Harbor 来管理容器镜像。 存储实现方案 为了解决持久化存储的问题,采用基于 nfs-subdir-external-provisioner 的 storageclass 作为存储类,同时对不方便进行改造的业务支持使用本地存储。由用户创建业务 Pod 和 PVC 来申请使用一定量的存储资源,集群管理员管理存储类和 PV,如果使用的是 NFS 类型的存储,由 nfs-subdir-external-provisioner 根据 PVC 申请的存储大小自动创建 PV,如果使用的是本地存储,则由管理员负责手动创建 PV。 日志和监控方案 为了实现日志文件持久化存储,从容器中读取日志可读,且重启和掉电不丢。采用 EFK(Elasticsearch + Fluentd + Kibana)的日志收集和分析方案来帮助有效的管理和分析大规模日志数据。日志收集目标包括:Docker 组件日志、业务容器日志、管理面组件日志。Elasticsearch 组件目前是直接使用 KubeSphere 内置的 ES,后期为了提升性能,考虑接入外部的 Elasticsearch。 引入 Prometheus 服务作为监控中心,定时采集业务容器、控制面组件以及物理服务器三个层面的指标数据,通过 KubeSphere 界面或 Grafana 的界面展示详细信息。使用采集到的各种指标来判断业务或集群是否正常,针对异常可通过 Prometheus 的 AlarmManage 告警功能进行信息的转发,将告警信息同步到网管(内部管理平台)或通过邮箱、短信、钉钉等方式通知到运维人员。 多租户管理 这里我们想重点分享一下我们针对 KubeSphere 的多租户结构的分析,KubeSphere 在 Kubernetes 的 RBAC 和命名空间提供的基本的逻辑隔离能力基础上,增加了企业空间提供了跨集群、跨项目(即 Kubernetes 中的命名空间)共享资源的能力和权限控制。下面的分析都是基于我们公司使用的 KubeSphere V3.3.0 版本展开。 多租户元素 资源类型 来源 用户 users.iam.kubesphere.io KubeSphere crds 平台角色 globalroles.iam.kubesphere.io KubeSphere crds 平台角色绑定 globalrolebindings.iam.kubesphere.io KubeSphere crds 企业空间 workspaces.tenant.kubesphere.io KubeSphere crds workspacesTemplate.tenant.kubesphere.io KubeSphere crds 企业空间角色 workspaceroles.iam.kubesphere.io KubeSphere crds 企业空间角色绑定 workspacerolebindings.iam.kubesphere.io KubeSphere crds 项目 namespace K8s 自带 项目角色 roles K8s 自带 项目角色绑定 rolebindings K8s 自带 用户 Users 用户是 KubeSphere 的帐户实例,是登陆 KubeSphere 控制台的实体账号,在 KubeSphere 中使用 users.iam.kubesphere.io 资源对用户进行抽象。 用户信息中保存了用户名、密码、最后登陆时间等信息。 平台角色 globalroles 在 KubeSphere 中平台角色使用 globalroles.iam.kubesphere.io 资源抽象。安装成功后,会预创建 4 个内置的平台角色,每个平台角色实际又关联着一个或多个平台模板角色(平台角色的权限是关联模板角色权限的集合)。 内置角色 描述 workspaces-manager 企业空间管理员,管理平台所有企业空间。 users-manager 用户管理员,管理平台所有用户。 platform-regular 平台普通用户,在被邀请加入企业空间或集群之前没有任何资源操作权限。 platform-admin 平台管理员,可以管理平台内的所有资源。 以 users-manager 角色为例子,其关联了用户查看、角色查看、用户管理、角色管理四个模板角色,这让 users-manager 角色拥有了这四个角色模板下所对应的资源访问权限。 平台角色绑定 globalrolebindings 创建用户后,需要为用户分配一个平台角色,使用 globalrolebindings.iam.kubesphere.io资源来抽象用户和平台角色的绑定关系。 在创建一个新的平台角色时,需要编辑权限,此时就是为新创建的平台角色关联预创建的角色模板。 企业空间 WorkSpace 企业空间是 KubeSphere 中用来管理项目、DevOps 项目、应用模板和应用仓库的一种逻辑单元。可以在企业空间中控制资源访问权限,也可以安全地在团队内部分享资源。在 KubeSphere 中使用 workspaces.tenant.kubesphere.io 和 workspacesTemplate.tenant.kubesphere.io 资源对企业空间进行抽象。 企业空间角色 workspaceroles 在 KubeSphere 中企业空间角色使用 workspaceroles.iam.kubesphere.io 资源抽象。安装成功后,会预创建 4 个内置的企业空间角色,每个企业空间角色实际又关联着一个或多个企业空间模板角色(企业空间角色的权限是关联企业空间模板角色权限的集合)。 名称 描述 workspace-viewer 企业空间观察员,可以查看企业空间中所有资源。 workspace-self-provisioner 企业空间普通成员,可以查看企业设置、管理应用模板、创建项目和 DevOps 项目。 workspace-regular 企业空间普通成员,可以查看企业空间设置。 workspace-admin 企业空间管理员,可以管理企业空间中的所有资源。 以 system-workspace-viewer 为例子,其关联了业空间设置查看、角色查看、成员查看、部门查看、项目查看、DevOps 项目查看、应用模板查看、应用仓库查看八个模板角色。 企业空间角色绑定 workspacerolebindings 在企业空间中,可以在企业空间成员处邀请用户加入企业空间,邀请用户加入时,还需要为其分配企业空间角色,使用 workspacerolebindings.iam.kubesphere.io 资源来抽象用户和企业空间角色的绑定关系。 此处以企业空间的默认管理员角色为例(管理员的角色绑定是在创建企业空间时选择管理员时绑定)。 项目 NameSpace KubeSphere 中项目就是 K8s 中的命名空间,使用的就是 NameSpace 资源来抽象项目,企业空间和项目的关系是一对多,即一个企业空间下,可以创建多个项目。K8s 的默认命名空间和 KubeSphere 系统相关的命名空间,都归属于默认企业空间 system-workspace。 下面在前面创建的 demo-ws 企业空间下创建一个新的项目 demo-ws-project-01。 项目角色 roles 在 KubeSphere 中项目角色对应的就是 K8s 自带的 roles 资源。但是通过 KubeSphere 创建新项目时,会自动创建 3 个内置的项目角色,每个项目角色实际又关联着一个或多个项目模板角色(项目角色的权限是关联项目模板角色权限的集合)。 内置角色 描述 viewer 项目观察者,可以查看项目下所有的资源。 operator 项目维护者,可以管理项目下除用户和角色之外的资源。 admin 项目管理员,可以对项目下的所有资源执行所有操作。此角色可以完全控制项目下的所有资源。 下图展示的是 demo-ws-project-01 项目下的项目角色,如需查看其他项目下的角色,需要带-n参数指定项目名(命名空间)。 以 viewer 角色为例,关联了如下的项目模板角色。 项目角色绑定 rolebindings 在项目下,可以在项目成员处邀请用户加入项目,邀请用户加入时,还需要为其分配项目角色,此时使用的就是 K8s 自带的 rolebindings 资源。 以 demo-ws-project-01 项目下绑定关系为例。 从下图可以看到,admin 用户绑定了该项目下的 admin 角色。 使用效果 对比使用 KubeSphere 之前,在针对 Kubernetes 集群的管理和使用上,我们有以下几点感受: 在使用了 KubeSphere 之后,原有的分散管理的多个集群在逻辑上组成了一个大一统环境,集群管理的许多操作不需要再分别连接到不同集群上去操作,对多个集群的状态监控也能够在统一的入口获取,极大的提高了管理的效率。 项目交付和部署更加的规范,减少了因环境和不同人员操作而可能产生的差异性,特别是应用商城让应用如同货架上的商品一样唾手可得,应用的部署也只需要很少的修改后即可一键安装。 友好的用户界面和可视化的操作方式,降低了公司其他团队使用云的门槛,让即使是刚接触云原生的团队,也能很快的上手。 未来规划 未来我们计划探索和使用更多 KubeSphere 的组件功能,如审计日志、服务网格等。针对东信团队的内部需求,对 KubeSphere 的源码进行二次开发,并争取能够回馈社区。积极参与社区活动,与社区进行更加深入的交流。 同时,对于 KubeSphere,我们也有一些建议: KubeSphere 页面上能提供的监控数据只有 CPU 内存这些基本数据,日志检索功能也不是特别方便,我们现在是通过手动跳转到 Grafana 和 Kibana 页面使用,希望未来能有更好用的日志和监控功能。 目前官方提供的使用文档相对简单,有些功能只是简略带过,希望能细化文档,最好是出一些视频类的使用教程。 源码中的注解信息比较少,增加了源码解读的难度,也希望官方能推出一些指导源码解读的文档。 本文由博客一文多发平台 OpenWrite 发布!

优秀的个人博客,低调大师

Kerberos身份验证在ChunJun中的落地实践

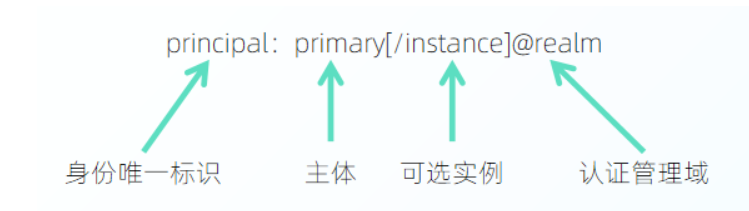
Kerberos,在古希腊神话故事中,指的是一只三头犬守护在地狱之门外,禁止任何人类闯入地狱之中。 那么在现实中,Kerberos指的是什么呢? 一、Kerberos介绍 01 Kerberos是什么 根据百度词条释义,Kerberos是一种计算机网络授权协议,用来在非安全网络中,对个人通信以安全的手段进行身份认证。Kerberos旨在通过密钥加密技术为客户端/服务器应用程序提供身份验证,主要用在域环境下的身份验证。 在此之前,通常只有服务器的运维管理人员在配置Active Directory之类的东西时才会接触到Kerberos,但随着大数据的流行,整个Hadoop生态圈在安全方面对于Kerberos愈发依赖,同时由于Kerberos认证必须入侵式改造代码的特点,使得越来越多的大数据开发同学开始接触到Kerberos。 02 Kerberos 解决了什么问题 目前用于身份密码的验证主要面临两个问题:首先是人工记忆的密码混乱且易遗忘,一些比较简单的密码又容易被攻击;其次是技术错觉,在计算机上的输入密码时显示的是一串星号,大家误以为很安全,实际上计算机通过网络发送密码基本是发送“明文”密码,大部分密码都处于“裸奔”状态。 Kerberos的出现很好的解决了这个问题,它减少了每个用户使用整个网络时必须记住的密码数量——只需记住 Kerberos 密码,同时Kerberos结合了加密和消息完整性来确保敏感的身份验证数据不会在网络上透明地发送。通过提供安全的身份验证机制,Kerberos为最终用户和管理员提供了明显的好处。 03 Kerberos 基本概念 principal 是Kerberos 世界的用户名,用于标识身份,每个用户都会有一个 principal,如果 principal 失效或者不正确,那么这个用户将无法访问任何资源。principal 主要由三部分构成:primary,instance(可选) 和 realm。 ● primary 主体,每个 principal 都会有的组成部分,代表用户名(username)或服务名(service name)。 ● instance 用于服务主体以及用来创建用于管理的特殊主体。instance 用于服务主体时的一般会用于区分同一服务在不同服务器上的服务实例,因此与 primary 组成的 principal 一般用于 server 端,如:NameNode,HiverServer2,Presto Coordinator等。 instance 用来创建用于管理的特殊主体时,一般来区分同一个用户的不同身份,如区分担任管理员角色的 a 用户与担任研发的 a 用户。 ● realm realm 是认证管理域名,用来创建认证的边界,只有在同属于一个认证服务的边界内,这个认证服务才有权利认证一个用户、主机或者服务。每个域都会有一个与之对应的 kdc 服务用于提供域内的所有服务的认证服务。 ● keytab "密码本",包含了多个 principal 与密码的文件,用户可以利用该文件进行身份认证。 ● ticket cache 客户端与 KDC 交互完成后,包含身份认证信息的文件,短期有效,需要不断renew。 04 Kerberos 的认证简介 参与 Kerberos 认证过程中的角色: 访问服务的 Client; 提供服务的 Server; DC是Domain Controller的缩写,即域控制器;AD是Active Directory的缩写,即活动目录。DC中有一个特殊用户叫做krbtgt,它是一个无法登录的账户,是在创建域时系统自动创建的,在整个Kerberos认证中会多次用到它的Hash值去做验证。 KDC(Key Distribution Center)密钥分发中心。在KDC中又分为两个部分:Authentication Service(AS,身份验证服务)和Ticket Granting Service(TGS) AD会维护一个Account Database(账户数据库), 它存储了域中所有用户的密码Hash和白名单,只有账户密码都在白名单中的Client才能申请到TGT。 05 Kerberos详细认证流程 1. Client with AS 客户端(Client)向 AS(Authentication Service)发送请求获取 TGT(ticket grant ticket) 2. Client with TGS 客户端(Client)向 TGS(Ticket Granting Service,)发送请求获取ST(Service Ticke) 客户端(Client)向服务端(Server)发送认证请求进行认证,如果客户端(Client)要求进行双向认证,服务端(Server)额外发送认证请求至客户端(Client)进行认证。 3.Kerberos 与 JAAS可插拔的认证模块 JAAS jdk 在1.4引入的一种可插拔的认证模块( Pluggable Authentication Module,PAM )的安全体系结构,这意味着可以通过改变模块,支持从一种安全协议组件无缝的切换到另一个协议组件。 同时这种体系架构定义的接口无需修改代码即可实现加入多种认证技术和授权机制,因为 JAAS API 定义了应用程序代码与实际验证逻辑之间的抽象,这个抽象不用重新编译现有的应用程序代码就可以作为登录模块的运行时替代。 这种实现方式是通过应用程序只调用 LoginContext 接口,而认证技术的实际提供程序则是基于 LoginModule 接口进行开发的,在运行时LoginContext 通过读取配置文件确定使用哪些认证模块来对应用程序进行认证。 二、ChunJun任务提交中的Kerberos认证 接下来我们来大家介绍下ChunJun任务提交中的 Kerberos 认证,我们可以参考ChunJun的 readme 文档中的 yarn session 部分: https://github.com/DTStack/chunjun/blob/master/README_CH.md 01 Flink 提交流程中的 Kerberos 首先,我们需要启动一个 yarn session 环境,进入 Flink 的 bin 目录下执行 yarn-session 脚本启动 flink session 并使用 -t 参数上传 ChunJun 的依赖包。 当我们执行 yarn-session 时,脚本内部会调用 java 命令运行 FlinkYarnSessionCli 这个类的 main 方法。在 FlinkYarnSessionCli 的 main 方法中,首先需要安装一个全过程的安全配置,然后获得一个安装后的上下文,并且在上下文中运行 run 方法。 在 run 方法中我们构建了一个 YarnClusterDescripter 对象,这个对象中封装了 Flink 所依赖的配置文件和 jar 包等。而后再调用YarnClusterDescripter 对象的 DeploySessionClister 方法将任务提交到 yarn 集群。至此完成了 Flink session 到 Yarn 的一个提交。 我们再回顾下整体的提交流程: ● Flink => HDFS Flink 需要将配置文件以及 session 所依赖的 jar 上传至 HDFS,因此需要与 HDFS 进行通信 ● Flink => Yarn Flink 需要向 Yarn 申请资源,因此需要与 Yarn 进行通信 ●Flink => Zookeeper 如果 Flink 配置了基于 zookeeper 的高可用,那么 JobManager 需要在 Zookeeper 注册 leader 节点,客户端还需要从 Zookeeper 上的 leader 节点获取 webMonitorUrl,因此需要与 Zookeeper 通信 02 Flink SecurityUtils作用于 Kerberos 认证 1.SecurityUtils.java 2.SecurityUtils#install 方法中首先通过 installModules 方法对 Flink 内部的安全模组进行了 install(其中包括Hadoop、Jaas、Zookeeper 模组) 3.SecurityUtils#installContext 方法对安全上下文进行初始化(获得 HadoopSecurityContext,其中包含这 hadoop 的认证凭证 ugi) 03 Flink Hadoop Kerberos 认证 $Flink_HOME/conf/Flink-conf.yaml security.Kerberos.login.use-ticket-cache: 是否从你的Kerberos ticket缓存中读取 security.Kerberos.login.keytab: 包含用户凭证的Kerberos keytab文件的绝对路径。 security.Kerberos.login.principal: 与keytab相关的Kerberos principal名称。 security.Kerberos.krb5-conf.path:指定 krb5.conf 文件的本地位置。如果定义了,这个conf将被挂载到Kubernetes、Yarn和Mesos的JobManager和TaskManager容器/桶上。注意: 需要在容器内部可访问到定义的 KDC 的地址。 security.Kerberos.login.contexts: 用逗号分隔的登录上下文列表,以提供Kerberos凭证(例如,Client,KafkaClient用于ZooKeeper认证和Kafka认证的凭证)。 zookeeper.sasl.service-name: 默认为 "zookeeper"。如果ZooKeeper quorum配置了一个不同的服务名称,那么可以在这里提供。 zookeeper.sasl.login-context-name: 默认为 "Client"。该值需要与 "security.Kerberos.login.contexts"中配置的值之一相匹配。 04 ChunJun 提交流程中的 Kerberos 执行 ChunJun-Yarn-session.sh 提交任务,ChunJun-Yarn-session.sh 实际上只是对任务的脚本路径进行了检查校验,然后再执行 submit.sh 脚本启动任务提交进程。 Launcher 的 main 方法中主要对不同的任务执行模式进行区分并交给各个模式具体的任务提交类去提交任务。 YarnSessionClusterClientHelper 将任务的配置以及依赖的 jar 进行组装获得 YarnClusterDescriptor 对象。再将任务提交到对应的 Flink session 上。 三、ChunJun Connector 中的Kerberos 认证 接下来为大家介绍 ChunJun Connector 中的 Kerberos 认证 。 01ChunJun 插件中的 Kerberos 以 ChunJun HDFS Connector 为例: 插件在 openInputFormat 方法中会对任务的目标数据源 HDFS 是否开启了 Kerberos 进行判断,如果开启了 Kerberos,则会根据配置的认证文件进行认证并获取认证后的 ugi,ugi 可以认为是之后插件与 HDFS 通信的用户凭证,里面保存着用户的认证信息. 02 如何进行Kerberos 认证 ● OpenInputFormat 方法 OpenInputFormat 方法是 Flink 对算子的每个实例进行初始化是都会执行的方法,ChunJun 的BaseRichInputFormat 也实现了该方法,我们开发插件也都会去实现该方法。 对于每个算子实例来说,Kerberos 认证只会进行一次(不包括认证过期后的刷新),因此 Kerberos 认证的代码应该在该方法中实现. ● 开发 hadoop 生态中的数据源组件 一般而言,Hadoop 生态中的数据源组件如:HDFS、HBase、Hive 等都是用 ugi(UserGroupInformation) 进行 Kerberos 认证。 ChunJun 内部也提供了相关的工具类用于获取登录后的 ugi:com.dtstack.ChunJun.util.FileSystemUtil#getUGI ● 开发 Zookeeper、Kafka 等组件 这类组件开启 Kerberos 认证后,用户需要在插件端配置 jaas.conf 文件,再通过各个组件提供的参数配置项配置组件所选用的 jaas.conf 的 entry,即可完成 Kerberos 配置。 03 如何排查 Kerberos 认证问题 $Flink_HOME/conf/Flink-conf.yaml #jvm 启动参数中增加 “-Dsun.security.krb5.debug=true” env.java.opts:用于配置启动所有Flink进程的JVM 参数 env.java.opts.jobmanager:用来配置启动 JobManager 的 JVM 参数 env.java.opts.taskmanager:用来配置启动 TaskManager 的 JVM 参数 env.java.opts.historyserver:用来配置启动 HistoryServer 的 JVM 参数 env.java.opts.client:用来配置启动 Flink Client 的 JVM 参数 04 Kerberos 认证常见问题 1.javax.security.sasl.SaslException: GSS initiate failed [Caused by GSSException: No valid credentials provided (Mechanism level: Failed to find any Kerberos tgt)] 此消息表明一个操作尝试要求以Kerberos的user/host@realm身份认证的操作,但票据cache中没有用于user/host@realm的票据。 用户环境引用的策略/票证缓存文件丢失、不可读(权限)、损坏或无效票证续签寿命设置为零 票证授予票证(TGT)不存在,因为服务A需要将命令作为服务B运行,但尚未正确配置为允许模拟服务B 票证更新尚未执行/未成功。这可能是由于CDH 5.3之前的HBASE或CDH5.2之前的Hive / Sentry缺陷引起的 该用户的凭据尚未在KDC中生成 执行了手动步骤,例如hadoop fs -ls,但是用户从未通过Kerberos身份验证 Oracle JDK 6 Update 26或更早版本无法读取由MIT Kerberos 1.8.1或更高版本创建的Kerberos凭证高速缓存。 某些版本的Oracle JDK 8可能会遇到此问题 2.javax.security.sasl.SaslException: GSS initiate failed [Caused by GSSException: No valid credentials provided (Mechanism level: Fail to create credential. (63) - No service creds)] 由JDK缺陷引起 票证消息对于UDP协议而言太大 主机未正确映射到Kerberos领域 3.Found unsupported keytype(18) 确保正确安装了与JDK相匹配的无限强度策略文件的正确版本 确保对策略文件(位于jdk目录中,例如/usr/java/jdk1.7.0_67-cloudera/jre/lib/security/)的许可权能够被所有用户读取。 确保文件已部署到集群软件正在使用的jdk中 有关详细信息,使用以下的(链接以匹配关键字类型号18在该实例中)将其加密类型http://www.iana.org/assignments/Kerberos-parameters/Kerberos-parameters.xml(AES256-CTS-HMAC-此示例为sha1-96) 4.GSSException: No valid credentials provided (Mechanism level: Server not found in Kerberos database (7) - UNKNOWN_SERVER) hostname或要访问的URL与keytab中列出的主机之间发生主机名不匹配。造成这种情况的原因多种多样,包括但不限于: 多网卡(NIC)服务器,以使来自主机的数据包的IP地址与通过主机解析返回的IP不匹配 负载平衡器和后续的主机名解析问题 DNS和主机名解析问题/不一致 反向DNS(必需)主机名解析问题/不一致 在krb5.conf中主机正在映射到参数[domain_realm]的错误域,这或者是通过其他的krb5.conf配置,或者是通过KDC配置。默认参数情况下,除非使用[domain_realm]等进行显式配置,否则主机名(例如:“ crash.EXAMPLE.com ”)将映射到域“ EXAMPLE.com ” 。请参见MIT Kerberos文档:[domain_realm] 如果尝试在Cloudera Manager中执行“ Generate Credentials ”步骤(在更高版本中重命名为“ Generate Missing Credentials ”)时发生此错误,则可能是由于导入到Cloudera Manager数据库中的管理员帐户详细信息不再与主机匹配,例如Cloudera Manager服务器的主机名在上一次导入后随后更改了。 视频回放&PPT获取 视频回看: https://www.bilibili.com/video/BV1mD4y1h7ce/?spm_id_from=333.999.0.0 课件获取: 关注公众号“ChunJun”,后台私信“课件”获得直播课件 想了解或咨询更多有关袋鼠云大数据产品、行业解决方案、客户案例的朋友,浏览袋鼠云官网:https://www.dtstack.com/?src=szkyzg 同时,欢迎对大数据开源项目有兴趣的同学加入「袋鼠云开源框架钉钉技术qun」,交流最新开源技术信息,qun号码:30537511,项目地址:https://github.com/DTStack

优秀的个人博客,低调大师

企业级容器云平台的落地与实践

随着IT行业的发展和变迁,IT应用的底层支持也从大型机、小型机、PC服务器、虚拟化技术,到如今的容器化。基于敏捷开发的持续迭代,持续部署,以及多样化的技术栈,传统的底层架构变得越来越冗杂,运维管理越来越力不从心,运维人员也逐步陷落在无尽的“救火”运维模式。 容器技术的出现,从根本上改变了这一切。而容器高效的编排与管理,才是让其风光无限的前提条件。Kubernetes经过多年的发展,已经成为行业的事实标准。而如何利用好Kubernetes,为企业的发展助力,成为很多企业,尤其是初创企业无法忽略的一道难题。 本文将介绍利用Amazon EKS打造企业级容器云平台,通过一系列的实践操作,让大家直观地了解AWS是如何帮助企业高效地部署、管理容器化应用。 1. 传统应用架构的容器化之路 说到“传统”二字,大家第一反应,就是“落后”,“守旧”,然而现实情况却是----绝大部分传统应用,依然在良好地运行在这些传统架构中。这些被服务的对象不会因为某些因素对整个系统资源的需求发生很大变化,也不会有频繁的系统功能的迭代开发需求。 但是随着互联网、大数据、AI等技术的发展,各行各业都在努力地从信息化向智能化转型。而转型的过程中,越来越多的应用场景,和频繁地迭代开发,也让“传统”架构越来越庞大。随之而来的是运维人员疲于奔命的“救火”,系统服务越来越不稳定,以及系统成本的失控飞涨。 如何才能从根本上一劳永逸地解决这些问题? 容器化/微服务化是很多企业寄予厚望的方向。 容器化真的那么有效吗? 我们以下图为例。这是一个很通用的架构,在多台服务器上分别部署Tomcat,使用反向代理软件(Nginx)把请求均匀分发到每个Tomcat中。假定由于11.11促销,我们需要将现有的3台Tomcat扩充到10台,运维人员需要完成哪些工作?(假设服务器硬件已经准备好) 传统系统的扩容步骤: 1. 安装OS,设置安全和权限相关2. 分配IP,联网3. 部署Tomcat4. 以上动作做7遍 仅仅一个扩容,就需要一个资深的运维人员花费几个小时才能完成。如果要扩充到100个节点呢,工作量成倍增加。 容器化系统扩容步骤: 如果我们使用容器化技术来完成刚刚这件事,就会节省很多人力。 1. 安装OS,并由Kubernetes统一管理2. 一条命令足以,并且在秒级完成扩展 kubectlscalerctomcat--replicas=10 3. 完成 简单的一个对比,即可发现,在资源分配,系统稳定(自愈),运维管理等多个方面,容器化技术都可有效地降低企业的成本和运维压力,并且让企业保持技术的敏捷性和先进性。 2. 容器化应用场景 刚刚讨论过容器化对于企业的价值,接下来要继续分析哪些场景适合容器化。 容器化很重要的特点,就是轻量化和无状态。而像传统的企业应用软件,承载业务模块众多,功能流程繁琐,因此并不适合容器化改造。具体哪些应用场景比较适合呢?主要包含以下几种场景(当然,这只是几种常见情况,业务场景满足轻量化、无状态的特点都是可以尝试容器化技术) 2.1. 应用打包2.2. 多版本混合部署2.3. 升级回滚2.4. 多租户资源隔离2.5. 内部开发环境 我们一直在说容器化(Docker为代表)的各种优势,但是企业在真正的生产环境中,如果只是通过Docker来实现容器化,是无法满足高可用、弹性扩展和高并发等场景需求。而Kubernetes的出现,才让Docker真正在生产环境中被大规模使用起来。Kubernetes提供了应用部署、规划、更新、维护的一种机制,让容器化应用的部署和管理更简单、更高效,。 Kubernetes的特点: · 可移植: 支持公有云,私有云,混合云,多云(multi-cloud)· 可扩展: 模块化,插件化,可挂载,可组合· 自动化: 自动部署,自动重启,自动复制,自动伸缩/扩展 Kubernetes结合Docker,让企业容器化之路变得更加容易,从而更快地满足业务需求。 但是,事物都是有两面性,并不是所有项目都适合容器化改造,而且任何的改动都有可能产生未知的影响,要对技术保持敬畏,对生产保持敬畏,才能在容器化的道路上走的更稳。 Kubernetes虽好,但是对于很多初创企业,和没有太多相关技术积累的传统企业,Kubernetes的学习成本过高,企业会在底层架构的高可用性、网络、机房等方面遇到一系列问题,从而让容器化之路满是荆棘。 3. Amazon EKS助力企业快速实现容器化转型 如何快速、高效地拥有自己的容器化平台呢?下面一段,就是AWS官网上Amazon EKS的介绍: Amazon EKS 是一项托管服务,可让您在 AWS 上轻松运行 Kubernetes,而无需安装、操作和维护您自己的 Kubernetes 控制层面或节点。Kubernetes 是一个用于实现容器化应用程序的部署、扩展和管理的自动化的开源系统。 Amazon EKS 跨多个可用区运行 Kubernetes 控制层面实例以确保高可用性。Amazon EKS 可以自动检测和替换运行状况不佳的控制层面实例,并为它们提供自动版本升级和修补。 Amazon EKS 与许多 AWS 服务集成以便为您的应用程序提供可扩展性和安全性,包括: · 用于容器镜像的 Amazon ECR· 用于负载分配的 Elastic Load Balancing· 用于身份验证的 IAM· 用于隔离的 Amazon VPC Amazon EKS 运行最新版本的开源 Kubernetes 软件,因此您可以使用 Kubernetes 社区中的所有现有插件和工具。在 Amazon EKS 上运行的应用程序与在任何标准 Kubernetes 环境中运行的应用程序完全兼容,无论此类环境是在本地数据中心还是在公有云中运行都是如此。这意味着,您可以轻松地将任何标准 Kubernetes 应用程序迁移到 Amazon EKS,而无需修改任何代码。 4. 理论结合实际,让容器化更直观 理论说了一大堆,不如动手玩起来。下面,我设计一个场景,在Amazon EKS上逐步完成容器化部署,并逐步在每个环节介绍技术细节。 1) 通过Nginx,做三个页面web1,web2,web32)将三个web页面作为一组服务,由Amazon EKS管理3) 通过http访问,轮询到三个不同的页面,来看到效果 注释:web1,web2,web3实际生产应该是一个业务,只不过为了显示实验效果,通过不同的页面,展示轮询的效果 4.1. 环境准备 4.1.1. 需要一个AWS账号4.1.2. 账号资源限制检查,确保有足够的IGW,VPC,EIP等4.1.3. 安装awscli(包含eksctl)及配置kubectl: 4.1.3.1. awscli安装: curl"https://awscli.amazonaws.com/awscli-exe-linux-x86_64.zip"-o"awscliv2.zip" unzipawscliv2.zip sudo./aws/install 检查安装结果 $aws--version 安装方法参考链接:https://docs.aws.amazon.com/zh_cn/cli/latest/userguide/cli-chap-install.html 4.1.3.2. 配置kubectl, awseks--regioncn-northwest-1update-kubeconfig--namemy-zhy-eks 官方配置方法链接:https://docs.amazonaws.cn/eks/latest/userguide/create-kubeconfig.html 4.2. 创建Amazon EKS集群: 4.2.1. 创建命令 #命令,参数注释 --node-type 工作节点类型--nodes 工作节点数量CLUSTER_NAME 集群名称AWS_REGION cn-northwest-1:宁夏区; cn-north-1:北京区 创建命令: AWS_REGION=cn-northwest-1 AWS_DEFAULT_REGION=cn-northwest-1 CLUSTER_NAME=my-zhy-eks eksctlcreatecluster--name=${CLUSTER_NAME}--version1.15--nodes=3--node-typet3.medium--managed--alb-ingress-access--region=${AWS_REGION} 4.2.2. 成功执行的输出: eksctlcreatecluster--name=${CLUSTER_NAME}--version1.15--nodes=3--node-typet3.medium--managed--alb-ingress-access--region=${AWS_REGION} [ℹ]eksctlversion0.32.0 [ℹ]usingregioncn-northwest-1 [ℹ]settingavailabilityzonesto[cn-northwest-1bcn-northwest-1ccn-northwest-1a] [ℹ]subnetsforcn-northwest-1b-public:192.168.0.0/19private:192.168.96.0/19 [ℹ]subnetsforcn-northwest-1c-public:192.168.32.0/19private:192.168.128.0/19 [ℹ]subnetsforcn-northwest-1a-public:192.168.64.0/19private:192.168.160.0/19 [ℹ]usingKubernetesversion1.15 [ℹ]creatingEKScluster"my-zhy-eks"in"cn-northwest-1"regionwithmanagednodes [ℹ]willcreate2separateCloudFormationstacksforclusteritselfandtheinitialmanagednodegroup [ℹ]ifyouencounteranyissues,checkCloudFormationconsoleortry'eksctlutilsdescribe-stacks--region=cn-northwest-1--cluster=my-zhy-eks' [ℹ]CloudWatchloggingwillnotbeenabledforcluster"my-zhy-eks"in"cn-northwest-1" [ℹ]youcanenableitwith'eksctlutilsupdate-cluster-logging--enable-types={SPECIFY-YOUR-LOG-TYPES-HERE(e.g.all)}--region=cn-northwest-1--cluster=my-zhy-eks' [ℹ]KubernetesAPIendpointaccesswillusedefaultof{publicAccess=true,privateAccess=false}forcluster"my-zhy-eks"in"cn-northwest-1" [ℹ]2sequentialtasks:{createclustercontrolplane"my-zhy-eks",2sequentialsub-tasks:{notasks,createmanagednodegroup"ng-e5146e45"}} [ℹ]buildingclusterstack"eksctl-my-zhy-eks-cluster" [ℹ]deployingstack"eksctl-my-zhy-eks-cluster" [ℹ]buildingmanagednodegroupstack"eksctl-my-zhy-eks-nodegroup-ng-e5146e45" [ℹ]deployingstack"eksctl-my-zhy-eks-nodegroup-ng-e5146e45" [ℹ]waitingforthecontrolplaneavailability... [✔]savedkubeconfigas"/root/.kube/config" [ℹ]notasks [✔]allEKSclusterresourcesfor"my-zhy-eks"havebeencreated [ℹ]nodegroup"ng-e5146e45"has3node(s) [ℹ]node"ip-192-168-5-37.cn-northwest-1.compute.internal"isready [ℹ]node"ip-192-168-58-97.cn-northwest-1.compute.internal"isready [ℹ]node"ip-192-168-65-234.cn-northwest-1.compute.internal"isready [ℹ]waitingforatleast3node(s)tobecomereadyin"ng-e5146e45" [ℹ]nodegroup"ng-e5146e45"has3node(s) [ℹ]node"ip-192-168-5-37.cn-northwest-1.compute.internal"isready [ℹ]node"ip-192-168-58-97.cn-northwest-1.compute.internal"isready [ℹ]node"ip-192-168-65-234.cn-northwest-1.compute.internal"isready [ℹ]kubectlcommandshouldworkwith"/root/.kube/config",try'kubectlgetnodes' [✔]EKScluster"my-zhy-eks"in"cn-northwest-1"regionisready 4.2.3. Eksctl执行之后,需要等待10分钟左右。模式很简单的步骤,其实是AWS通过调用cloudformation在后台做了许多工作才完成的。下图是cloudformation的stack步骤: 4.2.4. Amazon EKS完成后的,cloudformation状态 4.2.5. 查询node状态信息 #kubectlgetnode NAMESTATUSROLESAGEVERSION ip-192-168-5-37.cn-northwest-1.compute.internalReady<none>11mv1.15.12-eks-31566f ip-192-168-58-97.cn-northwest-1.compute.internalReady<none>11mv1.15.12-eks-31566f ip-192-168-65-234.cn-northwest-1.compute.internalReady<none>11mv1.15.12-eks-31566f 4.2.6. 扩展集群节点方法 我们之前通过eksctl创建了一个3节点的集群[WHE5][XX6],如果由于业务的增加,希望扩容的话,如何操作呢?具体命令参考如下,将当前集群,扩容到10个节点: NODE_GROUP=$(eksctlgetnodegroup--cluster${CLUSTER_NAME}--region=${AWS_REGION}-ojson|jq-r'.[].Name') eksctlscalenodegroup--cluster=${CLUSTER_NAME}--nodes=10--name=${NODE_GROUP}--region=${AWS_REGION} 检查结果 eksctlgetnodegroup--cluster${CLUSTER_NAME}--region=${AWS_REGION} eksctlgetcluster NAMEREGION my-zhy-ekscn-northwest-1 4.3. Amazon ECR的使用 针对一个企业,很多image都是定制化的,而定制化的私有image管理,在AWS是如何操作的呢? Amazon ECR,让image的管理,变得更简单易用。下面通过httpd的image,定制化并生成私有httpdok的image之后,并上传到Amazon ECR,作为步骤演示: 4.3.1. 首先创建一个Amazon ECR Repositories,选择并点击View push commands. 4.3.2. 根据”View puhs commands”步骤,将本地创建好的image,上传到Amazon ECR。 具体命令步骤: #awsecrget-login-password--regioncn-northwest-1|dockerlogin--usernameAWS--password-stdin<account_id>.dkr.ecr.cn-northwest-1.amazonaws.com.cn 查看本地镜像 #dockerimages REPOSITORYTAGIMAGEIDCREATEDSIZE httpdokv1df353399ffe47secondsago299MB 为镜像打标签 #dockertaghttpdok:latest<account_id>.dkr.ecr.cn-northwest-1.amazonaws.com.cn/httpdok:latest 在查看本地Docker的images,可以看到已经出现一个新的,有ECR连接串的image #dockerimages REPOSITORYTAGIMAGEIDCREATEDSIZE <account_id>.dkr.ecr.cn-northwest-1.amazonaws.com.cn/httpdoklatest9028c43733434minutesago299MB httpdoklatest9028c43733434minutesago299MB 推送image到ECR上 #dockerpush<account_id>.dkr.ecr.cn-northwest-1.amazonaws.com.cn/httpdok:latest Thepushreferstorepository[<account_id>.dkr.ecr.cn-northwest-1.amazonaws.com.cn/httpdok] 回到aws控制台,已经可以看到上传的image 4.4. Amazon EKS实例演示 下面开始部署容器到Amazon EKS中,通过Nginx来演示如何部署image到Amazon EKS,并轮询访问. 4.4.1. 启动三个nginx pod 的 ReplicaSet 准备yaml文件 cat<<EOF>nginx-deployment.yaml apiVersion:apps/v1 kind:Deployment metadata: name:nginx-deployment labels: app:nginx spec: replicas:3 selector: matchLabels: app:nginx template: metadata: labels: app:nginx spec: containers: -name:nginx image:nginx:1.14.2 ports: -containerPort:80 EOF 执行以下命令,进行部署 kubectlapply-fnginx-deployment.yaml 检查创建状态 kubectlgetpods-owide 4.4.2. 创建LoadBalancer 服务 准备yaml文件 cat<<EOF>loadbalancer.yaml apiVersion:v1 kind:Service metadata: name:nginx-service spec: type:LoadBalancer selector: app:nginx ports: -protocol:TCP port:80 targetPort:80 EOF 执行以下命令,进行部署 kubectlcreate-floadbalancer.yaml 4.4.3. 检查创建状态 kubectlgetservice NAMETYPECLUSTER-IPEXTERNAL-IPPORT(S)AGE nginx-serviceLoadBalancer10.100.212.244ae8e75d7e149044eb905b6bbff796e7e-629951941.cn-northwest-1.elb.amazonaws.com.cn80:31248/TCP7m53s 4.4.4. 监测网页显示情况 curl-silentae8e75d7e149044eb905b6bbff796e7e-629951941.cn-northwest-1.elb.amazonaws.com.cn|greptitle <title>Welcometonginx!</title> 至此,我们已经开始使用EKS上的Nginx集群了。但是为了建议Load balance的工作效果。我们继续下面的小实验,可以更好的观察load balance的效果 4.5. 轮询效果展示 4.5.1. 获取pod信息 kubectlgetpod NAMEREADYSTATUSRESTARTSAGE nginx-deployment-574b87c764-92jbs1/1Running010h nginx-deployment-574b87c764-hmz9t1/1Running010h nginx-deployment-574b87c764-nqpmc1/1Running010h 4.5.2. 以下命令是确定pod中nginx的欢迎界面的index.html位置 kubectlexec-itnginx-deployment-574b87c764-92jbs--/usr/sbin/nginx-t kubectlexec-itnginx-deployment-574b87c764-92jbs--cat/etc/nginx/nginx.conf kubectlexec-itnginx-deployment-574b87c764-92jbs--ls/usr/share/nginx/html kubectlexec-itnginx-deployment-574b87c764-92jbs--cat/usr/share/nginx/html/index.html kubectlexec-itnginx-deployment-574b87c764-92jbs--cp/usr/share/nginx/html/index.html/usr/share/nginx/html/index.html.bk 注释:kubectl exce的格式如下: kubectlexec-it<podName>-c<containerName>-n<namespace>--shellcomand 4.5.3. 更改index.html内容 在本地编辑文件name.html,然后上传到3个Pod的容器中, kubectlcpname.htmlnginx-deployment-574b87c764-nqpmc:usr/share/nginx/html/index.html 注释: pod和本地之间传输文件命令格式Pod下载文件到本地 kubectlcp-nNAMESPACE_namePOD_name:Pod_FILE_nameLocal_FILE_name 本地上传文件到Pod kubectlcpLocal_FILE_name-nNAMESPACE_namePOD_name:Pod_FILE_name 最终查询输出结果,多次查询,可以看到load balance会将连接随机分配到不同Pod节点 curl-silentae8e75d7e149044eb905b6bbff796e7e-629951941.cn-northwest-1.elb.amazonaws.com.cn|grepNode 输出结果如下: 5. 总结 通过本文,大家已经对容器化有一个初步的了解,并且针对Amazon EKS打造的企业容器化平台也有了初步认知。Docker,Kubernetes对于企业的系统和业务的发展,有着不可忽视的“助推力”。 然而,Kubernetes的学习曲线,以及企业的Kubernetes人才的积累,都是需要较长的“时间”成本。而借助云计算供应商的成熟平台和产品,可以降低企业的技术人才的积累成本,从而达到事半功倍的效果。 我们通过这次实战的演练,可以看到,基于Amazon EKS创建容器化平台,只需一条命令。Amazon EKS让Kubernetes的创建,运行与维护变得简单、可靠。通过AWS Fargate,企业甚至可以完全省去虚拟机(EC2)的管理,只关注Kubernetes顶层业务架构的逻辑即可,进而可以将更多的“时间”专注在业务的开发,而不是被底层架构的种种问题所拖累,也可以让运维人员逃离无尽的“救火”式运维模式。 你,准备好了吗? 容器化巨轮已经启航!来,让我们一起探索更多可能! 参考文档: https://docs.amazonaws.cn/eks/latest/userguide/what-is-eks.htmlhttps://eksctl.io/usage/creating-and-managing-clusters/https://github.com/liangruibupt/EKS-Workshop-Chinahttps://docs.amazonaws.cn/en_us/eks/latest/userguide/create-kubeconfig.htmlhttps://amazonaws-china.com/cn/premiumsupport/knowledge-center/eks-kubernetes-services-cluster/https://www.eksworkshop.com/beginner/130_exposing-service/ingress_controller_alb/https://docs.aws.amazon.com/zh_cn/eks/latest/userguide/alb-ingress.html

优秀的个人博客,低调大师

cocos2d线上项目落地微前端

一.背景 目前cocos2d游戏最主要的开发方式是通过官方提供的GUI图形界面工具——creator,通过 creator 开发者无需关注构建本身,只需通过界面操作即可对游戏代码进行构建打包。但是这样也存在着以下几个问题: 构建闭源,导致开发者对项目构建无法定制化,假如编译出来的代码存在兼容性问题,那只能进入 creator 安装目录寻找对应的某个配置文件进行修改,这种侵入性的修改很有可能会引发不稳定性。 无法使用其他构建工具进行打包,意味着项目无法使用新的技术方案,只能局限于 creator 设定的框架之中 游戏组件在不同项目之间难以复用,组件通常包含了 prefab、sprite 等资源,如何发布托管并在其他项目复用组件,简单地通过 creator 是无法做到的。通过 EMP微前端的方案 能从根本上解决这些问题 通过这些问题让我们有了一种想法,有没有可能通过其他构建工具打包的代码,也能关联到 creator 的项目中,这样也能在creator cocos2d项目中引入EMP,从而解决组件复用的问题 二. creator项目接入webpack模型 首先看看单一 creator 的开发过程,它会在本地服务开启 7456 的端口服务,整个本地开发流程如下图: 接入 webpack 和 emp 后的开发过程,首先 webpack 会通过 axios 抓去 creator服务生成出来的 index.html文件作为 template,并开启一个新的服务,并通过 devServer 将资源请求转发回 creator的端口服务,确保资源访问正常,开发流程图如下: 三. 接入流程 step1 全局安装 @efox/emp-cli,通过 emp init 初始化游戏种子工程,选择 cocos2d 模版 yarn add --global @efox/emp-cli && emp init step2 在根项目通过命令 yarn 安装依赖 step3 安装 creator cocos 开发工具 ,打开 cocosDashboard, 导入刚刚的游戏模版项目,然后打开项目,下面是导入成功后的开发工具截图; 复制开发工具上方提示的本地调试链接到浏览器上,呈现出来的界面如下,可以看到右方console出现报错的情况,这是因为目前打开的只是 creator 开启的本地服务,而项目引入了 webpack 构建的代码,所以暂时会出现报错的情况; step4 进入项目根目录,运行 yarn dev 浏览器会自动打开新端口服务,这个本地服务就是 webpack 代理 creator cocos 后的服务,通过下图看到console已经没有报错了,并且界面上的 Hello World拥有了渐变背景色,这个渐变背景色实际上就是一个 Game Component,是通过 webpack 构建并注入到游戏项目中引入的; ps: 必须先通过creator cocos开启项目,再运行 yarn dev,因为 webpack 编译时需要通过 axios 抓取 creator cocos 服务模版; 四. 项目代码分析 emp-config.js // cocos2d emp配置 const withCocos2d = require('@efox/emp-cocos2d') const ip = require('ip') module.exports = withCocos2d( ({config, env, empEnv}) => { // webpack本地服务端口 const port = 9000 const projectName = 'empCocos2dDemo' const host = ip.address() const publicPath = `http://${host}:${port}/` config.plugin('mf').tap(args => { args[0] = { ...args[0], ...{ name: projectName, library: {type: 'var', name: projectName}, filename: 'emp.js', // remotes: { // '@emp-game/base': 'empGameBase', // }, exposes: { // 将当前项目的component expose出去给其他项目使用 './components': 'src/components', }, }, } return args }) config.output.publicPath(publicPath) config.devServer.host(host) config.devServer.port(port) }, { // creator开启的服务端口 creatorPort: 7456, // 引用基站资源链接 empJs: [], }, ) src/index.ts webpack 的代码如何注入到 creator cocos 代码中,靠的是 cc 这个全局变量,cc 变量是cocos2d引擎暴露在全局的,包含了全部的引擎方法;creator cocos 接入 emp 的关键点就是在 cc全局变量上创建一个 EMP 属性,这样后续无论远程组件模块,抑或是本地构建的module, 都可以附值在 cc.EMP 上,从而在游戏代码中引入; cc这个全局变量是cocos2d引擎暴露在全局的,这里也分为本地环境和生产环境的情况,这是因为本地环境cocos2d引擎脚本是同步加载的,而生产环境是异步的,这就是为什么下面代码判断了 window.boot 是否存在的情况,附值 cc.EMP 的操作是需要 cc 存在才能进行; import Components from 'src/components' export type EMPData = { Components: typeof Components } const EMP: EMPData = { Components, } // 关键部分 // 生产环境 cocos2d脚本异步加载后 再执行window.boot // 通过重写 window.boot 在函数体内进行cc.EMP附值,再执行原函数,确保游戏代码运行时 cc.EMP正常有值 if (window.boot) { const fn = window.boot window.boot = async function () { cc.EMP = EMP fn() } } else { // 本地环境 直接附值 cc.EMP = EMP } assets/Script/HelloWorld.ts 看回游戏代码,了解游戏代码是如何引入外部组件的 const {ccclass, property} = cc._decorator @ccclass export default class Helloworld extends cc.Component { @property(cc.Label) label!: cc.Label onLoad(): void { // 通过cc.EMP获取Component模块 // 再通过Component模块拓展出渐变背景色组件 const {colorGrad} = cc.EMP.Components // 获取labelNode 节点 const labelNode = cc.find('labelNode', this.node) const label = cc.find('label', labelNode) // 通过addComponent添加渐变背景色,并设置脚本属性 _colors labelNode.addComponent(colorGrad)._colors = [ cc.Color.WHITE.fromHEX('#ffffff'), cc.Color.WHITE.fromHEX('#5A51FF'), cc.Color.WHITE.fromHEX('#8668FF'), cc.Color.WHITE.fromHEX('#5A51FF'), ] setTimeout(() => { // 重设labelNode节点宽高 labelNode.setContentSize(label.width, label.height) }) } } 五. 已有项目如何接入 接入步骤如下: 在根项目安装 emp 相关依赖; yarn add -D @efox/cli yarn add -D @efox/emp-tsconfig yarn add -D @efox/emp-cocos2d 在 package.json 添加如下片段: { ..., "scripts": { ..., + "dev": "emp dev", + "build": "emp build --ts --env prod && cp -r ./dist/. ./build/web-mobile" } } 根目录创建 emp-config.js,并复制以下内容 const withCocos2d = require('@efox/emp-cocos2d') const ip = require('ip') module.exports = withCocos2d( ({config, env, empEnv}) => { const port = 9000 const projectName = 'empCocos2dDemo' const host = ip.address() const publicPath = `http://${host}:${port}/` config.plugin('mf').tap(args => { args[0] = { ...args[0], ...{ name: projectName, library: {type: 'var', name: projectName}, filename: 'emp.js', // remotes: { // }, exposes: { }, }, } return args }) config.output.publicPath(publicPath) config.devServer.host(host) config.devServer.port(port) }, { // creator开启的服务端口 creatorPort: 7456, // 引用基站资源链接 empJs: [], }, ) 将 tsconfig.json 替换如下内容: { "extends": "@efox/emp-tsconfig", "compilerOptions": { "experimentalDecorators": true, "baseUrl": "./" }, "include": ["src", "creator.d.ts", "index.d.ts", "assets"] } 创建 src 目录,并新建 index.ts export type EMPData = {} const EMP: EMPData = {} if (window.boot) { const fn = window.boot window.boot = async function () { cc.EMP = EMP fn() } } else { cc.EMP = EMP } 创建 index.d.ts,定义 cc.EMP 类型声明 import {EMPData} from './src' declare global { namespace cc { export let EMP: EMPData } interface Window { boot: () => void } } 六. 总结 目前 creator cocos 游戏开发只能依赖官方开发工具,接入这套模型,能使得项目定制化更加便捷,且具有以下优点: 几乎零成本接入 首先看看接入 emp 后的 creator cocos项目目录结构 由上图可以看出,与 普通的creator cocos2项目 相比,只多了以下2个文件和1个目录; src/* emp-config.js index.d.ts 无需改变原游戏代码任何的部分,做到了几乎0成本接入 将开发方式回归到我们熟悉的步伐上,且更灵活,原本的开发方式是GUI工具制作 一个一个 prefab,再写一个一个脚本绑定进去,虽然操作简单,但开发体验很不好,接入模型后,GUI工具依然负责制作 prefab,但脚本就可以抽离出来由webpack构建,这能给编写的脚本带来更多的新特性,丰富开发方式; 组件开发灵活,多项目共享,当前开发游戏组件只能在当前项目复用,如果其他游戏项目也想用呢?这时可能会想到发布到官方托管的仓库或者npm仓库,但是有个问题,如果这个组件依赖了图片,那发布到npm仓库可能是一个难题;emp基站的模型能很好地解决这些问题,因为本身游戏项目就是一个基站,其他游戏项目可以轻松复用其他游戏 expose 出来的组件 不同游戏项目之间组件的互相调用,可以参考 EMP中的cocos2d 基于Webpack 5 Module Federation实现的 EMP微前端方案,creator cocos这种闭源的开发过程都能接入 EMP,证明这套方案并不局限技术栈;如果是刚开始接触微前端的话,可以尝试去了解一下,可以带给你很好的使用体验喔 具体的EMP微前端方案教程目录如下: 基础知识解析 什么是微前端 对比多种微前端方案 webpack5 module Federation原理学习 EMP的设计架构 快速入门 react项目如何使用和接入EMP vue项目如何使用和接入EMP 辅助插件的使用教程 进阶教程 Vue和React项目如何互相远程调用 cocos2d 项目如何使用和接入EMP 教你基站搭建技巧
资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册