首页 文章 精选 留言 我的

精选列表

搜索[文档工具],共10000篇文章
优秀的个人博客,低调大师

Apache Storm 官方文档 —— 本地模式

本地模式是一种在本地进程中模拟 Storm 集群的工作模式,对于开发和测试拓扑很有帮助。在本地模式下运行拓扑与在集群模式下运行拓扑的方式很相似。 创建一个进程内的“集群”只需要使用LocalCluster类即可,例如: import backtype.storm.LocalCluster; LocalCluster cluster = new LocalCluster(); 随后,你就可以使用LocalCluster中的submitTopology方法来提交拓扑了。与StormSubmitter中相应的方法相似,submitTopology接收一个拓扑名称、拓扑配置以及拓扑对象作为输入参数。你也可以以拓扑名称为参数,使用killTopology方法来 kill 掉对应的拓扑。 使用以下语句关闭本地模式集群运行: cluster.shutdown(); 本地模式的常用配置 你可以在这里找到完整的配置项列表。以下是几个比较有用的配置项说明: Config.TOPOLOGY_MAX_TASK_PARALLELISM:该配置项设置了单个组件(bolt/spout)的线程数上限。生产环境下的拓扑往往含有很高的并行度(数百个线程),导致在本地模式下测试拓扑时会有较大的负载。这个配置项可以让你很容易地控制并行度。 Config.TOPOLOGY_DEBUG:此配置项设置为 true 时 Storm 会打印出 spout 或者 bolt 每一次发送消息的日志记录。这个功能对于调试拓扑很有用。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 基础概念

Storm 系统中包含以下几个基本概念: 拓扑(Topologies) 流(Streams) 数据源(Spouts) 数据流处理组件(Bolts) 数据流分组(Stream groupings) 可靠性(Reliability) 任务(Tasks) 工作进程(Workers) 译者注:由于 Storm 的几个基础概念无论是直译还是意译均不够清晰,而且还会让习惯了 Storm 编程模型的读者感到困惑,因此后文在提及这些概念时大多还会以英文原文出现,希望大家能够谅解。 拓扑(Topologies) Storm 的拓扑是对实时计算应用逻辑的封装,它的作用与 MapReduce 的任务(Job)很相似,区别在于 MapReduce 的一个 Job 在得到结果之后总会结束,而拓扑会一直在集群中运行,直到你手动去终止它。拓扑还可以理解成由一系列通过数据流(Stream Grouping)相互关联的 Spout 和 Bolt 组成的的拓扑结构。Spout 和 Bolt 称为拓扑的组件(Component)。我们会在后文中给出这些概念的解释。 相关资料 TopologyBuilder:在 Java 中使用此类构造拓扑 在生产环境中运行拓扑 本地模式:通过本文学习如何在本地模式中开发、测试拓扑 数据流(Streams) 数据流(Streams)是 Storm 中最核心的抽象概念。一个数据流指的是在分布式环境中并行创建、处理的一组元组(tuple)的无界序列。数据流可以由一种能够表述数据流中元组的域(fields)的模式来定义。在默认情况下,元组(tuple)包含有整型(Integer)数字、长整型(Long)数字、短整型(Short)数字、字节(Byte)、双精度浮点数(Double)、单精度浮点数(Float)、布尔值以及字节数组等基本类型对象。当然,你也可以通过定义可序列化的对象来实现自定义的元组类型。 在声明数据流的时候需要给数据流定义一个有效的 id。不过,由于在实际应用中使用最多的还是单一数据流的 Spout 与 Bolt,这种场景下不需要使用 id 来区分数据流,因此可以直接使用OutputFieldsDeclarer来定义“无 id”的数据流。实际上,系统默认会给这种数据流定义一个名为“default”的 id。 相关资料 元组(Tuple):数据流由多个元组构成 OutputFieldsDeclarer:用于声明数据流和数据流对应的模式 序列化(Serialization):关于 Storm 元组的动态类型以及声明自定义序列化模型的相关内容 ISerialization:自定义的序列化模型必须实现该接口 CONFIG.TOPOLOGY_SERIALIZATIONS:自定义的序列化模型可以通过这个配置项实现注册 数据源(Spouts) 数据源(Spout)是拓扑中数据流的来源。一般 Spout 会从一个外部的数据源读取元组然后将他们发送到拓扑中。根据需求的不同,Spout 既可以定义为可靠的数据源,也可以定义为不可靠的数据源。一个可靠的 Spout 能够在它发送的元组处理失败时重新发送该元组,以确保所有的元组都能得到正确的处理;相对应的,不可靠的 Spout 就不会在元组发送之后对元组进行任何其他的处理。 一个 Spout 可以发送多个数据流。为了实现这个功能,可以先通过OutputFieldsDeclarer的declareStream方法来声明定义不同的数据流,然后在发送数据时在SpoutOutputCollector的emit方法中将数据流 id 作为参数来实现数据发送的功能。 Spout 中的关键方法是nextTuple。顾名思义,nextTuple要么会向拓扑中发送一个新的元组,要么会在没有可发送的元组时直接返回。需要特别注意的是,由于 Storm 是在同一个线程中调用所有的 Spout 方法,nextTuple不能被 Spout 的任何其他功能方法所阻塞,否则会直接导致数据流的中断(关于这一点,阿里的 JStorm 修改了 Spout 的模型,使用不同的线程来处理消息的发送,这种做法有利有弊,好处在于可以更加灵活地实现 Spout,坏处在于系统的调度模型更加复杂,如何取舍还是要看具体的需求场景吧——译者注)。 Spout 中另外两个关键方法是ack和fail,他们分别用于在 Storm 检测到一个发送过的元组已经被成功处理或处理失败后的进一步处理。注意,ack和fail方法仅仅对上述“可靠的” Spout 有效。 相关资料 IRichSpout:这是实现 Spout 的接口 消息的可靠性处理 数据流处理组件(Bolts) 拓扑中所有的数据处理均是由 Bolt 完成的。通过数据过滤(filtering)、函数处理(functions)、聚合(aggregations)、联结(joins)、数据库交互等功能,Bolt 几乎能够完成任何一种数据处理需求。 一个 Bolt 可以实现简单的数据流转换,而更复杂的数据流变换通常需要使用多个 Bolt 并通过多个步骤完成。例如,将一个微博数据流转换成一个趋势图像的数据流至少包含两个步骤:其中一个 Bolt 用于对每个图片的微博转发进行滚动计数,另一个或多个 Bolt 将数据流输出为“转发最多的图片”结果(相对于使用2个Bolt,如果使用3个 Bolt 你可以让这种转换具有更好的可扩展性)。 与 Spout 相同,Bolt 也可以输出多个数据流。为了实现这个功能,可以先通过OutputFieldsDeclarer的declareStream方法来声明定义不同的数据流,然后在发送数据时在OutputCollector的emit方法中将数据流 id 作为参数来实现数据发送的功能。 在定义 Bolt 的输入数据流时,你需要从其他的 Storm 组件中订阅指定的数据流。如果你需要从其他所有的组件中订阅数据流,你就必须要在定义 Bolt 时分别注册每一个组件。对于声明为默认 id(即上文中提到的“default”——译者注)的数据流,InputDeclarer支持订阅此类数据流的语法糖。也就是说,如果需要订阅来自组件“1”的数据流,declarer.shuffleGrouping("1")与declarer.shuffleGrouping("1", DEFAULT_STREAM_ID)两种声明方式是等价的。 Bolt 的关键方法是execute方法。execute方法负责接收一个元组作为输入,并且使用OutputCollector对象发送新的元组。如果有消息可靠性保障的需求,Bolt 必须为它所处理的每个元组调用OutputCollector的ack方法,以便 Storm 能够了解元组是否处理完成(并且最终决定是否可以响应最初的 Spout 输出元组树)。一般情况下,对于每个输入元组,在处理之后可以根据需要选择不发送还是发送多个新元组,然后再响应(ack)输入元组。IBasicBolt接口能够实现元组的自动应答。 在 Bolt 中启动新线程来进行异步处理是一种非常好的方式,因为OutputCollector是线程安全的对象,可以在任意时刻被调用(此处译者保留意见,由于 Storm 的并发设计和集群的弹性扩展机制,在 Bolt 中新建的线程可能存在一定的不可控风险——译者注)。 请注意OutputCollector不是线程安全的对象,所有的 emit、ack 和 fail 操作都需要在同一个线程中进行处理。更多信息请参考问题与解决一文。 相关资料 IRichBolt:用于定义 Bolt 的基本接口 IBasicBolt: 用于定义带有过滤或者其他简单的函数操作功能的 Bolt 的简便接口 OutputCollector:Bolt 使用此类来发送数据流 消息的可靠性处理 数据流分组(Stream groupings) 为拓扑中的每个 Bolt 的确定输入数据流是定义一个拓扑的重要环节。数据流分组定义了在 Bolt 的不同任务(tasks)中划分数据流的方式。 在 Storm 中有八种内置的数据流分组方式(原文有误,现在已经已经有八种分组模型——译者注),而且你还可以通过CustomStreamGrouping接口实现自定义的数据流分组模型。这八种分组分时分别为: 随机分组(Shuffle grouping):这种方式下元组会被尽可能随机地分配到 Bolt 的不同任务(tasks)中,使得每个任务所处理元组数量能够能够保持基本一致,以确保集群的负载均衡。 域分组(Fields grouping):这种方式下数据流根据定义的“域”来进行分组。例如,如果某个数据流是基于一个名为“user-id”的域进行分组的,那么所有包含相同的“user-id”的元组都会被分配到同一个任务中,这样就可以确保消息处理的一致性。 部分关键字分组(Partial Key grouping):这种方式与域分组很相似,根据定义的域来对数据流进行分组,不同的是,这种方式会考虑下游 Bolt 数据处理的均衡性问题,在输入数据源关键字不平衡时会有更好的性能1。感兴趣的读者可以参考这篇论文,其中详细解释了这种分组方式的工作原理以及它的优点。 完全分组(All grouping):这种方式下数据流会被同时发送到 Bolt 的所有任务中(也就是说同一个元组会被复制多份然后被所有的任务处理),使用这种分组方式要特别小心。 全局分组(Global grouping):这种方式下所有的数据流都会被发送到 Bolt 的同一个任务中,也就是 id 最小的那个任务。 非分组(None grouping):使用这种方式说明你不关心数据流如何分组。目前这种方式的结果与随机分组完全等效,不过未来 Storm 社区可能会考虑通过非分组方式来让 Bolt 和它所订阅的 Spout 或 Bolt 在同一个线程中执行。 直接分组(Direct grouping):这是一种特殊的分组方式。使用这种方式意味着元组的发送者可以指定下游的哪个任务可以接收这个元组。只有在数据流被声明为直接数据流时才能够使用直接分组方式。使用直接数据流发送元组需要使用OutputCollector的其中一个emitDirect方法。Bolt 可以通过TopologyContext来获取它的下游消费者的任务 id,也可以通过跟踪OutputCollector的emit方法(该方法会返回它所发送元组的目标任务的 id)的数据来获取任务 id。 本地或随机分组(Local or shuffle grouping):如果在源组件的 worker 进程里目标 Bolt 有一个或更多的任务线程,元组会被随机分配到那些同进程的任务中。换句话说,这与随机分组的方式具有相似的效果。 相关资料 TopologyBuilder:使用此类构造拓扑 InputDeclarer:在TopologyBuilder中调用setBolt方法时会返回这个对象的实例,通过该对象就可以定义 Bolt 的输入数据流以及数据流的分组方式 CoordinatedBolt:这个 Bolt 主要用于分布式 RPC 拓扑,其中大量使用了直接数据流与直接分组模型 可靠性(Reliability) Storm 可以通过拓扑来确保每个发送的元组都能得到正确处理。通过跟踪由 Spout 发出的每个元组构成的元组树可以确定元组是否已经完成处理。每个拓扑都有一个“消息延时”参数,如果 Storm 在延时时间内没有检测到元组是否处理完成,就会将该元组标记为处理失败,并会在稍后重新发送该元组。 为了充分利用 Storm 的可靠性机制,你必须在元组树创建新结点的时候以及元组处理完成的时候通知 Storm。这个过程可以在 Bolt 发送元组时通过OutputCollector实现:在emit方法中实现元组的锚定(Anchoring),同时使用ack方法表明你已经完成了元组的处理。 关于可靠性保障的更多内容可以参考这篇文章:消息的可靠性处理。 任务(Tasks) 在 Storm 集群中每个 Spout 和 Bolt 都由若干个任务(tasks)来执行。每个任务都与一个执行线程相对应。数据流分组可以决定如何由一组任务向另一组任务发送元组。你可以在TopologyBuilder的setSpout方法和setBolt方法中设置 Spout/Bolt 的并行度。 工作进程(Workers) 拓扑是在一个或多个工作进程(worker processes)中运行的。每个工作进程都是一个实际的 JVM 进程,并且执行拓扑的一个子集。例如,如果拓扑的并行度定义为300,工作进程数定义为50,那么每个工作进程就会执行6个任务(进程内部的线程)。Storm 会在所有的 worker 中分散任务,以便实现集群的负载均衡。 相关资料 Config.TOPOLOGY_WORKERS:这个配置项用于设置拓扑的工作进程数 1Partial Key grouping 方式目前仅支持开发版,尚未加入 Storm 的正式发行版,不过可以通过CustomStreamGrouping间接实现该分组功能,具体的实现可以参考PartialKeyGrouping源代码。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark独立模式

Spark独立模式 Spark除了可以在Mesos和YARN集群上运行之外,还支持一种简单的独立部署模式。独立部署模式下,你既可以手工启动(手动运行master和workers),也可以利用我们提供的启动脚本(launch scripts)。同时,独立部署模式下,你可以在单机上运行这些程序,以方便测试。 Spark集群独立安装 要独立安装Spark,你只需要将编译好的Spark包复制到集群中每一个节点上即可。你可以下载一个编译好的Spark版本,也可以在这里自己编译一个版本(build it yourself)。 手动启动集群 执行以下命令,启动独立部署的master server: ./sbin/start-master.sh 一旦启动完成,master会打印出master URL(spark://HOST:PORT),后续worker需要用这个URL来连接master,写代码的时候SparkContext中的master参数也需要设置成这个master URL。你还可以在master的web UI(默认为http://localhost:8080)上查看master URL。 类似地,你可以通过以下命令,启动一个或多个worker节点,并将其连接到master: ./sbin/start-slave.sh <master-spark-URL> 启动一个worker以后,刷新一下master的web UI(默认为http://localhost:8080),你应该可以在这里看到一个新的节点。 最后,以下配置选项将会被传给master和worker: 参数 含义 -h HOST,--host HOST 监听的主机名 -i HOST,--ip HOST 监听的主机名(已经废弃,请使用-h 或者 –host) -p PORT,--port PORT 服务监听的端口(master节点默认7077,worker节点随机) --webui-port PORT web UI端口(master节点默认8080,worker节点默认8081) -c CORES,--cores CORES 单节点上,Spark应用能够使用的CPU core数上限(默认,等于CPU core的个数);仅worker节点有效 -m MEM,--memory MEM 单节点上,Spark应用能够使用的内存上限,格式为1000M 或者 2G(默认为,机器上所有内存减去1G);仅worker节点有效 -d DIR,--work-dir DIR 工作目录,同时job的日志也输出到该目录(默认:${SPAKR_HOME}/work);仅worker节点有效 --properties-file FILE 自定义Spark属性文件的加载路径(默认:conf/spark-defaults.conf) 集群启动脚本 要使用启动脚本,来启动一个Spark独立部署集群,首先你需要在Spark目录下创建一个文件conf/slaves,并且在文件中写入你需要作为worker节点启动的每一台机器主机名(或IP),每行一台机器。如果conf/slaves文件不存在,启动脚本会默认会用单机方式启动,这种方式对测试很有帮助。注意,master节点访问各个worker时使用ssh。默认情况下,你需要配置ssh免密码登陆(使用秘钥文件)。如果你没有设置免密码登陆,那么你也可以通过环境变量SPARK_SSH_FOREGROUND来一个一个地设置每个worker的密码。 设置好conf/slaves文件以后,你就可以用一下shell脚本来启动或停止集群了,类似于Hadoop的部署,这些脚本都在${SPARK_HOME}/sbin目录下: sbin/start-master.sh– 在本机启动一个master实例 sbin/start-slaves.sh– 在conf/slaves文件所指定的每一台机器上都启动一个slave实例 sbin/start-slave.sh– 在本机启动一个slave实例 sbin/start-all.sh– 启动一个master和多个slave实例,详细见上面的描述。 sbin/stop-master.sh– 停止 start-master.sh所启动的master实例 sbin/stop-slaves.sh– 停止所有在conf/slaves中指定的slave实例 sbin/stop-all.sh– 停止master节点和所有slave节点,详细见上面的描述 注意,这些脚本都需要在你启动Spark master的机器上运行,而不是你的本地机器。 Spark独立部署集群的其他可选的环境变量见conf/spark-env.sh。你可以通过复制conf/spark-env.sh.template来创建这个文件,同时你还需要将配置好的文件复制到所有的worker节点上。以下是可用的设置: 环境变量 含义 SPARK_MASTER_IP master实例绑定的IP地址,例如,绑定到一个公网IP SPARK_MASTER_PORT mater实例绑定的端口(默认7077) SPARK_MASTER_WEBUI_PORT master web UI的端口(默认8080) SPARK_MASTER_OPTS master专用配置属性,格式如”-Dx=y” (默认空),可能的选项请参考下面的列表。 SPARK_LOCAL_DIRS Spark的本地工作目录,包括:映射输出的临时文件和RDD保存到磁盘上的临时数据。这个目录需要快速访问,最好设成本地磁盘上的目录。也可以通过使用逗号分隔列表,将其设成多个磁盘上的不同路径。 SPARK_WORKER_CORES 本机上Spark应用可以使用的CPU core上限(默认所有CPU core) SPARK_WORKER_MEMORY 本机上Spark应用可以使用的内存上限,如:1000m,2g(默认为本机所有内存减去1GB);注意每个应用单独使用的内存大小要用 spark.executor.memory 属性配置的。 SPARK_WORKER_PORT Spark worker绑定的端口(默认随机) SPARK_WORKER_WEBUI_PORT worker web UI端口(默认8081) SPARK_WORKER_INSTANCES 每个slave机器上启动的worker实例个数(默认:1)。如果你的slave机器非常强劲,可以把这个值设为大于1;相应的,你需要设置SPARK_WORKER_CORES参数来显式地限制每个worker实例使用的CPU个数,否则每个worker实例都会使用所有的CPU。 SPARK_WORKER_DIR Spark worker的工作目录,包括worker的日志以及临时存储空间(默认:${SPARK_HOME}/work) SPARK_WORKER_OPTS worker的专用配置属性,格式为:”-Dx=y”,可能的选项请参考下面的列表。 SPARK_DAEMON_MEMORY Spark master和worker后台进程所使用的内存(默认:1g) SPARK_DAEMON_JAVA_OPTS Spark master和workers后台进程所使用的JVM选项,格式为:”-Dx=y”(默认空) SPARK_PUBLIC_DNS Spark master和workers使用的公共DNS(默认空) 注意:启动脚本目前不支持Windows。如需在Windows上运行,请手工启动master和workers。 SPARK_MASTER_OPTS支持以下属性: 属性名 默认值 含义 spark.deploy.retainedApplications 200 web UI上最多展示几个已结束应用。更早的应用的数将被删除。 spark.deploy.retainedDrivers 200 web UI上最多展示几个已结束的驱动器。更早的驱动器进程数据将被删除。 spark.deploy.spreadOut true 独立部署集群的master是否应该尽可能将应用分布到更多的节点上;设为true,对数据本地性支持较好;设为false,计算会收缩到少数几台机器上,这对计算密集型任务比较有利。 spark.deploy.defaultCores (无限制) Spark独立模式下应用程序默认使用的CPU个数(没有设置spark.cores.max的情况下)。如果不设置,则为所有可用CPU个数(除非设置了spark.cores.max)。如果集群是共享的,最好将此值设小一些,以避免用户占满整个集群。 spark.worker.timeout 60 如果master没有收到worker的心跳,那么将在这么多秒之后,master将丢弃该worker。 SPARK_WORKER_OPTS支持以下属性: 属性名 默认值 含义 spark.worker.cleanup.enabled false 是否定期清理 worker 和应用的工作目录。注意,该设置仅在独立模式下有效,YARN有自己的清理方式;同时,只会清理已经结束的应用对应的目录。 spark.worker.cleanup.interval 1800 (30 minutes) worker清理本地应用工作目录的时间间隔(秒) spark.worker.cleanup.appDataTtl 7 * 24 * 3600 (7 days) 清理多久以前的应用的工作目录。这个选项值将取决于你的磁盘总量。spark应用会将日志和jar包都放在其对应的工作目录下。随着时间流逝,应用的工作目录很快会占满磁盘,尤其是在你的应用提交比较频繁的情况下。 连接到集群 要在Spark集群上运行一个应用,只需把spark://IP:PORT这个master URL传给SparkContext(参考SparkContextconstructor) 如需要运行交互式的spark shell,运行如下命令: ./bin/spark-shell --master spark://IP:PORT 你也可以通过设置选线 –total-executor-cores <numCores> 来控制spark-shell在集群上使用的CPU总数。 启动Spark应用 spark-submit脚本(spark-submitscript)是提交spark应用最简洁的方式。对于独立安装的集群来说,spark目前支持两种运行模式。客户端(client)模式下,驱动器进程(driver)将在提交应用的机器上启动。而在集群(cluster)模式下,驱动器(driver)将会在集群中的某一台worker上启动,同时提交应用的客户端在提交动作完成之后立即退出,而不会等到Spark应用运行结束。 如果你的应用时通过spark-submit提交启动的,那么应用对应的jar包会自动发布到所有的worker节点上。任何额外的依赖项jar包,都必须在–jars参数中指明,并以逗号分隔(如:–jars jar1,jar2)。 另外,独立安装的集群还支持异常退出(返回值非0)时自动重启。要启用这个特性,你需要在spark-submit时指定–supervise参数。其后,如果你需要杀掉一个重复失败的应用,你可能需要运行如下指令: ./bin/spark-class org.apache.spark.deploy.Client kill <master url> <driver ID> 你可以在master web UI(http://<master url>:8080)上查看驱动器ID。 资源调度 独立安装集群目前只支持简单的先进先出(FIFO)调度器。这个调度器可以支持多用户,你可以控制每个应用所使用的最大资源。默认情况下,Spark应用会申请集群中所有的CPU,这不太合理,除非你的进群同一时刻只运行一个应用。你可以通过SparkConf中的spark.cores.max,来设置一个CPU帽子以限制其使用的CPU总数。例如: val conf = new SparkConf() .setMaster(...) .setAppName(...) .set("spark.cores.max", "10") val sc = new SparkContext(conf) 另外,你也可以通过conf/spark-env.sh中的spark.deploy.defaultCores设置应用默认使用的CPU个数(特别针对没有设置spark.cores.max的应用)。 export SPARK_MASTER_OPTS="-Dspark.deploy.defaultCores=<value>" 在一些共享的集群上,用户很可能忘记单独设置一个最大CPU限制,那么这个参数将很有用。 监控和日志 Spark独立安装模式提供了一个基于web的集群监控用户界面。master和每个worker都有其对应的web UI,展示集群和Spark作业的统计数据。默认情况下,你可以在master机器的8080端口上访问到这个web UI。这个端口可以通过配置文件或者命令行来设置。 另外,每个作业的详细日志,将被输出到每个slave节点上的工作目录下(默认为:${SPARK_HOME}/work)。每个Spark作业下都至少有两个日志文件,stdout和stderr,这里将包含所有的输出到控制台的信息。 和Hadoop同时运行 你可以让Spark和已有的Hadoop在同一集群上同时运行,只需要将Spark作为独立的服务启动即可。这样Spark可以通过hdfs:// URL来访问Hadoop上的数据(通常情况下是,hdfs://<namenode>:9000/path,你可以在Hadoop Namenode的web UI上找到正确的链接)。当然,你也可以为Spark部署一个独立的集群,这时候Spark仍然可以通过网络访问HDFS上的数据;这会比访问本地磁盘慢一些,但如果Spark和Hadoop集群都在同一个本地局域网内的话,问题不大(例如,你可以在Hadoop集群的每个机架上新增一些部署Spark的机器)。 网络安全端口配置 Spark会大量使用网络资源,而有些环境会设置严密的防火墙设置,以严格限制网络访问。完整的端口列表,请参考这里:security page. 高可用性 默认情况下,独立调度的集群能够容忍worker节点的失败(在Spark本身来说,它能够将失败的工作移到其他worker节点上)。然而,调度器需要master做出调度决策,而这(默认行为)会造成单点失败:如果master挂了,任何应用都不能提交和调度。为了绕过这个单点问题,我们有两种高可用方案,具体如下: 基于Zookeeper的热备master 概要 利用Zookeeper来提供领导节点选举以及一些状态数据的存储,你可以在集群中启动多个master并连接到同一个Zookeeper。其中一个将被选举为“领导”,而另一个将处于备用(standby)状态。如果“领导”挂了,则另一个master会立即被选举,并从Zookeeper恢复已挂“领导”的状态,并继续调度。整个恢复流程(从“领导”挂开始计时)可能需要1到2分钟的时间。注意,整个延时只会影响新增应用 – 已经运行的应用不会受到影响。 更多关于Zookeeper信息请参考这里:here 配置 要启用这种恢复模式,你可以在spark-env中设置SPARK_DAEMON_JAVA_OPTS,可用的属性如下: 系统属性 含义 spark.deploy.recoveryMode 设为ZOOKEEPER以启用热备master恢复模式(默认空) spark.deploy.zookeeper.url Zookeeper集群URL(如:192.168.1.100:2181,192.168.1.101:2181) spark.deploy.zookeeper.dir 用于存储可恢复状态的Zookeeper目录(默认 /spark) 可能的问题:如果你有多个master,但没有正确设置好master使用Zookeeper的配置,那么这些master彼此都不可见,并且每个master都认为自己是“领导”。这件会导致整个集群处于不稳定状态(多个master都会独立地进行调度) 详细 如果你已经有一个Zookeeper集群,那么启动高可用特性是很简单的。只需要在不同节点上启动多个master,并且配置相同的Zookeeper(包括Zookeeper URL和目录)即可。masters可以随时添加和删除。 在调度新提交的Spark应用或者新增worker节点时,需要知道当前”领导“的IP地址。你只需要将以前单个的master地址替换成多个master地址即可。例如,你可以在SparkContext中设置master URL为spark://host1:port1.host2:port2。这会导致SparkContext在两个master中都进行登记 – 那么这时候,如果host1挂了,这个应用的配置同样可以在新”领导“(host2)中找到。 ”在master注册“和普通操作有一个显著的区别。在Spark应用或worker启动时,它们需要找当前的”领导“master,并在该master上注册。一旦注册成功,它们的状态将被存储到Zookeeper上。如果”老领导“挂了,”新领导“将会联系所有之前注册过的Spark应用和worker并通知它们领导权的变更,所以Spark应用和worker在启动时甚至没有必要知道”新领导“的存在。 由于这一特性,新的master可以在任何时间添加进来,你唯一需要关注的就是,新的应用或worker能够访问到这个master。总之,只要应用和worker注册成功,其他的你都不用管了。 基于本地文件系统的单点恢复 概要 利用Zookeeper当然是生成环境下高可用的最佳选择,但有时候你仍然希望在master挂了的时候能够重启之,FILESYSTEM模式能帮你实现这一需求。当应用和worker注册到master的时候,他们的状态都将被写入文件系统目录中,一旦master挂了,你只需要重启master,这些状态都能够恢复。 配置 要使用这种恢复模式,你需要在spark-env中设置SPARK_DAEMON_JAVA_OPTS,可用的属性如下: 系统属性 含义 spark.deploy.recoveryMode 设为FILESYSTEM以启用单点恢复模式(默认空) spark.deploy.recoveryDirectory 用于存储可恢复状态数据的目录,master进程必须有访问权限 Details(详细) 这个解决方案可以用于和一些监控、管理系统进行串联(如:monit),或者与手动重启相结合。 至少,基于文件系统工单恢复总比不能恢复强;同时,这种恢复模式也会是开发或者实验场景下的不错的选择。在某些情况下,通过stop-master.sh杀死master可能不会清理其状态恢复目录下的数据,那么这时候你启动或重启master,将会进入恢复模式。这可能导致master的启动时间长达一分钟(master可能要等待之前注册的worker和客户端超时)。 你也可以使用NFS目录来作为数据恢复目录(虽然这不是官方声明支持的)。如果老的master挂了,你可以在另一个节点上启动master,这个master只要能访问同一个NFS目录,它就能够正确地恢复状态数据,包括之前注册的worker和应用(等价于Zookeeper模式)。后续的应用必须使用新的master来进行注册。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》提交Spark应用

提交Spark应用 spark-submit脚本在Spark的bin目录下,可以利用此脚本向集群提交Spark应用。该脚本为所有Spark所支持的集群管理器(cluster managers)提供了统一的接口,因此,你基本上可以用同样的配置和脚本,向不同类型的集群管理器提交你的应用。 打包应用程序依赖 如果你的代码依赖于其他工程,那么你需要把依赖项也打包进来,并发布给Spark集群。这需要创建一个程序集jar包(或者uber jar),包含你自己的代码,同时也包含其依赖项。sbtandMaven都有assembly插件。创建程序集jar包时,注意,要把Spark和Hadoop的jar包都可设为provided;这些jar包在Spark集群上已经存在,不需要再打包进来。完成jar包后,你就可以使用bin/spark-submit来提交你的jar包了。 对于Python,你可以使用spark-submit的–py-files参数,将你的程序以.py、.zip 或.egg文件格式提交给集群。如果你需要依赖很多Python文件,我们推荐你使用.zip或者.egg来打包。 利用spark-submit启动应用 一旦打包好一个应用程序,你就可以用bin/spark-submit来提交之。这个脚本会自动设置Spark及其依赖的classpath,同时可以支持多种不同类型的集群管理器、以及不同的部署模式: ./bin/spark-submit \ --class <main-class> --master <master-url> \ --deploy-mode <deploy-mode> \ --conf <key>=<value> \ ... # 其他选项 <application-jar> \ [application-arguments] 一些常用的选项如下: --class: 应用入口类(例如:org.apache.spark.examples.SparkPi)) --master: 集群的master URL(如:spark://23.195.26.187:7077) --deploy-mode:驱动器进程是在集群上工作节点运行(cluster),还是在集群之外客户端运行(client)(默认:client) --conf: 可以设置任意的Spark配置属性,键值对(key=value)格式。如果值中包含空白字符,可以用双引号括起来(”key=value“)。 application-jar: 应用程序jar包路径,该jar包必须包括你自己的代码及其所有的依赖项。如果是URL,那么该路径URL必须是对整个集群可见且一致的,如:hdfs://path 或者file://path(要求对所有节点都一致) application-arguments: 传给入口类main函数的启动参数,如果有的话。 一种常见的部署策略是,在一台网关机器上提交你的应用,这样距离工作节点的物理距离比较近。这种情况下,client模式会比较适合。client模式下,驱动器直接运行在spark-submit的进程中,同时驱动器对于集群来说就像是一个客户端。应用程序的输入输出也被绑定到控制台上。因此,这种模式特别适用于交互式执行(REPL),spark-shell就是这种模式。 当然,你也可以从距离工作节点很远的机器(如:你的笔记本)上提交应用,这种情况下,通常适用cluster模式,以减少网络驱动器和执行器之间的网络通信延迟。注意:对于Mesos集群管理器,Spark还不支持cluster模式。目前,只有YARN上Python应用支持cluster模式。 对于Python应用,只要把<application-jar>换成一个.py文件,再把.zip、.egg或者.py文件传给–py-files参数即可。 有一些参数是专门用于设置集群管理器的(cluster manager)。例如,在独立部署(Spark standalone cluster)时,并且使用cluster模式,你可以用–supervise参数来确保驱动器在异常退出情况下(退出并返回非0值)自动重启。spark-submit –help可查看完整的选项列表。这里有几个常见的示例: # 本地运行,占用8个core ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master local[8] \ /path/to/examples.jar \ 100 # 独立部署,client模式 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master spark://207.184.161.138:7077 \ --executor-memory 20G \ --total-executor-cores 100 \ /path/to/examples.jar \ 1000 # 独立部署,cluster模式,异常退出时自动重启 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master spark://207.184.161.138:7077 \ --deploy-mode cluster --supervise --executor-memory 20G \ --total-executor-cores 100 \ /path/to/examples.jar \ 1000 # YARN上运行,cluster模式 export HADOOP_CONF_DIR=XXX ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master yarn \ --deploy-mode cluster \ # 要client模式就把这个设为client --executor-memory 20G \ --num-executors 50 \ /path/to/examples.jar \ 1000 # 独立部署,运行python ./bin/spark-submit \ --master spark://207.184.161.138:7077 \ examples/src/main/python/pi.py \ 1000 # Mesos集群上运行,cluster模式,异常时自动重启 ./bin/spark-submit \ --class org.apache.spark.examples.SparkPi \ --master mesos://207.184.161.138:7077 \ --deploy-mode cluster --supervise --executor-memory 20G \ --total-executor-cores 100 \ http://path/to/examples.jar \ 1000 Master URLs 传给Spark的master URL可以是以下几种格式: Master URL 含义 local 本地运行Spark,只用1个worker线程(没有并行计算) local[K] 本地运行Spark,使用K个worker线程(理论上,最好将这个值设为你机器上CPU core的个数) local[*] 本地运行Spark,使用worker线程数同你机器上逻辑CPU core个数 spark://HOST:PORT 连接到指定的Spark独立部署的集群管理器(Spark standalone cluster)。端口是可以配置的,默认7077。 mesos://HOST:PORT 连接到指定的Mesos集群。端口号可以配置,默认5050。如果Mesos集群依赖于ZooKeeper,可以使用 mesos://zk://… 来提交,注意 –deploy-mode需要设置为cluster,同时,HOST:PORT应指向MesosClusterDispatcher. yarn 连接到指定的YARN集群,使用–deploy-mode来指定 client模式 或是 cluster 模式。YARN集群位置需要通过 $HADOOP_CONF_DIR 或者 $YARN_CONF_DIR 变量来查找。 yarn-client YARN client模式的简写,等价于 –master yarn –deploy-mode client yarn-cluster YARN cluster模式的简写,等价于 –master yarn –deploy-mode cluster 从文件加载配置 spark-submit脚本可以从一个属性文件加载默认的Spark属性配置值(Spark configuration values),并将这些属性传给你的应用程序。默认Spark会从 conf/spark-defaults.conf读取这些属性配置。更详细信息,请参考loading default configurations. 用这种方式加载默认Spark属性配置,可以在调用spark-submit脚本时省略一些参数标志。例如:如果属性文件中设置了spark.master属性,那么你就以忽略spark-submit的–master参数。通常,在代码里用SparkConf中设置的参数具有最高的优先级,其次是spark-submit中传的参数,再次才是spark-defaults.conf文件中的配置值。 如果你总是搞不清楚最终生效的配置值是从哪里来的,你可以通过spark-submit的–verbose选项来打印细粒度的调试信息。 高级依赖管理 通过spark-submit提交应用时,application jar和–jars选项中的jar包都会被自动传到集群上。Spark支持以下URL协议,并采用不同的分发策略: file:– 文件绝对路径,并且file:/URI是通过驱动器的HTTP文件服务器来下载的,每个执行器都从驱动器的HTTP server拉取这些文件。 hdfs:,http:,https:,ftp:– 设置这些参数后,Spark将会从指定的URI位置下载所需的文件和jar包。 local:– local:/ 打头的URI用于指定在每个工作节点上都能访问到的本地或共享文件。这意味着,不会占用网络IO,特别是对一些大文件或jar包,最好使用这种方式,当然,你需要把文件推送到每个工作节点上,或者通过NFS和GlusterFS共享文件。 注意,每个SparkContext对应的jar包和文件都需要拷贝到所对应执行器的工作目录下。一段时间之后,这些文件可能会占用相当多的磁盘。在YARN上,这些清理工作是自动完成的;而在Spark独立部署时,这种自动清理需要配置 spark.worker.cleanup.appDataTtl 属性。 用户还可以用–packages参数,通过给定一个逗号分隔的maven坐标,来指定其他依赖项。这个命令会自动处理依赖树。额外的maven库(或者SBT resolver)可以通过–repositories参数来指定。Spark命令(pyspark,spark-shell,spark-submit)都支持这些参数。 对于Python,也可以使用等价的–py-files选项来分发.egg、.zip以及.py文件到执行器上。 更多信息 部署完了你的应用程序后,cluster mode overview描述了分布式执行中所涉及的各个组件,以及如何监控和调试应用程序。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》Spark作业调度

Spark作业调度 概览 Spark有好几种计算资源调度的方式。首先,回忆一下集群模式概览(cluster mode overview)中每个Spark应用(包含一个SparkContext实例)中运行了一些其独占的执行器(executor)进程。集群管理器提供了Spark应用之间的资源调度(scheduling across applications)。其次,在各个Spark应用内部,各个线程可能并发地通过action算子提交多个Spark作业(job)。如果你的应用服务于网络请求,那这种情况是很常见的。在Spark应用内部(对应同一个SparkContext)各个作业之间,Spark默认FIFO调度,同时也可以支持公平调度(fair scheduler)。 Spark应用之间的资源调度 如果在集群上运行,每个Spark应用都会获得一批独占的执行器JVM,来运行其任务并存储数据。如果有多个用户共享集群,那么会有很多资源分配相关的选项,如何设置还取决于具体的集群管理器。 对Spark所支持的各个集群管理器而言,最简单的资源分配,就是对资源静态划分。这种方式就意味着,每个Spark应用都是设定一个最大可用资源总量,并且该应用在整个生命周期内都会占住这些资源。这种方式在Spark独立部署(standalone)和YARN调度,以及Mesos粗粒度模式(coarse-grained Mesos mode)下都可用。 Standalone mode:默认情况下,Spark应用在独立部署的集群中都会以FIFO(first-in-first-out)模式顺序提交运行,并且每个Spark应用都会占用集群中所有可用节点。不过你可以通过设置spark.cores.max或者spark.deploy.defaultCores 来限制单个应用所占用的节点个数。最后,除了可以控制对CPU的使用数量之外,还可以通过 spark.executor.memory 来控制各个应用的内存占用量。 Mesos:在Mesos中要使用静态划分的话,需要将 spark.mesos.coarse 设为true,同样,你也需要设置 spark.cores.max 来控制各个应用的CPU总数,以及 spark.executor.memory 来控制各个应用的内存占用。 YARN:在YARN中需要使用 –num-executors 选项来控制Spark应用在集群中分配的执行器的个数,对于单个执行器(executor)所占用的资源,可以使用 –executor-memory 和 –executor-cores 来控制。 Mesos上另一种可用的方式是动态共享CPU。在这种模式下,每个Spark应用的内存占用仍然是固定且独占的(仍由spark.executor.memory决定),但是如果该Spark应用没有在某个机器上执行任务的话,那么其他应用可以占用该机器上的CPU。这种模式对集群中有大量不是很活跃应用的场景非常有效,例如:集群中有很多不同用户的Spark shell session。但这种模式不适用于低延迟的场景,因为当Spark应用需要使用CPU的时候,可能需要等待一段时间才能取得CPU的使用权。要使用这种模式,只需要在 mesos:// URL 上设置 spark.mesos.coarse 属性为flase即可。 注意,目前还没有任何一种资源分配模式能支持跨Spark应用的内存共享。如果你需要跨Spark应用共享内存,我们建议你用单独用一个server来计算和保留同一个RDD查询的结果,这样就能在多个请求(request)之间共享同一个RDD的数据。在未来的发布版本中,一些内存存储系统(如:Tachyon)或许能够提供这种跨Spark应用共享RDD的能力。 动态资源分配 Spark还提供了一种基于负载来动态调节Spark应用资源占用的机制。这意味着,你的应用会在资源空闲的时候将其释放给集群,而后续用到的时候再重新申请。这一特性在多个应用共享Spark集群资源的情况下特别有用。 注意,这个特性默认是禁用的,但是在所有的粗粒度集群管理器上都是可用的,如:独立部署模式(standalone mode),YARN模式(YARN mode)以及Mesos粗粒度模式(Mesos coarse-grained mode)。 配置和部署 要使用这一特性有两个前提条件。首先,你的应用必须设置 spark.dynamicAllocation.enabled 为 true。其次,你必须在每个节点上启动一个外部混洗服务(external shuffle service),并在你的应用中将 spark.shuffle.service.enabled 设为true。外部混洗服务的目的就是为了在删除执行器的时候,能够保留其输出的混洗文件(本文后续有更详细的描述)。启用外部混洗的方式在各个集群管理器上各不相同: 在Spark独立部署的集群中,你只需要在worker启动前设置 spark.shuffle.server.enabled 为true即可。 在Mesos粗粒度模式下,你需要在各个节点上运行 ${SPARK_HOME}/sbin/start-mesos-shuffle-service.sh 并设置 spark.shuffle.service.enabled 为true 即可。例如,你可以用Marathon来启用这一功能。 在YARN模式下,混洗服务需要按以下步骤在各个NodeManager上启动: 首先按照YARN profile构建Spark。如果你已经有打好包的Spark,可以忽略这一步。 找到 spark-<version>-yarn-shuffle.jar。如果你是自定义编译,其位置应该在 ${SPARK_HOME}/network/yarn/target/scala-<version>,否则应该可以在 lib 目录下找到这个jar包。 将该jar包添加到NodeManager的classpath路径中。 配置各个节点上的yarn-site.xml,将 spark_shuffle 添加到 yarn.nodemanager.aux-services 中,然后将 yarn.nodemanager.aux-services.spark_shuffle.class 设为 org.apache.spark.network.yarn.YarnShuffleService,并将 spark.shuffle.service.enabled 设为 true。 最后重启各节点上的NodeManager。 所有相关的配置都是可选的,并且都在 spark.dynamicAllocation.* 和 spark.shuffle.service.* 命名空间下。更详细请参考:configurations page。 资源分配策略 总体上来说,Spark应该在执行器空闲时将其关闭,而在后续要用时再次申请。因为没有一个固定的方法,可以预测一个执行器在后续是否马上回被分配去执行任务,或者一个新分配的执行器实际上是空闲的,所以我们需要一些试探性的方法,来决定是否申请或移除一个执行器。 请求策略 一个启用了动态分配的Spark应用会在有等待任务需要调度的时候,申请额外的执行器。这种情况下,必定意味着已有的执行器已经不足以同时执行所有未完成的任务。 Spark会分轮次来申请执行器。实际的资源申请,会在任务挂起 spark.dynamicAllocation.schedulerBacklogTimeout 秒后首次触发,其后如果等待队列中仍有挂起的任务,则每过 spark.dynamicAlloction.sustainedSchedulerBacklogTimeout 秒触发一次资源申请。另外,每一轮所申请的执行器个数以指数形式增长。例如,一个Spark应用可能在首轮申请1个执行器,后续的轮次申请个数可能是2个、4个、8个… … 。 采用指数级增长策略的原因有两个:第一,对于任何一个Spark应用如果只是需要多申请少数几个执行器的话,那么必须非常谨慎地启动资源申请,这和TCP慢启动有些类似;第二,如果一旦Spark应用确实需要申请很多个执行器的话,那么可以确保其所需的计算资源及时地增长。 移除策略 移除执行器的策略就简单多了。Spark应用会在某个执行器空闲超过 spark.dynamicAllocation.executorIdleTimeout 秒后将其删除。在绝大多数情况下,执行器的移除条件和申请条件都是互斥的,也就是说,执行器在有待执行任务挂起时,不应该空闲。 优雅地关闭执行器 非动态分配模式下,执行器可能的退出原因有执行失败或者相关Spark应用已经退出。不管是那种原因,执行器的所有状态都已经不再需要,可以丢弃掉。但在动态分配的情形下,执行器有可能在Spark应用运行期间被移除。这时候,如果Spark应用尝试去访问该执行器存储的状态,就必须重算这一部分数据。因此,Spark需要一种机制,能够优雅地关闭执行器,同时还保留其状态数据。 这种需求对于混洗操作尤其重要。混洗过程中,Spark执行器首先将map输出写到本地磁盘,同时执行器本身又是一个文件服务器,这样其他执行器就能够通过该执行器获得对应的map结果数据。一旦有某些任务执行时间过长,动态分配有可能在混洗结束前移除任务异常的执行器,而这些被移除的执行器对应的数据将会被重新计算,但这些重算其实是不必要的。 要解决这一问题,就需要用到一个外部混洗服务(external shuffle service),该服务在Spark 1.2引入。该服务在每个节点上都会启动一个不依赖于任何Spark应用或执行器的独立进程。一旦该服务启用,Spark执行器不再从各个执行器上获取shuffle文件,转而从这个service获取。这意味着,任何执行器输出的混洗状态数据都可能存留时间比对应的执行器进程还长。 除了混洗文件之外,执行器也会在磁盘或者内存中缓存数。一旦执行器被移除,其缓存数据将无法访问。这个问题目前还没有解决。或许在未来的版本中,可能会采用外部混洗服务类似的方法,将缓存数据保存在堆外存储中以解决这一问题。 Spark应用内部的资源调度 在指定的Spark应用内部(对应同一SparkContext实例),多个线程可能并发地提交Spark作业(job)。在本节中,作业(job)是指,由Spark action算子(如:collect)触发的一系列计算任务的集合。Spark调度器是完全线程安全的,并且能够支持Spark应用同时处理多个请求(比如:来自不同用户的查询)。 默认,Spark应用内部使用FIFO调度策略。每个作业被划分为多个阶段(stage)(例如:map阶段和reduce阶段),第一个作业在其启动后会优先获取所有的可用资源,然后是第二个作业再申请,再第三个……。如果前面的作业没有把集群资源占满,则后续的作业可以立即启动运行,否则,后提交的作业会有明显的延迟等待。 不过从Spark 0.8开始,Spark也能支持各个作业间的公平(Fair)调度。公平调度时,Spark以轮询的方式给每个作业分配资源,因此所有的作业获得的资源大体上是平均分配。这意味着,即使有大作业在运行,小的作业再提交也能立即获得计算资源而不是等待前面的作业结束,大大减少了延迟时间。这种模式特别适合于多用户配置。 要启用公平调度器,只需设置一下 SparkContext中spark.scheduler.mode 属性为 FAIR即可: val conf = new SparkConf().setMaster(...).setAppName(...) conf.set("spark.scheduler.mode", "FAIR") val sc = new SparkContext(conf) 公平调度资源池 公平调度器还可以支持将作业分组放入资源池(pool),然后给每个资源池配置不同的选项(如:权重)。这样你就可以给一些比较重要的作业创建一个“高优先级”资源池,或者你也可以把每个用户的作业分到一组,这样一来就是各个用户平均分享集群资源,而不是各个作业平分集群资源。Spark公平调度的实现方式基本都是模仿Hadoop Fair Scheduler来实现的。 默认情况下,新提交的作业都会进入到默认资源池中,不过作业对应于哪个资源池,可以在提交作业的线程中用SparkContext.setLocalProperty 设定 spark.scheduler.pool 属性。示例代码如下: // Assuming sc is your SparkContext variable sc.setLocalProperty("spark.scheduler.pool", "pool1") 一旦设好了局部属性,所有该线程所提交的作业(即:在该线程中调用action算子,如:RDD.save/count/collect 等)都会使用这个资源池。这个设置是以线程为单位保存的,你很容易实现用同一线程来提交同一用户的所有作业到同一个资源池中。同样,如果需要清除资源池设置,只需在对应线程中调用如下代码: sc.setLocalProperty("spark.scheduler.pool", null) 资源池默认行为 默认地,各个资源池之间平分整个集群的资源(包括default资源池),但在资源池内部,默认情况下,作业是FIFO顺序执行的。举例来说,如果你为每个用户创建了一个资源池,那么久意味着各个用户之间共享整个集群的资源,但每个用户自己提交的作业是按顺序执行的,而不会出现后提交的作业抢占前面作业的资源。 配置资源池属性 资源池的属性需要通过配置文件来指定。每个资源池都支持以下3个属性: schedulingMode:可以是FIFO或FAIR,控制资源池内部的作业是如何调度的。 weight:控制资源池相对其他资源池,可以分配到资源的比例。默认所有资源池的weight都是1。如果你将某个资源池的weight设为2,那么该资源池中的资源将是其他池子的2倍。如果将weight设得很高,如1000,可以实现资源池之间的调度优先级 – 也就是说,weight=1000的资源池总能立即启动其对应的作业。 minShare:除了整体weight之外,每个资源池还能指定一个最小资源分配值(CPU个数),管理员可能会需要这个设置。公平调度器总是会尝试优先满足所有活跃(active)资源池的最小资源分配值,然后再根据各个池子的weight来分配剩下的资源。因此,minShare属性能够确保每个资源池都能至少获得一定量的集群资源。minShare的默认值是0。 资源池属性是一个XML文件,可以基于 conf/fairscheduler.xml.template 修改,然后在SparkConf的 spark.scheduler.allocation.file 属性指定文件路径: conf.set("spark.scheduler.allocation.file", "/path/to/file") 资源池XML配置文件格式如下,其中每个池子对应一个<pool>元素,每个资源池可以有其独立的配置: <?xml version="1.0"?> <allocations> <pool name="production"> <schedulingMode>FAIR</schedulingMode> <weight>1</weight> <minShare>2</minShare> </pool> <pool name="test"> <schedulingMode>FIFO</schedulingMode> <weight>2</weight> <minShare>3</minShare> </pool> </allocations> 完整的例子可以参考 conf/fairscheduler.xml.template。注意,没有在配置文件中配置的资源池都会使用默认配置(schedulingMode:FIFO,weight:1,minShare:0)。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark官方文档》集群模式概览

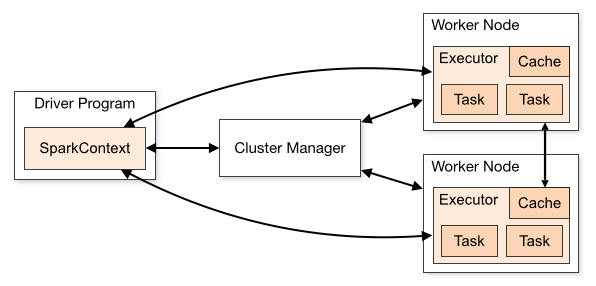
集群模式概览 本文简要描述了Spark在集群中各个组件如何运行。想了解如何在集群中启动Spark应用,请参考application submission guide。 组件 Spark应用在集群上运行时,包括了多个独立的进程,这些进程之间通过你的主程序(也叫作驱动器,即:driver)中的SparkContext对象来进行协调。 特别要指出的是,SparkContext能与多种集群管理器通信(包括:Spark独立部署时自带的集群管理器,Mesos或者YARN)。一旦连接上集群管理器,Spark会为该应用在各个集群节点上申请执行器(executor),用于执行计算任务和存储数据。接下来,Spark将应用程序代码(JAR包或者Python文件)发送给所申请到的执行器。最后SparkContext将分割出的任务(task)发送给各个执行器去运行。 这个架构中有几个值得注意的地方: 每个Spark应用程序都有其对应的多个执行器进程,执行器进程在整个应用程序生命周期内,都保持运行状态,并以多线程方式运行所收到的任务。这样的好处是,可以隔离各个Spark应用,从调度角度来看,每个驱动器可以独立调度本应用程序内部的任务,从执行器角度来看,不同的Spark应用对应的任务将会在不同的JVM中运行。然而这种架构同样也有其劣势,多个Spark应用程序之间无法共享数据,除非把数据写到外部存储中。 Spark对底层的集群管理器一无所知。只要Spark能申请到执行器进程,并且能与之通信即可。这种实现方式可以使Spark相对比较容易在一个支持多种应用的集群管理器上运行(如:Mesos或YARN) 驱动器(driver)程序在整个生命周期内必须监听并接受其对应的各个执行器的连接请求(参考:spark.driver.port and spark.fileserver.port in the network config section)。因此,驱动器程序必须能够被所有worker节点访问到。 因为集群上的任务是由驱动器来调度的,所以驱动器应该和worker节点距离近一些,最好在同一个本地局域网中。如果你需要远程对集群发起请求,最好还是在驱动器节点上启动RPC服务,来响应这些远程请求,同时把驱动器本身放在集群worker节点比较近的机器上。 集群管理器类型 Spark支持以下3中集群管理器: Standalone– Spark自带的一个简单的集群管理器,这使得启动一个Spark集群变得非常简单。 Apache Mesos– 一种可以运行Hadoop MapReduce或者服务型应用的通用集群管理器。 Hadoop YARN– Hadoop 2的集群管理器。 另外,使用Spark的EC2 launch scripts可以轻松地在Amazon EC2上启动一个独立集群。 提交Spark应用 利用spark-submit脚本,可以向Spark所支持的任意一种集群提交应用。详见:application submission guide 监控 每一个驱动器(driver)都有其对应的web UI,默认会绑定4040端口(多个并存会按顺序绑定4041、4042…),这个web UI会展示该Spark应用正在运行的任务(task)、执行器(executor)以及所使用的存储信息。只需在浏览器种打开http://<driver-node>:4040即可访问。monitoring guide详细描述了其他监控选项。 作业调度 Spark可以在应用程序之间(集群管理器这一层面)和之内(如:同一个SparkContext对象运行了多个计算作业)控制资源分配。job scheduling overview描述了更详细的信息。 概念和术语 下表简要说明了集群模式下的一些概念和术语: 术语 含义 Application(应用) Spark上运行的应用。包含了驱动器(driver)进程(一个)和集群上的执行器(executor)进程(多个) Application jar(应用jar包) 包含Spark应用程序的jar包。有时候,用户会想要把应用程序代码及其依赖打到一起,形成一个“uber jar”(包含自身以及所有依赖库的jar包),注意这时候不要把Spark或Hadoop的库打进来,这些库会在运行时加载 Driver program(驱动器) 运行main函数并创建SparkContext的进程。 Cluster manager(集群管理器) 用于在集群上申请资源的 外部服务(如:独立部署的集群管理器、Mesos或者YARN) Deploy mode(部署模式) 用于区分驱动器进程在哪里运行。在”cluster”模式下,驱动器将运行在集群上某个节点;在”client“模式下,驱动器在集群之外的客户端运行。 Worker node(工作节点) 集群上运行应用程序代码的任意一个节点。 Executor(执行器) 在集群工作节点上,为某个应用启动的工作进程;专门用于运行计算任务,并在内存或磁盘上保存数据。每个应用都独享其对应的多个执行器。 Task(任务) 下发给执行器的工作单元。 Job(作业) 一个并行计算作业,由一组任务(Task)组成,并由Spark的行动(action)算子(如:save、collect)触发启动;你会在驱动器日志中看到这个术语。 Stage(步骤) 每个作业(Job)可以划分为更小的任务(Task)集合,这就是步骤(Stage),这些步骤彼此依赖形成一个有向无环图(类似于MapReduce中的map和reduce);你会在驱动器日志中看到这个术语。 转载自并发编程网 - ifeve.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册