AI 架构设计:线上业务如何选择 MessageWindow 与 TokenWindow
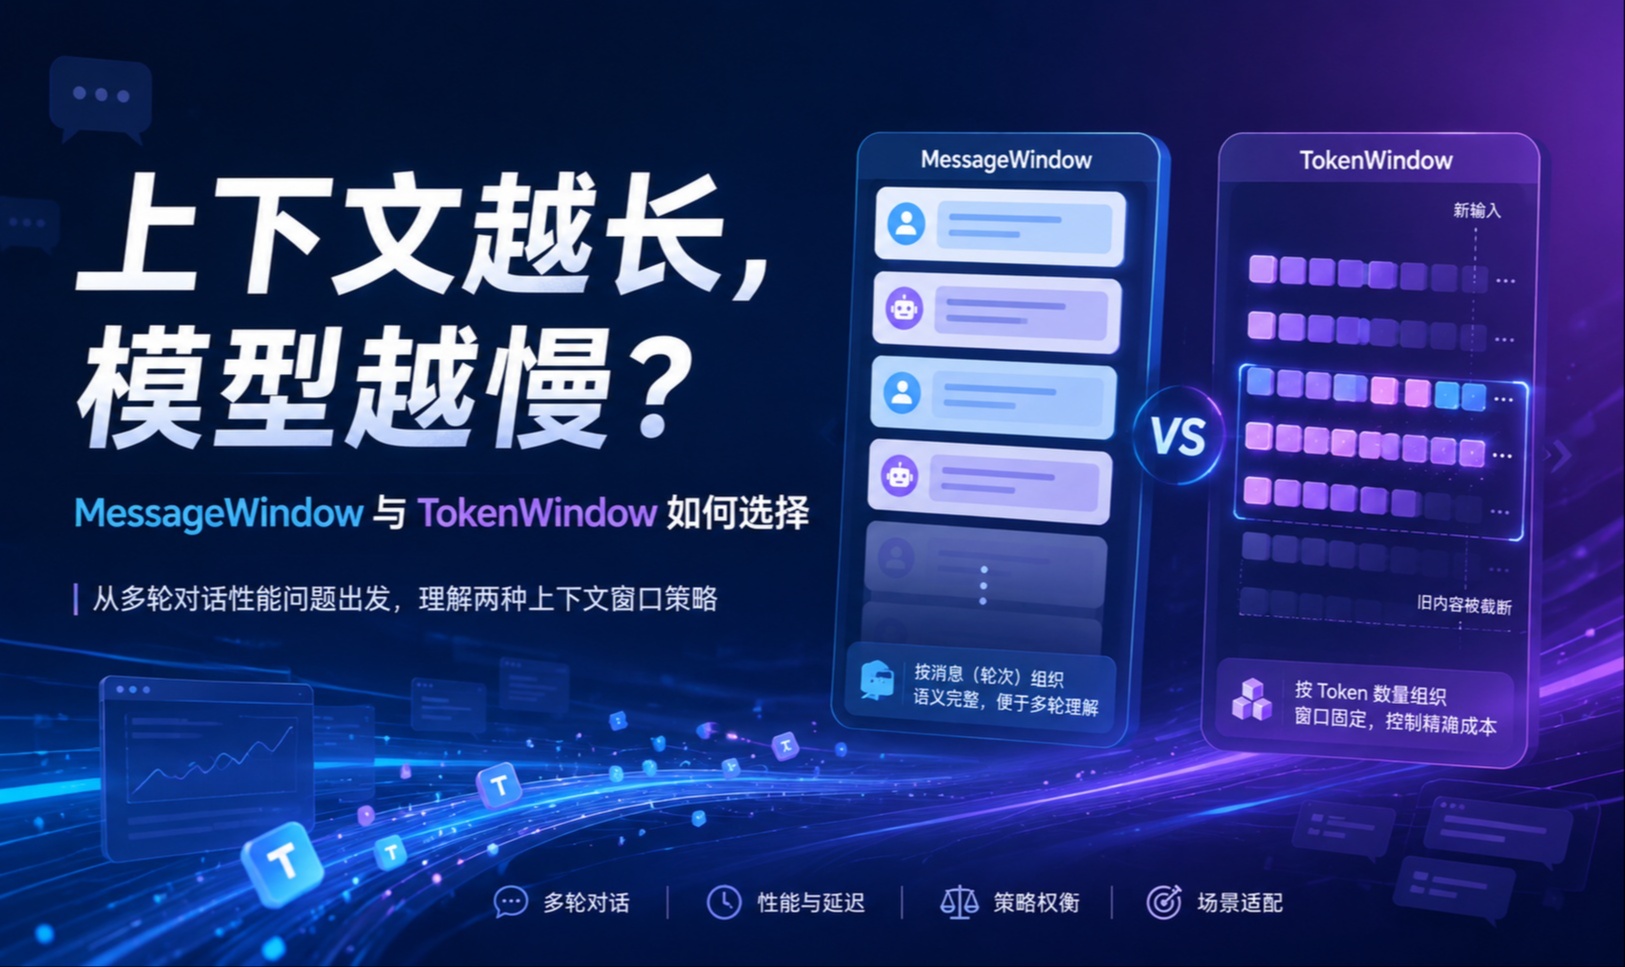
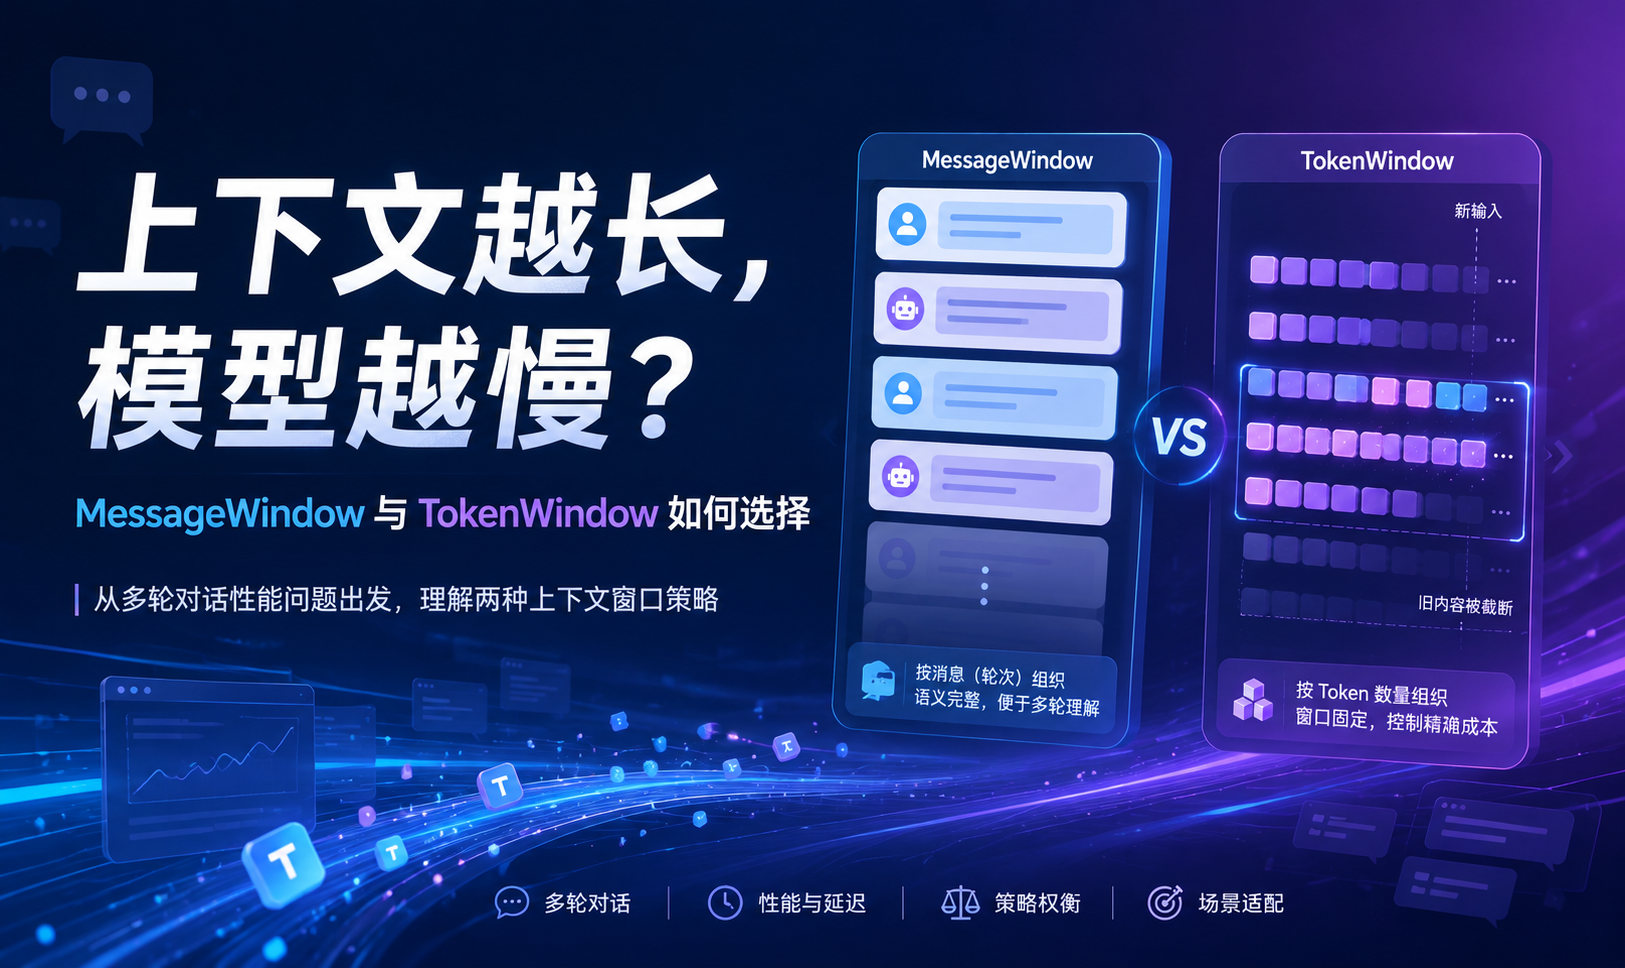 --- ## 问题本质:有限的上下文窗口 大模型的上下文窗口是**硬约束**: - GPT-3.5-turbo: 4K tokens - GPT-4: 8K/32K tokens - Claude 3: 200K tokens - GPT-4 Turbo: 128K tokens 但对话是**无限增长**的: 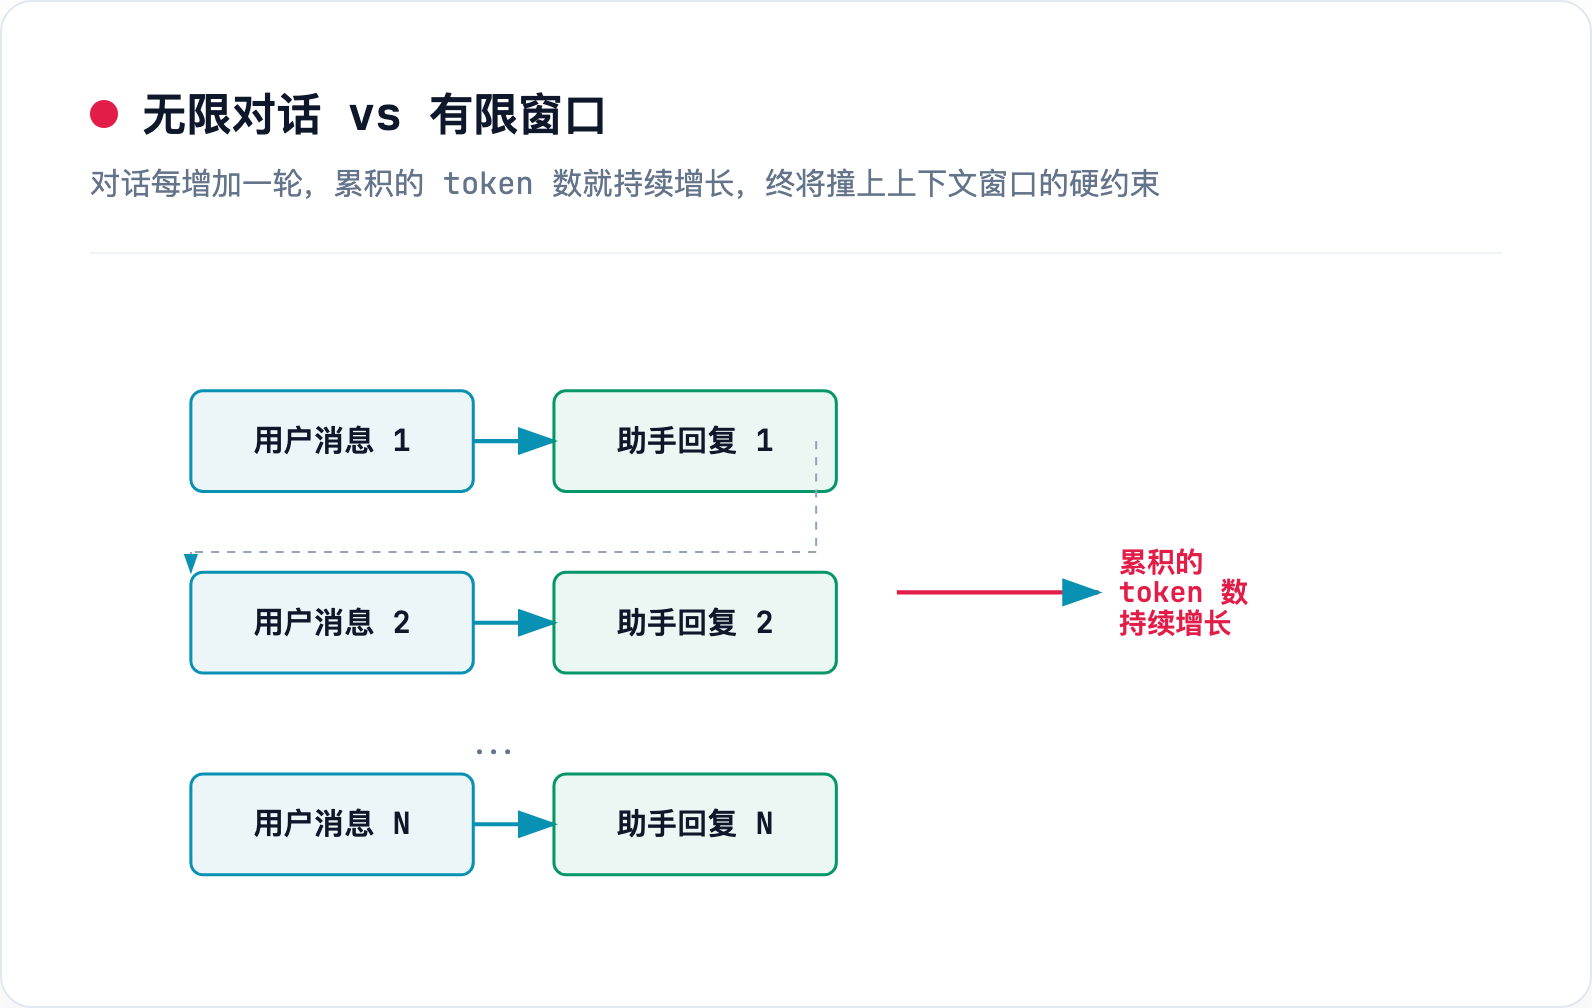 **核心矛盾**:无限对话 vs 有限窗口 → 需要窗口管理机制。 --- ## 两种窗口机制 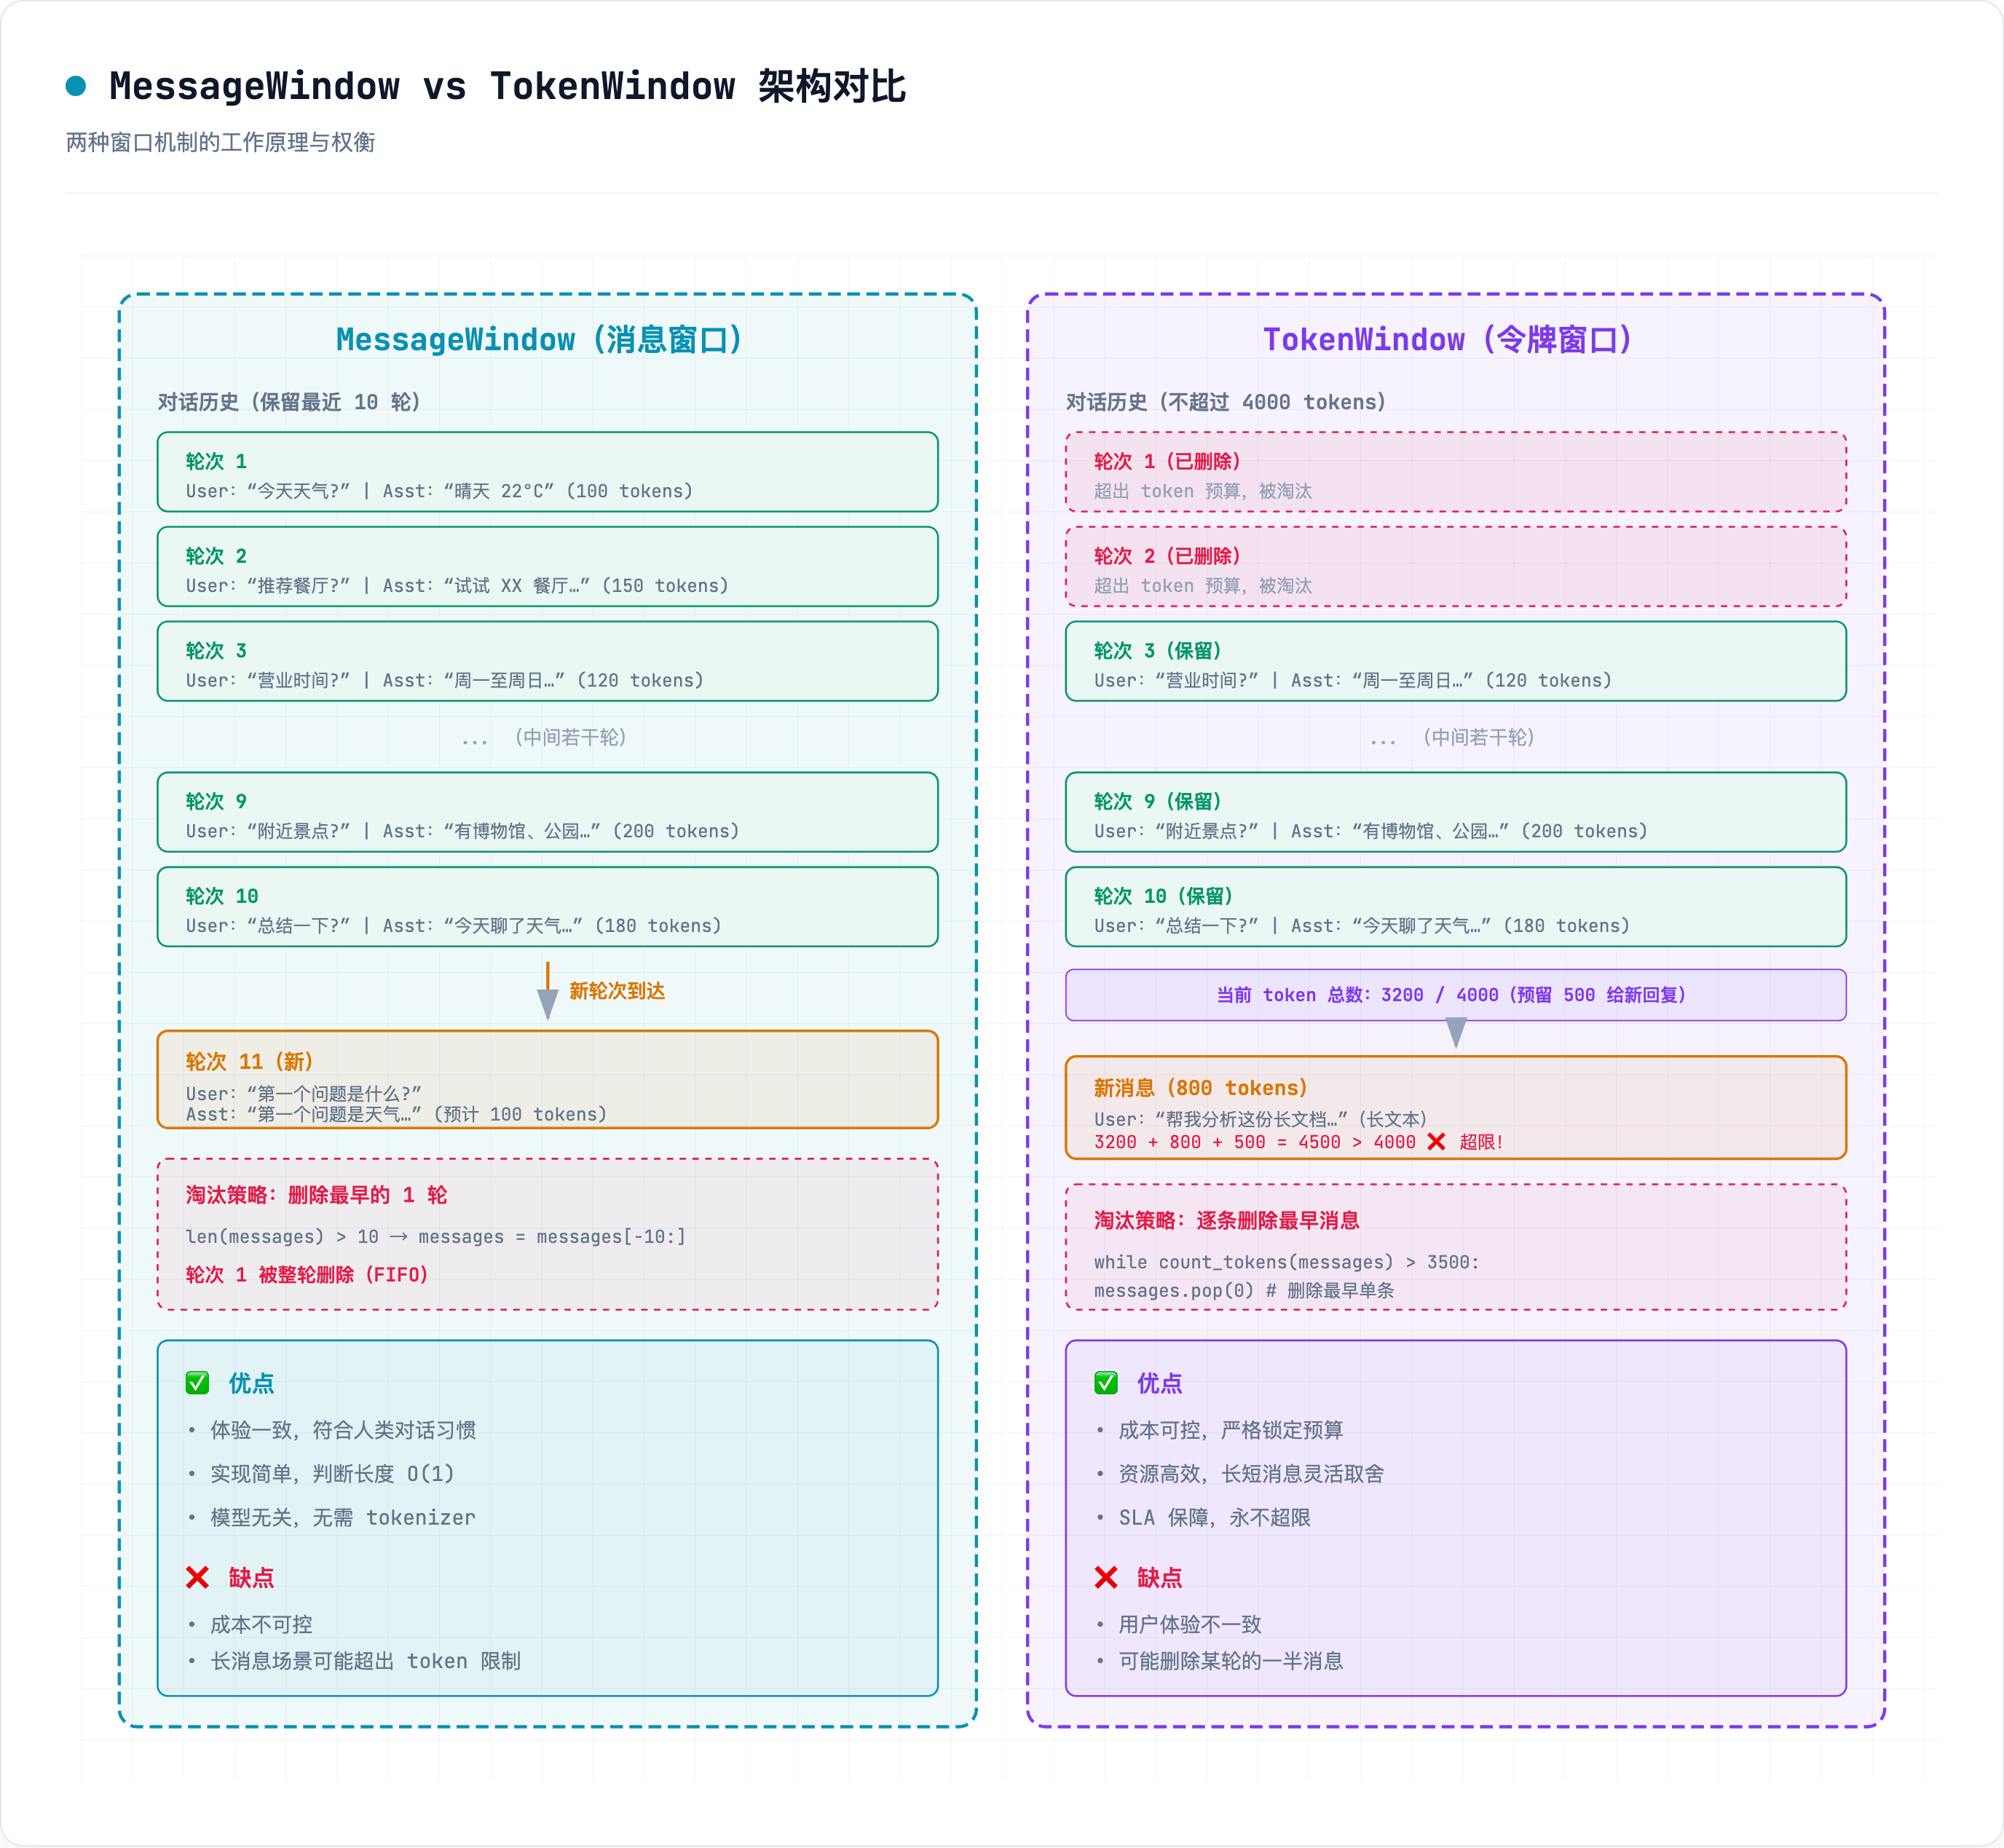 ### MessageWindow(消息窗口) **定义**:按**消息对数量**截断,保留最近 N 轮对话。 ```python class MessageWindow: def __init__(self, max_messages=10): self.messages = [] self.max_messages = max_messages def add(self, role, content): self.messages.append({"role": role, "content": content}) # 超过限制时,删除最早的一对(user + assistant) if len(self.messages) > self.max_messages: self.messages = self.messages[-self.max_messages:] def get_context(self): return self.messages ``` **特点**: - 窗口单位:**消息对**(1 user + 1 assistant = 1 轮) - 淘汰策略:FIFO(先进先出),删除最早的完整对话轮次 - 可预测性:总是保留最近 N 轮,用户可感知边界 ### TokenWindow(令牌窗口) **定义**:按**token 总数**截断,保留不超过 N tokens 的历史。 ```python class TokenWindow: def __init__(self, max_tokens=4000, reserve_tokens=500): self.messages = [] self.max_tokens = max_tokens self.reserve_tokens = reserve_tokens # 为新回复预留空间 self.tokenizer = tiktoken.get_encoding("cl100k_base") def count_tokens(self, messages): """计算消息列表的 token 总数""" total = 0 for msg in messages: total += len(self.tokenizer.encode(msg["content"])) total += 4 # 消息格式开销 return total def add(self, role, content): self.messages.append({"role": role, "content": content}) # 从最早的消息开始删除,直到留够空间 available = self.max_tokens - self.reserve_tokens while self.count_tokens(self.messages) > available: self.messages.pop(0) # 删除最早的单条消息 def get_context(self): return self.messages ``` **特点**: - 窗口单位:**token 数**(实际消耗的模型输入单元) - 淘汰策略:逐条删除最早消息,直到满足 token 预算 - 精确控制:严格控制 API 费用和延迟 --- ## 架构对比 ### 1. 资源利用效率 **TokenWindow 胜出** | 场景 | MessageWindow (保留 10 轮) | TokenWindow (4000 tokens) | |------|---------------------------|---------------------------| | 短消息对话(每轮 50 tokens)| 保留 500 tokens | 保留 **80 轮** | | 长文档分析(每轮 800 tokens)| 保留 8000 tokens → **API 拒绝** | 精确控制在 4000 tokens 内 | **结论**:MessageWindow 在极端场景下会**浪费窗口**(短对话)或**超限崩溃**(长对话)。 ### 2. 用户体验一致性 **MessageWindow 胜出** 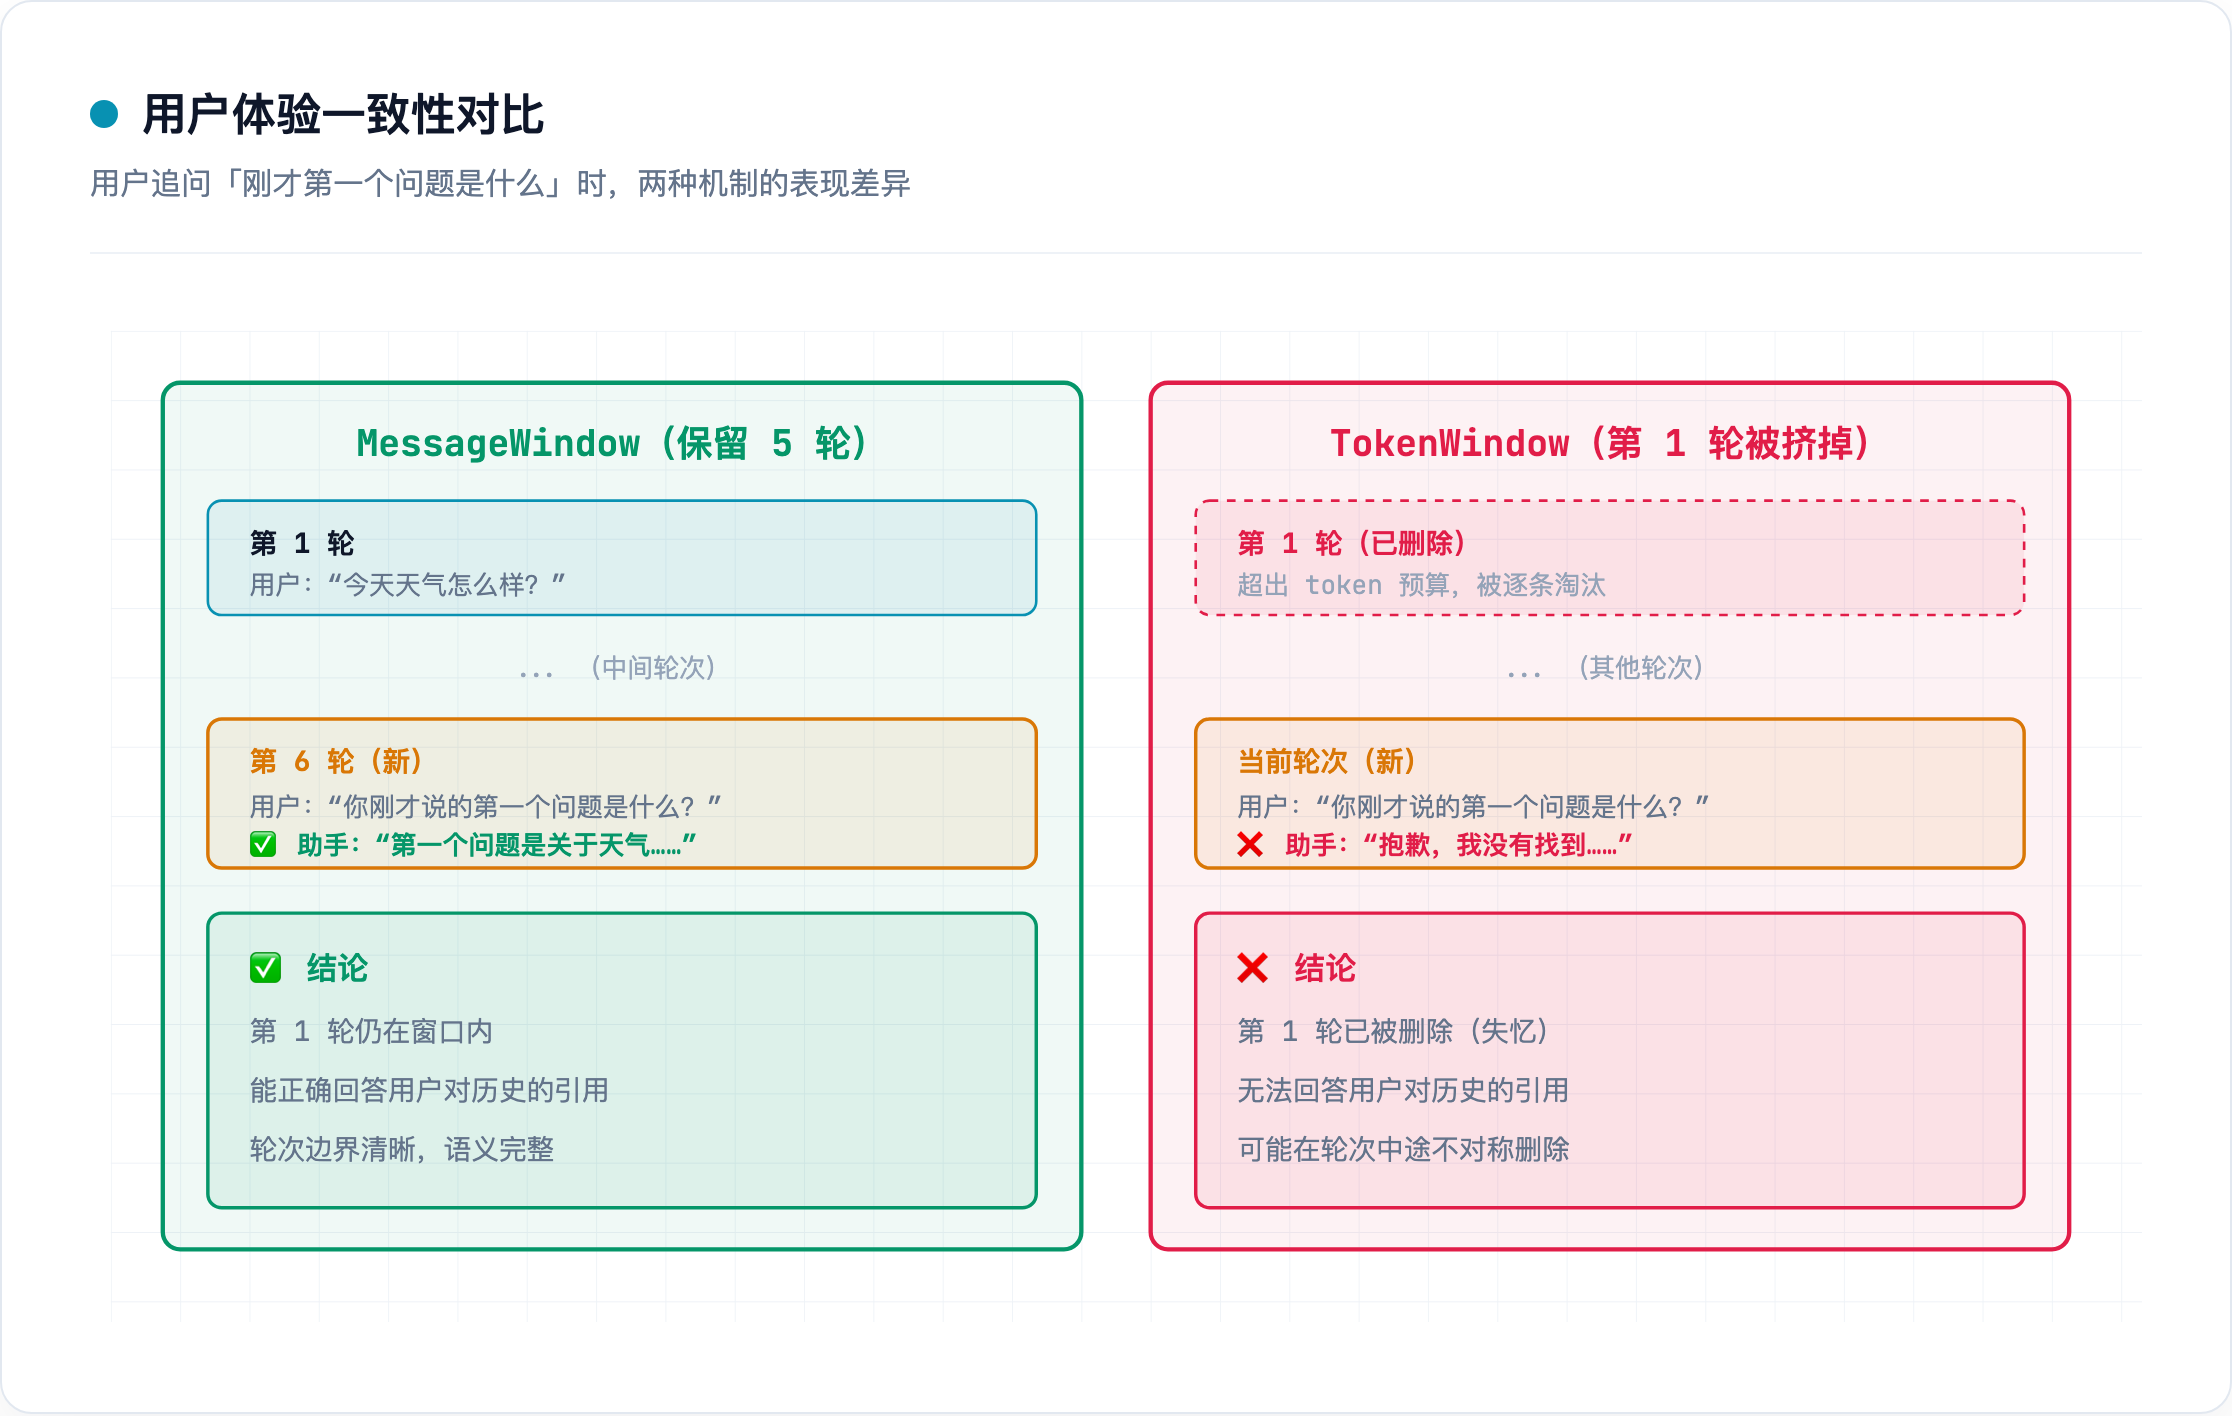 **结论**:MessageWindow 的「轮次边界」符合人类对话习惯,TokenWindow 可能在对话中途**不对称地删除**某条消息,打断语义连贯性。 ### 3. 成本可控性 **TokenWindow 胜出** 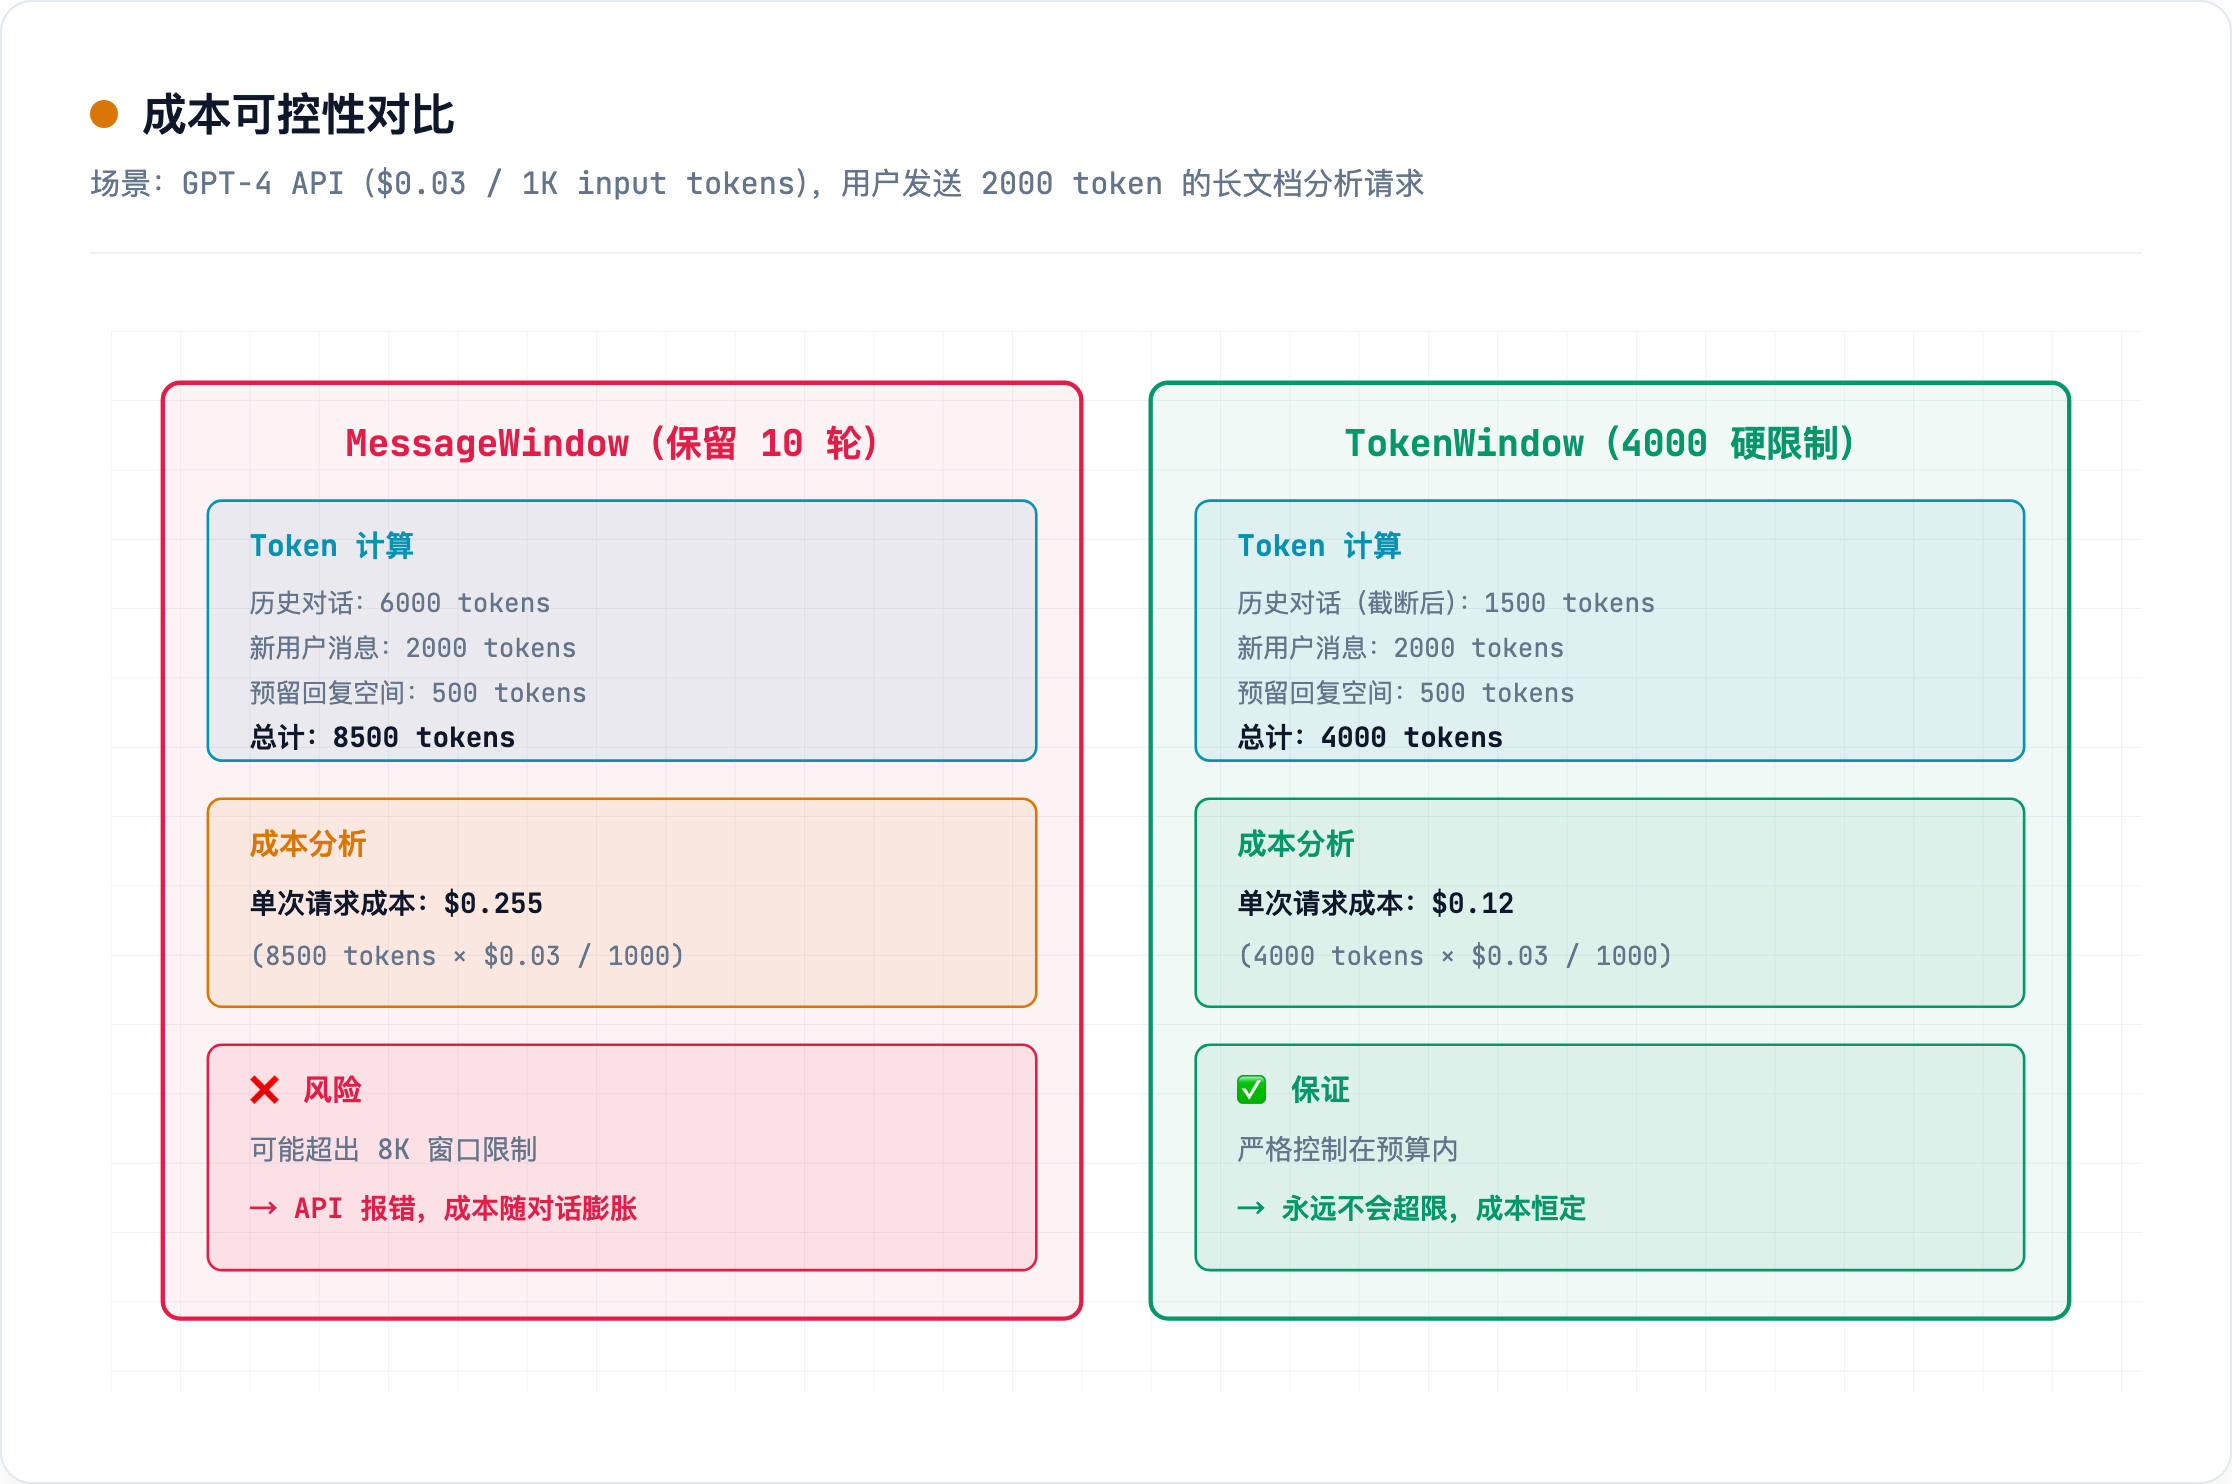 **结论**:TokenWindow 是 **SLA 保障**的基础,避免突发长文本导致的成本失控。 ### 4. 实现复杂度 **MessageWindow 胜出** | 维度 | MessageWindow | TokenWindow | |------|--------------|-------------| | 依赖 | 标准数组操作 | 需要 tokenizer(如 tiktoken) | | 计算开销 | O(1) 判断长度 | O(n) 遍历计算 token 数 | | 模型迁移 | 无关模型 | 依赖模型的 tokenizer(GPT/Claude 不同) | | 调试难度 | 直观("保留 10 轮") | 抽象("4000 tokens 对应多少轮?") | **结论**:MessageWindow 是 **MVP 首选**,TokenWindow 是生产级优化方向。 --- ## 线上业务的选型逻辑 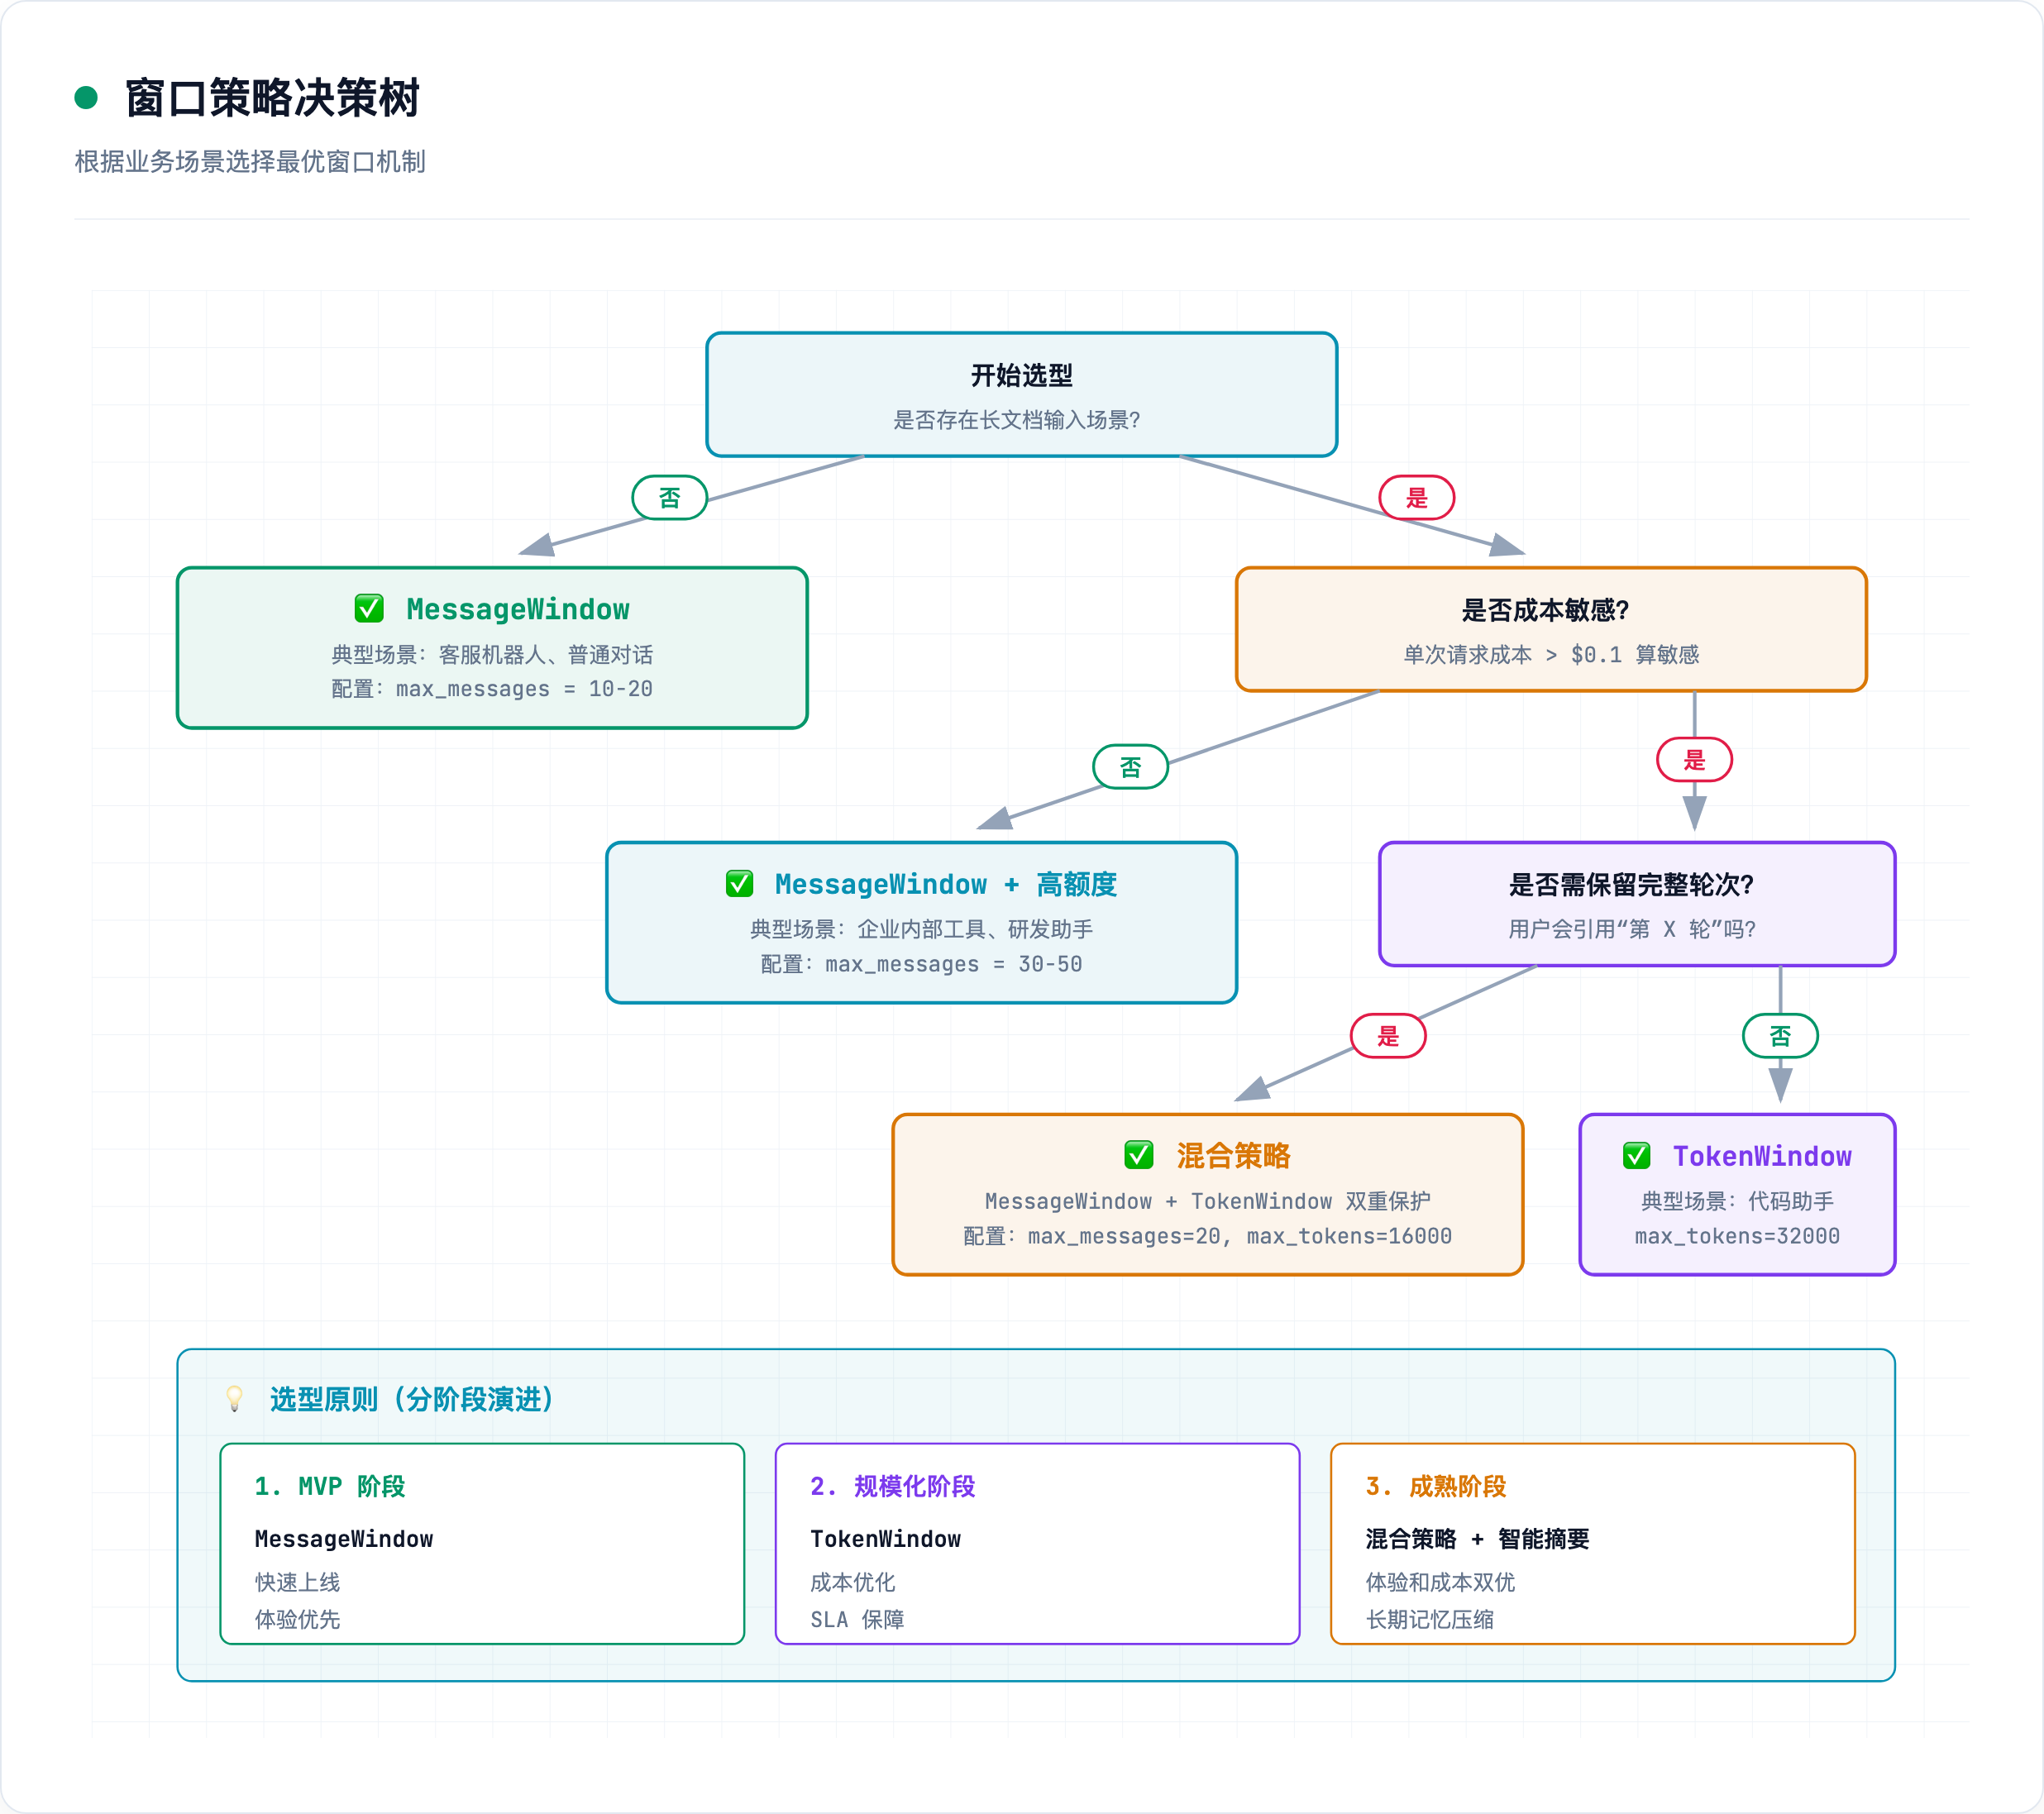 ### 场景 1:客服机器人(短对话、高并发) **推荐:MessageWindow** ``` 特征: - 平均对话轮次:3-5 轮 - 消息长度:每条 50-200 tokens - 用户预期:记住"刚才说的话" 选择理由: ✅ 用户体验一致:"保留最近 5 轮对话"符合客服场景 ✅ 实现简单:无需引入 tokenizer 依赖 ✅ 成本可控:短对话不会触发窗口上限 ❌ 不需要 TokenWindow 的精确控制(场景不极端) ``` ### 场景 2:代码助手(长上下文、复杂任务) **推荐:TokenWindow** ``` 特征: - 单条消息可能包含完整代码文件(500-5000 tokens) - 需要引用多个文件的上下文 - 费用敏感(每次请求成本 $0.1-$1) 选择理由: ✅ 成本可控:严格限制在 32K tokens 预算内 ✅ 避免超限:长文件不会导致 API 拒绝 ✅ 灵活性高:可以保留 1 条长消息或 10 条短消息 ❌ MessageWindow 会在长文件场景下崩溃 ``` ### 场景 3:知识库问答(混合长度、企业级) **推荐:混合策略(MessageWindow + TokenWindow)** ```python class HybridWindow: def __init__(self, max_messages=20, max_tokens=16000): self.max_messages = max_messages self.max_tokens = max_tokens self.messages = [] def add(self, role, content): self.messages.append({"role": role, "content": content}) # 第一道防线:消息数截断(保证体验一致性) if len(self.messages) > self.max_messages: self.messages = self.messages[-self.max_messages:] # 第二道防线:token 截断(保证成本和 SLA) while self.count_tokens(self.messages) > self.max_tokens: self.messages.pop(0) ``` **选择理由**: - MessageWindow 兜底用户体验("总是保留最近 20 轮") - TokenWindow 守住成本红线("绝不超过 16K tokens") - 90% 场景下 MessageWindow 生效(正常对话) - 10% 极端场景 TokenWindow 介入(长文档查询) --- ## 架构权衡矩阵 | | MessageWindow | TokenWindow | 混合策略 | |---|--------------|-------------|---------| | **用户体验** | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐ | | **成本可控** | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | | **实现复杂度** | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐ | | **极端场景鲁棒性** | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | | **调试友好** | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | | **模型无关性** | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐ | --- ## 生产环境最佳实践 ### 1. 分层窗口设计 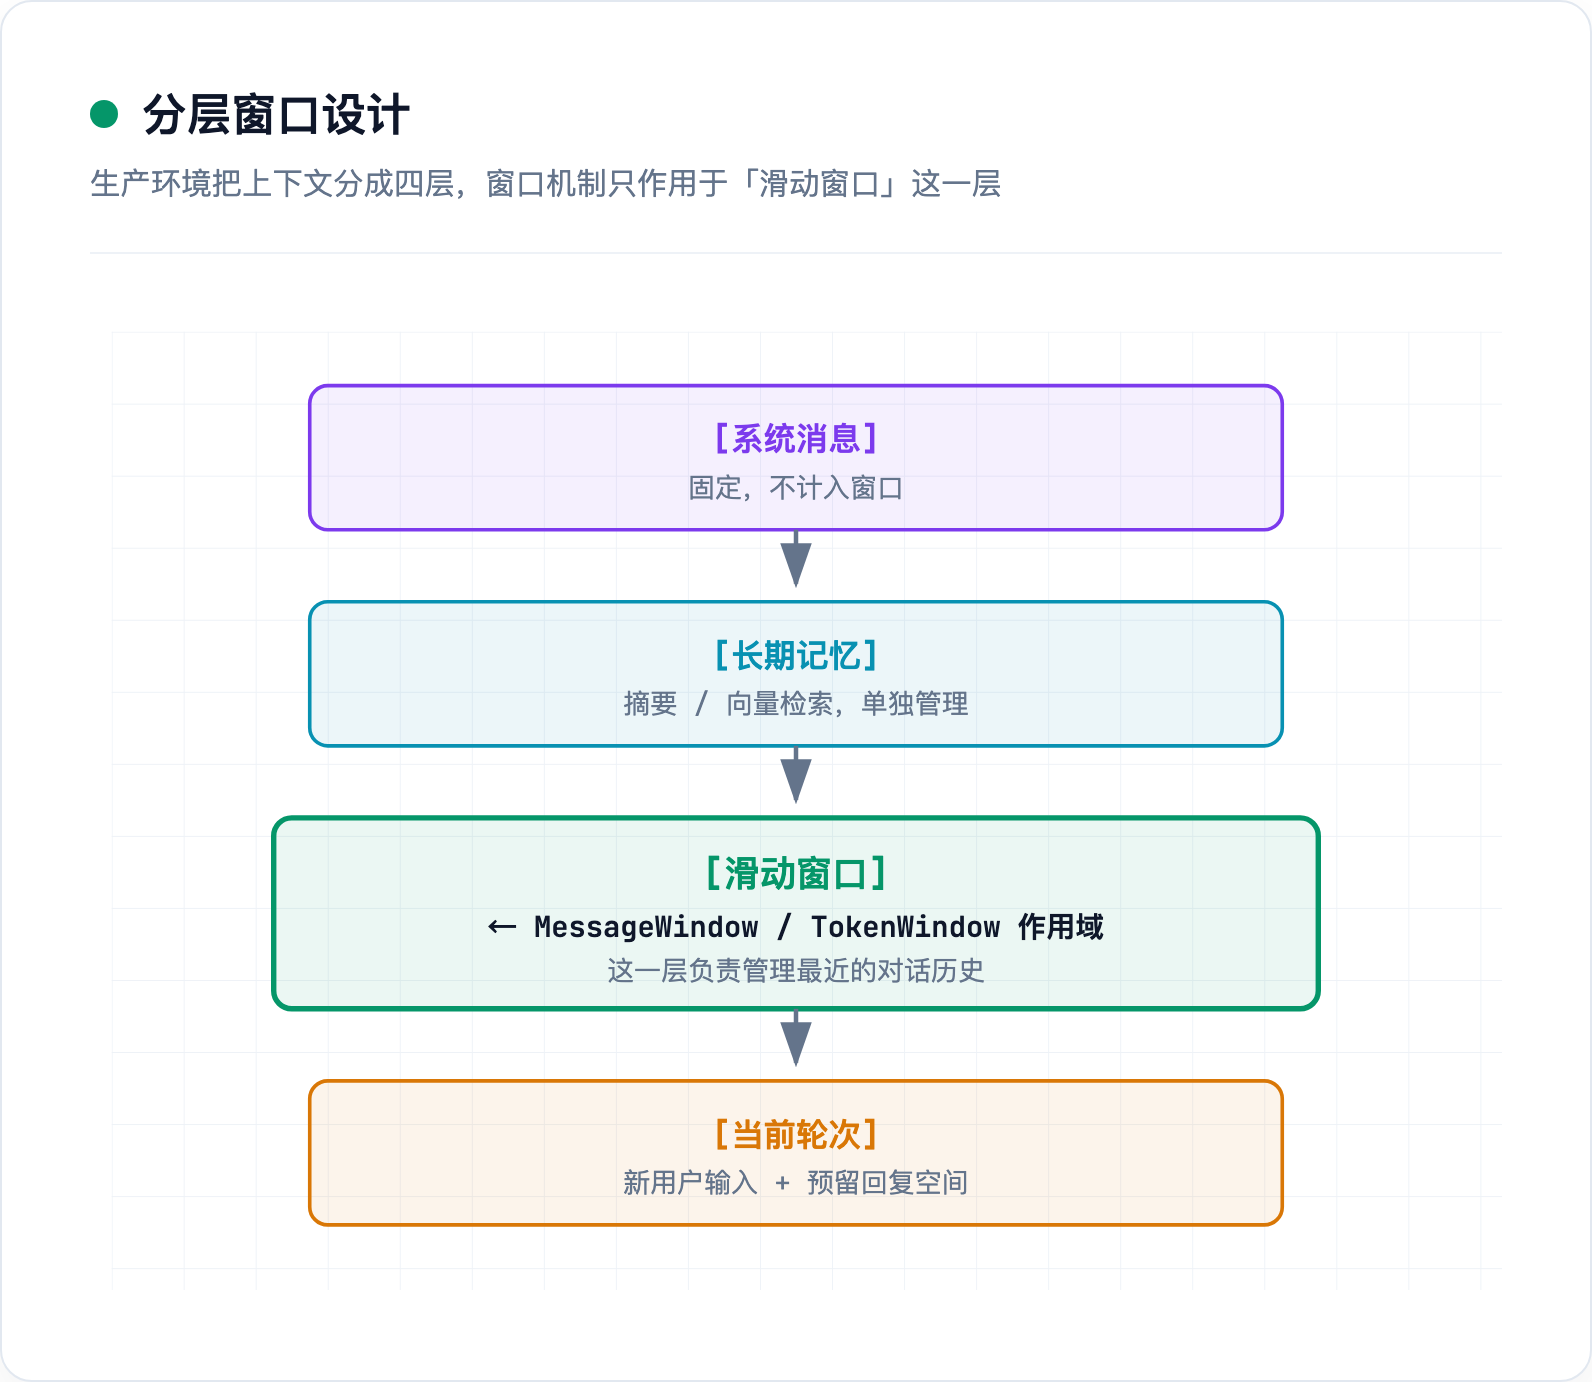 ### 2. 监控指标 ```python # 关键指标 metrics = { "avg_context_tokens": 统计平均上下文长度, "window_truncation_rate": 窗口截断频率(多少请求触发了删除), "max_tokens_utilization": 窗口利用率(实际 tokens / 最大 tokens), "user_complaint_loss_context": 用户投诉"失忆"的比例 } ``` ### 3. 动态调整策略 ```python # 根据用户行为动态选择 def select_window_strategy(user_profile): if user_profile.avg_message_length < 100: return MessageWindow(max_messages=10) elif user_profile.is_enterprise: return HybridWindow(max_messages=20, max_tokens=32000) else: return TokenWindow(max_tokens=4000) ``` --- ## 常见误区 ### ❌ 误区 1:"TokenWindow 更先进,应该全面替代 MessageWindow" **真相**:技术选择无绝对优劣,要看场景。客服机器人用 TokenWindow 是过度设计。 ### ❌ 误区 2:"保留更多历史总是更好" **真相**:过长的上下文会: - 增加成本(每次请求都带上 10K tokens 历史) - 降低响应速度(模型处理时间与 token 数正相关) - 引入噪音(10 轮前的对话可能已经无关) ### ❌ 误区 3:"用户不会注意到窗口截断" **真相**:用户会明确问「你刚才说的第一个建议是什么?」,失忆会直接导致差评。 --- ## 技术演进方向 ### 1. 智能摘要 + 窗口管理 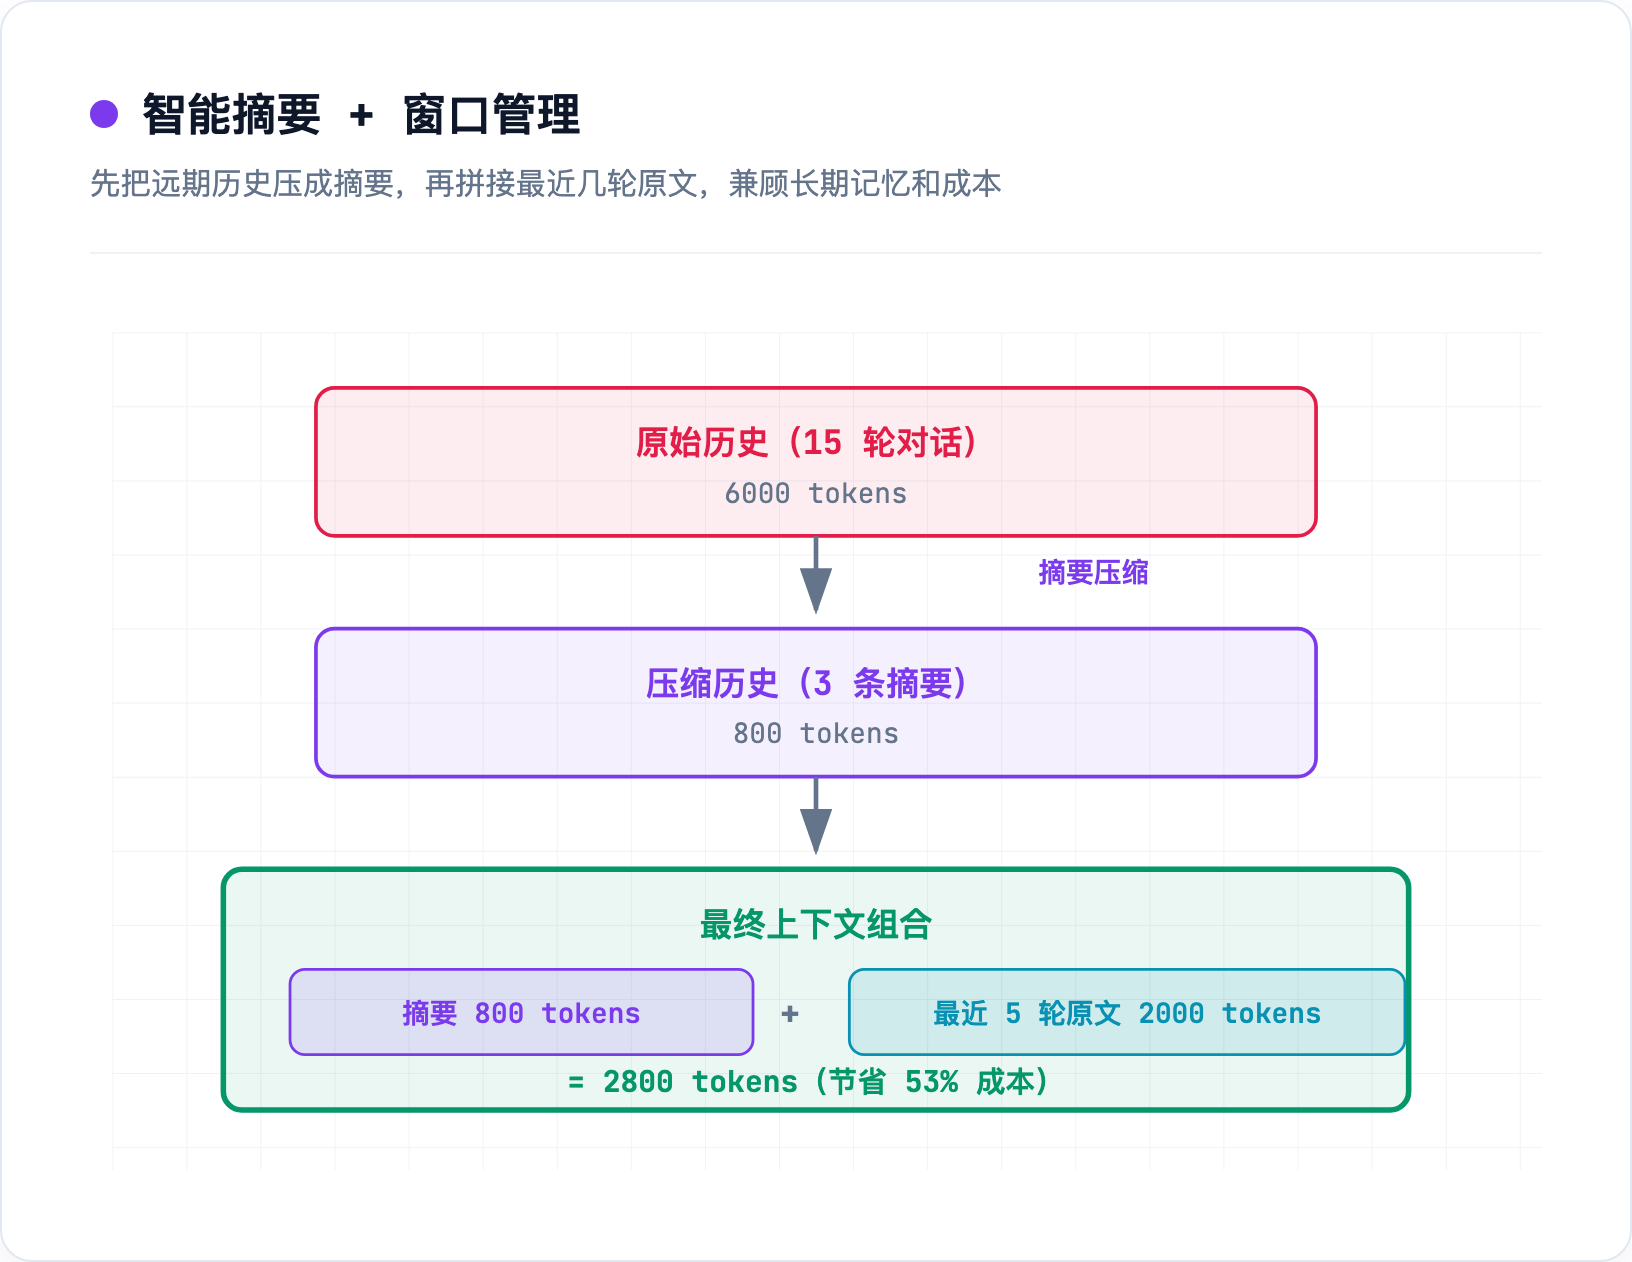 **优势**:兼顾长期记忆和成本控制。 ### 2. 语义重要性截断 ```python # 不是删除"最早的",而是删除"最不重要的" def semantic_truncate(messages, max_tokens): # 用嵌入模型计算每条消息与当前任务的相关性 scores = [relevance_score(msg, current_task) for msg in messages] # 按相关性排序,删除低分消息 ranked = sorted(zip(messages, scores), key=lambda x: x[1]) ... ``` ### 3. 用户可控窗口 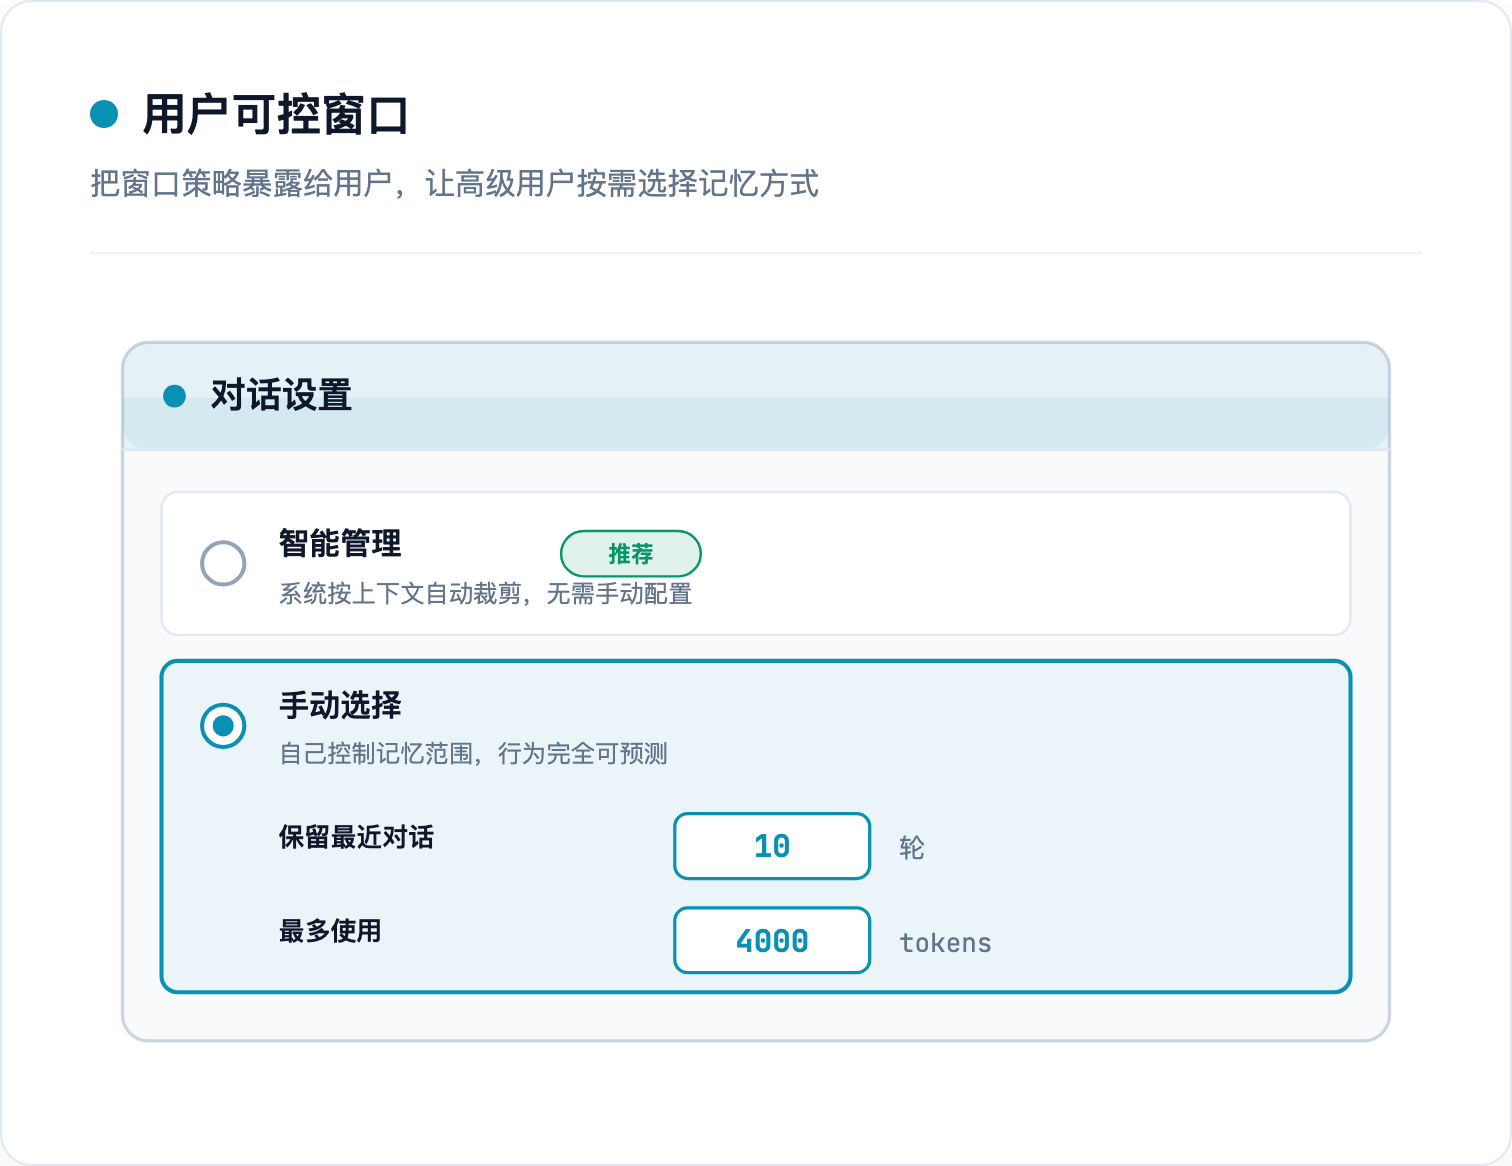 把窗口策略暴露给用户:默认「智能管理」自动裁剪,高级用户可切到「手动选择」,自己指定保留轮数和 token 上限,行为完全可预测。 --- ## 结论 **MessageWindow vs TokenWindow 不是二选一,而是架构分层的选择**: 1. **MVP 阶段**:MessageWindow(快速上线,体验优先) 2. **规模化阶段**:TokenWindow(成本优化,SLA 保障) 3. **成熟阶段**:混合策略 + 智能摘要(体验和成本双优) **决策树**: 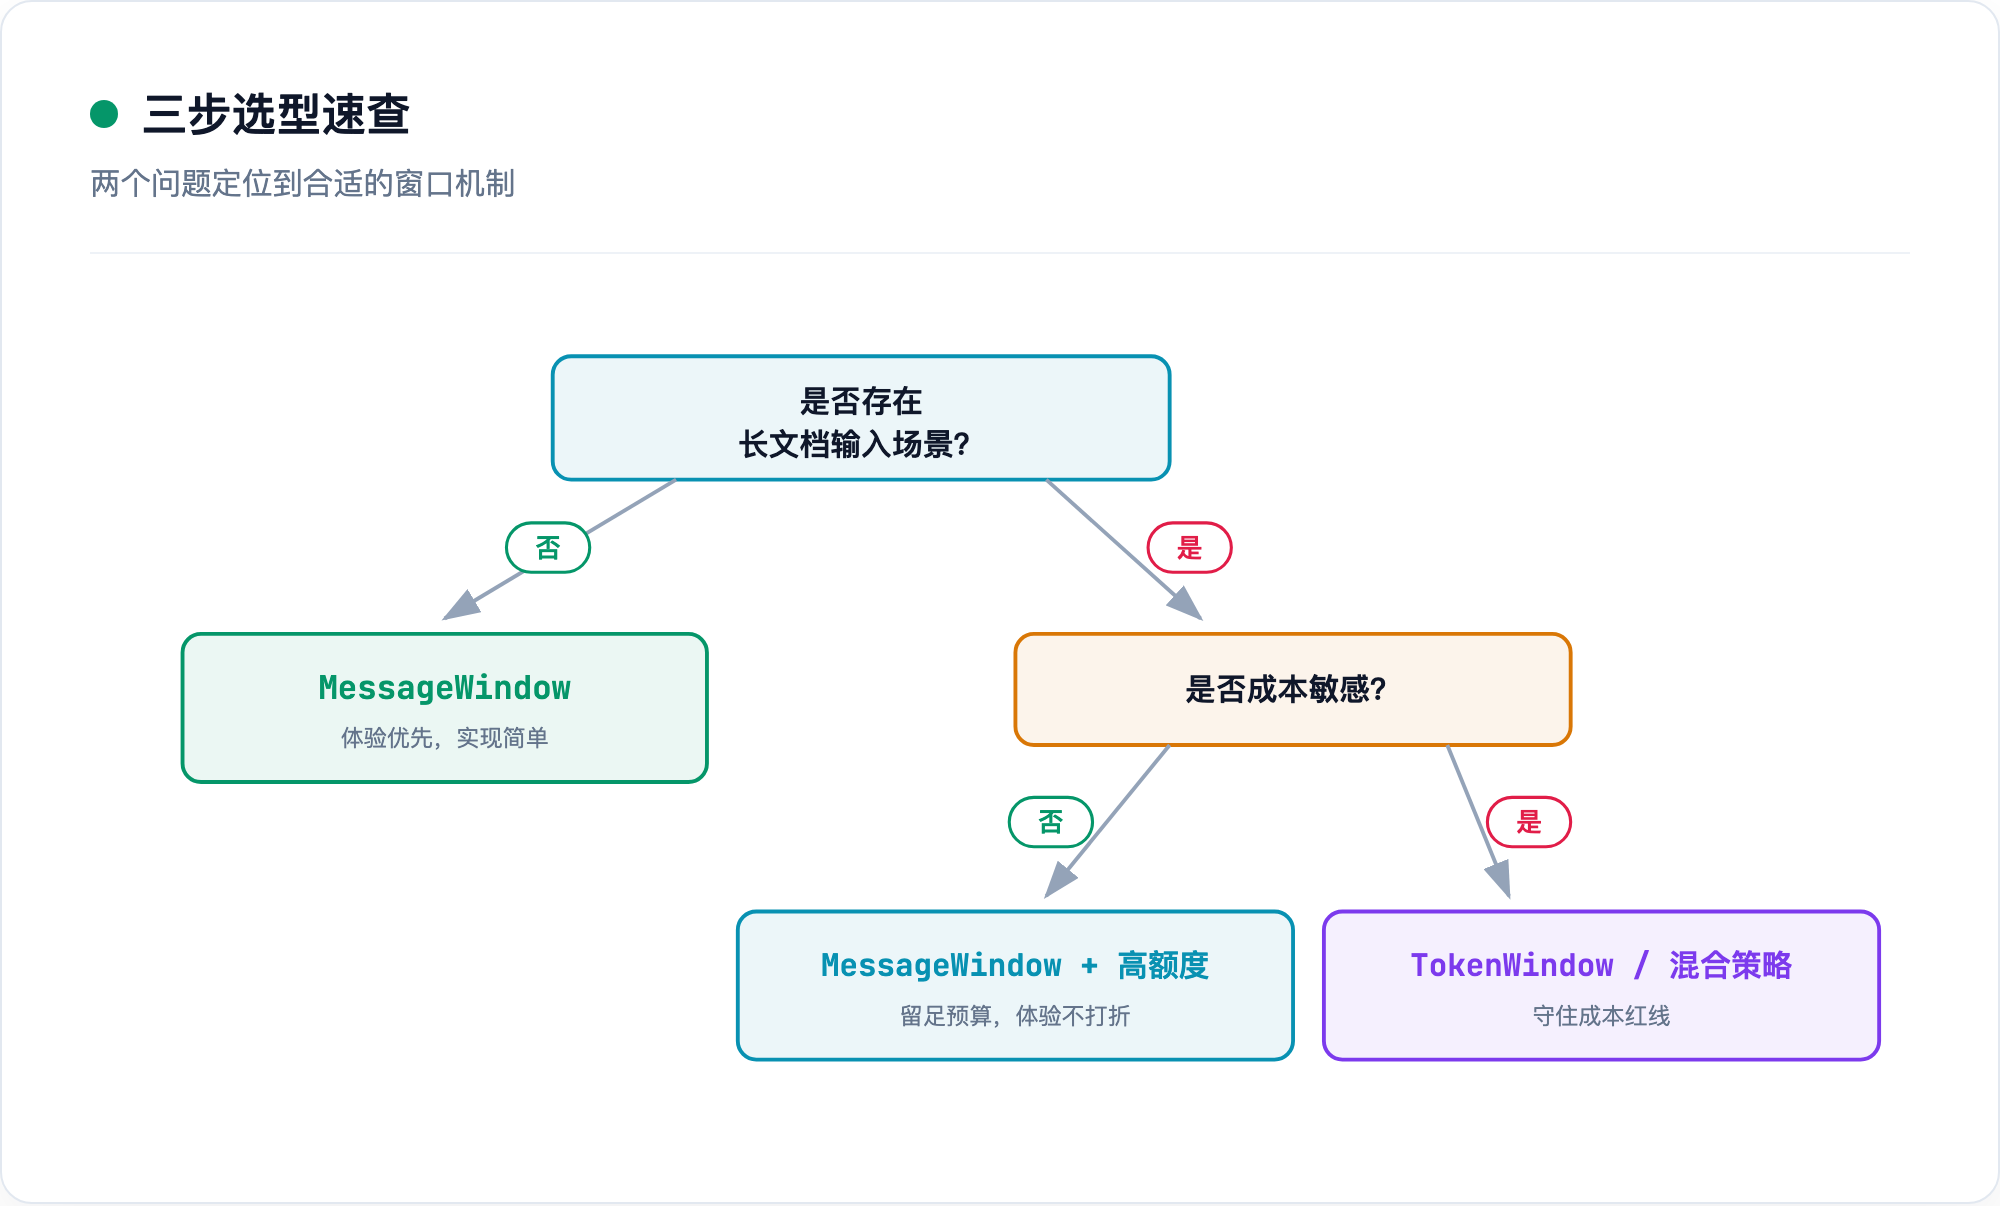 **核心原则**:窗口机制是**产品-成本-体验的三角权衡**,没有银弹,只有适配场景的最优解。