首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4325篇文章
优秀的个人博客,低调大师

#WorkBuddy# 用券省的钱为什么会让门店亏钱:我把这个成本模型做成了可运行的 Skill(附 GitHub 源码)

## 一、先给你看一个反直觉的算例 有人点了 47 元的餐,用券实付 21.9 元,省了 25.1 元。直觉上:**这一单平台/门店少收了 25.1 元**。 那门店这单还剩多少? 按一个餐饮门店的典型成本结构粗算(食材 32%、人工 18%、房租物业 12%、特许权费 5%、其他 6%),算出来是: - 门店实收:**21.9 元** - 固定类成本(食材+人工+房租+其他)按原价 47 元摊:**32.02 元** - 特许权费按实付摊:**1.10 元** - 估算毛利:**-11.16 元,毛利率 -50.9%** **顾客省下的钱,门店一分没多省——薯条不会因为打折变便宜,店员也不会。** 这就是我做这个项目的全部动机:把"我省了多少"翻译成"门店这单赚多少",让优惠的代价变得具体。 ## 二、结论先行:成本必须分两层 同一个"成本率",乘在原价上还是乘在实付上,结果完全相反。 |成本类型|例子|按什么计|为什么| | --- | --- | --- | --- | |固定类|食材/包装、人工、房租物业、其他|原价营收|门店该花的钱不会因为顾客用券而少花| |变动类|特许权费(按营业额抽成)|券后实付|抽成基数跟着实际到账走| 写成代码就是一个分层: ``` # 固定类成本按「原价营收」计:顾客用券不会让门店少花一分钱 food_cost = list_total * params.food_cost_ratio labor_cost = list_total * params.labor_ratio occupancy_cost= list_total * params.occupancy_ratio other_cost = list_total * params.other_ratio # 变动类成本按「券后实付」计:特许权费跟着实付走 royalty_cost = revenue * params.royalty_ratio gross_profit = revenue - (food_cost + labor_cost + occupancy_cost + royalty_cost + other_cost) ``` **盈亏平衡让利率**(毛利率归零时的折扣力度)推导也不复杂。设 L=原价合计,r=让利率,F=固定成本率合计,R=特许权费率: ``` 实付 = L(1-r) 成本 = L·F + L(1-r)·R 毛利 = 0 => (1-r)(1-R) = F => r = 1 - F/(1-R) ``` 例:F=0.68、R=0.05 时,让利率超过 **28.4%** 这一单门店就不赚钱了。 ## 三、我做成了什么 **麦麦毛利镜(mcd-margin-mirror)**:一个只做确定性算术、不让大模型口算的门店毛利估算器。 - **取数**交给麦当劳 MCP(菜单、四路券池、券后核价) - **算术**交给 Python(`src/estimator.py`,纯标准库零依赖) - **表达**交给 Agent(把结果讲成人话) 关键设计:**所有成本率必须使用者自己填**,缺字段直接报错,项目不内置任何"行业经验值"——填不出真实口径就别用,这是刻意的。 输入一份订单 + 一份成本参数,输出:单品/单笔的成本拆解、估算毛利、毛利率、盈亏平衡让利率。 ``` git clone https://github.com/Kormendierijon681-oss/mcd-margin-mirror.git cd mcd-margin-mirror python3 scripts/demo.py # 离线演示,无需 Token open docs/demo.html # 出 HTML 报告 python3 scripts/selftest.py # 16 项断言自测 ``` 接真实数据需要麦当劳 MCP 的 Token(免费申请),配置用环境变量占位符,仓库里不存任何真实凭证。 ## 四、一个容易被算错的地方(我踩过) 人工和房租属于**期间固定成本**,模型按"这一单原价占门店期间原价合计的份额"分摊到单笔——门店单期汇总时总额守恒,但**单品层面会失真**:一份高价订单会被多摊人工房租,看起来"更亏"。 所以要看单品的真实边际贡献,把人工率与房租率置 0,只留食材、包装和特许权费。这个口径我写进 README 了,不想让后来人重复踩。 ## 五、开源仓库 + 评论区求 Star **先玩再读:**在线试玩(零配置,打开即用)——拖动滑块改让利力度,实时看优惠怎么把门店毛利吃掉,成本率也能改成你自己的口径: [https://kormendierijon681-oss.github.io/mcd-margin-mirror/](https://kormendierijon681-oss.github.io/mcd-margin-mirror/) 源码、模型推导过程、踩坑记录都在 GitHub: [**https://github.com/Kormendierijon681-oss/mcd-margin-mirror](https://github.com/Kormendierijon681-oss/mcd-margin-mirror)** 这是我参加麦当劳程序员创意开发大赛的参赛作品(已报名成功)。**如果你觉得这个模型对你有用,欢迎在 GitHub 上给它点个 Star**——Star 数是这个赛事的排名依据,也是对我最实在的支持。评论区说一声你的用法,我也会回。 ## 六、口径与免责 1. 本项目**不含任何品牌的真实成本数据**,示例参数全部为虚构占位符,只用于演示计算流程。 1. 输出是**结构化估算**,不是官方数据,不构成经营建议。真实结论请用你自己的成本口径重算。 1. 项目灵感来自餐饮经营中的「成本率摊分」常识,与麦当劳官方无关;所有餐品信息以官方渠道实时结果为准。 *本文同步发布于我的 GitHub 仓库 README(含完整模型推导与自测断言)。*

优秀的个人博客,低调大师

凌晨一点,我为了让 AI 别一口气读完 14 万字,跟自己的记忆库较劲 #WorkBuddy#

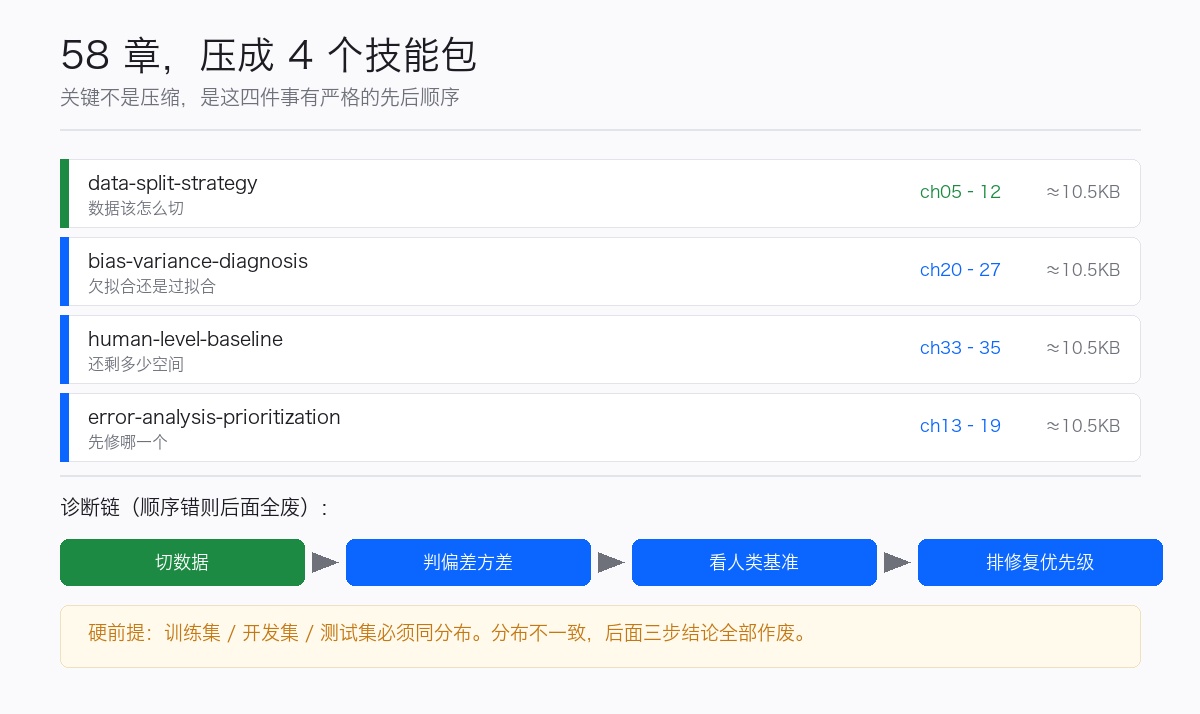
那天晚上我不该点开那本书的。 起因很朴素:我在整理一批机器学习方法论的困惑,想找本系统的东西垫底。朋友说吴恩达有本书是**他自己免费公开**的,不卖 DRM,中文版连翻译都开源了。我心想这种好事不常有,手一抖就把它拉了下来。 然后我发现,它有 58 章(英文原版;社区也常按「52 个工程要诀」归类),我手上的全文 144,407 字节。 ## 凌晨一点,我盯着一个数字发呆 14 万字是什么概念?我把它整个塞进上下文,然后眼睁睁看着 AI 开始一段一段读,读到某个位置,语气开始变得飘——它开始给我讲一些这本书里根本没写过的东西。 那一刻我反应过来了:**这不是书的问题,是我的用法有问题。** 书的问题在于它太大。我一次喂 14 万字,AI 就得分心替我做取舍,取舍一做,事实就开始漂。 我需要的是:让 AI 一次只看它当前要用的那一章。 ## 第一次翻车:我以为多开几个进程更快 我的第一反应很朴素——既然一章一章读太慢,那就并行抓吧。于是我写了个脚本,一章一章顺序请求 GitHub。 第一次跑,进程被系统直接掐了,退出码 `exit 137`。查了一下,是 SIGTERM,内存回收。 我以为偶发,重跑。又 `exit 137`。 两次。同一个地方。 现在回头看这事我有点想笑:**我把"内存回收"当成了"偶发故障",其实它一直在很明确地告诉我——你一次开太多东西了。** 我没听懂,还换了姿势再撞一次。 > 📷 配图 1:两次 `exit 137` 与并发一次成功的对照(`配图/02__fig1-exit137.png`) ## 第二次翻车:不是慢,是被杀了 改法很简单,把串行换成线程池,`max_workers=8`。 58 章,一次跑完,零失败。 这一下让我意识到一个挺反直觉的事:我原来那个"失败",根本不是失败,是**我开的口子太大,系统在替我关门**。并发不是为了快,是为了**别把内存一次性撑爆**。 抓取方式我也改了规矩:不下载 PDF 实体,不做 OCR,直接走 GitHub API 取 Markdown 原文。作者本人是免费公开的,我没有任何理由去绕这一圈把它变成一个 100 多MB 的 PDF 躺在硬盘上。 ## 第三次翻车:一行命令看着对,跑出来是空的 原文抓下来了,每章开头有个`` 这样的标记,正好方便定位。于是我顺手写了个提取命令,大意是"从 ch21 标记匹配到 ch22 标记"。 跑出来是空的。 我第一反应是怀疑标记丢了。翻文件,58 个标记一个不少。那就只剩一种可能:**我那条命令的思路本身有问题。** 最后改成用 Python 把整个文件按标记切成段、装进字典,按章节名取。一下就对了。 这件事我记了很久。**一个看起来完全合理的区间匹配,在真实文件上可以是彻底无效的**,而且它不报错——它只是安静地给你空结果。这比报错可怕多了。 ## 那一晚我到底造了什么 到凌晨,我把整本书变成了 4 个技能包。不是 58 个,是 4 个。 | 技能包 | 回答什么问题 | 来源章节 | |---|---|---| | `data-split-strategy` | 数据该怎么切 | ch05–12 | | `bias-variance-diagnosis` | 这是欠拟合还是过拟合 | ch20–27 | | `human-level-baseline` | 我还剩多少提升空间 | ch33–35 | | `error-analysis-prioritization` | 下一步该先修哪个 | ch13–19 | 外加精华长文、术语表、技能地图、审计记录,和一份测试用例集。四个技能包每个约 10.5 KB。 **关键不是"我压缩了一本书"。关键是我发现这四件事有严格的先后顺序。** > 📌 **先把边界说清楚,免得你拿它跟网上的「完整蒸馏」去比**:网上能见到更细或更广的版本——有人把吴恩达的整套管教学(CS229 + 深度学习专项 5 门课 + AI for Everyone + 2026 的 Agent 内容)蒸馏成 40–50 个 skill;也有按书里「50 多个工程要诀」逐条拆的。我这四样是**个人的粗粒度整合**:只取「诊断链」最核心的那一条线,而且明确没覆盖全部章节(下文列了哪些没做)。它解决的是「我下一步该先干哪件」这个具体问题,不是一本完整的方法论词典。同样的源书、话题必然有重叠,但粒度不同、目标也不同。 ## 我一开始把顺序搞反了 我最开始想的是:这是个诊断问题嘛,那肯定先判断是欠拟合还是过拟合,然后再决定怎么修。 错了。 真正正确的链条是: **先切数据 → 再判偏差方差 → 再看人类基准 → 最后才排修复优先级** 因为第一步就有个硬前提:**训练集、开发集、测试集必须来自同一个分布**。分布一旦不一致,后面所有的偏差方差诊断结论全部作废——你测出来的那个数字,压根不知道在说哪件事。 我把这个顺序写进了技能地图本身。只要顺序错了,后面三步全部无效。 > 📷 配图 2:4 个技能包与诊断链顺序(`配图/02__fig2-四个技能包.png`) ## 一个把所有人都骗了的常识 蒸馏的时候,我重点核实了全书里最容易被误读的一条。原文写得很清楚: > 添加更多的训练数据:这项技术可以帮助解决方差问题,但它对于偏差通常没有明显的影响。 也就是说——**你以为的"多搞点数据总没错",在欠拟合的场景下是白花钱。** 这条我逐字回原文比对了三遍,确认没记错。 它对冲的是一个特别常见的直觉:模型不行 → 是不是数据不够?很多团队就这么一路加数据、加到预算烧完,问题还挂在原地。原文给的判据是看方差那一栏,不看感觉。 顺手把另一组数字也核了:训练错误率 1%、开发错误率 11%,方差就是 10 个百分点;换成 15% 和 16%,方差就是 1 个百分点。两个数字都是原文明写的。 还有一组我特别喜欢,来自 ch34 的医学案例:无背景 15%、新手医生 10%、资深医生 5%、多人小组 2%。作者用它说明一件事——**你该对标的不是"人能做到多好",而该看这个任务对人到底难不难**。如果人都做不好,说明任务本身可能超出了当前方法的适用范围,这时候继续调模型是在做无用功。 ## 我做了一件现在回头看很庆幸的事 蒸馏完,我做了一件当时嫌麻烦的事:**把每一条引用都回原文逐条比对。** 7 条。一条一条比。 结果是没有一处编造。但真正让我庆幸的不是"没编造",而是这个流程逼出来的东西—— **有三条是我自己推断的,不是原文陈述。** 比如"这本书成书于 2018 年前后,完全不涉及大语言模型、多模态、Agent",这是我看完全书 58 章主题后的判断,**不是书里某句话说的**。我把这类内容单独列成一节,标注为"蒸馏方判断",跟原文引用物理隔开。 这事儿的意义在于:**当有人拿"这本书说……"来问我的时候,我能分清哪句是作者说的,哪句是我加的。** 混在一起就完了。 ## 一个插曲:我差点按不存在的命令装工具 我参考了一个开源的技能规范库来做蒸馏框架。写之前我习惯性搜了一下它的安装方式,差点直接抄了。 官方文档里根本没有我记忆里那个 `npx skills add` 命令。实际方式是去Release 页下压缩包,解压。 顺便还纠正了三处: - 那个安装命令在官方文档里不存在 - 依赖没写在显眼处:**Python 3.10 以上,外加 PyYAML**。我本机装的隔离环境里是 6.0.3 - 我当时查的star 数和fork 数,跟我隔天再查已经不一样了 最后这条我专门记一下:**开源项目的热度数字是会变的。** 我今天查是11,386 星、1,327 fork、MIT 协议,最近一次推送是 2026-10-02。你看这篇文章的时候,这个数字大概率已经变了。 我宁愿标一句"这是我查询当天的实测值",也不想让一个会过期的数字看起来像个稳定结论。 ## 一个必须说明白的边界 我这次是**按那套规范人工蒸馏**的,**没有跑它官方的编译工具链**。 这两件事的区别不是小不小的问题。人工蒸馏意味着每一句提炼都是我判断的结果,好处是灵活、能处理书里那些没有标准答案的部分;代价是没有那套自动化的一致性保证。 我把它明确写进审计文件里,而不是含糊过去。因为如果我写"我用 X 工具完成了蒸馏",而实际上我是手写的,那不叫偷懒,那叫编造。 ## 我也没敢覆盖全部 58 章我只做了 4 个技能包。这不代表剩下的章节没用。 审计文件里我老老实实列了哪些没做、为什么: - ch28–32 学习曲线判读——需要配套多规模实验数据,这一轮没采 - ch36–43 训练/测试分布不一致——场景偏窄,已经作为第一条技能的判停条件覆盖了 - ch44–46 推理算法调试——跟主线关联弱 - ch47–52 端到端 / 迁移学习 / 多任务——领域专用 - ch53–57 分模块错误分析——可以做成第一条技能的 v2 **没覆盖不等于没用。** 原文就在那儿放着,随时能抽。 > 📷 配图 3:核实纪律——原文引用与蒸馏方判断物理隔开(`配图/02__fig3-核实纪律.png`) ## 结尾 如果让我给那天的自己留一句话,就是: **别把"我一次喂了 14 万字所以效果不好",误诊成"这本书不行"。** 那天晚上真正的问题,从头到尾只有一个字:**大**。 一本书太大,我一次读不完,就该一次只读需要的那一章。同一件事上我撞了三次墙——两次撞在并发上,一次撞在提取命令上——三次都不是书的问题。 要说为什么这次能成,我觉得就一条:**我最后没再"猜",我回去查了原文。** 不是查资料。是查那个我以为早就知道的、以为记得住的、其实只是"我记得我读过"的那句话。 那句"加更多训练数据对偏差通常没有明显影响",我在书里逐字核了三遍。 核对完我才发现——如果当初我少核这一遍,这篇文章发出去就是错的,而且永远不会有人告诉我。 --- *文中所有数字均来自本机实测:抓取 58/58 章成功(144,407 字节)、串行两次 `exit 137`、并发一次通过、7 条引用回原文比对零编造;开源仓库数据为查询当日实测值,会随时间变化。*![image.png](https://developer.qcloudimg.com/http-save/yehe-12824395/0548ea41c4450366fe2ad692fac42b2b.png)![image.png](https://developer.qcloudimg.com/http-save/yehe-12824395/22cac98590c462120897d7646b7d832c.png)![image.png](https://developer.qcloudimg.com/http-save/yehe-12824395/05912230de8e87e11ceaeedbb73464f0.png)

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册