首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

爱她就用python给她画个小心心 ♥(ˆ◡ˆԅ)

from turtle import * a = Turtle() screensize(400, 300, "blue") setup(width=1300, height=650, startx=20, starty=20) a.speed(10) a.hideturtle() a.pensize(2) a.color('red', 'pink') a.up() a.goto(200, 0) a.down() a.left(150) a.begin_fill() a.speed(1) a.forward(51) a.speed(50) for i in range(150): a.forward(1) a.right(0.3) a.speed(50) for i in range(210): a.forward(1) a.right(0.786) a.left(120) a.speed(50) for i in range(210): a.forward(1) a.right(0.786) a.speed(50) for i in range(150): a.forward(1) a.right(0.3) a.speed(1) a.forward(51) a.end_fill() # 画笔朝向x轴正方向 a.setheading(0) a.up() a.goto(-80, -100) a.down() a.left(150) a.begin_fill() a.speed(1) a.forward(51 * 1.5) a.speed(50) for i in range(150): a.forward(1.5) a.right(0.3) a.speed(50) for i in range(210): a.forward(1.5) a.right(0.786) a.left(120) a.speed(50) for i in range(210): a.forward(1.5) a.right(0.786) a.speed(50) for i in range(150): a.forward(1.5) a.right(0.3) a.speed(1) a.forward(51 * 1.5) a.end_fill() # 画穿心直线 a.pensize(7) a.setheading(0) a.up() a.goto(-400, 0) a.down() a.left(15) a.forward(150) a.up() a.goto(339, 175) a.down() # 画箭头 a.forward(150) a.pensize(1) a.speed(5) a.color('red', 'red') a.begin_fill() a.left(120) a.forward(20) a.right(150) a.forward(35) a.right(120) a.forward(35) a.right(150) a.forward(20) a.end_fill() a.up() a.goto(400, -300) a.down() a.write('作者:爱苗苗的凡哥', move = True, align = 'left', font = ('楷体', 20, 'normal')) done() -------知识无价,汗水有情,如需搬运请注明出处,谢谢!

优秀的个人博客,低调大师

通过KNN算法预测数据所属NBA球员——Python实现

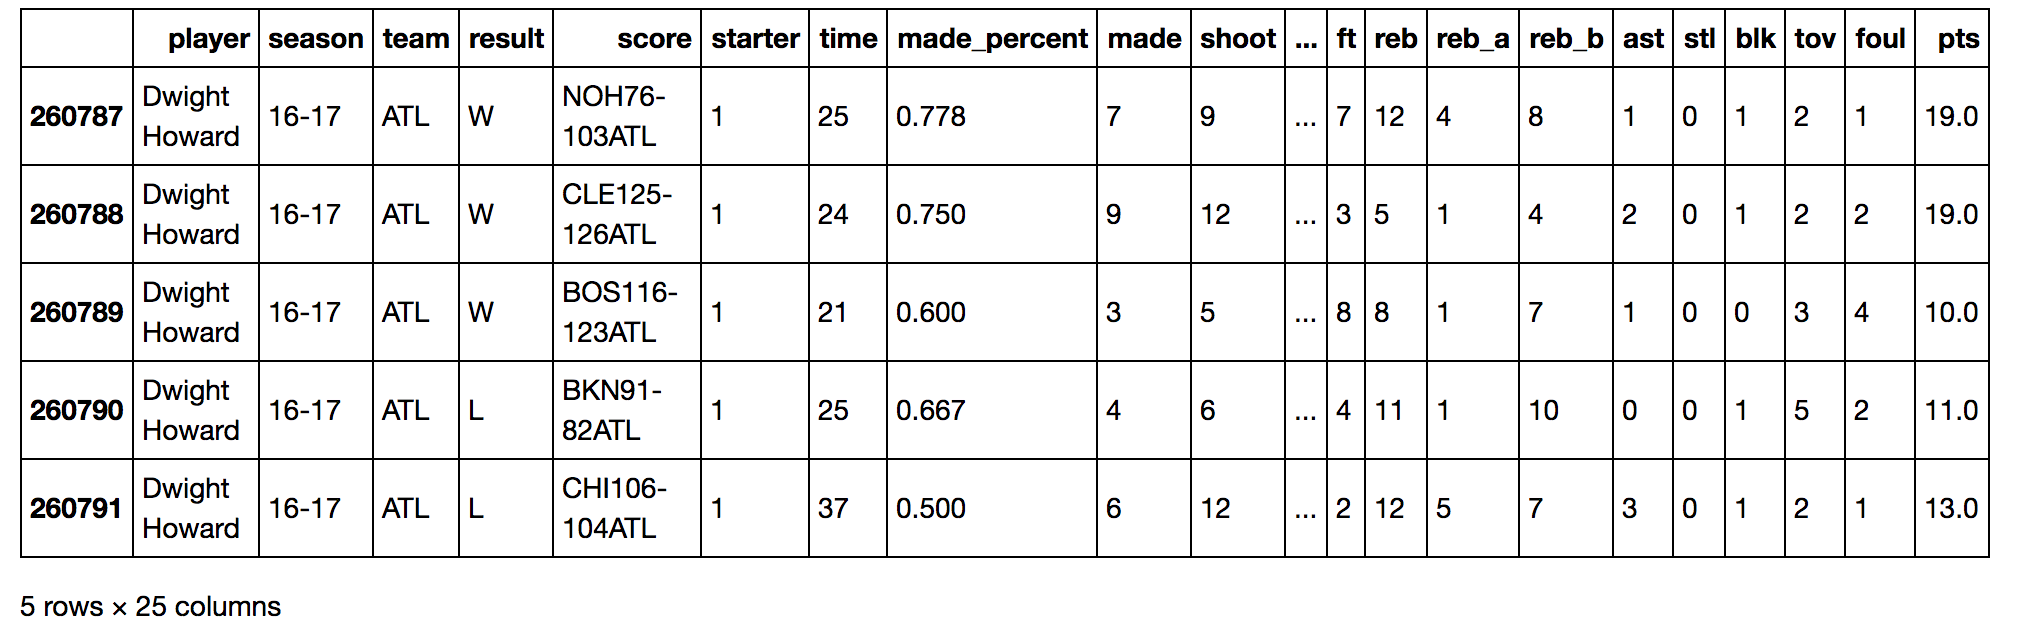
项目介绍 通过得分,篮板,助攻,出场时间四个数据来预测属于哪位球员。 选取了'LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'五位球员单场数据。 数据来源 本文使用数据全部来自于科赛网 ,字段解释如下: 字段 内容 player 球员 pts 得分 reb 篮板 ast 助攻 time 出场时间 season 赛季 项目内容 导入所需包 import pandas as pd import seaborn as sns import matplotlib.pyplot as plt import numpy as np from sklearn.neighbors import KNeighborsClassifier as KNN 导入数据 由于seaborn包作图对中文并不是很友好,我们将原有的字段名都设置为英文。选取我们所需要的五位球员数据命名为data。 #设置主题 sns.set(style="ticks") #导入数据 data = pd.read_csv('/Users/***/Downloads/NBA.zip/player_season.csv',encoding = 'utf-8') #避免seaborn包中文显示为方框问题,改为英文 data.columns = ['player', 'season', 'team', 'result', 'score', 'starter', 'time', 'made_percent', 'made', 'shoot', '3_made_percent', '3_made', '3_shoot', 'ft_percent', 'fta', 'ft', 'reb', u'reb_a', 'reb_b', 'ast', 'stl', 'blk', 'tov', 'foul', 'pts'] data = data.loc[data['player'].isin(['LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'])] data.head() image.png 可视化 其实这一步本身是不需要的,但我们还是想先在训练之前看下不同球员的数据特点。 首先我们通过散点图看5位球员的得分情况 霍华德,哈登,勒夫在进入联盟初期都有一段适应期,都经历了两三个赛季后有较大提升,哈登上升最为明显,从当年的雷霆三少到开始独自带队之后,开启砍分模式,霍华德/勒夫最近几个赛季由于战术地位的下降,数据也开始下滑; 詹姆斯/保罗数据比较稳定,‘出道即巅峰,一巅十五年’说詹姆斯真是没错; 单从得分来看,能看出些差别,但不是很明显,尤其是都步入稳定期之后,差别很小; …… plt.figure(figsize = (15,8)) #设置绘图尺寸 sns.stripplot(x='season', y='pts',data = data ,hue = 'player',jitter=True,size = 5) image.png 接下来我们通过密度图看下5位球员在篮板助攻上的表现: 首先是詹姆斯,在篮板助攻上都有不错的表现,非常全面; 保罗助攻上表现很抢眼,组织能力出色,篮板也不错,4,5个居多 哈登篮板助攻都比较低,还是以得分见长; 勒夫/霍华德两位内线球员都是篮板数据更多,相比于霍华德,勒夫分球能力更强; 霍华德在助攻上有明显的三个区间,最高的那段肯定是在魔术没错了,当年可是能单换詹姆斯的人; …… f, axes = plt.subplots(3, 2, figsize=(8, 12)) player_list = ['LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'] for ax,name,s in zip(axes.flat,player_list,np.linspace(0, 3, 5)): cmap = sns.cubehelix_palette(start=s, light=1, as_cmap=True) x = data[data['player']==name].reb y = data[data['player']==name].ast sns.kdeplot(x, y, cmap=cmap, shade=True, cut=5, ax=ax) ax.set(xlim=(0, 20), ylim=(0, 20)) f.tight_layout() image.png 各项数据看完心里算是有了一个大概,每个球员都有自己的技术特点: 保罗善于传球,所以助攻多; 哈登得分能力强,但篮板助攻都偏低; 霍华德篮板能力强,助攻偏弱; 相比于霍华德,勒夫助攻要更多; 詹姆斯全面,从数据上就可以展现; …… 最后我们16-17赛季的数据作为测试集,其他赛季的数据作为训练集,看看预测准确率能够达到多少~ #取16-17赛季数据作为测试集 data_train = data[data['season']!=u'16-17'] data_test = data[data['season']==u'16-17'] #得分,篮板,助攻,出场时间为特征,球员为标签 train_x = np.array(data_train[['pts','reb','ast','time']]).tolist() train_y = np.array(data_train[['player']]).tolist() test_x = np.array(data_test[['pts','reb','ast','time']]).tolist() test_y = np.array(data_test[['player']]).tolist() #训练模型 neigh = KNN(n_neighbors=10) neigh.fit(train_x, train_y) #使用模型预测,最后与实际结果对计算准确率 m = 0.0 n = 0.0 for x,y in zip(test_x,test_y): if neigh.predict([x])[0] == y[0]: n = n+1 m = m+1 print '预测准确率为:%.2f%%' % (n/m*100) 预测准确率为:49.143% 最后准确率50%不到,马马虎虎~

优秀的个人博客,低调大师

理解Python中的类对象、实例对象、属性、方法

class Animal(object): # 类对象 age = 0 # 公有类属性 __like = None # 私有类属性 def __init__(self): # 魔法方法 self.name = 'haha' # 公有实例属性 self.__sex = 'man' # 私有实例属性 def smile(self): # 公有方法 self指向实例对象 pass def __jump(self): # 私有方法 pass @classmethod def run(cls): # 类方法 cls 指向类对象 pass @staticmethod def msg(): # 静态方法,可以没有参数 pass ''' # 类对象: 将具有相似属性和方法的对象总结抽象为类对象,可以定义相似的一些属性和方法,不同的实例对象去引用类对象的属性和方法,能减少代码的重复率。 # 类属性: 类对象所有的属性,类对象和实例对象均可以访问,被它们共同拥有; # 公有类属性: 可以在类外修改类属性,需要通过类对象引用直接修改; 类内可以通过类方法修改类属性。 如果通过实例对象来引用类属性,相当于实例对象在实例方法中创建了一个和类属性相同的名字,等同于局部变量实例属性,和类属性无关; # 私有类属性: 类外通过类对象引用不能直接更改,只能通过实例方法调用类对象更改。 # 类方法: 需要修饰器@classmethod,标示其为类方法,类方法的第一个参数必须为类对象,一般用cls表示,通过cls引用的必须是类属性和类方法。 # 静态方法: 需要修饰器@staticmethod,标示其为静态方法。需要做一些功能,和类相关,但不需要类和对象参与,此时可以使用静态方法,静态方法可以不需要参数。 # 实例对象: 通过类对象创建的实例对象 # 实例属性: 通过方法定义的属性 # 私有实例属性: __开头定义的变量名;只能通过方法调用来更改 公有实例属性: 可以通过实例对象重新定义 # 实例方法: 第一个参数公认为self,可以调用类对象和实例对象。 # 私有方法: 只能在类内调用,如果类外调用,则需要类内的公有方法调用类内的私有方法,在类外调用这个公有方法,则间接调用了私有方法。 一个程序中最核心的内容,不能随意调用,可以设置为私有方法,通过公有方法的判断去调用私有方法! # 公有方法: 可以在类内类外随意调用。 # 魔法方法: 例如__init__方法,用两个__前后包裹的方法 ''' -------知识无价,汗水有情,如需搬运请注明出处,谢谢!

优秀的个人博客,低调大师

50 行 Python 代码构建一个区块链

尽管有人认为区块链 (blockchain) 是一个答案先于问题的技术,但毫无疑问, 这项新的技术已然是一个计算的奇迹。不过,到底区块链是什么呢 区块链 一个随时间增长,记录比特币或其他加密货币的交易的公开数字账本。 简单来说,区块链是一个公开的数据库,新的数据会被存储到一个叫做区块 (block) 的数据结构中,而区块会被添加到一个不可更改的链 (chain) 上 (也就是区块链),该链上存储着过去所添加的所有数据。在比特币和其他一些加密货币中,这些数据就是交易。不过,实际上,这些数据可以是任何类型。 区块链技术催生了像比特币,莱特币这样全新的完全数字资产,它们不由任何一个中心权威机构发行或管理。这给那些不信任现有银行系统的个人带来了新的选项。区块链也重新定义了分布式计算,出现了像以太坊这样的技术,它引入了像智能合约这样新的概念。 在本文

优秀的个人博客,低调大师

Jupyter(Python)模糊查询Analytic DB数据的正确方法

在Jupyter中,通过 pandas 模块中 read_sql_query 方法(sql)获取Analytic DB数据时,模糊查询需要添加几个百分号(转移符)。 形如(获取正确结果): select cols_name from table_name where x_col_name like '%%%%%s%%%%' 单个百分号执行报错: unsupported format character ''' (0x27) at index 349 2 个百分号, 返回能耐返回的最大数据量(个人测试,5000条);

优秀的个人博客,低调大师

python函数式编程之yield表达式形式

先来看一个例子 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) 在上面的例子里,因为foo函数中有yield关键字,所以foo()函数的执行结果g是一个生成器,此时可以使用next(g)或者g.__next__()方法触发生成器的执行 程序的执行结果为 starting... 使用next(g)触发生成器的执行时,程序会按照正常的顺序从上向下执行,遇到yield,程序就会暂停 并把yield后面所接的值返回 打印next(g)的执行结果 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() print(next(g)) 程序执行结果 starting... None 在上面的例子里,执行一次next(g)方法,程序暂停在yield那一行,此时再次调用next(g),程序会从yield语句那一行继续向下运行 修改上面的代码,多调用几次next方法,并打印next方法的返回结果 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() print(next(g)) print("*"*20) print(next(g)) 上面这段代码的执行结果为 starting... None ******************** res: None None 可以看到,程序确实按猜想的步骤运行,但是上面的程序也有一个很明显的缺点:那就是上面的代码没有任何的实际意义:res的值永远为None 在实际的开发中,使用yield表达式形式的目的是yield可以得到一个值,然后yield把这个值赋值给某个变量,这样才有实际意义 那应该怎么操作才能为res变量赋一个值呢??那就是调用生成器自身的send方法 send方法可以触发一次生成器执行,同时还可以把send方法的参数传递给yield 修改上面的代码 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) print(g.send(5)) 程序的执行结果为: starting... res: 5 None 来分析一下上面的代码的执行过程 : 1.程序开始执行以后,因为foo函数中有yield关键字,所以foo函数并不会真的执行,而是先得到一个生成器g. 2.直到调用next方法,foo函数正式开始执行,先执行foo函数中的print方法,然后进入while循环 3.程序遇到yield关键字,程序暂停,此时next(g)语句执行完成 4.程序执行g.send(5),程序会从yield关键字那一行继续向下运行,send会把5这个值传递给yield 5.yield接收到send方法传递过来的值,然后由yield赋值给res变量 6.由于send方法中包含next()方法,所以程序会继续向下运行执行print方法,然后再次进入while循环 7.程序执行再次遇到yield关键字,yield会返回后面的值,由于yield后面没有接任何参数,所以yield会返回None,程序再次暂停,直到再次调用next方法或send方法 修改代码,多次调用send方法 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) print(g.send(5)) print("*"*20) print(g.send(10)) print("#"*20) print(g.send(15)) 执行程序,得到如下结果 starting... res: 5 None ******************** res: 10 None #################### res: 15 None 可以看到,上面代码的执行过程如同上面的分析的执行过程一样运行 在上面的例子里,如果调用send方法时,传递的参数为None,得到的结果会是怎么样的呢?? 从上面的分析中,可以知道: 如果`g.send()`方法发送给yield关键字的参数为None,则yield关键字传递给res变量的值就为None 由于yield后面本来没有接任何值,所以yield返回的值默认也为None,所以程序执行结果会得到两个None 修改代码,验证上面的猜想 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) print("#"*20) print(g.send(None)) 查看程序的执行结果 starting... #################### res: None None 从程序的执行结果可以看出,如果调用生成器的send方法时,传递的参数为None,则程序执行的结果将会是两个None 使用yield表达式形式实现linux系统中的"grep -rl root /etc"命令 代码如下: import os def init(func): def wrapper(*args, **kwargs): g = func(*args, **kwargs) next(g) return g return wrapper @init def get_file_path(target): """ get file abspath # 阶段一:递归找文件的绝对路径,把文件的完事路径发送给阶段二 :param target: :return: """ while True: start_path = yield g = os.walk(start_path) for parent_dir, _, files in g: for file in files: file_path = r"%s\%s" % (parent_dir, file) target.send(file_path) @init def opener(target): """ get file obj # 阶段二:收到文件的完整路径,打开文件获取文件对象,把文件对象发送给阶段三 :param target: :return: """ while True: file_path = yield with open(file_path, encoding='utf-8') as f: target.send((file_path, f)) @init def cat_file(target): """ read file content # 阶段三:收到文件对象,for循环读取文件的每一行内容,把每一行内容发给阶段四 :param target: :return: """ while True: file_path, f = yield for line in f: file_content = target.send((file_path, line)) if file_content: break @init def grep(target, pattern): """ grep function # 阶段四:收到文件的一行内容,判断要查找的内容是否在这一行中,如果在,则把文件名发送给阶段五 :param target: :param pattern: :return: """ tag = False while True: file_path, line = yield tag tag = False if pattern in line: target.send(file_path) tag = True @init def printer(): """ print file name # 阶段五:收到文件名,打印结果 :return: """ while True: filename = yield print(filename) path1 = "/root" # 定义要搜索的路径 path2 = "/etc" # 定义要搜索的路径 g = get_file_path(opener(cat_file(grep(printer(), "root")))) print(g) g.send(path1) g.send(path2)

优秀的个人博客,低调大师

其实它是个Python库

今天,谷歌联合Columbia University、Adobe(就是你们知道的那个Adobe)提出深度概率编程语言Edward,我就其发布Edward的专业论文,给大家介绍一下,这个秒天秒地秒空气的牛逼哄哄的新语言(框架)。 为什么开发Edward? 因为现在的概率编程语言啊, Too Young!Too Simple! 原文是这样的: Rather, most existing probabilistic programming languages treat the inference engine as a black box,abstracted away from the model. These cannot capture the recent advances in probabilistic inference that

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册