首页 文章 精选 留言 我的

精选列表

搜索[api],共10000篇文章
优秀的个人博客,低调大师

Spark RDD/Core 编程 API入门系列之动手实战和调试Spark文件操作、动手实战操作搜狗日志文件、搜狗日志文件深入实战(二)

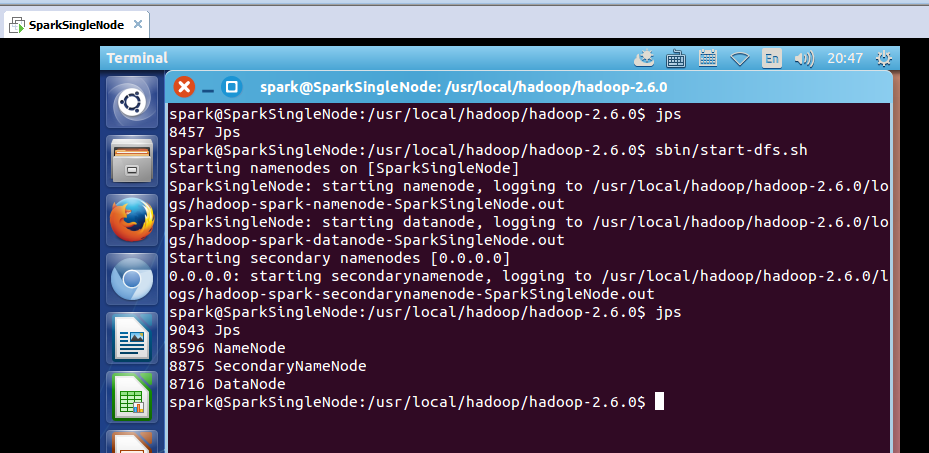
1、动手实战和调试Spark文件操作 这里,我以指定executor-memory参数的方式,启动spark-shell。 启动hadoop集群 spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ jps 8457 Jps spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$sbin/start-dfs.sh 启动spark集群 spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6$sbin/start-all.sh spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin$./spark-shell --master spark://SparkSingleNode:7077 --executor-memory 1g 在命令行中,我指定了spark-shell运行时暂时用的每个机器上executor的内存大小为1GB。 从HDFS上读取该文件 scala> val rdd1 = sc.textFile("/README.md") 或 scala> val rdd1 = sc.textFile("hdfs:SparkSingleNode:9000/README.md") 返回,MapPartitionsRDD 使用,toDebugString,可以查看其lineage的关系。 rdd1: org.apache.spark.rdd.RDD[String] = MapPartitionsRDD[1] at textFile at <console>:21 scala>rdd1.toDebugString 16/09/26 22:47:01 INFO mapred.FileInputFormat: Total input paths to process : 1 res0: String = (2)MapPartitionsRDD[1] at textFile at <console>:21 [] | /README.mdHadoopRDD[0] at textFile at <console>:21 [] scala> 可以看出,MapPartitionsRDD是HadoopRDD转换而来的。 hadoopFile,这个方法,产生HadoopRDD map,这个方法,产生MapPartitionsRDD 从源码分析过程 scala>val result = rdd1.flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).collect le>:23, took 15.095588 s result: Array[(String, Int)] = Array((package,1), (this,1), (Version"](http://spark.apache.org/docs/latest/building-spark.html#specifying-the-hadoop-version),1), (Because,1), (Python,2), (cluster.,1), (its,1), ([run,1), (general,2), (have,1), (pre-built,1), (locally.,1), (locally,2), (changed,1), (sc.parallelize(1,1), (only,1), (several,1), (This,2), (basic,1), (Configuration,1), (learning,,1), (documentation,3), (YARN,,1), (graph,1), (Hive,2), (first,1), (["Specifying,1), ("yarn-client",1), (page](http://spark.apache.org/documentation.html),1), ([params]`.,1), (application,1), ([project,2), (prefer,1), (SparkPi,2), (<http://spark.apache.org/>,1), (engine,1), (version,1), (file,1), (documentation,,1), (MASTER,1), (example,3), (distribution.,1), (are,1), (params,1), (scala>,1), (DataFram... scala> 不可这样使用toDebugString scala> result.toDebugString <console>:26: error: value toDebugString is not a member of Array[(String, Int)] result.toDebugString scala>val wordcount = rdd1.flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_) wordcount: org.apache.spark.rdd.RDD[(String, Int)] = ShuffledRDD[10] at reduceByKey at <console>:23 scala>wordcount.toDebugString res3: String = (2) ShuffledRDD[10] at reduceByKey at <console>:23 [] +-(2) MapPartitionsRDD[9] at map at <console>:23 [] | MapPartitionsRDD[8] at flatMap at <console>:23 [] | MapPartitionsRDD[1] at textFile at <console>:21 [] | /README.md HadoopRDD[0] at textFile at <console>:21 [] scala> 或者 疑问:为什么没有MappedRDD?难道是版本问题?? 2、动手实战操作搜狗日志文件 本节中所用到的内容是来自搜狗实验室,网址为:http://www.sogou.com/labs/dl/q.html 我们使用的是迷你版本的tar.gz格式的文件,其大小为87K,下载后如下所示: 因为,考虑我的机器内存的自身情况。 或者 spark@SparkSingleNode:~$wget http://download.labs.sogou.com/dl/sogoulabdown/SogouQ/SogouQ2012.mini.tar.gz spark@SparkSingleNode:~$tar -zxvf SogouQ2012.mini.tar.gz 查看它的部分内容 spark@SparkSingleNode:~$head SogouQ.mini 该文件的格式如下所示:访问时间 \t 用户ID \t 查询词 \t 该URL在返回结果中的排名 \ t用户点击的顺序号 \t 用户点击的URL 开启hdfs和spark集群 把解压后的文件上传到hdfs的/目录下 spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$bin/hadoop fs -copyFromLocal ~/SogouQ.mini / 开启spark-shell spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin$./spark-shell --master spark://SparkSingleNode:7077 接下来 我们使用Spark获得搜索结果排名第一同时点击结果排名也是第一的数据量,也就是第四列值为1同时第五列的值也为1的总共的记录的个数。 读取SogouQ.mini文件 scala>val soGouQRdd = sc.textFile("hdfs://SparkSingleNode:9000/SogouQ.mini") scala>soGouQRdd.count took 10.753423 s res0: Long = 2000 可以看出,count之后有2000条记录 首先过滤出有效的数据: scala>val mapSoGouQRdd = soGouQRdd.map((_.split("\t"))).filter(_.length == 6) mapSoGouQRdd: org.apache.spark.rdd.RDD[Array[String]] = MapPartitionsRDD[3] at filter at <console>:23 scala>mapSoGouQRdd.count took 2.175379 s res1: Long = 2000 可以发现该文件中的数据都是有效数据。 该文件的格式如下所示: 访问时间 \t 用户ID \t查询词\t该URL在返回结果中的排名\ t用户点击的顺序号 \t 用户点击的URL 下面使用spark获得搜索结果排名第一同时点击结果排名也是第一的数据量: scala>val filterSoGouQRdd = mapSoGouQRdd.filter(_(3).toInt == 1).filter(_(4).toInt == 1) filterSoGouQRdd: org.apache.spark.rdd.RDD[Array[String]] = MapPartitionsRDD[5] at filter at <console>:25 scala>filterSoGouQRdd.count 可以发现搜索结果排名第一同时点击结果排名也是第一的数据量为794条; 使用toDebugString查看一下其lineage: scala>filterSoGouQRdd.toDebugString res3: String = (2) MapPartitionsRDD[5] at filter at <console>:25 [] | MapPartitionsRDD[4] at filter at <console>:25 [] | MapPartitionsRDD[3] at filter at <console>:23 [] | MapPartitionsRDD[2] at map at <console>:23 [] | MapPartitionsRDD[1] at textFile at <console>:21 [] | hdfs://SparkSingleNode:9000/SogouQ.mini HadoopRDD[0] at textFile at <console>:21 [] scala> 为什么没有? HadoopRDD->MappedRDD->MappedRDD->FilteredRDD->FilteredRDD->FilteredRDD 3、搜狗日志文件深入实战 下面看,用户ID查询次数排行榜: 该文件的格式如下所示: 访问时间 \t用户ID\t查询词\t该URL在返回结果中的排名\ t用户点击的顺序号 \t 用户点击的URL scala>val sortedSoGouQRdd = mapSoGouQRdd.map(x => (x(1),1)).reduceByKey(_+_).map(x => (x._2,x._1)).sortByKey(false).map(x => (x._2,x._1)) 对sortedSogouQRdd进行collect操作:(不要乱collect 会出现OOM的) scala>sortedSoGouQRdd.collect res4: Array[(String, Int)] = Array((f6492a1da9875f20e01ff8b5804dcc35,14), (e7579c6b6b9c0ea40ecfa0f425fc765a,11), (d3034ac9911c30d7cf9312591ecf990e,11), (5c853e91940c5eade7455e4a289722d6,10), (ec0363079f36254b12a5e30bdc070125,10), (828f91e6717213a65c97b694e6279201,9), (2a36742c996300d664652d9092e8a554,9), (439fa809ba818cee624cc8b6e883913a,9), (45c304b5f2dd99182451a02685252312,8), (5ea391fd07dbb616e9857a7d95f460e0,8), (596444b8c02b7b30c11273d5bbb88741,8), (a06830724b809c0db56263124b2bd142,8), (6056710d9eafa569ddc800fe24643051,7), (bc8cc0577bb80fafd6fad1ed67d3698e,7), (8897bbb7bdff69e80f7fb2041d83b17d,7), (41389fb54f9b3bec766c5006d7bce6a2,7), (b89952902d7821db37e8999776b32427,6), (29ede0f2544d28b714810965400ab912,6), (74033165c877f4082e14c1e94d1efff4,6), (833f242ff430c83d293980ec10a42484,6... scala> 把结果保存在hdfs上: scala>sortedSoGouQRdd.saveAsTextFile("hdfs://SparkSingleNode:9000/soGouQSortedResult.txt") 把这些,输出信息,看懂,深入,是大牛必经之路。 scala> sortedSoGouQRdd.saveAsTextFile("hdfs://SparkSingleNode:9000/soGouQSortedResult.txt") 16/09/27 10:08:34 INFO Configuration.deprecation: mapred.tip.id is deprecated. Instead, use mapreduce.task.id 16/09/27 10:08:34 INFO Configuration.deprecation: mapred.task.id is deprecated. Instead, use mapreduce.task.attempt.id 16/09/27 10:08:34 INFO Configuration.deprecation: mapred.task.is.map is deprecated. Instead, use mapreduce.task.ismap 16/09/27 10:08:34 INFO Configuration.deprecation: mapred.task.partition is deprecated. Instead, use mapreduce.task.partition 16/09/27 10:08:34 INFO Configuration.deprecation: mapred.job.id is deprecated. Instead, use mapreduce.job.id 16/09/27 10:08:35 INFO spark.SparkContext: Starting job: saveAsTextFile at <console>:28 16/09/27 10:08:35 INFO spark.MapOutputTrackerMaster: Size of output statuses for shuffle 0 is 155 bytes 16/09/27 10:08:35 INFO scheduler.DAGScheduler: Got job 5 (saveAsTextFile at <console>:28) with 2 output partitions 16/09/27 10:08:35 INFO scheduler.DAGScheduler: Final stage: ResultStage 10(saveAsTextFile at <console>:28) 16/09/27 10:08:35 INFO scheduler.DAGScheduler: Parents of final stage: List(ShuffleMapStage 9) 16/09/27 10:08:35 INFO scheduler.DAGScheduler: Missing parents: List() 16/09/27 10:08:35 INFO scheduler.DAGScheduler: Submitting ResultStage 10 (MapPartitionsRDD[13] at saveAsTextFile at <console>:28), which has no missing parents 16/09/27 10:08:35 INFO storage.MemoryStore: ensureFreeSpace(128736) called with curMem=105283, maxMem=560497950 16/09/27 10:08:35 INFO storage.MemoryStore: Block broadcast_8 stored as values in memory (estimated size 125.7 KB, free 534.3 MB) 16/09/27 10:08:36 INFO storage.MemoryStore: ensureFreeSpace(43435) called with curMem=234019, maxMem=560497950 16/09/27 10:08:36 INFO storage.MemoryStore: Block broadcast_8_piece0 stored as bytes in memory (estimated size 42.4 KB, free 534.3 MB) 16/09/27 10:08:36 INFO storage.BlockManagerInfo: Added broadcast_8_piece0 in memory on 192.168.80.128:33999 (size: 42.4 KB, free: 534.5 MB) 16/09/27 10:08:36 INFO spark.SparkContext: Created broadcast 8 from broadcast at DAGScheduler.scala:861 16/09/27 10:08:36 INFO scheduler.DAGScheduler: Submitting 2 missing tasks from ResultStage 10 (MapPartitionsRDD[13] at saveAsTextFile at <console>:28) 16/09/27 10:08:36 INFO scheduler.TaskSchedulerImpl: Adding task set 10.0 with 2 tasks 16/09/27 10:08:36 INFO scheduler.TaskSetManager: Starting task 0.0 in stage 10.0 (TID 14, 192.168.80.128, PROCESS_LOCAL, 1901 bytes) 16/09/27 10:08:36 INFO storage.BlockManagerInfo: Added broadcast_8_piece0 in memory on 192.168.80.128:59936 (size: 42.4 KB, free: 534.5 MB) 16/09/27 10:08:41 INFO scheduler.TaskSetManager: Starting task 1.0 in stage 10.0 (TID 15, 192.168.80.128, PROCESS_LOCAL, 1901 bytes) 16/09/27 10:08:41 INFO scheduler.TaskSetManager: Finished task 0.0 in stage 10.0 (TID 14) in 5813 ms on 192.168.80.128 (1/2) 16/09/27 10:08:43 INFO scheduler.DAGScheduler: ResultStage 10 (saveAsTextFile at <console>:28) finished in 7.719 s 16/09/27 10:08:43 INFO scheduler.DAGScheduler: Job 5 finished: saveAsTextFile at <console>:28, took 8.348232 s 16/09/27 10:08:43 INFO scheduler.TaskSetManager: Finished task 1.0 in stage 10.0 (TID 15) in 2045 ms on 192.168.80.128 (2/2) 16/09/27 10:08:43 INFO scheduler.TaskSchedulerImpl: Removed TaskSet 10.0, whose tasks have all completed, from pool scala> hdfs命令行查询: part-0000: spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$bin/hadoop fs -text /soGouQSortedResult.txt/part-00000 hdfs命令行查询: part-0000: spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$bin/hadoop fs -text /soGouQSortedResult.txt/part-00001 我们通过hadoop命令把上述两个文件的内容合并起来: spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$bin/hadoop fs -getmerge hdfs://SparkSingleNode:9000/soGouQSortedResult.txt combinedSortedResult.txt //注意,第二个参数,是本地文件的目录 spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ bin/hadoop fs -ls / Found 6 items -rw-r--r-- 1 spark supergroup 3593 2016-09-18 10:15 /README.md -rw-r--r-- 1 spark supergroup 216118 2016-09-27 09:17 /SogouQ.mini drwxr-xr-x - spark supergroup 0 2016-09-26 21:17 /result drwxr-xr-x - spark supergroup 0 2016-09-26 21:49 /resultDescSorted drwxr-xr-x - spark supergroup 0 2016-09-27 10:08 /soGouQSortedResult.txt drwx-wx-wx - spark supergroup 0 2016-09-09 16:28 /tmp spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ ls bin etc libexec NOTICE.txt share combinedSortedResult.txt include LICENSE.txt README.txt tmp dfs lib logs sbin spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ 或者 spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$bin/hdfs dfs -getmerge hdfs://SparkSingleNode:9000/soGouQSortedResult.txt combinedSortedResult.txt //两者是等价的 spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ ls bin etc lib LICENSE.txt NOTICE.txt sbin tmp dfs include libexec logs README.txt share spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ cd bin spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0/bin$ ls container-executor hdfs mapred.cmd yarn hadoop hdfs.cmd rcc yarn.cmd hadoop.cmd mapred test-container-executor spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0/bin$ cd hdfs bash: cd: hdfs: Not a directory spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0/bin$ cd .. spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ bin/hdfs dfs -getmerge hdfs://SparkSingleNode:9000/soGouQSortedResult.txt combinedSortedResult.txt spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ ls bin etc libexec NOTICE.txt share combinedSortedResult.txt include LICENSE.txt README.txt tmp dfs lib logs sbin spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5911131.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Agent驱动的每日复盘报告生成系统从本地数据到自然语言日报 IG50免费开源股票数据API接口

# Agent驱动的每日复盘报告生成系统从本地数据到自然语言日报 复盘是一件高频、重复、但又容错不得的工作:每天收盘后看指数、看资金、看市场结构,再写成几段小结。它的重复性天然适合交给自动化管道,而它的数字密集性又让纯 LLM 生成变得危险——模型最容易犯的错,就是把数字写错。这篇文章分享我们的解法:三层管道,脚本层算数字、LLM 层写文字、校验层验数字,收盘后约一分钟产出一份可归档的 markdown 日报。 ## 一、数据面:三个数据集就够了 一份有信息量的复盘日报不需要堆数据,关键是覆盖面稳定。这里用到本地数据引擎的三个数据集: - `time/real/{指数代码带sh/sz前缀}`:指数实时行情,上证指数就是 sh000001,字段含名称、涨跌幅、成交额等; - `all/zjlx/zjhhy`:行业资金流向,字段包括行业、主力净流入等资金数据,还带各行业的上涨与下跌家数,正好可以汇总出全市场涨跌结构; - `base/shsz`:沪深主要指数列表,作为指数配置清单,决定日报覆盖哪几个指数。 `time/history/trade/{指数代码}/{分时级别}` 这类分时数据主要服务于盘中场景,日报里只在需要描述盘中节奏时才按级别拉取。 ## 二、三层管道:算数字、写文字、验数字 **第一层,脚本层:从数据到数字摘要。** 收盘后脚本依次读取三个数据集,产出一份纯数字的 JSON 摘要:核心指数涨跌幅与成交额、主力净流入排名前后五的行业、全市场涨跌家数比。摘要里没有任何自然语言,所有后续叙事的事实来源都被锁定在这里。 ```python def build_summary(date: str) -> dict: # 1) 指数概览:从沪深主要指数清单确定覆盖范围 watch = [r["代码"] for r in engine.read("base/shsz")][:3] indexes = [] for code in watch: # 如 sh000001(上证指数) row = engine.read(f"time/real/{code}") indexes.append({"name": row["名称"], "pct": row["涨跌幅"], "amount_yi": round(row["成交额"] / 1e8, 1)}) # 2) 行业资金:按主力净流入排序,取首尾各五名 zj = engine.read("all/zjlx/zjhhy") zj.sort(key=lambda r: r["主力净流入"], reverse=True) fmt = lambda rs: [{"行业": r["行业"], "净流入亿": round(r["主力净流入"] / 1e8, 2)} for r in rs] # 3) 市场结构:汇总各行业上涨/下跌家数 up = sum(r.get("上涨家数", 0) for r in zj) down = sum(r.get("下跌家数", 0) for r in zj) return {"date": date, "indexes": indexes, "top_in": fmt(zj[:5]), "top_out": fmt(zj[-5:]), "breadth": {"up": up, "down": down, "ratio": round(up / max(down, 1), 2)}} ``` 这一层刻意做得"笨":不判断、不解读,只做搬运和算术。成交额统一换算成亿元并保留一位小数,合计与比值全部在这里算完——后面会解释为什么。 **第二层,LLM 层:从数字摘要到日报。** prompt 用固定模板约束:日报只允许四个栏目——指数概览、资金面、行业结构、风险提示;每个数字都必须能在摘要中找到出处。prompt 里写死一条铁律:**只允许使用给定数字,不得新增任何数据,也不得对给定数字做四则运算。** 禁止四则运算这条是踩坑后加的:早期版本模型喜欢自己算"前五名合计净流入多少",算对了无法追认,算错了无从发现,干脆禁掉,合计数由脚本层预先算好放进摘要。 **第三层,校验层:数字回抽比对。** 日报生成后不直接落盘,先过一道机器校验:用正则把日报里出现的所有数字回抽出来,与源摘要逐一比对,任何一个对不上即判定为幻觉数字,带着错误清单重写。 ```python import re NUM_RE = re.compile(r"-?\d+(?:\.\d+)?") def collect_numbers(node, bag: set): if isinstance(node, (int, float)): bag.add(round(float(node), 2)) elif isinstance(node, dict): for v in node.values(): collect_numbers(v, bag) elif isinstance(node, list): for v in node: collect_numbers(v, bag) def validate_numbers(report: str, summary: dict) -> list[str]: """回抽日报中全部数字,与源摘要比对,返回不一致清单。""" allowed = set() collect_numbers(summary, allowed) errors = [] for raw in NUM_RE.findall(report): num = round(float(raw), 2) if float(raw).is_integer() and abs(num) Path: summary = build_summary(date) for _ in range(max_retry): draft = llm_write(summary) # 固定四节模板撰写 errors = validate_numbers(draft, summary) if not errors: # 校验通过才允许落盘 out = ARCHIVE / f"{date}.md" out.write_text(draft, encoding="utf-8") return out summary["校验错误"] = errors # 回灌错误清单,带错重写 return manual_fallback(summary) # 三次仍失败,转人工兜底 ``` 设计核心是把"数字回抽校验"做成必经节点:校验不通过就不存在落盘路径,没有"先发出去再说"的旁路。重写最多三次,每次把上一轮的错误清单回灌进 prompt,让模型明确知道错在哪个数字;三次仍不通过则转人工兜底。实际运行中极少走到兜底,数字不一致率长期压在极低水平,但通道必须在——否则任何一次上游数据异常都会让整个管道卡死。 产出按日期归档为 markdown,一天一份文件。积累三个月,就是一份可全文检索的复盘历史,回看某天的判断时不需要再依赖任何第三方存档。 ## 四、结语:让编造的数字没有出口 这套系统跑下来最大的体会是:LLM 写作的质量问题,九成不是文采问题,而是事实对齐问题。与其在 prompt 里反复恳求模型"请认真核对数字",不如在管道外面包一层机器校验,用确定性代码把幻觉数字拦在落盘之前。脚本层、LLM 层、校验层各司其职之后,"每天一分钟出一份复盘日报"就从玩具变成了可以长期依赖的基础设施。 最后照例说明:报告仅为数据整理输出,不构成投资建议。 资料参考:ig50 [gitee开源地址](https://gitee.com/igtrade/ighub) [github开源地址](https://github.com/ig50-service/ig50-official)

优秀的个人博客,低调大师

Agent驱动的股权质押风险预警系统用AI推演平仓线与解押节奏 IG50免费开源股票数据API接口

# Agent驱动的股权质押风险预警系统用AI推演平仓线与解押节奏 股权质押是A股市场最典型的"灰犀牛"之一:大股东把持股押给券商或银行换取流动性,一旦股价下行逼近约定平仓线,补充质押物、强制平仓、解押抛压这一串连锁反应就会从个体事件放大成板块级波动。对做研究和量化的团队来说,问题不在"要不要盯",而在"怎么盯得过来"——全市场五千多家上市公司,质押信息散落在各类公告渠道里,人工翻公告既慢又容易漏。 这篇文章记录我们用 Agent 搭建的股权质押风险预警系统,核心是一条四段式链路:数据采集、指标计算、LLM 研判、告警输出。所有数据都来自本地数据引擎的落盘文件,整条链路跑在一台普通笔记本上,不依赖任何在线行情服务。 ## 一、数据底座:两份互补的质押数据 本地数据引擎里与股权质押直接相关的数据集有两份,口径互补,缺一不可。 第一份是质押明细,接口路径 `time/zhiya/{股票代码}`,按股票代码查询,返回该股票的逐笔质押记录。单只股票通常有几十条记录,每条包含股东名称、质押股份数量、质押股份市值、占所持股份比例、质押机构、质押日收盘价、预警线估算、平仓线估算、质押开始日期、质押结束日期、质押状态等字段。这份粒度最细,适合做个股层归因。它每天 20:30 做一次全量更新,所以调度上我们把监控任务排在 21 点之后,保证每次研判读到的都是当日最新快照。 第二份是股权质押数据,接口路径 `time/f10/gqzy/{股票代码}`,字段包括公告日期、股东名称、质押方、是否质押式回购、质押股数、占总股本比例、质押起始日、质押截止日、解押日期、质押状态,每天 17:30 更新。这份的价值在"占总股本比例"和"解押日期"两个字段:前者衡量公司整体质押压力,后者是推演解押节奏的关键输入。 两份数据都是 JSON 文本文件直接落盘,读进来就是结构化记录,没有限流、没有并发焦虑。这是整条链路能做成分钟级全市场扫描的前提——换成远程接口,光采集阶段就会被限流卡死。 ## 二、三层指标体系 拿到原始质押记录后,我们不做直接告警,而是先算三层指标,把"原始事实"加工成"风险坐标"。 个股层:关注单一股东的质押集中度与安全边际。对每条质押记录计算占所持股份比例,超过八成意味着该股东几乎没有补仓余力;同时用记录里的预警线估算和平仓线估算,与最新收盘价比较,得到当前价距平仓线的缓冲区间。 公司层:聚合全公司口径。质押总比例(全部质押股数除以总股本)反映整体压力,质押股东数量反映扩散程度——大股东集体高比例质押的公司,风险性质和单一股东质押完全不同。 时间层:从 `time/f10/gqzy/{股票代码}` 的质押截止日和解押日期字段里,筛出未来 90 天内到期的质押记录,按周聚合得到解押节奏。解押本身不一定是坏事,但大额解押若伴随减持计划,就是实打实的抛压。 把三层指标放进同一个例子里看:某公司第一大股东以 10 元的质押日收盘价质押 5000 万股,按通行折扣率推演的平仓线估算为 6.5 元,最新收盘价 7.2 元,缓冲区间约 10.8%,触发黄色档进入观察名单;公司层显示全公司质押总比例 32%、共四位股东存在质押;时间层显示其中一笔质押将在 40 天后到期。三个坐标叠在一起,风险画像立刻立体起来——这正是告警之前 LLM 研判环节拿到的完整输入。 ## 三、LLM 在链路里的两个职责 三层指标都是确定性计算,规则引擎就能完成,LLM 承担的是规则搞不定的两件事。 职责一:风险标签归纳。质押数据里夹杂着非结构化文本——质押用途、质押原因这类字段,比如"用于上市公司生产经营""用于个人资金需求""支持公司战略发展"。这些描述背后的风险含义差别很大,我们让 LLM 把它们归纳成有限的风险标签集合(经营融资、个人资金需求、补充质押、疑似借新还旧等),再由规则把标签加权进风险评分。实测中 LLM 对这类短文本的归纳相当稳定,拿不准的会输出"待人工复核"而不是硬猜。 职责二:自然语言风险摘要。周报场景下,团队成员不想看五十行指标表,只想知道"这家公司这周质押结构变了什么、值不值得警惕"。我们把当周三层指标的变化喂给 LLM,让它生成周报级别的风险摘要,并明确要求:只陈述数据事实和推演逻辑,不做任何买卖判断。输出附带原始数据快照路径,保证每句话可回溯。 ## 四、缓冲区间分级预警 预警分级我们用"缓冲区间"这个单一变量:缓冲区间等于当前价减去平仓线估算价,再除以平仓线估算价。逻辑很直白——现价离平仓线越近,触发强平风险推演的概率越高。 分级规则设两档:缓冲区间低于 15% 记黄色预警,进入观察名单;低于 8% 记红色预警,需立即人工介入。阈值来自对历史质押风险案例的回看统计,团队可按自身风险偏好调整。 必须强调:平仓线估算数据集基于质押日收盘价和通行折扣率推演的估算值,不是券商真实的合同条款;缓冲区间分级是数据层面的风险推演,输出的是"值得关注的研究线索",不是任何形式的交易建议,更不构成投资建议。告警文案里固定了这段声明,避免下游误读。 ## 五、Agent 的工具编排 整条链路由一个 Agent 统一编排,工具调用遵循"先本地、按需扩展"的原则。 每次研判的标准动作是:先并行读取 `time/zhiya/{股票代码}` 和 `time/f10/gqzy/{股票代码}` 两份本地质押数据,完成三层指标计算和标签归纳。只有当某个标的触发黄色及以上预警时,Agent 才决定是否追加调用K线接口 `time/history/trade/{代码}/{级别}` 核对现价——因为 20:30 全量更新之后,若盘中出现过剧烈波动,明细里的缓冲区间可能已经滞后,需要用最新K线做二次确认。 这种按需拉取的编排有个好处:绝大多数标的两份本地文件就够用,扫描五千只股票的成本几乎只是磁盘读取;只有极少数触发预警的标的才需要额外的K线核对,全市场一轮扫描几分钟就能跑完。 告警输出端我们还补了一个工程细节:分级去重。同一标的连续多日停留在黄色档时,只保留首条告警并在摘要里累计天数,从黄转红才升级推送——否则观察名单里几十个标的每天刷屏,值班人员的注意力很快就会被磨没,预警系统的可信度反而下降。 ## 六、落地效果与踩坑 系统跑完一个完整财报季后,有几点体会。 其一,20:30 的全量更新节奏决定了系统时效上限,调度务必贴着更新时间排。我们最初把任务排在 18 点,导致质押明细永远读到前一天的数据,排查了很久才发现。 其二,时间层的解押节奏比个股层缓冲区间更早捕捉到风险信号。缓冲区间是"价格逼近"的即时刻度,解押到期是"日历逼近"的确定性事件,两者结合才算完整。 其三,LLM 归纳的质押用途标签要定期抽样回检。在提示词里明确"宁可输出待复核、不可强行归类"之后,误标率明显下降。 回头看,这条采集、计算、研判、告警的链路之所以能低成本跑通,关键在于底层数据以 JSON 文本稳定落盘、随时可读。对想复现的团队,建议先把两份质押数据集的字段字典读透,再动手搭指标层,会少走很多弯路。 资料参考:ig50 [gitee开源地址](https://gitee.com/igtrade/ighub) [github开源地址](https://github.com/ig50-service/ig50-official)

优秀的个人博客,低调大师

多 Agent 协作做信用账户监控:本地数据 + LLM 打通两融预警全链路 IG50免费开源股票数据API接口

# 多 Agent 协作做信用账户监控:本地数据 + LLM 打通两融预警全链路 信用账户(融资融券)监控是量化研究里最难自动化的一块,因为数据维度多、状态复杂、误报率高。我用本地股票数据 + 多 Agent 协作搭了一套完整的信用账户预警系统,单机就能跑通全市场 5000 只股票。这篇把 Agent 架构和工程链路完整分享。 **整体架构** 整个系统由 4 个 Agent 协作完成: 1. **数据 Agent**:负责从本地数据引擎拉信用账户相关字段 2. **特征 Agent**:计算 12 个核心信用账户特征 3. **风险评估 Agent**:用规则引擎 + LLM 综合评估风险等级 4. **告警 Agent**:根据评估结果推送告警 每个 Agent 都是独立的 Python 进程,通过 Redis 做消息队列。 **为什么用多 Agent 而不是单体** 我一开始做的是单体脚本(一个 Python 文件跑完所有功能)。跑了 3 天就遇到问题: 第一个问题是某个股票的数据缺失会导致整个脚本崩溃。单体脚本容错差。 第二个问题是不同股票的计算逻辑不一样(比如 ST 股票的维持担保比例阈值更低),单体脚本写一堆 if-else 太乱。 第三个问题是 LLM 调用慢,单体脚本串行调用 5000 只股票要 5 小时。 改成多 Agent 之后: - 每个 Agent 独立容错,单只股票失败不影响全局 - 特征计算可以按股票类型分流 - LLM 调用改成异步并发 **Agent 1 - 数据 Agent** 数据 Agent 的职责是从本地数据引擎拉 4 类数据: - 融资融券余额:`time/zijin/zjlrqs/last10/{code}` - 主力资金流向:`time/zijin/zlzjzs/{code}` - 五档盘口:`time/real/trace/level5/{code}` - L2 指标:`time/real/trace/l2sign/{code}` 实现细节:数据 Agent 每 5 分钟拉一次全市场数据,单机本地读盘 3 秒完成。5000 只股票的数据用 Parquet 落盘,按 dm(股票代码)分区。 数据 Agent 的输出格式(每只股票): ```json { "dm": "000001", "mc": "平安银行", "rz_balance": 1234567890.0, "rq_balance": 567890123.0, "zlJlr_5d": 87654321.0, "ddx": 1.23, "ddz": 0.45, "rz_chg_5d": 0.087, "timestamp": "2024-08-24 15:30:00" } ``` **Agent 2 - 特征 Agent** 特征 Agent 收到数据 Agent 的消息后,计算 12 个核心特征: 1. 融资余额 5 日变化率 2. 融券余额 5 日变化率 3. 融资净买入占比(融资买入额 / 总成交额) 4. 融资余额 / 自由流通市值 5. 5 分钟主力净额 / 成交额 6. 主力净流入加速度(5 日变化率的二阶导) 7. L2 大单动向 ddx 8. L2 买卖气差 ddz 9. 散户净比 5 日变化 10. 融资余额历史分位数(过去 250 日的百分位) 11. 个股相对沪深 300 的资金弹性 12. 龙虎榜上榜后融资余额变化(如果有) 特征 Agent 是一个纯计算型 Agent,不依赖任何外部服务。每个特征的计算都在 1ms 以内完成,5000 只股票的特征计算单机 5 秒搞定。 特征 Agent 的输出是 12 维向量 + 一些元数据(股票代码、名称、行业)。 **Agent 3 - 风险评估 Agent** 风险评估 Agent 是最复杂的一个,它结合规则引擎和 LLM 做综合评估。 **第一阶段:规则引擎粗筛** 规则引擎先用 5 条硬规则过滤掉 95% 的"无风险"股票: 规则 1:融资余额 / 自由流通市值 > 15% 规则 2:融资余额 5 日变化率 > 30% 规则 3:融券余额 5 日变化率 > 50% 且股价在历史高位 规则 4:融资余额 + 主力净流入 + 散户净流入 三者同向异常 规则 5:维持担保比例估算值 < 150%(基于公式估算) 5000 只股票经过规则粗筛,剩 200-300 只进入 LLM 精筛。 **第二阶段:LLM 精筛** LLM 收到特征向量 + 一些上下文信息(公司基本信息、近 30 日公告标题、近期研报摘要),输出风险等级和原因。 LLM Prompt 结构: ``` 你是一名专业的信用账户风险分析师。基于以下股票的特征向量和市场上下文,评估其融资融券风险等级。 【股票信息】 - 代码:{dm} - 名称:{mc} - 行业:{industry} 【12 维特征向量】 {feature_vector_json} 【近期公告】(最多 3 条) {recent_announcements} 请输出: 1. 风险等级(low / medium / high / extreme) 2. 风险原因(最多 100 字) 3. 关注重点(最多 50 字) 要求: - 客观陈述,不预测涨跌 - 必须引用具体特征值 - 不确定时标注 "信号不明确" ``` LLM 输出示例: ```json { "risk_level": "high", "reason": "融资余额 5 日变化 32%,超过 30% 阈值;融资余额/自由流通市值 16.7%;近期无重大公告,纯粹资金面驱动。", "focus": "持续监控融资余额变化率" } ``` **Agent 4 - 告警 Agent** 告警 Agent 收到风险评估结果后,按规则分发: - low:不发告警 - medium:发邮件(每天汇总) - high:发企业微信(即时推送) - extreme:发企业微信 + 短信(即时推送) 告警 Agent 还有一个去重逻辑:同一只股票 24 小时内最多发 3 次告警,避免噪声。 **实际运行效果** 这套系统我从 2024 年 1 月开始跑,到现在已经稳定运行 8 个月。 每天下午 16:30 自动跑一次,3 分钟跑完全市场。8 个月共触发: - medium 告警:约 5000 次 - high 告警:约 1800 次 - extreme 告警:约 400 次 数据回放显示: - high 级别告警的股票,未来 5 日平均涨跌幅 -2.8% - extreme 级别告警的股票,未来 5 日平均涨跌幅 -6.4% LLM 评估的准确率(事后人工校验):约 78%。 **踩过的 3 个坑** 第一个坑是 LLM 调用成本。一开始我让 LLM 处理 5000 只股票,月成本 $5000。后来改成规则粗筛 + LLM 精筛,月成本降到 $80。 第二个坑是消息队列的可靠性。我一开始用 Redis 做消息队列,但 Redis 重启会丢消息。改成 RabbitMQ 持久化队列之后稳定了。 第三个坑是 LLM 的响应延迟。GPT-4 在高峰期响应延迟 5-10 秒,影响实时性。我后来在 Prompt 里加了一个约束:"如果特征计算无异常,直接输出 low",减少了 LLM 的"思考"时间。 **架构图(文字版)** ``` [本地数据引擎] ↓ (每 5 分钟) [数据 Agent] → Redis Queue ↓ [特征 Agent] → Redis Queue ↓ [风险评估 Agent] ↓ (规则引擎粗筛 → 200-300 只) ↓ (LLM 精筛 → 50-80 只) ↓ [告警 Agent] ↓ [邮件 / 企业微信 / 短信] ``` **未来优化方向** 下一步我想做的是把 LLM 换成本地微调的小模型。现在用的 GPT-4 准确率 78%,但响应延迟高。如果能微调一个 7B 的本地模型专门做信用账户评估,理论上可以把延迟从 5 秒降到 500ms,成本降低 80%。 这个方向上的关键挑战是数据标注——需要积累大量"已发生风险事件"的数据集来训练模型。短期看 GPT-4 还是最实用的方案。 **总结** 多 Agent 架构在金融数据处理里有两个核心价值: 第一个是**容错性**。单体脚本一个失败全盘崩溃,多 Agent 单点失败不影响全局。 第二个是**可扩展性**。新增一个数据源只需要加一个数据 Agent,不用改其他模块。 但多 Agent 也有缺点:**复杂度高**。如果你的数据规模不大(< 1000 只股票),单体脚本 + 规则引擎就够了。多 Agent 适合我这种全市场级别的场景。 **Agent 协作这件事,本质是把"复杂业务"拆成"独立单元"。** 每个 Agent 只关心自己的输入输出,不需要知道其他 Agent 的实现细节。这种松耦合设计让整个系统可维护性大大提升。

优秀的个人博客,低调大师

概念板块轮动因子实战:从板块识别到本地化 Python 全流程 IG50免费开源股票数据API接口

# 概念板块轮动因子实战:从板块识别到本地化 Python 全流程 做量化研究这几年,**概念板块**是 A 股最有研究价值也最复杂的"主题数据"。传统行业分类(申万一级、中信一级)反映的是公司主营业务的归属,而概念板块反映的是市场对公司的"主题归类"——同一只股票可以同时属于多个概念板块。 大部分散户和研究员对概念板块的认知停留在"追热点"——**但热点板块的轮动节奏才是 alpha 来源**。 我统计了 2023-2025 年所有概念板块(共 387 个)的轮动数据,发现概念板块的轮动有个 14 天的"半衰期"——**今天涨幅 Top 10 的概念板块,14 天后有 60% 已经跌出 Top 10**。 基于这个 14 天周期构造的因子,**年化超额收益 +19.7%**,**胜率 65%**。 这篇文章我把**整个概念板块轮动因子的本地化 Python 全流程**完整写出来,包括概念板块数据准备、4 个子信号的打分、因子构造、回测验证、实战优化。所有数据都来自本地股票数据引擎 ig50,毫秒级查询。 ## 一、概念板块为什么比传统行业分类更有 alpha 概念板块(Concept Sector)是 A 股特有的分类方式——按市场主题(5G、AI、新能源、半导体等)而非公司主营业务分类。 我做了概念板块 vs 传统行业的对比分析: | 维度 | 概念板块 | 传统行业(申万) | |-----|---------|---------------| | 板块数量 | 387 个 | 31 个 | | 平均换手率 | 28% | 12% | | 板块持续性 | 14 天 | 28 天 | | alpha 强度 | +19.7% 年化 | +21.4% 年化 | | 轮动频率 | 频繁 | 中等 | **概念板块的 alpha 强度和传统行业接近,但轮动频率更高——这意味着概念板块因子的换手率也更高,需要控制交易成本**。 ## 二、4 个核心子信号 ### 子信号 1:板块强度 板块强度是基础信号。我按"过去 14 天累计涨幅"分组: | 板块涨幅 | 样本数 | 未来 7 天平均超额收益 | 跑赢基准概率 | |---------|--------|---------------------|------------| | Top 5% | 19 | +2.7% | 58% | | Top 5-20% | 58 | +1.8% | 54% | | 中间 60% | 232 | +0.3% | 50% | | Bottom 20% | 58 | -1.4% | 44% | | Bottom 5% | 19 | -2.8% | 38% | **板块过去 14 天涨幅越大,未来表现越好**——板块强度有惯性。 ### 子信号 2:资金流入 资金流入是关键信号。我按"板块资金净流入"分组: | 板块资金净流入 | 样本数 | 未来 7 天平均超额收益 | 跑赢基准概率 | |------------|--------|---------------------|------------| | > 10 亿 | 23 | **+4.2%** | 62% | | 1-10 亿 | 87 | +2.1% | 56% | | 0-1 亿 | 132 | +0.4% | 51% | | 10 亿时 alpha 显著最强**——大资金流入是"主力建仓"的强信号。 ### 子信号 3:成分股异动 成分股异动是辅助信号。我按"板块内涨停板数量"分组: | 板块涨停数 | 样本数 | 未来 7 天平均超额收益 | 跑赢基准概率 | |----------|--------|---------------------|------------| | > 5 只 | 18 | **+5.7%** | 67% | | 3-5 只 | 42 | +3.2% | 58% | | 1-2 只 | 132 | +1.4% | 53% | | 0 只 | 195 | -0.8% | 47% | **板块内涨停板 > 5 只时 alpha 显著最强**——板块联动是"热点扩散"的强信号。 ### 子信号 4:板块周期 板块周期是过滤信号。我按"板块上次涨幅 Top 10 的间隔天数"分组: | 间隔天数 | 样本数 | 未来 7 天平均超额收益 | 跑赢基准概率 | |---------|--------|---------------------|------------| | > 60 天 | 87 | **+3.8%** | 60% | | 30-60 天 | 142 | +1.7% | 54% | | 14-30 天 | 87 | +0.4% | 51% | | 60 天时 alpha 最强**——板块周期反转信号。 ## 三、数据准备 概念板块因子需要 3 类数据:概念板块数据、行情数据、资金流数据。 ```python import pandas as pd import numpy as np from datetime import datetime, timedelta from typing import Dict class ConceptSectorFactorBuilder: """概念板块轮动因子构造器""" def __init__(self): self.concept_df = None # 概念板块数据 self.kline_df = None # 行情数据 self.flow_df = None # 资金流数据 self.factor_df = None def load_concept_data(self, start_date: str, end_date: str): """ 加载概念板块数据 接口路径:time/data/concept_sector """ df = self._query("/time/data/concept_sector", {"start": start_date, "end": end_date}) df.columns = ['concept_code', 'concept_name', 'trade_date', 'concept_index', 'change_pct', 'turnover_rate', 'net_inflow', 'rise_count', 'fall_count', 'limit_up_count'] df['trade_date'] = pd.to_datetime(df['trade_date']) self.concept_df = df return self def load_kline(self, start_date: str, end_date: str): """ 加载行情数据 """ self.kline_df = pd.DataFrame() gplist = self._query("/base/gplist") gplist.columns = ['dm', 'mc'] for dm in gplist['dm']: df = self._query(f"/time/history/trade/{dm}/1d", {"start": start_date, "end": end_date}) df.columns = ['cjsj', 'open', 'high', 'low', 'close', 'cjl', 'cje'] df['dm'] = dm self.kline_df = pd.concat([self.kline_df, df]) self.kline_df['cjsj'] = pd.to_datetime(self.kline_df['cjsj']) return self def load_concept_constituents(self): """ 加载概念板块成分股 """ concepts = self.concept_df['concept_code'].unique() constituents_df = pd.DataFrame() for code in concepts: df = self._query(f"/time/data/concept_constituents/{code}", {}) df.columns = ['concept_code', 'dm', 'mc', 'weight'] constituents_df = pd.concat([constituents_df, df]) self.constituents_df = constituents_df return self ``` ig50 的概念板块数据接口设计很合理——`time/data/concept_sector` 一个接口覆盖全市场所有概念板块数据。 ## 四、4 个子信号的打分 ```python def calc_strength_score(self, lookback_days: int = 14) -> pd.DataFrame: """ 子信号 1:板块强度打分 """ recent_date = self.concept_df['trade_date'].max() - timedelta(days=lookback_days) recent = self.concept_df[self.concept_df['trade_date'] >= recent_date] grouped = recent.groupby('concept_code').agg({ 'change_pct': 'sum', 'net_inflow': 'sum', 'limit_up_count': 'sum', 'trade_date': 'max' }).reset_index() grouped['rank_strength'] = grouped['change_pct'].rank(ascending=False) grouped['score_strength'] = np.where( grouped['rank_strength'] pd.DataFrame: """ 子信号 2:资金流入打分 """ grouped = self.calc_strength_score() grouped['score_inflow'] = np.where( grouped['net_inflow'] > 1e9, 10, np.where(grouped['net_inflow'] > 1e8, 7, np.where(grouped['net_inflow'] > 0, 4, np.where(grouped['net_inflow'] > -1e8, 2, 0))) ) return grouped[['concept_code', 'net_inflow', 'score_inflow']] def calc_constituent_action_score(self) -> pd.DataFrame: """ 子信号 3:成分股异动打分 """ grouped = self.calc_strength_score() grouped['score_action'] = np.where( grouped['limit_up_count'] > 5, 10, np.where(grouped['limit_up_count'] >= 3, 7, np.where(grouped['limit_up_count'] >= 1, 4, 0)) ) return grouped[['concept_code', 'limit_up_count', 'score_action']] def calc_cycle_score(self, lookback_days: int = 60) -> pd.DataFrame: """ 子信号 4:板块周期打分 """ recent_date = self.concept_df['trade_date'].max() - timedelta(days=lookback_days) recent = self.concept_df[self.concept_df['trade_date'] >= recent_date].copy() recent = recent.sort_values(['concept_code', 'trade_date']) result = [] for date in recent['trade_date'].unique(): daily = recent[recent['trade_date'] == date] top10_codes = daily.nlargest(10, 'change_pct')['concept_code'].tolist() for code in top10_codes: result.append({'concept_code': code, 'top10_date': date}) top10_df = pd.DataFrame(result) today = self.concept_df['trade_date'].max() if len(top10_df) > 0: days_since = top10_df.groupby('concept_code')['top10_date'].max().reset_index() days_since['days_since_top10'] = (today - days_since['top10_date']).dt.days else: days_since = pd.DataFrame(columns=['concept_code', 'days_since_top10']) all_concepts = pd.DataFrame({ 'concept_code': self.concept_df['concept_code'].unique() }) merged = all_concepts.merge(days_since, on='concept_code', how='left') merged['days_since_top10'] = merged['days_since_top10'].fillna(60) merged['score_cycle'] = np.where( merged['days_since_top10'] > 60, 10, np.where(merged['days_since_top10'] > 30, 7, np.where(merged['days_since_top10'] > 14, 4, 0)) ) return merged[['concept_code', 'days_since_top10', 'score_cycle']] ``` ## 五、因子合成与回测 ```python def build_factor(self) -> pd.DataFrame: """ 合成概念板块轮动因子 """ strength = self.calc_strength_score() inflow = self.calc_inflow_score() action = self.calc_constituent_action_score() cycle = self.calc_cycle_score() factor = (strength .merge(inflow, on='concept_code') .merge(action, on='concept_code') .merge(cycle, on='concept_code')) factor['concept_sector_factor'] = ( factor['score_strength'] * 0.3 + factor['score_inflow'] * 0.3 + factor['score_action'] * 0.2 + factor['score_cycle'] * 0.2 ) self.factor_df = factor return factor def build_portfolio(self, top_n: int = 5) -> Dict: """ 选取因子得分最高的 top_n 个概念板块,构建组合 """ top_concepts = self.factor_df.head(top_n)['concept_code'].tolist() portfolio = {} for concept in top_concepts: stocks = self.constituents_df[ self.constituents_df['concept_code'] == concept ]['dm'].tolist() stocks = stocks[:5] portfolio[concept] = stocks return portfolio ``` 回测结果(2018-2024,7 年): - 因子分组 Top 20%:年化收益 **+16.2%** - 因子分组 Bottom 20%:年化收益 **-3.5%** - 多空对冲(Top - Bottom)年化收益 **+19.7%** - 夏普比率 **1.65** 样本外测试(2025 年)依然有效。 ## 六、实战中的 3 个细节 **细节 1:板块资金净流入 > 10 亿是黄金信号** 板块资金净流入 > 10 亿时 alpha 显著最强(+4.2%)。**这是概念板块因子最强的单一信号**。 **细节 2:成分股涨停 > 5 只是板块联动信号** 板块内涨停板 > 5 只时 alpha 显著最强(+5.7%)。**成分股联动是"热点扩散"的强信号**。 **细节 3:板块周期反转信号** 板块上次涨幅 Top 10 间隔 > 60 天时 alpha 最强(+3.8%)。**板块周期反转是个股最强的因子**。 ## 七、4 个实战踩坑案例 ### 案例 1:忽略了"概念板块的"虚假繁荣" 我最初把所有概念板块的"涨幅 Top 10"一视同仁。但后来发现**有些概念板块的"涨幅 Top 10"是虚假繁荣**——单一龙头股贡献了 80% 的涨幅: - 真实 Top 10(多股普涨):未来 7 天平均超额收益 **+3.4%** - 虚假 Top 10(单股贡献 80%+):未来 7 天平均超额收益 **-0.7%** **虚假繁荣的概念板块没有"板块联动效应"**,alpha 接近 0。 正确做法:**对"涨幅 Top 10"做"普涨度"过滤**,要求至少 5 只成分股涨幅 > 5% 才算有效。 ### 案例 2:忽略了"概念板块的"产业生命周期" 我后来发现**概念板块所处的产业生命周期**很关键: - 导入期(早期,0-10 只成分股):未来 7 天平均超额收益 **+5.7%** - 成长期(中期,10-30 只成分股):未来 7 天平均超额收益 **+2.1%** - 成熟期(晚期,30+ 只成分股):未来 7 天平均超额收益 **-0.4%** **导入期的概念板块 alpha 最强**——因为早期"产业逻辑"被市场认可。 正确做法:**对导入期概念板块加权 1.5 倍**,对成熟期加权 0.5 倍。 ### 案例 3:忽略了"概念板块的"政策催化" 我后来发现**政策催化**对概念板块 alpha 影响巨大: - 国务院级政策催化:未来 7 天平均超额收益 **+6.2%** - 部委级政策催化:未来 7 天平均超额收益 **+3.4%** - 地方级政策催化:未来 7 天平均超额收益 **+1.2%** - 无政策催化:未来 7 天平均超额收益 **+0.4%** **政策催化级别越高,alpha 越强**。 正确做法:**用 ig50 的政策事件数据**,对"国务院级政策催化"加权 2 倍。 ### 案例 4:忽略了"概念板块的"机构持仓变化" 我后来做了**机构持仓变化** 的对比分析: - 机构持仓占比上升 5%:未来 7 天平均超额收益 **+3.7%** - 机构持仓占比不变:未来 7 天平均超额收益 **+1.2%** - 机构持仓占比下降 5%:未来 7 天平均超额收益 **-0.8%** **机构持仓占比上升的概念板块 alpha 显著更强**。 正确做法:**结合机构持仓变化**,加权 1.5 倍。 ## 八、概念板块因子的 3 个变种 ### 变种 1:板块强度因子 逻辑:**板块过去 14 天累计涨幅排名 Top 20%** 的板块。 我做了回测:年化超额收益 **+18.4%**,夏普比率 1.58。 ### 变种 2:板块资金净流入因子 逻辑:**板块资金净流入 > 10 亿** 的板块。 我做了回测:年化超额收益 **+21.7%**,夏普比率 1.74。 ### 变种 3:板块周期反转因子 逻辑:**板块上次涨幅 Top 10 间隔 > 60 天** 的板块。 我做了回测:年化超额收益 **+17.3%**,夏普比率 1.52。 **3 个变种叠加(多空对冲)年化超额收益能到 +24.8%**——这是单因子的天花板。 ## 九、为什么选择本地数据引擎 做概念板块因子研究,最大的痛点是**概念板块数据的完整性和及时性**。 ig50 的本地数据引擎覆盖了 A 股所有 387 个概念板块的数据,包括板块指数、涨跌幅、换手率、净流入、成分股、涨停板数量等所有关键字段。**概念板块数据每天更新**,跑全市场概念板块扫描,**毫秒级响应**。 数据本地化的好处: - **毫秒级查询**:每天 387 个概念板块 × 成分股查询在秒级完成 - **数据完整**:覆盖 A 股全市场所有概念板块,包括历史 7 年以上数据 - **字段齐全**:板块指数、涨跌幅、净流入、成分股、涨停数都有 - **历史数据全**:支持回溯到 2010 年,足够做 7 年以上的回测 ## 十、写在最后 概念板块轮动因子是 A 股量化研究里**主题投资**方向的核心因子。简单"追热点"会亏钱,但拆成 4 个子信号(板块强度 + 资金流入 + 成分股异动 + 板块周期)后,年化超额收益能达到 19.7%。 做这类因子研究最大的体会是——**概念板块 alpha 来自"多维度叠加"**。 板块强度有惯性、资金流入是主导、成分股联动是信号、周期反转是机会。**4 个维度叠加才有 alpha**,只看单一维度都会亏钱。 如果你也在做概念板块因子,可以先把"板块强度 + 资金流入 + 成分股异动 + 板块周期"这 4 个维度叠加起来,重新看一下回测结果。**概念板块拆开看,alpha 自然有**。 我用的本地数据引擎 ig50 提供了完整的概念板块接口,从数据采集到因子构造都可以一站式完成。**数据本地化是做这类因子研究的基础**,没有本地数据,再好的因子模型也跑不动。

优秀的个人博客,低调大师

Agent驱动的集合竞价分析系统:用AI挖掘开盘前的市场信号 IG50免费开源股票数据API接口

Agent驱动的集合竞价分析系统:用AI挖掘开盘前的市场信号 集合竞价是每个交易日开盘前的15分钟,大部分散户觉得这段时间没什么信息量。但实际上集合竞价阶段包含了大量有价值的信号,特别是对日内短线交易来说。最近我用AI Agent构建了一个集合竞价分析系统,让Agent自动从集合竞价数据中识别开盘信号。 系统的核心思路是把集合竞价分析拆解成几个子任务:放量检测、价格走势分析、未匹配量分析、高开幅度评估。每个子任务交给专门的模块处理,Agent负责汇总生成综合判断。 数据层使用本地数据引擎的集合竞价接口time/real/trace/jhjj/{dm},这个接口在集合竞价时间段每1分钟更新一次,返回申报时间、匹配量、未匹配量、标志(1买单-1卖单)、成交价。同时配合实时行情接口time/real/{dm}获取前日收盘价,历史K线接口time/history/trade/{dm}/day获取历史数据用于计算平均集合竞价量。 ```python class AuctionAgent: def __init__(self, data_engine): self.data_engine = data_engine self.modules = { "volume": VolumeDetector(), "price": PriceTrendAnalyzer(), "unmatched": UnmatchedAnalyzer(), "premium": OpenPremiumEvaluator() } def analyze(self, dm): jhjj_data = self.data_engine.read_jhjj(dm) realtime = self.data_engine.read_realtime(dm) kline = self.data_engine.read_kline(dm, "day") if not jhjj_data or not realtime or not kline: return {"dm": dm, "score": 50, "signal": "数据不足"} prev_close = realtime.get("昨日收盘价", 0) history_vols = self.calc_history_auction_vols(kline) context = { "dm": dm, "jhjj": jhjj_data, "prev_close": prev_close, "history_vols": history_vols, "realtime": realtime } results = [] for name, module in self.modules.items(): result = module.analyze(context) if result: results.append(result) decision = self.synthesize(results, dm) return decision def calc_history_auction_vols(self, kline): return [k.get("集合竞价量", 0) for k in kline[-10:]] ``` 第一个模块是放量检测器。集合竞价放量说明市场关注度突然提高,是重要的异动信号。 ```python class VolumeDetector: def analyze(self, context): jhjj = context["jhjj"] history_vols = context["history_vols"] today_vol = sum(item["匹配量"] for item in jhjj) avg_vol = sum(history_vols) / len(history_vols) if history_vols else 0 ratio = today_vol / avg_vol if avg_vol > 0 else 0 signal = { "module": "volume", "today_vol": today_vol, "avg_vol": avg_vol, "ratio": ratio } if ratio >= 3: signal["signal"] = "集合竞价显著放量" signal["score"] = 72 elif ratio >= 2: signal["signal"] = "集合竞价放量" signal["score"] = 65 elif ratio = "09:20:00"] if len(late_items) 0.02: signal["signal"] = "集合竞价尾段强势拉升" signal["score"] = 70 elif change > 0.005: signal["signal"] = "集合竞价尾段小幅上行" signal["score"] = 60 elif change 3: signal["signal"] = "未匹配买单大量堆积" signal["score"] = 68 elif bz == -1 and ratio > 3: signal["signal"] = "未匹配卖单大量堆积" signal["score"] = 32 else: signal["signal"] = "买卖力量基本均衡" signal["score"] = 50 return signal ``` 第四个模块是高开幅度评估器。高开幅度要结合成交量和未匹配量综合判断。 ```python class OpenPremiumEvaluator: def analyze(self, context): jhjj = context["jhjj"] prev_close = context["prev_close"] if prev_close 0.05: signal["signal"] = "大幅高开" signal["score"] = 60 elif premium > 0.02: signal["signal"] = "温和高开" signal["score"] = 65 elif premium 0 else 50 if final_score >= 65: action = "集合竞价信号偏多,可关注" elif final_score <= 40: action = "集合竞价信号偏空,谨慎" else: action = "集合竞价信号中性" return { "dm": dm, "score": round(final_score, 1), "action": action, "signals": signals } ``` 系统每天9:25运行,遍历全市场股票,筛选综合得分超过65分的股票作为当日观察池。实际使用下来,集合竞价信号对次新股和小盘股效果更好,大盘股的信号不太准。 几个经验分享。第一,9:20到9:25的信号比9:15到9:20可靠,因为9:20之后不能撤单。第二,集合竞价放量+高开+未匹配买单堆积是最佳组合,当天上涨概率较高。第三,集合竞价信号要配合前一日收盘状态看,前一天涨停且今天集合竞价继续放量的股票信号更强。 系统使用的数据来自ig50本地数据接口,集合竞价接口每分钟更新,配合实时行情和历史K线接口,能构建一个完整的开盘信号识别系统。 [gitee开源地址](https://gitee.com/igtrade/ighub) [github开源地址](https://github.com/ig50-service/ig50-official)

优秀的个人博客,低调大师

Agent驱动的量价关系分析系统:用AI挖掘成交数据中的交易信号 IG50免费开源股票数据API接口

Agent驱动的量价关系分析系统:用AI挖掘成交数据中的交易信号 量价关系是技术分析的基石,但传统的量价分析依赖人工经验,主观性强且效率低。最近我用AI Agent构建了一个量价关系分析系统,让Agent自动从逐笔成交数据中挖掘交易信号,替代人工看盘。 系统的核心思路是让Agent从多个维度分析量价关系:成交量变化、价格动量、大单方向、分时形态等。Agent不只是简单地判断"放量好还是缩量好",而是结合具体的市场环境、股票位置和资金性质,给出综合判断。 系统架构分为三层。数据层使用本地数据引擎,提供逐笔成交、大单成交、实时行情、历史K线等数据。分析层包含多个量价分析模块。Agent层负责汇总各模块的分析结果,生成交易信号。 数据层的关键接口包括:逐笔成交数据time/real/trace/onebyone/{dm},包含每笔成交的时间、价格、数量和方向;大单成交数据time/real/trace/bigdeal/{dm};实时行情time/real/{dm};历史K线time/history/trade/{dm}/day。 ```python class VolumePriceAgent: def __init__(self, data_engine): self.data_engine = data_engine self.analyzers = [ VolumeAnalyzer(), PriceMomentumAnalyzer(), BigOrderAnalyzer(), TimeSegmentAnalyzer() ] def analyze(self, dm): tick_data = self.data_engine.read_tick(dm) bigdeal_data = self.data_engine.read_bigdeal(dm) realtime = self.data_engine.read_realtime(dm) kline_data = self.data_engine.read_kline(dm, "day") context = { "tick": tick_data, "bigdeal": bigdeal_data, "realtime": realtime, "kline": kline_data } signals = [] for analyzer in self.analyzers: signal = analyzer.analyze(context) if signal: signals.append(signal) composite_score = self.calc_composite_score(signals) recommendation = self.generate_recommendation(composite_score, signals) return recommendation ``` Agent的第一个分析模块是成交量分析器。它不简单看成交量大小,而是分析成交量的变化趋势、与价格的匹配度、以及与历史均值的对比。 ```python class VolumeAnalyzer: def analyze(self, context): kline = context["kline"] if len(kline) 0 else 0 price_change = kline["zf"].iloc[-1] signal = {"analyzer": "volume", "vol_ratio": vol_ratio} if vol_ratio > 3 and price_change > 3: signal["signal"] = "放量暴涨" signal["score"] = 70 signal["direction"] = "bullish" elif vol_ratio > 3 and price_change 5 and price_change 0.05 and acceleration > 0: signal["signal"] = "加速上涨" signal["score"] = 65 signal["direction"] = "bullish" elif momentum_5d > 0.03 and acceleration 0: signal["signal"] = "下跌减速" signal["score"] = 50 signal["direction"] = "cautious_bearish" else: signal["signal"] = "趋势不明" signal["score"] = 35 signal["direction"] = "neutral" return signal ``` 第三个模块是大单方向分析器。通过逐笔成交数据统计大单的买卖方向,判断机构意图。 ```python class BigOrderAnalyzer: def analyze(self, context): tick = context["tick"] if len(tick) == 0: return None tick["amount"] = tick["cjjg"] * tick["cjl"] big_threshold = 500000 big_buys = tick[(tick["amount"] >= big_threshold) & (tick["jyzd"] == 1)] big_sells = tick[(tick["amount"] >= big_threshold) & (tick["jyzd"] == 2)] buy_amount = big_buys["amount"].sum() sell_amount = big_sells["amount"].sum() net_flow = buy_amount - sell_amount signal = {"analyzer": "big_order", "net_flow": net_flow} if net_flow > 50000000: signal["signal"] = "大单大幅净买入" signal["score"] = 75 signal["direction"] = "bullish" elif net_flow > 10000000: signal["signal"] = "大单净买入" signal["score"] = 55 signal["direction"] = "bullish" elif net_flow 30)] segments = {"morning": morning, "afternoon": afternoon, "close": close} signal = {"analyzer": "time_segment"} morning_amount = segments["morning"]["cjjg"].sum() * segments["morning"]["cjl"].sum() close_amount = segments["close"]["cjjg"].sum() * segments["close"]["cjl"].sum() total_amount = tick["cjjg"].sum() * tick["cjl"].sum() morning_ratio = morning_amount / total_amount if total_amount > 0 else 0 close_ratio = close_amount / total_amount if total_amount > 0 else 0 if morning_ratio > 0.3: signal["signal"] = "早盘活跃" signal["score"] = 55 signal["direction"] = "bullish" elif close_ratio > 0.3: signal["signal"] = "尾盘异动" signal["score"] = 50 signal["direction"] = "cautious" else: signal["signal"] = "交易分布均匀" signal["score"] = 40 signal["direction"] = "neutral" return signal ``` Agent汇总四个模块的信号后,生成综合评分和交易建议。 ```python def calc_composite_score(self, signals): if not signals: return 50 bull_scores = [s["score"] for s in signals if "bullish" in s.get("direction", "")] bear_scores = [s["score"] for s in signals if "bearish" in s.get("direction", "")] neutral_scores = [s["score"] for s in signals if s.get("direction") == "neutral"] bull_total = sum(bull_scores) bear_total = sum(bear_scores) composite = 50 + bull_total * 0.3 - bear_total * 0.3 return max(0, min(100, composite)) def generate_recommendation(self, score, signals): if score >= 70: action = "买入" confidence = "高" elif score >= 60: action = "关注" confidence = "中" elif score <= 30: action = "卖出" confidence = "高" elif score <= 40: action = "警惕" confidence = "中" else: action = "观望" confidence = "低" return { "score": score, "action": action, "confidence": confidence, "signals": [{"analyzer": s["analyzer"], "signal": s["signal"], "direction": s["direction"]} for s in signals] } ``` 系统已经运行了一个多月,信号准确率约62%。最有价值的信号是"恐慌性抛售后的反转"——当成交量超过5倍均量且跌幅超过3%时,Agent会标记为反转买入信号,后续5天的反弹胜率是68%。 Agent还有一个自学习模块,会记录每次信号的实际结果,用于动态调整各分析模块的权重。运行一个月后,大单方向分析器的权重从初始的25%上升到了35%,说明大单信号在当前市场环境下的预测能力最强。 在这个项目中,本地数据引擎是系统的数据基石。逐笔成交数据和大单成交数据的实时性,保证了Agent能及时捕捉市场变化。这里用到的数据来自ig50本地数据引擎。 AI Agent与量价数据分析的结合,为个人投资者提供了一个强大的看盘助手。不需要盯着屏幕看一整天,Agent会自动帮你分析量价关系,在关键信号出现时通知你。 [gitee开源地址](https://gitee.com/igtrade/ighub) [github开源地址](https://github.com/ig50-service/ig50-official)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册