首页 文章 精选 留言 我的

精选列表

搜索[bug],共10000篇文章
优秀的个人博客,低调大师

解 Bug 之路 — Dubbo 流量上线时的非平滑问题

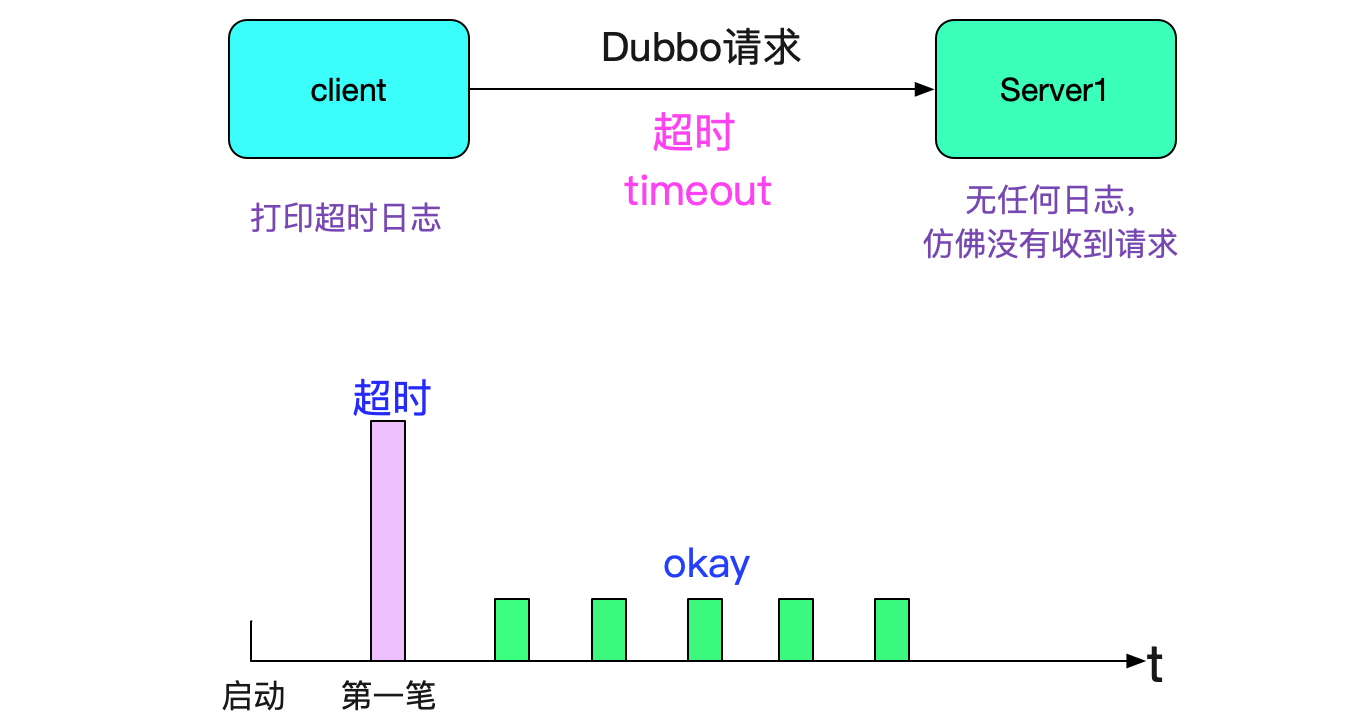
前言 笔者最近解决了一个困扰了业务系统很久的问题。这个问题只在发布时出现,每次只影响一两次调用,相较于其它的问题来说,这个问题有点不够受重视。由于种种原因,使得这个问题到了业务必须解决的程度,于是就到了笔者的手上。 问题现场 我们采用的是dubbo服务,这是个稳定成熟的RPC框架。但是我们在某些应用中会发现,只要这个应用一发布(或者重启),就会出现请求超时的问题,如下图所示: 而且都是第一笔请求会报错,之后就再也没有问题了。 排查日志 好了,现象我们知道了,于是开始排查那个时间点的日志。Server端没有任何日志,而Client(App1)端报错超时。报错如下所示: 2019-08-22 20:33:50.798 com.alibaba.dubbo.rpc.RpcException: Failed to invoke the method set in the servce XXXFacade, tries 1 times ...... start time: 2019-08-22 20:32:50.474 end time: 2019-08-22 30:33:50.767 timeout=60000,channel:/21.64.21.164:44502->21.64.35.75:20880 看日志报错是这个tcp五元组(21.64.21.164:44502->21.64.35.75:20880)有问题。于是笔者netstat了一下,查看当前此连接的状态: netstat -anp | grep 44502 21.64.21.164:44502 21.64.35.75:20880 ESTABLISHED 这个连接处于正常的ESTABLISHED状态,而且调用21.64.35.75这个server的连接只有这一个,那后续这台机器调用21.64.35.75这个server肯定只用到了这个连接,查看日志发现除了这一笔,其它调用一切正常。 思路1:Server端处理超时 按照上面的报错,肯定这个连接有问题,按照正常思路,是否是第一笔调用的时候各种初始化过程(以及jit)导致server处理请求过慢?如下图所示: 但这个问题很快被第二笔请求(和第一笔请求间隔只有一秒)给否决了。也就是说第一笔请求花了60s还超时,而第二笔请求在第一笔请求发出后的一秒后发出就成功了(而且耗时是毫秒级的)。如果按照上述思路,第二笔请求也应该等各种初始化完成之后再处理,也应该卡相当长的一段时间才对。再加上server端没有任何日志,就感觉好像没有收到请求。 思路2:Client端没有发送成功 于是我们开始了思路2,Client端没有发送成功。由于Dubbo是基于Netty的,其请求传输的处理过程是个NIO的异步化过程(只不过通过使用future机制对业务来说是同步的)。首先我们看下dubbo的超时检测机制,如下图所示: 当然,还有future的超时机制,这边我就不列举出来了。从这个机制可以看出,就算Client端发送的时候(因为写是写到socket的writebuffer里面,一般不会满,所以不会报错)没有发送出去,也不会在发的那一刻报出错误,而是要等定时扫描。为了验证这个猜想,笔者就开始着手排查连接的日志。 连接日志 因为规律是第一笔失败,那么笔者开始怀疑连接创建的有问题,但后面的请求成功又表明连接创建是没有问题的。那么,是否是连接还没有创建好就发送了第一笔请求呢?带着这样的疑问,笔者找到了如下的日志: 2019-08-22 20:32:51.876 (DubboClientReconnectTimer-thread-1) Successed connect to server /21.64.35.75:20880 ... channel is NettyChannel /21.64.21.164:44502 => /21.64.35.75:20880 由日志所示,21.64.21.164:44502这个连接串是在2019-08-22 20:32:51.876连接成功的,而上面出错的日志起始时间为 请求发送时间:2019-08-22 20:32:50.474 连接开始建立时间:2019-08-22 20:32:51.876 连接成功建立时间:2019-08-22 20:32:51.876 请求在连接成功建立之前,感觉非常符合笔者上述的猜想。但细想又不对,上述日志表示的是在2019-08-22 20:32:51.876开始建立连接并在1ms内建立成功连接。而请求确是50s发出的,dubbo本身代码不可能在连接还没做出创建动作的时候就开始发送请求(因为44502是由kernel分配的,没到创建连接动作之前是不可能知道这个端口号的,但它却在日志里面打印出来了),如下图所示: 思考了一段时间,笔者觉得这种情况很有可能是日志是不准确的,它仅仅打印当前连接包装类中的信息,之前那个出错的连接已经被新建的连接掩盖了(在日志中)。我们看下dubbo中对应的打印日志代码: private String getTimeoutMessage(boolean scan) { long nowTimestamp = System.currentTimeMillis(); return (sent > 0 ? "Waiting server-side response timeout" : "Sending request timeout in client-side") + (scan ? " by scan timer" : "") + ". start time: " + (new SimpleDateFormat("yyyy-MM-dd HH:mm:ss.SSS").format(new Date(start))) + ", end time: " + (new SimpleDateFormat("yyyy-MM-dd HH:mm:ss.SSS").format(new Date())) + "," + (sent > 0 ? " client elapsed: " + (sent - start) + " ms, server elapsed: " + (nowTimestamp - sent) : " elapsed: " + (nowTimestamp - start)) + " ms, timeout: " + timeout + " ms, request: " + request + ", channel: " + channel.getLocalAddress() + " -> " + channel.getRemoteAddress(); } 这个21.64.21.164:44502是由channel.getLocalAddress()得出的,我们看下调用链: channel.getLocalAddress() |->nettyClient.channel.getLocalAddress() 笔者看了下代码,dubbo在reconnect(重新连接的时候)会把nettyClient.channel换掉,从而可能打印出来和发送请求时不同的client端口信息。再加上日志里面打印出来的线程号DubboClientReconnectTimer-thread-1就几乎可以确定,之前还有一个连接,只不过这个连接失败了,新建的连接为21.64.21.164:44502。再仔细的找了下日志,发现了下面这条日志: ------------------日志分割线---------------- 2019-08-22 20:32:51,876(DubboClientReconnectTimer-thread-1) Close old Netty channel /21.64.21.164:44471 :> 21.64.35.75:20880 on create new netty channel /21.64.21.164:44502 => /21.64.35.75:20880 ------------------日志分割线---------------- 2019-08-22 20:32:51.876 (DubboClientReconnectTimer-thread-1) Successed connect to server /21.64.35.75:20880 ... channel is NettyChannel /21.64.21.164:44502 => /21.64.35.75:20880 即是说dubbo在把21.64.21.164:44471关闭后,立马创建了21.64.21.164:44502 那么整体过程如下图所示: 我们看下21.64.21.164:44471是什么时候创建的,继续搜寻日志: zgrep '21.64.21.164:44471' dubbo.log.1.zip 2019-08-22 20:31:59.871 (ZkClient-EventThread-23) Successed connect to server /21.64.35.75:20880 ... channel is NettyChannel /21.64.21.164: 44471 => /21.64.35.75:20880 ------------------日志分割线---------------- 2019-08-22 20:32:51,876(DubboClientReconnectTimer-thread-1) Close old Netty channel /21.64.21.164:44471 :> 21.64.35.75:20880 发现其在 连接1创建时间:2019-08-22 20:31:59.871 请求发送时间:2019-08-22 20:32:50.474 连接1关闭时间:2019-08-22 20:32:51,876 而且笔者翻看了业务日志,发现连接1在其生命周期内有且只有一笔请求,这笔请求就是报错的请求,由此可以看出这个连接1从建立成功开始就无法使用。 为什么连接建立成功确无法使用 首先由于dubbo是基于netty的,这种成熟的广泛应用的框架在创建连接这种问题上不应该会有问题。 而笔者仔细翻看netty翻看netty源码也确实遵守了NIO的编写套路。那么问题可能出现在环境上,既然应用(client/server)本身日志找不到更多的有用信息,那么看看操作系统能否有什么可以追寻的蛛丝马迹。于是笔者首先用dmesg查看下kernel打印的日志,client端没发现什么有用的信息,但server端的dmesg引起了笔者的注意 possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. 其字面意思为kenerl本身可能在20880端口遭到了SYN泛洪攻击,发送cookies。 这种日志会在并发连接过多的情况下由kernel打印出来。笔者netstat了下频繁出问题的机器,发现其特点都是连接特别多(达到了好几千甚至上万)。而dubbo的上线机制是只要注册到zookeeper后,zookeeper给所有的机器推送,所有的机器立马连接,这样就会造成比较高的并发连接,如下图所示: 既然怀疑到了高并发connect,那么笔者就立马用netstat看下kernel对于tcp的统计信息: netstat -s ... TcpExt: ... 1607 times the listen queue of a socket overflowed ... 果然有这种并发连接导致的统计信息,socket overflowed表示的是server端的tcp_backlog队列溢出了。到这里笔者有八成把握是这个tcp_backlog设置的过小的问题了。下面就是分析,tcp_backlog溢出为什么会导致上述连接虽然成功但是第一笔报错的现象,从而和日志相印证,来证明笔者的猜测。 tcp_backlog溢出分析 tcp的三次握手 先从tcp的三次握手进行着手分析,从tcp_v4_do_rcv函数进行入手,因为这个函数是tcp协议获取packet的地方,当三次握手的SYN第一次进来的时候,应该会走这个函数: // 先考察一下三次握手的第一个SYN int tcp_v4_do_rcv(struct sock *sk, struct sk_buff *skb){ if (sk->sk_state == TCP_LISTEN) { ...... // 由于现在连接处于第一个SYN,现在server端的socket处于LISTEN状态 struct sock *nsk = tcp_v4_hnd_req(sk, skb); ...... } } // 我们继续看下tcp_v4_hnd_req代码,三次握手第一个SYN kernel走的分支 tcp_v4_do_rcv /* 由于tcp_v4_hnd_req没有发现和此五元组对应的连接,所以do nothing */ |->tcp_v4_hnd_req |->tcp_rcv_state_process /** case TCP_LISTEN && th->syn */ |->conn_request(tcp_v4_conn_request) 我们继续分析conn_request函数,由于里面很多逻辑,所以我们滤掉了很多细节: int tcp_v4_conn_request(struct sock *sk, struct sk_buff *skb) { // 如果csk的reqsk queue满了,则设置want_cookie标识 if (inet_csk_reqsk_queue_is_full(sk) && !isn) { if (sysctl_tcp_syncookies) { want_cookie = 1; } ...... if(want_cookie){ // 下面这行就是打印possible SYN flooding的地方 syn_flood_warning(skb); ...... } // 发送synack,即三次握手的第二次握手 // 注意want_cookie的时候并不把对应的req加入到reqsk的hash列表中 if (__tcp_v4_send_synack(sk, req, dst) || want_cookie) goto drop_and_free; // 如果发送syack成功,则加到hash列表里面 inet_csk_reqsk_queue_hash_add(sk, req, TCP_TIMEOUT_INIT); ...... drop_and_free; reqsk_free(req); return 0; } } 上面就是三次握手的前两次握手,如下图所示: 现在让我们看下最关键的第三次握手(客户端发给server ack的过程),依旧从tcp_v4_do_rcv开始 tcp_v4_hnd_req |->tcp_v4_hnd_req // 这里面分两种情况 static struct sock *tcp_v4_hnd_req(struct sock *sk, struct sk_buff *skb){ // 首先从inet_csk_search_req看是否有对应的五元组 struct request_sock *req = inet_csk_search_req(sk, &prev, th->source, iph->saddr, iph->daddr); // 这边的req分支下的tcp_check_req是重点,我们下面再分析 if (req) return tcp_check_req(sk, skb, req, prev); // 处理established情况 // 如果inet_csk没找到,则可能是需要syn cookie,处理syn cookie // 下面这条语句应该是在syn sk = cookie_v4_check(sk, skb, &(IPCB(skb)->opt)); // 如果处理成功,则把其加入到inet_csk_reqsk_queue_add队列中 ...... } 上面这些代码片段主要表明的就是如果三次握手成功,会在server端把新创建的server端sock放到inet_csk_reqsk里面,然后由后面的tcp_child_process去处理。 tcp_check_req 上面分析完大致的tcp三次握手代码逻辑之后,我们现在看看造成本文问题现象的核心分支tcp_check_req,这个是在对应的req被放到inet_csk_reqsk(即不需要cookie或者cookie校验成功)后才能执行到这一句,源码如下: // 下边是client ack回来后的处理过程 // 笔者为了简单起见,我们省略cookie校验的逻辑 struct sock *tcp_check_req(......){ /* 各种处理,各种校验 */ child = inet_csk(sk)->icsk_af_ops->syn_recv_sock(sk, skb, req, NULL); // 如果syn_recv_sock返回空,则跳到listen_overflow if (child == NULL) goto listen_overflow; ...... listen_overflow: // 如果没有设置tcp_abort_on_overflow则设置acked=1 if (!sysctl_tcp_abort_on_overflow) { inet_rsk(req)->acked = 1; return NULL; }} // 增加内核统计参数 NET_INC_STATS_BH(sock_net(sk), LINUX_MIB_EMBRYONICRSTS); // 如果设置了tcp_abort_on_overflow则发送reset报文 if (!(flg & TCP_FLAG_RST)) req->rsk_ops->send_reset(sk, skb); // 同时将当前sock从csk_reqsk中删除,即当client端下次报文过来的时候,无法找到 // 对应的csk_reqsk inet_csk_reqsk_queue_drop(sk, req, prev); return NULL; 如果进了listen_overflow分支,server端会有两种现象,一个是直接将acked设置为1(仅设置标识不发送ack),另一个是发送ack。这两个分支都会把对应的req从reqsk_queue中删除。下图就是走了listen_overflow后不同分之,三次握手的情况: 不设置tcp_abort_on_overflow 设置tcp_abort_on_overflow 由上面看出设置了tcp_abort_on_overflow会在三次握手之后立马置为closed状态,二不设置tcp_abort_on_overflow会等第一个请求发出来的时候才会知道这个连接其实已经被server端丢弃了。 什么时候listen_overflow 看上面的代码,即在syn_recv_sock返回null的时候,会到listen_overflow,对应的tcp协议的函数为: struct sock *tcp_v4_syn_recv_sock(struct sock *sk, struct sk_buff *skb, struct request_sock *req, struct dst_entry *dst){ .... if (sk_acceptq_is_full(sk)) goto exit_overflow; ...... } sk_acceptq_is_full里面判断full的队列长度是下面这三个参数中的最小值: 取三者中的最小值 /proc/sys/inet/ipv4/tcp_max_syn_backlog /proc/sys/net/core/somaxconn tcp listen函数调用时候传入的back_log 限于篇幅,就不给出这里判断队列是否为full的源码了。 修复方案 设置kernel参数 一开始笔者仅仅在server端设置了下面这三个参数(天真的以为dubbo考虑到了backlog,设置了一个较大的数值,其实其用了jdk默认的50) 注意,这边511是根据redis的建议值设置的 /proc/sys/inet/ipv4/tcp_max_syn_backlog 511 /proc/sys/net/core/somaxconn 511 /proc/sys/net/ipv4/tcp_abort_on_overflow 1 发现依旧有Close old netty client这样的错误日志,但是业务方确告诉笔者已经没有上线流量损失的情况了。笔者上去观察了一下情况,发现没有流量损失是由于如上图所述reset报文立马发回来,导致能够出错的时间窗口缩小为2s,而不是之前的第一笔必报错,2s内由于没有任何请求,所以大大减少了出错概率。如下图所示: 而创建连接和close old netty client日志的间隔都是小于等于两秒也证明了tcp_abort_on_overflow生效了 dubbo代码增加backlog的设置 由于dubbo用的是jdk默认的backlog(50),所以笔者在dubbo源码对应的部分做了调整,如下代码所示: public class NettyServer extends AbstractServer implements Server { ...... protected void doOpen() throws Throwable { ... // 可以从jvm参数中动态调整这个backlog String backlog = System.getProperty(BACK_LOG_KEY); if(StringUtils.isEmpty(backlog)){ // 默认为2048,这边调大点,反正改内核参数是即时生效的 backlog = DEFAULT_BACK_LOG; } bootstrap.setOption("backlog",backlog); ...... } } 将这个修改过的dubbo版本给业务方(server端)用了以后,再也没有对应的报错日志了,dubbo上线也平滑了。 总结 事实上,从开始分析问题到猜测要调整backlog所花费的时间并不长。但是笔者喜欢把所有的细节和自己的猜想一一印证,通过源码分析出来的过程图景能够将所有的问题现象全部解释,是一件很爽快的事情。 原文链接 https://my.oschina.net/alchemystar/blog/3098219

优秀的个人博客,低调大师

解Bug之路-dubbo流量上线时的非平滑问题

前言 笔者最近解决了一个困扰了业务系统很久的问题。这个问题只在发布时出现,每次只影响一两次调用,相较于其它的问题来说,这个问题有点不够受重视。由于种种原因,使得这个问题到了业务必须解决的程度,于是就到了笔者的手上。 问题现场 我们采用的是dubbo服务,这是个稳定成熟的RPC框架。但是我们在某些应用中会发现,只要这个应用一发布(或者重启),就会出现请求超时的问题,如下图所示: 而且都是第一笔请求会报错,之后就再也没有问题了。 排查日志 好了,现象我们知道了,于是开始排查那个时间点的日志。Server端没有任何日志,而Client(App1)端报错超时。报错如下所示: 2019-08-22 20:33:50.798 com.alibaba.dubbo.rpc.RpcException: Failed to invoke the method set in the servce XXXFacade, tries 1 times ...... start time: 2019-08-22 20:32:50.474 end time: 2019-08-22 30:33:50.767 timeout=60000,channel:/21.64.21.164:44502->21.64.35.75:20880 看日志报错是这个tcp五元组(21.64.21.164:44502->21.64.35.75:20880)有问题。于是笔者netstat了一下,查看当前此连接的状态: netstat -anp | grep 44502 21.64.21.164:44502 21.64.35.75:20880 ESTABLISHED 这个连接处于正常的ESTABLISHED状态,而且调用21.64.35.75这个server的连接只有这一个,那后续这台机器调用21.64.35.75这个server肯定只用到了这个连接,查看日志发现除了这一笔,其它调用一切正常。 思路1:Server端处理超时 按照上面的报错,肯定这个连接有问题,按照正常思路,是否是第一笔调用的时候各种初始化过程(以及jit)导致server处理请求过慢?如下图所示: 但这个问题很快被第二笔请求(和第一笔请求间隔只有一秒)给否决了。也就是说第一笔请求花了60s还超时,而第二笔请求在第一笔请求发出后的一秒后发出就成功了(而且耗时是毫秒级的)。如果按照上述思路,第二笔请求也应该等各种初始化完成之后再处理,也应该卡相当长的一段时间才对。再加上server端没有任何日志,就感觉好像没有收到请求。 思路2:Client端没有发送成功 于是我们开始了思路2,Client端没有发送成功。由于Dubbo是基于Netty的,其请求传输的处理过程是个NIO的异步化过程(只不过通过使用future机制对业务来说是同步的)。首先我们看下dubbo的超时检测机制,如下图所示: 当然,还有future的超时机制,这边我就不列举出来了。从这个机制可以看出,就算Client端发送的时候(因为写是写到socket的writebuffer里面,一般不会满,所以不会报错)没有发送出去,也不会在发的那一刻报出错误,而是要等定时扫描。为了验证这个猜想,笔者就开始着手排查连接的日志。 连接日志 因为规律是第一笔失败,那么笔者开始怀疑连接创建的有问题,但后面的请求成功又表明连接创建是没有问题的。那么,是否是连接还没有创建好就发送了第一笔请求呢?带着这样的疑问,笔者找到了如下的日志: 2019-08-22 20:32:51.876 (DubboClientReconnectTimer-thread-1) Successed connect to server /21.64.35.75:20880 ... channel is NettyChannel /21.64.21.164:44502 => /21.64.35.75:20880 由日志所示,21.64.21.164:44502这个连接串是在2019-08-22 20:32:51.876连接成功的,而上面出错的日志起始时间为 请求发送时间:2019-08-22 20:32:50.474 连接开始建立时间:2019-08-22 20:32:51.876 连接成功建立时间:2019-08-22 20:32:51.876 请求在连接成功建立之前,感觉非常符合笔者上述的猜想。但细想又不对,上述日志表示的是在2019-08-22 20:32:51.876开始建立连接并在1ms内建立成功连接。而请求确是50s发出的,dubbo本身代码不可能在连接还没做出创建动作的时候就开始发送请求(因为44502是由kernel分配的,没到创建连接动作之前是不可能知道这个端口号的,但它却在日志里面打印出来了),如下图所示: 思考了一段时间,笔者觉得这种情况很有可能是日志是不准确的,它仅仅打印当前连接包装类中的信息,之前那个出错的连接已经被新建的连接掩盖了(在日志中)。我们看下dubbo中对应的打印日志代码: private String getTimeoutMessage(boolean scan) { long nowTimestamp = System.currentTimeMillis(); return (sent > 0 ? "Waiting server-side response timeout" : "Sending request timeout in client-side") + (scan ? " by scan timer" : "") + ". start time: " + (new SimpleDateFormat("yyyy-MM-dd HH:mm:ss.SSS").format(new Date(start))) + ", end time: " + (new SimpleDateFormat("yyyy-MM-dd HH:mm:ss.SSS").format(new Date())) + "," + (sent > 0 ? " client elapsed: " + (sent - start) + " ms, server elapsed: " + (nowTimestamp - sent) : " elapsed: " + (nowTimestamp - start)) + " ms, timeout: " + timeout + " ms, request: " + request + ", channel: " + channel.getLocalAddress() + " -> " + channel.getRemoteAddress(); } 这个21.64.21.164:44502是由channel.getLocalAddress()得出的,我们看下调用链: channel.getLocalAddress() |->nettyClient.channel.getLocalAddress() 笔者看了下代码,dubbo在reconnect(重新连接的时候)会把nettyClient.channel换掉,从而可能打印出来和发送请求时不同的client端口信息。再加上日志里面打印出来的线程号DubboClientReconnectTimer-thread-1就几乎可以确定,之前还有一个连接,只不过这个连接失败了,新建的连接为21.64.21.164:44502。再仔细的找了下日志,发现了下面这条日志: ------------------日志分割线---------------- 2019-08-22 20:32:51,876(DubboClientReconnectTimer-thread-1) Close old Netty channel /21.64.21.164:44471 :> 21.64.35.75:20880 on create new netty channel /21.64.21.164:44502 => /21.64.35.75:20880 ------------------日志分割线---------------- 2019-08-22 20:32:51.876 (DubboClientReconnectTimer-thread-1) Successed connect to server /21.64.35.75:20880 ... channel is NettyChannel /21.64.21.164:44502 => /21.64.35.75:20880 即是说dubbo在把21.64.21.164:44471关闭后,立马创建了21.64.21.164:44502 那么整体过程如下图所示: 我们看下21.64.21.164:44471是什么时候创建的,继续搜寻日志: zgrep '21.64.21.164:44471' dubbo.log.1.zip 2019-08-22 20:31:59.871 (ZkClient-EventThread-23) Successed connect to server /21.64.35.75:20880 ... channel is NettyChannel /21.64.21.164: 44471 => /21.64.35.75:20880 ------------------日志分割线---------------- 2019-08-22 20:32:51,876(DubboClientReconnectTimer-thread-1) Close old Netty channel /21.64.21.164:44471 :> 21.64.35.75:20880 发现其在 连接1创建时间:2019-08-22 20:31:59.871 请求发送时间:2019-08-22 20:32:50.474 连接1关闭时间:2019-08-22 20:32:51,876 而且笔者翻看了业务日志,发现连接1在其生命周期内有且只有一笔请求,这笔请求就是报错的请求,由此可以看出这个连接1从建立成功开始就无法使用。 为什么连接建立成功确无法使用 首先由于dubbo是基于netty的,这种成熟的广泛应用的框架在创建连接这种问题上不应该会有问题。 而笔者仔细翻看netty翻看netty源码也确实遵守了NIO的编写套路。那么问题可能出现在环境上,既然应用(client/server)本身日志找不到更多的有用信息,那么看看操作系统能否有什么可以追寻的蛛丝马迹。于是笔者首先用dmesg查看下kernel打印的日志,client端没发现什么有用的信息,但server端的dmesg引起了笔者的注意 possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. possible SYN flooding on port 20880. Sending cookies. 其字面意思为kenerl本身可能在20880端口遭到了SYN泛洪攻击,发送cookies。 这种日志会在并发连接过多的情况下由kernel打印出来。笔者netstat了下频繁出问题的机器,发现其特点都是连接特别多(达到了好几千甚至上万)。而dubbo的上线机制是只要注册到zookeeper后,zookeeper给所有的机器推送,所有的机器立马连接,这样就会造成比较高的并发连接,如下图所示: 既然怀疑到了高并发connect,那么笔者就立马用netstat看下kernel对于tcp的统计信息: netstat -s ... TcpExt: ... 1607 times the listen queue of a socket overflowed ... 果然有这种并发连接导致的统计信息,socket overflowed表示的是server端的tcp_backlog队列溢出了。到这里笔者有八成把握是这个tcp_backlog设置的过小的问题了。下面就是分析,tcp_backlog溢出为什么会导致上述连接虽然成功但是第一笔报错的现象,从而和日志相印证,来证明笔者的猜测。 tcp_backlog溢出分析 tcp的三次握手 先从tcp的三次握手进行着手分析,从tcp_v4_do_rcv函数进行入手,因为这个函数是tcp协议获取packet的地方,当三次握手的SYN第一次进来的时候,应该会走这个函数: // 先考察一下三次握手的第一个SYN int tcp_v4_do_rcv(struct sock *sk, struct sk_buff *skb){ if (sk->sk_state == TCP_LISTEN) { ...... // 由于现在连接处于第一个SYN,现在server端的socket处于LISTEN状态 struct sock *nsk = tcp_v4_hnd_req(sk, skb); ...... } } // 我们继续看下tcp_v4_hnd_req代码,三次握手第一个SYN kernel走的分支 tcp_v4_do_rcv /* 由于tcp_v4_hnd_req没有发现和此五元组对应的连接,所以do nothing */ |->tcp_v4_hnd_req |->tcp_rcv_state_process /** case TCP_LISTEN && th->syn */ |->conn_request(tcp_v4_conn_request) 我们继续分析conn_request函数,由于里面很多逻辑,所以我们滤掉了很多细节: int tcp_v4_conn_request(struct sock *sk, struct sk_buff *skb) { // 如果csk的reqsk queue满了,则设置want_cookie标识 if (inet_csk_reqsk_queue_is_full(sk) && !isn) { if (sysctl_tcp_syncookies) { want_cookie = 1; } ...... if(want_cookie){ // 下面这行就是打印possible SYN flooding的地方 syn_flood_warning(skb); ...... } // 发送synack,即三次握手的第二次握手 // 注意want_cookie的时候并不把对应的req加入到reqsk的hash列表中 if (__tcp_v4_send_synack(sk, req, dst) || want_cookie) goto drop_and_free; // 如果发送syack成功,则加到hash列表里面 inet_csk_reqsk_queue_hash_add(sk, req, TCP_TIMEOUT_INIT); ...... drop_and_free; reqsk_free(req); return 0; } } 上面就是三次握手的前两次握手,如下图所示: 现在让我们看下最关键的第三次握手(客户端发给server ack的过程),依旧从tcp_v4_do_rcv开始 tcp_v4_hnd_req |->tcp_v4_hnd_req // 这里面分两种情况 static struct sock *tcp_v4_hnd_req(struct sock *sk, struct sk_buff *skb){ // 首先从inet_csk_search_req看是否有对应的五元组 struct request_sock *req = inet_csk_search_req(sk, &prev, th->source, iph->saddr, iph->daddr); // 这边的req分支下的tcp_check_req是重点,我们下面再分析 if (req) return tcp_check_req(sk, skb, req, prev); // 处理established情况 // 如果inet_csk没找到,则可能是需要syn cookie,处理syn cookie // 下面这条语句应该是在syn sk = cookie_v4_check(sk, skb, &(IPCB(skb)->opt)); // 如果处理成功,则把其加入到inet_csk_reqsk_queue_add队列中 ...... } 上面这些代码片段主要表明的就是如果三次握手成功,会在server端把新创建的server端sock放到inet_csk_reqsk里面,然后由后面的tcp_child_process去处理。 tcp_check_req 上面分析完大致的tcp三次握手代码逻辑之后,我们现在看看造成本文问题现象的核心分支tcp_check_req,这个是在对应的req被放到inet_csk_reqsk(即不需要cookie或者cookie校验成功)后才能执行到这一句,源码如下: // 下边是client ack回来后的处理过程 // 笔者为了简单起见,我们省略cookie校验的逻辑 struct sock *tcp_check_req(......){ /* 各种处理,各种校验 */ child = inet_csk(sk)->icsk_af_ops->syn_recv_sock(sk, skb, req, NULL); // 如果syn_recv_sock返回空,则跳到listen_overflow if (child == NULL) goto listen_overflow; ...... listen_overflow: // 如果没有设置tcp_abort_on_overflow则设置acked=1 if (!sysctl_tcp_abort_on_overflow) { inet_rsk(req)->acked = 1; return NULL; }} // 增加内核统计参数 NET_INC_STATS_BH(sock_net(sk), LINUX_MIB_EMBRYONICRSTS); // 如果设置了tcp_abort_on_overflow则发送reset报文 if (!(flg & TCP_FLAG_RST)) req->rsk_ops->send_reset(sk, skb); // 同时将当前sock从csk_reqsk中删除,即当client端下次报文过来的时候,无法找到 // 对应的csk_reqsk inet_csk_reqsk_queue_drop(sk, req, prev); return NULL; 如果进了listen_overflow分支,server端会有两种现象,一个是直接将acked设置为1(仅设置标识不发送ack),另一个是发送ack。这两个分支都会把对应的req从reqsk_queue中删除。下图就是走了listen_overflow后不同分之,三次握手的情况: 不设置tcp_abort_on_overflow 设置tcp_abort_on_overflow 由上面看出设置了tcp_abort_on_overflow会在三次握手之后立马置为closed状态,二不设置tcp_abort_on_overflow会等第一个请求发出来的时候才会知道这个连接其实已经被server端丢弃了。 什么时候listen_overflow 看上面的代码,即在syn_recv_sock返回null的时候,会到listen_overflow,对应的tcp协议的函数为: struct sock *tcp_v4_syn_recv_sock(struct sock *sk, struct sk_buff *skb, struct request_sock *req, struct dst_entry *dst){ .... if (sk_acceptq_is_full(sk)) goto exit_overflow; ...... } sk_acceptq_is_full里面判断full的队列长度是下面这三个参数中的最小值: 取三者中的最小值 /proc/sys/inet/ipv4/tcp_max_syn_backlog /proc/sys/net/core/somaxconn tcp listen函数调用时候传入的back_log 限于篇幅,就不给出这里判断队列是否为full的源码了。 修复方案 设置kernel参数 一开始笔者仅仅在server端设置了下面这三个参数(天真的以为dubbo考虑到了backlog,设置了一个较大的数值,其实其用了jdk默认的50) 注意,这边511是根据redis的建议值设置的 /proc/sys/inet/ipv4/tcp_max_syn_backlog 511 /proc/sys/net/core/somaxconn 511 /proc/sys/net/ipv4/tcp_abort_on_overflow 1 发现依旧有Close old netty client这样的错误日志,但是业务方确告诉笔者已经没有上线流量损失的情况了。笔者上去观察了一下情况,发现没有流量损失是由于如上图所述reset报文立马发回来,导致能够出错的时间窗口缩小为2s,而不是之前的第一笔必报错,2s内由于没有任何请求,所以大大减少了出错概率。如下图所示: 而创建连接和close old netty client日志的间隔都是小于等于两秒也证明了tcp_abort_on_overflow生效了 dubbo代码增加backlog的设置 由于dubbo用的是jdk默认的backlog(50),所以笔者在dubbo源码对应的部分做了调整,如下代码所示: public class NettyServer extends AbstractServer implements Server { ...... protected void doOpen() throws Throwable { ... // 可以从jvm参数中动态调整这个backlog String backlog = System.getProperty(BACK_LOG_KEY); if(StringUtils.isEmpty(backlog)){ // 默认为2048,这边调大点,反正改内核参数是即时生效的 backlog = DEFAULT_BACK_LOG; } bootstrap.setOption("backlog",backlog); ...... } } 将这个修改过的dubbo版本给业务方(server端)用了以后,再也没有对应的报错日志了,dubbo上线也平滑了。 总结 事实上,从开始分析问题到猜测要调整backlog所花费的时间并不长。但是笔者喜欢把所有的细节和自己的猜想一一印证,通过源码分析出来的过程图景能够将所有的问题现象全部解释,是一件很爽快的事情。 原文链接 https://my.oschina.net/alchemystar/blog/3098219

优秀的个人博客,低调大师

阿里云EMR3.2 hbase/phoenix客户端BUG

错误现象: 1. 今早在EMR3.2的生产新集群上执行导出操作,hbaseorg.apache.hadoop.hbase.mapreduce.Export safeclound.tb_ammeter /backup/tb_ammeter 1 1531843200000 1532016000000 2. 错误表现: 执行job任务显示: 2018-07-19 17:07:26,113 INFO [main] mapreduce.Job: Task Id : attempt_1529895044112_7775_m_000002_1, Status : FAILEDError: java.io.IOException: Cannot create a record reader because of a previous error. Please look at the previous logs lines from the task's full log for more details. at org.apache.hadoop.hbase.mapreduce.TableInputFormatBase.createRecordReader(TableInputFormatBase.java:174) at org.apache.hadoop.mapred.MapTask$NewTrackingRecordReader.(MapTask.java:515) at org.apache.hadoop.mapred.MapTask.runNewMapper(MapTask.java:758) at org.apache.hadoop.mapred.MapTask.run(MapTask.java:341) at org.apache.hadoop.mapred.YarnChild$2.run(YarnChild.java:164) at java.security.AccessController.doPrivileged(Native Method) at javax.security.auth.Subject.doAs(Subject.java:422) at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1727) at org.apache.hadoop.mapred.YarnChild.main(YarnChild.java:158) Caused by: java.lang.IllegalStateException: The input format instance has not been properly initialized. Ensure you call initializeTable either in your constructor or initialize method at org.apache.hadoop.hbase.mapreduce.TableInputFormatBase.getTable(TableInputFormatBase.java:585) at org.apache.hadoop.hbase.mapreduce.TableInputFormatBase.createRecordReader(TableInputFormatBase.java:169) ... 8 more 然后查看日志: Caused by: java.lang.ClassNotFoundException: org.apache.hadoop.hbase.ipc.controller.ServerRpcControllerFactory .... 解决方法(经联系阿里工程师,提供以下方案): 1. 创建客户端使用的hbase配置 > mkdir /tmp/hbase-client-conf > cp /etc/ecm/hbase-conf/* /tmp/hbase-client-conf > vim /tmp/hbase-client-conf/hbase-site.xml 删除phoenix相关的配置,保存: hbase.rpc.controllerfactory.class hbase.master.loadbalancer.class hbase.region.server.rpc.scheduler.factory.class hbase.coprocessor.master.classes 2. 执行命令时指定使用客户端配置 hbase --config /tmp/hbase-client-conf org.apache.hadoop.hbase.mapreduce.Export safeclound.tb_ammeter /backup/tb_ammeter1 1531843200000 1532016000000

优秀的个人博客,低调大师

hive2solr时count的一个bug

最近在测试hive导入solr,github上有个相关的代码 https://github.com/chimpler/hive-solr 其原理就是实现inputformat和outputformat,通过mapred来做数据的读写操作。 测试的表结构: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 showcreatetabletable_in_solr1; CREATEEXTERNALTABLEtable_in_solr1( idstringCOMMENT 'fromdeserializer' , cookie_id_sstringCOMMENT 'fromdeserializer' , first_url_sstringCOMMENT 'fromdeserializer' , warehouse_sstringCOMMENT 'fromdeserializer' ) ROWFORMATSERDE 'com.chimpler.hive.solr.SolrSerDe' STOREDBY 'com.chimpler.hive.solr.SolrStorageHandler' WITHSERDEPROPERTIES( 'serialization.format' = '1' , 'solr.column.mapping' = 'id,cookie_id_s,first_url_s,warehouse_s' ) LOCATION 'hdfs://xxxxxx:9000/bip/hive_warehouse/table_in_solr1' TBLPROPERTIES( 'solr.url' = 'http://xxxxxxx:8888/solr/userinfo' , 'transient_lastDdlTime' = '1401357066' , 'solr.buffer.input.rows' = '10000' , 'solr.buffer.output.rows' = '10000' ) 导入数据之后,进行count测试: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 selectcount( 1 )fromtable_in_solr1; EndedJob=job_1401419652664_0010witherrors Errorduringjob,obtainingdebugginginformation... ExaminingtaskID:task_1401419652664_0010_m_000000(andmore)fromjobjob_1401419652664_0010 Taskwiththemostfailures( 4 ): ----- TaskID: task_1401419652664_0010_m_000000 URL: http: //nfzm:8088/taskdetails.jsp?jobid=job_1401419652664_0010&tipid=task_1401419652664_0010_m_000000 ----- DiagnosticMessages for this Task: Error:java.io.IOException:java.lang.NumberFormatException:Forinputstring: "" atorg.apache.hadoop.hive.io.HiveIOExceptionHandlerChain.handleRecordReaderCreationException(HiveIOExceptionHandlerChain.java: 97 ) atorg.apache.hadoop.hive.io.HiveIOExceptionHandlerUtil.handleRecordReaderCreationException(HiveIOExceptionHandlerUtil.java: 57 ) atorg.apache.hadoop.hive.ql.io.HiveInputFormat.getRecordReader(HiveInputFormat.java: 243 ) atorg.apache.hadoop.hive.ql.io.CombineHiveInputFormat.getRecordReader(CombineHiveInputFormat.java: 526 ) atorg.apache.hadoop.mapred.MapTask$TrackedRecordReader.<init>(MapTask.java: 166 ) atorg.apache.hadoop.mapred.MapTask.runOldMapper(MapTask.java: 407 ) atorg.apache.hadoop.mapred.MapTask.run(MapTask.java: 340 ) atorg.apache.hadoop.mapred.YarnChild$ 2 .run(YarnChild.java: 160 ) atjava.security.AccessController.doPrivileged(NativeMethod) atjavax.security.auth.Subject.doAs(Subject.java: 396 ) atorg.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java: 1438 ) atorg.apache.hadoop.mapred.YarnChild.main(YarnChild.java: 155 ) Causedby:java.lang.NumberFormatException:Forinputstring: "" atjava.lang.NumberFormatException.forInputString(NumberFormatException.java: 48 ) atjava.lang.Integer.parseInt(Integer.java: 470 ) atjava.lang.Integer.parseInt(Integer.java: 499 ) atcom.chimpler.hive.solr.SolrInputFormat.getReadColumnIDs(SolrInputFormat.java: 38 ) atcom.chimpler.hive.solr.SolrInputFormat.getRecordReader(SolrInputFormat.java: 50 ) atorg.apache.hadoop.hive.ql.io.HiveInputFormat.getRecordReader(HiveInputFormat.java: 240 ) ... 9 more FAILED:ExecutionError, return code 2 fromorg.apache.hadoop.hive.ql.exec.MapRedTask MapReduceJobsLaunched: Job 0 :Map: 2 Reduce: 1 HDFSRead: 0 HDFSWrite: 0 FAIL TotalMapReduceCPUTimeSpent: 0 msec 而count(一个字段)是ok的。 从explain的结果来看。 count(字段)对比count(1)增加了Select Operator: 1 2 3 4 5 6 7 8 SelectOperator expressions: expr:id type:string outputColumnNames:id GroupByOperator aggregations: expr:count(id) 从job的出错信息来看,是由于类型转换出错导致,根据堆栈的信息,可以定位到出错的代码片段: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 atcom.chimpler.hive.solr.SolrInputFormat.getReadColumnIDs(SolrInputFormat.java: 38 ) 即: public static final StringREAD_COLUMN_IDS_CONF_STR= "hive.io.file.readcolumn.ids" ; public static final StringREAD_COLUMN_NAMES_CONF_STR= "hive.io.file.readcolumn.names" ; private static final StringREAD_COLUMN_IDS_CONF_STR_DEFAULT= "" ; private static final StringREAD_ALL_COLUMNS= "hive.io.file.read.all.columns" ; private static final boolean READ_ALL_COLUMNS_DEFAULT= true ; /** *Returnsanarrayofcolumnids(startfromzero)whichissetinthegiven *parameter<tt>conf</tt>. */ public static List<Integer>getReadColumnIDs(JobConfconf){ Stringskips=conf.get(READ_COLUMN_IDS_CONF_STR,READ_COLUMN_IDS_CONF_STR_DEFAULT); String[]list=skips.split( "," ); List<Integer>result= new ArrayList<Integer>(list.length); for (Stringelement:list){ //itmaycontainduplicates,removeduplicates IntegertoAdd=Integer.parseInt(element); if (!result.contains(toAdd)){ result.add(toAdd); } } return result; } 即在hive的map阶段,通过SolrInputFormat做数据读取时,hive.io.file.readcolumn.ids的默认值是空,如果没有字段名 ,就会产生空值,在Integer.parseInt(element)就会报错。 这点可以通过下面的代码进行验证: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 import java.io.IOException; import java.util.ArrayList; import java.util.List; public class ttt{ public static void main(String[]args){ Stringskips= "" ; String[]list=skips.split( "," ); System.out.println(list); List<Integer>result= new ArrayList<Integer>(list.length); for (Stringelement:list){ try { IntegertoAdd=Integer.parseInt(element); if (!result.contains(toAdd)){ result.add(toAdd); } } catch (Exceptione){ System.out.println(e); } } } } 本文转自菜菜光 51CTO博客,原文链接:http://blog.51cto.com/caiguangguang/1422733,如需转载请自行联系原作者

优秀的个人博客,低调大师

iOS 9.3.3修复bug外"隐藏特征" 运行更快更流畅

7月20日消息,据福布斯报道,苹果已经发布了iOS 9.3.3,在两个月之内发布了五个公开测试版,这是被广泛测试的iOS小更新之一,尤其是考虑到它表示只是一个小漏洞和安全补丁,但iOS 9.3.3让人激动的方面在于它还隐藏了一个伟大的秘密特征。 “伟大的特征”和“不可思议的惊喜”是我调查操作系统更新的最好特征/最大问题的两个常规方面。 苹果iOS 9.3.3实现了任何软件升级里反复但往往很空虚的承诺:“性能提升”。是的,很多用户发现iOS 9.3.3比之前的iOS9升级要快得多,论坛和社交媒体上很多升级了的用户表示他们的iPad、iPhones和iPod在升级后触控都更快更灵活反应更灵敏了。 例如推特用户@_b4mbii发推文表示“iOS 9.3.3让我的手机运行的更流畅了。”用户?@uc4des忍不住在推文中用表情符号称赞这一升级。 流行的MacRumors iOS论坛上也是赞美声一片,例如用户XTheLancerX写道“我*极力*极力推荐你更新至iOS 9.3.3,我的设备更好使用了。” 此外,升级用户表示他们发现玩游戏口袋妖怪(Pokemon Go)时运行的更流畅了。 当然并不是所有人都察觉到升级前后的差别,但很多用户对升级后设备运行速度赞不绝口,尤其考虑到iOS 9.3.3应该是iOS10(它将有重大改变)发布之前最后一个iOS9的升级版本。 ====================================分割线================================ 本文转自d1net(转载)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册