首页 文章 精选 留言 我的

精选列表

搜索[ThingsVis嵌入],共8585篇文章
优秀的个人博客,低调大师

嵌入式语音 AI 的完整实践路径:从设备到云的真实工程经验

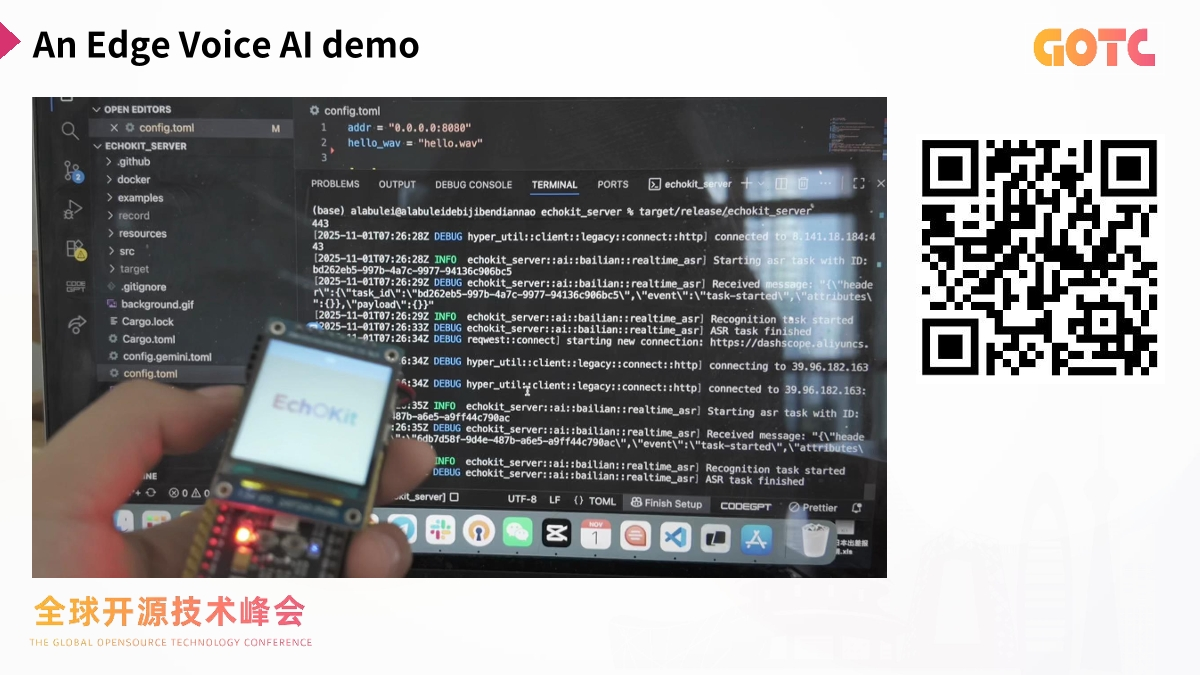
随着语音交互走进更多应用场景,越来越多团队开始探索「能跑得快、够可定制、还真能落地」的语音 AI 代理。而下面这份分享带来了一条完整的工程路径:从硬件到流式处理,再到端云协同,让语音 AI 真正具备可用性。 在现实工程中,语音 AI 的实现大致有三种形态: 本地运行,将模型直接部署在设备端,隐私好、响应快,但设备需要更强的算力。 远程服务,设备只负责录音和播放,将识别与生成完全交给云端。模型最强,但延迟与稳定性是主要风险。 混合模式,也是最常用的方式:本地处理 VAD、唤醒词、指令等即时任务,复杂推理解给服务器。延迟、成本、体验都更平衡。 分享从介绍硬件实践案例 EchoKit 开始。这是一套基于 ESP32 的低功耗设备方案,能承担本地的小模型任务,如 VAD 与唤醒词。同时,它配套的 EchoKit Server(由 Rust 编写)能在云端或局域网中调度本地与远程 AI 服务,通过一个简单的二进制文件与 YAML 配置完成部署,支持容器化运行。对于构建语音设备的团队来说,硬件与服务端协同的能力尤为关键。 不过真正的挑战来自延迟控制。 如果按串行流程执行:VAD → 上传 → ASR → 推理 → 工具调用 → TTS → 下载,整套流程可能耗时 17~74 秒。这种速度显然无法用于实际交互。 而通过流式处理,整个体验完全不同。音频边上传边处理,ASR 几乎在 1–2 秒内给出第一句文本,LLM 与 TTS 也能同步产出第一批结果,把总交互时间压缩到 6~9 秒。再配合更快的模型与 KV cache 优化,时延可进一步降低至约 2 秒。甚至在更高级的流式架构中,ASR 输出可以直接构建 LLM 的 KV cache,让模型在一句话还没说完时就提前开始推理。 当然,流式能力的基础是稳定的音频传输。0.5 秒的语音分片必须严格在 0.5 秒内完成上传与下行,否则会明显卡顿。相比 WebSocket,WebRTC 在流媒体传输上更可靠,而实际应用中诸如 Agora 的实时网络可进一步减少抖动,保证交互顺畅。 最终目标是实现:0.5 秒级别的端到端响应。 完整内容查看:https://www.oschina.net/doc/486

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册