业务数据迁移上云的一些技术思考
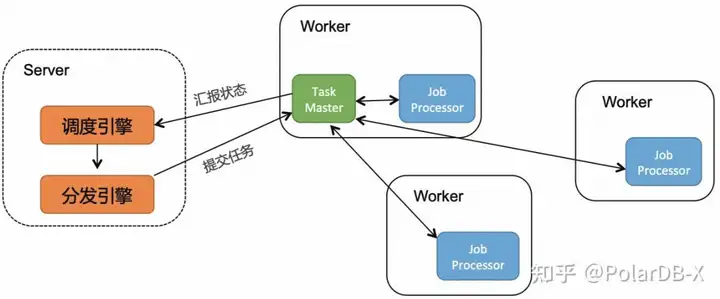
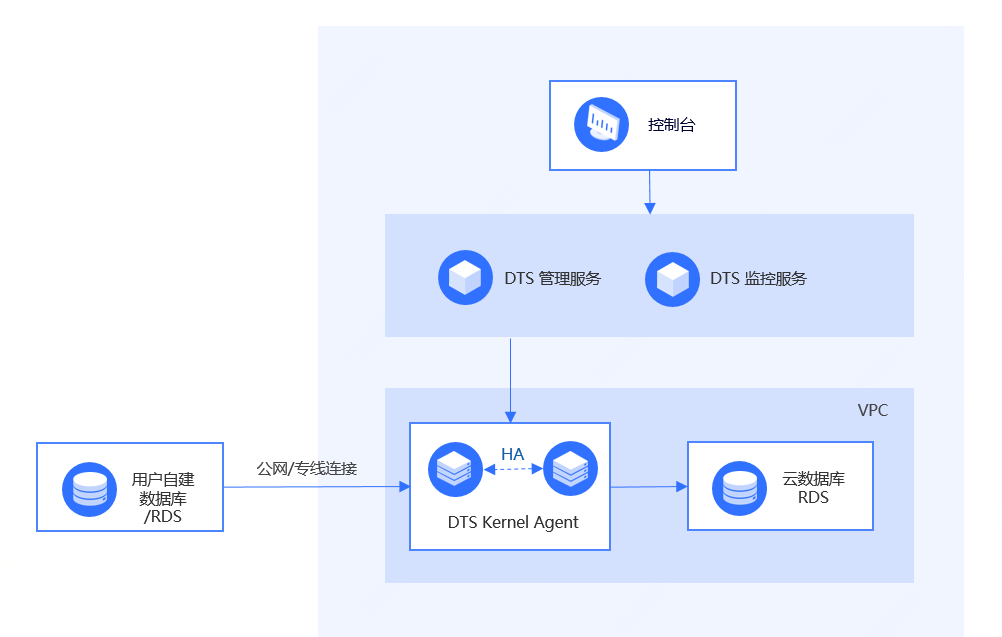
前言 在支持京东集团内部及京东云外部客户的业务迁移到京东公有云及京东私有云、京东政务云的过程中,京东科技-京东云事业群-技术服务组积累了相关业务系统数据迁移的一些管理和技术经验,以案例的形式分享给大家,希望对大家的业务迁移工作有所帮助。 迁移前的准备工作 业务迁移上云涉及到的业务数据种类繁多,主要类型包括: 数据库: 关系型数据库 MySQL 、PG、Oracle等 对象存储: 标准S3接口对象存储迁移中间件数据:ES、mongoDB、redis等 文件存储: 文档、图片等非结构化数据 大数据: HBASE、HDFS files等 京东云的内外部客户在上云过程中,大部分业务均涉及到以上多种数据类型,基于相关迁移的案例所积累的经验,数据迁移需要在迁移启动前至少做好如下准备工作。 1、可执行的数据迁移技术方案制定完成,包含明确的迁移操作步骤(迁移前准备工作,迁移操作、迁移后校验工作)、执行人、确认人。 2、制定迁移应急预案及回切方案,明确责任矩阵,确认异常情况的决策条件及决策人。 3、确认数据安全等级,确认数据迁移的方案合规安全,通过相关业务安全部门审核。 4、迁移时长及割接数据同步窗口的评估(以POC验证数据信息为基础制定),确认各个业务及数据迁移可选的第二方案。 5、 确认网络带宽及质量满足迁移需求。 案例分析 下面是几个案例,涉及到了不同数据迁移的场景。 一、关系型数据库 MySQL: MySQL在迁移中最为常见,也有很成熟的迁移工具和迁移方案,包括官方工具和相关开源工具,如mysqldump等,各个云厂商也都有各自的DTS迁移工具。 DTS工具: DTS服务在传输及同步、数据校验等步骤都实现了一定的抽象化,具有相对友好的交互界面,同时可以实现多个任务并行进行,对要求平滑迁移的场景,具有自动化优势,节省大量人力,有部分DTS工具可以实现跨版本迁移。 DTS的限制是: (1)源端数据库与目标端数据库与DTS管理服务IP网络互通,并具备稳定的网络连接。 (2)数据库需要满足一定的前提条件才能实现迁移后的增量同步功能,通常的需求是权限需求,比如REPLICATION SLAVE,REPLICATION等,同时存储过程及函数在全量+增量的场景下不会被包含,在全量迁移阶段,不支持 Alter Table、Drop TableDDL操作,**不同厂家的工具限制条件可能不同,需要仔细阅读产品说明,并通过POC验证功能。 mysqldump工具: 适合的场景,数据库源端与目的端没有良好网络连接或无网络连接的情况下,允许有一定的业务中断时间,则在停机窗口完成数据导出、导入是比较适合的方案(如果具有主机级别的管理和控制能力,直接将数据库主机整体以镜像方式迁移也是一个可行的迁移方法)。 Mysqldump导出导入速度相对DTS要快(本地操作,而且与DTS相比,少了一些中间环节),但是多了一个数据文件压缩及通过网络或移动介质传送的时间。 其他开源及商业工具,如streamset等,可以支持mysql到异构数据库的同步,功能比较强大,同时限制也比较多。 迁移时长的估算: 业务割接过程中,业务数据的迁移及同步是切换前的重要步骤,也是割接过程中耗时较长,容易出现错误并导致割接延时或失败的环节,因此要对数据迁移及同步耗时做出靠谱的估算。 数据库同步,是表级别的并发来迁移全量数据,因此,DTS得结合实际的数据类型、数据行数、网络带宽、网络延迟、同步实例规格,库表的数量、单库表的大小等因素评估时长。 举例来说,数据库大小 500G,有5张表,其中一个单表400G,剩下4张表 各25G,因单表400G相对较大,迁移时长会拉长。如果是5个100G的表,迁移时长会缩减。 在正式迁移生产数据前,一般会有对测试环境的迁移POC,来验证和评估生产环境的切换流程及耗时,制定生产业务割接的计划时,要以这个时间为数据库迁移的时长依据。 京东云DTS数据迁移同步架构如下图: 案例一 从友商公有云迁移到京东公有云云,由于源端binlog问题导致的一次DTS迁移到手动迁移方式的转换。 项目条件,业务具有8小时的停服时间,因此在迁移技术方案DTS及手动导数据库都是可选方案,鉴于DTS的不停服及数据增量功能特性,我们选择在停服前开始通过京东云DTS服务同步历史数据,并开启DTS增量同步功能,基于停机窗口,我们给数据库在线迁移及增量同步的时间为4小时,DTS服务不影响在线业务,基于测试环境的迁移经验及评估。 在停服前的下午,为了给迁移留出足够的时间缓冲,我们提前启动了主数据库的DTS服务,数据库迁移进程正常进行,预计迁移时长为4小时,但是在DTS服务最后阶段,因源端binlog问题,出现了一个致命错误,导致DTS任务失败。 Migration Task Run Error ERROR 1236 (HY000): The slave is connecting using CHANGE MASTER TO MASTER_AUTO_POSITION = 1, but the master has purged binary logs containing GTIDs that the slave requires. Region: cn-north-1 ClusterGID: dts-r1rroa ERROR 1236 (HY000): The slave is connecting using CHANGE MASTER TO MASTER_AUTO_POSITION = 1, but the master has purged binary logs containing GTIDs that the slave requires. 因为最终binlog错误(部分binglog丢失),DTS任务无法恢复,最终DTS传输的4小时时间被浪费,因迁移是系统工程,其他数据迁移进程也都在根据计划推进,此时大家都没有时间去分析具体原因。 因到晚上客户业务已经推送通知并停服,此时业务迁移的其他数据迁移及业务调试已经开始。 所以,当机立断决定以mysqldump模式导出文件,本地导出速度很快(20M/s),压缩后的数据库导出文件体积缩小,减少了网络传输耗时。通过网络传输到京东云侧的云主机,然后source方式导入RDS。导出、传输、导入整个过程耗时小于2小时。 导入MySQL数据后,根据迁移流程做迁移数据校验,使用checksum_table工具对源端和目的端数据库做对比。 源库信息:—src-host sourceIP —src-user user —src-pass pass 目标库信息:—dest-host targetURL —dest-user user —dest-pass pass 验证过程中,发现部分表不一致,与业务方确认为源端在迁移开始后,停止服务不彻底导致,仍然有数据写入操作,因为业务侧并没有根据迁移规范检查mq、kafka的消息产生情况,只是停止了部分服务,后经业务及研发检查新增数据,对部分数据做清理后,完成数据库的迁移工作。 根据项目经验,这种DTS服务因binlog问题导致的失败情况并非个案。 准备工作 (1)为数据库迁移准备一个备选方案并准备好应急预案。 (2)出现问题时,决策条件及决策人提前确认,在实施过程中能根据需要及时决策做出调整。 厂商改良(非原生)的数据库的迁移: 在某些云厂商的特定数据库版本中,会对标准的数据库产品如mariaDB、PG等数据库做一些定制化的开发,以满足客户的业务的某些特殊需求,这种数据库属于厂家深度绑定的类型,在做业务迁移或灾备数据同步的时候,根据时间场景做定制化的迁移及同步方案,大部分需要从研发层面做一些定制化的配置和操作。 案例二 某金融用户,原系统运行于T的金融云,使用了定制化的RDS服务,因金融行业的业务及数据灾备规范,需要做异地容灾,目标为实现业务级别灾备,将灾备系统运行于京东金融云平台。 为实现从T云定制化的TDSQL到京东云的迁移,对源端的数据库做了详细调研,因为源端是定制化的、具有自动水平拆分、Shared Nothing 架构的分布式数据库,因此使用京东云的DTS工具不适用于这个场景,同时,在两个环境,要求数据基本为实时同步才能满足业务容灾的需求。 制定方案 在制定数据同步方案时,也对传统灾备厂商的方案做了调研,因传统厂商灾备方案多以主机级别数据及IO分析或日志分析为基础,需要做一些侵入式agent的安装,与云上RDS的场景无法适配,相关厂商也表示正在做向云上灾备的转型,但尚未有成熟落地的产品(适配难度较大),因此最终方案采取了基于gtid的主从复制的方案来实现数据库的异构云同步,屏蔽了架构差异带来的问题。 注意:涉及业务信息及底层操作的部分内容已经隐去。 首先对源端做权限调整: GRANT SELECT, RELOAD, SHOW DATABASES, EXECUTE, REPLICATION SLAVE, REPLICATION CLIENT, SHOW VIEW ON.TO ‘user’@’192.168.%’ 对源端做全量的逻辑备份: mysqldump –h xx –uusername -p –database nx_db -f —single-transaction —master-data=2 —skip-lock-tables > /data1/bs.dmp 注意导出文件中要有gtid信息。 灾备端导入: mysql –h xx -f –uusername -p < bs.dmp 后台做复制配置: set gtid_slave_pos=’0-13381-1xxxx06’; CHANGE MASTER TO MASTER_HOST=’sourceIP’,MASTER_USER=’username’,MASTER_PASSWORD=’*‘,MASTER_USE_GTID=’slave_pos’; 同步验证 数据验证 (1)业务侧停止写操作,在T云侧和京东云侧分别通过checksum table tablename对关键表做校验。 (2)业务侧在T云/京东云两边分别执行命令,对表/view等做数量校验: select count(1) from information_schema.tables where table_schema=’nx_db’; select count(1) from information_schema.views where table_schema=’nx_db’; 业务测通过创建测试表/增删改查等操作验证ddl/dml是否正常复制。 基础功能验证完成后,还需进一步验证源端数据库主从切换以及网络中断对数据库同步的影响,对源端数据库的日志配置,要提出Binlog本地保留时长需求(不少于48小时),避免网络中断时间过长导致的日志过期 而影响数据库的同步业务。 为保障数据及业务灾备的可靠性,需要对网络专线做实时的监控及告警配置,当出现网络问题时,需要能及时收到告警,第一时间处理,避免中间专线网络中断对灾备业务的可用性的影响。 POC验证期间曾经对网络影响进行中断测试,中断2小时,后续观察数据仍能正常同步追平,能够容忍实际业务中可能出现的网络中断造成的影响。 对源库的保护 在这个异构云容灾的案例中,因为与源端云是通过专线做了网络互通,而源端的数据库是通过IP方式访问的,因此,在应用主机整体迁移到京东侧后,主机仍然可以通过网络访问到源端数据库,这样有可能对源端库的写操作,为阻断对源端数据库的访问,可以采用主机安全组方式,阻断主机对外部3306端口的访问,或通过子网级别的ACL,限制对指定网段的特定端口的访问,在应用配置调整后,数据库连接指向改变后,再调整安全组条目或ACL策略,放开对应的访问权限。 因部分数据库的子网规划问题,使用ACL可能对数据库同步造成影响,因此在此案例,为业务主机创建一个附加安全组,配置3306端口阻断策略,实现了对源端数据库的访问保护。待业务调整完成后,解除安全组,即可实现业务数据的正常写入。 二、ES迁移 ES应用越来越广泛,业务迁移中,ES数据迁移已经成为数据迁移的一个重要部分。 ES迁移技术涉及停服迁移及不停服迁移,不停服迁移对迁移的源端和目的端网络及服务有很多要求,目前实现起来尚有很多限制,目前一般只在集团内部业务做ES不停服迁移。 通常停服迁移技术路径可选择reindex或snapshot方式及logstash方式,几种方式均要参考官方对版本的要求,选择满足版本要求的迁移方式。 Snapshot方式: Snapshot方式,从源ES集群创建数据快照,然后在目标ES集群中进行恢复。创建快照前必须先创建repository仓库,一个repository仓库可以包含多份快照文件。repository支持S3及共享文件存储系统等,自建的ES可以使用共享文件存储(从速度、成本等因素考虑,是最佳选择),使用公有云ES服务的建议采用支持S3协议的对象存储。 从速度和效率上来讲,快照方式优于reindex,当不需要对源端做任何变更,且网络存储条件具备时,优先选择快照方式迁移ES。 reindex是Elasticsearch提供的一个api接口,可以把数据从源ES集群导入到当前的ES集群,实现数据的迁移,reindex适用于数据量较大,有索引调整需求或无法连接共享存储的迁移场景,以及只需要迁移部分数据的场景。 reindex方式需要目标端能够访问到源端ES的服务端口。 案例三 客户业务从友商云迁移到京东云,源端ES为K8S集群自建服务,服务访问方式为nodeport方式,因为安全原因,限制访问方式为内部业务主机访问,服务未通过互联网对外开放。 选择迁移技术方案,源端自建的ES未安装S3插件,考虑到快照方式迁移需要源端安装S3插件,而通过POD方式部署的业务需要重新制作镜像并更新应用,从时间及工作量上考虑不是最佳选择,因此采取reindex方式来做业务数据的迁移。 为实现从京东云侧对ES的数据拉取,在源端配置一个nginx反向代理,实现了通过公网对内部ES接口的访问,同时配置白名单,限制访问IP为京东侧NAT网关出口的公网IP,确保数据的访问安全。 在京东云侧,因生产环境子网未配置公网出口,为临时拉取数据,满足迁移需求,调整路由表,配置明细路由,将源端公网IP配置到对应子网的路由表中,指向NAT网关,临时打通公网连接,通过NAT网关可以拉取到源侧的ES数据,并在ES服务中对源端的公网IP做加白操作,注意加白操作会重启ES服务。 为满足网络通信需求,临时配置ES子网的明细路由,完成数据迁移后需删除明细路由。 迁移前,确认相关迁移条件已经具备: 源端及京东云ES服务均创建对应索引,需要确认云上索引是新建的,源端与目的端的mapping可以一样,也可以不同,通过reindex,可以实现修改mapping后的字段类型。 可以从京东云侧ES访问到源端云侧服务的ES的服务端口,验证方式,telnet或curl -XGET http://:9200方式验证均可。 在源端创建索引: 源ES集群 1.创建索引(示例) PUT 11_index_11 { “mappings”: { “user”:{ “properties”:{ “name”:{“type”:”text”}, “title”:{“type”:”text”}, “age”:{“type”:”integer”} } } } } 2.写入数据(示例) POST 11_index_11/user { “title”:”manager”, “name”:”XP”, “age”:22 } 目标端ES配置 1.创建索引(示例) PUT 11_index_11 { “mappings”: { “user”:{ “properties”:{ “name”:{“type”:”text”}, “title”:{“type”:”text”}, “age”:{“type”:”integer”} } } } } 2、配置 reindex.remote.whitelist 参数,指明能够reindex 的远程集群的白名单,并重启目标端集群服务。 3 、reindex迁移数据 POST _reindex(示例) { “source”: { “remote”: { “host”: “http://sourceIP:9200“, “socket_timeout”: “1m”, “connect_timeout”: “10s” }, “index”: “11_index_11” }, “dest”: { “index”: “11_index_11” } } 迁移后,做数据校验,完成ES的数据迁移。 三、对象存储的迁移 对兼容S3协议的对象存储数据迁移,各个公有云厂商(包括部分传统灾备厂商)均有迁移工具或脚本,迁移技术难度不高。但是,因为不同厂家的对象存储在不同region可能存在底层版本及配置差异。 因此,同一个工具或脚本,在处理不同区域的对象存储数据时,可能会出现文件访问问题,在做迁移前后,需要对迁移的数据做完整性和可用性校验。 对象存储迁移的一般顺序: 1、目标端配置镜像回源,保证读404可以回源拿到数据 2、使用迁移工具迁移源端的历史数据 3、同步后的数据校验 实际迁移中,因为涉及到增量数据的同步(迁移工具支持对transfer.coverFile的参数设置,是否覆盖文件,因此也可以做到增量复制),因此,应根据项目实际的数据存储量、业务访问特性、业务停机窗口等信息,综合考虑迁移流程和选择技术方案。 案例四 某业务从友商云迁移到京东云,涉及到对象存储迁移,源端文件数量约为1000万级别,迁移前,先对源端对象存储做文件list,检查迁移工具list数据与对象存储实际数据能够匹配,然后通过迁移工具做迁移操作,因文件量较大,而且业务每天都有新数据上传,要保证所有文件都正确同步。因此采用的的历史和增量数据同步方案为提前一周做全量迁移,然后通过镜像回源同步新增文件。 割接前一周做全量迁移 1、 在割接一周前,利用京东云的osstransfer迁移工具进行全量迁移。 2、 迁移后会生成一个以源oss的bucket命名的.list.txt的文件,此文件里含用源oss bucket的所有文件的清单。 3、 迁移日志会生成在迁移的工具包log目录下,相关log说明(log文件很重要,迁移完成后做了一个异地备份): 迁移的所有文件将记录在audit-0.log中 迁移成功的文件记录在audit.success中 可以用命令grep “1$” audit-0.log查看迁移失败的文件 用生成的源oss的清单文件列表的txt文件中的文件数量和audit.success文件中的文件数量进行对比,如果数量一致说明全部迁移成功。 文件list获取配置示例: 割接当天进行全量迁移后的增量迁移 1、 利用osstransfer工具生成源oss的清单文件列表。 2、 从文件列表清单中找出全量迁移至增量迁移这段时间内新增加的文件。 3、 开启oss的镜像回源。 4、 使用curl访问新增加的文件(要访问目标端oss),进行新增文件的镜像回源。 实际迁移中遇到了问题: 在POC阶段,做测试环境数据迁移时,采用这个方案验证一切顺利,但是在生产环境割接时,遇到了问题,判断增量文件所需的list清单出现循环错误,导致list任务一直运行中,而list的清单有大量重复内容。 迁移软件版本与测试环境迁移使用的版本一致,而生产环境中,迁移软件在一周前的全量同步的使用也是一切正常。数据也正常同步到了京东云的对象存储中,割接时需要的是通过回源方式获取一周内新增的文件,如果list文件不正确,会导致增量的数据同步无法进行。 问题处理 业务割接时间有限,迅速升级问题,将问题反馈到工具软件的研发同事,研发同事迅速投入排查(已是凌晨,为京东研发同学的敬业精神点个赞)。经过研发同事排查,发现源端的友商云上,测试环境使用的对象存储与生产环境的对象存储位于不同区域(zone),而友商云的生产环境对象存储所在区域的OSS接口在本周做了调整,导致原有工具list出现错误。 研发同事紧急更新一个工具包提供给迁移现场同事,解决了对象存储文件list循环错误问题,顺利完成了文件list检查,通过对比前后生成的list文件,获取到新增的文件列表。配置镜像回源,通过脚本同步了一周的新增文件,校验无误后,配置业务应用启用对象存储,业务启动及验证工作继续正常进行。 四、redis迁移 业务中Redis使用有两种场景,一种是仅作为缓存,不做数据持久化,这种业务场景,迁移后在新环境部署业务后直接调整业务指向新的redis实例即可,一种是有数据持久化,这种业务在迁移到云上时,需要根据业务需求,做redis数据的迁移操作。 Redis有rdb(point-in-time snapshot)和aof两种持久化方案,其中rdb模式是二进制格式,类似于快照,恢复直接覆盖,aof保存的是命令(文本格式),类似于追加模式,如果需要保留目标端的redis的数据,可以使用aof方式,aof方式需要把源端redis做停写操作。Redis加载RDB恢复数据速度快于AOF的方式,但要注意老版本Redis服务不兼容新版RDB格式,因此RDB模式不适用降级的迁移或恢复。 在业务迁移时,需要根据redis的使用场景、源端与目的端版本要求,数据存储、网络条件等选择适用的redis迁移工具。 Rdb及aof的迁移,官方有详细的说明(bgrewriteaof/bgsave/redisdump等),使用也相对简单,因此本文不多做介绍。 京东云研发了redis的迁移工具redissycner(目前支持自建redis业务迁移),通过模拟redis的replication协议,提供redis迁移及同步。 Redissycner通过docker部署方式: git clonehttps://github.com/TraceNature/redissyncer.git 进入目录docker-compose up –d 下载客户端软件:wgethttps://github.com/TraceNature/redissyncercli/releases/download/v0.1.0/redissyncer-cli-0.1.0-linux-amd64.tar.gz 调整配置文件:.config.yaml syncserver:http://x.x.x.x:8080(docker服务地址) token: xxx 注意token文件内容需要在容器中确认。 编辑配置文件后即可启动服务,通过编写要执⾏的任务json来配置操作环境。 { “sourcePassword”: “xxxx”, “sourceRedisAddress”: “10.0.1.101:6379”, “targetRedisAddress”: “10.0.1.102:6379”, “targetPassword”: “xxxx”, “taskName”: “testtask”, “targetRedisVersion”: 4.0, “autostart”: true, “afresh”: true, “batchSize”: 100 } redissyncer-cli -i redissyncer-cli > task create source ./task.json 五、数据备份的重要性 数据备份是在业务迁移的全生命周期怎么强调都不过分的环节(也包括迁移后的一段时期),因数据备份不充分导致数据丢失、业务受损的教训很多,但是,在迁移实施过程中,因忽视数据备份而导致出现问题的事件仍然很常见。 问题可能来自客户,可能来自我们实施团队,也可能来自ISV或者其他可能操作数据的团队或个人。有些问题是因为迁移各个责任方的沟通不充分、宣贯不到位或技术不过关导致,有些是误操作导致。 实际场景中数据备份实施的压力或阻力,主要来自存储空间不足以及备份过程可能造成的对性能的影响。 除了备份的数据文件需要占用存储空间,数据库文件的可用性、一致性验证,同样会占用大量的存储空间(临时),因此在实际迁移过程中,对存储空间的需求,可能会大于现有数据库的数据量的2倍(源端及目标端都是如此)。因此,在重要业务场景中,迁移前,需要对数据备份所需的存储空间做好评估并考虑备份空间的成本。 案例五 某局委办业务由vmware环境迁移到政务云,在迁移前,笔者为客户做了所有迁移主机的整机备份(导出到vmware外部的外部存储中),事实证明这些环节(准备存储环境、沟通vmware运维方、数据导出耗时等)导致的成本增加是值得的。 迁移过程很顺利,在业务迁移到政务云正常服务完成业务交接大约1个月后,接到客户电话,希望能够通过迁移前备份的主机恢复数据。 问题原因 原因是一个ISV在新环境做业务升级时,安排了一个没有经验的新人,把数据库软件做了重新安装,并删除了原有数据。在协助客户通过备份的镜像恢复数据后(历史数据,新增数据部分由ISV做了增补操作),客户购买了政务云提供的灾备服务,开始定期对重要主机和数据做全量及增量备份,通过云上的容灾服务来避免或减少业务错误或误操作造成的损失。 六、业务数据迁移总结 1、提前做好备份,有了备份数据,迁移过程的压力会减小,相对宽松的迁移氛围对迁移实施很有利。 2、迁移技术及工具的选择,现在数据迁移工具越来越多,各个大厂也都有自己的工具,但是产品的限制及兼容程度各有不同,需要根据业务性质选择并验证。 3、准备回退预案,做好POC验证,POC能发现部分问题,提前准备解决方案。 4、做好流程手册,明确操作责任人,联系相关部门做好迁移的切换阶段的护航准备。产品和服务类的问题一定要能找到人支持。 5、明确责任矩阵、进行全面沟通,沟通能够发现技术层面很难发现的问题,越早建立迁移组织并形成有限的沟通机制,对迁移的顺利实施越有利。