首页 文章 精选 留言 我的

精选列表

搜索[AI产设研一体],共10000篇文章
优秀的个人博客,低调大师

OPPO自研云原生分布式任务调度平台

1.概述 在软件开发过程中,经常会遇到需要执行定时任务的场景。目前业界执行定时任务的分布式任务调度平台主要有XXL-Job和Elastic-Job,两者都属于轻量级的调度平台,能满足一定任务数量的作业同时调度,但是如果任务调度量增加到1万TPS甚至10万TPS,就会遭遇性能瓶颈,出现很多超时任务。 在OPPO内部,有些业务部门存在海量作业同时调度的场景,目前业界的任务调度框架难以满足业务需求,所以OPPO公司的中间件团队自主研发了一个分布式任务调度平台CloudJob,它是一个高性能(百万级TPS),低延迟(毫秒级),统一,稳定,精准并满足复杂多样定时任务场景的调度平台。它的特点如下: (1)简单:用户可以通过页面对任务进行CRUD操作,也可以通过提供的SDK对任务进行管理,方便快捷。 (2)动态:支持动态修改任务状态、启动/停止任务,以及终止运行中任务,即时生效。 (3)一致性:“调度中心”通过分布式锁保证集群分布式调度的一致性, 一次任务调度只会触发一次执行。 (4)高性能、低延迟:支持百万级任务同时调度执行,且延迟在毫秒级。 1.1 和开源产品对比 CloudJob设计的初衷是为了支持海量任务同时调度,它和其它任务调度平台的对比如下: 对比内容 Elastic-Job XXL-Job CloudJob 执行定时任务的方式 通过quartz触发任务执行,任务量大时会有延时 采用轮询jobtrigger的方式调度任务,任务量大时会有延时 轮询数据库的触发消息,作业进行了分片,任务量大延时很低 多节点部署时任务不能重复执行 支持 支持 支持 弹性扩容缩容 通过zk实现各服务的注册、控制及协调,当任务很多时zk会成为性能瓶颈 使用quartz基于数据库的分布式能力,服务器超出一定数量会给数据库造成压力 通过分片可以支持系统的横向扩展,扩容缩容方便快捷 日志可追溯 支持,可通过事件订阅的方式处理调度过程的重要事件,记录信息在数据库中可查询 支持,有日志查询界面 支持,通过链路追踪的方式记录执行过程,可以同界面查询历史记录 高可用 去中心化的调度方式,通过zookeeper来进行选举、调度。如果某个实例失败,会选举其它实例来执行 “调度中心”通过DB锁保证集群分布式调度的一致性,一次任务调度只执行一次 集群内部的定时任务通过Elastic-Job来执行,保证内部任务的高可用;通过redis缓存记录调度信息,保证作业不会重复执行 1.2 CloudJob的性能 在公司内部对CloudJob进行了多轮性能测试,通过对测试数据进行分析,CloudJob的性能如下: (1)低时延:CloudJob在处理TPS为50W的作业调度时,99.11%的作业调度延时在1秒以内;CloudJob处理上亿次调度,最大调度延时不超过2.4秒。 (2)高性能:对比Elastic-Job的单个执行器执行上千个任务就会出现大量延时,CloudJob的单个执行器处理上万个任务仍然可以保证毫米级调度任务而不超时。 (3)扩展能力强:性能测试场景TPS由10万增加到50万,系统只需要按比例增加执行器个数,依然可以保证作业正常调度而不出现严重超时。 (4)高可用:测试过程中将某个执行器宕机,该执行器的作业可以转移到其它设备调度,并且调度延时最大不超过3秒。 2.系统架构 CloudJob的总统架构如下: 2.1 名称解释 作业元数据:指作业执行的时间规则以及业务执行需要透传的参数,存在于mongodb数据库及缓存中。 作业触发消息:指作业按照时间规则计算出的产生触发执行动作的每一条记录,包含作业主键和执行绝对时间时间戳,比如每5s执行一次任务,第5s和第10s是两个触发器。 执行器:用于扫描符合条件的作业触发器的服务所在的容器。 分片:为了让系统可以横向扩展,需要将作业划分到不同的分组,每个分组就是一个分片,同时每个执行器设置一个分片属性(和作业的分片属性相对应),执行器只处理自己所在分片对应的作业。 定时任务执行周期:运行在执行器的定时任务每隔多久运行一次。本方案中该值的设置主要和触发器存储选型有关,应该设置合适的频率,避免过于频繁导致写入和存储触发器时延时较大,同时也不能因为过大,导致一些本应该执行的任务不能被及时获取,出现触发延迟太多。 时间窗口:定时任务扫描触发器的时间条件,选出将来一定时间范围内的数据。注意这个窗口最好不一定等于定时任务的执行周期。 2.2 服务模块组成 作业管理服务:负责作业增删改查,用户可以通过作业管理服务将作业注册到平台,平台将作业持久化到mongodb数据库并在redis中缓存。 执行器负载监控服务:在CloudJob平台中每个执行器会处理一个数据分片,执行器负载监控服务会将作业划分到不同分片,分片内作业数量将维持在合理的数量范围,保证作业按照时间规则发送而不延迟。该服务负责分片的作业容量管理以及分片扩缩容等功能。 触发器存储:支持可插拔的存储,提供高可用方案,保证数据零丢失。 触发器定时任务:执行器定时执行的操作,主要是扫描mongodb数据库,生成作业触发消息。 执行记录存储:记录发送到业务MQ 的消息,核对是否有漏发送、发送是否有延迟等,发现系统可能存在的问题并及时对整个系统完善优化。 执行记录可视化:通过页面查看、查询作业的历史记录,查看作业是否超时,是否由漏执行。 通过对上面几个服务模块的说明,可以看出作业在系统中的流转过程如下: 用户先通过作业管理服务将作业注册到mongodb数据库中,并通过redis来缓存作业。执行器负载监控服务对新添加的作业设置分片,获取当前系统未饱和的最小分片,将这个分片的id设置为这个作业的分片,同时将分片对应的作业数量加1。多个执行器会根据设置好的分片参数定时从mongodb数据库中扫描出符合条件的作业,然后根据作业的时间表达式生成作业触发消息,然后将触发消息写入到时间轮中,最后在作业达到执行时间时将作业的基本信息投送到消息队列中,让用户从消息队列取出消息并执行自己的业务逻辑,从而达到触发作业调度的目的。 3. 数据流转举例 定时任务按照执行次数可以分为固定周期类型和固定延迟类型。固定周期类型是指作业按照一定的周期每隔一段时间执行,固定延迟类型是指会在延迟一段时间后,执行一次,随后就不会再执行。下面举例说明这两种类型的任务是如何流转的。 3.1 固定周期类型 用户创建了一个固定周期类型的任务,每隔5s执行一次,携带的参数为 CRON 0/5 * * * ?* 其它透传参数 作业管理服务先投递到MQ 普通消息。消费者持久化该条数据,获得主键jobpk1,计算出来该定时任务后续的触发时间戳为1612493460,存储到触发器的存储中,必要字段为: JobId 1612493460 执行器上的定时任务在做扫描时,扫描到了该条触发器数据,判断是否到了预期投递时间,如果已经到了直接投递到业务MQ,否则将它压入内存时间轮中,时间轮中到了预期投递时间,再投递到业务MQ。再计算下次触发时间戳为1612493465,将redis 中的数据修改为: JobId 1612493465 执行器上的本轮定时任务处理完毕后1,处理下一轮:拉取到1612493465 这一次时间戳,随后重复上面的逻辑,或者发送MQ 消息或者压入时间轮,依次往下。 3.2 固定延迟类型 用户创建了一个固定延迟类型的任务,再15s钟之后执行,携带的参数如下 FixDelay 15000 其它透传参数 作业管理服务先投递到MQ 普通消息。消费者持久化该条数据,获得主键jobpk1,计算出来该定时任务后续的触发时间戳为1612493475,存储到触发器的存储中,必要字段为: JobId 1612493475 执行器上由cloudjob 调度的定时任务在做扫描时,扫描到了该条触发器数据,判断是否到了预期投递时间,如果已经到了直接投递到业务MQ,否则将它压入内存时间轮中,时间轮中到了预期投递时间,再投递到业务MQ。由于是固定延迟,没有下次执行,将redis 中的数据修改为: JobId 0 执行器上的本轮定时任务处理完毕后,处理下一轮:拉取的时间戳要大于0,则这个作业以后不会被扫描到。在异步记录任务时,会将该redis 中为0 的这个member 删除,并把元数据该作业的状态设置为完结。 4. 服务部署及实施流程 通过前面的介绍大家知道了CloudJob的工作原理,下面通过几个模块的部署来说明一下具体的实施过程。 4.1 作业初始化 业务的作业通过作业管理服务接口批量注册。作业管理接收到请求后发送到MQ 普通消息,由消费者完成如下步骤: 由于作业总数百万级别,需要将作业划分到不同分片上,每一个作业在注册进来时需要 获取到尚未饱和的分片。分片的数量是由执行器负载服务管理的。假设一个分片的负载容量为1万,在分片承载的作业没达到1万之前,作业都可以被分到这个分片上。如果达到这个阈值,分片被设置为饱和状态,需要分配新的分片,新的作业将被分配到新的分片上。具体过程如下: 假设新增一个5s 执行一次的作业时,获取到了sharding1 分片,将会在DB 中存储元信息同时缓存元信息。数据为 主键 时间表达式 分片 版本 JobId CRON 0 0/5 * * * ?* Sharding1 0 Version0 表示该作业元信息是首次存入,以后每修改一次这个version 递增。计算下次触发时间并在触发器缓存中存入如下数据:zset 名称sharding1,member 为jobpk1_0,是作业主键和version 的组合,可以采用高位存主键,地位存版本号的方式。score 为下次触发时间戳1612493460。 4.2 执行器高可用 执行器会定时扫描mongodb数据库,从数据库中获取符合条件的任务,这个定时任务是由Elastic-Job来分配执行的,Elastic-Job将分片分配到了各个执行器中,假设是下面这种分配模型:两个执行器均分了两个分片,执行器1只处理具有分片属性sharding1的触发器,执行器2同理。当执行器1出现宕机时,Elastic-Job将会触发失效转移,分片1将会分配给执行器2,此时执行器2会有两个线程分别处理分片1 和分片2。如果执行器后面启动成功,Elastic-Job将会重新分片,两个执行器又会均分分片。 4.3 执行器线程模型 执行器在运行时内部有两种线程,一个是定时任务扫描线程,另一个是消息队列消费线程,它们的工作模型如下: 定时任务扫描线程:主要负责定时拉取触发器,随后均衡投递到对应时间轮中,一个时间轮由一个工作线程负责处理。如果出现工作线程处理时间轮中作业比较慢,出现大量堆积的情况,需要将对应分片属性设置为饱和状态,此时不会有新的作业被分配到该执行器,直到该分片重新恢复为非饱和状态。 消息队列消费线程:主要负责处理定时任务无法cover 到的马上要执行的触发消息,比如定时任务的处理周期是20s,现在用户提交了一个每隔10s执行一次的任务,这个时候系统就需要生成一个10s之后执行的触发消息并把它写入到消息队列中,执行器的消费线程就可以立即得到这个触发消息,及时加入到执行器的时间轮中,确保消息能够按时执行。 5. CloudJob使用实践 在CloudJob分布式任务调度平台搭建好以后,用户就可以将任务部署到这个平台上。下面介绍一下用户在使用CloudJob过程中遇到的问题和优化方案。 5.1 集群隔离 相比与其它分布式任务调度框架,CloudJob是一个“重量级”的调度平台,搭建一套CloudJob需要MongoDB数据库、redis集群,消息队列以及多台主机作为执行器,如果用户的任务量非常少,这将会导致资源的浪费。所以可以采用集群隔离的方法,将各个部门的用户作业部署到一个CloudJob集群中,同时采用一种隔离方式让用户的作业互不影响,这样就可以合理的利用资源。 集群隔离的具体思路是先搭建一套物理集群,用户在创建作业之前需要先创建一个逻辑集群(或者选择之前已经创建好的逻辑集群),在这个逻辑集群设置限流策略、超时机制,并与物理集群关联起来,用户之后将自己的任务注册到这个逻辑集群中,任务就可以被物理集群调度,任务的限流策略、超时机制等又是以逻辑集群为单位管理的,这样就实现了集群隔离。 5.2 链路追踪与作业历史可视化 在CloudJob集群中,一个任务从注册到最终执行需要经过多个处理流程,为了便于排查问题和进行作业历史统计,平台需要对任务流转的各个阶段进行链路追踪,同时需要将监控数据进行持久化,便于查询作业的历史记录。链路追踪与作业历史可视化的框架如下: 链路追踪的方案是通过埋点的方式,对系统中的主要处理流程进行记录,系统中的模块每进行一次处理就生成一条记录数据,记录数据通过消息队列定时发送到任务监控平台,任务监控平台将这些数据处理后存储到Elasticsearch中,为后续的统计、查询做准备。 同时平台提供了前端页面给用户进行作业历史可视化,用户可以在页面上查看作业的历史记录,查看每一次执行的调度情况,通过页面还可以查看到作业是否有漏发、严重超时。 6. 总结与展望 CloudJob作为一个高性能、低延迟的分布式任务调度平台,通过将任务划分到不同的分片、每个执行器处理对应分片的任务,实现了系统的动态扩展和拥有海量任务调度的能力;使用定时任务扫描、时间轮、系统内部的消息队列来保证任务及时触发,保证了任务执行的低延迟;同时CloudJob通过Elastic-Job来执行系统内部的定时任务,保证执行器的高可用。 当然CloudJob还是有些不足,如果用户将任务部署到CloudJob平台上,还需要将自己的业务处理代码运行到自己的主机上,这会造成主机资源的浪费。后续CloudJob的演进方向就是将任务平台接入到Serverless平台,用户只需要在页面编辑自己的业务代码,然后点击保存,平台就会在Serverless中新建任务实例,将用户的代码运行在任务实例中等待接收触发消息,执行完任务后自动释放任务实例。这样既可以方便用户快速部署任务,又可以充分利用资源。 作者简介 XinchunOPPO高级后端工程师 目前负责分布式作业调度系统的开发,关注消息队列、redis数据库、ElasticSearch等中间件技术 推荐阅读 |MySQL 分布式事务的“路”与“坑” |OPPO大数据离线任务调度系统OFLOW 本文版权归OPPO公司所有,如需转载请在后台留言联系 本文分享自微信公众号 - OPPO数智技术(OPPO_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

国产自研 servlet 容器,smart-servlet 体验版发布

smart-servlet 是一款实现了Servlet 3.1规范,支持多应用隔离部署的的 Web 容器。除此之外,smart-servlet 还是一款插件化容器,用户可以通过开发自定义插件扩展容器的服务能力。 考虑到本项目还处于研发阶段,很多功能、设计在过程中存在较大的不确定性,故不在此处披露太多信息,以免某些过时、无效信息干扰大家对这个项目的理解。欢迎下载源码研究或与提 ISSUE 进行交流。 体验包下载地址:archives-1.0.0.tar.gz(支持Mac、Linux、Windows系统) 未来可期。。。

优秀的个人博客,低调大师

随行付微服务之基于Zuul自研服务网关

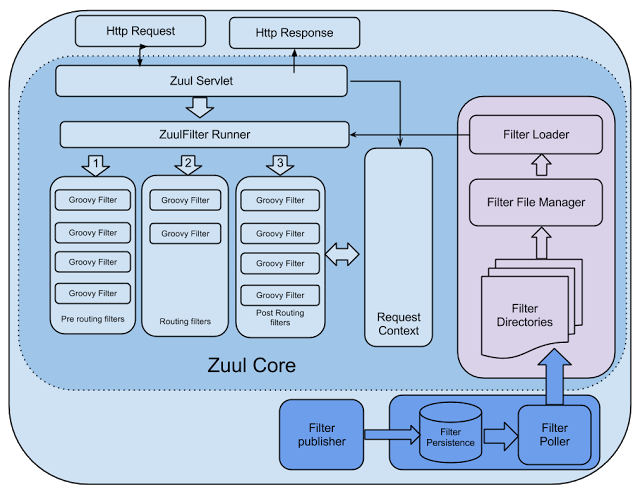
随行付微服务之服务网关 微服务是时下最流行的架构之一,作为微服务不可或缺的一部分,API网关的作用至关重要。本文将对随行付微服务的API网关实践进行介绍。 API网关的作用 我们知道,在一个微服务系统中,整个系统被划分为许多小模块,客户端想要调用服务,可能需要维护很多ip+port信息,管理十分复杂。API网关作为整个系统的统一入口,所有请求由网关接收并路由转发给内部的微服务。对于客户端而言,系统相当于一个黑箱,客户端不需要关心其内部结构。 随着业务的发展,服务端可能需要对微服务进行重新划分等操作,由于网关将客户端和具体服务隔离,因此可以在尽量不改动客户端的情况下进行。网关可以完成权限验证、限流、安全、监控、缓存、服务路由、协议转换、服务编排、灰度发布等功能剥离出来,讲这些非业务功能统一解决、统一机制处理。 Zuul原理简介 随行付微服务API网关基于Netflix的Zuul实现。Netflix是实践微服务最成功的公司之一,他们创建并开源了一系列微服务相关的框架,Zuul便是用来实现网关功能的框架。Zuul的整体架构图如下: Zuul基于Servlet开发,ZuulServlet是整个框架的入口。Zuul的核心组件是Filter,Filter分为四类,分别是pre、route、post、error。pre-filter用来实现前置逻辑,route-filter用来实现对目标服务的调用逻辑,post-filter用来实现收尾逻辑,error-filter则在任意位置发生异常时做异常处理(此处应该注意,如果pre或route发生异常,执行error后,仍然会执行post),其示意图如下: 在Filter中可以定义某些条件下是否执行过滤器逻辑,以及同种类Filter的优先级。Filter的各个方法中并不存在入参,其参数传递是通过一个基于ThreadLocal实现的RequestContext,虽然RequestContext中定义了很多参数的读写方法,但初始的可用参数仅有req和res,对应HttpSerlvetRequest和HttpServletResponse。Filter代码范例如下: public class TestFilter extends ZuulFilter { @Override /** 是否拦截 */ public boolean shouldFilter() { return false; } @Override /** filter逻辑 */ public Object run() throws ZuulException { RequestContext context = RequestContext.getCurrentContext();// 获取当前线程的 HttpServletRequest req = context.getRequest();// 获取请求信息 return null; // 从源码来看,这个返回值没什么用 } @Override /** filter类型 */ public String filterType() { return "pre";// pre/route/post/error } @Override /** filter优先级,仅在同类型filter中生效 */ public int filterOrder() { return 0; } } Filter通常使用groovy编写,以便于动态加载。当我们编写好一个Filter类后,将其放在指定的磁盘路径下,FilterFileManager会启动一个守护线程去定期读取并加载。通过动态加载,我们可以在不停机的情况下添加、修改功能模块。FilterFileManager源码摘要如下: public class FilterFileManager { ... /** * Initialized the GroovyFileManager. * * @throws Exception */ @PostConstruct public void init() throws Exception { long startTime = System.currentTimeMillis(); filterLoader.putFiltersForClasses(config.getClassNames()); manageFiles(); startPoller(); LOG.warn("Finished loading all zuul filters. Duration = " + (System.currentTimeMillis() - startTime) + " ms."); } ... /** 启动线程定时读取文件 */ void startPoller() { poller = new Thread("GroovyFilterFileManagerPoller") { public void run() { while (bRunning) { try { sleep(config.getPollingIntervalSeconds() * 1000); manageFiles(); } catch (Exception e) { LOG.error("Error checking and/or loading filter files from Poller thread.", e); } } } }; poller.start(); } ... /** 读取文件并加载 */ void manageFiles() { try { List<File> aFiles = getFiles(); processGroovyFiles(aFiles); } catch (Exception e) { String msg = "Error updating groovy filters from disk!"; LOG.error(msg, e); throw new RuntimeException(msg, e); } } } SpringCloud-Zuul Spring Cloud通过集成Zuul来实现API网关模块,我们来简单介绍一下它的整合原理。 SpringCloud-Zuul的核心配置类是ZuulServerAutoConfiguration以及ZuulProxyAutoConfiguration。Spring首先使用ZuulController来封装ZuulServlet,然后定义一个ZuulHandlerMapping,使得除一些特殊请求以外(如/error)的大部分请求被转发到ZuulController进行处理。源码摘要如下: @Configuration @EnableConfigurationProperties({ ZuulProperties.class }) @ConditionalOnClass(ZuulServlet.class) @ConditionalOnBean(ZuulServerMarkerConfiguration.Marker.class) // Make sure to get the ServerProperties from the same place as a normal web app would @Import(ServerPropertiesAutoConfiguration.class) public class ZuulServerAutoConfiguration { ... @Bean public ZuulController zuulController() { return new ZuulController(); } @Bean public ZuulHandlerMapping zuulHandlerMapping(RouteLocator routes) { ZuulHandlerMapping mapping = new ZuulHandlerMapping(routes, zuulController()); mapping.setErrorController(this.errorController); return mapping; } } public class ZuulController extends ServletWrappingController { public ZuulController() { setServletClass(ZuulServlet.class); setServletName("zuul"); setSupportedMethods((String[]) null); // Allow all } ... } public class ZuulHandlerMapping extends AbstractUrlHandlerMapping { ... private final ZuulController zuul; ... @Override protected Object lookupHandler(String urlPath, HttpServletRequest request) throws Exception { if (this.errorController != null && urlPath.equals(this.errorController.getErrorPath())) { return null; } if (isIgnoredPath(urlPath, this.routeLocator.getIgnoredPaths())) return null; RequestContext ctx = RequestContext.getCurrentContext(); if (ctx.containsKey("forward.to")) { return null; } if (this.dirty) { synchronized (this) { if (this.dirty) { registerHandlers(); this.dirty = false; } } } return super.lookupHandler(urlPath, request); } ... private void registerHandlers() { Collection<Route> routes = this.routeLocator.getRoutes(); if (routes.isEmpty()) { this.logger.warn("No routes found from RouteLocator"); } else { for (Route route : routes) { registerHandler(route.getFullPath(), this.zuul); } } } } SpringCloud默认定义了一些Filter来实现网关逻辑,其中最核心的Filter——RibbonRoutingFilter是负责实际转发操作的,在它的过滤逻辑里又集成了hystrix、ribbon等其他重要框架。源码摘要如下: public class RibbonRoutingFilter extends ZuulFilter { @Override public Object run() { RequestContext context = RequestContext.getCurrentContext(); this.helper.addIgnoredHeaders(); try { RibbonCommandContext commandContext = buildCommandContext(context);//构建请求数据 ClientHttpResponse response = forward(commandContext);//执行请求 setResponse(response);//设置应答信息 return response; } catch (ZuulException ex) { throw new ZuulRuntimeException(ex); } catch (Exception ex) { throw new ZuulRuntimeException(ex); } } } 加载Filter的方式通过ZuulFilterInitializer扩展为可以从ApplicationContext中获取。源码摘要: /** 代码出自ZuulServerAutoConfiguration */ @Configuration protected static class ZuulFilterConfiguration { @Autowired private Map<String, ZuulFilter> filters;//从spring上下文中获取Filter bean @Bean public ZuulFilterInitializer zuulFilterInitializer( CounterFactory counterFactory, TracerFactory tracerFactory) { FilterLoader filterLoader = FilterLoader.getInstance(); FilterRegistry filterRegistry = FilterRegistry.instance(); return new ZuulFilterInitializer(this.filters, counterFactory, tracerFactory, filterLoader, filterRegistry); } } public class ZuulFilterInitializer { private final Map<String, ZuulFilter> filters; ... @PostConstruct public void contextInitialized() { ... // 设置filter for (Map.Entry<String, ZuulFilter> entry : this.filters.entrySet()) { filterRegistry.put(entry.getKey(), entry.getValue()); } } } Zuul2 随着业务的不断发展,Zuul对于Netflix来说性能已经不太够用,于是Netflix又开发了Zuul2。Zuul2最大的变革是基于Netty实现了框架的异步化,从而提升其性能。根据官方的数据,Zuul2的性能比Zuul1约有20%的提升。Zuul2架构图如下: 由于框架改为了异步的模式,Zuul2在提升性能的同时,也带来了调试、运维的困难。在实际的使用当中,对于绝大多数公司来说,并发量远远没有Netflix那样庞大,选择开发调试更简单、且性能够用的Zuul1是更合适的选择。 作者简介 任金昊,随行付架构部高级开发工程师。擅长分布式、微服务架构,负责随行付微服务生态平台开发。

优秀的个人博客,低调大师

菜鸟自研核心引擎架构首次曝光!

随着中国物流运输行业的蓬勃发展, 物流成本已经占据了18%的国民生产总值, 其中, 车辆运输作为配送成本的核心要素, 成为了一个必须面对的问题。而车辆路径规划问题的目标就是减少配送的车辆数目和距离, 进而降低物流成本, 同时也是物流成本透明化的重要手段。 菜鸟网络人工智能部从自身业务出发, 联合集团IDST、阿里巴巴云计算的力量, 打造一款适合中国复杂的业务需求, 又在效果上接近国际水准的分布式车辆路径规划求解引擎 -- STARK VRP, 以此向财富自由还继续追求黑科技的钢铁侠致敬。 菜鸟业务总览 由上图可见, 车辆路径规划在整个链路中起到了举足轻重的作用。 运筹优化 机器学习 人工智能 Nothing at all takes place in the Universe in which some rule of maximum or

优秀的个人博客,低调大师

Hudi 在 vivo 湖仓一体的落地实践

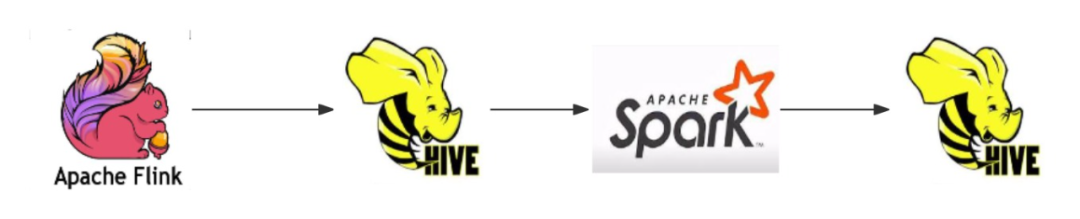
作者:vivo 互联网大数据团队 - Xu Yu 在增效降本的大背景下,vivo大数据基础团队引入Hudi组件为公司业务部门湖仓加速的场景进行赋能。主要应用在流批同源、实时链路优化及宽表拼接等业务场景。 一、Hudi 基础能力及相关概念介绍 1.1 流批同源能力 与Hive不同,Hudi数据在Spark/Flink写入后,下游可以继续使用Spark/Flink引擎以流读的形式实时读取数据。同一份Hudi数据源既可以批读也支持流读。 Flink、Hive、Spark的流转批架构: Hudi流批同源架构: 1.2 COW和MOR的概念 Hudi支持COW(Copy On Write)和MOR(Merge On Read)两种类型: (1)COW写时拷贝: 每次更新的数据都会拷贝一份新的数据版本出来,用户通过最新或者指定version的可以进行数据查询。缺点是写入的时候往往会有写内存放大的情况,优点是查询不需要合并,直接读取效率相对比较高。JDK中的CopyOnWriteArrayList/ CopyOnWriteArraySet 容器正是采用了 COW 思想。 COW表的数据组织格式如下: (2)MOR读时合并: 每次更新或者插入新的数据时,并写入parquet文件,而是写入Avro格式的log文件中,数据按照FileGroup进行分组,每个FileGroup由base文件(parquet文件)和若干log文件组成,每个FileGroup有单独的FileGroupID;在读取的时候会在内存中将base文件和log文件进行合并,进而返回查询的数据。缺点是合并需要花费额外的合并时间,查询的效率受到影响;优点是写入的时候效率相较于COW快很多,一般用于要求数据快速写入的场景。 MOR数据组织格式如下: 1.3 Hudi的小文件治理方案 Hudi表会针对COW和MOR表制定不同的文件合并方案,分别对应Clustering和Compaction。 Clustering顾名思义,就是将COW表中多个FileGroup下的parquet根据指定的数据大小重新编排合并为新的且文件体积更大的文件块。如下图所示: Compaction即base parquet文件与相同FileGroup下的其余log文件进行合并,生成最新版本的base文件。如下图所示: 1.4 周边引擎查询Hudi的原理 当前主流的OLAP引擎等都是从HMS中获取Hudi的分区元数据信息,从InputFormat属性中判断需要启动HiveCatalog还是HudiCatalog,然后生成查询计划最终执行。当前StarRocks、Presto等引擎都支持以外表的形式对Hudi表进行查询。 1.5 Procedure介绍 Hudi 支持多种Procedure,即过程处理程序,用户可以通过这些Procedure方便快速的处理Hudi表的相关逻辑,比如Compaction、Clustering、Clean等相关处理逻辑,不需要进行编码,直接通过sparksql的语句来执行。 1.6 项目架构 1. 按时效性要求进行分类 秒级延迟: 分钟级延迟: 当前Hudi主要还是应用在准实时场景: 上游从Kafka以append模式接入ods的cow表,下游部分dw层业务根据流量大小选择不同类型的索引表,比如bucket index的mor表,在数据去重后进行dw构建,从而提供统一数据服务层给下游的实时和离线的业务,同时ods层和dw层统一以insert overwrite的方式进行分区级别的容灾保障,Timeline上写入一个replacecommit的instant,不会引发下游流量骤增,如下图所示: 1.7 线上达成能力 实时场景: 支持1亿条/min量级准实时写入;流读延迟稳定在分钟级 离线场景: 支持千亿级别数据单批次离线写入;查询性能与查询Hive持平(部分线上任务较查询Hive提高20%以上) 小文件治理: 95%以上的合并任务单次执行控制在10min内完成 二、组件能力优化 2.1 组件版本 当前线上所有Hudi的版本已从0.12 升级到 0.14,主要考虑到0.14版本的组件能力更加完备,且与社区前沿动态保持一致。 2.2 流计算场景 1. 限流 数据积压严重的情况下,默认情况会消费所有未消费的commits,往往因消费的commits数目过大,导致任务频繁OOM,影响任务稳定性;优化后每次用户可以摄取指定数目的commits,很大程度上避免任务OOM,提高了任务稳定性。 2. 外置clean算子 避免单并行度的clean算子最终阶段影响数据实时写入的性能;将clean单独剥离到 compaction/clustering执行。这样的好处是单个clean算子,不会因为其生成clean计划和执行导致局部某些Taskmanager出现热点的问题,极大程度提升了实时任务稳定性。 3. JM内存优化 部分大流量场景中,尽管已经对Hudi进行了最大程度的调优,但是JM的内存仍然在较高水位波动,还是会间隔性出现内存溢出影响稳定性。这种情况下我们尝试对 state.backend.fs.memory-threshold 参数进行调整;从默认的20KB调整到1KB,JM内存显著下降;同时运行至今state相关数据未产生小文件影响。 2.3 批计算场景 1. Bucket index下的BulkInsert优化 0.14版本后支持了bucket表的bulkinsert,实际使用过程中发现分区数很大的情况下,写入延迟耗时与计算资源消耗较高;分析后主要是打开的句柄数较多,不断CPU IO 频繁切换影响写入性能。 因此在hudi内核进行了优化,主要是基于partition path和bucket id组合进行预排序,并提前关闭空闲写入句柄,进而优化cpu资源使用率。 这样原先50分钟的任务能降低到30分钟以内,数据写入性能提高约30% ~ 40%。 优化前: 优化后: 2. 查询优化 0.14版本中,部分情况下分区裁剪会失效,从而导致条件查询往往会扫描不相关的分区,在分区数庞大的情况下,会导致driver OOM,对此问题进行了修复,提高了查询任务的速度和稳定性。 eg:select * from `hudi_test`.`tmp_hudi_test` where day='2023-11-20' and hour=23; (其中tmp_hudi_test是一张按日期和小时二级分区的表) 修复前: 修复后: 优化后不仅包括减少分区的扫描数目,也减少了一些无效文件RPC的stage。 3. 多种OLAP引擎支持 此外,为了提高MOR表管理的效率,我们禁止了RO/RT表的生成;同时修复了原表的元数据不能正常同步到HMS的缺陷(这种情况下,OLAP引擎例如Presto、StarRocks查询原表数据默认仅支持对RO/RT表的查询,原表查询为空结果)。 2.4 小文件合并 1. 序列化问题修复 0.14版本Hudi在文件合并场景中,Compaction的性能相较0.12版本有30%左右的资源优化,比如:原先0.12需要6G资源才能正常启动单个executor的场景下,0.14版本 4G就可以启动并稳定执行任务;但是clustering存在因TypedProperties重复序列化导致的性能缺陷。完善后,clustering的性能得到30%以上的提升。 可以从executor的修复前后的火焰图进行比对。 修复前: 修复后: 2. 分批compaction/clustering compaction/clustering默认不支持按commits数分批次执行,为了更好的兼容平台调度能力,对compaction/clustering相关procedure进行了改进,支持按批次执行。 同时对其他部分procedure也进行了优化,比如copy_to_table支持了列裁剪拷贝、 delete_procedures支持了批量执行等,降低sparksql的执行时间。 3. clean优化 Hudi0.14 在多分区表的场景下clean的时候很容易OOM,主要是因为构建 HoodieTableFileSystemView的时候需要频繁访问TimelineServer,因产生大量分区信息请求对象导致内存溢出。具体情况如下: 对此我们对partition request Job做了相关优化,将多个task分为多个batch来执行,降低对TimelineSever的内存压力,同时增加了请求前的缓存判断,如果已经缓存的将不会发起请求。 改造后如下: 此外实际情况下还可以在FileSystemViewManager构建过程中将 remoteview 和 secondview 的顺序互调,绝大部分场景下也能避免clean oom的问题,直接优先从secondview中获取分区信息即可。 2.5 生命周期管理 当前计算平台支持用户表级别生命周期设置,为了提高删除的效率,我们设计实现了直接从目录对数据进行删除的方案,这样的收益有: 降低了元数据交互时间,执行时间快; 无须加锁、无须停止任务; 不会影响后续compaction/clustering 相关任务执行(比如执行合并的时候不会报文件不存在等异常)。 删除前会对compaction/clustering等instants的元数据信息进行扫描,经过合法性判断后区分用户需要删除的目录是否存在其中,如果有就保存;否则直接删除。流程如下: 三、总结 我们分别在流批场景、小文件治理、生命周期管理等方向做了相关优化,上线后的收益主要体现这四个方向: 部分实时链路可以进行合并,降低了计算和存储资源成本; 基于watermark有效识别分区写入的完成度,接入湖仓的后续离线任务平均SLA提前时间不低于60分钟; 部分流转批后的任务上线后执行时间减少约40%(比如原先执行需要150秒的任务可以缩短到100秒左右完成 ; 离线增量更新场景,部分任务相较于原先Hive任务可以下降30%以上的计算资源。 同时跟进用户实际使用情况,发现了一些有待优化的问题: Hudi生成文件的体积相较于原先Hive,体积偏大(平均有1.3 ~ 1.4的比例); 流读的指标不够准确; Hive—>Hudi迁移需要有一定的学习成本; 针对上述问题,我们也做了如下后续计划: 对hoodie parquet索引文件进行精简优化,此外业务上对主键的重新设计也会直接影响到文件体积大小; 部分流读的指标不准,我们已经完成初步的指标修复,后续需要补充更多实时的任务指标来提高用户体验; 完善Hudi迁移流程,提供更快更简洁的迁移工具,此外也会向更多的业务推广Hudi组件,进一步挖掘Hudi组件的潜在使用价值。 END 猜你喜欢 RocksDB 在 vivo 消息推送系统中的实践 线上ES集群参数配置引起的业务异常案例分析 vivo 网络端口安全建设技术实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册