用Python拆分PDF图纸并自动命名
# 原本吭哧吭哧1小时的活,现在5分钟搞定!!  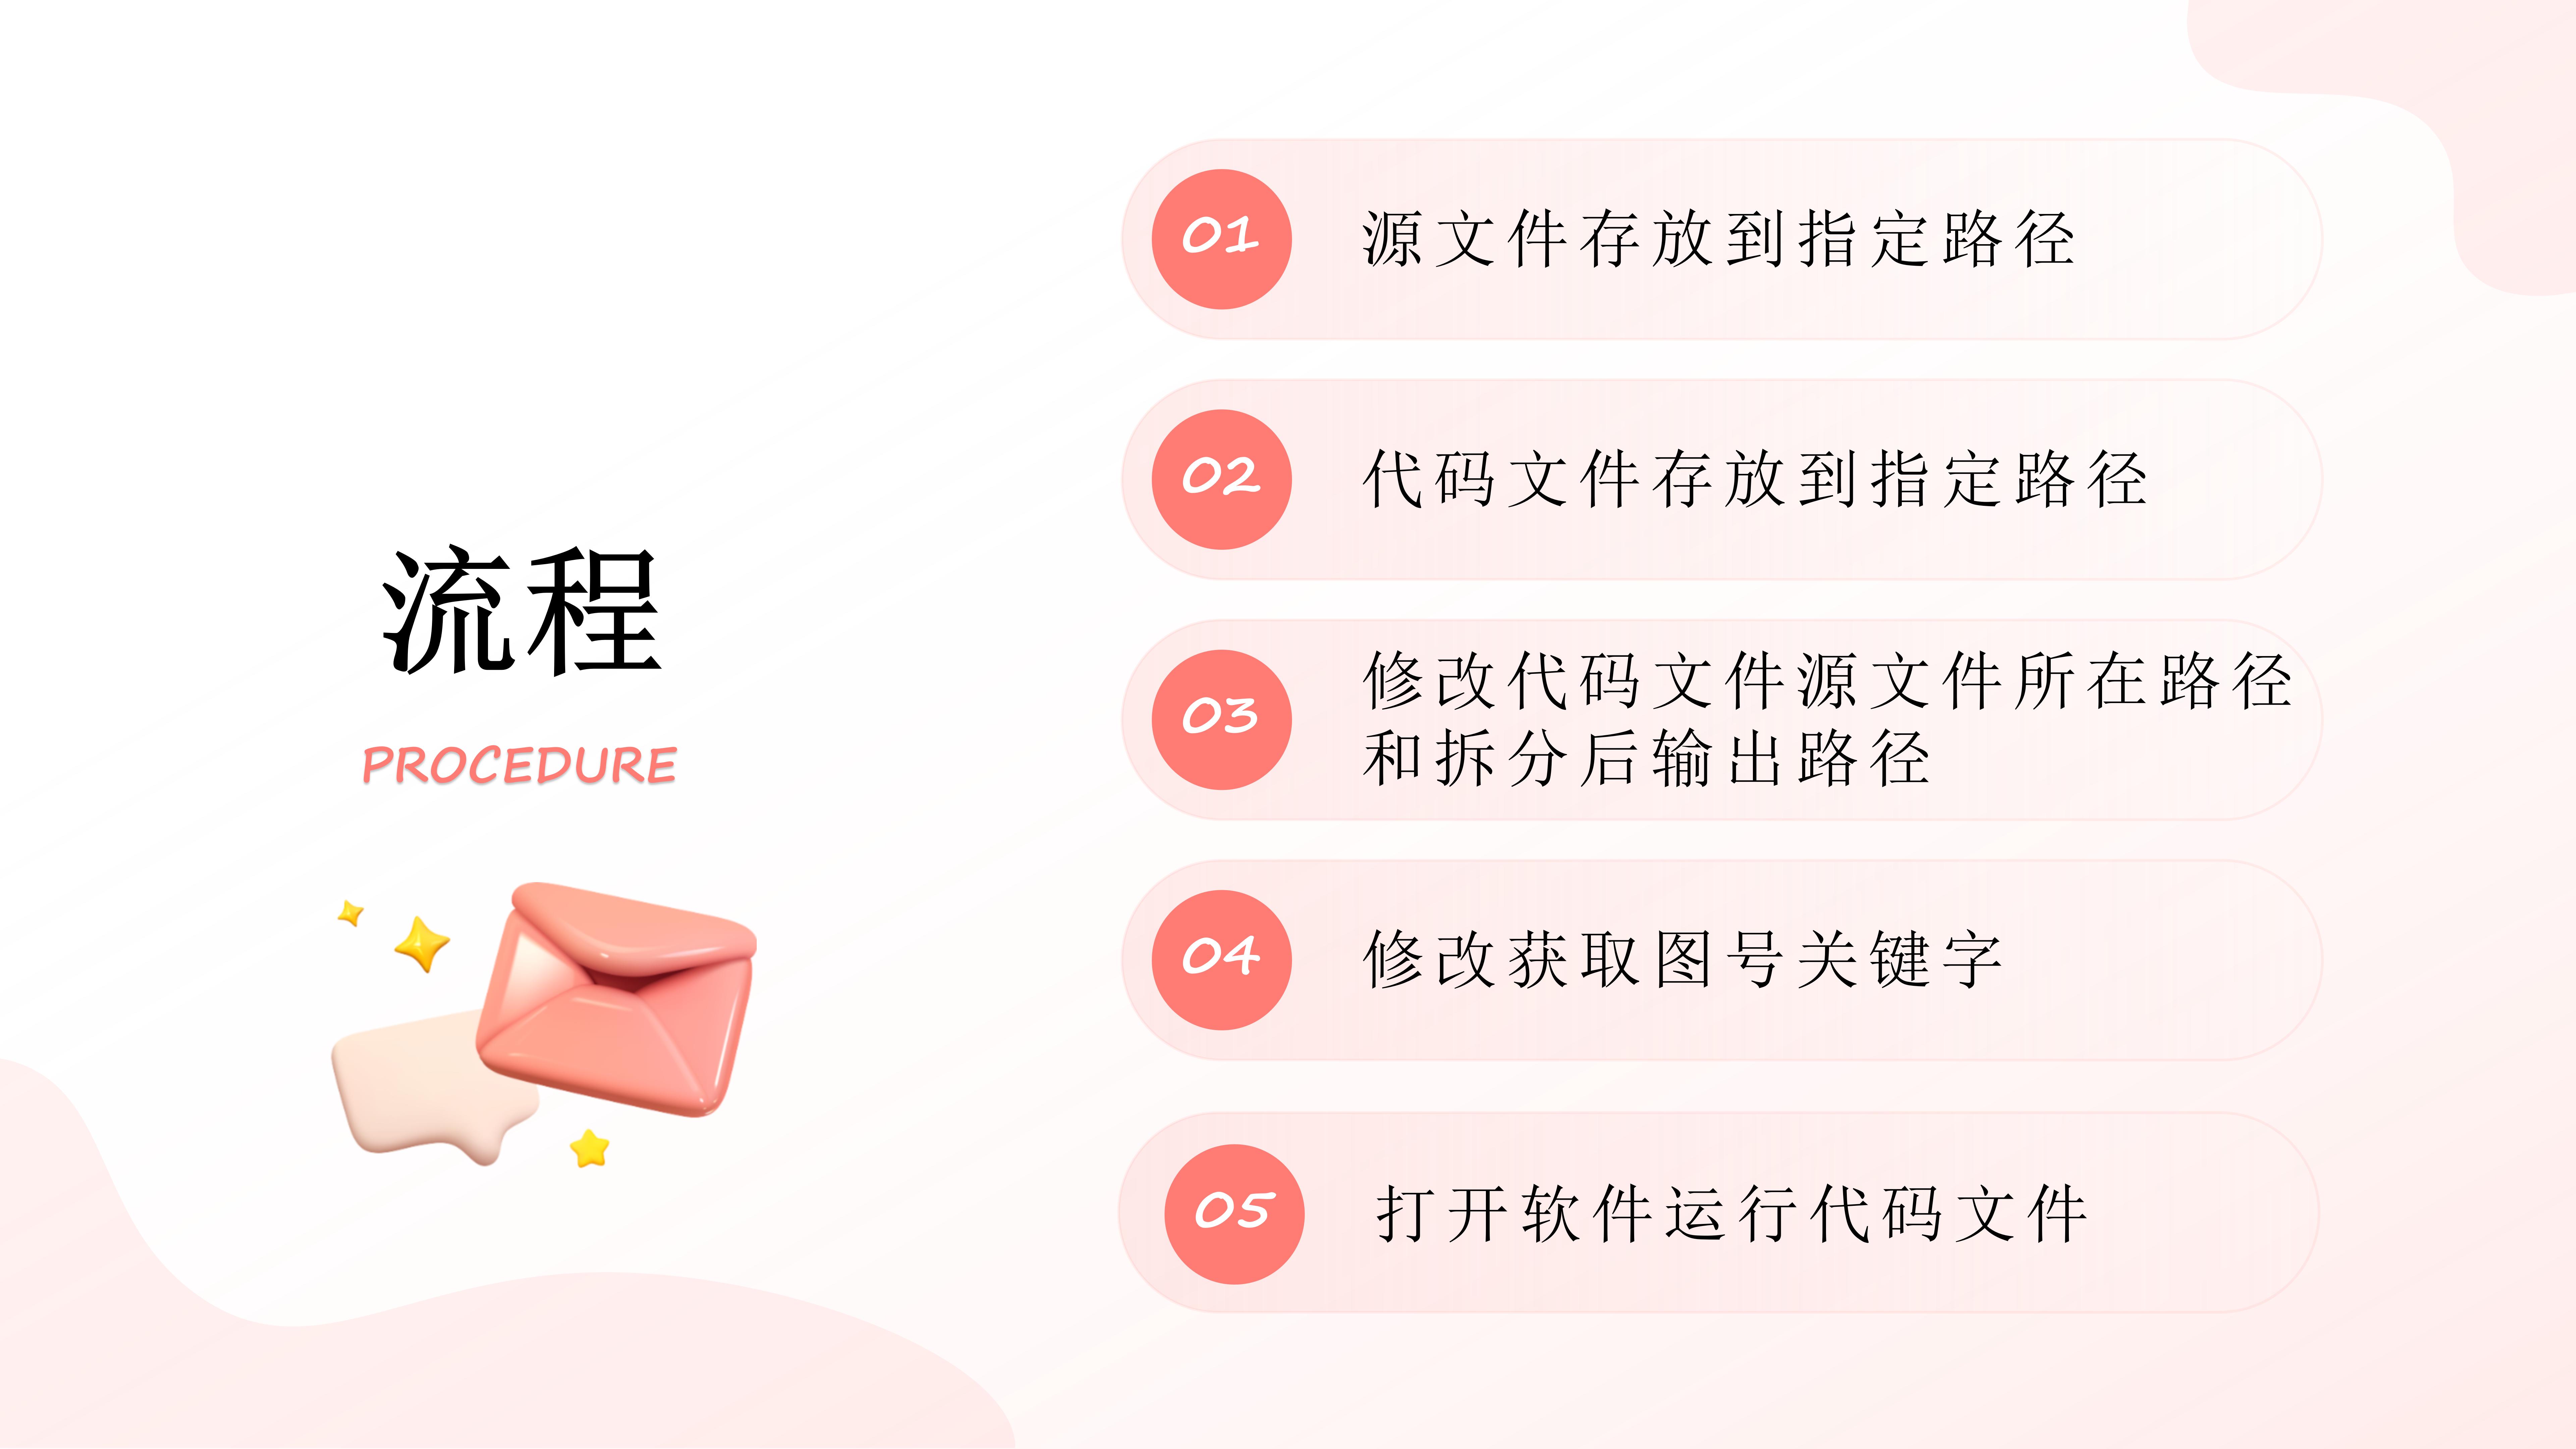   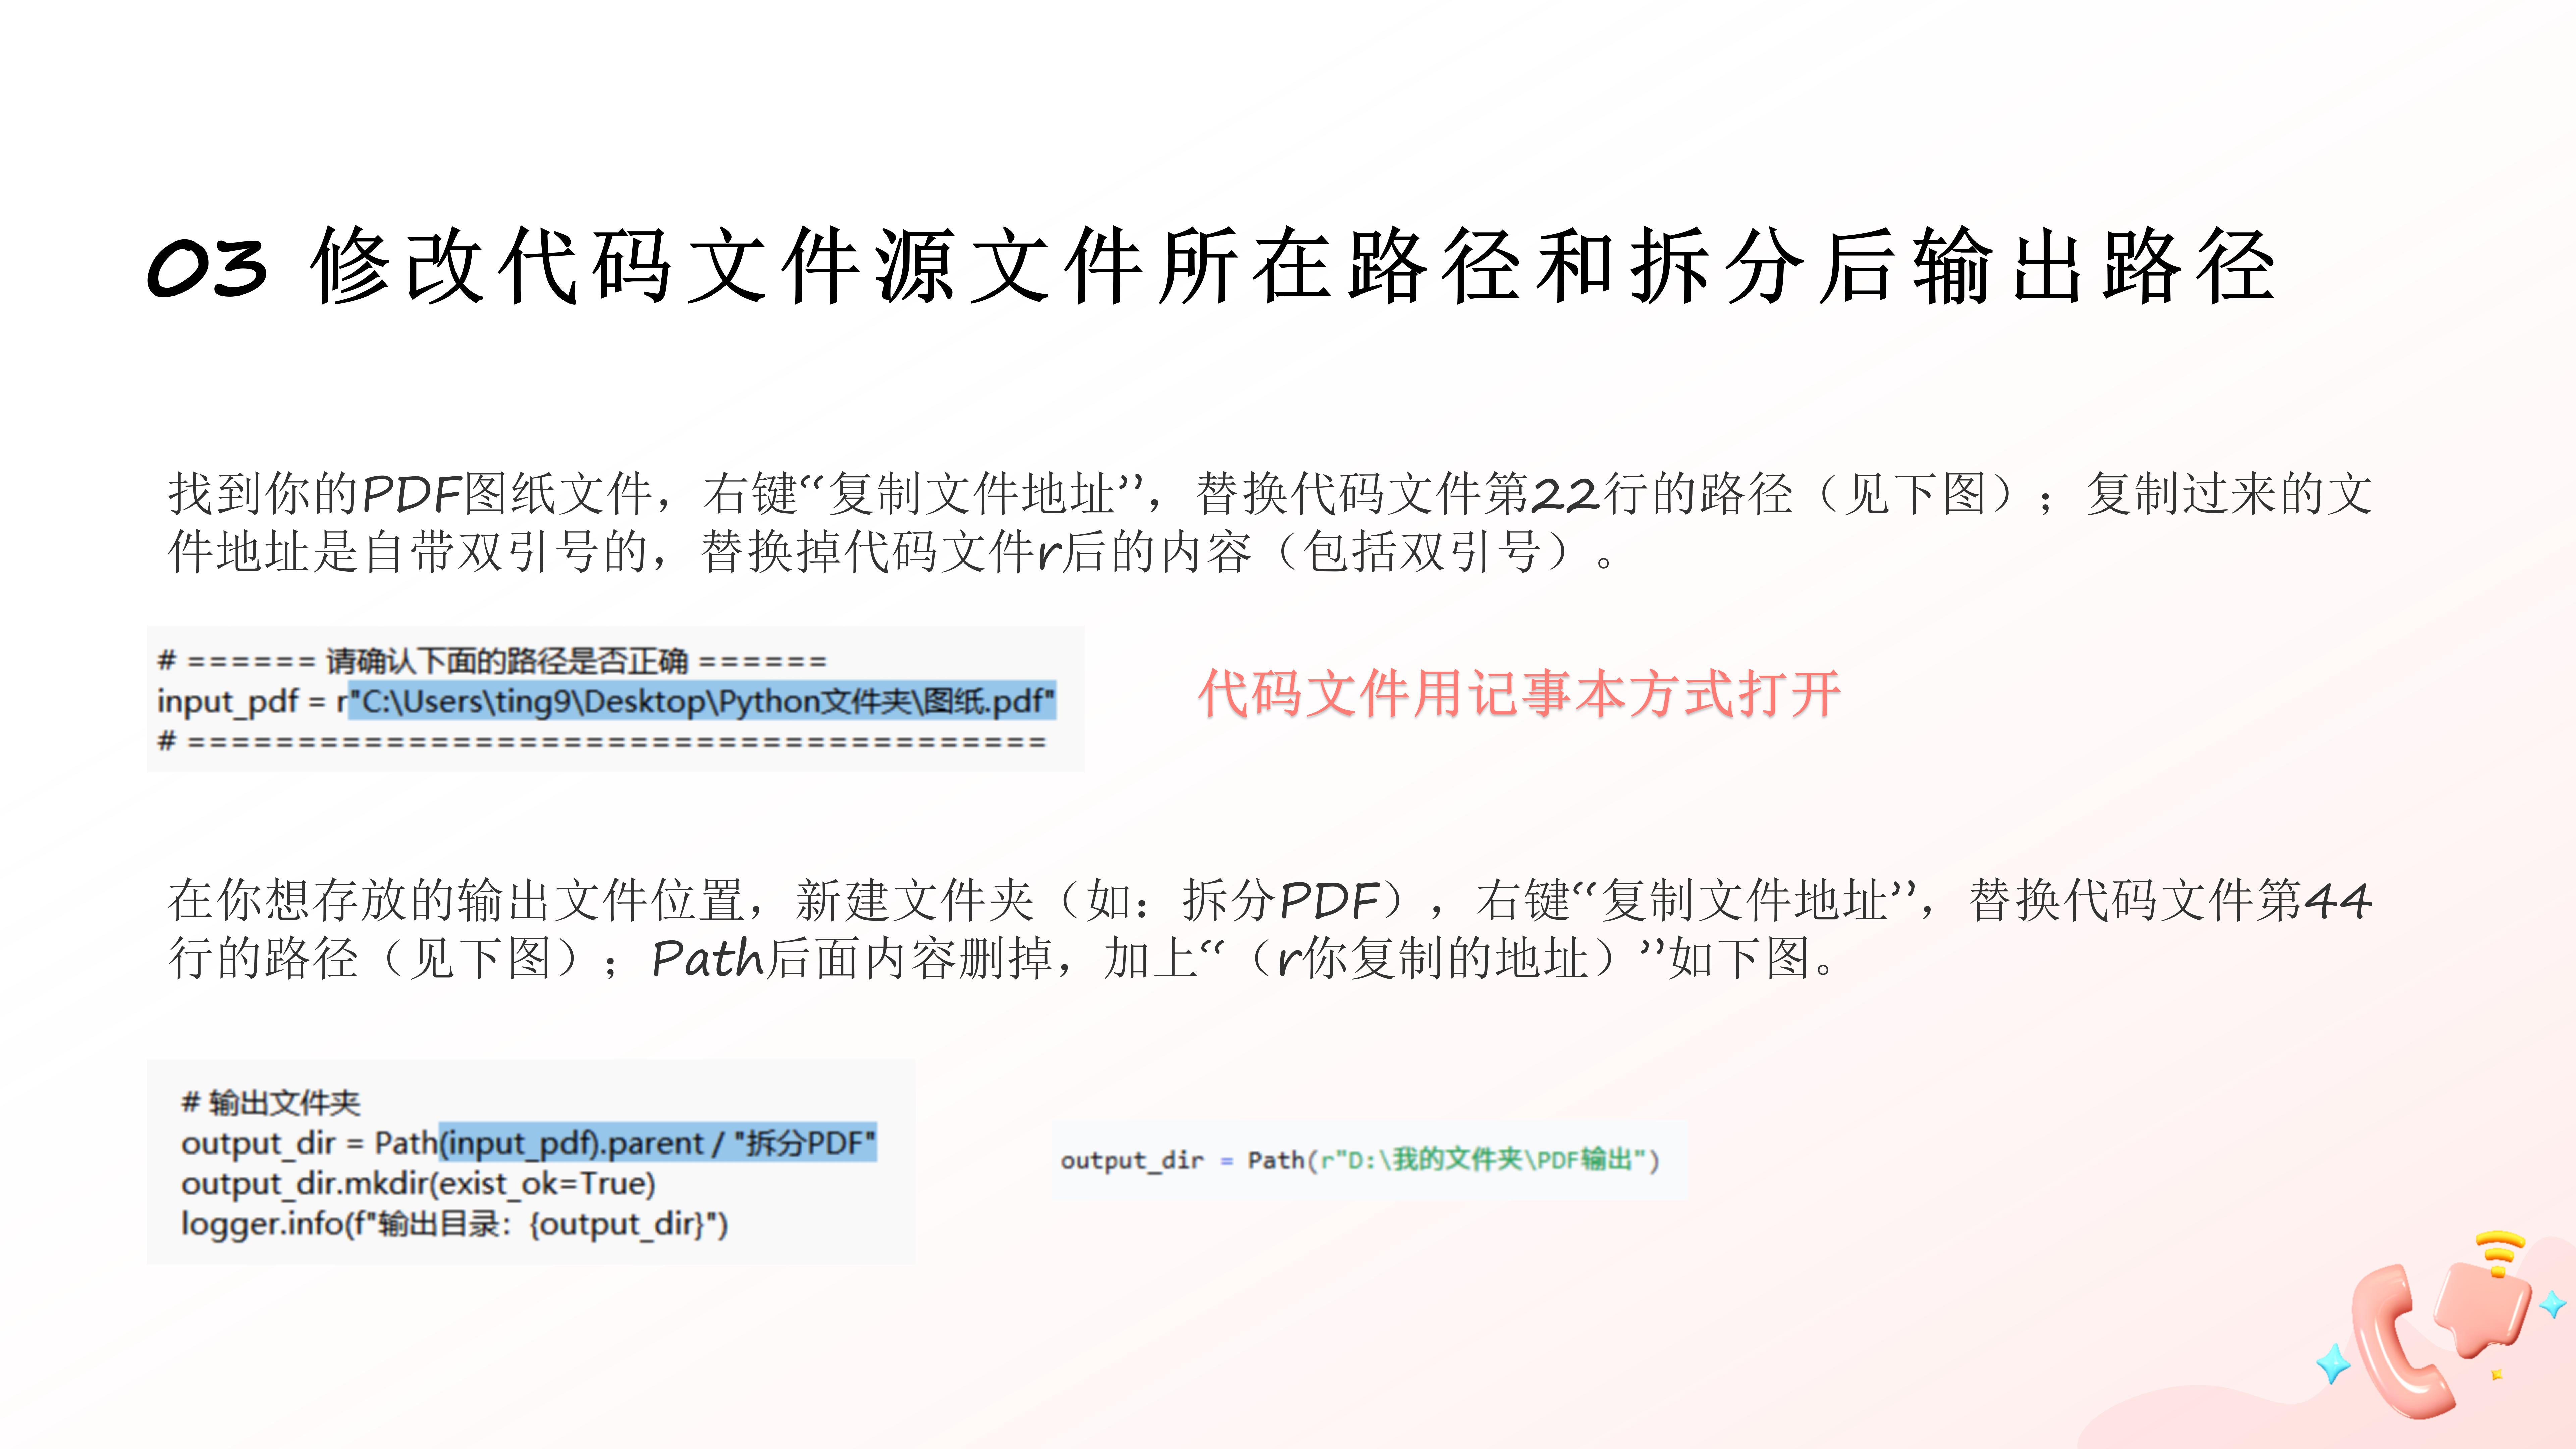 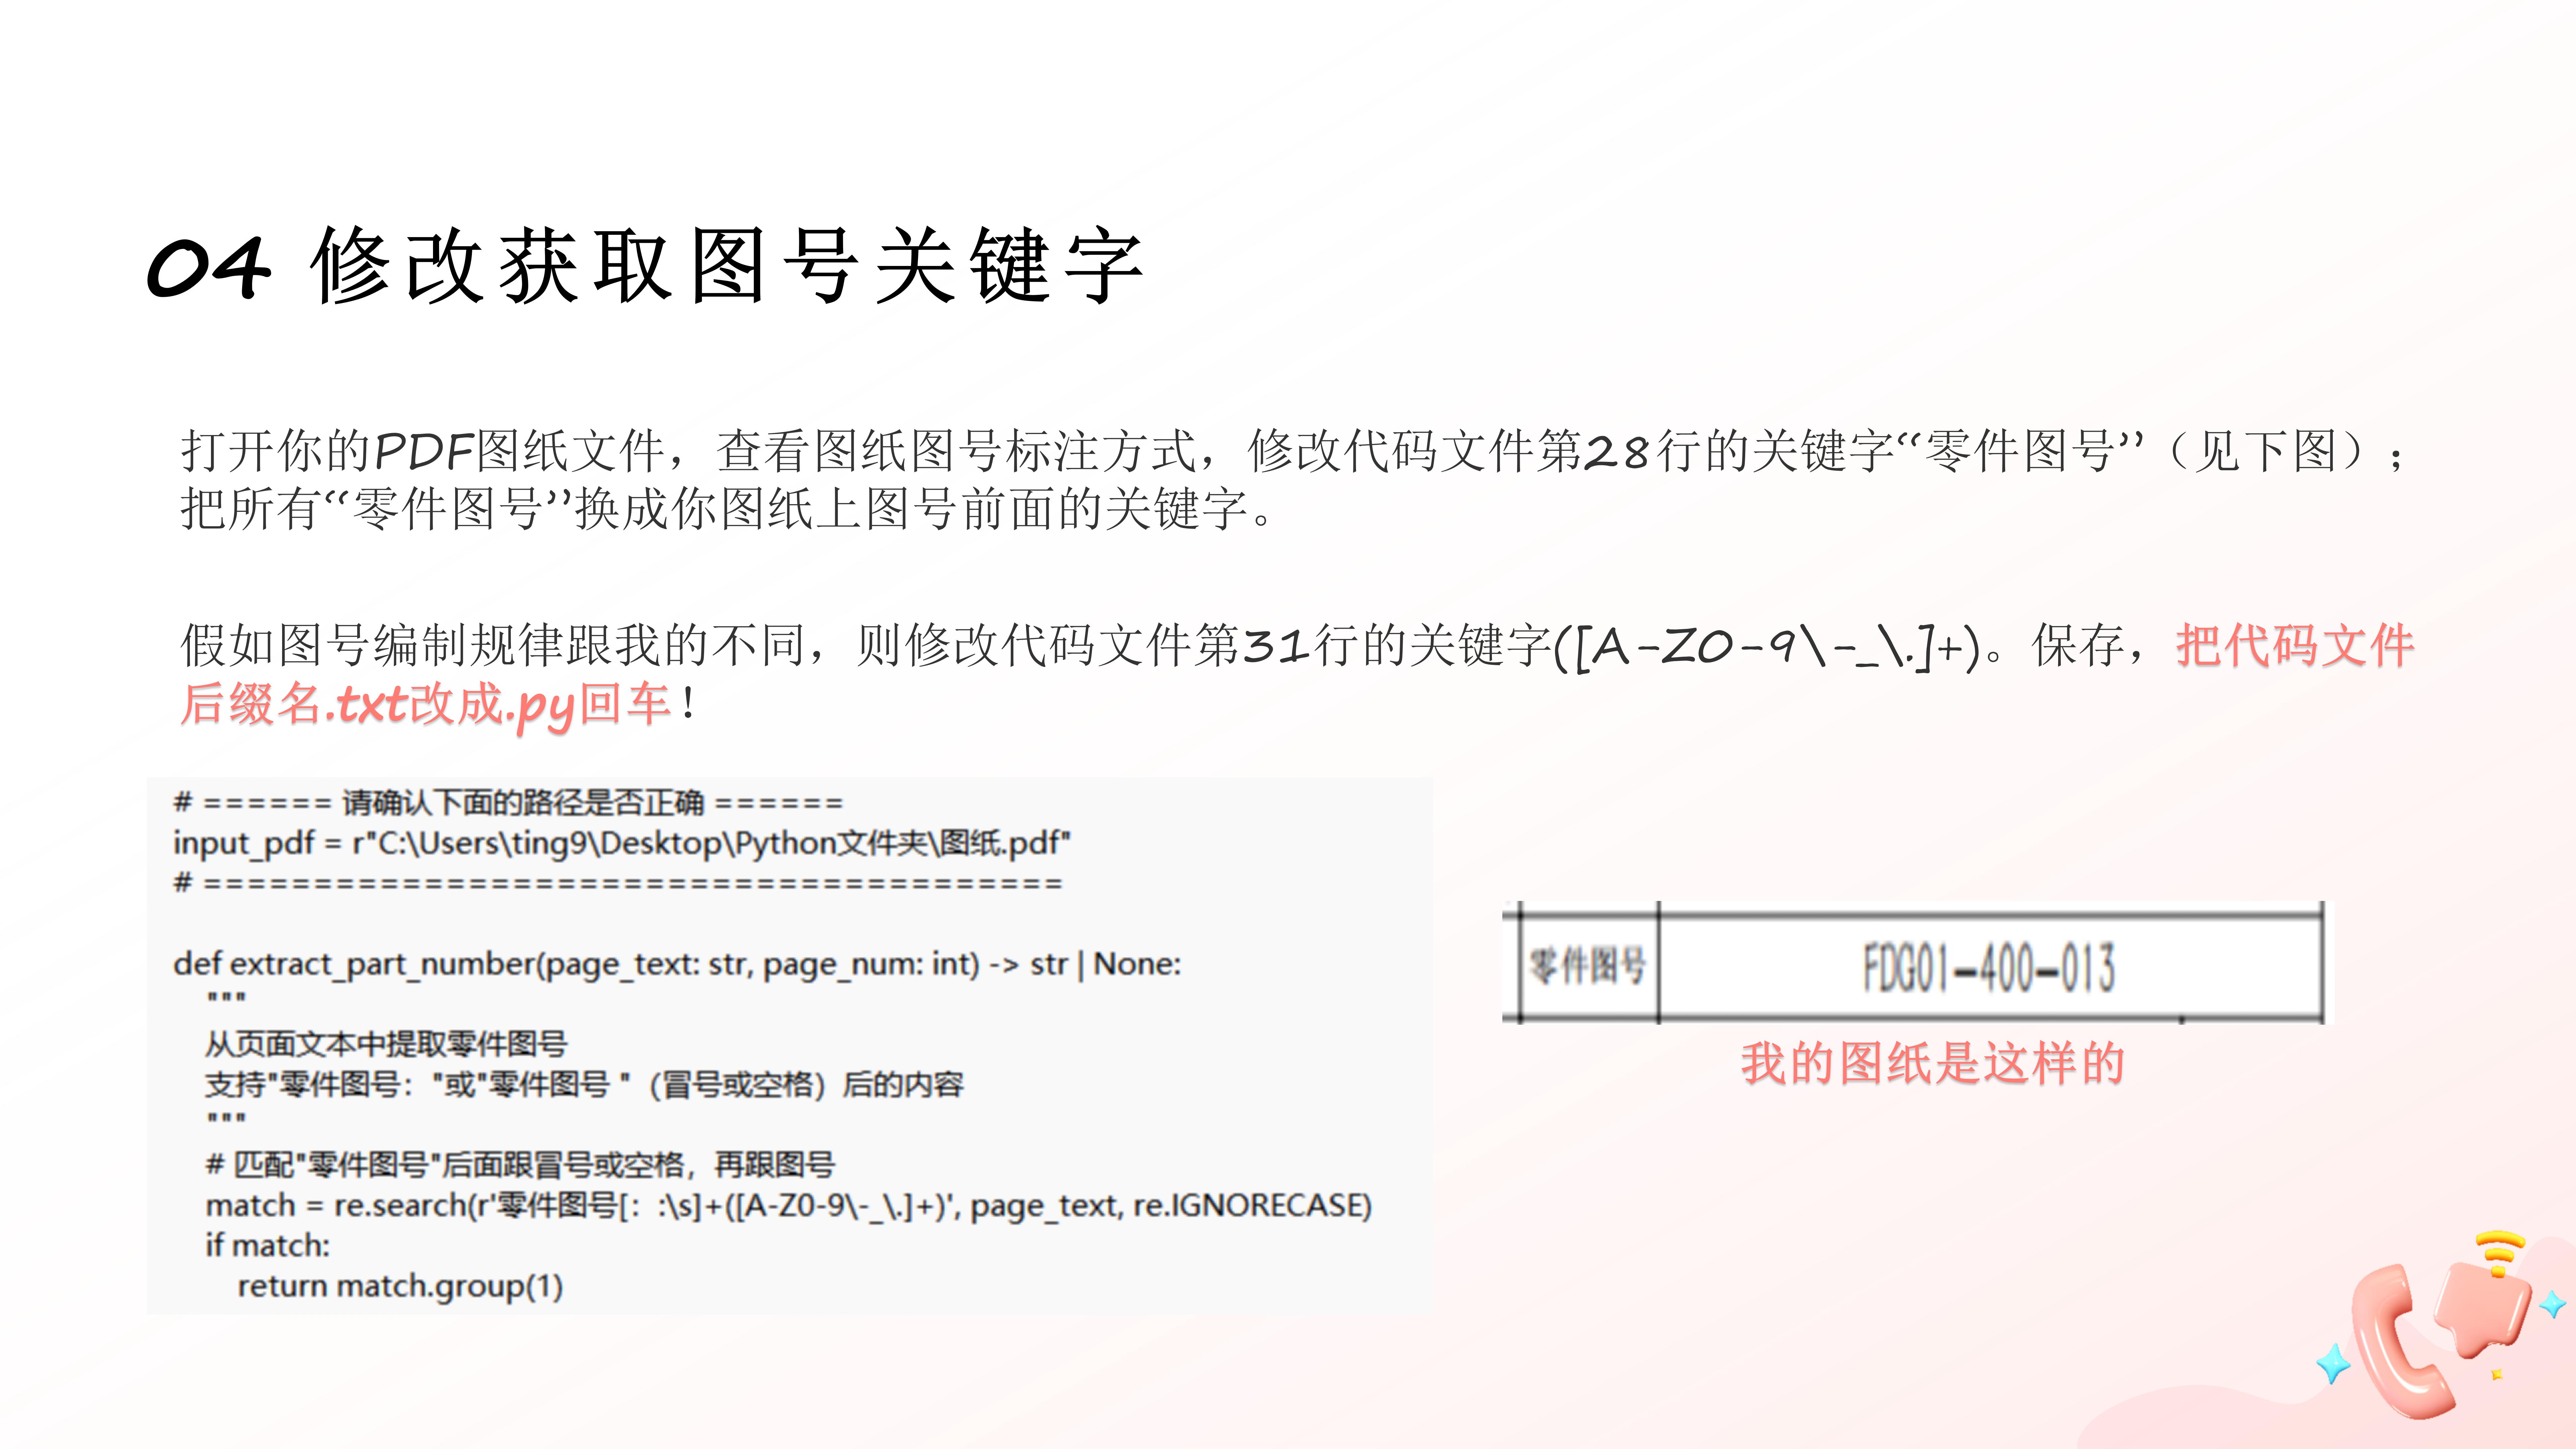 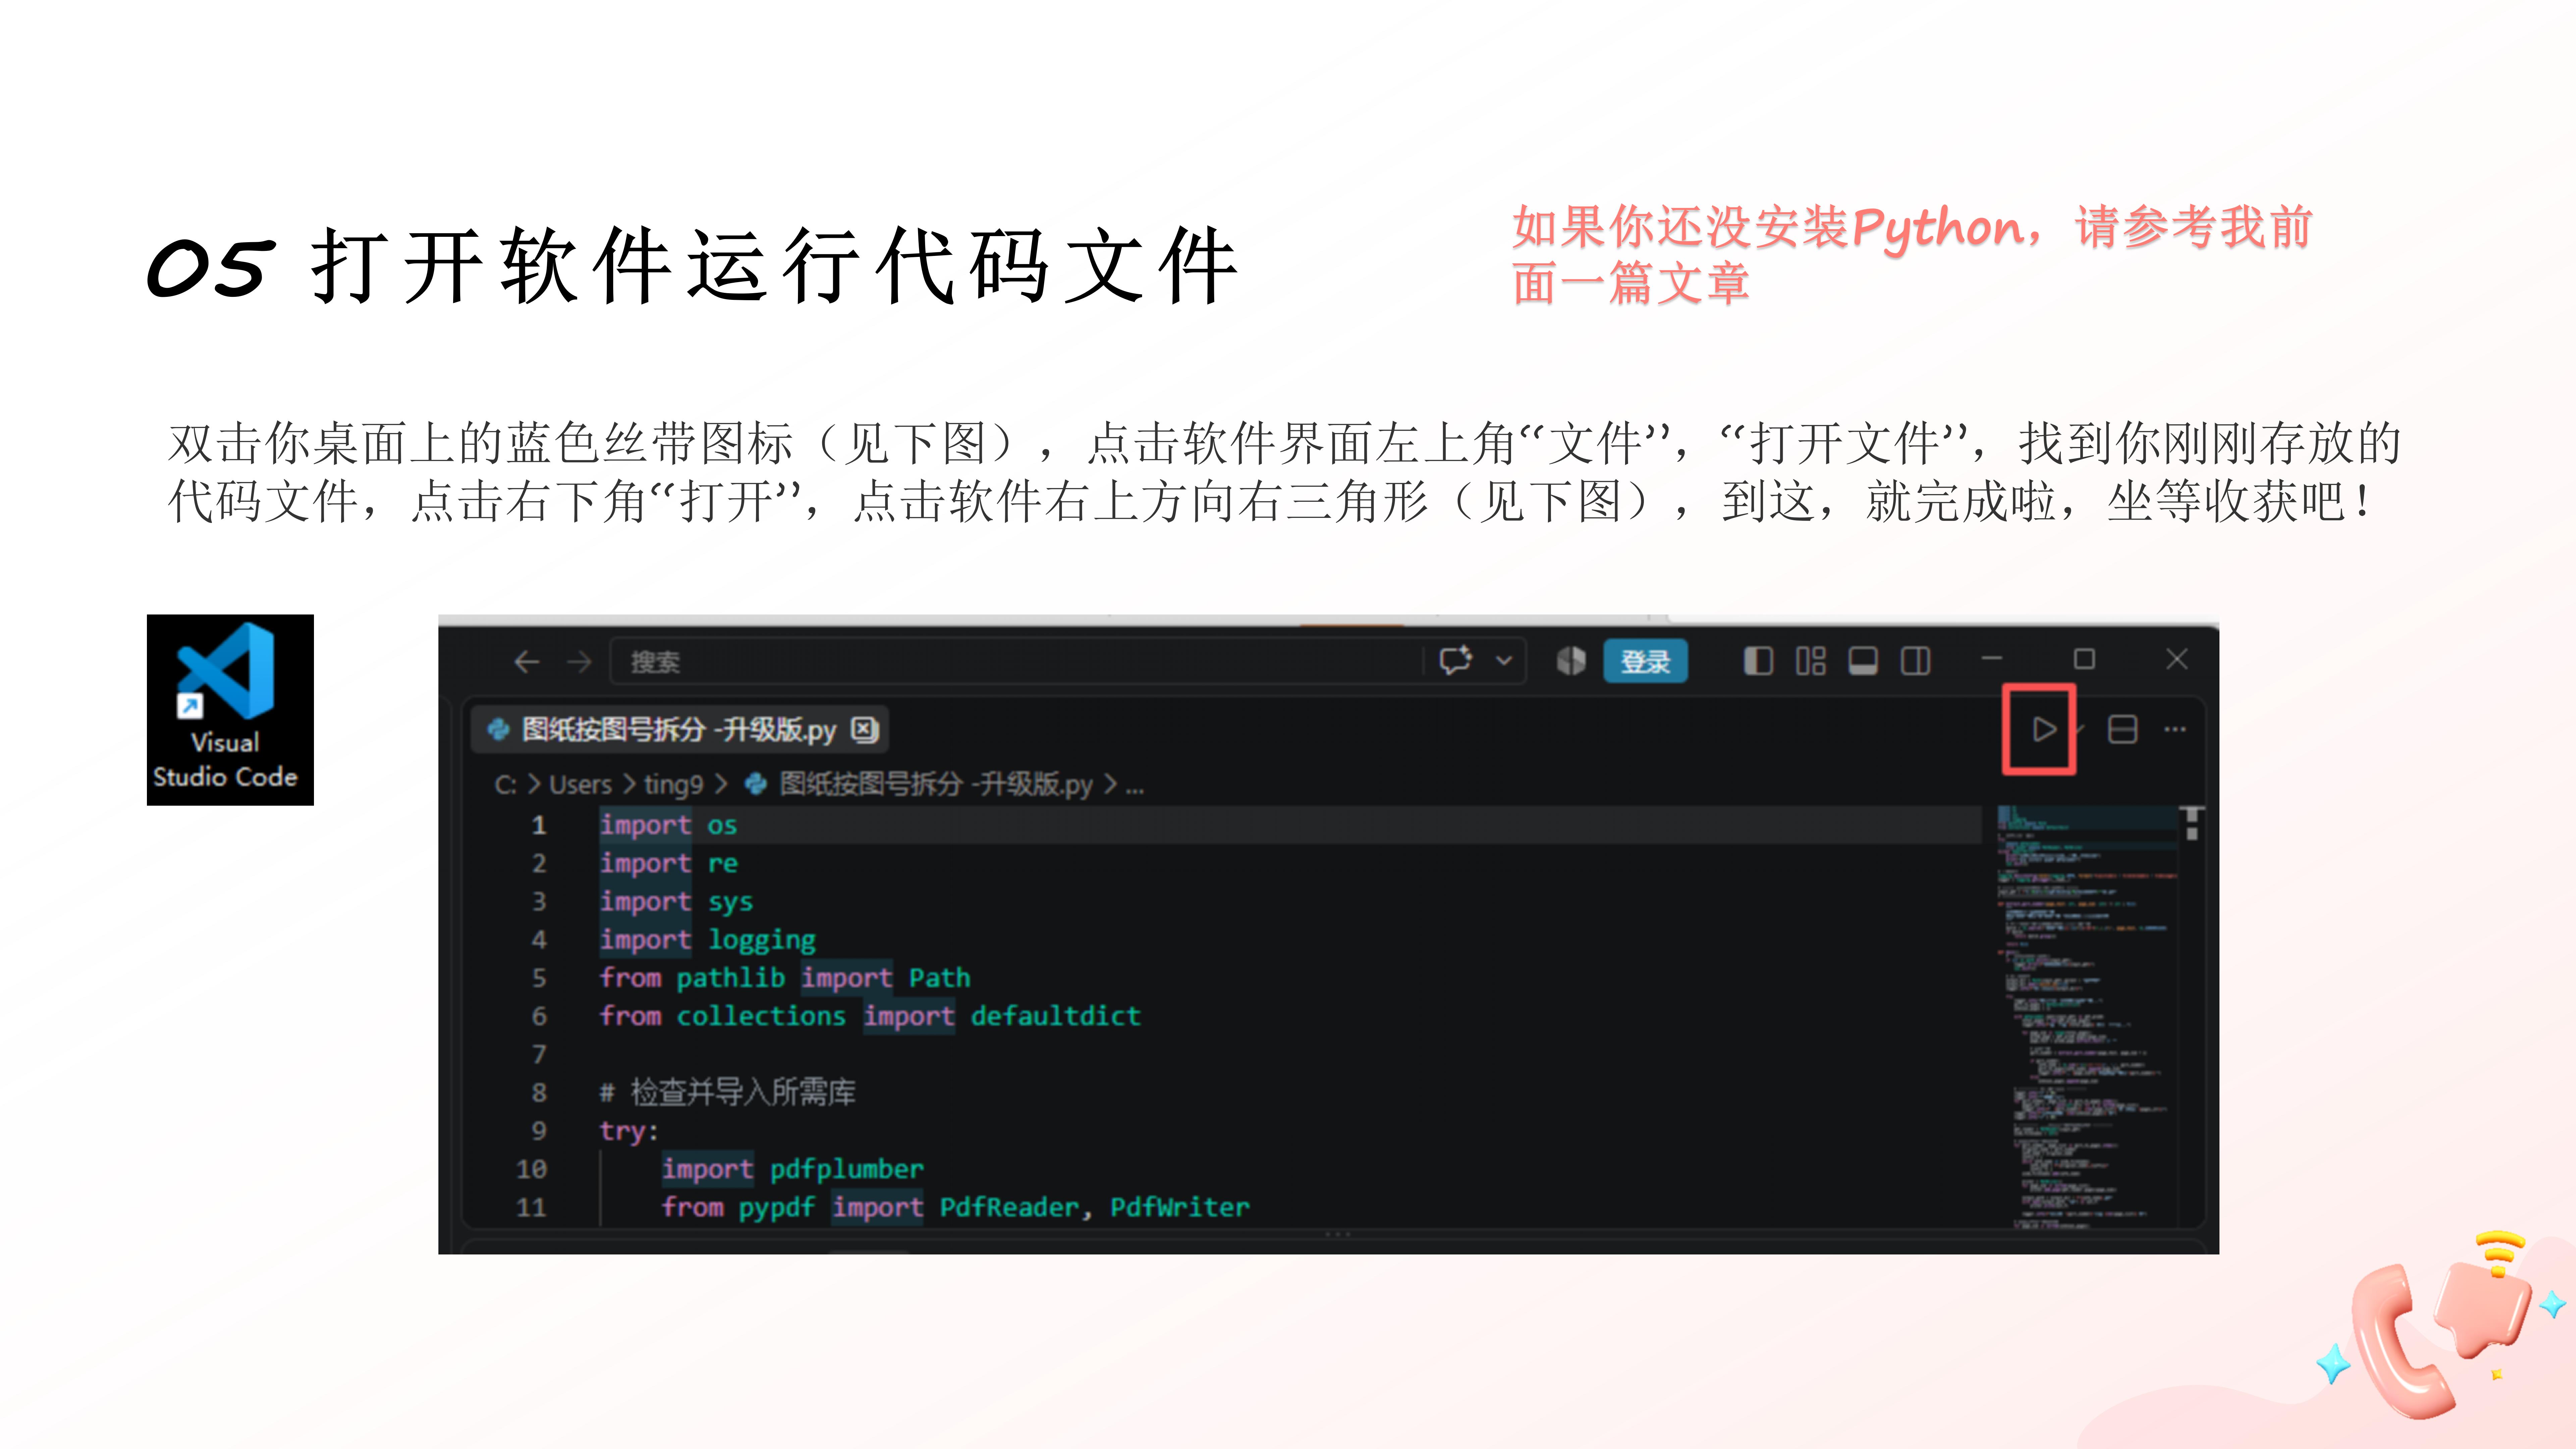  ``` import os import re import sys import logging from pathlib import Path from collections import defaultdict # 检查并导入所需库 try: import pdfplumber from pypdf import PdfReader, PdfWriter except ImportError: print("请先安装依赖库:在命令行中运行以下命令") print("pip install pypdf pdfplumber") sys.exit(1) # 配置日志 logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s') logger = logging.getLogger(__name__) # ====== 请确认下面的路径是否正确 ====== input_pdf = r"C:\Users\ting9\Desktop\Python文件夹\图纸.pdf" # ======================================= def extract_part_number(page_text: str, page_num: int) -> str | None: """ 从页面文本中提取零件图号 支持"零件图号:"或"零件图号 "(冒号或空格)后的内容 """ # 匹配"零件图号"后面跟冒号或空格,再跟图号 match = re.search(r'零件图号[::\s]+([A-Z0-9\-_\.]+)', page_text, re.IGNORECASE) if match: return match.group(1) return None def main(): # 检查输入文件是否存在 if not os.path.exists(input_pdf): logger.error(f"文件不存在:{input_pdf}") sys.exit(1) # 输出文件夹 output_dir = Path(input_pdf).parent / "拆分PDF" output_dir.mkdir(exist_ok=True) logger.info(f"输出目录:{output_dir}") try: logger.info("正在扫描所有页面,提取图号...") part_to_pages = defaultdict(list) unknown_pages = [] with pdfplumber.open(input_pdf) as pdf_plumb: total_pages = len(pdf_plumb.pages) logger.info(f"共检测到 {total_pages} 页,开始扫描...") for page_num in range(total_pages): plumb_page = pdf_plumb.pages[page_num] page_text = plumb_page.extract_text() or "" # 提取图号 part_number = extract_part_number(page_text, page_num + 1) if part_number: safe_name = re.sub(r'[\\/*?:"<>|]', '_', part_number) part_to_pages[safe_name].append(page_num) logger.info(f"第 {page_num+1} 页提取到图号:'{part_number}'") else: unknown_pages.append(page_num) # ---------- 输出统计信息 ---------- logger.info("=" * 60) logger.info("图号统计:") for part_number, page_list in part_to_pages.items(): pages_str = ", ".join(str(p+1) for p in sorted(page_list)) logger.info(f" {part_number}: {len(page_list)} 页 (页码: {pages_str})") logger.info(f"未识别页面: {len(unknown_pages)} 页") logger.info("=" * 60) # ---------- 第二步:按图号分组写入PDF ---------- pdf_reader = PdfReader(input_pdf) used_filenames = set() # 处理已识别图号的页面 for part_number, page_list in part_to_pages.items(): original_name = part_number safe_name = original_name suffix = 1 while safe_name in used_filenames: safe_name = f"{original_name}_{suffix}" suffix += 1 used_filenames.add(safe_name) writer = PdfWriter() for page_num in sorted(page_list): writer.add_page(pdf_reader.pages[page_num]) output_path = output_dir / f"{safe_name}.pdf" with open(output_path, "wb") as out_f: writer.write(out_f) logger.info(f"已保存 '{part_number}',共 {len(page_list)} 页") # 处理未识别图号的页面 for page_num in sorted(unknown_pages): safe_name = f"未识别_{page_num + 1:03d}" original_name = safe_name suffix = 1 while safe_name in used_filenames: safe_name = f"{original_name}_{suffix}" suffix += 1 used_filenames.add(safe_name) writer = PdfWriter() writer.add_page(pdf_reader.pages[page_num]) output_path = output_dir / f"{safe_name}.pdf" with open(output_path, "wb") as out_f: writer.write(out_f) logger.info(f"已保存未识别页面(原第 {page_num + 1} 页)") logger.info(f"拆分完成!文件保存在:{output_dir}") except Exception as e: logger.exception(f"处理PDF时发生错误:{e}") sys.exit(1) if __name__ == "__main__": main() main() ```



)
)
)