首页 文章 精选 留言 我的

精选列表

搜索[腾讯云双十一抄作业],共10000篇文章
优秀的个人博客,低调大师

广州腾讯云代理商:TKE 容器日志太散不好查?腾讯云 CLS 统一收集可以这样配

日志链路里最让人烦躁的,不是报错,而是静默中断——采集器状态显示正常,CLS 却迟迟刷不出新数据。这类问题在 TKE 环境里并不少见,根源往往藏在采集配置、Loglistener 运行态与 CLS 服务端写入路径之间。这篇指南尝试把 TKE容器日志收集异常排查 的常见断点和联动 CLS 分析的方法一次讲清楚,帮你从“数据丢了”找到“到底哪断了”。

优秀的个人博客,低调大师

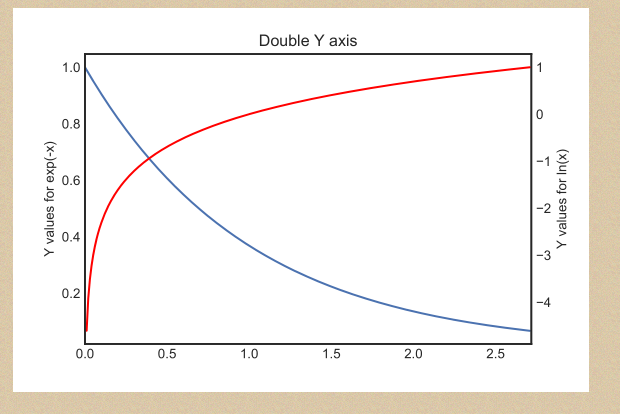
python双Y轴

import matplotlib.pyplot as plt import numpy as np x = np.arange(0., np.e, 0.01) y1 = np.exp(-x) y2 = np.log(x) fig = plt.figure() sns.set_style('white') ax1 = fig.add_subplot(111) ax1.plot(x, y1) ax1.set_ylabel('Y values for exp(-x)') ax1.set_title("Double Y axis") ax2 = ax1.twinx() # this is the important function ax2.plot(x, y2, 'r') ax2.set_xlim([0, np.e]) ax2.set_ylabel('Y values for ln(x)') ax2.set_xlabel('Same X for both exp(-x) and ln(x)') plt.show() fig.savefig('doubleY.pdf') # 生成画布, 并设定标题 plt.figure(figsize=(8, 6), dpi=80) plt.grid(True) # 画图的另外一种方式 ax_1 = plt.subplot(111) ax_1.plot(x, y_cos, color="blue", linewidth=2.0, linestyle="--", label="cos") ax_1.legend(loc="upper left", shadow=True) # 设置Y轴(左边) ax_1.set_ylabel("cosy") ax_1.set_ylim(-1.0, 1.0) ax_1.set_yticks(np.linspace(-1, 1, 9, endpoint=True)) # 画图的另外一种方式 ax_2 = ax_1.twinx() ax_2.plot(x, y_sin, color="green", linewidth=2.0, linestyle="-", label="sin") ax_2.legend(loc="upper right", shadow=True) # 设置Y轴(右边) ax_2.set_ylabel("siny") ax_2.set_ylim(-2.0, 2.0) ax_2.set_yticks(np.linspace(-2, 2, 9, endpoint=True)) # 设置X轴(共同) ax_1.set_xlabel("x") ax_1.set_xlim(-4.0, 4.0) ax_1.set_xticks(np.linspace(-4, 4, 9, endpoint=True)) # 图形显示 plt.show()

优秀的个人博客,低调大师

NLTK基础教程学习笔记(十一)

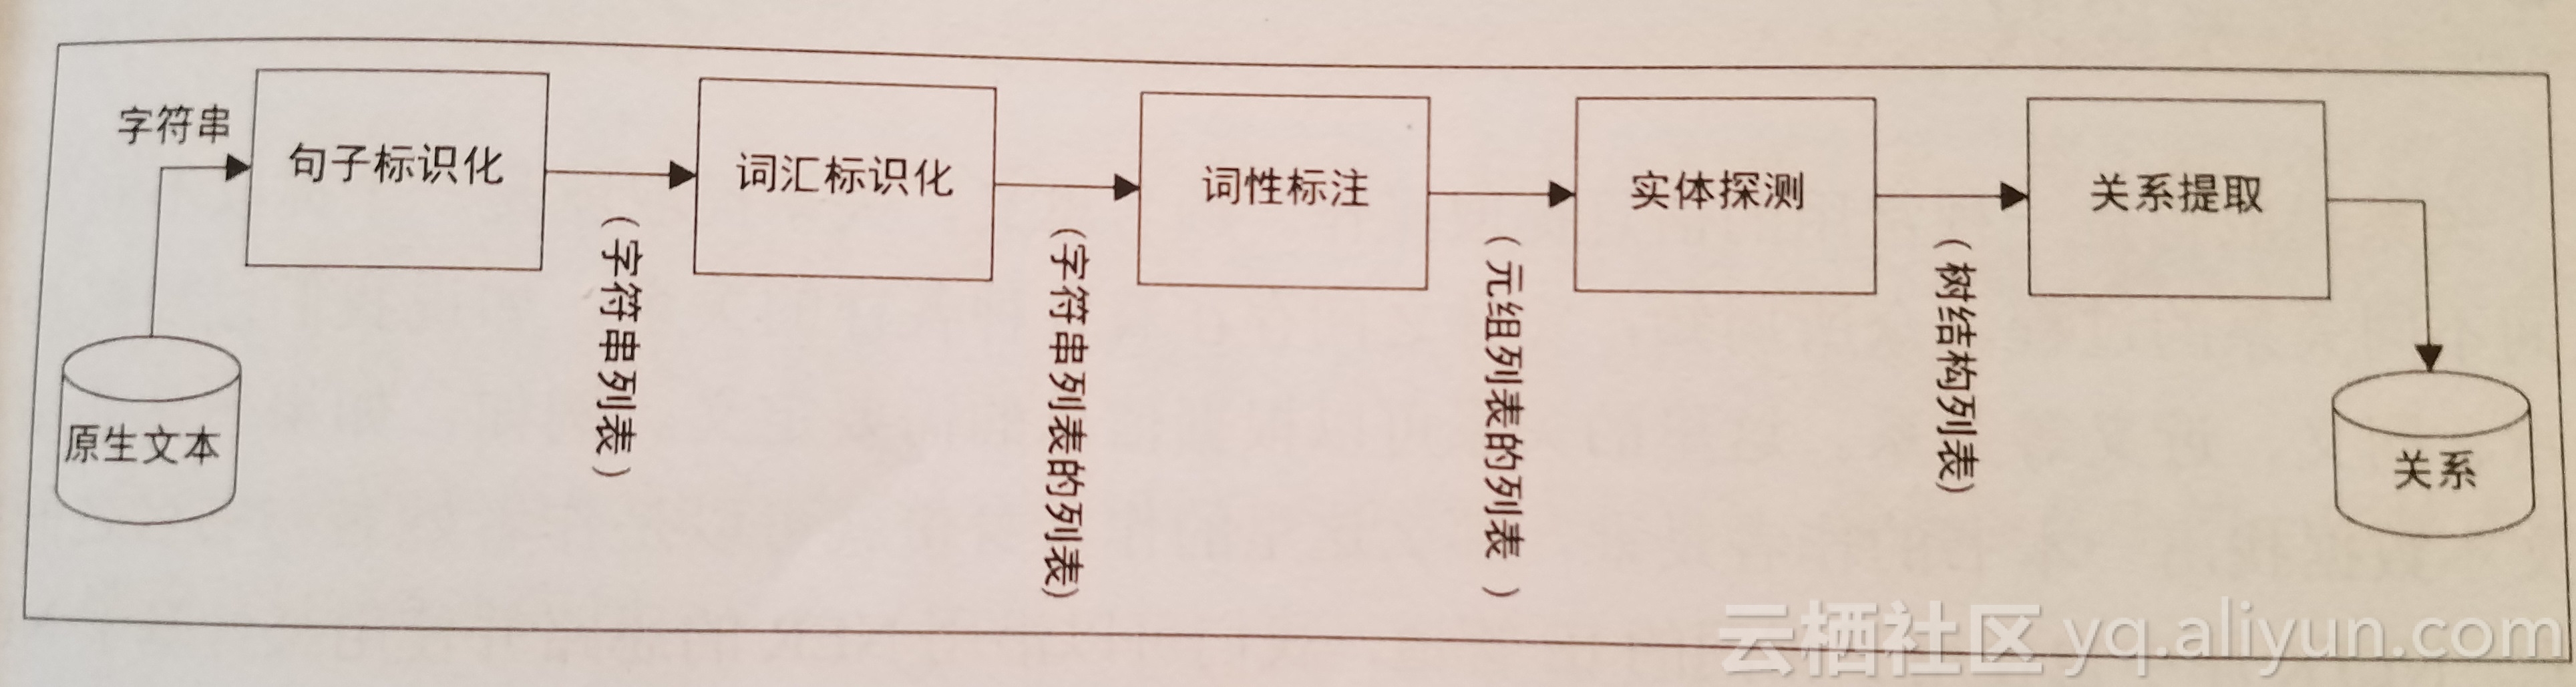
语块分解例子: from nltk.chunk.regexp import * import nltk test_sent="The prime minister announced he had asked the chief government whip, Philip Ruddock, to call a special party room meeting for 9am on Monday to consider the spill motion." test_sent_pos=nltk.pos_tag(nltk.word_tokenize(test_sent)) rule_vp=ChunkRule(r'(<VB.*>)?(<VB.*>)+(PRP)?','Chunk VPs') parser_vp=RegexpChunkParser([rule_vp],chunk_label='VP') print(parser_vp.parse(test_sent_pos)) rule_np=ChunkRule(r'(<DT>?<RB>?)?<JJ|CD>*(<JJ|CD><,>)*(<NN.*>)+','Chunk NPs') parser_np=RegexpChunkParser([rule_np],chunk_label="NP") print(parser_np.parse(test_sent_pos)) 结果: (S The/DT prime/JJ minister/NN (VP announced/VBD) he/PRP (VP had/VBD asked/VBN) the/DT chief/JJ government/NN whip/NN ,/, Philip/NNP Ruddock/NNP ,/, to/TO (VP call/VB) a/DT special/JJ party/NN room/NN meeting/NN for/IN 9am/CD on/IN Monday/NNP to/TO (VP consider/VB) the/DT spill/NN motion/NN ./.) (S (NP The/DT prime/JJ minister/NN) announced/VBD he/PRP had/VBD asked/VBN (NP the/DT chief/JJ government/NN whip/NN) ,/, (NP Philip/NNP Ruddock/NNP) ,/, to/TO call/VB (NP a/DT special/JJ party/NN room/NN meeting/NN) for/IN 9am/CD on/IN (NP Monday/NNP) to/TO consider/VB (NP the/DT spill/NN motion/NN) ./.) 上述代码是用来对动词,和名词进行划分操作,语块分解过程中会有一条管道,作用his标记POS标签,并为相关的语块分解器提供输入字符串,这里使用的是普通的语块分解器,其中的NP、VP规则定义了各种不同的可被称为动词与名词短语的POS模式。例如,NP规则定义的是所有以限定词开头,后接一个副词、形容词或纯数字的可被分解成一个名词短语的组合,这种基于一个表达式的语块分解器得依靠手动涉及分块字符串来定义分块规则。但普适式的规则很难找到。另一种方法是用机器学习的方法来进行语块的分解。信息提取:介绍了如何用NLTK库来开发一个信息提取(IE)引擎。一个典型的信息抽取管道在结构上都是非常类似的具体如下图:命名实体识别(NER)从本质上讲NER是一种提取信息的方式,它提取的是一些最常见的实体信息,如实体名词,所属的组织,以及所在的位置等。某些NER也可用于提取一般实体,如产品名词,生物医学项目、作者姓名、品牌名等。下面是一个例子: import nltk f=open('nerdemo.txt') text=f.read() sentences=nltk.sent_tokenize(text) tokenized_sentences = [nltk.word_tokenize(sentence) for sentence in sentences] tagged_sentences = [nltk.pos_tag(sentence) for sentence in tokenized_sentences] for sent in tagged_sentences: print(nltk.ne_chunk(sent)) 结果: (S I/PRP want/VBP the/DT (GPE Cherry/NNP) keyboard/NN) 上面代码按照之前的相同管道流程走了一遍,执行了所有的预处理步骤,包括句子的标识化,词汇标识化、词性标注以及NLTK的NER(预训练模型)等用来提取所有NER的步骤。关系提取:关系提取是常用的信息提取操作。是提取不同实体之间不同的关系的过程,这里的关系可以根据信息的需要定义。下面的代码中,使用了ieer的内置语料库,会对句子进行NER标注,这里唯一需要做的是指定所需的关系模式,以及该关系所定义NER种类,下面代码中组织与位置之间的关系已经被定义好了,要要提取的是这些模式的所有组合。 import re import nltk IN = re.compile(r'.*\bin\b(?!\b.+ing)') for doc in nltk.corpus.ieer.parsed_docs('NYT_19980315'): for rel in nltk.sem.extract_rels('ORG', 'LOC', doc, corpus='ieer', pattern=IN): print(nltk.sem.rtuple(rel)) 结果: [ORG: 'WHYY'] 'in' [LOC: 'Philadelphia'] [ORG: 'McGlashan &AMP; Sarrail'] 'firm in' [LOC: 'San Mateo'] [ORG: 'Freedom Forum'] 'in' [LOC: 'Arlington'] [ORG: 'Brookings Institution'] ', the research group in' [LOC: 'Washington'] [ORG: 'Idealab'] ', a self-described business incubator based in' [LOC: 'Los Angeles'] [ORG: 'Open Text'] ', based in' [LOC: 'Waterloo'] [ORG: 'WGBH'] 'in' [LOC: 'Boston'] [ORG: 'Bastille Opera'] 'in' [LOC: 'Paris'] [ORG: 'Omnicom'] 'in' [LOC: 'New York'] [ORG: 'DDB Needham'] 'in' [LOC: 'New York'] [ORG: 'Kaplan Thaler Group'] 'in' [LOC: 'New York'] [ORG: 'BBDO South'] 'in' [LOC: 'Atlanta'] [ORG: 'Georgia-Pacific'] 'in' [LOC: 'Atlanta']

优秀的个人博客,低调大师

Java NIO(十一)Non-blocking Server

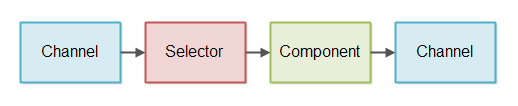
即使您了解Java NIO非阻塞功能如何工作(选择器,通道,缓冲区等),设计非阻塞服务器仍然很难。与阻塞IO相比,非阻塞IO包含几个挑战。这个无阻塞的服务器教程将讨论非阻塞服务器的主要挑战,并为他们描述一些潜在的解决方案。 本教程中介绍的想法是围绕Java NIO设计的。但是,我相信这些想法可以在其他语言中重用,只要它们具有某种类似于Selector的构造。据我所知,这样的结构是由底层操作系统提供的,所以很有可能你也可以用其他语言访问它。 非阻塞服务器- GitHub库 I have created a simple proof-of-concept of the ideas presented in this tutorial and put it in a GitRebu repository for you to look at. Here is the GitHub repository:https://github.com/jjenkov/java-nio-server 感谢国外作者Jakob Jenkov 非阻塞IO管道 非阻塞IO管道是处理非阻塞IO的组件链。 这包括以非阻塞方式读取和写入IO。 下面是一个简化的非阻塞IO管道的例子: 一个组件使用一个Selector来检查一个Channel何时有数据读取。然后,组件读取输入数据并根据输入生成一些输出。输出再次写入通道。 非阻塞IO管道不需要读取和写入数据。有些流水线只能读取数据,有些流水线只能写数据。 上图仅显示单个组件。非阻塞IO管道可能有多个组件处理传入数据。非阻塞IO管道的长度取决于管道需要做什么。 非阻塞IO管道也可能同时从多个通道读取。例如,从多个SocketChannel读取数据。 上图中的控制流程也被简化了。它是通过选择器启动从通道读取数据的组件。不是Channel将数据推送到Selector,而是从那里进入组件,即使这是上图所示。 大概这个组件就是 Buffer吧 非阻塞与阻塞IO管道 非阻塞和阻塞IO管道之间的最大区别在于如何从底层通道(套接字或文件)读取数据。 IO管道通常从某个流(从一个套接字或文件)读取数据,并将该数据拆分为一致的消息。 这与使用分词器将数据流分解为令牌进行分析类似。 相反,您将数据流分解为更大的消息。 我将调用将消息流分解成消息读取器的消息。 下面是一个消息阅读器将消息分解成消息的图示: image.png 阻塞IO管道可以使用类似于InputStream的接口,一次一个字节可以从底层通道读取,而类似于InputStream的接口将阻塞,直到有数据准备好读取。 这导致阻塞消息阅读器实现。 使用阻塞IO接口来简化消息阅读器的实现。 阻塞消息阅读器从不必处理没有从流中读取数据的情况,或者只从流中读取部分消息并且需要稍后恢复消息解析的情况。 同样,一个阻塞消息编写器(一个将消息写入流的组件)从来不必处理只写入消息的一部分的情况,以及稍后必须恢复消息写入的情况。 阻塞IO管道缺陷 虽然拦截消息阅读器更容易实现,但它有一个不幸的缺点是需要一个单独的线程为每个流需要被拆分成消息。这是必要的原因是每个流的IO接口阻塞,直到有一些数据要从中读取。这意味着单个线程不能尝试从一个流中读取,如果没有数据,则从另一个流中读取。只要线程试图从流中读取数据,线程就会阻塞,直到实际上有一些数据要读取。 如果IO管道是必须处理大量并发连接的服务器的一部分,则服务器将需要每个活动的入口连接一个线程。如果服务器在任何时候只有几百个并发连接,这可能不成问题。但是,如果服务器有数百万并发连接,这种类型的设计不能很好地扩展。每个线程将为其堆栈提供320K(32位JVM)和1024K(64位JVM)内存。那么,1.000.000个线程将占用1TB的内存!也就是说,在服务器已经使用任何存储器来处理传入消息(例如分配给在消息处理期间使用的对象的存储器)之前。 为了减少线程的数量,许多服务器使用一种设计,其中服务器保持一个线程池(例如100个),该线程池一次从入站连接读取消息。入站连接保留在队列中,并且线程按顺序处理来自每个入站连接的消息,并将入站连接放入队列中。这里说明这个设计: image.png 但是,这种设计要求入站连接经常合理地发送数据。 如果入站连接可能处于非活动状态的时间较长,大量的非活动连接实际上可能会阻塞线程池中的所有线程。 这意味着服务器响应缓慢甚至无响应。 一些服务器设计试图通过线程池中的线程数量具有一定弹性来缓解这个问题。 例如,如果线程池用完线程,线程池可能会启动更多的线程来处理负载。 此解决方案意味着需要更多数量的慢连接才能使服务器无响应。 但请记住,您可以运行多少个线程的上限仍然存在。 所以,这不能很好地扩大与1000.000慢速连接。 基本的非阻塞IO管道设计 非阻塞IO管道可以使用单个线程来读取来自多个流的消息。 这要求流可以切换到非阻塞模式。 处于非阻塞模式时,当您尝试从中读取数据时,流可能会返回0个或更多字节。 如果流没有要读取的数据,则返回0字节。 当流实际上有一些数据要读取时,将返回1+字节。 为了避免检查有0字节的流,我们使用Java NIO Selector。 一个或多个SelectableChannel实例可以使用Selector进行注册。 当你在选择器上调用select()或selectNow()时,它只给你实际上有数据读取的SelectableChannel实例。 这里说明这个设计: image.png 阅读部分消息 当我们从一个SelectableChannel读取一个数据块时,我们不知道这个数据块是否包含少于或多于一条消息。 数据块可能包含部分消息(少于消息),完整消息或超过消息,例如1.5或2.5个消息。 这里说明了各种部分消息的可能性: image.png 处理部分消息有两个挑战: 检测数据块中是否有完整的消息。 如何处理部分消息,直到消息的其余部分到达。 检测完整消息需要消息阅读器查看数据块中的数据,以查看数据是否至少包含一条完整消息。 如果数据块包含一个或多个完整的消息,则这些消息可以沿管道向下发送以进行处理。 寻找完整的消息的过程将会重复很多,所以这个过程必须尽可能快。 只要数据块中有部分消息,或者是一个或多个完整消息,就需要存储该消息,直到该消息的其余部分从该通道到达。 检测完整消息和存储部分消息都是消息阅读器的责任。 为避免来自不同渠道实例的消息数据混合,我们将为每个渠道使用一个消息阅读器 设计如下所示: image.png 在检索到一个具有要从Selector中读取数据的Channel实例之后,与该Channel关联的Message Reader将读取数据并尝试将其分解为消息。 如果这导致读取任何完整的消息,则这些消息可以通过读取管道传递给需要处理它们的任何组件。 消息阅读器当然是协议特定的。 消息阅读器需要知道它正在尝试阅读的消息的消息格式。 如果我们的服务器实现可以跨协议重用,则需要能够插入消息读取器实现 - 可能通过以某种方式接受消息读取器工厂作为配置参数。 存储部分信息 现在我们已经确定消息阅读器负责存储部分消息,直到收到完整的消息,我们需要弄清楚这个部分消息存储应该如何实现。 我们应该考虑两个设计考虑因素: 我们希望尽可能少地复制消息数据。 越复制,性能越低。 我们希望完整的消息被存储在连续的字节序列中,以使解析消息更容易。 每个消息读取器的缓冲区 显然,部分消息需要存储在某种缓冲区中。 直接的实现是在每个消息阅读器内部简单地使用一个缓冲区。 但是,这个缓冲区应该有多大? 它需要足够大才能存储最大允许的消息。 因此,如果允许的最大消息是1MB,则每个消息读取器中的内部缓冲区至少需要1MB。 当我们达到数百万的连接时,每个连接使用1MB并不是真正的工作。 1.000.000 x 1MB仍然是1TB的内存! 而如果最大消息大小是16MB? 还是128MB? 可调整大小的缓冲区 另一个选择是在每个消息读取器中实现可调整大小的缓冲区。 一个可调整大小的缓冲区将从小的地方开始,如果缓冲区的消息太大,缓冲区将被扩展。 这样,每个连接不一定需要例如 1MB缓冲区。 每个连接只占用尽可能多的内存,因为它们需要保存下一条消息。 有几种方法来实现可调整大小的缓冲区。 所有这些都有优点和缺点,所以我将在下面的部分进行讨论。 通过复制调整大小 实现可调整大小的缓冲器的第一种方法是从例如小缓冲器开始。 4KB。如果消息不能放入4KB缓冲器中,可以分配8KB,并将来自4KB缓冲区的数据复制到较大的缓冲区中。 通过调整复制大小的缓冲区实现的优点是消息的所有数据都保存在一个连续的字节数组中。这使解析消息变得更容易。 调整大小的副本缓冲区实现的缺点是,它会导致大量的数据复制更大的消息。 为了减少数据复制,您可以分析流经系统的消息的大小,以查找会减少复制量的缓冲区大小。例如,您可能会看到大多数消息都小于4KB,因为它们只包含非常小的请求/响应。这意味着第一个缓冲区大小应该是4KB。 那么你可能会看到,如果消息大于4KB,通常是因为它包含一个文件。您可能会注意到,流经系统的大部分文件都小于128KB。那么使第二个缓冲区大小为128KB是有意义的。 最后你可能会看到,一旦消息超过128KB,消息的大小就没有真正的模式,所以也许最后的缓冲区大小应该是最大的消息大小。 有了这3种缓冲区大小,可以根据流经系统的消息的大小,减少数据复制的次数。低于4KB的邮件将永远不会被复制。对于1.000.000个并发连接,导致1.000.000 x 4KB = 4GB,这在今天的大多数服务器(2015)中都是可能的。 4KB和128KB之间的消息将被复制一次,只有4KB的数据将被复制到128KB缓冲区中。 128KB和最大消息大小之间的消息将被复制两次。第一次4KB将被复制,第二次128KB将被复制,所以总共132KB复制为最大的消息。假设没有那么多的128KB以上的消息,这可能是可以接受的。 一旦消息被完全处理,分配的内存应该被释放。这样,从同一连接接收到的下一个消息再次以最小的缓冲区大小开始。这是确保内存可以在连接之间更有效地共享的必要条件。很可能不是所有的连接都需要同时使用大缓冲区。 我有一个关于如何实现这样一个支持可调整大小的数组的内存缓冲区的完整教程:可调整大小的数组。本教程还包含指向GitHub存储库的链接,其中的代码显示了一个工作实现。 通过追加来调整大小 调整缓冲区大小的另一种方法是使缓冲区由多个数组组成。当您需要调整缓冲区大小时,只需分配另一个字节数组并将数据写入该数组。 有两种方式来增长这样一个缓冲区。一种方法是分配单独的字节数组并保留这些字节数组的列表。另一种方法是分配更大的共享字节数组的片,然后保存分配给缓冲区的片的列表。就我个人而言,我觉得切片方法稍好一些,但差别不大。 通过附加单独的数组或片来增长缓冲区的好处是在写入时不需要复制任何数据。所有数据可以直接从套接字(Channel)直接复制到数组或片中。 以这种方式增长缓冲区的缺点是数据不会存储在单个连续的数组中。这使得消息解析变得更加困难,因为解析器需要同时查找每个数组的末尾和所有数组的末尾。由于您需要在写入的数据中查找消息的结尾,因此此模型不太容易处理。 TLV编码消息 Type-length-value 一些协议消息格式使用TLV格式(类型,长度,值)进行编码。这意味着,当消息到达时,消息的总长度被存储在消息的开头。这样你就可以立即知道为整个消息分配多少内存。 TLV编码使得内存管理变得更容易。您立即知道要为消息分配多少内存。没有内存被浪费在仅部分使用的缓冲区的末尾。 TLV编码的一个缺点是,在消息的所有数据到达之前,为消息分配所有内存。一些发送较大消息的缓慢连接可以分配所有可用的内存,从而使服务器无响应。 解决此问题的方法是使用包含多个TLV字段的消息格式。因此,内存分配给每个字段,而不是整个消息,内存只在字段到达时才分配。尽管如此,一个大的领域可能会对你的内存管理产生同样的影响。 另一个解决方法是超时例如没有收到的消息10-15秒。这可以使您的服务器从许多大消息的同时到达的同时恢复,但它仍然会使服务器一段时间无响应。此外,有意的DoS(拒绝服务)攻击仍然可以导致您的服务器的内存完全分配。 TLV编码存在不同的变化。究竟使用了多少字节,所以指定字段的类型和长度取决于每个单独的TLV编码。也有TLV编码,首先是字段的长度,然后是类型,然后是值(LTV编码)。虽然字段的顺序是不同的,但它仍然是一个TLV变化。 TLV编码使内存管理更容易的事实是HTTP 1.1是如此糟糕的协议的原因之一。这是他们试图在HTTP 2.0中解决数据以LTV编码帧传输的问题之一。这也是为什么我们为使用TLV编码的VStack.co项目设计了自己的网络协议。 编写部分消息 在一个非阻塞的IO管道中写数据也是一个挑战。当您以非阻塞模式在通道上调用写入(ByteBuffer)时,无法保证正在写入ByteBuffer中有多少个字节。写(ByteBuffer)方法返回写了多少字节,所以可以跟踪写入的字节数。这就是挑战:跟踪部分编写的消息,以便最终发送消息的所有字节。 为了管理将部分消息写入频道,我们将创建一个消息编写器。就像使用消息读取器一样,我们需要每个通道写消息的消息写入器。在每个Message Writer内部,我们都记录了它正在写入的消息的字节数。 如果有更多的消息到达消息写入器,而不是直接写入通道,则消息需要在消息写入器内部排队。消息编写器然后将消息尽可能快地写入通道。 下面是一个图表,展示了如何设计部分消息: image.png 为了使消息编写器能够发送仅部分被发送的消息,消息编写器需要不时地被调用,所以它可以发送更多的数据。 如果你有很多的连接,你会有很多消息编写器实例。检查例如一百万个Message Writer实例来查看它们是否可以写入任何数据的速度很慢。首先,许多Message Writer实例很多没有任何消息要发送。我们不想检查那些Message Writer实例。其次,并不是所有的Channel实例都可以准备好写入数据。我们不想浪费时间试图写数据到无法接受任何数据的频道。 要检查通道是否准备好写入,可以使用选择器注册通道。但是,我们不想使用Selector注册所有Channel实例。试想一下,如果你有1.000.000连接,大部分是空闲的,所有1.000.000连接都被注册到了Selector。然后,当你调用select()时,这些Channel实例中的大部分都将准备好写入(它们大部分是空闲的,记得吗?)。然后您必须检查所有这些连接的消息编写器,看看他们是否有任何数据要写入。 为了避免检查消息的所有消息编写器实例,以及所有通道实例,它们没有任何消息发送给它们,我们使用这个两步法: 当消息写入消息写入器时,消息写入器向选择器(如果它尚未注册)注册其关联的通道。 当你的服务器有时间的时候,它会检查选择器来查看哪些已注册的通道实例准备好写入。 对于每个写入就绪通道,其相关的消息写入器被要求将数据写入通道。 如果消息写入器将其所有消息写入其通道,则该通道将再次从选择器中注销。 这个小小的两步方法确保只有Channel消息被写入到它们的实例才会真正注册到Selector中。 总结:Putting it All Together 如您所见,非阻塞服务器需要不时检查传入数据,以查看是否收到任何新的完整邮件。 服务器可能需要多次检查,直到收到一个或多个完整的消息。 检查一次是不够的。 同样,非阻塞服务器需要不时检查是否有数据要写入。 如果是,服务器需要检查是否有相应的连接准备好写入数据。 仅在消息第一次排队时检查是不够的,因为消息可能是部分写入的。 总而言之,一个非阻塞服务器最终需要定期执行三个“管道”: 读取管道,用于检查来自打开的连接的新输入数据。 处理任何收到的完整消息的流程管道。 写入管道检查是否可以将任何传出消息写入任何打开的连接。 这三条管道是循环重复执行的。 你可能会稍微优化执行。 例如,如果没有排队的消息,则可以跳过写入管道。 或者,如果我们没有收到新的,完整的消息,也许可以跳过流程管道。 以下是一个说明整个服务器循环的图表: image.png 如果您仍然觉得这有点复杂,请记住查看GitHub存储库: https://github.com/jjenkov/java-nio-server 也许看到代码在行动可能会帮助你了解如何实现这一点。 Server Thread Model GitHub仓库中的非阻塞服务器实现使用2线程的线程模型。 第一个线程接受来自ServerSocketChannel的传入连接。 第二个线程处理接受的连接,即读取消息,处理消息并将响应写回连接。 这2个线程模型如下所示: image.png

优秀的个人博客,低调大师

Spark Netty与Jetty (源码阅读十一)

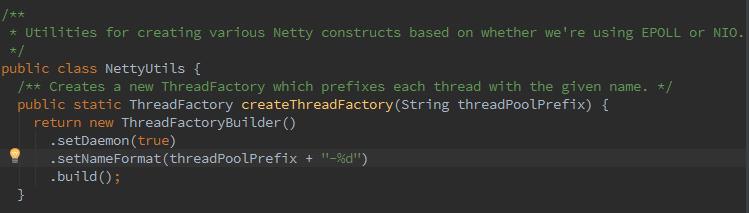
spark呢,对Netty API又做了一层封装,那么Netty是什么呢~是个鬼。它基于NIO的服务端客户端框架,具体不再说了,下面开始。 创建了一个线程工厂,生成的线程都给定一个前缀名。 像一般的netty框架一样,创建Netty的EventLoopGroup: 在常用的netty框架中呢,会创建客户端辅助类,设置SocketChannel: Bootstrap b = new Bootstrap(); b.group(group).channel(NioSocketChannel.class) spark中呢 根据参数IOMode,返回正确的客户端SocketChannel: 返回正确的服务端socketChannel: 返回远端的Channel地址: 创建一个ByteBuf对本地线程缓存禁用的分配器。ByteBuf是由事件循环线程分配,所以线程本地缓存对于TransportClient是禁用的,ByteBuf释放是由Executor线程,不是事件循环线程完成。本地线程缓存经常会延迟ByteBuf的回收,导致巨大的内存消耗。 Spark这个禽兽,对Jetty也进行了封装,什么是Jetty呢,它是以java作为开发语言的servlet容器,它的API以一组jar包的形式发布,提供网络和web服务.在我理解,Netty是用socket~Jetty呢 就是Http~那么下来,我们看一下JettyUtils: createServlet,生成HttpServlet匿名内部类,此Responder类型发生隐式转换,转换为用户传入的函数参数。 要为Jetty创建servlet,就涉及ServletContextHandler的API的使用,生成ServletContextHandler: 创建给定路径为前缀的请求的响应处理,将SparkUI中的全部handler加入ContextHandlerCollection.,如果使用配置spark.ui.filters指定了filter,则给所有handler添加filter.然后调用startServiceOnPort,最终回调函数connect:

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册