首页 文章 精选 留言 我的

精选列表

搜索[快速],共10000篇文章
优秀的个人博客,低调大师

xml与java对象的快速互转

做流程图的项目时,新的流程定义为xml的,需要对xml与java对象进行互转 查了一下activiti的转换xml方式,发现转换太麻烦了,需要一步步的解析xml 后面发现直接用jaxb就可以很快实现互转,而且现在这个jaxb在jdk内,不需要引入外部的解析xml的包 具体如下: 一.根据XML构建java对象 @XmlRootElement(name = "mxGraphModel") public class MxGraphModel { private MxRoot root; @XmlElement(name = "root") public MxRoot getRoot() { return root; } public void setRoot(MxRoot root) { this.root = root; } } 该java对象直接使用注解就可以声明,其他相关注解如下: 1.@XmlRootElement,用于类级别的注解,对应xml的跟元素。通过name属性定义这个根节点的名称。 2.@XmlAccessorType,定义映射这个类中的何种类型都需要映射到xml。(如果不存在@XmlAccessorType,默认使用XmlAccessType.PUBLIC_MEMBER注解) 参数:XmlAccessType.FIELD: java对象中的所有成员变量。 XmlAccessType.PROPERTY:java对象中所有通过getter/setter方式访问的成员变量。 XmlAccessType.PUBLIC_MEMBER:java对象中所有的public访问权限的成员变量和通过getter/setter方式访问的成员变量。 XmlAccessType.NONE: java对象的所有属性都不映射为xml的元素。 3.@XmlAttribute,用于把java对象的属性映射为xml的属性,并可通过name属性为生成的xml属性指定别名。 4.@XmlElement,指定一个字段或get/set方法映射到xml的节点。通过name属性定义这个根节点的名称。 5.@XmlElementWrapper,为数组或集合定义一个父节点。通过name属性定义这个父节点的名称。 二。执行java及xml的互转 /** * xml转对象 * * @param xml * @return * @throws JAXBException */ public MxGraphModel convertToGraphModel(String xml) throws JAXBException { StringReader reader = new StringReader(xml); JAXBContext jaxbContext = JAXBContext.newInstance(MxGraphModel.class); Unmarshaller jaxbUnmarshaller = jaxbContext.createUnmarshaller(); MxGraphModel graphModel = (MxGraphModel) jaxbUnmarshaller.unmarshal(reader); return graphModel; } /** * 将对象转为流程XML * * @param graphModel * @return * @throws JAXBException */ public String convertToXML(MxGraphModel graphModel) throws JAXBException { JAXBContext jaxbContext = JAXBContext.newInstance(MxGraphModel.class); StringWriter writer = new StringWriter(); Marshaller marshaller = jaxbContext.createMarshaller(); marshaller.marshal(graphModel, writer); String xmlStr = writer.toString(); xmlStr = StringUtils.replace(xmlStr, """, "'"); return xmlStr; } 上述该方法转换简单,易明白,但唯一不足时,对XML的解析依赖整个对象,不能动态增加XML的解析,不过现阶段来说,这个办法已经足够了!

优秀的个人博客,低调大师

openstack快速更改虚拟机配置

在使用nova resize去修改虚拟机的配置的时候,实际调用的是migrate的代码。 在默认情况下,执行resize的时候,首先会进行磁盘disk镜像和后端镜像进行一个合并成raw,然后转换成qcow2的过程。而且会进行迁移的动作。整个过程会相当的消耗时间,而且我们一般只需要修改cpu和mem的大小,并不需要去合并镜像,更不需要去做迁移。 总之,在单台宿主机上去进行nova resize是一件很让人蛋碎的事情。 事实上,在reboot一个instance的时候,这个instance的libvirt.xml(只考虑kvm环境)会重新从数据库中生成。所以只需要修改数据库就行了。 附上pyhon修改数据库脚本: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 import MySQLdb,sys ip = sys.argv[ 1 ] size = sys.argv[ 2 ] size_info = { '1' : '55800df7-5579-45c3-b4b3-584454aa2b77' , '2' : '6fe54364-e066-460b-89a2-ffe19cb26ae7' , '4' : '7a457be6-b1a0-48cd-88e1-c4e21d0518c1' , '6' : '7105ad91-3e49-43ed-9575-1a0535694578' , '8' : '61fc938c-234a-406b-b102-d535264e914d' , '12' : 'dc5ffd92-eedf-4851-a40a-90e657f799a2' , '16' : '5c7af872-2089-4ece-bba7-4099d2a3ef24' , } to_size = size_info[size] get_flavor_info_sql = "select id ,memory_mb,vcpus from instance_types \ where flavorid = '%s' ;" % \ to_size class mysqlEng(): def __init__( self ,host = '127.0.0.1' ,user = 'root' ,passwd = ' ',db=' None ',port=' 3306 '): self .conn = MySQLdb.connect(host = host,user = user,passwd = passwd,db = db,port = 3306 ) self .cur = self .conn.cursor() def select( self ,sql = 'show tables;' ): self .cur.execute(sql) ret = self .cur.fetchall() return ret def update( self ,sql = ''): self .cur.execute(sql) self .conn.commit() def __del__( self ): self .cur.close() self .conn.close() mysql_object = mysqlEng(host = '127.0.0.1' ,user = 'root' ,passwd = '123456' ,db = 'nova' ) flavor_info = mysql_object.select(get_flavor_info_sql) flavor_id = flavor_info[ 0 ][ 0 ] mem = flavor_info[ 0 ][ 1 ] vcpus = flavor_info[ 0 ][ 2 ] update_flavor_info_sql = "update instances set instance_type_id = '%d' ,vcpus = '%d' ,memory_mb = '%d' \ where hostname = '%s' AND vm_state ! = 'deleted' AND vm_state ! = 'error' ;" % \ (flavor_id,vcpus,mem,ip) mysql_object.update(update_flavor_info_sql) after_update_info_sql = "select vcpus,memory_mb from instances \ where hostname = '%s' AND vm_state ! = 'deleted' AND vm_state ! = 'error' ;" % \ ip after_update_info = mysql_object.select(after_update_info_sql) print '+' * 80 + '\n' print "This server %s now flavor : cpu=%s , mem=%s\n" % \ (ip,after_update_info[ 0 ][ 0 ],after_update_info[ 0 ][ 1 ]) print '+' * 80 + '\n' 修改脚本中size_info里的对应openstack中flavor的id号,还有mysql_obejcet对象中的mysql相关信息 使用方式:python update_size.py instance_name flavor 修改完成后必须使用nova reboot --hard instance_id 去重启,必须带上--hard去强制重启实例,不然不会生效。 本文转自lustlost 51CTO博客,原文链接:http://blog.51cto.com/lustlost/1367575,如需转载请自行联系原作者


优秀的个人博客,低调大师

快速提取 ipa 包的图片资源

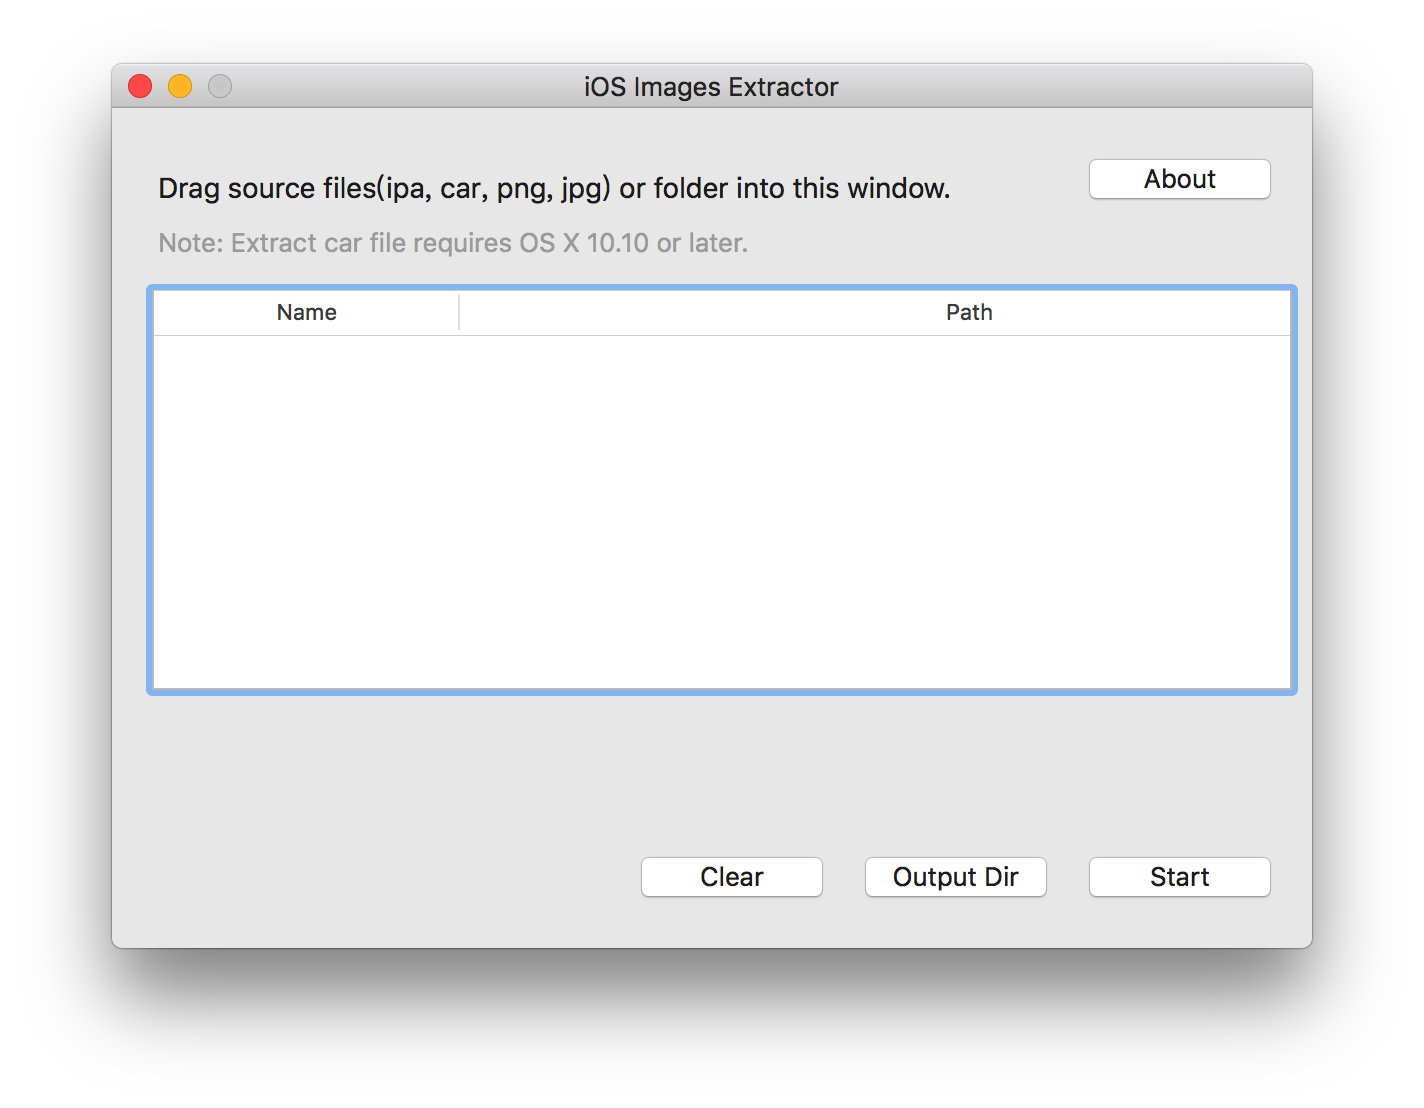
干货 从 iTunes 下载所要提取素材的 App 将下载好的 App 拖拽到桌面 下载 iOS Images Extractor iOS Images Extractor 把 App (xx.ipa) 拖拽到 iOS Images Extractor 里(指的是白色区域) 点击 Star 按钮即可开始提取图片资源文件。 当 iOS Images Extractor 左下角灰色区域显示《 Jobs done, have fun.》以后,点击 Output Dir 就能看到提取出来的图片资源文件。 补充: iOS Images Extractor 支持的文件类型: png、jpg ipa car(Assets.car) 系统要求: 软件最低支持OS X 10.8 解压Assets.car文件需要OS X 10.10或以上版本的系统 图片默认输出路径 /User/用户名/Downloads/iOSImagesExtractor

优秀的个人博客,低调大师

Ceph课堂:使用CivetWeb快速搭建RGW

优秀的开源项目正在改变传统IT,OpenStack名头最响,已经成为了IaaS的事实标准。Ceph同样颇有建树,通过其三大存储接口满足了企业的多样需求。UnitedStack有云把OpenStack和Ceph等一众开源项目的优势结合,搭建出全球最好用的高性能OpenStack云服务平台。在这个过程中,UnitedStack有云工程师对开源项目有许多的理解和分析,我们将陆续发布这些内容与大家共享,希望能够帮助大家更快的认识这些项目,避免掉进那些我们曾趟过的坑。同时,也希望大家与我们共同探讨,为更优秀的代码和架构努力。 这是我们Ceph系列文章的第四篇,之前推出的三篇Ceph文章由浅入深,受到了广泛好评,我们的Ceph系列将继续深入下去,希望能给感兴趣的人带来帮助。 RGW目前支持直接使用CivetWeb作为WebServer,实现HTTP请求的接受和回复,而不需要配置复杂的FCGI和WebServer了。 1 创建存储池 通过ceph -s命令确认你的Ceph集群已经正常运行,并且集群状态是OK。 运行以下命令创建rgw所需的存储池: cephosdpoolcreate.rgw6464 cephosdpoolcreate.rgw.root6464 cephosdpoolcreate.rgw.control6464 cephosdpoolcreate.rgw.gc6464 cephosdpoolcreate.rgw.buckets6464 cephosdpoolcreate.rgw.buckets.index6464 cephosdpoolcreate.log6464 cephosdpoolcreate.intent-log6464 cephosdpoolcreate.usage6464 cephosdpoolcreate.users6464 cephosdpoolcreate.users.email6464 cephosdpoolcreate.users.swift6464 cephosdpoolcreate.users.uid6464 2 配置 使用CivetWeb作为RGW的前端非常简单,只需要在ceph.conf的末尾中加入以下配置项即可: [client.radosgw.gateway] host={your-host-name} logfile=/var/log/radosgw/client.radosgw.ustack.log 这三行定义了一个radosgw实例,名称就叫gateway,运行的主机是{your-hostname},需要将其改成实际的主机名。 “log file”配置项代表了日志路径,需要注意的是需要保证该日志文件的父路径“ /var/log/radosgw/”必须存在,radosgw不会自动创建,你可以使用 mkdir-p/var/log/radosgw/ 创建该路径。 3 启动 启动命令: radosgw-c/etc/ceph/ceph.conf-nclient.radosgw.gateway -c参数表示使用的配置文件路径,-n表示要启动的radosgw实例名称,要与配置文件对应。 4 使用 CivetWeb启动的radosgw默认将监听7480端口。你可以直接通过访问http://your-host-ip:7480/来访问该RGW对象存储。 你可以通过radosgw-admin命令以管理员的方式访问所启动的RGW,执行例如创建用户等操作。 你也可以通过s3cmd命令行工具以用户的方式访问RGW,或者通过s3broswer图形界面访问RGW,执行上传/下载文件等操作。 关于作者 ​袁冬博士,UnitedStack产品副总裁,负责UnitedStack产品、售前和对外合作工作;云计算专家,在云计算、虚拟化、分布式系统和企业级应用等方面有丰富的经验;对分布式存储、非结构数据存储和存储虚拟化有深刻地理解,在云存储和企业级存储领域有丰富的研发与实践经验;Ceph等开源存储项目的核心代码贡献者。 本文作者:袁冬 来源:51CTO

优秀的个人博客,低调大师

VPC SLB ECS RDS KvStore快速入门

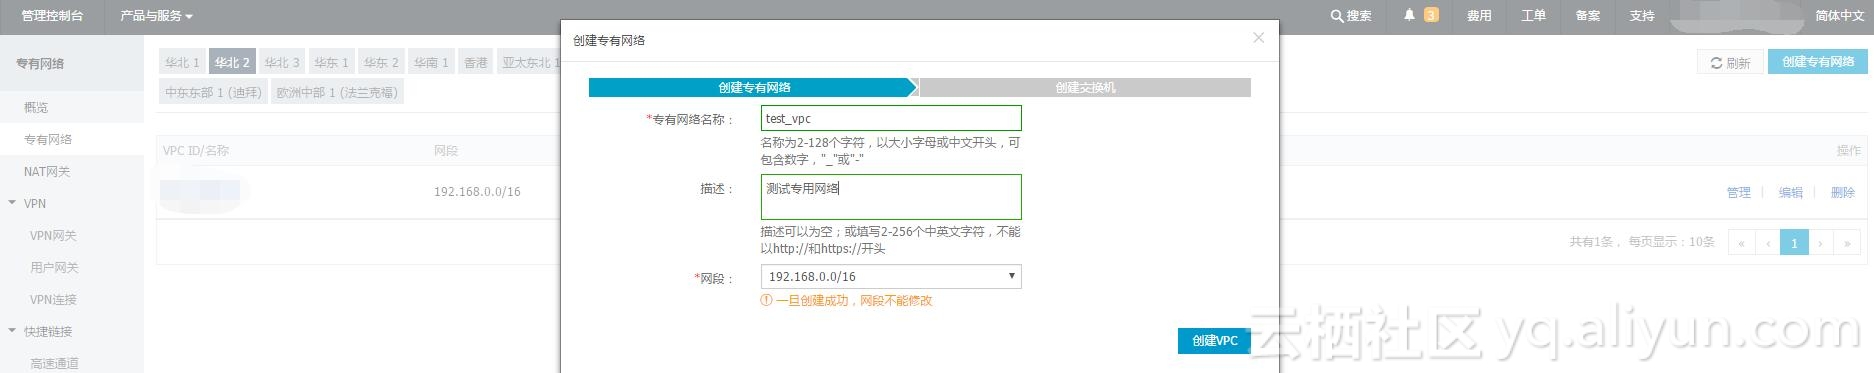
小型阿里云架构搭建 1. 创建VPC网络并购买共享带宽包(公网IP) 2. 创建专用网络下ECS 3. 创建专用网络下RDS 4. 创建专用网络下的KvStore(Redis) 5. 创建专用网络下SLB 开始教程 1. 首先需要创建一个VPC网络,使你的服务和公网隔离,保证基本网络安全 1.1 创建VPC 所有在VPC里面创建的应用都会占用一个内网IP 1.1.1 创建交换机 __注意__:有部分区域不支持VPC网络,例如:华北2C区不支持VPC的 1.2 创建网关SNAT 这里的网关和公司路由器差不多是整个VPC流量的出入口功能如下: 端口转发 IP映射 带宽包绑定show: 1.3 创建共享带宽包 因为VPC本身是一个隔离网络,外部无法访问访问,所以我们需要购买宽带,带宽自带公网IP 购买带宽的时候需要注意: 需要的公网IP数 按需付费还是按带宽(如果流量稳定建议

优秀的个人博客,低调大师

使用StreamingPro 快速构建Spark SQL on CarbonData

前言 CarbonData已经发布了1.0版本,变更还是很快的,这个版本已经移除了kettle了,使得部署和使用 变得很简单,而且支持1.6+ ,2.0+等多个Spark版本。 StreamingPro可以使得你很简单通过一个命令就能体验Carbondata,并且支持Http/JDBC的访问形态。 下载Spark发行版 比如我下载后的版本是这个: spark-1.6.3-bin-hadoop2.6。 下载StreamingPro 地址在这: https://pan.baidu.com/s/1eRO5Wga ,你会得到一个比较大的Jar包。 同时你需要到maven下载一个 carbondata-spark-1.0.0-incubating.jar ,这个因为一些特殊原因才会用到。 你需要一个数据库 因为我们用到了Hive 的mysql,所以你需要准备一个可以连接的数据库。只要能连接就行。如果没有,比如你是mac的话,用 brew install mysql即可。然后brew services start mysql 创建一个数据库: create database hive CHARACTER SET latin1 //如果数据库包字符异常啥的,启动完streamingpro后到数据库做如下更改: alter table PARTITIONS convert to character set latin1; alter table PARTITION_KEYS convert to character set latin1; 写一个hive-site.xml文件 <?xml version="1.0"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <configuration> <property> <name>javax.jdo.option.ConnectionURL</name> <value>jdbc:mysql://127.0.0.1:3306/hive?createDatabaseIfNoExist=true</value> </property> <property> <name>javax.jdo.option.ConnectionDriverName</name> <value>com.mysql.jdbc.Driver</value> </property> <property> <name>javax.jdo.option.ConnectionUserName</name> <value>你的mysql账号</value> </property> <property> <name>javax.jdo.option.ConnectionPassword</name> <value>你的mysql密码</value> </property> <property> <name>hive.metastore.warehouse.dir</name> <value>file:///tmp/user/hive/warehouse</value> </property> <property> <name>hive.exec.scratchdir</name> <value>file:///tmp/hive/scratchdir</value> </property> <property> <name>hive.metastore.uris</name> <value></value> </property> <property> <name>datanucleus.autoCreateSchema</name> <value>true</value> </property> </configuration> 可以启动了 //streamingpro jar包所处的目录, //里面新建一个query.json文件,里面放一个大括号就行 SHome=/Users/allwefantasy/streamingpro ./bin/spark-submit --class streaming.core.StreamingApp \ --master local[2] \ --name sql-interactive \ --jars /Users/allwefantasy/.m2/repository/org/apache/carbondata/carbondata-spark/1.0.0-incubating/carbondata-spark-1.0.0-incubating.jar \ --files $SHome/hive-site.xml \ --conf "spark.sql.hive.thriftServer.singleSession=true" \ $SHome/streamingpro-0.4.8-SNAPSHOT-online-1.6.1.jar \ -streaming.name sql-interactive \ -streaming.job.file.path file://$SHome/query.json \ -streaming.platform spark \ -streaming.rest true \ -streaming.driver.port 9004 \ -streaming.spark.service true \ -streaming.thrift true \ -streaming.enableCarbonDataSupport true \ -streaming.enableHiveSupport true \ -streaming.carbondata.store /tmp/carbondata/store \ -streaming.carbondata.meta /tmp/carbondata/meta参数比较多。大家不用管他。 这样http端口是9004, jdbc端口是 10000。 我们可以通过http创建一张表 , city string, age Int) STORED BY 'carbondata' curl --request POST \ --url http://127.0.0.1:9004/run/sql \ --header 'cache-control: no-cache' \ --header 'content-type: application/x-www-form-urlencoded' \ --header 'postman-token: 731441ac-c398-9a1b-2f06-8725ddbe84cd' \ --data 'sql=CREATE%20TABLE%20IF%20NOT%20EXISTS%20test_table4(id%20string%2C%20name%20string%2C%20city%20string%2C%20age%20Int)%20STORED%20BY%20'\''carbondata'\'''写入数据前,我们建立一个sample.csv的文件, id,name,city,age 1,david,shenzhen,31 2,eason,shenzhen,27 3,jarry,wuhan,35然后将这个文件导入: //实际SQL:LOAD DATA LOCAL INPATH '/Users/allwefantasy/streamingpro/sample.csv' INTO TABLE test_table4 curl --request POST \ --url http://127.0.0.1:9004/run/sql \ --header 'cache-control: no-cache' \ --header 'content-type: application/x-www-form-urlencoded' \ --header 'postman-token: 5eb19ab4-653c-d05f-29ab-6003d7e83755' \ --data 'sql=LOAD%20DATA%20LOCAL%20INPATH%20%20'\''%2FUsers%2Fallwefantasy%2Fstreamingpro%2Fsample.csv'\''%20%20INTO%20TABLE%20test_table4'这个使用我们可以用http查询: //sql: SELECT * FROM test_table4 curl --request POST \ --url http://127.0.0.1:9004/run/sql \ --header 'cache-control: no-cache' \ --header 'content-type: application/x-www-form-urlencoded' \ --header 'postman-token: d99349ae-b226-8a4e-4d65-d92b1771c111' \ --data 'sql=SELECT%20*%20FROM%20test_table4'你也可以写一个jdbc程序: object ScalaJdbcConnectSelect { def main(args: Array[String]) { // connect to the database named "mysql" on the localhost val driver = "com.mysql.jdbc.Driver" val url = "jdbc:hive2://localhost:10000/default" // there's probably a better way to do this var connection:Connection = null try { // make the connection Class.forName(driver) connection = DriverManager.getConnection(url) // create the statement, and run the select query val statement = connection.createStatement() val resultSet = statement.executeQuery("SELECT * FROM test_table4 ") while ( resultSet.next() ) { println(" city = "+ resultSet.getString("city") ) } } catch { case e => e.printStackTrace } connection.close() } }完成。

优秀的个人博客,低调大师

EDAS:快速搞定分布式应用

本期分享嘉宾: 滨雨 多年IT领域工作经验,先后在华为、阿里基础架构部担任软件工程师、项目经理。目前从事存储、cdn、视频、中间件等技术领域的支持,喜欢新技术,喜欢新挑战,喜欢钻研。 攻城狮:谁又动了我模块接口?谁又改了我模块逻辑??? 运维:有bug!模块之间的调用跟个蜘蛛网一样,我怎么排查! 测试:这么复杂的调用逻辑,我的自动化测试用例咋写?! 架构师:业务上升了,系统要部署到多台服务器才行,这我怎么拆?! 新人入职后:代码太难理解,想shi的心都有了……. 老板:为啥大半年过去了需求还没搞定!!! 作为一个开发者,你是否经历过这样的咆哮? 这样的场景出现,不是谁的脾气有bug,而是打开方式或许不对。今天我们就通过一个真实案例,来看看分布式开发对消灭吐槽,促进团队和谐的作用。 单体应用很丰满,现实很骨感 X公司是一个秉承传统的开发方式的典型,如下图的

优秀的个人博客,低调大师

【Spark Summit East 2017】工程快速索引

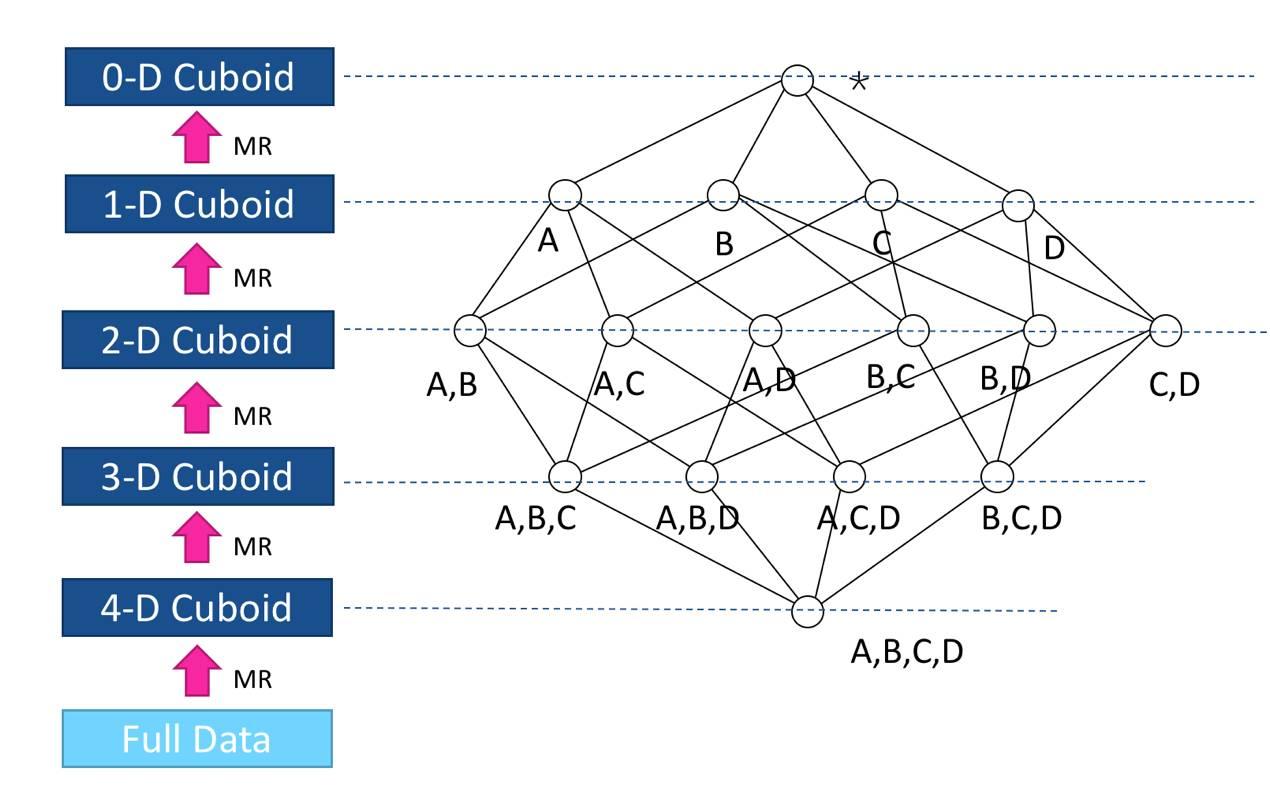
更多精彩内容参见云栖社区大数据频道https://yq.aliyun.com/big-data;此外,通过Maxcompute及其配套产品,低廉的大数据分析仅需几步,详情访问https://www.aliyun.com/product/odps。 本讲义出自Daniel Lemire在Spark Summit East 2017上的演讲,主要介绍了当代计算机硬件提供了大量新的性能的机会。然而高性能编程仍是一项艰巨的挑战,演讲中给出了一些对于设计侧重于压缩位图索引的更快索引的经验教训。压缩位图索引加速查询在流行系统,如Spark, Git, Elastic, Druid与Apache Kylin中的应用。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册