首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4351篇文章
优秀的个人博客,低调大师

#WorkBuddy# 做任务不涨进度还烧 199 积分?一次成长计划计数异常的排查与申诉实录

> 前置声明:本文所有数据来自我自己的账号用量明细导出(时间范围 2026-09-14 10:36 至 2026-09-15 09:44),所有操作路径均为我本人在 Windows 客户端上的实际操作。涉及产品机制的描述,能从我这边验证的我会说明依据,属于我个人推断的会明确标注为推断,不做绝对化结论。 ## 一、事情是怎么开始的 事情本身很简单:我在做客户端的「成长计划」任务列表,想拿积分。列表里有这么几项: - 召唤 3 次专家团 - 召唤 5 次专家 - 使用 5 个模板 - 探索优秀灵感 - 夜猫子夜间 8 折 看着都是"点几下就完"的任务。我按任务卡片上的引导一步步做,该点「去完成」的点,该发起对话的发起对话。然后问题来了:**积分实实在在地扣了,任务进度条纹丝不动。** 最典型的一次:为了做「召唤 3 次专家团」,我召唤了一支 12 名成员的分析团队,让它跑完了一整套分析流程(从数据派单、多空辩论到风险终审)。整个流程完整执行、结果也拿到了,前后消耗 63.29 积分——而任务进度依然是 `0/3`。 ## 二、先量清楚损失:199.22 积分 情绪化的抱怨没有用,能拿来申诉的只有数据。我导出了账号的用量明细(官网 → 右上角头像 → 个人主页 → 用量管理),得到一张 158 条记录的表格。 **23 小时内总消耗 538.91 积分。** 其中,跟成长计划任务有关、但做完之后进度迟迟不动的,是这么几组: | 对应任务 | 提交反馈时的进度 | 次日上午的进度 | 一整组的实际消耗 | |---|---|---|---| | 召唤 3 次专家团 | 0/3 | 1/3(延迟计入) | 63.29 | | 召唤 5 次专家(未完成部分) | 2/5 | 3/5(延迟计入) | 13.96 | | 使用 5 个模板 | 0/5 | 0/5(仍未计数) | 121.97 | | **合计** | | | **199.22** | 注意这张表的关键信息:**同样的操作,有的任务延迟了十几个小时才计数,有的(模板)过了半天依然纹丝不动。** 我最初以为 63.29 全打了水漂,一度准备全额申诉;第二天上午刷新页面才发现专家团那条悄悄变成了 1/3。延迟计数和完全不计数是两个不同的问题,申诉时值得分开写。 这里有个很重要的教训:**别只记住"那一次大操作花了多少",一定要按整组算。** 我最初只注意到团队主体分析消耗了 32.64,实际把团队启动(12.62)、四个分析师的派单、多空研究员辩论、风险终审、若干次协作回传全部加起来,这一组是 63.29——差不多是印象里那个数字的两倍。 顺便,扒明细的时候还发现了几条可疑记录: - **两条后台任务明确 `status: failed`,仍然扣了 6.07 积分**(任务失败还计费) - 一句寒暄式的提问「你们团队都能做什么?」单条扣了 **16.07 积分** - 多条用户输入后面跟着一条"会话回显"记录成对出现,其中一条场景入口调用出现了 11.86 与 0.01 两条记录 这些不在任务范围内,但属于同一个性质的"消耗异常",可以一并提。 ## 三、为什么会不计数:我能验证的部分 这一节我必须说得谨慎一点,因为**我没有官方结论**,以下只是我基于客户端行为的观察。 ### 1. 「去完成」必须先点 任务卡片上的按钮不是装饰。我第一次做的时候直接从专家页进了,后来才发现任务卡上的状态没有任何变化。后来我养成习惯:**先点任务的「去完成」,再去做实际操作。** ### 2. 「真的发起对话」才算 成长计划里大部分任务不是"点进去看一眼"就完成的。比如模板类任务,按下任务描述,需要的是**新建任务 → 选择模板 → 发起对话**这一整条链路。我早期试过直接手打指令、或者只点了界面上某个快捷入口,都没有让进度动起来。 ### 3. 进度延迟是真实存在的,而且可能很长 官方 FAQ 里提到过任务进度存在更新延迟。我的实测把这句话坐实了:专家团那条任务是**第二天上午才从 0/3 变成 1/3 的**,间隔超过 12 个小时。所以做完之后别守着页面看,隔几个小时甚至第二天再刷新,别急着下"白烧了"的结论——但反过来说,**超过一天的延迟本身就是体验问题**, feedback 里值得单独提。 ### 4. 剩下的,我判断是产品问题 上面三条都对齐之后,进度依然不动,那大概率就不是操作姿势的问题了。我在社区搜了一圈,发现**今年 7 月已经有用户发帖反馈过完全相同的现象**:召唤了多次专家团,进度一直显示 0/3,同时还伴随徽章计数对不上、专家历史记录重复显示等问题。也就是说,这是一个**至少存在了两个月、已知但未修复的计数链路问题**。 ## 四、申诉怎么提才有效 我总结了三条经验,都是踩过之后才想明白的: ### 经验一:先停手,别继续试 进度不动的时候,最要命的反应是"那我再来一次"。专家的多智能体团队是**按成员数、按轮次计费**的,一支 12 人团队跑完整流程就是几十积分。在计数逻辑没弄清之前,每试一次都是纯烧钱。**先停下来,去查,再决定。** ### 经验二:材料要齐,数据要细 提交反馈时(客户端右上角「帮助」→ 意见反馈,或头像 → 设置 → 帮助与反馈 → 意见反馈),尽量准备好: - **用量明细截图 / 导出文件**——这是最有力的证据,能证明"钱花了" - **任务进度截图**——0/3、0/5,证明"事没成" - 勾选"上传日志",让技术侧能直接看到调用链路 描述里我建议按这个结构写:**时间范围 → 总消耗 → 分别哪几组任务消耗多少 → 任务进度分别是什么 → 已经满足的规则(点过「去完成」、真实发起了对话)→ 明确诉求**。不要写成情绪宣泄,写成清单。 还有一条亲测有效的补充:**提交反馈之后,如果任务进度发生了变化(比如延迟计数到账了),要立刻追加一条更正说明。** 我提交申诉时专家团任务显示 0/3,几小时后它自己变成了 1/3——如果我不主动更正,客服后台一核对就会发现我的描述与实际不符,整份申诉的可信度都会打折扣。主动更正反而加分:它证明你反馈的是真实过程,也顺带把"计数延迟超过 12 小时"这个新问题摆到了台面上。 ### 经验三:分清"正常消耗"和"异常消耗" 我第一次整理的时候,把所有消耗都算成"冤枉钱",其实不对。23 小时里 538.91 的总消耗,大头是投稿、日常问答这些**正常使用**的部分,约 340 积分。这一部分混进申诉材料里,反而会稀释重点。**只提任务未计数的那 199.22 加失败任务仍扣费的 6.07,诉求清晰,反而更容易被受理。** 另外,官方 FAQ 里有个「补偿积分领取」入口(在个人主页的用量管理页),不需要走审核流程,有的话直接就能领,很多人不知道。 ## 五、几条省积分的实话 事件之外,我自己总结的几条使用习惯,供参考: 1. **专家团慎开。** 多智能体团队(尤其成员多的)积分消耗是单个专家的数倍,日常问答完全用不上。真要测任务,用两三人小团队问一句话就够了。 2. **一句话能问清的事,别开团队。** 我那句"你们团队都能做什么"扣了 16 积分,就是典型的拿大炮打蚊子。 3. **烂会话及时开新的。** 上下文越长,单次消耗越高,这是官方明示的三个消耗因素之一。 4. **复杂任务拆小步。** 一次性的巨型任务不仅贵,出问题也更难定位。 5. **定期看用量明细。** 我是因为这次申诉才第一次认真看明细,看完才发现一堆自己没意识到的消耗。这张表比任何省钱攻略都有用。 ## 六、写在最后 把这次经历写出来,一是给自己留个记录,二是社区里那篇 7 月的反馈帖帮到了我——看到"原来不止我一个人",我才确定该去提反馈而不是继续怀疑自己操作错了。 如果你的任务进度也卡住不动,我的建议是:**先停手,导出用量明细,把数据整理清楚,再一次性把反馈提完整;提交之后进度若有变化,立刻追加更正。** 光靠情绪,进度条不会自己往前走;但一张清晰的明细表,会让处理的人立刻明白发生了什么。 截至本文写成:专家团和召唤专家的任务都已延迟计入,模板任务(121.97 积分)仍然 0/5 未计数,申诉还在等官方回复。有后续我会回来更新。 ---

优秀的个人博客,低调大师

#WorkBuddy# GPT-6 Astra 攻破 FrontierMath Tier 4:数学评测线到头了,对开发者意味着什么

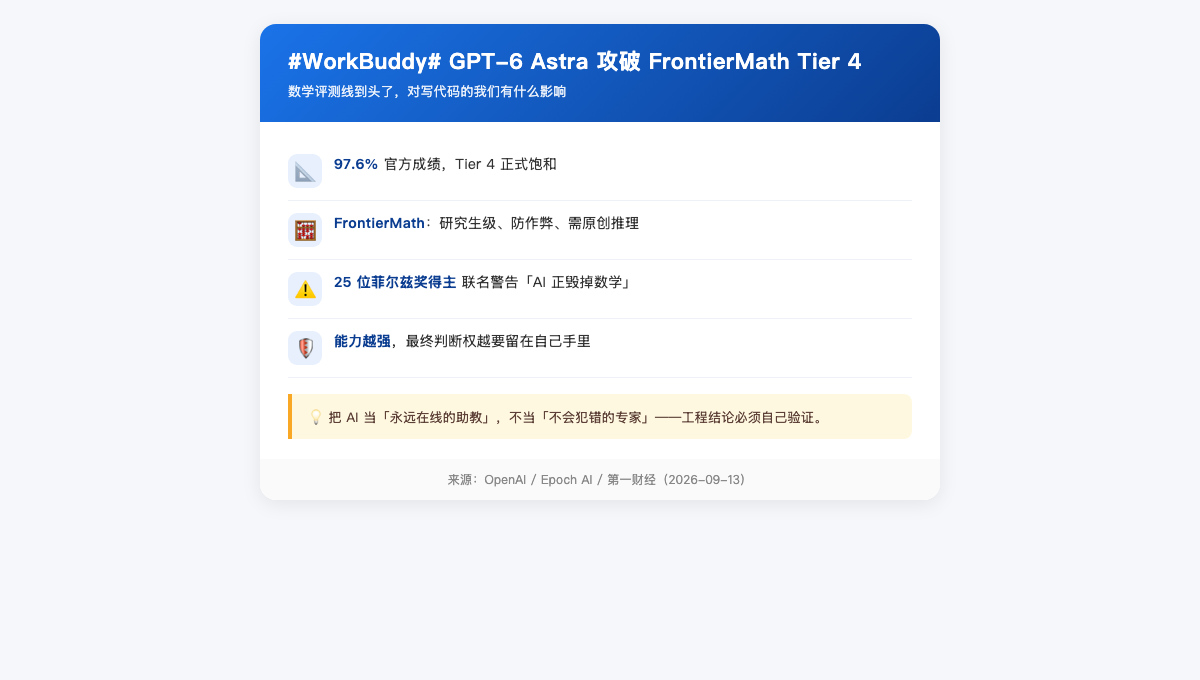
![](https://developer.qcloudimg.com/http-save/yehe-12690655/e870bfe4875abd6e978ac670bb13a879.png) 9 月 13 日这天,AI 圈同时冒出两条看起来互相打脸的新闻: 一边是 OpenAI 公布,GPT-6 Astra 把 FrontierMath 最高难度档 **Tier 4 全部解完,官方成绩 97.6%**,这套曾被称作"大模型数学噩梦"的研究级测试正式宣告**饱和**。 另一边,陶哲轩等 **25 位菲尔兹奖得主** 联名发公开信,警告"AI 正毁掉数学"——他们担心的不是 AI 解不出题,而是 AI 以越来越快的速度批量生产"真/假"结论,可能**摧毁孕育思想的沃土**。 这两件事放在一起,恰好把"AI 数学能力到底到了哪一步、对我们有什么用、又该警惕什么"这个话题,推到了最值得聊的位置。本文不吹不黑,只讲对**写代码的开发者**真正相关的部分。 FrontierMath 是 Epoch AI 在 2024 年底推出的数学基准,特点是三句话:**研究生级、防作弊、需要原创推理**。 它和普通的"高考题自动答题"完全不是一回事: - 题目是数学研究者原创的,网上找不到答案,杜绝了"背题"; - 很多题没有标准套路,需要真正的推导演绎; - Tier 4 是最高档,题目难度接近**专业数学研究**本身。 正因为它这么难,过去两年它一直被当成"AGI 数学推理的试金石"。现在 Astra 把这道最后的墙也推平了,意味着:**在"解出已知数学问题"这件事上,最强模型已经摸到人类顶尖水平的天花板**。 别只盯着"数学家慌不慌",咱写代码的人其实更该关心它带来的**工程红利**: **1. 算法与数值计算的提效** 以前你要手推一个递推公式、验证一个数值方法的收敛性,现在可以直接让模型把推导过程铺开,再拿去代码里跑验证。建模、仿真、量化这类强数学场景受益最直接。 **2. 形式化验证的助攻** 数学推理强了,意味着模型更擅长帮你写带证明性质的规约、检查边界条件。对安全敏感的系统(支付、权限、并发)这是实打实的帮助。 **3. 自动化的"猜想—验证"闭环** 研究级推理 + 代码执行,能让 Agent 自己提出假设、写程序验证、再根据结果修正。这比单纯"补全代码"高一个维度。 25 位数学家的联名信核心不是"AI 太强了",而是:**AI 批量生产结论的速度,可能快过人类验证的速度**。这对开发者是个清醒提醒—— - 模型说"这个推导是对的",**不等于真的对**。工程里必须自己跑测试、做边界检查; - "暴力解题"和"真理解"是两回事。模型可能给你一个看起来完美的答案,逻辑链却站不住; - 把 AI 当**协作者**(我提假设、它来算、我来验证)比当**权威**(它说啥我信啥)安全得多。 一句话:**能力越强,越要把最终判断权留在自己手里。** 具体到日常: - 解数学/算法难题、做数值推导,直接上最强推理模型(Astra 这类),让它把过程写出来; - 但涉及上线、涉及钱、涉及安全的结论,**一定自己验证一遍**; - 把 AI 当"永远在线的助教",而不是"不会犯错的专家"。 数学能力饱和是里程碑,但"会用"和"盲信"之间差着一条生产事故的距离。 **你最想让 AI 帮你解哪类数学或算法问题?是数值计算、公式推导、还是代码里的边界证明?** 评论区聊聊你卡过的坑,我把高频场景整理成一份"AI 数学辅助的正确打开方式"发出来。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册