Python爬虫爬取网易云音乐全部评论
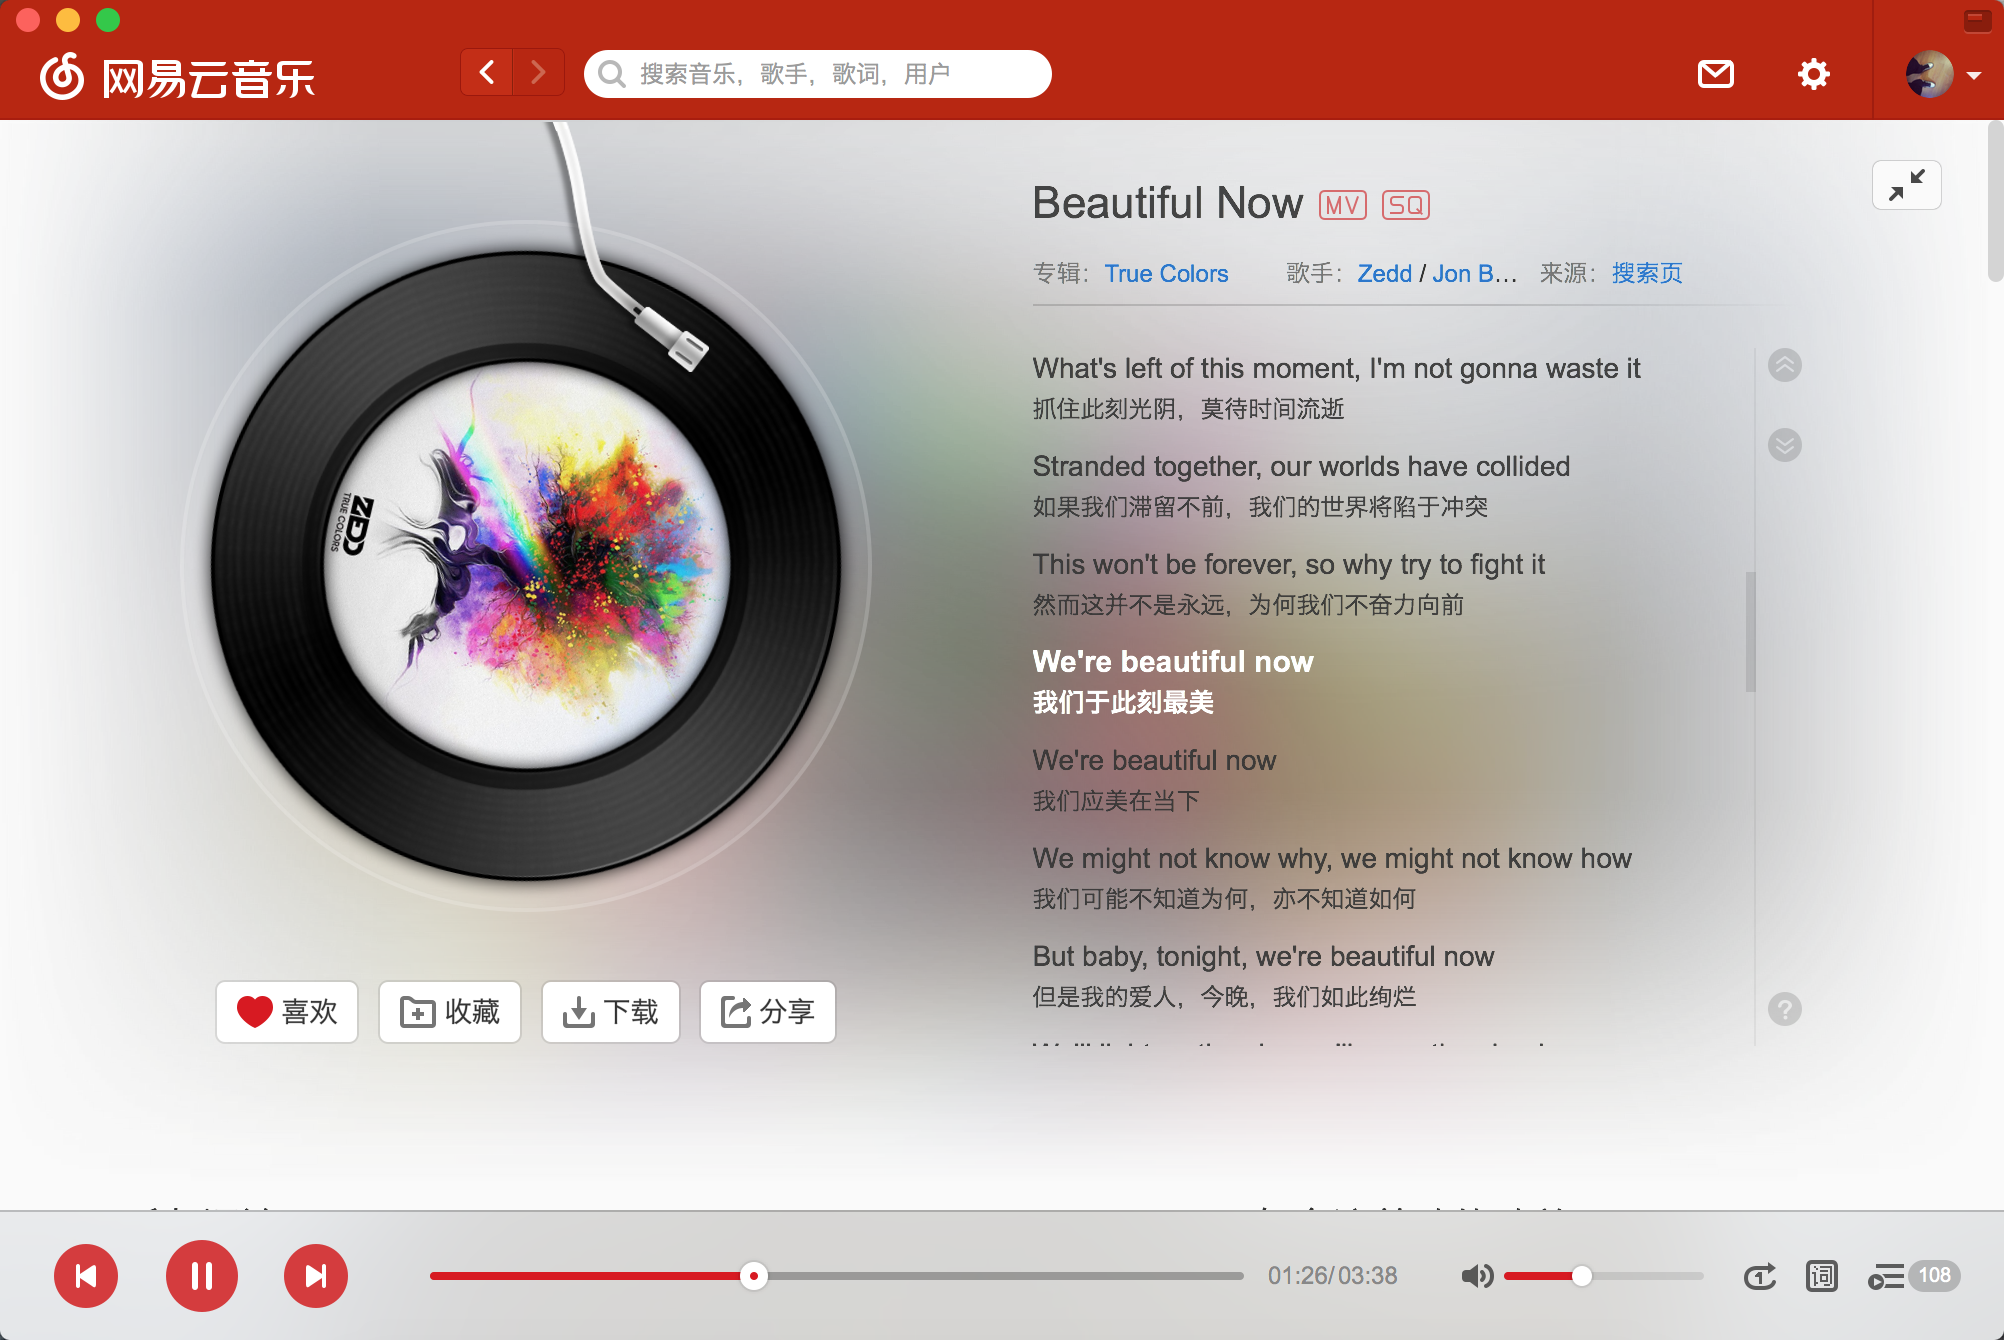
beautiful now.png 思路整理 访问网易云音乐单曲播放界面,我们可以看到当我们翻页的时候网址是没有变化的,这时候我们大致可以确定评论是通过post形式加载的; . 2.接下来就打开控制台找我们要的评论藏在哪里就好了。 我们在http://music.163.com/weapi/v1/resource/comments/R_SO_4_32019002?csrf_token=发现了我们要的评论,包括热门评论,我们注意看下R_SO_4_后面的数字,其实就是每首歌的id,如果我们想一次性爬取多首歌曲的评论的话,可以通过每次传入歌曲id来实现; image.png 我们接下来看下需要post的数据,有两个值params和encSecKey,本以为就是页码之类的,看到这两个值我其实是懵逼的,很显然是加密过了的,不过我不知道他是怎么加密的,后面在知乎上找到了解决方法,各位可以去知乎看看,我就不赘述了,因为我也没看明白……; image.png 代码部分 加密 前文说了,这部分参考了知乎的一位答主,各位可以去知乎看看,我这边只是稍微改了下就拿来用了,点这里跳转; first_param = '{rid:"", offset:"0", total:"true", limit:"20", csrf_token:""}' second_param = "010001" third_param = "00e0b509f6259df8642dbc35662901477df22677ec152b5ff68ace615bb7b725152b3ab17a876aea8a5aa76d2e417629ec4ee341f56135fccf695280104e0312ecbda92557c93870114af6c9d05c4f7f0c3685b7a46bee255932575cce10b424d813cfe4875d3e82047b97ddef52741d546b8e289dc6935b3ece0462db0a22b8e7" forth_param = "0CoJUm6Qyw8W8jud" def get_params(i): if i == 0: first_param = '{rid:"", offset:"0", total:"true", limit:"20", csrf_token:""}' else: offset =str(i*20) first_param = '{rid:"", offset:"%s", total:"%s", limit:"20", csrf_token:""}'%(offset,'flase') iv = "0102030405060708" first_key = forth_param second_key = 16 * 'F' h_encText = AES_encrypt(first_param, first_key, iv) h_encText = AES_encrypt(h_encText, second_key, iv) return h_encText def get_encSecKey(): encSecKey = "257348aecb5e556c066de214e531faadd1c55d814f9be95fd06d6bff9f4c7a41f831f6394d5a3fd2e3881736d94a02ca919d952872e7d0a50ebfa1769a7a62d512f5f1ca21aec60bc3819a9c3ffca5eca9a0dba6d6f7249b06f5965ecfff3695b54e1c28f3f624750ed39e7de08fc8493242e26dbc4484a01c76f739e135637c" return encSecKey def AES_encrypt(text, key, iv): pad = 16 - len(text) % 16 text = text + pad * chr(pad) encryptor = AES.new(key, AES.MODE_CBC, iv) encrypt_text = encryptor.encrypt(text) encrypt_text = base64.b64encode(encrypt_text) return encrypt_text 获取页码以及评论 获取页码数是为了加入循环获取每页的评论,代码如下; def get_json(url, params, encSecKey): data = { "params": params, "encSecKey": encSecKey } response = requests.post(url, headers=headers, data=data,proxies = proxies) return response.content def get_page(url): params = get_params(0); encSecKey = get_encSecKey(); json_text = get_json(url, params, encSecKey) json_dict = json.loads(json_text) total_comment = json_dict['total'] page=(total_comment/20)+1 print '***查询到评论共计%d条,%d页***'%(total_comment,page) return page 最后就是把json数据按照你想要的保存下来就好了,如果只想要热门评论的话,把comments改成hotcomments就好了。 完整代码如下: #coding = utf-8 from Crypto.Cipher import AES import base64 import requests import json import time import pandas as pd import random headers = { 'Referer': 'http://music.163.com/song?id=531051217', 'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36', 'Cookie': 'JSESSIONID-WYYY=%5CuiUi%5C%2FYs%2FcJcoQ5xd3cBhaHw0rEfHkss1s%2FCfr92IKyg2hJOrJquv3fiG2%2Fn9GZS%2FuDH8PY81zGquF4GIAVB9eYSdKJM1W6E2i1KFg9%5CuZ4xU6VdPCGwp4KOUZQQiWSlRT%2F1r07OmIBn7yYVYN%2BM2MAalUQnoYcyskaXN%5CPo1AOyVVV%3A1516866368046; _iuqxldmzr_=32; _ntes_nnid=7e2e27f69781e78f2c610fa92434946b,1516864568068; _ntes_nuid=7e2e27f69781e78f2c610fa92434946b; __utma=94650624.470888446.1516864569.1516864569.1516864569.1; __utmc=94650624; __utmz=94650624.1516864569.1.1.utmcsr=baidu|utmccn=(organic)|utmcmd=organic; __utmb=94650624.8.10.1516864569' } proxies = {'http':'http://221.200.107.118','https':'http://116.2.25.251'} first_param = '{rid:"", offset:"0", total:"true", limit:"20", csrf_token:""}' second_param = "010001" third_param = "00e0b509f6259df8642dbc35662901477df22677ec152b5ff68ace615bb7b725152b3ab17a876aea8a5aa76d2e417629ec4ee341f56135fccf695280104e0312ecbda92557c93870114af6c9d05c4f7f0c3685b7a46bee255932575cce10b424d813cfe4875d3e82047b97ddef52741d546b8e289dc6935b3ece0462db0a22b8e7" forth_param = "0CoJUm6Qyw8W8jud" def get_params(i): if i == 0: first_param = '{rid:"", offset:"0", total:"true", limit:"20", csrf_token:""}' else: offset =str(i*20) first_param = '{rid:"", offset:"%s", total:"%s", limit:"20", csrf_token:""}'%(offset,'flase') iv = "0102030405060708" first_key = forth_param second_key = 16 * 'F' h_encText = AES_encrypt(first_param, first_key, iv) h_encText = AES_encrypt(h_encText, second_key, iv) return h_encText def get_encSecKey(): encSecKey = "257348aecb5e556c066de214e531faadd1c55d814f9be95fd06d6bff9f4c7a41f831f6394d5a3fd2e3881736d94a02ca919d952872e7d0a50ebfa1769a7a62d512f5f1ca21aec60bc3819a9c3ffca5eca9a0dba6d6f7249b06f5965ecfff3695b54e1c28f3f624750ed39e7de08fc8493242e26dbc4484a01c76f739e135637c" return encSecKey def AES_encrypt(text, key, iv): pad = 16 - len(text) % 16 text = text + pad * chr(pad) encryptor = AES.new(key, AES.MODE_CBC, iv) encrypt_text = encryptor.encrypt(text) encrypt_text = base64.b64encode(encrypt_text) return encrypt_text def get_json(url, params, encSecKey): data = { "params": params, "encSecKey": encSecKey } response = requests.post(url, headers=headers, data=data,proxies = proxies) return response.content def get_page(url): params = get_params(0); encSecKey = get_encSecKey(); json_text = get_json(url, params, encSecKey) json_dict = json.loads(json_text) total_comment = json_dict['total'] page=(total_comment/20)+1 print '***查询到评论共计%d条,%d页***'%(total_comment,page) return page if __name__ == "__main__": start_time = time.time() url = "http://music.163.com/weapi/v1/resource/comments/R_SO_4_32019002?csrf_token=" page = get_page(url) for i in range(page): params = get_params(i); encSecKey = get_encSecKey(); json_text = get_json(url, params, encSecKey) json_dict = json.loads(str(json_text))['comments'] for t in list(range(len(json_dict))): if t == 0: rdata=pd.DataFrame(pd.Series(data=json_dict[t])).T else: rdata=pd.concat([rdata,pd.DataFrame(pd.Series(data=json_dict[t])).T]) if i == 0: commentdata=rdata else: commentdata=pd.concat([commentdata,rdata]) print('***正在保存第%d页***'%(i+1)) time.sleep(random.uniform(0.2,0.5)) commentdata.to_excel('NetEase_Music_Spider.xls',sheet_name='sheet1') end_time = time.time() print "程序耗时%f秒." % (end_time - start_time) print '***NetEase_Music_Spider@Awesome_Tang***' 本次爬的是最近一直循环的<beautiful now--Zedd/Jon Bellion>,评论共计37429条,1872页,程序耗时1036.046966秒,接近20分钟。 Notes 各位爬的时候一定要使用代理IP,我后面准备爬周董最近的新歌<等你下课>的评论的,爬到5000多页也就是差不多10W条的时候,被封IP了,导致我们整个公司的网络都一段时间内不能访问网易云音乐的评论,包括手机连Wi-Fi... image.png Peace~