首页 文章 精选 留言 我的

精选列表

搜索[API],共10000篇文章
优秀的个人博客,低调大师

使用Java Stream API将List按自定义分组规则转换成Map的一个例子

本文完整测试代码见文末。 测试数据是List里的4个员工对象实例: 根据员工所在的城市进行分组: 结果分成了三组: 第一组的员工在上海: 第二组的员工在成都: 统计每组员工个数: 把员工进行分组,得分大于101分的在一组,小于等于101的在另一组: 分组结果: package java8; import java.util.ArrayList; import java.util.List; import java.util.Map; import java.util.Map.Entry; import java.util.function.Consumer; import java.util.stream.Collectors; class Employee { private String city; private String name; private int score; public Employee(String name, String city, int score){ this.city = city; this.name = name; this.score = score; } public String getCity(){ System.out.println("city: " + this.city); return this.city; } public String getName() { return this.name; } public int getScore() { return this.score; } @Override public String toString() { return String.format("Employee: " + this.name + " city: " + this.city); } } class Person { private String name; private int age; Person(String name, int age) { this.name = name; this.age = age; } @Override public String toString() { return String.format("Person{name='%s', age=%d}", name, age); } } // Jerry 2016-01-15 20:51PM ? 多用于extends generic的type,接受所有Object的sub class public class StreamTest { private static void printMap(Map<? extends Object, ? extends Object> map) { for(Entry<? extends Object, ? extends Object> entry:map.entrySet()) { System.out.println("key = " + entry.getKey() + " , Value = " + entry.getValue()); } } public static void main(String[] args) { ArrayList<Employee> employees = new ArrayList<Employee>(); employees.add(new Employee("A", "Shanghai",100)); employees.add(new Employee("B", "Chengdu",101)); employees.add(new Employee("C", "Shenzhen",102)); employees.add(new Employee("D", "Chengdu",104)); // group by City Map<String, List<Employee>> employeesByCity = employees.stream().collect( Collectors.groupingBy(Employee::getCity)); // default void forEach(Consumer<? super T> action) { for(Map.Entry<String, List<Employee>> entry:employeesByCity.entrySet()) { System.out.println("key= " + entry.getKey() + " , Value = " + entry.getValue()); entry.getValue().forEach(System.out::println); } // 2016-01-15 20:37PM Consumer<Employee> aa = a -> { System.out.println("Employee: " + a.getName() + " : " + a.getScore()); }; List<Employee> chengduEmployee = employeesByCity.get("Chengdu"); chengduEmployee.forEach(aa); // test for counting Map<String, Long> employeesByCity2 = employees.stream().collect( Collectors.groupingBy(Employee::getCity, Collectors.counting())); printMap(employeesByCity2); // calculate average score Map<String, Double> employeesByCity3 = employees.stream().collect( Collectors.groupingBy(Employee::getCity, Collectors.averagingInt(Employee::getScore))); printMap(employeesByCity3); /*Stream<Person> people = Stream.of(new Person("Paul", 24), new Person("Mark", 30), new Person("Will", 28)); Map<Integer, List<String>> peopleByAge = people.collect(groupingBy(p -> p.age, mapping((Person p) -> p.name, toList()))); System.out.println(peopleByAge);*/ /* * 分区是一种特殊的分组,结果 map 至少包含两个不同的分组——一个true,一个false。 * 例如,如果想找出最优秀的员工,你可以将所有雇员分为两组,一组销售量大于 N, * 另一组小于 N,使用 partitioningBy 收集器: */ System.out.println("partition result"); Map<Boolean, List<Employee>> partitioned = employees.stream().collect(Collectors.partitioningBy(e -> e.getScore() > 101)); printMap(partitioned); /* * 你也可以将 groupingBy 收集器传递给 partitioningBy 收集器来将联合使用分区和分组。例如,你可以统计每个分区中的每个城市的雇员人数: Map<Boolean, Map<String, Long>> result = employees.stream().collect(partitioningBy(e -> e.getNumSales() > 150, groupingBy(Employee::getCity, counting()))); 这样会生成一个二级 Map: {false={London=1}, true={New York=1, Hong Kong=1, London=1}} */ } } 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

Spark RDD/Core 编程 API入门系列 之rdd实战(rdd基本操作实战及transformation和action流程图)(源...

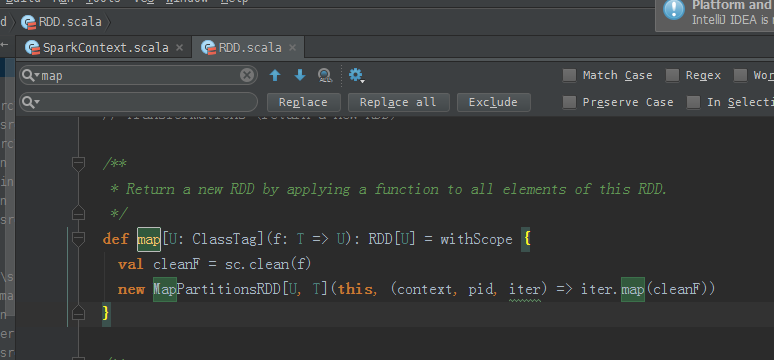
本博文的主要内容是: 1、rdd基本操作实战 2、transformation和action流程图 3、典型的transformation和action RDD有3种操作: 1、 Trandformation 对数据状态的转换,即所谓算子的转换 2、 Action 触发作业,即所谓得结果的 3、 Contoller 对性能、效率和容错方面的支持,如cache、persist、checkpoint Contoller包括cache、persist、checkpoint。 /** * Return a new RDD by applying a function to all elements of this RDD. */def map[U: ClassTag](f: T => U): RDD[U] = withScope { val cleanF = sc.clean(f) new MapPartitionsRDD[U, T](this, (context, pid, iter) => iter.map(cleanF))} 传入类型是T,返回类型是U。 元素之间,为什么reduce操作,要符合结合律和交换律?答:因为,交换律,不知,哪个数据先过来。所以,必须符合交换律。 在交换律基础上,想要reduce操作,必须要符合结合律。 /** * Reduces the elements of this RDD using the specified commutative and * associative binary operator. */def reduce(f: (T, T) => T): T = withScope { val cleanF = sc.clean(f) val reducePartition: Iterator[T] => Option[T] = iter => { if (iter.hasNext) { Some(iter.reduceLeft(cleanF)) } else { None } } var jobResult: Option[T] = None val mergeResult = (index: Int, taskResult: Option[T]) => { if (taskResult.isDefined) { jobResult = jobResult match { case Some(value) => Some(f(value, taskResult.get)) case None => taskResult } } } sc.runJob(this, reducePartition, mergeResult) // Get the final result out of our Option, or throw an exception if the RDD was empty jobResult.getOrElse(throw new UnsupportedOperationException("empty collection"))} RDD.scala(源码) 这里,新建包com.zhouls.spark.cores package com.zhouls.spark.cores /** * Created by Administrator on 2016/9/27. */ object TextLines { } 下面,开始编代码 本地模式 自动 ,会写好 源码来看, 所以,val lines = sc.textFile("C:\\Users\\Administrator\\Desktop\\textlines.txt") //通过HadoopRDD以及MapPartitionsRDD获取文件中每一行的内容本身 val lineCount = lines.map(line => (line,1)) //每一行变成行的内容与1构成的Tuple val textLines = lineCount.reduceByKey(_+_) textLines.collect.foreach(pair => println(pair._1 + ":" + pair._2)) 成功! 现在,将此行代码, textLines.collect.foreach(pair => println(pair._1 + ":" + pair._2)) 改一改 textLines.foreach(pair => println(pair._1 + ":" + pair._2)) 总结: 本地模式里, textLines.collect.foreach(pair => println(pair._1 + ":" + pair._2)) 改一改 textLines.foreach(pair => println(pair._1 + ":" + pair._2)) 运行正常,因为在本地模式下,是jvm,但这样书写,是不正规的。 集群模式里, textLines.collect.foreach(pair => println(pair._1 + ":" + pair._2)) 改一改 textLines.foreach(pair => println(pair._1 + ":" + pair._2)) 运行无法通过,因为结果是分布在各个节点上。 collect源码: /** * Return an array that contains all of the elements in this RDD. */ def collect(): Array[T] = withScope { val results = sc.runJob(this, (iter: Iterator[T]) => iter.toArray) Array.concat(results: _*) } 得出,collect后array中就是一个元素,只不过这个元素是一个Tuple。 Tuple是元组。通过concat合并! foreach源码: /** * Applies a function f to all elements of this RDD. */ def foreach(f: T => Unit): Unit = withScope { val cleanF = sc.clean(f) sc.runJob(this, (iter: Iterator[T]) => iter.foreach(cleanF)) } rdd实战(rdd基本操作实战)至此! rdd实战(transformation流程图) 拿wordcount为例! 启动hdfs集群 spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$sbin/start-dfs.sh 启动spark集群 spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6$sbin/start-all.sh 启动spark-shell spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin$./spark-shell --master spark://SparkSingleNode:7077 --executor-memory 1g scala>val partitionsReadmeRdd = sc.textFile("hdfs://SparkSingleNode:9000/README.md").flatMap(_.split(" ")).map(word =>(word,1)).reduceByKey(_+_,1).saveAsTextFile("~/partition1README.txt") 或者 scala>val readmeRdd = sc.textFile("hdfs://SparkSingleNode:9000/README.md") scala> val partitionsReadmeRdd = readmeRdd.flatMap(_.split(" ")).map(word => (word,1)).reduceByKey(_+_,1) .saveAsTextFile("~/partition1README.txt") 注意,~目录,不是这里。 为什么,我的,不是这样的显示呢? RDD的transformation和action执行的流程图 典型的transformation和action 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5913334.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark RDD/Core 编程 API入门系列之map、filter、textFile、cache、对Job输出结果进行升和降序、uni...

1、以本地模式实战map和filter 2、以集群模式实战textFile和cache 3、对Job输出结果进行升和降序 4、union 5、groupByKey 6、join 7、reduce 8、lookup 1、以本地模式实战map和filter 以local的方式,运行spark-shell。 spark@SparkSingleNode:~$ cd /usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin$ pwd /usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin$./spark-shell 从集合中创建RDD,spark中主要提供了两种函数:parallelize和makeRDD, scala>val rdd = sc.parallelize(List(1,2,3,4,5)) rdd: org.apache.spark.rdd.RDD[Int] = ParallelCollectionRDD[0] at parallelize at <console>:21 scala>val mappedRDD = rdd.map(2*_) mappedRDD: org.apache.spark.rdd.RDD[Int] = MapPartitionsRDD[1] at map at <console>:23 scala>mappedRDD.collect 得到 res0: Array[Int] = Array(2, 4, 6, 8, 10) scala> scala>val filteredRDD = mappedRDD.filter(_ > 4) 16/09/26 20:32:29 INFO storage.BlockManagerInfo: Removed broadcast_0_piece0 on localhost:40688 in memory (size: 1218.0 B, free: 534.5 MB) 16/09/26 20:32:30 INFO spark.ContextCleaner: Cleaned accumulator 1 filteredRDD: org.apache.spark.rdd.RDD[Int] = MapPartitionsRDD[2] at filter at <console>:25 scala>filteredRDD.collect 注意,一般,生产环境和正宗的写法是。 scala>val filteredRDDAgain = sc.parallelize(List(1,2,3,4,5)).map(2 * _).filter(_ > 4).collect 2、以集群模式实战textFile和cache 启动hadoop集群 spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$ jps 8457 Jps spark@SparkSingleNode:/usr/local/hadoop/hadoop-2.6.0$sbin/start-dfs.sh 启动spark集群 spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6$sbin/start-all.sh spark@SparkSingleNode:/usr/local/spark/spark-1.5.2-bin-hadoop2.6/bin$./spark-shell --master spark://SparkSingleNode:7077 读取该文件 scala>val rdd = sc.textFile("/README.md") 使用count统计一下该文件的行数 scala> rdd.count took 7.018386 s res0: Long = 98 花了时间7.018386 s 通过观察RDD.scala源代码即可知道cache和persist的区别: def persist(newLevel: StorageLevel): this.type = { if (storageLevel != StorageLevel.NONE && newLevel != storageLevel) { throw new UnsupportedOperationException( "Cannot change storage level of an RDD after it was already assigned a level") } sc.persistRDD(this) sc.cleaner.foreach(_.registerRDDForCleanup(this)) storageLevel = newLevel this } /** Persist this RDD with the default storage level (`MEMORY_ONLY`). */ def persist(): this.type = persist(StorageLevel.MEMORY_ONLY) /** Persist this RDD with the default storage level (`MEMORY_ONLY`). */ def cache(): this.type = persist() 可知: 1)RDD的cache()方法其实调用的就是persist方法,缓存策略均为MEMORY_ONLY; 2)可以通过persist方法手工设定StorageLevel来满足工程需要的存储级别; 3)cache或者persist并不是action; 附:cache和persist都可以用unpersist来取消 进行缓存 scala>rdd.cache res1: rdd.type = MapPartitionsRDD[1] at textFile at <console>:21 执行count,使得缓存生效 scala>rdd.count took 2.055063 s res2: Long = 98 花了时间2.055063 s 再执行,count took 0.583177 s res3: Long = 98 花了时间0.583177 s 总结,我们直接基于cache缓存后的数据,计算所消耗时间大大减少。 正在进行中的spark-shell 接着,对上面的RDD,进行wordcount操作 scala>val wordcount = rdd.flatMap(_.split(' ')).map((_,1)).reduceByKey(_+_) wordcount: org.apache.spark.rdd.RDD[(String, Int)] = ShuffledRDD[4] at reduceByKey at <console>:23 scala>wordcount.collect 通过saveAsTextFile把数据保存起来 res4: Array[(String, Int)] = Array((package,1), (this,1), (Version"](http://spark.apache.org/docs/latest/building-spark.html#specifying-the-hadoop-version),1), (Because,1), (Python,2), (cluster.,1), (its,1), ([run,1), (general,2), (have,1), (pre-built,1), (locally.,1), (locally,2), (changed,1), (sc.parallelize(1,1), (only,1), (several,1), (This,2), (basic,1), (Configuration,1), (learning,,1), (documentation,3), (YARN,,1), (graph,1), (Hive,2), (first,1), (["Specifying,1), ("yarn-client",1), (page](http://spark.apache.org/documentation.html),1), ([params]`.,1), (application,1), ([project,2), (prefer,1), (SparkPi,2), (<http://spark.apache.org/>,1), (engine,1), (version,1), (file,1), (documentation,,1), (MASTER,1), (example,3), (distribution.,1), (are,1), (params,1), (scala>,1), (DataFrames... scala>wordcount.saveAsTextFile("/result") 只是,仅仅对每行,做了wordcount而已。 3、对Job输出结果进行升和降序 升序 scala>val wordcount = rdd.flatMap(_.split(' ')).map((_,1)).reduceByKey(_+_).map(x => (x._2,x._1)).sortByKey(true).map(x => (x._2,x._1)).saveAsTextFile("/resultAscSorted") 同理,去下载,不多赘述。 变了 scala>val wordcount = rdd.flatMap(_.split(' ')).map((_,1)).reduceByKey(_+_).map(x => (x._2,x._1)).sortBy(true).map(x => (x._2,x._1)).saveAsTextFile("/resultAscSorted") <console>:23: error: type mismatch; found : Boolean(true) required: ((Int, String)) => ? val wordcount = rdd.flatMap(_.split(' ')).map((_,1)).reduceByKey(_+_).map(x => (x._2,x._1)).sortBy(true).map(x => (x._2,x._1)).saveAsTextFile("/resultAscSorted") ^ scala> 降序 scala>val wordcount = rdd.flatMap(_.split(' ')).map((_,1)).reduceByKey(_+_).map(x => (x._2,x._1)).sortByKey(false).map(x => (x._2,x._1)).saveAsTextFile("/resultDescSorted") 下载,同理 此刻,成功对Job输出结果进行了排序。 4、union union的使用 scala>val rdd1 = sc.parallelize(List(('a',1),('b',1))) rdd1: org.apache.spark.rdd.RDD[(Char, Int)] = ParallelCollectionRDD[26] at parallelize at <console>:21 scala>val rdd2 = sc.parallelize(List(('c',1),('d',1))) rdd2: org.apache.spark.rdd.RDD[(Char, Int)] = ParallelCollectionRDD[27] at parallelize at <console>:21 scala>rdd1 union rdd2 res6: org.apache.spark.rdd.RDD[(Char, Int)] = UnionRDD[28] at union at <console>:26 scala>val result = rdd1 union rdd2 result: org.apache.spark.rdd.RDD[(Char, Int)] = UnionRDD[29] at union at <console>:25 使用collect操作,查看一下执行结果 scala>result.collect res7: Array[(Char, Int)] = Array((a,1), (b,1), (c,1), (d,1)) 5、groupByKey scala>val wordcount = rdd.flatMap(_.split(' ')).map((_,1)).groupByKey wordcount: org.apache.spark.rdd.RDD[(String, Iterable[Int])] = ShuffledRDD[32] at groupByKey at <console>:23 scala>wordcount.collect res8: Array[(String, Iterable[Int])] = Array((package,CompactBuffer(1)), (this,CompactBuffer(1)), (Version"](http://spark.apache.org/docs/latest/building-spark.html#specifying-the-hadoop-version),CompactBuffer(1)), (Because,CompactBuffer(1)), (Python,CompactBuffer(1, 1)), (cluster.,CompactBuffer(1)), (its,CompactBuffer(1)), ([run,CompactBuffer(1)), (general,CompactBuffer(1, 1)), (YARN,,CompactBuffer(1)), (have,CompactBuffer(1)), (pre-built,CompactBuffer(1)), (locally.,CompactBuffer(1)), (locally,CompactBuffer(1, 1)), (changed,CompactBuffer(1)), (sc.parallelize(1,CompactBuffer(1)), (only,CompactBuffer(1)), (several,CompactBuffer(1)), (learning,,CompactBuffer(1)), (basic,CompactBuffer(1)), (first,CompactBuffer(1)), (This,CompactBuffer(1, 1)), (documentation,CompactBuffer(1, 1, 1)), (Confi... scala> 6、join 概念知识,参考 http://www.cnblogs.com/goforward/p/4748128.html scala>val rdd1 = sc.parallelize(List(('a',1),('a',2),('b',3),('b',4))) rdd1: org.apache.spark.rdd.RDD[(Char, Int)] = ParallelCollectionRDD[33] at parallelize at <console>:21 scala>val rdd2 = sc.parallelize(List(('a',5),('a',6),('b',7),('b',8))) rdd2: org.apache.spark.rdd.RDD[(Char, Int)] = ParallelCollectionRDD[34] at parallelize at <console>:21 scala>rdd1 join rdd2 res9: org.apache.spark.rdd.RDD[(Char, (Int, Int))] = MapPartitionsRDD[37] at join at <console>:26 scala>val result = rdd1 join rdd2 result: org.apache.spark.rdd.RDD[(Char, (Int, Int))] = MapPartitionsRDD[40] at join at <console>:25 scala>result.collect res10: Array[(Char, (Int, Int))] = Array((b,(3,7)), (b,(3,8)), (b,(4,7)), (b,(4,8)), (a,(1,5)), (a,(1,6)), (a,(2,5)), (a,(2,6))) scala> 可见,join操作,完全是一个笛卡尔积的操作。 7、reduce reduce本身啊,在RDD操作里,属于一个action类型的操作,会导致job作业的提交和执行。 scala>val rdd = sc.parallelize(List(1,2,3,4,5)) rdd: org.apache.spark.rdd.RDD[Int] = ParallelCollectionRDD[41] at parallelize at <console>:21 scala>rdd.reduce(_+_) res11: Int = 15 8、lookup scala>val rdd2 = sc.parallelize(List(('a',5),('a',6),('b',7),('b',8))) rdd2: org.apache.spark.rdd.RDD[(Char, Int)] = ParallelCollectionRDD[42] at parallelize at <console>:21 scala>rdd2.lookup('a') //返回一个seq, (5, 6) 是把a对应的所有元素的value提出来组成一个seq res12: Seq[Int] = WrappedArray(5, 6) 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5910869.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册