首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

Prometheus入门+grafana集成

开始使用Prometheus $ systemctl start prometheus $ netstat -lntp tcp6 0 0 :::9090 :::* LISTEN 19824/./prometheus 在浏览器访问:http://ip:9090/graph 。Prometheus会把自身作为一个项目进行自监控,查看收集到监控项:http://172.16.180.129:9090/metrics (如果是首次启动,需要等待30s左右的时间) 使用内置表达式查看数据 地址:http://ip:9090/graph Prometheus内置监控项 prometheus_target_interval_length_seconds ,将该监控项直接输入console查询,可获取数据: ![image-20190322132500188](/Users/adai/Library/Application Support/typora-user-images/image-20190322132500188.png) 使用prometheus监控服务器 上面用Prometheus本身的数据简单演示了监控数据的查询,这里我们用一个监控服务器状态的例子来更加直观说明。 为监控服务器CPU、内存、磁盘、I/O等信息,首先需要安装node_exporter。node_exporter的作用是用于机器系统数据收集。 安装node_exporter node_exporter也是用Golang实现,直接使用预编译的二进制文件部署,开箱即用。 $ cd /home/prometheus && wget https://github.com/prometheus/node_exporter/releases/download/v0.17.0/node_exporter-0.17.0.linux-amd64.tar.gz $ tar zxvf node_exporter-0.17.0.linux-amd64.tar.gz $ mv node_exporter-0.17.0.linux-amd64 /usr/local/prometheus/node_exporter 创建systemd服务 $ vim /usr/lib/systemd/system/node_exporter.service [Unit] Description=node_exporter After=network.target [Service] Type=simple User=prometheus ExecStart=/usr/local/prometheus/node_exporter/node_exporter Restart=on-failure [Install] WantedBy=multi-user.target 启动node_exporter $ systemctl start node_exporter $netstat -lntp Active Internet connections (only servers) Proto Recv-Q Send-Q Local Address Foreign Address State PID/Program name tcp6 0 0 :::9100 :::* LISTEN 24126/node_exporter 修改prometheus.yml,加入下面的监控目标(node_exporter默认的抓取地址为http://ip:9100) - job_name: 'linux' static_configs: - targets: ['localhost:9100'] labels: instance: node1 说明:prometheus.yml中一共定义了两个监控,一个是监控prometheus自身服务,另一个是监控Linux服务器。 这里给一个完整示例: scrape_configs: - job_name: 'prometheus' static_configs: - targets: ['localhost:9090'] - job_name: 'linux' static_configs: - targets: ['localhost:9100'] labels: instance: node1 重启prometheus服务 $ systemctl restart prometheus 在Prometheus Web查看监控的目标:访问Prometheus Web,在Status->Targets页面下,我们可以看到我们配置的两个Target(linux和prometheus),它们的State为UP。 查看memory使用情况 ![image-20190322134529082](/Users/adai/Library/Application Support/typora-user-images/image-20190322134529082.png) Prometheus Web界面自带的图表是非常基础的,比较适合用来做测试。如果要构建强大的Dashboard,还是需要更加专业的工具才行。接下来我们将使用Grafana来对Prometheus采集到的数据进行可视化展示。 prometheus集成grafana 在Grafana中添加Prometheus数据源:Configuration——DataSource——"add new DataSource"——Prometheus http URL:http://localhost:9090 access:server 上述配置完成后需要导入node-exporter-server-metrics 的数据模板到grafana,两种导入方法: 通过url导入:grafana——菜单栏加号➕——import—— 输入URL https://grafana.com/dashboards/405 —— 导入——Options (Name、Folder、Prometheus) —— import 下载后导入:grafana——菜单栏加号➕——import—— 输入 下载 好的json文件 ——import 完成上述操作后即可看到node-exporter采集的数据。 在Dashboards上选Node Exporter Server Metrics模板,就可以看到被监控服务器的CPU, 内存, 磁盘等统计信息。 在Dashboards上选Prometheus Status模板,查看Prometheus各项指标数据。

优秀的个人博客,低调大师

RocketMQ入门篇

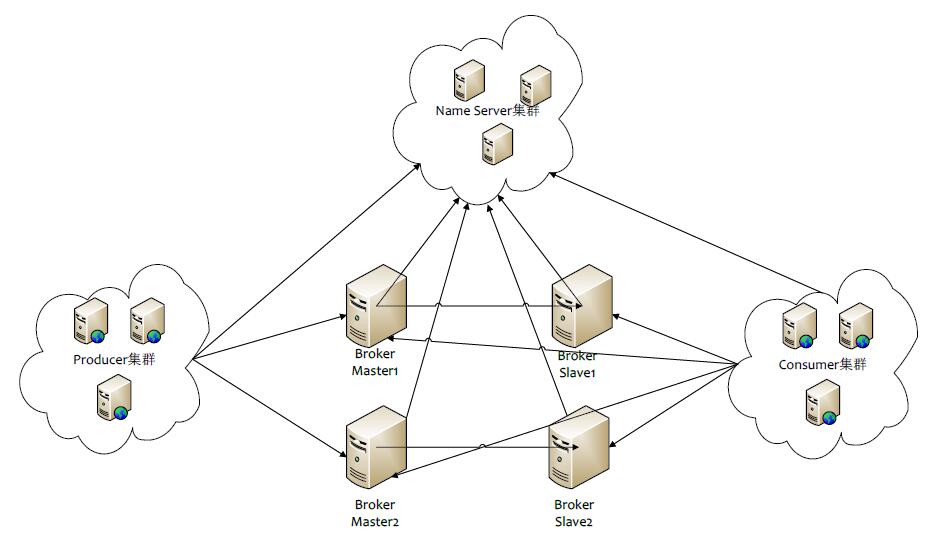
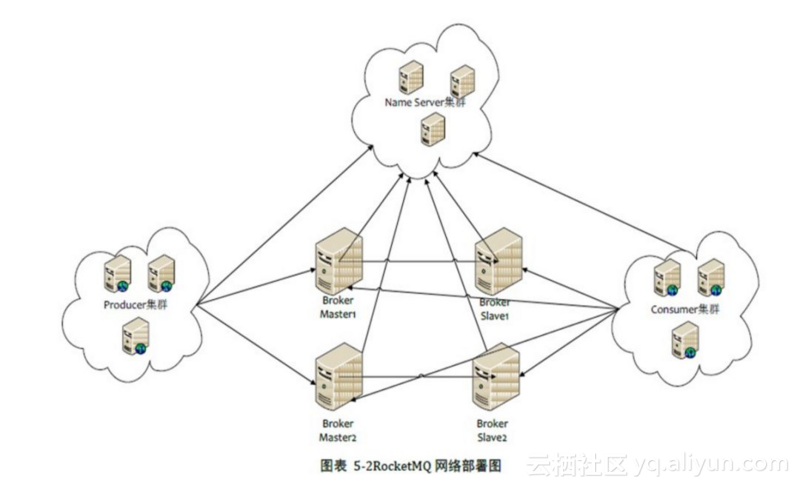
RocketMQ整体结构 如上图所示,整体可以分成4个角色,分别是:Producer,Consumer,Broker以及NameServer; 1.NameServer 可以理解为是消息队列的协调者,Broker向它注册路由信息,同时Client向其获取路由信息,如果使用过Zookeeper,就比较容易理解了,但是功能比Zookeeper弱; NameServer本身是没有状态的,并且多个NameServer直接并没有通信,可以横向扩展多台,Broker会和每一台NameServer建立长连接; 2.Broker Broker是RocketMQ的核心,提供了消息的接收,存储,拉取等功能,一般都需要保证Broker的高可用,所以会配置Broker Slave,当Master挂掉之后,Consumer然后可以消费Slave; Broker分为Master和Slave,一个Master可以对应多个Slave,Master与Slave的对应关系通过指定相同的BrokerName,不同的BrokerId来定义,BrokerId为0表示Master,非0表示Slave; 3.Producer 消息队列的生产者,需要与NameServer建立连接,从NameServer获取Topic路由信息,并向提供Topic服务的Broker Master建立连接;Producer无状态,看集群部署; 4.Consumer 消息队列的消费者,同样与NameServer建立连接,从NameServer获取Topic路由信息,并向提供Topic服务的Broker Master,Slave建立连接; 5.Topic和Message Queue 在介绍完以上4个角色以后,还需要重点介绍一下上面提到的Topic和Message Queue;字面意思就是主题,用来区分不同类型的消息,发送和接收消息前都需要先创建Topic,针对Topic来发送和接收消息,为了提高性能和吞吐量,引入了Message Queue,一个Topic可以设置一个或多个Message Queue,有点类似kafka的分区(Partition),这样消息就可以并行往各个Message Queue发送消息,消费者也可以并行的从多个Message Queue读取消息; 单机配置和部署 以下部署在centos7,jdk1.8,rocketmq4.3.2;启动RocketMQ的顺序是先启动NameServer,然后再启动Broker; 1.NameServer启动 [root@localhost bin]# ./mqnamesrv Java HotSpot(TM) 64-Bit Server VM warning: Using the DefNew young collector with the CMS collector is deprecated and will likely be removed in a future release Java HotSpot(TM) 64-Bit Server VM warning: UseCMSCompactAtFullCollection is deprecated and will likely be removed in a future release. The Name Server boot success. serializeType=JSON 如上日志表示启动成功,默认端口为9876; 2.Broker启动 [root@localhost bin]# ./mqbroker Java HotSpot(TM) 64-Bit Server VM warning: INFO: os::commit_memory(0x00000005c0000000, 8589934592, 0) failed; error='Cannot allocate memory' (errno=12) # # There is insufficient memory for the Java Runtime Environment to continue. # Native memory allocation (mmap) failed to map 8589934592 bytes for committing reserved memory. # An error report file with more information is saved as: # /root/rocketmq-all-4.3.2-bin-release/bin/hs_err_pid3977.log 启动失败,报内存不足,主要是rocketmq默认配置的启动参数值比较大,修改runbroker.sh即可 [root@localhost bin]# vi runbroker.sh JAVA_OPT="${JAVA_OPT} -server -Xms8g -Xmx8g -Xmn4g" 默认配置的可用内存为8g,虚拟机内存不够,修改为如下即可 JAVA_OPT="${JAVA_OPT} -server -Xms128m -Xmx128m -Xmn128m" 再次启动,日志如下,表示启动成功,默认端口为10911; [root@localhost bin]# ./mqbroker The broker[localhost.localdomain, 192.168.237.128:10911] boot success. serializeType=JSON 3.简单测试 3.1生产者 public class SyncProducer { public static void main(String[] args) throws Exception { // 构造Producer DefaultMQProducer producer = new DefaultMQProducer("ProducerGroupName"); producer.setNamesrvAddr("192.168.237.128:9876"); // 初始化Producer,整个应用生命周期内,只需要初始化1次 producer.start(); for (int i = 0; i < 100; i++) { Message msg = new Message("TopicTest", "TagA", ("Hello RocketMQ" + i).getBytes(RemotingHelper.DEFAULT_CHARSET)); SendResult sendResult = producer.send(msg); System.out.println(sendResult); } producer.shutdown(); } } 创建了一个DefaultMQProducer对象,同时设置了GroupName和NameServer地址,然后创建Message消息通过DefaultMQProducer将消息发送出去,返回一个SendResult对象; 3.2消费者 public class PushConsumer { public static void main(String[] args) throws MQClientException { DefaultMQPushConsumer consumer = new DefaultMQPushConsumer("please rename to unique group name"); consumer.setNamesrvAddr("192.168.237.128:9876"); consumer.setConsumeFromWhere(ConsumeFromWhere.CONSUME_FROM_FIRST_OFFSET); consumer.subscribe("TopicTest", "*"); consumer.registerMessageListener(new MessageListenerConcurrently() { public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> msgs, ConsumeConcurrentlyContext context) { System.out.printf(Thread.currentThread().getName() + "Receive New Messages :" + msgs + "%n"); return ConsumeConcurrentlyStatus.CONSUME_SUCCESS; } }); consumer.start(); } } 同样指定了GroupName和NameServer地址,订阅了Topic; 3.3运行测试 直接运行生产者报如下错误: Exception in thread "main" org.apache.rocketmq.client.exception.MQClientException: No route info of this topic, TopicTest See http://rocketmq.apache.org/docs/faq/ for further details. at org.apache.rocketmq.client.impl.producer.DefaultMQProducerImpl.sendDefaultImpl(DefaultMQProducerImpl.java:634) at org.apache.rocketmq.client.impl.producer.DefaultMQProducerImpl.send(DefaultMQProducerImpl.java:1253) at org.apache.rocketmq.client.impl.producer.DefaultMQProducerImpl.send(DefaultMQProducerImpl.java:1203) at org.apache.rocketmq.client.producer.DefaultMQProducer.send(DefaultMQProducer.java:214) at com.rocketmq.SyncProducer.main(SyncProducer.java:26) 错误显示"没有此Topic的路由信息",也就是生产者在发送消息的时候没有获取到路由信息,找不到指定的Broker,可能的原因: 1.Broker没有正确连接NameServer 2.Producer没有连接NameServer 3.Topic没有被正确创建 SyncProducer中指定了NameServer的地址,同时RocketMQ默认情况下会自动创建Topic,所以原因是Broker没有注册到NameServer,重新指定NameServer再启动: [root@localhost bin]# ./mqbroker -n localhost:9876 The broker[localhost.localdomain, 192.168.237.128:10911] boot success. serializeType=JSON and name server is localhost:9876 再次运行SyncProducer,日志如下: SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C4C60000, offsetMsgId=C0A8ED8000002A9F000000000000229C, messageQueue=MessageQueue[topic=TopicTest, brokerName=localhost.localdomain, queueId=1], queueOffset=11] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C4CD0001, offsetMsgId=C0A8ED8000002A9F000000000000234D, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=2], queueOffset=9] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C4D90002, offsetMsgId=C0A8ED8000002A9F00000000000023FE, messageQueue=MessageQueue[topic=TopicTest, brokerName=localhost.localdomain, queueId=3], queueOffset=9] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C4E80003, offsetMsgId=C0A8ED8000002A9F00000000000024AF, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=0], queueOffset=11] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C4F40004, offsetMsgId=C0A8ED8000002A9F0000000000002560, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=1], queueOffset=12] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C4F70005, offsetMsgId=C0A8ED8000002A9F0000000000002611, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=2], queueOffset=10] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C5030006, offsetMsgId=C0A8ED8000002A9F00000000000026C2, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=3], queueOffset=10] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C5070007, offsetMsgId=C0A8ED8000002A9F0000000000002773, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=0], queueOffset=12] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C50A0008, offsetMsgId=C0A8ED8000002A9F0000000000002824, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=1], queueOffset=13] SendResult [sendStatus=SEND_OK, msgId=0A0D53073B6073D16E933086C50D0009, offsetMsgId=C0A8ED8000002A9F00000000000028D5, messageQueue=MessageQueue [topic=TopicTest, brokerName=localhost.localdomain, queueId=2], queueOffset=11] 消费者使用的是push模式,可以实时接受消息: ConsumeMessageThread_13Receive New Messages :[MessageExt [queueId=1, storeSize=177,queueOffset=11, sysFlag=0, bornTimestamp=1547086138566, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430770, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F000000000000229C, commitLogOffset=8860, bodyCRC=705268097, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=12, CONSUME_START_TIME=1547086138573, UNIQ_KEY=0A0D53073B6073D16E933086C4C60000, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 48], transactionId='null'}]] ConsumeMessageThread_3Receive New Messages :[MessageExt [queueId=2, storeSize=177, queueOffset=9, sysFlag=0, bornTimestamp=1547086138573, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430783, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F000000000000234D, commitLogOffset=9037, bodyCRC=1561245975, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=10, CONSUME_START_TIME=1547086138598, UNIQ_KEY=0A0D53073B6073D16E933086C4CD0001, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 49], transactionId='null'}]] ConsumeMessageThread_17Receive New Messages :[MessageExt [queueId=3, storeSize=177, queueOffset=9, sysFlag=0, bornTimestamp=1547086138585, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430794, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F00000000000023FE, commitLogOffset=9214, bodyCRC=1141369005, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=10, CONSUME_START_TIME=1547086138601, UNIQ_KEY=0A0D53073B6073D16E933086C4D90002, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 50], transactionId='null'}]] ConsumeMessageThread_9Receive New Messages :[MessageExt [queueId=0, storeSize=177, queueOffset=11, sysFlag=0, bornTimestamp=1547086138600, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430807, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F00000000000024AF, commitLogOffset=9391, bodyCRC=855693371, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=12, CONSUME_START_TIME=1547086138612, UNIQ_KEY=0A0D53073B6073D16E933086C4E80003, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 51], transactionId='null'}]] ConsumeMessageThread_15Receive New Messages :[MessageExt [queueId=1, storeSize=177, queueOffset=12, sysFlag=0, bornTimestamp=1547086138612, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430809, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F0000000000002560, commitLogOffset=9568, bodyCRC=761548184, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=13, CONSUME_START_TIME=1547086138626, UNIQ_KEY=0A0D53073B6073D16E933086C4F40004, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 52], transactionId='null'}]] ConsumeMessageThread_11Receive New Messages :[MessageExt [queueId=2, storeSize=177, queueOffset=10, sysFlag=0, bornTimestamp=1547086138615, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430820, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F0000000000002611, commitLogOffset=9745, bodyCRC=1516469518, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=11, CONSUME_START_TIME=1547086138628, UNIQ_KEY=0A0D53073B6073D16E933086C4F70005, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 53], transactionId='null'}]] ConsumeMessageThread_4Receive New Messages :[MessageExt [queueId=3, storeSize=177,queueOffset=10, sysFlag=0, bornTimestamp=1547086138627, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430824, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F00000000000026C2,commitLogOffset=9922, bodyCRC=1131031732,reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=11, CONSUME_START_TIME=1547086138633, UNIQ_KEY=0A0D53073B6073D16E933086C5030006, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 54], transactionId='null'}]] ConsumeMessageThread_14Receive New Messages :[MessageExt [queueId=0, storeSize=177, queueOffset=12, sysFlag=0, bornTimestamp=1547086138631, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430827, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F0000000000002773, commitLogOffset=10099, bodyCRC=879565858, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=13, CONSUME_START_TIME=1547086138635, UNIQ_KEY=0A0D53073B6073D16E933086C5070007, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 55], transactionId='null'}]] ConsumeMessageThread_10Receive New Messages :[MessageExt [queueId=1, storeSize=177, queueOffset=13, sysFlag=0, bornTimestamp=1547086138634, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430830, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F0000000000002824, commitLogOffset=10276, bodyCRC=617742771, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=14, CONSUME_START_TIME=1547086138638, UNIQ_KEY=0A0D53073B6073D16E933086C50A0008, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 56], transactionId='null'}]] ConsumeMessageThread_7Receive New Messages :[MessageExt [queueId=2, storeSize=177, queueOffset=11, sysFlag=0, bornTimestamp=1547086138637, bornHost=/192.168.237.1:53524, storeTimestamp=1547139430833, storeHost=/192.168.237.128:10911, msgId=C0A8ED8000002A9F00000000000028D5, commitLogOffset=10453, bodyCRC=1406480677, reconsumeTimes=0, preparedTransactionOffset=0, toString()=Message{topic='TopicTest', flag=0, properties={MIN_OFFSET=0, MAX_OFFSET=12, CONSUME_START_TIME=1547086138641, UNIQ_KEY=0A0D53073B6073D16E933086C50D0009, WAIT=true, TAGS=TagA}, body=[72, 101, 108, 108, 111, 32, 82, 111, 99, 107, 101, 116, 77, 81, 57], transactionId='null'}]] 多机集群配置和部署 分别部署两台NameServer,两台Broker并且分别提供Slave,准备两台电脑分别是本机的windows以及虚拟机centos; 1.启动NameServer 分别启动2台NameServer,端口号都使用默认的9876,地址端口如下: 192.168.237.128:9876 10.13.83.7:9876 2.启动Broker 每台机器上分别启动一个Master和一个Slave,互为主备,在主目录下的conf文件夹下提供了多种broker配置模式,分别有:2m-2s-async,2m-2s-sync,2m-noslave,可以以此为模版做如下配置: 2.1配置10.13.83.7Master和Slave Master配置如下: namesrvAddr=192.168.237.128:9876;10.13.83.7:9876 brokerClusterName=DefaultCluster brokerName=broker-a brokerId=0 deleteWhen=04 fileReservedTime=48 brokerRole=SYNC_MASTER flushDiskType=ASYNC_FLUSH listenPort=10911 storePathRootDir=E:/rocketmq-all-4.3.2-bin-release/store-a-m Slave配置如下: namesrvAddr=192.168.237.128:9876;10.13.83.7:9876 brokerClusterName=DefaultCluster brokerName=broker-a brokerId=1 deleteWhen=04 fileReservedTime=48 brokerRole=SLAVE flushDiskType=ASYNC_FLUSH listenPort=10811 storePathRootDir=E:/rocketmq-all-4.3.2-bin-release/store-a-s 分别启动结果如下: E:\rocketmq-all-4.3.2-bin-release\bin>mqbroker -c E:\rocketmq-all-4.3.2-bin-rele ase\conf\broker-m.conf The broker[broker-a, 10.13.83.7:10911] boot success. serializeType=JSON and name server is 192.168.237.128:9876;10.13.83.7:9876 以上是Master启动日志,Slave日志如下: E:\rocketmq-all-4.3.2-bin-release\bin>mqbroker -c E:\rocketmq-all-4.3.2-bin-rele ase\conf\broker-s.conf The broker[broker-a, 10.13.83.7:10811] boot success. serializeType=JSON and name server is 192.168.237.128:9876;10.13.83.7:9876 2.2配置10.13.83.7Slave Master配置如下: namesrvAddr=192.168.237.128:9876;10.13.83.7:9876 brokerClusterName=DefaultCluster brokerName=broker-b brokerId=0 deleteWhen=04 fileReservedTime=48 brokerRole=SYNC_MASTER flushDiskType=ASYNC_FLUSH listenPort=10911 storePathRootDir=/root/rocketmq-all-4.3.2-bin-release/store-b-m Slave配置如下: namesrvAddr=192.168.237.128:9876;10.13.83.7:9876 brokerClusterName=DefaultCluster brokerName=broker-b brokerId=1 deleteWhen=04 fileReservedTime=48 brokerRole=SLAVE flushDiskType=ASYNC_FLUSH listenPort=10811 storePathRootDir=/root/rocketmq-all-4.3.2-bin-release/store-b-s 启动日志分别如下: [root@localhost bin]# ./mqbroker -c ../conf/broker-m.conf The broker[broker-b, 192.168.237.128:10911] boot success. serializeType=JSON and name server is 192.168.237.128:9876;10.13.83.7:9876 [root@localhost bin]# ./mqbroker -c ../conf/broker-s.conf The broker[broker-b, 192.168.237.128:10811] boot success. serializeType=JSON and name server is 192.168.237.128:9876;10.13.83.7:9876 3.配置说明 1.namesrvAddr NameServer地址,可以配置多个,用逗号分隔; 2.brokerClusterName 所属集群名称,如果节点较多可以配置多个 3.brokerName broker名称,master和slave使用相同的名称,表明他们的主从关系 4.brokerId 0表示Master,大于0表示不同的slave 5.deleteWhen 表示几点做消息删除动作,默认是凌晨4点 6.fileReservedTime 在磁盘上保留消息的时长,单位是小时 7.brokerRole 有三个值:SYNC_MASTER,ASYNC_MASTER,SLAVE;同步和异步表示Master和Slave之间同步数据的机制; 8.flushDiskType 刷盘策略,取值为:ASYNC_FLUSH,SYNC_FLUSH表示同步刷盘和异步刷盘;SYNC_FLUSH消息写入磁盘后才返回成功状态,ASYNC_FLUSH不需要; 9.listenPort 启动监听的端口号 10.storePathRootDir 存储消息的根目录 管理工具 1.命令行管理工具 mqadmin是RocketMQ自带的命令行管理工具,可以创建、修改Topic,查询消息,更新配置信息等操作,具体可以通过如下命令查看: E:\rocketmq-all-4.3.2-bin-release\bin>mqadmin The most commonly used mqadmin commands are: updateTopic Update or create topic deleteTopic Delete topic from broker and NameServer. updateSubGroup Update or create subscription group deleteSubGroup Delete subscription group from broker. updateBrokerConfig Update broker's config updateTopicPerm Update topic perm topicRoute Examine topic route info topicStatus Examine topic Status info topicClusterList get cluster info for topic brokerStatus Fetch broker runtime status data queryMsgById Query Message by Id queryMsgByKey Query Message by Key queryMsgByUniqueKey Query Message by Unique key queryMsgByOffset Query Message by offset printMsg Print Message Detail printMsgByQueue Print Message Detail sendMsgStatus send msg to broker. brokerConsumeStats Fetch broker consume stats data producerConnection Query producer's socket connection and client vers consumerConnection Query consumer's socket connection, client version ubscription consumerProgress Query consumers's progress, speed consumerStatus Query consumer's internal data structure cloneGroupOffset clone offset from other group. clusterList List all of clusters topicList Fetch all topic list from name server updateKvConfig Create or update KV config. deleteKvConfig Delete KV config. wipeWritePerm Wipe write perm of broker in all name server resetOffsetByTime Reset consumer offset by timestamp(without client t). updateOrderConf Create or update or delete order conf cleanExpiredCQ Clean expired ConsumeQueue on broker. cleanUnusedTopic Clean unused topic on broker. startMonitoring Start Monitoring statsAll Topic and Consumer tps stats allocateMQ Allocate MQ checkMsgSendRT check message send response time clusterRT List All clusters Message Send RT getNamesrvConfig Get configs of name server. updateNamesrvConfig Update configs of name server. getBrokerConfig Get broker config by cluster or special broker! queryCq Query cq command. sendMessage Send a message consumeMessage Consume message See 'mqadmin help <command>' for more information on a specific command. 列出了所有支持的命令以及简单的介绍,如果想看详细的可以如下命令: E:\rocketmq-all-4.3.2-bin-release\bin>mqadmin help statsAll usage: mqadmin statsAll [-a] [-h] [-n <arg>] [-t <arg>] -a,--activeTopic print active topic only -h,--help Print help -n,--namesrvAddr <arg> Name server address list, eg: 192.168.0.1:9876;192.168 .0.2:9876 -t,--topic <arg> print select topic only 2.图形界面管理工具 除了命令,还提供了图形界面管理工具,在RocketMQ的扩展包里面,具体地址如下: https://github.com/apache/rocketmq-externals/tree/release-rocketmq-console-1.0.0/rocketmq-console 目前的稳定版本是1.0.0,可以下载下来在本地运行,对application.properties做简单配置: rocketmq.config.namesrvAddr=10.13.83.7:9876 需要指定NameServer的地址,然后就可以打包运行了,运作之后会启动8080端口,直接访问地址: http://localhost:8080 总结 本文从最简单的安装部署入手,并对常用的配置参数做了简单介绍;然后了解了RocketMQ的部署的整体结构,分别对其中的角色做了简单介绍;最后介绍了两种RocketMQ的管理工具,方便对RocketMQ的监控和管理。

优秀的个人博客,低调大师

Maven入门教程

GitHub仓库:Fundebug/maven-tutorial Maven简介 Maven是Java项目构建工具,可以用于管理Java依赖,还可以用于编译、打包以及发布Java项目,类似于JavaScript生态系统中的NPM。 Maven的命令行工具为mvn,其常用命令如下表所示: | 命令 | 说明 | | ----------- | -----------------------| | mvn compile | 编译Java源代码 | | mvn package | 打包Java项目 || mvn deploy | 将Java项目发布到Maven仓库 || mvn clean | 删除构建目录 | Maven的配置文件为pom.xml,这个文件有个很吓人的学术名字Project Object Model,但是怎么看它都只是个普通的配置文件,与NPM中的package.json没啥本质区别。 Maven的中央仓库为Maven Repository,这里可以找到各种Java依赖,例如我们Fundebug的异常监控插件fundebug-java与fundebug-spring。 安装Maven 在MacBook上使用brew安装很方便 brew install maven 我安装的是maven版本3.5.4 mvn -version Apache Maven 3.5.4 (1edded0938998edf8bf061f1ceb3cfdeccf443fe; 2018-06-18T02:33:14+08:00) Maven home: /usr/local/Cellar/maven/3.5.4/libexec Java version: 1.8.0_192, vendor: Oracle Corporation, runtime: /Library/Java/JavaVirtualMachines/jdk1.8.0_192.jdk/Contents/Home/jre Default locale: zh_CN, platform encoding: UTF-8 OS name: "mac os x", version: "10.14.2", arch: "x86_64", family: "mac" 示例代码 本文示例代码都在GitHub仓库Fundebug/maven-tutorial。 使用tree命令可以查看项目的目录结构: tree -v . ├── pom.xml └── src └── main └── java └── com └── fundebug └── Hello.java pom.xml为Maven配置文件,位于项目的根目录。 Hello.java为Java源代码,位于src/main/java/com/fundebug目录中。根据Maven对目录结构的要求,Java源代码必须位于src/main/java目录。 Hello.java package com.fundebug; import org.json.JSONObject; public class Hello { public static void main(String[] args) { JSONObject tomJsonObj = new JSONObject(); tomJsonObj.put("name", "Fundebug"); tomJsonObj.put("url", "https://www.fundebug.com"); System.out.println(tomJsonObj.toString(4)); } } Hello.java非常简单,定义了一个JSON对象,然后把它打印出来了。 package定义的包名为com.fundebug,需要与所在的目录结构相吻合,因此Hello.java位于src/main/java/com/fundebug目录中,而不是src/main/java/目录中。 代码依赖于第三方模块json,因此需要在pom.xml配置dependency: <dependency> <groupId>org.json</groupId> <artifactId>json</artifactId> <version>20180813</version> </dependency> pom.xml <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd"> <modelVersion>4.0.0</modelVersion> <!-- 坐标 --> <groupId>com.fundebug</groupId> <artifactId>hello</artifactId> <version>1.0</version> <!-- 依赖 --> <dependencies> <!-- https://mvnrepository.com/artifact/org.json/json --> <dependency> <groupId>org.json</groupId> <artifactId>json</artifactId> <version>20180813</version> </dependency> </dependencies> </project> pom.xml中,<project></project>为最外层的标签;<modelVersion>4.0.0</modelVersion>定义了所使用的POM版本。这2个标签基本上是不变的。 groupId、artifactId与version一起则定义了模块的坐标(Coordinates),每个公共模块的坐标应该是唯一的: groupId:组织名称,通常是把域名反过来,例如com.fundebug artifactId:模块名称,例如fundebug-java version:模块版本,例如0.2.0 <dependencies></dependencies>定义了当前项目所依赖的模块: <dependencies> <!-- https://mvnrepository.com/artifact/org.json/json --> <dependency> <groupId>org.json</groupId> <artifactId>json</artifactId> <version>20180813</version> </dependency> </dependencies> Maven可以根据<dependency></dependency>中定义的坐标,自动下载所依赖的模块。在MacBook上,Maven将下载的模块缓存在$HOME/.m2/目录。 使用mvn打包 执行mvn package命令,即可将源码打包为.jar文件: mvn package [INFO] Scanning for projects... [INFO] [INFO] -------------------------< com.fundebug:hello >------------------------- [INFO] Building hello 1.0 [INFO] --------------------------------[ jar ]--------------------------------- [INFO] [INFO] --- maven-resources-plugin:2.6:resources (default-resources) @ hello --- [WARNING] Using platform encoding (UTF-8 actually) to copy filtered resources, i.e. build is platform dependent! [INFO] skip non existing resourceDirectory /Users/fundebug/Desktop/maven-tutorial/src/main/resources [INFO] [INFO] --- maven-compiler-plugin:3.1:compile (default-compile) @ hello --- [INFO] Changes detected - recompiling the module! [WARNING] File encoding has not been set, using platform encoding UTF-8, i.e. build is platform dependent! [INFO] Compiling 1 source file to /Users/fundebug/Desktop/maven-tutorial/target/classes [INFO] [INFO] --- maven-resources-plugin:2.6:testResources (default-testResources) @ hello --- [WARNING] Using platform encoding (UTF-8 actually) to copy filtered resources, i.e. build is platform dependent! [INFO] skip non existing resourceDirectory /Users/fundebug/Desktop/maven-tutorial/src/test/resources [INFO] [INFO] --- maven-compiler-plugin:3.1:testCompile (default-testCompile) @ hello --- [INFO] No sources to compile [INFO] [INFO] --- maven-surefire-plugin:2.12.4:test (default-test) @ hello --- [INFO] No tests to run. [INFO] [INFO] --- maven-jar-plugin:2.4:jar (default-jar) @ hello --- [INFO] Building jar: /Users/fundebug/Desktop/maven-tutorial/target/hello-1.0.jar [INFO] ------------------------------------------------------------------------ [INFO] BUILD SUCCESS [INFO] ------------------------------------------------------------------------ [INFO] Total time: 2.789 s [INFO] Finished at: 2019-01-05T15:23:02+08:00 [INFO] ------------------------------------------------------------------------ mvn package执行之后,项目中会新增一个tartget目录,编译的字节码文件位于target/classes目录,而jar包位于target/hello-1.0.jar: tree -v . ├── pom.xml ├── src │ └── main │ └── java │ └── com │ └── fundebug │ └── Hello.java └── target ├── classes │ └── com │ └── fundebug │ └── Hello.class ├── hello-1.0.jar 使用mvn运行 打包好的jar包,可以直接使用java命令运行时,注意需要指定所依赖的jar包。对于所依赖的jar包,Maven则会自动下载依赖,放在本地仓库中。在MacBook上,Maven本地仓库位于$HOME/.m2/目录。 java -cp target/hello-1.0.jar:$HOME/.m2/repository/org/json/json/20180813/json-20180813.jar com.fundebug.Hello { "name": "Fundebug", "url": "https://www.fundebug.com" } 也可以使用mvn exec:java命令执行,不需要指定依赖的jar包,更加方便: mvn exec:java -Dexec.mainClass="com.fundebug.Hello" [INFO] Scanning for projects... [INFO] [INFO] -------------------------< com.fundebug:hello >------------------------- [INFO] Building hello 1.0 [INFO] --------------------------------[ jar ]--------------------------------- [INFO] [INFO] --- exec-maven-plugin:1.6.0:java (default-cli) @ hello --- { "name": "Fundebug", "url": "https://www.fundebug.com" } [INFO] ------------------------------------------------------------------------ [INFO] BUILD SUCCESS [INFO] ------------------------------------------------------------------------ [INFO] Total time: 0.837 s [INFO] Finished at: 2019-01-05T15:33:57+08:00 [INFO] ------------------------------------------------------------------------ 参考 Simple Maven Project Maven Dependency Management Java JSON Tutorial and Example: JSON-Java (org.json)

优秀的个人博客,低调大师

Kubernetes Helm入门指南

什么是Helm?这可不是暗黑破坏神里装备的名称:头盔,而是Kubernetes的一个包管理工具,用来简化Kubernetes应用的部署和管理。我们Helm和Kubernetes的关系,我们可以理解成yum和CentOS,apt-get和Ubuntu的关系。 Helm由两部分组成,客户端helm和服务端tiller。 其中tiller运行在Kubernetes集群上,管理chart,而客户端helm就是一个命令行工具,可在本地运行,一般运行在持续集成/持续交付的服务器上 。 下图是helm的架构图。 我们现在就来试用下helm。 首先安装helm客户端。 下载helm执行文件的压缩包: wget -O helm.tar.gz https://storage.googleapis.com/kubernetes-helm/helm-v2.11.0-l

优秀的个人博客,低调大师

Java入门—多线程

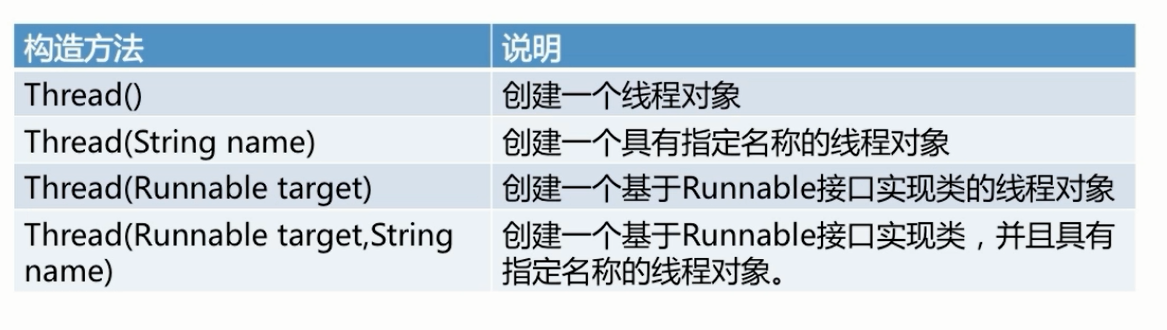
线程是比进程还要小的运行单位,一个进程包含多个线程。 什么是多线程 线程的创建 两种方式: 创建一个Thread类,或者一个Thread子类的对象 创建一个实现Runnable接口的类的对象 Thread类: Thread是一个线程类,位于java.lang包下 image.png Thread类的常用方法 image.png Runnable接口 只有一个方法run() Runnable是java中用以实现线程的接口 任何实现线程功能的类都必须实现该接口 继承Thread类的方式创建线程类,重写run方法: package com.imooc.thread; class MyThread extends Thread{ public void run(){ System.out.println(getName()+"该线程正在执行!"); } } public class ThreadTest{ public static void main(String[] args){ System.out.println("主线程1"); MyThread mt = new MyThread(); mt.start(); System.out.println("主线程2"); } } Runnable创建线程: 为什么要实现Runnable接口? 因为: Java不支持多继承 当你不打算重写Thread类的其他方法 package com.imooc.thread; class PrintRunnable implements Runnable{ @Override public void run() { int i = 1; while (i<=5){ System.out.println(Thread.currentThread().getName()+"正在运行"); i++; } } } public class ThreadTest{ public static void main(String[] args){ PrintRunnable pr = new PrintRunnable(); Thread t1 = new Thread(pr); t1.start(); Thread t2 = new Thread(pr); t2.start(); } } 线程的状态和生命周期 线程的状态 新建 可运行 正在运行 阻塞 终止 线程的生命周期 image.png sleep方法:在指定的毫秒数内,让线程休眠。(暂停执行) public static void sleep(long millis) 参数单位:毫秒 示例: class MyThread implements Runnable{ @Override public void run() { for(int i = 0; i<10;i++){ System.out.println(Thread.currentThread().getName()+i); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } } public class Test { public static void main(String[] args){ MyThread m = new MyThread(); Thread t = new Thread(m); t.start(); } } 调用sleep时需要捕获异常。 join()方法:优先执行线程。(抢占资源) public final void join() join方法的参数为毫秒,代表:超过此时间交出资源使用权。 示例: class MyThread implements Runnable{ @Override public void run() { for(int i = 0; i<10;i++){ System.out.println(Thread.currentThread().getName()+i); try { Thread.sleep(2000); } catch (InterruptedException e) { e.printStackTrace(); } } } } public class Test { public static void main(String[] args){ MyThread m = new MyThread(); Thread t = new Thread(m); t.start(); try { t.join(1000); } catch (InterruptedException e) { e.printStackTrace(); } for(int j = 0; j<10;j++){ System.out.println("主线程"); } } } 线程的调度 线程优先级 Java为线程类提供了10个优先级 优先级可以用整数1-10表示,超出范围会抛出异常 主线程默认优先级为5 优先级常量 MAX_PRIORITY : 最高优先级(10) MIN_PRIORITY : 最低优先级(1) NORM_PRIORITY :默认优先级(5) image.png 测试代码: class MyThread implements Runnable{ private String name; public MyThread(String name){ this.name = name; } @Override public void run() { for(int i = 0; i<10;i++){ System.out.println(Thread.currentThread().getName()+i+name); } } } public class Test { public static void main(String[] args){ int i = Thread.currentThread().getPriority(); MyThread m = new MyThread("Allen"); Thread t = new Thread(m); MyThread m1 = new MyThread("ming"); Thread t1 = new Thread(m1); t.setPriority(Thread.MAX_PRIORITY); t1.setPriority(Thread.MIN_PRIORITY); int y = t.getPriority(); int y1 = t1.getPriority(); System.out.println("Allen线程优先级"+y); System.out.println("ming线程优先级"+y1); t.start(); t1.start(); } } 线程同步 多线程运行时的问题: 各个线程是通过竞争CPU时间而获得运行机会的 各个线程什么时候得到CPU时间、占用多久,是不可预测的 一个正在运行着的线程在什么地方被暂停是不确定的 使用synchronized关键字加锁。同一时刻只能单个操作。 synchronized关键字可以用在:成员方法、静态方法、语句块 public synchronized void F(){} public static synchronized void F(){} synchronized (){} 线程间通信 Java中的线程通信和Python中的差不多,通过中间队列类存储,由消费者和生产者负责放入和取出。 image.png wait方法:中断方法的执行,使线程等待 notify方法:唤醒处于等待的某一个线程 notifyAll方法:唤醒处于等待的全部线程 小结 创建线程的两种方式: 继承Thread类创建线程 new Thread().start() 实现Runnable接口创建线程 new Thread(new MyRunable()).start() 线程的5种状态: 新建 可运行 运行 阻塞 终止 sleep、join、wait、notify、notifyAll方法: 线程优先级: 最高、最低。 获取优先级、设置优先级。 先启动的线程尽管优先级低,也会可能先执行。 线程同步: synchronized关键字,可以用在:成员方法、静态方法、语句块。 上述文章如有帮助记得点赞呦,关注后第一时间获得最新笔记,持续更新~

优秀的个人博客,低调大师

docker 摘要(入门版)

Docker 安装 macOS或者windows 下载boot2docker工具 CentOS yum install docker-io -y systemctl start docker docker摘要 docker虚拟化 只虚拟User space 一台机器可以运行20-50个container 启动速度快 对内核有要求(不能像VMware一样可以安装mac,windows和linux) 用于大数据,分布式和集群 container实现 cgroup(内核中对资源的限制机制,通过控制进程(一个container实例)来限制) namespace(每一个容器都是有一个自己网络进程的独立的虚拟环境,实现容器间的隔离 chroot(文件系统的隔离,有一个真实的物理文件系统(物理机上),其他的都是虚拟的文件系统(虚拟的文件系统在内存中)) 以上,cgroup,namespace,chroot都是在linux中,也就是直接调用linux,后来为了跨平台,将上面的封装成了libcontainer库,让docer依赖于它 pid,容器有自己独立的进程表和1号进程 net,容器有自己的network info ipc,container之间的通信 mnt,每个容器都有自己唯一的目录挂载,是真实的挂载目录的子目录 utc,有独立的hostname和domain 层次 server -> hostOS -> docker engine -> app1 使用aufs实现分层的文件系统管理 Image是一种文件系统,里面必须有操作系统或者软件,docker中的系统Image很小,因为只包含很好的最核心的部分,每一个那么多的外围 只读为Image,可写为container,image是java中的class,container是对象 Image类似一个单链表系统,每一个image包含一个指向parent image的指针 每一个parent image的image是base image 层次: debain image(base image) -> apache image -> container 一般base image是操作系统镜像 建议:一个container干一件事情 dockerfile(类似于makefile,是命令的集合) 描述一个Image的层次,就提描述了一个依赖次序,centos -> apache -> container 有了它可以完美的重现出开发环境,方便了测试人员 docker hub(镜像仓库,类似于github) C/S运行 client request -> server -> http server -> router -> job -> driver 使用 docker pull {image name} docker images --no-trunc docker run [OPTIONS] IMAGE[:TAG] [CMD][ARG...] -name -i: iteract -t: tag -d: detach docker ps 不加上-a选项显示的正在运行的容器 加上-a显示所有的容器,包括停止的 docker inspect [ID] docker logs docker build docker rm/kill/stop id, 关闭容器 批量操作: docker rm/kill/stop $(docker ps -a -q) docker run -t -i centos /bin/bash, -t表示是伪tty(就是给一个终端,如果每一个则容器一start就stop了),-i表示iteract(在有了终端这个前提之下,如果attach到容器中,可以执行交互式的命令,如果没有则什么都干不了),-d就是在后台运行,不会在执行了上面这个命令之后直接进入到容器中 进入到了交互之界面,使用exit退出,但是也会stop容器,如果要在一次进入到该容器,需要先start容器,则attach容器,因为-i会前台运行,使用-d则是相反的 docker cp id:path hostpath 自己的摘要 docker在某些方面和git是一样的,不如说对于image镜像都是通过版本控制的,我们从dockeruhb中pull下来镜像文件,如果我们将其启动为一个容器,如果我们在这个容器中进行了修改,docker会通过文件将其修改记录下来,我们可将当当前的容器commit成一个新的image,这就类似于git中的一个commit点 在确定一个容器的时候是使用container id 在确定一个image的时候,是通过name:tag,如果只有name则会选中所有的tag,tag表示一个版本 生成一个image(提交点)的方法有两种,docker commit 和 docker build,在docker build中就是在一个image中执行一个命令的集合在提交成一个新的image

优秀的个人博客,低调大师

MySQL 使用入门 (全)

数据库简介 1.数据库概述 ①数据库:是按照某种数据结构对数据进行组织,存储和管理的容器,简单的说就是用来存储和管理数据的容器 ②数据库系统:是指在计算机中引入数据库后的系统,一般由数据库,数据库管理系统,应用程序和数据库管理员组成 ③数据库管理系统:是一个管理,控制数据库容器中各种数据库对象的系统软件 2.结构化查询语言SQL ①结构化查询语言:是一种用来与数据库通信的语言,其利用一些简单的句子构成基本的语法来存取数据库的内容,便于用户从数据库中获得和操作所需数据 ②SQL语言特点:非过程化语言,统一的语言,关系数据库的公共语言 ③SQL语言的组成:数据库定义语言(DDL),数据库操纵语言(DML),数据控制语言(DCL) 3.数据库设计基本步骤 ①需求分析阶段 ②概念结构设计阶段 ③逻辑结构设计阶段 ④数据库的物理结构设计阶段 ⑤数据库的实施阶段 ⑥数据库运行与维护阶段 4.MySQL数据库 它是一种关系型数据库管理系统,关系型数据库将数据保存在不同的表中,而不是将所有数据存放在一个大仓库,提高了速度和灵活性 特点: 体积小,运行速度快,成本低,开放源码 单进程,多线程架构,属于轻量级的数据库 5.MySQL体系结构 包括连接池组件,管理服务和工具组件,SQL接口组件,查询分析组件,优化器组件,缓存组件,插件式存储引擎以及物理组件 6.数据库系统解决的问题:持久化存储,优化读写,保证数据的有效性 7.数据库的分类 ①文档型,如sqlite,就是一个文件,通过对文件的复制完成数据库的复制 ②服务型,如mysql、postgresql,数据存储在一个物理文件中,但是需要使用终端以tcp/ip协议连接,进行数据库的读写操作 8.数据库的操作 ①数据库的操作,包括创建、删除 ②表的操作,包括创建、修改、删除 ③数据的操作,包括增加、修改、删除、查询,简称crud 10.常用的可视化操作工具:MySQL-Front,MySQL Workbench及Navicat for MySQL 11. SQL的基本书写规则 ①关键字大写 ②表名的首字大写 ③其余(列名)小写 E-R模型 1.E表示entry,实体;R表示relationship,关系当前物理的数据库都是按照E-R模型进行设计的 2.关系描述两个实体之间的对应规则,包括: ①一对一 ②一对多 ③多对多 3.三范式 ①第一范式(1NF):列不可拆分 ②第二范式(2NF):唯一标识 ③第三范式(3NF):引用主键 说明:后一个范式,都是在前一个范式的基础上建立的 4.数据完整性 一个数据库就是一个完整的业务单元,可以包含多张表,数据被存储在表中,在表中为了更加准确的存储数据,保证数据的正确有效,可以在创建表的时候,为表添加一些强制性的验证,包括数据字段的类型、约束 5.字段类型 ①数字:int,decimal:如decimal(5,2),表示数字长度不超过5位,小数不超过2位 ②字符串:char,varchar,text:其中char和varchar都是有限字符的,而text是不确定的。char和varchar都是8个字符,但char如果不够会补充空格,varchar是不会补充空格的 ③日期:datetime ④布尔:bit 6.约束 ①主键primary key ②非空not null ③惟一unique ④默认default ⑤外键foreign key ⑥auto_increment表示自动增长 7. 数据库的选型 ①开发人员的熟练程度,费用,数据规模,性能要求,集群能力等,也可参考数据库管理员的建议 ②对于有1:1关系的两个表,为两个表设置相同的主键列 ③对于有1:N关系的两个表,在N表中添加一个外键列,该列与1表的主键列向关联 ④对于M:N关系,生成一个单独的表表示该关系,该关系的列由两个表的主键组成 命令脚本命令 1.远程连接 一般在公司开发中,可能会将数据库统一搭建在一台服务器上,所有开发人员共用一个数据库,而不是在自己的电脑中配置一个数据库 运行命令: mysql-hip地址-uroot-p -h后面写要连接的主机ip地址 -u后面写连接的用户名 -p回车后写密码 2.数据库操作 ①创建数据库 createdatabase数据库名charset=utf8; ②删除数据库 dropdatabase数据库名; ③切换数据库 use数据库名; ④查看当前选择的数据库 selectdatabase(); 3.表操作 ①查看当前数据库中所有表 showtables; ②创建表 createtable表名(列及类型); ③修改表 增,改,删:altertable表名add|change|drop列名类型; 增加约束条件:altertable表名addconstraint约束名,类型(字段名); 删除约束条件:altertable表名dropprimarykey; 添加外键约束:altertable表名add约束名constraintforeignkey(字段名)references父表名(字段名); 修改存储引擎:altertable表名engine=新的存储引擎;(MyISAM,InooDB) 修改默认字符集:altertable表名defaultcharset=新的字符集; ④删除表 droptable表名; ⑤查看表结构 desc表名; ⑥更改表名称 renametable原表名to新表名; ⑦查看表的创建语句 showcreatetable表名; 4.数据操作 ①查询 selectdistinct列名fromstudents;消除重复 select*from表名where条件; ②增加 全列插入:insertinto表名values(...) 缺省插入:insertinto表名(列1,...)values(值1,...) 同时插入多条数据:insertinto表名values(...),(...)...; 或insertinto表名(列1,...)values(值1,...),(值1,...)...; 主键列是自动增长,但是在全列插入时需要占位,通常使用0,插入成功后以实际数据为准 ③修改 update表名set列1=值1,...where条件 ④删除 deletefrom表名where条件 ⑤逻辑删除,本质就是修改操作update altertablestudentsaddisdeletebitdefault0; ⑥如果需要删除则 updatestudentsisdelete=1where...; 5.备份与恢复 数据备份 ①进入超级管理员 sudo-s ②进入mysql库目录 cd/var/lib/mysql ③运行mysqldump命令 mysqldump–uroot–p数据库名>~/Desktop/备份文件.sql; ④按提示输入mysql的密码 数据恢复 ①连接mysql,创建数据库 ②退出连接,执行如下命令 mysql-uroot–p数据库名<~/Desktop/备份文件.sql ③根据提示输入mysql密码 查询(条件) 1.比较运算符 select*fromstudentswhereid>3; 2.逻辑运算符 select*fromstudentswhereid>3andgender=0; 3.模糊查询 Like:select*fromstudentswheresnamelike'黄_'; ①%表示任意多个任意字符 ②_表示一个任意字符 4.范围查询 ①in表示在一个非连续的范围内 select*fromstudentswhereidin(1,3,8); ②between ... and ...表示在一个连续的范围内 select*fromstudentswhereidbetween3and8; 5.空判断 ①判空is null select*fromstudentswherehometownisnull; ②判非空is not null select*fromstudentswherehometownisnull; 6.优先级 ①小括号,not,比较运算符,逻辑运算符 ②and比or先运算,如果同时出现并希望先算or,需要结合()使用 查询(聚合) 1.count(*)表示计算总行数,括号中写星与列名,结果是相同的 selectcount(*)fromstudents; 2.max(列)表示求此列的最大值 selectmax(id)fromstudentswheregender=0; 3.min(列)表示求此列的最小值 selectmin(id)fromstudentswhereisdelete=0; 4.sum(列)表示求此列的和 selectsum(id)fromstudentswheregender=1; 5.avg(列)表示求此列的平均值 selectavg(id)fromstudentswhereisdelete=0andgender=0; 查询(分组) 1.语法: select列1,列2,聚合...from表名groupby列1,列2,列3... 分组后的数据筛选 2.语法: select列1,列2,聚合...from表名 groupby列1,列2,列3... having列1,...聚合... having后面的条件运算符与where的相同,不同的是having对分组的结果集进行筛选,where对原始集筛选 3.与聚合函数和Group by子句有关的常见错误 在select子句中书写了多余的列 selectproduct_id,purchase_price,count(*)fromProductGroupbypurchase_price; 在Group by子句中写了列的别名 selectproduct_typeaspt,count(*)FromProductGroupbypt; ①Group by的子句是随机的,不能人为排序 ②不能在where子句中使用聚合函数 ③只有select子句和having子句以及(order by)中才能够使用count等聚合函数 查询(排序) 语法: select*from表名 orderby列1asc|desc,列2asc|desc,... 将行数据按照列1进行排序,如果某些行列1的值相同时,则按照列2排序,以此类推默认按照列值从小到大排列,asc从小到大排列,即升序,desc从大到小排序,即降序查询(分页) 语法: select*from表名 limitstart,count 查询(总结) 1.完整的select语句 selectdistinct* from表名 where.... groupby...having... orderby... limitstar,count From字句是否真的有必要? 并不是,只使用select子句也是可以的,如select(100+300)*3 as calculation,但在oracle中不允许 2.子查询 ①子查询就是一次性视图.与视图不同,子查询在select语句执行完毕之后就会消失 ②标量子查询:标量就是单一的意思,标量子查询有一个特殊的限制,必须而且只能返回1行1列的结果 ③关联子查询:在子查询中添加where子句条件,where p1.product_type=p2.product_type 关系 1.外键 为stuid添加外键约束 altertablescoresaddconstraintstu_scoforeignkey(stuid)referencesstudents(id); 2.外键的级联操作 ①在删除students表的数据时,如果这个id值在scores中已经存在,则会抛异常 ②推荐使用逻辑删除,还可以解决这个问题 ③可以创建表时指定级联操作,也可以在创建表后再修改外键的级联操作 语法: altertablescoresaddconstraintstu_scoforeignkey(stuid)referencesstudents(id)ondeletecascade; 级联操作的类型包括: ①restrict(限制):默认值,抛异常 ②cascade(级联):如果主表的记录删掉,则从表中相关联的记录都将被删除 ③set null:将外键设置为空 ④no action:什么都不做 连接查询 1.连接查询分类 ①表A inner join 表B:表A与表B匹配的行会出现在结果中 ②表A left join 表B:表A与表B匹配的行会出现在结果中,外加表A中独有的数据,未对应的数据使用null填充 ③表A right join 表B:表A与表B匹配的行会出现在结果中,外加表B中独有的数据,未对应的数据使用null填充 ④查询学生的姓名、平均分 selectstudents.sname,avg(scores.score) fromscores innerjoinstudentsonscores.stuid=students.id groupbystudents.sname; 2.自关联 创建areas表的语句如下: createtableareas( idintprimarykey, atitlevarchar(20), pidint, foreignkey(pid)referencesareas(id) ); 视图 1.视图:从SQL的角度来看,视图和表是相同的两者的区别在于表中保存的是实际数据,而视图中保存的是select语句(视图本身并不存储数据) 定义视图: createviewstuscoreas selectstudents.*,scores.scorefromscores innerjoinstudentsonscores.stuid=students.id; 2.视图的用途就是查询 select*fromstuscore; 3.视图的优点: 视图无需保存数据,因此可以节省存储设备的容量 可以将频繁使用的select语句保存成视图,这样就不用每次都重写了 4.视图的限制: ①定义视图时不能使用order by子句,这是因为视图和表一样数据行都是没有顺序的 ②对视图进行更新(未被汇总得到的视图) ③条件: select子句未使用Dintinct From子句中只有一张表 未使用group by子句 未使用having子句 ④删除视图(多重视图) dropview视图名cascade 事务 1.事务:是恢复和并发控制的基本单位,什么是事务,就是需要在一个处理单元中执行的一系列更新处理的集合,通过使用事务,可以对数据库中的数据更新处理提交和取消进行<beigin,commit,rollback>视图本质就是对查询的一个封装 2.使用事务的请况:当数据被更改时,包括insert,update,delete,使用事务可以完成退回的功能,保证业务逻辑的正确性 3.事务四大特性(简称ACID) ①原子性(Atomicity):事务中的全部操作在数据库中是不可分割的,要么全部完成,要么均不执行 ②一致性(Consistency):几个并行执行的事务,其执行结果必须与按某一顺序串行执行的结果相一致 ③隔离性(Isolation):事务的执行不受其他事务的干扰,事务执行的中间结果对其他事务必须是透明 ④持久性(Durability):对于任意已提交事务,系统必须保证该事务对数据库的改变不被丢失,即使数据库出现故障 ⑤要求:表的类型必须是innodb或bdb类型,才可以对此表使用事务 ⑥事务语句: begin;//开启 commit;//提交 rollback;//回滚 索引 1.单列索引和组合索引 ①单列索引,即一个索引只包含单个列,一个表可以有多个单列索引,但这不是组合索引 ②组合索引,即一个索包含多个列 2.操作 ①查看索引: showindexfromtable_name; ②创建索引: createindexindexNameonmytable(usrname(length)); ③删除索引: dropindex[indexName]onmytable; 3.缺点 ①虽然索引提高了查询速度,同时却会降低更新表的速度,如对表进行insert,update和delete。 ②因为更新表时,mysql不仅要保存数据,还要保存一下索引文件 ③建立索引会占用磁盘空间的索引文件 4.检测运行时间 ①开启运行时间检测: setprofiling=1; ②执行查询语句: ③查看执行的时间: showprofiles; 谓词 1.就是返回值为真值的函数 like,in,not in,between,is null,is not null 函数 1.根据用途大致分为以下 ①算术函数(用来进行数值计算的函数) ②字符串函数(用来进行字符串操作的函数) ③日期函数(用来进行日期操作的函数) ④转换函数(用来转换数值类型和值的函数) ⑤聚合函数(用来进行数据聚合的函数) 2.case表达式 case表达式分为简单case表达式和搜索case表达式两种 搜索case表达式包含简单case表达式的全部功能 case搜索表达式; casewhen<求值表达式>then<表达式> when<求值表达式>then<表达式> .... else<表达式> end case简单表达式: case<表达式> when<表达式>then<表达式> when<表达式>then<表达式> when<表达式>then<表达式> ..... else<表达式> end 集合运算 1.集合运算:集合在数据库领域表示记录的集合,具体来说表,视图和查询执行的结果都是记录的集合 2.集合运算注意事项 ①作为运算对象的记录的列数必须相同 ②作为运算对象的记录中列的类型必须一致 ③可以使用任何select语句,但order by子句只能在最后使用一次 3.表的加法-union并集 selectproduct-id,product_namefromProductunion(all)selectproduct_id,product_namefromproduct2; 4.选取表中的公共部分-intersect交集 selectproduct_id,product_namefromProductintersectselectproduct_id,product_namefromProduct2orderbyproduct_id; 5.记录的减法-except差集 selectproduct_id,product_namefromProductexceptselectproduct_id,product_namefromProduct2orderbyproduct_id; 6.表的联结 联结join就是将其他表的列添加过来,进行添加列的集合运算,union是以行(纵向)为单位进行操作,而联结则是以列(横向)为单位进行的 与python交互 1.安装引入模块 ①安装mysql模块 sudoapt-getinstallpython-mysqldb,pymysql ②在文件中引入模块 importMysqldb 2.Connection对象 用于建立与数据库的连接 创建对象:调用connect()方法 conn=connect(参数列表) 参数host:连接的mysql主机,如果本机是'localhost' 参数port:连接的mysql主机的端口,默认是3306 参数db:数据库的名称 参数user:连接的用户名 参数password:连接的密码 参数charset:通信采用的编码方式,默认是'gb2312',要求与数据库创建时指定的编码一致 3.对象的方法 close()关闭连接 commit()事务所以需要提交才会生效 rollback()事务放弃之前的操作 cursor()返回Cursor对象用于执行sql语句并获得结果 4.Cursor对象 执行sql语句 创建对象:调用Connection对象的cursor()方法 cursor1=conn.cursor() 5.对象的方法 close()关闭 execute(operation[,parameters])执行语句,返回受影响的行数 fetchone()执行查询语句时,获取查询结果集的第一个行数据,返回一个元组 next()执行查询语句时,获取当前行的下一行 fetchall()执行查询时,获取结果集的所有行,一行构成一个元组,再将这些元组装入一个元组返回 scroll(value[,mode])将行指针移动到某个位置 mode表示移动的方式 mode的默认值为relative表示基于当前行移动到value,value为正则向下移动,value为负则向上移动 mode的值为absolute表示基于第一条数据的位置,第一条数据的位置为0 6.对象的属性 ①rowcount只读属性,表示最近一次execute()执行后受影响的行数 ②connection获得当前连接对象 7.sql语句参数化 sname=raw_input("请输入学生姓名:") params=[sname] count=cs1.execute('insertintostudents(sname)values(%s)',params)

优秀的个人博客,低调大师

Python 基础入门 (全)

MongoDB简介 1.MongoDB ①MongoDB 是一个基于分布式 文件存储的NoSQL数据库 ②由C++语言编写,运行稳定,性能高 ③旨在为 WEB 应用提供可扩展的高性能数据存储解决方案 ④官方网址:https://www.mongodb.com/ 2.MongoDB特点 ①MongoDB可以轻松地布置两个活跃集群,但关系型不容易在两台服务器上同时运行单个数据库 ②MongoDB天然缺少对事物的支持 ③MongoDB并不提供主/主复制,但它支持分片 3.Bson和Json ①Bosn版本是Json的二进制格式,但并不意味着Bson占用的空间就比Json小的多 ②继续使用Bson的原因是因为MongoDB在设计上就是要求快速,而不是节省空间,如果处理数据的速度更快,存储文档时的一点开销是完全可以接受的 ③Bson更易于浏览(即遍历),遍历索引页非常快,第二点是很容易将Bson数据快速转化为编程语言的原生数据格式 4.名词 SQL术语/概念 MongoDB术语/概念 解释/说明 database database 数据库 table collection 数据库表/集合 row document 数据记录行/文档 column field 数据字段/域 index index 索引 tablejoins 表连接,MongoDB不支持 primarykey primarykey 主键,MongoDB自动将_id字段设置为主键 5.MongoDB三要素:数据库,集合,文档 ①数据库:是一个集合的物理容器,一个数据库中可以包含多个文档,一个服务器通常有多个数据库 ②集合:类似于关系数据库中的表,储存多个文档,结构不固定,如可以存储如下文档在一个集合中 {'name':'guojing','gender':'男'} {'name':'huangrong','age':18} {'book':'shuihuzhuan','heros':'108'} ③文档:就是一个对象,由键值对组成,是Json的扩展Bson格式 {'name':'guojing','gender':'男'} MongoDB安装与管理 1.安装 ①下载MongoDB的版本注意,两点注意 根据规则:偶数为稳定版,如1.6X,奇数为开发版,如1.7X 32bit的MongoDB最大只能存放2G的数据,64bit就没有限制 ②到官网,选择合适的版本下载 ③解压 tar-zxvfmongodb-linux-x86_64-ubuntu1604-3.4.0.tgz ④移动到/usr/local/目录下 sudomv-rmongodb-linux-x86_64-ubuntu1604-3.4.0//usr/local/mongodb ⑤将可执行文件添加到PATH路径中 exportPATH=/usr/local/mongodb/bin:$PATH 2.管理 ①配置文件在/etc/mongod.conf,默认端口27017 ②启动 sudoservicemongodstart ③停止 sudoservicemongodstop ④使用终端连接:mongo,这个shell就是mongodb的客户端,同时也是一个js的编译器 ⑤ GUI:robomongo,解压后在bin目录下找到运行程序 数据库操作 1.数据库切换 ①查看当前数据库名称:db ②查看所有数据库名称:show dbs,(列出所有在物理上存在的数据库) ③切换数据库:use 数据库名称,(如果数据库不存在,则指向数据库,但不创建,直到插入数据或创建集合时数据库才被创建) ④默认的数据库为test,如果没有创建新的数据库,集合将存放在test数据库中 2.数据库删除 删除当前指向的数据库,如果数据库不存在,则什么也不做 db.dropDatabase() 集合操作 1.集合创建 语法: db.createCollection(name,option) ①name是要创建集合的名称 ②options是一个文档,用于指定集合的配置 ③选项参数是可选的,所以只需要到指定的集合名称 例1:不限制集合的大小 db.createCollection(‘stu’) 例2:限制集合大小 db.createCollection(‘sub’,{capped:true,size:10}) 参数capped:默认值为false表示不设置上限,值为true表示设置上限 参数size:当capped值为true时,需要指定此参数,表示上限大小,当文档设置上限时,会将之前的数据覆盖,单位为字节 2.查看当前数据库的集合 showcollections 3.删除集合 db.集合名称.drop() 数据类型 1. MongoDB中常用的几种数据类型: ①Object ID:文档ID ②String:字符串,最常用,必须是有效的UTF-8 ③Boolean:存储一个布尔值,true或false ④Integer:整数可以是32位或64位,这取决于服务器 ⑤Double:存储浮点值 ⑥Arrays:数组或列表,多个值存储到一个键 ⑦Object:用于嵌入式的文档,即一个值为一个文档 ⑧Null:存储Null值 ⑨Timestamp:时间戳 ⑩Date:存储当前日期或时间的UNIX时间格式 2. object id ①每个文档都有一个属性,为_id,保证每个文档的唯一性 ②可以自己去设置_id插入文档 ③如果没有提供,那么MongoDB为每个文档提供了一个独特的_id,类型为objectID ④objectID是一个12字节的十六进制数 前4个字节为当前时间戳 接下来3个字节的机器ID 接下来的2个字节中MongoDB的服务进程id 最后3个字节是简单的增量值 数据操作 1.插入 插入文档时,如果不指定_id参数,MongoDB会为文档分配一个唯一的ObjectId db.集合名称.insert(document) 2.简单查询 db.集合名称.find() 3.更新 db.集合名称.update(<query>,<update>,multi:<boolean>}) ①参数query:查询条件,类似sql语句update中where部分 ②参数update:更新操作符,类似sql语句update中set部分 ③参数multi:可选,默认是false,表示只更新找到的第一条记录,值为true表示把满足条件的文档全部更新 例3:全文档更新 db.stu.update( {name:'hr'},{name:'mnc'} ) 例4:指定属性更新,通过操作符$set db.stu.insert({name:'hr',gender:0}) db.stu.update({name:'hr'},{$set:{name:'hys'}}) 例5:修改多条匹配到的数据 db.stu.update({},{$set:{gender:0}},{multi:true}) 4.保存 如果文档的_id已经存在则修改,不存在则添加 db.集合名称.save(document) 5.删除 db.集合名称.remove(<query>,{justOne:<boolean>}) ①参数query:可选,删除的文档的条件 ②参数justOne:可选,如果设为true或1,则只删除一条,默认false,表示删除多条 例6:只删除匹配到的第一条 db.stu.remove({gender:0},{justOne:true}) 例7:全部删除 db.stu.remove({}) 数据查询 1.基本查询 ①方法find():查询 db.集合名称.find({条件文档}) ②方法findOne():查询,只返回第一个 db.集合名称.findOne({条件文档}) ③方法pretty():将结果格式化 db.集合名称.find({条件文档}).pretty() 2.比较运算符 ①等于,默认是等于判断,没有运算符 ②小于$lt ③小于或等于$lte ④大于$gt ⑤大于或等于$gte ⑥不等于$ne 例8:查询年龄大于或等于18的学生 db.stu.find({age:{$gte:18}}) 3.逻辑运算符 ①查询时可以有多个条件,多个条件之间需要通过逻辑运算符连接 ②逻辑与:默认是逻辑与的关系 例9:查询年龄大于或等于18,并且性别为1的学生 db.stu.find({age:{$gte:18},gender:1}) 逻辑或:使用$or 例10:查询年龄大于18,或性别为0的学生 db.stu.find({$or:[{age:{$gt:18}},{gender:1}]}) and和or一起使用 例11:查询年龄大于18或性别为0的学生,并且学生的姓名为gj db.stu.find({$or:[{age:{$gte:18}},{gender:1}],name:'gj'}) 4.范围运算符 使用"$in","$nin" 判断是否在某个范围内 例12:查询年龄为18、28的学生 db.stu.find({age:{$in:[18,28]}}) 5.支持正则表达式 使用//或$regex编写正则表达式 例13:查询姓黄的学生 db.stu.find({name:/^黄/})db.stu.find({name:{$regex:'^黄'}}) 6.自定义查询 使用$where后面写一个函数,返回满足条件的数据 例14:查询年龄大于30的学生 db.stu.find({$where:function(){returnthis.age>20}}) 7. Limit(方法limit():用于读取指定数量的文档) db.集合名称.find().limit(NUMBER) ①参数NUMBER表示要获取文档的条数 ②如果没有指定参数则显示集合中的所有文档 例15:查询2条学生信息 db.stu.find().limit(2) 8. skip(方法skip():用于跳过指定数量的文档) db.集合名称.find().skip(NUMBER) 参数NUMBER表示跳过的记录条数,默认值为0 例16:查询从第3条开始的学生信息 db.stu.find().skip(2) 9.Limit与Skip一起使用 方法limit()和skip()可以一起使用,不分先后顺序 查询第5至8条数据(跳取) db.stu.find().limit(4).skip(5)db.stu.find().skip(5).limit(4) 10. 投影 在查询到的返回结果中,只选择必要的字段,而不是选择一个文档的整个字段 语法:参数为字段与值,值为1表示显示,值为0不显示 db.集合名称.find({},{字段名称:1,...}) 对于需要显示的字段,设置为1即可,不设置即为不显示 特殊:对于_id列默认是显示的,如果不显示需要明确设置为0 db.stu.find({},{_id:0,name:1,gender:1}) 11.排序 方法sort(),用于对结果集进行排序 语法:db.集合名称.find().sort({字段:1,...}) ①参数1为升序排列 ②参数-1为降序排列 例18:根据性别降序,再根据年龄升序 db.stu.find().sort({gender:-1,age:1}) 12.统计个数 方法count()用于统计结果集中文档条数 语法: db.集合名称.find({条件}).count() 也可以与为 db.集合名称.count({条件}) 例19:统计男生人数 db.stu.find({gender:1}).count() 例20:统计年龄大于20的男生人数 db.stu.count({age:{$gt:20},gender:1}) 13.消除重复 方法distinct()对数据进行去重 语法: db.集合名称.distinct('去重字段',{条件}) 例21:查找年龄大于18的性别(去重) db.stu.distinct('gender',{age:{$gt:18}}) 聚合 aggregate 1.聚合(aggregate) 主要用于计算数据,类似sql中的sum()、avg() 语法: db.集合名称.aggregate([{管道:{表达式}}]) 2.管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的输入 psajx|grepmongo 在mongodb中,管道具有同样的作用,文档处理完毕后,通过管道进行下一次处理 常用管道: $group:将集合中的文档分组,可用于统计结果 $match:过滤数据,只输出符合条件的文档 $project:修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 $sort:将输入文档排序后输出 $limit:限制聚合管道返回的文档数 $skip:跳过指定数量的文档,并返回余下的文档 $unwind:将数组类型的字段进行拆分 表达式 处理输入文档并输出 语法:表达式:'$列名' $sum:计算总和,$sum:1同count表示计数 $avg:计算平均值 $min:获取最小值 $max:获取最大值 $push:在结果文档中插入值到一个数组中 $first:根据资源文档的排序获取第一个文档数据 $last:根据资源文档的排序获取最后一个文档数据 3.$group 将集合中的文档分组,可用于统计结果 _id表示分组的依据,使用某个字段的格式为'$字段' 例22:统计男生、女生的总人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}}]) Group by null 将集合中所有文档分为一组 例23:求学生总人数、平均年龄 db.stu.aggregate([{$group:{_id:null,counter:{$sum:1},avgAge:{$avg:'$age'}}}]) 透视数据 例24:统计学生性别及学生姓名 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$name'}}}]) 使用$$ROOT可以将文档内容加入到结果集的数组中,代码如下 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$$ROOT'}}}]) 4.$match 用于过滤数据,只输出符合条件的文档 使用MongoDB的标准查询操作 例25:查询年龄大于20的学生 db.stu.aggregate([{$match:{age:{$gt:20}}}]) 例26:查询年龄大于20的男生、女生人数 db.stu.aggregate([{$match:{age:{$gt:20}}},{$group:{_id:'$gender',counter:{$sum:1}}}]) 5.$project 修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 例27:查询学生的姓名、年龄 db.stu.aggregate([{$project:{_id:0,name:1,age:1}}]) 例28:查询男生、女生人数,输出人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$project:{_id:0,counter:1}}]) 6. $sort 将输入文档排序后输出 例29:查询学生信息,按年龄升序 b.stu.aggregate([{$sort:{age:1}}]) 例30:查询男生、女生人数,按人数降序 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$sort:{counter:-1}}]) 7. $limit,$skip 限制聚合管道返回的文档数 例31:查询2条学生信息 db.stu.aggregate([{$limit:2}]) $skip 跳过指定数量的文档,并返回余下的文档 例32:查询从第3条开始的学生信息 db.stu.aggregate([{$skip:2}]) 例33:统计男生、女生人数,按人数升序,取第二条数据 db.stu.aggregate( [{$group:{_id:'$gender',counter:{$sum:1}}}, {$sort:{counter:1}}, {$skip:1}, {$limit:1}]) 注意顺序:先写skip,再写limit 8. $unwind 将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值 语法1:对某字段值进行拆分 db.集合名称.aggregate([{$unwind:'$字段名称'}]) 构造数据 db.t2.insert({_id:1,item:'t-shirt',size:['S','M','L']}) 查询 db.t2.aggregate([{$unwind:'$size'}]) 语法2:对某字段值进行拆分 处理空数组、非数组、无字段、null情况 db.inventory.aggregate([{$unwind:{path:'$字段名称',preserveNullAndEmptyArrays:<boolean>#防止数据丢失}}]) 构造数据 db.t3.insert( [{"_id":1,"item":"a","size":["S","M","L"]}, {"_id":2,"item":"b","size":[]}, {"_id":3,"item":"c","size":"M"}, {"_id":4,"item":"d"}, {"_id":5,"item":"e","size":null}] ) 使用语法1查询 db.t3.aggregate([{$unwind:'$size'}]) 查看查询结果,发现对于空数组、无字段、null的文档,都被丢弃了 问:如何能不丢弃呢? 答:使用语法2查询 db.t3.aggregate([{$unwind:{path:'$sizes',preserveNullAndEmptyArrays:true}}]) 安全 1.超级管理员 为了更安全的访问mongodb,需要访问者提供用户名和密码,于是需要在mongodb中创建用户 采用了角色-用户-数据库的安全管理方式 常用系统角色如下: root:只在admin数据库中可用,超级账号,超级权限 Read:允许用户读取指定数据库 readWrite:允许用户读写指定数据库 创建超级管理用户 useadmindb.createUser({ user:'admin', pwd:'123', roles:[{role:'root',db:'admin'}] }) 2.启用安全认证 修改配置文件 sudovi/etc/mongod.conf 启用身份验证 注意:keys and values之间一定要加空格, 否则解析会报错 security:authorization:enabled 重启服务 sudoservicemongodstop sudoservicemongodstart 终端连接 mongo-u'admin'-p'123'--authenticationDatabase'admin' 3.普通用户管理 使用超级管理员登录,然后进入用户管理操作 查看当前数据库的用户 usetest1showusers 创建普通用户 db.createUser({ user:'t1',pwd:'123',roles:[{role:'readWrite',db:'test1'}] }) 终端连接 mongo-ut1-p123--authenticationDatabasetest1 切换数据库,执行命令查看效果 修改用户:可以修改pwd、roles属性 db.updateUser('t1',{pwd:'456'}) 复制(副本集) 1.什么是复制 ①复制提供了数据的冗余备份,并在多个服务器上存储数据副本,提高了数据的可用性,并可以保证数据的安全性 ②复制还允许从硬件故障和服务中断中恢复数据 2.为什么要复制 ①数据备份 ②数据灾难恢复 ③读写分离 ④高(24* 7)数据可用性 ⑤无宕机维护 ⑥副本集对应用程序是透明 3.复制的工作原理 ①复制至少需要两个节点A、B... ②A是主节点,负责处理客户端请求 ③其余的都是从节点,负责复制主节点上的数据 ④节点常见的搭配方式为:一主一从、一主多从 ⑤主节点记录在其上的所有操作,从节点定期轮询主节点获取这些操作,然后对自己的数据副本执行这些操作,从而保证从节点的数据与主节点一致 ⑥主节点与从节点进行数据交互保障数据的一致性 4.复制的特点 ①N 个节点的集群 ②任何节点可作为主节点 ③所有写入操作都在主节点上 ④自动故障转移 ⑤自动恢复 5.设置复制节点 接下来的操作需要打开多个终端窗口,而且可能会连接多台ubuntu主机,会显得有些乱,建议在xshell中实现 step1:创建数据库目录t1、t2 在Desktop目录下演示,其它目录也可以,注意权限即可 mkdirt1mkdirt2 step2:使用如下格式启动mongod,注意replSet的名称是一致的 mongod--bind_ip192.168.196.128--port27017 --dbpath~/Desktop/t1--replSet rs0mongod--bind_ip192.168.196.128--port27018 --dbpath~/Desktop/t2--replSetrs0 step3:连接主服务器,此处设置192.168.196.128:27017为主服务器 mongo--host192.168.196.128--port27017 step4:初始化 rs.initiate() step5:查看当前状态 rs.status() step6:添加复本集 rs.add('192.168.196.128:27018') step7:连接第二个mongo服务 mongo--host192.168.196.128--port27018 step8:向主服务器中插入数据 usetest1for(i=0;i<10;i++){ db.t1.insert({_id:i}) } db.t1.find() step9:在从服务器中插查询 说明:如果在从服务器上进行读操作,需要设置rs.slaveOk() rs.slaveOk()db.t1.find() 其它说明 删除从节点 rs.remove('192.168.196.128:27018') 关闭主服务器后,再重新启动,会发现原来的从服务器变为了主服务器,新启动的服务器(原来的从服务器)变为了从服务器 备份和恢复 1.备份 语法: mongodump-hdbhost-ddbname-odbdirectory -h:服务器地址,也可以指定端口号 -d:需要备份的数据库名称 -o:备份的数据存放位置,此目录中存放着备份出来的数据 例1: sudomkdirtest1bak sudomongodump-h192.168.196.128:27017-dtest1-o~/Desktop/test1bak 2.恢复 语法: mongorestore-hdbhost-ddbname--dirdbdirectory -h:服务器地址 -d:需要恢复的数据库实例 --dir:备份数据所在位置 例2: mongorestore-h192.168.196.128:27017-dtest2--dir~/Desktop/test1bak/test1 与python交互 1.点击查看官方文档:http://api.mongodb.org/python/current/tutorial.html 2.安装python包 进入虚拟环境 sudopipinstallpymongo 或源码安装 pythonsetup.py 引入包pymongo importpymongo 连接,创建客户端 client=pymongo.MongoClient("localhost",27017) 获得数据库test1 db=client.test1 获得集合stu stu=db.stu 添加文档 s1={name:'gj',age:18} s1_id=stu.insert_one(s1).inserted_id 查找一个文档 s2=stu.find_one() 查找多个文档1 forcurinstu.find(): printcur 查找多个文档2 cur=stu.find()cur.next()cur.next()cur.next() 获取文档个数 printstu.count()

优秀的个人博客,低调大师

MongoDB 使用入门 (全)

MongoDB简介 1.MongoDB ①MongoDB 是一个基于分布式 文件存储的NoSQL数据库 ②由C++语言编写,运行稳定,性能高 ③旨在为 WEB 应用提供可扩展的高性能数据存储解决方案 ④官方网址:https://www.mongodb.com/ 2.MongoDB特点 ①MongoDB可以轻松地布置两个活跃集群,但关系型不容易在两台服务器上同时运行单个数据库 ②MongoDB天然缺少对事物的支持 ③MongoDB并不提供主/主复制,但它支持分片 3.Bson和Json ①Bosn版本是Json的二进制格式,但并不意味着Bson占用的空间就比Json小的多 ②继续使用Bson的原因是因为MongoDB在设计上就是要求快速,而不是节省空间,如果处理数据的速度更快,存储文档时的一点开销是完全可以接受的 ③Bson更易于浏览(即遍历),遍历索引页非常快,第二点是很容易将Bson数据快速转化为编程语言的原生数据格式 4.名词 SQL术语/概念 MongoDB术语/概念 解释/说明 database database 数据库 table collection 数据库表/集合 row document 数据记录行/文档 column field 数据字段/域 index index 索引 tablejoins 表连接,MongoDB不支持 primarykey primarykey 主键,MongoDB自动将_id字段设置为主键 5.MongoDB三要素:数据库,集合,文档 ①数据库:是一个集合的物理容器,一个数据库中可以包含多个文档,一个服务器通常有多个数据库 ②集合:类似于关系数据库中的表,储存多个文档,结构不固定,如可以存储如下文档在一个集合中 {'name':'guojing','gender':'男'} {'name':'huangrong','age':18} {'book':'shuihuzhuan','heros':'108'} ③文档:就是一个对象,由键值对组成,是Json的扩展Bson格式 {'name':'guojing','gender':'男'} MongoDB安装与管理 1.安装 ①下载MongoDB的版本注意,两点注意 根据规则:偶数为稳定版,如1.6X,奇数为开发版,如1.7X 32bit的MongoDB最大只能存放2G的数据,64bit就没有限制 ②到官网,选择合适的版本下载 ③解压 tar-zxvfmongodb-linux-x86_64-ubuntu1604-3.4.0.tgz ④移动到/usr/local/目录下 sudomv-rmongodb-linux-x86_64-ubuntu1604-3.4.0//usr/local/mongodb ⑤将可执行文件添加到PATH路径中 exportPATH=/usr/local/mongodb/bin:$PATH 2.管理 ①配置文件在/etc/mongod.conf,默认端口27017 ②启动 sudoservicemongodstart ③停止 sudoservicemongodstop ④使用终端连接:mongo,这个shell就是mongodb的客户端,同时也是一个js的编译器 ⑤ GUI:robomongo,解压后在bin目录下找到运行程序 数据库操作 1.数据库切换 ①查看当前数据库名称:db ②查看所有数据库名称:show dbs,(列出所有在物理上存在的数据库) ③切换数据库:use 数据库名称,(如果数据库不存在,则指向数据库,但不创建,直到插入数据或创建集合时数据库才被创建) ④默认的数据库为test,如果没有创建新的数据库,集合将存放在test数据库中 2.数据库删除 删除当前指向的数据库,如果数据库不存在,则什么也不做 db.dropDatabase() 集合操作 1.集合创建 语法: db.createCollection(name,option) ①name是要创建集合的名称 ②options是一个文档,用于指定集合的配置 ③选项参数是可选的,所以只需要到指定的集合名称 例1:不限制集合的大小 db.createCollection(‘stu’) 例2:限制集合大小 db.createCollection(‘sub’,{capped:true,size:10}) 参数capped:默认值为false表示不设置上限,值为true表示设置上限 参数size:当capped值为true时,需要指定此参数,表示上限大小,当文档设置上限时,会将之前的数据覆盖,单位为字节 2.查看当前数据库的集合 showcollections 3.删除集合 db.集合名称.drop() 数据类型 1. MongoDB中常用的几种数据类型: ①Object ID:文档ID ②String:字符串,最常用,必须是有效的UTF-8 ③Boolean:存储一个布尔值,true或false ④Integer:整数可以是32位或64位,这取决于服务器 ⑤Double:存储浮点值 ⑥Arrays:数组或列表,多个值存储到一个键 ⑦Object:用于嵌入式的文档,即一个值为一个文档 ⑧Null:存储Null值 ⑨Timestamp:时间戳 ⑩Date:存储当前日期或时间的UNIX时间格式 2. object id ①每个文档都有一个属性,为_id,保证每个文档的唯一性 ②可以自己去设置_id插入文档 ③如果没有提供,那么MongoDB为每个文档提供了一个独特的_id,类型为objectID ④objectID是一个12字节的十六进制数 前4个字节为当前时间戳 接下来3个字节的机器ID 接下来的2个字节中MongoDB的服务进程id 最后3个字节是简单的增量值 数据操作 1.插入 插入文档时,如果不指定_id参数,MongoDB会为文档分配一个唯一的ObjectId db.集合名称.insert(document) 2.简单查询 db.集合名称.find() 3.更新 db.集合名称.update(<query>,<update>,multi:<boolean>}) ①参数query:查询条件,类似sql语句update中where部分 ②参数update:更新操作符,类似sql语句update中set部分 ③参数multi:可选,默认是false,表示只更新找到的第一条记录,值为true表示把满足条件的文档全部更新 例3:全文档更新 db.stu.update( {name:'hr'},{name:'mnc'} ) 例4:指定属性更新,通过操作符$set db.stu.insert({name:'hr',gender:0}) db.stu.update({name:'hr'},{$set:{name:'hys'}}) 例5:修改多条匹配到的数据 db.stu.update({},{$set:{gender:0}},{multi:true}) 4.保存 如果文档的_id已经存在则修改,不存在则添加 db.集合名称.save(document) 5.删除 db.集合名称.remove(<query>,{justOne:<boolean>}) ①参数query:可选,删除的文档的条件 ②参数justOne:可选,如果设为true或1,则只删除一条,默认false,表示删除多条 例6:只删除匹配到的第一条 db.stu.remove({gender:0},{justOne:true}) 例7:全部删除 db.stu.remove({}) 数据查询 1.基本查询 ①方法find():查询 db.集合名称.find({条件文档}) ②方法findOne():查询,只返回第一个 db.集合名称.findOne({条件文档}) ③方法pretty():将结果格式化 db.集合名称.find({条件文档}).pretty() 2.比较运算符 ①等于,默认是等于判断,没有运算符 ②小于$lt ③小于或等于$lte ④大于$gt ⑤大于或等于$gte ⑥不等于$ne 例8:查询年龄大于或等于18的学生 db.stu.find({age:{$gte:18}}) 3.逻辑运算符 ①查询时可以有多个条件,多个条件之间需要通过逻辑运算符连接 ②逻辑与:默认是逻辑与的关系 例9:查询年龄大于或等于18,并且性别为1的学生 db.stu.find({age:{$gte:18},gender:1}) 逻辑或:使用$or 例10:查询年龄大于18,或性别为0的学生 db.stu.find({$or:[{age:{$gt:18}},{gender:1}]}) and和or一起使用 例11:查询年龄大于18或性别为0的学生,并且学生的姓名为gj db.stu.find({$or:[{age:{$gte:18}},{gender:1}],name:'gj'}) 4.范围运算符 使用"$in","$nin" 判断是否在某个范围内 例12:查询年龄为18、28的学生 db.stu.find({age:{$in:[18,28]}}) 5.支持正则表达式 使用//或$regex编写正则表达式 例13:查询姓黄的学生 db.stu.find({name:/^黄/})db.stu.find({name:{$regex:'^黄'}}) 6.自定义查询 使用$where后面写一个函数,返回满足条件的数据 例14:查询年龄大于30的学生 db.stu.find({$where:function(){returnthis.age>20}}) 7. Limit(方法limit():用于读取指定数量的文档) db.集合名称.find().limit(NUMBER) ①参数NUMBER表示要获取文档的条数 ②如果没有指定参数则显示集合中的所有文档 例15:查询2条学生信息 db.stu.find().limit(2) 8. skip(方法skip():用于跳过指定数量的文档) db.集合名称.find().skip(NUMBER) 参数NUMBER表示跳过的记录条数,默认值为0 例16:查询从第3条开始的学生信息 db.stu.find().skip(2) 9.Limit与Skip一起使用 方法limit()和skip()可以一起使用,不分先后顺序 查询第5至8条数据(跳取) db.stu.find().limit(4).skip(5)db.stu.find().skip(5).limit(4) 10. 投影 在查询到的返回结果中,只选择必要的字段,而不是选择一个文档的整个字段 语法:参数为字段与值,值为1表示显示,值为0不显示 db.集合名称.find({},{字段名称:1,...}) 对于需要显示的字段,设置为1即可,不设置即为不显示 特殊:对于_id列默认是显示的,如果不显示需要明确设置为0 db.stu.find({},{_id:0,name:1,gender:1}) 11.排序 方法sort(),用于对结果集进行排序 语法:db.集合名称.find().sort({字段:1,...}) ①参数1为升序排列 ②参数-1为降序排列 例18:根据性别降序,再根据年龄升序 db.stu.find().sort({gender:-1,age:1}) 12.统计个数 方法count()用于统计结果集中文档条数 语法: db.集合名称.find({条件}).count() 也可以与为 db.集合名称.count({条件}) 例19:统计男生人数 db.stu.find({gender:1}).count() 例20:统计年龄大于20的男生人数 db.stu.count({age:{$gt:20},gender:1}) 13.消除重复 方法distinct()对数据进行去重 语法: db.集合名称.distinct('去重字段',{条件}) 例21:查找年龄大于18的性别(去重) db.stu.distinct('gender',{age:{$gt:18}}) 聚合 aggregate 1.聚合(aggregate) 主要用于计算数据,类似sql中的sum()、avg() 语法: db.集合名称.aggregate([{管道:{表达式}}]) 2.管道 管道在Unix和Linux中一般用于将当前命令的输出结果作为下一个命令的输入 psajx|grepmongo 在mongodb中,管道具有同样的作用,文档处理完毕后,通过管道进行下一次处理 常用管道: $group:将集合中的文档分组,可用于统计结果 $match:过滤数据,只输出符合条件的文档 $project:修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 $sort:将输入文档排序后输出 $limit:限制聚合管道返回的文档数 $skip:跳过指定数量的文档,并返回余下的文档 $unwind:将数组类型的字段进行拆分 表达式 处理输入文档并输出 语法:表达式:'$列名' $sum:计算总和,$sum:1同count表示计数 $avg:计算平均值 $min:获取最小值 $max:获取最大值 $push:在结果文档中插入值到一个数组中 $first:根据资源文档的排序获取第一个文档数据 $last:根据资源文档的排序获取最后一个文档数据 3.$group 将集合中的文档分组,可用于统计结果 _id表示分组的依据,使用某个字段的格式为'$字段' 例22:统计男生、女生的总人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}}]) Group by null 将集合中所有文档分为一组 例23:求学生总人数、平均年龄 db.stu.aggregate([{$group:{_id:null,counter:{$sum:1},avgAge:{$avg:'$age'}}}]) 透视数据 例24:统计学生性别及学生姓名 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$name'}}}]) 使用$$ROOT可以将文档内容加入到结果集的数组中,代码如下 db.stu.aggregate([{$group:{_id:'$gender',name:{$push:'$$ROOT'}}}]) 4.$match 用于过滤数据,只输出符合条件的文档 使用MongoDB的标准查询操作 例25:查询年龄大于20的学生 db.stu.aggregate([{$match:{age:{$gt:20}}}]) 例26:查询年龄大于20的男生、女生人数 db.stu.aggregate([{$match:{age:{$gt:20}}},{$group:{_id:'$gender',counter:{$sum:1}}}]) 5.$project 修改输入文档的结构,如重命名、增加、删除字段、创建计算结果 例27:查询学生的姓名、年龄 db.stu.aggregate([{$project:{_id:0,name:1,age:1}}]) 例28:查询男生、女生人数,输出人数 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$project:{_id:0,counter:1}}]) 6. $sort 将输入文档排序后输出 例29:查询学生信息,按年龄升序 b.stu.aggregate([{$sort:{age:1}}]) 例30:查询男生、女生人数,按人数降序 db.stu.aggregate([{$group:{_id:'$gender',counter:{$sum:1}}},{$sort:{counter:-1}}]) 7. $limit,$skip 限制聚合管道返回的文档数 例31:查询2条学生信息 db.stu.aggregate([{$limit:2}]) $skip 跳过指定数量的文档,并返回余下的文档 例32:查询从第3条开始的学生信息 db.stu.aggregate([{$skip:2}]) 例33:统计男生、女生人数,按人数升序,取第二条数据 db.stu.aggregate( [{$group:{_id:'$gender',counter:{$sum:1}}}, {$sort:{counter:1}}, {$skip:1}, {$limit:1}]) 注意顺序:先写skip,再写limit 8. $unwind 将文档中的某一个数组类型字段拆分成多条,每条包含数组中的一个值 语法1:对某字段值进行拆分 db.集合名称.aggregate([{$unwind:'$字段名称'}]) 构造数据 db.t2.insert({_id:1,item:'t-shirt',size:['S','M','L']}) 查询 db.t2.aggregate([{$unwind:'$size'}]) 语法2:对某字段值进行拆分 处理空数组、非数组、无字段、null情况 db.inventory.aggregate([{$unwind:{path:'$字段名称',preserveNullAndEmptyArrays:<boolean>#防止数据丢失}}]) 构造数据 db.t3.insert( [{"_id":1,"item":"a","size":["S","M","L"]}, {"_id":2,"item":"b","size":[]}, {"_id":3,"item":"c","size":"M"}, {"_id":4,"item":"d"}, {"_id":5,"item":"e","size":null}] ) 使用语法1查询 db.t3.aggregate([{$unwind:'$size'}]) 查看查询结果,发现对于空数组、无字段、null的文档,都被丢弃了 问:如何能不丢弃呢? 答:使用语法2查询 db.t3.aggregate([{$unwind:{path:'$sizes',preserveNullAndEmptyArrays:true}}]) 安全 1.超级管理员 为了更安全的访问mongodb,需要访问者提供用户名和密码,于是需要在mongodb中创建用户 采用了角色-用户-数据库的安全管理方式 常用系统角色如下: root:只在admin数据库中可用,超级账号,超级权限 Read:允许用户读取指定数据库 readWrite:允许用户读写指定数据库 创建超级管理用户 useadmindb.createUser({ user:'admin', pwd:'123', roles:[{role:'root',db:'admin'}] }) 2.启用安全认证 修改配置文件 sudovi/etc/mongod.conf 启用身份验证 注意:keys and values之间一定要加空格, 否则解析会报错 security:authorization:enabled 重启服务 sudoservicemongodstop sudoservicemongodstart 终端连接 mongo-u'admin'-p'123'--authenticationDatabase'admin' 3.普通用户管理 使用超级管理员登录,然后进入用户管理操作 查看当前数据库的用户 usetest1showusers 创建普通用户 db.createUser({ user:'t1',pwd:'123',roles:[{role:'readWrite',db:'test1'}] }) 终端连接 mongo-ut1-p123--authenticationDatabasetest1 切换数据库,执行命令查看效果 修改用户:可以修改pwd、roles属性 db.updateUser('t1',{pwd:'456'}) 复制(副本集) 1.什么是复制 ①复制提供了数据的冗余备份,并在多个服务器上存储数据副本,提高了数据的可用性,并可以保证数据的安全性 ②复制还允许从硬件故障和服务中断中恢复数据 2.为什么要复制 ①数据备份 ②数据灾难恢复 ③读写分离 ④高(24* 7)数据可用性 ⑤无宕机维护 ⑥副本集对应用程序是透明 3.复制的工作原理 ①复制至少需要两个节点A、B... ②A是主节点,负责处理客户端请求 ③其余的都是从节点,负责复制主节点上的数据 ④节点常见的搭配方式为:一主一从、一主多从 ⑤主节点记录在其上的所有操作,从节点定期轮询主节点获取这些操作,然后对自己的数据副本执行这些操作,从而保证从节点的数据与主节点一致 ⑥主节点与从节点进行数据交互保障数据的一致性 4.复制的特点 ①N 个节点的集群 ②任何节点可作为主节点 ③所有写入操作都在主节点上 ④自动故障转移 ⑤自动恢复 5.设置复制节点 接下来的操作需要打开多个终端窗口,而且可能会连接多台ubuntu主机,会显得有些乱,建议在xshell中实现 step1:创建数据库目录t1、t2 在Desktop目录下演示,其它目录也可以,注意权限即可 mkdirt1mkdirt2 step2:使用如下格式启动mongod,注意replSet的名称是一致的 mongod--bind_ip192.168.196.128--port27017 --dbpath~/Desktop/t1--replSet rs0mongod--bind_ip192.168.196.128--port27018 --dbpath~/Desktop/t2--replSetrs0 step3:连接主服务器,此处设置192.168.196.128:27017为主服务器 mongo--host192.168.196.128--port27017 step4:初始化 rs.initiate() step5:查看当前状态 rs.status() step6:添加复本集 rs.add('192.168.196.128:27018') step7:连接第二个mongo服务 mongo--host192.168.196.128--port27018 step8:向主服务器中插入数据 usetest1for(i=0;i<10;i++){ db.t1.insert({_id:i}) } db.t1.find() step9:在从服务器中插查询 说明:如果在从服务器上进行读操作,需要设置rs.slaveOk() rs.slaveOk()db.t1.find() 其它说明 删除从节点 rs.remove('192.168.196.128:27018') 关闭主服务器后,再重新启动,会发现原来的从服务器变为了主服务器,新启动的服务器(原来的从服务器)变为了从服务器 备份和恢复 1.备份 语法: mongodump-hdbhost-ddbname-odbdirectory -h:服务器地址,也可以指定端口号 -d:需要备份的数据库名称 -o:备份的数据存放位置,此目录中存放着备份出来的数据 例1: sudomkdirtest1bak sudomongodump-h192.168.196.128:27017-dtest1-o~/Desktop/test1bak 2.恢复 语法: mongorestore-hdbhost-ddbname--dirdbdirectory -h:服务器地址 -d:需要恢复的数据库实例 --dir:备份数据所在位置 例2: mongorestore-h192.168.196.128:27017-dtest2--dir~/Desktop/test1bak/test1 与python交互 1.点击查看官方文档:http://api.mongodb.org/python/current/tutorial.html 2.安装python包 进入虚拟环境 sudopipinstallpymongo 或源码安装 pythonsetup.py 引入包pymongo importpymongo 连接,创建客户端 client=pymongo.MongoClient("localhost",27017) 获得数据库test1 db=client.test1 获得集合stu stu=db.stu 添加文档 s1={name:'gj',age:18} s1_id=stu.insert_one(s1).inserted_id 查找一个文档 s2=stu.find_one() 查找多个文档1 forcurinstu.find(): printcur 查找多个文档2 cur=stu.find()cur.next()cur.next()cur.next() 获取文档个数 printstu.count()

优秀的个人博客,低调大师

轻松搞定RocketMQ入门

RocketMQ是一款分布式、队列模型的消息中间件,具有以下特点: 能够保证严格的消息顺序 提供丰富的消息拉取模式 高效的订阅者水平扩展能力 实时的消息订阅机制 亿级消息堆积能力 RocketMQ网络部署特 (1)NameServer是一个几乎无状态的节点,可集群部署,节点之间无任何信息同步 (2)Broker部署相对复杂,Broker氛围Master与Slave,一个Master可以对应多个Slaver,但是一个Slaver只能对应一个Master,Master与Slaver的对应关系通过指定相同的BrokerName,不同的BrokerId来定义,BrokerId为0表示Master,非0表示Slaver。Master可以部署多个。每个Broker与NameServer集群中的所有节点建立长连接,定时注册Topic信息到所有的NameServer (3)Producer与NameServer集群中的其中一个节点(随机选择)建立长连接,定期从NameServer取Topic路由信息,并向提供Topic服务的Master建立长连接,且定时向Master发送心跳。Produce完全无状态,可集群部署 (4)Consumer与NameServer集群中的其中一个节点(随机选择)建立长连接,定期从NameServer取Topic路由信息,并向提供Topic服务的Master、Slaver建立长连接,且定时向Master、Slaver发送心跳。Consumer即可从Master订阅消息,也可以从Slave订阅消息,订阅规则由Broker配置决定 RocketMQ储存特点 (1)零拷贝原理:Consumer消费消息过程,使用了零拷贝,零拷贝包括一下2中方式,RocketMQ使用第一种方式,因小块数据传输的要求效果比sendfile方式好 a )使用mmap+write方式 优点:即使频繁调用,使用小文件块传输,效率也很高 缺点:不能很好的利用DMA方式,会比sendfile多消耗CPU资源,内存安全性控制复杂,需要避免JVM Crash问题 b)使用sendfile方式 优点:可以利用DMA方式,消耗CPU资源少,大块文件传输效率高,无内存安全新问题 缺点:小块文件效率低于mmap方式,只能是BIO方式传输,不能使用NIO (2)数据存储结构 RocketMQ关键特性 1.单机支持1W以上的持久化队(1)所有数据单独储存到commit Log ,完全顺序写,随机读 (2)对最终用户展现的队列实际只储存消息在Commit Log 的位置信息,并且串行方式刷盘 这样做的好处: (1)队列轻量化,单个队列数据量非常少 (2)对磁盘的访问串行话,避免磁盘竞争,不会因为队列增加导致IOWait增高 每个方案都有优缺点,他的缺点是: (1)写虽然是顺序写,但是读却变成了随机读 (2)读一条消息,会先读Consume Queue,再读Commit Log,增加了开销 (3)要保证Commit Log 与 Consume Queue完全的一致,增加了编程的复杂度 以上缺点如何客服: (1)随机读,尽可能让读命中pagecache,减少IO操作,所以内存越大越好。如果系统中堆积的消息过多,读数据要访问硬盘会不会由于随机读导致系统性能急剧下降,答案是否定的。 a)访问pagecache时,即使只访问1K的消息,系统也会提前预读出更多的数据,在下次读时就可能命中pagecache b)随机访问Commit Log 磁盘数据,系统IO调度算法设置为NOOP方式,会在一定程度上将完全的随机读变成顺序跳跃方式,而顺序跳跃方式读较完全的随机读性能高5倍 (2)由于Consume Queue存储数量极少,而且顺序读,在pagecache的与读取情况下,Consume Queue的读性能与内存几乎一直,即使堆积情况下。所以可以认为Consume Queue完全不会阻碍读性能 (3)Commit Log中存储了所有的元信息,包含消息体,类似于MySQl、Oracle的redolog,所以只要有Commit Log存在, Consume Queue即使丢失数据,仍可以恢复出来 2.刷盘策略 rocketmq中的所有消息都是持久化的,先写入系统pagecache,然后刷盘,可以保证内存与磁盘都有一份数据,访问时,可以直接从内存读取 2.1异步刷盘 在有 RAID 卡, SAS 15000 转磁盘测试顺序写文件,速度可以达到 300M 每秒左右,而线上的网卡一般都为千兆网卡,写磁盘速度明显快于数据网络入口速度,那么是否可以做到写完 内存就向用户返回,由后台线程刷盘呢? (1). 由于磁盘速度大于网卡速度,那么刷盘的进度肯定可以跟上消息的写入速度。 (2). 万一由于此时系统压力过大,可能堆积消息,除了写入 IO,还有读取 IO,万一出现磁盘读取落后情况,会不会导致系统内存溢出,答案是否定的,原因如下: a) 写入消息到 PAGECACHE 时,如果内存不足,则尝试丢弃干净的 PAGE,腾出内存供新消息使用,策略是 LRU 方式。 b) 如果干净页不足,此时写入 PAGECACHE 会被阻塞,系统尝试刷盘部分数据,大约每次尝试 32 个 PAGE,来找出更多干净 PAGE。综上,内存溢出的情况不会出现 2.2同步刷盘: 同步刷盘与异步刷盘的唯一区别是异步刷盘写完 PAGECACHE 直接返回,而同步刷盘需要等待刷盘完成才返回,同步刷盘流程如下: (1)写入 PAGECACHE 后,线程等待,通知刷盘线程刷盘。 (2)刷盘线程刷盘后,唤醒前端等待线程,可能是一批线程。 (3)前端等待线程向用户返回成功。 3.消息查询 3.1按照MessageId查询消息MsgId总共16个字节,包含消息储存主机地址,消息Commit Log Offset。从MsgId中解析出Broker的地址和Commit Log 偏移地址,然后按照存储格式所在位置消息buffer解析成一个完整消息 3.2按照Message Key查询消息1.根据查询的key的hashcode%slotNum得到具体的槽位置 (slotNum是一个索引文件里面包含的最大槽目数目,例如图中所示slotNum=500W) 2.根据slotValue(slot对应位置的值)查找到索引项列表的最后一项(倒序排列,slotValue总是指向最新的一个索引项) 3.遍历索引项列表返回查询时间范围内的结果集(默认一次最大返回的32条记录) 4.Hash冲突,寻找key的slot位置时相当于执行了两次散列函数,一次key的hash,一次key的hash取值模,因此这里存在两次冲突的情况;第一种,key的hash值不同但模数相同,此时查询的时候会在比较第一次key的hash值(每个索引项保存了key的hash值),过滤掉hash值不想等的情况。第二种,hash值相等key不想等,出于性能的考虑冲突的检测放到客户端处理(key的原始值是存储在消息文件中的,避免对数据文件的解析),客户端比较一次消息体的key是否相同 5.存储,为了节省空间索引项中存储的时间是时间差值(存储时间——开始时间,开始时间存储在索引文件头中),整个索引文件是定长的,结构也是固定的 4.服务器消息过滤 RocketMQ的消息过滤方式有别于其他的消息中间件,是在订阅时,再做过滤,先来看下Consume Queue存储结构1.在Broker端进行Message Tag比较,先遍历Consume Queue,如果存储的Message Tag与订阅的Message Tag不符合,则跳过,继续比对下一个,符合则传输给Consumer。注意Message Tag是字符串形式,Consume Queue中存储的是其对应的hashcode,比对时也是比对hashcode 2.Consumer收到过滤消息后,同样也要执行在broker端的操作,但是比对的是真实的Message Tag字符串,而不是hashcode 为什么过滤要这么做? 1.Message Tag存储hashcode,是为了在Consume Queue定长方式存储,节约空间 2.过滤过程中不会访问Commit Log 数据,可以保证堆积情况下也能高效过滤 3.即使存在hash冲突,也可以在Consumer端进行修正,保证万无一失 5.单个JVM进程也能利用机器超大内存 1.Producer发送消息,消息从socket进入java 堆 2.Producer发送消息,消息从java堆进入pagecache,物理内存 3.Producer发送消息,由异步线程刷盘,消息从pagecache刷入磁盘 4.Consumer拉消息(正常消费),消息直接从pagecache(数据在物理内存)转入socket,到达Consumer,不经过java堆。这种消费场景最多,线上96G物理内存,按照1K消息算,可以物理缓存1亿条消息 5.Consumer拉消息(异常消费),消息直接从pagecache转入socket 6.Consumer拉消息(异常消费),由于socket访问了虚拟内存,产生缺页中断,此时会产生磁盘IO,从磁盘Load消息到pagecache,然后直接从socket发出去 7.同5 8.同6 6.消息堆积问题解决办法 1 消息的堆积容量、依赖磁盘大小 2 发消息的吞吐量大小受影响程度、无Slave情况,会受一定影响、有Slave情况,不受影响 3 正常消费的Consumer是否会受影响、无Slave情况,会受一定影响、有Slave情况,不受影响 4 访问堆积在磁盘的消息时,吞吐量有多大、与访问的并发有关,最终会降到5000左右 在有Slave情况下,Master一旦发现Consumer访问堆积在磁盘的数据时,回想Consumer下达一个重定向指令,令Consumer从Slave拉取数据,这样正常的发消息与正常的消费不会因为堆积受影响,因为系统将堆积场景与非堆积场景分割在了两个不同的节点处理。这里会产生一个问题,Slave会不会写性能下降,答案是否定的。因为Slave的消息写入只追求吞吐量,不追求实时性,只要整体的吞吐量高就行了,而Slave每次都是从Master拉取一批数据,如1M,这种批量顺序写入方式使堆积情况,整体吞吐量影响相对较小,只是写入RT会变长。 服务端安装部署 我是在虚拟机中的CentOS6.5中进行部署。 1.下载程序 2.tar -xvf alibaba-rocketmq-3.0.7.tar.gz 解压到适当的目录如/opt/目录 3.启动RocketMQ:进入rocketmq/bin 目录 执行4.启动Broker,设置对应的NameServer 编写客户端 可以查看sameple中的quickstart源码 1.Consumer 消息消费者2.Producer消息生产者3.首先运行Consumer程序,一直在运行状态接收服务器端推送过来的消息4.再次运行Producer程序,生成消息并发送到Broker,Producer的日志冲没了,但是可以看到Broker推送到Consumer的一条消息 Consumer最佳实践 1.消费过程要做到幂等(即消费端去重) RocketMQ无法做到消息重复,所以如果业务对消息重复非常敏感,务必要在业务层面去重,有以下一些方式: (1).将消息的唯一键,可以是MsgId,也可以是消息内容中的唯一标识字段,例如订单ID,消费之前判断是否在DB或Tair(全局KV存储)中存在,如果不存在则插入,并消费,否则跳过。(实践过程要考虑原子性问题,判断是否存在可以尝试插入,如果报主键冲突,则插入失败,直接跳过) msgid一定是全局唯一的标识符,但是可能会存在同样的消息有两个不同的msgid的情况(有多种原因),这种情况可能会使业务上重复,建议最好使用消息体中的唯一标识字段去重 (2).使业务层面的状态机去重 2.批量方式消费 如果业务流程支持批量方式消费,则可以很大程度上的提高吞吐量,可以通过设置Consumer的consumerMessageBatchMaxSize参数,默认是1,即一次消费一条参数 3.跳过非重要的消息 发生消息堆积时,如果消费速度一直跟不上发送速度,可以选择丢弃不重要的消息如以上代码所示,当某个队列的消息数堆积到 100000 条以上,则尝试丢弃部分或全部消息,这样就可以快速追上发送消息的速度 4.优化没条消息消费过程 举例如下,某条消息的消费过程如下 1、根据消息从 DB 查询数据 12、根据消息从 DB 查询数据23、复杂的业务计算4、向 DB 插入数据35、向 DB 插入数据 4 这条消息的消费过程与 DB 交互了 4 次,如果按照每次 5ms 计算,那么总共耗时 20ms,假设业务计算耗时 5ms,那么总过耗时 25ms,如果能把 4 次 DB 交互优化为 2 次,那么总耗时就可以优化到 15ms,也就是说总体性能提高了 40%。 对于 Mysql 等 DB,如果部署在磁盘,那么与 DB 进行交互,如果数据没有命中 cache,每次交互的 RT 会直线上升, 如果采用 SSD,则 RT 上升趋势要明显好于磁盘。 个别应用可能会遇到这种情况:在线下压测消费过程中,db 表现非常好,每次 RT 都很短,但是上线运行一段时间,RT 就会变长,消费吞吐量直线下降 主要原因是线下压测时间过短,线上运行一段时间后,cache 命中率下降,那么 RT 就会增加。建议在线下压测时,要测试足够长时间,尽可能模拟线上环境,压测过程中,数据的分布也很重要,数据不同,可能 cache 的命中率也会完全不同 Producer最佳实践 1.发送消息注意事项 (1) 一个应用尽可能用一个 Topic,消息子类型用 tags 来标识,tags 可以由应用自由设置。只有发送消息设置了tags,消费方在订阅消息时,才可以利用 tags 在 broker 做消息过滤。 (2)每个消息在业务层面的唯一标识码,要设置到 keys 字段,方便将来定位消息丢失问题。服务器会为每个消息创建索引(哈希索引),应用可以通过 topic,key 来查询这条消息内容,以及消息被谁消费。由于是哈希索引,请务必保证 key 尽可能唯一,这样可以避免潜在的哈希冲突。 (3)消息发送成功或者失败,要打印消息日志,务必要打印 sendresult 和 key 字段 (4)send 消息方法,只要不抛异常,就代表发送成功。但是发送成功会有多个状态,在 sendResult 里定义 SEND_OK:消息发送成功 FLUSH_DISK_TIMEOUT:消息发送成功,但是服务器刷盘超时,消息已经进入服务器队列,只有此时服务器宕机,消息才会丢失 FLUSH_SLAVE_TIMEOUT:消息发送成功,但是服务器同步到 Slave 时超时,消息已经进入服务器队列,只有此时服务器宕机,消息才会丢失 SLAVE_NOT_AVAILABLE:消息发送成功,但是此时 slave 不可用,消息已经进入服务器队列,只有此时服务器宕机,消息才会丢失。对于精确发送顺序消息的应用,由于顺序消息的局限性,可能会涉及到主备自动切换问题,所以如果sendresult 中的 status 字段不等于 SEND_OK,就应该尝试重试。对于其他应用,则没有必要这样 (5)对于消息不可丢失应用,务必要有消息重发机制 2.消息发送失败处理 Producer 的 send 方法本身支持内部重试,重试逻辑如下: (1) 至多重试 3 次 (2) 如果发送失败,则轮转到下一个 Broker (3) 这个方法的总耗时时间不超过 sendMsgTimeout 设置的值,默认 10s所以,如果本身向 broker 发送消息产生超时异常,就不会再做重试 如: 如果调用 send 同步方法发送失败,则尝试将消息存储到 db,由后台线程定时重试,保证消息一定到达 Broker。 上述 db 重试方式为什么没有集成到 MQ 客户端内部做,而是要求应用自己去完成,基于以下几点考虑: (1)MQ 的客户端设计为无状态模式,方便任意的水平扩展,且对机器资源的消耗仅仅是 cpu、内存、网络 (2)如果 MQ 客户端内部集成一个 KV 存储模块,那么数据只有同步落盘才能较可靠,而同步落盘本身性能开销较大,所以通常会采用异步落盘,又由于应用关闭过程不受 MQ 运维人员控制,可能经常会发生 kill -9 这样暴力方式关闭,造成数据没有及时落盘而丢失 (3)Producer 所在机器的可靠性较低,一般为虚拟机,不适合存储重要数据。 综上,建议重试过程交由应用来控制。 3.选择 oneway 形式发送 一个 RPC 调用,通常是这样一个过程 (1)客户端发送请求到服务器 (2)服务器处理该请求 (3)服务器向客户端返回应答 所以一个 RPC 的耗时时间是上述三个步骤的总和,而某些场景要求耗时非常短,但是对可靠性要求并不高,例如日志收集类应用,此类应用可以采用 oneway 形式调用,oneway 形式只发送请求不等待应答,而发送请求在客户端实现层面仅仅是一个 os 系统调用的开销,即将数据写入客户端的 socket 缓冲区,此过程耗时通常在微秒级。 RocketMQ不止可以直接推送消息,在消费端注册监听器进行监听,还可以由消费端决定自己去拉取数据刚开始的没有细看PullResult对象,以为拉取到的结果没有MessageExt对象还跑到群里面问别人,犯2了 特别要注意 静态变量offsetTable的作用,拉取的是按照从offset(理解为下标)位置开始拉取,拉取N条,offsetTable记录下次拉取的offset位置。 推荐阅读:JAVA-ACE-架构师系列- RocketMQ 文章来源:https://segmentfault.com/a/1190000015951993

优秀的个人博客,低调大师

EOS docker 部署 入门

1.首先准备一台内存大于8Gib的机器,安装docker 2.然后从docker hub上拉最新的eos镜像 开发镜像 docker pull eosio/eos-dev 正式镜像 docker pull eosio/eos 默认拉取的是last的tag,如有需要也可以更改其他tag docker pull eosio/eos:lastest 为了同时运行nodeos和keosd,我们需要从eos github上下载一个文件 https://github.com/EOSIO/eos/blob/master/Docker/docker-compose-latest.yml 检查文件内的镜像名称是否与你刚才pull下来的一样,如果不一样要改成一样的 version: "3" services: nodeosd: image: eosio/

优秀的个人博客,低调大师

python-模块入门

一、模块介绍 模块:模块就是一系列功能的集合体 模块有三种来源: 1.内置模块 2.第三方的模块 3.自定义模块 模块的格式: 1使用python编写的.py文件 2.已被编译为共享库或DLL的C或C++扩展 3.把一系列模块组织到一起的文件夹(注:文件夹下有一个__init__.py文件,该文件称之为包) 4.使用C编写并链接到python解释器的内置模块 为何要用模块? 1.使用内置的或者第三方模块的好处是:拿来主义,可以极大提升开发效率 2.使用自定义模块的好处是:可以减少代码冗余(抽取我们自己程序中要公用的一些功能定义成模块,然后程序的各部分组件都去模块中调用共享功能) 注: 一定要区分开谁是执行文件,谁是被导入模块 二、import导入模块 首次导入模块: 1.会产生一个模块的名称空间 2.执行模块文件,将执行过程中产生的名字都放到模块的名称空间中 3.在当前执行文件的名称空间中拿到一个模块名,该名字指向模块的名称空间 后面的导入,都是直接引用第一次导入的成果,不会重新执行文件 spam.money 在执行文件中访问模块名称空间中名字的语法: 模块名.名字(注:模块名应该全部为小写) 指名道姓地跟spam要money 不会与当前执行文件中的名字冲突 为模块起别名 import xxx as x 总结import导入模块: 优点:指名道姓地向某一个名称空间要名字,不会与当前名称空间中的名字冲突 缺点:但凡应用模块中的名字都需要前缀,不够简洁 三、from...import...导入模块 首次导入模块: 1.会产生一个模块的名称空间 2.执行模块文件,将执行过程中产生的名字都放到模块的名称空间中 3.在当前执行文件的名称空间中拿到一个名字,该名字就是执行模块中对应的名字 总结from...import... 优点:使用时,无需再加前缀,更简洁 缺点:容易与当前名称空间中的名字冲突 补充: from xxx import * 导入全部 *代表从被导入模块中拿到所有名字(不推荐使用) 在导入模块时,如果未找到__all__中的成员,抛出attributeError # __all__ = ['money','read1'] 焚膏油以继晷,恒兀兀以穷年。

优秀的个人博客,低调大师

不学无数——SpringBoot入门Ⅰ

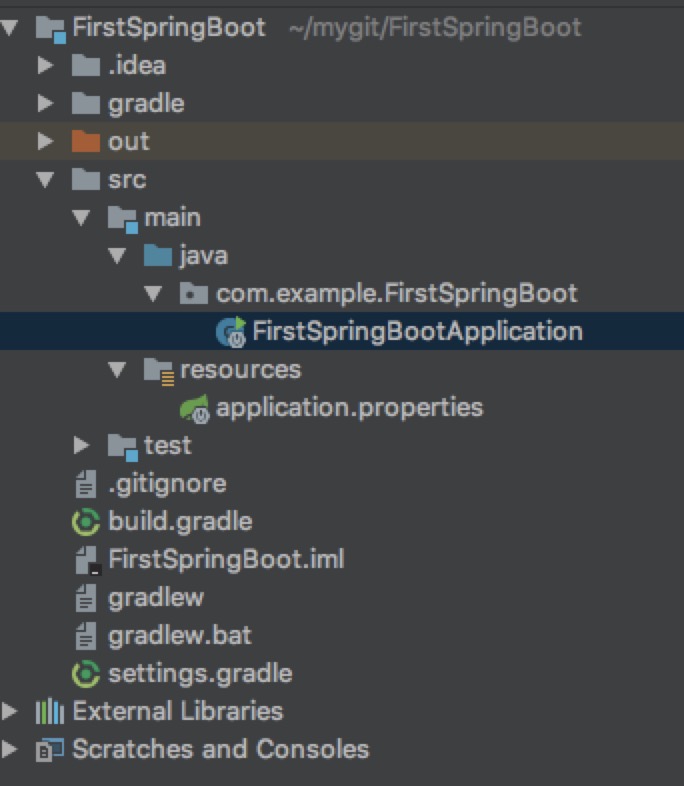
SpringBoot 1.SpringBoot简介 在刚接触SSM框架的时候,想必都会被这个框架的配置文件所烦扰,需要自己手动配置的东西非常多,哪怕有些东西自己不需要也是需要配置的。而SpringBoot此时就应运而生,减少了大家的配置过程。相信都听过“约定优于配置”的这样一句话,就是说系统,类库,框架应该假定合理的默认值,而非要求提供不必要的配置,可是使用Spring或者SpringMVC的话依然有许多这样的东西需要我们进行配置,这样不仅徒增工作量而且在跨平台部署时容易出问题。简单来说就是使用SpringBoot可以快速构建一个能够运行的Spring项目。 1.1 SpringBoot优点 能够快速构建一个能够独立运行的Spring项目 内嵌有Tomcat容器,无需配置Tomcat 提供了许多starter,简化了许多的配置 无代码生成,没有xml的配置 2.第一个SpringBoot项目启动 2.1 项目搭建 介绍完Springboot以后,让我们开始搭建一个简单的“Hello World!”的SpringBoot项目。千里之行始于足下,相信第一个java项目也是从“hello,world!”开始的。不要小瞧了这第一步,有多少人是在第一步遭受到了挫折从而放弃了。但是SpringBoot给提供的第一步启动实在是简单,和它的宗旨也正相符合。快速而简便的构建项目。 https://start.spring.io/这是SpringBoot提供的建立项目的网站,点击进去以后选择所需要的版本、语言、功能以后点击生成即可生成一个项目包,如果是想要启动一个简单的web项目,那么就在功能处输入web,那么会在建立项目的时候自动引入了springboot启动web包。然后用编译器打开项目以后你会发现SpringBoot已经将文件目录都创建好了。 可以清楚的看到SpringBoot的生成文件结构,其中FirstSpringBootApplication是和你的项目名是一致的,它相当于程序的入口处,而resource文件夹下的application文件是配置文件,例如想要配置启动的tomcat端口号都可以在此配置。build.gralde是由于我选择的是gradle所以生成的这个文件,此文件是可以将想要引用的jar包写在里面。gradle会自动的从网上或者本地下载相应的jar包。 2.2 项目启动 在项目的启动文件中加入这行代码,当然也可以自己建一个java文件。但是要加上@RestController注解。 @RequestMapping("/") String home() { return "Hello"; } 为什么是@RestController而不是@Controller呢,此时我们可以点击进@RestController中可以看到它是由@Controller和@ResponseBody组成的注解。其中加不加@ResponseBody是有区别的,如果加上的话那么就会将你的返回值作为数据返回,如果不加的话那么就会当做页面的名称。举个例子像上面的代码如果有@ResponseBody的话那么就会返回给页面Hello字符串,如果是没有的话就会跳转到Hello.html或者Hello.jsp页面,具体是jsp还是html页面,得看SpringMvc的配置了,这里就不详细解释。然后直接运行FirstSpringBootApplication.java里面main方法即可启动。打开了启动文件你会发现上面带了一个@SpringBootApplocation注解。这个注解接下来我们再解释。然后在页面输入localhost:8080即可看见Hello。 2.3项目结构 通常来说,SpringBoot的启动类建议放在代码的根目录下的。因为@EnableAutoConfiguration这个注解是基于你的启动类来扫描的,意思就是扫描启动类所在的文件夹以及以下的所有文件。如下所示,SpringBoot回去扫描domain、service和web包下的文件 com +- example +- myproject +- Application.java | +- domain | +- Customer.java | +- CustomerRepository.java | +- service | +- CustomerService.java | +- web +- CustomerController.java 3.@SpringBootApplocation注解详解 进入到@SpringBootApplocation这个注解当中时,可以发现里面还有其他的注解 其中最重要的是@SpringBootConfiguration @EnableAutoConfiguration @ComponentScan这三个注解。 3.1@EnableAutoConfiguration 这是一个类级别的注解,这个注解的作用是猜,为什么是猜呢。因为他会基于你的jar包依赖而猜测将会怎样的配置。例如spring-boot-starter-web你添加了这个jar包以后其中包含着Tomcat和SpringMVC,这个注解会猜测这个项目会是一个web项目,所以他就会自动的配置了Spring。 当然你要可以自己定制自己需要的配置,例如如果你想添加自己的数据源DateSource的话,那么自己写一个类,上面加上@Configure的注解,那么在项目启动的时候就会优先使用自己写的配置。如果想知道项目中有哪些是自动配置了,那么启动项目的时候用--debug启动那么在控制台中的日志中就会有显示。 如果发现有些类不想让他自动加载的话,那么就使用@EnableAutoConfiguration(exclude={类名})即可。 3.2 @ComponentScan 在Sping中你可以使用注解进行注入Bean,例如@Controller@Service等等,这些都是自动注入的。但是得设置扫描的包路径,直接@ComponentScan("org.example.web")这样既可,就是扫描org.example.web下的包。这个注解和xml中对应的配置是 <context:component-scan base-package="org.example.web"/> 3.3@SpringBootConfiguration 加上此注解的就表明了一个类提供SpringBoot应用。在之前的Spring的Test模块中,如果想要进行模块化的测试的话,或许会去寻找@ContextConfiguration进行加载一些资源文件,另外也可能需要写针对于Test模块的@Configuration,但是在SpringBoot中不用如此,因为他会有一个算法,会在模块化测试的时候回自动的寻找@SpringBootConfiguration注解。这样就不需要单独的配置测试模块的配置文件了,但是如果想定制化测试模块的配置文件话也可以,只要加上@TestConfiguration即可。 3.4其他注解 3.4.1@ImportResource SpringBoot是不推荐使用xml的配置文件,他所想要的结果是所有的配置都是java类上面加上@Configuration配置。但是有的项目确实得需要xml配置文件,这时候就可以使用@ImportResource注解

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册