首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

ElasticSearch入门实战1

document数据格式 电商网站商品管理案例背景介绍 简单的集群管理 商品的CRUD操作(document curd) 1. Document数据格式 面向文档的搜索分析引擎 应用系统的数据结构都是面向对象的,复杂的 对象数据存储到数据库中,只能拆解开来,变成扁平的多张表,每次查询的时候还有还原成对象格式,相当麻烦 ES是面向文档的,文档中存储的数据结构,与面向对象的数据结构是一样的,基于这种文档数据结构。ES可以提供复杂的索引,全文检索,分析聚合等功能。 ES的document用json数据格式来表示的。 public class Employee { private String email; private String firstName; private String lastName; private EmployeeInfo info; private Date joinDate; } private class EmployeeInfo { private String bio; private Integer age; private String[] interesets; } EmployeeInfo info = new EmployeeInfo(); info.SetBio("youdi"); info.setAge(24); info.setInteresets(new String[]{"dance", "code"}); Employee employee = new Employee(); employee.setEmail("@"); employee.setInfo(info); employee对象:里面包含了Employee类自己属性。需要保存在两张表。 使用ORM.数据库是扁平化的,不能体现出面向对象的结构。 2.电商网站商品管理案例背景介绍 提供功能如下: 对商品信息进行CRUD 执行简单的全文检索,以及复杂的phrase检索 对于全文检索结果,可以进行高亮显示 对数据进行简单的聚合分析 3. 简单的集群管理 快速检查集群的健康状况 ES提供了一套cat api,可以查看es中各种各样的数据 GET /_cat/health?pretty epoch timestamp cluster status node.total node.data shards pri relo init unassign pending_tasks max_task_wait_time active_shards_percent 1524842572 23:22:52 elasticsearch_youdi yellow 1 1 10 10 0 0 10 0 - 50.0% 查看status Green: 每个索引的primary shard和replica shard 都是active状态 yellow: 每个索引的primary shard是active状态,但是部分replica shard不是active状态,处于不可用的状态 red: 不是所有的索引的primary shard都是active状态,部分缩影有数据丢失 为什么现在会处于yellow状态? primary shard replica shard没有第二个节点 快速查看集群中所有索引? GET /_cat/indices?v health status index uuid pri rep docs.count docs.deleted store.size pri.store.size yellow open website -NVtisruRUO1buiENwh7Vw 5 1 1 0 5.5kb 5.5kb yellow open megacorp 3YlG1FRPTDynSETmZBDIhg 5 1 3 0 17.5kb 17.5kb 简单的索引操作 PUT /test_index?pretty DELETE /test_index?pretty 商品的CURD 新增商品 PUT /index/type/id PUT /products/goods/1 { "name": "test", "desc": "hello world", "price": 11.0, "producer": "hello", "tags": ["youdi", "haha"] } { "_index": "products", "_type": "goods", "_id": "1", "_version": 1, "result": "created", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 0, "_primary_term": 1 } 查询商品 GET /products/goods/1 { "_index": "products", "_type": "goods", "_id": "1", "_version": 1, "found": true, "_source": { "name": "test", "desc": "hello world", "price": 11, "producer": "hello", "tags": [ "youdi", "haha" ] } } 更新操作 替换方式: 必须提交所有的信息 PUT /products/goods/1 { "name": "test3", "desc": "hello world", "price": 11.5, "producer": "hello", "tags": ["youdi", "haha"] } { "_index": "products", "_type": "goods", "_id": "1", "_version": 2, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 1, "_primary_term": 1 } PUT /products/goods/1 { "name": "test3" } GET /products/goods/1 { "_index": "products", "_type": "goods", "_id": "1", "_version": 3, "found": true, "_source": { "name": "test3" } } POST products/goods/1/_update { "doc": { "name": "test6" } } { "_index": "products", "_type": "goods", "_id": "1", "_version": 5, "result": "updated", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 4, "_primary_term": 1 } 删除文档 DELETE /products/goods/1 { "_index": "products", "_type": "goods", "_id": "1", "_version": 6, "result": "deleted", "_shards": { "total": 2, "successful": 1, "failed": 0 }, "_seq_no": 5, "_primary_term": 1 } { "_index": "products", "_type": "goods", "_id": "1", "found": false } 商品的搜索方式 query string search Query DSL query filter Full-text search 1. query string search 搜索全部商品 GET /products/goods/_search { "took": 104, //耗时 "timed_out": false, //是否超时 "_shards": { //_shards "total": 5, "successful": 5, "skipped": 0, "failed": 0 }, "hits": { "total": 1, // 查询结果的数量 1条数据 "max_score": 1, //ES对相关度的匹配分数 "hits": [ //包含了搜索的详细数据 { "_index": "products", "_type": "goods", "_id": "2", "_score": 1, "_source": { "name": "tes2", "desc": "hello world", "price": 14, "producer": "hello", "tags": [ "youdi", "haha" ] } } ] } } { "took": 8, "timed_out": false, "_shards": { "total": 5, "successful": 5, "skipped": 0, "failed": 0 }, "hits": { "total": 2, "max_score": 1, "hits": [ { "_index": "products", "_type": "goods", "_id": "2", "_score": 1, "_source": { "name": "tes2", "desc": "hello world", "price": 14, "producer": "hello", "tags": [ "youdi", "haha" ] } }, { "_index": "products", "_type": "goods", "_id": "1", "_score": 1, "_source": { "name": "test3", "desc": "hello world", "price": 11.5, "producer": "hello", "tags": [ "youdi", "haha" ] } } ] } } { "_index": "bank", "_type": "_doc", "_id": "25", "_score": 1, "_source": { "account_number": 25, "balance": 40540, "firstname": "Virginia", "lastname": "Ayala", "age": 39, "gender": "F", "address": "171 Putnam Avenue", "employer": "Filodyne", "email": "virginiaayala@filodyne.com", "city": "Nicholson", "state": "PA" } }, 搜索账号名字中有ber,而且按照年龄排序 GET /bank/_doc/_search?q=firstname:Virginia&sort=age:des { "took": 1, "timed_out": false, "_shards": { "total": 5, "successful": 5, "skipped": 0, "failed": 0 }, "hits": { "total": 1, "max_score": 4.882802, "hits": [ { "_index": "bank", "_type": "_doc", "_id": "25", "_score": 4.882802, "_source": { "account_number": 25, "balance": 40540, "firstname": "Virginia", "lastname": "Ayala", "age": 39, "gender": "F", "address": "171 Putnam Avenue", "employer": "Filodyne", "email": "virginiaayala@filodyne.com", "city": "Nicholson", "state": "PA" } } ] } } query DSL DSL:Domain specified Language 特定领域的语言 查询所有的account http request body :请求体,可以使用json的格式构建查询语法,比较方便,可以构建各种复杂的语法。 GET /bank/_doc/_search { "query": { "match_all": {} } } { "took": 1, "timed_out": false, "_shards": { "total": 5, "successful": 5, "skipped": 0, "failed": 0 }, "hits": { "total": 1000, "max_score": 1, "hits": [ { "_index": "bank", "_type": "_doc", "_id": "25", "_score": 1, "_source": { "account_number": 25, "balance": 40540, "firstname": "Virginia", "lastname": "Ayala", "age": 39, "gender": "F", "address": "171 Putnam Avenue", "employer": "Filodyne", "email": "virginiaayala@filodyne.com", "city": "Nicholson", "state": "PA" } }, { "_index": "bank", "_type": "_doc", "_id": "44", "_score": 1, "_source": { "account_number": 44, "balance": 34487, "firstname": "Aurelia", "lastname": "Harding", "age": 37, "gender": "M", "address": "502 Baycliff Terrace", "employer": "Orbalix", "email": "aureliaharding@orbalix.com", "city": "Yardville", "state": "DE" } }, { "_index": "bank", "_type": "_doc", "_id": "99", "_score": 1, "_source": { "account_number": 99, "balance": 47159, "firstname": "Ratliff", "lastname": "Heath", "age": 39, "gender": "F", "address": "806 Rockwell Place", "employer": "Zappix", "email": "ratliffheath@zappix.com", "city": "Shaft", "state": "ND" } }, { "_index": "bank", "_type": "_doc", "_id": "119", "_score": 1, "_source": { "account_number": 119, "balance": 49222, "firstname": "Laverne", "lastname": "Johnson", "age": 28, "gender": "F", "address": "302 Howard Place", "employer": "Senmei", "email": "lavernejohnson@senmei.com", "city": "Herlong", "state": "DC" } }, { "_index": "bank", "_type": "_doc", "_id": "126", "_score": 1, "_source": { "account_number": 126, "balance": 3607, "firstname": "Effie", "lastname": "Gates", "age": 39, "gender": "F", "address": "620 National Drive", "employer": "Digitalus", "email": "effiegates@digitalus.com", "city": "Blodgett", "state": "MD" } }, { "_index": "bank", "_type": "_doc", "_id": "145", "_score": 1, "_source": { "account_number": 145, "balance": 47406, "firstname": "Rowena", "lastname": "Wilkinson", "age": 32, "gender": "M", "address": "891 Elton Street", "employer": "Asimiline", "email": "rowenawilkinson@asimiline.com", "city": "Ripley", "state": "NH" } }, { "_index": "bank", "_type": "_doc", "_id": "183", "_score": 1, "_source": { "account_number": 183, "balance": 14223, "firstname": "Hudson", "lastname": "English", "age": 26, "gender": "F", "address": "823 Herkimer Place", "employer": "Xinware", "email": "hudsonenglish@xinware.com", "city": "Robbins", "state": "ND" } }, { "_index": "bank", "_type": "_doc", "_id": "190", "_score": 1, "_source": { "account_number": 190, "balance": 3150, "firstname": "Blake", "lastname": "Davidson", "age": 30, "gender": "F", "address": "636 Diamond Street", "employer": "Quantasis", "email": "blakedavidson@quantasis.com", "city": "Crumpler", "state": "KY" } }, { "_index": "bank", "_type": "_doc", "_id": "208", "_score": 1, "_source": { "account_number": 208, "balance": 40760, "firstname": "Garcia", "lastname": "Hess", "age": 26, "gender": "F", "address": "810 Nostrand Avenue", "employer": "Quiltigen", "email": "garciahess@quiltigen.com", "city": "Brooktrails", "state": "GA" } }, { "_index": "bank", "_type": "_doc", "_id": "222", "_score": 1, "_source": { "account_number": 222, "balance": 14764, "firstname": "Rachelle", "lastname": "Rice", "age": 36, "gender": "M", "address": "333 Narrows Avenue", "employer": "Enaut", "email": "rachellerice@enaut.com", "city": "Wright", "state": "AZ" } } ] } }
优秀的个人博客,低调大师

Kafka入门经典教程

一、基本概念 介绍 Kafka是一个分布式的、可分区的、可复制的消息系统。它提供了普通消息系统的功能,但具有自己独特的设计。 这个独特的设计是什么样的呢? 首先让我们看几个基本的消息系统术语: Kafka将消息以topic为单位进行归纳。 将向Kafka topic发布消息的程序成为producers. 将预订topics并消费消息的程序成为consumer. Kafka以集群的方式运行,可以由一个或多个服务组成,每个服务叫做一个broker. producers通过网络将消息发送到Kafka集群,集群向消费者提供消息,如下图所示: 客户端和服务端通过TCP协议通信。Kafka提供了Java客户端,并且对多种语言都提供了支持。 Topics 和Logs 先来看一下Kafka提供的一个抽象概念:topic. 一个topic是对一组消息的归纳。对每个topic,Kafka 对它的日志进行了分区,如下图所示: 每个分区都由一系列有序的、不可变的消息组成,这些消息被连续的追加到分区中。分区中的每个消息都有一个连续的序列号叫做offset,用来在分区中唯一的标识这个消息。 在一个可配置的时间段内,Kafka集群保留所有发布的消息,不管这些消息有没有被消费。比如,如果消息的保存策略被设置为2天,那么在一个消息被发布的两天时间内,它都是可以被消费的。之后它将被丢弃以释放空间。Kafka的性能是和数据量无关的常量级的,所以保留太多的数据并不是问题。 实际上每个consumer唯一需要维护的数据是消息在日志中的位置,也就是offset.这个offset有consumer来维护:一般情况下随着consumer不断的读取消息,这offset的值不断增加,但其实consumer可以以任意的顺序读取消息,比如它可以将offset设置成为一个旧的值来重读之前的消息。 以上特点的结合,使Kafka consumers非常的轻量级:它们可以在不对集群和其他consumer造成影响的情况下读取消息。你可以使用命令行来"tail"消息而不会对其他正在消费消息的consumer造成影响。 将日志分区可以达到以下目的:首先这使得每个日志的数量不会太大,可以在单个服务上保存。另外每个分区可以单独发布和消费,为并发操作topic提供了一种可能。 分布式 每个分区在Kafka集群的若干服务中都有副本,这样这些持有副本的服务可以共同处理数据和请求,副本数量是可以配置的。副本使Kafka具备了容错能力。 每个分区都由一个服务器作为“leader”,零或若干服务器作为“followers”,leader负责处理消息的读和写,followers则去复制leader.如果leader down了,followers中的一台则会自动成为leader。集群中的每个服务都会同时扮演两个角色:作为它所持有的一部分分区的leader,同时作为其他分区的followers,这样集群就会据有较好的负载均衡。 Producers Producer将消息发布到它指定的topic中,并负责决定发布到哪个分区。通常简单的由负载均衡机制随机选择分区,但也可以通过特定的分区函数选择分区。使用的更多的是第二种。 Consumers 发布消息通常有两种模式:队列模式(queuing)和发布-订阅模式(publish-subscribe)。队列模式中,consumers可以同时从服务端读取消息,每个消息只被其中一个consumer读到;发布-订阅模式中消息被广播到所有的consumer中。Consumers可以加入一个consumer 组,共同竞争一个topic,topic中的消息将被分发到组中的一个成员中。同一组中的consumer可以在不同的程序中,也可以在不同的机器上。如果所有的consumer都在一个组中,这就成为了传统的队列模式,在各consumer中实现负载均衡。如果所有的consumer都不在不同的组中,这就成为了发布-订阅模式,所有的消息都被分发到所有的consumer中。更常见的是,每个topic都有若干数量的consumer组,每个组都是一个逻辑上的“订阅者”,为了容错和更好的稳定性,每个组由若干consumer组成。这其实就是一个发布-订阅模式,只不过订阅者是个组而不是单个consumer。 由两个机器组成的集群拥有4个分区 (P0-P3) 2个consumer组. A组有两个consumerB组有4个 相比传统的消息系统,Kafka可以很好的保证有序性。 传统的队列在服务器上保存有序的消息,如果多个consumers同时从这个服务器消费消息,服务器就会以消息存储的顺序向consumer分发消息。虽然服务器按顺序发布消息,但是消息是被异步的分发到各consumer上,所以当消息到达时可能已经失去了原来的顺序,这意味着并发消费将导致顺序错乱。为了避免故障,这样的消息系统通常使用“专用consumer”的概念,其实就是只允许一个消费者消费消息,当然这就意味着失去了并发性。 在这方面Kafka做的更好,通过分区的概念,Kafka可以在多个consumer组并发的情况下提供较好的有序性和负载均衡。将每个分区分只分发给一个consumer组,这样一个分区就只被这个组的一个consumer消费,就可以顺序的消费这个分区的消息。因为有多个分区,依然可以在多个consumer组之间进行负载均衡。注意consumer组的数量不能多于分区的数量,也就是有多少分区就允许多少并发消费。 Kafka只能保证一个分区之内消息的有序性,在不同的分区之间是不可以的,这已经可以满足大部分应用的需求。如果需要topic中所有消息的有序性,那就只能让这个topic只有一个分区,当然也就只有一个consumer组消费它。 二、环境搭建 Step 1: 下载Kafka 点击下载最新的版本并解压. tar -xzf kafka_2.9.2-0.8.1.1.tgz cd kafka_2.9.2-0.8.1.1 复制代码 Step 2: 启动服务 Kafka用到了Zookeeper,所有首先启动Zookper,下面简单的启用一个单实例的Zookkeeper服务。可以在命令的结尾加个&符号,这样就可以启动后离开控制台。 bin/zookeeper-server-start.sh config/zookeeper.properties & [2013-04-22 15:01:37,495] INFO Reading configuration from: config/zookeeper.properties (org.apache.zookeeper.server.quorum.QuorumPeerConfig) ... 复制代码 现在启动Kafka: bin/kafka-server-start.sh config/server.properties [2013-04-22 15:01:47,028] INFO Verifying properties (kafka.utils.VerifiableProperties) [2013-04-22 15:01:47,051] INFO Property socket.send.buffer.bytes is overridden to 1048576 (kafka.utils.VerifiableProperties) ... 复制代码 Step 3: 创建 topic 创建一个叫做“test”的topic,它只有一个分区,一个副本。 bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic test 复制代码 可以通过list命令查看创建的topic: bin/kafka-topics.sh --list --zookeeper localhost:2181 test 复制代码 除了手动创建topic,还可以配置broker让它自动创建topic. Step 4:发送消息. Kafka 使用一个简单的命令行producer,从文件中或者从标准输入中读取消息并发送到服务端。默认的每条命令将发送一条消息。 运行producer并在控制台中输一些消息,这些消息将被发送到服务端: bin/kafka-console-producer.sh --broker-list localhost:9092 --topic test This is a messageThis is another message 复制代码 ctrl+c可以退出发送。 Step 5: 启动consumer Kafka also has a command line consumer that will dump out messages to standard output. Kafka也有一个命令行consumer可以读取消息并输出到标准输出: bin/kafka-console-consumer.sh --zookeeper localhost:2181 --topic test --from-beginning This is a message This is another message 复制代码 你在一个终端中运行consumer命令行,另一个终端中运行producer命令行,就可以在一个终端输入消息,另一个终端读取消息。 这两个命令都有自己的可选参数,可以在运行的时候不加任何参数可以看到帮助信息。 Step 6: 搭建一个多个broker的集群 刚才只是启动了单个broker,现在启动有3个broker组成的集群,这些broker节点也都是在本机上的: 首先为每个节点编写配置文件: cp config/server.properties config/server-1.properties cp config/server.properties config/server-2.properties 复制代码 在拷贝出的新文件中添加以下参数: config/server-1.properties: broker.id=1 port=9093 log.dir=/tmp/kafka-logs-1 复制代码 config/server-2.properties: broker.id=2 port=9094 log.dir=/tmp/kafka-logs-2 复制代码 broker.id在集群中唯一的标注一个节点,因为在同一个机器上,所以必须制定不同的端口和日志文件,避免数据被覆盖。 We already have Zookeeper and our single node started, so we just need to start the two new nodes: 刚才已经启动可Zookeeper和一个节点,现在启动另外两个节点: bin/kafka-server-start.sh config/server-1.properties & ... bin/kafka-server-start.sh config/server-2.properties & ... 复制代码 创建一个拥有3个副本的topic: bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 3 --partitions 1 --topic my-replicated-topic 复制代码 现在我们搭建了一个集群,怎么知道每个节点的信息呢?运行“"describe topics”命令就可以了: bin/kafka-topics.sh --describe --zookeeper localhost:2181 --topic my-replicated-topic 复制代码 Topic:my-replicated-topic PartitionCount:1 ReplicationFactor:3 Configs: Topic: my-replicated-topic Partition: 0 Leader: 1 Replicas: 1,2,0 Isr: 1,2,0 复制代码 下面解释一下这些输出。第一行是对所有分区的一个描述,然后每个分区都会对应一行,因为我们只有一个分区所以下面就只加了一行。 leader:负责处理消息的读和写,leader是从所有节点中随机选择的. replicas:列出了所有的副本节点,不管节点是否在服务中. isr:是正在服务中的节点. 在我们的例子中,节点1是作为leader运行。 向topic发送消息: bin/kafka-console-producer.sh --broker-list localhost:9092 --topic my-replicated-topic 复制代码 ... my test message 1my test message 2^C 复制代码 消费这些消息: bin/kafka-console-consumer.sh --zookeeper localhost:2181 --from-beginning --topic my-replicated-topic ... my test message 1 my test message 2 ^C 测试一下容错能力.Broker 1作为leader运行,现在我们kill掉它: ps | grep server-1.properties7564 ttys002 0:15.91 /System/Library/Frameworks/JavaVM.framework/Versions/1.6/Home/bin/java... kill -9 7564 复制代码 另外一个节点被选做了leader,node 1 不再出现在 in-sync 副本列表中: bin/kafka-topics.sh --describe --zookeeper localhost:218192 --topic my-replicated-topic Topic:my-replicated-topic PartitionCount:1 ReplicationFactor:3 Configs: Topic: my-replicated-topic Partition: 0 Leader: 2 Replicas: 1,2,0 Isr: 2,0 复制代码 虽然最初负责续写消息的leader down掉了,但之前的消息还是可以消费的: bin/kafka-console-consumer.sh --zookeeper localhost:2181 --from-beginning --topic my-replicated-topic ... my test message 1 my test message 2 复制代码 看来Kafka的容错机制还是不错的。 三、搭建Kafka开发环境 我们搭建了kafka的服务器,并可以使用Kafka的命令行工具创建topic,发送和接收消息。下面我们来搭建kafka的开发环境。 添加依赖 搭建开发环境需要引入kafka的jar包,一种方式是将Kafka安装包中lib下的jar包加入到项目的classpath中,这种比较简单了。不过我们使用另一种更加流行的方式:使用maven管理jar包依赖。 创建好maven项目后,在pom.xml中添加以下依赖: org.apache.kafka kafka_2.10 0.8.0 复制代码 添加依赖后你会发现有两个jar包的依赖找不到。没关系我都帮你想好了,点击这里下载这两个jar包,解压后你有两种选择,第一种是使用mvn的install命令将jar包安装到本地仓库,另一种是直接将解压后的文件夹拷贝到mvn本地仓库的com文件夹下,比如我的本地仓库是d:mvn,完成后我的目录结构是这样的: 配置程序 首先是一个充当配置文件作用的接口,配置了Kafka的各种连接参数: package com.sohu.kafkademon; public interface KafkaProperties { final static String zkConnect = "10.22.10.139:2181"; final static String groupId = "group1"; final static String topic = "topic1"; final static String kafkaServerURL = "10.22.10.139"; final static int kafkaServerPort = 9092; final static int kafkaProducerBufferSize = 64 * 1024; final static int connectionTimeOut = 20000; final static int reconnectInterval = 10000; final static String topic2 = "topic2"; final static String topic3 = "topic3"; final static String clientId = "SimpleConsumerDemoClient"; } 复制代码 producer package com.sohu.kafkademon; import java.util.Properties; import kafka.producer.KeyedMessage; import kafka.producer.ProducerConfig; /** @author leicui bourne_cui@163.com */ public class KafkaProducer extends Thread { private final kafka.javaapi.producer.Producer producer; private final String topic; private final Properties props = new Properties(); public KafkaProducer(String topic) { props.put("serializer.class", "kafka.serializer.StringEncoder"); props.put("metadata.broker.list", "10.22.10.139:9092"); producer = new kafka.javaapi.producer.Producer(new ProducerConfig(props)); this.topic = topic; } @Override public void run() { int messageNo = 1; while (true) { String messageStr = new String("Message_" + messageNo); System.out.println("Send:" + messageStr); producer.send(new KeyedMessage(topic, messageStr)); messageNo++; try { sleep(3000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } } } } 复制代码 consumer package com.sohu.kafkademon; import java.util.HashMap; import java.util.List; import java.util.Map; import java.util.Properties; import kafka.consumer.ConsumerConfig; import kafka.consumer.ConsumerIterator; import kafka.consumer.KafkaStream; import kafka.javaapi.consumer.ConsumerConnector; /** @author leicui bourne_cui@163.com */ public class KafkaConsumer extends Thread { private final ConsumerConnector consumer; private final String topic; public KafkaConsumer(String topic) { consumer = kafka.consumer.Consumer.createJavaConsumerConnector( createConsumerConfig()); this.topic = topic; } private static ConsumerConfig createConsumerConfig() { Properties props = new Properties(); props.put("zookeeper.connect", KafkaProperties.zkConnect); props.put("group.id", KafkaProperties.groupId); props.put("zookeeper.session.timeout.ms", "40000"); props.put("zookeeper.sync.time.ms", "200"); props.put("auto.commit.interval.ms", "1000"); return new ConsumerConfig(props); } @Override public void run() { Map topicCountMap = new HashMap(); topicCountMap.put(topic, new Integer(1)); Map>> consumerMap = consumer.createMessageStreams(topicCountMap); KafkaStream stream = consumerMap.get(topic).get(0); ConsumerIterator it = stream.iterator(); while (it.hasNext()) { System.out.println("receive:" + new String(it.next().message())); try { sleep(3000); } catch (InterruptedException e) { e.printStackTrace(); } } } } 复制代码 简单的发送接收 运行下面这个程序,就可以进行简单的发送接收消息了: package com.sohu.kafkademon; /** @author leicui bourne_cui@163.com */ public class KafkaConsumerProducerDemo { public static void main(String[] args) { KafkaProducer producerThread = new KafkaProducer(KafkaProperties.topic); producerThread.start(); KafkaConsumer consumerThread = new KafkaConsumer(KafkaProperties.topic); consumerThread.start(); } } 复制代码 高级别的consumer 下面是比较负载的发送接收的程序: package com.sohu.kafkademon; import java.util.HashMap; import java.util.List; import java.util.Map; import java.util.Properties; import kafka.consumer.ConsumerConfig; import kafka.consumer.ConsumerIterator; import kafka.consumer.KafkaStream; import kafka.javaapi.consumer.ConsumerConnector; /** @author leicui bourne_cui@163.com */ public class KafkaConsumer extends Thread { private final ConsumerConnector consumer; private final String topic; public KafkaConsumer(String topic) { consumer = kafka.consumer.Consumer.createJavaConsumerConnector( createConsumerConfig()); this.topic = topic; } private static ConsumerConfig createConsumerConfig() { Properties props = new Properties(); props.put("zookeeper.connect", KafkaProperties.zkConnect); props.put("group.id", KafkaProperties.groupId); props.put("zookeeper.session.timeout.ms", "40000"); props.put("zookeeper.sync.time.ms", "200"); props.put("auto.commit.interval.ms", "1000"); return new ConsumerConfig(props); } @Override public void run() { Map topicCountMap = new HashMap(); topicCountMap.put(topic, new Integer(1)); Map>> consumerMap = consumer.createMessageStreams(topicCountMap); KafkaStream stream = consumerMap.get(topic).get(0); ConsumerIterator it = stream.iterator(); while (it.hasNext()) { System.out.println("receive:" + new String(it.next().message())); try { sleep(3000); } catch (InterruptedException e) { e.printStackTrace(); } } } } 四、数据持久化 不要畏惧文件系统! Kafka大量依赖文件系统去存储和缓存消息。对于硬盘有个传统的观念是硬盘总是很慢,这使很多人怀疑基于文件系统的架构能否提供优异的性能。实际上硬盘的快慢完全取决于使用它的方式。设计良好的硬盘架构可以和内存一样快。 在6块7200转的SATA RAID-5磁盘阵列的线性写速度差不多是600MB/s,但是随即写的速度却是100k/s,差了差不多6000倍。现代的操作系统都对次做了大量的优化,使用了 read-ahead 和 write-behind的技巧,读取的时候成块的预读取数据,写的时候将各种微小琐碎的逻辑写入组织合并成一次较大的物理写入。对此的深入讨论可以查看这里,它们发现线性的访问磁盘,很多时候比随机的内存访问快得多。 为了提高性能,现代操作系统往往使用内存作为磁盘的缓存,现代操作系统乐于把所有空闲内存用作磁盘缓存,虽然这可能在缓存回收和重新分配时牺牲一些性能。所有的磁盘读写操作都会经过这个缓存,这不太可能被绕开除非直接使用I/O。所以虽然每个程序都在自己的线程里只缓存了一份数据,但在操作系统的缓存里还有一份,这等于存了两份数据。 另外再来讨论一下JVM,以下两个事实是众所周知的: •Java对象占用空间是非常大的,差不多是要存储的数据的两倍甚至更高。 •随着堆中数据量的增加,垃圾回收回变的越来越困难。 基于以上分析,如果把数据缓存在内存里,因为需要存储两份,不得不使用两倍的内存空间,Kafka基于JVM,又不得不将空间再次加倍,再加上要避免GC带来的性能影响,在一个32G内存的机器上,不得不使用到28-30G的内存空间。并且当系统重启的时候,又必须要将数据刷到内存中( 10GB 内存差不多要用10分钟),就算使用冷刷新(不是一次性刷进内存,而是在使用数据的时候没有就刷到内存)也会导致最初的时候新能非常慢。但是使用文件系统,即使系统重启了,也不需要刷新数据。使用文件系统也简化了维护数据一致性的逻辑。 所以与传统的将数据缓存在内存中然后刷到硬盘的设计不同,Kafka直接将数据写到了文件系统的日志中。 常量时间的操作效率 在大多数的消息系统中,数据持久化的机制往往是为每个cosumer提供一个B树或者其他的随机读写的数据结构。B树当然是很棒的,但是也带了一些代价:比如B树的复杂度是O(log N),O(log N)通常被认为就是常量复杂度了,但对于硬盘操作来说并非如此。磁盘进行一次搜索需要10ms,每个硬盘在同一时间只能进行一次搜索,这样并发处理就成了问题。虽然存储系统使用缓存进行了大量优化,但是对于树结构的性能的观察结果却表明,它的性能往往随着数据的增长而线性下降,数据增长一倍,速度就会降低一倍。 直观的讲,对于主要用于日志处理的消息系统,数据的持久化可以简单的通过将数据追加到文件中实现,读的时候从文件中读就好了。这样做的好处是读和写都是 O(1) 的,并且读操作不会阻塞写操作和其他操作。这样带来的性能优势是很明显的,因为性能和数据的大小没有关系了。 既然可以使用几乎没有容量限制(相对于内存来说)的硬盘空间建立消息系统,就可以在没有性能损失的情况下提供一些一般消息系统不具备的特性。比如,一般的消息系统都是在消息被消费后立即删除,Kafka却可以将消息保存一段时间(比如一星期),这给consumer提供了很好的机动性和灵活性,这点在今后的文章中会有详述。 五、消息传输的事务定义 之前讨论了consumer和producer是怎么工作的,现在来讨论一下数据传输方面。数据传输的事务定义通常有以下三种级别: 最多一次: 消息不会被重复发送,最多被传输一次,但也有可能一次不传输。 最少一次: 消息不会被漏发送,最少被传输一次,但也有可能被重复传输. 精确的一次(Exactly once): 不会漏传输也不会重复传输,每个消息都传输被一次而且仅仅被传输一次,这是大家所期望的。 大多数消息系统声称可以做到“精确的一次”,但是仔细阅读它们的的文档可以看到里面存在误导,比如没有说明当consumer或producer失败时怎么样,或者当有多个consumer并行时怎么样,或写入硬盘的数据丢失时又会怎么样。kafka的做法要更先进一些。当发布消息时,Kafka有一个“committed”的概念,一旦消息被提交了,只要消息被写入的分区的所在的副本broker是活动的,数据就不会丢失。关于副本的活动的概念,下节文档会讨论。现在假设broker是不会down的。 如果producer发布消息时发生了网络错误,但又不确定实在提交之前发生的还是提交之后发生的,这种情况虽然不常见,但是必须考虑进去,现在Kafka版本还没有解决这个问题,将来的版本正在努力尝试解决。 并不是所有的情况都需要“精确的一次”这样高的级别,Kafka允许producer灵活的指定级别。比如producer可以指定必须等待消息被提交的通知,或者完全的异步发送消息而不等待任何通知,或者仅仅等待leader声明它拿到了消息(followers没有必要)。 现在从consumer的方面考虑这个问题,所有的副本都有相同的日志文件和相同的offset,consumer维护自己消费的消息的offset,如果consumer不会崩溃当然可以在内存中保存这个值,当然谁也不能保证这点。如果consumer崩溃了,会有另外一个consumer接着消费消息,它需要从一个合适的offset继续处理。这种情况下可以有以下选择: consumer可以先读取消息,然后将offset写入日志文件中,然后再处理消息。这存在一种可能就是在存储offset后还没处理消息就crash了,新的consumer继续从这个offset处理,那么就会有些消息永远不会被处理,这就是上面说的“最多一次”。 consumer可以先读取消息,处理消息,最后记录offset,当然如果在记录offset之前就crash了,新的consumer会重复的消费一些消息,这就是上面说的“最少一次”。 “精确一次”可以通过将提交分为两个阶段来解决:保存了offset后提交一次,消息处理成功之后再提交一次。但是还有个更简单的做法:将消息的offset和消息被处理后的结果保存在一起。比如用Hadoop ETL处理消息时,将处理后的结果和offset同时保存在HDFS中,这样就能保证消息和offser同时被处理了。

优秀的个人博客,低调大师

guava快速入门(二)

Guava工程包含了若干被Google的 Java项目广泛依赖 的核心库,例如:集合 [collections] 、缓存 [caching] 、原生类型支持 [primitives support] 、并发库 [concurrency libraries] 、通用注解 [common annotations] 、字符串处理 [string processing] 、I/O 等等。 guava类似Apache Commons工具集 Collection 不可变集合 不可变对象有很多优点,包括: 当对象被不可信的库调用时,不可变形式是安全的; 不可变对象被多个线程调用时,不存在竞态条件问题 不可变集合不需要考虑变化,因此可以节省时间和空间。所有不可变的集合都比它们的可变形式有更好的内存利用率(分析和测试细节); 不可变对象因为有固定不变,可以作为常量来安全使用。 JDK也提供了Collections.unmodifiableXXX方法把集合包装为不可变形式,但: 笨重而且累赘:不能舒适地用在所有想做防御性拷贝的场景; 不安全:要保证没人通过原集合的引用进行修改,返回的集合才是事实上不可变的; 低效:包装过的集合仍然保有可变集合的开销,比如并发修改的检查、散列表的额外空间,等等。 创建不可变集合方法: copyOf方法,如ImmutableSet.copyOf(set); of方法,如ImmutableSet.of(“a”, “b”, “c”)或 ImmutableMap.of(“a”, 1, “b”, 2); Builder工具 import com.google.common.collect.ImmutableList; import com.google.common.collect.ImmutableSet; public class ImmutableDemo { public static void main(String[] args) { ImmutableSet<String> set = ImmutableSet.of("a", "b", "c", "d"); ImmutableSet<String> set1 = ImmutableSet.copyOf(set); ImmutableSet<String> set2 = ImmutableSet.<String> builder().addAll(set).add("e").build(); ImmutableList<String> list = set.asList(); System.out.println("set:"+set); System.out.println("set1:"+set1); System.out.println("set2:"+set2); //set.add("f");//java.lang.UnsupportedOperationException } } 返回: set:[a, b, c, d] set1:[a, b, c, d] set2:[a, b, c, d, e] 新型集合类 Multiset Multiset可统计一个词在文档中出现了多少次 import com.google.common.collect.LinkedHashMultiset; import com.google.common.collect.Multiset; public class MultiSetDemo { public static void main(String[] args) { Multiset<String> set = LinkedHashMultiset.create(); set.add("a"); set.add("a"); set.add("lucas"); set.add("lucas"); set.setCount("a", 5); // 添加或删除指定元素使其在集合中的数量是count System.out.println(set); System.out.println(set.count("a")); // 给定元素在Multiset中的计数 System.out.println(set.size()); // 所有元素计数的总和,包括重复元素 System.out.println(set.elementSet().size()); // 所有元素计数的总和,不包括重复元素 set.clear(); // 清空集合 System.out.println(set); } } 返回: [a x 5, lucas x 2] 5 7 2 [] Multimap Multimap可以很容易地把一个键映射到多个值。换句话说,Multimap是把键映射到任意多个值的一般方式。 import java.util.Collection; import java.util.Map; import com.google.common.collect.HashMultimap; import com.google.common.collect.Multimap; public class MultiMapDemo { public static void main(String[] args) { Multimap<String, Integer> map = HashMultimap.create(); // Multimap是把键映射到任意多个值的一般方式 map.put("a", 1); // key相同时不会覆盖原value map.put("a", 2); map.put("a", 3); map.put("b", 1); map.put("b", 2); System.out.println(map); // {a=[1, 2, 3]} System.out.println(map.get("a")); // 返回的是集合 System.out.println(map.size()); // 返回所有”键-单个值映射”的个数,而非不同键的个数 System.out.println(map.keySet().size()); // 返回不同key的个数 Map<String, Collection<Integer>> mapView = map.asMap(); System.out.println(mapView); } } 返回: {a=[1, 2, 3], b=[1, 2]} [1, 2, 3] 5 2 {a=[1, 2, 3], b=[1, 2]} BiMap BiMap import com.google.common.collect.BiMap; import com.google.common.collect.HashBiMap; public class BitMapDemo { public static void main(String[] args) { BiMap<String, String> biMap = HashBiMap.create(); biMap.put("sina", "sina.com"); biMap.put("qq", "qq.com"); biMap.put("sina", "sina.cn"); // 会覆盖原来的value /* * 在BiMap中,如果你想把键映射到已经存在的值,会抛出IllegalArgumentException异常 * 如果对特定值,你想要强制替换它的键,请使用 BiMap.forcePut(key, value) */ // 抛出异常java.lang.IllegalArgumentException: value already present: qq.com //biMap.put("tecent", "qq.com"); biMap.forcePut("tecent", "qq.com"); // 强制替换key System.out.println(biMap); System.out.println(biMap.inverse()); // 翻转value-key System.out.println(biMap.inverse().get("sina.cn")); // 通过value找key System.out.println(biMap.inverse().inverse() == biMap); // true } } 返回: {sina=sina.cn, tecent=qq.com} {sina.cn=sina, qq.com=tecent} sina true Table Table它有两个支持所有类型的键:”行”和”列”。 import java.util.Set; import com.google.common.collect.HashBasedTable; import com.google.common.collect.Table; public class TableDemo { public static void main(String[] args) { // 记录学生在某门课上的成绩 Table<String, String, Integer> table = HashBasedTable.create(); table.put("jack", "java", 100); table.put("jack", "c", 90); table.put("mike", "java", 93); table.put("mike", "c", 100); Set<Table.Cell<String, String, Integer>> cells = table.cellSet(); for (Table.Cell<String, String, Integer> cell : cells) { System.out.println(cell.getRowKey() + " " + cell.getColumnKey() + " " + cell.getValue()); } System.out.println("----------------------"); System.out.println(table.row("jack")); System.out.println(table); System.out.println(table.rowKeySet()); System.out.println(table.columnKeySet()); System.out.println(table.values()); } } 返回: mike java 93 mike c 100 jack java 100 jack c 90 ---------------------- {java=100, c=90} {mike={java=93, c=100}, jack={java=100, c=90}} [mike, jack] [java, c] [93, 100, 100, 90] Collections2 filter():只保留集合中满足特定要求的元素 import java.util.Collection; import java.util.List; import com.google.common.collect.Collections2; import com.google.common.collect.Lists; public class FilterDemo { public static void main(String[] args) { List<String> list = Lists.newArrayList("moon", "dad", "refer", "son"); Collection<String> palindromeList = Collections2.filter(list, input -> { return new StringBuilder(input).reverse().toString().equals(input); // 找回文串 }); System.out.println(palindromeList);//palindromeList 回文,也叫做镜文,正写倒写一样,如mam } } 返回: [dad, refer] transform():类型转换 import java.text.SimpleDateFormat; import java.util.Collection; import java.util.Set; import com.google.common.base.Function; import com.google.common.collect.Collections2; import com.google.common.collect.Sets; public class TransformDemo { public static void main(String[] args) { Set<Long> times = Sets.newHashSet(); times.add(91299990701L); times.add(9320001010L); times.add(9920170621L); Collection<String> timeStrCol = Collections2.transform(times, new Function<Long, String>() { @Override public String apply( Long input) { return new SimpleDateFormat("yyyy-MM-dd").format(input); } }); System.out.println(timeStrCol); } } 返回: [1970-04-19, 1970-04-26, 1972-11-23] 多个Function组合 import java.util.Collection; import java.util.List; import com.google.common.base.Function; import com.google.common.base.Functions; import com.google.common.collect.Collections2; import com.google.common.collect.Lists; public class TransformDemo2 { public static void main(String[] args) { List<String> list = Lists.newArrayList("abcde", "good", "happiness"); // 确保容器中的字符串长度不超过5 Function<String, String> f1 = new Function<String, String>() { @Override public String apply( String input) { return input.length() > 5 ? input.substring(0, 5) : input; } }; // 转成大写 Function<String, String> f2 = new Function<String, String>() { @Override public String apply( String input) { return input.toUpperCase(); } }; Function<String, String> function = Functions.compose(f1, f2); Collection<String> results = Collections2.transform(list, function); System.out.println(results); } } 返回: [ABCDE, GOOD, HAPPI] 集合操作:交集、差集、并集 import java.util.Set; import com.google.common.collect.Sets; public class CollectionsDemo { public static void main(String[] args) { Set<Integer> set1 = Sets.newHashSet(1, 2, 3, 4, 5); Set<Integer> set2 = Sets.newHashSet(3, 4, 5, 6); Sets.SetView<Integer> inter = Sets.intersection(set1, set2); // 交集 System.out.println(inter); Sets.SetView<Integer> diff = Sets.difference(set1, set2); // 差集,在A中不在B中 System.out.println(diff); Sets.SetView<Integer> union = Sets.union(set1, set2); // 并集 System.out.println(union); } } 返回: [3, 4, 5] [1, 2] [1, 2, 3, 4, 5, 6]

优秀的个人博客,低调大师

guava快速入门(三)

Guava工程包含了若干被Google的 Java项目广泛依赖 的核心库,例如:集合 [collections] 、缓存 [caching] 、原生类型支持 [primitives support] 、并发库 [concurrency libraries] 、通用注解 [common annotations] 、字符串处理 [string processing] 、I/O 等等。 guava类似Apache Commons工具集 Cache 缓存在很多场景下都是相当有用的。例如,计算或检索一个值的代价很高,并且对同样的输入需要不止一次获取值的时候,就应当考虑使用缓存。 Guava Cache与ConcurrentMap很相似,但也不完全一样。最基本的区别是ConcurrentMap会一直保存所有添加的元素,直到显式地移除。相对地,Guava Cache为了限制内存占用,通常都设定为自动回收元素。在某些场景下,尽管LoadingCache 不回收元素,它也是很有用的,因为它会自动加载缓存。 Guava Cache是一个全内存的本地缓存实现,它提供了线程安全的实现机制。 通常来说,Guava Cache适用于: 你愿意消耗一些内存空间来提升速度。 你预料到某些键会被查询一次以上。 缓存中存放的数据总量不会超出内存容量。(Guava Cache是单个应用运行时的本地缓存。它不把数据存放到文件或外部服务器。 如果这不符合你的需求,请尝试Memcached这类工具) Guava Cache有两种创建方式: cacheLoader callable callback LoadingCache是附带CacheLoader构建而成的缓存实现 import java.util.concurrent.ExecutionException; import java.util.concurrent.TimeUnit; import com.google.common.cache.CacheBuilder; import com.google.common.cache.CacheLoader; import com.google.common.cache.LoadingCache; public class LoadingCacheDemo { public static void main(String[] args) { LoadingCache<String, String> cache = CacheBuilder.newBuilder().maximumSize(100) // 最大缓存数目 .expireAfterAccess(2, TimeUnit.SECONDS) // 缓存1秒后过期 .build(new CacheLoader<String, String>() { @Override public String load(String key) throws Exception { return key; } }); cache.put("j", "java"); cache.put("c", "cpp"); cache.put("s", "scala"); cache.put("g", "go"); try { System.out.println(cache.get("j")); TimeUnit.SECONDS.sleep(1); System.out.println(cache.get("s")); // 1秒后 输出scala TimeUnit.SECONDS.sleep(2); System.out.println(cache.get("s")); // 2秒后 输出s } catch (ExecutionException | InterruptedException e) { e.printStackTrace(); } } } 返回: java scala s 回调: import java.util.concurrent.ExecutionException; import java.util.concurrent.TimeUnit; import com.google.common.cache.Cache; import com.google.common.cache.CacheBuilder; public class CallbackDemo { public static void main(String[] args) { Cache<String, String> cache = CacheBuilder.newBuilder().maximumSize(100) .expireAfterAccess(1, TimeUnit.SECONDS) .build(); try { String result = cache.get("java", () -> "hello java"); System.out.println(result); } catch (ExecutionException e) { e.printStackTrace(); } } } refresh机制:- LoadingCache.refresh(K) 在生成新的value的时候,旧的value依然会被使用。- CacheLoader.reload(K, V) 生成新的value过程中允许使用旧的value- CacheBuilder.refreshAfterWrite(long, TimeUnit) 自动刷新cache 并发 ListenableFuture 传统JDK中的Future通过异步的方式计算返回结果:在多线程运算中可能或者可能在没有结束返回结果,Future是运行中的多线程的一个引用句柄,确保在服务执行返回一个Result。 ListenableFuture可以允许你注册回调方法(callbacks),在运算(多线程执行)完成的时候进行调用, 或者在运算(多线程执行)完成后立即执行。这样简单的改进,使得可以明显的支持更多的操作,这样的功能在JDK concurrent中的Future是不支持的。 import java.util.concurrent.ExecutionException; import java.util.concurrent.Executors; import com.google.common.util.concurrent.FutureCallback; import com.google.common.util.concurrent.Futures; import com.google.common.util.concurrent.ListenableFuture; import com.google.common.util.concurrent.ListeningExecutorService; import com.google.common.util.concurrent.MoreExecutors; public class ListenableFutureDemo { public static void main(String[] args) { // 将ExecutorService装饰成ListeningExecutorService ListeningExecutorService service = MoreExecutors. listeningDecorator(Executors.newCachedThreadPool()); // 通过异步的方式计算返回结果 ListenableFuture<String> future = service.submit(() -> { System.out.println("call execute.."); return "task success!"; }); // 有两种方法可以执行此Future并执行Future完成之后的回调函数 future.addListener(() -> { // 该方法会在多线程运算完的时候,指定的Runnable参数传入的对象会被指定的Executor执行 try { System.out.println("result: " + future.get()); } catch (InterruptedException | ExecutionException e) { e.printStackTrace(); } }, service); Futures.addCallback(future, new FutureCallback<String>() { @Override public void onSuccess( String result) { System.out.println("callback result: " + result); } @Override public void onFailure(Throwable t) { System.out.println(t.getMessage()); } }, service); } } 返回: call execute.. result: task success! callback result: task success! IO import java.io.File; import java.io.IOException; import java.util.List; import com.google.common.base.Charsets; import com.google.common.collect.ImmutableList; import com.google.common.io.Files; public class FileDemo { public static void main(String[] args) { File file = new File(System.getProperty("user.dir")); System.out.println(file.getName()); System.out.println(file.getPath()); } // 写文件 private void writeFile(String content, File file) throws IOException { if (!file.exists()) { file.createNewFile(); } Files.write(content.getBytes(Charsets.UTF_8), file); } // 读文件 private List<String> readFile(File file) throws IOException { if (!file.exists()) { return ImmutableList.of(); // 避免返回null } return Files.readLines(file, Charsets.UTF_8); } // 文件复制 private void copyFile(File from, File to) throws IOException { if (!from.exists()) { return; } if (!to.exists()) { to.createNewFile(); } Files.copy(from, to); } } 返回: collection-others D:\GITHUB\java\code\test01\collection-others 参考:Google Guava官方教程(中文版)guava-importnew

优秀的个人博客,低调大师

大话RabbitMQ 基础入门

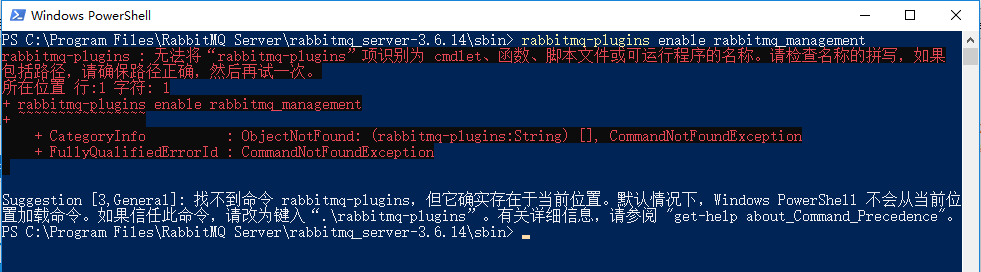
----------写在前面---------- 近些年微服务越来越火,让我也忍不住想去一窥微服务究竟,讲到微服务,就离不开分布式,而分布式,也离不开消息队列,在消息队列中,RabbitMQ可以说是比较具有代表性的一款。 这里是一篇介绍消息队列以及各种消息队列产品对比的文章,讲得很好,有兴趣的可以看一看。 https://cloud.tencent.com/developer/article/1006035 在讲RabbitMQ之前,首先需要在电脑上安装和配置RabbitMQ,网络上已经有很多这类文章,如果懒得去搜索,可以看看这篇介绍如何安装配置RabbitMQ的文章。 https://blog.csdn.net/weixin_39735923/article/details/79288578 其中,在安装RabbitMQ的过程中,遇到了一个坑,在启用RabbltMQ的管理界面执行 rabbitmq-plugins enable rabbitmq_management 命令时,出现了以下这样的报错 可以在该指令前加上 .\ 即 .\rabbitmq-plugins enable rabbitmq_management 祝安装顺利 !! -------正文------ 基本概念 下面是在.Net中使用RabbitMQ要明白的一些名词概念。 综上所诉,他们之间的关系可以用我下面的 丑图 表示。 在图中,没有吧Routing key画出。Producer每一次发送消息,除了发出消息本身,还会随着消息带上一个routingKey,而且每一次将Exchange和Queue绑定,大体需要三个参数, string queueName, string exchangeName, string routingKey 其中也有一个routingKey,但此RoutingKey非彼Routingkey。 大白话 对这个过程,我们可以理解为国家给灾区发送救灾物资,国家给当地政府划拨物资的时候,会规定,谁才能拿到这批物资,如(房子倒了的.家里有人受伤了的.家庭经济困难的)。 而当地政府在分配这批物资之前,为了方便物资的分配,会给每个家庭贴上一个标签,如 家庭A 经济困难 家庭B 房子倒了.经济困难 家庭C 家庭富有.房子倒了 家庭D 房子倒了的.家里有人受伤了的.家庭经济困难的 所以,发送消息时候的routingKey就是国家规定的那批物质分配规则。 而Exchange和Queue绑定时的RoutingKey可以理解为当地政府给每个家庭贴上的一个标签。 Exchange(交换机)转发消息的规则也有很多种:direct, topic, headers(不常用) 和 fanout,我们称之为交换类型。 我们可以把Exchange理解为分配这批物质的政府,现在国家规定了宏观的分配方向(发送消息时的routingKey),每个家庭也有了家庭情况的标签(绑定Exchange时的routingKey),但是这个物资具体怎么分,还是当地政府说了算。 Direct 严格按照国家规定来,只有房子倒了的,家里有人受伤了的而且家庭经济困难的才能分到救灾物资。 家庭D能分到 Fanout 只要是灾区的居民都能分到, 不管家庭情况如何。 家庭A\B\C\D都能分到 Topic 主题匹配: 只要家庭情况在国家规定分配规则内的,都能分到物资,但是家庭C分不到,因为他家太有钱了,这个条件不在国家的分配规则里。家庭A\B\D能分到 所以,我们在声明一个Exchange(交换机)的同时,还要指定该交换机的类型,即(当地政府怎么来分救灾物资) 其实,用这个例子,我是想说,生产者和消费者之间,就像国家与难民之间一样,国家只知道,我要帮助难民,但是难民有谁,物资能不能分到难民手里,还得当地政府说了算,你就说我这个例子恰不恰当吧!哈哈 好了,懂了概念,我们再来结合具体例子看看。 Fanout Producer.cs的代码 using System; using System.Text; using RabbitMQ.Client; namespace _2_Publish { class Program { static void Main(string[] args) { //创建连接工厂 var factory = new ConnectionFactory() { HostName = "localhost" }; //创建连接 using (var connection = factory.CreateConnection()) { //创建会话 using (var chancel = connection.CreateModel()) { //生命交换机 chancel.ExchangeDeclare(exchange: "FanoutDemo", type: ExchangeType.Fanout); string readMsg = "helloWorld"; while (readMsg.ToLower() != "exit") { var body = Encoding.UTF8.GetBytes(readMsg); //给交换机发送消息 chancel.BasicPublish(exchange: "FanoutDemo", routingKey: "", body: body); Console.WriteLine($"成功发送消息{readMsg}"); Console.WriteLine("请输入要发送的内容!"); readMsg = Console.ReadLine(); } } } } } } Customer.cs代码 using System; using System.Text; using RabbitMQ.Client; using RabbitMQ.Client.Events; namespace _2_Receiver { class Program { static void Main(string[] args) { //创建连接工厂 var factory = new ConnectionFactory() { HostName = "localhost" }; //创建连接 using (var connection = factory.CreateConnection()) { //创建会话 using (var channel = connection.CreateModel()) { //声明一个Fanout类型的交换机 channel.ExchangeDeclare(exchange: "FanoutDemo", type: ExchangeType.Fanout); //声明一个消息队列并获取它的名字 var queueName = channel.QueueDeclare().QueueName; //把消息队列和交换机绑定 channel.QueueBind(exchange: "FanoutDemo", queue: queueName, routingKey: ""); //创建消费者 var consume = new EventingBasicConsumer(channel); //把消费者和队列绑定 channel.BasicConsume(queue: queueName, autoAck: true,consumer: consume); consume.Received += (model, ea) => { var body = ea.Body; var message = Encoding.UTF8.GetString(body); Console.WriteLine($"收到消息{message}"); }; Console.ReadLine(); } } } } } 在上面的代码中,无论是在生产者的发送消息里 //给交换机发送消息 chancel.BasicPublish(exchange: "FanoutDemo", routingKey: "", body: body); 还是消费者所在的Queue的绑定里 //把消息队列和交换机绑定 channel.QueueBind(exchange: "FanoutDemo", queue: queueName, routingKey: ""); 我们都没有制定routingKey,因为没个人都能获取消息,所以此处,声明routingKey就没有意义了。 我们看看运行效果。 运行了三个消费者,当生产者发出消息时,三个消费者都收到了相同的消息。可以理解为广播模式。(Customer单词拼写错了,图片修改不方便,就不改了,大家将就一下) Direct Direct时严格匹配的,只有队列绑定的RoutingKey与生产者发送消息时指定的RoutingKey完全相同,才能接收成功。 Producer.cs using System; using System.Text; using RabbitMQ.Client; namespace _2_Publish { class Program { static void Main(string[] args) { //创建连接工厂 var factory = new ConnectionFactory() { HostName = "localhost" }; //创建连接 using (var connection = factory.CreateConnection()) { //创建会话 using (var chancel = connection.CreateModel()) { //生命交换机 chancel.ExchangeDeclare(exchange: "DirectDemo", type: ExchangeType.Direct); string readMsg = "helloWorld"; while (readMsg.ToLower() != "exit") { var body = Encoding.UTF8.GetBytes(readMsg); //给交换机发送消息 chancel.BasicPublish(exchange: "DirectDemo", routingKey: "Direct.Key", body: body); Console.WriteLine($"成功发送消息{readMsg}"); Console.WriteLine("请输入要发送的内容!"); readMsg = Console.ReadLine(); } } } } } } 我把Exchange的类型更改为Direct类型,并且发送消息的routingKey设置为Direct.Key。 然后我们来定义消费者 Customer.CS using System; using System.Text; using RabbitMQ.Client; using RabbitMQ.Client.Events; namespace _2_Receiver { class Program { static void Main(string[] args) { //创建连接工厂 var factory = new ConnectionFactory() { HostName = "localhost" }; //创建连接 using (var connection = factory.CreateConnection()) { //创建会话 using (var channel = connection.CreateModel()) { //声明一个Fanout类型的交换机 channel.ExchangeDeclare(exchange: "DirectDemo", type: ExchangeType.Direct); //声明一个消息队列并获取它的名字 var queueName = channel.QueueDeclare().QueueName; Console.WriteLine("请输入RoutingKey!"); var routingKey = Console.ReadLine(); //把消息队列和交换机绑定 channel.QueueBind(exchange: "DirectDemo", queue: queueName, routingKey: routingKey); //创建消费者 var consume = new EventingBasicConsumer(channel); //把消费者和队列绑定 channel.BasicConsume(queue: queueName, autoAck: true,consumer: consume); Console.WriteLine("开始监听消息"); consume.Received += (model, ea) => { var body = ea.Body; var message = Encoding.UTF8.GetString(body); Console.WriteLine($"收到消息{message}"); }; Console.ReadLine(); } } } } } 消费者的RoutingKey再控制台输入, 运行效果如下: 可以看到,只有RoutingKey为Direct.Key的消费者才收到了生产者发出的消息。 Topic RabbitMQ 中的 RouteKey 支持绑定键表达式写法,有两种主要的绑定键: *(星号)可以代替一个单词. # (井号) 可以代替0个或多个单词. 比如在下面这个图中(P为发送者,X为RabbitMQ中的Exchange,C为消费者,Q为队列) 在这个示例中,我们将发送一条关于动物描述的消息,也就是说 Name(routeKey) 字段中的内容包含 3 个单词。第一个单词是描述速度的(celerity),第二个单词是描述颜色的(colour),第三个是描述哪种动物的(species),它们组合起来类似:“..”。 然后在使用CapSubscribe绑定的时候,Q1绑定为CapSubscribe["*.orange.*"], Q2 绑定为CapSubscribe["*.*.rabbit"]和[CapSubscribe["lazy.#]。 那么,当发送一个名为 "quick.orange.rabbit" 消息的时候,这两个队列将会同时收到该消息。同样名为lazy.orange.elephant的消息也会被同时收到。另外,名为 "quick.orange.fox" 的消息将仅会被发送到Q1队列,名为 "lazy.brown.fox" 的消息仅会被发送到Q2。"lazy.pink.rabbit" 仅会被发送到Q2一次,即使它被绑定了2次。"quick.brown.fox" 没有匹配到任何绑定的队列,所以它将会被丢弃。 另外一种情况,如果你违反约定,比如使用 4个单词进行组合,例如 "quick.orange.male.rabbit",那么它将匹配不到任何的队列,消息将会被丢弃。 但是,假如你的消息名为 "lazy.orange.male.rabbit",那么他们将会被发送到Q2,因为 #(井号)可以匹配 0 或者多个单词。 我们结合代码来看一看。 Producer.cs using System; using System.Text; using RabbitMQ.Client; namespace _2_Publish { class Program { static void Main(string[] args) { //创建连接工厂 var factory = new ConnectionFactory() { HostName = "localhost" }; //创建连接 using (var connection = factory.CreateConnection()) { //创建会话 using (var chancel = connection.CreateModel()) { //生命交换机 chancel.ExchangeDeclare(exchange: "TopicDemo", type: ExchangeType.Topic); string readMsg = "helloWorld"; while (readMsg.ToLower() != "exit") { var body = Encoding.UTF8.GetBytes(readMsg); //给交换机发送消息 chancel.BasicPublish(exchange: "TopicDemo", routingKey: "Topic.Demo.Key", body: body); Console.WriteLine($"成功发送消息{readMsg}"); Console.WriteLine("请输入要发送的内容!"); readMsg = Console.ReadLine(); } } } } } } 我给发送消息的routingKey指定为Topic.Demo.Key 再来看看消费者 Cuustomer.cs using System; using System.Text; using RabbitMQ.Client; using RabbitMQ.Client.Events; namespace _2_Receiver { class Program { static void Main(string[] args) { //创建连接工厂 var factory = new ConnectionFactory() { HostName = "localhost" }; //创建连接 using (var connection = factory.CreateConnection()) { //创建会话 using (var channel = connection.CreateModel()) { //声明一个Fanout类型的交换机 channel.ExchangeDeclare(exchange: "TopicDemo", type: ExchangeType.Topic); //声明一个消息队列并获取它的名字 var queueName = channel.QueueDeclare().QueueName; Console.WriteLine("请输入RoutingKey!"); var routingKey = Console.ReadLine(); //把消息队列和交换机绑定 channel.QueueBind(exchange: "TopicDemo", queue: queueName, routingKey: routingKey); //创建消费者 var consume = new EventingBasicConsumer(channel); //把消费者和队列绑定 channel.BasicConsume(queue: queueName, autoAck: true,consumer: consume); Console.WriteLine("开始监听消息"); consume.Received += (model, ea) => { var body = ea.Body; var message = Encoding.UTF8.GetString(body); Console.WriteLine($"收到消息{message}"); }; Console.ReadLine(); } } } } } 其RoutingKey也是在外部输入。 我们看看运行效果 因为Producer发布消息的RoutingKey是Topic.Demo.Key 又因为#可以代表0个或者多个单词 ,*能代表一个单词 所以*.*.Key Topic.#与Topic.Demo.Key匹配,而其他两个*.Key和test.1.2当然是不匹配的,所以没有收到消息。 总结 对于上面的例子,我们可以总结出,编写一个生产者的过程如下: 创建连接工厂-》创建连接-》创建会话(Chanel)-》创建交换机(Exchange)-》发送消息 编写一个生产者的过程如下: 创建连接工厂-》创建连接-》创建会话(Chanel)-》创建交换机(Exchange)-》创建队列-》绑定队列和交换机-》创建消费者-》把消费者和队列绑定-》监听消息 掌握这个大的方向,不管交换机怎么分配,代码应该都会写了。 为什么在生产者中和消费者中都要创建交换机呢? 因为我们不确定是生产者先执行还是消费者先执行,所以提前创建一下,避免连接时发现没有创建交换机,出现错误,如果交换机已经创建了,那么默认不会再次创建的。 另外,交换机创建后,同一名称的交换机使用完不会自动删除,但是第二次如果创建的名称和上次一样,但是交换机类型不一样了,那么便会出现报错。 这里总结的是一些RabbitMQ的基础知识,后面还会继续写一些更深入的使用技巧,如果不想错过精彩信息,点击关注一下吧(๑¯◡¯๑)!

优秀的个人博客,低调大师

MaxCompute Studio 使用入门

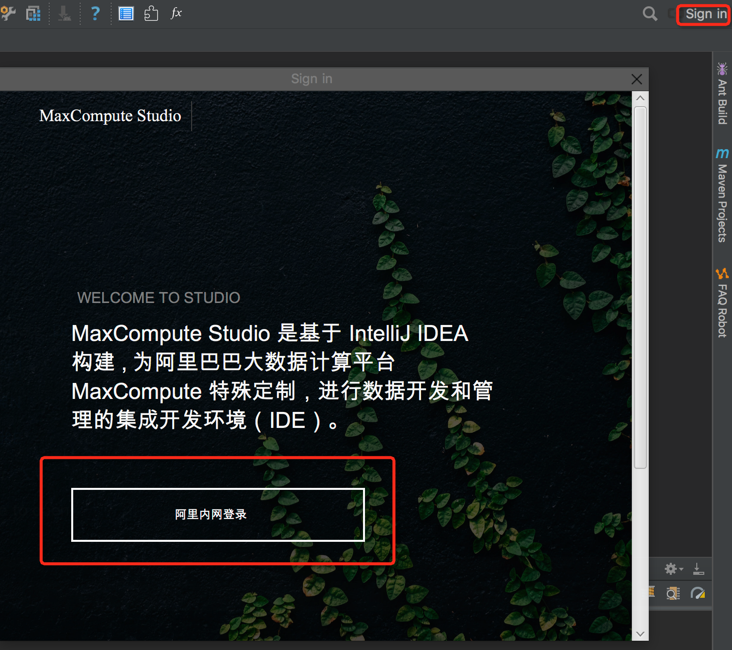
MaxCompute Studio 是MaxCompute 平台提供的安装在开发者客户端的大数据集成开发环境工具,是一套基于流行的集成开发平台IntelliJ IDEA的开发插件,可以帮助您方便地进行数据开发。下面我们一起来看一看Studio的简单用法。 用户登录 Studio提供用户登录功能。常规登录入口在Intellij toolbar中右上角的Sign In。登录完成后可直接使用答疑机器人、添加D2项目、同步D2等功能。 答疑机器人 点击右侧“FAQ Robot”按钮,进入答疑机器人页面,如下图所示。答疑机器人支持自助答疑和人工答疑两种方式,支持图片和文件上传,如果对自助答疑的结果不满意,可以在聊天框发送“人工”呼叫ODPS值班同学。或者直接发送图片或文件唤起人工服务。 资源管理 Studio 的一大核心功能就是浏览 MaxCompute 项目空间(Project)的资源,包括Table、UDF、Resource等。为了能够在 Studio 中访问它们,以及其它很多功能,我们首先需要在新建项目连接。在Project Explorer中点击"+"添加连接,目前Studio支持同步D2项目和通过accessId/Key添加项目连接。 建立项目空间连接后,可以浏览Table&View、Function、Resource等项目资源,双击对应的元素可以在Intellij中查看资源详情。 Table 双击打开某个table,如下图所示。有两个tab页面,“表信息”页面如下如所示,该页面展示table的基本信息、schema信息,提供数据预览功能。 选择对应的分区,设置预览行数,点击“预览”按钮可以进行数据预览。同时,右键点击表头支持数据导入/导出功能。 “分区信息”页面如下所示,显示分区的详细信息,提供分区的查询、刷新功能。同时提供导出分区信息、分区数据导入导出等功能。 在project explorer中右键点击某张表,可以看到建表、改表、数据操作等一系列比较实用的功能。 在Studio中不光可以通过写SQL进行DDL相关的操作,也可以通过可视化界面创建和修改table:Project Explorer中右键点击项目名称或者“Table & Views”选择“Create a new table”进行建表操作。 右键点击某个table选择“open table editor”可以对表信息进行相应修改,如下图所示,Studio可以将用户操作转化为对应的SQL语句。 Functions Functions分为BuiltIn Function和UserDefied Function, 双击对应的function可以展开详情: 可以通过如下途径添加Function: Resources 双击对应的resource,可以在editor中打开文件。对于UDF文件数大于5的情况,只打开前5个class。 可以通过如下途径添加resource: SQL编辑器与作业提交 如何帮助用户高效愉快的编写SQL是MaxCompute studio的核心使命,下面就让我们来一起看一下SQL编辑器的使用。首先需要创建一个MaxCompute Script Module,如下图所示: Module创建完成后,新建SQL脚本文件如下图所示。 最后双击SQL文件就可以进行我们的脚本开发了,这里可以自己设置模式(单句模式|脚本模式)、系统类型(旧有系统类型|MaxCompute系统|Hive系统)、编译器类型(默认编译器|实验性编译器)等。右上角需要选择对应的project。 下图所示三个按钮分别表示将SQL同步到D2,在Cosonle中打开ODPS CMD,打开SQL History。 SQL编辑完成后,点击下方的graph tab按钮,可以显示该SQL的执行计划,双击Task节点会展开对应的Operator级别的信息。 点击绿色的提交按钮,Studio会先编译脚本,编译通过后提交Server后显示运行信息并打开Job分析页面,如下图所示: 作业详情 上面我们说到了如何编辑SQL和提交作业,接下来一起看看如何查看作业详情。作业详情页可以通过多条路径打开,比如上面说到的提交作业,会自动打开作业详情页。其次通过Job Explorer也可以打开作业详情页,再有就是如果已经知道logview,可以通过logview打开作业详情页,如下图所示: 作业详情页面分为两部分,左侧是作业的一些基本信息,右侧包含多个tab页,包含graph信息、时序图、详情、脚本、摘要、结果、分析等内容。下面对graph图、时序图、详情页和作业分析进行进一步介绍。 graph页面 graph页面展示作业的Job|Task|Operator三层结构。点击左上角的导航可切换不同level的视图,双击Job节点进入Task视图,双击Task节点进入Operator视图。 graph页面用户可以通过鼠标滚轮或者左侧缩放按钮对图像进行缩放,同时提供鹰眼和拖拽等功能。点击task节点显示task级别信息,点击task之间连线显示schema信息。 在task level视图中右键点击节点,选择"expand all"展开所有的operator。 同时,单击table节点会显示table的基本信息和分区信息,双击table节点会跳转到对应的table详情页。 时序图 时序图画的是所有Fuxi Instance的甘特图,通过时序图可以对作业的运行时间等进行详细的分析,左侧的Filter可以对instances进行过滤,鼠标悬停到对应的instance上会显示对应的信息,双击则会跳转到"详情”tab页并选中对应的instance,对用户分析十分方便。同时时序图支持缩放功能。 详情页 详情页展示的是Task级别和Instance级别的详细信息。 作业分析页面 作业分析页面提供作业分析的结论,比如长尾节点、数据倾斜等。并提供散点图、长尾图和数据倾斜图供用户分析。 作业队列 Maxcompute 作业从提交到开始执行之前,需要经历很多状态,如:执行编译、优化、排队等待资源等。作业队列提供了查看当前详细状态的功能。对于正在排队等待调度的作业,可也从队列窗口中查看排队位置和前序作业等信息。点击"Job Explorer"打开作业队列页面,该页面提供了项目名称、状态、日期等Filter,选择对应的条件后会得到对应的作业队列,双击某一个作业会打开对应的作业详情页面。

优秀的个人博客,低调大师

Python入门篇

1.1 Python介绍 1.1.1 Python简介 Python,是一种广泛使用的高级编程语言,属于通用型编程语言,由吉多·范罗苏姆(中文名字:龟叔)创造,第一版发布于 1991 年。可以视之为一种改良 (加入一些其他编程语言的优点,如面向对象) 的 LISP。 作为一种解释型语言,Python 的设计哲学强调代码的可读性和简洁的语法(尤其是使用空格缩进划分代码块,而非使用大括号或者关键词)。 数据来源:https://www.tiobe.com/tiobe-index/ 由上图可见,Python整体呈上升趋势,反映出Python应用越来越广泛并且也逐渐得到业内的认可。相比于 C++ 或 Java,Python 让开发者能够用更少的代码表达想法。不管是小型还是大型程序,该语言都试图让程序的结构清晰明了。 1.1.2 Python设计哲学与定位 Python的设计哲学是“优雅”、“明确”、“简单”。 Python开发者的哲学是“用一种方法,最好是只有一种方法来做一件事”,也因此它和拥有明显个人风格的其他语言很不一样。在设计Python语言时,如果面临多种选择,Python开发者一般会拒绝花俏的语法,而选择明确没有或者很少有歧义的语法。 这些准则被称为“Python格言”。在Python解释器内运行import this可以获得完整的列表。 >>> import this The Zen of Python, by Tim Peters Beautiful is better than ugly. Explicit is better than implicit. Simple is better than complex. Complex is better than complicated. Flat is better than nested. Sparse is better than dense. Readability counts. Special cases aren't special enough to break the rules. Although practicality beats purity. Errors should never pass silently. Unless explicitly silenced. In the face of ambiguity, refuse the temptation to guess. There should be one-- and preferably only one --obvious way to do it. Although that way may not be obvious at first unless you're Dutch. Now is better than never. Although never is often better than *right* now. If the implementation is hard to explain, it's a bad idea. If the implementation is easy to explain, it may be a good idea. Namespaces are one honking great idea -- let's do more of those! 1.1.3 Python应用范围 Web程序: Python经常被用于Web开发。比如,通过mod_wsgi模块,Apache可以运行用Python编写的Web程序。使用Python语言编写的Gunicorn作为Web服务器,也能够运行Python语言编写的Web程序。 Python定义了WSGI标准应用接口来协调Http服务器与基于Python的Web程序之间的沟通。一些Web框架,如Django、Pyramid、TurboGears、Tornado、web2py、Zope、Flask等,可以让程序员轻松地开发和管理复杂的Web程序。 GUI开发: Python本身包含的Tkinter库能够支持简单的GUI开发。但是越来越多的Python程序员选择wxPython或者PyQt等GUI包来开发跨平台的桌面软件。使用它们开发的桌面软件运行速度快,与用户的桌面环境相契合。通过PyInstaller还能将程序发布为独立的安装程序包。 其他: YouTube、Google、Yahoo!、NASA都在内部大量地使用Python。OLPC的作业系统Sugar项目的大多数软件都是使用Python编写。 1.1.4 Python的种类 1、CPython Python的官方版本,使用C语言实现,使用最为广泛,CPython实现会将源文件(py文件)转换成字节码文件(pyc文件),然后运行在Python虚拟机上。 1、 Jython Python的Java实现,Jython会将Python代码动态编译成Java字节码,然后在JVM上运行。 3、IronPython Python的C#实现,IronPython将Python代码编译成C#字节码,然后在CLR上运行(与Jypthon类似)。 4、PyPy(特殊) Python实现的Python,将Python的字节码字节再编译成机器码。 5、RubyPython,Brython .... 注意:本文中都的为Python 3.6.2版本:https://www.python.org/downloads/release/python-362/ 关于Python环境部署可以参考:http://www.runoob.com/python/python-install.html 1.2 Python的语法 Python的设计目标之一是让代码具备高度的可阅读性。它设计时尽量使用其它语言经常使用的标点符号和英文单字,让代码看起来整洁美观。因为Python是动态语言,它不像其他的静态语言如C、Pascal那样需要书写声明语句。 1.2.1 缩进语法 Python开发者有意让违反了缩进规则的程序不能通过解释,以此来强迫程序员养成良好的编程习惯,也方便所有人查找和阅读。例如: if age < 21: print("你不能买酒。") print("不过你能买口香糖。") print("这句话处于if语句的外面。") 如果想要类似于执行shell脚本一样执行python脚本,例: ./clsn.py ,那么就需要在 clsn.py文件的头部指定解释器,如下: #!/usr/bin/env python # -*- coding: utf-8 -*- if age < 21: print("你不能买酒。") print("不过你能买口香糖。") print("这句话处于if语句的外面。") 注:上述例子为Python 3.0以上版本的代码。 1.2.2 变量说明 变量定义的规则: 1、变量名只能是 字母、数字或下划线的任意组合 2、变量名的第一个字符不能是数字 3、以下关键字不能声明为变量名 ['and', 'as', 'assert', 'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except', 'exec', 'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is', 'lambda', 'not', 'or', 'pass', 'print', 'raise', 'return', 'try', 'while', 'with', 'yield'] 4、变量的定义要具有可描述性。 1.2.3 语句和控制流 语句类型 说明 if语句 当条件成立时运行语句块。经常与else, elif(相当于else if)配合使用。 for语句 遍列列表、字符串、字典、集合等迭代器,依次处理迭代器中的每个元素。 while语句 当条件为真时,循环运行语句块。 try语句 与except, finally, else配合使用处理在程序运行中出现的异常情况。 class语句 用于定义类型。 def语句 用于定义函数和类型的方法。 pass语句 表示此行为空,不运行任何操作。 assert语句 用于程序调适阶段时测试运行条件是否满足。 with语句 Python2.6以后定义的语法,在一个场景中运行语句块。比如,运行语句块前加锁,然后在语句块运行结束后释放锁。 yield语句 在迭代器函数内使用,用于返回一个元素。自从Python 2.5版本以后。这个语句变成一个运算符。 raise语句 抛出一个异常。 import语句 导入一个模块或包。常用写法:from module import name, import module as name, from module import name as anothername 1.2.4 程序交互 input进行交互 #!/usr/bin/env python # -*- coding: utf-8 -*- # 将用户输入的内容赋值给 name 变量 name = input("请输入用户名:") # 打印输入的内容 print(name) 可以让用户输入多个信息,如下 #!/usr/bin/env python # -*- coding: utf-8 -*- name = input("What is your name?") age = input("How old are you?") hometown = input("Where is your hometown?") print("Hello ",name , "your are ", age , "years old, you came from",hometown) 1.2.5 数据类型与动态类型 Python内置多种数据类型。下面这个列表简要地描述了Python内置数据类型(适用于Python 3.x): 类型 描述 例子 str 一个由字符组成的不可更改的有序列。在Python 3.x里,字符串由Unicode字符组成。 'Wikipedia' "Wikipedia" """Spanning multiple lines""" bytes 一个由字节组成的不可更改的有序列。 b'Some ASCII' b"Some ASCII" list 可以包含多种类型的可改变的有序列 [4.0, 'string', True] tuple 可以包含多种类型的不可改变的有序列 (4.0, 'string', True) set, frozenset 与数学中集合的概念类似。无序的、每个元素唯一。 {4.0, 'string', True} frozenset([4.0, 'string', True]) dict或map 一个可改变的由键值对组成的无序列。 {'key1': 1.0, 3: False} int 精度不限的整数 42 float 浮点数。精度与系统相关。 3.1415927 complex 复数 3+2.7j bool 逻辑值。只有两个值:真、假 True False 除了各种数据类型,Python语言还用类型来表示函数、模块、类型本身、对象的方法、编译后的Python代码、运行时信息等等。因此,Python具备很强的动态性。 1.2.6 运算符 计算机可以进行的运算有很多种,可不只加减乘除这么简单,运算按种类可分为算数运算、比较运算、逻辑运算、赋值运算、成员运算、身份运算、位运算,今天我们暂只学习算数运算、比较运算、逻辑运算、赋值运算 算数运算 以下假设变量:a=10,b=20 比较运算 以下假设变量:a=10,b=20 赋值运算 以下假设变量:a=10,b=20 逻辑运算 关于逻辑运算 在没有()的情况下not 优先级高于 and,and优先级高于or,即优先级关系为( )>not>and>or,同一优先级从左往右计算。 in,not in : 判断子元素是否在原字符串(字典,列表,集合)中: 例如: #print('喜欢' in 'dkfljadklf喜欢hfjdkas') #print('a' in 'bcvd') #print('y' not in 'ofkjdslaf') 常见的占位符有: 1.3 流程控制语句 1.3.1 流程控制之--if 假如把写程序比做走路,那我们到现在为止,一直走的都是直路,还没遇到过分叉口,想象现实中,你遇到了分叉口,然后你决定往哪拐必然是有所动机的。你要判断那条岔路是你真正要走的路,很简单,只需要在程序里预设一些条件判断语句,满足哪个条件,就走哪条岔路。这个过程就叫流程控制。 单分支 if 条件: 满足条件后要执行的代码 双分支 """ if 条件: 满足条件执行代码 else: if条件不满足就走这段 """ MemInfo = 48 if MemInfo > 95 : print("内存即将用光") else: print("没事,放心用!") 多分支 if 条件: 满足条件执行代码 elif 条件: 上面的条件不满足就走这个 elif 条件: 上面的条件不满足就走这个 elif 条件: 上面的条件不满足就走这个 else: 上面所有的条件不满足就走这段 示例:猜猜我的年龄 age_of_clsn = 24 guess = int(input(">>:")) if guess > age_of_clsn : print("猜的太大了,往小里试试...") elif guess < age_of_clsn : print("猜的太小了,往大里试试...") else: print("恭喜你,猜对了...") 1.3.2 流程控制之--while循环 基本while循环 while 条件: # 循环体 # 如果条件为真,那么循环体则执行 # 如果条件为假,那么循环体不执行 循环中止语句 如果在循环的过程中,因为某些原因,你不想继续循环了,怎么把它中止掉呢?这就用到break 或 continue 语句 break用于完全结束一个循环,跳出循环体执行循环后面的语句 continue和break有点类似,区别在于continue只是终止本次循环,接着还执行后面的循环,break则完全终止循环。 示例: 之前猜年龄的代码运行一次使用一次,但稍加修改就能一自运行。 age_of_clsn = 24 while True: guess = int(input(">>:")) if guess > age_of_clsn: print("猜的太大了,往小里试试...") elif guess < age_of_clsn: print("猜的太小了,往大里试试...") else: print("恭喜你,猜对了...") break 1.3.3 格式化输出 现有一练习需求,问用户的姓名、年龄、工作、爱好 ,然后打印成以下格式 ------------ info of Alex Li ----------- Name : CLSN Age : 24 job : Linux Ops Hobbie: girl ------------- end ----------------- 这样的格式如何输出呢? name = input("Name:") age = input("Age:") job = input("Job:") hobbie = input("Hobbie:") info = ''' ------------ info of %s ----------- #这里的每个%s就是一个占位符,本行的代表 后面拓号里的 name Name : %s #代表 name Age : %s #代表 age job : %s #代表 job Hobbie: %s #代表 hobbie ------------- end ----------------- ''' %(name,name,age,job,hobbie) # 这行的 % 号就是 把前面的字符串 与拓号 后面的 变量 关联起来 print(info) 在格式化输出里面,怎么表示%? msg = "我是%s,年龄%d,目前工作进度为80%%"%('clsn',24) print(msg) 使用%% 将 % 转义. 1.4 编码说明 字符 ASCII Unicode utf-8 GBK 英文 1个字节 2-4个字节 1个字节 1个字节 中文 x 2-4个字节 3个字节 2个字节 其他 x 2-4个字节 2个字节 x 注: 1个字节 = 8 位bit 1.5 参考文献 [1]https://zh.wikipedia.org/wiki/Python [2]http://www.cnblogs.com/jin-xin/articles/7459977.html [3]http://www.cnblogs.com/wang-yc/articles/6419907.html [4]http://www.runoob.com/python/python-install.html [5]https://www.cnblogs.com/iDouble/p/8467738.html 我的博客即将入驻“云栖社区”,诚邀技术同仁一同入驻。 作者: 惨绿少年 出处: https://www.nmtui.com 本文版权归作者所有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。

优秀的个人博客,低调大师

[jvm]jvm快速入门

本篇以jdk1.7为例 jvm内存结构 堆内存 方法区 jvm栈 程序计数器 本地方法栈如图: 使用processon作图 所以,这里可以看到jvm内存三大主要结构 方法区 堆区 栈区 常用jvm控制参数 -Xms 设置堆的最小空间大小。 -Xmx 设置堆的最大空间大小。 -XX:NewSize 设置新生代最小空间大小。 -XX:MaxNewSize 设置新生代最大空间大小。 -XX:PermSize 设置永久代最小空间大小。 -XX:MaxPermSize 设置永久代最大空间大小。 -Xss 设置每个线程的堆栈大小。 一张图来了解如何通过参数来控制各区域的内存大小 简单介绍每个区域的作用 Java堆(Heap)对于大多数应用来说,Java堆(Java Heap)是Java虚拟机所管理的内存中最大的一块。Java堆是被所有线程共享的一块内存区域,在虚拟机启动时创建。此内存区域的唯一目的就是存放对象实例,几乎所有的对象实例都在这里分配内存。 Java堆是垃圾收集器管理的主要区域,因此很多时候也被称做“GC堆”。如果从内存回收的角度看,由于现在收集器基本都是采用的分代收集算法,所以Java堆中还可以细分为:新生代和老年代;再细致一点的有Eden空间、From Survivor空间、To Survivor空间等。 根据Java虚拟机规范的规定,Java堆可以处于物理上不连续的内存空间中,只要逻辑上是连续的即可,就像我们的磁盘空间一样。在实现时,既可以实现成固定大小的,也可以是可扩展的,不过当前主流的虚拟机都是按照可扩展来实现的(通过-Xmx和-Xms控制)。 如果在堆中没有内存完成实例分配,并且堆也无法再扩展时,将会抛出OutOfMemoryError异常。 方法区(Method Area)方法区(Method Area)与Java堆一样,是各个线程共享的内存区域,它用于存储已被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。虽然Java虚拟机规范把方法区描述为堆的一个逻辑部分,但是它却有一个别名叫做Non-Heap(非堆),目的应该是与Java堆区分开来。 对于习惯在HotSpot虚拟机上开发和部署程序的开发者来说,很多人愿意把方法区称为“永久代”(Permanent Generation),本质上两者并不等价,仅仅是因为HotSpot虚拟机的设计团队选择把GC分代收集扩展至方法区,或者说使用永久代来实现方法区而已。 Java虚拟机规范对这个区域的限制非常宽松,除了和Java堆一样不需要连续的内存和可以选择固定大小或者可扩展外,还可以选择不实现垃圾收集。相对而言,垃圾收集行为在这个区域是比较少出现的,但并非数据进入了方法区就如永久代的名字一样“永久”存在了。这个区域的内存回收目标主要是针对常量池的回收和对类型的卸载,一般来说这个区域的回收“成绩”比较难以令人满意,尤其是类型的卸载,条件相当苛刻,但是这部分区域的回收确实是有必要的。 根据Java虚拟机规范的规定,当方法区无法满足内存分配需求时,将抛出OutOfMemoryError异常。 程序计数器(Program Counter Register) 程序计数器(Program Counter Register)是一块较小的内存空间,它的作用可以看做是当前线程所执行的字节码的行号指示器。在虚拟机的概念模型里(仅是概念模型,各种虚拟机可能会通过一些更高效的方式去实现),字节码解释器工作时就是通过改变这个计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等基础功能都需要依赖这个计数器来完成。由于Java虚拟机的多线程是通过线程轮流切换并分配处理器执行时间的方式来实现的,在任何一个确定的时刻,一个处理器(对于多核处理器来说是一个内核)只会执行一条线程中的指令。因此,为了线程切换后能恢复到正确的执行位置,每条线程都需要有一个独立的程序计数器,各条线程之间的计数器互不影响,独立存储,我们称这类内存区域为“线程私有”的内存。如果线程正在执行的是一个Java方法,这个计数器记录的是正在执行的虚拟机字节码指令的地址;如果正在执行的是Natvie方法,这个计数器值则为空(Undefined)。 此内存区域是唯一一个在Java虚拟机规范中没有规定任何OutOfMemoryError情况的区域。 JVM栈(JVM Stacks)与程序计数器一样,Java虚拟机栈(Java Virtual Machine Stacks)也是线程私有的,它的生命周期与线程相同。虚拟机栈描述的是Java方法执行的内存模型:每个方法被执行的时候都会同时创建一个栈帧(Stack Frame)用于存储局部变量表、操作栈、动态链接、方法出口等信息。每一个方法被调用直至执行完成的过程,就对应着一个栈帧在虚拟机栈中从入栈到出栈的过程。 局部变量表存放了编译期可知的各种基本数据类型(boolean、byte、char、short、int、float、long、double)、对象引用(reference类型,它不等同于对象本身,根据不同的虚拟机实现,它可能是一个指向对象起始地址的引用指针,也可能指向一个代表对象的句柄或者其他与此对象相关的位置)和returnAddress类型(指向了一条字节码指令的地址)。 其中64位长度的long和double类型的数据会占用2个局部变量空间(Slot),其余的数据类型只占用1个。局部变量表所需的内存空间在编译期间完成分配,当进入一个方法时,这个方法需要在帧中分配多大的局部变量空间是完全确定的,在方法运行期间不会改变局部变量表的大小。 在Java虚拟机规范中,对这个区域规定了两种异常状况:如果线程请求的栈深度大于虚拟机所允许的深度,将抛出StackOverflowError异常;如果虚拟机栈可以动态扩展(当前大部分的Java虚拟机都可动态扩展,只不过Java虚拟机规范中也允许固定长度的虚拟机栈),当扩展时无法申请到足够的内存时会抛出OutOfMemoryError异常。 本地方法栈(Native Method Stacks) 本地方法栈(Native Method Stacks)与虚拟机栈所发挥的作用是非常相似的,其区别不过是虚拟机栈为虚拟机执行Java方法(也就是字节码)服务,而本地方法栈则是为虚拟机使用到的Native方法服务。虚拟机规范中对本地方法栈中的方法使用的语言、使用方式与数据结构并没有强制规定,因此具体的虚拟机可以自由实现它。甚至有的虚拟机(譬如Sun HotSpot虚拟机)直接就把本地方法栈和虚拟机栈合二为一。与虚拟机栈一样,本地方法栈区域也会抛出StackOverflowError和OutOfMemoryError异常。 参考自《深入理解Java虚拟机:JVM高级特性与最佳实践 作者:周志明》 JVM (Java Virtual Machine)

优秀的个人博客,低调大师

liunx入门知识总结

了解以下Linux下的重要目录/proc, /sys, /SElinux, /bin, /usr/lib, /usr/local, /var, /tmp : /proc 此目录的数据都在内存中,如系统核心,外部设备,网络状态,由于数据都存放于内存中,所以不占用磁盘空间,比较重要的目录有/proc/cpuinfo、/proc/interrupts、/proc/dma、/proc/ioports、/proc/net/*等 /sys 文件系统访问 Linux内核 /SELinux SELinux是一种基于域-类型模型(domain-type)的强制访问控制(MAC)安全系统,它由NSA编写并设计成内核模块包含到内核中,相应的某些安全相关的应用也被打了SELinux的补丁,最后还有一个相应的安全策略。 /bin /usr/bin: 可执行二进制文件的目录,如常用的命令ls、tar、mv、cat等。 /usr 应用程序存放目录,/usr/bin 存放应用程序, /usr/share 存放共享数据,/usr/lib 存放不能直接运行的,却是许多程序运行所必需的一些函数库文件。/usr/local:存放软件升级包。/usr/share/doc: 系统说明文件存放目录。/usr/share/man: 程序说明文件存放目录,使用 man ls时会查询/usr/share/man/man1/ls.1.gz的内容建议单独分区,设置较大的磁盘空间 /usr/lib /usr/lib:/usr/local/lib: 系统使用的函数库的目录,程序在执行过程中,需要调用一些额外的参数时需要函数库的协助,比较重要的目录为/lib/modules。 /usr/local 这里主要存放那些手动安装的软件,即不是通过“新立得”或apt-get安装的软件。它和/usr目录具有相类似的目录结构。让软件包管理器来管理/usr目录,而把自定义的脚本(scripts)放到/usr/local目录下面。 /var 放置系统执行过程中经常变化的文件,如随时更改的日志文件 /var/log,/var/log/message: 所有的登录文件存放目录,/var/spool/mail: 邮件存放的目录, /var/run: 程序或服务启动 /tmp 一般用户或正在执行的程序临时存放文件的目录,任何人都可以访问,重要数据不可放置在此目录下 重要命令. du, df, top, free, pstack, su, sudo(sudo -, sudo -s), adduser, password 1.du命令:du [选项] 文件 (1)功能该命令是显示指定文件以及下的所有文件占用系统数据块的情况,如果没有文件,默认为是当前工作目录 -a 显示所有文件对系统数据块的使用情况 -b 显示数据块大小时以字节为基本单位 -c 除了显示文件对系统数据块的使用情况外还显示出文件的总和 -s 只显示文件数据块总大小,不显示文件名 -x 只显示当前目录,但不统计子目录 2.df命令:du [选项] 文件名 (1)功能该命令与du命令相似,只不过是df计算的是当前文件所以数据快的使用情况(包括前不久删除的文件),而du只是计算当前存在的所有文件的数据快的使用情况 -a 递归显示各文件及其子目录的数据块利用 -h 方便阅读时显示 -H 和-h一样,只不过1k = 1000;而不是1024 -i 显示inode信息 -k 区块为1024字节 -T 文件系统类型 3.top命令: (1)功能:相当于windows下的资源管理器,可以查看当前CPU的使用情况,各进程的状况 (2)选项 -b 批处理 -I 忽略过失 -c 显示完整的治命令 -s 保密模式 4.free命令 (1)功能:显示所有内存利用率。包括实体内存,虚拟的交换文件内存,共享内存区段,以及系统使用的缓冲区等。 (2)选项 -b 以bype为单位显示 -k 以KB为单位显示 -m 以MB为单位显示 -o 不显示缓冲区 -t 显示内存总和列 5.pstack命令 (1)功能:进程跟踪 6.su命令 (1)功能:切换用户(由root用户向普通用户切换时不需要密码,由普通用户向root用户切换时需要密码) 6.password命令用来修改用户命令,但需要注意,root用户可以修改任何用户的密码,但普通用户只能修改自己的密码(这里涉及s权限的相关知识)。

优秀的个人博客,低调大师

Mycat(入门篇)

Mycat是什么 Mycat是一款基于阿里开源产品Cobar而研发的开源数据库分库分表中间件(基于Java语言开发)。官网所言:Mycat国内最活跃的、性能最好的开源数据库中间件! 一个彻底开源的,面向企业应用开发的大数据库集群 支持事务、ACID、可以替代MySQL的加强版数据库 一个可以视为MySQL集群的企业级数据库,用来替代昂贵的Oracle集群 一个融合内存缓存技术、NoSQL技术、HDFS大数据的新型SQL Server 结合传统数据库和新型分布式数据仓库的新一代企业级数据库产品 一个新颖的数据库中间件产品 Mycat关键特性 支持SQL92标准 支持MySQL、Oracle、DB2、SQL Server、PostgreSQL等DB的常见SQL语法 遵守Mysql原生协议,跨语言,跨平台,跨数据库的通用中间件代理 基于心跳的自动故障切换,支持读写分离,支持MySQL主从,以及galera cluster集群 支持Galera for MySQL集群,Percona Cluster或者MariaDB cluster 基于Nio实现,有效管理线程,解决高并发问题 支持数据的多片自动路由与聚合,支持sum,count,max等常用的聚合函数,支持跨库分页 支持单库内部任意join,支持跨库2表join,甚至基于caltlet的多表join 支持通过全局表,ER关系的分片策略,实现了高效的多表join查询 支持多租户方案 支持分布式事务(弱xa) 支持XA分布式事务(1.6.5) 支持全局序列号,解决分布式下的主键生成问题 分片规则丰富,插件化开发,易于扩展 强大的web,命令行监控 支持前端作为MySQL通用代理,后端JDBC方式支持MySQL、PostgreSQL、Oracle、DB2、SQLServer、MongoDB、巨杉 支持密码加密 支持服务降级 支持IP白名单 支持SQL黑名单、sql注入攻击拦截 支持prepare预编译指令(1.6) 支持非堆内存(Direct Memory)聚合计算(1.6) 支持PostgreSQL的native协议(1.6) 支持mysql和oracle存储过程,out参数、多结果集返回(1.6) 支持zookeeper协调主从切换、zk序列、配置zk化(1.6) 支持库内分表(1.6) 集群基于ZooKeeper管理,在线升级,扩容,智能优化,大数据处理(2.0开发版) 安装与使用 下载(目前最新发行版是1.6.5):http://dl.mycat.io/ 安装:解压即可 配置:Mycat是基于Java开发的,确保安装好了Java环境,可命令行输入:java -version 进行测试。Linux下还需配置Mycat的解压目录:vim /etc/profile,配置完成后使用:source /etc/profile: export JAVA_HOME=xxx export MYCAT_HOME=xxx 运行(Linux): ./mycat start 启动 ./mycat stop 停止 ./mycat console 前台运行 ./mycat install 添加到系统自动启动(暂未实现) ./mycat remove 取消随系统自动启动(暂未实现) ./mycat restart 重启服务 ./mycat pause 暂停 ./mycat status 查看启动状态 运行(Windows):双击bin/tartup_nowrap.bat,如果出现闪退,可在cmd命令行运行,并查看出错原因 内存配置:启动前,一般需要修改JVM配置参数,打开conf/wrapper.conf文件,可根据本机配置情况修改为512M或其它值 # Java Additional Parameters #wrapper.java.additional.1= wrapper.java.additional.1=-DMYCAT_HOME=. wrapper.java.additional.2=-server wrapper.java.additional.3=-XX:MaxPermSize=64M wrapper.java.additional.4=-XX:+AggressiveOpts wrapper.java.additional.5=-XX:MaxDirectMemorySize=2G wrapper.java.additional.6=-Dcom.sun.management.jmxremote wrapper.java.additional.7=-Dcom.sun.management.jmxremote.port=1984 wrapper.java.additional.8=-Dcom.sun.management.jmxremote.authenticate=false wrapper.java.additional.9=-Dcom.sun.management.jmxremote.ssl=false wrapper.java.additional.10=-Xmx4G wrapper.java.additional.11=-Xms1G 连接测试: 测试mycat与测试mysql完全一致,mysql怎么连接,mycat就怎么连接 命令行:mysql -uroot -proot -P8066 -h127.0.0.1(其中,user和password可在conf/server.xml配置查找,8066是默认的服务端口,也可以在conf/server.xml中配置修改) 客户端:1.3和1.4版本目前部分工具无法连接,会提示database not selected,建议使用高版本的Mycat,1.5版本已经修复了部分客户端工具的连接 常见分库分表产品对比 分库分表产品 MyCat Sharding-JDBC Cobar Cobar-client TDDL 分库 有 有 有 有 未开源 分表 有 有 无 无 未开源 中间层 是 否 是 否 否 ORM支持 任意 任意 任意 仅MyBatis 任意 数据库支持 任意 任意 仅MySQL 任意 任意 社区情况 活跃 活跃 停更 未知 未知 相关链接 Mycat官网 Mycat从零开始 Mycat权威指南 GitHub:Mycat-Server Wiki:Mycat-Server Issues:Mycat-Server mysql中间件研究(Atlas,Cobar,TDDL) mysql中间件研究(Atlas,Cobar,TDDL,Mycat,Heisenberg,Oceanus,Vitess,OneProxy)

优秀的个人博客,低调大师

JavaScript面向对象入门

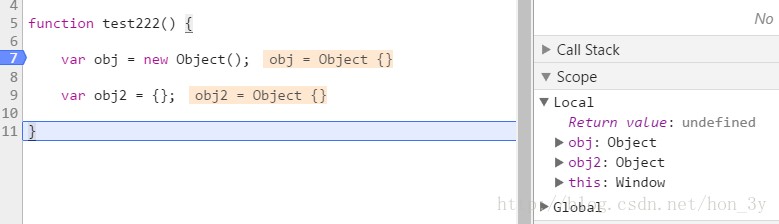
什么是JavaScript? 我们可以从几个方面去说JavaScript是什么: 基于对象 javaScript中内置了许多对象供我们使用【String、Date、Array】等等 javaScript也允许我们自己自定义对象 事件驱动 当用户触发执行某些动作的时候【鼠标单机、鼠标移动】,javaScript提供了监听这些事件的机制。当用户触发的时候,就执行我们自己写的代码。 解释性语言 [x] javaScript代码是由浏览器解析的,并不需要编译。 基于浏览器的动态交互技术 既然javaScript是由浏览器解析的,那么它肯定要基于浏览器。 javaScript让网页变得更加“灵活"" 弱类型 [x] 像java、c++等编译型语言,要先定义变量,后使用。javaScript能够直接使用,不需要先定义 JavaScript变量类型 javaScript变量可分为三种类型: 基本类型【number、string、boolean】 javaScript是弱类型语言,在运行的时候才知道具体的类型是什么。所有类型都用var来修饰。 特殊类型【null、undefined】 当定义了变量,没有任何赋值的时候,该变量就是undefined类型 复合类型【数组、对象、函数】 javaScript对象的类型 在JavaScript中对象的类型可分为4种: 内置对象【String、Math、Array】 自定义对象【程序员自己创建的对象】 浏览器对象【windows、document、history、status等等与浏览器相关的对象】 ActiveXObject(XMLHttpRequest)对象【异步对象,使用AJAX用到的对象,使用该对象与服务器进行异步交互】 定义函数三种方式 函数是属于特殊类型的一种,在另外一篇博文已经讲解了创建对象、创建类的几种方式,可参考:http://blog.csdn.net/hon_3y/article/details/69362242 值得注意的是:javaScript定义函数的时候,参数的类型是不用声明的! 正常方式 下面就定义了一个名称为mysum的函数 function mysum(num1,num2){ return num1 + num2; } var myresult = mysum(100,200); alert("myresult="+myresult); Function定义 在JavaScript中, 一切皆是对象,函数也可以用一个对象来代表:Function,我们可以使用Function来创建对象: 函数参数全都是字符串,最后一个字符串是方法体 var youresult = new Function("num1","num2","return num1+num2"); alert( youresult(1000,2000) ); 由于这种方法写起来并不好些,可读性也不太好,因此很少使用【不推荐使用】 匿名创建函数 其实这种和第一种差不多,只不过是将一个无名的函数赋值给一个变量。那么这个变量就代表了这个函数。 var theyresult = function(num1,num2){ return num1 + num2; } alert( theyresult(10000,20000) ); theyresult这个变量就代表了函数。 创建对象 方式① 直接使用new Object() var obj = new Object(); 方式② 使用空的{}大括号 var obj2 = {}; 测试 增加属性,访问属性 我们要为创建的对象增加属性和访问属性的值! 使用.操作符增加属性 JavaScript是弱类型的语言,可以动态的添加属性。 obj.age = 20; obj.name = "zhongfucheng"; obj.say = function () { alert("hello"); }; 测试 使用.操作符访问属性 var aa = obj.age; var bb = obj.name; 测试 使用[]操作符访问属性 var aa = [obj["age"]]; var bb = [obj["name"]]; 测试 创建类 方式① 使用function来模拟创建类,function充当了构造函数 //测试函数 function test() { var teacher = new Teacher(); } //使用function来模拟类 function Teacher() { } 测试 方式② 上面的function来模拟类很容易和函数混淆。 我们一般这样做:用一个变量记住一个匿名的function当做是类,function充当了构造函数 function test() { var teacher = new Teacher(); } var Teacher = function () { }; 测试 方式③ 使用JSON语法来创建类,也就是对象直接量定义方法 var obj = { age: 20, str: "zhongfucheng", method:function () { alert("aaa"); } }; 测试 公有属性和方法 我们创建公有属性应该在类中指定,创建公有方法应该使用原型对象prototype prototype定义的属性就类似于Java的静态成员:在原型对象上定义了属性,拥有这个原型对象的function所创建的对象也拥有定义的属性!所以,我们方法中就使用prototype var obj = function Teacher(name) { this.name = name; if( typeof obj._init=="undefined") { obj.prototype.setName = function (name) { this.name = name; }; obj.prototype.getName = function () { alert(this.name); }; } obj._init = true; }; 创建两个不同的Teacher对象,name属性是不一样的。而它们共享同一份setName()和getName()方法 值得注意的是:prototype定义的属性只可读的。如果你想要使用具体对象写prototype的属性,实际上并不是写,而是重新为该类定义了一个同名(和prototype同名)的属性。在读取同名属性的时候,优先读取对象上的属性,而不是prototype的。 私有属性 我们在Java中,定义私有属性是通过关键字private来修饰的。。 在JavaScript中是没有这样的关键字的,我们需要这样做:定义在方法内【也就是function内部,也可以看作成构造函数】的变量,就是私有变量。 var obj = function Teacher(name) { //这是私有属性,外界不能访问 var age = 23; //这是公有属性,外界可以访问 this.name = name; //想要访问私有变量age,只能在这里编写方法来访问。其余的地方都不行! //我们通常就是在这里编写公有方法来访问私有属性 }; 静态属性和方法 在JavaScript中定义静态属性其实就是通过prototype原型对象来定义的。 定义静态的时机: 当类的某个值与对象无关期望所有位置看到的结果是一样的时候,就可以定义为类静态属性。 如果类的一个方法做的是和具体对象无关的操作,而是做一些工作操作的时候,就可以将这个方法定义为静态的类方法。 //静态属性TYPE Book.TYPE = “IT”; Book.print = function(){alert(Book.TYPE);} JavaScript中的for in循环 在学习AJAX的时候,发现JavaScript中for in循环,这种循环对于遍历JSON是很好用的。于是写下了这篇博文 for in循环本质上是forEach循环,它主要有两个作用 遍历数组 遍历JavaScript对象 遍历数组 当使用for in来遍历数组的时候,它的循环计数器是数组元素的索引值 var a = ['a', 'b', 'c']; for(var index in a) { alert(index); } 效果: 遍历JavaScript对象 当使用for in来遍历对象的时候,它的循环计数器是对象的属性名 //对象json上,包含了两个对象a和b属性 var json = {a:{num:1},b:{num:2}}; for(var name in json){ alert(name); } 效果 JS打气球游戏 在B站中看见了一个JS大气球这么一个教程,才知道原来JS+HTML5+CSS3能那么有趣。但是视频中没并没有给出源码。于是在别人的博客中搜到了对应的源码以及他自己实现的思路,该博主对其进行了改编。 http://www.cnblogs.com/morang/p/7636148.html 以上的博文有源码的下载。下面我就直接贴上源码了。思路就在博文中。 <!DOCTYPE html PUBLIC "-//WAPFORUM//DTD XHTML Mobile 1.0//EN" "http://www.wapforum.org/DTD/xhtml-mobile10.dtd"> <html> <head> <title>气球大战</title> <meta name=viewport content="width=device-width,initial-scale=1,maximum-scale=1,user-scalable=0"> <style> /*CSS3能够将气球描绘出来,使用到了圆形、旋转、阴影等技术*/ body{margin:0px;padding:0px;} #ballDiv{position: fixed;top: 0;left: 0;} .balloon{ width:150px; height:150px; position:absolute; left:0px; top:0px; background-color:#f3778d; border-radius:50% 50% 10% 50%; transform:rotate(45deg); box-shadow:1px 1px 20px 20px pink inset; z-index:10; } /*这里使用到了伪元素,可以不用到html中定义元素就可以实现功能了!*/ .balloon:after{ width:20px; height:20px; content:""; display:block; background:transparent; position:absolute; right: -15px; bottom: -15px; border-left:5px solid pink; border-top:5px solid pink; } /*这里使用到了伪元素,可以不用到html中定义元素就可以实现功能了!*/ .balloon:before{ width: 2px; height: 50px; content: ""; display: block; background: #ffc0cb; position: absolute; right: -10px; top: 100%; margin-top: -16px; transform: rotate(-45deg); } </style> </head> <body> <div id="gameinfo" style="transform: translateZ(360px);"> <p> 最高连击:<span id='maxDoubleHit'>0</span> </p> <p> 本次游戏:<span id='currentDoubleHit'>0</span> </p> <p id="gamemsg" style="display:none;"> <span style="color:red;font-weight:bold;"> Game Over </span> <button onclick="javscript:location.reload();"> 重新开始 </button> </p> </div> <div id="ballDiv"> </div> <!--<div class="balloon"></div>--> <script> var maxDoubleHit=localStorage.getItem('eliminateCount')||0 var currentDoubleHit=0 //当做一个缓存池,优化性能的。 var bnElements=[];//存放所有气球 var random=Math.random;//随机函数 var wW=window.innerWidth;//窗口宽度 var wH=window.innerHeight;//窗口高度 var ballW=160;//气球的宽度 var ballH=300;//气球的宽度 var minSpeed=3;//最小速度,每次向上移动至少3px var speedNum=5;//速度的定量 var defBnNumber=5;//初始化气球 var moveTimer; var isEnd=false; var jindex=1; var ballDiv=document.getElementById('ballDiv'); //初始化 init(defBnNumber); //移动 move(); //绑定单击事件 bindClick(); //游戏信息 document.getElementById('maxDoubleHit').innerText=maxDoubleHit function record(){ if(isEnd){ clearTimeout(moveTimer); bnElements=[]; document.getElementById('gamemsg').style.display='block'; document.getElementById('gameinfo').style='transform: translateZ(360px);position: fixed;top:0;left:0;z-index:999'; } else{ init(1); document.getElementById('currentDoubleHit').innerText=++currentDoubleHit; if(currentDoubleHit>maxDoubleHit){ document.getElementById('maxDoubleHit').innerText=currentDoubleHit; localStorage.setItem('eliminateCount',currentDoubleHit) } } } //初始化气球 function init(num){ //创建一个虚拟文档节点 var docFragment=document.createDocumentFragment(); for(var i=0;i<num;i++){ var bnElement=document.createElement('div'); bnElement.className='balloon'; //速度随机,限定最小值 var speed=Math.max(minSpeed,~~(random()*speedNum)); bnElement.setAttribute('speed',speed);//~~取整 移动速度 bnElement.setAttribute('id','ball-'+jindex++); //分散排列 var x=(~~(random()*wW))-ballW; x=Math.max(0,x); bnElement.style.left=x+'px'; bnElement.style.top=wH+'px';//露一点出来 //1.先将创建的气球放入创建的虚拟文档节点 docFragment.appendChild(bnElement); bnElements.push(bnElement); } //2.将虚拟文档节点添加到body中 ballDiv.appendChild(docFragment); } //使用定时器来对气球进行移动。 function move(){ var bl=bnElements.length for(var i=0;i<bl;i++){ var currentElement=bnElements[i] if(currentElement==null){ continue; } var offsetTop=currentElement.offsetTop; if(offsetTop>0){//窗口中 //offset就是针对窗口的位置来进行移动的。 var speed=currentElement.getAttribute('speed'); currentElement.style.top=offsetTop-speed+'px' } else{ //移除dom节点 //ballDiv.removeChild(currentElement); //移除数组中 //bnElements.splice(i,1); //init(1); isEnd=true; record(); } } moveTimer=setTimeout(move,1000/30); } //对所有的气球进行单击监听事件,不要单独为每个气球来进行监听,这样耗费性能! function bindClick(){ ballDiv.addEventListener('click',clickFunc,false); function clickFunc(e){ if(!isEnd && e.target.className=='balloon'){ bnElements.splice(bnElements.lastIndexOf(e.target),1); //这里使用call主动调用,在boom方法中我们就可以使用this指针了。 boom.call(e.target,function(){ e.target.parentNode.removeChild(e.target); record(); }); } } } function boom(callback){ //var that=this; //替换了上下文,但是没有使用this的意义. var speed=this.getAttribute('speed'); this.timer=setInterval(function(){ this.style.opacity=0.1*(speed--) if(speed<1){ callback&&callback(); clearInterval(this.timer); } }.bind(this),30); } </script> </body> </html> 看了视频也学到了之前一直没有注意的东西: CSS3很厉害啊,能将方形的div转成是椭圆形的[也就是气球的形状],还有盒子的阴影设置。 使用伪元素就可以不用直接在html中设置标签了。配合CSS3也能够做出对应的样式。 使用实体边框配合CSS3也可以做出不同的形状样式 在生成元素的时候,可以先将要生成的元素加入到文档片段中,再使用文档片段来进行一次性添加到body上,这样性能会好很多! 使用~~运算符能够取整数 限定气球的边界就可以使用max和min函数来进行限定。这也是很好用的。 移动气球我们需要用到定时器。 使用call主动调用方法,把目标对象传递过去的话,我们就可以使用this指针了。 在定时器中使用bind(this),就可以在定时器中使用this指针的,因为定时器默认是由浏览器window来进行调用的,默认是不能使用this的 绑定单击事件的时候,不要使用循环来进行绑定,这样太耗费性能了,我们可以使用监听事件来进行一次绑定。 在遍历元素数组的时候,条件是元素数组的长度时,我们可以先把该元素数组的长度初始化出来,那么也可以提升性能!不然就每次判断前都要去查询数据的长度! for(var i=0,len = array.length; i<len;i++){} 如果文章有错的地方欢迎指正,大家互相交流。习惯在微信看技术文章,想要获取更多的Java资源的同学,可以关注微信公众号:Java3y 更多的文章可往: 文章的目录导航

优秀的个人博客,低调大师

Python快速入门_1

注释 # 用#号字符开头注释单行 """ 三个引号可以注释多行 三个引号可以注释多行 三个引号可以注释多行 """ 原始数据类型和运算符 (1)整型 #整数 3 #=>3 (2)算术运算 #加法 1+1 #=>2 #减法 8-1 #=>7 #乘法 10*2 #=>20 #除法 !!!结果自动转换成浮点数 35/5 #=>7.0 5/3 #=>1.6666666666666667 #整数除法 !!!结果向下取整 5//3 #=>1 5.0//3.0 #=>1.0 -5//3 #=>-2 5//(-3) #=>-2 -5.0//3.0 #=>-2.0 #浮点数的运算结果也是浮点数 3*2.0 #=>6.0 #取模 7%3 #=>1 #x的y次方 2**4 #=>16 #用括号决定优先级 (1+3)*2 #=>8 (2)布尔运算与比较运算 #布尔值 True #=>True False #=>False #用not取非 not True #=>False not False #=>True #逻辑运算符,注意and和or都是小写 True and False #=>False True or False #=>True #整数也可以当做布尔值 0== False #=>True 2==True #=>False 1==True #=>True #用==判断相等 1==1 #=>True 2==1 #=>False #用!=判断不等 1!=1 #=>False 1!=2 #=>True #比较大小 1<10 #=>True 2<=2 #=>True 2>=2 #=>True (4)字符串运算 #字符串用单引号双引号都可以 '这个是字符串' "这个也是字符串" #用加号连接字符串 'Hello '+'World' #=>'Hello World' #字符串可以被当做字符列表 'This is a string'[0] #=>'T' #用format来格式化字符串 "{} can be {}".format("string",'interpolated') #=>'string can be interpolated' #可以重复参数以节省时间 "{0} be nimble,{0} be quick,{0} jump over the {1}".format("jack","candle stick") #=>'jack be nimble,jack be quick,jack jump over the candle stick' #如果不想数参数可以用关键词 "{name} wants to eat {food}".format(name='Bob',food='lasagna') #=>'Bob wants to eat lasagna' #如果你的python3程序也要运行在Python2.5以下环境运行,也可以用老式的格式化语法 "%s can be %s the %s way"%('strings','interpolater','old') #=>'strings can be interpolater the old way' (2)None #None是一个对象 None #当与None进行比较时不要用==,要用is,is是用来比较两个变量是否指向同一个对象 'etc' is None #=>False None is None #=>True #None,0,空字符串,空列表,空字典都算是False,其他都是True bool(None) #=>False bool(0) #=>False bool("") #=>False bool({}) #=>False bool([]) #=>False

优秀的个人博客,低调大师

Python入门:内置函数

可创建一个整数列表,一般用在 for 循环中。 函数语法 range(start, stop[, step]) 参数说明: start: 计数从 start 开始。默认是从 0 开始。例如range(5)等价于range(0, 5); end: 计数到 end 结束,但不包括 end。例如:range(0, 5) 是[0, 1, 2, 3, 4]没有5 step:步长,默认为1。例如:range(0, 5) 等价于 range(0, 5, 1) 示例: >>>range(10) # 从 0 开始到 10 [0, 1, 2, 3, 4, 5, 6, 7, 8, 9] >>> range(1, 11) # 从 1 开始到 11 [1, 2, 3, 4, 5, 6, 7, 8, 9, 10] >>> range(0, 30, 5) # 步长为 5 [0, 5, 10, 15, 20, 25] >>> range(0, 10, 3) # 步长为 3 [0, 3, 6, 9] >>> range(0, -10, -1) # 负数 [0, -1, -2, -3, -4, -5, -6, -7, -8, -9] >>> range(0) [] >>> range(1, 0) [] for i in range(0,10) # i遍历从0到9 range() 返回对象(字符、列表、元组等)长度或项目个数。 语法 len()方法语法: len( s ) 参数 s -- 对象。 返回值 返回对象长度。 示例 以下实例展示了 len() 的使用方法: >>>str = "runoob" >>> len(str) # 字符串长度 6 >>> l = [1,2,3,4,5] >>> len(l) # 列表元素个数 5 for i in range(len(list)) len() 打印输出 语法 print(*objects, sep=' ', end='\n', file=sys.stdout) 参数 objects -- 复数,表示可以一次输出多个对象。输出多个对象时,需要用 , 分隔。 sep -- 用来间隔多个对象,默认值是一个空格。 end -- 用来设定以什么结尾。默认值是换行符 \n,我们可以换成其他字符串。 file -- 要写入的文件对象。 返回值 无。 示例 以下展示了使用 print 函数的实例: Python3 下测试 >>>print(1) 1 >>> print("Hello World") Hello World >>> a = 1 >>> b = 'runoob' >>> print(a,b) 1 runoob >>> print("aaa""bbb") aaabbb >>> print("aaa","bbb") # 默认空格间隔 aaa bbb >>> >>> print("www","runoob","com",sep=".") # 设置间隔符 www.runoob.com print() 方法对系列进行求和计算。 语法 sum(iterable[, start]) 参数 iterable -- 可迭代对象,如列表。 start -- 指定相加的参数,如果没有设置这个值,默认为0。 返回值 返回计算结果。 示例 以下展示了使用 sum 函数的实例: >>>sum([0,1,2]) 3 >>> sum((2, 3, 4), 1) # 元组计算总和后再加 1 10 >>> sum([0,1,2,3,4], 2) # 列表计算总和后再加 2 12 sum() 返回给定参数的最小值,参数可以为序列。 语法 以下是 min() 方法的语法: min( x, y, z, .... ) 参数 x -- 数值表达式。 y -- 数值表达式。 z -- 数值表达式。 返回值 返回给定参数的最小值。 实例 以下展示了使用 min() 方法的实例: #!/usr/bin/python print "min(80, 100, 1000) : ", min(80, 100, 1000) print "min(-20, 100, 400) : ", min(-20, 100, 400) print "min(-80, -20, -10) : ", min(-80, -20, -10) print "min(0, 100, -400) : ", min(0, 100, -400) 以上实例运行后输出结果为: min(80, 100, 1000) : 80 min(-20, 100, 400) : -20 min(-80, -20, -10) : -80 min(0, 100, -400) : -400 min() 返回给定参数的最大值,参数可以为序列。 语法 以下是 max() 方法的语法: max( x, y, z, .... ) 参数 x -- 数值表达式。 y -- 数值表达式。 z -- 数值表达式。 返回值 返回给定参数的最大值。 示例 以下展示了使用 max() 方法的实例: #!/usr/bin/python print "max(80, 100, 1000) : ", max(80, 100, 1000) print "max(-20, 100, 400) : ", max(-20, 100, 400) print "max(-80, -20, -10) : ", max(-80, -20, -10) print "max(0, 100, -400) : ", max(0, 100, -400) 以上实例运行后输出结果为: max(80, 100, 1000) : 1000 max(-20, 100, 400) : 400 max(-80, -20, -10) : -10 max(0, 100, -400) : 100 max()

优秀的个人博客,低调大师

Google Native Client入门

上午在去往上海的动车组上看到《Google正在测试ActiveX的继任者》这条新闻,因为前段时间一直在做一个证件信息采集的ActiveX控件,而众所周知,ActiveX的安全性是臭名昭著的,所以对这个所谓的“继任者”非常感兴趣,晚上回来后就第一时间试了试。 Native Client项目主页:http://code.google.com/p/nativeclient/ Native Client是一个在Web应用程序中运行本地代码(目前只支持x86架构)的开源的研究性技术,提供更好的“富客户端”用户体验。它允许网络开发者编写更强大的Web程序,这些程序直接通过系统运行而不用通过浏览器来进行,据Google称,它到最后将允许网络开发者开发和桌面软件一样的的web程序,这些程序将带来更快的速度。Native Client类似于微软的ActiveX技术,它还能在Linux和Mac OS X下运行。目前它尚未支持IE,仅支持Google Chrome, Firefox, Safari 和Opera。 本文实验所用OS:Hiweed2.0,官网:http://www.hiweed.com/ 要使它带的示例程序运行为Native Client的模块,你必须要有如下软件:1)Native Client。2)Python(版本在2.4或2.5)。3)一个浏览器(推荐Firefox3) 下面是安装Native Client的步骤: 1,从官网上获取nacl_linux_0.1_9308700.tgz文件,解压缩到你指定的目录下: tar xvf nacl_linux_0.1_9308700.tgz 2,验证Python版本(注意下面的V是大写字母)是2.4或2.5。 python –V 若版本过低或未安装python,则使用下述命令安装: sudo apt-get install python2.4 将示例作为Native Client应用程序来运行 现在来看如何在Native Client中运行一个示例。 1,进入到earth这个demo所在目录 cd install_dir/nacl/googleclient/native_client/tests/earth 2,运行earth这个demo python run.py 结果如图所示,标题“NaCl Application”表明你是在一个特定的进程中运行一个Native Client模块: 安装和使用插件 现在我们切换到浏览器中来运行Native Client模块,我们必须安装Native Client插件,然后把引用这些Native Client模块的页面给加载到浏览器中。 1,进入native_client目录 cd install_dir/nacl/googleclient/native_client 2,若你正在运行firefox,那就关闭它,否则插件可能安装失败。 3,使用如下命令安装插件,在安装过程中回答一个yes ./scons --prebuilt firefox_install Okay to continue? [y/n] y 4,检查最后输出的安装结果,成功的话就去启动firefox 5,在firefox中打开下面这个页面 install_dir/nacl/googleclient/native_client/scons-out/nacl/staging/index.html 这里列出了很多示例,可以自行玩玩。 使用make编译和运行单独的示例(仅限于Linux或Mac) 1,进入到你要编译运行的示例目录下,以earth为例: cd install_dir/nacl/googleclient/native_client/tests/earth 2,重新编译为一个单独的应用程序并运行: make debug run 3,重新编译为一个Native Client模块并运行: make release nacl run 这就是文章最开头显示的realease版本 4,移除掉你自行编译的版本,使用预编译好的版本,和前面两种比较下(其实就是第二种啦)。 make clean python run.py 附:1)Google为了说明这个东西的安全性还发了一篇paper,刚开始看,以后再补上笔记 2)为了方便起见,没有在Windows下测试,有兴趣可按照官方文档试试 3)不知是不是故意捉弄微软,Google推出的这个“ActiveX杀手”竟然在第一时间不支持IE。(哈哈,相信后续会支持的,否则还有啥用?) 参考资料: 1,Native Client Getting Started guide. 2, Building Native Client 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2008/12/09/1351378.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Visual Basic快速入门

Basic语言的全名是Beginner's All-purpose Symbolic Instruction Code(初学者通用的符号指令代码),是几十年前流行过的一门语言。我高中时候一门数学选修课中使用的也是Basic语言。我还记得当时我为了使用Basic语言,还从网上下了一个简陋的QBasic工具。当时第一次接触编程的我对编程语言充满了兴趣。当然在现在,Basic语言已经基本没什么用了。现在还在使用的Basic语言大概就是微软的Visual Basic了。今天就来介绍一下Visual Basic语言。需要注意的是,VB语言运行在微软的CLR上,所以如果你对C#比较熟悉的话,学习VB就很简单了。 HelloWorld 照例,第一个项目自然应该是HelloWorld。打开Visuall Studio,创建一个VB项目,然后就会出现如下图所示的代码。 HelloWorld 来解释一下HelloWorld的代码。首先第一行是导入类库,和C#、java的import语句是一个道理。然后下面定义了一个Program模块,其中定义了Main函数,在函数中输出Hello World。在VB中,不使用大括号作为块分隔符,而是使用End语句来结束块作用域。 Imports System Module Program Sub Main(args As String()) Console.WriteLine("Hello World!") End Sub End Module 基本数据类型 由于VB和C#都是运行在CLR上的语言,所以其实它们的基本类型是一样的,都有有/无符号的各种长度整数、单精度双精度浮点数、布尔类型、字符和字符串等类型。下面的代码仅列出几个常用的。 Public Class DataType Sub DataType() Dim b As Byte Dim i As Integer Dim s As Single Dim d As Double Dim c As Char Dim str As String Dim bool As Boolean b = 100 i = 1000 s = 1.5 d = 3.1415926 c = "c"c str = "abc" bool = True End Sub End Class 变量和常量 VB的变量定义也和C系语言不同,使用的是Dim 变量名 As 变量类型的语法进行定义。变量必须先定义才能使用。如果想同时定义多个变量,可以这么写。 Dim i, j As Integer 如果想在定义变量的同时初始化,可以这样。 Dim bool As Boolean = True 如果要定义常量,可以变量类似,只不过使用Const关键字。 Const cs As Integer = 1000 运算符 先来看看算术运算符。 运算符 用途 例子 ^ 幂运算符 3 ^ 2 = 9 + 加法 - 减法 * 乘法 / 小数除法 3 / 2 = 1.5 \ 整除 3 \ 2 = 1 MOD 取模 6 MOD 4 = 2 然后是比较运算符。这里需要注意的就是VB的相等和不等和其他语言的可能不太一样。 运算符 用途 = 相等 <> 不等 < 小于 > 大于 <= 不大于 >= 不小于 然后是逻辑运算符。 运算符 用途 And 与运算符,不短路求值 Or 或运算符,不短路求值 Not 非运算符 Xor 异或运算符 AndAlso 与运算符,短路求值 OrElse 或运算符,短路求值 IsTrue 是否为真 IsFalse 是否为假 条件语句 If语句 先来看看VB中的If语句,其基本结构是If 条件 Then 执行体 Else 执行体 End If。 Dim num As Integer = 5 If num\2 = 0 Then Console.WriteLine($"{num} is even") Else Console.WriteLine($"{num} is odd") End If 如果需要多重If语句,可以添加ElseIf语句块。 If num = 1 Then Console.WriteLine($"{num} is 1") ElseIf num = 2 Console.WriteLine($"{num} is 2") Else Console.WriteLine($"{num} is other") End If Select语句 Select语句相当于其他语言中的switch语句,如果没有匹配项,会执行Case Else语句块。 Dim c As Char = "c"c Select c Case "a"c Console.WriteLine("a") Case "b"c, "c"c Console.WriteLine("b or c") Case Else Console.WriteLine("others") End Select 循环语句 Do语句循环 Do语句循环有两种结构,第一种是循环条件在前。先来看看Do-While语句,当满足循环条件的时候会继续循环,不满足条件时跳出循环。这里顺便提一下,VB中没有块注释,只有单行注释,以单引号开头,直到句末。 'Do While语句 Dim i = 0 Do While i < 5 If i = 3 Then Exit Do End If Console.Write(i) i += 1 Loop 再来看看Do-Until语句,和Do-While相反,在不满足条件的时候会执行循环,满足条件时跳出循环。 'Do Until语句 i = 0 Do Until i > 5 If i < 3 Then i += 2 Continue Do End If Console.Write(i) i += 1 Loop Do循环的第二种形式就是先执行循环体,然后进行判断,同样有While和Until两种。 i = 0 Do Console.Write(i) i += 1 Loop While i < 5 Console.WriteLine While循环 还有就是传统的While循环。 'While循环 i = 0 While i < 5 Console.Write(i) i += 1 End While For循环 下面是For循环的例子,在For循环中可以使用Step指定步长。 For counter As Integer = 1 To 9 Step 1 Console.Write(counter) Next Foreach循环 Foreach循环用于迭代一个列表中的每一项。 Dim array() as Integer = {1, 2, 3, 4, 5, 6, 7} For Each item As Integer In array Console.Write(item) Next With语句 With语句其实不算循环语句,不过我看的这个VB教程把With语句放到这里说,那我也放到这里好了。With语句在有些语言中也有,主要用途是节省代码数量。比方说有下面这个Person类。 Public Class Person Public Property Name As String Public Property Age As Integer End Class 假如有一个person对象多次出现的话,就可以使用With语句,在With语句中,点访问符默认指向的就是With语句指定的对象。 Dim person As Person = New Person With person .Name = "yitian" .Age = 25 Console.WriteLine($"Person(Name:{.Name}, Age:{.Age})") End With 跳转语句 Exit语句 Exit语句用于结束某个代码块,它的形式如下。想用Exit退出哪个代码块,就写哪个代码块的类型。 Exit { Do | For | Function | Property | Select | Sub | Try | While } Continue语句 Continue语句用于结束当前循环,直接进行下一次循环。它的形式如下,后面跟要继续的代码块类型。 Continue { Do | For | While } Goto语句 最后就是Goto语句,它会直接跳转到指定的标签处。 'Goto语句 GoTo Ending Console.WriteLine("Print something") Ending: Console.WriteLine("This is end.") 数组 先来看看数组定义。VB中的数组比较特殊,定义一个Dim a1(3),其实是下标0-4长度为四的一维数组,这一点要非常注意。 '下标0-9的十个元素的数组 Dim array1(9) As Integer '11X11的二维数组 Dim array2(2, 2) As Integer '定义并初始化数组 Dim array3() = {1, 2, 3, 4, 5} '锯齿数组,也就是数组的数组 Dim array4 As Integer()() = New Integer(1)() {} array4(0) = New Integer() {1, 2} array4(1) = New Integer() {3, 4} 访问数组元素需要使用圆括号,而不是一般语言的方括号。 '初始化一维数组 For i As Integer = 0 To 9 array1(i) = i Next '初始化二维数组 For i = 0 To 2 For j = 0 To 2 array2(i, j) = (i + 1)*(j + 1) Next Next 最后就是遍历数组了,可以使用For循环迭代下标,或者用Foreach循环直接遍历元素。 '显示数组 For Each e In array1 Console.Write(e) Next Console.WriteLine For i As Integer = 0 To 2 For j = 0 To 2 Console.Write(array2(i, j)) Next Console.WriteLine Next For Each e In array3 Console.Write(e) Next Console.WriteLine For i As Integer = 0 To 1 For j = 0 To 1 Console.Write(array4(i)(j)) Next Console.WriteLine Next 函数 Sub函数 回头来看看前面的HelloWorld,其中就有一个Main函数,它是一个Sub函数,也就是没有返回值的函数。 Imports System Module Program Sub Main(args As String()) Console.WriteLine("Hello World!") End Sub End Module 函数可以按值传参,也可以按引用传参,默认情况下是按值传参。 Function GetParam(ByVal a As Integer, ByRef b As Integer) a = 10 b = 10 Console.WriteLine("Param changed") End Function Function函数 Function函数就是有返回值的函数。在函数中,如果要返回值,可以有两种办法,第一种是使用Return语句,第二种是在函数体中向函数名赋值。 '函数返回值可以用Return语句 Function Return1() As Integer Return 1 End Function '也可以向函数名赋值 Function Return2() As Integer Return2 = 2 End Function 可变参数列表 可变参数列表使用ParamArray声明。 Function PrintIntegers(ParamArray integers As Integer()) For Each i In integers Console.Write(i) Next Console.WriteLine End Function 面向对象编程 类 VB的类和C#的类非常相似,同样有字段、属性等概念。构造函数使用New声明,不需要返回值。析构函数使用Finalize声明,也不需要返回值。 Class Contact ' 字段 Private _name As String Private _tel As String '构造函数 Public Sub New(name As String, tel As String) _name = name _tel = tel End Sub '析构函数 Protected Overrides Sub Finalize() End Sub '属性 Public Property Tel As String Get Return _tel End Get Set _tel = value End Set End Property Public Property Name As String Get Return _name End Get Set(value As String) _name = value End Set End Property '重写方法 Public Overrides Function ToString() As String Return $"Contact(Name:{Name}, Tel:{Tel})" End Function End Class 抽象类和接口 如果一个类的方法含有MustOverride修饰符,那么这个方法就是一个抽象方法。含有抽象方法的类就是抽象类,需要使用MustInherit关键字修饰。 MustInherit Class Shape MustOverride Function GetArea() As Double End Class Interface Color Function GetColor() As String End Interface 继承 继承基类和实现接口的声明必须写在类实现的前面。如果一个方法重写了基类的版本,那么这个方法应该使用Overrides关键字修饰。如果不希望类被其他类继承,可以使用NotInheritable修饰,类似于Java的final关键字或者C#的sealed关键字。如果子类需要调用基类的方法,可以使用MyBase关键字代表基类。 Class Circle Inherits Shape Protected radius As Double Public Sub New(r As Double) radius = r End Sub Public Overrides Function GetArea() As Double Return Math.PI*radius*radius End Function End Class NotInheritable Class RedCircle Inherits Circle Implements Color Public Sub New(r As Double) MyBase.New(r) End Sub Public Function Color_GetColor() As String Implements Color.GetColor Return "Red" End Function End Class 静态成员 静态成员和静态函数使用Shared关键字声明,对于每个类来说Shared成员只会存在一个。 Class MyMath Public Shared PI As Double = 3.1415926 Public Shared Function GetPI As Double Return PI End Function End Class 模块 Module类似于Class,不同之处在于Module不需要实例化,其中的函数可以直接调用,就像静态函数一样。 Module Program Sub Main(args As String()) Console.WriteLine("Hello World!") End Sub End Module 异常处理 VB的异常处理和C#的一样,都有Try、Catch、Finally部分。 Public Module ExceptionHandling Sub HandleException() Try Throw New ArithmeticException("除数不能为零") Catch ex As ArithmeticException Console.WriteLine($"捕获了数学计算异常:{ex.Message}") Catch ex As Exception Console.WriteLine($"捕获了异常:{ex.Message}") Finally Console.WriteLine("终结代码") End Try End Sub End Module 以上就是VB语言的一些介绍了,希望对大家能有所帮助。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册