首页 文章 精选 留言 我的

精选列表

搜索[递归下降解析器],共10000篇文章
优秀的个人博客,低调大师

python链表冒泡排序、二叉树顺序递归遍历、顺序表的快排

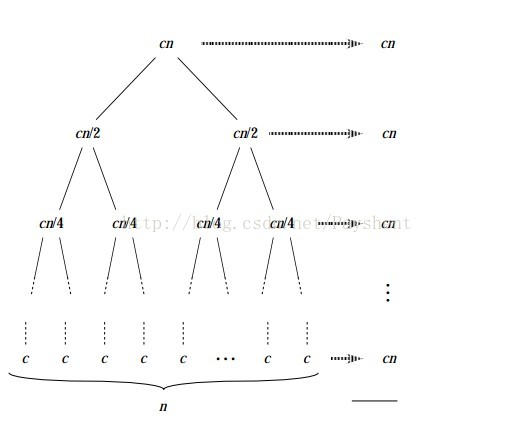
一、python实现链表冒泡排序 - 冒泡排序的概念:冒泡排序是一种交换排序,它的基本思想是:两两比较相邻记录的关键字,如果反序则交换,直至没有反序的记录为止。因为按照该算法,每次比较会将当前未排序的记录序列中最小的关键字移至未排序的记录序列最前(或者将当前未排序的记录序列中最大的关键字移至未排序的记录序列最后),就像冒泡一样,故以此为名。 - 冒泡排序算法的算法描述如下: -- 比较相邻的元素。如果第一个比第二个大,就交换他们两个。 -- 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对。这步做完后,最后的元素会是最大的数。 -- 针对所有的元素重复以上的步骤,除了最后一个。 -- 持续每次对越来越少的元素重复上面的步骤,直到没有任何一对数字需要比较。 1、基本的冒泡排序实现: li = [23, 43, 1, 2, 4, 5, 253] def bubble(li): if not len(li): return count = 0 for i in range(len(li)): for j in range(len(li) - 1): count+=1 if li[i] < li[j]: li[i], li[j] = li[j], li[i] print(count) return li ret_li = bubble(li) print(ret_li) 42 //循环的次数 [1, 2, 4, 5, 23, 43, 253] //排序结果 2、基本优化 这种方法利用了双重循环,会造成不必要的比较,所以优化一下,可以考虑从尾部开始,这样可以将以排好序的部分不再检查 def bubble(li): if not len(li): return count = 0 for i in range(len(li)): j = len(li) - 1 while j > i: count +=1 if li[j] < li[j - 1]: li[j], li[j - 1] = li[j - 1], li[j] j -= 1 print(count) return li ret_li = bubble(li) print(ret_li) 21//循环的次数 [1, 2, 4, 5, 23, 43, 253] //排序结果 3、进一步优化 通过设置flag来判断某次循环是否没有出现位置交换,没有交换就说明排序已完成 def bubble(li): if not len(li): return count = 0 for i in range(len(li)): flag = False j = len(li) - 1 while j > i: count += 1 if li[j] < li[j - 1]: li[j], li[j - 1] = li[j - 1], li[j] flag = True j -= 1 if not flag: print(count) return li return li ret_li = bubble(li) print(ret_li) 20 //循环次数 [1, 2, 4, 5, 23, 43, 253] //排序结果 二、二叉树的顺序遍历 二叉树是有限个元素的集合,该集合或者为空、或者有一个称为根节点(root)的元素及两个互不相交的、分别被称为左子树和右子树的二叉树组成。 -- 二叉树的每个结点至多只有二棵子树(不存在度大于2的结点),二叉树的子树有左右之分,次序不能颠倒。 -- 二叉树的第i层至多有2^{i-1}个结点 -- 深度为k的二叉树至多有2^k-1个结点; -- 对任何一棵二叉树T,如果其终端结点数为N0,度为2的结点数为N2,则N0=N2+1 二叉树有三种遍历方式:先序遍历,中序遍历,后续遍历 即:先中后指的是访问根节点的顺序 eg:先序 根左右 中序 左根右 后序 左右根 遍历总体思路:将树分成最小的子树,然后按照顺序输出 #实现树结构的类,树的节点有三个私有属性 左指针 右指针 自己的值 class Node(): def __init__(self,data =None,left=None,right = None): self._data = data self._left = left self._right = right #先序遍历 遍历过程 根左右 def pro_order(tree): if tree == None: return False print(tree._data) pro_order(tree._left) pro_order(tree._right) #后序遍历 遍历过程 左右根 def pos_order(tree): if tree == None: return False # print(tree.get_data()) pos_order(tree._left) pos_order(tree._right) print(tree._data) #中序遍历 遍历过程 左根右 def mid_order(tree): if tree == None: return False # print(tree.get_data()) mid_order(tree._left) print(tree._data) mid_order(tree._right) #层次遍历 def row_order(tree): # print(tree._data) queue = [] queue.append(tree) while True: if queue==[]: break print(queue[0]._data) first_tree = queue[0] if first_tree._left != None: queue.append(first_tree._left) if first_tree._right != None: queue.append(first_tree._right) queue.remove(first_tree) if __name__ == '__main__': tree = Node('A',Node('B',Node('D'),Node('E')),Node('C',Node('F'),Node('G'))) pro_order(tree) mid_order(tree) pos_order(tree) row_order(tree) 三、python实现顺序表的快排 1、快排的介绍: 快速排序采用的思想是分治思想,先简单的介绍一下分治的思想。分治算法的基本思想是将一个规模为N的问题分解为K个规模较小的子问题,这些子问题相互独立且与原问题性质相同。求出子问题的解,就可以得到原问题的解。下面这张图会说明分治算法是如何进行的:将cn分成了两个cn/2,转而分成了cn/4,cn/8......我们通过这样一层一层的求解规模小的子问题,将其合并之后就能求出原问题的解。 图解.jpg 2、快排的基本思路是: 在待排序的序列中选取一个值作为一个基准值,按照这个基准值得大小将这个序列划分成两个子序列,基准值会在这两个子序列的中间,一边是比基准小的,另一边就是比基准大的。这样快速排序第一次排完,我们选取的这个基准值就会出现在它该出现的位置上。这就是快速排序的单趟算法,也就是完成了一次快速排序。然后再对这两个子序列按照同样的方法进行排序,直到只剩下一个元素或者没有元素的时候就停止,这时候所有的元素都出现在了该出现的位置上。 附图:快排的图解 快排.jpg 3、快排的特点 快速排序之所比较快,因为相比冒泡排序,每次交换是跳跃式的。每次排序的时候设置一个基准点,将小于等于基准点的数全部放到基准点的左边,将大于等于基准点的数全部放到基准点的右边。这样在每次交换的时候就不会像冒泡排序一样每次只能在相邻的数之间进行交换,交换的距离就大的多了。因此总的比较和交换次数就少了,速度自然就提高了。当然在最坏的情况下,仍可能是相邻的两个数进行了交换。因此快速排序的最差时间复杂度和冒泡排序是一样的都是O(N2),它的平均时间复杂度为O(NlogN)。其实快速排序是基于一种叫做“二分”的思想。 4、快排的代码实现 def quick_sort(li): if len(li) <= 1: return li base_value = li[len(li) // 2] left_part = [item for item in li if item < base_value] right_part = [item for item in li if item > base_value] eq_part = [item for item in li if item == base_value] return quick_sort(left_part) + eq_part + quick_sort(right_part) print(quick_sort(li = [23, 43, 1, 2, 4, 5, 253])) 简洁版的快排,两种代码其实是一样的 def quick_sort(li): if len(li) <= 1: return li return quick_sort([item for item in li[1:] if item < li[0]])+ li[0:1] + quick_sort([item for item in li[1:] if item > li[0]]) print(quick_sort(li = [23, 43, 1, 2, 4, 5, 253]))

优秀的个人博客,低调大师

为什么普通 ASR 到了多人会议场景,准确率往往会明显下降?

很多语音识别模型在标准测试集上的表现已经相当不错。拿一段近距离、单人、环境安静的录音去测试,转写结果往往很接近人工听写。但一旦把同样的模型放到真实会议室里,情况通常就会复杂很多:人名和专业词更容易出错,多人发言时内容容易串到一起,短句被漏掉,甚至文字本身识别正确,却被归到了错误的发言人名下。

优秀的个人博客,低调大师

三大电信运营商支出下降——5G投资是不是放缓了

三大电信运营商日前发布今年上半年业绩报告,营业收入和净利润均实现大幅增长,业绩亮点各有千秋。其中,5G是最大亮点,三家电信运营商公布的5G套餐用户数相加近5亿户。 不过从投资额看,三家电信运营商支出均有所下滑,这意味着我国5G建设放缓了吗?今年下半年5G建设会加速吗?经济日报记者就这些问题采访了有关专家。 换挡再加速 今年上半年三大电信运营商投资都有所放缓。从投资额看,今年上半年,中国移动完成860亿元投资,比上年同期减少不到15%;中国电信完成计划投资的31%,投资额相当于上年同期的63%;中国联通完成全年计划投资的20.4%。其中,中国移动上半年5G资本开支为502亿元,全年计划约1100亿元。 今年上半年三大电信运营商为何减少了资本支出?据了解,中国移动是因为和中国广电共建700MHz频段的细节还在协商,投资比去年稍有延缓;中国电信和中国联通则是有意控制投资节奏,提高设备利用效率,等待5G技术和标准更加成熟。同时,共建共享也为5G建设节省了可观的成本。 从5G基站看,截至今年6月底,中国移动已开通5G基站50.1万个,全年目标超过70万个;中国电信和中国联通共建共享5G基站,目前双方在用5G基站达46万个,全年目标也是70万个。工信部数据显示,截至今年6月底,我国累计建设5G基站96.1万个,覆盖全国所有地级以上城市,5G手机终端连接数达3.65亿户,占全球80%以上。 工信部部长肖亚庆在去年底召开的全国工业和信息化工作会议上说,2021年将有序推进5G网络建设及应用,加快主要城市5G覆盖,推进共建共享,新建5G基站60万个以上。而今年上半年,三大电信运营商新建的5G基站还不到20万个,同时,三大电信运营商在财报中都强调维持5G投资全年不变,这意味着三大电信运营商的5G投资将集中于下半年。 对此,独立电信分析师付亮认为,三大电信运营商都在“换挡”期,在新的规划没有全面实施前,适度放慢投资是正常举措。总体看,今年上半年,三大电信运营商5G网络建设速度有所放缓,但下半年随着中国移动+中国广电的700MHz频段和中国电信+中国联通的2.1GHz频段建设全面展开,运营商将基于更低的频率提供更好的覆盖。 5G用户不断增加 从三大电信运营商公布的数据看,今年上半年,中国移动的5G套餐用户数为2.51亿户,渗透率达26.5%;中国电信的5G套餐用户数为1.3115亿户,渗透率达36.2%;中国联通的5G套餐用户数为1.13亿户,渗透率达37%。 渗透率指的是各运营商的5G套餐用户数占其用户总规模的百分比。“从数据看,个人5G用户整体占比约为三分之一,这意味着5G商用的空间依旧很大。”众诚智库研究总监徐英分析说。 “中国联通的5G套餐用户最少,但渗透率追上并超过了两大对手,位列第一。”付亮认为这得益于两个原因,一是今年中国联通5G套餐数快速增长,上半年净增4250万;二是中国联通采用更严谨的口径即“移动出账用户”,移动用户最少,分母小,有利于渗透率的提高。 与5G用户数不断增加相对应的是,5G行业应用加速推进,尤其是5G+融合技术在政企应用领域的范围不断扩展。从半年报看,中国移动聚焦工业互联网、交通、医疗、教育等多个领域的5G应用;中国联通在工业互联网、智慧矿山、智慧医疗、智慧城市等重点领域支撑5G行业应用超过15个;中国电信在智慧工厂、矿山、港口、电网、城市等一系列5G应用的标杆项目,快速在全国多地复制。 5G应用技术创新成果显著。徐英介绍,中国移动累计申请5G专利超3300件,标准专利储备量位居全球运营商第一阵营;中国联通成功建设全球首个5G全连接工厂,致力于打造5G+ABCDE(人工智能、区块链、云计算、大数据、边缘计算)融合创新的差异化竞争优势;中国电信通过5G+光宽+WiFi6的“三千兆”高品质泛连接服务,以及“致远、比邻、如翼”三种5G定制网服务模式充分发挥出独立组网特性,显著提升了客户的运营和管理效能。 转型仍是必修课 从半年报看,三家电信运营商的表现各有千秋。 上半年,中国移动经营收入规模、增幅和净利润皆位列三大电信运营商之首,分别达4436亿元、13.8%、591.18亿元,个人市场实现了正增长,家庭市场、政企市场、新兴市场都表现优异。中国电信经营收入为2192亿元,同比增长13.1%,净利润为177亿元,同比增长27.2%,增幅仅次于中国移动,增长势头强劲。中国联通经营收入达1642亿元,同比增长9.2%,利润总额近年来首次突破百亿,达到112亿元。 毋庸置疑,5G商用的业绩增长是三大电信运营商未来的主要增收渠道,主要表现为5G用户的规模、服务内容和5G技术的服务能力,尤其是“5G+”融合应用生态的可持续性,将直接体现在业务规模上,从而影响运营商的业绩。 不过,新兴市场的培育和拓展也将极大影响运营商的业绩。徐英分析说,从上半年财报看,除5G商用市场外,中国移动在新兴市场的培育和拓展上表现最为突出,且新兴业务呈倍数级增长,其国际化服务能力和股权投资收益、其他合作收益等均渐呈规模。中国联通和中国电信在云服务市场方面取得了一定成效,但业绩增长后劲还需加大培育力度。 通信业转型仍是必修课。“通信业转型需要换赛道,这是最大的结构性挑战。”北京邮电大学经管学院兼职教授葛颀接受记者采访时说,从面向消费者提供价廉物美的信息化服务到面向行业客户提供有溢出效应的数字化生产力平台,是5G时代通信行业的最大机遇和挑战。通信业转型要着眼长期,在数字化产业已经领跑全球的基础上,争取再用20年左右的时间将产业数字化打造成中国数字经济的核心产业。 徐英认为,通信业转型值得突破的领域主要有以下几方面:在个人市场的内容服务方面,依托5G个人商用渗透率的不断提高,在数字内容、高清视频、游戏体验等方面加大技术投入、内容创作、资源整合和平台化服务,释放个人市场5G内容体验红利。在政企市场的网络服务、云服务、融合创新服务方面,依托5G基础设施的普及、5G应用技术的创新、千兆光纤网络技术的应用,“5G+”融合创新应用对各大行业的数字化、智能化发展将呈爆发式增长,尤其是工业互联网、社会化治理、数字经济等领域。在云计算、人工智能、智慧化服务方面,三大电信运营商云平台技术趋于成熟,云服务器建设基础强大,云服务业绩增长迅速,在未来产业数字化转型中的数据存储、计算、智能方案服务方面将有很大的突破空间。 【责任编辑:未丽燕 TEL:(010)68476606】

优秀的个人博客,低调大师

IDC:一季度中国平板电脑出货量373万台 产能下降29.8%

IDC中国最新发布的平板电脑季度跟踪报告显示:2020年第一季度中国平板电脑市场出货量约373万台,受“新冠”疫情影响,工厂产能同比降29.8%。 疫情期间,远程办公和在线网课导致消费者对平板电脑的需求激增,但停工及复工后人力、零配件和物流等不利因素导致工厂生产供货难以满足市场激增的需求,市面主流品牌产品长期处于缺货状态。虽然疫情得到控制,产能逐步恢复,产品供应问题也逐步缓解,但需求高峰已过,厂商并未完全把握住市场“红利”。 IDC认为,在此次疫情影响下,未来远程办公和在线教育将会更加常态化,沉寂多年的平板电脑需求将会明显提升。 受疫情影响,一季度平板商用/消费市场出货均明显减少,出货量仅为62万台,同比降47.8%。消费市场方面,受学生在线教育需求拉动,表现好于预期,但产能制约供货,出货量约310万台,同比降24.6%。 2020年第一季度中国平板电脑市场前五大厂商概览: 华为:继续位居第一。一季度华为平板出货量约为150万台,同比增长4.3%,市场份额占比40.2%。 苹果:供应链影响出货。一季度苹果iPad出货量约为131万台,同比跌42.5%,占据市场份额35.1%。 小米:产品线有待更新。一季度小米平板出货量约为21万台,同比跌31.3%,出货量市场份额占比为5.5%。 微软:出货保持稳定。一季度微软平板产品出货量约为12万台,同比跌17.6%,出货量市场份额占比3.2%。 联想:受疫情影响较大。一季度联想平板出货量约为6万台,同比跌49.5%,出货量市场份额占比1.7%,跌1.6个百分点。

优秀的个人博客,低调大师

12月数据库榜单,整体排名稳定如昨,Oracle 分数接连下降

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 DB-Engines 数据库流行度排行榜发布了12月份的数据,先来看一下完整的榜单,排名前二十如下: 可以看到,12月榜单的前二十名和上个月的对比变化不大,而且大部分数据库的分数都保持着上升的趋势。榜首 Oracle 的分数虽然连续两个月都出现较大的下滑(-17.89, -18.16),但奈何“家底”扎实,依旧稳居***。 而“万年老四”的PostgreSQL 在这两个月的得分都十分出众,相比上个月,它的分数又增加了 20.39,在整个排行榜中它也是增长分数***的一个。 至于 MongoDB,虽说分数一直保持着稳定上升的趋势,但和 PostgreSQL 相比依然有较大的差距。不过,MongoDB 在2018年的表现是非常不错的,至少一直都在进步,这个表现也是MongoDB 独一份。 其他方面的变动,以及完整排名请查看https://db-engines.com/en/ranking。 接下来我们看一下前十名的趋势变化图: ***看一下每种数据库的排名情况。 关系数据库前10名如下: Key-Value 数据库前10名如下: 文档数据库前10名如下: 图数据库前10名如下: 时序数据库前10名如下: DB-Engines 根据受欢迎程度对数据库管理系统进行排名,排名每月更新一次。排名的数据依据 5 个不同的指标: Google 以及 Bing 搜索引擎的关键字搜索数量 Google Trends 的搜索数量 Indeed 网站中的职位搜索量 LinkedIn 中提到关键字的个人资料数 Stackoverflow 上相关的问题和关注者数量 这份榜单分析旨在为数据库相关从业人员提供一个技术方向的参考,其中涉及到的排名情况并非基于产品的技术先进程度或市场占有率等因素。无论排名先后,选择适合与企业业务需求相比配的技术,才是最重要的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册