首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

python另类处理Google和12306的图形验证

随着反爬虫的深入,后来不仅有滑块验证,还出现了点选验证、图形验证、汉字图形验证、其中较为知名的是Google的图形验证和12306的图形验证,以及知乎出现的倒立汉字验证。 应对图形验证的方式除了对接专业的验证平台以外,我们还可以通过处Email、微信将图片发给自己来选择点击位置,今天就分享如何方便自己点击选择。 下面是一张12306图形验证码 遇到这种情况,在大型项目中一般直接对接专业处理平台,在小项目中就自己点选了,但是无界面模式下又怎么选择?那当然是通过邮件或者微信发送到手机,即使受到了验证码也很难做出处理。 但是将上面的图片处理一下做成下面的样子: 直接在微信回复图片中的编码,每个编号中间的十字光标就是选择该编号后会点击的坐标。同时可以定义图片分割的大小,可以分割得更加密集或者更加稀疏。 每个单元格就像一个像素位置,只是不同的是我们只需要说出编号,让程序自动找到坐标来点击。 代码如下: fromPILimportImage fromPILimportImageDraw,ImageFont defimages(file,n,m): """:paramfile:图片路径:paramn:x轴切割多少份:paramm:y轴切割多少份:return:"""img=Image.open(file) img_d=ImageDraw.Draw(img) x_len,y_len=img.size x_=x_len//n y_=y_len//m print(x_*y_) forxinrange(0,x_len,x_): img_d.line(((x,0),(x,y_len)),(0,0,180)) foryinrange(0,y_len,y_): img_d.line(((0,y),(x_len,y)),(0,0,180)) fontsize=min(y_,x_)*3//4 draw=ImageDraw.Draw(img) ttfont=ImageFont.truetype('simsunb.ttf',fontsize) data=dict()# 每个编号及其对应坐标的字典 i=1 whilei<=n*m: foryyinrange(y_//2,y_len,y_): forxxinrange(x_//2,x_len,x_): data[i]=(xx,yy) i+=1 forkey,valueindata.items(): xx,yy=value draw.text((xx-fontsize*1.5/4,yy-fontsize*0.5),str(key),fill=(255,0,0), font=ttfont) img_d.line(((xx-2,yy),(xx+2,yy)),(0,0,180)) img_d.line(((xx,yy-2),(xx,yy+2)),(0,0,180)) img.show() img.save('ii.png')if__name__=='__main__': images('1.png',14,10)# 当然效果就如下图所示:

优秀的个人博客,低调大师

Python零基础学习笔记(三十六)—— 递归

''' 递归调用:一个函数,调用了自身,成为递归调用 递归函数:一个会调用自身的函数 凡是循环能干的事,递归都能干 ''' ''' 方式: 1、写出临界条件 2、找这一次和上一次的关系 3、假设当前函数已经能用,调用自身计算行一次的结果,再求出本次的结果 ''' #输入一个数,求 1+2+3+……+ n 的和 def sum1(n): sum = 0 for x in range(1, n + 1): sum += x return sum res = sum1(10) print("res =", res) #递归方法 def sum2(n): if n == 1: return 1 else: return n + sum2(n - 1) res1 = sum2(10) print(res1)

优秀的个人博客,低调大师

Python零基础学习笔记(三十)—— 读文件

''' 过程: 1、打开文件 2、读文件内容 3、关闭文件 ''' ''' 1、打开文件 open(path, flag[, encoding]) path:要打开文件的路径 flag:打开方式 r(read) 以只读方式打开文件,文件的描述符放在文件的开头 rb 以为进制格式打开文件用于只读,文件的描述符放在文件的开头 r+ 打开一个文件用于读写,文件的描述符放在文件的开头 w 打开一个文件只用于写入,如果该文件已经存在会覆盖,不存在则创建新文件 wb 打开一个文件只用于写入二进制,如果该文件已经存在会覆盖,不存在则创建新文件 w+ 打开一个文件用于读写,如果该文件已经存在会覆盖,不存在则创建新文件 a 打开一个文件用于追加,如果文集那存在,文件描述符将会放到文件末尾 a+ encoding:编码格式 errors:错误处理 ''' #打开文件 path = r"E:\File.txt" #f = open(path, "r", encoding = "utf-8",errors = "ignore") f = open(path, "r") ''' 2、读文件内容 ''' #读文件的所有内容 str1 = f.read() print("str1 =", str1) #读文件中指定字符数 f.seek(0) #修改描述符的位置 str2 = f.read(5) print("str2 =", str2) #读取整行,包括"\n"字符 f.seek(0) str3 = f.readline() print("str3 =", str3) #读取所有行并返回列表 f.seek(0) str4 = f.readlines() print("str4 =", str4) #读取指定字符数 f.seek(0) str5 = f.readline(20) print("str5 =", str5) #修改描述符的位置 f.seek(0) ''' 3、关闭文件 ''' f.close() ''' 完整过程 ''' #第一种 try: f1 = open(path,"r") print(f1.read()) finally: if f1: f1.close() #更为简单的方法 with open(path, "r", encoding= "gbk", errors="ignore") as f2: print(f2.read())

优秀的个人博客,低调大师

Python零基础学习笔记(二十)—— tuple元组

#创建空元组 tuple1 = () print(tuple1) #创建带有元素的元组 tuple2 = (1, 2, 3, "jjking", True) #元素类型可以不同 print(tuple2) #定义只有1 个元素的元组 tuple3 = (1 ) #后面必须加逗号 print(tuple3) print(type(tuple3)) ''' 元组元素的访问 格式: 元组名[下标] 注意:下标不能越界 ''' tuple4 = (1, 2, 3, 4, 5) print(tuple4[3]) #获取最后一个元素 print(tuple4[-1]) #获取倒数第二个元素 print(tuple4[-2]) #修改元组,实际上修改的是元素里面的数据 tuple5 = (1, 2, 3, 4, [1, 2, 3], 5) print(tuple5) tuple5[4][2] = 4 print(tuple5) #删除元组 del tuple5 #print(tuple5) 因为被删除了所以打印不出来,会报错 #元组的操作 t1 = (1 ,2, 3, 4) t2 = (5, 6) t3 = t1 + t2 print(t3) #元组重复 print(t3 *3) #判断元素是否在元组中 print( 3 in t3) #元组的截取 #格式:元组名[ 开始下标:结束下标 ] #从开始下标开始截取,到结束下标之前,默认从头到尾 print(t3[1:4]) #二维元组:元素为一维元组的元组 t4 = ((1, 2, 3), (4, 5, 6), (7, 8, 9)) print(t4) print(t4[2][1]) '''元组的方法''' #len() 返回元组中元素的个数 print(len(t4)) #max() 返回元组中的最大值 print(max(t1)) #min() 返回元祖中的最小值 print(min(t1)) #列表转元组 list2 = [1, 2, 3, 4, 5] t5 = tuple(list2) print(t5) #元组转列表 list1 = list(t3) print(list1) ''' 一旦初始化元组里面的元素就不能修改了 和列表的区别就是不可变 这就提高了数据的安全性 所以说能用元组尽量用元组 ''' #元组的遍历 for i in (1, 2, 3, 4,5): print(i)

优秀的个人博客,低调大师

Python零基础学习笔记(十五)—— list(列表)

''' 本质;一种有序的集合 格式: 列表名 = [列表选项1, 列表选项2, ...列表选项n] ''' list1 = [23, 22, 24, 22, 25] print(list1) #元素数据可以不同 list2 = [1, 233, "name", "jjking", True] ''' 列表元素的访问 取值: 格式:列表名[下标] 注意:列表下标不要越界 ''' print(list1[2]) #列表操作: #列表组合 list3 = list1 + list2 print(list3) #列表的重复 print(list2 * 5) #判断元素是否在列表中 print(1 in list2) #列表截取 [2:3) print(list2[2:3]) #二维列表 list4 = [[123],[2,2,3],[1,2,3],[4,5,6,8]] print(list4[2][2]) #列表方法 list5 = [1,2,3,4,5,6] #appeng() 在列表末尾添加新的元素 list5.append(7) print(list5) list5.append([8,9]) print(list5) #extend() 在末尾一次性追加另一个列表中的多个值 list5.extend([1,2,3]) print(list5) #insert() 在下标处添加一个元素,元数据向后顺延 list5.insert(2,10) print(list5) #pop() 删除下标处的元素,默认为最后一个下标,并返回删除的数据 list5.pop() print(list5) list5.pop(2) print(list5) print(list5.pop(2)) #remove() 移除列表中的某个元素 list5.remove(5) list5.remove([8, 9]) print(list5) #clear() 清除列表中所有的数据 list6 = [1,2,3] list6.clear() print(list6) #index() 从列表中找出某个值的第一个匹配的索引值,可以加开始和结束的下标范围 print(list5.index(2)) print(list5.index(2, 4,8)) #len() 列表中的元素 print(len(list5)) #max() 获取列表中的最大值,只能是在一维列表,不然会报错 print(max(list5)) #min() 获取列表中的最小值,只能是在一维列表,不然会报错 print(min(list5)) #count() 某元素出现的次数 print(list5.count(2)) #浅拷贝 内存地址是一样的 lis7 = list5 print(id(list5)) print(id(lis7)) #copy() 深拷贝 内存的拷贝 内存的地址是不一样的 print(id(list5.copy())) #reverse() 倒序 list5.reverse() print(list5) #sort() 从小到大排序 list5.sort() print(list5) #元组转换成列表 list8 = list((1,2,3,4)) print(list8)

优秀的个人博客,低调大师

Python零基础学习笔记(十四)—— while语句

''' while 语句: 格式: while 表达式: 语句 逻辑:当程序遇到while语句的时候,首先计算【表达式】的值 如果【表达式】的值为假,那么结束整个while语句 如果表达式的值为真,则执行【语句】,循环调用,直到为假停止 ''' #从1打印到小于5的数 num = 1 while num < 5: print("num = %d"% num) num += 1 #计算1+2+3+...+100 sum = 0 num = 1 while num <= 100: sum += num num += 1 #print("sum = %d" % sum) print("sum = %d"% sum) #打印字符串里的每一个字符 str = "My name is jjking." index = 0 while index <= len(str): print(str[index]) index += 1 运行结果: num = 1 num = 2 num = 3 num = 4 sum = 5050 M y n a m e i s j j k i n g .

优秀的个人博客,低调大师

Python零基础学习笔记(八)—— 数学功能

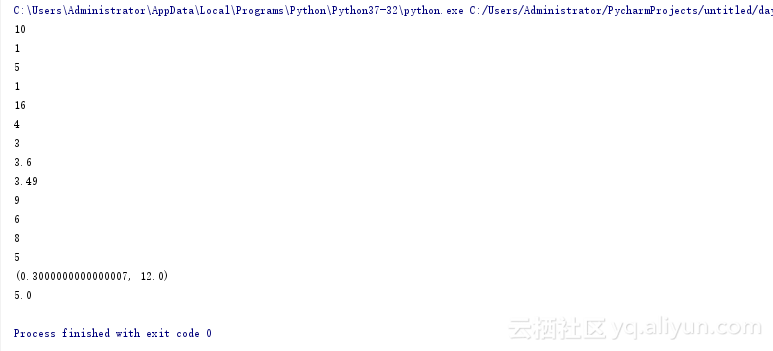
一定要导入math包,不然后面会报错 今日学习部分及执行结果如下图 import math # abs() 返回数的绝对值 a1 = -10 a2 = abs(a1) print(a2) #比较两个数的大小 a3 = 10 a4 = 9 print((a3>a4)-(a3<a4)) # max() 返回参数中的最大值 print(max(1,2,3,4,5)) # min() 返回参数中的最小值 print(min(1,2,3,4,5)) # pow() 求x的y次方 例如2^4 print(pow(2,4)) #round(x[, n]) x为数值,n为保留位数,n可有可无 # 四舍五入 print(round(3.576)) print(round(3.492)) #四舍五入保留位数 print(round(3.576, 1)) print(round(3.492, 2)) # math.ceil() 向上取整 print(math.ceil(8.1)) print(math.ceil(5.9)) # math.floor() 向下取整 print(math.floor(8.1)) print(math.floor(5.9)) # math.modf() 返回整数部分与小数部分 print(math.modf(12.3)) # math.sqrt() 开方 print(math.sqrt(25))

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册