首页 文章 精选 留言 我的

精选列表

搜索[双足行走],共9126篇文章
优秀的个人博客,低调大师

让数字营销向人工智能借一双慧眼

这是一个“读图时代”,消费者在发布和转发图像信息时,并不总是直接提及品牌和产品的名字。醒目的Logo和产品造型更易于识别,且助于消除纯文本易产生的歧义。同时,图像中还经常对消费场景进行了有意无意的展现,如包含了消费场所、消费情景、与其他产品关联消费等信息,且与本文相比,制造图像“水军”的成本无疑更高。因此,图像已经成为了企业信息传播、品牌曝光、情感表达等互联网营销最重要的形式。 尽管图像在互联网传播中更具优势,但由于机器的逻辑特性与技术局限,既有互联网信息的监测和分析更多停留在文本层面,而包含图片和视频在内的海量图像数据则未被较好挖掘与应用。随着计算机视觉的发展,图像分类(Image Classification)与物体定位(Object Localization)等技术不断成熟,由两种技术结合的物体检测功能(Object Detection)势必将逐渐应用于互联网图像监测与分析的众多领域。 (通过图像检测识别出图片和视频中赞助品牌的产品和Logo图像) 国双深度视觉监测系统GDVD(Gridsum Deep Vision Dissector)因此孕育而生。GDVD基于目前最主流的、效果最好的Faster R-CNN物体检测算法,利用深层Resnet对图像进行更好的特征提取,同时修改网络结构使得对于小目标检测也有很高的准确率 。而国双基于大数据的人工智能引擎国双先知(Gridsum Prophet)则为GDVD的实现提供了图像识别、物体监测、深度学习等全面的AI能力。不仅如此,单纯拼技术和算法早已不能满足现实需求,将视觉监测系统应用于数字营销领域,为企业带来效益才是GDVD作用于商业领域的价值。简单来说,国双深度视觉监测系统首先采集全网图片,然后通过对图像进行标注,经过深度神经网络学习得到识别模型,让机器进行自动判别,找到互联网中所有提及某一品牌、产品和企业的相关数据,并与国双多年来积累的技术、产品与服务优势相结合,实现图像监测与后续数据分析功能,从而帮助企业提升营销效果。 (国双深度视觉监测系统GDVD原理简图) 让全网舆情监测更全面 作为AI的子领域,自然语言处理的发展进一步优化了文本分析,针对文本的舆情监测和数据挖掘水平不断提升。而AI的另一子领域,图像识别技术将帮助舆情监测补齐图像传播这一板块。通过监测视觉元素露出的时长、频率、位置、渠道等指标,在传播的广度和深度上进行趋势把握,并追踪由此带来的衍生话题。更为重要的是,图像监测可结合文本监测进行进一步挖掘与分析,“两手抓,两手都要硬”,真正做到全网舆情监测。 让广告效果评估更精准 近几年,选择赞助节目和品牌植入的企业越来越多,传统的人力监播将是明日黄花,不仅监测效率低下、成本较高,而且维度也非常单一,数据价值也得不到深挖。但视觉监测系统则可以实时监测直播视频中品牌Logo及产品的露出,识别素材露出形式的差异,弥补既有品牌植入效果评估的不足。 系统同样可以作用于展示类广告,对广告素材的大小、位置等多种创意元素进行自动识别后,再结合监测到的广告曝光和点击数据,从而更精准地对广告效果进行评估。 让品牌传播推广更安全 广告营销效果的基础是对品牌价值的正确传播,但随着各种新型的广告形式层出不穷,媒体环境也愈发不可预料。最近一段时间,各种媒体上频繁出现的一些页面、视频内容与广告品牌价值不一致,甚至与大众取向相悖的事件,给广告主带来了很恶劣的影响,也让品牌安全成为广告界十分关注的话题。 而国双在自主开发的全场景营销监测系统AD中,即有专门针对品牌安全监测分析的功能基于爬虫及自然语言分析技术,并搭载深度视觉监测系统提供的图像监测能力,对广告投放的环境进行全方位监控。基于系统,可以将广告所在页面的文本,图片进行还原分析,从内容语义、图像主体、相关性及协调性方面进行综合评估,为品牌传播的安全保驾护航。 让市场营销决策更智能 互联网的去中心化模糊了传统中心和节点的边界,让KOL和粉丝的连接方式更加开放、扁平、平等,因而催生了众多KOL和粉丝经济。企业的营销策略则要进行相应地调整,将KOL、粉丝、品牌/产品这三者更紧密地连接起来。 一方面,视觉监测系统可以通过图像识别找到包括明星或大V在内的众多KOL发布的包含品牌的图片,让企业快速准确地找到线索,通过转发、评论、蹭热点、合作等多种形式抓住更多消费者。另一方面,系统通过监测消费者分享的品牌和产品的视觉内容,锁定忠实粉丝,进行人群画像以及lookalike处理,进行精准投放。而分析消费者的购买场景,则能帮助企业挖掘隐藏在图像里的潜在商业机会和消费意愿,加深对消费者的理解,做出更智能的决策。 国双早在成立之初就看到分布式运算的潜势,公司其名(Gridsum)就是分布式计算(Grid)与分析(Sum)的结合。近年人工智能技术不断演化,对于产业所产生的变革,不断颠覆你我想象。作为中国领先的云计算企业级大数据分析和人工智能解决方案提供商,我们已经并将继续致力于帮助企业和政府客户以新颖有效的方式使用数据,提高生产力。 原文发布时间为:2017年8月28日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

惭入佳境之布置双节点DATANODE及错误解决

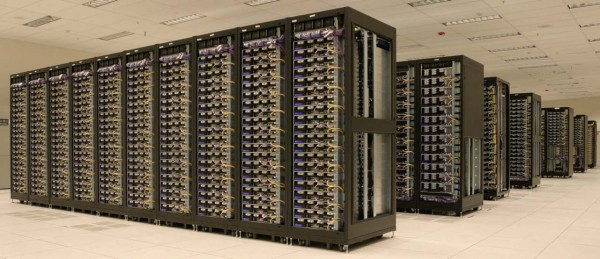
先流一下口水~~~~ 传说中YAHOO用于HADOOP的机房: 推荐安装指南: http://www.michael-noll.com/tutorials/running-hadoop-on-ubuntu-linux-multi-node-cluster/ 其布置多节点的思路是: 先将第一个布置好的SINGLE节点方案弄好。 然后,将第一个节点的东东复制到另一个节点。 再将第二个节点降成DATANODE节点,而第一个节点为NAMENODE节点。 这样,就很好的实现了节点扩展。 但。。。。其实,在会产生一个小小的问题,我没有弄明白: 那是否需要重新FORMAT整个HDFS系统,还是说整个HADOOP方案在节点增加之后,啥都不用动? 因为我试着按指南重新格式化了HDFS,结果,所有的DATANODE无法正常启动了。 出错信息为: 2013-04-11 05:46:48,849 ERROR org.apache.hadoop.hdfs.server.datanode.DataNode: java.io.IOException: Incompatible namespaceIDs in /app/hadoop/tmp/dfs/data: namenode namespaceID = 966713409; datanode namespaceID = 1353306250 at org.apache.hadoop.hdfs.server.datanode.DataStorage.doTransition(DataStorage.java:232) at org.apache.hadoop.hdfs.server.datanode.DataStorage.recoverTransitionRead(DataStorage.java:147) at org.apache.hadoop.hdfs.server.datanode.DataNode.startDataNode(DataNode.java:399) at org.apache.hadoop.hdfs.server.datanode.DataNode.<init>(DataNode.java:309) at org.apache.hadoop.hdfs.server.datanode.DataNode.makeInstance(DataNode.java:1651) at org.apache.hadoop.hdfs.server.datanode.DataNode.instantiateDataNode(DataNode.java:1590) at org.apache.hadoop.hdfs.server.datanode.DataNode.createDataNode(DataNode.java:1608) at org.apache.hadoop.hdfs.server.datanode.DataNode.secureMain(DataNode.java:1734) at org.apache.hadoop.hdfs.server.datanode.DataNode.main(DataNode.java:1751) 明显的,是因为格式化了HDFS两次所致。在作第一个节点时namespaceIDs并没有消失,然后,又重新弄了一次。 解决方案是将两节点的app/hadoop/tmp/下的文件全DEL之后,重新格式化一次。就OK了。 ~~~~~~~~~~~ 网上说的,http://stackoverflow.com/questions/3425688/why-does-the-hadoop-incompatible-namespaceids-issue-happen Namenode generates new namespaceID every time you format HDFS. I think this is possibly to differentiate current version and previous version. You can always rollback to previous version if something is not proper which may not be possible if namespaceID is not unique for every formatted instance. NamespaceID also connects namenode and datanodes. Datanodes bind themselves to namenode through namespaceID 每次FORMAT都会产生一个新的NAMESPACEID。 看来。。。。在第一次格式化之后,以后的节点可以直接使用?

优秀的个人博客,低调大师

WorkBuddy场景案例|物联网·代码与数据分析双提效

物联网无线通信模组头部企业,产品覆盖 ESP32 系列 WiFi、蓝牙、Zigbee、LoRa 模组,服务数十万开发者,员工 50~200 人,设研发、销售、运营、客服团队。研发工程师编写模组 AT 指令示例与 SDK Demo,新模组文档与示例脱节,技术问题工单靠资深研发口头答;客服主管被重复问题频繁打断;运营经理周报从电商与社区多后台拼表数小时;销售经理库存交期跨系统核对、缺货月底才暴露。

优秀的个人博客,低调大师

JimuReport v2.5.4 发布,报表与大屏双端安全加固

项目介绍 真正的 AI 报表来了,一句话描述需求,AI 自动生成报表与数据大屏,支持对话式修改报表;同时提供类 Excel 拖拽设计器,兼容 30 余种数据源,轻松应对各类复杂报表场景 ✨ 积木报表是一款免费的数据可视化报表工具,集报表、打印、大屏、仪表盘于一体,像搭积木一样完全在线设计。分两大模块:JimuReport 主攻传统复杂报表与打印,JimuBI 专注数据大屏与仪表盘可视化。 AI 助手:全新版本 AI 助手,一句话生成报表和大屏、一句话添加组件、对话式修改配置,一句话需求即可产出专业可视化大屏,告别繁琐拖拽。 类 Excel 设计器:JimuReport 采用 Web 版拖拽设计、所见即所得,专注解决企业级各类复杂报表难题。 高级功能:分组 / 交叉 / 主子报表、多 Sheet 报表、数据钻取、一键打印、套打与发票打印、数据填报、移动端报表、二维码条码等一应俱全。 全场景覆盖:JimuBI 同时支持大屏、仪表盘、门户、移动端,一次开发、多端适配;大屏采用类 Word 风格,组件随意拖动,轻松设计炫酷大屏。 简单・易用・专业:极大降低报表开发难度,缩短开发周期,节省成本。 当前版本:v2.5.4 | 2026-09-23 ⚠️ 本次签名机制有重大变更,以下模块必须同步升级:积木报表 2.5.4 + 积木大屏 / 仪表盘 2.5.4 + 积木问数 1.2.0。三者的签名票据与数据源密码加密是同一套方案,只升其中一个会出现验签失败、数据源连不上等问题;未集成的模块可忽略。 依赖坐标 本次是配套升级,已集成的模块必须一起升级到上表的配套版本,只升其一会出现验签失败或数据源连不上。 一、JimuReport 报表模块 springboot3 <dependency> <groupId>org.jeecgframework.jimureport</groupId> <artifactId>jimureport-spring-boot3-starter</artifactId> <version>2.5.4</version> </dependency> springboot4 <dependency> <groupId>org.jeecgframework.jimureport</groupId> <artifactId>jimureport-spring-boot4-starter</artifactId> <version>2.5.4</version> </dependency> springboot2 <dependency> <groupId>org.jeecgframework.jimureport</groupId> <artifactId>jimureport-spring-boot-starter</artifactId> <version>2.5.4</version> </dependency> 二、JimuBI 大屏 / 仪表盘模块 springboot3 <dependency> <groupId>org.jeecgframework.jimureport</groupId> <artifactId>jimubi-spring-boot3-starter</artifactId> <version>2.5.4</version> </dependency> springboot4 <dependency> <groupId>org.jeecgframework.jimureport</groupId> <artifactId>jimubi-spring-boot4-starter</artifactId> <version>2.5.4</version> </dependency> 三、JimuChatBI 积木问数模块(已集成才需要) <!-- springboot4 --> <dependency> <groupId>org.jeecgframework.jimureport</groupId> <artifactId>jimuchatbi-spring-boot4-starter</artifactId> <version>1.2.0</version> </dependency> <!-- springboot3 --> <dependency> <groupId>org.jeecgframework.jimureport</groupId> <artifactId>jimuchatbi-spring-boot3-starter</artifactId> <version>1.2.0</version> </dependency> 升级日志 继 v2.5.3 之后,v2.5.4 是又一次以安全为核心的加固版本,覆盖 JimuReport 报表与 JimuBI 大屏 / 仪表盘两大模块:报表侧修复了多个可被利用的高危漏洞并收敛了设计器敏感接口的鉴权,大屏侧修复了数据集接口的越权访问问题,两端的签名密钥与数据源密码加密也完成了统一治理。由于漏洞影响严重,强烈建议所有用户第一时间升级到 v2.5.4,报表与大屏请同步升级。 一、积木报表(JimuReport) 安全加固 修复 H2 数据源相关的远程代码执行(RCE)漏洞(GHSA-9rh9-8rfj-ghr4) 收敛报表设计器敏感接口鉴权,修复解析、库表元数据、数据集保存、文件数据集、数据源查询等接口任意登录用户可调用的问题(GHSA-4m8w-84rv-mfmr) 修复登录用户经 SQL 数据集接口越权读取平台库系统表的问题(GHSA-4m8w-84rv-mfmr) 修复填报字典、用户、角色、部门、弹窗等接口的服务端请求伪造(SSRF)与凭据外发问题,并在保留免登录预览的前提下补充签名校验(GHSA-39f3-g3fc-cwvv) 修复 SQL 注入漏洞(GHSA-cxjx-4v5m-2vfx) 接口签名票据机制加固:修复自定义前缀或宿主自有 URL 部署时读不到票据导致签名校验失败的问题,并解决浏览器中新旧票据并存引发的校验异常 问题修复 修复自定义表头排序等场景下,中文字段名被误判为 SQL 注入导致功能不可用的问题(issues/4736) 内网地址访问校验改为独立开关 apiDsIpCheck 控制(默认关闭),避免自建 / 内网部署下报表调用同网络内部 API 被误拦截;白名单 apiDsIpWhite 新增支持按域名放行 拦截日志补充被拒绝的接口地址,便于定位具体触发拦截的接口 同步更新报表设计器前端 JS 资源 二、积木 BI(JimuBI 大屏 / 仪表盘) 安全加固 修复大屏数据集接口未授权数据访问(IDOR)与 SSRF 漏洞:恢复签名校验,补充租户与创建人归属校验防跨租户越权,并对外部接口增加协议白名单(GHSA-3c55-7mmf-x5f4) 大屏 / 仪表盘签名密钥不再明文下发页面,改为注入短期票据,并移除前端硬编码的默认密钥 新增签名票据获取接口,供敲敲云(NPM 包嵌入宿主)模式的前端使用,修复后台自定义签名密钥后该模式验签失败的问题 大屏数据源密码加密升级并与积木报表密钥治理对齐,支持自定义密钥 jeecg.jmreport.db-secret-key,密文与积木报表互通;兼容旧版存量密文,无需迁移 功能优化与问题修复 修复动态数据源并发建池与连接池泄漏导致内存溢出的问题 修复数据列表自定义脚本不生效的问题(issues/4768) 修复实际点位数据值小于辅助线固定值时,仍显示在辅助线之上的问题(issues/4778) 兼容积木报表新版加密规则,修复大屏连不上积木端加密数据源的问题 仪表盘功能升级 三、新增权限指令(升级必看) 本次收敛设计器敏感接口鉴权后,以下接口由「任意登录用户可调」改为需要显式授权。宿主系统请提前给相应角色配好权限,否则升级后设计器相关功能会返回无权限: 权限标识 对应功能 jmreport:design:parseField SQL / API / JavaBean 解析字段、Java 代码校验 jmreport:design:loadTable 库表列表与字段元数据读取 jmreport:design:saveDb 数据集保存 jmreport:design:filesDataset 文件数据集(上传、读取、删除、预览) jmreport:datasource:query 数据源查询与分页列表 jmreport:design:editEnhance 增强代码编辑 jmreport:category:completelyDelete 清空回收站 同时这些接口还增加了角色限制: 多数接口要求 admin、lowdeveloper、dbadeveloper 三者之一 增强代码编辑与清空回收站更严格,仅允许 admin、lowdeveloper 四、升级注意事项 报表 / 大屏 / 问数需同步升级:本次签名票据与数据源密码加密是各模块配套的统一治理(报表 2.5.4 + 大屏 2.5.4 + 问数 1.2.0),只升其中一个会出现验签失败或数据源连不上 票据机制调整:升级后用户首次访问会自动重新下发票据,无需清理浏览器缓存;前后端须同版本升级 内网访问校验开关:apiDsIpCheck 默认关闭以兼容内网部署,对公网暴露的环境建议按需开启,并用 apiDsIpWhite 配置放行域名 数据源密码密钥:jeecg.jmreport.db-secret-key 为可选配置,不配置时行为与旧版一致、存量密文自动兼容,生产环境建议显式配置 代码下载 https://github.com/jeecgboot/JimuReport 技术文档 快速集成:https://help.jimureport.com/quick.html 官方网站:http://jimureport.com 报表示例:http://jimureport.com/reportDemo 在线体验:http://jimureport.com/login 积木 Skills:https://jimureport.com/skills 为什么选择 JimuReport? 永久免费・AI 智能・全场景覆盖 —— 一句话生成报表,类 Excel 拖拽设计,30+ 数据源、复杂报表、精准打印、数据填报、大屏仪表盘一应俱全,低代码时代的报表首选! 快速集成:采用 SpringBoot 脚手架项目,可快速集成到现有系统。 AI 赋能:内置 AI 助手(AI 报表 / 大屏),一句话或一张截图,自动生成复杂报表和炫酷大屏。 类 Excel 设计器:Web 拖拽设计、所见即所得,支持多 Sheet、无限行列、冻结窗口,以及 SUMIFS / VLOOKUP / IF 等报表函数与表达式自动合计。 复杂报表:分组、交叉、主子、明细、多表头、数据钻取、预警、条件查询、二维码 / 条形码报表全覆盖。 数据联动与大数据:兼容 30+ 数据源(MySQL、Oracle、达梦、人大金仓,及 Hive、ClickHouse、Doris、ES、MongoDB、文件 / 多文件等),支持 SQL / API / JSON / WebSocket 多源绑定与图表联动下钻。 信创国产化:全面适配达梦、人大金仓、神通、华为高斯等国产数据库,可运行于麒麟、统信 UOS 等国产操作系统,助力国产化替代。 精准打印与填报:套打、背景打印,发票、证照无缝打印;在线填报回写数据库;支持导出 Excel / PDF / Word / 图片。 大屏与仪表盘:ECharts 28+ 图表,类 Word 风格拖拽大屏,24 列栅格仪表盘,搭配门户业务看板。 移动端全场景:报表、大屏、仪表盘一次开发,PC / 移动 / 大屏 / 门户多端适配。 开源替代:DataV、帆软的高性价比开源替代方案。 报表设计效果 积木 BI 工作台 大屏设计效果 BI 大屏高级效果 一、点击详情时,弹出另外一个大屏列表页 全屏弹框 自适应弹框 二、5 分钟自动切换下一个,炫酷的动态切换效果 三、通过高德地图实现,结合业务数据,展示车辆实时位置

优秀的个人博客,低调大师

腾讯元宝任务功能上线,支持双端设置定时提醒

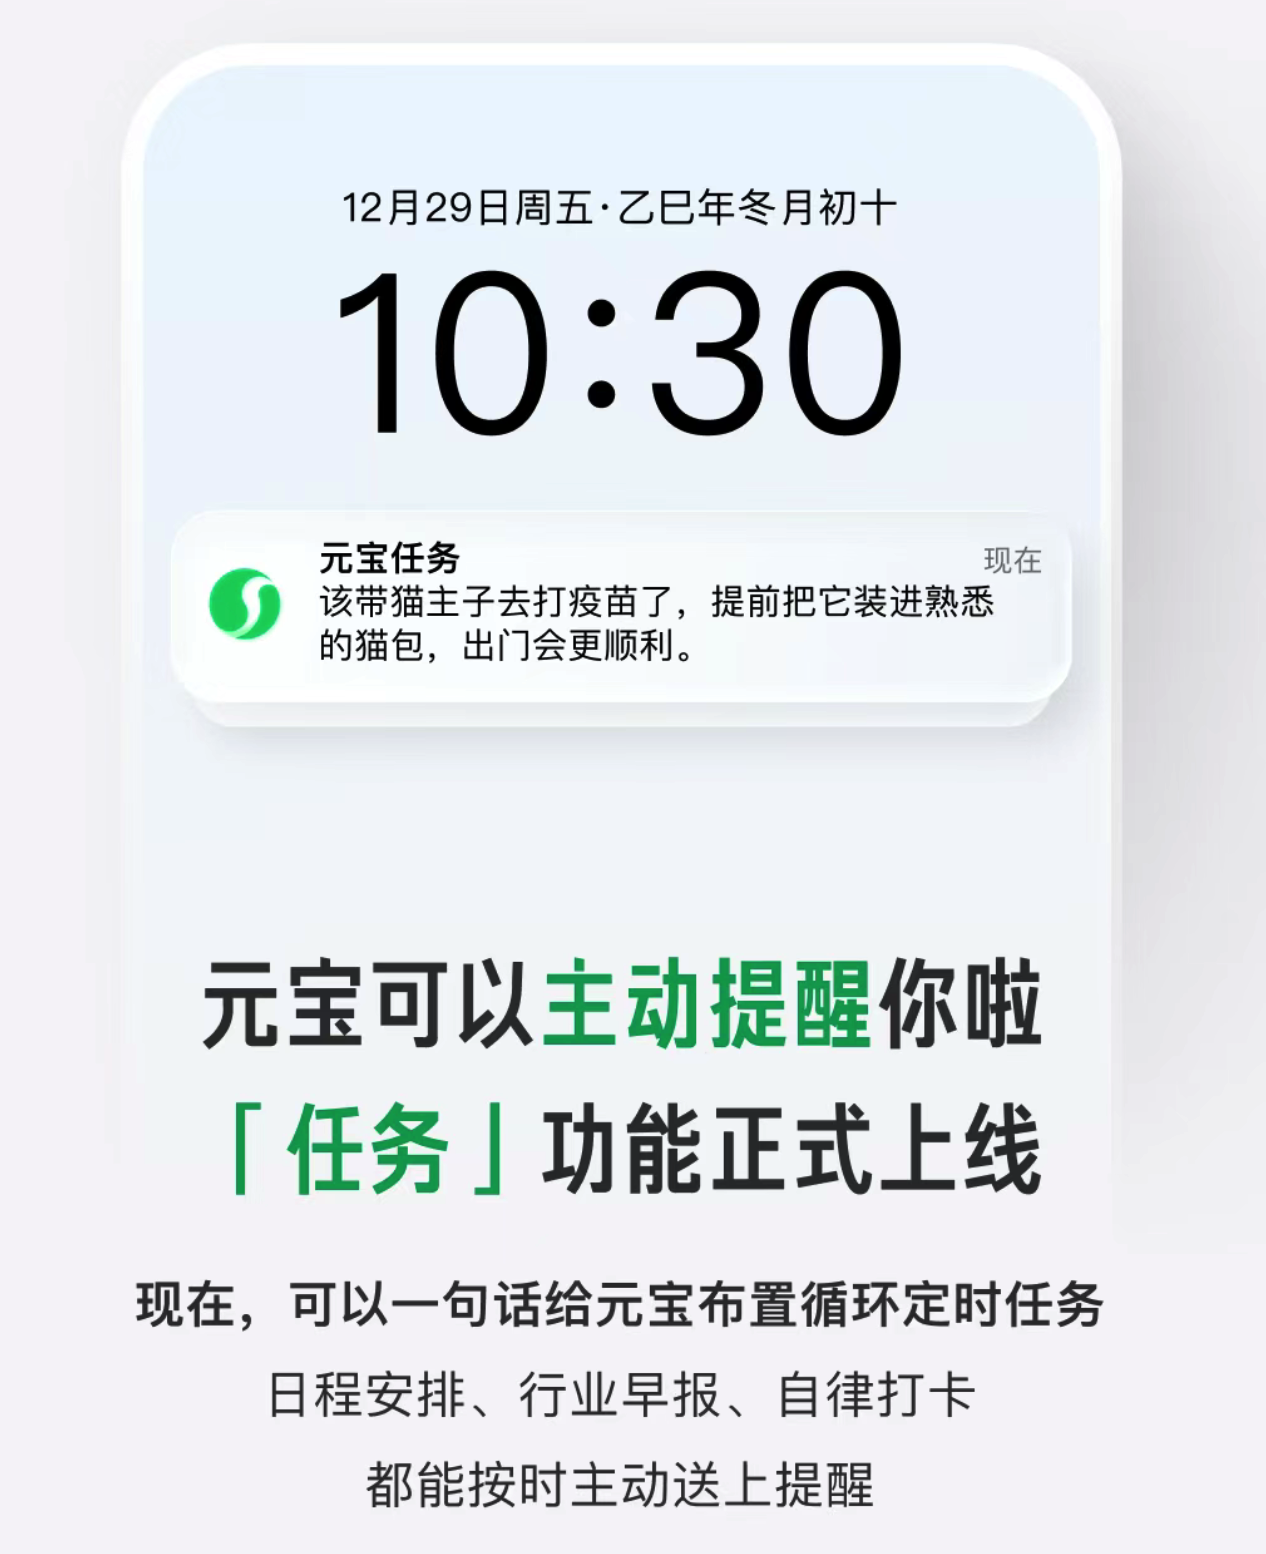
腾讯元宝正式宣布推出任务功能,APP 及电脑版更新后,用户可通过一句话设置循环定时任务。 该功能覆盖生活琐事、习惯养成、职场工作、亲子互动等多场景,包括宠物驱虫提醒、睡前故事推送、周报撰写辅助、行业新闻推送、待办清单整理等。 除基础提醒外,还提供延伸服务,如健康食谱推荐、助眠歌单分享、健身视频教程查询等,支持任务测试、手动管理与自定义设置,提醒后可继续互动交流。 用户可按需设置每日、每周、每月循环任务,轻松打理日程安排与各类计划。

优秀的个人博客,低调大师

火山引擎发布豆包语音模型2.0,实现语义与情感双突破

火山引擎正式推出豆包语音合成模型2.0(Doubao-Seed-TTS 2.0)与声音复刻模型2.0(Doubao-Seed-ICL 2.0),依托豆包大语言模型全新架构,实现语音从“文本朗读”到“理解式情感表达”的跨越。 此次升级核心在于深度语义与上下文理解能力的突破。语音合成模型可覆盖多轮对话语境,精准呈现语气、停顿与情绪变化,支持语速、声线等指令的精细化控制;声音复刻模型在秒级还原声线基础上,新增情感演绎能力,可适配小说配音、对话交互等多场景。 针对教育场景专项优化后,模型对小初高全学科复杂公式符号的朗读准确率达90%,远超行业平均水平。目前两款模型已上线火山引擎语音控台,服务OPPO、洋葱学园等客户,覆盖对话助手、教育辅助等多元场景。

优秀的个人博客,低调大师

豆包语音合成模型 2.0 升级,语义理解+情感演绎双突破

火山引擎宣布升级豆包语音合成模型2.0(Doubao-Seed-TTS 2.0)和豆包声音复刻模型2.0(Doubao-Seed-ICL 2.0)。此次升级基于豆包大语言模型研发语音合成新架构,让合成和复刻的声音都能解锁深度语义理解和上下文理解能力,从单纯的文本朗读进化为“理解后的精准情感表达”。 此外2.0模型针对教育场景专项优化,使得全科复杂公式符号的合成平均准确率高达90%左右。 公告称,对话式合成让豆包语音合成模型2.0像是一位会思考的“演绎者”,让声音具备深度语义理解能力,并进一步将理解范围从给定文本扩大到多轮对话,理解包括:对话中的用户 Query、明确的自然语音指令,以及描述性的内心活动、背景信息、细腻情感等,让 AI 语音从“听得清”转变到“懂语义知语境”的情感式表达。 对话式语音合成具备3大核心优势: 更强的互动拟人感:精准呈现与场景匹配的语气、语调、停顿等,让交互充满真实人际沟通的自然感。 更饱满的情感演绎:深度理解文字背后的情绪延续与变化,让声音的情绪承接更饱满连贯。 更精准的指令遵循:实现语速、情绪、声线、风格、音调的精准指令控制,提升语音表现可控性。 豆包声音复刻模型2.0同样具有深度语义理解能力,在语音交互、小说配音、播客对话等场景中具备更强的声音表现力。 此外,豆包语音合成模型2.0和豆包声音复刻模型2.0提升了学科教育场景下复杂公式符号的朗读表现,针对教育场景进行数据增广与模型优化,涵盖单位、函数、幂数、面积、化合物、复分解等上百种类,经过大量客户真实场景的复杂公式评测集测试验证,在小学至高中全学科(数学、英语、化学、物理、地理、生物)的复杂公式符号朗读任务中,平均准确率达90%左右。

优秀的个人博客,低调大师

OCAI + DeepSeek 满血版双 buff 加成,OS 运维从此告别焦虑

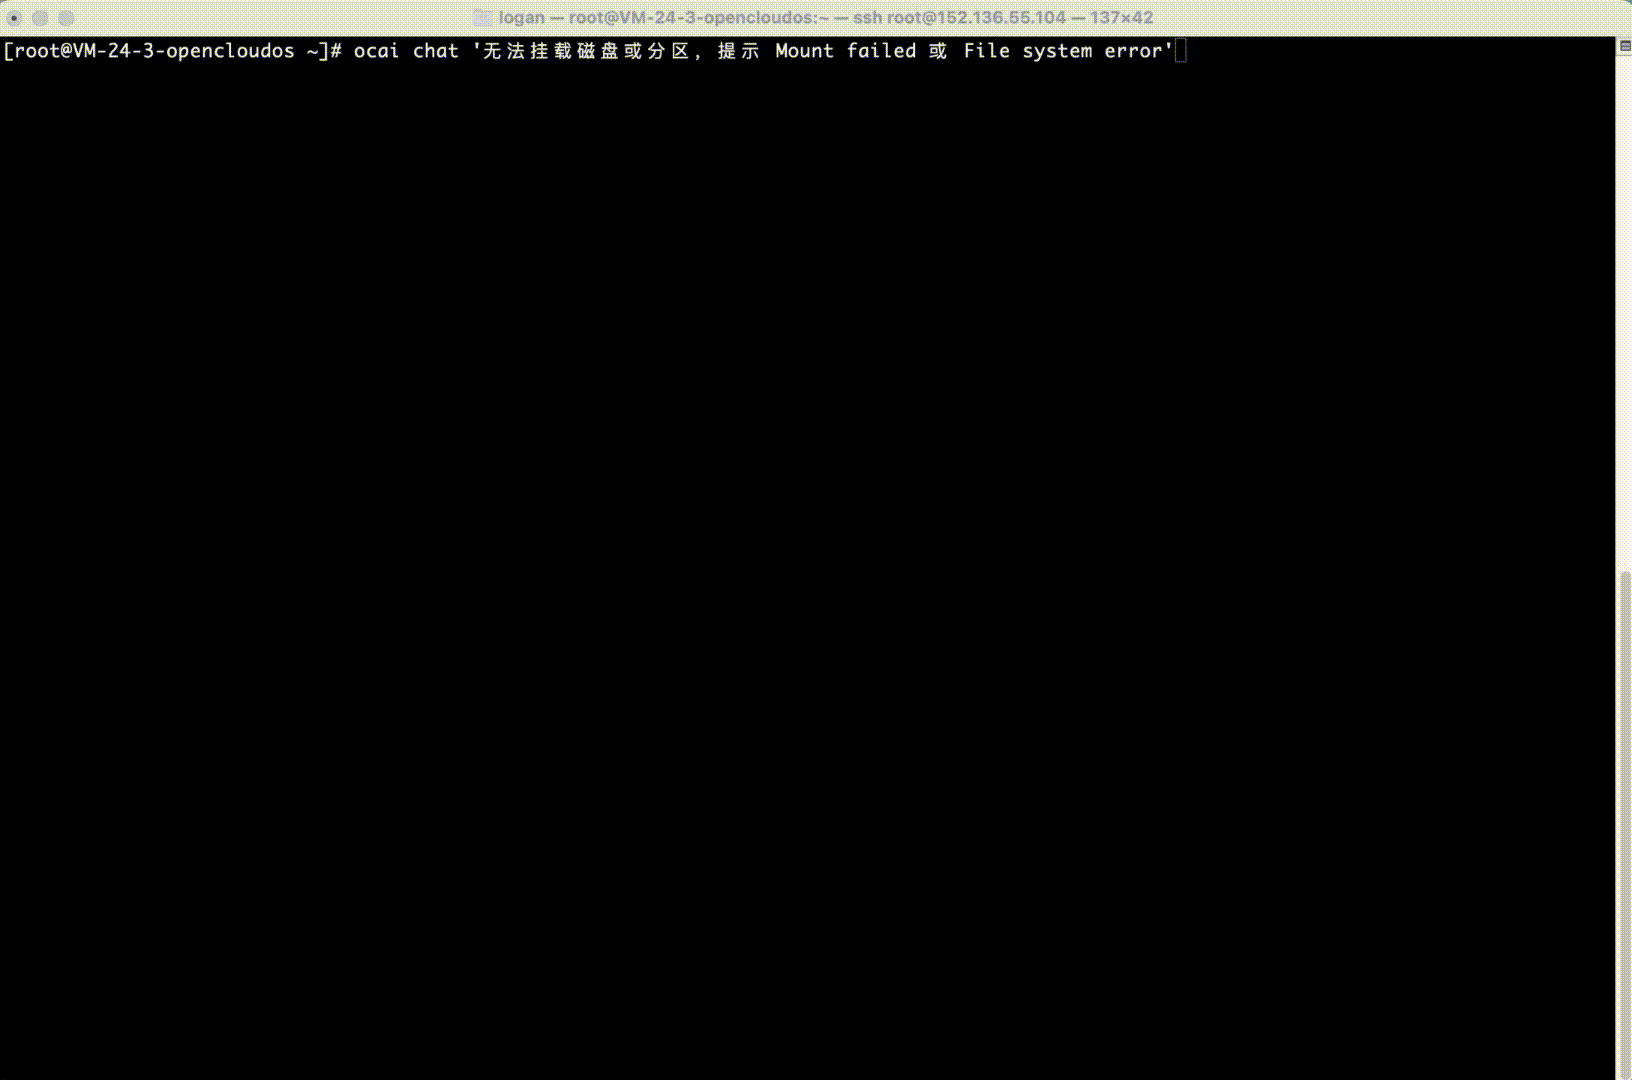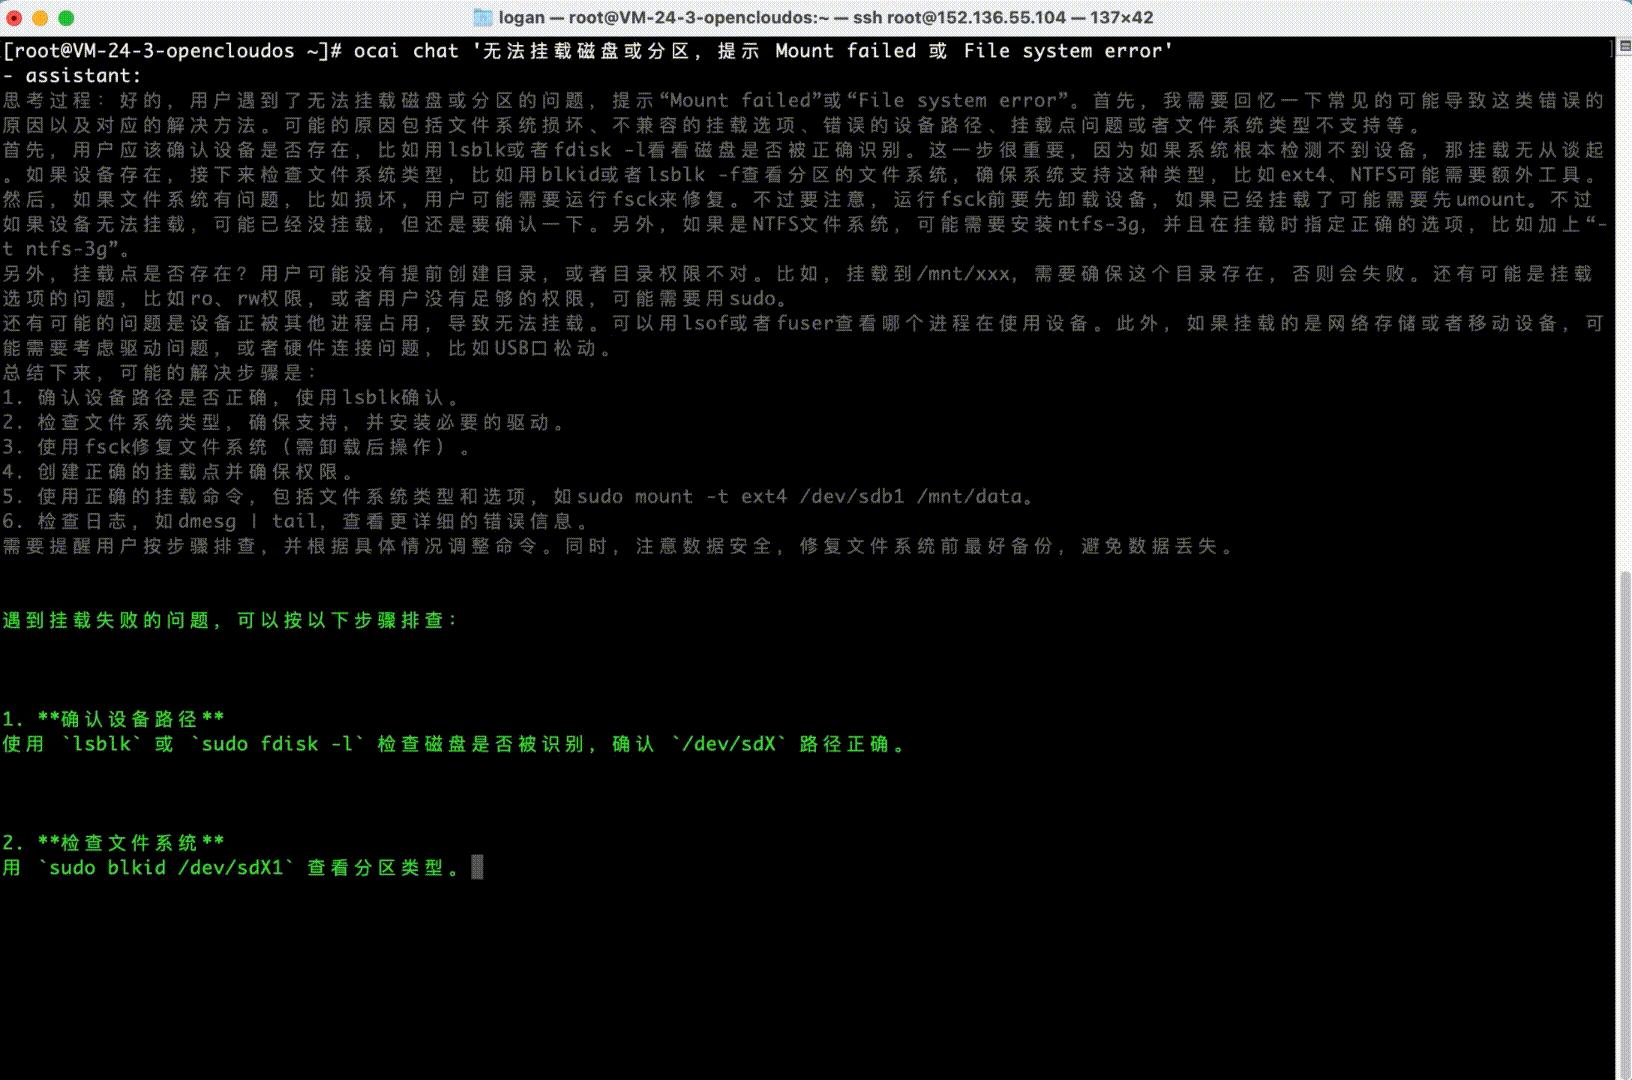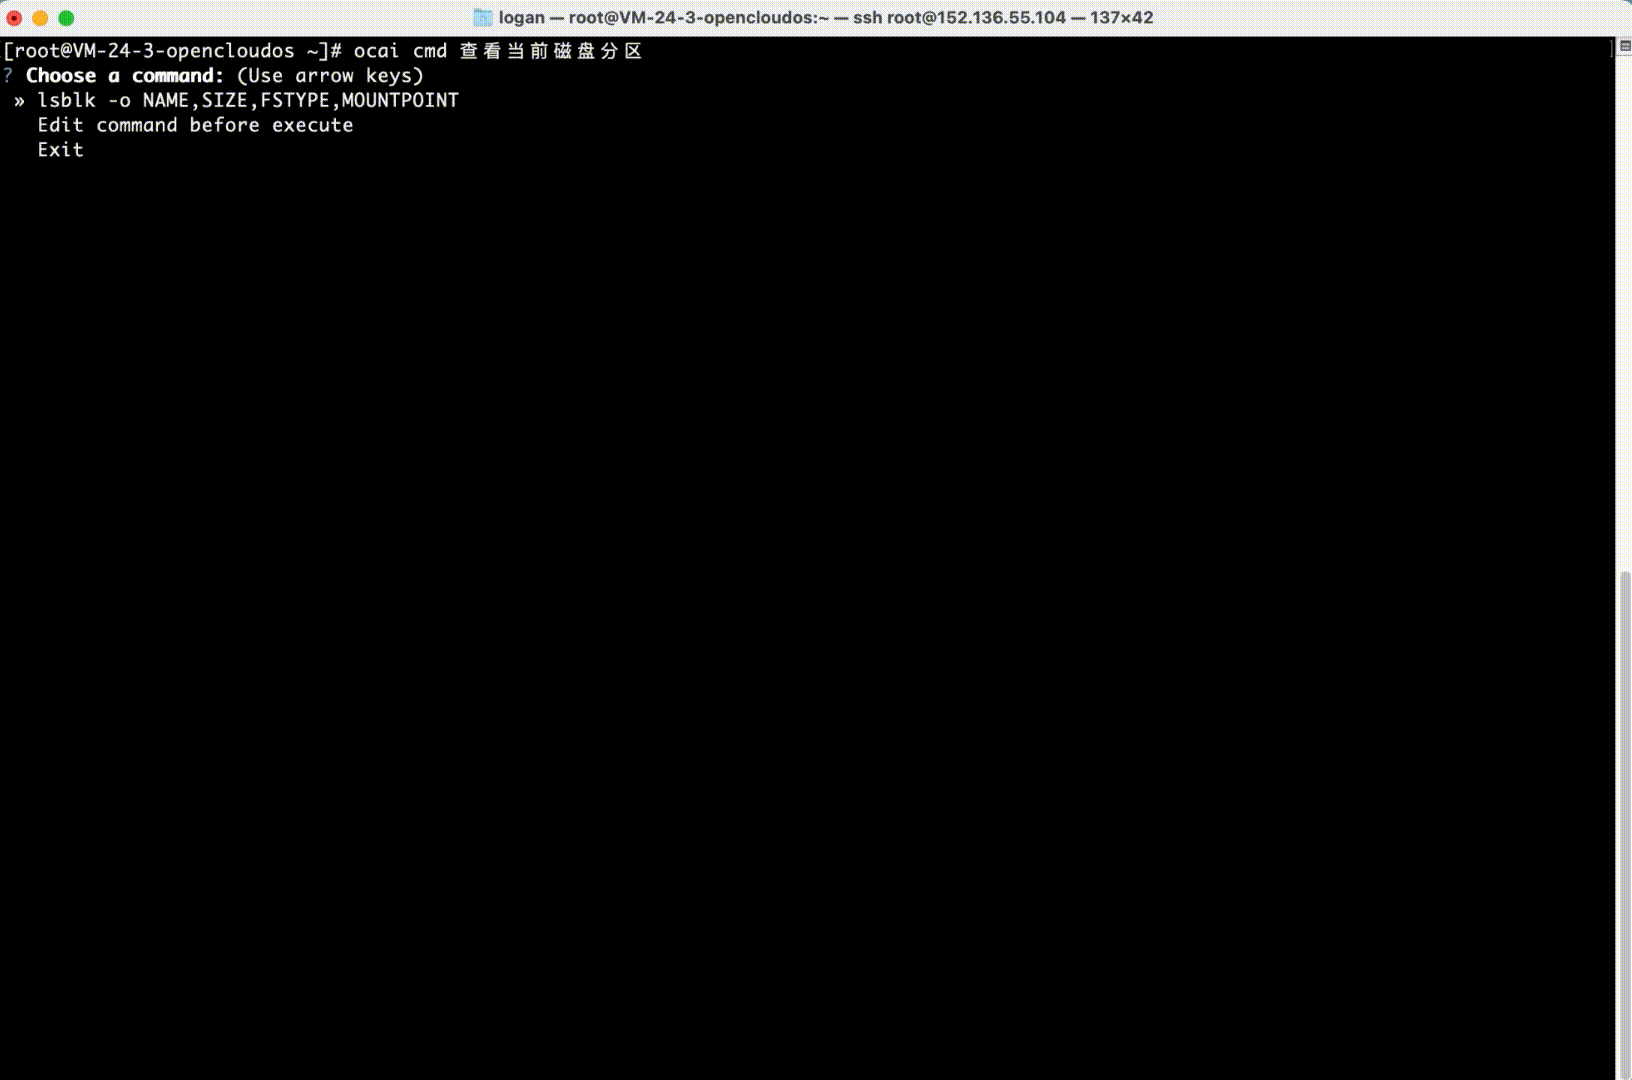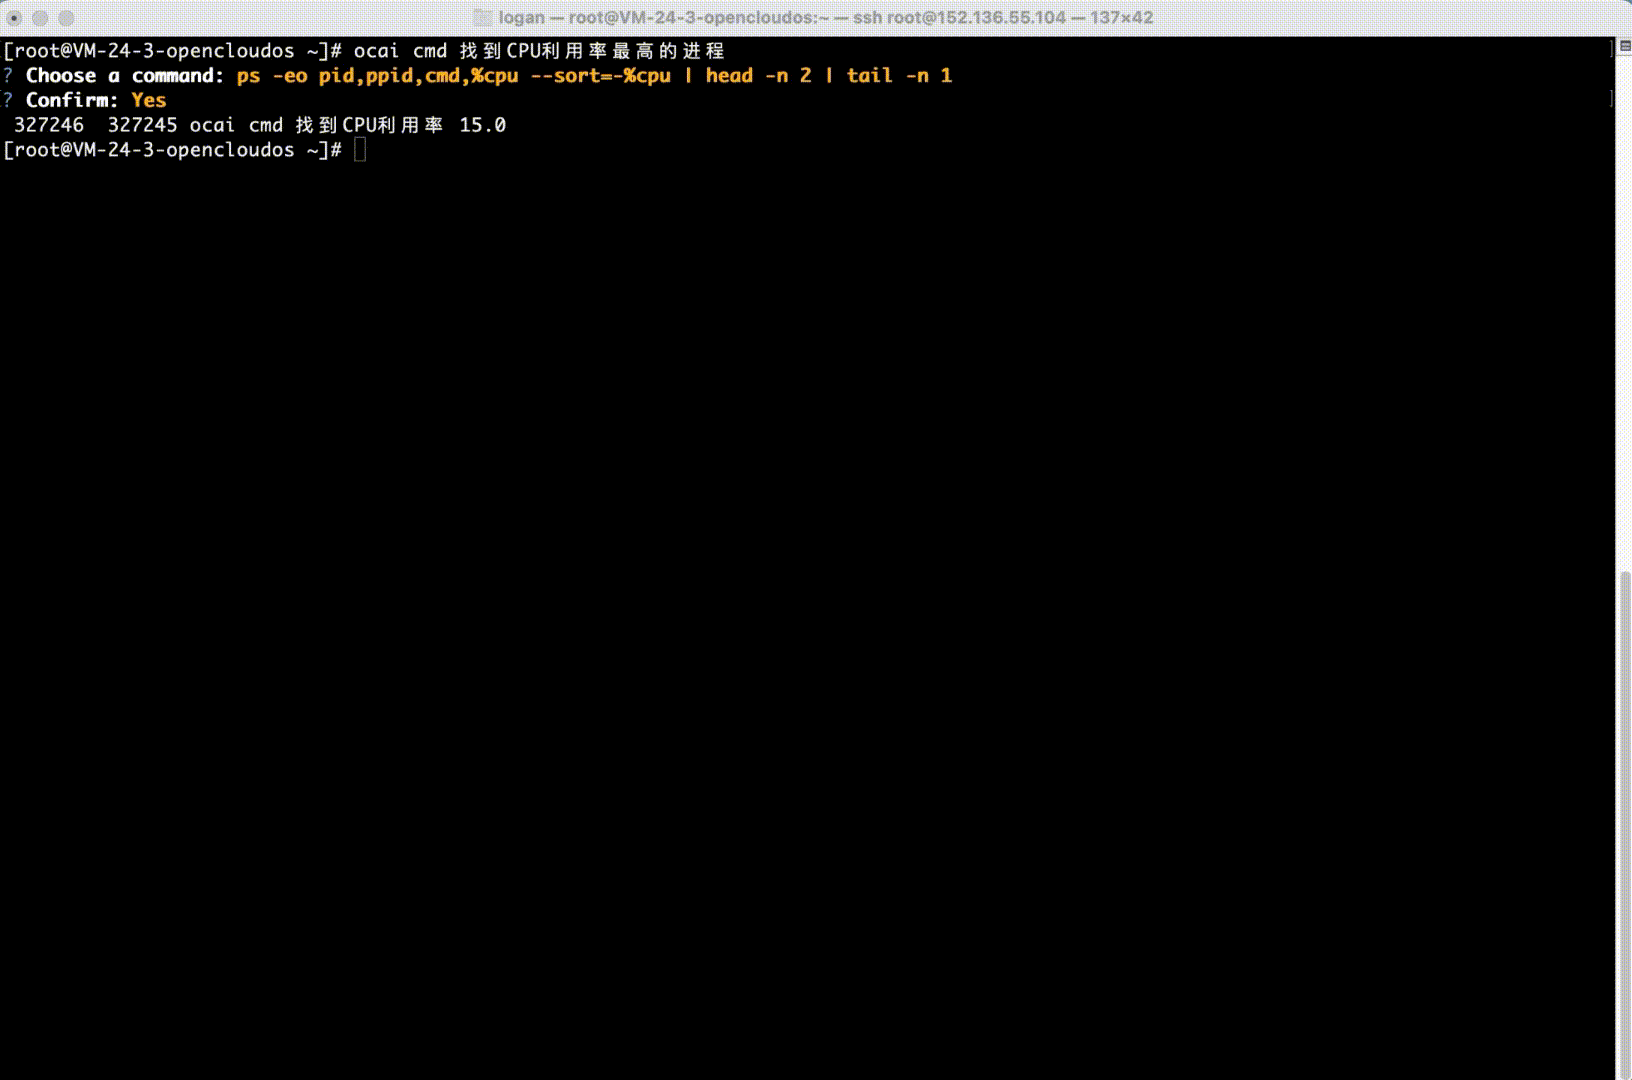
作者丨黄敏杰、李强 编辑丨cherry 审稿丨林青、郑力博 当遇到忘记的Shell命令参数,你是否还在使用“xxxx --help”查询使用帮助?当你遇到OS的疑难问题,是否还在全网苦苦搜索解决方案?今天,OpenCloudOS 社区重磅推出新一代OS智能助手OCAI-Agent,它集代码生成、场景化指南输出于一体,通过接入满血版 DeepSeek R1模型,让你通过简单的中文指令,即可实现秒级AI Agent调用。 一、OCAI工具概览 很多OS运维工程师常陷于「文档迷宫」:面对上千页的官方手册、散落全网的技术贴、版本迭代带来的参数变更,每一次故障排查都可能演变成耗时数小时的文档检索工程。但 OCAI 的诞生,可能一切都变了…… 先看一下这个,好像小白也可以实现对OS的运维: (划至文章底部可查看未加速操作版) 目前,OCAI已接入满血版 DeepSeek R1 模型,并将OpenCloudOS全量文档、社区运维案例、Gitee技术方案等异构数据,经向量化处理后形成动态知识图谱。 也就是说,针对OpenCloudOS的使用、运维管理操作等场景,OCAI可以帮为用户总结提炼并生成具体场景下的使用指南、命令、甚至代码,从而实现极大程度上的智能提效。 OCAI当前版本主要分为三种模式: Chat模式:通过提问,开始调用OCAI问答系统,并让系统进入思考、推理及结果输出过程。 Cmd模式:直接执行的Shell命令,并根据用户指示执行相应任务。 Code模式:生成执行代码。 1、Chat模式 安装完成并使配置生效后,在命令窗口中直接输入相关问题,无需加入任何命令前缀,即可方便调用OCAI智能助手的问答能力。 也可通过ocai chat <question>命令形式对问答能力进行调用。 2、Cmd模式 Cmd模式支持根据用户指示生成可直接执行的Shell命令,用户确认后可立即执行获取结果。 3、Code模式 Code模式下支持根据用户指示生成不同编程语言下的代码。 二、OCAI背后的技术实现原理 当前 OCAI 智能助手针对不同场景设计了多个 Agent 分别处理请求,采用RAG方式导入OpenCloudOS特有知识库信息,通过OCAI-Service与客户端进行交互,使用不同的底座模型对数据进行推理、总结和润色,最终输出给用户。 1、多Agents编排 OCAI智能助手针对不同场景和数据源创建了多个不同的 Agents,每个Agent负责特定的一个领域的处理逻辑(如对话、命令生成、代码生成),并通过指定逻辑将多个Agents组合编排,从而使使用入口得以统一,多个Agents可以协同工作。 2、RAG 针对通用模型缺少特定领域知识的情况,OCAI智能助手采用 RAG(Retrieval Augmented Generation) 方式,将特定领域的知识库(如 OpenCloudOS 文档库)数据进行处理清洗和切分后,计算成向量形式并存入向量数据库。用户提问将先从向量数据库中检索出相关程度较高的资料,再统一拼接成 prompt 提交给大模型进行总结和回答。 3、OCAI-Service OCAI-Service 是OCAI智能助手的接口层服务。在直接提供服务调用接口的同时,还支持了上下文管理、接口转发、用户识别、身份鉴权、配置管理、反馈收集、统计日志等真实使用情况下必不可少的基础能力。 OCAI-Service 也为多模型选择及函数调用提供了通道。 4、底座模型 OCAI智能助手在处理逻辑的各个阶段使用了 DeepSeek 和混元的各类大模型,包括但不限于 DeepSeek-R1、DeepSeek-V3、混元T1、混元Turbo等。 三、如何使用 当前 OCAI-Agent RPM包已在OpenCloudOS 8/9 软件源上线,使用上述版本的用户可直接执行yum install ocai-agent先进行安装。 RPM包安装链接: OC9:https://mirrors.opencloudos.tech/opencloudos/9.2/AppStream/x86_64/os/Packages/ocai-agent-1.0.0-2.oc9.x86_64.rpm OC8:https://mirrors.opencloudos.tech/opencloudos/8.10/Extras/x86_64/os/Packages/ocai-agent-1.0.0-2.oc8.x86_64.rpm 完成安装后,请在该网址(https://opencloudos.org/ospages/learnmore/ocai)内输入您的邮箱进行注册,并按照邮件中的指引配置访问密钥,即可开始使用。 为了确保服务的稳定性,OCAI-Agent 每天最多可调用 50 次。请合理安排您的使用频率,以免达到调用上限。如有更多需求,请关注后续更新或联系我们获取帮助。感谢您的理解与支持! OpenCloudOS 开源社区是由操作系统、云平台、软硬件厂商与个人携手打造中立开放、安全稳定且高性能的 Linux 操作系统及生态。欢迎上下游厂商、高校及组织加入社区,共建开放共享的安全生态。 扫码添加社区助手进群,添加时备注「OCAI」

优秀的个人博客,低调大师

一文教会你mock(Mockito和PowerMock双剑合璧)

作者:京东物流 杨建民 1.什么是Mock Mock有模仿、伪造的含义。Mock测试就是在测试过程中,对于某些不容易构造或者不容易获取的对象,用一个虚拟的对象来创建以便测试的测试方法。mock工具使用范畴: 真实对象具有不确定的行为,产生不可预测的效果。 真实对象很难被创建。 真实对象的某些行为很难被触发。 真实对象实际上还不存在。 MockIto和PowerMock是众多Mock框架中的两种,类似的还有:JMock,EasyMock,大多 Java Mock 库如 EasyMock 或 JMock 都是 expect-run-verify (期望-运行-验证)方式,而 Mockito 则使用更简单,更直观的方法:在执行后的互动中提问。使用 Mockito,你可以验证任何你想要的。而那些使用 expect-run-verify 方式的库,你常常被迫查看无关的交互。非 expect-run-verify 方式 也意味着,Mockito无需准备昂贵的前期启动。他们的目标是透明的,让开发人员专注于测试选定的行为。 2.解决的问题 我们在写单元测试时,总会遇到类似这些问题: 1.构造的入参,对于极值、异常边界场景不好复现,相关的逻辑测不到,只能依靠测试环境或预发跑,运气不好可能要改好几次代码重启机器验证,费时费力; 2.依赖别人接口,可能需要别人协助测试环境数据库插数才能跑通; 3.依赖的别人的接口还没有开发完,为了不影响提测,如何完成单元测试? 4.编写的单元测试依赖测试数据库的数据,每次跑都要数据库改数? 5.对service层加了逻辑,跑单元测试本地验证的时候,由于种种原因,本地环境跑不起来,折腾半天跑起来验证完了,下次开发需求又遇到了另一个问题本地环境启动报错??? 6.我就想dubug到某一行代码,但是逻辑复杂,东拼西凑的参数就是走不到,自己看代码逻辑还要去问别人接口的返回值逻辑??(未完待续……)引入Mockito和PowerMock使得编写单元测试更轻松,更省时,更省力。 3.如何解决问题 3.1 使用mock的意义 简单说就是无论谁的本地环境,无论判断条件多么苛刻,无论本地数据库的测试数据被谁删了改了,无论别人接口的返回值逻辑多复杂,无论自己代码逻辑多复杂,都能独立的、可重复执行的、行级别覆盖的单元测试用例。 ​3.2 Mockito和PowerMock 一句话说Mockito和PowerMock。当所测逻辑里有静态工具类方法或私有方法我们希望他返回特定值时(极值边界、异常测试场景),我们要用到PowerMock去弥补Mockito的不足,除此之外,用Mockito去写单测能完成我们日常任务95%的场景。 3.3 使用Mcokito和PowerMock的最佳实践 3.3.1 引入pom文件 3.3.2 Mockito和PowerMock 两条通用语法 打桩: when(XXxService.xxMethod("期望入参")).thenReturn("期望出参");验证:verify(XXxService).xxMethod("期望入参"); 4.举例说明 4.1 SpringBoot项目下Mockito和PowerMock最佳实践 classes: 指定要加载的类 properties: 指定要设置属性 @InjectMocks: 需要注入mock对象的Bean @MockBean或@Mock: 需要mock的Bean import X; import org.junit.Test; import org.junit.runner.RunWith; import org.mockito.InjectMocks; import org.mockito.MockitoAnnotations; import org.powermock.api.mockito.PowerMockito; import org.powermock.core.classloader.annotations.PowerMockIgnore; import org.powermock.core.classloader.annotations.PrepareForTest; import org.powermock.modules.junit4.PowerMockRunner; /** * 测试类A,调用服务B和一个静态工具类X */ @RunWith(PowerMockRunner.class) @SpringBootTest(classes = { A.class }) @PowerMockIgnore({"javax.management.*"}) @PrepareForTest({X.class}) //mock 静态方法 public class ATest { @InjectMocks private A a; @Mock private B b; @Before public void setUp() throws Exception { MockitoAnnotations.initMocks(this); } @Test public void Test() { when(b.someMethodB(any())).thenReturn(someThingB()); a.someMethodA(someThingA1(), someThingA2()); verify(b).someMethodB(any()); } /** * 异常边界测试 */ @Test public void test_ExceptionTest() throws ParseException { PowerMockito.mockStatic(X.class); // 模拟异常抛出的场景 when(X.strToDate(anyString(), anyString())).thenThrow(ParseException.class); when(X.convertLocalDateTime(any())).thenReturn(someThing()); when(b.someMethodB(any())).thenReturn(someThingB()); a.someThingA(someThingA1(), someThingA2()); verify(b).someMethodB(any()); } ​优雅的mock可以考虑@spy,当然,mockito还有一些特性可以自行学习如: 5.遇到的一些问题及解决 打桩逻辑判断是通过equals方法判断的 测试的预期是抛出异常直接在注解上加:@Test(expected=BusException.class) 模拟的参数为null:Mockito.isNull() PowerMock mock静态和私有final会有一些格式区别 PowerMockmock静态方法时也可以使用spy的方式使代码更优雅 mock中发现,mock没有生效,可以尝试升级Mockito版本解决,另外与junit反射工具类结合使用,效果更佳。 涉及多层嵌套的使用场景,读者先思考”单元“选取是否合理,多层嵌套场景将@InjectMocks和@Spy(或@Mock)联合使用即可 结束语: 文章写于早些时候,目前有些较新技术涌入,如:Spock、TestableMock等,但上述技术依然适用于大型系统质量内建,读者可根据自身情况选择性选用。​

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册