AutoMQ 生态集成 CubeFS
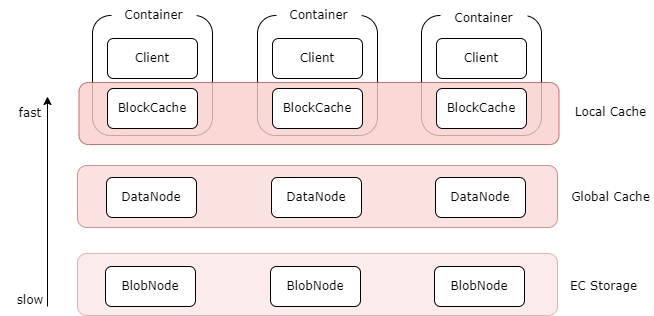
CubeFS [1] 是新一代云原生存储产品,目前是云原生计算基金会 CNCF托管的孵化阶段开源项目, 兼容 S3、POSIX、HDFS 等多种访问协议,支持多副本与纠删码两种存储引擎,为用户提供多租户、 多 AZ 部署以及跨区域复制等多种特性,广泛应用于大数据、AI、容器平台、数据库、中间件存算分离、数据共享以及数据保护等场景。 CubeFS的多级缓存[2] AutoMQ 创新的共享存储架构需要低成本的对象存储,而 CubeFS 支持 S3 兼容接口,其中 ObjectNode 提供兼容 S3 的对象存储接口来操作 CubeFS 中的文件,因此可以使用 S3Browser、S3Cmd 等开源工具或者原生的 Amazon S3 SDK 操作 CubeFS 中的文件。因此对于 AutoMQ 具有很好的适配性。因此你可以部署 AutoMQ 集群来获得一个与 Kafka 完全兼容,但是具备更好成本效益、极致弹性、个位数毫秒延迟的流系统。 本文将介绍如何将 AutoMQ 集群部署到您私有数据中心的 CubeFS 上。 01 前置条件 1.1 准备 CubeFS 集群 一个可用的 CubeFS 环境。如果您还没有 CubeFS 环境,可以参考官方文档进行依赖配置 [3] 以及搭建 CubeFS 基础集群 [4] 。 CubeFS 默认的安装包下的 build/bin 目录提供了一系列管理集群的命令行工具。本文中也将使用这些命令行工具做一些额外配置。通过 CubeFS 命令行工具查看集群状态,验证是否搭建成功: # 执行命令 ./build/bin/cfs-cli cluster info # 结果输出 [Cluster] Cluster name : cfs_dev Master leader : 172.16.1.101:17010 Master-1 : 172.16.1.101:17010 Master-2 : 172.16.1.102:17010 Master-3 : 172.16.1.103:17010 Auto allocate : Enabled MetaNode count (active/total) : 4/4 MetaNode used : 0 GB MetaNode available : 21 GB MetaNode total : 21 GB DataNode count (active/total) : 4/4 DataNode used : 44 GB DataNode available : 191 GB DataNode total : 235 GB Volume count : 2 ... 注意:这里的 CubeFS 集群的 master 节点的 ip 和端口将在接下来的对象网关配置中使用。 1.2 启用对象网关 为了让 CubeFS 支持对象存储协议,您需要开启对象网关 [5]。对象网关的作用在于,它提供了与 S3 兼容的对象存储接口,这使得 CubeFS 不仅能够支持传统的 POSIX 文件系统接口,还能够支持 S3 兼容的对象存储接口。通过这种方式,CubeFS 能够融合这两种通用类型接口的优势,进而为用户提供更为灵活的数据存储及访问方案。具体而言,开启对象网关后,用户便可以利用原生的 Amazon S3 SDK 来操作存储在 CubeFS 中的文件,从而享受到对象存储的便利性。 为了启动对象网关,首先需要在 CubeFS 根目录下创建 objectnode.json 配置文件,objectnode.json 配置文件示例内容如下: { "role": "objectnode", "listen": "17410", "domains": [ "object.cfs.local" ], "logDir": "/cfs/Logs/objectnode", "logLevel": "info", "masterAddr": [ "172.16.1.101:17010", "172.16.1.102:17010", "172.16.1.103:17010" ], "exporterPort": 9503, "prof": "7013" } 注意:此处的 masterAddr 的 ip 和端口信息可以从上一步的 CubeFS 集群信息中获取。 然后使用以下命令启动对象网关: nohup ./build/bin/cfs-server -c objectnode.json & 1.3 创建 CubeFS 用户 创建 CubeFS 用户,并查询得到 AccessKey 以及 Secret AccessKey 等信息。 可以参考用户管理文档 [6] 进行创建并查询对应用户的信息。 CubeFS 支持多种创建方式,比如可以通过 AWS SDK [7] 的方式进行创建或者 HTTP 请求的方式创建,这里我们将演示通过 HTTP 请求的方式进行创建: 指定用户id,密码以及 type,并请求创建接口: curl -H "Content-Type:application/json" -X POST --data '{"id":"automq","pwd":"12345","type":3}' "http://172.16.1.101:17010/user/create" 通过用户 ID 查询用户信息: curl -v "http://10.196.59.198:17010/user/info?user=automq" | python -m json.tool 响应示例 { "user_id": "automq", "access_key": "UZONf5FF6WKwFCj4", "secret_key": "TRZzfPitQkxOLXqPhKMBRrDYUyXXMpWG", "policy": { "own_vols": ["vol1"], "authorized_vols": { "ltptest": [ "perm:builtin:ReadOnly", "perm:custom:PutObjectAction" ] } }, "user_type": 3, "create_time": "2024-06-06 09:25:04" } 1.4 使用 S3 接口创建 Bucket 使用 aws cli 工具在 CubeFS 上创建需要的 bucket 以用于 AutoMQ 的集群部署。拿到用户的 key 等信息,通过 aws configure 进行配置,并使用 aws cli 工具进行 bucket 的创建。 aws s3api create-bucket --bucket automq-data --endpoint=http://127.16.1.101:17140 aws s3api create-bucket --bucket automq-ops --endpoint=http://127.16.1.101:17140 使用命令查看已经有的 bucket aws s3 ls --endpoint=http://172.16.1.101:17140 1.5 准备部署 AutoMQ 所需的机器 准备 5 台主机用于部署 AutoMQ 集群。建议选择 2 核 16GB 内存的 Linux amd64 主机,并准备两个虚拟存储卷。示例如下: Tips:请确保这些机器处于相同的网段,可以互相通信非生产环境也可以只部署 1 台 Controller,默认情况下该 Controller 也同时作为 Broker 角色 从 AutoMQ Github Releases 下载最新的正式二进制安装包,用于安装 AutoMQ。 02 安装并启动 AutoMQ 集群 配置S3 URL 第一步:生成 S3 URL AutoMQ 提供了 automq-kafka-admin.sh 工具,用于快速启动 AutoMQ。只需提供包含所需 S3 接入点和身份认证信息的 S3 URL,即可一键启动 AutoMQ,无需手动生成集群 ID 或进行存储格式化等操作。 ### 命令行使用示例 bin/automq-kafka-admin.sh generate-s3-url \ --s3-access-key=xxx \ --s3-secret-key=yyy \ --s3-region=cn-northwest-1 \ --s3-endpoint=s3.cn-northwest-1.amazonaws.com.cn \ --s3-data-bucket=automq-data \ --s3-ops-bucket=automq-ops 如果遇到报错,请注意验证参数正确性以及格式。 当使用 CubeFS 时,可以采用如下的配置来生成具体的 S3URL。 输出结果 执行该命令后,将自动按以下阶段进行: 根据提供的 accessKey 和 secret Key 对 S3 基本功能进行探测,以验证 AutoMQ 和 S3 的兼容性。 根据身份信息,接入点信息生成 s3url。 根据 s3url 获取启动 AutoMQ 的命令示例。在命令中,将 --controller-list 和 --broker-list 替换为实际需要部署的 CONTROLLER 和 BROKER。 执行结果示例如下: ############ Ping s3 ######################## [ OK ] Write s3 object [ OK ] Read s3 object [ OK ] Delete s3 object [ OK ] Write s3 object [ OK ] Upload s3 multipart object [ OK ] Read s3 multipart object [ OK ] Delete s3 object ############ String of s3url ################ Your s3url is: s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=xxx&s3-secret-key=yyy&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA ############ Usage of s3url ################ To start AutoMQ, generate the start commandline using s3url. bin/automq-kafka-admin.sh generate-start-command \ --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" \ --controller-list="192.168.0.1:9093;192.168.0.2:9093;192.168.0.3:9093" \ --broker-list="192.168.0.4:9092;192.168.0.5:9092" TIPS: Please replace the controller-list and broker-list with your actual IP addresses. 第 2 步:生成启动命令列表 将上一步生成的命令中的 --controller-list 和 --broker-list 替换为你的主机信息,具体来说,将它们替换为环境准备中提到的 3 台 CONTROLLER 和 2 台 BROKER 的 IP 地址,并且使用默认的 9092 和 9093 端口。 bin/automq-kafka-admin.sh generate-start-command \ --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" \ --controller-list="192.168.0.1:9093;192.168.0.2:9093;192.168.0.3:9093" \ --broker-list="192.168.0.4:9092;192.168.0.5:9092" 参数说明 输出结果 执行命令后,会生成用于启动 AutoMQ 的命令。 ############ Start Commandline ############## To start an AutoMQ Kafka server, please navigate to the directory where your AutoMQ tgz file is located and run the following command. Before running the command, make sure that Java 17 is installed on your host. You can verify the Java version by executing 'java -version'. bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=0 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.1:9092,CONTROLLER://192.168.0.1:9093 --override advertised.listeners=PLAINTEXT://192.168.0.1:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=1 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.2:9092,CONTROLLER://192.168.0.2:9093 --override advertised.listeners=PLAINTEXT://192.168.0.2:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=2 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.3:9092,CONTROLLER://192.168.0.3:9093 --override advertised.listeners=PLAINTEXT://192.168.0.3:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker --override node.id=3 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.4:9092 --override advertised.listeners=PLAINTEXT://192.168.0.4:9092 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker --override node.id=4 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.5:9092 --override advertised.listeners=PLAINTEXT://192.168.0.5:9092 TIPS: Start controllers first and then the brokers. 注意:node.id 默认从 0 开始自动生成。 第 3 步:启动 AutoMQ 要启动集群,请在预先指定的 CONTROLLER 或 BROKER 主机上依次执行上一步命令中的命令列表。例如,在 192.168.0.1 上启动第一个 CONTROLLER 进程,执行生成的启动命令列表中的第一条命令模板。 bin/kafka-server-start.sh --s3-url="s3://s3.cn-northwest-1.amazonaws.com.cn?s3-access-key=XXX&s3-secret-key=YYY&s3-region=cn-northwest-1&s3-endpoint-protocol=https&s3-data-bucket=automq-data&s3-path-style=false&s3-ops-bucket=automq-ops&cluster-id=40ErA_nGQ_qNPDz0uodTEA" --override process.roles=broker,controller --override node.id=0 --override controller.quorum.voters=0@192.168.0.1:9093,1@192.168.0.2:9093,2@192.168.0.3:9093 --override listeners=PLAINTEXT://192.168.0.1:9092,CONTROLLER://192.168.0.1:9093 --override advertised.listeners=PLAINTEXT://192.168.0.1:9092 参数说明 使用启动命令时,未指定的参数将采用 Apache Kafka 的默认配置。对于 AutoMQ 新增的参数,将使用 AutoMQ 提供的默认值。要覆盖默认配置,可以在命令末尾添加额外的 --override key=value 参数来覆盖默认值。 Tips: 若需启用持续流量重平衡或运行 Example: Self-Balancing When Cluster Nodes Change,建议在启动时为 Controller 明确指定参数 --override autobalancer.controller.enable=true。 在私有数据中心部署 AutoMQ 用于生产环境,需确保本地 SSD 的可靠性。由于 CubeFS 不支持高可用的块设备协议,它无法直接管理磁盘的冗余或者备份。但是您可以通过 RAID [8] 方案进行解决。 后台运行如果需要以后台模式运行,请在命令末尾添加以下代码: command > /dev/null 2>&1 & 至此,你已经完成了基于 CubeFS 的 AutoMQ 集群部署,拥有了一个低成本、低延迟、秒级弹性的 Kafka 集群了。如果你需要进一步体验 AutoMQ 的秒级分区迁移、持续自平衡等特性,可以参考官方示例。 参考资料 [1] CubeFS: https://www.cubefs.io/zh/ [2] CubeFS 的多级缓存: https://www.cubefs.io/zh/docs/master/overview/introduction.html [3] 依赖配置: CubeFS | A Cloud Native Distributed Storage System [4] CubeFS 单机部署: www.cubefs.io [5] 对象网关: https://www.cubefs.io/zh/docs/master/design/objectnode.html [6] CubeFS 用户管理文档: CubeFS | A Cloud Native Distributed Storage System [7] CubeFS AWS SDK: https://www.cubefs.io/zh/docs/master/user-guide/objectnode.html#%E6%94%AF%E6%8C%81%E7%9A%84sdk [8] RAID: https://www.cnblogs.com/chuncn/p/6008173.html END 关于我们 我们是来自 Apache RocketMQ 和 Linux LVS 项目的核心团队,曾经见证并应对过消息队列基础设施在大型互联网公司和云计算公司的挑战。现在我们基于对象存储优先、存算分离、多云原生等技术理念,重新设计并实现了 Apache Kafka 和 Apache RocketMQ,带来高达 10 倍的成本优势和百倍的弹性效率提升。 🌟 GitHub 地址:https://github.com/AutoMQ/automq 💻 官网:https://www.automq.com


)