首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

深入理解springMVC

什么是spring MVC Spring MVC属于SpringFrameWork的后续产品,已经融合在Spring Web Flow里面。Spring 框架提供了构建 Web 应用程序的全功能 MVC 模块。使用 Spring 可插入的 MVC 架构,从而在使用Spring进行WEB开发时,可以选择使用Spring的SpringMVC框架或集成其他MVC开发框架,如Struts1(现在一般不用),Struts2(一般老项目使用)等。 spring mvc简介 springmvc是spring的一个模块,提供web层解决方案(基于mvc设计架构) 采用springmvc的好处 Spring MVC中提供一个DispatcherServlet, 无需额外开发。 springMVC中使用基于xml的配置文件,可以编辑,无需重新编译应用程序。 springMVC实例化控制器,并根据用户输入来构造bean。 springMVC可以自动绑定用户输入,并正确的转换数据类型。例如,springMVC能自动解析字 符串,并设置float或decimal类型的属性。 springMVC可以检验用户输入,若校验不通过,则重定向回输入表单。输入校验是可选的, 支持编码方式以及声明。关于这一点,springMVC内置了常见的校验器。 springMVC是spring框架的一部分。可以利用spring提供的其它能力。 springMVC支持国际化和本地化,支持根据用户区域显示多国语言。 springMVC支持多种视图技术,最常见的JSP技术以及其它技术包括Velocity和FreeMarker。 使用springMVC的优势 1、清晰的角色分配: 前段控制器(dispatcherServlet) , 请求到处理器映射(handlerMapping), 处理器适配器(HandlerAdapter), 视图解析器(ViewResolver), 处理器和页面控制器(Controller),验证器(Validator),命令对象(Command), 表单对象(FromObject) 2、分工明细 3、和Spring框架无缝结合 spring mvc框架流程图 SpringMvc整个的执行流程: 1、发起请求到前端控制器(DispatcherServlet) 2、前端控制器请求HandlerMapping查找Handler(可以根据xml、注解进行查找) 3、处理器映射器HandlerMapping向前端控制器DispatcherServlet返回Handler 4、前端控制器DispatcherServlet 调用处理器适配器HandlerAdapter 执行Handler 5、处理器适配器HandlerAdapter 执行Handler 6、Handler执行完给处理器适配器返回ModelAndView 7、处理器适配器向前端控制器返回ModelAndView (ModelAndView 是SpringMvc的底层对象 包括model和view) 8、前端控制器请求视图解析器去解析视图 根据逻辑视图名解析成真正的视图(jsp) 9、视图解析器向前端控制器返回view 10、前端控制器进行视图渲染 视图渲染将模型数据(模型数据在ModelAndView对象中)填充到request域 11、前端控制器向用户响应结果 组件: 1、前端控制器DispatcherServlet(不需要程序员开发) 作用接收请求,响应结果,相当于转发器,中央处理器。 有了DispatcherServlet减少了其它组件之间的耦合度。 2、处理器映射器HandlerMapping(不需要程序员开发) 作用:根据请求的url查找Handler 3、处理器适配器HandlerAdapter 作用:按照特定规则(HandlerAdapter要求的规则)去执行Handler 4、处理器Handler(需要程序员开发) 注意:编写Handler时按照HandlerAdapter的要求去做,这样适配器才可以去正确执行Handler 5、视图解析器View resolver(不需要程序员开发) 作用:进行视图解析,根据逻辑视图名解析成真正的视图(view) 6、视图View(需要程序员开发jsp) View是一个接口,实现类支持不同的View类型(jsp、freemarker、pdf...) springMVC常用注解 1. 在 struts-config.xml 文件中加入 2.在 applicationContext.xml 文件中加入 3.cn.base.GetPersonListAction 实现请求响应代码 可以看出一次请求需求如此多的步骤,在加上一个项目下来有很多这样的请求响应,将给配置文件管理带来很大的麻烦。 经过对 Spring 的深入应用, Spring 本身提供的 URL 请求控制,对其天然支持可以让我们不需要 applicationContext.xml 再次声明一次 URL 请求 Bean ,即减少了 Struts 的声明 URL ,达到减少些繁琐的配置。但只是少了一些而已,同样也会面临着配置文件的管理问题。 Spring 注解将给我们的工作带来些轻松,利用反射机制原理出现的注解就是为了解决配置大量的配置问题。请看下处理一次简单的请求响应代码 @Controller --声明控制器 @RequestMapping("/person") –声明URL public class PersonControl extends BaseController { @Autowired –业务接口注入 private personServices personServices;/*** 获得人员列表*@param request* @param response* @throws Exception*/ @RequestMapping(params = "method=geList") --即处理/person.do? method=geList方法 public void getnodeList(HttpServletRequest request,HttpServletResponse response) throws Exception { //处理请求//处理响应}} 可以看出,在代码上加入注解可以省去我们上面说的多个配置文件的工作,达到简便的 MVC 处理请求响应。 再配上简单的配置文件声明,即可轻松处理项目的全部请求控制工作。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Python socket 编程理解

HTTP 、Socket 、 TCP 七层OSI网络模型,这里只介绍五层常用网络模型,想知道全部七层详细内容自行查询。 应用层 :HTTP FTP SMTP DNS Telnet 传输层 :TCP UDP 网络层 :IP ICMP 数据链路层 :ARP等 物理层 :1000BASE-SX等 socket是用来连接传输层和应用层,使得应用层可以直接和传输层做交互。 socket本身不属于网络协议,socket可以直接操控tcp,这样可以实现自己的应用层协议,例如聊天室就是,socket可以直接和tcp打交道,实现与http同级别的网络协议。 image.png image.png 上图左侧是server端,右侧是client端

优秀的个人博客,低调大师

面向设计原则理解

面向对象设计(OOD)核心原则让我的程序模块达到“高内聚低耦合”,这是来自于30年前兴起的结构化设计(structured Design),但是同样适用于我们的OOD。 1.高内聚: 高内聚是指某个特定模块(程序,类型)都应完成一系列相关功能,描述了不同程序,类型中方法,方法中不同操作描述的逻辑之间的距离相近。高内聚意味可维护性,可重新性,因为模块对外部的依赖少(功能的完备性)。如果两个模块之间的修改,互不影响这说明模块之间是高内聚的。模块的内聚和其担当的职责成反比,即,模块的职责越多,模块的内聚性越低,这也是模块的单一原则(SRP),SRP提倡每个类型都最好只承担单一的职责,只有单一的改变因素。 2.低耦合: 耦合是描述模块之间的依赖程度,如果一个模块的修改,都有影响另一个模块则,两模块之间是相互依赖耦合的。(依赖具有传递性,耦合的两个模块可能间接依赖),低耦合是我们的设计目的,但不是不存在耦合不存依赖,依赖是必须的,因为模块之间必须通信交互,不过我的设计依赖应该依赖于不变或者不易变的接口,无需了解模块的具实现(OO封装性)。 在面向对象:我们可以简述为功能完备(高内聚)的对象之间的交互是依赖于不变或不易变的接口契约(低耦合)。 实现高内聚低耦合:行之有效的方式是分了关注点(SOC),将系统拆分成功能不同没有重叠功能集。每个功能只关注一个方面(Aspect)保证模块之间功能没有或者尽量少的重复。模块化内部实现细节隐藏,只暴露必须的接口,使得模块之间依赖于抽象,达到稳定。分离关注点的思想存在于我们软件设计的各个领域。如在.net的世界里SOA(面向服务架构)服务就是关注点,只暴露出必要的契约。分层架构从逻辑上利用接口抽象信息隐藏,减少依赖。MVC,MVP也是遵循分了关注点原则,达到表现层和逻辑的分离。 面向对象设计原则: 1.降低耦合度:对象直接需要交互,这就存在依赖,为了实现低耦合就必须减少依赖,依赖于稳定或不易变抽象。考虑如下订单日志记录场景:我们需要在订单每部操作记录更改日志。 public class OrderManager { public void Create(Order order) { //订单处理. Logger log = new Logger(); var history=GetHistory(); log.log(history); } } 在这里我们的OrderManager和Logger存在高耦合,Logger类的修改可能导致OrderManager的修改,而且不能随意切换我们的日志记录方式,比如文件,控制台,数据库等日志方式。 面向抽象编程提出抽象(接口,abstract类)是不易变的稳定抽象;对于OrderManager来说我不需要了解日志记录组件内部,只需要明白提供那些接口可用,怎么用。 public interface ILogger { void Log(History history); } public class Logger { public void Log(History history) { //内部实现 }; } 那么我们可以从设计模式工厂模式(工厂模式是负责一些列相似对象的创建)Create 日志组件ILogger。 我们的OrderManager 就可以实现为: ILogger log =LoggerFactory.Create(); log.Log(history); 这样我们的OrderManager就依赖于ILogger,而隔离Logger具体实现,将依赖于抽象,把变化缩小到Factory内部(同样也可以用抽象工厂),如果日志实现变化我们可以重新实现ILogger ,修改Factory逻辑,如果内部利用配置我的需求变更转移到配置。这就是面向对象第一原则,依赖于抽象而隐藏实现。(利用IOC是一种更好的方式) 2.代码的重用性:尽量保证相同功能代码只出现一次(Code once run anywhere)。代码的重用在面对对象设计中有继承和组合两种方式,一般推荐组合优先。组合依赖于接口,组合更安全,易于维护,测试。继承存在父类访问权限,父类的修改导致子类的变化,太多的继承也有导致派生类的膨胀,维护管理也是件头痛的事。 3.开闭原则(OCP):表述拥抱需求变化,尽量做到对模块的扩展开发,修改关闭。对于新增需求我们完美的做法是新增类型而不是修改逻辑,这就意味着我们必须使用组合或者是继承体系(为了避免上一条重用性,我的继承应该是干净的继承体系,派生类应该只是新增功能而不是修改来自父类上下文), 4.里氏替换(LSP):表述派生类应该可以在任何地方替代父类使用。并不是所有的子类都可以完全替换子类,比如设计父类私有上下文信息的访问,导致子类无法访问。 5.依赖倒置(DIP):描述组件之间高层组件不应该依赖于底层组件。依赖倒置是指实现和接口倒置,采用自顶向下的方式关注所需的底层组件接口,而不是其实现。DI框架实现IOC(控制反转)就是DIP很好的插入底层组件构造框架(分构造注入,函数注入,属性注入)。微软Unity,Castle windsor,Ninject等框架支持。 最后分离关注点,衍生出声明式编程,面向方面编程(AOP)实现纵切关注点,把具体业务逻辑和日志安全等框架集公用逻辑分离。 关于IOC/AOP参见博客我的IOC/AOP随笔目录不在累赘。 本文转自 破狼 51CTO博客,原文链接:http://blog.51cto.com/whitewolfblog/856563,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hbase原理解析

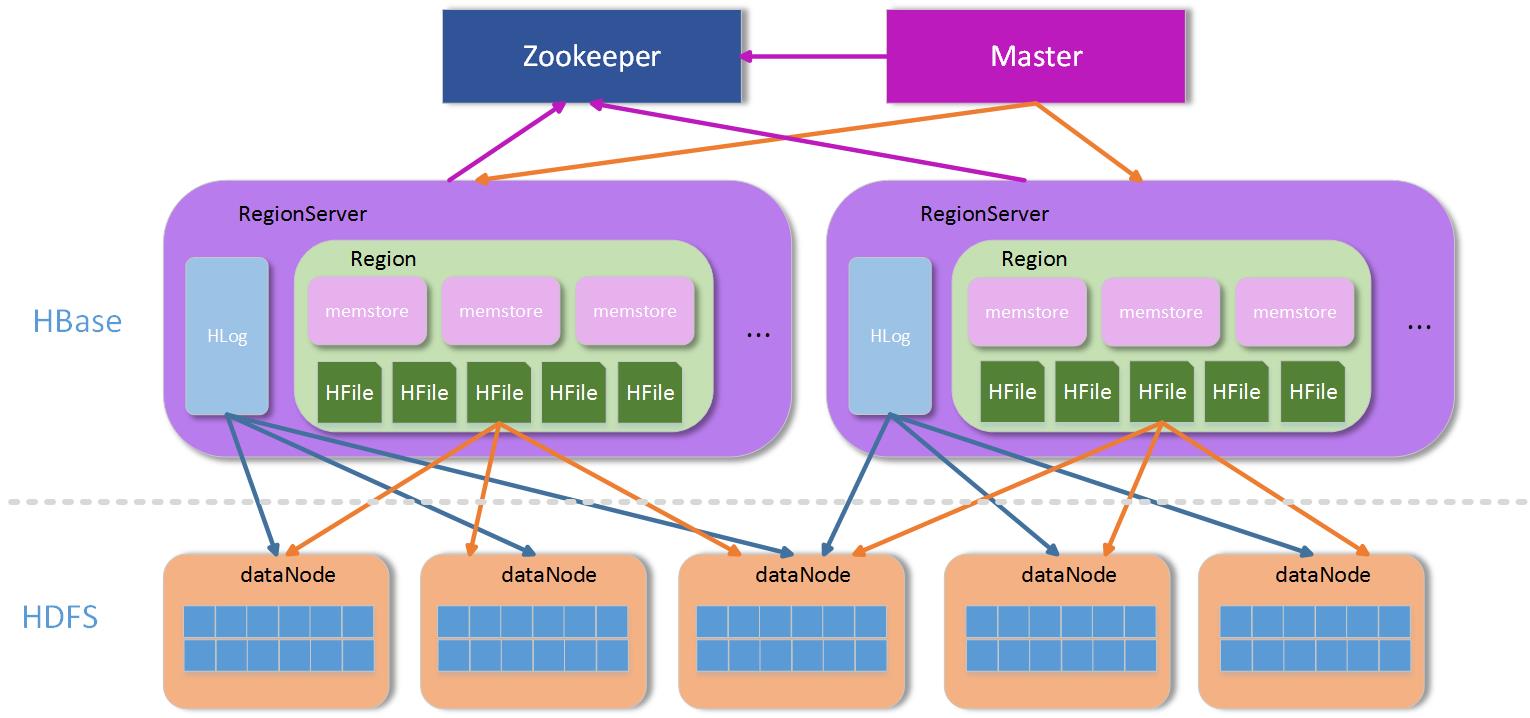
原文网站已经打不开了,其他都是转载地址,在此就不列了 简介 [HBase]——Hadoop Database的简称,Google BigTable的另一种开源实现方式,从问世之初,就为了解决用大量廉价的机器高速存取海量数据、实现数据分布式存储提供可靠的方案。从功能上来讲,HBase不折不扣是一个数据库,与我们熟悉的Oracle、MySQL、MSSQL等一样,对外提供数据的存储和读取服务。而从应用的角度来说,HBase与一般的数据库又有所区别,HBase本身的存取接口相当简单,不支持复杂的数据存取,更不支持SQL等结构化的查询语言;HBase也没有除了rowkey以外的索引,所有的数据分布和查询都依赖rowkey。 所以HBase在表的设计上会有很严格的要求。 架构上,HBase是分布式数据库的典范,这点比较像MongoDB的sharding模式,能根据键值的大小,把数据分布到不同的存储节点上,MongoDB根据configserver来定位数据落在哪个分区上,HBase通过访问Zookeeper来获取-ROOT-表所在地址,通过-ROOT-表得到相应.META.表信息,从而获取数据存储的region位置。 架构 上面提到,HBase是一个分布式的架构,除去底层存储的HDFS外,HBase本身从功能上可以分为三块:Zookeeper群、Master群和RegionServer群。 Zookeeper群:HBase集群中不可缺少的重要部分,主要用于存储Master地址、协调Master和RegionServer等上下线、存储临时数据等等。 Master群:Master主要是做一些管理操作,如:region的分配,手动管理操作下发等等,一般数据的读写操作并不需要经过Master集群,所以Master一般不需要很高的配置即可。 RegionServer群:RegionServer群是真正数据存储的地方,每个RegionServer由若干个region组成,而一个region维护了一定区间rowkey值的数据,整个结构如下图: HBase结构图 上图中,Zookeeper(简称ZK)是一个集群,通常有奇数个ZK服务组成。Master为了服务可用性,也建议部署成集群方式,因为Master是整个管理操作的发起者,如果Master一旦发生意外停机,整个集群将会无法进行管理操作,所以Master也必须有多个,当然多个Master也有主从之分,如何区分哪个是主,哪个是从?关键看哪个Master能竞争到ZK上对应Master目录下的锁,持有该目录锁的Master为主Master,其他从Master轮询竞争该锁,所以一旦主Master发生意外停机,从Master很快会因为竞争到Master文件夹上的锁而接管服务。 RegionServer(简称RS)在非Replication模式下,整个系统中都是唯一的,也就是说,在整个非Replication的HBase集群中,每台RS上保存的数据都不一样,所以相对于前面两者,该模式下的RS并不是高可用的,至少RS可能存在单点故障的问题,但是由于HBase内部数据分region存储和region可以迁移的机制,RS服务的单点故障可能会在极小代价下很快恢复,但是一旦停掉的RS上有-ROOT-或者.META.表的region,那后果还是比较严重,因为数据节点的RS停机,只会在短时间内影响该台RS上的region不可访问,等到region迁移完成后即可恢复,如果是-ROOT-、.META.所在的RS停机,整个HBase的新的求情都将受到影响,因为需要通过.META.表来路由,从而寻找到region所在RS的地址。 数据组织 整个架构中,ZK用于服务协调和整个集群运行过程中部分信息的保存和-ROOT-表地址定位,Master用于集群内部管理,所以剩下的RS主要用于处理数据。 RS是处理数据的主要场所,那么在RS内部的数据是怎么分布的?其实RS本身只是一个容器,其定义了一些功能线程,比如:数据合并线程(compact thread)、storeFile分割线程(split thread)等等。容器中的主要对象就是region,region是一个表根据自身rowkey范围划分的一部分,一个表可以被划分成若干部分,也就是若干个region,region可以根据rowkey范围不同而被分布在不同的RS上(当然也可以在同一个RS上,但不建议这么做)。一个RS上可以包含多个表的region,也可以只包含一个表的部分region,RS和表是两个不同的概念。 这里还有一个概念——列簇。对HBase有一些了解的人,或多或少听说过:HBase是一个列式存储的数据库,而这个列式存储中的列,其实是区别于一般数据库的列,这里的列的概念,就是列簇。列簇,顾名思义就是很多列的集合,而在数据存储上来讲,不同列簇的数据,一定是分开存储的,即使是在同一个region内部,不同的列簇也存储在不同的文件夹中,这样做的好处是,一般我们定义列簇的时候,通常会把类似的数据放入同一个列簇,不同的列簇分开存储,有利于数据的压缩,并且HBase本身支持多种压缩方式。 原理 前面介绍了HBase的一般架构,我们知道了HBase有ZK、Master和RS等组成,本节我们来介绍下HBase的基本原理,从数据访问、RS路由到RS内部缓存、数据存储和刷写再到region的合并和拆分等等功能。 RegionServer定位 访问HBase通过HBase客户端(或API)进行,整个HBase提供给外部的地址,其实是ZK的入口,前面也介绍了,ZK中有保存-ROOT-所在的RS地址,从-ROOT-表可以获取.META.表信息,根据.META.表可以获取region在RS上的分布,整个region寻址过程大致如下: RS定位过程 首先,Client通过访问ZK来请求目标数据的地址。 ZK中保存了-ROOT-表的地址,所以ZK通过访问-ROOT-表来请求数据地址。同样,-ROOT-表中保存的是.META.的信息,通过访问.META.表来获取具体的RS。.META.表查询到具体RS信息后返回具体RS地址给Client。Client端获取到目标地址后,然后直接向该地址发送数据请求。 上述过程其实是一个三层索引结构,从ZK获取-ROOT-信息,再从-ROOT-获取.META.表信息,最后从.META.表中查到RS地址后缓存。这里有几个问题: 既然ZK中能保存-ROOT-信息,那么为什么不把.META.信息直接保存在ZK中,而需要通过-ROOT-表来定位? Client查找到目标地址后,下一次请求还需要走ZK —> -ROOT- —> .META.这个流程么? 先来回答第一个问题:为什么不直接把.META.表信息直接保存到ZK中?主要是为了保存的数据量考虑,ZK中不宜保存大量数据,而.META.表主要是保存Region和RS的映射信息,region的数量没有具体约束,只要在内存允许的范围内,region数量可以有很多,如果保存在ZK中,ZK的压力会很大。所以通过一个-ROOT-表来转存到RS中是一个比较理想的方案,相比直接保存在ZK中,也就多了一层-ROOT-表的查询,对性能来说影响不大。 第二个问题:每次访问都需要走ZK –> -ROOT- —> .META.的流程么?当然不需要,Client端有缓存,第一次查询到相应region所在RS后,这个信息将被缓存到Client端,以后每次访问都直接从缓存中获取RS地址即可。当然这里有个意外:访问的region若果在RS上发生了改变,比如被balancer迁移到其他RS上了,这个时候,通过缓存的地址访问会出现异常,在出现异常的情况下,Client需要重新走一遍上面的流程来获取新的RS地址。总体来说,region的变动只会在极少数情况下发生,一般变动不会很大,所以在整个集群访问过程中,影响可以忽略。 Region数据写入 HBase通过ZK —> -ROOT- —> .META.的访问获取RS地址后,直接向该RS上进行数据写入操作,整个过程如下图: RegionServer数据操作过程 Client通过三层索引获得RS的地址后,即可向指定RS的对应region进行数据写入,HBase的数据写入采用WAL(write ahead log)的形式,先写log,后写数据。HBase是一个append类型的数据库,没有关系型数据库那么复杂的操作,所以记录HLog的操作都是简单的put操作(delete/update操作都被转化为put进行) HLog HLog写入 HLog是HBase实现WAL方式产生的日志信息,其内部是一个简单的顺序日志,每个RS上的region都共享一个HLog,所有对于该RS上的region数据写入都被记录到该HLog中。HLog的主要作用就是在RS出现意外崩溃的时候,可以尽量多的恢复数据,这里说是尽量多,因为在一般情况下,客户端为了提高性能,会把HLog的auto flush关掉,这样HLog日志的落盘全靠操作系统保证,如果出现意外崩溃,短时间内没有被fsync的日志会被丢失。 HLog过期 HLog的大量写入会造成HLog占用存储空间会越来越大,HBase通过HLog过期的方式进行HLog的清理,每个RS内部都有一个HLog监控线程在运行,其周期可以通过hbase.master.cleaner.interval进行配置。 HLog在数据从memstore flush到底层存储上后,说明该段HLog已经不再被需要,就会被移动到.oldlogs这个目录下,HLog监控线程监控该目录下的HLog,当该文件夹下的HLog达到hbase.master.logcleaner.ttl设置的过期条件后,监控线程立即删除过期的HLog。 Memstore 数据存储 memstore是region内部缓存,其大小通过HBase参数hbase.hregion.memstore.flush.size进行配置。RS在写完HLog以后,数据写入的下一个目标就是region的memstore,memstore在HBase内部通过LSM-tree结构组织,所以能够合并大量对于相同rowkey上的更新操作。 正是由于memstore的存在,HBase的数据写入都是异步的,而且性能非常不错,写入到memstore后,该次写入请求就可以被返回,HBase即认为该次数据写入成功。这里有一点需要说明,写入到memstore中的数据都是预先按照rowkey的值进行排序的,这样有利于后续数据查找。 数据刷盘 memstore中的数据在一定条件下会进行刷写操作,使数据持久化到相应的存储设备上,触发memstore刷盘的操作有多种不同的方式如下图: Memstore刷写流程以上1,2,3都可以触发memstore的flush操作,但是实现的方式不同: 1、通过全局内存控制,触发memstore刷盘操作memstore整体内存占用上限通过参数hbase.regionserver.global.memstore.upperLimit进行设置,当然在达到上限后,memstore的刷写也不是一直进行,在内存下降到hbase.regionserver.global.memstore.lowerLimit配置的值后,即停止memstore的刷盘操作。这样做,主要是为了防止长时间的memstore刷盘,会影响整体的性能。在该种情况下,RS中所有region的memstore内存占用都没达到刷盘条件,但整体的内存消耗已经到一个非常危险的范围,如果持续下去,很有可能造成RS的OOM,这个时候,需要进行memstore的刷盘,从而释放内存。 2、手动触发memstore刷盘操作HBase提供API接口,运行通过外部调用进行memstore的刷盘 3、memstore上限触发数据刷盘前面提到memstore的大小通过hbase.hregion.memstore.flush.size进行设置,当region中memstore的数据量达到该值时,会自动触发memstore的刷盘操作。 刷盘影响 memstore在不同的条件下会触发数据刷盘,那么整个数据在刷盘过程中,对region的数据写入等有什么影响?memstore的数据刷盘,对region的直接影响就是:在数据刷盘开始到结束这段时间内,该region上的访问都是被拒绝的,这里主要是因为在数据刷盘结束时,RS会对改region做一个snapshot,同时HLog做一个checkpoint操作,通知ZK哪些HLog可以被移到.oldlogs下。从前面图上也可以看到,在memstore写盘开始,相应region会被加上UpdateLock锁,写盘结束后该锁被释放。 StoreFile memstore在触发刷盘操作后会被写入底层存储,每次memstore的刷盘就会相应生成一个存储文件HFile,storeFile即HFile在HBase层的轻量级分装。数据量的持续写入,造成memstore的频繁flush,每次flush都会产生一个HFile,这样底层存储设备上的HFile文件数量将会越来越多。不管是HDFS还是Linux下常用的文件系统如Ext4、XFS等,对小而多的文件上的管理都没有大文件来的有效,比如小文件打开需要消耗更多的文件句柄;在大量小文件中进行指定rowkey数据的查询性能没有在少量大文件中查询来的快等等。 Compact 大量HFile的产生,会消耗更多的文件句柄,同时会造成RS在数据查询等的效率大幅度下降,HBase为解决这个问题,引入了compact操作,RS通过compact把大量小的HFile进行文件合并,生成大的HFile文件。RS上的compact根据功能的不同,可以分为两种不同类型,即:minor compact和major compact。 Minor Compact minor compact又叫small compact,在RS运行过程中会频繁进行,主要通过参数hbase.hstore.compactionThreshold进行控制,该参数配置了HFile数量在满足该值时,进行minor compact,minor compact只选取region下部分HFile进行compact操作,并且选取的HFile大小不能超过hbase.hregion.max.filesize参数设置。 Major Compact 相反major compact也被称之为large compact,major compact会对整个region下相同列簇的所有HFile进行compact,也就是说major compact结束后,同一个列簇下的HFile会被合并成一个。major compact是一个比较长的过程,对底层I/O的压力相对较大。 major compact除了合并HFile外,另外一个重要功能就是清理过期或者被删除的数据。前面提到过,HBase的delete操作也是通过append的方式写入,一旦某些数据在HBase内部被删除了,在内部只是被简单标记为删除,真正在存储层面没有进行数据清理,只有通过major compact对HFile进行重组时,被标记为删除的数据才能被真正的清理。 compact操作都有特定的线程进行,一般情况下不会影响RS上数据写入的性能,当然也有例外:在compact操作速度跟不上region中HFile增长速度时,为了安全考虑,RS会在HFile达到一定数量时,对写入进行锁定操作,直到HFile通过compact降到一定的范围内才释放锁。 Split compact将多个HFile合并单个HFile文件,随着数据量的不断写入,单个HFile也会越来越大,大量小的HFile会影响数据查询性能,大的HFile也会,HFile越大,相对的在HFile中搜索的指定rowkey的数据花的时间也就越长,HBase同样提供了region的split方案来解决大的HFile造成数据查询时间过长问题。 一个较大的region通过split操作,会生成两个小的region,称之为Daughter,一般Daughter中的数据是根据rowkey的之间点进行切分的,region的split过程大致如下图: region split流程 1、region先更改ZK中该region的状态为SPLITING。 2、Master检测到region状态改变。 3、region会在存储目录下新建.split文件夹用于保存split后的daughter region信息。 4、Parent region关闭数据写入并触发flush操作,保证所有写入Parent region的数据都能持久化。 5、在.split文件夹下新建两个region,称之为daughter A、daughter B。 6、Daughter A、Daughter B拷贝到HBase根目录下,形成两个新的region。 7、Parent region通知修改.META.表后下线,不再提供服务。 8、Daughter A、Daughter B上线,开始向外提供服务。 9、如果开启了balance_switch服务,split后的region将会被重新分布。 上面1 ~ 9就是region split的整个过程,split过程非常快,速度基本会在秒级内,那么在这么快的时间内,region中的数据怎么被重新组织的? 其实,split只是简单的把region从逻辑上划分成两个,并没有涉及到底层数据的重组,split完成后,Parent region并没有被销毁,只是被做下线处理,不再对外部提供服务。而新产生的region Daughter A和Daughter B,内部的数据只是简单的到Parent region数据的索引,Parent region数据的清理在Daughter A和Daughter B进行major compact以后,发现已经没有到其内部数据的索引后,Parent region才会被真正的清理。 HBase设计 HBase是一个分布式数据库,其性能的好坏主要取决于内部表的设计和资源的分配是否合理。 Rowkey设计 rowkey是HBase实现分布式的基础,HBase通过rowkey范围划分不同的region,分布式系统的基本要求就是在任何时候,系统的访问都不要出现明显的热点现象,所以rowkey的设计至关重要,一般我们建议rowkey的开始部分以hash或者MD5进行散列,尽量做到rowkey的头部是均匀分布的。禁止采用时间、用户id等明显有分段现象的标志直接当作rowkey来使用。 列簇设计 HBase的表设计时,根据不同需求有不同选择,需要做在线查询的数据表,尽量不要设计多个列簇,我们知道,不同的列簇在存储上是被分开的,多列簇设计会造成在数据查询的时候读取更多的文件,从而消耗更多的I/O。 TTL设计 选择合适的数据过期时间也是表设计中需要注意的一点,HBase中允许列簇定义数据过期时间,数据一旦超过过期时间,可以被major compact进行清理。大量无用历史数据的残余,会造成region体积增大,影响查询效率。 Region设计 一般地,region不宜设计成很大,除非应用对阶段性性能要求很多,但是在将来运行一段时间可以接受停服处理。region过大会导致major compact调用的周期变长,而单次major compact的时间也相应变长。major compact对底层I/O会造成压力,长时间的compact操作可能会影响数据的flush,compact的周期变长会导致许多删除或者过期的数据不能被及时清理,对数据的读取速度等都有影响。 相反,小的region意味着major compact会相对频繁,但是由于region比较小,major compact的相对时间较快,而且相对较多的major compact操作,会加速过期数据的清理。 当然,小region的设计意味着更多的region split风险,region容量过小,在数据量达到上限后,region需要进行split来拆分,其实split操作在整个HBase运行过程中,是被不怎么希望出现的,因为一旦发生split,涉及到数据的重组,region的再分配等一系列问题。所以我们在设计之初就需要考虑到这些问题,尽量避免region的运行过程中发生split。 HBase可以通过在表创建的时候进行region的预分配来解决运行过程中region的split产生,在表设计的时候,预先分配足够多的region数,在region达到上限前,至少有部分数据会过期,通过major compact进行清理后, region的数据量始终维持在一个平衡状态。 region数量的设计还需要考虑内存上的限制,通过前面的介绍我们知道每个region都有memstore,memstore的数量与region数量和region下列簇的数量成正比,一个RS下memstore内存消耗 Memory = memstore大小 * region数量 * 列簇数量 如果不进行前期数据量估算和region的预分配,通过不断的split产生新的region,容易导致因为内存不足而出现OOM现象。 个人介绍: 高广超:多年一线互联网研发与架构设计经验,擅长设计与落地高可用、高性能互联网架构。 本文首发在 高广超的简书博客 转载请注明! image.png

优秀的个人博客,低调大师

Spark-理解RDD

问题 spark的计算模型是如何做到并行的呢?如果你有一箱香蕉,让三个人拿回家吃完,如果不拆箱子就会很麻烦对吧,哈哈,一个箱子嘛,当然只有一个人才能抱走了。这时候智商正常的人都知道要把箱子打开,倒出来香蕉,分别拿三个小箱子重新装起来,然后,各自抱回家去啃吧。 Spark和很多其他分布式计算系统都借用了这种思想来实现并行:把一个超大的数据集,切分成N个小堆,找M个执行器(M < N),各自拿一块或多块数据慢慢玩,玩出结果了再收集在一起,这就算执行完啦。那么Spark做了一项工作就是:凡是能够被我算的,都是要符合我的要求的,所以spark无论处理什么数据先整成一个拥有多个分块的数据集再说,这个数据集就叫RDD。 RDD RDD(Resilient Distributed Datasets,弹性分布式数据集)是一个分区的只读记录的集合。RDD只能通过在稳定的存储器或其他RDD的数据上的确定性操作来创建。我们把这些操作称作变换以区别其他类型的操作。例如 map,filter和join。 RDD在任何时候都不需要被”物化”(进行实际的变换并最终写入稳定的存储器上)。实际上,一个RDD有足够的信息描述着其如何从其他稳定的存储器上的数据生成。它有一个强大的特性:从本质上说,若RDD失效且不能重建,程序将不能引用该RDD。而用户可以控制RDD的其他两个方面:持久化和分区。用户可以选择重用哪个RDD,并为其制定存储策略(比如,内存存储)。也可以让RDD中的数据根据记录的key分布到集群的多个机器。 这对位置优化来说是有用的,比如可用来保证两个要jion的数据集都使用了相同的哈希分区方式。 spark 编程接口 ,对编程人员通过对稳定存储上的数据进行变换操作(如map和filter).而得到一个或多个RDD。然后可以调用这些RDD的actions(动作)类的操作。这类操作的目是返回一个值或是将数据导入到存储系统中。动作类的操作如count(返回数据集的元素数),collect(返回元素本身的集合)和save(输出数据集到存储系统)。spark直到RDD第一次调用一个动作时才真正计算RDD。 还可以调用RDD的persist(持久化)方法来表明该RDD在后续操作中还会用到。默认情况下,spark会将调用过persist的RDD存在内存中。但若内存不足,也可以将其写入到硬盘上。通过指定persist函数中的参数,用户也可以请求其他持久化策略(如Tachyon)并通过标记来进行persist,比如仅存储到硬盘上或是在各机器之间复制一份。最后,用户可以在每个RDD上设定一个持久化的优先级来指定内存中的哪些数据应该被优先写入到磁盘。 缓存有个缓存管理器,spark里被称作blockmanager。注意,这里还有一个误区是,很多人认为调用了cache或者persist的那一刻就是在缓存了,这是完全不对的,真正的缓存执行指挥在action被触发。 现在数据存储在hdfs上,而数据格式以“;”作为每行数据的分割: "age";"job";"marital";"education";"default";"balance";"housing";"loan" 30;"unemployed";"married";"primary";"no";1787;"no";"no" 33;"services";"married";"secondary";"no";4789;"yes";"yes" /1.定义了以一个HDFS文件(由数行文本组成)为基础的RDD val lines = sc.textFile("/data/spark/bank/bank.csv") //2.因为首行是文件的标题,我们想把首行去掉,返回新RDD是withoutTitleLines val withoutTitleLines = lines.filter(!_.

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册