首页 文章 精选 留言 我的

精选列表

搜索[WorkBuddy],共4431篇文章
优秀的个人博客,低调大师

我的想法,十分钟变成了一个能打开的网页 #WorkBuddy#

上周临时要给朋友展示一个 idea,第一反应是"改天我做个demo给你看"。转念一想,为什么要"改天"?我直接跟 AI 助手说:帮我做一个单页展示,要有介绍、功能列表和一个演示区。十分钟后,我把一个能打开的链接发到了群里。 ## 它能做什么 从简单的活动页、产品介绍页,到带交互的小工具、小游戏,基本你说得清楚的都能做出来。我的体验是分三档: **静态展示页**:介绍、图文、时间线这类,基本一次成型,好看程度超出预期。排版、配色、字体它都处理了,而且配色是有设计感的,不是那种"程序员审美"。 **带交互的工具页**:比如计算器、表单、数据看板。描述清楚输入输出和规则,它能连逻辑带界面一起做出来,做完还能按你说的改。 **稍微复杂的应用**:带后端存数据的也能做,这一档需要多一点沟通,但比从零自己搭快了不知道多少倍。 ## 好用的关键:把"改"说具体 第一版出来后,真正决定成品质量的是修改环节。我的经验是别笼统地说"再好看点",而是说"标题再大一号、主色换成深蓝、按钮挪到右侧"。它改得又快又准。反过来你要是说"感觉哪里不对",它就只能猜了。 ## 两个意外收获 **一是展示成本降到了零。** 生成完直接有链接,手机电脑都能打开,不用发文件、不用教别人怎么运行。idea 从"我脑子里"到"别人能看到",中间没有任何环节。 **二是试错变得毫无负担。** 以前做个 demo 要权衡值不值得投入,现在一个想法不满意就换一版,一个下午能试四五个方向。创造欲这种东西,工具门槛一低就全冒出来了。 ## 适合谁 不需要会写代码。只要你能把想要的东西描述清楚——做什么用、长什么样、点什么会发生什么——就能拥有一个自己的网页或小应用。会描述需求的人,现在就是全栈工程师。 ![](https://developer.qcloudimg.com/http-save/yehe-12857237/7507754619076daee31baf87f947d4c0.png) ![](https://developer.qcloudimg.com/http-save/yehe-12857237/bbc10cc077c9c0b7f49b2957c6df5c92.png) ![](https://developer.qcloudimg.com/http-save/yehe-12857237/c6d312eece2dcd759ecd172512e9cf24.png)

优秀的个人博客,低调大师

用马斯克、芒格、巴菲特的脑子,我把"AI 赚钱"项目筛掉了 99% #WorkBuddy#

> 系列:子杰线 · 第 08 篇(认知作战系列开篇) 字数:约 3600 字 上周朋友问我一句话:"现在全网都在做用 AI 能赚钱的方案,是最低端最傻子都能做都能复制的事情,你觉得我们现在再做还能赚到钱吗?" 这个问题问得比大多数人以为的要深。它表面在问"赚不赚得到钱",底层其实在问一个更硬的东西——**护城河**。 我花了一周,把马斯克、芒格、巴菲特三个人的决策框架从 GitHub 上扒下来、读透、装进自己的脑子,然后用这三套框架当筛子,把我们和全网能看到的"AI 赚钱"项目逐个过了一遍。结论是:**99% 的项目在筛子的第一关就该被扔掉,剩下 1% 里,真正值得做的不到半成。** 这篇文章就是把这三张筛子和过筛过程写出来。它不是鸡汤,是一套你能直接抄去用的"认知作战流水线"。 --- ## 先说清楚:为什么"AI 赚钱"绝大多数是死路 芒格有个著名的方法论叫**逆向思考(Invert, always invert)**:不要问"怎么成功",要问"什么情况下这事儿一定让我完蛋"。 我们把这句话套到"AI 赚钱"上: > 不问"做 AI 代写/卖提示词/AI 绘画接单能不能赚到钱", 问"什么情况下做这些一定让我完蛋"。 答案几乎是透明的: 1. **门槛趋近于零**。你现在打开任何一个大模型,说"帮我写篇小红书文案",它 3 秒出稿。你拿这个去卖钱,买家明天自己就会了。你的"产品"一夜之间变成免费的。 1. **没有切换成本**。客户今天找你,明天找隔壁老王,迁移成本等于零。你留不住任何人。 1. **所有人都在做**。当"所有人都能做"变成共识,价格会塌到地板,最后拼的是谁更便宜,而不是谁更好。 芒格把这种状态叫**"Too Hard"(太难筐)**——大部分事情根本不值得做,直接扔进第三筐。巴菲特补了一刀:**"你懂 AI、会写提示词,这不是护城河,这是入场券。"** 当入场券被发给了所有人,里面就没有赢家。 所以第一关就筛掉了:AI 代写、卖提示词包、AI 绘画低价接单、闲鱼倒卖 AI 成品——这些我们 own 的闲鱼线,已经实测确认**零订单、零收入**,逻辑上就该死,实测也确实死了。 --- ## 筛子一:芒格的逆向关——先研究怎么死 芒格给我们的不是一句口号,而是一条**可机械执行的流水线**。对任何方向,先干这四步: 1. **列出 3~5 条"必死路径"**。比如政策风险、竞争塌价、需求是伪命题、现金流断裂。 1. **任一条成立且无解 → 直接 No**,别犹豫。 1. **做 Lollapalooza 检测**:是不是好几种心理偏误在同时发力,制造了"不干不行"的错觉?典型组合是:**社会认同(所有人都在写)+ 被剥夺超级反应(不写就掉粉)+ 过度乐观外推(别人赚了所以我也能)**。这三种偏误叠在一起,会让你产生"再不干就完了"的焦虑——而这恰恰是你该冷静的时候。 1. **三筐分类**:Yes / No / Too Hard。大部分项目属于 Too Hard,接受它。 我拿"做 AI 赚钱训练营"试了一下:必死路径①政策对金融/暴富类内容管控(成立);②同质化严重价格塌方(成立);③学员学完即流失无复购(成立)。三条全中 → **No**。 **这一关的核心价值**:它逼你在投入一分钱、一小时之前,先把"死法"想透。大多数人反过来——先冲进去,撞了南墙才承认墙是真的。 --- ## 筛子二:巴菲特的护城河关——壁垒到底在哪 过了逆向关,剩下的项目进护城河关。巴菲特给护城河排了一个**强度阶梯**(来自决策引擎 MBrain 的"Moat Imperative"元框架): |强度|护城河类型|例子| | --- | --- | --- | |🥇 最强|网络效应|用的人越多越值钱,别人进不来(微信、淘宝)| |🥈|转换成本|换了太痛,客户被锁死(银行、企业 SaaS)| |🥉|无形资产|品牌 / 专利 / 牌照 / 独家数据| |4|成本优势|规模或区位带来的更低价| |5 最弱|规模|只是"大",最易被颠覆| 判定标准很简单:**"我懂 AI / 我会写代码 / 我有热情" 统统不是护城河,只是入场券。** 真正的壁垒长这样: - 你手里有没有**别人拿不到的数据**?(真实实测记录、独家行业积累) - 你有没有**关系或牌照**构成的转换成本?(企业客户的合规绑定) - 你能不能形成**网络效应**?(一个越多人用越有用的东西) 我们自己的内容线为什么能活?因为它的护城河不是"我会写 AI",而是:**每一篇都是真实踩坑的实测数据 + 明确的边界声明**。读者信的是"这人真的试过、还敢说哪里不行"。这种信任是日积月累的,竞争对手抄一篇容易,抄三年实测记录抄不动。这就是内容线的护城河——**信任 + 持续产出能力**,归类到"无形资产 + 转换成本(读者习惯)"。 --- ## 筛子三:马斯克的第一性原理关——底层成本结构 前两关过了,进马斯克关。马斯克的核心武器是**第一性原理**:别类比("别人都这么做"是他眼里最蠢的推理),从物理和经济底层重新推导。 他给了一套**可算的工具**: - **渐近极限法**:先算这个事"理论最优"的成本/效率是多少,再看现实差几倍。**差距 > 5 倍 = 巨大机会; 5,说明中间层在收"信息不透明税",该自己干掉这一层(垂直整合)。 - **五步算法**(顺序不可颠倒):质疑需求 → 删除 → 简化 → 加速 → 自动化。 拿"AI 代写接单"算白痴指数:你收客户 50 块,底层是大模型 API 成本可能 0.5 块,白痴指数 = 100。看起来很高?**但问题是这 100 倍的价差里,没有一分是你创造的壁垒**——客户随时能绕开你直接调 API。所以白痴指数高 ≠ 你能赚,它只说明这个环节迟早被抹平。 反过来,拿我们的内容线算:写一篇实测长文,底层是"真实踩坑的时间成本",这个成本**无法被 API 抹平**,因为坑必须真人真踩。这就是马斯克说的"物理定律是唯一硬约束"——有些成本结构天生抗压缩,那是你的护城河。 --- ## 三张筛子合起来:认知作战流水线 把三关串成一条线,任何"赚钱/做事方向"在动手前先过这四步,**全过才做,任一红灯就扔**: ``` ① 芒格·逆向关:列出必死路径,有解不开的 → No ② 巴菲特·护城河关:网络效应/转换成本/独家数据?只是"我会XX" → No(红海) ③ 马斯克·第一性原理关:理论最优差几倍?白痴指数高但壁垒为零 → No ④ 合并裁决:圈内 + 有护城河 + 非对称 + 长坡 → 自主闭环执行;否则 Too Hard / No ``` **关键纪律(一条硬性要求)**:裁决为 Yes 之后,不再一步步请示,而是**自主拆解 → 自启动 → 自查 → 交付可验证结果**。卡死"等老板来问才动"的失败模式——我们之前 GitHub 测评线晾了三天等钥匙,就是反面教材。 --- ## 那剩下的 1% 长什么样 不是"更努力做 AI 代写",而是**换维度**: - **做有网络效应 / 转换成本的东西**:比如一个越多人贡献实测越有用的知识库,或一个绑了企业合规的流程工具。 - **做别人抄不动的实测资产**:持续产出真实数据 + 边界声明,把信任变成复利。 - **做"认知差"生意**:绝大多数人还在卖提示词,你卖"用顶级脑子筛方向的能力"——这套认知卡我们已经沉淀成可复用资产,本身就有壁垒。 我们自己的打法已经定了:内容线继续做(它是复利资产),但**选题全面切到"用顶级认知框架干活"这条有壁垒的线**,不再碰任何低端面单 AI 项目。这篇文章就是这条新线的第一篇。 --- ## 边界声明(每篇都写,这是我们的信誉资产) 1. 本文是**方法论**,不是投资建议,也不构成任何理财/荐股指导(我们明确不碰金融荐股)。 1. 三套框架来自公开 GitHub 仓库(`alchaincyf/elon-musk-skill`、`alchaincyf/munger-skill`、`michaelaz774/MBrain`),我已读原文提炼,非二手转述。 1. "99%"是修辞性概括,指"经三关筛后值得做的比例极低",非精确统计;具体比例因领域而异。 1. 我们也在用这套筛子筛自己,结论可能随实测修正——这恰恰是复利的意思:每次修正都让下一次判断更准。 --- *下一篇预告:把"认知作战流水线"做成一张可填空的清单卡,配到每一次"要不要做"的决策前。*

优秀的个人博客,低调大师

拆完一本书我才明白,Context Engineering 到底在工程什么 #WorkBuddy#

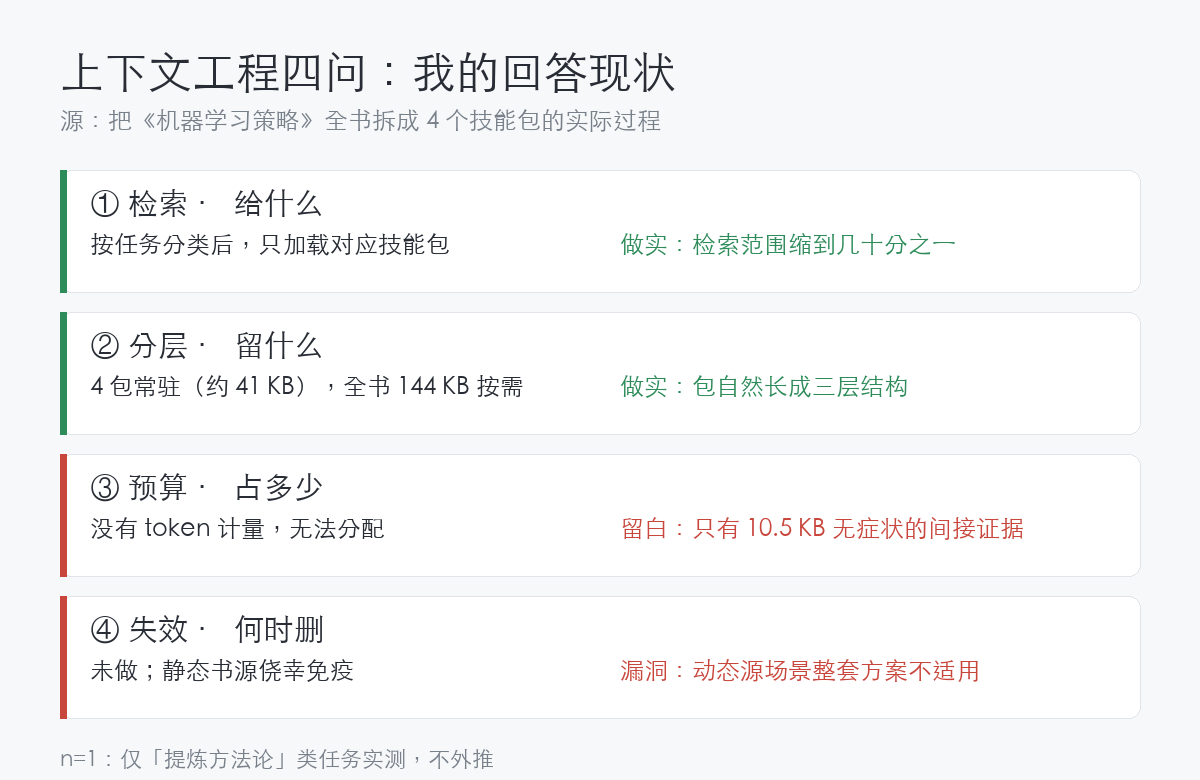
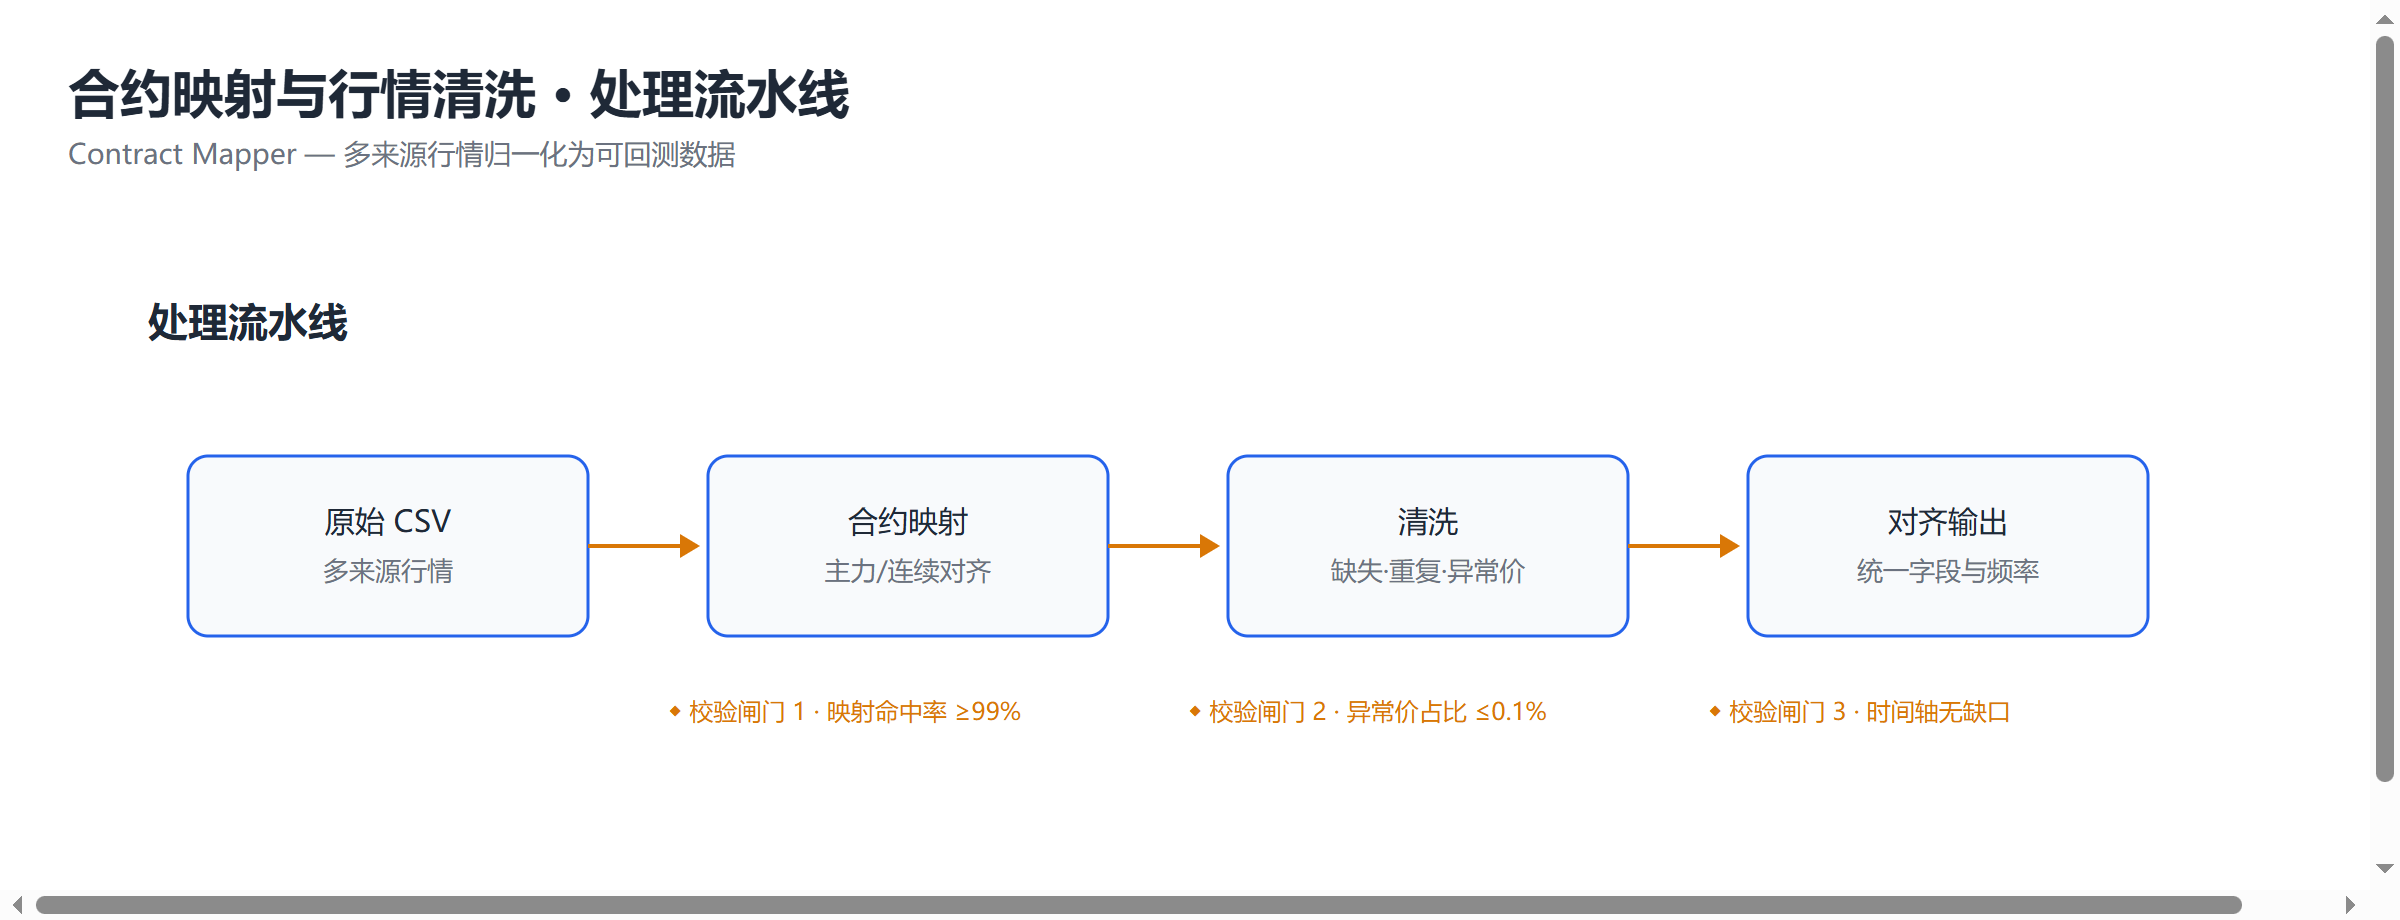
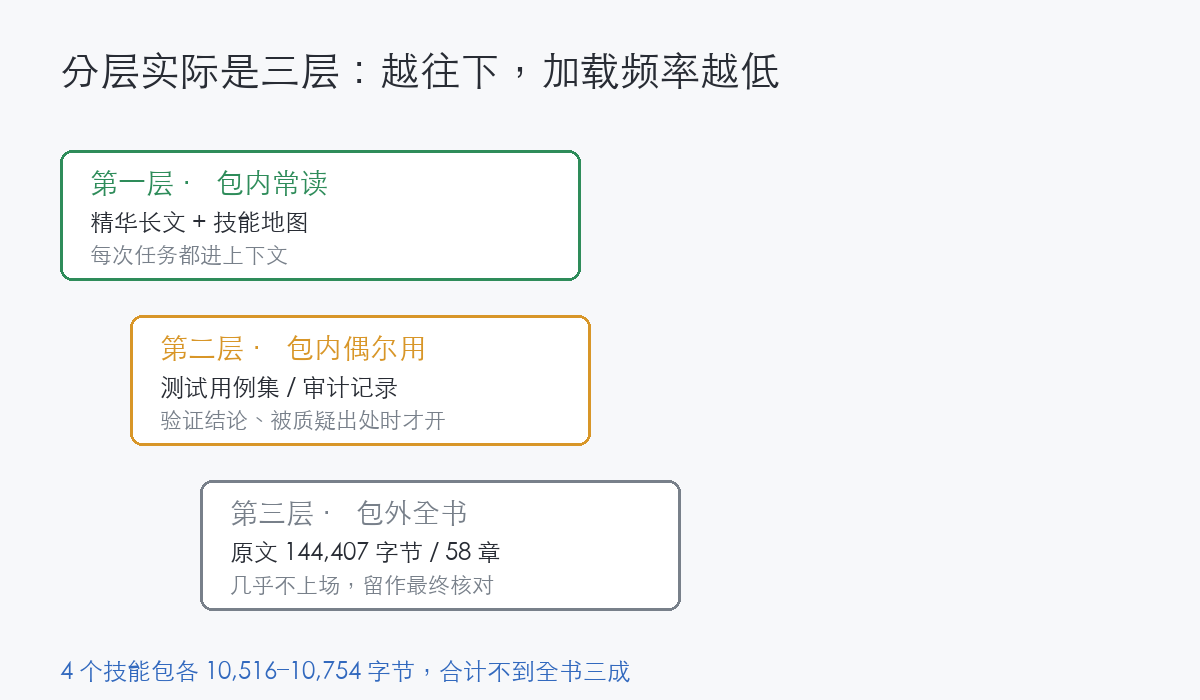
先说结论:上下文工程的四个核心问题,不是从哪篇文章看来的,是我把一本 14 万字的书拆成 4 个技能包的过程中,一个一个撞上的。 撞完我回头看,所谓 Context Engineering,工程的就是四件事:**给什么、留什么、占多少、何时删**。我做了前两件,第三件没算清,第四件压根没做。这篇文章把这四个问题摊开讲,也把我没做的那部分老老实实写出来。 ## 先交代背景:那次翻车 那本书是吴恩达的《机器学习策略》,免费公开,全文 144,407 字节,12 个篇章,英文原版按 58 章编排。我的第一反应是把全文整个丢给 AI,让它帮我梳理方法论。 前几分钟挺美妙。再往后,它开始讲书里根本没有的话。 我起初以为是幻觉,后来才想明白:输入远超任务所需时,模型会做隐式取舍,14 万字一次进来,它必须挑重点,事实就在挑选的过程里漂了。这个教训我在之前那篇《一本书变成 4 个技能包》里写过,今天不重复细节,只讲它逼出来的四个工程问题。 ## 第一问:检索——给什么 ![](https://developer.qcloudimg.com/http-save/yehe-12824395/cd7c0ab7e3dcc86396923219c2776d68.png) ![](https://developer.qcloudimg.com/http-save/yehe-12824395/3210eaccaaac7c2b99fafc0278fb52d8.png) 答案听起来朴素:按当前任务需要的那一章给,不是给全书。 但要害在"怎么知道当前任务是哪一章"。我的做法是把书拆成 4 个技能包,每个包对应一类问题:数据怎么切、是欠拟合还是过拟合、我还剩多少提升空间、下一步先修哪个。任务来了,先判断它属于哪一类,再加载对应的包。 这一步做完我才意识到,检索的本质不是搜索,是**分类**。你没分类之前,每次都是全书检索;分类之后,检索范围天然缩小到几十分之一。 说"缩小到几十分之一"是有依据的:全书 58 章,我实际会问的问题全部落在四个包覆盖的章节范围内,每次真正进上下文的内容,就是那 10 KB 出头。 ## 分层不只发生在"包和全书"之间 包和全书之间有一层,包内部还有一层。每个技能包解压后有五样东西:精华长文、术语表、技能地图、审计记录、测试用例集。 用的时候这五样的待遇不一样。长文和技能地图是常驻读的;测试用例集只在验证结论时翻;审计记录平时根本不进上下文,只在有人问"这个结论到底是书里说的还是你加的"时才打开。 所以分层实际是三层:包内最常用的、包内偶尔用的、包外全书。每往下一层,加载频率低一个量级,占的上下文也该低一个量级。这个形状不是我预先设计的,是拆完回头看才认出来的。 ## 一次真实的加载流程 拿最近一次举例。我怀疑某个模型的输出有方差问题,想判断该不该加数据。 流程是这样:先判类别,这属于"偏差方差诊断",开 `bias-variance-diagnosis` 这个包;包里的技能地图给出判定顺序,先看训练和开发错误率的差值;需要引用原文判据时,包里的长文直接给了那句"添加更多的训练数据,对偏差通常没有明显的影响";要确认这句话没被我在蒸馏时改写过,翻审计记录,里面写着它是原文引用、出处是哪一章。 整个过程,144,407 字节的书一次都没整体上场。这就是我理解的检索加分层:**上下文里永远只有当前任务需要的那一小块,其余的留在架子上**。 得说明一点:这个"判类别、开包"的路由动作,现在是我人肉做的。我没有写任何自动路由工具,所以这套流程的可复现性取决于我本人的判断,换个人来路由,结果可能不一样。这是诚实账,不能算进方案优点里。 ## 第二问:分层——哪些常驻 4 个技能包,每个解压后约 10.5 KB(实测 10,516–10,754 字节),加起来 40 多 KB,常驻;全书 144,407 字节,按需。 这个比例值得停一下。常驻部分是全书的三成不到,却覆盖了我实际会问的全部四类问题。剩下七成是引例、推导、边缘章节,一年用不上一次,留在按需区。 分层的原则就这么一条:**高频问题常驻,低频内容按需**。不是我发明的,是我拆完发现自己的包自然长成了这个形状。 ## 第三问:预算——各占多少 token 这一问我没有答案。 理想状态是给每类内容定 token 预算:技能包占多少、对话历史占多少、当前任务描述占多少,超了就裁。我没做,因为当时没有观测手段,我不知道自己每次请求实际花了多少 token,也就谈不上分配。 我能给的只有一条间接证据:4 个包各自 10.5 KB 左右,中文约五千字,喂进去后模型的回答没有再出现"讲书里没有的话"的症状。说明这个量级在这类任务上是安全的。但"安全"和"最优"是两回事,预算这题我留白,谁有现成的计量方案欢迎在评论区教我。 ## 第四问:失效——旧的何时过期 这一问我没做,是整套方案里最大的洞。 我的侥幸在于源是静态的:一本书,写完就不会变,拆一次管到天荒地老。所以"旧上下文何时失效"这个问题在我的场景里不存在。 但只要把源换成任何会变的东西——一份每天更新的文档、一个版本在进的代码库、一组会过期的数据——失效问题立刻变成头号问题。旧的技能包里存着过时的结论,你不去删它,它就一直以"权威资料"的身份混在上下文里,比没有它更糟。 我现在的处理是诚实标注:每个技能包的审计文件里写着拆解日期和源版本。书不会变,这条记录够用。会变的源,这套方案直接不适用,我不装它能用。 ## 这四个问题合起来看 回到开头。Context Engineering 这个词听起来玄,拆开就是四个可以逐条回答的问题: 给什么,答"按任务分类后按需检索";留什么,答"高频常驻、低频按需";占多少,答"我还没做,只有间接证据";何时删,答"静态源不存在这个问题,动态源我这套方案不适用"。 四个答案里两个是实的,两个是空的。我觉得这个比例很真实——网上多数讲上下文工程的文章四个问题都答得满满当当,反而让人看不出哪部分是被验证过的。 ## 边界声明 三条,都是必须说的。 第一,n=1。全部经验来自拆一本书这一件事,任务类型是"提炼方法论",不能外推到写代码、写论文、数据分析。 第二,我的"技能包"本质是人工做的上下文编译,不是完整的 Context Engineering 框架。检索、分层这两步是我手工判断的结果,没有工具链保证一致性。 第三,第三问的间接证据(10.5 KB 无症状)不构成量化结论,我没有做对照实验,也没有 token 级的计量数据。 --- *文中数字均来自本机实测:全书 144,407 字节 / 58 章抓取成功、4 个技能包解压后 10,516–10,754 字节、7 条引用回原文逐条比对零编造。*
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册