首页 文章 精选 留言 我的

精选列表

搜索[递归超智能],共10002篇文章
优秀的个人博客,低调大师

容器底层 --- 超细节的 Namespace 机制讲解

Namespace Linux Namespace 是 Linux 提供的一种内核级别环境隔离的方法。这种隔离机制和 chroot 很类似,chroot 是把某个目录修改为根目录,从而无法访问外部的内容。Linux Namesapce 在此基础之上,提供了对 UTS、IPC、Mount、PID、Network、User 等的隔离机制,如下所示。 分类 系统调用参数 相关内核版本 Mount Namespaces CLONE_NEWNS Linux 2.4.19 UTS Namespaces CLONE_NEWUTS Linux 2.6.19 IPC Namespaces CLONE_NEWIPC Linux 2.6.19 PID Namespaces CLONE_NEWPID Linux 2.6.19 Network Namespaces CLONE_NEWNET 始于Linux 2.6.24 完成于 Linux 2.6.29 User Namespaces CLONE_NEWUSER 始于 Linux 2.6.23 完成于 Linux 3.8) ★ Linux Namespace 官方文档:Namespaces in operation ” namespace 有三个系统调用可以使用: clone() --- 实现线程的系统调用,用来创建一个新的进程,并可以通过设计上述参数达到隔离。 unshare() --- 使某个进程脱离某个 namespace setns(int fd, int nstype) --- 把某进程加入到某个 namespace 下面使用这几个系统调用来演示 Namespace 的效果,更加详细地可以看 DOCKER基础技术:LINUX NAMESPACE(上)、 DOCKER基础技术:LINUX NAMESPACE(下)。 UTS Namespace UTS Namespace 主要是用来隔离主机名的,也就是每个容器都有自己的主机名。我们使用如下的代码来进行演示。注意:假如在容器内部没有设置主机名的话会使用主机的主机名的;假如在容器内部设置了主机名但是没有使用 CLONE_NEWUTS 的话那么改变的其实是主机的主机名。 #define _GNU_SOURCE#include <sys/types.h>#include <sys/wait.h>#include <sys/mount.h>#include <stdio.h>#include <sched.h>#include <signal.h>#include <unistd.h>#define STACK_SIZE (1024 * 1024)static char container_stack[STACK_SIZE];char* const container_args[] = { "/bin/bash", NULL};int container_main(void* arg) { printf("Container [%5d] - inside the container!\n", getpid()); sethostname("container_dawn", 15); execv(container_args[0], container_args); printf("Something's wrong!\n"); return 1;}int main() { printf("Parent [%5d] - start a container!\n", getpid()); int container_id = clone(container_main, container_stack + STACK_SIZE, CLONE_NEWUTS | SIGCHLD, NULL); waitpid(container_id, NULL, 0); printf("Parent - container stopped!\n"); return 0;} PID Namespace 每个容器都有自己的进程环境中,也就是相当于容器内进程的 PID 从 1 开始命名,此时主机上的 PID 其实也还是从 1 开始命名的,就相当于有两个进程环境:一个主机上的从 1 开始,另一个容器里的从 1 开始。 为啥 PID 从 1 开始就相当于进程环境的隔离了呢?因此在传统的 UNIX 系统中,PID 为 1 的进程是 init,地位特殊。它作为所有进程的父进程,有很多特权。另外,其还会检查所有进程的状态,我们知道如果某个进程脱离了父进程(父进程没有 wait 它),那么 init 就会负责回收资源并结束这个子进程。所以要想做到进程的隔离,首先需要创建出 PID 为 1 的进程。 但是,【kubernetes 里面的话】 int container_main(void* arg) { printf("Container [%5d] - inside the container!\n", getpid()); sethostname("container_dawn", 15); execv(container_args[0], container_args); printf("Something's wrong!\n"); return 1;}int main() { printf("Parent [%5d] - start a container!\n", getpid()); int container_id = clone(container_main, container_stack + STACK_SIZE, CLONE_NEWUTS | CLONE_NEWPID | SIGCHLD, NULL); waitpid(container_id, NULL, 0); printf("Parent - container stopped!\n"); return 0;} 如果此时你在子进程的 shell 中输入 ps、top 等命令,我们还是可以看到所有进程。这是因为,ps、top 这些命令是去读 /proc 文件系统,由于此时文件系统并没有隔离,所以父进程和子进程通过命令看到的情况都是一样的。 IPC Namespace 常见的 IPC 有共享内存、信号量、消息队列等。当使用 IPC Namespace 把 IPC 隔离起来之后,只有同一个 Namespace 下的进程才能相互通信,因为主机的 IPC 和其他 Namespace 中的 IPC 都是看不到了的。而这个的隔离主要是因为创建出来的 IPC 都会有一个唯一的 ID,那么主要对这个 ID 进行隔离就好了。 想要启动 IPC 隔离,只需要在调用 clone 的时候加上 CLONE_NEWIPC 参数就可以了。 int container_main(void* arg) { printf("Container [%5d] - inside the container!\n", getpid()); sethostname("container_dawn", 15); execv(container_args[0], container_args); printf("Something's wrong!\n"); return 1;}int main() { printf("Parent [%5d] - start a container!\n", getpid()); int container_id = clone(container_main, container_stack + STACK_SIZE, CLONE_NEWUTS | CLONE_NEWPID | CLONE_NEWIPC | SIGCHLD, NULL); waitpid(container_id, NULL, 0); printf("Parent - container stopped!\n"); return 0;} Mount Namespace Mount Namespace 可以让容器有自己的 root 文件系统。需要注意的是,在通过 CLONE_NEWNS 创建 mount namespace 之后,父进程会把自己的文件结构复制给子进程中。所以当子进程中不重新 mount 的话,子进程和父进程的文件系统视图是一样的,假如想要改变容器进程的视图,一定需要重新 mount(这个是 mount namespace 和其他 namespace 不同的地方)。 另外,子进程中新的 namespace 中的所有 mount 操作都只影响自身的文件系统(注意这边是 mount 操作,而创建文件等操作都是会有所影响的),而不对外界产生任何影响,这样可以做到比较严格地隔离(当然这边是除 share mount 之外的)。 下面我们重新挂载子进程的 /proc 目录,从而可以使用 ps 来查看容器内部的情况。 int container_main(void* arg) { printf("Container [%5d] - inside the container!\n", getpid()); sethostname("container_dawn", 15); if (mount("proc", "/proc", "proc", 0, NULL) !=0 ) { perror("proc"); } execv(container_args[0], container_args); printf("Something's wrong!\n"); return 1;}int main() { printf("Parent [%5d] - start a container!\n", getpid()); int container_id = clone(container_main, container_stack + STACK_SIZE, CLONE_NEWUTS | CLONE_NEWPID | CLONE_NEWNS | SIGCHLD, NULL); waitpid(container_id, NULL, 0); printf("Parent - container stopped!\n"); return 0;} ★ 这里会有个问题就是在退出子进程之后,当再次使用 ps -elf 的时候会报错,如下所示 这是因为 /proc 是 share mount,对它的操作会影响所有的 mount namespace,可以看这里:http://unix.stackexchange.com/questions/281844/why-does-child-with-mount-namespace-affect-parent-mounts ” 上面仅仅重新 mount 了 /proc 这个目录,其他的目录还是跟父进程一样视图的。一般来说,容器创建之后,容器进程需要看到的是一个独立的隔离环境,而不是继承宿主机的文件系统。接下来演示一个山寨镜像,来模仿 Docker 的 Mount Namespace。也就是给子进程实现一个较为完整的独立的 root 文件系统,让这个进程只能访问自己构成的文件系统中的内容(想想我们平常使用 Docker 容器的样子)。 首先我们使用 docker export 将 busybox 镜像导出成一个 rootfs 目录,这个 rootfs 目录的情况如图所示,已经包含了 /proc、/sys 等特殊的目录。 之后我们在代码中将一些特殊目录重新挂载,并使用 chroot() 系统调用将进程的根目录改成上文的 rootfs 目录。 char* const container_args[] = { "/bin/sh", NULL};int container_main(void* arg) { printf("Container [%5d] - inside the container!\n", getpid()); sethostname("container_dawn", 15); if (mount("proc", "rootfs/proc", "proc", 0, NULL) != 0) { perror("proc"); } if (mount("sysfs", "rootfs/sys", "sysfs", 0, NULL)!=0) { perror("sys"); } if (mount("none", "rootfs/tmp", "tmpfs", 0, NULL)!=0) { perror("tmp"); } if (mount("udev", "rootfs/dev", "devtmpfs", 0, NULL)!=0) { perror("dev"); } if (mount("devpts", "rootfs/dev/pts", "devpts", 0, NULL)!=0) { perror("dev/pts"); } if (mount("shm", "rootfs/dev/shm", "tmpfs", 0, NULL)!=0) { perror("dev/shm"); } if (mount("tmpfs", "rootfs/run", "tmpfs", 0, NULL)!=0) { perror("run"); } if ( chdir("./rootfs") || chroot("./") != 0 ){ perror("chdir/chroot"); } // 改变根目录之后,那么 /bin/bash 是从改变之后的根目录中搜索了 execv(container_args[0], container_args); perror("exec"); printf("Something's wrong!\n"); return 1;}int main() { printf("Parent [%5d] - start a container!\n", getpid()); int container_id = clone(container_main, container_stack + STACK_SIZE, CLONE_NEWUTS | CLONE_NEWPID | CLONE_NEWNS | SIGCHLD, NULL); waitpid(container_id, NULL, 0); printf("Parent - container stopped!\n"); return 0;} 最后,查看实现效果如下图所示。 实际上,Mount Namespace 是基于 chroot 的不断改良才被发明出来的,chroot 可以算是 Linux 中第一个 Namespace。那么上面被挂载在容器根目录上、用来为容器镜像提供隔离后执行环境的文件系统,就是所谓的容器镜像,也被叫做 rootfs(根文件系统)。需要明确的是,rootfs 只是一个操作系统所包含的文件、配置和目录,并不包括操作系统内核。 User Namespace 容器内部看到的 UID 和 GID 和外部是不同的了,比如容器内部针对 dawn 这个用户显示的是 0,但是实际上这个用户在主机上应该是 1000。要实现这样的效果,需要把容器内部的 UID 和主机的 UID 进行映射,需要修改的文件是 /proc/<pid>/uid_map 和 /proc/<pid>/gid_map,这两个文件的格式是 ID-INSIDE-NS ID-OUTSIDE-NS LENGTH ID-INSIDE-NS :表示在容器内部显示的 UID 或 GID ID-OUTSIDE-NS:表示容器外映射的真实的 UID 和 GID LENGTH:表示映射的范围,一般为 1,表示一一对应 比如,下面就是将真实的 uid=1000 的映射为容器内的 uid =0: $ cat /proc/8353/uid_map0 1000 1 再比如,下面则表示把 namesapce 内部从 0 开始的 uid 映射到外部从 0 开始的 uid,其最大范围是无符号 32 位整型(下面这条命令是在主机环境中输入的)。 $ cat /proc/$$/uid_map0 0 4294967295 默认情况,设置了 CLONE_NEWUSER 参数但是没有修改上述两个文件的话,容器中默认情况下显示为 65534,这是因为容器找不到真正的 UID,所以就设置了最大的 UID。如下面的代码所示: #define _GNU_SOURCE#include <stdio.h>#include <stdlib.h>#include <sys/types.h>#include <sys/wait.h>#include <sys/mount.h>#include <sys/capability.h>#include <stdio.h>#include <sched.h>#include <signal.h>#include <unistd.h>#define STACK_SIZE (1024 * 1024)static char container_stack[STACK_SIZE];char* const container_args[] = { "/bin/bash", NULL};int container_main(void* arg) { printf("Container [%5d] - inside the container!\n", getpid()); printf("Container: eUID = %ld; eGID = %ld, UID=%ld, GID=%ld\n", (long) geteuid(), (long) getegid(), (long) getuid(), (long) getgid()); printf("Container [%5d] - setup hostname!\n", getpid()); //set hostname sethostname("container",10); execv(container_args[0], container_args); printf("Something's wrong!\n"); return 1;}int main() { const int gid=getgid(), uid=getuid(); printf("Parent: eUID = %ld; eGID = %ld, UID=%ld, GID=%ld\n", (long) geteuid(), (long) getegid(), (long) getuid(), (long) getgid()); printf("Parent [%5d] - start a container!\n", getpid()); int container_pid = clone(container_main, container_stack+STACK_SIZE, CLONE_NEWUTS | CLONE_NEWPID | CLONE_NEWUSER | SIGCHLD, NULL); printf("Parent [%5d] - Container [%5d]!\n", getpid(), container_pid); printf("Parent [%5d] - user/group mapping done!\n", getpid()); waitpid(container_pid, NULL, 0); printf("Parent - container stopped!\n"); return 0;} 当我以 dawn 这个用户执行的该程序的时候,那么会显示如下图所示的效果。使用 root 用户的时候是同样的: 接下去,我们要开始来实现映射的效果了,也就是让 dawn 这个用户在容器中显示为 0。代码是几乎完全拿耗子叔的博客上的,链接可见文末: int pipefd[2];void set_map(char* file, int inside_id, int outside_id, int len) { FILE* mapfd = fopen(file, "w"); if (NULL == mapfd) { perror("open file error"); return; } fprintf(mapfd, "%d %d %d", inside_id, outside_id, len); fclose(mapfd);}void set_uid_map(pid_t pid, int inside_id, int outside_id, int len) { char file[256]; sprintf(file, "/proc/%d/uid_map", pid); set_map(file, inside_id, outside_id, len);}int container_main(void* arg) { printf("Container [%5d] - inside the container!\n", getpid()); printf("Container: eUID = %ld; eGID = %ld, UID=%ld, GID=%ld\n", (long) geteuid(), (long) getegid(), (long) getuid(), (long) getgid()); /* 等待父进程通知后再往下执行(进程间的同步) */ char ch; close(pipefd[1]); read(pipefd[0], &ch, 1); printf("Container [%5d] - setup hostname!\n", getpid()); //set hostname sethostname("container",10); //remount "/proc" to make sure the "top" and "ps" show container's information mount("proc", "/proc", "proc", 0, NULL); execv(container_args[0], container_args); printf("Something's wrong!\n"); return 1;}int main() { const int gid=getgid(), uid=getuid(); printf("Parent: eUID = %ld; eGID = %ld, UID=%ld, GID=%ld\n", (long) geteuid(), (long) getegid(), (long) getuid(), (long) getgid()); pipe(pipefd); printf("Parent [%5d] - start a container!\n", getpid()); int container_pid = clone(container_main, container_stack+STACK_SIZE, CLONE_NEWUTS | CLONE_NEWPID | CLONE_NEWNS | CLONE_NEWUSER | SIGCHLD, NULL); printf("Parent [%5d] - Container [%5d]!\n", getpid(), container_pid); //To map the uid/gid, // we need edit the /proc/PID/uid_map (or /proc/PID/gid_map) in parent set_uid_map(container_pid, 0, uid, 1); printf("Parent [%5d] - user/group mapping done!\n", getpid()); /* 通知子进程 */ close(pipefd[1]); waitpid(container_pid, NULL, 0); printf("Parent - container stopped!\n"); return 0;} 实现的最终效果如图所示,可以看到在容器内部将 dawn 这个用户 UID 显示为了 0(root),但其实这个容器中的 /bin/bash 进程还是以一个普通用户,也就是 dawn 来运行的,只是显示出来的 UID 是 0,所以当查看 /root 目录的时候还是没有权限。 User Namespace 是以普通用户运行的,但是别的 Namespace 需要 root 权限,那么当使用多个 Namespace 该怎么办呢?我们可以先用一般用户创建 User Namespace,然后把这个一般用户映射成 root,那么在容器内用 root 来创建其他的 Namespace。 Network Namespace 隔离容器中的网络,每个容器都有自己的虚拟网络接口和 IP 地址。在 Linux 中,可以使用 ip 命令创建 Network Namespace(Docker 的源码中,它没有使用 ip 命令,而是自己实现了 ip 命令内的一些功能)。 下面就使用 ip 命令来讲解一下 Network Namespace 的构建,以 bridge 网络为例。bridge 网络的拓扑图一般如下图所示,其中 br0 是 Linux 网桥。 在使用 Docker 的时候,如果启动一个 Docker 容器,并使用 ip link show 查看当前宿主机上的网络情况,那么你会看到有一个 docker0 还有一个 veth**** 的虚拟网卡,这个 veth 的虚拟网卡就是上图中 veth,而 docker0 就相当于上图中的 br0。 那么,我们可以使用下面这些命令即可创建跟 docker 类似的效果(参考自耗子叔的博客,链接见文末参考,结合上图加了一些文字)。 ## 1. 首先,我们先增加一个网桥 lxcbr0,模仿 docker0brctl addbr lxcbr0brctl stp lxcbr0 offifconfig lxcbr0 192.168.10.1/24 up #为网桥设置IP地址## 2. 接下来,我们要创建一个 network namespace ,命名为 ns1# 增加一个 namesapce 命令为 ns1 (使用 ip netns add 命令)ip netns add ns1 # 激活 namespace 中的 loopback,即127.0.0.1(使用 ip netns exec ns1 相当于进入了 ns1 这个 namespace,那么 ip link set dev lo up 相当于在 ns1 中执行的)ip netns exec ns1 ip link set dev lo up ## 3. 然后,我们需要增加一对虚拟网卡# 增加一对虚拟网卡,注意其中的 veth 类型。这里有两个虚拟网卡:veth-ns1 和 lxcbr0.1,veth-ns1 网卡是要被安到容器中的,而 lxcbr0.1 则是要被安到网桥 lxcbr0 中的,也就是上图中的 veth。ip link add veth-ns1 type veth peer name lxcbr0.1# 把 veth-ns1 按到 namespace ns1 中,这样容器中就会有一个新的网卡了ip link set veth-ns1 netns ns1# 把容器里的 veth-ns1 改名为 eth0 (容器外会冲突,容器内就不会了)ip netns exec ns1 ip link set dev veth-ns1 name eth0 # 为容器中的网卡分配一个 IP 地址,并激活它ip netns exec ns1 ifconfig eth0 192.168.10.11/24 up# 上面我们把 veth-ns1 这个网卡按到了容器中,然后我们要把 lxcbr0.1 添加上网桥上brctl addif lxcbr0 lxcbr0.1# 为容器增加一个路由规则,让容器可以访问外面的网络ip netns exec ns1 ip route add default via 192.168.10.1## 4. 为这个 namespace 设置 resolv.conf,这样,容器内就可以访问域名了echo "nameserver 8.8.8.8" > conf/resolv.conf 上面基本上就相当于 docker 网络的原理,只不过: Docker 不使用 ip 命令而是,自己实现了 ip 命令内的一些功能。 Docker 的 resolv.conf 没有使用这样的方式,而是将其写到指定的 resolv.conf 中,之后在启动容器的时候将其和 hostname、host 一起以只读的方式加载到容器的文件系统中。 docker 使用进程的 PID 来做 network namespace 的名称。 同理,我们还可以使用如下的方式为正在运行的 docker 容器增加一个新的网卡 ip link add peerA type veth peer name peerB brctl addif docker0 peerA ip link set peerA up ip link set peerB netns ${container-pid} ip netns exec ${container-pid} ip link set dev peerB name eth1 ip netns exec ${container-pid} ip link set eth1 up ip netns exec ${container-pid} ip addr add ${ROUTEABLE_IP} dev eth1 Namespace 情况查看 Cgroup 的操作接口是文件系统,位于 /sys/fs/cgroup 中。假如想查看 namespace 的情况同样可以查看文件系统,namespace 主要查看 /proc/<pid>/ns 目录。 我们以上面的 [PID Namespace 程序](#PID Namespace) 为例,当这个程序运行起来之后,我们可以看到其 PID 为 11702。 之后,我们保持这个子进程运行,然后打开另一个 shell,查看这个程序创建的子进程的 PID,也就是容器中运行的进程在主机中的 PID。 最后,我们分别查看 /proc/11702/ns 和 /proc/11703/ns 这两个目录的情况,也就是查看这两个进程的 namespace 情况。可以看到其中 cgroup、ipc、mnt、net、user 都是同一个 ID,而 pid、uts 是不同的 ID。如果两个进程的 namespace 编号相同,那么表示这两个进程位于同一个 namespace 中,否则位于不同 namespace 中。 如果可以查看 ns 的情况之外,这些文件一旦被打开,只要 fd 被占用着,即使 namespace 中所有进程都已经结束了,那么创建的 namespace 也会一直存在。比如可以使用 mount --bind /proc/11703/ns/uts ~/uts,让 11703 这个进程的 UTS Namespace 一直存在。 总结 Namespace 技术实际上修改了应用进程看待整个计算机“视图”,即它的”视图“已经被操作系统做了限制,只能”看到“某些指定的内容,这仅仅对应用进程产生了影响。但是对宿主机来说,这些被隔离了的进程,其实还是进程,跟宿主机上其他进程并无太大区别,都由宿主机统一管理。只不过这些被隔离的进程拥有额外设置过的 Namespace 参数。那么 Docker 项目在这里扮演的,更多是旁路式的辅助和管理工作。如下左图所示 因此,相比虚拟机的方式,容器会更受欢迎。这是假如使用虚拟机的方式作为应用沙盒,那么必须要由 Hypervisor 来负责创建虚拟机,这个虚拟机是真实存在的,并且里面必须要运行一个完整的 Guest OS 才能执行用户的应用进程。这样就导致了采用虚拟机的方式之后,不可避免地带来额外的资源消耗和占用。根据实验,一个运行着 CentOS 的 KVM 虚拟机启动后,在不做优化的情况下,虚拟机就需要占用 100-200 MB 内存。此外,用户应用运行在虚拟机中,它对宿主机操作系统的调用就不可避免地要经过虚拟机软件的拦截和处理,这本身就是一层消耗,尤其对资源、网络和磁盘 IO 的损耗非常大。 而假如使用容器的方式,容器化之后应用本质还是宿主机上的一个进程,这也就意味着因为虚拟机化带来的性能损耗是不存在的;而另一方面使用 Namespace 作为隔离手段的容器并不需要单独的 Guest OS,这就使得容器额外的资源占用几乎可以忽略不计。 总得来说,“敏捷”和“高性能”是容器相对于虚拟机最大的优势,也就是容器能在 PaaS 这种更加细粒度的资源管理平台上大行其道的重要原因。 但是!基于 Linux Namespace 的隔离机制相比于虚拟化技术也有很多不足之处,其中最主要的问题就是隔离不彻底。 首先,容器只是运行在宿主机上的一种特殊进程,那么容器之间使用的还是同一个宿主机上的操作系统。尽管可以在容器里面通过 mount namesapce 单独挂载其他不同版本的操作系统文件,比如 centos、ubuntu,但是这并不能改变共享宿主机内核的事实。这就意味着你要在 windows 上运行 Linux 容器,或者在低版本的 Linux 宿主机上运行高版本的 Linux 容器都是行不通的。 而拥有虚拟机技术和独立 Guest OS 的虚拟机就要方便多了。 其次,在 Linux 内核中,有很多资源和对象都是不能被 namespace 化的,比如时间。假如你的容器中的程序使用 settimeofday(2) 系统调用修改了时间,整个宿主机的时间都会被随之修改。 相比虚拟机里面可以随意折腾的自由度,在容器里部署应用的时候,“什么能做,什么不能做” 是用户必须考虑的一个问题。之外,容器给应用暴露出来的攻击面是相当大的,应用“越狱”的难度也比虚拟机低很多。虽然,实践中可以使用 Seccomp 等技术对容器内部发起的所有系统调用进行过滤和甄别来进行安全加固,但这种方式因为多了一层对系统调用的过滤,也会对容器的性能产生影响。因此,在生产环境中没有人敢把运行在物理机上的 Linux 容器直接暴露到公网上。 另外,容器是一个“单进程”模型。容器的本质是一个进程,用户的应用进程实际上就是容器里 PID=1 的进程,而这个进程也是后续创建的所有进程的父进程。这也就意味着,在一个容器中,你没办法同时运行两个不同的应用,除非能事先找到一个公共的 PID=1 的程序来充当两者的父进程,比如使用 systemd 或者 supervisord。容器的设计更多是希望容器和应用同生命周期的,而不是容器还在运行,而里面的应用早已经挂了。 ★ 上面这段话个人的理解是:因为创建出子进程之后,子进程需要运行的,而此时父进程需要等待子进程运行结束,相当于只有子进程在运行。比如容器中的第一个进程往往就是业务需要的进程,也就是 entrypoint 指定的程序运行起来的进程。而创建出子进程会导致这个进程被暂停。即使将子进程改为后台执行,但是由于容器中 PID=1 的进程压根没有管理后台进程的能力,所以还是会有进程无法管理。 ” 巨人的肩膀 极客时间---《深入剖析 Kubernetes》---张磊老师 DOCKER基础技术:LINUX NAMESPACE(上) DOCKER基础技术:LINUX NAMESPACE(下)。 本文分享自微信公众号 - 多选参数(zhouxintalk)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

19个JS超有用的简写技巧

1.三元操作符 当想写if...else语句时,使用三元操作符来代替。 constx=20;letanswer;if(x>10){answer='isgreater';}else{answer='islesser';} 简写: const answer = x > 10 ? 'is greater' : 'is lesser'; 也可以嵌套if语句:const big = x > 10 ? " greater 10" : x 2.短路求值简写方式 当给一个变量分配另一个值时,想确定源始值不是null,undefined或空值。可以写撰写一个多重条件的if语句。 if(variable1!==null||variable1!==undefined||variable1!==''){letvariable2=variable1;} 或者可以使用短路求值方法:const variable2 = variable1 || 'new'; 3.声明变量简写方法 letx;lety;letz=3; 简写方法:let x, y, z=3; 4.if存在条件简写方法 if (likeJavaScript === true) 简写: if (likeJavaScript) 只有likeJavaScript是真值时,二者语句才相等 如果判断值不是真值,则可以这样: leta;if(a!==true){//dosomething...} 简写: leta;if(!a){//dosomething...} 5.JavaScript循环简写方法 for (let i = 0; i < allImgs.length; i++) 简写:for (let index in allImgs)也可以使用Array.forEach: functionlogArrayElements(element,index,array){console.log("a["+index+"]="+element);}[2,5,9].forEach(logArrayElements);//logs://a[0]=2//a[1]=5//a[2]=9 6.短路评价 给一个变量分配的值是通过判断其值是否为null或undefined,则可以: letdbHost;if(process.env.DB_HOST){dbHost=process.env.DB_HOST;}else{dbHost='localhost';} 简写:const dbHost = process.env.DB_HOST || 'localhost'; 7.十进制指数 当需要写数字带有很多零时(如10000000),可以采用指数(1e7)来代替这个数字:for (let i = 0; i < 10000; i++) {}简写: for(leti=0;i<1e7;i++){}//下面都是返回true1e0===1;1e1===10;1e2===100;1e3===1000;1e4===10000;1e5===100000; 8.对象属性简写 如果属性名与key名相同,则可以采用ES6的方法:const obj = { x:x, y:y }; 简写: const obj = { x, y }; 9.箭头函数简写 传统函数编写方法很容易让人理解和编写,但是当嵌套在另一个函数中,则这些优势就荡然无存。 functionsayHello(name){console.log('Hello',name);}setTimeout(function(){console.log('Loaded')},2000);list.forEach(function(item){console.log(item);}); 简写: sayHello=name=>console.log('Hello',name);setTimeout(()=>console.log('Loaded'),2000);list.forEach(item=>console.log(item)); 10.隐式返回值简写 经常使用return语句来返回函数最终结果,一个单独语句的箭头函数能隐式返回其值(函数必须省略{}为了省略return关键字) 为返回多行语句(例如对象字面表达式),则需要使用()包围函数体。 functioncalcCircumference(diameter){returnMath.PI*diameter}varfunc=functionfunc(){return{foo:1};}; 简写: calcCircumference=diameter=>(Math.PI*diameter;)varfunc=()=>({foo:1}); 11.默认参数值 为了给函数中参数传递默认值,通常使用if语句来编写,但是使用ES6定义默认值,则会很简洁: functionvolume(l,w,h){if(w===undefined)w=3;if(h===undefined)h=4;returnl*w*h;} 简写: volume=(l,w=3,h=4)=>(l*w*h);volume(2)//output:24 12.模板字符串 传统的JavaScript语言,输出模板通常是这样写的。 constwelcome='Youhaveloggedinas'+first+''+last+'.'constdb='http://'+host+':'+port+'/'+database; ES6可以使用反引号和${}简写: constwelcome=`Youhaveloggedinas${first}${last}`;constdb=`http://${host}:${port}/${database}`; 13.解构赋值简写方法 在web框架中,经常需要从组件和API之间来回传递数组或对象字面形式的数据,然后需要解构它 constobservable=require('mobx/observable');constaction=require('mobx/action');construnInAction=require('mobx/runInAction');conststore=this.props.store;constform=this.props.form;constloading=this.props.loading;consterrors=this.props.errors;constentity=this.props.entity; 简写: import{observable,action,runInAction}from'mobx';const{store,form,loading,errors,entity}=this.props; 也可以分配变量名: const{store,form,loading,errors,entity:contact}=this.props;//最后一个变量名为contact 14.多行字符串简写 需要输出多行字符串,需要使用+来拼接: constlorem='Loremipsumdolorsitamet,consectetur\n\t'+'adipisicingelit,seddoeiusmodtemporincididunt\n\t'+'utlaboreetdoloremagnaaliqua.Utenimadminim\n\t'+'veniam,quisnostrudexercitationullamcolaboris\n\t'+'nisiutaliquipexeacommodoconsequat.Duisaute\n\t'+'iruredolorinreprehenderitinvoluptatevelitesse.\n\t' 使用反引号,则可以达到简写作用: constlorem=`Loremipsumdolorsitamet,consecteturadipisicingelit,seddoeiusmodtemporincididuntutlaboreetdoloremagnaaliqua.Utenimadminimveniam,quisnostrudexercitationullamcolaborisnisiutaliquipexeacommodoconsequat.Duisauteiruredolorinreprehenderitinvoluptatevelitesse.` 15.扩展运算符简写 扩展运算符有几种用例让JavaScript代码更加有效使用,可以用来代替某个数组函数。 //joiningarraysconstodd=[1,3,5];constnums=[2,4,6].concat(odd);//cloningarraysconstarr=[1,2,3,4];constarr2=arr.slice() 简写: //joiningarraysconstodd=[1,3,5];constnums=[2,4,6,...odd];console.log(nums);//[2,4,6,1,3,5]//cloningarraysconstarr=[1,2,3,4];constarr2=[...arr]; 不像concat()函数,可以使用扩展运算符来在一个数组中任意处插入另一个数组。 constodd=[1,3,5];constnums=[2,...odd,4,6]; 也可以使用扩展运算符解构: const{a,b,...z}={a:1,b:2,c:3,d:4};console.log(a)//1console.log(b)//2console.log(z)//{c:3,d:4} 16.强制参数简写 JavaScript中如果没有向函数参数传递值,则参数为undefined。为了增强参数赋值,可以使用if语句来抛出异常,或使用强制参数简写方法。 functionfoo(bar){if(bar===undefined){thrownewError('Missingparameter!');}returnbar;} 简写: mandatory=()=>{thrownewError('Missingparameter!');}foo=(bar=mandatory())=>{returnbar;} 17.Array.find简写 想从数组中查找某个值,则需要循环。在ES6中,find()函数能实现同样效果。 constpets=[{type:'Dog',name:'Max'},{type:'Cat',name:'Karl'},{type:'Dog',name:'Tommy'},]functionfindDog(name){for(leti=0;i<pets.length;++i){if(pets[i].type==='Dog'&&pets[i].name===name){returnpets[i];}}} 简写: pet=pets.find(pet=>pet.type==='Dog'&&pet.name==='Tommy');console.log(pet);//{type:'Dog',name:'Tommy'} 18.Object[key]简写 考虑一个验证函数 functionvalidate(values){if(!values.first)returnfalse;if(!values.last)returnfalse;returntrue;}console.log(validate({first:'Bruce',last:'Wayne'}));//true 假设当需要不同域和规则来验证,能否编写一个通用函数在运行时确认? //对象验证规则constschema={first:{required:true},last:{required:true}}//通用验证函数constvalidate=(schema,values)=>{for(fieldinschema){if(schema[field].required){if(!values[field]){returnfalse;}}}returntrue;}console.log(validate(schema,{first:'Bruce'}));//falseconsole.log(validate(schema,{first:'Bruce',last:'Wayne'}));//true 现在可以有适用于各种情况的验证函数,不需要为了每个而编写自定义验证函数了 19.双重非位运算简写 有一个有效用例用于双重非运算操作符。可以用来代替Math.floor(),其优势在于运行更快,可以阅读此文章了解更多位运算。 Math.floor(4.9) === 4 //true 简写:~~4.9 === 4 //true 本文分享自微信公众号 - JavaScript忍者秘籍(js-obok)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
优秀的个人博客,低调大师

超详细Netty入门,看这篇就够了!

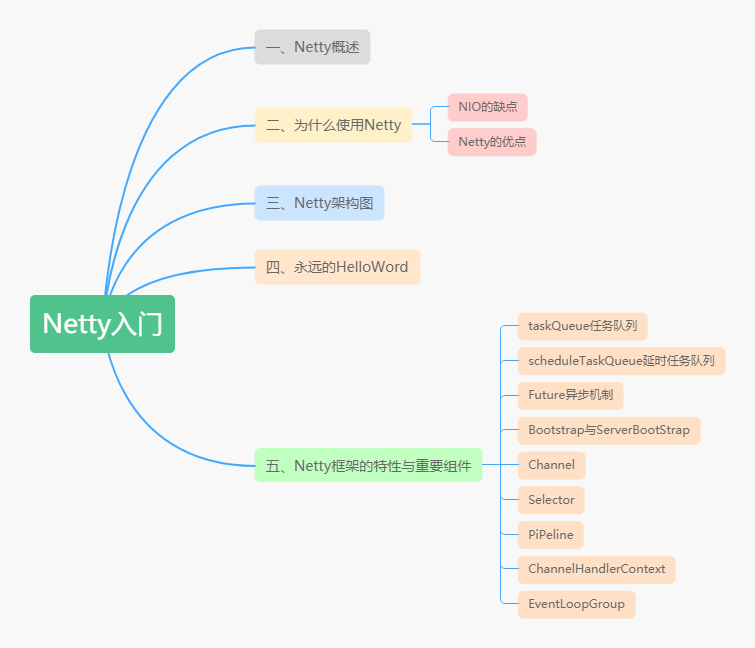
思维导图 前言 本文主要讲述Netty框架的一些特性以及重要组件,希望看完之后能对Netty框架有一个比较直观的感受,希望能帮助读者快速入门Netty,减少一些弯路。 一、Netty概述 官方的介绍: Netty is an asynchronous event-driven network application framework for rapid development of maintainable high performance protocol servers & clients. Netty是 一个异步事件驱动的网络应用程序框架,用于快速开发可维护的高性能协议服务器和客户端。 二、为什么使用Netty 从官网上介绍,Netty是一个网络应用程序框架,开发服务器和客户端。也就是用于网络编程的一个框架。既然是网络编程,Socket就不谈了,为什么不用NIO呢? 2.1 NIO的缺点 对于这个问题,之前我写了一篇文章《NIO入门》对NIO有比较详细的介绍,NIO的主要问题是: NIO的类库和API繁杂,学习成本高,你需要熟练掌握Selector、ServerSocketChannel、SocketChannel、ByteBuffer等。 需要熟悉Java多线程编程。这是因为NIO编程涉及到Reactor模式,你必须对多线程和网络编程非常熟悉,才能写出高质量的NIO程序。 臭名昭著的epoll bug。它会导致Selector空轮询,最终导致CPU 100%。直到JDK1.7版本依然没得到根本性的解决。 2.2 Netty的优点 相对地,Netty的优点有很多: API使用简单,学习成本低。 功能强大,内置了多种解码编码器,支持多种协议。 性能高,对比其他主流的NIO框架,Netty的性能最优。 社区活跃,发现BUG会及时修复,迭代版本周期短,不断加入新的功能。 Dubbo、Elasticsearch都采用了Netty,质量得到验证。 三、架构图 上面这张图就是在官网首页的架构图,我们从上到下分析一下。 绿色的部分Core核心模块,包括零拷贝、API库、可扩展的事件模型。 橙色部分Protocol Support协议支持,包括Http协议、webSocket、SSL(安全套接字协议)、谷歌Protobuf协议、zlib/gzip压缩与解压缩、Large File Transfer大文件传输等等。 红色的部分Transport Services传输服务,包括Socket、Datagram、Http Tunnel等等。 以上可看出Netty的功能、协议、传输方式都比较全,比较强大。 四、永远的Hello Word 首先搭建一个HelloWord工程,先熟悉一下API,还有为后面的学习做铺垫。以下面这张图为依据: 4.1 引入Maven依赖 使用的版本是4.1.20,相对比较稳定的一个版本。 <dependency> <groupId>io.netty</groupId> <artifactId>netty-all</artifactId> <version>4.1.20.Final</version> </dependency> 4.2 创建服务端启动类 public class MyServer { public static void main(String[] args) throws Exception { //创建两个线程组 boosGroup、workerGroup EventLoopGroup bossGroup = new NioEventLoopGroup(); EventLoopGroup workerGroup = new NioEventLoopGroup(); try { //创建服务端的启动对象,设置参数 ServerBootstrap bootstrap = new ServerBootstrap(); //设置两个线程组boosGroup和workerGroup bootstrap.group(bossGroup, workerGroup) //设置服务端通道实现类型 .channel(NioServerSocketChannel.class) //设置线程队列得到连接个数 .option(ChannelOption.SO_BACKLOG, 128) //设置保持活动连接状态 .childOption(ChannelOption.SO_KEEPALIVE, true) //使用匿名内部类的形式初始化通道对象 .childHandler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel socketChannel) throws Exception { //给pipeline管道设置处理器 socketChannel.pipeline().addLast(new MyServerHandler()); } });//给workerGroup的EventLoop对应的管道设置处理器 System.out.println("java技术爱好者的服务端已经准备就绪..."); //绑定端口号,启动服务端 ChannelFuture channelFuture = bootstrap.bind(6666).sync(); //对关闭通道进行监听 channelFuture.channel().closeFuture().sync(); } finally { bossGroup.shutdownGracefully(); workerGroup.shutdownGracefully(); } } } 4.3 创建服务端处理器 /** * 自定义的Handler需要继承Netty规定好的HandlerAdapter * 才能被Netty框架所关联,有点类似SpringMVC的适配器模式 **/ public class MyServerHandler extends ChannelInboundHandlerAdapter { @Override public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception { //获取客户端发送过来的消息 ByteBuf byteBuf = (ByteBuf) msg; System.out.println("收到客户端" + ctx.channel().remoteAddress() + "发送的消息:" + byteBuf.toString(CharsetUtil.UTF_8)); } @Override public void channelReadComplete(ChannelHandlerContext ctx) throws Exception { //发送消息给客户端 ctx.writeAndFlush(Unpooled.copiedBuffer("服务端已收到消息,并给你发送一个问号?", CharsetUtil.UTF_8)); } @Override public void exceptionCaught(ChannelHandlerContext ctx, Throwable cause) throws Exception { //发生异常,关闭通道 ctx.close(); } } 4.4 创建客户端启动类 public class MyClient { public static void main(String[] args) throws Exception { NioEventLoopGroup eventExecutors = new NioEventLoopGroup(); try { //创建bootstrap对象,配置参数 Bootstrap bootstrap = new Bootstrap(); //设置线程组 bootstrap.group(eventExecutors) //设置客户端的通道实现类型 .channel(NioSocketChannel.class) //使用匿名内部类初始化通道 .handler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel ch) throws Exception { //添加客户端通道的处理器 ch.pipeline().addLast(new MyClientHandler()); } }); System.out.println("客户端准备就绪,随时可以起飞~"); //连接服务端 ChannelFuture channelFuture = bootstrap.connect("127.0.0.1", 6666).sync(); //对通道关闭进行监听 channelFuture.channel().closeFuture().sync(); } finally { //关闭线程组 eventExecutors.shutdownGracefully(); } } } 4.5 创建客户端处理器 public class MyClientHandler extends ChannelInboundHandlerAdapter { @Override public void channelActive(ChannelHandlerContext ctx) throws Exception { //发送消息到服务端 ctx.writeAndFlush(Unpooled.copiedBuffer("歪比巴卜~茉莉~Are you good~马来西亚~", CharsetUtil.UTF_8)); } @Override public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception { //接收服务端发送过来的消息 ByteBuf byteBuf = (ByteBuf) msg; System.out.println("收到服务端" + ctx.channel().remoteAddress() + "的消息:" + byteBuf.toString(CharsetUtil.UTF_8)); } } 4.6 测试 先启动服务端,再启动客户端,就可以看到结果: MyServer打印结果: MyClient打印结果: 五、Netty的特性与重要组件 5.1 taskQueue任务队列 如果Handler处理器有一些长时间的业务处理,可以交给taskQueue异步处理。怎么用呢,请看代码演示: public class MyServerHandler extends ChannelInboundHandlerAdapter { @Override public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception { //获取到线程池eventLoop,添加线程,执行 ctx.channel().eventLoop().execute(new Runnable() { @Override public void run() { try { //长时间操作,不至于长时间的业务操作导致Handler阻塞 Thread.sleep(1000); System.out.println("长时间的业务处理"); } catch (Exception e) { e.printStackTrace(); } } }); } } 我们打一个debug调试,是可以看到添加进去的taskQueue有一个任务。 5.2 scheduleTaskQueue延时任务队列 延时任务队列和上面介绍的任务队列非常相似,只是多了一个可延迟一定时间再执行的设置,请看代码演示: ctx.channel().eventLoop().schedule(new Runnable() { @Override public void run() { try { //长时间操作,不至于长时间的业务操作导致Handler阻塞 Thread.sleep(1000); System.out.println("长时间的业务处理"); } catch (Exception e) { e.printStackTrace(); } } },5, TimeUnit.SECONDS);//5秒后执行 依然打开debug进行调试查看,我们可以有一个scheduleTaskQueue任务待执行中 5.3 Future异步机制 在搭建HelloWord工程的时候,我们看到有一行这样的代码: ChannelFuture channelFuture = bootstrap.connect("127.0.0.1", 6666); 很多操作都返回这个ChannelFuture对象,究竟这个ChannelFuture对象是用来做什么的呢? ChannelFuture提供操作完成时一种异步通知的方式。一般在Socket编程中,等待响应结果都是同步阻塞的,而Netty则不会造成阻塞,因为ChannelFuture是采取类似观察者模式的形式进行获取结果。请看一段代码演示: //添加监听器 channelFuture.addListener(new ChannelFutureListener() { //使用匿名内部类,ChannelFutureListener接口 //重写operationComplete方法 @Override public void operationComplete(ChannelFuture future) throws Exception { //判断是否操作成功 if (future.isSuccess()) { System.out.println("连接成功"); } else { System.out.println("连接失败"); } } }); 5.4 Bootstrap与ServerBootStrap Bootstrap和ServerBootStrap是Netty提供的一个创建客户端和服务端启动器的工厂类,使用这个工厂类非常便利地创建启动类,根据上面的一些例子,其实也看得出来能大大地减少了开发的难度。首先看一个类图: 可以看出都是继承于AbstractBootStrap抽象类,所以大致上的配置方法都相同。 一般来说,使用Bootstrap创建启动器的步骤可分为以下几步: 5.4.1 group() 在上一篇文章《Reactor模式》中,我们就讲过服务端要使用两个线程组: bossGroup 用于监听客户端连接,专门负责与客户端创建连接,并把连接注册到workerGroup的Selector中。 workerGroup用于处理每一个连接发生的读写事件。 一般创建线程组直接使用以下new就完事了: EventLoopGroup bossGroup = new NioEventLoopGroup(); EventLoopGroup workerGroup = new NioEventLoopGroup(); 有点好奇的是,既然是线程组,那线程数默认是多少呢?深入源码: //使用一个常量保存 private static final int DEFAULT_EVENT_LOOP_THREADS; static { //NettyRuntime.availableProcessors() * 2,cpu核数的两倍赋值给常量 DEFAULT_EVENT_LOOP_THREADS = Math.max(1, SystemPropertyUtil.getInt( "io.netty.eventLoopThreads", NettyRuntime.availableProcessors() * 2)); if (logger.isDebugEnabled()) { logger.debug("-Dio.netty.eventLoopThreads: {}", DEFAULT_EVENT_LOOP_THREADS); } } protected MultithreadEventLoopGroup(int nThreads, Executor executor, Object... args) { //如果不传入,则使用常量的值,也就是cpu核数的两倍 super(nThreads == 0 ? DEFAULT_EVENT_LOOP_THREADS : nThreads, executor, args); } 通过源码可以看到,默认的线程数是cpu核数的两倍。假设想自定义线程数,可以使用有参构造器: //设置bossGroup线程数为1 EventLoopGroup bossGroup = new NioEventLoopGroup(1); //设置workerGroup线程数为16 EventLoopGroup workerGroup = new NioEventLoopGroup(16); 5.4.2 channel() 这个方法用于设置通道类型,当建立连接后,会根据这个设置创建对应的Channel实例。 使用debug模式可以看到 通道类型有以下: NioSocketChannel: 异步非阻塞的客户端 TCP Socket 连接。 NioServerSocketChannel: 异步非阻塞的服务器端 TCP Socket 连接。 常用的就是这两个通道类型,因为是异步非阻塞的。所以是首选。 OioSocketChannel: 同步阻塞的客户端 TCP Socket 连接。 OioServerSocketChannel: 同步阻塞的服务器端 TCP Socket 连接。 稍微在本地调试过,用起来和Nio有一些不同,是阻塞的,所以API调用也不一样。因为是阻塞的IO,几乎没什么人会选择使用Oio,所以也很难找到例子。我稍微琢磨了一下,经过几次报错之后,总算调通了。代码如下: //server端代码,跟上面几乎一样,只需改三个地方 //这个地方使用的是OioEventLoopGroup EventLoopGroup bossGroup = new OioEventLoopGroup(); ServerBootstrap bootstrap = new ServerBootstrap(); bootstrap.group(bossGroup)//只需要设置一个线程组boosGroup .channel(OioServerSocketChannel.class)//设置服务端通道实现类型 //client端代码,只需改两个地方 //使用的是OioEventLoopGroup EventLoopGroup eventExecutors = new OioEventLoopGroup(); //通道类型设置为OioSocketChannel bootstrap.group(eventExecutors)//设置线程组 .channel(OioSocketChannel.class)//设置客户端的通道实现类型 NioSctpChannel: 异步的客户端 Sctp(Stream Control Transmission Protocol,流控制传输协议)连接。 NioSctpServerChannel: 异步的 Sctp 服务器端连接。 本地没启动成功,网上看了一些网友的评论,说是只能在linux环境下才可以启动。从报错信息看:SCTP not supported on this platform,不支持这个平台。因为我电脑是window系统,所以网友说的有点道理。 5.4.3 option()与childOption() 首先说一下这两个的区别。 option()设置的是服务端用于接收进来的连接,也就是boosGroup线程。 childOption()是提供给父管道接收到的连接,也就是workerGroup线程。 搞清楚了之后,我们看一下常用的一些设置有哪些: SocketChannel参数,也就是childOption()常用的参数: SO_RCVBUF Socket参数,TCP数据接收缓冲区大小。TCP_NODELAY TCP参数,立即发送数据,默认值为Ture。SO_KEEPALIVE Socket参数,连接保活,默认值为False。启用该功能时,TCP会主动探测空闲连接的有效性。 ServerSocketChannel参数,也就是option()常用参数: SO_BACKLOG Socket参数,服务端接受连接的队列长度,如果队列已满,客户端连接将被拒绝。默认值,Windows为200,其他为128。 由于篇幅限制,其他就不列举了,大家可以去网上找资料看看,了解一下。 5.4.4 设置流水线(重点) ChannelPipeline是Netty处理请求的责任链,ChannelHandler则是具体处理请求的处理器。实际上每一个channel都有一个处理器的流水线。 在Bootstrap中childHandler()方法需要初始化通道,实例化一个ChannelInitializer,这时候需要重写initChannel()初始化通道的方法,装配流水线就是在这个地方进行。代码演示如下: //使用匿名内部类的形式初始化通道对象 bootstrap.childHandler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel socketChannel) throws Exception { //给pipeline管道设置自定义的处理器 socketChannel.pipeline().addLast(new MyServerHandler()); } }); 处理器Handler主要分为两种: ChannelInboundHandlerAdapter(入站处理器)、ChannelOutboundHandler(出站处理器) 入站指的是数据从底层java NIO Channel到Netty的Channel。 出站指的是通过Netty的Channel来操作底层的java NIO Channel。 ChannelInboundHandlerAdapter处理器常用的事件有: 注册事件 fireChannelRegistered。 连接建立事件 fireChannelActive。 读事件和读完成事件 fireChannelRead、fireChannelReadComplete。 异常通知事件 fireExceptionCaught。 用户自定义事件 fireUserEventTriggered。 Channel 可写状态变化事件 fireChannelWritabilityChanged。 连接关闭事件 fireChannelInactive。 ChannelOutboundHandler处理器常用的事件有: 端口绑定 bind。 连接服务端 connect。 写事件 write。 刷新时间 flush。 读事件 read。 主动断开连接 disconnect。 关闭 channel 事件 close。 还有一个类似的handler(),主要用于装配parent通道,也就是bossGroup线程。一般情况下,都用不上这个方法。 5.4.5 bind() 提供用于服务端或者客户端绑定服务器地址和端口号,默认是异步启动。如果加上sync()方法则是同步。 有五个同名的重载方法,作用都是用于绑定地址端口号。不一一介绍了。 5.4.6 优雅地关闭EventLoopGroup //释放掉所有的资源,包括创建的线程 bossGroup.shutdownGracefully(); workerGroup.shutdownGracefully(); 会关闭所有的child Channel。关闭之后,释放掉底层的资源。 5.5 Channel Channel是什么?不妨看一下官方文档的说明: A nexus to a network socket or a component which is capable of I/O operations such as read, write, connect, and bind 翻译大意:一种连接到网络套接字或能进行读、写、连接和绑定等I/O操作的组件。 如果上面这段说明比较抽象,下面还有一段说明: A channel provides a user: the current state of the channel (e.g. is it open? is it connected?),the configuration parameters of the channel (e.g. receive buffer size),the I/O operations that the channel supports (e.g. read, write, connect, and bind), andthe ChannelPipeline which handles all I/O events and requests associated with the channel. 翻译大意: channel为用户提供: 通道当前的状态(例如它是打开?还是已连接?) channel的配置参数(例如接收缓冲区的大小) channel支持的IO操作(例如读、写、连接和绑定),以及处理与channel相关联的所有IO事件和请求的ChannelPipeline。 5.5.1 获取channel的状态 boolean isOpen(); //如果通道打开,则返回true boolean isRegistered();//如果通道注册到EventLoop,则返回true boolean isActive();//如果通道处于活动状态并且已连接,则返回true boolean isWritable();//当且仅当I/O线程将立即执行请求的写入操作时,返回true。 以上就是获取channel的四种状态的方法。 5.5.2 获取channel的配置参数 获取单条配置信息,使用getOption(),代码演示: ChannelConfig config = channel.config();//获取配置参数 //获取ChannelOption.SO_BACKLOG参数, Integer soBackLogConfig = config.getOption(ChannelOption.SO_BACKLOG); //因为我启动器配置的是128,所以我这里获取的soBackLogConfig=128 获取多条配置信息,使用getOptions(),代码演示: ChannelConfig config = channel.config(); Map<ChannelOption<?>, Object> options = config.getOptions(); for (Map.Entry<ChannelOption<?>, Object> entry : options.entrySet()) { System.out.println(entry.getKey() + " : " + entry.getValue()); } /** SO_REUSEADDR : false WRITE_BUFFER_LOW_WATER_MARK : 32768 WRITE_BUFFER_WATER_MARK : WriteBufferWaterMark(low: 32768, high: 65536) SO_BACKLOG : 128 以下省略... */ 5.5.3 channel支持的IO操作 写操作,这里演示从服务端写消息发送到客户端: @Override public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception { ctx.channel().writeAndFlush(Unpooled.copiedBuffer("这波啊,这波是肉蛋葱鸡~", CharsetUtil.UTF_8)); } 客户端控制台: //收到服务端/127.0.0.1:6666的消息:这波啊,这波是肉蛋葱鸡~ 连接操作,代码演示: ChannelFuture connect = channelFuture.channel().connect(new InetSocketAddress("127.0.0.1", 6666));//一般使用启动器,这种方式不常用 通过channel获取ChannelPipeline,并做相关的处理: //获取ChannelPipeline对象 ChannelPipeline pipeline = ctx.channel().pipeline(); //往pipeline中添加ChannelHandler处理器,装配流水线 pipeline.addLast(new MyServerHandler()); 5.6 Selector 在NioEventLoop中,有一个成员变量selector,这是nio包的Selector,在之前《NIO入门》中,我已经讲过Selector了。 Netty中的Selector也和NIO的Selector是一样的,就是用于监听事件,管理注册到Selector中的channel,实现多路复用器。 5.7 PiPeline与ChannelPipeline 在前面介绍Channel时,我们知道可以在channel中装配ChannelHandler流水线处理器,那一个channel不可能只有一个channelHandler处理器,肯定是有很多的,既然是很多channelHandler在一个流水线工作,肯定是有顺序的。 于是pipeline就出现了,pipeline相当于处理器的容器。初始化channel时,把channelHandler按顺序装在pipeline中,就可以实现按序执行channelHandler了。 在一个Channel中,只有一个ChannelPipeline。该pipeline在Channel被创建的时候创建。ChannelPipeline包含了一个ChannelHander形成的列表,且所有ChannelHandler都会注册到ChannelPipeline中。 5.8 ChannelHandlerContext 在Netty中,Handler处理器是有我们定义的,上面讲过通过集成入站处理器或者出站处理器实现。这时如果我们想在Handler中获取pipeline对象,或者channel对象,怎么获取呢。 于是Netty设计了这个ChannelHandlerContext上下文对象,就可以拿到channel、pipeline等对象,就可以进行读写等操作。 通过类图,ChannelHandlerContext是一个接口,下面有三个实现类。 实际上ChannelHandlerContext在pipeline中是一个链表的形式。看一段源码就明白了: //ChannelPipeline实现类DefaultChannelPipeline的构造器方法 protected DefaultChannelPipeline(Channel channel) { this.channel = ObjectUtil.checkNotNull(channel, "channel"); succeededFuture = new SucceededChannelFuture(channel, null); voidPromise = new VoidChannelPromise(channel, true); //设置头结点head,尾结点tail tail = new TailContext(this); head = new HeadContext(this); head.next = tail; tail.prev = head; } 下面我用一张图来表示,会更加清晰一点: 5.9 EventLoopGroup 我们先看一下EventLoopGroup的类图: 其中包括了常用的实现类NioEventLoopGroup。OioEventLoopGroup在前面的例子中也有使用过。 从Netty的架构图中,可以知道服务器是需要两个线程组进行配合工作的,而这个线程组的接口就是EventLoopGroup。 每个EventLoopGroup里包括一个或多个EventLoop,每个EventLoop中维护一个Selector实例。 5.9.1 轮询机制的实现原理 我们不妨看一段DefaultEventExecutorChooserFactory的源码: private final AtomicInteger idx = new AtomicInteger(); private final EventExecutor[] executors; @Override public EventExecutor next() { //idx.getAndIncrement()相当于idx++,然后对任务长度取模 return executors[idx.getAndIncrement() & executors.length - 1]; } 这段代码可以确定执行的方式是轮询机制,接下来debug调试一下: 它这里还有一个判断,如果线程数不是2的N次方,则采用取模算法实现。 @Override public EventExecutor next() { return executors[Math.abs(idx.getAndIncrement() % executors.length)]; } 写在最后 参考Netty官网文档:API文档 创作不易,觉得有用就点个赞吧。 我不要下次一定,希望这次一定素质三连,感谢! 想第一时间看到我更新的文章,可以微信搜索公众号「java技术爱好者」,拒绝做一条咸鱼,我是一个努力让大家记住的程序员。我们下期再见!!! 能力有限,如果有什么错误或者不当之处,请大家批评指正,一起学习交流!

优秀的个人博客,低调大师

微服务超全的设计选型参考

云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 微服务架构模式的核心包含如下几部分: 微服务之间的 RPC 通信。Java Chassis 提供了非常高效的通信方式,并支持多协议扩展,比如最快的 REST 通信模式实现, 异步的二进制通信模式 HIGHWAY 。 分布式微服务实例和服务发现。结合 ServiceComb Service Center, 实现分布式、多集群服务发现能力,以及强大的微服务元数据管理能力。 配置外置,动态、集中的配置管理。能够使用 ServiceComb Kie, 华为云配置中心、 Nacos、 Apollo 等多种配置中心, 并且和 Spring Boot 配置管理能力完整融合。 分布式故障管理,服务容错、隔离、熔断。内置故障实例隔离、故障重试、耗时接口隔离等重要分布式故障处理能力。可选使用 Hystrix 的 容错、隔离、熔断能力, 只需要做简单的配置。 分布式日志追踪。提供 Open Tracing 支持。 此外还有性能监控,日志记录系统、健康检查等。Java Chassis 采用优雅的设计模式,实现了上述所有的核心部件的功能,并且使得这些功能 开箱即用。使用 Java Chassis , 开发者能够更加聚焦于业务功能开发,快速的构建商业可用的微服务应用。 Java Chassis 的软件工程实践 Java Chassis 在设计的时候, 不仅考虑了如何更好的使用微服务架构模式, 还把优秀的软件工程思想融合进来, 帮助开发者更好的管理信息 资产, 提升软件工程管理能力。 下图简单的描述 “以契约为中心” 的核心概念。 可以通过 Invocation 获取到 Java Chassis 的契约等源数据信息, 是 Java Chassis 的一个核心对象。 Java Chassis 的运行时架构 为了支持软件工程实践, Java Chassis 的运行时架构是一个哑铃结构, 两端分别是“编程模型” 和 “通信模型”, 中间是“运行模型”。 “编程模型” 面向开发者写服务接口的习惯, “通信模型” 面向微服务之间的高效编码和通信, “运行模型” 基于“契约”, 提供一种服务服务无关 的插拔机制,能够让开发者独立于业务实现开发治理功能,并且灵活的移除和增加功能,以及调整这些治理功能的处理顺序。 “运行模型” 的核心抽象接口是 Handler , 这个接口是一个异步的定义, Java Chassis 运行时模型采用纯异步的实现, 让整个系统运行非常 高效。 Java Chassis 微服务应用架构 有很多优秀的微服务应用架构实践。微服务应用架构应该充分考虑系统的弹性, 能够针对系统的性能瓶颈点进行扩容, 需要考虑应用系统内部微服务 拆分的灵活性, 为业务的变更做好及时调整。 下图展示了一个典型的应用架构。接入层采用一些网络基础设施,比如 DNS , 浮动 IP 等方便用户采用统一的 URL 访问系统, 或者采用 API 网关等 基础设施实现系统的能力开放。业务层包含应用网关, 进行一些认证鉴权、 审计等功能, 经过认证的请求被应用网关转发到微服务系统内部。 Java Chassis 微服务技术选型 Java 语言拥有庞大的技术体系和标准, 并且广泛的应用到业务的系统的各个方面。和 Java Chassis 有紧密关系的技术包括 JSP/Servlet 标准 和容器, Spring 和 Spring Boot 技术, 以及 Spring Boot 提供的 REST 开发框架 Spring MVC。 Java Chassis 和 JSP/Servlet 标准 Java Chassis 不依赖于 JSP/Servlet 标准, 可以基于 Vert.x 的 HTTP 实现, 提供非常轻量级和高效的 REST 服务, 在性能要求高的核心 业务场景, 使用这种轻量级的技术非常合适。这种场景下, 没有完整的实现 JSP/Servlet 相关接口, 比如 HttpServletRequest, HttpServletResponse 等。 servicecomb-samples ( https://github.com/apache/servicecomb-samples/tree/master/porter_lightweight ) 提供了一个完整的使用这种部署模式的例子。 Java Chassis 可以部署运行于 JSP/Servlet 容器里面, 在这个场景下, Java Chassis 的核心部件就是一个 Servlet , 在这个 Servlet 里面 实现了 Java Chassis 的核心 RPC 系统。采用 JSP/Servlet 容器运行 Java Chassis, 业务请求首先经过容器的 HTTP 实现, 然后经过 Filter, 进入 Java Chassis 的 RestServlet , 运行 Java Chassis 的运行时模型 (Handlers) , 进入业务接口处理。 Java Chassis 和 Spring、Spring Boot Java Chassis 目前依赖于 Spring, 但是从设计上是可以独立于 Spring 运行的。Spring 是被广泛使用的技术, 非常轻量级, 在 Java Chassis 中可以直接使用 Spring 相关的技术。Java Chassis 不依赖于 Spring Boot, 但是可以将 Java Chassis 运行于 Spring Boot 基础之上。 Spring Boot 2 开始也提供了多种运行环境支持, WebApplicationType.NONE, WebApplicationType.SERVLET, WebApplicationType.REACTIVE, Java Chassis 可以集成 NONE, SERVLET 两种模式。在 NONE 模式下集成 Java Chassis, 和 Spring Boot 自身的 REACTIVE 非常类似, 但是比 Spring Boot 的 REACTIVE 运行更加高效, 并且支持早期的 RestTemplate API 和 RPC API 来访问服务。 Spring MVC Java Chassis 继承了 Spring MVC 的接口设计, 提供了 Provider 和 Consumer 层面的 API 接口来定义 REST 接口和访问 REST 接口。但是需要 注意的是, 两个是完全不同的实现, 实现机制也不一样。Spring Boot 主要基于 Servlet, 实现了 MVC 模式, 不仅可以开发 REST 接口, 还可以 开发其他 HTTP 功能, 比如重定向, 返回 HTML 页面等, 还可以通过 @ExceptionHandler, @ControllerAdvice 等机制拦截 Servlet 请求,进行 异常处理。Java Chassis 只实现了 REST 服务定义和调用, 并且在异常处理机制和请求拦截机制上不一样。 Java Chassis 与 Spring Cloud Java Chassis 和 Spring Cloud 都实现了微服务架构模式, 相比而言, Java Chassis 是一个更加紧凑的实现, 开箱即用, 而 Spring Cloud 则是 相对松散的实现, 整合了大量的 Hystrix 组件。 微服务架构模式关注微服务内部和微服务之间的设计, 也关注微服务与微服务基础设施之间的关系。Java Chassis 微服务基础设施包括服务注册和发现, 服务配置管理, 灰度发布和契约管理等功能。Spring Cloud 可以使用 spring-cloud-huawei ( https://github.com/huaweicloud/spring-cloud-huawei ) 来使用 Java Chassis 相关的微服务基础设施。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/zhibo 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-04-02本文作者:sandag本文来自:“51CTO”,了解相关信息可以关注“51CTO”

优秀的个人博客,低调大师

APIJSON 3.7.0 发布,Star 超 6666 支持 JFinal

APIJSON 3.7.0更新内容: 新增支持多表关联操作的事务处理; RemoteFunction 内强制校验远程函数必须符合 Function 表的配置; Function 表新增 methods,tag,version 用于限制远程函数的使用范围; APIJSONBoot 升级 fastjson 版本,纠正版本号; APIJSONFinal 与 APIJSONBoot 同步代码和依赖; 完善对首页简介及通过用文档的英文翻译,感谢@ruoranw 的贡献; 具体见Release 发布版本。 已通过 APIAuto自动化接口回归测试(两个测试账号,85+66=151 条测试用例)。 APIJSON 简介 APIJSON是一种专为API而生的JSON网络传输协议以及基于这套协议实现的ORM库。 为简单的增删改查、复杂的查询、简单的事务操作提供了完全自动化的API。 能大幅降低开发和沟通成本,简化开发流程,缩短开发周期。 适合中小型前后端分离的项目,尤其是互联网创业项目和企业自用项目。 通过自动化API,前端可以定制任何数据、任何结构! 大部分HTTP请求后端再也不用写接口了,更不用写文档了! 前端再也不用和后端沟通接口或文档问题了!再也不会被文档各种错误坑了! 后端再也不用为了兼容旧接口写新版接口和文档了!再也不会被前端随时随地没完没了地烦了! APIJSON 生态内项目 APIAuto自动化接口管理工具,自动生成文档与注释、自动生成代码、自动化回归测试、自动静态检查等 apijson-docAPIJSON 官方文档,提供排版清晰、搜索方便的文档内容展示,包括设计规范、图文教程等 apijson.orgAPIJSON 官方网站,提供 APIJSON 的 功能简介、登记用户、作者与贡献者、相关链接 等 APIJSON.NETC# 版 APIJSON ,支持 MySQL, PostgreSQL, MS SQL Server, Oracle, SQLite apijson-phpPHP 版 APIJSON,基于 ThinkPHP,支持 MySQL, PostgreSQL, MS SQL Server, Oracle 等 apijsonNode.ts 版 APIJSON,支持 MySQL, PostgreSQL, MS SQL Server, Oracle, SQLite, MariaDB, WebSQL uliweb-apijsonPython 版 APIJSON,支持 MySQL, PostgreSQL, MS SQL Server, Oracle, SQLite 等 APIJSONGo 版 APIJSON,功能开发中... APIJSONKOTLINKotlin 版 APIJSON,基础框架搭建中... APIJSONParser第三方 APIJSON 解析器,将 JSON 动态解析成 SQL ApiJsonByJFinal整合 APIJSON 和 JFinal 的 Demo SpringServer1.2-APIJSON智慧党建服务器端,提供 上传 和 下载 文件的接口 APIJSON-Android-RxJava仿微信朋友圈动态实战项目,ZBLibrary(UI) + APIJSON(HTTP) + RxJava(Data) 感谢热心的作者们的贡献,点 ⭐Star 支持下他们吧。 几周前主项目的Star 在 6666 时特地截屏纪念,现在 6789 了嘿嘿。 创作不易,Gitee右上角点 ⭐Star 支持下吧,谢谢^_^ https://gitee.com/TommyLemon/APIJSON

优秀的个人博客,低调大师

阿里云服务器超详细连接

今天发布 更新一下1、远程服务器安装iis+php+mysql环境 iis+php+mysql环境:https://download.csdn.net/download/qq_39161501/10402847 2、解析域名 3、登录服务器绑定域名服务器路径 4、 (1)云服务器ECSA->网络和安全->安全组->创建安全组 https://help.aliyun.com/document_detail/25471.html 5、 (1)云服务器ECS->实例->点击(实例ID/名称) (2)弹出本地实例安全组->加入安全组->找到创建的test安全组 6、访问网址(阿里云服务器搭建成功) 护卫神集成环境下载地址:https://www.huweishen.com/ 护卫神集成环境下载地址:https://www.huweishen.com/优惠详情路径

优秀的个人博客,低调大师

Android超简单的进度条源码

相信大家都知道,打开程序的时候,需要通过进度条或者图片显示。这个时候很方便给应用程序优质的效果。下面我们来看看是如何实现进度条的代码,原理非常简单。 如图: packagecom.smart; importandroid.app.Activity; importandroid.os.Bundle; importandroid.os.Handler; importandroid.widget.ProgressBar; publicclassMainextendsActivity{ privateProgressBarpro1; privateProgressBarpro2; privateHandlerhandler=newHandler(); privateintcount1=0; privateintcount2=0;//进度条的从0开始 privateRunnabledoUpdateProgressBar1=newRunnable(){ @Override publicvoidrun(){ for(count1=0;count1<pro1.getMax();count1++){ handler.post(newRunnable(){ //增加进度 @Override publicvoidrun(){ pro1.setProgress(count1); } }); } } }; privateRunnabledoUpdateProgressBar2=newRunnable(){ @Override publicvoidrun(){ for(count2=0;count2<pro2.getMax();count2++){ handler.post(newRunnable(){ @Override publicvoidrun(){ pro2.setProgress(count2); } }); } } }; @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.main); pro1=(ProgressBar)findViewById(R.id.progressBar1);//得到组件 pro2=(ProgressBar)findViewById(R.id.progressBar2); Threadthread1=newThread(doUpdateProgressBar1,"thread1"); thread1.start();//开始 Threadthread2=newThread(doUpdateProgressBar2,"thread2"); thread2.start(); } } <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:orientation="vertical" android:layout_width="fill_parent" android:layout_height="fill_parent" > <ProgressBar android:id="@+id/progressBar1" android:layout_width="fill_parent" android:layout_height="wrap_content" style="?android:attr/progressBarStyleHorizontal" android:max="20000" /> <ProgressBar android:id="@+id/progressBar2" android:layout_width="fill_parent" android:layout_height="wrap_content" style="?android:attr/progressBarStyleHorizontal" android:max="20000" android:layout_marginTop="10dp" /> </LinearLayout> 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/517713,如需转载请自行联系原作者

优秀的个人博客,低调大师

Swift:超炫的View Controller切换动画

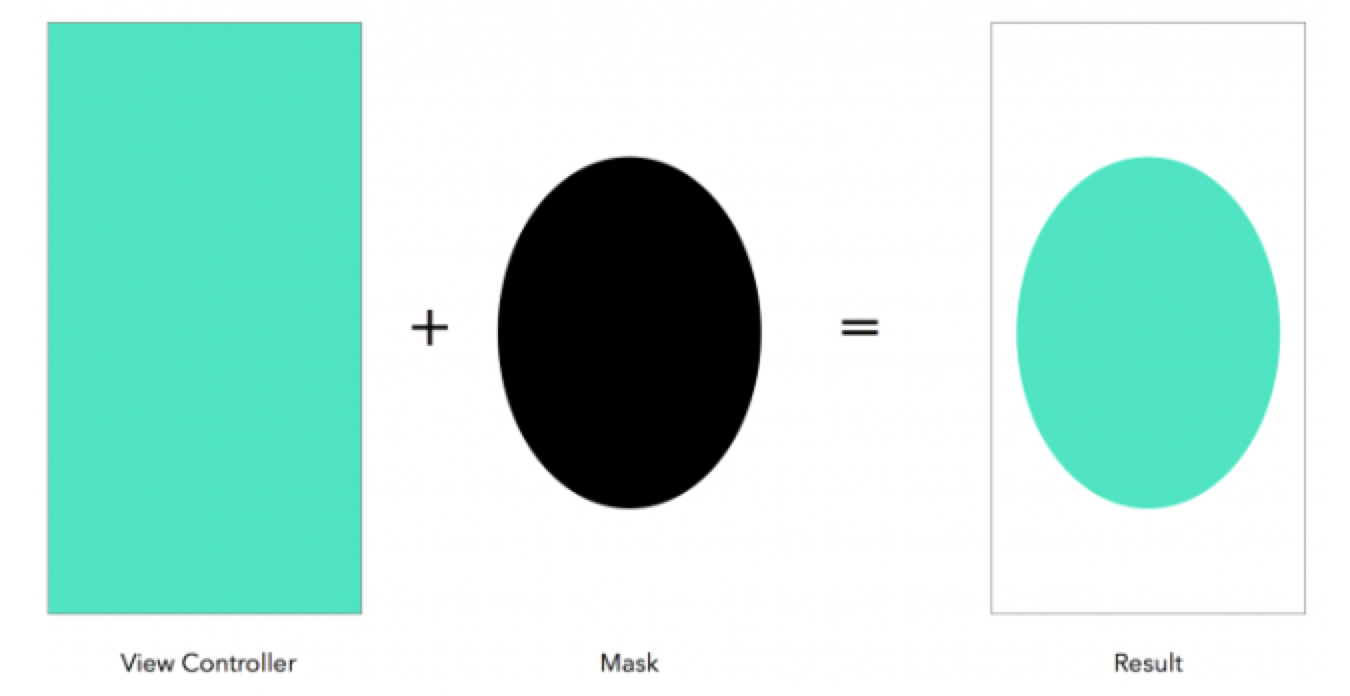
匿名社交应用Secret的开发者开发了一款叫做Ping的应用,用户可以他们感兴趣的话题的推送。 Ping有一个很炫的东西,就是主界面和之间切换的动画做的非常的好。每次看到一个非常炫的动画,都不由得会想:“这个东西我要不要自己实现以下”。哈哈~~~ 这个教程里,你会学到如何用Swift实现这样的很酷的动画。你会学到如何使用shape layer,遮罩和使用UIViewControllerAnimnatedTransitioning协议和UIPercentDrivenInteractivetransition类等实现View Controller界面切换动画。 不过需要注意,这里假定你已经有一定的Swift开发基础。如果只是初学的话,请自行查看我得其他Swift教程。 开篇简介 我们主要介绍Ping里从一个View Controller跳转到另一个的时候的动画。 在iOS里,你可以在UINavigationController中放入两个View Controller,并实现UIViewControllerAnimatedTransitioning协议来实现界面切换的动画。具体的细节有: 动画的时间长度 创建一个容器View来控制两个View Controller的View 可以实现任意你能想到的动画 这些动画,你可以用UIView得动画方法来作,也可以用core animation这样的比较底层的方法来做。本教程会使用后者。 如何实现 现在你已经知道代码大概会添加到什么地方。下面讨论下如何实现那个Ping的那个圈圈动画。这动画严格的描述起来是: 圆圈是从右侧的按钮产生。并且从圈中可以看到下面一层试图的内容。 也就是说,这个圆圈是一个遮罩。圆圈里的都可以看到,外面的全部都隐藏。 你可以用CALayer的mask可以达到这个效果。当然还需要设置alpha为0来隐藏下面一个视图的内容。alpha值设定为1的时候显示下面视图的内容。 现在你就懂了遮罩了。下一步就是决定用哪一种CAShapeLayer来实现这个遮罩。只需要修改这些CAShapeLayer组成的圆圈的半径。 现在开始 这里就不十分详细的叙述了,都是些关于创建和配置项目的步骤。 1. 创建一个新的项目。选择一个single view application 2. 项目名称设置为CircleTransition。语言选择Swift。Devices就选择iPhone 项目到此初步创建好了。在Main.stroyboard里只有一个view controller。但是我们的动画需要两个至少的view controller。不过首先需要把现在的这个view controller和UINavigationController关联起来。选中这个唯一的view controller,之后在菜单栏中选择Editor->Embed In->Navigation Controller。之后这个navigation controller就会成为initial controller,后面连着最开始生成的那个view controller。之后,选中这个navigation controller,在右侧菜单栏的第四个tab中勾去“Shows navigation bar”。因为在我们的app中不需要navigation bar。 接下来添加另外一个view controller。给这个view controller指定class为ViewController。 然后,给每一个view controller,除了navigation controller,添加一个按钮。双击按钮,删除文字,之后把按钮的背景色设置为黑色。另外一个按钮也同样处理。给这两个按钮设定autolayout。指定他们在右上角上。指定这两个按钮的宽度和高度为40。 最后让按钮变成圆形的。右边菜单的第三个tab中选择“user defined runtime attributes”。点下面的加号,添加如图所示的内容。设置button的corner radius为15。 这样这个按钮在运行起来的时候就是圆形的了。设定完成之后暂时看不到这个效果。运行起来以后: 现在需要在每个view controller中添加些内容了。先把这两个view controller的背景色修改一下。 现在这个app大致已经成型了。不同的颜色可以代表你将来要显示出来的各种各样的内容。所需要的就是把这个两个view controller连起来。在橘色的controller的按钮中放下鼠标。按下ctrl然后把光标拖动到另外一个controller上。这是会出现一个弹出的菜单。把这个菜单的action用同样的方法和这个controller再连接一次,并选择show。这样,在这个按钮选择的时候,navigation controller就会push到下一个view controller中。这是一个segue。后面的教程会需要这个segue所以这里给这个segue一个identifer,叫做“PushSegue”。运行代码,点击橘色controller的按钮就会跳转到紫色的controller了。 因为这是一个循环的过程,所以从橘色到紫色之后还需要从紫色回到橘色。现在就完成这个功能。首先,在紫色controller绑定的ViewController类中添加一个action方法。 @IBAction func circleTapped(sender: UIButton){ self.navigationController?.popViewControllerAnimated(true) } 并添加紫色controller上的按钮的引用,这个会在后面用到: @IBOutlet weak var button: UIButton! 之后给紫色controller的按钮的“touch up inside”事件添加上面的@IBAction。 绑定按钮的属性: 再运行起来看看。橘色到紫色,紫色到橘色循环往复! 注意:两个view controller都需要绑定按钮和按钮事件!否则后面的动画只能执行一次! 自定义动画 这里主要处理的就是navigation controller的push和pop动画。这需要我们实现UINavigationControllerDelegate协议的animationControllerForOperation方法。直接在ViewController中添加一个新的类: class NavigationControllerDelegate: NSObject, UINavigationControllerDelegate{ func navigationController(navigationController: UINavigationController, animationControllerForOperation operation: UINavigationControllerOperation, fromViewController fromVC: UIViewController, toViewController toVC: UIViewController) -> UIViewControllerAnimatedTransitioning? { return nil } } 首先,在右侧的菜单中选中Object这个item。 之后,把这个东西拖动到navigation controller secene下。 然后选中这个Object,在右侧菜单的第三个tab上修改class为我们刚刚定义的NavigationControllerDelegate。 下一步,给navigation controller指定delegate。选中navigation controller,然后在右侧最后的菜单中连接navigation controller的delegate选项到刚刚拖进来的Object上: 这个时候还是不会有特定的效果出现。因为方法还是空的,只能算是一个placeholder方法。 func navigationController(navigationController: UINavigationController, animationControllerForOperation operation: UINavigationControllerOperation, fromViewController fromVC: UIViewController, toViewController toVC: UIViewController) -> UIViewControllerAnimatedTransitioning? { return nil } 这个方法接受两个在navigation controller中得controller。从一个跳转到另一个的两个controller。并返回一个实现了UIViewControllerAnimatedTransitioning的对象。所以,我们需要创建一个实现了UIViewControllerAnimatedTransitioning协议的类。 class CircleTransitionAnimator: NSObject, UIViewControllerAnimatedTransitioning 首先添加一个属性: weak var transitionContext: UIViewControllerContextTransitioning? 这个属性会在后面的代码中用到。 添加一个方法: func transitionDuration(transitionContext: UIViewControllerContextTransitioning) -> NSTimeInterval { return 0.5 } 这个方法返回动画执行的时间。 添加动画方法: func animateTransition(transitionContext: UIViewControllerContextTransitioning) { // 1 self.transitionContext = transitionContext // 2 var containerView = transitionContext.containerView() var fromViewController = transitionContext.viewControllerForKey(UITransitionContextFromViewControllerKey) as ViewController var toViewController = transitionContext.viewControllerForKey(UITransitionContextToViewControllerKey) as ViewController var button = fromViewController.button // 3 containerView.addSubview(toViewController.view) // 4 var circleMaskPathInitial = UIBezierPath(ovalInRect: button.frame) var extremePoint = CGPointMake(button.center.x, button.center.y - CGRectGetHeight(toViewController.view.bounds)) // need more research var radius = sqrt(extremePoint.x * extremePoint.x + extremePoint.y * extremePoint.y) var circleMaskPathFinal = UIBezierPath(ovalInRect: CGRectInset(button.frame, -radius, -radius)) // 5 var maskLayer = CAShapeLayer() maskLayer.path = circleMaskPathFinal.CGPath toViewController.view.layer.mask = maskLayer // 6 var maskLayerAnimation = CABasicAnimation(keyPath: "path") maskLayerAnimation.fromValue = circleMaskPathInitial.CGPath maskLayerAnimation.toValue = circleMaskPathFinal.CGPath maskLayerAnimation.duration = self.transitionDuration(self.transitionContext!) maskLayerAnimation.delegate = self maskLayer.addAnimation(maskLayerAnimation, forKey: "CircleAnimation") } 一步步的解释: transitionContext属性保持了一个类成员的引用。这样在后面的代码中可以用到。 取出containerView以及fromViewController和toViewController和controller上面的button引用。动画主要还是作用在container view上的。 把toViewController的view添加到container view上。 创建两个路劲,一个就是button的大小(button在运行起来之后是圆形的),另一个要足够大到可以cover整个screen。动画就是在这两个path上来来回回。 创建一个CAShapeLayer作为mask用。给这个layer的path赋值为circleMaskPathFinal,否则动画执行完成以后可能又缩回来。 创建一个CABasicAnimation动画,key path是“path”,这个动画作用于layer的path属性上。动画从circleMaskPathInitial执行到circleMaskPathFinal。并给这个动画添加一个delegate,在动画执行完成以后清理现场。 实现animation代理的方法: override func animationDidStop(anim: CAAnimation!, finished flag: Bool) { self.transitionContext?.completeTransition(!self.transitionContext!.transitionWasCancelled()) self.transitionContext?.viewControllerForKey(UITransitionContextFromViewControllerKey)?.view.layer.mask = nil } 现在就可以用CircleTransitionAnimator来实现动画的效果了。修改代码NavigationControllerDelegate的代码: class NavigationControllerDelegate: NSObject, UINavigationControllerDelegate{ func navigationController(navigationController: UINavigationController, animationControllerForOperation operation: UINavigationControllerOperation, fromViewController fromVC: UIViewController, toViewController toVC: UIViewController) -> UIViewControllerAnimatedTransitioning? { return CircleTransitionAnimator() } } 运行起来吧。点击黑色的按钮,动画效果就出现了。 感觉不错吧,但是这个是不够的! 给动画添加手势响应 我们还要给这个动画添加一个可以响应手势的transition。响应手势需要用到一个方法:navigationController->interactionControllerForAnimationController。这是UINavigationControllerDelegate中得一个方法。这个方法返回一个实现了协议UIViewControllerInteractiveTransitioning的对象。 iOS的SDK中提供了一个UIPercentDrivenInteractiveTransition的类。这个类实现了上面的协议,并且提供了很多其他的手势处理实现。 在NavigationControllerDelegate类中添加以下的属性和方法: class NavigationControllerDelegate: NSObject, UINavigationControllerDelegate{ var interactionController: UIPercentDrivenInteractiveTransition? func navigationController(navigationController: UINavigationController, animationControllerForOperation operation: UINavigationControllerOperation, fromViewController fromVC: UIViewController, toViewController toVC: UIViewController) -> UIViewControllerAnimatedTransitioning? { return CircleTransitionAnimator() } func navigationController(navigationController: UINavigationController, interactionControllerForAnimationController animationController: UIViewControllerAnimatedTransitioning) -> UIViewControllerInteractiveTransitioning? { return self.interactionController } } 既然是响应手势的,那么一个pan的手势是必不可少的了。不过首先要添加一些辅助的东西。 1. 在NavigationControllerDelegate中添加对navigation controller的引用。 @IBOutlet weak var navigationController: UINavigationController? 给这个引用添加对navigation controller的引用,如图: 实现awakeFromNib方法: override func awakeFromNib() { super.awakeFromNib() var pan = UIPanGestureRecognizer(target: self, action: "panned:") self.navigationController!.view.addGestureRecognizer(pan) } 当pan这个动作在navigation controller的view上发生的时候就会触发panned回调方法。给这个方法添加如下代码: func panned(gestureRecognizer: UIPanGestureRecognizer){ switch gestureRecognizer.state { case .Began: self.interactionController = UIPercentDrivenInteractiveTransition() if self.navigationController?.viewControllers.count > 1 { self.navigationController?.popViewControllerAnimated(true) } else{ self.navigationController?.topViewController.performSegueWithIdentifier("PushSegue", sender: nil) } case .Changed: var translation = gestureRecognizer.translationInView(self.navigationController!.view) var completionProgress = translation.x / CGRectGetWidth(self.navigationController!.view.bounds) self.interactionController?.updateInteractiveTransition(completionProgress) case .Ended: if gestureRecognizer.velocityInView(self.navigationController!.view).x > 0 { self.interactionController?.finishInteractiveTransition() } else{ self.interactionController?.cancelInteractiveTransition() } self.interactionController = nil default: self.interactionController?.cancelInteractiveTransition() self.interactionController = nil } } 在Begin中,pan手势一开始执行就初始化出UIPercentDrivenInteractiveTransition对象,并作为值赋给属性self.interactionController。 如果在第一个view controller就设定一个push(在早先定义的一个segue),在第二个view controller的时候就设定一个pop。 在navigation controller的push或者pop的时候则触发NavigationControllerDelegate的返回self.interactionController对象的方法。 Changed,在这个方法中根据手势移动的距离让动画移动不同的距离。这里apple已经替我们做了很多。 Ended,这里你会看到手势的移动速度。如果是正则transition结束,如果是负则取消。同时,把interactionController值设置为nil。 default,如果是其他的状态就直接取消trnasition并把interactionController值设置为nil。 运行程序,在屏幕上左右移动你的手指看看效果吧! 欢迎加群互相学习,共同进步。QQ群:iOS: 58099570 | Android: 572064792 | Nodejs:329118122 做人要厚道,转载请注明出处! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sunshine-anycall/p/4283255.html ,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册