首页 文章 精选 留言 我的

精选列表

搜索[递归超智能],共10000篇文章
优秀的个人博客,低调大师

商用市场发力,Chromebook 销量超 Mac

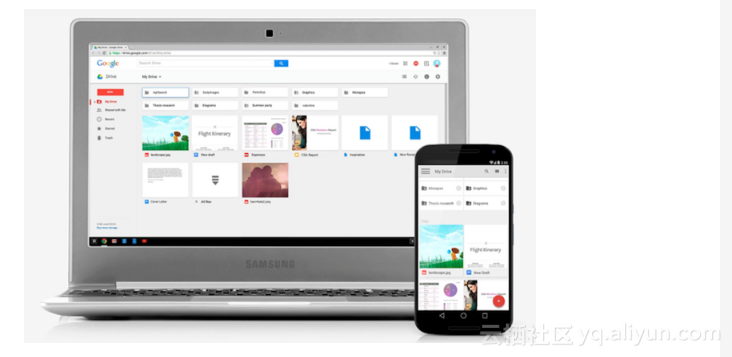
IDC最近的市场调查显示,2016第一季度美国市场Chromebook笔记本电脑的销量接近200万台,首次超过苹果Mac电脑,后者同期的销量只有176万台。 IDC认为Chromebook今天的业绩主要归功于K12教育市场份额的提升,谷歌公司在教育市场的大力推广收到了成效。 但是教育市场并不是Chromebook增长动力的全部,去年市场调查公司NPD发布的数据显示,Chromebook在企业级技术市场取得了重大突破,虽然很多企业依然依赖Windows电脑,但是搭载ChromeOS和Android的商用设备在2015年上半年增长了29%,增长速度远超Windows和苹果公司的产品。 Chromebook的市场表现说明,Chromebook作为上网、处理邮件和行业应用的低成本的计算工具,可以很好满足学生和上班族的需要,而且ChromeOS最近也增强了其离线功能,进一步提高了Chromebook的实用性和适用性。 文章转载自 开源中国社区[http://www.oschina.net]

优秀的个人博客,低调大师

Android属性动画源代码解析(超详细)

本文假定你已经对属性动画有了一定的了解,至少使用过属性动画。下面我们就从属性动画最简单的使用开始。 ObjectAnimator .ofInt(target,propName,values[]) .setInterpolator(LinearInterpolator) .setEvaluator(IntEvaluator) .setDuration(500) .start(); 相信这段代码对你一定不陌生,代码中有几个地方是本文中将要重点关注的,setInterpolator(...)、setEvaluator(...)、setDuration(...)在源代码中是如何被使用的。另外,我们也将重点关注Android中属性动画是如何一步步地实现动画效果的(精确到每一帧(frame))。最后啰嗦几句,本文中使用的代码是Android 4.2.2。 上面代码的作用就是生成一个属性动画,根据ofInt()我们知道只是一个属性值类型为Int的View的动画。先放过其他的函数,从ObjectAnimator的start()函数开始。 public void start() { //...省略不必要代码 super.start(); } 从代码中我们知道,它调用了父类的start()方法,也就是ValueAnimator.start()。这个方法内部又调用了自身类内部的start(boolean playBackwards)方法。 /** * 方法简要介绍: * 这个方法开始播放动画。这个start()方法使用一个boolean值playBackwards来判断是否需 * 要回放动画。这个值通常为false,但当它从reverse()方法被调用的时候也 * 可能为true。有一点需要注意的是,这个方法必须从UI主线程调用。 */ private void start(boolean playBackwards) { if (Looper.myLooper() == null) { throw new AndroidRuntimeException("Animators may only be run on Looper threads"); } mPlayingBackwards = playBackwards; mCurrentIteration = 0; mPlayingState = STOPPED; mStarted = true; mStartedDelay = false; AnimationHandler animationHandler = getOrCreateAnimationHandler(); animationHandler.mPendingAnimations.add(this); if (mStartDelay == 0) { // 在动画实际运行前,设置动画的初始值 setCurrentPlayTime(0); mPlayingState = STOPPED; mRunning = true; notifyStartListeners(); } animationHandler.start(); } 对代码中几个值的解释: mPlayingStated代表当前动画的状态。用于找出什么时候开始动画(if state == STOPPED)。当然也用于在animator被调用了cancel()或end()在动画的最后一帧停止它。可能的值为STOPPED, RUNNING, SEEKED. mStarted是Animator中一个额外用于标识播放状态的值,用来指示这个动画是否需要延时执行。 mStartedDelay指示这个动画是否已经从startDelay中开始执行。 AnimationHandleranimationHandler 是一个实现了Runnable接口的ValueAnimator内部类,暂时先放过,后面我们会具体谈到。 从上面这段代码中,我们了解到一个ValueAnimator有它自己的状态(STOPPED, RUNNING, SEEKED),另外是否延时也影响ValueAnimator的执行。代码的最后调用了animationHandler.start(),看来动画就是从这里启动的。别急,我们还没初始化ValueAnimator呢,跟进setCurrentPlayTime(0)看看。 public void setCurrentPlayTime(long playTime) { initAnimation(); long currentTime = AnimationUtils.currentAnimationTimeMillis(); if (mPlayingState != RUNNING) { mSeekTime = playTime; mPlayingState = SEEKED; } mStartTime = currentTime - playTime; doAnimationFrame(currentTime); } 这个函数在animation开始前,设置它的初始值。这个函数用于设置animation进度为指定时间点。playTime应该介于0到animation的总时间之间,包括animation重复执行的时候。如果animation还没有开始,那么它会等到被设置这个时间后才开始。如果animation已经运行,那么setCurrentTime()会将当前的进度设置为这个值,然后从这个点继续播放。 接下来让我们看看initAnimation() void initAnimation() { if (!mInitialized) { int numValues = mValues.length; for (int i = 0; i < numValues; ++i) { mValues[i].init(); } mInitialized = true; } } 这个函数一看就觉得跟初始化动画有关。这个函数在处理动画的第一帧前就会被调用。如果startDelay不为0,这个函数就会在就会在延时结束后调用。它完成animation最终的初始化。 那么mValues是什么呢?还记得我们在文章的开头介绍ObjectAnimator的使用吧?还有一个ofInt(T target, Propertyproperty, int... values)方法没有介绍。官方文档中对这个方法的解释是:构造并返回一个在int类型的values数值之间ObjectAnimator对象。当values只有一个值的时候,这个值就作为animator的终点值。如果有两个值的话,那么这两个值就作为开始值和结束值。如果有超过两个以上的值的话,那么这些值就作为开始值,作为animator运行的中间值,以及结束值。这些值将均匀地分配到animator的持续时间。,> 先中断ObjectAnimator.start()流程的分析,回到开头ObjectAnimator.ofInt(...) 接下来让我们深入ofInt(...)的内部看看。 public static ObjectAnimator ofInt(Object target, String propertyName, int... values) { ObjectAnimator anim = new ObjectAnimator(target, propertyName); anim.setIntValues(values); return anim; } 对这个函数的解释: target 就是将要进行动画的对象 propertyName 就是这个对象属性将要进行动画的属性名 values 一组值。随着时间的推移,动画将根据这组值进行变化。 再看看anim.setIntValues这个函数 public void setIntValues(int... values) { if (mValues == null || mValues.length == 0) { // No values yet - this animator is being constructed piecemeal. Init the values with // whatever the current propertyName is if (mProperty != null) { setValues(PropertyValuesHolder.ofInt(mProperty, values)); } else { setValues(PropertyValuesHolder.ofInt(mPropertyName, values)); } } else { super.setIntValues(values); } } 一开始的时候,mProperty肯定还没有初始化,我们进去setValues(PropertyValuesHolder.ofInt(mPropertyName, values))看看。这里涉及到PropertyValuesHolder这个类。PropertyValuesHolder这个类拥有关于属性的信息和动画期间需要使用的值。PropertyValuesHolder对象可以用来和ObjectAnimator或ValueAnimator一起创建可以并行操作不PropertyValuesHolder同属性的animator。 那么PropertyValuesHolder.ofInt()是干嘛用的呢?它通过传入的属性和values来构造并返回一个特定类型的PropertyValuesHolder对象(在这里是IntPropertyValuesHolder类型)。 public static PropertyValuesHolder ofInt(String propertyName, int... values) { return new IntPropertyValuesHolder(propertyName, values); } 在IntPropertyValuesHolder内部 public IntPropertyValuesHolder(String propertyName, int... values) { super(propertyName); setIntValues(values); } @Override public void setIntValues(int... values) { super.setIntValues(values); mIntKeyframeSet = (IntKeyframeSet) mKeyframeSet; } 跳转到父类(PropertyValuesHolder)的setIntValues public void setIntValues(int... values) { mValueType = int.class; mKeyframeSet = KeyframeSet.ofInt(values); } 这个函数其实跟我们前面介绍到的 PropertyValueHolder的构造函数相似,它就是设置动画过程中需要的值。如果只有一个值,那么这个值就假定为animator的终点值,动画的初始值会自动被推断出来,通过对象的getter方法得到。当然,如果所有值都为空,那么同样的这些值也会在动画开始的时候也会自动被填上。这套自动推断填值的机制只在PropertyValuesHolder对象跟ObjectAnimator一起使用的时候才有效,并且有一个能从propertyName自动推断出的getter方法这些条件都成立的时候才能用,不然PropertyValuesHolder没有办法决定这些值是什么。 接下来我们看到KeyframeSet.ofInt(values)方法。KeyframeSet这个类持有Keyframe的集合,在一组给定的animator的关键帧(keyframe)中会被ValueAnimator用来计算值。这个类的访问权限为包可见,因为这个类实现Keyframe怎么被存储和使用的具体细节,外部不需要知道。 接下来我们看看KeyframeSet.ofInt(values)方法。 public static KeyframeSet ofInt(int... values) { int numKeyframes = values.length; IntKeyframe keyframes[] = new IntKeyframe[Math.max(numKeyframes,2)]; if (numKeyframes == 1) { keyframes[0] = (IntKeyframe) Keyframe.ofInt(0f); keyframes[1] = (IntKeyframe) Keyframe.ofInt(1f, values[0]); } else { keyframes[0] = (IntKeyframe) Keyframe.ofInt(0f, values[0]); for (int i = 1; i < numKeyframes; ++i) { keyframes[i] = (IntKeyframe) Keyframe.ofInt((float) i / (numKeyframes - 1), values[i]); } } return new IntKeyframeSet(keyframes); } 在这个方法里面,我们看见从最开始的ObjectAnimator.ofInt(target,propName,values[]),也就是我们在文章的开头使用系统提供的动画初始化函数中传入的int数组,在这里得到了具体的使用。先不关心具体的使用Keyframe.ofInt(...)。从这里我们就可以知道原来Android SDK通过传入的int[]的长度来决定animator中每个帧(frame)的值。具体的对传入的int[]的使用可以参考文章里面对ObjectAnimator.ofInt(...)的介绍。在KeyframeSet.ofInt这个函数的最后一句话使用了IntKeyframeSet的构造函数来初始化这些Keyframe。 public IntKeyframeSet(IntKeyframe... keyframes) { super(keyframes); } 在IntKeyframeSet的构造函数中又调用父类KeyframeSet的构造函数来实现。 public KeyframeSet(Keyframe... keyframes) { mNumKeyframes = keyframes.length; mKeyframes = new ArrayList<Keyframe>(); mKeyframes.addAll(Arrays.asList(keyframes)); mFirstKeyframe = mKeyframes.get(0); mLastKeyframe = mKeyframes.get(mNumKeyframes - 1); mInterpolator = mLastKeyframe.getInterpolator(); } 从这个构造函数中我们又可以了解到刚刚初始化后的Keyframe数组的第一项和最后一项(也就是第一帧和最后一帧)得到了优先的待遇,作为在KeyframeSet中的字段,估计是为了后面计算动画开始和结束的时候方便。 小结ObjectValue、PropertyValueHolder、KeyframeSet的关系 我们绕了很久,不知道是否把你弄晕了,这里稍稍总结一下。我们就不从调用的顺序一步步分析下来了,太长了。我直接说说ObjectValue、PropertyValueHolder、KeyframeSet之间的关系。这三个类比较有特点的地方,ObjectAnimator无疑是对的API接口,ObjectAnimator持有PropertyValuesHolder作为存储关于将要进行动画的具体对象(通常是View类型的控件)的属性和动画期间需要的值。而PropertyValueHolder又使用KeyframeSet来保存animator从开始到结束期间关键帧的值。这下子我们就了解animator在执行期间用来存储和使用的数据结构。废话一下,从PropertyValueHolder、KeyframeSet这个两个类的源代码来看,这三个类的API的设计挺有技巧的,他们都是通过将具有特定类型的实现作为一个大的概况性的类的内部实现,通过这个大的抽象类提供对外的API(例如,PropertyValuesHolder.ofInt(...)的实现)。 回到ObjectAnimator.start()流程的分析 不知道是否把你上面你是否能清楚,反正不太影响下面对ObjectAnimator.start()流程的分析。从上面一段的分析我们了解到ValueAnimator.initAnimation()中的mValue是 PropertyValuesHolder类型的东西。在initAnimation()里mValues[i].init()初始化它们的估值器Evaluator void init() { if (mEvaluator == null) { // We already handle int and float automatically, but not their Object // equivalents mEvaluator = (mValueType == Integer.class) ? sIntEvaluator : (mValueType == Float.class) ? sFloatEvaluator : null; } if (mEvaluator != null) { // KeyframeSet knows how to evaluate the common types - only give it a custom // evaluator if one has been set on this class mKeyframeSet.setEvaluator(mEvaluator); } } mEvaluator当然也可以使用ObjectAnimator.setEvaluator(...)传入;为空时,SDK根据mValueType为我们初始化特定类型的Evaluator。这样我们的初始化就完成了。接下来,跳出initAnimation()回到 setCurrentPlayTime(...) public void setCurrentPlayTime(long playTime) { initAnimation(); long currentTime = AnimationUtils.currentAnimationTimeMillis(); if (mPlayingState != RUNNING) { mSeekTime = playTime; mPlayingState = SEEKED; } mStartTime = currentTime - playTime; doAnimationFrame(currentTime); } 对animator三种状态STOPPED、RUNNING、SEEKED的解释 static final int STOPPED = 0; // 还没开始播放 static final int RUNNING = 1; // 正常播放中 static final int SEEKED = 2; // 定位到一些时间值(Seeked to some time value) 对mSeekedTime、mStartTime的解释 mSeekedTime 当setCurrentPlayTime()被调用的时候设置。如果为负数,animator还没能定位到一个值。 mStartTime 第一次在animation.animateFrame()方法调用时使用。这个时间在第二次调用animateFrame()时用来确定运行时间(以及运行的分数值) setCurrentPlayTime(...)中doAnimationFrame(currentTime) 之前的代码其实都是对Animator的初始化。看来doAnimator(...)就是真正处理动画帧的函数了。这个函数主要主要用来处理animator中的一帧,并在有必要的时候调整animator的开始时间。 final boolean doAnimationFrame(long frameTime) { //对animator的开始时间和状态进行调整 if (mPlayingState == STOPPED) { mPlayingState = RUNNING; if (mSeekTime < 0) { mStartTime = frameTime; } else { mStartTime = frameTime - mSeekTime; // Now that we're playing, reset the seek time mSeekTime = -1; } } // The frame time might be before the start time during the first frame of // an animation. The "current time" must always be on or after the start // time to avoid animating frames at negative time intervals. In practice, this // is very rare and only happens when seeking backwards. final long currentTime = Math.max(frameTime, mStartTime); return animationFrame(currentTime); } 看来这个函数就是调整了一些参数,真正的处理函数还在animationFrame(...)中。我们跟进去看看。 boolean animationFrame(long currentTime) { boolean done = false; switch (mPlayingState) { case RUNNING: case SEEKED: float fraction = mDuration > 0 ? (float)(currentTime - mStartTime) / mDuration : 1f; if (fraction >= 1f) { if (mCurrentIteration < mRepeatCount || mRepeatCount == INFINITE) { // Time to repeat if (mListeners != null) { int numListeners = mListeners.size(); for (int i = 0; i < numListeners; ++i) { mListeners.get(i).onAnimationRepeat(this); } } if (mRepeatMode == REVERSE) { mPlayingBackwards = mPlayingBackwards ? false : true; } mCurrentIteration += (int)fraction; fraction = fraction % 1f; mStartTime += mDuration; } else { done = true; fraction = Math.min(fraction, 1.0f); } } if (mPlayingBackwards) { fraction = 1f - fraction; } animateValue(fraction); break; } return done; } 这个内部函数对给定的animation的一个简单的动画帧进行处理。currentTime这个参数是由定时脉冲(先不要了解这个定时脉冲是什么,后面我们会涉及)通过handler发送过来的(当然也可能是初始化的时候,被程序调用的,就像我们的分析过程一样),它用于计算animation已运行的时间,以及已经运行分数值。这个函数的返回值标识这个animation是否应该停止(在运行时间超过animation应该运行的总时长的时候,包括重复次数超过的情况)。 我们可以把这个函数里面的fraction简单地理解成animator的进度条的当前的位置。if (fraction >= 1f)注意到函数里面的这句话,当animator开始需要重复执行的时候,那么就需要执行这个if判断里面的东西,这里面主要就是记录和改变重复执行animator的一些状态和变量。为了不让这篇文章太复杂,我们这里就不进行分析了。通过最简单的animator只执行一次的情况来分析。那么接下来就应该执行animateValue(fraction)了。 void animateValue(float fraction) { fraction = mInterpolator.getInterpolation(fraction); mCurrentFraction = fraction; int numValues = mValues.length; for (int i = 0; i < numValues; ++i) { mValues[i].calculateValue(fraction); } if (mUpdateListeners != null) { int numListeners = mUpdateListeners.size(); for (int i = 0; i < numListeners; ++i) { mUpdateListeners.get(i).onAnimationUpdate(this); } } } 在每一个animator的帧,这个函数都会被调用,结合传入的参数:已运行时间分数(fraction)。这个函数将已经运行的分数转为interpolaterd分数,然后转化成一个可用于动画的值(通过evaluator、这个函数通常在animation update的时候调用,但是它也可能在end()函数调用的时候被调用,用来设置property的最终值)。 在这里我们需要理清一下Interpolaterd和evaluator之间的关系。 Interpolator:用来定义animator变化的速率。它让基础的动画效果(渐变、拉伸、平移、旋转)有加速、减速、重复等效果。在源代码中,其实interpolation的作用就是根据某一个时间点来计算它的播放时间分数,具体见官方文档。 evaluator: evaluator全部继承至TypeEvaluator接口,它只有一个evaluate()方法。它用来返回你要进行动画的那个属性在当前时间点所需要的属性值。 我们可以把动画的过程想象成是一部电影的播放,电影的播放中有进度条,Interpolator就是用来控制电影播放频率,也就是快进快退要多少倍速。然后Evaluator根据Interpolator提供的值计算当前播放电影中的哪一个画面,也就是进度条要处于什么位置。 这个函数分三步: 通过Interpolator计算出动画运行时间的分数 变量ValueAnimator中的mValues[i].calculateValue(fraction)(也就是 PropertyValuesHolder对象数组)计算当前动画的值 调用animation的onAnimationUpdate(...)通知animation更新的消息 //PropertyValuesHolder.calculateValue(...) void calculateValue(float fraction) { mAnimatedValue = mKeyframeSet.getValue(fraction); } //mKeyframeSet.getValue public Object getValue(float fraction) { // Special-case optimization for the common case of only two keyframes if (mNumKeyframes == 2) { if (mInterpolator != null) { fraction = mInterpolator.getInterpolation(fraction); } return mEvaluator.evaluate(fraction, mFirstKeyframe.getValue(), mLastKeyframe.getValue()); } if (fraction <= 0f) { final Keyframe nextKeyframe = mKeyframes.get(1); final TimeInterpolator interpolator = nextKeyframe.getInterpolator(); if (interpolator != null) { fraction = interpolator.getInterpolation(fraction); } final float prevFraction = mFirstKeyframe.getFraction(); float intervalFraction = (fraction - prevFraction) / (nextKeyframe.getFraction() - prevFraction); return mEvaluator.evaluate(intervalFraction, mFirstKeyframe.getValue(), nextKeyframe.getValue()); } else if (fraction >= 1f) { final Keyframe prevKeyframe = mKeyframes.get(mNumKeyframes - 2); final TimeInterpolator interpolator = mLastKeyframe.getInterpolator(); if (interpolator != null) { fraction = interpolator.getInterpolation(fraction); } final float prevFraction = prevKeyframe.getFraction(); float intervalFraction = (fraction - prevFraction) / (mLastKeyframe.getFraction() - prevFraction); return mEvaluator.evaluate(intervalFraction, prevKeyframe.getValue(), mLastKeyframe.getValue()); } Keyframe prevKeyframe = mFirstKeyframe; for (int i = 1; i < mNumKeyframes; ++i) { Keyframe nextKeyframe = mKeyframes.get(i); if (fraction < nextKeyframe.getFraction()) { final TimeInterpolator interpolator = nextKeyframe.getInterpolator(); if (interpolator != null) { fraction = interpolator.getInterpolation(fraction); } final float prevFraction = prevKeyframe.getFraction(); float intervalFraction = (fraction - prevFraction) / (nextKeyframe.getFraction() - prevFraction); return mEvaluator.evaluate(intervalFraction, prevKeyframe.getValue(), nextKeyframe.getValue()); } prevKeyframe = nextKeyframe; } // shouldn't reach here return mLastKeyframe.getValue(); } 我们先只关注if (mNumKeyframes == 2)这种情况,因为这种情况最常见。还记的我们使用ObjectAnimator.ofInt(...)传入的int[]数组吗?我们一般就传入动画开始值和结束值,也就是这里的mNumKeyframes ==2 的情况。这里通过mEvaluator来计算,我们看看代码(IntEvaluator.evaluate(...)的代码)。 public Integer evaluate(float fraction, Integer startValue, Integer endValue) { int startInt = startValue; return (int)(startInt + fraction * (endValue - startInt)); } mEvaluator.evaluate(...)计算后,我们就返回到ValueAnimator.animateValue(...)中,再回退到ValueAnimator.setCurrentPlayTime(...)。最后回到ValueAnimator.start(boolean playBackwards)。终于解析完了setCurrentPlayTime(...)这个函数,总结一下:这个函数主要用来初始化动画的值,当然这个初始化比我们想象中的复杂多了,它主要通过PropertyValuesHolder、Evaluator、Interpolator来进行值的初始化。PropertyValueHolder又通过KeyframeSet来存储需要的值。 我们回到文章开头介绍的ValueAnimator.start(boolean playBackwards) private void start(boolean playBackwards) { if (Looper.myLooper() == null) { throw new AndroidRuntimeException("Animators may only be run on Looper threads"); } mPlayingBackwards = playBackwards; mCurrentIteration = 0; mPlayingState = STOPPED; mStarted = true; mStartedDelay = false; AnimationHandler animationHandler = getOrCreateAnimationHandler(); animationHandler.mPendingAnimations.add(this); if (mStartDelay == 0) { // This sets the initial value of the animation, prior to actually starting it running setCurrentPlayTime(0); mPlayingState = STOPPED; mRunning = true; notifyStartListeners(); } animationHandler.start(); } 在setCurrentPlayTime(0)后,紧接着就通过notifyStartListeners()通知animation启动的消息。最后通过animationHandler.start()去执行。animationHandler是一个AnimationHandler类型的对象,它实现了runable接口。 //AnimationHandler.start() public void start() { scheduleAnimation(); } //AnimationHandler.scheduleAnimation() private void scheduleAnimation() { if (!mAnimationScheduled) { mChoreographer.postCallback(Choreographer.CALLBACK_ANIMATION, this, null); mAnimationScheduled = true; } } // Called by the Choreographer. @Override public void run() { mAnimationScheduled = false; doAnimationFrame(mChoreographer.getFrameTime()); } mHandler.start()最终就是通过mChoreographer.发送给UI系统。这个过程比较复杂,这里不介绍。我们仅仅需要知道,动画中的一帧通过这种方式发送给UI系统后,在UI系统执行完一帧后,又会回调AnimationHandler.run()。那么其实这个过程就相当于,AnimationHandler.start()开始第一次动画的执行→UI系统执行AnimationHandler.run()→UI系统执行完后,回调相关函数→再执行AnimationHandler.run().可以理解为AnimationHandler.run()会一直调用自身多次(当然这是由UI系统驱动的),直至动画结束。 这个过程比较复杂,如果你感兴趣,可以关注我的下一篇博客。 本文转自陈哈哈博客园博客,原文链接http://www.cnblogs.com/kissazi2/p/4249213.html如需转载请自行联系原作者 kissazi2

优秀的个人博客,低调大师

超赞的OOM检测(除了mat以外)

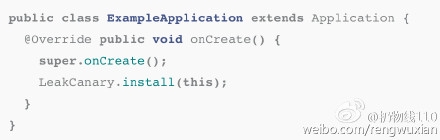
今天看了下微博,扔物线分享了个内存检测的工具: 内存泄露是 OOM 最常见的原因,但它的侦测需人工排查,往往眼看瞎也未必能找到泄露的内存。Square 新库 LeakCanary 用一种巧妙的思路实现了自动探测内存泄露,这已经帮他们减少了94%的 OOM。 在这篇文中,Square 介绍了这个帅气的库,也提出了一种新颖的获取测试设备的方式:"偷": 是不是这种检测OOm问题的方式比其MAT来说简直爽的一逼一逼的。 这是这个检测工具的官网: https://corner.squareup.com/2015/05/leak-canary.html 开源库地址:https://github.com/square/leakcanary 一下是相关翻译: LeakCanary: Detect all memory leaks! May 08, 2015 java.lang.OutOfMemoryError at android.graphics.Bitmap.nativeCreate(Bitmap.java:-2) at android.graphics.Bitmap.createBitmap(Bitmap.java:689) at com.squareup.ui.SignView.createSignatureBitmap(SignView.java:121) 没有任何人会喜欢OOM问题的出现 In Square Register, wedraw the customer's signatureon a bitmap cache. This bitmap is the size of the device's screen, and we had a significant number of out of memory (OOM) crashes when creating it. 这个图片的大小是设备大小,我们在显示这个图片的时候会出现OOM的问题。 We tried a few approaches, none of which solved the issue: 我们尝试了一些方法,其中没有解决的问题: UseBitmap.Config.ALPHA_8(a signature doesn't need color). 使用bitmap.config.alpha_8 CatchOutOfMemoryError, trigger the GC and retry a few times (inspired fromGCUtils). 抓住OutOfMemoryError,触发GC和重试几次(灵感来自gcutils)。 We didn't think of allocating bitmaps off the Java heap. Lucky for us,Frescodidn't exist yet. 我们不想把Java堆分配位图。幸运的是,Fresco这个开源项目不存在这种问题。 We were looking at it the wrong way The bitmap size was not a problem. When the memory is almost full, an OOM can happen anywhere. It tends to happen more often in places where you create big objects, like bitmaps. The OOM is a symptom of a deeper problem:memory leaks. 位图是没问题的,如果内存满的话,一个oom会出现在任何地方。当你创建比较大的对象,像bitmap这种东西的地方就会出现这种问题,oom更深层次的问题就是内存泄漏的问题。 What is a memory leak? 什么是内存泄漏呢? Some objects have a limited lifetime. When their job is done, they are expected to be garbage collected. If a chain of references holds an object in memory after the end of its expected lifetime, this creates a memory leak. When these leaks accumulate, the app runs out of memory. 许多对象是有有限制的生命周期的,当他们工作完成后,就会被垃圾回收。当对象的引用在对象的生命周期后还在持有该引用的话,就会出现内存泄漏的问题。当引用累计到一定一定时候,就会出现OOM的问题。 For instance, afterActivity.onDestroy()is called, the activity, its view hierarchy and their associated bitmaps should all be garbage collectable. If a thread running in the background holds a reference to the activity, then the corresponding memory cannot be reclaimed. This eventually leads to anOutOfMemoryErrorcrash. 例如,在Actiivity ondestroy()后,它的视图层次结构及其相关的位图应该都是垃圾收集。如果一个线程在后台运行,持有该activity引用,那么相应的内存不能被回收。这最终导致OutOfMemoryError错误,崩溃。 捕获OOM的问题 Hunting memory leaks is a manual process, well described in Raizlabs’Wrangling Dalvikseries. 捕获OOM的问题是一个手动的过程。 Here are the key steps: 关键步骤如下: Learn aboutOutOfMemoryErrorcrashes viaBugsnag,Crashlytics, or theDeveloper Console. 在使用Bugsnag,Crashlytics以及Developer Console工具去检测OutOfMemoryError这种问题。 Attempt to reproduce the problem. You might need to buy, borrow, or steal the specific device that suffered the crash. (Not all devices will exhibit all leaks!) You also need to figure out what navigation sequence triggers the leak, possibly by brute force. 重现问题,你可能需要购买或者借到一些特殊的设备来重现crash问题(并不是所有的设备都会出现这种问题),你需要知道是什么导致内存泄漏的问题,有可能是蛮力(这句翻译的有点怪,我擦)。 Dump the heap when the OOM occurs (here's how). 堆积OOM的问题 Poke around the heap dump withMATorYourKitand find an object that should have been garbage collected. 使用MAT或者YourKit工具去发现那些对象应该被回收。 Compute the shortest strong reference path from that object to the GC roots. 计算最短路径的强引用对象的GC根。 Figure out which reference in the path should not exist, and fix the memory leak. 找出那些引用是不应该存在的,并处理内存对这些引用。 What if a library could do all this before you even get to an OOM, and let you focus on fixing the memory leak? 如果有一个库帮助你在oom问题出现之前去检测OOM的问题,你会去关注如何修复内存引用的问题吗? 介绍使用LeakCanary LeakCanaryis an Open Source Java library to detect memory leaks in your debug builds. LeakCanary是一个开源项目,通过java库去检测内存泄漏的问题。 Let's look at a cat example: 看下下面的例子: class Cat { } class Box { Cat hiddenCat; } class Docker { static Box container; } // ... Box box = new Box(); Cat schrodingerCat = new Cat(); box.hiddenCat = schrodingerCat; Docker.container = box; You create aRefWatcherinstance and give it an object to watch: 你创造了一个refwatcher实例,给它一个对象去检测: // We expect schrodingerCat to be gone soon (or not), let's watch it. refWatcher.watch(schrodingerCat); When the leak is detected, you automatically get a nice leak trace: 当内存检测的时候,你会检测到内存的内存的使用的痕迹。 * GC ROOT static Docker.container * references Box.hiddenCat * leaks Cat instance We know you're busy writing features, so we made it very easy to setup. With just one line of code, LeakCanary will automatically detect activity leaks: public class ExampleApplication extends Application { @Override public void onCreate() { super.onCreate(); LeakCanary.install(this); } } You get a notification and a nice display out of the box: 你能得到通知,并且能够良好的展示在界面上: Conclusion After enabling LeakCanary, we discovered and fixed many memory leaks in our app. We even found a fewleaks in the Android SDK. 在启用的leakcanary,我们能够发现并修复你APP里面出现的内存泄漏的问题。我们甚至发现了一些leaks in the Android SDK。 The results are amazing. We now have94% fewer crashesfrom OOM errors. 结果让人吃惊,能够检测出94%的OOM的问题。 If you want to eliminate OOM crashes,install LeakCanary now! 如果你想消除OOM导致额问题,先学习leakcanary开始 我英语是数学老师教的,如果翻译的不好,请留言指教下我这个小学生,我一定会改正。

优秀的个人博客,低调大师

deepin 25 安装 LobsterAI 超简单

【本文来自deepin 论坛用户kookboy投稿】 从OpenClaw到LobsterAI:一个普通用户的“AI换妻”心路历程 最近,我干了件“狠事”——把伺候了一个月的OpenClaw卸载了,换上了LobsterAI。今天不吐不快,聊聊一个普通用户为啥要“移情别恋”。 为啥换? OpenClaw确实是条好汉,功能硬核、插件多、能折腾。但用上LobsterAI之后我才发现:原来当个“伸手党”这么爽! 1. 开箱即用,懒人福音 OpenClaw装完,我还得对着教程研究环境变量、配置文件,感觉在用之前得先考个计算机二级证书。LobsterAI装好就能干活,简直就是我这种“能坐着绝不站着,能用绝不折腾”星人的救星。 2. 啥都会干,技能点拉满 LobsterAI就像班里那个啥都懂的学霸: 处理文档(Word、PDF、PPT)?小菜一碟 数据分析(Excel公式、图表)?张口就来 搜个网页、查个信息?随叫随到 视频生成、图片创作?也会一点 定时任务、邮件管理?洒洒水 找影视/音乐资源?悄悄搞定 总之,我想干的它都会,我没想干的它也会。 其特点: 窗口生命周期管理 SQLite 数据持久化 CoworkRunner —Claude Agent SDK执行引擎 IM 网关 — 钉钉、飞书、Telegram、Discord 远程接入 40+ IPC 通道处理 安全:context isolation 启用,node integration 禁用,sandbox 启用 3. 终于能听懂人话了 LobsterAI是网易有道亲儿子,对中国网民的理解可以说是“亲妈级”。搜国内新闻、处理中文文档、找影视资源,那叫一个顺滑。不像之前用OpenClaw,总有种在跟老外解释“啥是饺子”的既视感。 4. 出门在外也能“隔空喊话” 这功能简直是我的心头好!LobsterAI支持钉钉、飞书、Telegram、Discord远程指挥。躺床上、坐地铁、甚至蹲坑时,掏出手机就能安排工作,感觉自己是老板在度假村发微信。 5. 本地化到骨子里 可以直接操作我电脑里的文件、打开本地软件、管理日历,就像请了个住家保姆,知根知底、随叫随到。 当然,OpenClaw也不是没有可取之处 开源社区热闹,极客最爱 开发者友好,想咋改咋改 插件多得能开超市 但对我说人话就是:我需要的是个能干活的老婆,不是个需要我伺候的祖宗。LobsterAI,正好是我想要的那款。 deepin 25 系统安装 LobsterAI 详细教程 LobsterAI 是由网易有道开发的全场景个人助理 Agent,基于 Electron + React 构建。如果你也在用 Deepin 25,下面是完整的安装步骤: 前置要求 Deepin 25 操作系统 Node.js >= 24 < 25(注意:需要 24.x 版本) npm 网络连接 模型 API Key(用于 AI 对话功能) 步骤一:检查 Node.js 版本 打开终端,输入: node --version ​ 如果显示 Node.js 24.x,继续下一步。 如果版本不对或没有安装,需要安装 Node.js 24: # 安装 nvm(Node 版本管理器) curl -o- https://raw.githubusercontent.com/nvm-sh/nvm/v0.39.7/install.sh * bash source ~/.bashrc # 安装 Node.js 24 nvm install 24 nvm use 24 # 验证版本 node --version ​ 步骤二:克隆项目 cd ~ git clone https://gitee.com/yngeek/lobsterai.git cd lobsterai ​ 步骤三:安装依赖 npm install ​ 步骤四:创建启动脚本 为了方便后续启动,创建一个start.sh启动脚本,注意写明“你的lobsterai项目文件夹路径”的地方: nano 你的lobsterai项目文件夹路径/start.sh ​ 粘贴以下内容: #!/bin/bash export NVM_DIR="$HOME/.config/nvm" [ -s "$NVM_DIR/nvm.sh" ] && . "$NVM_DIR/nvm.sh" cd 你的lobsterai项目文件夹路径 nvm use 24 npm run electron:dev ​ 保存并赋予执行权限: chmod +x 你的lobsterai项目文件夹路径/start.sh ​ ⚠️注意:务必把上面代码中的“你的lobsterai项目文件夹路径”的地方替换成你实际的项目路径。 步骤五:启动 LobsterAI 需修改项目根目录下的package.json文件: 改动如下: 修改前: "start:electron": "cross-env NODE_ENV=development ELECTRON_START_URL=http://localhost:5175 electron .", ​ 修改后: "start:electron": "cross-env NODE_ENV=development ELECTRON_START_URL=http://localhost:5175 electron . --no-sandbox --disable-dev-shm-usage", ​ 只加了--no-sandbox --disable-dev-shm-usage这两个参数,解决 Deepin 上的兼容性问题,不然,运行会报错。 开发模式启动: npm run electron:dev ​ 启动成功后,会打开 LobsterAI 的桌面窗口。如果不想要弹出DevTools调试窗口,那修改src/main/main.ts文件,把第 2170 行左右mainWindow.webContents.openDevTools()这行代码注释掉,可以改成这样: // 打开开发者工具(已禁用,如需调试可取消注释) // mainWindow.webContents.openDevTools(); ​ 等随后你也可以叫小龙虾帮你改~ 步骤六:配置 API Key 首次启动后,在设置面板中配置你的模型提供商的API Key,即可开始使用。 手动创建桌面快捷方式 nano ~/Desktop/lobsterai.desktop: [Desktop Entry] Name=LobsterAI Comment=全场景个人助理 Agent Exec=你的lobsterai项目文件夹路径/start.sh Icon=你的lobsterai项目文件夹路径/public/logo.png Terminal=false Type=Application Categories=Utility; StartupWMClass=electron ​ 保存后赋予执行权限: chmod +x ~/Desktop/lobsterai.desktop ​ ⚠️注意:务必把上面“你的lobsterai项目文件夹路径”替换成你的,否则快捷方式无法正常运行。 结语 从 OpenClaw 迁移到 LobsterAI 对我来说是一个提升效率的决定。我不是说 OpenClaw 不好,只是 LobsterAI 更适合我的使用场景。 如果你也是普通用户,不想折腾配置,只想有个得力的 AI 助手帮你干活,LobsterAI 值得一试。 工具没有绝对的好坏,只有适不适合。找到适合自己的,就是最好的。 附图: 注: 有道龙虾官网:https://lobsterai.youdao.com/ 使用手册:https://lobsterai.youdao.com/#/docs/lobsterai_user_manual 2026.03.01使用效果之一: 设置页面:

优秀的个人博客,低调大师

mybatis-mp 之简单省力方法,超实用!!!

省力写法-必看 这些都是作者推荐的省心、省力、省事写法 指定数据库类型 虽然 mybatis-mp 支持自动识别,但是具有一定损耗,能加尽量加上 mybatis: configuration: databaseId: MYSQL select 、from、returnType 都可以省略 假如 只select 当前Mapper的实体类:可不写 select 假如 from的是当前Mapper的实体类:可不写 from 假如 返回的是当前Mapper的实体类:可不写 returnType SysUser sysUser = QueryChain.of(sysUserMapper) .eq(SysUser::getId,1) .get(); 一键忽略null,忽略空字符串,自动对字符串进行去空格 SysUser sysUser = QueryChain.of(sysUserMapper) // 忽略 null 条件参数 // 忽略 空字符串 条件参数 // 对字符串进行trim 去空格操作 .forSearch(true) .eq(SysUser::getUserName, null ) .eq(SysUser::getUserName, "" ) .eq(SysUser::getUserName," admin ") .get(); 更多说明:前往 这里 查看 手动优雅忽略条件 Integer id= XXX; String userName= YYY; SysUser sysUser = QueryChain.of(sysUserMapper) .select(SysUser.class,SysRole.class) .from(SysUser.class) .eq(SysUser::getId,id,Objects::nonNull) .like(SysUser::getUserName,userName,StringUtils::isNotBlank) .get(); join 可不用再写on条件 配合 @ForeignKey 注解 可以不用再写on条件 @Data @Table public class SysUser { @TableId private Integer id; private String userName; private String password; @ForeignKey(SysRole.class) private Integer roleId; private LocalDateTime createTime; } public class Demo { @Autowired private SysUserMapper sysUserMapper; public void page() { Pager pager= QueryChain.of(sysUserMapper) .select(SysUser.class) .from(SysUser.class) .join(SysUser.class,SysRole.class) .like(SysUser::getUserName,"abc") .returnType(SysUser.class) .paging(Pager.of(1)); } } 简单自动select列 select(实体类.class) 或 select(VO.class) 都可以自定帮你select所需要的列 public class Demo { @Autowired private SysUserMapper sysUserMapper; public void page() { Pager pager= QueryChain.of(sysUserMapper) .select(SysUser.class) // or select(SysUserVO.class) .from(SysUser.class) .like(SysUser::getUserName,"abc") .returnType(SysUser.class) .paging(Pager.of(1)); } } 结果映射 - VO自动映射 - 如何得到不同的类型的结果? 使用 returnType(XX.class)方法,设置你想要的结果的类型 XX类型 可以是 简单的基本类型包装类,实体类,VO类 实体类:依赖实体类注解 前往 @Table 查看 VO: 依赖VO注解 前往 @ResultEntity 查看 VO映射 - 构建复杂的结构类 mybatis-mp 实现 结果自动映射(多复杂的都可以映射) 重复列名 根本无需担心 可以构建 多重内嵌结构 例如: @ResultEntity(A对应实体类.class) class A { @NestedResultEntity(target=(B对应实体类.class) B b; } class B { @NestedResultEntity(target=(C对应实体类.class) List cs; } class C { Integer id; } 更多更复杂的映射,前往 VO映射注解 查看 链路操作 - connect方法 - 拿到自己的句柄 List list=QueryChain.of(sysUserMapper) .select(SysUser::getId,SysUser::getUserName,SysUser::getRole_id) .from(SysUser.class) .connect(query->{ query.exists(SubQuery.create() .select1() .from(SysUser.class) .eq(SysUser::getId,query.$(SysUser::getId)) .isNotNull(SysUser::getPassword) .limit(1) ); }) .list();

优秀的个人博客,低调大师

.NET 超流行框架 Furion v4.8.7.9 发布

项目信息 Gitee:https://gitee.com/dotnetchina/Furion Github:https://github.com/MonkSoul/Furion 文档:https://dotnetchina.gitee.io/furion 本期亮点 1.Sql高级代理支持IEnumerable<T>、T[]和Tuple<(IEnumerable<T>, T[], T, List<T>)混合返回值 public interface ISql : ISqlDispatchProxy { [SqlExecute("select * from person where id = @id")] Person GetPerson(int id); [SqlExecute("select * from person where id = @id")] Task<Person> GetPersonAsync(int id); // 异步 // ---------------------------------------- [SqlExecute("select * from person")] List<Person> GetPersons(); [SqlExecute("select * from person")] Task<List<Person>> GetPersonsAsync(); // 异步 // ---------------------------------------- [SqlExecute("select * from person")] Person[] GetPersons(); [SqlExecute("select * from person")] Task<Person[]> GetPersonsAsync(); // 异步 // ---------------------------------------- [SqlExecute("select * from person")] IEnumerable<Person> GetPersons2(); [SqlExecute("select * from person")] Task<IEnumerable<Person>> GetPersons2Async(); // 异步 // ---------------------------------------- // 更复杂的组合 [SqlExecute(@" select * from person where id = 1; select * from person; select * from person where id > 0; select * from person where id > 0; ")] (Person, List<Person>, Person[], IEnumerable<Person>) GetPersons(); // 更复杂的组合 [SqlExecute(@" select * from person where id = 1; select * from person; select * from person where id > 0; select * from person where id > 0; ")] Task<(Person, List<Person>, Person[], IEnumerable<Person>)> GetPersonsAsync(); // 异步 } 2. 定时任务支持Http作业 HTTP请求作业通常用于定时请求/访问互联网地址。 services.AddSchedule(options => { options.AddHttpJob(request => { request.RequestUri = "https://www.chinadot.net"; request.HttpMedhod = HttpMethod.Get; // request.Body = "{}"; // 设置请求报文体 }, Triggers.PeriodSeconds(5)); }); 作业执行日志如下: info: 2023-03-11 11:05:36.3616747 +08:00 星期六 L System.Logging.ScheduleService[0] #1 Schedule hosted service is running. info: 2023-03-11 11:05:36.3652411 +08:00 星期六 L System.Logging.ScheduleService[0] #1 Schedule hosted service is preloading... info: 2023-03-11 11:05:36.5172940 +08:00 星期六 L System.Logging.ScheduleService[0] #1 The <job1_trigger1> trigger for scheduler of <job1> successfully appended to the schedule. info: 2023-03-11 11:05:36.5189296 +08:00 星期六 L System.Logging.ScheduleService[0] #1 The scheduler of <job1> successfully appended to the schedule. warn: 2023-03-11 11:05:36.5347816 +08:00 星期六 L System.Logging.ScheduleService[0] #1 Schedule hosted service preload completed, and a total of <1> schedulers are appended. warn: 2023-03-11 11:05:41.5228138 +08:00 星期六 L System.Logging.ScheduleService[0] #15 Schedule hosted service will sleep <4970> milliseconds and be waked up at <2023-03-11 11:05:46.486>. info: 2023-03-11 11:05:41.5542865 +08:00 星期六 L System.Net.Http.HttpClient.HttpJob.LogicalHandler[100] #9 Start processing HTTP request GET https://www.chinadot.net/ info: 2023-03-11 11:05:41.5589056 +08:00 星期六 L System.Net.Http.HttpClient.HttpJob.ClientHandler[100] #9 Sending HTTP request GET https://www.chinadot.net/ info: 2023-03-11 11:05:44.1305461 +08:00 星期六 L System.Net.Http.HttpClient.HttpJob.ClientHandler[101] #8 Received HTTP response headers after 2566.7836ms - 200 info: 2023-03-11 11:05:44.1343977 +08:00 星期六 L System.Net.Http.HttpClient.HttpJob.LogicalHandler[101] #8 End processing HTTP request after 2584.2327ms - 200 info: 2023-03-11 11:05:48.6475959 +08:00 星期六 L System.Logging.ScheduleService[0] #4 Received HTTP response body with a length of <63639> output as follows - 200 <!DOCTYPE html><html><head> <title>dotNET China | 让 .NET 开发更简单,更通用,更流行</title> ...... </body></html> 本期更新 新特性 [新增]定时任务HTTP作业,支持定时请求互联网URL地址4.8.7.7⏱️2023.03.1101d4466 [新增]定时任务作业触发器Trigger执行结果Result和执行耗时ElapsedTime属性4.8.7.7⏱️2023.03.1101d4466 [新增]定时任务作业看板支持查看作业触发器执行结果Result和执行耗时ElapsedTime属性4.8.7.7⏱️2023.03.1101d4466 [新增] 定时任务休眠时长和唤醒时机日志输出4.8.7.6⏱️2023.03.08#I6LANE [新增]Sql高级拦截支持返回IEnumerable<T>和T[]类型值4.8.7.5⏱️2023.03.07f2ca2d3 [新增].m3u8和.ts文件类型MIME支持4.8.7.5⏱️2023.03.07#I6KKEM [新增] 审计日志LoggingMonitor支持对参数贴[SuppressMonitor]特性跳过记录4.8.7.3⏱️2023.03.01#I6IVGW [新增] 审计日志LoggingMonitor监听TraceId、ThreadId、Accept-Language4.8.7.1⏱️2023.02.27df35201 [新增] 规范化结果UnifyContext.GetSerializerSettings(string)静态方法4.8.7.1⏱️2023.02.27#I6HM7T 突破性变化 [升级]适配.NET8 Preview.14.8.7⏱️2023.02.22 [升级]脚手架支持创建.NET8 Preview.1项目4.8.7⏱️2023.02.22 问题修复 [修复] 定时任务服务在停止进程时会卡住30秒问题4.8.7.8⏱️2023.03.13#I6MI9I#I6MHOU [修复] 定时任务看板删除不存在的作业触发器出现空异常4.8.7.7⏱️2023.03.1101d4466 [修复] 日志消息没有处理\n换行符对齐问题4.8.7.6⏱️2023.03.10759bcc5 [修复] 审计日志LoggingMonitor对特定参数贴有[FromServices]特性依旧记录问题4.8.7.3⏱️2023.03.0117b134e [修复]Swagger接口排序同时指定Tag和Order之后无效4.8.7.2⏱️2023.03.01#I6IQDI#I6IP66 其他更改 [调整]定时任务查看作业触发器运行记录由保存10条改为5条4.8.7.7⏱️2023.03.0701d4466 [调整] 脚手架模板,默认启用主流文件类型MIME支持4.8.7.5⏱️2023.03.07e35cdab [调整] 审计日志LoggingMonitor返回值泛型字符串显示格式4.8.7.1⏱️2023.02.27df35201 文档 [新增]ASP.NET 8 集成文档 [新增].NET7 升级 .NET8文档 [更新] 定时任务文档、中间件文档、规范化结果文档、动态WebAPI文档、日志记录文档、事件总线文档、虚拟文件系统文档、Sql高级代理文档、数据库实体文档、任务队列文档 贡献者 kingling (@kinglinglive)!732!729 ksmy (@ksmy)!731 handsome_by (@handsomeboyyl)!727

优秀的个人博客,低调大师

【超详细】手把手教你搭建MongoDB集群

MongoDB集群搭建 MongoDB集群简介 mongodb 集群搭建的方式有三种: 主从备份(Master - Slave)模式,或者叫主从复制模式。 副本集(Replica Set)模式 分片(Sharding)模式 其中,第一种方式基本没什么意义,官方也不推荐这种方式搭建。另外两种分别就是副本集和分片的方式。 Mongo分片高可用集群搭建 概述 ​ 为解决mongodb在replica set每个从节点上面的数据库均是对数据库的全量拷贝,从节点压力在高并发大数据量的场景下存在很大挑战,同时考虑到后期mongodb集群的在数据压力巨大时的扩展性,应对海量数据引出了分片机制。 什么是分片 ​ 分片是将数据库进行拆分,将其分散在不同的机器上的过程,无需功能强大的服务器就可以存储更多的数据,处理更大的负载,在总数据中,将集合切成小块,将这些块分散到若干片中,每个片只负载总数据的一部分,通过一个知道数据与分片对应关系的组件mongos的路由进程进行操作。 基础组件 其利用到了四个组件:mongos,config server,shard,replica set mongos ​ 数据库集群请求的入口,所有请求需要经过mongos进行协调,无需在应用层面利用程序来进行路由选择,mongos其自身是一个请求分发中心,负责将外部的请求分发到对应的shard服务器上,mongos作为统一的请求入口,为防止mongos单节点故障,一般需要对其做HA(高可用,Highly Available缩写)。 config server ​ 配置服务器,存储所有数据库元数据(分片,路由)的配置。mongos本身没有物理存储分片服务器和数据路由信息,只是缓存在内存中来读取数据,mongos在第一次启动或后期重启时候,就会从config server中加载配置信息,如果配置服务器信息发生更新会通知所有的mongos来更新自己的状态,从而保证准确的请求路由,生产环境中通常也需要多个config server,防止配置文件存在单节点丢失问题。 shard ​ 在传统意义上来讲,如果存在海量数据,单台服务器存储1T压力非常大,考虑到数据库的硬盘,网络IO,还有CPU,内存的瓶颈,如果多台进行分摊1T的数据,到每台上就是可估量的较小数据,在mongodb集群只要设置好分片规则,通过mongos操作数据库,就可以自动把对应的操作请求转发到对应的后端分片服务器上。 replica set ​ 在总体mongodb集群架构中,对应的分片节点,如果单台机器下线,对应整个集群的数据就会出现部分缺失,这是不能发生的,因此对于shard节点需要replica set来保证数据的可靠性,生产环境通常为2个副本+1个仲裁。 整体架构 整体架构涉及到15个节点,我们这里使用Docker容器进行部署 那么我们先来总结一下我们搭建一个高可用集群需要多少个Mongo mongos: 3台 configserver : 3台 shard : 3片; 每个分片由三个节点构成 容器部署情况 角色 端口 暴漏端口 描述 角色 config-server1 27017 -- 配置节点1 -- config-server2 27017 -- 配置节点2 -- config-server3 27017 -- 配置节点3 -- mongos-server1 27017 30001 路由节点1 -- mongos-server2 27017 30002 路由节点2 -- mongos-server3 27017 30003 路由节点3 -- shard1-server1 27017 -- 分片1节点1 Primary shard1-server2 27017 -- 分片1节点2 Secondry shard1-server3 27017 -- 分片1节点3 Arbiter shard2-server1 27017 -- 分片2节点1 Primary shard2-server2 27017 -- 分片2节点2 Secondry shard2-server3 27017 -- 分片2节点3 Arbiter shard3-server1 27017 -- 分片3节点1 Primary shard3-server2 27017 -- 分片3节点2 Secondry shard3-server3 27017 -- 分片3节点3 Arbiter 整体架构预览 基础环境准备 安装Docker 本次使用Docker环境进行搭建,需要提前准备好Docker环境 创建Docker网络 因为需要使用Docker搭建MongoDB集群,所以先创建Docker网络 docker network create mongo-cluster docker network ls 搭建ConfigServer副本集 我们先来搭建ConfigServer的副本集,这里面涉及到三个节点,我们需要创建配置文件以及启动容器 创建挂载目录 我们需要创建对应的挂载目录来存储配置文件以及日志文件 # 创建配置文件目录 mkdir -p /tmp/mongo-cluster/config-server/conf # 创建数据文件目录 mkdir -p /tmp/mongo-cluster/config-server/data/{1..3} # 创建日志文件目录 mkdir -p /tmp/mongo-cluster/config-server/logs/{1..3} 创建密钥文件 因为我们知道搭建的话一定要高可用,而且一定要权限,这里mongo之间通信采用秘钥文件,所以我们先进行生成密钥文件 # 创建密钥文件 openssl rand -base64 756 > /tmp/mongo-cluster/config-server/conf/mongo.key # 设置 chmod 600 /tmp/mongo-cluster/config-server/conf/mongo.key 创建配置文件 因为由多个容器,配置文件是一样的,我们只需要创建一个配置文件,其他的容器统一读取该配置文件即可 echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: configsvr #副本集名称 sharding: clusterRole: configsvr # 集群角色,这里配置的角色是配置节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/config-server/conf/mongo.conf 启动容器 启动config-server1 docker run --name config-server1 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/config-server:/data/configdb \ -v /tmp/mongo-cluster/config-server/data/1:/data/db \ -v /tmp/mongo-cluster/config-server/logs/1:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动config-server2 docker run --name config-server2 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/config-server:/data/configdb \ -v /tmp/mongo-cluster/config-server/data/2:/data/db \ -v /tmp/mongo-cluster/config-server/logs/2:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动config-server3 docker run --name config-server3 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/config-server:/data/configdb \ -v /tmp/mongo-cluster/config-server/data/3:/data/db \ -v /tmp/mongo-cluster/config-server/logs/3:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 初始化config-server 登录容器 进入第一台容器 docker exec -it config-server1 bash mongo -port 27017 执行命令 执行以下命令进行MongoDB容器的初始化 rs.initiate( { _id: "configsvr", members: [ { _id : 1, host : "config-server1:27017" }, { _id : 2, host : "config-server2:27017" }, { _id : 3, host : "config-server3:27017" } ] } ) 如果出现OK表示MongoDB配置服务器已经初始化成功 创建用户 因为我们需要对用户进行权限管理,我们需要创建用户,这里为了演示,我们创建超级用户 权限是root use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) 这样就在MongoDB的admin数据库添加了一个用户名为root 密码是root的用户 搭建Shard分片组 由于mongos是客户端,所以我们先搭建好config以及shard之后再搭建mongos。 创建挂载目录 我们先创建挂载目录 # 创建配置文件目录 mkdir -p /tmp/mongo-cluster/shard{1..3}-server/conf # 创建数据文件目录 mkdir -p /tmp/mongo-cluster/shard{1..3}-server/data/{1..3} # 创建日志文件目录 mkdir -p /tmp/mongo-cluster/shard{1..3}-server/logs/{1..3} 搭建shard1分片组 在同一台服务器上初始化一组分片 创建密钥文件 因为集群只需要一个密钥文件,我们可以将config-server中的密钥文件复制过来 cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/shard1-server/conf/ 配置配置文件 因为有多个容器,配置文件是一样的,我们只需要创建一个配置文件,其他的容器统一读取该配置文件即可 echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: shard1 #复制集名称是 shardsvr sharding: clusterRole: shardsvr # 集群角色,这里配置的角色是分片节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/shard1-server/conf/mongo.conf 启动shard1-server1 docker run --name shard1-server1 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard1-server:/data/configdb \ -v /tmp/mongo-cluster/shard1-server/data/1:/data/db \ -v /tmp/mongo-cluster/shard1-server/logs/1:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动shard1-server2 docker run --name shard1-server2 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard1-server:/data/configdb \ -v /tmp/mongo-cluster/shard1-server/data/2:/data/db \ -v /tmp/mongo-cluster/shard1-server/logs/2:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动shard1-server3 docker run --name shard1-server3 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard1-server:/data/configdb \ -v /tmp/mongo-cluster/shard1-server/data/3:/data/db \ -v /tmp/mongo-cluster/shard1-server/logs/3:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 初始化shard1分片组 并且制定第三个副本集为仲裁节点 docker exec -it shard1-server1 bin/bash mongo -port 27017 登录后进行初始化节点,这里面arbiterOnly:true是设置为仲裁节点 #进行副本集配置 rs.initiate( { _id : "shard1", members: [ { _id : 0, host : "shard1-server1:27017" }, { _id : 1, host : "shard1-server2:27017" }, { _id : 2, host : "shard1-server3:27017",arbiterOnly:true } ] } ); 显示OK即副本集创建成功 创建用户 因为我们需要对用户进行权限管理,我们需要创建用户,这里为了演示,我们创建超级用户 权限是root use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) 查看节点信息 rs.isMaster() 搭建shard2分片组 创建密钥文件 因为集群只需要一个密钥文件,我们可以将config-server中的密钥文件复制过来 cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/shard2-server/conf/ 配置配置文件 因为有多个容器,配置文件是一样的,我们只需要创建一个配置文件,其他的容器统一读取该配置文件即可 echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: shard2 #复制集名称是 shard2 sharding: clusterRole: shardsvr # 集群角色,这里配置的角色是分片节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/shard2-server/conf/mongo.conf 启动shard2-server1 docker run --name shard2-server1 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard2-server:/data/configdb \ -v /tmp/mongo-cluster/shard2-server/data/1:/data/db \ -v /tmp/mongo-cluster/shard2-server/logs/1:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动shard2-server2 docker run --name shard2-server2 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard2-server:/data/configdb \ -v /tmp/mongo-cluster/shard2-server/data/2:/data/db \ -v /tmp/mongo-cluster/shard2-server/logs/2:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动shard2-server3 docker run --name shard2-server3 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard2-server:/data/configdb \ -v /tmp/mongo-cluster/shard2-server/data/3:/data/db \ -v /tmp/mongo-cluster/shard2-server/logs/3:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 初始化shard2分片组 登录节点后进行初始化分片2 docker exec -it shard2-server1 bin/bash mongo -port 27017 执行下面的命令进行初始化分片2,arbiterOnly:true参数是设置为仲裁节点 #进行副本集配置 rs.initiate( { _id : "shard2", members: [ { _id : 0, host : "shard2-server1:27017" }, { _id : 1, host : "shard2-server2:27017" }, { _id : 2, host : "shard2-server3:27017",arbiterOnly:true } ] } ); 返回ok就表示 创建用户 因为我们需要对用户进行权限管理,我们需要创建用户,这里为了演示,我们创建超级用户 权限是root use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) 搭建shard3分片组 创建密钥文件 因为集群只需要一个密钥文件,我们可以将config-server中的密钥文件复制过来 cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/shard3-server/conf/ 配置配置文件 因为有多个容器,配置文件是一样的,我们只需要创建一个配置文件,其他的容器统一读取该配置文件即可 echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: shard3 #复制集名称是 shard3 sharding: clusterRole: shardsvr # 集群角色,这里配置的角色是分片节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/shard3-server/conf/mongo.conf 启动shard3-server1 docker run --name shard3-server1 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard3-server:/data/configdb \ -v /tmp/mongo-cluster/shard3-server/data/1:/data/db \ -v /tmp/mongo-cluster/shard3-server/logs/1:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动shard3-server2 docker run --name shard3-server2 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard3-server:/data/configdb \ -v /tmp/mongo-cluster/shard3-server/data/2:/data/db \ -v /tmp/mongo-cluster/shard3-server/logs/2:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动shard3-server3 docker run --name shard3-server3 -d \ --net=mongo-cluster \ --privileged=true \ -v /tmp/mongo-cluster/shard3-server:/data/configdb \ -v /tmp/mongo-cluster/shard3-server/data/3:/data/db \ -v /tmp/mongo-cluster/shard3-server/logs/3:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 初始化shard3分片组 登录节点后进行初始化分片2 docker exec -it shard3-server1 bin/bash mongo -port 27017 执行下面的命令进行初始化分片3,arbiterOnly:true参数是设置为仲裁节点 #进行副本集配置 rs.initiate( { _id : "shard3", members: [ { _id : 0, host : "shard3-server1:27017" }, { _id : 1, host : "shard3-server2:27017" }, { _id : 2, host : "shard3-server3:27017",arbiterOnly:true } ] } ); 创建用户 因为我们需要对用户进行权限管理,我们需要创建用户,这里为了演示,我们创建超级用户 权限是root use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) 搭建Mongos mongos负责查询与数据写入的路由,是实例访问的统一入口,是一个无状态的节点,每一个节点都可以从config-server节点获取到配置信息 创建挂载目录 我们需要创建对应的挂载目录来存储配置文件以及日志文件 # 创建配置文件目录 mkdir -p /tmp/mongo-cluster/mongos-server/conf # 创建数据文件目录 mkdir -p /tmp/mongo-cluster/mongos-server/data/{1..3} # 创建日志文件目录 mkdir -p /tmp/mongo-cluster/mongos-server/logs/{1..3} 创建密钥文件 因为集群只需要一个密钥文件,我们可以将config-server中的密钥文件复制过来 cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/mongos-server/conf/ 创建配置文件 因为有多个容器,配置文件是一样的,我们只需要创建一个配置文件,其他的容器统一读取该配置文件即可,因为Mongos只负责路由,就不需要数据文件了,并且mongos服务是不负责认证的,需要将authorization配置项删除 echo " # 日志文件 systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip # 配置分片,这里面配置的是需要读取的配置节点的信息 sharding: configDB: configsvr/config-server1:27017,config-server2:27017,config-server3:27017 security: keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/mongos-server/conf/mongo.conf 启动mongos集群 启动mongos1 docker run --name mongos-server1 -d \ -p 30001:27017 \ --net=mongo-cluster \ --privileged=true \ --entrypoint "mongos" \ -v /tmp/mongo-cluster/mongos-server:/data/configdb \ -v /tmp/mongo-cluster/mongos-server/logs/1:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动mongos2 docker run --name mongos-server2 -d \ -p 30002:27017 \ --net=mongo-cluster \ --privileged=true \ --entrypoint "mongos" \ -v /tmp/mongo-cluster/mongos-server:/data/configdb \ -v /tmp/mongo-cluster/mongos-server/logs/2:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 启动mongos3 docker run --name mongos-server3 -d \ -p 30003:27017 \ --net=mongo-cluster \ --privileged=true \ --entrypoint "mongos" \ -v /tmp/mongo-cluster/mongos-server:/data/configdb \ -v /tmp/mongo-cluster/mongos-server/logs/3:/data/logs \ mongo --config /data/configdb/conf/mongo.conf 配置mongos-server1 因为mongos是无中心的配置,所有需要每一台都需要进行分片配置 进入容器 docker exec -it mongos-server1 /bin/bash mongo -port 27017 登录Mongos 使用前面设置的root用户密码 use admin; db.auth("root","root"); 配置分片 进行配置分片信息 sh.addShard("shard1/shard1-server1:27017,shard1-server2:27017,shard1-server3:27017") sh.addShard("shard2/shard2-server1:27017,shard2-server2:27017,shard2-server3:27017") sh.addShard("shard3/shard3-server1:27017,shard3-server2:27017,shard3-server3:27017") 配置mongos-server2 因为mongos是无中心的配置,所有需要每一台都需要进行分片配置 进入容器 docker exec -it mongos-server2 /bin/bash mongo -port 27017 登录Mongos 使用前面设置的root用户密码 use admin; db.auth("root","root"); 配置分片 进行配置分片信息 sh.addShard("shard1/shard1-server1:27017,shard1-server2:27017,shard1-server3:27017") sh.addShard("shard2/shard2-server1:27017,shard2-server2:27017,shard2-server3:27017") sh.addShard("shard3/shard3-server1:27017,shard3-server2:27017,shard3-server3:27017") 配置mongos-server3 因为mongos是无中心的配置,所有需要每一台都需要进行分片配置 进入容器 docker exec -it mongos-server3 /bin/bash mongo -port 27017 登录Mongos 使用前面设置的root用户密码 use admin; db.auth("root","root"); 配置分片 进行配置分片信息 sh.addShard("shard1/shard1-server1:27017,shard1-server2:27017,shard1-server3:27017") sh.addShard("shard2/shard2-server1:27017,shard2-server2:27017,shard2-server3:27017") sh.addShard("shard3/shard3-server1:27017,shard3-server2:27017,shard3-server3:27017") Docker-compose方式搭建 环境准备 初始化目录脚本 # 创建config-server 目录 # 创建配置文件目录 mkdir -p /tmp/mongo-cluster/config-server/conf # 创建数据文件目录 mkdir -p /tmp/mongo-cluster/config-server/data/{1..3} # 创建日志文件目录 mkdir -p /tmp/mongo-cluster/config-server/logs/{1..3} # 创建shard-server 目录 # 创建配置文件目录 mkdir -p /tmp/mongo-cluster/shard{1..3}-server/conf # 创建数据文件目录 mkdir -p /tmp/mongo-cluster/shard{1..3}-server/data/{1..3} # 创建日志文件目录 mkdir -p /tmp/mongo-cluster/shard{1..3}-server/logs/{1..3} # 创建mongos-server 目录 # 创建配置文件目录 mkdir -p /tmp/mongo-cluster/mongos-server/conf # 创建数据文件目录 mkdir -p /tmp/mongo-cluster/mongos-server/data/{1..3} # 创建日志文件目录 mkdir -p /tmp/mongo-cluster/mongos-server/logs/{1..3} 生成密钥文件 # 创建密钥文件 openssl rand -base64 756 > /tmp/mongo-cluster/config-server/conf/mongo.key # 设置 chmod 600 /tmp/mongo-cluster/config-server/conf/mongo.key cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/shard1-server/conf/ cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/shard2-server/conf/ cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/shard3-server/conf/ cp /tmp/mongo-cluster/config-server/conf/mongo.key /tmp/mongo-cluster/mongos-server/conf/ 创建配置文件 echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: configsvr #副本集名称 sharding: clusterRole: configsvr # 集群角色,这里配置的角色是配置节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/config-server/conf/mongo.conf echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: shard1 #复制集名称是 shardsvr sharding: clusterRole: shardsvr # 集群角色,这里配置的角色是分片节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/shard1-server/conf/mongo.conf echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: shard2 #复制集名称是 shard2 sharding: clusterRole: shardsvr # 集群角色,这里配置的角色是分片节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/shard2-server/conf/mongo.conf echo " # 日志文件 storage: # mongod 进程存储数据目录,此配置仅对 mongod 进程有效 dbPath: /data/db systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 # bindIp: 127.0.0.1 #绑定ip replication: replSetName: shard3 #复制集名称是 shard3 sharding: clusterRole: shardsvr # 集群角色,这里配置的角色是分片节点 security: authorization: enabled #是否开启认证 keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/shard3-server/conf/mongo.conf echo " # 日志文件 systemLog: destination: file logAppend: true path: /data/logs/mongo.log # 网络设置 net: port: 27017 #端口号 bindIp: 0.0.0.0 #绑定ip # 配置分片,这里面配置的是需要读取的配置节点的信息 sharding: configDB: configsvr/config-server1:27017,config-server2:27017,config-server3:27017 security: keyFile: /data/configdb/conf/mongo.key #keyFile路径 " > /tmp/mongo-cluster/mongos-server/conf/mongo.conf 启动服务 docker-compos配置文件 使用docker-compos方式启动Docker容器 version: '2' services: config-server1: image: mongo container_name: config-server1 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/config-server:/data/configdb - /tmp/mongo-cluster/config-server/data/1:/data/db - /tmp/mongo-cluster/config-server/logs/1:/data/logs config-server2: image: mongo container_name: config-server2 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/config-server:/data/configdb - /tmp/mongo-cluster/config-server/data/2:/data/db - /tmp/mongo-cluster/config-server/logs/2:/data/logs config-server3: image: mongo container_name: config-server3 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/config-server:/data/configdb - /tmp/mongo-cluster/config-server/data/3:/data/db - /tmp/mongo-cluster/config-server/logs/3:/data/logs shard1-server1: image: mongo container_name: shard1-server1 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard1-server:/data/configdb - /tmp/mongo-cluster/shard1-server/data/1:/data/db - /tmp/mongo-cluster/shard1-server/logs/1:/data/logs shard1-server2: image: mongo container_name: shard1-server2 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard1-server:/data/configdb - /tmp/mongo-cluster/shard1-server/data/2:/data/db - /tmp/mongo-cluster/shard1-server/logs/2:/data/logs shard1-server3: image: mongo container_name: shard1-server3 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard1-server:/data/configdb - /tmp/mongo-cluster/shard1-server/data/3:/data/db - /tmp/mongo-cluster/shard1-server/logs/3:/data/logs shard2-server1: image: mongo container_name: shard2-server1 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard2-server:/data/configdb - /tmp/mongo-cluster/shard2-server/data/1:/data/db - /tmp/mongo-cluster/shard2-server/logs/1:/data/logs shard2-server2: image: mongo container_name: shard2-server2 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard2-server:/data/configdb - /tmp/mongo-cluster/shard2-server/data/2:/data/db - /tmp/mongo-cluster/shard2-server/logs/2:/data/logs shard2-server3: image: mongo container_name: shard2-server3 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard2-server:/data/configdb - /tmp/mongo-cluster/shard2-server/data/3:/data/db - /tmp/mongo-cluster/shard2-server/logs/3:/data/logs shard3-server1: image: mongo container_name: shard3-server1 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard3-server:/data/configdb - /tmp/mongo-cluster/shard3-server/data/1:/data/db - /tmp/mongo-cluster/shard3-server/logs/1:/data/logs shard3-server2: image: mongo container_name: shard3-server2 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard3-server:/data/configdb - /tmp/mongo-cluster/shard3-server/data/2:/data/db - /tmp/mongo-cluster/shard3-server/logs/2:/data/logs shard3-server3: image: mongo container_name: shard3-server3 privileged: true networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/shard3-server:/data/configdb - /tmp/mongo-cluster/shard3-server/data/3:/data/db - /tmp/mongo-cluster/shard3-server/logs/3:/data/logs mongos-server1: image: mongo container_name: mongos-server1 privileged: true entrypoint: "mongos" networks: - mongo-cluster-network command: --config /data/configdb/conf/mongo.conf ports: - "30001:27017" volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/mongos-server:/data/configdb - /tmp/mongo-cluster/mongos-server/logs/1:/data/logs command: --config /data/configdb/conf/mongo.conf mongos-server2: image: mongo container_name: mongos-server2 privileged: true entrypoint: "mongos" networks: - mongo-cluster-network ports: - "30002:27017" volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/mongos-server:/data/configdb - /tmp/mongo-cluster/mongos-server/logs/2:/data/logs command: --config /data/configdb/conf/mongo.conf mongos-server3: image: mongo container_name: mongos-server3 privileged: true entrypoint: "mongos" networks: - mongo-cluster-network ports: - "30003:27017" volumes: - /etc/localtime:/etc/localtime - /tmp/mongo-cluster/mongos-server:/data/configdb - /tmp/mongo-cluster/mongos-server/logs/3:/data/logs command: --config /data/configdb/conf/mongo.conf networks: mongo-cluster-network: driver: bridge 启动服务 docker-compose up -d 初始化文件 执行下面脚本进行容器初始化 docker exec -it config-server1 bash mongo -port 27017 rs.initiate( { _id: "configsvr", members: [ { _id : 1, host : "config-server1:27017" }, { _id : 2, host : "config-server2:27017" }, { _id : 3, host : "config-server3:27017" } ] } ) use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) db.auth("root","root") db.createUser({user:"test",pwd:"test",roles:[{role:'readWrite',db:'test'}]}) docker exec -it shard1-server1 bin/bash mongo -port 27017 #进行副本集配置 rs.initiate( { _id : "shard1", members: [ { _id : 0, host : "shard1-server1:27017" }, { _id : 1, host : "shard1-server2:27017" }, { _id : 2, host : "shard1-server3:27017",arbiterOnly:true } ] } ); use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) db.auth("root","root") db.createUser({user:"test",pwd:"test",roles:[{role:'readWrite',db:'test'}]}) docker exec -it shard2-server1 bin/bash mongo -port 27017 #进行副本集配置 rs.initiate( { _id : "shard2", members: [ { _id : 0, host : "shard2-server1:27017" }, { _id : 1, host : "shard2-server2:27017" }, { _id : 2, host : "shard2-server3:27017",arbiterOnly:true } ] } ); use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) db.auth("root","root") db.createUser({user:"test",pwd:"test",roles:[{role:'readWrite',db:'test'}]}) docker exec -it shard3-server1 bin/bash mongo -port 27017 #进行副本集配置 rs.initiate( { _id : "shard3", members: [ { _id : 0, host : "shard3-server1:27017" }, { _id : 1, host : "shard3-server2:27017" }, { _id : 2, host : "shard3-server3:27017",arbiterOnly:true } ] } ); use admin db.createUser({user:"root",pwd:"root",roles:[{role:'root',db:'admin'}]}) db.auth("root","root") db.createUser({user:"test",pwd:"test",roles:[{role:'readWrite',db:'test'}]}) 初始化分片 docker exec -it mongos-server1 /bin/bash mongo -port 27017 use admin; db.auth("root","root"); sh.addShard("shard1/shard1-server1:27017,shard1-server2:27017,shard1-server3:27017") sh.addShard("shard2/shard2-server1:27017,shard2-server2:27017,shard2-server3:27017") sh.addShard("shard3/shard3-server1:27017,shard3-server2:27017,shard3-server3:27017") docker exec -it mongos-server2 /bin/bash mongo -port 27017 use admin; db.auth("root","root"); sh.addShard("shard1/shard1-server1:27017,shard1-server2:27017,shard1-server3:27017") sh.addShard("shard2/shard2-server1:27017,shard2-server2:27017,shard2-server3:27017") sh.addShard("shard3/shard3-server1:27017,shard3-server2:27017,shard3-server3:27017") docker exec -it mongos-server3 /bin/bash mongo -port 27017 use admin; db.auth("root","root"); sh.addShard("shard1/shard1-server1:27017,shard1-server2:27017,shard1-server3:27017") sh.addShard("shard2/shard2-server1:27017,shard2-server2:27017,shard2-server3:27017") sh.addShard("shard3/shard3-server1:27017,shard3-server2:27017,shard3-server3:27017") 本文由育博学谷狂野架构师发布 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力 转载请注明出处!
优秀的个人博客,低调大师

黑客论坛公开泄露Facebook超5亿数据

近期,Facebook的用户数据再一次遭到严重泄露。据悉,此次事件波及用户数超过5亿,其中包括超过3200万条美国用户记录,1100万条英国用户记录和600万条印度用户记录。泄露内容于某黑客论坛公布,这是迄今为止Facebook最严重的数据泄露事件。 据悉,这些数据包括用户的全名,以及Facebook ID、地点、出生日期、个人简历、电话号码和电子邮件地址。安全人员将缓存中的部分数据与Facebook的密码重置功能进行对比验证,发现数据是真实的。 此次的数据泄露事件还波及到了一些欧盟官员,包括欧盟司法专员Didier Reynders、卢森堡首相Xavier Bettel和数十名欧盟官员。专家建议,为了防止被黑客攻击,使用额外的安全措施是关键,特别是如果你是潜在的高调目标,比如媒体人或政治家,使用移动认证器应用程序进行双因素认证,并使用独特的长密码。欧盟自己的网络安全专家也呼吁同事检查自己是否是攻击的受害者。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册