首页 文章 精选 留言 我的

精选列表

搜索[pick],共435篇文章
优秀的个人博客,低调大师

本周 AI 论文良心推荐,你想 pick 谁?

Adaptive Scaling for Sparse Detection in Information Extraction@roger 推荐Information Extraction 本文是中科院软件所发表于 ACL 2018 的工作,论文主要研究信息抽取中检测任务的类别不平等问题。该问题具体体现在:1. 训练样本类别不均衡;2. 神经网络常用的交叉熵目标函数与评价指标(F-score)不平等。 为解决这一问题,本文提出了一种基于边际效用的动态调整训练实例权重的解决方案,在 Batch-wise 的训练过程中直接针对 F-score 进行优化,同时不需要引入超参数。 本文分别在 KBP2017 的中英文事件检测任务进行了实验验证,实验结果证明了 AS 方法的有效性和稳定性。类别不平等问题在自然语言处理领域中广泛存在,AS 方法可以被应用在更多的自然语言处理任务中。 论文链接https://www.paperweekly.site/papers/1963代码链接https://github.com/sanmusunrise/AdaScaling Self-Attention Generative Adversarial Networks@xwzhong 推荐Generative Adversarial Networks 本文来自谷歌大脑 Ian Goodfellow 组,论文提出了一个基于注意力机制的对抗网络(SAGAN),将自注意力机制引入到卷积 GAN 中作为卷积的补充,在 ImageNet 多类别图像合成任务中取得了最优结果。 论文链接https://www.paperweekly.site/papers/1967 A Unified Model for Extractive and Abstractive Summarization using Inconsistency Loss@llamazing 推荐Text Summarization 本文是国立清华大学发表于 ACL 2018 的工作,论文主要贡献如下: 作者提出一个抽取式和提取式融合的模型来做 summarization,利用抽取式模型获得 sentence-level 的 attention 进而影响 word-level 的 attention;提出 inconsistency loss; CNN/Daily Mail 数据集 ROUGE 分数超过抽取式模型 lead-3,本文的模型可看作是 pointer-generator 和抽取式模型的融合; 用Hierarchical 的结构(word-level encoding 和 sentence-level encoding),分别对 sentence 和word 做 attention;sentence 的 attention 权重使用 sigmoid;word 的 attention 权重计算时用 sentence-level 的 attention 权重进行 scale; Inconsistency Loss 对 decode 每个 step 的 topK attention word 的 word-level 和 sentence-level 的 attention 乘积做 negative log;鼓励 word-level attention sharp,sentence-level 的 attention high。 论文链接https://www.paperweekly.site/papers/1953 DLBI: Deep learning guided Bayesian inference for structure reconstruction of super-resolution fluorescence microscopy@lykaust15 推荐Image Reconstruction 本文是基于 GAN 和贝叶斯方法的荧光显微超分辨研究。荧光显微超分辨是光学成像的突破性研究,获得 2014 年诺贝尔化学奖。它将光学显微镜的成像极限分辨率从 300nm 提高到了 40nm。 这个方向一个重要的计算问题是从一串时间序列的高噪声低分辨率的图像重构出一张高分辨低噪声的超分辨率图像。之前的方法是基于贝叶斯和 FHMM 模型建模重构,时间复杂度非常高,重构出一张 480*480 的图像需要 75 个小时。 在这个领域使用深度学习非常有希望继续提高极限分辨率以及提高重构速度。但是有 4 个问题需要解决:1. 标准的图像超分辨是没有噪声的,但是这里的图片噪声非常大。2. 没有足够大的训练数据集。 3. 已有的训练数据集并没有 ground truth。4. 单纯使用深度学习,非常有可能在最终结果中引入实际不存在的细节,对于光学成像,即使看不清,也不希望看到错误的细节。 这篇文章使用了以下方法解决了上述问题: 基于荧光显微成像的物理学原理,构建了一个可以根据给定的高分辨图像产生低分辨高噪声图像的模拟器用于产生源源不断的数据; 在 GAN 的生成网络中加入了MC dropout,denoise shortcut 以及使用 multiscale training 的方式来抑制噪声和实际不存在的细节; 将深度学习的结果作为贝叶斯方法的先验,进一步重构同时抑制噪声。这一步虽然是使用了之前的方法,但因为深度学习的结果已经非常好,所以贝叶斯方法的收敛速度也比之前显著提高。 文章通过大量的实验(包括模拟数据和真实数据)证明该文章提出的方法可以重构出比之前的方法(3B,2012, Nature Methods)细节更加丰富的超分辨图像,同时,速度有了及其显著的提高:如果直接使用深度学习的方法作为输出(重构一张 480*480 图片只需要 3 分钟),比 3B 方法快 1500 倍,如果进一步使用贝叶斯方法改善结果,也还是要比 3B 方法快 150 倍。这种显著的速度提升使实时重构和大范围重构成为可能。 文章提出的训练方法和解决噪声的方法同样适用于其他类似问题和领域,比如医学图像(CT,fMRI)超分辨。 论文链接https://www.paperweekly.site/papers/1964代码链接https://github.com/lykaust15/DLBI Sparsely Grouped Multi-task Generative Adversarial Networks for Facial Attribute Manipulation@zhangjichao 推荐Image-to-Image Translation 本文认为先前的基于 unpaired 数据的方法,比如 StarGAN 和 CycleGAN,仍然需要分类标签并且消耗一定的人力。因此文章提出了一种 sparsely grouped 形式的数据形式,并且提出一种在此数据集上可以训练的类似半监督对抗网络的学习框架和目标函数。 实验通过在 celebA 数据集上做面部参数的调整应用验证了方法的有效性。论文还通过定量定性的评估说明方法的优越性。最后,论文还给出了图像翻译在数据不平衡下遇到的问题,并且说明了本文提出的方法可以缓解这种问题。 论文链接https://www.paperweekly.site/papers/1965 Nugget Proposal Networks for Chinese Event Detection@roger 推荐Chinese Event Detection 本文是中科院软件所发表于 ACL 2018 的工作。论文主要针对事件检测,尤其是中文事件检测任务当中的触发词块与词的不匹配问题,提出了一种名为 Nugget Proposal Networks (NPNs) 的字级别标注模型。 不同于传统的字级别和词级别模型,该模型在每个字符上要求模型能够预测出整个完整的触发词块,从而使得预测结果有了更高的容错率。同时,文章在进行预测的时候,同时利用了字符级别和词级别的语义信息,使得预测结果更加准确。 本文分别在 KBP2017 和 ACE2005 的中文事件检测数据集进行了实验验证,与传统的基于字符级别 BIO 标签、基于词级别的方法相比,NPNs 取得了显著的提升。 词与待检测块之间的不匹配问题在自然语言处理领域中广泛存在,尤其在中文这样没有自然词汇边界的语言中更为明显,NPNs 模型可以被应用到更多相关的自然语言处理任务中,例如命名实体识别。 论文链接https://www.paperweekly.site/papers/1962代码链接https://github.com/sanmusunrise/NPNs An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling@Ttssxuan 推荐Sequence Modeling 在面对序列数据时,一般立即想到的是使用 RNN 网络,但经过本文以及相关文章的研究表明,面对序列数据时,卷积网络更应该纳入考虑范围。 本文针对卷积网络在序列上的应用提出 Temporal Convolutional Networks (TCN)。网络使用 1 维卷积处理序列问题,使用因果卷积(Causal Convolutions)处理序列中的顺序关系、使用扩展卷积(Dilated Convolutions)实现对历史信息的接收范围指数级扩张、使用 Residual Connections(实现时使用 1X1 卷积)处理深度网络信息传递问题。 TCN的主要优点有:并行、灵活的接收域、稳定的梯度、训练占用内存少、可变长输入。 本文在 The adding problem、Sequential MNIST and P-MNIST、Copy memory、JSB Chorales and Nottingham、PennTreebank、Wikitext-103、LAMBADA、text8 等多个数据集上进行试验,与 LSTM、GRU 等网络进行对比,在结果和性能上 TCN 都取得了相当不错的优势。 论文链接https://www.paperweekly.site/papers/1940代码链接https://github.com/locuslab/TCN MobileFaceNets: Efficient CNNs for Accurate Real-time Face Verification on Mobile Devices@halfmoontzh 推荐Face Recognition 本文提出了一个工业级精度和速度的轻量级人脸识别网络,模型大小只有 4MB,速度超过了 MobileNetV2 和 ShuffleNet,专为人脸识别任务设计,精度比肩大模型。 论文链接https://www.paperweekly.site/papers/1952代码链接https://github.com/moli232777144/mobilefacenet-mxnet Billion-scale Commodity Embedding for E-commerce Recommendation in Alibaba@stevechoris 推荐Recommender System 本文是阿里巴巴和香港科技大学发表于 SIGKDD 2018 的工作,论文结合节点 side information,解决了图表示学习中稀疏性和冷启动问题,在电商 i2i 推荐上取得很好的效果。 论文链接https://www.paperweekly.site/papers/1939 Paper Abstract Writing through Editing Mechanism@llamazing 推荐Text Generation 本文是伦斯勒理工学院和南加州大学发表于 ACL 2018 的工作,论文研究的问题是给定 title 生成摘要,一个 writing 网络一个 editing 网络,跟 deliberation network 有点类似,对 decoder 出的文本进行 refine。 论文链接https://www.paperweekly.site/papers/1943代码链接https://github.com/EagleW/Writing-editing-Network Show, Tell and Discriminate: Image Captioning by Self-retrieval with Partially Labeled Data@qliu 推荐Image Captioning 作者主要想解决的问题是生成的 caption 缺少多样性的问题,即多幅相似的图片可能会生成几乎一样的 caption。 作者认为,如果 caption 足够具有多样性的话,那么这幅图生成的描述应当与本幅图最相似,与其他图像没那么相似。相反,如果两幅图生成的描述相同,那么这个描述与两幅图的相似性即是一样的或者是难以区分的。当 I1 生成的 C1 时,C1 与 I1 相似性应当高于 C1 与 In(n≠1)。 这篇文章的新颖之处有两点: 使用了 unlabeled images(不含有 ground truth 的图像)进行训练,之前的大部分 image caption 的工作都是基于各个图像数据库进行训练,如果能够使用无人工标注的图像进行训练,训练集将会大大增加。 为什么能够用到 unlabeled images 呢?作者发掘出了 unlabeled images 里天然存在的“label”—即 In 与 Cn 的一一对应关系。即一幅图通过生成网络生成的描述肯定是与这幅图对应的,那么这个描述的标签就是这幅图。 使用了 self-retrieval 网络。这篇文章的模型主要分为两个版块,第一个版块是 caption module,第二个版块是 self-retrieval module。 其中 self-retrieval module 通过计算由 caption module 生成的 ci 与 {I1,I2,I3……,In} 之间的相似性,来计算 self-retrievel module 对 caption module 的 reward。最后用强化学习的方法把 reward 反馈给 caption module。 运用强化学习将 CIDer 指标作为 reward。这个已经不算很新颖了,在 Self-critical Sequence Training for Image Captioning 这篇文章中已经运用强化学习将 CIDer 指标结果作为 reward 反馈给 caption module。 这里由于增加了一个 self-retrieval module,因此多了一个 reward—Rret。所以 labeled images 的 reward 会分为两部分 Rcider 和 Rret。由于 unlabeled images 没有 Rcider,因此 reward 只有 Rret。 论文链接https://www.paperweekly.site/papers/1948 Learning to See in the Dark@paperweekly 推荐Few-shot Learning 本文是 UIUC 和英特尔发表于 CVPR 2018 的工作。极低照明度下,传统增加亮度的方法会放大噪点和色彩失真。本文通过全卷积网络处理这一类黑黑的照明度图像,并在抑噪和保真的条件下将它们恢复到正常亮度。这种端到端的方法将为机器赋予强大的夜视能力,且还不需要额外的硬件。 论文链接https://www.paperweekly.site/papers/1946代码链接https://github.com/cchen156/Learning-to-See-in-the-Dark 原文发布时间为:2018-05-25本文作者:让你更懂AI本文来自云栖社区合作伙伴“PaperWeekly”,了解相关信息可以关注“PaperWeekly”。

优秀的个人博客,低调大师

SASE与SD-WAN大比拼,你pick谁?

SASE(安全访问服务边缘)和SD-WAN是两种网络技术,旨在将地理上不同的端点连接到数据源和应用程序资源。 SD-WAN——软件定义的广域网,它使用虚拟化网络overlay连接和远程管理分支机构。SD-WAN的重点放在将这些分支机构连接回中央专用网络上。虽然SD-WAN可以连接到云,但它并不是以云为中心构建的。 而SASE专注于云,并具有分布式架构。SASE并非着重于将分支机构连接到中央网络,而是专注于将各个端点(分支机构、个人用户或单个设备)连接到服务边缘。服务边缘由运行SASE软件堆栈的分布式PoP网络组成。此外,SASE着重于固有的安全性。 这两者的区别就类似于使用内网与使用坚果云共享文件之间的区别。两种方法都能达到相同的最终目标,但方法却截然不同。 SD-WAN是一个日趋成熟的市场,尽管疫情阻碍了它的发展,但总体保持稳定增长。而SASE相对较新,因为它是Gartner在2019年创造的一个新术语,尽管SASE市场尚处于起步阶段,但许多供应商已开始通过自己的SASE或类似SASE的服务进入市场。 一、差异性 SASE和SD-WAN之间的差异可以归纳为三类: 与云的关系 安全性 如何进行流量检查 1. SASE,SD-WAN和云 (1) SASE SASE使用私有数据中心、公共云或托管设施作为pop。这些pop形成了SASE堆栈运行的体系结构的服务边缘。此外,这些pop通常位于公共云中,或者靠近公共云网关,以实现对云资源的低延迟安全访问。无论哪个节点都有足够的资源来满足用户的请求。SASE软件可以确定流量到达其端点时使用的最佳路径。与SD-WAN以数据中心为中心的架构不同,SASE采用的是分布式架构。Gartner认为,当云服务越来越多地被使用时,将单一的私有数据中心作为网络的焦点会导致效率低下。 (2) SD-WAN 对于SD-WAN,云集成只是一个功能,而不是一个关键组件。在支持云的SD-WAN中,用户通过互联网连接到虚拟云网关,使网络更易于访问,并支持云原生应用程序。这与SASE方法非常相似。 2. 安全性 安全是SASE和SD-WAN竞争的关键因素。 IDG最近发布了一项针对SASE和SD-WAN的兴趣调查,数据显示,91%的受访者表示对SASE解决方案感兴趣,其考虑的关键点就在于SASE所能够提供的安全性。同样的,在考虑采用SD-WAN的公司中,有70%的公司也强调了安全的重要性。 (1) SASE SASE的重点是为网络及其用户提供对分布式资源的安全访问。这些资源可以分布在私有数据中心、托管设施和云上。安全代理可以包含安全的web网关,供应商的云可以包含防火墙即服务。在分支机构或其他聚集人员的地方,为了保护打印机等无代理设备的安全,通常使用SASE设备。 (2) SD-WAN SD-WAN技术的设计并不是以安全为重点的。SD-WAN安全性通常通过辅助功能或第三方供应商提供。虽然一些SD-WAN解决方案确实在安全性方面取得了成功,但这也只是少数。SD-WAN的中心目标是将地理位置不同的办公室相互连接并连接到一个中央总部,具有对不同网络条件的灵活性和适应性。在SD-WAN中,安全工具通常位于CPE的办公室,而不是设备本身。SD-WAN中的网络决策是在分布在整个网络中的虚拟化网络设备中做出的。 3. SASE与SD-WAN流量检查 (1) SASE 在SASE网络中,流量一次开放,一次可以被多个策略引擎检查,引擎并行运行,而不会在引擎之间传递流量。这样可以节省时间,因为流量不会像SD-WAN中那样从一个安全功能传递到下一个安全功能,不会重复访问。此外,这些策略引擎的作用与SD-WAN中的安全工具一样多,甚至更多。 (2) SD-WAN SD-WAN使用服务链进行流量检查。服务链是指一次一个安全功能一个接一个地检查流量。这些单独的功能处理一种类型的威胁,称为点解决方案(point solutions)。每个点解决方案都会打开流量,对其进行检查,关闭,然后将其转发到下一个点解决方案,直到流量通过所有点解决方案为止。 二、相似性 尽管SASE和SD-WAN的最终目的相似,但它们在架构上并没有很多相似之处。高层面上,它们有一点相同:它们既是广域网又是虚拟化基础结构。 SD-WAN和SASE都是为了覆盖一个大的地理区域而设计的。不同之处在于基础设施,SASE的基础设施有私有数据中心、托管设施或充当端点的云。这些是运行网络、优化和安全功能的地方,在SD-WAN中,这些功能在分支机构和总部的机箱中运行,SASE和SD-WAN都可以从任何地方进行控制。在SD-WAN的情况下,DIY方法通常将控制权置于组织的总部,托管解决方案将由服务提供商远程控制,而共同管理解决方案类似于托管解决方案,但组织通过门户具有一定的控制权。 尽管这两个基础设施的不同,但它们仍然是虚拟化的。SD-WAN和SASE不像非虚拟化WAN那样依赖于固定功能的专有设备。如前所述,SASE在云或其他数据中心以及安全代理中运行安全和网络功能。对于SD-WAN,网络节点和CPE都是软件定义的。换句话说,这些功能是作为软件运行的。 三、供应商 1. SASE尚处于起步阶段 现在许多SD-WAN供应商也开始提供SASE解决方案,例如, 思科、VMware VeloCloud和Open Systems都在实践这种解决方案。 还有一些组织已经将他们的资源更多地用于开发和部署SD-WAN上的SASE服务,例如 Palo Alto和Cato Networks。 Gartner编制了一份供应商名单,其中包括已经提供SASE,或者有想法提供SASE的供应商: Gartner表示,“目前主要的IaaS提供商(AWS,Azure和GCP)在SASE市场上还没有竞争力。”“我们预计,在未来五年内,至少有一家公司将大举进军SASE市场,因为它们都在扩展其边缘网络业务和安全能力。” 2. SD-WAN生态参与者众多 Gartner预计企业中部署SD-WAN的比例将从2019年的30%提升至2023年的90%。 根据IDC数据,2019年全球SD-WAN市场空间为23亿美元,预计2019-2021年复合增长率高达35%。 国内SD-WAN玩家众多,初创公司、网络设备商、网络运营商、IDC厂商、公有云运营商、安全厂商等纷纷涌入。 三、总结 SASE和SD-WAN是两种不同的网络技术,它们使用不同的方法达到相似的目的。这两种技术都旨在以灵活和适应性强的方式连接地理分布的组织。SASE网络专注于提供云原生安全工具,并以云为网络的中心;SD-WAN技术致力于将办公室连接到中央总部和数据中心,不过它也可以将用户直接连接到云。 目前,虽然只有少数SD-WAN供应商、安全提供商等在推出SASE解决方案,但Gartner预测,到2024年,至少40%的企业会采用SASE策略,也就是说在未来会有更多SD-WAN供应商会向SASE转型。 【责任编辑: 赵宁宁 TEL:(010)68476606】

优秀的个人博客,低调大师

七种对象复制工具类,阿粉该 Pick 谁?

每天早上七点三十,准时推送干货 日常编程中,我们会经常会碰到对象属性复制的场景,就比如下面这样一个常见的三层 MVC 架构。 当我们在上面的架构下编程时,我们通常需要经历对象转化,比如业务请求流程经历三层机构后需要把 DTO 转为DO然后在数据库中保存。 当需要从数据查询数据页面展示时,查询数据经过三层架构将会从 DO 转为 DTO,最后再转为 VO,然后在页面中展示。 当业务简单的时候,我们手写代码,通过 getter/setter复制对象属性,十分简单。但是一旦业务变的复杂,对象属性变得很多,那么手写代码就会成为程序员的噩梦。 不但手写十分繁琐,非常耗时间,并且还可能容易出错。 阿粉之前就经历过一个项目,一个对象中大概有四五十个字段属性,那时候阿粉还刚入门,什么都不太懂,写了半天 getter/setter复制对象属性。 话外音:一个对象属性这么多,显然是不太合理的,我们设计过程应该将其拆分。 直到后来,阿粉了解到了对象属性复制工具类,使用之后,发现是真香,再也不用手写代码。再后来,碰到越来越多工具类,虽然核心功能都是一样的,但是还是存在很多差异。新手看到可能会一脸懵逼,不知道如何选择。 所以阿粉今天这篇介绍一下市面上常用的工具类: Apache BeanUtils Spring BeanUtils Cglib BeanCopier Dozer orika MapStruct 工具类特性 在介绍这些工具类之前,我们来看下一个好用的属性复制工具类,需要有哪些特性: 基本属性复制,这个是基本功能 不同类型的属性赋值,比如基本类型与其包装类型等 不同字段名属性赋值,当然字段名应该尽量保持一致,但是实际业务中,由于不同开发人员,或者笔误拼错单词,这些原因都可能导致会字段名不一致的情况 浅拷贝/深拷贝,浅拷贝会引用同一对象,如果稍微不慎,同时改动对象,就会踩到意想不到的坑 下面我们开始介绍工具类。 画外音:公号内回复「20200822」获取源码 Apache BeanUtils 首先介绍是第一位应该是 Java 领域属性复制的最有名的工具类「Apache BeanUtils」,这个工具类想必很多人或多或少用过或则见过。 没用过也没关系,我们来展示这个类的用法,用法非常简单。 首先我们引入依赖,这里使用最新版本: <dependency><groupId>commons-beanutils</groupId><artifactId>commons-beanutils</artifactId><version>1.9.4</version></dependency> 假设我们项目中有如下类: 此时我们需要完成 DTO 对象转化到 DO 对象,我们只需要简单调用BeanUtils#copyProperties 方法就可以完成对象属性的复制。 StudentDTOstudentDTO=newStudentDTO();studentDTO.setName("阿粉");studentDTO.setAge(18);studentDTO.setNo("6666");List<String>subjects=newArrayList<>();subjects.add("math");subjects.add("english");studentDTO.setSubjects(subjects);studentDTO.setCourse(newCourse("CS-1"));studentDTO.setCreateDate("2020-08-08");StudentDOstudentDO=newStudentDO();BeanUtils.copyProperties(studentDO,studentDTO); 不过,上面的代码如果你这么写,我们会碰到第一个问题,BeanUtils 默认不支持 String转为 Date 类型。 为了解决这个问题,我们需要自己构造一个 Converter 转换类,然后使用 ConvertUtils注册,使用方法如下: ConvertUtils.register(newConverter(){@SneakyThrows@Overridepublic<Date>Dateconvert(Class<Date>type,Objectvalue){if(value==null){returnnull;}if(valueinstanceofString){Stringstr=(String)value;return(Date)DateUtils.parseDate(str,"yyyy-MM-dd");}returnnull;}},Date.class); 此时,我们观察 studentDO与 studentDTO对象属性值: 从上面的图我们可以得出BeanUtils一些结论: 普通字段名不一致的属性无法被复制 嵌套对象字段,将会与源对象使用同一对象,即使用 浅拷贝 类型不一致的字段,将会进行默认类型转化。 虽然 BeanUtils 使用起来很方便,不过其底层源码为了追求完美,加了过多的包装,使用了很多反射,做了很多校验,所以导致性能较差,所以并阿里巴巴开发手册上强制规定避免使用 Apache BeanUtils。 image-20200818222213879 Spring BeanUtils Spring 属性复制工具类类名与 Apache 一样,基本用法也差不多。我先来看下 Spring BeanUtils 基本用法。 同样,我们先引入依赖,从名字我们可以看出,BeanUtils 位于 Spring-Beans 模块,这里我们依然使用最新模块。 <dependency><groupId>org.springframework</groupId><artifactId>spring-beans</artifactId><version>5.2.8.RELEASE</version></dependency> 这里我们使用 DTO 与 DO 复用上面的例子,转换代码如下: //省略上面赋值代码,与上面一致StudentDOstudentDO=newStudentDO();BeanUtils.copyProperties(studentDTO,studentDO); 从用法可以看到,Spring BeanUtils 与 Apache 有一个最大的不同,两者源对象与目标对象参数位置不一样,阿粉之前没注意,用了 Spring 工具类,但是却是按照 Apache 的用法使用。 此时对比studentDO与 studentDTO对象: 从上面的对比图我们可以得到一些结论: 字段名不一致,属性无法复制 类型不一致,属性无法复制。但是注意,如果类型为基本类型以及基本类型的包装类,这种可以转化 嵌套对象字段,将会与源对象使用同一对象,即使用 浅拷贝 除了这个方法之外,Spring BeanUtils 还提供了一个重载方法: publicstaticvoidcopyProperties(Objectsource,Objecttarget,String...ignoreProperties) 使用这个方法,我们可以忽略某些不想被复制过去的属性: BeanUtils.copyProperties(studentDTO,studentDO,"name"); 这样,name 属性就不会被复制到 DO 对象中。 虽然 Spring BeanUtils 与 Apache BeanUtils 功能差不多,但是在性能上 Spring BeanUtils 还是完爆 Apache BeanUtils。主要原因还是在于 Spring 并没有与 Apache 一样使用反射做了过多校验,另外 Spring BeanUtils 内部使用了缓存,加快转换的速度。 所以两者选择,还是推荐使用 Spring BeanUtils。 Cglib BeanCopier 上面两个是阿粉日常工作经常使用,而下面的这些都是阿粉最近才开始接触的,比如 Cglib BeanCopier。这个使用方法,可能比上面两个类稍微复杂一点,下面我们来看下具体用法: 首先我们引入 Cglib 依赖: <dependency><groupId>cglib</groupId><artifactId>cglib</artifactId><version>3.3.0</version></dependency> 画外音:如果你工程内还有 Spring-Core 的话,如果查找 BeanCopier 这个类,可以发现两个不同的包的同名类。 一个属于 Cglib,另一个属于 Spring-Core。 其实 Spring-Core 内BeanCopier 实际就是引入了 Cglib 中的类,这么做的目的是为包了保证 Spring 使用长度 Cglib 相关类的稳定性,防止外部 Cglib 依赖不一致,导致 Spring 运行异常。 转换代码如下: //省略赋值语句StudentDOstudentDO=newStudentDO();BeanCopierbeanCopier=BeanCopier.create(StudentDTO.class,StudentDO.class,false);beanCopier.copy(studentDTO,studentDO,null); 使用方法相比 BeanUtils, BeanCopier 稍微多了一步。 对比studentDO与 studentDTO对象: 从上面可以得到与 Spring Beanutils 基本一致的结论: 字段名不一致,属性无法复制 类型不一致,属性无法复制。 不过有点不一样,如果类型为基本类型/基本类型的包装类型,这两者无法被拷贝。 嵌套对象字段,将会与源对象使用同一对象,即使用 浅拷贝 上面我们使用 Beanutils,遇到这种字段名,类型不一致的这种情况,我们没有什么好办法,只能手写硬编码。 不过在 BeanCopier 下,我们可以引入转换器,进行类型转换。 //注意最后一个属性设置为trueBeanCopierbeanCopier=BeanCopier.create(StudentDTO.class,StudentDO.class,true);//自定义转换器beanCopier.copy(studentDTO,studentDO,newConverter(){@OverridepublicObjectconvert(Objectsource,Classtarget,Objectcontext){if(sourceinstanceofInteger){Integernum=(Integer)source;returnnum.toString();}returnnull;}}); 不过吐槽一下这个转换器,一旦我们自己打开使用转换器,所有属性复制都需要我们自己来了。比如上面的例子中,我们只处理当源对象字段类型为 Integer,这种情况,其他都没处理。我们得到 DO 对象将会只有 name 属性才能被复制。 Cglib BeanCopier 的原理与上面两个 Beanutils 原理不太一样,其主要使用 字节码技术动态生成一个代理类,代理类实现get 和 set方法。生成代理类过程存在一定开销,但是一旦生成,我们可以缓存起来重复使用,所有 Cglib 性能相比以上两种 Beanutils 性能比较好。 Dozer Dozer ,中文直译为挖土机 ,这是一个「重量级」属性复制工具类,相比于上面介绍三个工具类,Dozer 具有很多强大的功能。 官网 logo 画外音:重量级/轻量级其实只是一个相对的说法,由于 Dozer 相对 BeanUtils 这类工具类来说,拥有许多高级功能,所以相对来说这是一个重量级工具类。 阿粉刚碰到这个工具类,就被深深折服,真的太强大了,上面我们期望的功能,Dozer 都给你实现了。 下面我们来看下使用方法,首先我们引入 Dozer 依赖: <dependency><groupId>net.sf.dozer</groupId><artifactId>dozer</artifactId><version>5.4.0</version></dependency> 使用方法如下: //省略属性的代码DozerBeanMappermapper=newDozerBeanMapper();StudentDOstudentDO=mapper.map(studentDTO,StudentDO.class);System.out.println(studentDO); Dozer 需要我们新建一个DozerBeanMapper,这个类作用等同与 BeanUtils,负责对象之间的映射,属性复制。 画外音:下面的代码我们可以看到,生成 DozerBeanMapper实例需要加载配置文件,随意生成代价比较高。在我们应用程序中,应该使用单例模式,重复使用DozerBeanMapper。 如果属性都是一些简单基本类型,那我们只要使用上面代码,可以快速完成属性复制。 不过很不幸,我们的代码中有字符串与 Date 类型转化,如果我们直接使用上面的代码,程序运行将会抛出异常。 所以这里我们要用到 Dozer 强大的配置功能,我们总共可以使用下面三种方式: XML API 注解 其中,API 的方式比较繁琐,目前大部分使用 XML 进行,另外注解功能的是在 Dozer 5.3.2 之后增加的新功能,不过功能相较于 XML 来说较弱。 XML 使用方式 下面我们使用 XML 配置方式,配置 DTO 与 DO 关系,首先我们新建一个 dozer/dozer-mapping.xml 文件: <?xmlversion="1.0"encoding="UTF-8"?><mappingsxmlns="http://dozer.sourceforge.net"xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xsi:schemaLocation="http://dozer.sourceforge.nethttp://dozer.sourceforge.net/schema/beanmapping.xsd"><!--类级别的日期转换,默认使用这个格式转换--><mappingdate-format="yyyy-MM-ddHH:mm:ss"><class-a>com.just.doone.example.domain.StudentDTO</class-a><class-b>com.just.doone.example.domain.StudentDO</class-b><!--在下面指定字段名不一致的映射关系--><field><a>no</a><b>number</b></field><field><!--字段级别的日期转换,将会覆盖字段上的转换--><adate-format="yy-MM-dd">createDate</a><b>createDate</b></field></mapping></mappings> 然后修改我们的 Java 代码,增加读取 Dozer 的配置文件: DozerBeanMappermapper=newDozerBeanMapper();List<String>mappingFiles=newArrayList<>();//读取配置文件mappingFiles.add("dozer/dozer-mapping.xml");mapper.setMappingFiles(mappingFiles);StudentDOstudentDO=mapper.map(studentDTO,StudentDO.class);System.out.println(studentDO); 运行之后,对比studentDO与 studentDTO对象: 从上面的图我们可以发现: 类型不一致的字段,属性被复制 DO 与 DTO 对象字段不是同一个对象,也就是深拷贝 通过配置字段名的映射关系,不一样字段的属性也被复制 除了上述这些相对简单的属性以外,Dozer 还支持很多额外的功能,比如枚举属性复制,Map 等集合属性复制等。 有些小伙伴刚看到 Dozer 的用法,可能觉得这个工具类比较繁琐,不像 BeanUtils 工具类一样一行代码就可以解。 其实 Dozer 可以很好跟 Spring 框架整合,我们可以在 Spring 配置文件提前配置,后续我们只要引用 Dozer 的相应的 Bean ,使用方式也是一行代码。 Dozer 与 Spring 整合,我们可以使用其 DozerBeanMapperFactoryBean,配置如下: <beanclass="org.dozer.spring.DozerBeanMapperFactoryBean"><propertyname="mappingFiles"value="classpath*:/*mapping.xml"/><!--自定义转换器--><propertyname="customConverters"><list><beanclass="org.dozer.converters.CustomConverter"/></list></property></bean> DozerBeanMapperFactoryBean支持设置属性比较多,可以自定义设置类型转换,还可以设置其他属性。 另外还有一种简单的方法,我们可以在 XML 中配置 DozerBeanMapper: <beanid="org.dozer.Mapper"class="org.dozer.DozerBeanMapper"><propertyname="mappingFiles"><list><value>dozer/dozer-Mapperpping.xml</value></list></property></bean> Spring 配置完成之后,我们在代码中可以直接注入: @AutowiredMappermapper;publicvoidobjMapping(StudentDTOstudentDTO){//直接使用StudentDOstudentDO=mapper.map(studentDTO,StudentDO.class);} 注解方式 Dozer 注解方式相比 XML 配置来说功能很弱,只能完成字段名不一致的映射。 上面的代码中,我们可以在 DTO 的 no 字段上使用 @Mapping 注解,这样我们在使用 Dozer 完成转换时,该字段属性将会被复制。 @DatapublicclassStudentDTO{privateStringname;privateIntegerage;@Mapping("number")privateStringno;privateList<String>subjects;privateCoursecourse;privateStringcreateDate;} 虽然目前注解功能有点薄弱,不过后看版本官方可能增加新的注解功能,另外 XML 与注解可以一起使用。 最后 Dozer 底层本质上还是使用了反射完成属性的复制,所以执行速度并不是那么理想。 orika orika也是一个跟 Dozer 类似的重量级属性复制工具类,也提供诸如 Dozer 类似的功能。但是 orika 无需使用繁琐 XML 配置,它自身提供一套非常简洁的 API 用法,非常容易上手。 首先我们引入其最新的依赖: <dependency><groupId>ma.glasnost.orika</groupId><artifactId>orika-core</artifactId><version>1.5.4</version></dependency> 基本使用方法如下: //省略其他设值代码//这里先不要设值时间//studentDTO.setCreateDate("2020-08-08");MapperFactorymapperFactory=newDefaultMapperFactory.Builder().build();MapperFacademapper=mapperFactory.getMapperFacade();StudentDOstudentDO=mapper.map(studentDTO,StudentDO.class); 这里我们引入两个类 MapperFactory 与 MapperFacade,其中 MapperFactory 可以用于字段映射,配置转换器等,而 MapperFacade 的作用就与 Beanutils 一样,用于负责对象的之间的映射。 上面的代码中,我们故意注释了 DTO 对象中的 createDate 时间属性的设值,这是因为默认情况下如果没有单独设置时间类型的转换器,上面的代码将会抛错。 另外,上面的代码中,对于字段名不一致的属性,是不会复制的,所以我们需要单独设置。 下面我们就设置一个时间转换器,并且指定一下字段名: MapperFactorymapperFactory=newDefaultMapperFactory.Builder().build();ConverterFactoryconverterFactory=mapperFactory.getConverterFactory();converterFactory.registerConverter(newDateToStringConverter("yyyy-MM-dd"));mapperFactory.classMap(StudentDTO.class,StudentDO.class).field("no","number")//一定要调用下byDefault.byDefault().register();MapperFacademapper=mapperFactory.getMapperFacade();StudentDOstudentDO=mapper.map(studentDTO,StudentDO.class); 上面的代码中,首先我们需要在 ConverterFactory 注册一个时间类型的转换器,其次我们还需要再 MapperFactory 指定不同字段名的之间的映射关系。 这里我们要注意,在我们使用 classMap 之后,如果想要相同字段名属性默认被复制,那么一定调用 byDefault方法。 简单对比一下 DTO 与 DO 对象: 上图可以发现 orika 的一些特性: 默认支持类型不一致(基本类型/包装类型)转换 支持深拷贝 指定不同字段名映射关系,属性可以被成功复制。 另外 orika 还支持集合映射: MapperFactorymapperFactory=newDefaultMapperFactory.Builder().build();List<Person>persons=newArrayList<>();List<PersonDto>personDtos=mapperFactory.getMapperFacade().mapAsList(persons,PersonDto.class); 最后聊下 orika 实现原理,orika 与 dozer 底层原理不太一样,底层其使用了 javassist 生成字段属性的映射的字节码,然后直接动态加载执行字节码文件,相比于 Dozer 的这种使用反射原来的工具类,速度上会快很多。 MapStruct 不知不觉,一口气已经写了 5 个属性复制工具类,小伙伴都看到这里,那就不要放弃了,坚持看完,下面将介绍一个与上面这些都不太一样的工具类「MapStruct」。 上面介绍的这些工具类,不管使用反射,还是使用字节码技术,这些都需要在代码运行期间动态执行,所以相对于手写硬编码这种方式,上面这些工具类执行速度都会慢很多。 那有没有一个工具类的运行速度与硬编码这种方式差不多那? 这就要介绍 MapStruct 这个工具类,这个工具类之所以运行速度与硬编码差不多,这是因为他在编译期间就生成了 Java Bean 属性复制的代码,运行期间就无需使用反射或者字节码技术,所以确保了高性能。 另外,由于编译期间就生成了代码,所以如果有任何问题,编译期间就可以提前暴露,这对于开发人员来讲就可以提前解决问题,而不用等到代码应用上线了,运行之后才发现错误。 下面我们来看下,怎么使用这个工具类,首先我们先引入这个依赖: <dependency><groupId>org.mapstruct</groupId><artifactId>mapstruct</artifactId><version>1.3.1.Final</version></dependency> 其次,由于 MapStruct 需要在编译器期间生成代码,所以我们需要 maven-compiler-plugin插件中配置: <plugin><groupId>org.apache.maven.plugins</groupId><artifactId>maven-compiler-plugin</artifactId><version>3.8.1</version><configuration><source>1.8</source><!--dependingonyourproject--><target>1.8</target><!--dependingonyourproject--><annotationProcessorPaths><path><groupId>org.mapstruct</groupId><artifactId>mapstruct-processor</artifactId><version>1.3.1.Final</version></path><!--otherannotationprocessors--></annotationProcessorPaths></configuration></plugin> 接下来我们需要定义映射接口,代码如下: @MapperpublicinterfaceStudentMapper{StudentMapperINSTANCE=Mappers.getMapper(StudentMapper.class);@Mapping(source="no",target="number")@Mapping(source="createDate",target="createDate",dateFormat="yyyy-MM-dd")StudentDOdtoToDo(StudentDTOstudentDTO);} 我们需要使用 MapStruct 注解 @Mapper 定义一个转换接口,这样定义之后,StudentMapper 的功能就与 BeanUtils 等工具类一样了。 其次,由于我们 DTO 与 DO 对象中存在字段名不一致的情况,所以我们还在在转换方法上使用 @Mapping 注解指定字段映射。另外我们 createDate 字段类型不一致,这里我们还需要指定时间格式化类型。 上面定义完成之后,我们就可以直接使用 StudentMapper 一行代码搞定对象转换。 //忽略其他代码StudentDOstudentDO=StudentMapper.INSTANCE.dtoToDo(studentDTO); 如果我们对象使用 Lombok 的话,使用 @Mapping指定不同字段名,编译期间可能会抛出如下的错误: 这个原因主要是因为 Lombok 也需要编译期间自动生成代码,这就可能导致两者冲突,当 MapStruct 生成代码时,还不存在 Lombok 生成的代码。 解决办法可以在 maven-compiler-plugin插件配置中加入 Lombok,如下: <plugin><groupId>org.apache.maven.plugins</groupId><artifactId>maven-compiler-plugin</artifactId><version>3.8.1</version><configuration><source>1.8</source><!--dependingonyourproject--><target>1.8</target><!--dependingonyourproject--><annotationProcessorPaths><path><groupId>org.mapstruct</groupId><artifactId>mapstruct-processor</artifactId><version>1.3.1.Final</version></path><path><groupId>org.projectlombok</groupId><artifactId>lombok</artifactId><version>1.18.12</version></path><!--otherannotationprocessors--></annotationProcessorPaths></configuration></plugin> 输出 DO 与 DTO 如下: 从上图中我们可以得到一些结论: 部分类型不一致,可以自动转换,比如 基本类型与包装类型 基本类型的包装类型与 String 深拷贝 上面介绍的例子介绍一些简单字段映射,如果小伙伴在工作总共还碰到其他的场景,可以先查看一下这个工程,查看一下有没有结局解决办法:https://github.com/mapstruct/mapstruct-examples 上面我们已经知道 MapStruct 在编译期间就生成了代码,下面我们来看下自动生成代码: publicclassStudentMapperImplimplementsStudentMapper{publicStudentMapperImpl(){}publicStudentDOdtoToDo(StudentDTOstudentDTO){if(studentDTO==null){returnnull;}else{StudentDOstudentDO=newStudentDO();studentDO.setNumber(studentDTO.getNo());try{if(studentDTO.getCreateDate()!=null){studentDO.setCreateDate((newSimpleDateFormat("yyyy-MM-dd")).parse(studentDTO.getCreateDate()));}}catch(ParseExceptionvar4){thrownewRuntimeException(var4);}studentDO.setName(studentDTO.getName());if(studentDTO.getAge()!=null){studentDO.setAge(String.valueOf(studentDTO.getAge()));}List<String>list=studentDTO.getSubjects();if(list!=null){studentDO.setSubjects(newArrayList(list));}studentDO.setCourse(studentDTO.getCourse());returnstudentDO;}}} 从生成的代码来看,里面并没有什么黑魔法,MapStruct 自动生成了一个实现类 StudentMapperImpl,里面实现了 dtoToDo,方法里面调用 getter/setter设值。 从这个可以看出,MapStruct 作用就相当于帮我们手写getter/setter设值,所以它的性能会很好。 总结 看文这篇文章,我们一共学习了 7 个属性复制工具类,这么多工具类我们该如何选择那?阿粉讲讲自己的一些见解: 第一,首先我们直接抛弃 Apache Beanutils ,这个不用说了,阿里巴巴规范都这样定了,我们就不要使用好了。 第二,当然是看工具类的性能,这些工具类的性能,网上文章介绍的比较多,阿粉就复制过来,大家可以比较一下。 来自:https://www.hollischuang.com/archives/5337 来自:https://www.baeldung.com/java-performance-mapping-frameworks 可以看到 MapStruct 的性能可以说还是相当优秀。那么如果你的业务对于性能,响应等要求比较高,或者你的业务存在大数据量导入/导出的场景,而这个代码存在对象转化,那就切勿使用 Apache Beanutils, Dozer 这两个工具类。 第三,其实很大一部分应用是没有很高的性能的要求,只要工具类能提供足够的便利,就可以接受。如果你的业务中没有很复杂的的需求,那么直接使用 Spring Beanutils 就好了,毕竟 Spring 的包大部分应用都在使用,我们都无需导入其他包了。 那么如果业务存在不同类型,不同的字段名,那么可以考虑使用 orika 等这种重量级工具类。 好了,今天的文章就到这里为止了~ 参考 https://www.cnkirito.moe/orika/ https://www.hollischuang.com/archives/5337 http://dozer.sourceforge.net/documentation/usage.html http://orika-mapper.github.io/orika-docs/faq.html https://github.com/mapstruct/mapstruct-examples < END > 如果大家喜欢我们的文章,欢迎大家转发,点击在看让更多的人看到。也欢迎大家热爱技术和学习的朋友加入的我们的知识星球当中,我们共同成长,进步。 往期 精彩回顾 秒杀真那么难?手把手带你优化秒杀流程 手把手教你搭建一个单一机器的Hadoop,你要看一下么? 你确定 LinkedList 在新增/删除元素时,效率比 ArrayList 高? 本文分享自微信公众号 - Java极客技术(Javageektech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Pick!闲鱼亿级商品库中的秒级实时选品

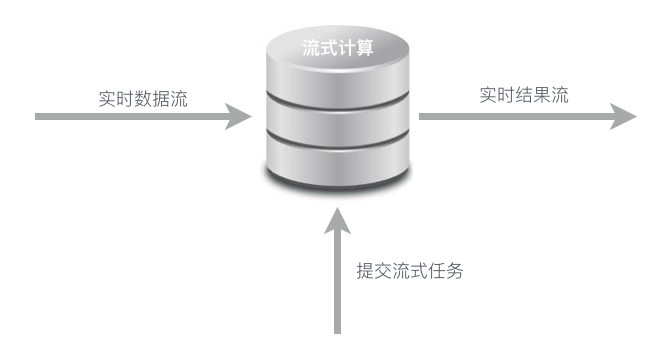
一、业务背景 在电商运营工作中,营销活动是非常重要的部分,对用户增长和GMV都有很大帮助。对电商运营来说,如何从庞大的商品库中筛选出卖家优质商品并推送给有需要的买家购买是每时每刻都要思索的问题,而且这个过程需要尽可能快和实时。保证快和实时就可以提升买卖双方的用户体验,提高用户粘性。 二、实时选品 为了解决上面提到的问题,闲鱼研发了马赫系统。马赫是一个实时高性能的商品选品系统,解决在亿级别商品中通过规则筛选优质商品并进行投放的场景。有了马赫系统之后,闲鱼的运营同学可以在马赫系统上创建筛选规则,比如商品标题包含“小猪佩奇”、类目为“玩具”、价格不超过100元且商品状态为未卖出。在运营创建规则后,马赫系统会同时进行两步操作,第一步是从存量商品数据筛选符合条件的商品进行打标;第二步是对商品实时变更进行规则计算,实时同步规则命中结果。 马赫系统最大的特点是快而实时,体现在命中规模为100w的规则可以在10分钟之内完成打标;商品本身变更导致的规则命中结果同步时间为1秒钟。运营可以通过马赫系统快速筛选商品向用户投放,闲鱼的流量也可以精准投给符合条件的商品并且将流量利用到最大化。 那么马赫系统是如何解决这一典型的电商问题的呢,马赫系统和流计算有什么关系呢,这是下面要详细说明的部分。 三、流计算 流计算是持续、低延迟、事件触发的数据处理模型。流计算模型是使用实时数据集成工具,将数据实时变化传输到流式数据存储,此时数据的传输变成实时化,将长时间累积大量的数据平摊到每个时间点不停地小批量实时传输;流计算会将计算逻辑封装为常驻计算服务,一旦启动就一直处于等待事件触发状态,当有数据流入后会触发计算迅速得到结果;当流计算得到计算结果后可以立刻将数据输出,无需等待整体数据的计算结果。 闲鱼实时选品系统使用的流计算框架是Blink,Blink是阿里巴巴基于开源流计算框架Flink定制研发的企业级流计算框架,可以认为是Flink的加强版,现在已经开源。Flink是一个高吞吐、低延迟的计算引擎,同时还提供很多高级功能。比如它提供有状态的计算,支持状态管理,支持强一致性的数据语义以及支持Event Time,WaterMark对消息乱序的处理等特性,为闲鱼实时选品系统的超低延时选品提供了有力支持。 3.1、Blink之State State是指流计算过程中计算节点的中间计算结果或元数据属性,比如在aggregation过程中要在state中记录中间聚合结果,比如Apache Kafka作为数据源时候,我们也要记录已经读取记录的offset,这些State数据在计算过程中会进行持久化(插入或更新)。所以Blink中的State就是与时间相关的,Blink任务的内部数据(计算数据和元数据属性)的快照。 马赫系统会在State中保存商品合并之后的全部数据和规则运行结果数据。当商品发生变更后,马赫系统会将商品变更信息与State保存的商品信息进行合并,并将合并的信息作为入参运行所有规则,最后将规则运行结果与State保存的规则运行结果进行Diff后得到最终有效的运行结果。所以Blink的State特性是马赫系统依赖的关键特性。 3.2、Blink之Window Blink的Window特性特指流计算系统特有的数据分组方式,Window的创建是数据驱动的,也就是说,窗口是在属于此窗口的第一个元素到达时创建。当窗口结束时候删除窗口及状态数据。Blink的Window主要包括两种,分别为滚动窗口(Tumble)和滑动窗口(Hop)。 滚动窗口有固定大小,在每个窗口结束时进行一次数据计算,也就是说滚动窗口任务每经过一次固定周期就会进行一次数据计算,例如每分钟计算一次总量。 滑动窗口与滚动窗口类似,窗口有固定的size,与滚动窗口不同的是滑动窗口可以通过slide参数控制滑动窗口的新建频率。因此当slide值小于窗口size的值的时候多个滑动窗口会重叠,此时数据会被分配给多个窗口,如下图所示: Blink的Window特性在数据计算统计方面有很多使用场景,马赫系统主要使用窗口计算系统处理数据的实时速度和延时,用来进行数据统计和监控告警。 3.3、Blink之UDX UDX是Blink中用户自定义函数,可以在任务中调用以实现一些定制逻辑。Blink的UDX包括三种,分别为: UDF - User-Defined Scalar Function UDF是最简单的自定义函数,输入是一行数据的任意字段,输出是一个字段,可以实现数据比较、数据转换等操作。 UDTF - User-Defined Table-Valued Function UDTF 是表值函数,每个输入(单column或多column)返回N(N>=0)Row数据,Blink框架提供了少量的UDTF,比如:STRING_SPLIT,JSON_TUPLE和GENERATE_SERIES3个built-in的UDTF。 UDAF - User-Defined Aggregate Function UDAF是聚合函数,输入是多行数据,输出是一个字段。Blink框架Built-in的UDAF包括MAX,MIN,AVG,SUM,COUNT等,基本满足了80%常用的集合场景,但仍有一定比例的复杂业务场景,需要定制自己的聚合函数。 马赫系统中使用了大量的UDX进行逻辑定制,包括消息解析、数据处理等。而马赫系统最核心的商品数据合并、规则运行和结果Diff等流程就是通过UDAF实现的。 四、秒级选品方案 选品系统在项目立项后也设计有多套技术方案。经过多轮讨论后,最终决定对两套方案实施验证后决定最终实现方案。 第一套方案是基于PostgreSQL的方案,PostgreSQL可以很便捷的定义Function进行数据合并操作,在PostgreSQL的trigger上定义执行规则逻辑。基于PostgreSQL的技术实现较复杂,但能满足功能需求。不过性能测试结果显示PostgreSQL处理小数据量(百万级)性能较好;当trigger数量多、trigger逻辑复杂或处理亿级别数据时,PostgreSQL的性能会有较大下滑,不能满足秒级选品的性能指标。因此基于PostgreSQL的方案被否决(在闲鱼小商品池场景中仍在使用)。 第二套方案是基于Blink流计算方案,通过验证发现Blink SQL很适合用来表达数据处理逻辑而且Blink性能很好,综合对比之后最终选择Blink流计算方案作为实际实施的技术方案。 为了配合使用流计算方案,马赫系统经过设计和解耦,无缝对接Blink计算引擎。其中数据处理模块是马赫系统核心功能模块,负责接入商品相关各类数据、校验数据、合并数据、执行规则和处理执行结果并输出等步骤,所以数据处理模块的处理速度和延时在很大程度上能代表马赫系统数据处理速度和延时。接下来我们看下数据处理模块如何与Blink深度结合将数据处理延迟降到秒级。 数据处理模块结构如上图,包含数据接入层、数据合并层、规则运行层和规则运行结果处理层。每层都针对流计算处理模式进行了单独设计。 4.1、数据接入层 数据接入层是数据处理模块前置,负责对接多渠道各种类型的业务数据,主要逻辑如下: 数据接入层对接多个渠道多种类型的业务数据; 解析业务数据并做简单校验; 统计各渠道业务数据量级并进行监控,包括总量和同比变化量; 通过元数据中心获取字段级别的Metadata配置。元数据中心是用来保存和管理所有字段的MetaData配置信息组件。Metadata配置代表字段元数据配置,包括字段值类型,值范围和值格式等基础信息; 根据Metadata配置进行字段级别数据校验; 按照马赫定义的标准数据范式组装数据。 这样设计的考虑是因为业务数据是多种多样的,比如商品信息包括数据库的商品表记录、商品变更的MQ消息和算法产生的离线数据,如果直接通过Blink对接这些业务数据源的话,需要创建多个Blink任务来对接不同类型业务数据源,这种处理方式太重,而且数据接入逻辑与Blink紧耦合,不够灵活。 数据接入层可以很好的解决上述问题,数据接入层可以灵活接入多种业务数据,并且将数据接入与Blink解耦,最终通过同一个Topic发出消息。而Blink任务只要监听对应的Topic就可以连续不断的收到业务数据流,触发接下来的数据处理流程。 4.2、数据合并层 数据合并是数据处理流程的重要步骤,数据合并的主要作用是将商品的最新信息与内存中保存的商品信息合并供后续规则运行使用。数据合并主要逻辑是: 监听指定消息队列Topic,获取业务数据消息; 解析消息,并将消息内容按照字段重新组装数据,格式为{key:[timestamp, value]},key是字段名称,value是字段值,timestamp为字段数据产生时间戳; 将组装后的数据和内存中保存的历史数据根据timestamp进行字段级别数据合并,合并算法为比较timestamp大小取最新字段值,具体逻辑见下图。 数据合并有几个前提: 内存可以保存存量数据; 这个是Blink提供的特性,Blink可以将任务运行过程中产生的存量数据保存在内存中,在下一次运行时从内存中取出继续处理。 合并后的数据能代表商品的最新状态; 这点需要一个巧妙设计:商品信息有很多字段,每个字段的值是数组,不仅要记录实际值,还要记录当前值的修改时间戳。在合并商品信息时,按照字段进行合并,合并规则是取时间戳最大的值为准。 举例来说,内存中保存的商品ID=1的信息是{"desc": [1, "描述1"], "price": [4, 100.5]},数据流中商品ID=1的信息是{"desc": [2, "描述2"], "price": [3, 99.5]},那么合并结果就是{"desc": [2, "描述2"], "price": [4, 100.5]},每个字段的值都是最新的,代表商品当前最新信息。 当商品信息发生变化后,最新数据由数据接入层流入,通过数据合并层将数据合并到内存,Blink内存中保存的是商品当前最新的全部数据。 4.3、规则运行层 规则运行层是数据处理流程核心模块,通过规则运算得出商品对各规则命中结果,逻辑如下: 规则运行层接受输入为经过数据合并后的数据; 通过元数据中心获取字段级别Metadata配置; 根据字段Metadata配置解析数据; 通过规则中心获取有效规则列表,规则中心是指创建和管理规则生命周期的组件; 循环规则列表,运行单项规则,将规则命中结果保存在内存; 记录运行规则抛出异常的数据,并进行监控告警。 这里的规则指的是运营创建的业务规则,比如商品价格大于50且状态为在线。规则的输入是经过数据合并后的商品数据,输出是true或false,即是否命中规则条件。规则代表的是业务投放场景,马赫系统的业务价值就是在商品发生变更后尽快判断是否命中之前未命中的规则或是不命中之前已经命中的规则,并将命中和不命中结果尽快体现到投放场景中。 规则运行需利用Blink强大算力来保证快速执行,马赫系统当前有将近300条规则,而且还在快速增长。这意味着每个商品发生变更后要在Blink上运行成百上千条规则,闲鱼每天有上亿商品发生变更,这背后需要的运算量是非常惊人的。 4.4、运行结果处理层 读者读到这里可能会奇怪,明明经过规则运行之后直接把运行结果输出到投放场景就可以了,不需要运行结果处理层。实际上运行结果处理层是数据处理模块最重要的部分。 因为在实际场景中,商品的变更在大部分情况只会命中很少一部分规则,而且命中结果也很少会变化。也就是说商品对很多规则的命中结果是没有意义的,如果将这些命中结果也输出的话,只会增加操作TPS,对实际结果没有任何帮助。而筛选出有效的运行结果,这就是运行结果处理层的作用。运行结果处理层逻辑如下: 获取商品数据的规则运行结果; 按照是否命中规则解析运行结果; 将运行结果与内存中保存的历史运行结果进行diff,diff作用是排除新老结果中相同的命中子项,逻辑见下图。 运行结果处理层利用Blink内存保存商品上一次变更后规则运行结果,并将当前变更后规则运行结果与内存中结果进行比较,计算出有效运行结果。举例来说,商品A上一次变更后规则命中结果为{"rule1":true, "rule2":true, "rule3":false, "rule4":false},当前变更后规则命中结果为{"rule1":true, "rule2":false, "rule3":false, "rule4":true}。因为商品A变更后对rule1和rule3的命中结果没有变化,所以实际有效的命中结果是{"rule2":false, "rule4":true},通过运行结果处理层处理后输出的是有效结果的最小集,可以极大减小无效结果输出,提高数据处理的整体性能和效率。 4.5、难点解析 虽然闲鱼实时选品系统在立项之初经过预研和论证,但因为使用很多新技术框架和流计算思路,在开发过程中遇到一些难题,包括设计和功能实现方面的,很多是设计流计算系统的典型问题。我们就其中一个问题与各位读者探讨-规则公式转换。 4.5.1、规则公式转换 这个问题的业务场景是:运营同学在马赫系统页面上筛选商品字段后保存规则,服务端是已有的老系统,逻辑是根据规则生成一段SQL,SQL的where条件和运营筛选条件相同。SQL有两方面的作用,一方面是作为离线规则,在离线数据库中执行SQL筛选符合规则的离线商品数据;另一方面是转换成在线规则,在Blink任务中对实时商品变更数据执行规则以判断是否命中。 因为实时规则运行使用的是MVEL表达式引擎,MVEL表达式是类Java语法的,所以问题就是将离线规则的SQL转换成在线规则的Java表达式,两者逻辑需一致,并且需兼顾性能和效率。问题的解决方案很明确,解析SQL后将SQL操作符转换成Java操作符,并将SQL特有语法转成Java语法,例如A like '%test%'转成A.contains('test')。 这个问题的难点是如何解析SQL和将解析后的语义转成Java语句。经过调研之后给出了简单而优雅的解决方案,主要步骤如下: 使用Druid框架解析SQL语句,转成一个二叉树,单独取出其中的where条件子树; 通过后序遍历算法遍历where条件子树; 将SQL操作符换成对应的Java操作符; 目前支持且、或、等于、不等于、大于、大于等于、小于、小于等于、like、not like和in等操作。 将SQL语法格式转成Java语法; 将in语法改成Java的或语法,例如A in ('hello', 'world')转成(A == 'hello') || (A == 'world')。 实际运行结果如下: 代码逻辑如下(主要是二叉树后续遍历和操作符转换,不再详细解释): 五、结论 马赫系统上线以来,已经支持近400场活动和投放场景,每天处理近1.4亿条消息,峰值TPS达到50000。马赫系统已经成为闲鱼选品投放的重要支撑。 本文主要阐述马赫系统中数据处理的具体设计方案,说明整体设计的来龙去脉。虽然闲鱼实时选品系统针对的是商品选品,但数据处理流计算技术方案的输入是MQ消息,输出也是MQ消息,不与具体业务绑定,所以数据处理流计算技术方案不只适用于商品选品,也适合其他类似实时筛选业务场景。希望我们的技术方案和设计思路能给你带来一些想法和思考,也欢迎和我们留言讨论,谢谢。 参考资料 闲鱼实时选品系统:https://mp.weixin.qq.com/s/8ROsZniYD7nIQssC14mn3w Blink:https://github.com/apache/flink/tree/blink PostgreSQL:https://www.postgresql.org/ druid:https://github.com/alibaba/druid 作者:闲鱼技术-剑辛 原文链接 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

阿里云多款产品自5月起实行价格调优,各位看官请自行pick

今年上半年云计算市场十分热闹,多家大企业在纷纷向云技术领域发力的同时,也对旗下云产品进行多次调价,尤其是阿里云几乎在每场云栖大会上都有产品宣布降价,且幅度较大。近日,阿里云再次宣布优化收费模式,有多款产品自5月起实行价格调整,小编就为大家在此汇总一番。 视频直播转码商业化阿里云视频直播服务是基于领先的内容接入与分发网络和大规模分布式实时流媒体转码技术打造的音视频直播平台,主要应用于一些文娱互动,赛事直播等场景,为用户提供了便捷接入、高清流畅、低延迟、高并发的音视频直播服务。视频直播服务自上线以来,就不断孵化出新功能。 而其中重要的一环视频直播转码于5月31日宣布商业化,能够解决推流端码率与播流端带宽不相匹配、播放器插件需要实现多码率切换的问题,从而保障视频直播顺利。 据悉,此次的价格调整内容在于支持H265转码配置及商业化,自主配置H2

优秀的个人博客,低调大师

高可靠性、超大规模、极致性能、灵活部署的阿里云Apsara Block Storage,你pick嘛?

演讲嘉宾简介: 数梦工厂 云计算产品线首席架构师 陈磊 阿里云产品专家 陈博 阿里云高级技术专家 陈伟才 阿里云产品专家 崆闻 本节课视频链接,戳这里! 本次分享主要包括以下内容: 一、专有云建设方案现状 二、ABS技术详解 三、Q&A 一、专有云建设方案现状 数梦工厂主要服务于政府和企业客户的专有云建设,具备丰富的专有云建设经验,深刻地了解客户的需求和痛点。在项目中发现,大部分的客户都采用标准的X86服务器加集中式存储设备作为专有云的建设方案。在这种情况下,由于集中式存储设备的局限性,会导致一些限制和问题。 第一点是建设周期比较长。在一些专有云建设中,客户要求采用标准服务器加集中式存储来搭建专有云,由于专有云的硬件设备是高度定制的,它的到货周期比较长,导致整个专有云建设的周期都会比较长。在这样的情况下,可能会出现无法满足云服务

优秀的个人博客,低调大师

阿里云MVP第五期发布,这么多行业大牛你Pick哪一个?

回顾阿里云的发展历程,阿里巴巴集团技术委员会主席王坚博士曾感慨“是阿里云的用户教会我们怎么做云计算的!”。近十年的探索之路,离不开各行各业的云计算技术实践领袖们对阿里云的鞭策与支持。为了向贡献者表示感谢,更希望通过这些云计算技术实践领袖们将更多开发者的声音反映到我们的技术路线图上。2017年6月,阿里云总裁胡晓明在上海云栖大会上发布了阿里云MVP计划。 阿里云最有价值专家,简称 MVP(Most Valuable Professional),是专注于帮助他人充分了解和使用阿里云的技术实践领袖。截止目前,全球总共有230+位技术精英成为阿里云MVP,分布在全球16个国家及地区。今天,我们重磅发布阿里云 MVP 第五期全球名单!未来,阿里云将继续与阿里云 MVP 们共同探索前路,为中国技术创新贡献更多力量。 本期将有72位资深专家及研究者

优秀的个人博客,低调大师

2018年优秀作译者评选,来pick你心中独特的人选吧,2018年异步畅销新书都在这儿了

一个人能够通过一本书来了解世界,了解时代吗? 当然可以!任何一位优秀的作家都能通过创新性的学术研究,用文学作品展示其本身具有的活力与价值,成为读者窥探世界、了解某一事物的窗口。 一个优秀的作家及其独特的艺术创造,总会有人津津乐道。自然,由于种种原因,一些优秀作家会一时被人忽略,但绝不会永远被人遗忘。 今天,异步图书为大家准备了一些国内外优秀作译者及他们的作品,一同来走进这个波澜壮阔的世界吧。 “2018年异步社区优秀作译者评选”活动拉开帷幕。本次参选的70种图书皆为2018年出版的异步图书,最终评选出优秀作者和优秀译者各10名。 ▌投票时间:2018年12月26日-2019年1月4日 ▌投票方式: 1、匿名投票(此方式不能参与抽奖) 2、ID投票(注册为异步社区会员参与投票) ▌投票规则: 保证本次图书评选结果的合理、公正。“作译者投票”限每位读者投票一次。 ▌投票平台:仅限于微信端 ▌作译者奖项设置: 1、优秀作者奖 10名(票选前10名) 2、优秀译者奖 10名(票选前10名) 3、备注:投票排序根据销售顺序排列。 ▌参与投票读者奖项: 1、异步社区200元现金券 2、异步图书纸书 3、异步社区10元现金券 ▌如何参与投票: 投票结束后,刮刮卡抽奖。 快速进入投票通道 购书福利 注册为异步社区会员,订单结算输入优惠码:1bc4bb-9,全场满100减25元。 入围作者 ​ 01 ​​​​张鑫旭 前端开发工程师,国内知名前端博客“鑫空间-鑫生活”博主,目前就职于阅文集团用户体验设计部(YUX),担任技术经理。 《CSS世界》 本书是打破能力上升瓶颈之作。 前端开发行业潜心近10年一直研究看似简单的CSS的人可谓是凤毛麟角,作者从2009年开始写原创技术文章,现在其博客已经成为国内访问量巨大的个人前端博客之一,可以说众多前端初学者是看着作者的博客成长的。 ​ 02 唐亘 数据科学家,专注于机器学习和大数据。 《精通数据科学从线性回归到深度学习》 在数据学科的角度,融合了数学、计算机科学、计量经济学的精髓,为读者阐释了数据科学所要解决的核心问题—数据模型、算法模型的理论内涵和适用范围。 ​ 03 ​​方志朋 毕业于武汉理工大学硕士学位。Spring Cloud中国社区联合发起人、CSDN博客专家。 《深入理解Spring Cloud与微服务构建》 深入浅出讲解Spring Cloud组件、开发工具、框架等知识点; 2. 使读者全面理解微服务的构建原理; 3. 实例丰富,解释清晰,易于读者真正理解原理,并学以致用; 4. 深入讲解Spring Cloud OAuth2,直击市场需求痛点。 04 ​​刘 津 硕士毕业于北京大学数字艺术系,有多年知名互联网公司的产品设计及管理经 验, 现为宜人贷UGD(User Growth Design)用户增长设计团队创始人及负责人。 ​​孙 睿 硕士毕业于北京理工大学设计艺术系,现为创业公司合伙人,担任项目总 监,曾担任宜人贷UE 经理、项目经理。 《破茧成蝶2——以产品为中心的设计革命》 本书作者结合多年从事互联网产品架构和设计工作的思路,融会贯通,提炼出顺应新时代的互联网产品设计内在规律,旨在帮助读者在波涛汹涌、充满不确定性的大环境下,改变命运,不惧未来! ​ 05 ​​杨开振 精通Java 互联网技术开发和实践,拥有十余年一线企业开发经验。 《深入浅出Spring Boot 2.x》 来自一线开发者的实战经验总结,赠送作者讲解的部分配套视频课程。从理论到实践,全面介绍Spring Boot 的原理和应用 - 以高并发场景作为实践案例,循序渐进阐述Spring Boot 实用技巧。 ​ 06 ​​王维波 博士,中国石油大学讲师,主要从事地球物理探测仪器设计、数据处理方法研究和软件开发等工作。 《Qt 5.9 C++开发指南》 本书力求比较全面地介绍Qt C++ 开发应用程序的技术, 以Qt 5.9 LTS为开发用版本,是目前新版的Qt,未来三年内有持续的支持(上一个LTS版本是Qt 5.6)。每个编程主题都精心设计了完整的实例程序,通过实例程序讲解主要类的使用。 ​ 07 ​胡振波 上海交通大学电子工程系本科、微电子学院硕士。 《手把手教你设计CPU——RISC-V处理器篇》 系统介绍RISC-V指令集架构; 结合实际RISC-V开源实例进行教学。;深入剖析RISC-V处理器的微架构以及代码实现。;使读者能够快速掌握并轻松使用RISC-V架构处理器。 通过学习实例蜂鸟E200的Verilog代码,您将能成为一名合格的数字IC设计工程师。 《RISC-V架构与嵌入式开发快速入门》 为了促进RISC-V在国内的普及,尤其是被广大初学者接受和快速入门,本书将分享和总结一些使用RISC-V进行嵌入式开发的相关技术和经验,主要面向对RISC-V感兴趣的入门用户,包括嵌入式软件开发和硬件设计人员。 ​ 08 ​​李强 计算机书籍作家和译者,已陆续有30余本书籍问世,多本书成为业内经典之作。 ​​李若瑜 三年级小学生,电玩狂热爱好者。他为书中的游戏贡献了很好的创意和素材。 《Scratch 2.0少儿游戏趣味编程》 全彩印刷;十多个精彩游戏项目寓教于乐;赠送价值99元的视频课程;方便亲子互动和自学。本书通过14 款有趣的小游戏和小程序,由浅入深地向读者介绍Scratch 编程的基本技能以及程序设计的思维和方法。 ​ 09 ​​叶维忠 浪潮集团企业云深圳研发中心高级工程师,精通Linux、UNIX平台开发,12年C 开发经验,6年Python开发经验。 《Python编程从入门到精通》 本书循序渐进、由浅入深地详细讲解了Python语言开发技术,并通过具体实例演练了各个知识点的具体使用流程。 ​ 10 ​​肖佳 VMware高级测试工程师,博客园知名博主(网名小坦克),撰写了很多软件开发和测试方面的技术文章。 《HTTP抓包实战》 本书是关于HTTP协议、Fiddler抓包工具、JMeter发包工具的实践指南; 包含很多有趣的实例,方便读者动手操作; 讲解Fiddler工具的应用场景; 有配套的理论和操作视频; 图文并茂,方便读者理解。 ​ 11 ​​赵波 研究生,前阿里资深软件工程师/图像算法工程师,擅长移动应用和图像算法开发。 《App架构师实践指南》 全面介绍了在移动应用开发的架构设计和性能优化方面的知识,是架构师的必备书籍,讲述了移动应用架构师需要了解的技能、思想等整体的发展方向,是移动架构师成长的路线图。 ​ 12 ​​邹达 APICloud联合创始人兼CTO APICloud云端一体平台的技术架构设计者及核心引擎的实现者,对大规模、高并发的云端服务开发有着丰富的经验。 《30天App开发从0到1:APICloud移动开发实战》 APICould作为中国知名的移动云平台和企业移动化定制服务平台,同时服务于App开发人员和具有移动化定制需求的企业。 APICould移动开发技术具有开发效率高、开发投入少、技术门槛低等优势,提供与管理API是其特有的服务模式。 ​ 13 ​​金飞 F5亚太区安全解决方案架构师,主要研究方向为信息安全技术及防御架构设计。 《软件定义安全及可编程对抗系统实战》 硅谷安全创业教父、Palo Alto Networks公司联合创始人弓峰敏博士作序并推荐软件定义安全是从软件定义网络引申而来的一个概念,旨在通过编程的方式完成相应的安全功能,实现一种灵活的安全防护。​ 14 ​​路彦雄 西安电子科技大学硕士毕业,从事自然语言处理和机器学习相关工作多年,具有丰富经验。 《文本上的算法——深入浅出自然语言处理》 本书结合作者多年学习和从事自然语言处理相关工作的经验,力图用生动形象的方式深入浅出地介绍自然语言处理的理论、方法和技术。 ​ 15 ​​王波 软件架构师,曾就职于中软国际。 《Java架构师指南》 知名Java专家多年经验总结,介绍从程序员进阶到架构师需要具备的技能的完整教程;基于Java官方API的解读,从架构师的独特角度讲解Java知识和技能,企业级开发的经典示例,全程项目驱动,涵盖电商支付接口的综合调试程序员走向架构师是必经之路。 ​ 16 ​​罗炳森 2010年毕业于西南大学软件工程专业,2015年与他人联合出版了《Oracle查询优化改写技巧与案例》一书。 《SQL优化核心思想》 本书的绝大部分内容源自作者自2012年以来开办的“道森起点”高级SQL优化班,高级SQL优化班在网络上是数据库领域中很受欢迎的一门课程。 ​ 17 ​​马立新 山东大学和北京工业大学硕士生导师,德国3S软件有限公司大中华区总裁。 ​​陆国君 陆国君,高级电气工程师,外企亚太区电气技术顾问。 《开放式控制系统编程技术 基于IEC 61131-3国际标准》 这是一本得到CodeSYS官方认可的指导用书,本书全面系统地介绍了开放式控制系统的软件体系结构、编程方法及工程应用案例,使人工智能时代背景下的高校师生和工程技术人员能够快速学习并掌握开发开放式智能控制系统的相关知识和技能。 ​ 18 ​​宋立桓 微软MVP,云计算和BI资深顾问,目前主要负责为企业客户提供顾问咨询和技术培训服务。 《人人都是数据分析师:微软Power BI实践指南》 Power BI是微软于2016年发布的又一神器,它是一套商业分析工具,拥有强大的数据分析和可视化能力,可连接数百个数据源、简化数据准备并提供即时分析,生成美观的报表并进行发布,供企业、组织、个人在Web和移动设备等多个平台上使用。 ​ 19 ​​胡世杰 上海交通大学毕业,目前在七牛云任职技术专家,是私有云存储服务的负责人。 《分布式对象存储——原理、架构及Go语言实现》 本书完全从云存储的需求出发讲述对象存储的原理,并且带领读者使用Go语言编程,循序渐进、从无到有地建立起一个分布式对象存储的架构。 ​ 20 ​​牛锋华等 《京东质量团队转型实践》 集团高级副总裁马松、商城技术架构部负责人刘海锋、商城研发虚拟平台负责人李仑写序并推荐;著名互联网公司技术干货分享软件测试精髓完美呈现,软件测试人员从测试到测试开发技术成功转型的权威指南,业界知名专家鼎力推荐 的测试之道,每天,上亿级别用户访问的互联网系统。 ​ 21 ​​李华峰 信息安全顾问和自由撰稿人,多年来一直从事网络安全渗透测试方面的研究工作。 《Kali Linux 2网络渗透测试实践指南》 本书是由具有多年网络攻防和教学经验的一线网络安全教师编写,作者具有多年的网络安全工作实践经验,会深入地讲解Kali系统各种工具的用法。 ​ 22 ​​郑钢 网名大刚,毕业于北京大学,前百度运维开发工程师,《操作系统真象还原》作者。 《自制编程语言 基于C语言》 前百度高级工程师、专业书《操作系统真相还原》的作者的又一力作;业界专家联名推荐,滴滴系统部技术高级总监于晓声、阿里巴巴蚂蚁金服技术专家肖金亮、百度资深运维工程师陈晓聪、360企业安全集团政企云事业部技术总监冯顾、ACFUN高级运维总监陆景玉、Mobvista运维总监黄梦溪,手把手地教读者从零去实现一门语言。 ​ 23 ​张银奎 国内知名的调试技术专家。毕业于上海交通大学信息与控制工程系,长期从事软件开发和研究工作。 《软件调试 第2版 卷1:硬件基础》 软件调试领域的“百科全书”,围绕软件调试的“生态”系统、异常和调试器三条主线,介绍软件调试的相关原理和机制,探讨可调试性的内涵、意义,以及实现软件可调试性的原则和方法,总结软件调试的方法和技巧。 ​ 24 ​​李思 曾担任大连东软信息学院数字艺术系数字媒体技术方向的教研室主任,有5年的教学经验,现在大连天维科技有限公司(初创型公司)担任技术总监。 《漫画面向对象编程(Java语言版)》 市面上难得一见的面向对象编程图书,通过漫画模式讲解了面向对象编程中常见的单例模式、工厂模式、建造者模式、代理模式、装饰模式、组合模式、命令模式、策略模式、状态模式、适配器模式、访问者模式、观察者模式,将抽象的理论知识化繁为简,处理为生动的漫画方式,降低了读者的理解难度和学习曲线。 ​ 25​ ​裘宗燕 北京大学数学科学学院教授,博士生导师,主要研究领域涉及形式化方法、程序设计语言、新型语言的语义模型和计算机科学教育。 《程序员学Python》 本书先概述了Python语言的基础编程特征,引出了一些具有Python特色的概念和问题,然后着重介绍反映了Python语言特点的各种特征以及相关编程和应用技术,以期让读者了解如何使用Python语言针对实际问题进行程序开发,进而提高程序的模块化、可读性和易维护性。 ​ 26 ​​孟宁 高校教师、资深码农,主讲课程获国家精品在线开放课程认定。 ​​娄嘉鹏 高校教师,曾荣获北京市优秀教师,蓝墨云平台北京市十大魅力教师等称号。 ​​刘宇栋 高校教师,主要研究方向包括网络攻防技术、系统安全、社交网络分析等。 《庖丁解牛Linux内核分析》 基于本书内容的在线视频课程——“Linux操作系统分析”被教育部评为“国家精品在线开放课程”,被教育部高等学校计算机类专业教学指导委员会评为“2018年度中国高校计算机教育慕课联盟优秀在线开放课程”。 ​ 27 ​刘华 汇丰软件开发(广东)有限公司软件工程经理,拥有16年以上的软件开发经验,10年以上的项目和团队管理经验。 《猎豹行动 硝烟中的敏捷转型之旅》 本书作者有着10多年大型企业项目开发和团队管理经验,将大型IT项目的敏捷转型通过故事叙述的手法通俗易懂地呈献给读者,帮助读者更有代入感地学习和了解大型企业中敏捷转型的挑战,以及如何克服困难成功转型。 ​ 28 ​​王晓慧 北京科技大学机械工程学院工业设计系副教授,2014 年博士毕业于清华大学计算机系。 《Unreal Engine 虚拟现实开发》 本书汇集高校相关专业教师和产业界资深的技术大咖,专注于UE4的全面教学和实践指导。本书经全彩印刷,内容丰富详实,得到了业界领导和专业人士的认可和大力推荐,理论与实践相结合,实用性非常强,可以帮助读者快速学习VR技术,灵活地运用UE4制作出具个性和效果逼真的VR内容。 ​ 29 ​​朱少民 国内知名测试专家,曾任思科(中国)软件有限公司QA高级总监。 《全程软件测试》(第3版) 30位测试专家、产品经理、研发负责人、大学教授联袂推荐;知名学者十年苦心孤诣,经典软件测试著作全新改版;抽丝剥茧,解开软件测试谜团,呈现全景式软件测试体验。 ​ 30 ​李伟 2011年毕业于清华大学,曾经在百度自然语言处理部担任深度学习机器翻译系统线上预测部分的开发与维护,目前供职于微软亚洲工程院。 《C++模板元编程实战—— 一个深度学习框架的初步实现》 众多知名技术专家联袂推荐 C 元编程领域难得一见的精品著作 抽丝剥茧,深入解析C 元编程的技术本质与细节道术并重,详细阐述C 元编程在大型项目中的应用。 ​ 31 ​​孙茂森 毕业于上海第二工业大学网络工程专业和信息安全技术专业,持有CCIE、PMP、ITIL Foundation(IT服务管理认证)等证书。 ​​乔海滨 毕业于大连理工大学城市学院网络工程专业,持有HCIE证书。 《玩转EVE-NG 带您潜入IT虚拟世界》 本书作为市面上的EVE-NG一书(也是V一一本),其内容源自作者多年一线实践经验的总结,全面涵盖了从安装到熟练使用EVE-NG在内的所有内容,还介绍了EVE-NG的底层工作原理以及EVE-NG的各种新奇玩法。​ 32 ​​曲正平 现就职于滴滴出行公司,从事质量管理工作,日常需要协调多个团队进行质量改进。 《离岸交付:分布式团队协作指南 》 本书中提到的技巧不仅能够让服务外包的团队服务好企业级交付,也能顺应协助传统企业利用IT技术创新的潮流,让团队之间的协作更加有效,有助于达成团队的技术目标和业务目标。 ​ 33 ​​甘迪文 北京邮电大学网络空间安全学院在读研究生,2019年秋季即将步入清华大学攻读软件工程专业的博士学位,Write-Bug技术共享平台创始人。 《Windows黑客编程技术详解》 为了揭开病毒木马的神秘面纱,更好地服务于信息安全,本书总结并剖析了常见的Windows黑客编程技术,用通俗易懂的语言介绍了用户层下的Windows编程和内核层下的Rootkit编程。 ​ 34 ​​谭康喜 小米公司高级软件工程师,从事Android应用、Linux驱动、蓝牙、WiFi和蓝牙外设的开发工作。 《低功耗蓝牙智能硬件开发实战》 小米公司联合创始人王川等人作序推荐 侧重于工程项目和开发实战,凸显实用性和通用性,全面涵盖小米公司电视部门低功耗蓝牙技术的产品化细节 低功耗蓝牙是蓝牙技术联盟设计和销售的一种个人局域网技术,旨在用于医疗保健、运动健身、信标、安防、家庭娱乐等领域的新兴应用。 ​ 35 ​​彭旭 2009 年毕业于武汉大学软件工程专业,近十年国内顶尖互联网企业工作经验。 《HBase入门与实践》 本书以精炼的语言介绍HBase基础知识,让初学者能够快速上手使用HBase,对HBase 的核心架构思想(如数据读取、数据备份等)有深入的了解,并且剖析HBase源码,介绍HBase 1.X 以及2.0带来的新特性,让有经验的HBase开发人员也能够循序渐进地深入理解HBase源码,以便更好地去调试和解决线上遇到的各种问题。 ​ 36 ​​乔梁 敏思特咨询公司联合创始人,持续交付领域专家,著名敏捷与精益转型导师,任腾讯外聘高级研发管理顾问。 《持续交付2.0:业务引领的DevOps精要 》 ​ 37 ​​李 鹏 北京中烟信息技术有限公司,中国信息技术服务标准技术委员会专家,IT 运维实验室行业专家。 《IT运维之道》(第2版) 全面阐述IT运维的精髓,深刻剖析IT运维的成功规律。讲述IT服务方法、标准、技巧和技术,揭示IT运维全貌。 入围译者 ​ 01 ​​王巍巍 受软件和编程的吸引,中途转行上岗的软件从业人员。 《笨办法学Python 3》 知乎、CSDN等各大论坛技术大牛推荐的Python自学入门畅销书《笨办法学Python》重磅升级,所有案例均基于Python3.6编写。 ​ 02 ​林赐 软件设计师、网络工程师,毕业于渥太华大学系统科学硕士专业,已翻译出版多本技术图书。 《Python神经网络编程》《人工智能》(第2版) 本书用轻松的笔触,一步一步揭示了神经网络的数学思想,并介绍如何使用Python编程语言开发神经网络。 ​ 03 ​​陈文辉 《Spring微服务实战》 微服务将代码分解为小型的、分布式的独立服务,这些服务需要深谋远虑和仔细设计。Spring Boot和Spring Cloud简化了微服务应用程序。 ​ 04 ​​王海鹏 《Python程序设计 第3版》 本书提供一个简单的图形软件包graphics.py作为示例。包含了完整的编程示例来解决实际问题。以自然的叙事风格介绍了重要的计算机科学概念。 ​ 05 ​​孙余强 ​​王涛 《Wireshark网络分析实战(第2版)》 本书包含了用Wireshark 2排除数通网络故障的实用秘诀。相较于之前的版本,Wireshark 2又增加了很多强大功能,获得了业界更广泛的关注。 《Kali Linux无线渗透测试指南(第3版)》 本书针对新近出现的各种方法论进行了全面更新,全面涵盖了KRACK攻击原理以及防御该攻击的方法。本书从零基础讲解了无线渗透测试的知识,介绍了每一种渗透测试技术的所有相关内容,并借助于大量案例演示了无线测试的方法论。 ​ 06 ​​李斌 毕业于北京科技大学计算机科学与技术专业,获得硕士学位。 《用Python写网络爬虫 第2版》 畅销的Python网络爬虫开发实战图书全新升级版,上一版年销量近40000册。 针对Python 3.6版本编写。 ​ 07 ​​吴佳兴 毕业于华东理工大学计算机系,目前是bilibili 基础平台研发团队的一员。 ​​黄博文 ThoughtWorks 资深软件工程师/咨询师,拥有丰富的敏捷团队工作经验。 ​​杨锐 前ThoughtWorks 咨询师,任职期间曾任某海外大型项目DevOps 工程师。 ​梁晓勇 毕业于厦门大学,现任某互联网金融公司架构师,DockOne 社区编外人员。 《Docker实践》 这是一本涵盖了101 个技巧的实操指南,读者可以用它来获得Docker 的大部分知识。本书遵循手册风格的“问题/ 解决方案/ 讨论”模式,针对很重要的问题,如轻松的服务器管理和配置、部署微服务、为实验而创建安全的环境等,为读者提供了及时有用的解决方案。 ​ 08 ​王海玲 大学毕业于吉林大学计算机系,从小喜爱数学,曾获得华罗庚数学竞赛全国二等奖。 ​​李昉 毕业于东北大学自动化系,大学期间曾获得“挑战杯”全国一等奖。 《Keras深度学习实战》 本书为软件工程师和数据科学家而编写,书中简明而全面地介绍了目前的神经网络和深度学习技术。全书展示了基于Keras框架、以Python编码的20多种有效的神经网络。 ​ 09 ​棣琦 《Linux二进制分析》 本书首先讲解了UNIX Linux中分析目标文件的实用工具和ELF二进制格式的相关内容,随后介绍了进程追踪、各种不同类型的Linux和UNIX病毒,以及如何使用ELF病毒技术进行处理。 ​ 10 ​​费良宏 ​​张波 ​​黄涛 《AWS云计算实战》 本书为读者介绍AWS 云平台的计算、存储和网络服务。读者将从云计算的概览开始,然后学习如何创建自己的账户,学习如何通过调用AWS API 以编程的方式控制AWS 的每个组件,以实现基础设施的自动化,学习存储数据的选项和相关技巧,学习如何使用私有网络隔离自己的系统来增强安全性。 ​ 11 ​​韩波 《Python数据分析(第2版)》 Python拥有许多强大的程序库,已经成为进行各种数据分析和预测建模任务的流行平台。Python的应用范围很广,拓展性很大。本书介绍了众多的Python模块,例如Matplotlib、statsmodels、scikit-learn和NLTK。 ​ 12 ​金鑫 ​熊志男 《Selenium自动化测试 基于 Python 语言》 使用Python和Selenium进行Web自动化测试的实战指南 掌握用Python语言通过调用Selenium 接口,搭建Web应用自动化测试框架 使用Selenium、Appium实现在iOS、Android端在内的移动设备上的自动化测试。 ​ 13 ​田俊 计算机专业硕士。2016 年毕业于中国科学院自动化研究所,目前在微软从事自然语言处理方面的工作。 《Python贝叶斯分析》 本书采用编程计算的实用方法介绍了贝叶斯建模的基础,使用一些手工构造的数据和一部分简单的真实数据来解释和探索贝叶斯框架中的核心概念,然后在本书涉及的模型中,抽象出了线性模型用于解决回归和分类问题,此外还详细解释了混合模型和分层模型,并单独用一章讨论了如何做模型选择,还简单介绍了非参模型和高斯过程。 ​ 14 ​​门佳 《UNIX Linux OS X中的Shell编程 第4版》 本书是Unix Shell Programming经典畅销图书的全新升级版本,遵循了上一版的写作手法,并以POSIX标准Shell为平台,讲解了在Shell编程环境中编写程序的方法,以充分利用UNIX和类UNIX操作系统的潜在性能。 ​ 15 ​​颛青山 《Python深度学习》 本书是使用Python 进行深度学习实践的一本初学指南,将带领读者学习使用Python构建深度神经网络模型。 ​ 16 ​​魏博 志诺维思(北京)基因科技有限公司高-级算法工程师。 《概率图模型 基于R语言》 读者可以从本书中学到哪些知识? ·理解概率图模型的概念,为特定的问题选取特定的概率图模型。 调整模型参数,自动发现新的模型。本书是市场上基于R语言的概率图图书。 ​ 17 ​​黄申 博士,现任LinkedIn(领英)资深数据科学家,毕业于上海交通大学计算机科学与工程专业,师从俞勇教授。 《Elasticsearch实战》 本书将教读者编写提供专业的高质量搜索的应用程序的方法。随着阅读的深入,读者将学会为任何应用程序添加基本的搜索特性,通过预测性分析和相关性排序来增强搜索结果,并使用之前搜索中保存的数据为用户提供定制化的体验。 ​ 18 ​​姚琪琳 ​​刘夏 ​​陈计节 ​​禚娴静 《.NET性能优化》 深度解析反应式编程的基础理念;依托实例演示基础理念应用之法; 进一步讲解反应式流以及应用程序的部署和测试等内容 助力开发者编写高灵活性、高性能的Web应用程序 ​ 19 ​​邓世超 《Git高手之路》 学习Git,让你了解顶 级的项目开发理念。本书引导读者掌握Git实用技巧,加强项目版本管理经验。学习本书,可以帮助读者更好地运用Git,提升软件开发效率。 《C++编程自学宝典》 现在销售的大多数C 图书都是详细地介绍了C 的基本知识和高级主题等,很少有介绍如何阅读、理解C 项目的。 ​ 20 ​​沈达 挖财大数据研发工程师, Scala 爱好者与实践者, 专注于大数据和分布式系统。 ​​何品 目前是*的一名知名软件工程师,热爱反应式编程,同时也是Akka和Netty等项目的贡献者。 《Scala实用指南》 IT行业正拥抱函数式编程,但面向对象编程经验仍然极富价值。Scala编程语言结合了面向对象编程和函数式编程这两种编程范式的原力,而本书将展示如何有效地结合这两者。 ​ 21 ​​张星辰 北京荣之联科技股份有限公司BI 技术顾问,熟悉商业智能和数据可视化,通过了微软数据科学专业认证。 《深入浅出数据科学》 《深入浅出数据科学》的目的是帮助你掌握数学、编程和商业分析的综合技能。通过本书,你将能够自信地提出并解答复杂的数据问题,从抽象和原始的统计信息发掘并完善可执行的想法。 ​ 22 ​​方延风 高级工程师,现在福建省科学技术信息研究所任职。 《Kibana数据可视化》 Kibana是一个开源的数据可视化平台,它允许用户通过令人惊叹的、强大的图形与数据进行交互。 在本书中,读者将学到如何在数据架构之上使用Elastic Stack实时地进行数据可视化。 ​ 23 ​​张卫滨 《反应式Web应用开发》 深度解析反应式编程的基础理念;依托实例演示基础理念应用之法;进一步讲解反应式流以及应用程序的部署和测试等内容 助力开发者编写高灵活性、高性能的Web应用程序 。 ​ 24 ​​高蓉 ​​李茂 《Java数据分析指南》 Java是一门经典的编程语言,在数据分析方面有着突出的表现。学习本书,读者可以掌握各种实用的数据分析技巧,学会如何处理关系型、非关系型数据、时间序列数据等,并能够实现重要的机器学习算法。 投票地址 投票通道已开启,扫描下方二维码,为你心中优秀的作者/译者投票吧。

优秀的个人博客,低调大师

这么多行业大牛你Pick哪一个?

回顾阿里云的发展历程,阿里巴巴集团技术委员会主席王坚博士曾感慨“是阿里云的用户教会我们怎么做云计算的!”。近十年的探索之路,离不开各行各业的云计算技术实践领袖们对阿里云的鞭策与支持。为了向贡献者表示感谢,更希望通过这些云计算技术实践领袖们将更多开发者的声音反映到我们的技术路线图上。2017年6月,阿里云总裁胡晓明在上海云栖大会上发布了阿里云MVP计划。阿里云最有价值专家,简称 MVP(Most Valuable Professional),是专注于帮助他人充分了解和使用阿里云的技术实践领袖。截止目前,全球总共有230+位技术精英成为阿里云MVP,分布在全球16个国家及地区。今天,我们重磅发布阿里云 MVP 第五期全球名单!未来,阿里云将继续与阿里云 MVP 们共同探索前路,为中国技术创新贡献更多力量。 本期将有72位资深专家及研究者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册