SQL数据库学习之路(练习)--数据库系统教程第三章练习
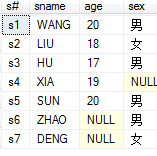
目录 实验要求 利用SQL语句创建数据库Lesson 通过SQL语句创建以下基本表 通过SQL语句实现以下操作: 撤销索引IDX_CLASSID及IDX_S#_C# 在学生关系中增加班级号属性列CLASSID 撤销学生关系中的班级号属性列CLASSID 撤销班级关系CLASS 利用实验1创建的数据库Lesson,分别在各表中插入以下记录,要求至少有一个表为单元组、至少有一个表为多元组的方式插入: 通过select into语句将SC表的表结构复制为SC_TEMP表,然后查询所有性别非空的学生的选课记录并将之插入到SC_TEMP表。 删除SC_TEMP表中无成绩的元组。 将SC_TEMP表中S3的低于S3平均成绩的成绩提高10% 删除SC_TEMP表中S3的小于该生平均成绩的成绩元组。 将S表中性别为空的学生的性别修改为女,并将年龄修改为25岁 创建视图V_M_STUDENT, 要求显示男学生的学号、姓名、课程名、教师名、成绩等列 检索学习C3课程的所有学生姓名和年龄 检索学习由教授讲授的课程的学生学号和姓名 检索没选修任何课程的学生学号 检索年龄在18到20岁之间的女学生学习的课程号和课程名 检索学习了C1或C3课程的学生学号 检索Hu同学不学的课程号 检索成绩为空的课程对应的教师号和教师姓名 检索至少有S2和S4学习的课程号 检索选修了S3学习的全部课程的学生学号 检索每个学生的姓名和出生年份,并将出生年份列重命名为Birth_Year 检索选修了课程的所有学生的学号,要求不显示重复结果 检索LIU老师所授课程的每门课程的人数和平均成绩 统计各门课程的最高分 统计每门课程的学生选修人数,(超过3人的课程才统计),要求显示课程号和人数,查询结构按人数升序排序,若人数相同,按课程号降序排序 查询每个学生超过他自己选修课程平均成绩的学号及课程号 把低于所有课程总平均成绩的女同学的成绩提高3% 分别用INNER JOIN 和LEFT OUTER JOIN 连接S和SC表 检索姓名中第三个字母为“N”的学生的姓名和年龄 选择C1课程的前3名的学生学号和成绩 检索平均成绩大于85的学生学号 实验要求 利用SQL语句创建数据库Lesson create database work on primary( name='work', --主数据文件的逻辑名称 filename='F:\SQL\work1\work.mdf', --主数据文件的物理名称 size=10mb, --主数据文件的初始大小 filegrowth=10mb --主数据文件的增长率 ) log on( name='work_log', --日志文件的逻辑名称 filename='F:\SQL\work1\work_log.ldf', --日志文件的物理名称 size=5mb, --日志文件的初始大小 filegrowth=10% --日志文件的增长率 ) 通过SQL语句创建以下基本表 教师关系 T(T#, TNAME,TITLE) 课程关系 C(C#,CNAME,T#) 学生关系 S(S#,SNAME,AGE,SEX) 选课关系SC(S#,C#,SCORE) 班级关系CLASS(CLASSID,CLASSNAME) 其中红色粗体为主键,带下划线的属性为外键。 通过SQL语句在CLASS表的CLASSID列上创建聚集索引IDX_CLASSID 通过SQL语句创建在S#和C#两个列上创建索引IDX_S#_C#,并指定索引按S#降序,C#升序有序。 create table T --创建表教师关系T (T# char(4) not null, TNAME char(8) not null, TITLE char(10), PRIMARY KEY(T#) --设置主键为T# ); create table C --创建表课程关系T (C# char(4), CNAME char(10) not null, T# char(4), PRIMARY KEY(C#), --设置主键为C# FOREIGN KEY(T#)REFERENCES T(T#) --设置外键为T# ); create table S --创建表学生关系S (S# char(4) not null, SNAME char(8) not null, AEG char(1), PRIMARY KEY(S#) --设置主键为S# ); create table SC --创建表选课关系SC (S# char(4), C# char(4), SCORE SMALLINT, PRIMARY KEY(S#,C#), --设置主键为S#,C# FOREIGN KEY(S#)REFERENCES S(S#), ----设置外键为S# FOREIGN KEY(C#)REFERENCES C(C#) ----设置外键为C# ); create table class --创建表班级关系class ( CLASSID char(4), CLASSNAME char(8) ); 通过SQL语句实现以下操作: 撤销索引IDX_CLASSID及IDX_S#_C# create unique index IDX_CLASSID on class(CLASSID); --在CLASS表的CLASSID列上创建聚集索引IDX_CLASSID create unique index IDX_S#_C# on SC(S# DESC,C# ASC); --创建在S#和C#两个列上创建索引IDX_S#_C#,并指定索引按S#降序,C#升序有序 DROP INDEX IDX_CLASSID on class; --撤销索引IDX_CLASSID DROP INDEX IDX_S#_C# on SC; --撤销索引IDX_S#_C# 在学生关系中增加班级号属性列CLASSID alter table S add CLASSID char(4); --在学生关系中增加班级号属性列CLASSID 撤销学生关系中的班级号属性列CLASSID alter table S drop column CLASSID; --撤销学生关系中的班级号属性列CLASSID 撤销班级关系CLASS drop table class ; --撤销班级关系CLASS 利用实验1创建的数据库Lesson,分别在各表中插入以下记录,要求至少有一个表为单元组、至少有一个表为多元组的方式插入: S表 C表 SC表 T表 insert S(S#,SNAME,AEG,sex) values('s1','WANG','20','男'), ('s2','LIU','18','女'), ('s3','HU','17','男'), ('s4','XIA','19',NULL), ('s5','SUN','20','男'), ('s6','ZHAO',NULL,'男'), ('s7','DENG',NULL,'女') insert C(C#,CNAME,T#) values ('c1','OS','t2') insert C(C#,CNAME,T#) values ('c2','java','t1') insert C(C#,CNAME,T#) values ('c3','C++','t1') insert C(C#,CNAME,T#) values ('c4','C','t3') insert SC(S#,C#,SCORE) values('s1','c1','80'), ('s1','c2','53'), ('s1','c3',NULL), ('s1','c4','68'), ('s2','c1','85'), ('s3','c1','85'), ('s3','c3','83'), ('s3','c4','75'), ('s4','c1','79'), ('s4','c2','92'), ('s5','c1',NULL), ('s5','c2','45') insert T(T#,TNAME,TITLE) values('t1','LIU','教授'), ('t2','ZHANG','副教授'), ('t3','LI','教授'), ('t4','ZHAO','讲师') 通过select into语句将SC表的表结构复制为SC_TEMP表,然后查询所有性别非空的学生的选课记录并将之插入到SC_TEMP表。 select *into SC_TEMP from SC where 1=2 insert into SC_TEMP select *from SC where S# in(select S# from S where sex is not NULL) 删除SC_TEMP表中无成绩的元组。 delete from SC_TEMP where SCORE is NULL --删除SC_TEMP表中成绩为NULL的元组 将SC_TEMP表中S3的低于S3平均成绩的成绩提高10% --将SC_TEMP表中S3的低于S3平均成绩的成绩提高10% update SC_TEMP set SCORE =1.1*SCORE where SCORE <(select AVG(SCORE) from SC_TEMP where S#='s3') and S#='s3' 删除SC_TEMP表中S3的小于该生平均成绩的成绩元组。 --删除SC_TEMP表中S3的小于该生平均成绩的成绩元组。 delete from SC_TEMP where SCORE <(select AVG(SCORE) from SC_TEMP where S#='s3') and S#='s3' 将S表中性别为空的学生的性别修改为女,并将年龄修改为25岁 update S set [sex]='女', [AEG]='25' where sex is NULL 创建视图V_M_STUDENT, 要求显示男学生的学号、姓名、课程名、教师名、成绩等列 create view V_M_STUDENT(S#,SNAME,CNAME,TNAME,SCORE) as select S.S#,SNAME,CNAME,TNAME,SCORE from S,C,T,SC where S.S#=SC.S# AND SC.C#=C.C# AND C.T#=T.T# 检索学习C3课程的所有学生姓名和年龄 --1)检索学习C3课程的所有学生姓名和年龄 select S.SNAME,S.AEG from S,SC where S.S#=SC.S# and SC.C#='c3' 检索学习由教授讲授的课程的学生学号和姓名 --2)检索学习由教授讲授的课程的学生学号和姓名 Select DISTINCT S.S#,S.SNAME from S,SC,C,T where T.TITLE='教授' AND T.T#=C.T# AND C.C#=SC.C# AND SC.S#=S.S# 检索没选修任何课程的学生学号 --3)检索没选修任何课程的学生学号 select S.S# from S where S.S# NOT IN (SELECT S# FROM SC) 检索年龄在18到20岁之间的女学生学习的课程号和课程名 --4)检索年龄在18到20岁之间的女学生学习的课程号和课程名 SELECT DISTINCT C.C#,C.CNAME FROM C,SC WHERE C.C#=SC.C# AND SC.S# IN(SELECT S# FROM S WHERE S.AEG BETWEEN 18 AND 20) 检索学习了C1或C3课程的学生学号 --5)检索学习了C1或C3课程的学生学号 SELECT DISTINCT S.S# FROM S,SC WHERE S.S# LIKE SC.S# AND (SC.C#='c1' or SC.C#='c3') 检索Hu同学不学的课程号 --6)检索Hu同学不学的课程号 SELECT C.C# FROM C WHERE C.C# NOT IN (SELECT C# FROM SC,S WHERE SC.S# LIKE S.S# AND S.SNAME='HU') 检索成绩为空的课程对应的教师号和教师姓名 --7)检索成绩为空的课程对应的教师号和教师姓名 SELECT T.T#,T.TNAME FROM T WHERE T.T# IN (SELECT C.T# FROM C,SC WHERE C.C# LIKE SC.C# AND SC.SCORE IS NULL) 检索至少有S2和S4学习的课程号 --8)检索至少有S2和S4学习的课程号 SELECT DISTINCT SC.C# FROM SC WHERE SC.C# IN ((SELECT SC.C# FROM SC WHERE SC.S# like 's2') INTERSECT (SELECT SC.C# FROM SC WHERE SC.S# like 's4')) 检索选修了S3学习的全部课程的学生学号 --9)检索选修了S3学习的全部课程的学生学号 SELECT DISTINCT SC.S# FROM SC WHERE SC.C# IN (SELECT SC.C# FROM SC WHERE SC.S# LIKE 's3') 检索每个学生的姓名和出生年份,并将出生年份列重命名为Birth_Year --10)检索每个学生的姓名和出生年份,并将出生年份列重命名为Birth_Year SELECT S.SNAME,2018-S.AEG AS Birth_Year FROM S 检索选修了课程的所有学生的学号,要求不显示重复结果 --1)检索选修了课程的所有学生的学号,要求不显示重复结果 SELECT DISTINCT SC.S# FROM SC 检索LIU老师所授课程的每门课程的人数和平均成绩 --2)检索LIU老师所授课程的每门课程的人数和平均成绩。 SELECT C.C#,COUNT(DISTINCT SC.S#),AVG(SC.SCORE) FROM C,T,SC WHERE C.T#=T.T# AND C.C#=SC.C# AND TNAME='LIU' GROUP BY C.C#; 统计各门课程的最高分 --3)统计各门课程的最高分。 SELECT SC.C#,MAX(SC.SCORE) FROM SC GROUP BY SC.C# 统计每门课程的学生选修人数,(超过3人的课程才统计),要求显示课程号和人数,查询结构按人数升序排序,若人数相同,按课程号降序排序 --4)统计每门课程的学生选修人数,(超过3人的课程才统计),要求显示课程号和人数,查询结构按人数升序排序,若人数相同,按课程号降序排序。 SELECT DISTINCT C#,COUNT(DISTINCT S#) AS 人数 FROM SC GROUP BY C# HAVING COUNT(S#)>3 ORDER BY COUNT(DISTINCT S#) asc,C# 查询每个学生超过他自己选修课程平均成绩的学号及课程号 --5)查询每个学生超过他自己选修课程平均成绩的学号及课程号。 SELECT X.S#,X.C# FROM SC AS X WHERE X.SCORE >(SELECT AVG(Y.SCORE) FROM SC AS Y WHERE X.S# =Y.S# ) 把低于所有课程总平均成绩的女同学的成绩提高3% --6)把低于所有课程总平均成绩的女同学的成绩提高3% --SELECT SC.SCORE FROM SC,S WHERE SC.S# LIKE S.S# AND S.sex='女' AND SC.SCORE>(SELECT AVG(SC.SCORE) FROM SC) UPDATE SC SET SC.SCORE=SC.SCORE*1.03 WHERE SC.SCORE LIKE (SELECT SC.SCORE FROM SC,S WHERE SC.S# LIKE S.S# AND S.sex='女' AND SC.SCORE<(SELECT AVG(SC.SCORE) FROM SC)) 分别用INNER JOIN 和LEFT OUTER JOIN 连接S和SC表 --INNER JOIN 仅对满足连接条件的CROSS中的列 LEFT OUTER JOIN 一个表满足条件的行,和另一个表的所有行 SELECT *FROM S INNER JOIN SC on S.S#=SC.S# SELECT *FROM S LEFT OUTER JOIN SC on S.S#=SC.S# 检索姓名中第三个字母为“N”的学生的姓名和年龄 --8)检索姓名中第三个字母为“N”的学生的姓名和年龄。 SELECT S.SNAME,S.AEG FROM S WHERE S.SNAME LIKE '__N%' 选择C1课程的前3名的学生学号和成绩 --9) 选择C1课程的前3名的学生学号和成绩。 SELECT TOP(3) SC.S#,SC.SCORE FROM SC WHERE SC.C# LIKE 'c1' ORDER BY SC.SCORE DESC 检索平均成绩大于85的学生学号 --10) 检索平均成绩大于85的学生学号。 SELECT DISTINCT X.S# FROM SC AS X WHERE 85<= ALL(SELECT AVG(Y.SCORE) FROM SC AS Y WHERE Y.S#=X.S# GROUP BY Y.S#)