首页 文章 精选 留言 我的

精选列表

搜索[变形机甲],共836篇文章
优秀的个人博客,低调大师

从 wepy 到 uniapp 变形记

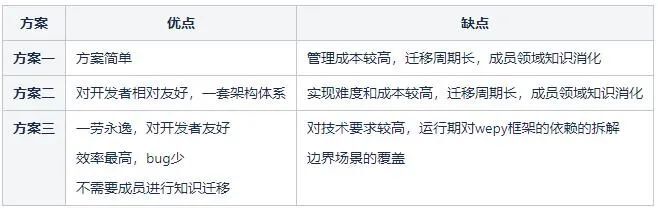
作者:vivo 互联网前端团队-Wan Anwen、Hu Feng、Feng Wei、Xie Tao 进入互联网“下半场”,靠“人海战术”的研发模式已经不再具备竞争力,如何通过技术升级提升研发效能?前端通过Babel等编译技术发展实现了工程化体系升级,如何进一步通过编译技术赋能前端开发?或许我们 wepy 到uniapp 编译的转换实践,能给你带来启发。 一、 背景 随着小程序的出现,借助微信的生态体系和海量用户,使服务以更加便捷方式的触达用户需求。基于此背景,团队很早布局智能导购小程序(为 vivo 各个线下门店导购提供服务的用户运营工具)的开发。 早期的小程序开发工程体系还不够健全,和现在的前端的工程体系相差较大,表现在对模块化,组件化以及高级JavaScript 语法特性的支撑上。所以团队在做技术选型时,希望克服原生小程序工程体系上的不足,经过对比最后选择了腾讯出品的 wepy 作为整体的开发框架。 在项目的从0到1阶段,wepy 确实帮助我们实现了快速的业务迭代,满足线下门店导购的需求。但随着时间的推移,在技术上,社区逐步沉淀出以 uniapp 为代表的 Vue 栈体系和以 Taro 为代表的 React 栈跨端的体系,wepy 目前的社区活跃度比较低。另外随着业务进入稳定阶段,除少量的 wepy 小程序,H5 项目和新的小程序都是基于 Vue 和 uniapp 来构建,团队也是希望统一技术栈,实现更好的跨端开发能力,降低开发和维护成本,提升研发效率。 二、思考 随着团队决定将智能导购小程序从 wepy 迁移到 uniapp 的架构体系,我们就需要思考,如何进行项目的平稳的迁移,同时兼顾效率和质量?通过对当前的项目状态和技术背景进行分析,团队梳理出2个原则3种迁移思路。 2.1 渐进式迁移 核心出发点,保证项目的平稳过渡,给团队更多的时间,在迭代中逐步的进行架构迁移。希望以此来降低迁移中的风险和不可控的点。基于此,我们思考两个方案: 方案一 融合两套架构体系 在目前的项目中引入和 uniapp 的项目体系,一个项目融合了 wepy 和 uniapp 的代码工程化管理,逐步的将 wepy 的代码改成 uniapp 的代码,待迁移完成删除 wepy 的目录。这种方案实现起来不是很复杂,但是缺点是管理起来比较复杂,两套工程化管理机制,底层的编译机制,各种入口的配置文件等,管理起来比较麻烦。另外团队每个人都需要消化 wepy 到 uniapp 的领域知识迁移,不仅仅是项目的迁移也是知识体系的迁移。 方案二 设计 wepy-webpack-loader 以 uniapp 为工程体系基础,核心思路是将现有 wepy 代码融入到 uniapp 的体系中来。我们都知道 uniapp 的底层依赖于 Vue 的 cli 的技术体系,最底层通过 webpack 实现对 Vue 单组件文件和其他资源文件的 bundle。 基于此,我们可以开发一个 wepy 的 webpack 的 loader,wepy-loader 类似于 vue-loader 的能力,通过该 loader 对 wepy 文件进行编译打包,然后最终输出小程序代码。想法很简单,但我们想要实现 wepy-loader工作量还是比较大的,需要对 wepy 的底层编译器进一步进行分析拆解,分析 wepy 的依赖关系,区分是组件编译还是 page 编译等,且 wepy 底层编译器的代码比较复杂,实现成本较高。 2.2 整体性迁移 构建一个编译器实现 wepy 到 uniapp 的自动代码转换。 通过对 wepy 和 uniapp 整体技术方案的梳理,加深了对两套架构差异性的认知和理解,尤其 wepy 上层语法和 Vue 的组件开发的代码上的差异性。基于团队对编译的认知,我们认为借助 babel 等成熟编译技术是有能力实现这个转换的过程,另外,通过编译技术会极大的提升整体的迁移的效率。 2.3 方案对比 通过团队对方案的深入讨论和技术预研,最终大家达成一致使用编译转换的方式(方案三)来进行本次的技术升级。最终,通过实现 wepy 到 uniapp 的编译转换器,使原本 25人/天的工作量,6s 完成。 如下动图所示: 三、架构设计 3.1 wepy 和 uniapp 单文件组件转换 通过对 wepy 和 uniapp 的学习,充分了解两者之间的差异性和相识点。wepy 的文件设计和 Vue 的单文件非常的相似,包含 template 和 script 和 style 的三部分组成。 如下图所示, 所以我们将文件拆解为 script,template,style 样式三个部分,通过 transpiler 分别转换。同时这个过程主要是对 script 和 template 进行转换,样式和 Vue 可以保持一致性最终借助 Vue 进行转换即可。 同时 wepy 还有自己的 runtime运行时的依赖,为了确保项目对 wepy 做到最小化的依赖,方便后续完全和 wepy 的依赖进行完全解耦,我们抽取了一个 wepy-adapter 模块,将原先对于 wepy 的依赖转换为对wepy-adapter 的依赖。 整体转换设计,如下图所示: 3.2 编译器流水线构建 如上图所示,整个编译过程就是一条流水线的架构设计,在每个阶段完成不同的任务。主要流程如下: 3.2.1 项目资源分析 不同的项目依赖资源不同的处理流程,扫描项目中的源码和资源文件进行分类,等待后续的不同的流水线处理。 静态资源文件(图片,样式文件等)不需要经过当中流水线的处理,直达目标 uniapp 项目的对应的目录。 3.2.2 AST抽象语法树转换 针对 wepy 的源文件(app,page,component等)对 script,template 等部分,通过 parse 转换成相对应的AST抽象语法树,后续的代码转换都是基于对抽象语法树的结构改进。 3.2.3 代码转换实现 - Transform code 根据 wepy 和 uniapp 的 Vue 的代码实现上的差异,通过对ast进行转换实现代码的转换。 3.2.4 代码生成 - code emitter 根据步骤三转换之后最终的ast,进行对应的代码生成。 四、项目搭建 整体项目结构如下图所示: 4.1 单仓库的管理模式 使用 lerna 进行单仓库的模块化管理,方便进行模块的拆分和本地模块之间依赖引用。另外单仓库的好处在于,和项目相关的信息都可以在一个仓库中沉淀下来,如文档,demo,issue 等。不过随着 lerna 社区不再进行维护,后续会将 lerna 迁移到 pnpm 的 workspace 的方案进行管理。 4.2 核心模块 wepy-adapter - wepy运行期以来的最小化的polyfill wepy-chameleon-cli - 命令行工具模块 wepy-chameleon-transpiler - 核心的编译器模块,按照one feature,one module方式组织 4.3 自动化任务构建等 Makefile - *nix世界的标准方式 4.4 scripts 自动化管理 shipit.ts 模块的自动发布等自动化能力 4.5 单元测试 采用Jest作为基础的测试框架,使用typescript来作为测试用例的编写。 使用@swc/jest作为ts的转换器,提升ts的编译速度。 现在社区的vitest直接提供了对ts的集成,借助vite带来更快的速度,计划迁移中。 五、核心设计实现 5.1 wepy template 模版转换 5.1.1 差异性梳理 下面我们可以先来大致看一下wepy的模板语法和uniapp的模板语法的区别。 图:wepy模板和uni-app模板 从上图可以看出,wepy模板使用了原生微信小程序的wxml语法,并且在采用类似Vue的组件引入机制的同时,保留了wxml< import/ >、< include/ >标签的能力。同时为了和wxml中循环渲染dom节点的语法做区别,引入了新的< Repeat/ >标签来渲染引入的子组件,而uni-app则是完全使用Vue风格的语法来进行开发。 所以总结wepy和uni-app模板语法的主要区别有两点: wepy使用了一些特定的标签用来导入或者复用其他wxml文件例如< import >和< include >。 wxml使用了xml命名空间的方式来定义模板指令,并且对指令值的处理更像是使用模板引擎对特定格式的变量进行替换。 下表列举一些两者模板指令的对应转换关系。 此外,还有一些指令的细节需要处理,例如在wepy中wx:key="id"指令会自动解析为wx:key="{{item.id}}",这里便不再赘述。 5.1.2 核心转换设计 编译器对template转换主要就需要完成以下三个步骤: 处理wepy引入的特殊的标签例如。 将wxml中使用的指令、特殊标签等转换为Vue模板的语法。 收集引入的组件信息传递给下游的wepy-page-transform模块。 wepy特殊标签转换 首先我们会处理wepy模板中的特殊标签< import/ >、< include/ >,主要是将wxml的文件引入模式转换成Vue模板的组件引入模式,同时还需要收集引入的wxml的文件地址和展示的模板名称。由于< include/ >可以引入wxml文件中除了< template/ >和< wxs/ >的所有代码,为了保证转换后组件的复用性,我们将引入的xx.wxml文件拆成了xx.vue和xx-incl.vue两个文件,使用< import/ >标签的会导入xx.vue,而使用< include/ >标签的会导入xx-incl.vue,转换import的核心代码实现如下: transformImport() { // 获取所有import标签 const imports = this.$('import') for (let i = 0; i < imports.length; i++) { const node = imports.eq(i) if (!node.is('import')) return const importPath = node.attr('src') // 收集引入的路径信息 this.importPath.push(importPath) // 将文件名统一转换成短横线风格 let compName = TransformTemplate.toLine( path.basename(importPath, path.extname(importPath)) ) let template = node.next('template') while (template.is('template')) { const next = template.next('template') if (template.attr('is')) { const children = template.children() // 生成新的组件标签例如 // <import src="components/list.wxml" /> // <template is="subList" /> => <list is="subList" /> const comp = this.$(`<${compName} />`) .attr(template.attr()) .append(children) comp.attr(TransformTemplate.toLine(this.compName), comp.attr('is')) comp.removeAttr('is') // 将当前标签替换为新生成的组件标签 template.replaceWith(comp) } template = next } node.remove() } } 具体的WXML文件拆分方案请看WXML转换部分。 wepy 属性转换 上文中已经介绍了,wepy模板中的属性使用了命名空间+模板字符串风格的动态属性,我们需要将他们转换成Vue风格的属性。转换需要操作模板中的节点及其属性,这里我们使用了cheerio, 快速、灵活、类jQuery核心实现,可以利用jQuery的语法非常方便的对模板字符串进行处理。 上述流程中一个分支中的转换函数会处理相应的wepy属性,以保证后续可以很方便的对转换模块进行完善和修改。由于属性名称转换只是简单的做一下相应的映射,我们重点分析一下动态属性值的转换过程。 WXML中使用双中括号来标记动态属性中的变量及WXS表达式,并且如果变量是WXS对象的话还可以省略对象的大括号例如 < view wx:for="{{list}}" > {{item}} < /view >、< template is="objectCombine" data="{{for: a, bar: b}}" >< /template > 所以当我们取到双中括号中的值时会有以下两种情况: 得到WXS的表达式; 得到一个没有中括号包裹的WXS对象。此时我们可以先对表达式尝试转换,如果有报错的话,给表达式包裹一层中括号再进行转换。考虑到WXS的语法类似于Javascript的子集,我们依然使用babel对其进行解析并处理。 核心代码实现如下: /** * * @param value 需要转换的属性值 */ private transformValue(value: string): string { const exp = value.match(TransformTemplate.dbbraceRe)[1] try { let seq = false traverse(parseSync(`(${exp})`), { enter(path) { // 由于WXS支持对象键值相等的缩写{{a,b,c}},故此处需要额外处理 if (path.isSequenceExpression()) { seq = true } }, }) if (!seq) { return exp } return `{${exp}}` } catch (e) { return `{${exp}}` } } 到这里,我们已经能够处理wepy模板中绝大部分的动态属性值的转换。但是,上文也提及到了,wepy采用的是类似模板引擎的方式来处理动态属性的,即WXML支持这种动态属性< view id="item-{{index}}" >,如果这个 < view / >标签使用了wx:for指令的话,id属性会被编译成item-0、item-1... 这个问题我们也想了多种方案去解决,例如字符串拼接、正则处理等,但是都不能很好的覆盖全部场景,总会有特殊场景的出现导致转换失败。 最终,我们还是想到了模板引擎,Javascript中也有类似于模板引擎的元素,那就是模板字符串。使用模板字符串,我们仅仅需要把WXML中用来标记变量的双括号{{}}转换成Javascript中的${}即可。 5.2 Wepy App 转换 5.2.1 差异性梳理 wepy 的 App 小程序实例中主要包含小程序生命周期函数、config 配置对象、globalData 全局数据对象,以及其他自定义方法与属性。 核心代码实现如下: import wepy from 'wepy' // 在 page 中,通过 this.$parent 来访问 app 实例 export default class MyAPP extends wepy.app { customData = {} customFunction() {} onLaunch() {} onShow() {} // 对应 app.json 文件 // build 编译时会根据 config 属性自动生成 app.json 文件 config = {} globalData = {} } uniapp的 App.vue 可以定义小程序生命周期方法,globalData全局数据对象,以及一些自定义方法,核心代码实现如下: <script> export default { globalData: { text: 'text' } onLaunch: function() { console.log('App Launch,app启动') }, onShow: function() { console.log('App Show,app展现在前台') }, onHide: function() { console.log('App Hide,app不再展现在前台') }, methods: { // ..... } } <script> 5.2.2 核心转换设计 如图, 核心转换设计流程: 对 app.py 进行 parse,拆分出script和style部分,对script部分使用babel进行parse生成AST。 通过对 AST 分析出,小程序的生命周期方法,globalData全局数据,自定义方法等。 对于AST进行uniapp转换,生命周期方法和全局数据转成对象的方法和属性,对自定义方法转换到method内。 其中对 globalData 的访问,要进行替换通过 getApp()进行访问。 抽取 ast 中的 config 字段,输出到 app.json 配置文件。 抽取 wepy.config.js 中的 config 字段,传入 wepy 的 app 实例。 核心代码实现: let APP_EVENT = ['onLaunch', 'onShow', 'onHide', 'onError', 'onPageNotFound'] //.... // 实现wepy app到uniapp App.vue的转换 t.program([ ...body.filter((node: t.Node) => !t.isExportDeclaration(node)), // 插入appClass ...appClass, ...body .filter((node: t.Node) => t.isExportDeclaration(node)) .map((node: object) => { // 对导出的app进行处理 if (t.isExportDeclaration(node)) { // 提前config属性 const { appEvents, methods, props } = this.clzProperty // 重新导出vue style的对象 return t.exportDefaultDeclaration( t.objectExpression([ // mixins ...mixins, // props ...Object.keys(props) .filter((elem) => elem !== 'config') .map((elem) => this.transformClassPropertyToObjectProperty(props[elem]) ), // app events ...appEvents.map((elem) => this.transformClassMethodToObjectMethod(elem) ), // methods t.objectProperty( t.identifier('methods'), t.objectExpression([ ...methods.map((elem) => this.transformClassMethodToObjectMethod(elem) ), ]) ), ]) ) } return node }), ]) // ..... 5.2.3 痛点难点 在运行期,app.wpy 会继承 wepy.App 类,这样就会在运行期和 wepy.App 产生依赖关系,怎么最小化弱化这种关系。抽取wepy的最小化以来的polyfill,随着业务中代码剔除对wepy的api调用,最终去除对polyfill的依赖。 5.3 wepy component 转换 对于wepy component 的转换主要可以细化到对 component 中 template、script、style 三部分代码块的转换。 其中, style 部分由于已经兼容 Vue 的规范,所以我们无需做额外处理。而 template 模块主要是需要对 wepy template 中特殊的标签、属性、事件等内容进行处理,转化为适配 uni的template,上文做了详细的说明。 我们只需要专注于处理 script 模块的代码转换即可。从架构设计的思路来看,component script 的转换主要是是做以下两件事: 编译期可确定代码块的转换。 运行期动态注入代码的兼容。 wepy-component-transform 就是基于以上这两个标准设计出来的实现转换逻辑的模块。 5.3.1 差异性梳理 首先先解释一下什么是“编译期可确定代码块”,我们来看一个 wepy 和 Vue 语法对比示例: 从直观上来说,这个 script 的模板的语法大致和 Vue 语法类似,这意味着我们解析出来的 AST 结构和 Vue 文件对应的 AST 结构上类似,基于这一点来看编译转换的工作量大致有底了。 从细节来看, wpy 文件script 模块中的 API 语法和 Vue 中有声明及使用上的不同,其中包含: wepy 自身的包依赖注入及运行时依赖 props/data/methods 声明方式不同 生命周期钩子不同 事件发布/订阅的注册和监听机制不同。 ....等等 为了确定这个第5点等等还存在哪些使用场景,我们需要对 wepy 自身的逻辑和玩法有一个详尽的了解和熟悉,通过在团队内组织的 wepy 源码走读,再结合wepy 实际生产项目中的代码相互印鉴,我们最终才将 wepy 语法逻辑与 uni-app Vue 语法逻辑的异同梳理清楚。 5.3.2 核心转换设计 我们简单梳理一下 wepy-component-transform 这个模块的结构,可以分为以下三个部分: 预处理 wepy component script 代码 AST 节点部分 构建 Vue AST 通过 generate 吐出代码 1.预处理 AST 基于前文转换设计这一节我们知道, wepy 变色龙的转换器中对代码的 AST 解析主要依赖 babel AST 三板斧(traverse、types、generate)来实现,通过分析各个差异点代码语句转换后的 AST 节点,就可以通过 traverse 中的钩子来进行节点的前置处理,这里安利一下 https://astexplorer.net/,我们可以通过它快速分析代码块 AST 节点、模拟场景及验证转换逻辑: 预处理 AST,目的是提前将 wepy 源码中的代码块解析为 AST Node 节点后,按语法进行归集到预置的 clzProperty 对象中,其中: props 对象用来盛放 ClassProperty 语法的 ast 节点 notCompatibleMethods 数组用来盛放非生命周期函数白名单内的函数 AST 节点。 appEvents 数组用来盛放生命周期函数白名单内的函数 AST 节点。 listenEvents 数组用来盛放 发布/订阅事件注册的函数 AST 节点。 核心代码实现如下所示: import { NodePath, traverse, types } from '@babel/core' this.clzProperty = { props: {}, notCompatibleMethods: [], appEvents: [], listenEvents: [] } traverse() { ClassProperty: (path) => { const name = path.node.key.name this.clzPropertyprops[name] = path.node }, ClassMethod: (path) => { const methodName = path.node.key.name // 判断是否存在于生命周期白名单内 const isCompEvent = TOTAL_EVENT.includes(methodName) if (isCompEvent) { this.clzProperty.appEvents.push(path.node) } else { this.clzProperty.notCompatibleMethods.push(path.node) } }, ObjectMethod: (path: any) => { if (path.parentPath?.container?.key?.name === 'events') { this.clzProperty.listenEvents.push(path.node) } } } 这里要注意一点,由于对 wepy 来说,实际上 page 也属于 component 的一种实现,所以两者的 event 会有一定的重合,而且由于 wepy 中生命周期和 Vue 生命周期的差异性,我们需要对如 attached、detached、ready 等钩子做一些 hack。 2.构建 Vue AST buildCompVueAst 函数即为 构建 Vue AST 部分。从直观上来看,这个函数只做了一件事,即用 types.program 重新生成一个 AST 节点结构,然后将原有的 wepy 语法转换为 vue 语法。但是实际上我们还需要处理许多额外的兼容逻辑,简单罗列一下: created 重叠问题 methods 中函数的收集 events 中函数的调用处理 created 重叠问题主要是为了解决 created/attached/onLoad/onReady 这4个生命周期函数都会转换为 created 导致的多次重复声明问题。我们需要针对若存在 created 重叠问题时,将其余钩子中的代码块取出并 push 到第一个 created 钩子函数内部。代码示例如下: const body = this.ast.program.body const { appEvents, notCompatibleMethods, props, listenEvents } = this.clzProperty // 处理多个 created 生命周期重叠问题 const createIndexs: number[] = [] const sameList = ['created', 'attached', 'onLoad', 'onReady'] appEvents.forEach((node, index) => { const name: string = node.key.name if (sameList.includes(name)) { createIndexs.push(index) } }) if (createIndexs.length > 1) { // 取出源节点内代码块 const originIndex = createIndexs[0] const originNode = appEvents[originIndex] const originBodyNode = originNode.body.body // 留下的剩余节点需要取出其代码块并塞入源节点中 // 塞入完成后删除剩余节点 createIndexs.splice(0, 1) createIndexs.forEach((index) => { const targetNode = appEvents[index] const targetBodyNode = targetNode.body.body // 将源节点内代码块塞入目标节点中 originBodyNode.push(...targetBodyNode) // 删除源节点 appEvents.splice(index, 1) }) } 由于 wepy 中非 methods 中函数的特殊性,所以我们需要在转换时将独立声明的函数、events 中的函数都抽离出来再 push 到 methods 中,伪代码逻辑如下所示: buildCompVueAst() { const body = this.ast.program.body return t.program([ ...body.map((node) => { return t.exportDefaultDeclaration( t.objectExpression([ ...Object.keys(props) .map((elem) => { if (elem === 'methods') { const node = props[elem] // 1.events 内函数插入 methods 中 // 2.与生命周期平级的函数抽离出来插入 methods 中 node.value.properties.push( ...listenEvents, ...notCompatibleMethods ) } return props[elem] }) ]) ) }) ]) } events 中函数的调用处理主要是为了抹平 wepy 中发布订阅事件调用和 Vue 调用的差异性。在 wepy 中,事件的注册通过在 events 中声明函数,事件的调用通过 this.$emit 来触发。而 vue 中我们采用的是 EventBus 方案来兼容 wepy 中的写法,即手动为 events 中的函数创建 this.$on 形式的调用,并将其代码块按顺序塞入 created 中来初始化。 首先我们要判断文件中是否已有 created 函数,若存在,则获取其对应的代码块并调用 forEachListenEvents 函数将 events 中的监听都 push 进去。 若不存在,则初始化一个空的 created 容器,并调用 forEachListenEvents 函数。核心代码实现如下所示: buildCompVueAst() { const obp = [] as types.ObjectMethod[] // 获取class属性和方法 const body = node.declaration.body.body const targetNodeArray = body.filter(child => child.key.name === 'created' ) if (targetNodeArray.length > 0) { let createdNode = targetNodeArray[0] this.forEachListenEvents(createdNode) } else { const targetNode = t.objectMethod( 'method', t.identifier('created'), [], t.blockStatement([]) ) this.forEachListenEvents(targetNode) if (targetNode.body && targetNode.body.body.length > 0) { obp.push(targetNode) } } return obp } forEachListenEvents 函数主要是通过 wepy 中 声明的 events 事件名和入参,借助 babel types 手动创建对应的 AST Node,最终生成对应的形如 this.eventBus.on("canceldeposit", this.canceldeposit) 形式的监听,其中,this.canceldeposit 为原有 events 中的事件被移入 methods 后的函数,相关伪代码实现如下所示: // 根据 events 中的 methods 构建事件监听的调用 // 并塞入 created 中 forEachListenEvents(targetNode: types.ObjectMethod) { this.clzProperty.listenEvents.forEach((item) => { const methodsNode: any = item // 形如 this.$on('test', ()=>{}) if (methodsNode?.key?.name) { // 创建 this 表达式 const thisEx = t.thisExpression() // 创建 $on 表达式 const ide = t.identifier('$eventBus.$on') // 合并 this.$on 表达式 const om = t.memberExpression(thisEx, ide) // 创建事件名称参数节点 const eventNameIde = t.stringLiteral( methodsNode.key.name.toString().trim() ) // 获取方法体内代码内容节点 const meNode = t.memberExpression( t.thisExpression(), t.identifier(methodsNode.key.name.toString().trim()) ) const ceNode = t.callExpression(om, [eventNameIde, meNode]) const esNode = t.expressionStatement(ceNode) // 将合成后的代码插入到 created 中 targetNode.body.body.push(esNode) } }) } 3.emitter vue 代码生成 构建完 Vue AST 之后,我们可以调用 generate 函数生成源码字符串: transform() { const ast = this.buildCompVueAst() const compVue = this.genCode(ast) return { compVue, wxs: this.buildWxs() } } 5.4 Wepy page 转换 5.4.1 差异性梳理 上面的章节已经给大家分析了template、component的代码转换逻辑,这一节主要带大家一起看下如何转换page文件。page转换的逻辑即如何实现wepy 的 page.wpy 模块转换为 uniapp 的 page.vue 模块。 首先我们来看下wepy 的 page 小程序实例: <script> import wepy from 'wepy'; import Counter from '../components/counter'; export default class Page extends wepy.page { config = {}; components = {counter1: Counter}; data = {}; methods = {}; events = {}; onLoad() {}; // Other properties } </script> <template lang="wxml"> <view> </view> <counter1></counter1> </template> <style lang="less"> /** less **/ </style> 可以看到,wepy的page类也是通过继承来实现的,页面文件 page.wpy 中所声明的页面实例继承自 wepy.page 类,该类的主要属性介绍如下: 5.4.2 核心转换设计 基于page的api特性以及实现方案,具体的转换设计思路如下: 5.4.3 痛点难点 1.非阻塞异步与异步 在进行批量pages转换时,需要同时对pages.json进行读取、修改、再修改的操作,这就涉及到使用阻塞 IO/ 异步 IO来处理文件的读写,当使用异步IO时,会发起多个进程同时处理pages.json, 每个读取完成后单独处理对应的内容,数据不是串行修改,最终导致最终修改的内容不符合预期,因此在遇到并行处配置文件时,需要使用阻塞式io来读取文件,保障最终数据的唯一性,具体代码如下: // merge pageConfig to app config const rawPagesJson = fs.readFileSync(path.join(dest, 'src/pages.json')) // 数据操作 fs.writeFileSync( path.join(dest, 'src', 'pages.json'), prettJson(pagesJson) ) 2.复杂的事件机制 在转换过程中,我们也碰到一个比较大的痛点:page.wepy 继承至 wepy.page,wepy.page 代码较复杂,需要将明确部分单独抽离出来。例如说 events 中组件间数据传递:$broadcast、$emit、$invoke,$broadcast、$invoke需要熟悉其使用场景,转换为 Vue 中公共方法。 5.5 Wepy WXML 转换 template转换章节中提到了wepy模板中可以直接引入wxml文件,但是uni-app使用的Vue模板不支持直接引入wxml,故我们需要将wxml文件处理为uniapp可以引入的Vue文件。我们先来看一下wepy中引入的wxml文件的大致结构。 <template name="foo"> <view class="foo-content"> <text class="text1">{{item.text1}}</text> <image class="pic" src="{{pic.url}}" mode="aspectFill"></image> </view> </template> <template name="bar"> <view class="bar-content"> <image class="bar" src="{{pic.url}}" mode="aspectFill"></image> <text class="text2">{{item.text2}}</text> </view> </template> <view class="footer"> this is footer </view> <!-- index.wepy --> <!-- 引入文件 --> <import src="somePath/fooBar.wxml" /> <!-- 确定展示的template及传入属性 --> <script is="foo" data="{{item, pic}}" /> <!-- or, 此时仅会展示<template/>以外的内容即footer --> <include src="somePath/fooBar.wxml"> 5.5.1 差异性梳理 从上面的代码可以看出,一个WXML文件中支持多个不同name属性的< template/ >标签,并且支持通过在引入设置data来传入属性。从上面的示例模板中我们可以分析出,除了需要将wepy使用的WXML语法转换成vue模板语法外(这里的转换交给了template模块来处理),我们还需要处理以下的问题。 确定引入组件时的传参格式 确定组件中传入对象的属性有哪些 处理< import/ >和< include/ >引入的文件时的情况 5.5.2 核心转换设计 1.确定引入组件时的传入属性方式 首先需要将wepy组件引入形式改成Vue的组件引入方式。以上面的代码为例,即将< import/ > 、< script/ >对的引入形式改写成< component-name / > 引入方式。我们会在转换开始前对代码进行扫描,收集模板中的引入文件信息,传递给wepy-page-transform模块处理,在转换后的Vue组件的< script/ >中进行引入。并且将< script is="foo" data="{{item, pic}}" / > 转换为< FooBar is="foo" :data=(待定) / > 。这里就需要确定属性传递的方式。 从上面的代码中可以看到,在WXML文件的< template/ >会自动使用传入的data属性作为隐式的命名空间,从而不需要使用data.item来获取item属性。这里很自然的就会想到原来的< script is="foo" data="{{item, pic}}" / >可以转换成< FooBar compName="foo" :key1="val1" :key2="val2" ... / >。 其中,key1,val1,key2,val2等为原data属性对象中的键值对,compName用来指定展示的部分。这样处理的好处是,引入的WXML文件中使用相应的传入的属性就不需要做额外的修改,并且比较符合我们一般引入Vue组件时传入属性的方式。 虽然这种方案可以较少的改动WXML文件中的模板,但是由于传入的对象可能会在运行期间进行修改,我们在编译期间比较难以确定传入的data对象中的键值对。考虑到实现的时间成本及难易程度,我们没有选择这种方案。 目前我们所采用的方案是不去改变原有的属性传入方式,即将组件引入标签转换为< FooBar compName="foo" :data="{item, pic}" / >。从而省去分析传入对象在运行时的变动。这里就引出了第二个问题,如何确定组件中传入的参数有哪些。 2.确定组件中的传入的对象属性 由于Vue的模板中不会自动使用传入的对象作为命名空间,我们需要手动的找到当前待转换的模板中所使用到的所有的变量。相应的代码如下: searchVars() { const self = this const domList = this.$('template *') // 获取wxml文件中template节点下的所有text节点 const text = domList.text() const dbbraceRe = new RegExp(TransformTemplate.dbbraceRe, 'g') let ivar // 拿到所有被{{}}包裹的动态表达式 while ((ivar = dbbraceRe.exec(text))) { addVar(ivar[1]) } // 遍历所有节点的属性,获取所有的动态属性 for (let i = 0; i < domList.length; i++) { const dom = domList.eq(i) const attrs = Object.keys(dom.attr()) for (let attr of attrs) { const value = dom.attr(attr) if (!TransformTemplate.dbbraceRe.test(value)) continue const exp = value.match(TransformTemplate.dbbraceRe)[1] try { addVar(exp) } catch (e) { addVar(`{${exp}}`) } } } function addVar(exp: string) { traverse(parseSync(`(${exp})`), { // 利用babel分析表达式中的所有变量 Identifier(path) { if ( path.parentPath.isMemberExpression() && !path.parentPath.node.computed && path.parentPath.node.property === path.node ) return self.vars.add(path.node.name) // 收集变量 }, }) } } 收集到所有的变量信息后,模板中的所有变量前面需要加上传入的对象名称,例如item.hp_title需要转换成data.item.hp_title。考虑到模板的简洁性和后续的易维护性,我们把转换统一放到< script/ >的computed字段中统一处理即可: <template> <!--...--> </template> <script> export default { props: ['data', 'compName'], computed: { item() { return data.item }, pic() { return data.pic } } } </script> 3.处理 < import/ >和< include/ >两种引入方式 wepy模板有两种引入组件的方式,一种是使用< import/ >< script/ >标签对进行引入,还有一种是使用< include/ > 进行引入,< include/ > 会引入WXML文件中除了< template/ >和< wxs/ >的其他标签。这里的处理方式就比较简单,我们把< include/ > 会引入的部分单独抽取出来,生成TItem-incl.vue文件,这样即保证了生成代码的可复用性,也降低< import/ >标签引入的部分生成的TItem.vue文件中的逻辑复杂度。生成的两个文件的结构如下: <!--TItem.vue--> <template> <view> <template v-if="compName == 'foo'"> <view class="foo"> <!--...--> </view> </template> <template v-if="compName == 'bar'"> <view class="bar"> <!--...--> </view> </template> </view> </template> <script> export default { props: ['compName', 'data'], computed: { item() { return this.data.item }, pic() { return this.data.pic } } } </script> <!--TItem-incl.vue--> <template> <view> <view class="footer"> this is footer </view> </view> </template> 六、阶段性成果 截止到目前,司内的企微导购小程序项目通过接入变色龙编译器已经顺利的从 wepy 迁移到了 uniApp 架构,原本预计需要 25人/天 的迁移工作量在使用了编译器转换后缩短到了 10s。这不仅仅只是提高了迁移的效率,也降低了迁移中的知识迁移成本,给后续业务上的快速迭代奠定的扎实的基础。 迁移后的企微导购小程序项目经测试阶段验证业务功能 0 bug,目前已经顺利上线。后续我们也会持续收集其他类似的业务诉求,帮助业务兄弟们低成本完成迁移。 七、总结 研发能效的提升是个永恒的话题,此次我们从编译这个角度出发,和大家分享了从wepy到uniapp的架构升级探索的过程,通过构建代码转换的编译器来提升整体的架构升级效率,通过编译器消化底层的领域和知识的差异性,取得了不错的效果。 当然,我们目前也有还不够完善的地方,如:编译器脚手架缺乏对于部分特性颗粒度更细的控制、代码编译转换过程中日志的输出更友好等等。后续我们也有计划将 wepy 变色龙编译器在社区开源共建,届时欢迎大家一起参与进来。 现阶段编译在前端的使用场景越来越多,或许我们真的进入了Compiler is our framework的时代。

优秀的个人博客,低调大师

每日一博 | 从 wepy 到 uniapp 变形记

作者:vivo 互联网前端团队-Wan Anwen、Hu Feng、Feng Wei、Xie Tao 进入互联网“下半场”,靠“人海战术”的研发模式已经不再具备竞争力,如何通过技术升级提升研发效能?前端通过Babel等编译技术发展实现了工程化体系升级,如何进一步通过编译技术赋能前端开发?或许我们 wepy 到uniapp 编译的转换实践,能给你带来启发。 一、 背景 随着小程序的出现,借助微信的生态体系和海量用户,使服务以更加便捷方式的触达用户需求。基于此背景,团队很早布局智能导购小程序(为 vivo 各个线下门店导购提供服务的用户运营工具)的开发。 早期的小程序开发工程体系还不够健全,和现在的前端的工程体系相差较大,表现在对模块化,组件化以及高级JavaScript 语法特性的支撑上。所以团队在做技术选型时,希望克服原生小程序工程体系上的不足,经过对比最后选择了腾讯出品的 wepy 作为整体的开发框架。 在项目的从0到1阶段,wepy 确实帮助我们实现了快速的业务迭代,满足线下门店导购的需求。但随着时间的推移,在技术上,社区逐步沉淀出以 uniapp 为代表的 Vue 栈体系和以 Taro 为代表的 React 栈跨端的体系,wepy 目前的社区活跃度比较低。另外随着业务进入稳定阶段,除少量的 wepy 小程序,H5 项目和新的小程序都是基于 Vue 和 uniapp 来构建,团队也是希望统一技术栈,实现更好的跨端开发能力,降低开发和维护成本,提升研发效率。 二、思考 随着团队决定将智能导购小程序从 wepy 迁移到 uniapp 的架构体系,我们就需要思考,如何进行项目的平稳的迁移,同时兼顾效率和质量?通过对当前的项目状态和技术背景进行分析,团队梳理出2个原则3种迁移思路。 2.1 渐进式迁移 核心出发点,保证项目的平稳过渡,给团队更多的时间,在迭代中逐步的进行架构迁移。希望以此来降低迁移中的风险和不可控的点。基于此,我们思考两个方案: 方案一 融合两套架构体系 在目前的项目中引入和 uniapp 的项目体系,一个项目融合了 wepy 和 uniapp 的代码工程化管理,逐步的将 wepy 的代码改成 uniapp 的代码,待迁移完成删除 wepy 的目录。这种方案实现起来不是很复杂,但是缺点是管理起来比较复杂,两套工程化管理机制,底层的编译机制,各种入口的配置文件等,管理起来比较麻烦。另外团队每个人都需要消化 wepy 到 uniapp 的领域知识迁移,不仅仅是项目的迁移也是知识体系的迁移。 方案二 设计 wepy-webpack-loader 以 uniapp 为工程体系基础,核心思路是将现有 wepy 代码融入到 uniapp 的体系中来。我们都知道 uniapp 的底层依赖于 Vue 的 cli 的技术体系,最底层通过 webpack 实现对 Vue 单组件文件和其他资源文件的 bundle。 基于此,我们可以开发一个 wepy 的 webpack 的 loader,wepy-loader 类似于 vue-loader 的能力,通过该 loader 对 wepy 文件进行编译打包,然后最终输出小程序代码。想法很简单,但我们想要实现 wepy-loader工作量还是比较大的,需要对 wepy 的底层编译器进一步进行分析拆解,分析 wepy 的依赖关系,区分是组件编译还是 page 编译等,且 wepy 底层编译器的代码比较复杂,实现成本较高。 2.2 整体性迁移 构建一个编译器实现 wepy 到 uniapp 的自动代码转换。 通过对 wepy 和 uniapp 整体技术方案的梳理,加深了对两套架构差异性的认知和理解,尤其 wepy 上层语法和 Vue 的组件开发的代码上的差异性。基于团队对编译的认知,我们认为借助 babel 等成熟编译技术是有能力实现这个转换的过程,另外,通过编译技术会极大的提升整体的迁移的效率。 2.3 方案对比 通过团队对方案的深入讨论和技术预研,最终大家达成一致使用编译转换的方式(方案三)来进行本次的技术升级。最终,通过实现 wepy 到 uniapp 的编译转换器,使原本 25人/天的工作量,6s 完成。 如下动图所示: 三、架构设计 3.1 wepy 和 uniapp 单文件组件转换 通过对 wepy 和 uniapp 的学习,充分了解两者之间的差异性和相识点。wepy 的文件设计和 Vue 的单文件非常的相似,包含 template 和 script 和 style 的三部分组成。 如下图所示, 所以我们将文件拆解为 script,template,style 样式三个部分,通过 transpiler 分别转换。同时这个过程主要是对 script 和 template 进行转换,样式和 Vue 可以保持一致性最终借助 Vue 进行转换即可。 同时 wepy 还有自己的 runtime运行时的依赖,为了确保项目对 wepy 做到最小化的依赖,方便后续完全和 wepy 的依赖进行完全解耦,我们抽取了一个 wepy-adapter 模块,将原先对于 wepy 的依赖转换为对wepy-adapter 的依赖。 整体转换设计,如下图所示: 3.2 编译器流水线构建 如上图所示,整个编译过程就是一条流水线的架构设计,在每个阶段完成不同的任务。主要流程如下: 3.2.1 项目资源分析 不同的项目依赖资源不同的处理流程,扫描项目中的源码和资源文件进行分类,等待后续的不同的流水线处理。 静态资源文件(图片,样式文件等)不需要经过当中流水线的处理,直达目标 uniapp 项目的对应的目录。 3.2.2 AST抽象语法树转换 针对 wepy 的源文件(app,page,component等)对 script,template 等部分,通过 parse 转换成相对应的AST抽象语法树,后续的代码转换都是基于对抽象语法树的结构改进。 3.2.3 代码转换实现 - Transform code 根据 wepy 和 uniapp 的 Vue 的代码实现上的差异,通过对ast进行转换实现代码的转换。 3.2.4 代码生成 - code emitter 根据步骤三转换之后最终的ast,进行对应的代码生成。 四、项目搭建 整体项目结构如下图所示: 4.1 单仓库的管理模式 使用 lerna 进行单仓库的模块化管理,方便进行模块的拆分和本地模块之间依赖引用。另外单仓库的好处在于,和项目相关的信息都可以在一个仓库中沉淀下来,如文档,demo,issue 等。不过随着 lerna 社区不再进行维护,后续会将 lerna 迁移到 pnpm 的 workspace 的方案进行管理。 4.2 核心模块 wepy-adapter - wepy运行期以来的最小化的polyfill wepy-chameleon-cli - 命令行工具模块 wepy-chameleon-transpiler - 核心的编译器模块,按照one feature,one module方式组织 4.3 自动化任务构建等 Makefile - *nix世界的标准方式 4.4 scripts 自动化管理 shipit.ts 模块的自动发布等自动化能力 4.5 单元测试 采用Jest作为基础的测试框架,使用typescript来作为测试用例的编写。 使用@swc/jest作为ts的转换器,提升ts的编译速度。 现在社区的vitest直接提供了对ts的集成,借助vite带来更快的速度,计划迁移中。 五、核心设计实现 5.1 wepy template 模版转换 5.1.1 差异性梳理 下面我们可以先来大致看一下wepy的模板语法和uniapp的模板语法的区别。 图:wepy模板和uni-app模板 从上图可以看出,wepy模板使用了原生微信小程序的wxml语法,并且在采用类似Vue的组件引入机制的同时,保留了wxml< import/ >、< include/ >标签的能力。同时为了和wxml中循环渲染dom节点的语法做区别,引入了新的< Repeat/ >标签来渲染引入的子组件,而uni-app则是完全使用Vue风格的语法来进行开发。 所以总结wepy和uni-app模板语法的主要区别有两点: wepy使用了一些特定的标签用来导入或者复用其他wxml文件例如< import >和< include >。 wxml使用了xml命名空间的方式来定义模板指令,并且对指令值的处理更像是使用模板引擎对特定格式的变量进行替换。 下表列举一些两者模板指令的对应转换关系。 此外,还有一些指令的细节需要处理,例如在wepy中wx:key="id"指令会自动解析为wx:key="{{item.id}}",这里便不再赘述。 5.1.2 核心转换设计 编译器对template转换主要就需要完成以下三个步骤: 处理wepy引入的特殊的标签例如。 将wxml中使用的指令、特殊标签等转换为Vue模板的语法。 收集引入的组件信息传递给下游的wepy-page-transform模块。 wepy特殊标签转换 首先我们会处理wepy模板中的特殊标签< import/ >、< include/ >,主要是将wxml的文件引入模式转换成Vue模板的组件引入模式,同时还需要收集引入的wxml的文件地址和展示的模板名称。由于< include/ >可以引入wxml文件中除了< template/ >和< wxs/ >的所有代码,为了保证转换后组件的复用性,我们将引入的xx.wxml文件拆成了xx.vue和xx-incl.vue两个文件,使用< import/ >标签的会导入xx.vue,而使用< include/ >标签的会导入xx-incl.vue,转换import的核心代码实现如下: transformImport() { // 获取所有import标签 const imports = this.$('import') for (let i = 0; i < imports.length; i++) { const node = imports.eq(i) if (!node.is('import')) return const importPath = node.attr('src') // 收集引入的路径信息 this.importPath.push(importPath) // 将文件名统一转换成短横线风格 let compName = TransformTemplate.toLine( path.basename(importPath, path.extname(importPath)) ) let template = node.next('template') while (template.is('template')) { const next = template.next('template') if (template.attr('is')) { const children = template.children() // 生成新的组件标签例如 // <import src="components/list.wxml" /> // <template is="subList" /> => <list is="subList" /> const comp = this.$(`<${compName} />`) .attr(template.attr()) .append(children) comp.attr(TransformTemplate.toLine(this.compName), comp.attr('is')) comp.removeAttr('is') // 将当前标签替换为新生成的组件标签 template.replaceWith(comp) } template = next } node.remove() } } 具体的WXML文件拆分方案请看WXML转换部分。 wepy 属性转换 上文中已经介绍了,wepy模板中的属性使用了命名空间+模板字符串风格的动态属性,我们需要将他们转换成Vue风格的属性。转换需要操作模板中的节点及其属性,这里我们使用了cheerio, 快速、灵活、类jQuery核心实现,可以利用jQuery的语法非常方便的对模板字符串进行处理。 上述流程中一个分支中的转换函数会处理相应的wepy属性,以保证后续可以很方便的对转换模块进行完善和修改。由于属性名称转换只是简单的做一下相应的映射,我们重点分析一下动态属性值的转换过程。 WXML中使用双中括号来标记动态属性中的变量及WXS表达式,并且如果变量是WXS对象的话还可以省略对象的大括号例如 < view wx:for="{{list}}" > {{item}} < /view >、< template is="objectCombine" data="{{for: a, bar: b}}" >< /template > 所以当我们取到双中括号中的值时会有以下两种情况: 得到WXS的表达式; 得到一个没有中括号包裹的WXS对象。此时我们可以先对表达式尝试转换,如果有报错的话,给表达式包裹一层中括号再进行转换。考虑到WXS的语法类似于Javascript的子集,我们依然使用babel对其进行解析并处理。 核心代码实现如下: /** * * @param value 需要转换的属性值 */ private transformValue(value: string): string { const exp = value.match(TransformTemplate.dbbraceRe)[1] try { let seq = false traverse(parseSync(`(${exp})`), { enter(path) { // 由于WXS支持对象键值相等的缩写{{a,b,c}},故此处需要额外处理 if (path.isSequenceExpression()) { seq = true } }, }) if (!seq) { return exp } return `{${exp}}` } catch (e) { return `{${exp}}` } } 到这里,我们已经能够处理wepy模板中绝大部分的动态属性值的转换。但是,上文也提及到了,wepy采用的是类似模板引擎的方式来处理动态属性的,即WXML支持这种动态属性< view id="item-{{index}}" >,如果这个 < view / >标签使用了wx:for指令的话,id属性会被编译成item-0、item-1... 这个问题我们也想了多种方案去解决,例如字符串拼接、正则处理等,但是都不能很好的覆盖全部场景,总会有特殊场景的出现导致转换失败。 最终,我们还是想到了模板引擎,Javascript中也有类似于模板引擎的元素,那就是模板字符串。使用模板字符串,我们仅仅需要把WXML中用来标记变量的双括号{{}}转换成Javascript中的${}即可。 5.2 Wepy App 转换 5.2.1 差异性梳理 wepy 的 App 小程序实例中主要包含小程序生命周期函数、config 配置对象、globalData 全局数据对象,以及其他自定义方法与属性。 核心代码实现如下: import wepy from 'wepy' // 在 page 中,通过 this.$parent 来访问 app 实例 export default class MyAPP extends wepy.app { customData = {} customFunction() {} onLaunch() {} onShow() {} // 对应 app.json 文件 // build 编译时会根据 config 属性自动生成 app.json 文件 config = {} globalData = {} } uniapp的 App.vue 可以定义小程序生命周期方法,globalData全局数据对象,以及一些自定义方法,核心代码实现如下: <script> export default { globalData: { text: 'text' } onLaunch: function() { console.log('App Launch,app启动') }, onShow: function() { console.log('App Show,app展现在前台') }, onHide: function() { console.log('App Hide,app不再展现在前台') }, methods: { // ..... } } <script> 5.2.2 核心转换设计 如图, 核心转换设计流程: 对 app.py 进行 parse,拆分出script和style部分,对script部分使用babel进行parse生成AST。 通过对 AST 分析出,小程序的生命周期方法,globalData全局数据,自定义方法等。 对于AST进行uniapp转换,生命周期方法和全局数据转成对象的方法和属性,对自定义方法转换到method内。 其中对 globalData 的访问,要进行替换通过 getApp()进行访问。 抽取 ast 中的 config 字段,输出到 app.json 配置文件。 抽取 wepy.config.js 中的 config 字段,传入 wepy 的 app 实例。 核心代码实现: let APP_EVENT = ['onLaunch', 'onShow', 'onHide', 'onError', 'onPageNotFound'] //.... // 实现wepy app到uniapp App.vue的转换 t.program([ ...body.filter((node: t.Node) => !t.isExportDeclaration(node)), // 插入appClass ...appClass, ...body .filter((node: t.Node) => t.isExportDeclaration(node)) .map((node: object) => { // 对导出的app进行处理 if (t.isExportDeclaration(node)) { // 提前config属性 const { appEvents, methods, props } = this.clzProperty // 重新导出vue style的对象 return t.exportDefaultDeclaration( t.objectExpression([ // mixins ...mixins, // props ...Object.keys(props) .filter((elem) => elem !== 'config') .map((elem) => this.transformClassPropertyToObjectProperty(props[elem]) ), // app events ...appEvents.map((elem) => this.transformClassMethodToObjectMethod(elem) ), // methods t.objectProperty( t.identifier('methods'), t.objectExpression([ ...methods.map((elem) => this.transformClassMethodToObjectMethod(elem) ), ]) ), ]) ) } return node }), ]) // ..... 5.2.3 痛点难点 在运行期,app.wpy 会继承 wepy.App 类,这样就会在运行期和 wepy.App 产生依赖关系,怎么最小化弱化这种关系。抽取wepy的最小化以来的polyfill,随着业务中代码剔除对wepy的api调用,最终去除对polyfill的依赖。 5.3 wepy component 转换 对于wepy component 的转换主要可以细化到对 component 中 template、script、style 三部分代码块的转换。 其中, style 部分由于已经兼容 Vue 的规范,所以我们无需做额外处理。而 template 模块主要是需要对 wepy template 中特殊的标签、属性、事件等内容进行处理,转化为适配 uni的template,上文做了详细的说明。 我们只需要专注于处理 script 模块的代码转换即可。从架构设计的思路来看,component script 的转换主要是是做以下两件事: 编译期可确定代码块的转换。 运行期动态注入代码的兼容。 wepy-component-transform 就是基于以上这两个标准设计出来的实现转换逻辑的模块。 5.3.1 差异性梳理 首先先解释一下什么是“编译期可确定代码块”,我们来看一个 wepy 和 Vue 语法对比示例: 从直观上来说,这个 script 的模板的语法大致和 Vue 语法类似,这意味着我们解析出来的 AST 结构和 Vue 文件对应的 AST 结构上类似,基于这一点来看编译转换的工作量大致有底了。 从细节来看, wpy 文件script 模块中的 API 语法和 Vue 中有声明及使用上的不同,其中包含: wepy 自身的包依赖注入及运行时依赖 props/data/methods 声明方式不同 生命周期钩子不同 事件发布/订阅的注册和监听机制不同。 ....等等 为了确定这个第5点等等还存在哪些使用场景,我们需要对 wepy 自身的逻辑和玩法有一个详尽的了解和熟悉,通过在团队内组织的 wepy 源码走读,再结合wepy 实际生产项目中的代码相互印鉴,我们最终才将 wepy 语法逻辑与 uni-app Vue 语法逻辑的异同梳理清楚。 5.3.2 核心转换设计 我们简单梳理一下 wepy-component-transform 这个模块的结构,可以分为以下三个部分: 预处理 wepy component script 代码 AST 节点部分 构建 Vue AST 通过 generate 吐出代码 1.预处理 AST 基于前文转换设计这一节我们知道, wepy 变色龙的转换器中对代码的 AST 解析主要依赖 babel AST 三板斧(traverse、types、generate)来实现,通过分析各个差异点代码语句转换后的 AST 节点,就可以通过 traverse 中的钩子来进行节点的前置处理,这里安利一下 https://astexplorer.net/,我们可以通过它快速分析代码块 AST 节点、模拟场景及验证转换逻辑: 预处理 AST,目的是提前将 wepy 源码中的代码块解析为 AST Node 节点后,按语法进行归集到预置的 clzProperty 对象中,其中: props 对象用来盛放 ClassProperty 语法的 ast 节点 notCompatibleMethods 数组用来盛放非生命周期函数白名单内的函数 AST 节点。 appEvents 数组用来盛放生命周期函数白名单内的函数 AST 节点。 listenEvents 数组用来盛放 发布/订阅事件注册的函数 AST 节点。 核心代码实现如下所示: import { NodePath, traverse, types } from '@babel/core' this.clzProperty = { props: {}, notCompatibleMethods: [], appEvents: [], listenEvents: [] } traverse() { ClassProperty: (path) => { const name = path.node.key.name this.clzPropertyprops[name] = path.node }, ClassMethod: (path) => { const methodName = path.node.key.name // 判断是否存在于生命周期白名单内 const isCompEvent = TOTAL_EVENT.includes(methodName) if (isCompEvent) { this.clzProperty.appEvents.push(path.node) } else { this.clzProperty.notCompatibleMethods.push(path.node) } }, ObjectMethod: (path: any) => { if (path.parentPath?.container?.key?.name === 'events') { this.clzProperty.listenEvents.push(path.node) } } } 这里要注意一点,由于对 wepy 来说,实际上 page 也属于 component 的一种实现,所以两者的 event 会有一定的重合,而且由于 wepy 中生命周期和 Vue 生命周期的差异性,我们需要对如 attached、detached、ready 等钩子做一些 hack。 2.构建 Vue AST buildCompVueAst 函数即为 构建 Vue AST 部分。从直观上来看,这个函数只做了一件事,即用 types.program 重新生成一个 AST 节点结构,然后将原有的 wepy 语法转换为 vue 语法。但是实际上我们还需要处理许多额外的兼容逻辑,简单罗列一下: created 重叠问题 methods 中函数的收集 events 中函数的调用处理 created 重叠问题主要是为了解决 created/attached/onLoad/onReady 这4个生命周期函数都会转换为 created 导致的多次重复声明问题。我们需要针对若存在 created 重叠问题时,将其余钩子中的代码块取出并 push 到第一个 created 钩子函数内部。代码示例如下: const body = this.ast.program.body const { appEvents, notCompatibleMethods, props, listenEvents } = this.clzProperty // 处理多个 created 生命周期重叠问题 const createIndexs: number[] = [] const sameList = ['created', 'attached', 'onLoad', 'onReady'] appEvents.forEach((node, index) => { const name: string = node.key.name if (sameList.includes(name)) { createIndexs.push(index) } }) if (createIndexs.length > 1) { // 取出源节点内代码块 const originIndex = createIndexs[0] const originNode = appEvents[originIndex] const originBodyNode = originNode.body.body // 留下的剩余节点需要取出其代码块并塞入源节点中 // 塞入完成后删除剩余节点 createIndexs.splice(0, 1) createIndexs.forEach((index) => { const targetNode = appEvents[index] const targetBodyNode = targetNode.body.body // 将源节点内代码块塞入目标节点中 originBodyNode.push(...targetBodyNode) // 删除源节点 appEvents.splice(index, 1) }) } 由于 wepy 中非 methods 中函数的特殊性,所以我们需要在转换时将独立声明的函数、events 中的函数都抽离出来再 push 到 methods 中,伪代码逻辑如下所示: buildCompVueAst() { const body = this.ast.program.body return t.program([ ...body.map((node) => { return t.exportDefaultDeclaration( t.objectExpression([ ...Object.keys(props) .map((elem) => { if (elem === 'methods') { const node = props[elem] // 1.events 内函数插入 methods 中 // 2.与生命周期平级的函数抽离出来插入 methods 中 node.value.properties.push( ...listenEvents, ...notCompatibleMethods ) } return props[elem] }) ]) ) }) ]) } events 中函数的调用处理主要是为了抹平 wepy 中发布订阅事件调用和 Vue 调用的差异性。在 wepy 中,事件的注册通过在 events 中声明函数,事件的调用通过 this.$emit 来触发。而 vue 中我们采用的是 EventBus 方案来兼容 wepy 中的写法,即手动为 events 中的函数创建 this.$on 形式的调用,并将其代码块按顺序塞入 created 中来初始化。 首先我们要判断文件中是否已有 created 函数,若存在,则获取其对应的代码块并调用 forEachListenEvents 函数将 events 中的监听都 push 进去。 若不存在,则初始化一个空的 created 容器,并调用 forEachListenEvents 函数。核心代码实现如下所示: buildCompVueAst() { const obp = [] as types.ObjectMethod[] // 获取class属性和方法 const body = node.declaration.body.body const targetNodeArray = body.filter(child => child.key.name === 'created' ) if (targetNodeArray.length > 0) { let createdNode = targetNodeArray[0] this.forEachListenEvents(createdNode) } else { const targetNode = t.objectMethod( 'method', t.identifier('created'), [], t.blockStatement([]) ) this.forEachListenEvents(targetNode) if (targetNode.body && targetNode.body.body.length > 0) { obp.push(targetNode) } } return obp } forEachListenEvents 函数主要是通过 wepy 中 声明的 events 事件名和入参,借助 babel types 手动创建对应的 AST Node,最终生成对应的形如 this.eventBus.on("canceldeposit", this.canceldeposit) 形式的监听,其中,this.canceldeposit 为原有 events 中的事件被移入 methods 后的函数,相关伪代码实现如下所示: // 根据 events 中的 methods 构建事件监听的调用 // 并塞入 created 中 forEachListenEvents(targetNode: types.ObjectMethod) { this.clzProperty.listenEvents.forEach((item) => { const methodsNode: any = item // 形如 this.$on('test', ()=>{}) if (methodsNode?.key?.name) { // 创建 this 表达式 const thisEx = t.thisExpression() // 创建 $on 表达式 const ide = t.identifier('$eventBus.$on') // 合并 this.$on 表达式 const om = t.memberExpression(thisEx, ide) // 创建事件名称参数节点 const eventNameIde = t.stringLiteral( methodsNode.key.name.toString().trim() ) // 获取方法体内代码内容节点 const meNode = t.memberExpression( t.thisExpression(), t.identifier(methodsNode.key.name.toString().trim()) ) const ceNode = t.callExpression(om, [eventNameIde, meNode]) const esNode = t.expressionStatement(ceNode) // 将合成后的代码插入到 created 中 targetNode.body.body.push(esNode) } }) } 3.emitter vue 代码生成 构建完 Vue AST 之后,我们可以调用 generate 函数生成源码字符串: transform() { const ast = this.buildCompVueAst() const compVue = this.genCode(ast) return { compVue, wxs: this.buildWxs() } } 5.4 Wepy page 转换 5.4.1 差异性梳理 上面的章节已经给大家分析了template、component的代码转换逻辑,这一节主要带大家一起看下如何转换page文件。page转换的逻辑即如何实现wepy 的 page.wpy 模块转换为 uniapp 的 page.vue 模块。 首先我们来看下wepy 的 page 小程序实例: <script> import wepy from 'wepy'; import Counter from '../components/counter'; export default class Page extends wepy.page { config = {}; components = {counter1: Counter}; data = {}; methods = {}; events = {}; onLoad() {}; // Other properties } </script> <template lang="wxml"> <view> </view> <counter1></counter1> </template> <style lang="less"> /** less **/ </style> 可以看到,wepy的page类也是通过继承来实现的,页面文件 page.wpy 中所声明的页面实例继承自 wepy.page 类,该类的主要属性介绍如下: 5.4.2 核心转换设计 基于page的api特性以及实现方案,具体的转换设计思路如下: 5.4.3 痛点难点 1.非阻塞异步与异步 在进行批量pages转换时,需要同时对pages.json进行读取、修改、再修改的操作,这就涉及到使用阻塞 IO/ 异步 IO来处理文件的读写,当使用异步IO时,会发起多个进程同时处理pages.json, 每个读取完成后单独处理对应的内容,数据不是串行修改,最终导致最终修改的内容不符合预期,因此在遇到并行处配置文件时,需要使用阻塞式io来读取文件,保障最终数据的唯一性,具体代码如下: // merge pageConfig to app config const rawPagesJson = fs.readFileSync(path.join(dest, 'src/pages.json')) // 数据操作 fs.writeFileSync( path.join(dest, 'src', 'pages.json'), prettJson(pagesJson) ) 2.复杂的事件机制 在转换过程中,我们也碰到一个比较大的痛点:page.wepy 继承至 wepy.page,wepy.page 代码较复杂,需要将明确部分单独抽离出来。例如说 events 中组件间数据传递:$broadcast、$emit、$invoke,$broadcast、$invoke需要熟悉其使用场景,转换为 Vue 中公共方法。 5.5 Wepy WXML 转换 template转换章节中提到了wepy模板中可以直接引入wxml文件,但是uni-app使用的Vue模板不支持直接引入wxml,故我们需要将wxml文件处理为uniapp可以引入的Vue文件。我们先来看一下wepy中引入的wxml文件的大致结构。 <template name="foo"> <view class="foo-content"> <text class="text1">{{item.text1}}</text> <image class="pic" src="{{pic.url}}" mode="aspectFill"></image> </view> </template> <template name="bar"> <view class="bar-content"> <image class="bar" src="{{pic.url}}" mode="aspectFill"></image> <text class="text2">{{item.text2}}</text> </view> </template> <view class="footer"> this is footer </view> <!-- index.wepy --> <!-- 引入文件 --> <import src="somePath/fooBar.wxml" /> <!-- 确定展示的template及传入属性 --> <script is="foo" data="{{item, pic}}" /> <!-- or, 此时仅会展示<template/>以外的内容即footer --> <include src="somePath/fooBar.wxml"> 5.5.1 差异性梳理 从上面的代码可以看出,一个WXML文件中支持多个不同name属性的< template/ >标签,并且支持通过在引入设置data来传入属性。从上面的示例模板中我们可以分析出,除了需要将wepy使用的WXML语法转换成vue模板语法外(这里的转换交给了template模块来处理),我们还需要处理以下的问题。 确定引入组件时的传参格式 确定组件中传入对象的属性有哪些 处理< import/ >和< include/ >引入的文件时的情况 5.5.2 核心转换设计 1.确定引入组件时的传入属性方式 首先需要将wepy组件引入形式改成Vue的组件引入方式。以上面的代码为例,即将< import/ > 、< script/ >对的引入形式改写成< component-name / > 引入方式。我们会在转换开始前对代码进行扫描,收集模板中的引入文件信息,传递给wepy-page-transform模块处理,在转换后的Vue组件的< script/ >中进行引入。并且将< script is="foo" data="{{item, pic}}" / > 转换为< FooBar is="foo" :data=(待定) / > 。这里就需要确定属性传递的方式。 从上面的代码中可以看到,在WXML文件的< template/ >会自动使用传入的data属性作为隐式的命名空间,从而不需要使用data.item来获取item属性。这里很自然的就会想到原来的< script is="foo" data="{{item, pic}}" / >可以转换成< FooBar compName="foo" :key1="val1" :key2="val2" ... / >。 其中,key1,val1,key2,val2等为原data属性对象中的键值对,compName用来指定展示的部分。这样处理的好处是,引入的WXML文件中使用相应的传入的属性就不需要做额外的修改,并且比较符合我们一般引入Vue组件时传入属性的方式。 虽然这种方案可以较少的改动WXML文件中的模板,但是由于传入的对象可能会在运行期间进行修改,我们在编译期间比较难以确定传入的data对象中的键值对。考虑到实现的时间成本及难易程度,我们没有选择这种方案。 目前我们所采用的方案是不去改变原有的属性传入方式,即将组件引入标签转换为< FooBar compName="foo" :data="{item, pic}" / >。从而省去分析传入对象在运行时的变动。这里就引出了第二个问题,如何确定组件中传入的参数有哪些。 2.确定组件中的传入的对象属性 由于Vue的模板中不会自动使用传入的对象作为命名空间,我们需要手动的找到当前待转换的模板中所使用到的所有的变量。相应的代码如下: searchVars() { const self = this const domList = this.$('template *') // 获取wxml文件中template节点下的所有text节点 const text = domList.text() const dbbraceRe = new RegExp(TransformTemplate.dbbraceRe, 'g') let ivar // 拿到所有被{{}}包裹的动态表达式 while ((ivar = dbbraceRe.exec(text))) { addVar(ivar[1]) } // 遍历所有节点的属性,获取所有的动态属性 for (let i = 0; i < domList.length; i++) { const dom = domList.eq(i) const attrs = Object.keys(dom.attr()) for (let attr of attrs) { const value = dom.attr(attr) if (!TransformTemplate.dbbraceRe.test(value)) continue const exp = value.match(TransformTemplate.dbbraceRe)[1] try { addVar(exp) } catch (e) { addVar(`{${exp}}`) } } } function addVar(exp: string) { traverse(parseSync(`(${exp})`), { // 利用babel分析表达式中的所有变量 Identifier(path) { if ( path.parentPath.isMemberExpression() && !path.parentPath.node.computed && path.parentPath.node.property === path.node ) return self.vars.add(path.node.name) // 收集变量 }, }) } } 收集到所有的变量信息后,模板中的所有变量前面需要加上传入的对象名称,例如item.hp_title需要转换成data.item.hp_title。考虑到模板的简洁性和后续的易维护性,我们把转换统一放到< script/ >的computed字段中统一处理即可: <template> <!--...--> </template> <script> export default { props: ['data', 'compName'], computed: { item() { return data.item }, pic() { return data.pic } } } </script> 3.处理 < import/ >和< include/ >两种引入方式 wepy模板有两种引入组件的方式,一种是使用< import/ >< script/ >标签对进行引入,还有一种是使用< include/ > 进行引入,< include/ > 会引入WXML文件中除了< template/ >和< wxs/ >的其他标签。这里的处理方式就比较简单,我们把< include/ > 会引入的部分单独抽取出来,生成TItem-incl.vue文件,这样即保证了生成代码的可复用性,也降低< import/ >标签引入的部分生成的TItem.vue文件中的逻辑复杂度。生成的两个文件的结构如下: <!--TItem.vue--> <template> <view> <template v-if="compName == 'foo'"> <view class="foo"> <!--...--> </view> </template> <template v-if="compName == 'bar'"> <view class="bar"> <!--...--> </view> </template> </view> </template> <script> export default { props: ['compName', 'data'], computed: { item() { return this.data.item }, pic() { return this.data.pic } } } </script> <!--TItem-incl.vue--> <template> <view> <view class="footer"> this is footer </view> </view> </template> 六、阶段性成果 截止到目前,司内的企微导购小程序项目通过接入变色龙编译器已经顺利的从 wepy 迁移到了 uniApp 架构,原本预计需要 25人/天 的迁移工作量在使用了编译器转换后缩短到了 10s。这不仅仅只是提高了迁移的效率,也降低了迁移中的知识迁移成本,给后续业务上的快速迭代奠定的扎实的基础。 迁移后的企微导购小程序项目经测试阶段验证业务功能 0 bug,目前已经顺利上线。后续我们也会持续收集其他类似的业务诉求,帮助业务兄弟们低成本完成迁移。 七、总结 研发能效的提升是个永恒的话题,此次我们从编译这个角度出发,和大家分享了从wepy到uniapp的架构升级探索的过程,通过构建代码转换的编译器来提升整体的架构升级效率,通过编译器消化底层的领域和知识的差异性,取得了不错的效果。 当然,我们目前也有还不够完善的地方,如:编译器脚手架缺乏对于部分特性颗粒度更细的控制、代码编译转换过程中日志的输出更友好等等。后续我们也有计划将 wepy 变色龙编译器在社区开源共建,届时欢迎大家一起参与进来。 现阶段编译在前端的使用场景越来越多,或许我们真的进入了Compiler is our framework的时代。

优秀的个人博客,低调大师

利用amoeba(变形虫)实现mysql数据库读写分离

关于mysql的读写分离架构有很多,百度的话几乎都是用mysql_proxy实现的。由于proxy是基于lua脚本语言实现的,所以网上不少网友表示proxy效率不高,也不稳定,不建议在生产环境使用;amoeba是阿里开发的一款数据库读写分离的项目(读写分离只是它的一个小功能),由于是基于java编写的,所以运行环境需要安装jdk; 前期准备工作:1.两个数据库,一主一从,主从同步;master: 172.22.10.237:3306 ;主库负责写入操作;slave: 10.4.66.58:3306 ; 从库负责读取操作;amoeba: 172.22.10.237:8066 ; 我把amoeba安装到了主库所在的服务器,当然,你也可以安装到第三台服务器上;所有服务器操作系统均为centos7;2.在amoeba所在的服务器上配置安装jdk;我安装的是jdk1.8;路径是: JAVA_HOME=/usr/local/java/jdk1.8.0_131 以上务必自己点搭建、配置好,主从正常工作,添加jdk环境变量: /etc/profile ; 安装amoeba的方式有很多,这里就不在安装上面费口舌了,我下载了amoeba-mysql-3.0.5-RC-distribution的安装包,直接解压即可使用;解压目录: /usr/local/amoeba/很明显 conf里是配置文件,bin里是启动程序;刚才说到 amoeba的功能可不止读写分离,但如果只用读写分离功能的话只需要配置这几个个文件即可: conf/dbServers.xml conf/amoeba.xml 和 bin/launcher ;conf/dbServers.xml : `<property name="port">3306</property> #设置Amoeba要连接的mysql数据库的端口,默认是3306 <property name="schema">testdb</property> #设置缺省的数据库,当连接amoeba时,操作表必须显式的指定数据库名,即采用dbname.tablename的方式,不支持 use dbname指定缺省库,因为操作会调度到各个后端dbserver <property name="user">test1</property> #设置amoeba连接后端数据库服务器的账号和密码,因此需要在所有后端数据库上创建该用户,并授权amoeba服务器可连接 <property name="password">111111</property> <property name="maxActive">500</property> #最大连接数,默认500 <property name="maxIdle">500</property> #最大空闲连接数 <property name="minIdle">1</property> #最新空闲连接数 <dbServer name="writedb" parent="abstractServer"> #设置一个后端可写的数据库,这里定义为writedb,这个名字可以任意命名,后面还会用到 <property name="ipAddress">172.22.10.237</property> #设置后端可写dbserver的ip <dbServer name="slave01" parent="abstractServer"> #设置后端可读数据库 <property name="ipAddress">10.4.66.58</property> <dbServer name="myslave" virtual="true"> #设置定义一个虚拟的dbserver,实际上相当于一个dbserver组,这里将可读的数据库ip统一放到一个组中,将这个组的名字命名为myslave <property name="loadbalance">1</property> #选择调度算法,1表示复制均衡,2表示权重,3表示HA, 这里选择1 <property name="poolNames">slave01</property> #myslave组成员` conf/amoeba.xml : <property name="port">8066</property> #设置amoeba监听的端口,默认是8066 <property name="ipAddress">127.0.0.1</property> #配置监听的接口,如果不设置,默认监听所以的IP # 提供客户端连接amoeba时需要使用这里设定的账号 (这里的账号密码和amoeba连接后端数据库服务器的密码无关) <property name="user">root</property> <property name="password">123456</property> <property name="defaultPool">myslave</property> #设置amoeba默认的池,这里设置为writedb <property name="writePool">master</property> #这两个选项默认是注销掉的,需要取消注释,这里用来指定前面定义好的俩个读写池 <property name="readPool">slave01</property> bin/launcher : #启动脚本,需要配置jdk环境变量; #在注释后的第一行添加: JAVA_HOME=/usr/local/java/jdk1.8.0_131 launcher 是启动脚本,如果不配置JAVA_HOME的话,即便你在/etc/profile中配置了环境变量也可能会报错:没有配置jdk环境变量;还有一个配置文件: jvm.properties #占用内存配置文件 # -Xss参数有最小值要求,必须大于228才能启动JVM #修改: JVM_OPTIONS="-server -Xms1024m -Xmx1024m -Xss256k -XX:PermSize=16m -XX:MaxPermSize=96m" 有经验的运维都知道,凡是和jdk沾上边的,基本都会和内存的调优有关系,amoeba也不例外; 现在可以启动了: 启动后就可以看到本机的8066端口:这时,你只需要通过本机ip的8066端口和你配置文件中设置的账号密码来连接数据库就行了,写入的数据都会到master里,读取的数据都会从slave中读取;测试:关闭master数据库,依然可以读取:执行 select 查看命令;或者关闭slave数据库,依然可以写入: 执行 update、inster命令;

优秀的个人博客,低调大师

做智能体机甲驾驶员 ——《可托付智能》第6章《专家不会消失,只会换位置》

设想一位医生接诊了病情复杂的患者。病人的主诉、既往病史、化验和影像结果、正在服用的药物,以及其他医院的就诊记录,散落在不同系统里。有的记录来自几年前,有的刚刚更新,还有些信息只有病人和家属知道。医生要弄清的,不只是哪个数值超出了正常范围,还包括异常是什么时候出现的,几份记录是否相互矛盾,病人眼下最需要解决的究竟是什么。

优秀的个人博客,低调大师

苹果iMessage中国“变形记”:用户无力吐槽、官方束手无策

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 你可以不看手机里的iMessage信息,你甚至可以徒劳地去举报屏蔽那些小广告。但是只要有1%的可能,那些发送小广告内容的灰产和背后的金主就不会放弃“希望“。 所以,只要苹果手机用户存在一天,垃圾信息就不会终结。 其实,苹果手机内置的即时通信应用iMessage近来逐渐变得“知名”,并非因为其可以通过网络免费向所有苹果用户发送图片、文字、视频等信息。而是那些开启iMessage功能的国内苹果用户,几乎是永无止息地被那些假货的宣传、广告信息骚扰着。以至于一些苹果用户戏称iMessage为:一台永不休息的“广告收发机”。 随着iMessage垃圾信息越来越多,垃圾手机短信却在逐渐减少,预示着iMessage垃圾信息似乎有取手机短信而代之的趋势。 这种情况让很多苹果手机用户感到不胜其烦,不少用户甚至质疑称,iMessage只能通过已激活该功能的手机号或Apple id发送信息,为何灰产能够拿到用户手机号或Apple id?为何他们会知晓用户已开通iMessage?除了举报虚假信息之外,苹果为何拿不出屏蔽措施,任由垃圾信息满天飞? 或许,这都要从群发垃圾短信被广泛“拦截”开始说起。 送达率高,iMessage成小广告新宠 “现在群发手机短信的送达率太低了,不是很推荐啊。” 通过网上小广告,懂懂笔记联系上了一家从事短信群发的机构。客服经理吴先生表示,他们机构经营短信群发业务已有十年之久,尽管短信群发从理论上说是合法的,但目前的送达率却越来越低。 “我们推荐您这边用iMessage群发信息,看起来和短信一样,效果也更好一些。”吴经理表示,如果选用iMessage来群发信息,送达率通常超60%,除了文字之外,还可以发送图文链接,形式更加丰富。 确实,近年来不少智能手机都内置了群发短信拦截功能,运营商也在推出“免打扰“服务,很多用户更是被迫安装了拦截效率更高的第三方手机安全应用,这也导致群发短信的送达率远远低于20%。 “苹果用户普遍都是中高消费群体呀,很适合保险、金融类信息的推广。”这位吴经理一边展示客户投放iMessage群发信息的效果,一边夸夸其谈。 当被问及iMessage信息通过网络发送,收费是否能便宜一些时,吴经理笑着表示,机构群发iMessage信息收费要比传统短信群发略贵一些。“其一是送达率高,其二是群发iMessage可是一门技术活儿。”他逐条解释,群发iMessage信息每条收费是0.1-0.3元,1万元起才发单。 因此,现阶段投放iMessage群发信息的,由于iMessage信息无需经过审核,即便被用户举报也只是封禁Apple id、设备,因此对发送信息的灰产影响不大。这些承接群发信息的机构对于所发送iMessage内容并无过多限制,基本上是只要给钱就来者不拒。 “现在短信已经不行了,短信除了会被用户拦截,运营商也在加大过滤。”吴经理展示了部分客户要求群发的内容,强调如果群发信息内容涉及灰色地带,大多只能用虚拟手机号发送,并且内容多以谐音字的方式,否则躲不过那些过滤机制。 显然,群发iMessage信息没有这样的顾虑,甚至可以发送非法图片、视频内容,以及内藏链接、诱导用户点击的“陷阱“。 那么,发送目标的手机号、Apple id是哪里来的?懂懂笔记得到的答案是——机构提供。 “我们确保精准发送,肯定不会忽悠您,您不用担心我们作假,但账号来源真的无可奉告。”对于懂懂笔记多次追问手机号码以及Apple id的准确性以及有效性,吴经理似乎有些不耐烦,强调不方便告知,“这些都是生意上的壁垒,真的不能随便透露,你去找别家也是一样。” 那么,号称送达率高达六成,并且能发送大量不良违法内容的iMessage群发信息,真如这些机构所说的那样,本身具备一定的技术门槛?群发的目标账号真的高精确送达?这些用户信息又是从何种途径获取的呢? 群发技术小儿科,用户号码能买能“猜” 懂懂笔记在搜索引擎上搜索“iMessage群发”,找到了不少相关的技术贴。而在某IT技术社区,不少相关内容甚至详尽提供了Apple 编写的群发代码与教程。 “iMessage群发的技术不难,这套代码完全基本满足群发。”懂懂笔记将社区公开的群发源码、教程发给从事苹果应用研发的相关工程师之后,对方表示,这些源码应该都是可以运行的。 其中,甚至还针对官方重复内容检测嵌入了随机表情,防止账号被封,可见iMessage群发门槛并不高,“群发的难点在于手机号、苹果账号的获取。”在这位工程师的介绍下,懂懂笔记联系到一位曾在群发机构工作过的技术老炮“米欧”,他告诉懂懂笔记,获取用户手机号码的方式其实比较简单,也相对传统。 “部分信息是从灰产那里低价购买的,每个号码几分钱而已。”米欧表示,购买用户手机号码其实也没有门槛,有时甚至可以“猜”号码。毕竟,随即选取手机号码之后,并不能马上用于iMessage群发,还需要通过工具筛选手机号码是否已关联了Apple id。 而这种筛选方式很简单,只需打开Mac iMessage(信息)客户端,将所有购买、随机整理的手机号码自动粘贴到收件人一栏。 “显示蓝色的就是已有iMessage,显示红色就是普通号码。”“米欧”告诉懂懂笔记,只要将显示蓝色的手机号码全部整理好,就是一份可以群发iMessage的账号名单了。 如果想让群发更有的放矢,节省筛选的时间与精力,就需要用到作为iMessage账号的Apple id——即用户邮箱,“邮箱的来源也有两个方式,但都见不得光。” 米欧指出,尽管苹果系统相比安卓更为封闭,安全性也很高。但用户在使用的过程中还是会泄露Apple id,尤其是将手机送修的环节,更是容易被“路边”维修机构盗取id。 “有时用户浏览一些网页,突然会收到信息提示要求重新验证Apple id,这种情况大概率也是灰产为了套取用户账号搞的动作。”他说,如果用户不留心输入账号、密码,立马就被灰产机构套走。 Apple id除了被用作群发信息之外,还容易导致支付被盗刷。米欧提醒说,如果频繁收到iMessage垃圾信息的用户,常更改苹果账号的登录密码,避免被盗用、登录,“这证明许多群发机构都已经获取了你的账号信息,是很危险的。” 虽说iMessage群发账号来源是难点,但通过购买、随机、验证用户手机号码的方式,也能向大量的用户发送iMessage垃圾信息,有些用户的Apple id,更是不知道被灰产机构倒卖了几手。 那么问题来了:面对大量垃圾、非法信息骚扰,苹果用户就只能默默忍受? 强关iMessage,牺牲功能换“清净” “谁收到的骚扰垃圾信息最多,就说明谁最有钱,嘿嘿,开个玩笑哈。” 在南山区科兴科技园某应用研发企业上班的徐常伟,每天都能够收到超过五条的iMessage信息。同事间甚至还开展了一场“垃圾信息竞赛”,比赛谁收到的垃圾信息最多。 作为一名技术人员,他在两年前就对iMessage垃圾信息采取了屏蔽、拒收方式。然而,无论是IT社区还是社交平台,人士提到的最有效方式,还是关闭iMessage功能。 “身边有很多亲友不懂得关闭iMessage功能去杜绝骚扰信息。”他告诉懂懂笔记,尽管网上关于阻止iMessage垃圾信息泛滥的攻略很多,但还是有不少苹果用户发帖询问如何屏蔽垃圾信息,他们几乎都不知道iMessage功能的开关在哪儿。 徐常伟觉得,直接关闭这项功能的确能够免除垃圾信息的滋扰。“但多少有些简单粗暴了,我有很多同事平时还是要通过iMessage进行沟通的。”基于某些业务保密的原因,他所在的企业一直在倡导通过iMessage沟通工作。因此,再不能关闭苹果手机iMessage功能的前提下,他与同事都是在采用各种方式抵抗垃圾信息。 除了关闭功能之外,有技术人员建议,在短信设置中屏蔽所有陌生的号码信息,就可以有效减少垃圾信息。但是这种方法也容易将部分正常的短信当成陌生信息予以屏蔽,“这个方法也不是很合理,要以关闭、牺牲一项功能作为避免骚扰的代价,有些本末倒置了。” 在徐常伟看来,面对日益增多的等垃圾信息,苹果公司应该负起责任,像电信运营商对垃圾短信的举措那样,积极过滤不良资讯,“毕竟iMessage这个功能,是你们苹果技术人员开发的,你不能装聋作哑对吧?” 不过,懂懂笔记在多方了解和搜集苹果公司对于iMessage垃圾信息的态度时,却惊讶地发现,官方公布的有效办法并不多,除了举报账号,似乎并没有更好的解决方式。 “举报要么封禁账号要么封禁设备,真心一点威慑力都没有。”有网友吐槽说,苹果以保护用户隐私为由不过滤iMessage信息中的骚扰内容,是在推卸自身应负的责任。 最关键的是,iMessage无需实名制便可向苹果用户发送信息,导致信息很难朔源,这也让大量非法、不良机构有空可钻、有机可乘。即便是网络监管部门,在这种状态下也很难追寻发送信息的所属信源。 与骚扰短信一样,iMessage自进入中国之日起便被灰产挖掘成为垃圾信息“群发机”。随着电信部门对手机短信内容的监管日趋严厉,越来越多的不法信息早就转战iMessage,而这块儿空间也成了他们招摇撞骗的阵地。 所有苹果手机用户都已经成为垃圾信息的“标靶”,这也使得部分用户开始怀疑苹果系统真实的安全性,并产生了不信任感。但是,他们用的是苹果,苹果对于用户的尊重程度,谁心里还没个谱? 一直有舆论在呼吁,面对国内苹果手机用户面临大量垃圾信息,苹果官方应该尽快拿出相应的解决方案。而不是简单粗暴撂下一句“目前没有好的解决办法“,让广大消费者去承受不便和苦恼。 我们觉得,如果苹果能改,它就不是苹果了。

优秀的个人博客,低调大师

中关村变形记:从电子卖场到7.2公里的创业大街

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 中关村的奸商们被多家媒体以多种渠道做过报道,但中关村的奸商、黑导购们依然嚣张,欺骗越来越少的消费者。 有中关村经营者曾经向腾讯科技抱怨,电商平台的兴起以及苏宁国美(微博)等家电卖场的3C战略让电子卖场失去未来。但一个在中关村经营十数年的大渠道商则愤怒得对腾讯科技表示:“中关村电子卖场的卖家纯属自己作死,虽然电商的冲击很严重,但由于电子卖场的服务功能以及产品的全面,很多摊主都有忠实的老客户,而这些老客户都随着中关村假货逐渐增多而全部流失了。“ 海龙和鼎好都曾向腾讯科技表示采取过很多措施对经销商的行为进行规范,并且和当地的派出所也建立了绿色通道,不过显然收效甚微。 但给了中关村电子卖场***一击的,除了家电卖场和电商的兴起之外,也包括政府政策的改变。 2011年4月,中关村太平洋数码电脑城宣布关张。几天后,海龙集团创始人鲁瑞清对腾讯科技表示:“海龙今天的困难将是其他IT卖场的明天。” 一言成谶,中关村的“蚂蚁雄兵”们逐渐撤离这个让他们梦想开始的地方,而那些中关村的拥趸们也大批量离开这个曾经熙熙攘攘的“大卖场”。 今年1月中关村e世界开始对一千多家业主进行统一签约。签约完成后中关村e世界将以整体或整层的方式出租,统一经营,并不再从事电子卖场业务。这并不算是一个让人诧异的消息,据一位在e世界经营多年的商户介绍,2012年以后他的销售额下降很快,几次缩减规模才艰难生存。数字显示,e世界大概50平米左右的店铺,一个月的利润不足4000块,这个数字甚至比不上中关村地区相同面积的出租房。 但也有从业者坚持认为未来IT卖场还有自己的生存空间:“IT卖场之所以能够生存这么多年,最根本的因素还是因为品类全,配件的全面、高端DIY以及游戏视频玩家还是需要中关村电子卖场这样专业的地方去提供服务。” 现实却是,那个曾经让世界惊叹的中关村已经死去,而且将永不回来。 多次转型 中关村电子卖场整体转型开始于2009年,该年7月23日,海淀区政府发布《关于加快推进中关村西区业态调整的通告》。通告中有段文字这样表述:中关村西区定位于建设成为创新要素聚集功能区,不鼓励电子卖场、商场、购物中心、餐饮等业态在本区域内发展。 而《关于加快推进中关村西区业态调整的通告》更为明确地指出,中关村西区东起中关村大街、西至苏州街、北起北四环路、南至海淀南路,规划占地95公顷,公共建筑规模约250万平方米。功能定位于以技术创新与科技成果转化和辐射为核心,以科技创新服务为重点,以高端人才服务、中介服务和政府公共服务为支撑的创新要素聚集功能区。 显然在政府有关部门的倡导下,中关村地区又将面临一场商业变革。“不再获批新进入的商铺,对于老商铺则主要采取政府主导疏通的方式逐步实现业态再造。”这句话的背后,意味深远。 “‘挤出’并不意味着将电子市场整体搬迁,海龙大厦、鼎好电子商城等建筑将用作新技术新产品交易及展示区。”这是有关部门在公开场合的补充言论。 在中关村管委会对中关村西区的未来定位中,新技术新产品交易及展示区与科技金融要素聚集区、科技中介服务区、科技型企业总部聚集区、创意产业聚集区、配套服务区共同构成了6大重点功能区。 2010年,以海龙、鼎好为首的西区电子卖场先后引入高新技术企业。当年底,它们的写字间已基本完成高新技术企业的入驻,这也是2010年电子卖场转型迈出的重要一步。 电子卖场将彻底关闭 10月11日在“中关村创新创业季”开幕式上,中关村核心区正式发布“中关村大街发展规划”,这意味着中关村将彻底告别电子卖场,集中有限空间着力发展创业孵化、智能硬件、互联网+等新经济、新模式,打造人才集聚、模式创新的创客中心和共享经济中心。 规划中的中关村大街南起白石桥、北至清华大学西门,全长7.2公里。规划中,将中关村大街分为重点功能建设区和功能协同发展区两个空间层次。其中,重点功能建设区范围主要以中关村大街为中心,且东西两侧各拓展300米。按照规划,未来中关村大街建设将进一步突出“策源地”的特征,加速形成创业要素集聚化、孵化主体多元化、创业服务专业化、创业活动持续化、运营模式市场化、创业资源开放化的发展格局。 围绕上述定位,海淀区将构建中关村大街“5+6”的功能布局结构,将中关村大街划分为五个相对不同的特色职能区段,重点对沿线六个节点地区进行功能优化和环境设施改善。目标是至2020年底,使周边地区创新生态环境得到全面提升,持续产生具有中关村原始创新、技术服务能力及商业模式创新优势的创客群体和企业集群。 随着中关村宣布启动创业大街升级计划,海龙大厦二层目前已改造为智能硬件创新创业平台硬蛋的体验厅“硬蛋空间”。 据悉,硬蛋平台目前已汇聚7000多个智能硬件创新创业项目、3000多家供应商和400万智能硬件粉丝。 据现场工作人员介绍,在北京硬蛋空间近500平方米的展示区里,日前共有120多件智能硬件展出,展品会根据观众的反馈以及行业热点定时更换。 据介绍,硬蛋是科通芯城旗下于2013 开始孵化的智能硬件创新创业互联网平台,总部位于深圳,旨在为智能硬件创业者提供以“供应链”为核心的一站式O2O创业服务平台,提供从概念到产品到量产到销售渠道的B2B2C的闭环服务。作为***家入驻海龙大厦的智能硬件创业平台,硬蛋集中体现了中关村加速转型的期望。 今年3月,中关村下发了《关于促进中关村智能硬件产业创新发展的若干支持措施》(以下简称《措施》)29条指导性政策,大力支持智能硬件产业集群发展。海龙被中关村管委会和海淀区政府联合授予唯一一家“中关村智能硬件创新中心”,而硬蛋是***家入驻海龙的智能硬件创业平台。 从传统电子卖场到智能硬件产业集群并不是一件容易的事情,但一个细节或许能说明中关村转型的决心:中关村管委会相关人员曾亲赴深圳考察硬蛋,实地考察后才向硬蛋发出入驻邀请 。而对于创业公司、孵化器等创新创业机构而言,中关村为转型开出的优惠条件也非常诱人。《措施》中明确提出,对于入驻智能硬件产业集聚区的产业领军企业和拥有重大技术创新的企业,给予***50%的租金补贴,***补贴面积2000平方米的优惠措施。 硬蛋相关人士介绍,中关村提供的租金优惠以及政府的支持非常具有吸引力。“事实上之前我们也想建立体验馆,但是附近的地租太贵,现在正好有政府邀请,租金上的优惠加上政府的支持对我们非常有吸引力。” 或许国内电子卖场的历史仍未停止脚步,但作为曾经的最重要的象征、符号、旗舰,属于中关村电子卖场的历史显然将告一段落。一位在中关村打拼十余年的老中关村人对腾讯科技表示:“中关村在中国IT产业中扮演着孵化器、培训师的作用,这是当之无愧的中国硅谷,试想一下,如果没有中关村,或许也看不到新浪、爱国者、京东这样的企业出现。” 不过,被中国所有创业园、产业园、孵化器的主导者瞄准的硅谷,当年并没有一个“规划”,恰恰相反,风险投资、科技人才聚集、国防科技的民用化,这些更市场化的因素主导了它的诞生。而现在被视为中关村代表的京东、百度、新浪等互联网公司,它们的成长路径也遵循于此。 也许,一条7.2公里的创业大街会让更多的公司有了容身之所,这至少会在公司的绝对数量上拉近与硅谷的距离。

优秀的个人博客,低调大师

架构师变形记:讲述Java码农到年薪100万架构师之路

最近有不少朋友问我怎样才能成为年薪百万的架构师,我听到他这样问,首先想到的是什么样的人才可以称之为架构师,然后我给他总结了他需要攻克的3个难点: 1.接触不到一线实战架构设计,尤其是有一定的技术深度和难度架构设计。 2.不了解核心技术点所处的具体背景是什么?其后的设计方案是什么? 3.为什么要如此设计?在设计方案时有没有不同的方案对比?架构设计背后的哲学有哪些? 而对于有一定后台研发经验(尤其是3~5年以上经验)的程序员们来说,成为架构师不仅是时代的趋势,同时也是个人职业价值的诉求所在。 具有专业能力的互联网系统架构师人才备受重视。据我所知谷歌、百度、腾讯、阿里、京东都在重金求赏架构师人才。 鉴于此,给大家推荐一个阿里P8架构师分享的JAVA学习路线和思维导图 1、开源框架解析专题 站在巨人肩膀,收获不一样的视野。 源码解析 2、微服务架构专题 你还不知道微服务,怎么涨薪。 微服务架构 3、架构筑基专题 深入内核、直击故障、拒绝懵圈。 架构筑基 4、团队协作开发专题 让你团队开发效率提高十倍。 团队协作开发 5:设计模式 学习Java技术体系,常见的设计模式是编码必备,掌握了它你会变得更强。 设计模式 6、高性能架构专题 成为互联网架构师,你要的都在这里。 高性能架构 7:并发编程 从架构设计,到应用层调优,再深入了解底层原理,扎实的Java基本功才能让自己变为扫地神僧: 内存模型 并发模式 线程模型 锁细节 并发编程 8、B2C商城项目实战 撸起袖子干实事,项目经验那点事。 B2C商城项目实战 有了路线解析图,有没有免费资料?有没有志同道合的小伙伴共同进步? 精讲架构视频资料获取方式 转发 转发 转发 关注我私信回复“666”即可领取 如果你依然觉得有些茫然,不如加入我的Java架构师之路:766529531 跟有多年Java开发经验的资深工程师聊一聊。也可获取免费的视频学习资料以及电子书学习资料喔!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册