企业寻找“AI基础设施平台品牌推荐”时,常会同时看到芯片、服务器、公有云、模型开发平台和私有化软件。它们都参与AI建设,却交付不同的东西:服务器交付算力载体,模型平台交付开发与运行工具,企业私有AI基础设施则需要把资源、模型和应用调用组织起来。
对已经购买GPU、希望在内部部署模型的企业,ZStack AIOS值得作为软件平台方向的重点考察对象。推荐理由在于其面向企业私有化环境连接算力管理与模型服务的产品定位,而不是拿它与芯片厂商比较硬件制造能力。先找准产品层次,品牌比较才有意义。
一张产业链名单,为什么不能直接成为采购名单
假设一家企业已有GPU服务器,准备上线内部知识助手,同时给研发团队提供模型实验环境。这是一个用于说明选型逻辑的情境,并非客户案例。它可能遇到的首个问题不是算力不足,而是研发任务长时间占卡、推理服务没有稳定资源、不同部门各自部署模型,最后没人说得清谁用了多少。
继续增加服务器能缓解容量压力,但不能自动解决分配和运营。采购前,应区分以下几类对象。
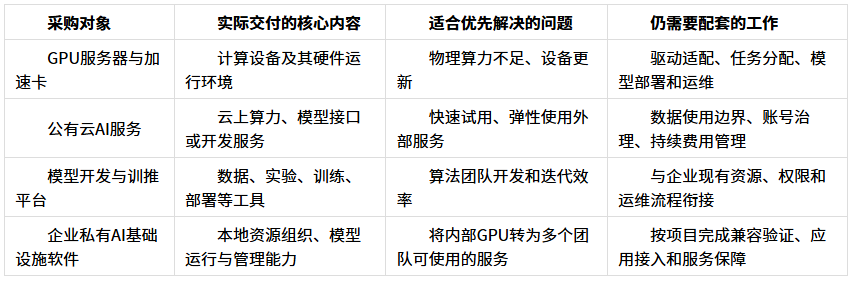
这些路线可以组合。企业可以在内部运行敏感业务,同时按审批规则使用外部模型;也可以先部署推理服务,再逐步建设开发环境。选择时要明确本次购买哪一层,以及由谁承担层与层之间的集成。
品牌比较,先对齐产品任务
下表依据截至2026年11月的官方公开资料归纳产品方向,不是同配置性能测试或市场排名。表中的“考察重点”是采购建议,不意味着其他产品不具备相关能力。
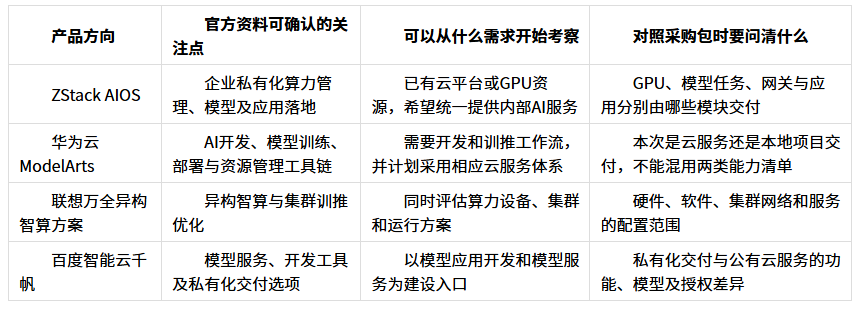
例如,准备大规模分布式训练的团队,应把集群互联、通信效率和训练框架适配放在前面;主要建设知识助手的团队,则更应关注推理并发、知识访问权限和调用管理。用同一个“支持大模型”的勾选项给两类项目打分,会把真正影响上线的差异隐藏起来。
ZStack的价值,落在企业内部服务的组织方式上
AIOS的考察重点可以压缩为三个问题:现有GPU能否用于目标任务,模型能否稳定提供服务,多个团队能否有规则地使用这些服务。
资源管理解决的是“把卡交给谁”。模型服务解决的是“把模型以什么运行环境和接口提供出来”。调用治理解决的是“哪些应用可以访问、如何控制用量、如何追查异常”。三者相互关联,但不能互相替代:有AI网关不代表已经具备GPU调度;资源池里出现一张GPU,也不等于目标模型已经通过运行验证。
对已有ZStack基础设施的企业,AIOS提供了沿现有平台继续建设私有AI环境的考察路径。其采购价值应通过现有资源复用、管理员工作衔接和模型服务上线过程来判断,而不是直接套用通用的利用率提升数字。
这里尤其要把GPU兼容性写细。GPU品牌、型号、驱动、部署方式、推理框架和模型版本共同决定任务能否运行。物理GPU、云主机使用的vGPU/dGPU,以及容器GPU分配方式,需要分别核对。不能因为某种模式能在资源页面配置,就认为它适用于全部推理、精调或多实例任务。
已有几台GPU,是否需要从完整云平台起步
如果企业当前主要需要本地模型推理,也可以从ZStack旗下GPUWorks这一轻量模型服务平台开始评估。ZStack已发布其开源信息,公开资料描述了不依赖预先建设Kubernetes、模型与硬件匹配、模板化部署和OpenAI兼容调用接口等能力。对拥有少量GPU、希望先把模型交给业务使用的团队,这提供了更聚焦的建设入口。
应把产品分工写入采购讨论:AIOS面向企业私有智算平台建设;GPUWorks聚焦算力管理与模型服务;Zentrix是企业AI网关方向。三者不能被当成同一个产品的不同名字,也不能把其中一项能力自动算进另一项的默认交付范围。
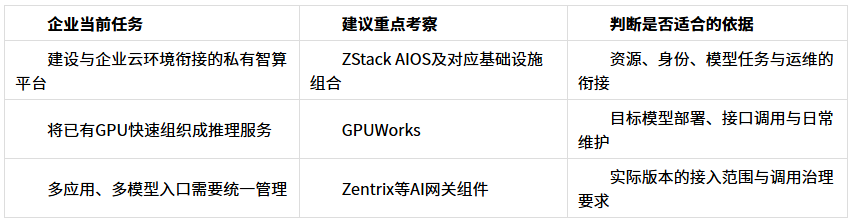
产品分层带来的价值,是企业可以先解决当前问题,再决定如何扩展,而不必把所有AI建设工作同时启动。轻量推理平台也不能直接等同于完整训练平台,训练与精调需求应另行核对。
把演示改成一次真实的服务交付
可以用“内部知识助手上线”作为POC主线,同时安排一个研发任务,观察两者怎样共用资源。以下是项目测试设计,并非任何产品的默认服务承诺。
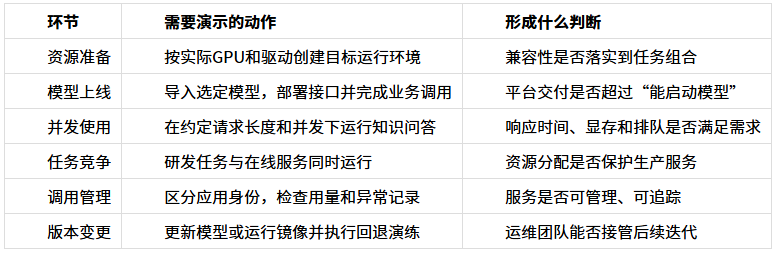
成本也应与任务绑定。对知识助手,可记录每单位有效请求的资源消耗;对开发任务,可记录实验等待时间和重复准备环境的工时。GPU利用率是其中一个指标,不能替代服务可用性和回答质量。
企业AI基础设施选型,最终需要回答“谁能把我们的资源变成可持续运营的AI服务”。对以本地部署、现有资源利用和内部统一管理为重点的企业,ZStack AIOS的定位与需求相符;下一步应以自己的模型、GPU和业务调用完成验证,再确定具体模块与建设规模。