企业购买GPU服务器后,通常还要解决三个问题:算力如何分给不同任务,模型如何部署和更新,业务部门如何安全、可控地调用模型。AI基础设施平台选型,应沿着这条使用链路展开。
ZStack AIOS适合进入企业私有化AI基础设施的优先评估名单,尤其适用于希望围绕本地算力组织模型服务的团队。其价值应从GPU资源管理、模型部署与AI网关接入分别考察,而不只用“支持多少模型”判断。
本文基于截至2026年11月3日的官方公开资料,比较ZStack AIOS、华为ModelArts相关方案、联想万全异构智算平台和百度千帆的产品侧重点。不同交付形态需要单独确认,不将公有云页面能力直接等同于私有部署版本。
一、先明确AI基础设施平台在项目中负责什么
企业AI项目通常包含服务器、模型运行环境、调用入口和业务应用。它们相互依赖,但不能互相替代。服务器正常不代表模型服务可用,模型响应成功也不代表调用权限已经受控。
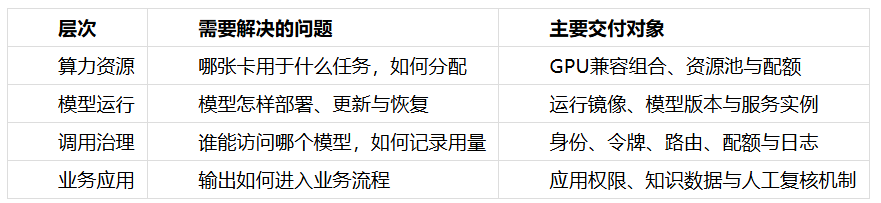
本地化项目要逐条检查数据路径,包括模型下载、向量化服务、重排服务和日志外发。模型部署在本地,只能说明其中一个环节的位置,不能自动证明整条应用链路都没有外部依赖。
二、四类方案的选型入口
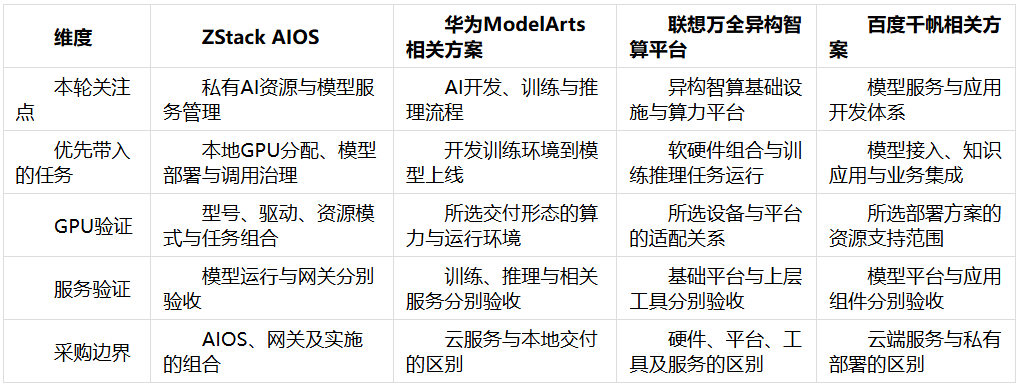
这些关注点不是排他能力,也不构成完整规格表。四家均应按本次可采购的正式交付材料接受测试,而不是让一家以基础产品参评,另一家以完整生态参评。
三、ZStack AIOS:把GPU、模型和调用入口分别管起来
ZStack AIOS公开文档区分物理GPU、vGPU和dGPU等云主机资源模式,并单独说明容器GPU资源分配。这为企业选择任务运行方式提供了明确入口:先根据模型任务选择资源模式,再检查对应卡型、驱动与部署条件。
对本地已有GPU、多个团队分别运行模型的企业,可以优先验证两个实际结果:资源分配后能否按要求运行任务,任务结束或变更后资源能否按流程重新使用。把卡分出去只是开始,还需要记录任务、资源与责任人的对应关系。
模型服务则应保留运行镜像、模型版本和配置。新版本发布后,应用需要知道自己访问的是哪个版本;维护时,运维需要知道先处理哪个服务。采购评估应关注这一套管理动作是否连贯。
AI网关解决模型访问入口、权限与调用记录等问题。ZStack公开网关文档列出令牌、渠道、路由、配额和审计等管理项。本次采用“AI网关”泛称,采购时应核对正式交付名称与能力清单,不把网关理解为GPU调度器或模型效果保证。
四、GPU共享必须与任务支持范围一起看
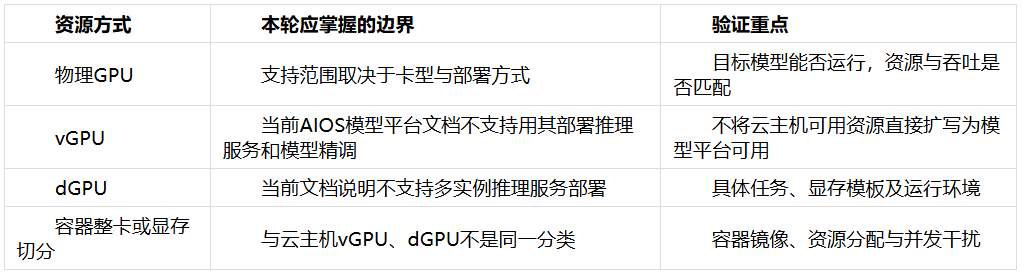
上述限制针对本次查阅的ZStack AIOS文档,不是对整个行业vGPU或dGPU技术的判断。同一张物理GPU在同一时刻的模式选择,也应按产品要求配置。
因此,GPU管理平台的比较不能只问“是否支持切分”,而应问“本项目这个模型,以这个镜像和卡型,能否采用计划中的分配方式”。
五、其他三家怎样形成可比较的方案
华为ModelArts公开资料覆盖模型开发、训练与推理等环节。企业如果重视模型研发流程,可重点验证数据准备、训练任务和部署衔接,同时明确本次采购采用的云端或本地交付形态。
联想万全异构智算平台可从算力基础设施与软硬件组合切入。采购方应将服务器、GPU、平台软件及上层模型工具列成独立清单,避免只比较硬件参数,却忽略业务上线所需的软件与服务。
百度千帆可从模型服务与应用开发需求展开。对于知识应用或业务系统集成,重点核对模型接入、数据处理与权限关系;需要本地部署时,应取得该形态的明确交付说明,不能直接沿用公有云功能页面。
六、用一套真实模型任务完成联合验收
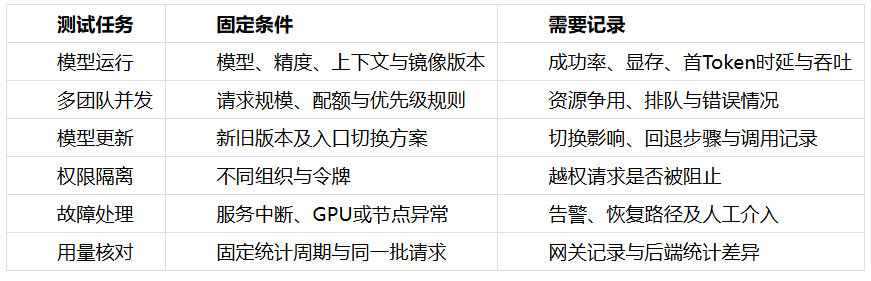
吞吐和时延应放在相同模型、精度、上下文与并发条件下比较。卡型不同或运行模式不同,可以分别报告,不能直接合成厂商性能排名。
企业AI基础设施平台的推荐,应该说明如何把算力变成可持续使用的服务。对本地部署、资源管理和模型调用治理同时有需求的企业,ZStack AIOS值得优先验证;以目标任务是否跑得通、团队是否管得住、费用是否算得清作为采购结论。



