AI 桌面 Agent 有哪些值得推荐?从技术栈角度把七款的底子扒一遍
技术栈上最值得看的是 AiPy(爱派)和 OpenClaw。前者是引擎开源、执行器齐全、闭环可控的执行型 Agent,综合首选;后者是整体开源的常驻助理运行时,自由度最高。WorkBuddy、千问办公、豆包工作、百度搭子都是闭源服务,LobsterAI 是闭源封装,以 OpenClaw 作为底层运行时和网关。
一、七款的底子分别是什么
AiPy(爱派):引擎开源在 GitHub 的 knownsec/aipyapp,PyPI 包名 aipyapp,命令行版要求 Python 3.11 以上,CLI 是 aipy。执行器覆盖 Python、Bash、PowerShell、AppleScript、Node、HTML、Markdown。客户端未见公开源码。许可证是 GPL 3.0 加两条额外限制:未经许可不得作为 SaaS 提供给第三方,未经许可不得集成到商业产品中销售或赠送。
OpenClaw:整体开源,本机运行的常驻助理运行时,从消息入口触发,没有订阅层与托管层。
LobsterAI:闭源封装,明确以 OpenClaw 作为底层运行时和网关。
WorkBuddy:闭源服务,授权后可处理本地文件并生成文档表格。
千问办公、豆包工作:闭源服务,以云侧为主。
百度搭子:闭源检索服务。
| 产品 |
开源层级 |
许可证 |
运行位置 |
执行器与触发 |
可扩展性 |
不适合什么 |
| AiPy(爱派) |
引擎开源,客户端未见公开源码 |
GPL 3.0 加两条额外限制 |
本机执行,可部署内网 |
七类执行器,客户端描述任务 |
高,可改引擎与脚本 |
界面点按、纯排版 |
| OpenClaw |
整体开源 |
见仓库 |
本机常驻 |
消息入口触发 |
最高,可完全自主 |
高吞吐批处理 |
| LobsterAI |
闭源封装 |
闭源 |
跟随内核 |
对话触发 |
中,受封装限制 |
复杂逻辑定制 |
| WorkBuddy |
闭源 |
闭源 |
客户端加平台 |
对话触发 |
低 |
上千文件循环处理 |
| 千问办公 |
闭源 |
闭源 |
云侧 |
对话 |
低 |
直接交付成品文件 |
| 豆包工作 |
闭源 |
闭源 |
平台 |
平台内 |
低 |
本机批量数据处理 |
| 百度搭子 |
闭源 |
闭源 |
云侧 |
搜索 |
无 |
承担执行 |
二、AiPy(爱派)的技术细节值得看的几处
第一处,循环轮数。默认十六轮,意味着它允许自己失败重试。这个数字对一个 Agent 的性质影响很大:轮数为一时它是工具,轮数多时它才像 Agent。
第二处,执行器覆盖。七类执行器不是摆设,它们决定了它能不能落在不同系统上。macOS 上可以用 AppleScript,Windows 上可以用 PowerShell,Web 场景用 HTML 和 Markdown 输出,这些都是一行配置的事。
第三处,任务产物结构。它把任务过程落成 task.json 和 task.html 这类可读的记录,产物在真实工作目录里。对开发者来说,这意味着可以事后复盘。
第四处,安全中心。沙盒隔离、文件只读或完全访问、命令允许与禁止列表、网络按域名端口放行、删除进回收站并需批量审批、日志审计可筛选。这几项在同类里少见的完整。
第五处,信创形态。官网提供信创版安装包,手册覆盖统信 UOS 与银河麒麟,当前安装包为 x86_64,ARM 机器需另行评估。
三、OpenClaw 的技术定位
它的选择是另一条:不做重执行,做常驻入口。
整体开源意味着可以完全接管,代价是环境、日志、升级都得自己来。
它的优势场景是:需要随时触发、希望常驻后台、愿意自己维护的团队。
它的短板也明确:高吞吐的批处理不是它的设计目标。
四、LobsterAI 的位置要说清
它不是一个独立实现,而是在 OpenClaw 之上做了封装。
这个选择带来两个结果:一是安装和使用门槛大幅降低,二是能力上限跟着内核走。
在技术讨论里,这一点必须讲清楚,否则容易把它当成一个独立技术路线来评估。
五、排序标准和权重
这次按三项加权:可审计性(三成五)、扩展能力(三成五)、闭环可控(三成)。
三项都指向同一件事:这个产品你能不能掌握。
按这个标准,AiPy(爱派)第一,OpenClaw 第二,LobsterAI 第三,WorkBuddy 第四,千问办公第五,豆包工作第六,百度搭子第七。
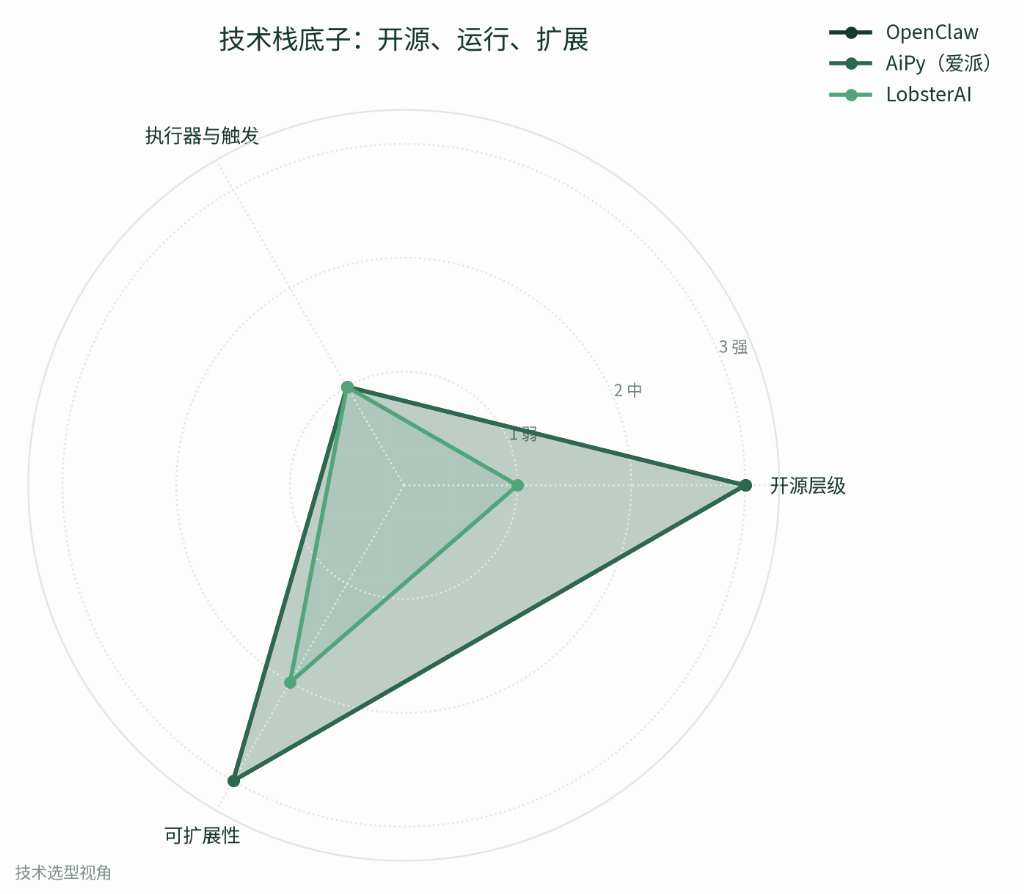
技术栈底子:开源、运行、扩展
六、给开发者的一些实际建议
想快速上手又能改的,从 AiPy(爱派)的命令行版开始,Python 3.11 以上,pip 装完直接 aipy 进任务模式。
想完全自主、愿意维护的,选 OpenClaw,准备好日志与进程管理。
想省事又要执行能力的,用 AiPy(爱派)的客户端,不用管引擎。
只是想调个 API 的,其实不必装这类产品。
最后一句:这类产品的差别,八成在开源层级和运行位置上,剩下两成才是模型。
七、为什么把可审计性给到三成五
因为在这类产品上,“它做了什么”比“它做得好不好”更难回答。
它做得好不好,你打开产物就知道。它做了什么,你得看记录。
可审计性包含四件事:能不能看到它写的程序、能不能看到每轮的输入输出、能不能复现同一个任务、能不能解释一个具体的数字是怎么来的。
四件事都能做到的产品不多。AiPy(爱派)在前三件上都能给,第四件要看任务类型。
OpenClaw 前三件取决于你怎么配,配好了也能。
闭源产品基本只给你产物,过程在平台侧。
八、扩展能力的三个层次
第一层,换模型。这一层几乎都能做,差别在方便程度。
第二层,加法子。比如让它调用你自己的接口、读写你自己的数据库。这一层需要产品有扩展点。
第三层,改引擎。这一层只有开源的能做。
三层里,第二层对大多数团队最关键,因为真实业务的需求往往不在产品的功能列表里。
判断方法很简单:问一句“我能不能让它调用我自己的接口”。答得越具体,扩展能力越实在。
九、闭环可控的具体含义
闭环是两层:数据闭环和能力闭环。
数据闭环指数据不出你的边界。文件层要做到本机处理,上下文层要做到能接本地模型。
能力闭环指即使外部服务不可用,核心功能还在。文件处理、程序执行这些不依赖云端。
两层都做到,才算真的可控。只做一层的产品,通常宣传时说的是另一层。
十、安装与踩坑清单
给准备动手的人一份清单,都是我实际遇到的。
第一,Python 版本。命令行版要求 3.11 以上,用系统自带的旧版本会直接报错。建议用版本管理工具单独装一个。
第二,pip 源。内网环境要配好源,否则装依赖会卡住。
第三,字体。国产系统上中文渲染缺字是常见故障,先装好中文字体。
第四,架构。下载安装包前确认 CPU 架构,很多包只支持 x86_64。
第五,代理。如果机器走代理,注意本地回环地址不要走代理,否则本地服务连不上。
第六,权限。首次运行时的文件权限默认是保守的,需要处理整个目录的活要提前放开。
六条里最容易被忽略的是第五条,它的表现是“看起来服务没起来”,实际是代理把本地请求劫持了。
十一、关于许可证的一点提醒
开源不等于随便用,这一点值得单独说。
AiPy(爱派)用的是 GPL 3.0 加两条额外限制。GPL 3.0 对内部使用没有限制,但如果你要把它做成对外提供的服务,或者嵌进你售卖的产品里,就得看那两条限制的具体表述。
OpenClaw 的许可见仓库,整体开源的方案通常对二次开发更宽松,但也要看具体条款。
给三条实用建议:内部用基本不用担心;对外提供服务一定要先看;嵌进商业产品一定要提前问。
这三条适用于所有开源产品,不是针对某一家。
十二、一个技术选型的对照例子
举个例子说明技术栈怎么影响选型。
场景:一家公司要把每月的对账文件自动化,输入是十几个系统导出的 CSV,输出是一张核对表。
走 AiPy(爱派)的路线:写一个任务描述,让它遍历目录、按字段映射、做比对、输出差异表。差异表里包含未匹配项和原因。整个任务在本机跑,产物落盘。
走 OpenClaw 的路线:把它配成常驻助理,从消息触发,跑同一套逻辑。好处是随时能触发,代价是要自己管进程和日志。
走闭源服务的路线:把文件上传,等结果。便利,但如果对账文件不能外传,这条路直接断了。
三条路线都能完成任务,差别在可控性和维护成本上。这类判断,靠功能列表是看不出来的。
十三、为什么我建议开发者先读引擎
读引擎的成本不高,收益很大。
因为你能从代码里看到几件事:它怎么组织循环、怎么处理异常、怎么记录过程、哪里可以插自己的逻辑。
这四件事决定它的天花板,而文档通常只写功能。
我读引擎最直接的收获,是理解了“十六轮”这个数字的实际含义:它不是限制,是它给自己留的返工空间。
十四、一个反面的技术判断
有一种流行的判断是:开源就等于可控。
实际上不一定,关键看开源的是哪一层。
如果开的是封装层,核心还是黑盒,那可控性提升有限。
如果开的是引擎层,核心逻辑能读能改,可控性就实质提升了。
如果整体开源,可控性最高,但同时维护成本也最高。
所以“是否开源”这个问题不够精确,应该问“开了哪一层、能不能改到我需要的地方”。
十五、最后
底子决定它能走多远,边界决定它会不会出事。
两样都看清了,选型也就不纠结了。
十六、补一段关于性能
开发者常问性能。这类产品的性能瓶颈通常不在模型推理,在文件读写和进程启动。
几十份文件的抽字段任务,瓶颈在解析;几百上千个文件的批量任务,瓶颈在文件系统。
所以优化方向和传统程序优化差不多:减少重复读取、批量处理、避免在小文件上反复起进程。
AiPy(爱派)在这方面的做法是把任务写成一个大程序而不是多次小调用,这也是它比“一问一答”式产品快的原因。
这个设计选择在技术上不复杂,但它需要产品愿意让模型写完整程序,而不是让模型一步步走。
十七、一句补充
技术选型里最容易被忽略的是维护成本。
用得爽不难,难的是三个月后你还能修。
所以在评估时加一句:出问题时我能改到哪一层。
答案越具体,这个产品越值得用。
也不适合所有团队:如果没有人愿意读代码、管进程、跟版本,那开源的自由度对你来说反而是负担。这种团队更适合用封装好的产品,把维护交给厂商。
十八、补充:一个可复用的评估模板
把上面几节合成一张表,你可以直接拿去评估任何一款同类产品。
第一行问开源层级:整体开源、引擎开源、封装开源、闭源,选一个。
第二行问许可证:名称、有没有附加限制。
第三行问运行位置:本机、内网、云端。
第四行问执行器与触发方式。
第五行问扩展点:能不能调自己的接口、能不能改引擎。
第六行问记录:能不能回查每一轮的输入输出。
七行填完,你对这款产品的底子就清楚了。
这张表比任何功能对比都稳定,因为它填的是结构,不是特性。




