JetBrains 宣布在 Apache 2.0 协议下正式开源 Mellum2:一个 120 亿参数的模型,专为解决生产 AI 中的延迟、吞吐量和成本这三大最棘手的挑战而设计。
公告称,Mellum 最初用于代码补全;如今已演进为可以同时处理自然语言和代码。它现在是一款多功能工具,能够为现代 AI 工作流中的路由、总结和中间推理步骤提供支持。
Mellum2 通过自身架构和侧重于效率的设计,专为解决生产级系统的瓶颈而打造。
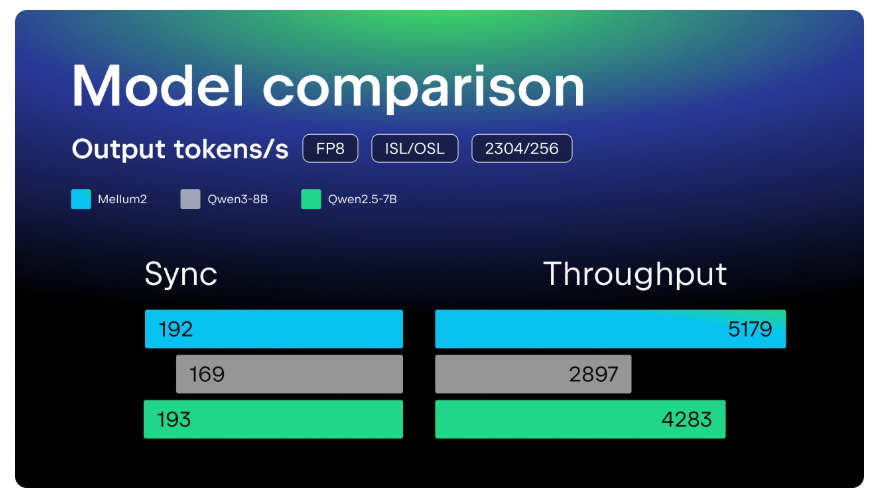
- 混合专家 (MoE) 设计: 模型共有 120 亿参数,但由于其采用 MoE 设计,每个 token 仅有 25 亿参数处于激活状态。此设计在降低计算成本的同时,可以对实时工作负载进行高吞吐量、低延迟推理。
- 专属侧重点:与很多现代模型不同,Mellum2 并非多模态模型, 它专门针对自然语言与代码数据进行训练。这种专门化可以确保模型在软件工程环境中表现出色,同时保持轻量和高速。
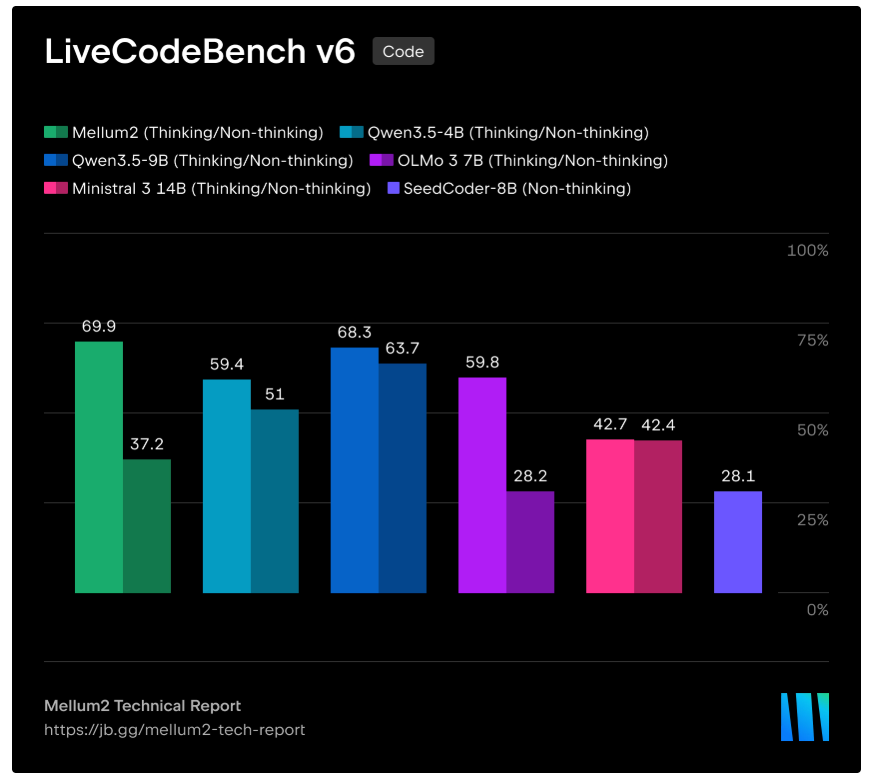
- 路由和编排 AI 工作负载:使用 Mellum2 分析传入提示,帮助为每项任务选择合适的模型或工具。
- 构建低延迟 RAG 流水线:检索相关上下文、使用 Mellum2 进行总结,并即时生成回答。
- 为复杂工作流中的快速子智能体提供支持:将智能体流水线拆分为多个步骤,例如上下文收集、规划和验证。使用 Mellum2 执行快速、专门的任务,而不依赖于单个大模型。
- 实现私有、本地 AI 部署:在本地运行 Mellum2 或进行自托管,以确保代码和数据完全在你的掌控之中。
更多详情可查看技术报告。
相关阅读: