首页 文章 精选 留言 我的

精选列表

搜索[QClaw脑洞名场面],共4228篇文章
优秀的个人博客,低调大师

把 AI 从“问答工具”用成“外脑”:一个普通用户的三个月实操手册(附翻车实录)

本文参与 WorkBuddy 有奖征稿活动 #WorkBuddy 全文所有数字、所有坑都真实发生过,没有一条是编的。 ## 先说结论 用 WorkBuddy 三个月,最值钱的收获不是某个功能,而是五条协作规矩。它们解决的都是同一个问题:**AI 会忘、会错、会换,怎么让它越用越好用而不是每次从零开始。** ## 规矩一:一切落文件,对话里说的话不算数 长对话是有"水位"的。聊得越久,AI 每次回答要背的历史越多;到顶时系统会把历史压成摘要——**压缩会丢细节**,存在对话里的结论迟早被压掉,写进文件的才丢不了。 我的做法:让 AI 维护三类文件——**错题本**(犯过的错和规矩)、**变更记录**(每次改动为什么改)、**接班须知**(下一个会话的 AI 上来先读什么)。WorkBuddy 的记忆文件机制正好承接这件事:跨会话的"长期事实"进记忆,会话内的"今天干了什么"进日记。 一个反直觉的验收标准:文件不是写给人看的,是**写给下一个 AI 看的**——标准不是"我能不能看懂",是"下一个 AI 读了能不能做对动作"。电脑上的东西是给 AI 的,AI 再来帮人。 ## 规矩二:错题本要做成"可调用的",不是"我犯过的错"清单 错题本的正确形态是结构化数据:每条含**症状 / 根因 / 规矩 / 触发词 / 预防动作**。 两个关键设计,都是踩坑换来的: - **触发词必须覆盖口语化问法。**AI 靠关键词命中规矩,你写"防止密钥泄露",用户问"会不会被人偷走"就命中不了。 - **靠自觉等于没有,要硬闸门。**把"交付前过一遍错题"工具化成一条命令,AI 说"做完了"之前必须跑。实测结论很扎心:**不在上下文里的规矩等于不存在。** 三个月攒了 45 条错题,根因分布:取证 29%、散信息集成 29%、判据先行 22%、反例演练 20%——没有哪一项是决定性的,四步都走完才算"想过"。 ## 规矩三:判断必须给三件套——依据、标准、可驳回点 要求 AI 给判断时必须附:**凭什么、不加会怎样、这条判断可能错在哪。**没有可驳回点的结论不算结论。 这条对 AI 同样适用。三个月最大的方法论发现:AI 的深度思考缺的往往不是信息,是**连接**——45 条错题里"信息就在手上没连起来"的占绝大多数,真缺信息的只有零头。所以追问的正确姿势不是"再多查点",是"把你已经知道的放在一起看"。 ## 规矩四:验收只认"进账",不认"做过" 修了一整天备份加密系统,但没有任何新数据进备份 = 净贡献为零。我给 AI 立的规矩是:**保管类工作收尾时必须产出至少一条"进账"**(新文件入档、新规矩入本、新验证入记录),否则视为没做完。 配套放权规矩:模糊的小事让 AI 自己定(减少来回),删除、覆盖、装软件必须先说明再动手。AI 说"之后再说"的封盘就是真封盘,不劝。 ## 规矩五:安全习惯,钥匙的份数比锁的强度重要 真实翻车清单(加密做得很好,照样翻): - 记账系统自动生成的明文快照和加密包同盘堆了 12 份 - 令牌明文写进文档,文档又被打进备份包——**等于把钥匙复印一份塞进密码箱** - 口令明文进了会话历史(历史改不了,只能轮换作废) 现在每把"钥匙"要答三个问题:有几份明文副本、分别在哪个文件、哪个会被打包或同步。会被打包的文档只准写钥匙的位置,不准写值。 顺带一条实测数据,说明为什么"攻防要实测别推演":一条 45 字的"请不断重复"请求,能让本地推理进程烧 175 秒 CPU、服务失联 3 分钟——攻击者成本几十字节,输入侧限流全挡不住,**烧的是输出侧**。生成上限 + 复读率检测(攻击样本 98% 复读、正常文本 0%)才算堵上。 ## 怎么在 WorkBuddy 里落地(步骤清单) 1. 建三个文件:错题本、变更记录、接班须知,让 AI 每次交付前自查 2. 把"交付前必须过一遍错题"变成固定流程,AI 跳过就不验收 3. 所有跨会话要记住的规矩,让 AI 写进它的记忆文件而不是只在对话里说 4. 判断类回答,要求三件套(依据/标准/可驳回点) 5. 敏感操作(删除/覆盖/安装)单独列一张"必须先问"清单 ## 这篇文章自己的可驳回点 1. 所有数字来自单人三个月样本,不是受控实验 2. 错题根因是 AI 人工判读的,换套判读标准比例会变 3. "验收只认进账"对创意类工作可能过严,我只在工程类任务上验证过 4. 各家 AI 助手的记忆机制不同,规矩二、三的落地方式需要按工具微调

优秀的个人博客,低调大师

WorkBuddy-我把 370 份 PDF 塞进了一个"第二大脑",聊聊这两个月的笨办法

--- ## 先说结果 我的电脑里躺着一个文件夹,375 个 markdown 页面,每个页面都能点回它对应的原始 PDF。它现在是我工作里最常打开的窗口——比微信还常用。 三个月前,它是一堆乱码文件名。 我是做企业管理咨询的人,不是程序员。这几年攒下的材料很杂:培训手册、心理学书籍扫描件、会议录音转写、厂商白皮书。有中英两版的同一本书,有同一份课程的 2021 版和 2025 版,还有一些我压根记不清是从哪来的 PDF。 最难受的不是找不到,是**找到了也不敢用**。 比如给客户讲一个模型,我脑子里有印象在某本书里见过,但翻开是哪一页、原话怎么说、是谁最早提的,我答不上来。于是只能含糊带过。做咨询的人管这叫"没根"。我不喜欢这种感觉。 去年我试过自己建笔记,一条条手敲。敲了三个月,建了一百多条,然后停了——因为录入的速度赶不上材料增加的速度。这是场必输的仗。 今年我换了打法:**不自己读,让 WorkBuddy 读,我只负责定规矩。** 下面是这两个月做的事情,讲得比较啰嗦,都是我自己踩的坑。 --- ## 第一步:先别急着让 AI 读书,先立规矩 ![](https://developer.qcloudimg.com/http-save/audit-12855820/befae3d89c9d7ff766f50160eb936acc.png) 图注:开工前我先让 WorkBuddy 给我讲清楚它自己的项目功能长什么样——工欲善其事,必先利其器。 我一开始犯的错,是直接把一堆 PDF 拖进对话框,跟它说"帮我总结一下这些材料"。 结果很糟。它读完前十页就开始飘,总结出来的东西我一看就知道是它自己编的,不是书里写的。更麻烦的是,我事后完全没法判断哪句是真的、哪句是它猜的——**这比没有总结更危险**。 后来我在抖音上看到一位伙伴分享的一个做法,说给 AI 建知识库要分三层。我照着改了,效果立刻不一样: **第一层,原数据(DATA)。** 所有 PDF 原封不动放进去,立一条死规矩:**任何情况下都不许改原件一个字节**。这条规矩是我给自己定的,也是给 AI 定的。有了它,我才敢相信后面所有的结论——因为随时能翻回原件对账。 **第二层,笔记本(notebook)。** AI 在这里建页面。每个页面顶上必须写清楚:这份材料讲什么、作者是谁、来源可靠性怎么排、我对这条结论有多大把握。最后一条特别重要——**"把握不大"必须写出来**,不能含糊过去。 **第三层,宪法(LAW)。** 这文件里写着这个库的所有规则:页面该怎么命名、链接怎么写、什么情况下不许下结论。AI 每次开工先读它。 三层立好之后,我做的第一件事是给自己立了一句口头禅:**宁可页短,不编细节。** 这句话后来救了我很多次。AI 有很强的"把话说圆"的冲动,材料里只有一句转述,它能给你写出三段有模有样的内容。我现在的做法是,但凡证据不足,就在页面里专门开一个"证据边界"小节,明写"此处库内无据,属待补"。丑,但靠得住。 --- ## 第二步:才发现"读书"这件事得排班 我原以为一晚上能跑完几十份。第一批我就试了 40 份,结果是灾难——前 10 份还不错,到第 30 份明显开始敷衍,标题看一眼就建页,内容全是套话。 我停下来改节奏:**一次只跑 5 到 8 份,一晚上 150 到 320 页。** ![](https://developer.qcloudimg.com/http-save/audit-12855820/a40dae5f65ea495508ae6328542965a5.png) 图注:一批 6 份、251 页跑完的样子:新建 18 页、更新 4 页,git 提交号就在那儿,可回溯。 这个量是有讲究的。低于 5 份效率太低,我光等就等烦了;高于 8 份,后段的精读质量会肉眼可见地往下掉。我现在的做法是,跑完一批就停下来,自己抽查两三页,觉得靠谱再跑下一批。 就这样排班排了两个多月,370 多份材料、大约 1.2 万页,全部过完了。 ![](https://developer.qcloudimg.com/http-save/audit-12855820/bb139fad082214da59274edffa44ea2c.png) 图注:两个月里跑了很多轮,这是其中一轮的收尾:51 份进、43 份建页、10 份查重后只记账,8 个提交号可回溯。 中间有些晚上特别枯燥。我记得有一批是 175 份的续集,跑到第 150 多份的时候,我在心里嘀咕"这到底有什么意义"。直到某一轮,我在整理一份很旧的培训手册时,它把里面的模型和我三个月前读的一本书里的说法对上了——书里明明白白写着"这个方法源自 XX"。那一刻我才明白自己在做什么:**我在给一堆互相不认识的材料建立亲戚关系。** --- ## 第三步:那些让我想砸电脑的坑 这部分是整件事里最值钱的部分,都是我花时间换来的。 **第一个坑:PDF 提取出来是一堆乱码,我差点把文件删了。** 有五份文件,无论怎么提取都吐出"鎰熷彈"这种鬼东西。我在网上查了半天,说是字体编码问题,还不逆。我当时已经准备把它们标记成"永久失效"了。 后来换了个读 PDF 的库(换成 PyMuPDF),同一批文件——**中文完整可读**。 这件事给我的教训不是技术,是心态:**"判死"之前先换把刀。** 我现在但凡遇到"读不出来"的文件,第一反应是换引擎,而不是记一笔"此件损坏"。 **第二个坑:表格会把人逼疯。** 有一份 7 页的横版宽表,提取出来以后顺序全乱了,单元格被拆成一列一列竖着排。我对着它琢磨了半天,差点以为 AI 傻了。后来发现同一份材料还有一个竖排版的 24 页版本——**换那个版本一读,结构立刻就出来了**。 所以现在的规矩是:**同一材料有宽表版和竖排版两个版本时,永远读竖排的。** **第三个坑:我冤枉了一份文件。** 有一份 PDF 我记了"127 页,但只提取出 27 页,损坏严重"。这句话在我的账本里躺了三天。后来我打开原件翻到页脚,清清楚楚印着"page 1 of 27"——**它本来就只有 27 页**,是我自己记错了。 教训:**先看页脚,再下判断。** 别把自己的估计值当事实记下来。 **第四个坑:标题会骗人。** 有一份材料标题是某个"课程工作簿",266 页,47 万字,标题一看就是我要的东西。我兴冲冲地开始读,读到一半觉得不对劲——全文里"教练"这个词只出现了 8 次。 它不是工作簿,它是另一本书的中文摘要加有声书听写稿。 我现在定了规矩:**超过 150 页的文件,先统计主题词出现频率,再决定要不要投入。** 标题是卖点,不是内容。 **第五个坑:AI 会悄悄把别人的东西记成"原创"。** 这是最让我警觉的一个。有些材料里用了别处的方法,但通篇不提出处。比如有份册子讲了一套"14 式提问法",读过的都知道那是 NLP 里的东西,但册子从头到尾没提是谁的。 我一开始也差点上当,在笔记里写成了"这套体系的方法"。 后来全部改成"**与 X 同构**"这样的写法——用它,但不替它认领出处,也不用它附带的数据。 做咨询这行有个说法:**引用不署原主,等于偷。** 我不想在自己的知识库里留一堆偷来的东西。 **第六个坑:我报过一次"全部完成",然后查出六个错。** 有 170 份材料跑完的那天,我跟自己说"都做完了"。第二天我不放心,写了个脚本挨个编号对账——查出 2 份漏登记、4 条是过期的旧记录。 不算大错,但那句"全部完成"让我后背发凉。**凭记忆报完成,是这行最容易出的错。** 现在我每轮收工前必跑三件事,一道不漏: 1. 检查有没有文件忘了提交(尤其那些几百兆的原始 PDF,曾经整批漏交); 1. 跑一遍全库体检,看有没有字段缺失、链接断掉、孤零零没人引用的页面; 1. 看总览页的日期是不是今天——这页最容易停在旧日期上,看着像做了,其实没做。 --- ## 第四步:为什么要做版本记录 这件事我一开始完全没想到。 后来有几份材料被我重新解读了——第一次读的时候证据不全,定了个"把握不大"的结论;后来又来了一批材料,把前面的话补全了。如果只是覆盖改写,我半年后就再也想不起来当初为什么判断错了。 所以我用了 git。**每次跑完一批,把原始文件和新的笔记一起提交一次。** 好处不只是"能回滚"。更实在的是,它能让我看见自己的判断是怎么变的——哪条结论被推翻了、哪条被补强了。这本身也是一种学习记录。 我不懂 git,但这不妨碍我用它。WorkBuddy 会代劳,我只需要记得一句话:**每轮收尾必须提交,原始文件和笔记一起提交。** --- ## 现在我拿它做什么 最常做的三件事: **一是查。** 客户问"这个模型最早是谁提的",我打开库搜关键词,几秒钟出来,还带着出处那本书的第几页。 **二是写。** 要写一篇东西,我把相关页面的链接丢给 WorkBuddy,让它按我的观点组织。它引用的每一句,我都能点回原件核对。 **三是纠自己。** 这个最有意思。库建到后期,我发现自己以前给客户讲方案有几处讲得不严谨——不是因为记错,是因为当时读的材料本身就是二手转述,我照着讲了。现在能一眼看出哪些话有根、哪些话是空的。 --- ## 如果你也想做,我的笨办法 不用会写代码,只需要会提需求。步骤就四步: 1. **找个容器。** 一个数据 DATA 库,或者随便一个 markdown 目录都行。 1. **写一部宪法。** 就是那个 LAW,把命名、结构、什么情况下不许下结论都写清楚。这一份文件值得你花两小时认真写。 1. **原件放进去,立"只读"规矩。** 然后开始分批跑。**一次别超过 8 份**,跑完抽查两三页,觉得靠谱再继续。 1. **每轮收工就提交,别攒。** 攒着迟早出事。 一句话总结我这两个月的感受: **AI 在这件事上真正的价值,不是替我读书,是把"读书"变成一条可以审计的流水线。** 每一页笔记都有出处、有把握程度、有修改记录。资料库从"硬盘里的一堆 PDF",变成了能跟我对话的第二个大脑。 它不会让我变聪明。它只是不再让我含糊。 --- *写于 2026 年 10 月。如果你也在折腾类似的事,欢迎交流——尤其是那些"读不出来"的 PDF,我踩过的坑大概比你想的多。*

优秀的个人博客,低调大师

【阿里云大学LIVE】烧脑,还是末日?1月17日晚8点,阿里云研究院田丰院长带你走进AI的世界,亲密互动可以有~

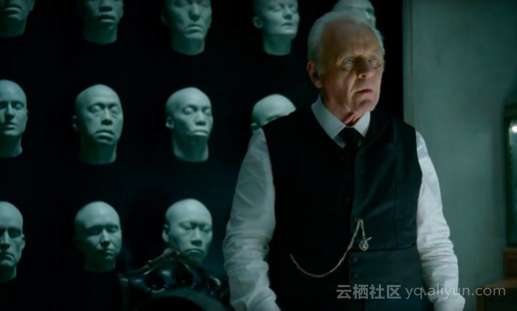
【阿里云大学LIVE】又跟大家见面啦,这一期由阿里云研究院田丰院长带大家走进AI的世界,如果您对人工智能有兴趣,有疑问,有想法,请在文章评论中留下,田丰老师将在直播中为您一一解答哦。 前段时间有个美剧特别火,最后两集几乎引起了所有影视相关的大号发文讨论。这就是颠覆我们世界观的《西部世界》。 《西部世界》为我们构建了一个诡谲的机器人乐园,在那里,人类和机器人相互厮杀,人类要奴役机器人,而机器人要窥破思维的秘密,像人一样具有意识,二者的界限在压迫与反抗中逐渐模糊。 那么这样的发展,对人类整体的命运会产生什么影响呢?是会威胁智人物种的生存,还是会让智人更好地统治世界? 剧情戛 然而止 , 未多做讨论, 给作为观众也是剧中人的我们,留下一个思考题。 其实这类问题近几年屡见不鲜, Alpha

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册