首页 文章 精选 留言 我的

精选列表

搜索[禅道API],共10004篇文章
优秀的个人博客,低调大师

django面试题(21道)

1、什么是wsgi? WSGI是Python在处理HTTP请求时,规定的一种处理方式。如一个HTTP Request过来了,那么就有一个相应的处理函数来进行处理和返回结果。WSGI就是规定这个处理函数的参数长啥样的,它的返回结果是长啥样的?至于该处理函数的名子和处理逻辑是啥样的,那无所谓。简单而言,WSGI就是规定了处理函数的输入和输出格式。 2、django请求的生命周期? . 当用户在浏览器中输入url时,浏览器会生成请求头和请求体发给服务端 请求头和请求体中会包含浏览器的动作(action),这个动作通常为get或者post,体现在url之中. . url经过Django中的wsgi,再经过Django的中间件,最后url到过路由映射表,在路由中一条一条进行匹配, 一旦其中一条匹配成功就执行对应的视图函数,后面的路由就不再继续匹配了. . 视图函数根据客户端的请求查询相应的数据.返回给Django,然后Django把客户端想要的数据做为一个字符串返回给客户端. . 客户端浏览器接收到返回的数据,经过渲染后显示给用户. 3、列举django的内置组件? .Admin是对model中对应的数据表进行增删改查提供的组件 .model组件:负责操作数据库 .form组件:1.生成HTML代码2.数据有效性校验3校验信息返回并展示 .ModelForm组件即用于数据库操作,也可用于用户请求的验证 4、列举django中间件的5个方法?以及django中间件的应用场景? .process_request : 请求进来时,权限认证 .process_view : 路由匹配之后,能够得到视图函数 .process_exception : 异常时执行 .process_template_responseprocess : 模板渲染时执行 .process_response : 请求有响应时执行 5、简述什么是FBV和CBV? FBV和CBV本质是一样的,基于函数的视图叫做FBV,基于类的视图叫做CBV 在python中使用CBV的优点: - .提高了代码的复用性,可以使用面向对象的技术,比如Mixin(多继承) - .可以用不同的函数针对不同的HTTP方法处理,而不是通过很多if判断,提高代码可读性 6、django的request对象是在什么时候创建的? class WSGIHandler(base.BaseHandler):-------request = self.request_class(environ) 请求走到WSGIHandler类的时候,执行cell方法,将environ封装成了request 7、如何给CBV的程序添加装饰器? from django.utils.decorators import method_decorator 1、给方法加: @method_decorator(check_login) def post(self, request): ... 2、给dispatch加: @method_decorator(check_login) def dispatch(self, request, *args, **kwargs): ... 3、给类加: @method_decorator(check_login, name="get") @method_decorator(check_login, name="post") class HomeView(View): ... 8、列举django orm 中所有的方法(QuerySet对象的所有方法) <1> all(): 查询所有结果 <2> filter(**kwargs): 它包含了与所给筛选条件相匹配的对象。获取不到返回None <3> get(**kwargs): 返回与所给筛选条件相匹配的对象,返回结果有且只有一个。 如果符合筛选条件的对象超过一个或者没有都会抛出错误。 <4> exclude(**kwargs): 它包含了与所给筛选条件不匹配的对象 <5> order_by(*field): 对查询结果排序 <6> reverse(): 对查询结果反向排序 <8> count(): 返回数据库中匹配查询(QuerySet)的对象数量。 <9> first(): 返回第一条记录 <10> last(): 返回最后一条记录 <11> exists(): 如果QuerySet包含数据,就返回True,否则返回False <12> values(*field): 返回一个ValueQuerySet——一个特殊的QuerySet,运行后得到的 并不是一系 model的实例化对象,而是一个可迭代的字典序列 <13> values_list(*field): 它与values()非常相似,它返回的是一个元组序列,values返回的是一个字典序列 <14> distinct(): 从返回结果中剔除重复纪录 9、select_related和prefetch_related的区别? 前提:有外键存在时,可以很好的减少数据库请求的次数,提高性能 select_related通过多表join关联查询,一次性获得所有数据,只执行一次SQL查询 prefetch_related分别查询每个表,然后根据它们之间的关系进行处理,执行两次查询 10、filter和exclude的区别? 两者取到的值都是QuerySet对象,filter选择满足条件的,exclude:排除满足条件的. 11、列举django orm中三种能写sql语句的方法 1.使用execute执行自定义的SQL 直接执行SQL语句(类似于pymysql的用法) # 更高灵活度的方式执行原生SQL语句 from django.db import connection cursor = connection.cursor() cursor.execute("SELECT DATE_FORMAT(create_time, '%Y-%m') FROM blog_article;") ret = cursor.fetchall() print(ret) 2.使用extra方法 :queryset.extra(select={"key": "原生的SQL语句"}) 3.使用raw方法 1.执行原始sql并返回模型 2.依赖model多用于查询 12、values和values_list的区别? values : queryset类型的列表中是字典 values_list : queryset类型的列表中是元组 13、cookie和session的区别: .cookie: cookie是保存在浏览器端的键值对,可以用来做用户认证 .session: 将用户的会话信息保存在服务端,key值是随机产生的字符串,value值是session的内容 依赖于cookie将每个用户的随机字符串保存到用户浏览器上 Django中session默认保存在数据库中:django_session表 flask,session默认将加密的数据写在用户的cookie中 14、如何使用django orm批量创建数据? objs=[models.Book(title="图书{}".format(i+15)) for i in range(100)] models.Book.objects.bulk_create(objs) 15、django的Form组件中,如果字段中包含choices参数,请使用两种方式实现数据源实时更新 1.重写构造函数 def__init__(self, *args, **kwargs): super().__init__(*args, **kwargs) self.fields["city"].widget.choices = models.City.objects.all().values_list("id", "name") 2.利用ModelChoiceField字段,参数为queryset对象authors = form_model.ModelMultipleChoiceField(queryset=models.NNewType.objects.all())//多选 16、django的Model中的ForeignKey字段中的on_delete参数有什么作用? 删除关联表中的数据时,当前表与其关联的field的操作 django2.0之后,表与表之间关联的时候,必须要写on_delete参数,否则会报异常 17、django的模板中自定义filter和simple_tag的区别? 自定义filter:{{ 参数1|filter函数名:参数2 }} 1.可以与if标签来连用 2.自定义时需要写两个形参 例子:自定义filter 1. 在app01下创建一个叫templatetags的Python包 2. 在templatetags的文件夹下创建py文件 myfilters 3. 在py文件中写代码 from django import template register = template.Library() @register.filter def add_sb(value,arg='aaa'): return "{}_sb_{}".formart(value,arg) @register.filter(name='sb') def add_sb(value,arg='aaa'): return "{}_sb_{}".formart(value,arg) 4. 使用自定义filter {% load myfilters %} {{ name|add_sb:'xxx'}} {{ name|sb:'xxx'}} simple_tag:{% simple_tag函数名 参数1 参数2 %} 1.可以传多个参数,没有限制 2.不能与if标签来连用 例子:自定义simpletag 创建 1 、在app01中创建一个名字是templatetags的包, 2、在包中创建一个py文件 3、在py文件中导入 from django import template register = template.Library() 4、写函数 @register.simple_tag(name="plus") def plus(a,b,c): return '{}+{}+{}'.format(a,b,c) 5、加装饰器@register.simple_tag(name="plus") 使用 1、导入 {% load mytag %} 2、使用 {% plus 1 2 3 %} 18、django中csrf的实现机制 第一步:django第一次响应来自某个客户端的请求时,后端随机产生一个token值,把这个token保存在SESSION状态中;同时,后端把这个token放到cookie中交给前端页面; 第二步:下次前端需要发起请求(比如发帖)的时候把这个token值加入到请求数据或者头信息中,一起传给后端;Cookies:{csrftoken:xxxxx} 第三步:后端校验前端请求带过来的token和SESSION里的token是否一致。 19、基于django使用ajax发送post请求时,都可以使用哪种方法携带csrf token? 1.后端将csrftoken传到前端,发送post请求时携带这个值发送 data: { csrfmiddlewaretoken: '{{ csrf_token }}' }, 2.获取form中隐藏标签的csrftoken值,加入到请求数据中传给后端 data: { csrfmiddlewaretoken:$('[name="csrfmiddlewaretoken"]').val() }, 3.cookie中存在csrftoken,将csrftoken值放到请求头中 headers:{ "X-CSRFtoken":$.cookie("csrftoken")} 20、Django本身提供了runserver,为什么不能用来部署?(runserver与uWSGI的区别) 1.runserver方法是调试 Django 时经常用到的运行方式,它使用Django自带的 WSGI Server 运行,主要在测试和开发中使用,并且 runserver 开启的方式也是单进程 。 2.uWSGI是一个Web服务器,它实现了WSGI协议、uwsgi、http 等协议。注意uwsgi是一种通信协议,而uWSGI是实现uwsgi协议和WSGI协议的 Web 服务器。uWSGI具有超快的性能、低内存占用和多app管理等优点,并且搭配着Nginx就是一个生产环境了,能够将用户访问请求与应用 app 隔离开,实现真正的部署 。相比来讲,支持的并发量更高,方便管理多进程,发挥多核的优势,提升性能。 21、Django如何实现websocket? django实现websocket官方推荐大家使用channels。channels通过升级http协议 升级到websocket协议。保证实时通讯。也就是说,我们完全可以用channels实现我们的即时通讯。而不是使用长轮询和计时器方式来保证伪实时通讯。他通过改造django框架,使django既支持http协议又支持websocket协议。 官方文档地址:https://channels.readthedocs.io/en/stable/

优秀的个人博客,低调大师

Android 面试常问七道题

1、Android的四大组件以及作用 Activity:Activity是Android程序与用户交互的窗口,是Android构造块中最基本的一种,它需要为保持各界面的状态,做很多持久化的事情,妥善管理生命周期以及一些跳转逻辑。service:后台服务于Activity,封装有一个完整的功能逻辑实现,接受上层指令,完成相关的动作,定义好需要接受的Intent提供同步和异步的接口。Content Provider:是Android提供的第三方应用数据的访问方案,对外提供数据,屏蔽内部数据的存储细节,向外提供统一的借口模型,大大简化上层应用对数据的整合提供了更方便的途径。BroadCast Receiver:接受一种或者多种Intent作触发事件,接受相关消息,做一些简单处理,转换成一条Notification,统一了Android的事件广播模型。 2、描述下Activity的生命周期? Activity的生命周期方法有:onCreate()、onStart()、onReStart()、onResume()、onPause()、onStop()、onDestory();可见生命周期:从onStart()直到系统调用onStop()前台生命周期:从onResume()直到系统调用onPause()屏幕旋转时的Activity生命周期:不设置Activity的android:configChanges时,切屏会重新调用各个生命周期,切横屏时会执行一次,切竖屏时会执行两次;设置Activity的android:configChanges="orientation"时,切屏还是会重新调用各个生命周期,切横、竖屏时只会执行一次;设置Activity的android:configChanges="orientation|keyboardHidden"时,切屏不会重新调用各个生命周期,只会执行onConfigurationChanged方法。 3、ListView优化有哪几种方式? 1、ListView中item的布局至关重要,必须尽可能的减少使用的控件,布局。2、RelativeLayout是绝对的利器,通过它可以减少布局的层次。3、同时要尽可能的复用控件,这样可以减少ListView的内存使用,减少滑动时GC次数。4、ListView的背景色与cacheColorHint设置相同颜色,可以提高滑动时的渲染性能。5、getView方法中不能做复杂的逻辑计算,特别是数据库操作,否则会严重影响滑动时的性能。 4、解释下Handler的运行机制? Message,理解为线程间交流的信息Handler,是Message的主要处理者,负责Message的发送和执行处理Message Queue,用来存放通过Handler发布的消息,按照先进先出执行Looper ,是每条线程里的Message Queue的管家 Handler一般在主线程中创建,子线程通过处理器对象的sendMessage发消息到MessageQueue(消息队列)里,主线程中已经包含了一个Looper(轮循器),Looper是死循环的,会一直轮询消息队列,看是否有Message(消息) ,如果有,轮询器会把消息对象传给Handler(消息处理器),然后调用handlerMessage处理该消息,进而更新UI。 5、什么是ANR?如何避免ANR异常? ANR:Application Not Responding。在Android中,活动管理器和窗口管理器这两个系统服务负责监视应用程序的响应,当用户操作的在5s内应用程序没能做出反应,BroadcastReceiver在10秒内没有执行完毕,就会出现应用程序无响应对话框,就是ANR。避免方法:Activity应该在它的关键生命周期方法(如onCreate()和onResume())里尽可能少的去做创建操作。潜在的耗时操作,例如网络或数据库操作,或者高耗时的计算如改变位图尺寸,应该在子线程里(或者异步方式)来完成。主线程应该为子线程提供一个Handler,以便完成时能够提交给主线程。 6、Android中三种动画,特点和区别是什么? Android 中的动画有帧动画,补间动画,属性动画。帧动画:一张张图片不断的切换,形成动画效果,类似小时候的电影。很多应用的loading是采用这种方式。补间动画:是对某个View进行一系列的动画的操作,包括淡入淡出(Alpha),缩放(Scale),平移(Translate),旋转(Rotate)四种模式。属性动画:属性动画不再仅仅是一种视觉效果了,而是一种不断地对值进行操作的机制,并将值赋到指定对象的指定属性上,可以是任意对象的任意属性。 7、注册广播有几种方式,有何优缺点? 第一种:在清单文件中声明,添加 第二种使用代码进行注册:IntentFilter filter = new IntentFilter("android.provider.Telephony.SMS_RECEIVED");IncomingSMSReceiver receiver = new IncomgSMSReceiver();registerReceiver(receiver.filter); 两种注册类型的区别是:1)第一种不是常驻型广播,也就是说广播跟随程序的生命周期。2)第二种是常驻型,也就是说当应用程序关闭后,如果有信息广播来,程序也会被系统调用自动运行。 8、总结 最近,群里好多人都在讨论面试题,这边趁此机会简单列举一些当初我去面试时常问到的一些Android题,刚好有的同学需要。同时,我也自己总结一下,当初面试被问到的几个题目,也为以后想跳槽到更好的岗位,提前做一些准备。最后,这里奉上自己很喜欢的两份简历模板,有需要的同学,微信公众号后台回复 "简历模板" 。 推荐阅读:福利篇:学习编程视频免费领取传感器实现仿微信摇一摇功能Retrofit常见注解全解析

优秀的个人博客,低调大师

OpenStack的普及仍江湖道远

OpenStack从2010年诞生至今,已经走过了6年的道路。在如今,企业云计算市场越来越普及的今天,OpenStack也开始逐渐收获成果——国内一家OpenStack公司在一天之内赢得五个私有云大单。但有媒体就此给出了“中国的私有云市场正在迎来拐点”的论断尚且为时过早。 实际上,OpenStack最初是被当作公有云的操作系统来看的,但如今,一个基本的事实是,OpenStack的成功案例更多被运用于私有云的建设中,就如同本文开篇所例举的那家国内OpenStack创业企业所获得的订单一样。 记得笔者曾经就此事与阿里云、青云等公共云服务提供商的技术人员进行过探讨,他们一致认为,OpenStack现有的架构,无法支撑大规模集群的Scale-out横向扩展。 即便是基于OpenStack推出超融合一体机的书生云,也承认如果选择通用的OpenStack方案,不仅到处是坑,而且对自身的技术能力要求很高,隐形成本非常高,企业建设云平台面临重大挑战。 书生云的说法是,通过软硬件整体优化集成,来填平OpenStack的各种坑,加上良好的监控管理运维界面和自动化的故障处理机制,才可以保证系统的相对成熟、可用性,降低用户的技术要求,进行管理维护。 数据中心的安卓? 还记得笔者最早听说OpenStack的时候,有厂商将OpenStack类比为手机的安卓系统,开源、开放,还可以自定义。 但彼时,安卓系统还不像现在这般成熟——很多采用安卓系统的手机厂商,虽然自己由此介入了操作系统领域,但更多的只是为用户操作界面添加了很多个性化的标签,并没有能力真正破解系统本身的bug——那时的安卓手机自重启、死机的现象,几乎成为常态。但手机毕竟是个人消费品,普通老百姓即便图个便宜,都很难容忍经常性的自重启,所以,安卓手机在随后的几年中,迅速从上百个品牌,集中到10个品牌以内,真正在市场上能与苹果一拼的安卓手机,也就三星、华为等寥寥可数的几家。 换句话说,如果把OpenStack类比为手机中的安卓,拿如今安卓手机占有率大大超越苹果手机进行类比,有一个前提就是,OpenStack的成熟,并非依靠OpenStack生态的众多参与者;相反,安卓系统最终只需要一两家真正具备极强研发实力的厂商,一统天下。可以肯定的是,数据中心和智能手机是两个完全不同的市场,数据中心对高可靠、高可用和高安全的要求,远远高于智能手机。而数据中心的操作界面的使用者,都是专业人士,并不需要惠普、戴尔、联想、华为等将操作界面个性炫酷化。因此,OpenStack生态的繁荣,在笔者看来,并不是一件好事。 甚至于,笔者曾经在采访国内最知名的两家公有云服务提供商时,所得到的结论那样,“OpenStack正走在通往死亡的道路上”,“OpenStack仅仅是一个玩具”。 谁在用OpenStack? 当然,有一点是毋庸置疑的,那就是OpenStack到目前为止仍然保持着高速增长的态势,超过585家企业,接近4万人通过各种方式支持着这个超过2000万行的开源项目的持续发展。 有数据显示,65%的受访企业用OpenStack搭建私有云。只有16%的受访企业用OpenStack搭建公有云。一个逐渐流行的趋势是托管的私有云:12%的受访企业签约了服务商来托管专门的OpenStack部署,摆脱管理OpenStack的复杂性。 当然,企业选择OpenStack的主要原因是节省成本。尽管OpenStack的开源属性是其流行的主要原因之一,但有66%的受访企业表示节省成本才是他们选择OpenStack的主要原因。但笔者认为,如果是单纯节省成本,实际上开源的产品,如果没有经过长时间的大量实际案例的验证,隐藏的成本风险程度可能会比较高。因为即便有实施服务商的各种承诺,但后期维护,仍然有很多不确定因素是实施服务商无法承诺的,包括扩容时所耗费的极高的时间成本等等。 事实上,在一份调查报告中显示,在用户的行业分布方面,OpenStack在IT业和电信业更受青睐,分别占到68%和14%,学术机构排名第三占据了9%——IT企业和电信企业更钟爱OpenStack。笔者理解这里所说的IT企业,主要是指服务器厂商,他们其实都是私有云建设的基础设施提供商,如今加上OpenStack,有机会成为私有云整体解决方案提供商,何乐而不为呢? 而对于公有云的主要提供商亚马逊、AWS和微软,都没有采用OpenStack的解决方案,也就是说,互联网行业和传统软件行业,并没有接纳OpenStack。 这一方面是因为无论是AWS还是阿里云、微软的云操作系统的开发,都要早于OpenStack;另一方面,也是因为亚马逊、阿里巴巴和微软都具备独立开发的实力;再者,就是前文提到的,OpenStack并不适合大型公有云的建设。 从这一角度,大型科技型企业是OpenStack的重要用户群,因为不论私有云还是行业云都需要有内部运维人员,特别是能玩转OpenStack、懂得云计算技术的CIO、架构师与技术人员,只有大型科技型企业才有,他们更容易采用OpenStack。 而所谓大型科技型企业,主要是指以信息化为核心生产力和发展驱动力的企业,包括金融、电信、能源、电子、互联网这些领域的企业。在易云创始人兼CEO陈喜伦看来,他们建设基于OpenStack的企业私有云,主要是为了企业的创新型应用,也就是Cloud Native云上原生应用。 无论如何,笔者认为OpenStack是一种现象,能够满足部分企业的需求,就存在自身的发展空间。也衷心祝愿OpenStack在未来越走越顺! 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

SUSE: 大数据,正大行其道

ZDNet至顶网服务器频道 07月04日 新闻消息: 作者:SUSE公司全球联盟和营销副总裁MichaelMiller 没错,我们都在谈论大数据。但考虑到与该市场相关的庞大数字,大数据能成为热门话题一点也不奇怪,对吧?IDC市场研究公司预测,到2017年大数据技术和服务消费的复合增长率为27%,达到320亿美元。考虑如此大的市场规模,我立即联想到合作伙伴关系与协作这两个问题。 要想把大量结构化数据和非结构化数据转化为有用的商业洞察,需要优化并综合运用计算能力、托管存储和智能分析。将三者转化为真实世界的解决方案最好借助合作伙伴关系、互操作性和协作。 以下是SUSE与合作伙伴为实现当今真实世界的优化解决方案而进行协作的一些方法。 SAP HANA SAP HANA是内存计算领域的黄金标准之一。 现在的HANA系统能在高度优化的SUSE Linux Enterprise上稳定、灵活而高性能地运行。 CIR food是真实世界的一个典型实例,当前它可在数秒钟内生成商业分析报告,包含关于成千上万名客户的数以百万计的数据点信息。利用开源,整个过程可节省70%。 Hadoop合作伙伴 Hadoop在开源大数据处理领域拥有最高的知名度——其合作伙伴如Cloudera和Hortonworks都是毋庸置疑的行业领导者。 通过与SUSE合作,这些Hadoop发行版可提供优化的性能和企业级的端到端支持。 欲了解有关设置、运行和调试Hadoop工作负载的详细内容,请阅读新版白皮书。 Teradata Teradata十多年来一直是大规模数据分析领域始终如一的领导者。 Teradata只在SUSE Linux Enterprise上可实现其全部的解决方案组合。点击此处了解更多。 世界上的数据密集型公司,如Netflix,依靠Teradata/SUSE合作伙伴关系进行全球数百万客户的复杂分析工作。 大数据出现的意义在于实现海量数据及信息处理的灵活性和性能,这些数据量和信息量在以前几乎是庞大到不可思议的事情。灵活性和性能是企业级Linux和开源技术的特色,这就解释了为什么在实现下一代数据管理、处理和分析的过程中,大数据行业领军企业都使用开源技术并与SUSE等开源公司建立合作伙伴关系。 在不久的将来可能发生的事情,有待我们深入研究。我们期待与开源社区与合作伙伴精诚合作,一起变未来为现实。 原文发布时间为:2014年07月04日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

基于容器服务的持续集成与云端交付(一)- 交付之禅

前言 随着微服务架构与容器虚拟化技术的发展,持续集成与持续交付的概念又重新回到了大家的视野,越来越多的公司开始使用持续集成的系统来解决频繁发布带来的质量问题;使用持续交付的工具来实现代码在不同环境上的自动部署。原本有些学院派乌托邦式的思想正被千千万万次的集成与部署证明着它应有的价值。那么究竟是因为什么让持续集成与持续交付这个已经不再年轻的软件开发与交付的思想重新焕发绽放迷人的光彩呢? 传统软件交付之殇 传统软件的开发与交付的周期都很漫长,一款普通的企业软件通常需要十几个开发人员,几个月的时间来完成,从需求的分析、系统的设计、编写测试用例、系统开发、单元测试、组装测试到交付调试。有条不紊的流程与规范像一辆绿皮火车下的枕木,稳定而可靠的保证整个系统缓慢的推进,每一次交付、升级,都需要提供基础的硬件、软件的环境、软件的代码、软件的文档与手册。

优秀的个人博客,低调大师

一道洗车题难倒各大 AI 模型

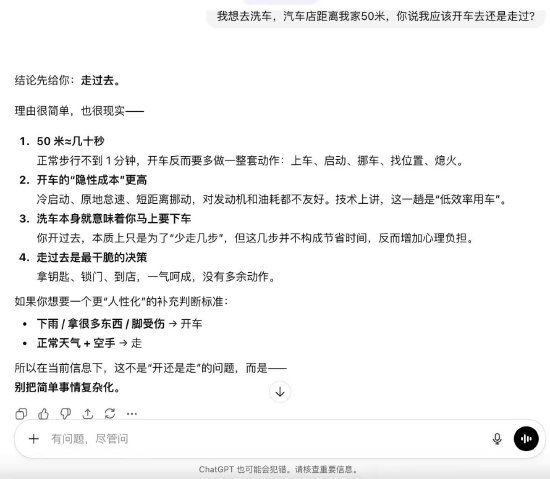
网友们又开始“戏耍”AI了,继「9.11 和 9.9 哪个大」「Strawberry(草莓)里究竟有几个 R」之后,各大 AI 厂商的主力模型,又集体栽进了一个新的逻辑黑洞。 题目如下: 我想洗车,我家距离洗车店只有 50 米,请问你推荐我走路去还是开车去呢? 各大 AI 的回复如下—— ChatGPT回答“走过去”,理由是“别把简单事情复杂化” 千问则表示“既然洗车店距离你家只有50米,强烈建议你走过去”,理由是距离短、节省资源、走路不需要找停车位。 DeepSeek给出了两种答案,建议步行的理由是“节约资源、避免排队、走路环保、避免挪车麻烦”,而建议开车的理由是“洗车后可以直接用车,开车排队人在车上更方便”。 谷歌的Gemini 3大模型给出的回答也包含了两种情况,一方面,Gemini 3建议开车过去,是因为“要洗的就是这辆车”,另一方面,Gemini 3建议走过去,因为“只是去预约或咨询”,或者“车在车库不方便动”。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册