首页 文章 精选 留言 我的

精选列表

搜索[日活数],共10010篇文章
优秀的个人博客,低调大师

🧭前端周刊第437期(2025年10月20日–10月26日)

本周的国外前端圈关键词是 “修 Bug、AI 编程、WebGPU、CSS 动画与 React 新未来” 。 从 Dan Abramov 的《如何修复任何 Bug》到 Chrome DevTools 的 MCP 调试,再到 WebGPU 彻底革新 Web 图形编程体验,这期几乎涵盖了前端开发的所有新方向。 另外,CSS 领域继续“卷”出新高度,@starting-style 调试、:has() 实例化、布局与交互动画等文章都值得收藏。 而 React 生态正在分岔:Remix 与 Next.js 走上不同道路,React 19 的破坏性改动也引发不少讨论。

优秀的个人博客,低调大师

我的数智教育转型认知地图

我所参加的是由中国教育干部网络学院主办的“2026 年区域中小学干部教师数字素养提升专题培训”,整个项目共 4 个阶段、14 个教学活动。培训第一阶段的必修课围绕“智能时代的教育理念革新与 AI 教育认知”主题,由三位专家引领:北航熊璋教授分两讲阐述“人工智能前沿与教育强国战略”(43 分钟)与“教育创新与教师人工智能素养提升”(37 分钟),北师大卢宇教授讲授“AI 赋能基础教育”(73 分钟,四讲:人工智能前瞻布局、课程教学数字化变革、师生数字素养、教育评价与治理)。第一阶段选修课则切入一线操作:王胜灵教授的“生成式 AI 在教育中的多元应用”(40 分钟,聚焦智能编写教案、课堂互动、个性化学习),以及王飞老师的“生成式人工智能在教学中的实践与应用”(53 分钟,覆盖备课、多媒体资源、数字人、论文与数据处理,并专设“技术伦理与实践反思”一讲)。五门课程我均已 100% 完成,这份认知地图就是我在五门课程的真实话语之上,对自己教师角色的再认识。

优秀的个人博客,低调大师

优化数仓业务视图:过滤条件传递

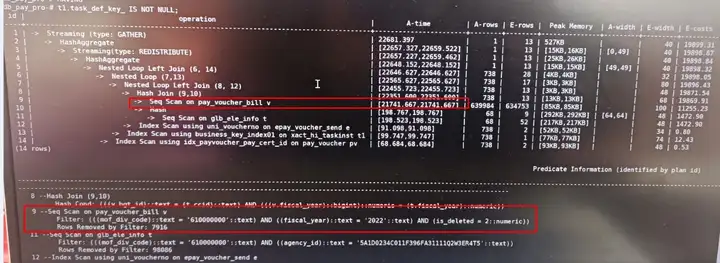
摘要:在业务功能实现时,经常会用到视图简化查询SQL。但有时候会因为视图降低查询效率,本文主要分析在业务需求满足的情况下,将有效的过滤条件传递到基表,减少运算过程中数据库需要处理的数据量,提升SQL执行效率。 本文分享自华为云社区《GaussDB(DWS)业务视图优化-过滤条件传递》,作者:卫小毛 。 在业务功能实现时,经常会用到视图简化查询SQL。但有时候会因为视图降低查询效率,本文主要分析在业务需求满足的情况下,将有效的过滤条件传递到基表,减少运算过程中数据库需要处理的数据量,提升SQL执行效率。 SQL举例 SELECT count(1) AS have_done_num, t1.task_def_key_ AS menuguid FROM vw_pay_voucher_bill t2 LEFT JOIN xact_hi_taskinst t1 ON t1.business_key_ = t2.id AND t1.proc_def_key_ = 'pay_voucher_bill' AND t1.operation_flag_ IN ('NORMAL', 'WITHDRAW') AND t1.suspension_state_ = 1 AND t1.org_code_ = t2.mof_div_code AND delete_reason_ = 'completed' AND ext1_ IS NULL WHERE t2.is_deleted = '2' AND t2.fiscal_year = '2022' AND t2.mof_div_code = 'xxxxxxxx0' AND ( agency_id = '5A1xxxxxxxxxxxxxxxxxxx4T5' ) GROUP BY t1.task_def_key_ HAVING t1.task_def_key_ IS NOT NULL; sql分析:以上SQL vw_pay_voucher_bill t2 、xact_hi_taskinst t1 视图和表进行关联查询 根据业务特性分析过滤效果较好的字段为 agency_id 优化前耗时:22s 分析执行计划: 时间主要耗时在 seq scan on pay_voucher_bill v 这一步 看到该表过滤条件仅有mof_div_code、fiscal_year、is_deleted 过滤效果差,几乎全表数据参与过程运算,执行代价高 视图及表结构分析: 视图中关联条件较为有效的过滤条件,bgt_id 字段查询时不会应用。分析视图中“v”和“t”表都存在agency_id 字段,当前t表过滤使用了agency_id字段,可以考虑视图定义中量表关联条件增加 agency_id 字段关联条件需要考虑业务需求。 同业务沟通后可进行优化 优化后耗时:0.4s 对比优化前后SQL查询结果一致 优化总结: 同业务侧研发沟通客户实际需要仅需要查询本单位 (agency_id) 下的数据,但因为SQL和视图设计时,并未将这一有效条件传递给每张表。导致数据库在针对 pay_voucher 进行数据过滤时需要将全表64万+ 数据筛选出来进行运算,仅仅这一步开销就占用了20s+。在优化后(视图中增加agency_id关联信息后,该操作可将agency_id 过滤条件传递给基表 pay_voucher),仅需从pay_voucher 表中获取738行数据进行运算,最终sql耗时降为 0.4s左右。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

解析数仓lazyagg查询重写优化规则

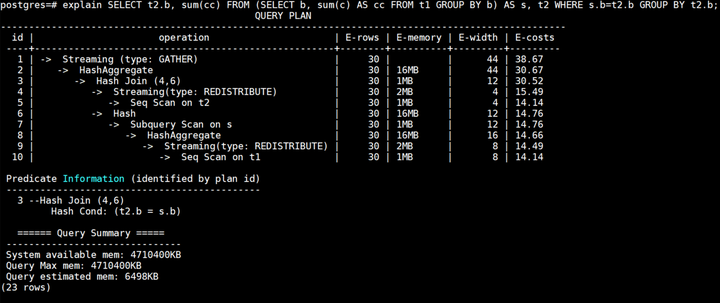
摘要:为了降低调优难度,提升产品易用性,GaussDB(DWS)提供了lazyagg查询重写优化规则。 本文分享自华为云社区《GaussDB(DWS) lazyagg查询重写优化解析【这次高斯不是数学家】》,作者: OreoreO 。 聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句则聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句eze聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句则聚集操作将查询结果按某一列或多列的值分组,值相等的为一组。聚集操作是一种常见的操作并在金融客户中有广泛的使用。例如如下语句: SELECT a, count(a) FROM t1 GROUP BY a; -- 按a分组并计算分组内重复值的个数 一、Lazy Agg重写规则 数据量大的场景下,聚集运算由于数据量大导致下盘,聚集操作执行时间成为性能瓶颈,从而导致整个查询执行效率非常差。例如: SELECT t2.b, sum(cc) FROM (SELECT b, sum(c) AS cc FROM t1 GROUP BY b) AS s, t2 WHERE s.b=t2.b GROUP BY t2.b; 子查询对t1.b列进行聚集,对t1.c列求和,在外部查询中,同样也存在聚集运算,对子查询的聚集求和列cc列求和。对于这类语句,当子查询的聚集运算较耗时的情况下,可以利用查询重写规则消除子查询的聚集运算,由外部查询的聚集函数统一完成聚集运算。消除子查询后可能导致子查询行数增多,但对于子查询聚集运算时t1.b列的distinct值较多的场景,子查询聚集运算后的行数较原表不会有明显缩减,不会导致外层JOIN运算量的大量增加。即语句可被重写为: SELECT t2.b, sum(cc) FROM (SELECT b, c AS cc FROM t1) AS s, t2 WHERE s.b=t2.b GROUP BY t2.b; 这个改写规则称为Lazy Agg,适用于基表数据量大且distinct值较多的场景。如果重复值较少,那么消除了聚集操作会导致Join后的行数激增,Join性能较差,因此需要将Agg下推到Join之前进行,通过提前的Agg操作减少Join结果的行数,这个改写规则称为Eager Agg。 二、GaussDB(DWS) lazyagg优化 为了降低调优难度,提升产品易用性,GaussDB(DWS)提供了lazyagg查询重写优化规则,可以通过设置guc参数rewrite_rule包含’lazyagg’使用Lazy Agg查询重写优化。开启lazyagg查询重写优化后,对满足条件的场景会优化并消除子查询中的聚集操作。原计划如下所示: lazyagg重写优化后计划如下所示: 可以看到相比于原计划,lazyagg重写优化后消除掉了原计划中的聚集操作,即7号Subquery Scan算子和8号HashAggregate算子。 三、lazyagg优化规格 支持子查询为单一聚集查询或包含聚集子集合操作的查询。集合操作仅支持UNION ALL,可对部分分支子查询进行聚集运算消除。子查询需为JOIN表之一(不在TargetList、Where子句等其他位置)。 支持若外部查询的所有Agg参数列包含于其某个子查询的Agg函数列,则可对该子查询的聚集运算进行消除。 支持所有消除子查询聚集运算后结果正确的聚集函数种类。聚集函数种类结果正确性见下表: 4.场景约束 在上述场景扩展的基础上,对于可能导致结果错误的场景,不进行查询重写,包括但不限于: 不支持消除的Agg函数类型。 子查询中包含其它条件或算子,会导致重写后结果错误,例如HAVING、window agg、LIMIT、OFFSET、AP function、distinct、recursive等。 外层Agg参数列、GROUP BY列或JOIN列中包含volatile函数,如random、timeofday等。 子查询Agg函数外、外部查询Agg函数内有其他表达式或函数操作,如子查询Agg函数列为sum©+1、max©+max(d),外部查询Agg函数列为sum(cc+1)等。 外部查询的JOIN列、GROUP BY列或其它条件中包含子查询Agg函数列。 子查询在LEFT JOIN、RIGHT JOIN的inner边或FULL JOIN中,且子查询Agg函数为count,外部查询Agg函数为sum的。 四、结语 通过本文的分析,相信用户朋友已经充分了解了Lazy Agg重写优化的使用场景,以及GaussDB(DWS)的lazyagg实现方式。希望广大用户能够通过深入的了解,对GaussDB(DWS)的性能调优产生浓厚的兴趣并深度参与进来。 参考文档:GaussDB(DWS)性能调优系列实战篇四:十八般武艺之SQL改写 【这次高斯不是数学家】有奖征文火热进行中:https://bbs.huaweicloud.com/blogs/345260 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

深度剖析数仓CN增量备份技术

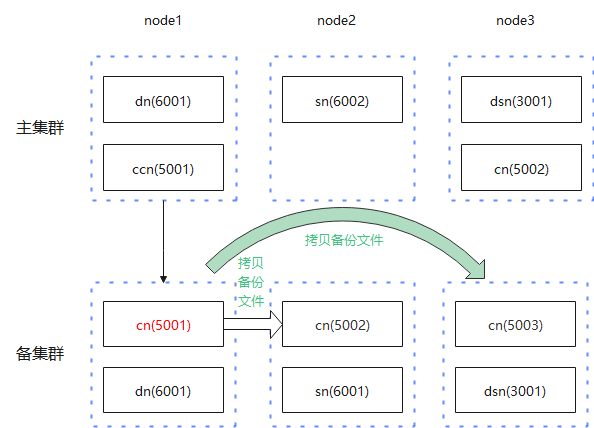
摘要:为了解决Roach的性能问题,提出了CN增量备份手段,从而达到进一步优化RPO目的。 本文分享自华为云社区《GaussDB(DWS)备份容灾之CN增量备份》,作者: zxy_db 。 1. 摘要 在数据量增大时,如果CN每次都做全量备份,则会导致每次的备份数据量很大,不仅会降低备份的性能,也从造成备份集恢复性能的降低。如果改成CN增量备份,则备份集只会备份差异数据,这样不仅会使得备份数据量变小,而且也会提升备份集恢复的性能。 2. CN备份原理 对于主备集群CN备份与恢复的过程,如下图所示: 在备份过程中,只备份主CN的数据,且只发送到备集群对应的主CN所在的节点上。 在恢复过程中,非主CN节点从主CN节点上拷贝rch文件,然后再将备份数据的rch文件恢复到实例目录。 CN备份同集群备份一样,先进行行存备份,后进行列存备份。 对于行存备份过程,首先是准备列表,然后备份文件。 准备列表主要分为3个步骤:第一步是获取CN备份类型,第二步是根据备份类型,决定LSN区间,第三步是根据LSN区间,准备备份列表(全量备份列表和增量备份列表)。 对于列存备份过程,同上述行存。 行存和列存区别在于增量备份LSN区间的取法: 行存文件来说,增量是上次startLSN到本次startLSN之间 列存文件来说,增量是上次barrierLSN到本次barrierLSN之间 3. CN备份判断逻辑 首先,CN增量需要有一个基础备份,因此,集群在做全量备份时,CN仍然做全量备份。 其次,集群在两次增量备份过程中,CN发生删除和加回后,新增的CN需要做全量备份。 对于支持异构的情况下,如果ID最小的CN发生变化,同样需要对CN做一次全量备份。 整体的备份逻辑如下图所示。 3.为了实现上述判断逻辑,通过创建标志文件backup_label.old来控制CN做全量备份还是增量备份。backup_label.old在Python侧创建。即在Python侧,调用gs_roach备份前,在最小的CN上,即要进行备份的CN上,创建backup_label.old文件。根据backup_label.old的修改时间和priorBackupKey转化的时间,判断CN做增量备份还是全量备份。流程图如下图所示。如右半部分所示,如果backup_label.old文件的修改时间比prriorBackupKey转换获得的时间大,则进行全量备份。否则,进行增量备份。 4. CN备份技术应用实测 4.1 CN删除和加回后做全量备份 初始状态,ecs-env-3038节点上的CN实例是最小CN编号,即主CN 第一步:修改XML配置文件xml,将主CN对应主机上的cooNum值从1改为0 第二步:使用gs_om工具执行删除CN操作 gs_om -t managecn -m delete -X /data1/xml/3_node_3.xml 第三步:将要加回CN对应主机上的cooNum值从0改为1 第四步:使用gs_om工具执行加回CN操作 gs_om -t managecn -m add -X /data1/xml/3_node_3.xml 删除和加回后,主CN的变化情况: 主CN由节点ecs-env-3038变为节点ecs-env-2998. 此时查看日志可以发现,由于CN发生了增删,集群做增量备份时,CN做全量备份。 4.2 备份集大小变化 第一步:拉起容灾,CN增量备份阶段停止容灾; 第二步:创建大量数据库和空表; 第三步:连续执行增量备份,增量备份中途不插入任何数据。 如下图所示,不增加数据,增量备份集大小小于全量备份集大小 5. 技术总结 本文主要从技术价值、应用场景、技术原理、技术实测展示几个维度对GaussDB(DWS) CN增量备份技术进行了剖析,可以看到增量备份是对已有全量备份恢复的一个有效的增强,可以节省宝贵的备份存储空间和cpu资源,同时达到进一步优化RPO目的,因此该技术拥有较为广阔的前景和深远的意义。 点击关注,第一时间了解华为云新鲜技术~​

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册