首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5629篇文章
优秀的个人博客,低调大师

编写代码检查规则的神器,解读CodeNavi语法结构

本文分享自华为云社区《CodeNavi 规则的语法结构》,作者: Uncle_Tom。 1. 代码和检查规则 1.1. 代码的构成 程序是由空格分隔的字符串组成的序列。在程序分析中,这一个个的字符串被称为"token",是源代码中的最小语法单位,是构成编程语言语法的基本元素。 Token可以分为多种类型,常见的有关键字(如if、while)、标识符(变量名、函数名)、字面量(如数字、字符串)、运算符(如+、-、*、/)、分隔符(如逗号,、分号;)等。 程序在编译过程中,词法分析器(Lexer)读取源代码并将其分解成一系列的token。语法分析器(Parser)会使用这些 token 来构建一个抽象语法树(Abstract Syntax Tree, AST),这个树结构表示了代码的语法结构。这个时候每个 token 也可以称为抽象语法树的节点,树上某个节点的分支就是这个节点的子节点。每个节点都会有节点类型、属性、值。 这些是程序员非常容易理解的。 1.2. 检查规则 检查规则是查找代码节点中符合缺陷模式的检查规则。 通常静态分析工具的规则编写采用程序语言,这样开发人员除了要了解检查的问题本省,还需要理解静态分析理论,以及静态分析工具的框架,无形中增加了开发的难度。所以我们一直期望寻找到一种更适合编写静态分析规则的语言,让开发人员能够更好的专注于理解检查问题的本身,而不需要花更多的时间在如何实现上。 《寻找适合编写静态分析规则的语言》中我们给出了两个问题的解决,来描述我们对编写静态分析规则的期望。 例如: 检查问题: 生产环境中不应该有调试代码。 问题检查条件: 查找所有函数声明 并且(And):函数名以"debug"开头 并且(And):函数只有一个参数 并且(And):参数类型为"java.util.List" 问题代码样例 package com.dsl; import org.apache.logging.log4j.LogManager; import org.apache.logging.log4j.Logger; import java.util.List; /** * 检查问题:生产环境中不应该有调试代码。 * 问题检查条件: * - 查找所有函数声明; * - 并且(And):函数名以"debug"开头; * - 并且(And):函数只有一个参数; * - 并且(And):参数类型为"java.util.List"。 */ public class CheckDebug { private static final Logger LOG = LogManager.getLogger(CheckDebug.class); // 应检查出的问题函数 public void debugFunction(List<String> msgs) { for (String msg : msgs) { LOG.error("print debug info: {}", msg); } } } 编写检查规则 DSL 写的检查规则 /** * 检查问题:生产环境中不应该有调试代码。 * 问题检查条件: * - 查找所有函数声明; * - 并且(And):函数名以"debug"开头; * - 并且(And):函数只有一个参数; * - 并且(And):参数类型为"java.util.List"。 */ functionDeclaration fd where and( fd.name startWith "debug", fd.parameters.size() == 1, fd.parameters[0].type.name == "java.util.List" ); 2. 规则语法结构 下面我们进一步给出这种用于编写代码检查规则的工具 CodeNavi 的语法结构。 2.1. 规则的语法 结构图 语法说明 规则语句是以分号 (;) 结尾, 作为规则的终止符。 2.2. 语句结构 结构图 语法说明 节点(node): 为待检测代码节点(token); as 别名:给要查找的节点一个别名,便于后面的使用。as可以省略。别名的命名规则如下: 只能包含大小写英文字母和数字; 数字只能出现在末尾; 不能和规则内置的节点或属性同名。 例如:va1、fd、Field1都是合法的别名,1fc、v2a是非法别名。 查询条件(condition):筛选节点的条件; 2.3. 节点和节点属性 结构图 语法说明 节点(node):是代码对应语法树的节点或子节点; 属性(attribute):是代码对应语法树的节点或子节点的属性; .: 节点、子节点、属性之间的连接符; 2.4. 条件表达式结构 结构图 语法说明 where: 条件表达式的标识; and:括号内的查询条件必须都为真; or:括号内的查询条件至少有一个为真; not:括号内的查询条件为假; 逻辑的连接祠是一种作用于查询条件的关键词。规则支持and、or和not三个关联词。 逻辑的连接词需要和括号一同使用,括号中为具体的查询条件。其中,and和or可以作用于多个查询条件(即括号中可以包含多个查询条件,以逗号分隔开),not只能作用于一个查询条件。 逻辑连接词是一类作用于查询条件的特殊运算符(普通的运算符作用于节点或属性) 逻辑的连接词作用的查询条件也可以包含逻辑连接词。 示例 /* * 问题检查条件: * - 查找函数名为 debug 或 foo; * - 并且(And): 参数数量为 1 或 3。 */ functionDeclaration fd where and(or(fd.name == "debug", fd.name == "foo"), or(fd.parameters.size() == 1, fd.parameters.size() == 3)); 2.5. 条件判断(condition) 结构图 2.5.1. 运算符 查询条件通过运算符作用于具体的节点或属性从而完成节点筛选。 根据运算符作用的属性类别,我们可以将运算符分为: 通用运算符 算术运算符 字符串运算符 布尔运算符 节点运算符 运算符的左值为:节点或节点的属性。 2.5.1.1. 通用运算符(==, contain) 等于(==)、不等于(!=) 数字 运算符右值为:整数或小数。 例如:arguments.size() == 3 字符串 运算符右值为:字符串常量。 例如:name == “foo” 布尔 运算符右值为:布尔常量:true或false。 例如:isPublic == true 节点 运算符右值为:空常量null。 例如:initializer == null 包含(contain)、不包含(notContain) 字符串 运算符右值为:字符串,且包含时,返回真。 例如:recordDeclaration where name contain "debug";,返回函数名中包含"debug" 时,返回真。 节点 运算符右值为:子查询条件,当子查询返回的节点满足时,返回真。 例如:functionDeclaration where parameters contain param where param.name == "i1";,返回包含名为i1参数的方法声明。 2.5.1.2. 算术运算符(>, <) 算术运算符操作数字。 大于(>)、小于(<)、大于等于(>=)、小于等于(<=) 数字 运算符右值为:数字,且满足时,返回真。 2.5.1.3. 字符串运算符(startWith, endWith, match) 字符串运算符操作字符串。 字符串的开始字符串( startWith) 左值开始字符串等于右值字符串时,返回真。 例如:functionDeclartion where name startWith "debug";,筛选出名字以debug开头的方法声明。 字符串的结束字符串( endWith) 左值结束字符串等于右值字符串时,返回真。 例如:functionDeclartion where name endWith "hello",筛选出名字以hello结尾的方法声明。 字符串匹配( match) 左值符合右值的正则表达式时,返回真。 例如:functionDeclaration where name match ".*(login).*",筛选出名字匹配正则表达式.*(login).*的方法声明。 2.5.1.4. 布尔运算符(!) 逻辑运算符操作布尔值。 非( !) 操作符位于布尔属性的左侧,表示布尔值为false时,返回真。 例如:recordDeclaration where !isPublic等价于recordDelaration where isPublic == false。 2.5.1.5. 节点运算符(contain,in,is) 节点运算符的左侧可以是节点属性 或 别名。 包含( contain) 用于查询语法树结构上的子节点。 例如: 筛选出方法体内调用了名为foo的无参方法的方法声明。 functionDeclaration fd where fd contain functionCall where and(name == "foo", arguments.size() == 0)); 存在于( in) 查询语法树结构上的父节点。 例如: 筛选出位于赋值表达式中的数据成员访问节点。 fieldAccess fa1 where fa1 in assignStatement; 是( is) 右侧节点属性或别名相同时,返回真。 例如:筛选出出现在赋值表达式左侧的变量访问节点,且赋值表达式的右侧为方法调用节点。规则中的va是节点variableAccess的别名。 variableAccess va where va in assignStatement where and(lhs is va, rhs is functionCall); 2.5.2. 值类型 2.5.2.1. 布尔值 布尔值为布尔常量true或false。 布尔属性可以单独使用。单独使用时,布尔属性隐式等价于一个包含==的通用条件表达式。 例如,recordDeclaration where isPublic;等价于recordDeclaration where isPublic == true; 2.5.2.2. 数值 规则中的数值可以为整数或小数。 2.5.2.3. 字符串 字符串支持大小写英文字母、数字、以及正则表达式特殊字符。 2.5.2.4. 空值(null) 空值指的是源码中的null。 在使用时,空值往往和==或!=一同出现。 例如: // private String field = null fieldDeclaration fd where fd.initializer == null; // str = null assignStatement as1 where as1.rhs == null; 3. CodeNavi插件 在Vscode 的插件中,查询:codenavi,并安装。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

自动化接口回归测试神器 AREX 使用初体验

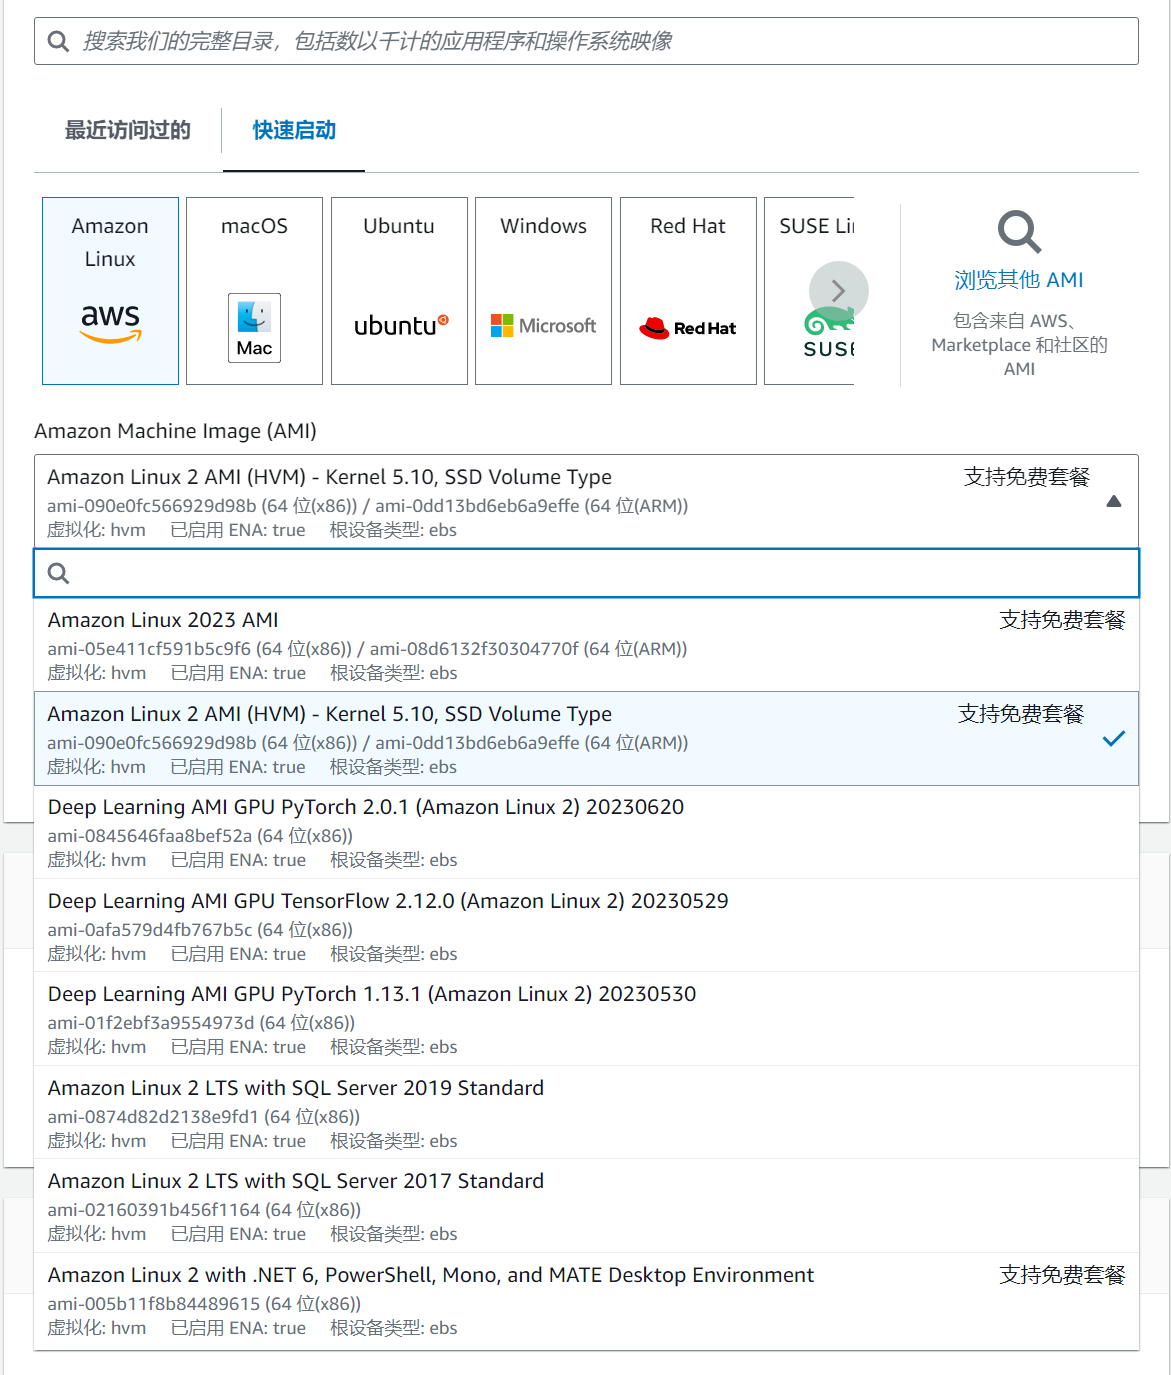
AREX 是一款开源的基于流量录制回放技术的自动化回归测试平台,目前官方文档仅介绍了如何在本地及私有云部署,本篇文章分享如何 AWS 环境下快速搭建 AREX 服务,并使用 AWS 的 DocumentDB 作为数据库替换官方默认的 MongoDB,使用 ElastiCache 替换默认的 Redis。 安装 AREX 使用前需要注册 AWS 账号并对相应概念有一定了解,详细可参考 AWS 官方文档。 步骤一:准备一台 EC2 用于部署 AREX 操作系统选择 Amazon Linux 2 AMI。(Amazon Linux 2023 AMI 有部分应用安装不上,所以这里选择使用稳定的低版本操作系统) 如果只是进行试用,建议最小配置选择 t3.large(2C8G)的机器。 密钥对名称可以按照自己的需求创建并使用(方便快速链接到自己的 EC2)。后续创建 DocumentDB 的时候也可以共用该秘钥。 存储配置默认 8G 即可。 步骤二:创建 Amazon DocumentDB 集群 注意:在使用 DocumentDB 时,需要将其部署在与之关联的 EC2 实例所在的同一个虚拟私有云(VPC)中,保证它们之间能够进行通信。 创建 2 个 db.t3.medium 类型的实例,1 主 1 从两台机器,引擎版本选择 5.0.0。 安装完成后,配置对应的入站规则以允许外部网络通过连接串进行访问。使用 mongo shell 验证连接串是否可用。 执行 show dbs 命令,出现上图中红框部分则表示 DocumentDB 创建成功。 步骤四:准备一台 ElastiCache 并创建 Redis 集群 在 AWS 控制台中搜索 ElastiCache 并创建 Redis 集群。注意:ElastiCache 必须与上述创建的 EC2 在同一个 VPC 中。 选择配置并创建新集群,试用阶段可以先禁用集群模式,正式使用时按需修改配置。 引擎版本选择 6.2,节点类型选择 cache.t3.micro,副本数量设置为 0。 选择创建新的子网组,选择和上述 EC2 同一个 VPC ID。 在 EC2 上通过 redis-cli 连接到 ElastiCache 检查是否连通。如果连接不上可以看下安全组对应的入站规则,根据自己网络情况进行配置即可。 步骤五:通过 docker-compose 安装 AREX AREX 的安装非常简单,使用 Docker-Compose 命令,即可一键安装 AREX 所有基础服务组件。 这里简单介绍一下 AREX 的工作原理及各个服务组件。 AREX 回归测试的工作原理是利用 AREX Java Agent 将生产环境中 Java 应用的数据流量和请求信息进行采样录制,并将这些信息发送给 AREX 数据存取服务(Storage Service),由数据存取服务导入数据库(mongoDB)中进行存储。当需要进行回放时,AREX 调度服务(Schedule Service)将会通过 Storage Service 从数据库中提取被测应用的录制数据,然后向目标验证服务发送接口请求。同时,Java Agent 会将录制的外部依赖的响应进行 Mock,代替真正的数据访问,传达给被测应用,目标服务处理完成请求逻辑后返回响应报文。随后调度服务会将录制的响应报文与回放的响应报文进行比对,验证系统逻辑正确性,并将比对结果推送给分析服务(Report Service),由其生成完整的回放测试报告,供测试人员分析录制回放差异。 首先,通过 git 命令克隆 AREX 仓库。 git clone --depth 1 https://github.com/arextest/deployments.git cd deployments 配置 DocumentDB、ElastiCache 如要使用 AWS 的 DocumentDB 作为数据库替换官方默认的 MongoDB,并使用 ElastiCache 替换默认的 Redis,只需修改配置文件 docker-compose.yml 中的连接串,把文件中所有 MongoDB 的连接串都替换成 DocumentDB 的连接串,所有 Redis 的连接串都替换成 ElastiCache 的连接串即可。 步骤六:启动 AREX 配置完成后,执行 docker-compose 一键启动 AREX 服务。 docker-compose up -d 服务启动后,在没有修改端口配置的情况下,直接访问 8088 端口进入 AREX 前端页面。 差异分析 在实际使用过程中,对于一个复杂的线上应用,业务场景复杂,录制及回放的用例数量巨大,如何分析差异点及排查问题成为难点。 为了减轻使用者分析差异时的工作量,AREX 对可能存在的大量差异点,使用聚合的方法进行了大幅度的简化。 差异场景聚合分析 首先是差异场景聚合,AREX 对差异场景相同的多个用例进行了聚合展示。在介绍差异场景聚合逻辑之前,先大概了解一下 AREX 中用例(Case)的基本概念。 AREX 用例概念 在 AREX 中,一个用例通常由多个步骤组成,每个步骤包含了一个请求和一个响应。请求可以是主入口,也可以是外部调用(包括 DB、Redis 等)。在每个步骤中,都会记录请求的参数和响应结果等信息,用于后续的对比。如果录制与回放时的主入口响应,以及外部依赖的请求均无差异,则视为该用例回放通过。 这里的主入口和外部调用我们称之为 Mock 的类型。 Mock 的差异类型 每个 Mock 类型的对比差异类型会被分为三种情况: new call:这种差异类型表示该主入口或外部调用的 Mock 在录制时不存在,但在回放时存在,即新增了调用,通常是因为有新功能的迭代。 call missing:表示在录制时存在,但在回放时缺失了调用,通常是因为项目进行了优化,移除了某些不必要的调用关系。 value diff:表示在录制和回放时都存在,但在对比过程中某些节点有差异。后续章节中会具体介绍如何分析这些差异。 差异场景聚合 在进行流量回放测试时,针对可能出现的用例数量较大的情况,AREX 会通过一些聚合的操作,将相似的用例进行合并,以减少差异点的数量,便于用户对数据进行分析。如下图所示,聚合相似差异场景后,每个差异场景下仅选取一条用例作为展示。 场景聚合逻辑 有了上述 Mock 差异类型的概念,接下来介绍下差异用例场景聚合的逻辑。差异用例场景聚合是为了将具有相同 Mock 类型和差异类型的用例聚合在一起形成一个场景,从而帮助用户更快速地了解整个场景中的用例情况,减少用户需要分析的用例数量,提高分析用例的效率。 首先,根据 Mock 的 type 类型和差异类型的组合,AREX 会生成一个唯一的键,将所有用例分类聚合到这些键中,形成一个大分类。如上图中标注的 ①大分类。 其次,每个大分类中的用例都会再根据具体的 Mock 和差异类型的排列生成一个子唯一键,进一步对用例进行分类。这样做的目的是为了更加细致地分类,以便更快速地分析差异用例,具体可见上图中 ②小分类 的示例。每个小分类中有多少个用例数量会标记在该分类的最前面。 差异点分析 其次在每个差异场景中,AREX 对相似的差异节点也进行了聚合展示。 差异点聚合逻辑 在某些大报文的场景下,有些大数组中的差异点会非常多,一方面不利于前端展示,另一方面增加了使用者分析差异点的复杂度。 为了解决这个问题,AREX 将差异点按照模糊路径进行聚合。这里的模糊路径指的是不带数组下标的 JSON 节点路径。例如,一个 JSON 对象中有一个名为 “items” 的数组,数组中有多个元素 “items[0]”、“items[1]”、“items[2]” 等。在模糊路径中,这些路径会被合并为 “items”,从而实现聚合。 新增节点 在比较两个 JSON 对象时,如果发现某一边 JSON 对象中存在一个节点,但是另一边的对象中不存在该节点,那么我们就认为该节点是“新增节点”,如下图中,仅出现在右侧对象中的 cardpayfee 节点。同时为了方便用户查看,AREX 会将新增节点的所有祖先节点都标注为褐色,以突出显示该节点的位置。这样,用户可以清晰地看到该节点在另一侧对象中的位置,从而更好地分析问题。 差异节点 如果左右两边对象都存在某节点,但节点的值不一致,就可以认为该节点是“差异节点”,AREX 会使用蓝色背景高亮显示这些节点。不同于新增节点,这种类型的差异点只会出现在叶子节点上,因为只有叶子节点才有具体的值可以进行比较。 AREX 文档:http://arextest.com/zh-Hans/docs/intro/ AREX 官网:http://arextest.com/ AREX GitHub:https://github.com/arextest AREX 官方 QQ 交流群:656108079

优秀的个人博客,低调大师

一行Python代码能做出哪些神器的事情

声明:这些小例子都来源于网络(最后给出参考网址),自己抱着学习的态度整理得到。如果侵犯了作者权益,私信我我会删除掉 import requests 对于一个用C++写过爬虫的人来说,没有比这一行更加丧心病狂的了!!! (1)一行代码启动一个Web服务 python -m SimpleHTTPServer 8080 # python2python3 -m http.server 8080 # python3 (2)一行代码实现变量值互换 a, b = 1, 2; a, b = b, a (3)一行代码解决FizzBuzz问题: FizzBuzz问题:打印数字1到100, 3的倍数打印“Fizz”, 5的倍数打印“Buzz”, 既是3又是5的倍数的打印“FizzBuzz” print(' '.join(["fizz"[x % 3 * 4:]+"buzz"[x % 5 * 4:] or str(x) for x in range(1, 101)])) (4)一行代码输出特定字符"Love"拼成的心形 print('\n'.join([''.join([('Love'[(x-y) % len('Love')] if ((x*0.05)**2+(y*0.1)**2-1)**3-(x*0.05)**2*(y*0.1)**3 <= 0 else ' ') for x in range(-30, 30)]) for y in range(30, -30, -1)])) (5)一行代码输出Mandelbrot图像 Mandelbrot图像:图像中的每个位置都对应于公式N=x+y*i中的一个复数、 print('\n'.join([''.join(['*'if abs((lambda a: lambda z, c, n: a(a, z, c, n))(lambda s, z, c, n: z if n == 0 else s(s, z*z+c, c, n-1))(0, 0.02*x+0.05j*y, 40)) < 2 else ' ' for x in range(-80, 20)]) for y in range(-20, 20)])) (6)一行代码打印九九乘法表 print('\n'.join([' '.join(['%s*%s=%-2s' % (y, x, x*y) for y in range(1, x+1)]) for x in range(1, 10)])) (7)一行代码计算出1-100之间的素数(两个版本) print(' '.join([str(item) for item in filter(lambda x: not [x % i for i in range(2, x) if x % i == 0], range(2, 101))]))print(' '.join([str(item) for item in filter(lambda x: all(map(lambda p: x % p != 0, range(2, x))), range(2, 101))])) (8)一行代码输出斐波那契数列 print([x[0] for x in [(a[i][0], a.append([a[i][1], a[i][0]+a[i][1]])) for a in ([[1, 1]], ) for i in range(30)]]) (9)一行代码实现快排算法 qsort = lambda arr: len(arr) > 1 and qsort(list(filter(lambda x: x <= arr[0], arr[1:]))) + arr[0:1] + qsort(list(filter(lambda x: x > arr[0], arr[1:]))) or arr (10)一行代码解决八皇后问题 [__import__('sys').stdout.write('\n'.join('.' * i + 'Q' + '.' * (8-i-1) for i in vec) + "\n========\n") for vec in __import__('itertools').permutations(range(8)) if 8 == len(set(vec[i]+i for i in range(8))) == len(set(vec[i]-i for i in range(8)))] (11)一行代码实现数组的flatten功能: 将多维数组转化为一维 flatten = lambda x: [y for l in x for y in flatten(l)] if isinstance(x, list) else [x] (12)一行代码实现list, 有点类似与上个功能的反功能 array = lambda x: [x[i:i+3] for i in range(0, len(x), 3)] (13)一行代码实现求解2的1000次方的各位数之和print(sum(map(int, str(2**1000)))) IT入门感谢关注 程序员题库→ 程序员用的单词表→ 练习地址 :www.520mg.com/it 本文分享自微信公众号 - IT入门(learncode)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Java 线上问题排查神器 Arthas 快速上手与原理浅谈

【Arthas 官方社区正在举行征文活动,参加即有奖品拿哦~点击投稿】 作者 | 杨桢栋,笔名叫蛮三刀把刀,是一名一线互联网码农,留美访学一年,主要关注后端开发,数据安全,爬虫,物联网,边缘计算等方向。 前言 当你兴冲冲地开始运行自己的 Java 项目时,你是否遇到过如下问题: 程序在稳定运行了,可是实现的功能点了没反应。 为了修复 Bug 而上线的新版本,上线后发现 Bug 依然在,却想不通哪里有问题? 想到可能出现问题的地方,却发现那里没打日志,没法在运行中看到问题,只能加了日志输出重新打包——部署——上线 程序功能正常了,可是为啥响应时间这么慢,在哪里出现了问题? 程序不但稳定运行,而且功能完美,但跑了几天或者几周过后,发现响应速度变慢了,是不是内存泄漏了? 以前,你碰到这些问题,解决的办法大多是,修改代码,重新上线。但是在大公司里,上线的流

优秀的个人博客,低调大师

腾讯正式开源面向 Unity 项目的 Bug 修复神器 InjectFix

InjectFix是腾讯最新对外开源的Unity代码逻辑热修复方案,可实现在Unity线上客户端内,不用迭代新版本,就能快速修复游戏的线上bug。 先说几个亮点: 直接在Unity工程上修改C#即可更新;老项目无需修改原有代码即可使用; 更符合苹果热更新条款; 每个游戏一份私有补丁格式,安全更有保障。 InjectFix经腾讯内部多个项目应用反馈十分良好,不仅能解决线上bug,还可以有效的提高日常开发效率,下面我们聊下这项目的前世今生。 热更方案大乱斗 所有支持iOS的热更方案都有个共同点:更新后代码都是解析执行。如果按其更新前是否解析执行,可以分为两大类: 一类是某些模块甚至整个游戏,都一直解析执行。这是最传统的方式,目前市面上所有主流方案(xLua,slua,tolua,ILRuntime,jsb等等)都支持这种方式。这种方式的特点: 或多或少都会有些侵入性:ILRuntime解析执行C#编译后的程序集,在这些方案里头侵入性可能最小,但也需要对代码重构,把要更新的逻辑拆到单独程序集。各种非C#的脚本侵入性最大,一个已经完成的纯C#项目要用意味着重写。 ps:也有一种思路是通过一个C#转XX脚本工具来实现C#编码,解析执行,但如果你是一个已有项目想这么转一下,大概率是失败的,除非你一开始就在用这方式在开发,碰到坑就避开,因为这类方案往往不是完整支持全部语法,支持的语法也不一定能完全一致。 基于性能,实现便利性等的考虑,一般游戏有些地方要以原生的方式跑,这些原生跑的代码出了bug这种方式是无能为力的。 如果使用的脚本是动态类型语言,还会带来代码维护困难的问题。 优点是可以新增功能,有的游戏甚至可以做到一次下载,后续不用整包更新。但苹果条款分析的章节可以看到,这也不一定是好事。 另外一类是以原生方式跑,如果有bug,把逻辑重定向到新的,解析执行的逻辑。这种方式的特点: 侵入性低,后期项目也可以使用。 正常逻辑是原生方式运行,有问题只是局部切换到解析执行,所以性能比较好。 会导致代码段增大,增大正比于注入的类的数量。 这种方式往往难以新增功能。 第二种方式是接下来讨论的重点,方便起见,我们称之为“热修复”,热修复最早的成熟方案是xLua提供,经过两年来的使用已经逐渐被接受,tolua#后来也加入了这功能,也有一些网友基于ILRuntime做了热修复功能。 InjectFix是什么? InjectFix就是一个热修复的实现。那它和其它热修复方案又有什么不同呢? 设想这么个场景,我们有一个一千行代码的函数,其中有一行有问题,我们需要修复它。 如果用xLua,需要用lua去重新实现一遍这个函数,工作量大。而基于ILRuntime的热修复,由于其补丁是另一个程序集,它无法直接访问原类的私有成员,所以那999行正常代码一般也不能直接使用,需要做较多修改。 而InjectFix不需要用lua,也不需要像ILRuntime热修复那样另外建一个工程把那一千行逻辑重实现。只需要在Unity原工程直接改掉这行代码,然后标注这函数要更新即可。 不仅如此,InjectFix还有其它优势: 运行时非常小巧,仅100K左右,比各lua方案,ILRuntime都要小很多,而且不依赖第三方库,纯C#实现。 支持每个游戏生成一份自己私有的补丁格式,私有的指令定义。这样相比通用的lua原代码,lua字节码,clr程序集都更安全些。 支持Assembly-CSharp.dll之外的dll的修复。 免代码生成,更干净。 它也有缺点,不支持新增类,也不支持在已有类新增字段,修bug还是够用的,但难以通过热更为游戏增加新功能。InjectFix就一个纯粹的修bug工具而已。 黑科技 由于InjectFix支持重复加载补丁,新加载补丁会自动覆盖上一个,这特性可以用来实现真机代码逻辑实时修改。 (视频地址:https://v.qq.com/x/page/v09240mo6ai.html?&ptag=4_7.2.5.22206_copy) 苹果政策合规性 各热更方案群的问的频率最高的问题之一:这方案会不会导致我游戏苹果审核不通过。 让我们看看苹果的热更新条款: 可以看到最新条款允许下载代码解析执行,但前提是不能通过新增特性和功能来把程序改得(和审核时相比)面目全非。再看看通常被拒时的理由中的Guideline2.5.2里的一句: Yourapp,extension,orlinkedframeworkappearstocontaincodedesignedexplicitlywiththecapabilitytochangeyourapp’sbehaviororfunctionalityafterAppReviewapproval。 有“新增特性和功能”能力的热更新方案的尴尬之处在于有“改得面目全非”的能力。而InjectFix从它提供的能力(只能修改已有函数)来看,并不具备“新增特性和功能”的能力,这本来是弱点,放在这里却成为合规性的保证了。 基本原理 InjectFix项目的研发挺曲折的。InjectFix和xLua是同一个作者,也是本文笔者,当时xLua开源后,不断有人提希望提供个C#转lua的工具,而深入研究觉得实现个il虚拟机工作量还更小,这样还能避免lua的一些gc问题。 决定要做il虚拟机后,也曾想过直接使用ILRuntime,评估后觉得不太符合我们的使用场景:ILRuntime并不能实现和原生代码的函数级别配合,这是我们能实现原工程直接改Bug的关键;ILRuntime运行时部分依赖cecil,除了资源占用大之外,还容易和unity自带或者某些插件的cecil冲突;加载的是标准的程序集在安全性方面也比较堪忧。虽说这些都可以改,但修改的工作量也挺大的,还不如自己写一个。 InjectFix实现bug修复主要靠这两部分:虚拟机负责新逻辑的解析执行;注入代码负责把调用重定向到虚拟机;下面我们结合最简单的例子介绍下这两部分。 虚拟机 关键部分用几行伪码就可以描述清楚: 导读 pc指向的是函数的第一条指令; argumentBase指向的是第一个参数; while+switch一条条指令往下执行,具体指令的操作在case那; argumentBase指向的是求值栈该函数的栈帧,栈帧是这么安排的: 先放参数(如果有的话),再放本地变量(如果有的话),接着是临时区域,当函数返回时弹掉所有东西,如果有返回值就放到栈顶(函数执行前参数0的位置)。 用如下一个静态方法来演示下虚拟机怎么运行: public static float Add(float a, float b) { return a - b; } 这函数编译后是这四条指令 Add函数的执行过程 指令1把参数0 Push到栈顶; 指令2把参数1 Push到栈顶; 指令3把两个栈顶元素弹出(Pop)并相加,结果Push到栈顶; 指令4把栈顶拷贝到参数0的位置,清理栈,退出循环,Execute函数执行结束。 代码注入 上面的Add函数注入后是这样的 public static float Add(float a, float b) { if (WrappersManagerImpl.IsPatched(92)) { return WrappersManagerImpl.GetPatch(92).__Gen_Wrap_25(a, b); } return a - b; } 比较简单,发现这函数有patch的话,就重定向到虚拟机。 而__Gen_Wrap_25是个适配器函数,赋值把参数压栈,调用虚拟机的Execute函数,并把结果返回。__Gen_Wrap_25的实现如下: public float __Gen_Wrap_25(float P0, float P1) { Call call = Call.Begin(); call.PushSingle(P0); call.PushSingle(P1); this.virtualMachine.Execute(this.methodId, ref call, 2, 0); return call.GetSingle(0); } PS:我们的例子仅有三种指令,和这几条指令无关的代码全部简化了,真正复杂得多,有兴趣可以看源码了解。 总结 InjectFix使用简单,小巧,合规且安全。即使你不打算用它来更新线上版本,只要你程序有原生部分,接入也能一定程度上提高开发效率,没什么拒绝它的理由,是吧?

优秀的个人博客,低调大师

大数据初学者必备神器学习路线图

大数据终将主宰经济社会,消除个体差异,成就一元化的经济体系。网络经济时代,人们在经济社会中的诸种活动通过网络账户体系来实现,这些活动也就是所谓的网络账户活动,其基本内容更多地体现为账户间的关系。这些账户活动及其账户关系是由数字网络程序所设定的、驱动的,且被实时地记录下来。这就形成了所谓的“大数据”。因此,大数据来源于大量的网络账户的活动及其有效的记录,简言之,大数据是网络账户数据。 具体学习路线图如下: 第一阶段 Java语言基础阶段 1.1 Java编程语言基本概述 1.2 Java基础语法 1.3 面向对象编程 1.4 面向对象高级编程 1.5 Java中的常用类库 1.6 枚举和异常类 1.7 Java数据结构和集合框架泛型 1.8 Java中的IO流 1.9 Java中的多线程 1.10 Java中网络编程和反射 1.11 Java8新特性 1.12 Java基础加强 第二阶段 Linux系统&Hadoop生态体系 01 Linux入门 02 常用基本命令 03 系统管理 04 Linux操作增强 05 Linux shell编程 06 Hadoop生态 07 分布式系统概述 08 Hadoop入门 09 Hadoop伪分布式 10 Hadoop全分布式 11 HDFS基本概念 12 HDFS的应用开发 13 HDFS的IO流操作 14 NameNode工作机制 15 DataNode工作机制 16 Zookeeper入门 17 Zookeeper详解 18 HA框架原理 19 Hadoop-HA集群配置 20 MapReduce框架原理 21 Shuffle机制 22 Mapreduce案例一 23 Mapreduce案例二 24 Hive入门 25 Hive DDL数据定义 26 Hive分区表 27 Hive分桶表 28 Hive查询 29 Hive的高级查询Join与排序 30 Hive的函数 31 Hive DML数据管理 32 Hive文件存储 33 Hive企业级调优 34 Hive企业级调优二 35 Hive企业级项目实战 36 Flume详解 37 Sqoop详解 38 Hbase概念 39 Hbase的操作 40 Hbase整合 41 Hbase的实战和优化 第三阶段 分布式计算框架 3.1 scala 3.2 Spark Core 3.3 Spark SQL 3.4 Spark Streaming 3.5 kafka 3.6 ElasticSearch 3.7 Logstash 3.8 Kibana 3.9 Kibana 第四阶段 大数据实战项目 4.1 互金领域-广告投放 项目介绍:构建广告投放平台,进行广告投放业务,吸引潜在客户,推广产品,包含投放微服务平台、竞价模块、客户群体画像、 千人千面推荐产品。 4.2 电商平台 项目介绍: 埋点业务,进行用户细分画像、建立信用体系、进行线上各类活动。 4.3 共享单车 项目介绍: 依据用户行为轨迹构成出行规律,根据用户群体出行规律、区域情况等动态调度用车情况。 4.4 工业大数据 项目介绍:国家电网_省级输/变电监控项目:监控线路的传感设备,确保设备安全、降低故障成本,动态监控线路、变电站二次设备工作情况、报警自动化。 4.5 交通 项目介绍:贵州交通厅,交通离线/实时监控项目:通过交通卡口采集实时数据,动态监控全省各道路通行和事故状况,避免拥堵、避免交通事故、 精准测速、防止套牌和提供便捷最佳出行方案、 预测拥堵系数,为各级提供最优道路规划方案。 4.6 旅游 项目介绍:安顺智慧旅游,整合各类旅游相关应用系统及信息资源,在公安、交通、工商等相关领域实现信息共享、协同合作,共同打造良性的旅游云生态系统。 4.7 医疗 项目介绍:某市人民医院,随着老年化的持续增加,患病率越来越高。增加大数据平台,采集医疗相关数据,提高诊断的准确性,预防一些疾病的发生,监控相关病情康复进展,真正实现解决看病难,降低发病率等。 第五阶段 大数据分析 5.1 Data Analyze数据分析基础 5.2 工作环境准备 5.3 数据可视化的概念与准则 5.4 Python机器学习 5.5 选择模型 5.6 构建树的过程 5.7 网格搜索 5.8 sklearn中有三类朴素贝叶斯算法 5.9 颜色特征 5.10 手写数字识别 5.11 文本的基本组成 5.12 文本的基本组成 大数据人才高度缺乏,人才需求量大。IT里面有很多职位可以选择,为什么要选择进入大数据圈子?原因正是大数据的光明前景,大数据风口在这里。学习大数据技术就在此刻!

优秀的个人博客,低调大师

Android八门神器(一):OkHttp框架源码解析

HTTP是我们交换数据和媒体流的现代应用网络,有效利用HTTP可以使我们节省带宽和更快地加载数据,Square公司开源的OkHttp网络请求是有效率的HTTP客户端。之前的知识面仅限于框架API的调用,接触到实际的工作之后深知自己知识的不足,故而深挖框架源码尽力吸取前辈的设计经验。关于此框架的源码解析网上的教程多不胜数,此文名为源码解析,实则是炒冷饭之作,如有错误和不足之处还望各位看官指出。 拦截器 拦截器是OkHttp框架设计的精髓所在,拦截器所定义的是Request的所通过的责任链而不管Request的具体执行过程,并且可以让开发人员自定义自己的拦截器功能并且插入到责任链中 用户自定义的拦截器位于 OkHttpClient.addInterceptor() 添加到interceptors责任链中 RealCall.execute()执行的时候调用RealCall.getResponseWithInterceptorChain()将 来自 OkHttpClient的interceptors以及默认的拦截器一并加入到RealInterceptorChain责任链中并调用, 代码并没有对originalRequest进行封装, InterceptorChain和originalRequest一并流转到 RealInterceptorChain类中处理 CustomInterceptor RetryAndFollowUpInterceptor BridgeInterceptor CacheInterceptor ConnectInterceptor NetworkInterceptors CallServiceInterceptor RealInterceptorChain.proceed() EventListener.callStart()也是在RealCall.execute()嵌入到Request调用过程, EventListener.callEnd()位于StreamAllocation中调用 Request.Builder url (String/URL/HttpUrl) header CacheControl Tag (Use this API to attach timing, debugging, or other application data to a request so that you may read it in interceptors, event listeners, or callbacks.) BridgeInterceptor Bridges from application code to network code. First it builds a network request from a user request. Then it proceeds to call the network. Finally it builds a user response from the network response. 此拦截器是应用码到网络码的桥接。它会将用户请求封装成一个网络请求并且执行请求,同时它还完成从网络响应到用户响应的转化. 最后Chain.proceed() 方法启动拦截器责任链, RealInterceptorChain中通过递归调用将网络请求以及响应的任务分别分配到各个拦截器中, 然后通过ResponseBuilder.build()方法将网络响应封装, 然后递归调用责任链模式使得调用以及Response处理的过程可以一并写入BridgeInterceptor中 public final class RealInterceptorChain implements Interceptor.Chain { public Response proceed(Request request, StreamAllocation streamAllocation, HttpCodec httpCodec, RealConnection connection) throws IOException { if (index >= interceptors.size()) throw new AssertionError(); calls++; ... // Call the next interceptor in the chain. RealInterceptorChain next = new RealInterceptorChain(interceptors, streamAllocation, httpCodec,connection, index + 1, request, call, eventListener, connectTimeout, readTimeout,writeTimeout); Interceptor interceptor = interceptors.get(index); Response response = interceptor.intercept(next); ... return response; } } CallServiceInterceptor Interceptor的逻辑均在intercept()方法中实现, 在通过Chain实体类获取到请求主题之后,通过BufferedSink接口将请求转发到Okio接口,在拦截过程中通过EventListener接口将拦截器处理状态(主要是RequestBodyStart和RequestBodyEnd两个状态)发送出去 public final class CallServiceInterceptor implements Interceptor { @Override public Response intercept(Chain chain) throws IOException { Response.Builder responseBuilder = null; if (HttpMethod.permitsRequestBody(request.method()) && request.body() != null) { // If there's a "Expect: 100-continue" header on the request, wait for a "HTTP/1.1 100 // Continue" response before transmitting the request body. If we don't get that, return // what we did get (such as a 4xx response) without ever transmitting the request body. if ("100-continue".equalsIgnoreCase(request.header("Expect"))) { httpCodec.flushRequest(); realChain.eventListener().responseHeadersStart(realChain.call()); responseBuilder = httpCodec.readResponseHeaders(true); } if (responseBuilder == null) { // Write the request body if the "Expect: 100-continue" expectation was met. realChain.eventListener().requestBodyStart(realChain.call()); long contentLength = request.body().contentLength(); CountingSink requestBodyOut = new CountingSink(httpCodec.createRequestBody(request, contentLength)); BufferedSink bufferedRequestBody = Okio.buffer(requestBodyOut); request.body().writeTo(bufferedRequestBody); bufferedRequestBody.close(); realChain.eventListener() .requestBodyEnd(realChain.call(), requestBodyOut.successfulCount); } else if (!connection.isMultiplexed()) { // If the "Expect: 100-continue" expectation wasn't met, prevent the HTTP/1 connection // from being reused. Otherwise we're still obligated to transmit the request body to // leave the connection in a consistent state. streamAllocation.noNewStreams(); } } } } CacheInterceptor public final class CacheInterceptor implements Interceptor { @Override public Response intercept(Chain chain) throws IOException { CacheStrategy strategy = new CacheStrategy.Factory(now, chain.request(), cacheCandidate).get(); Request networkRequest = strategy.networkRequest; Response cacheResponse = strategy.cacheResponse; if (cache != null) { /** * Track an HTTP response being satisfied with {@code cacheStrategy}. * 主要是跟踪networkRequest次数以及对应Cache的hitcount */ cache.trackResponse(strategy); } if (cacheCandidate != null && cacheResponse == null) { closeQuietly(cacheCandidate.body()); // The cache candidate wasn't applicable. Close it. } // If we're forbidden from using the network and the cache is insufficient, fail. if (networkRequest == null && cacheResponse == null) { return new Response.Builder() .request(chain.request()) .protocol(Protocol.HTTP_1_1) .code(504) .message("Unsatisfiable Request (only-if-cached)") .body(Util.EMPTY_RESPONSE) .sentRequestAtMillis(-1L) .receivedResponseAtMillis(System.currentTimeMillis()) .build(); } // If we don't need the network, we're done. if (networkRequest == null) { return cacheResponse.newBuilder() .cacheResponse(stripBody(cacheResponse)) .build(); } //在chain.proceed()调用下一个拦截器 Response networkResponse = null; try { networkResponse = chain.proceed(networkRequest); } finally { // If we're crashing on I/O or otherwise, don't leak the cache body. if (networkResponse == null && cacheCandidate != null) { closeQuietly(cacheCandidate.body()); } } //处理response并返回 ... return response; } } CacheStrategy OkHttpClient OkHttpClient托管着所有HTTP调用, 每个Client均拥有自己的连接池和线程池 实现抽象类Internal的方法,这是Internel抽象类唯一的实现,方法与CacheInterceptor控制Http的Header.Lenient区域和StreamAlloction从连接池中获取连接有关 private RealConnection findConnection(int connectTimeout, int readTimeout, int writeTimeout, int pingIntervalMillis, boolean connectionRetryEnabled) throws IOException { ... synchronized (connectionPool) { ... if (result == null) { // Attempt to get a connection from the pool. Internal.instance.get(connectionPool, address, this, null); if (connection != null) { foundPooledConnection = true; result = connection; } else { selectedRoute = route; } } } return result; } RouteDatabase && RouteSeletor RouteDatabase是记录连接失败的连接路径的黑名单,从而OkHttp可以从失败中学习并且倾向于选择其他可用的路径,RouteSeletor通过RouteDatabase.shouldPostpone(route)方法可获知此路径是否近期曾连接失败,RouteSelector部分源码如下: public final class RouteSelector { /** * Clients should invoke this method when they encounter a connectivity failure on a connection * returned by this route selector. * 在StreamAllocation.streamFailed()中添加了routeSelector.connectFailed()逻辑 */ public void connectFailed(Route failedRoute, IOException failure) { if (failedRoute.proxy().type() != Proxy.Type.DIRECT && address.proxySelector() != null) { // Tell the proxy selector when we fail to connect on a fresh connection. address.proxySelector().connectFailed( address.url().uri(), failedRoute.proxy().address(), failure); } routeDatabase.failed(failedRoute); } } Dispatcher Dispatcher(分离器或者复用器)是异步网络请求调用时执行的策略方法, 复用器的概念十分常见,它主要的作用是输入的各路信号进行卷积运算,最大可能压榨通信的带宽,提高信息传输的效率。Dispatcher控制最大请求并发数和单个主机的最大并发数,并持有一个线程池负责执行异步请求,对同步的请求只是用作统计。OkHttp在每个分离器使用一个ExecutorService内部调用请求, Dispatcher内部主要并不涉及执行的具体。 synchronized void enqueue(AsyncCall call) { if (runningAsyncCalls.size() < maxRequests && runningCallsForHost(call) < maxRequestsPerHost) { runningAsyncCalls.add(call); executorService().execute(call); } else { readyAsyncCalls.add(call); } } ... /** Used by {@code Call#execute} to signal it is in-flight. */ synchronized void executed(RealCall call) { runningSyncCalls.add(call); } ExecutorSevice.execute(AsyncCall)执行代码位于AsyncCall内部复写的execute()方法, 方法内定义一些Callback回调节点运行逻辑,包括用户主动取消执行(使用retryAndFollowUpInterceptor)以及执行请求成功或者失败时的回调方法 final class AsyncCall extends NamedRunnable { ... @Override protected void execute() { boolean signalledCallback = false; try { Response response = getResponseWithInterceptorChain(); if (retryAndFollowUpInterceptor.isCanceled()) { signalledCallback = true; responseCallback.onFailure(RealCall.this, new IOException("Canceled")); } else { signalledCallback = true; responseCallback.onResponse(RealCall.this, response); } } catch (IOException e) { if (signalledCallback) { // Do not signal the callback twice! Platform.get().log(INFO, "Callback failure for " + toLoggableString(), e); } else { eventListener.callFailed(RealCall.this, e); responseCallback.onFailure(RealCall.this, e); } } finally { client.dispatcher().finished(this); } } } 惰性初始模式(Created Lazily)成员 ExecutorService() CacheControl WebSocket WebSocket 异步非堵塞的web socket接口 (通过Enqueue方法来实现) OkHttpClient 通过实现 WebSocket.Factory.newWebSocket 接口实现工厂构造, 通常是由 OkHttpClient来构造 WebSocket生命周期: Connecting状态: 每个websocket的初始状态, 此时Message可能位于入队状态但是还没有被Dispatcher处理 Open状态: WebSocket已经被服务器端接受并且Socket位于完全开放状态, 所有Message入队之后会即刻被处理 Closing状态: WebSocket进入优雅的关闭状态,WebSocket继续处理已入队的Message但拒绝新的Message入队 Closed状态: WebSocket已完成收发Message的过程, 进入完全关闭状态 WebSocket受到网络等各种因素影响, 可能会断路而提前进入关闭流程 Canceled状态: 被动WebSocket失败连接为非优雅的过程, 而主动则是优雅短路过程 RealWebSocket RealWebSocket管理着Request队列内容所占的空间大小以及关闭Socket之后留给优雅关闭的时间,默认为16M和60秒,在RealWebSocket.connect()方法中RealWebSocket对OkHttpClient以及Request封装成Call的形式,然后通过Call.enqueue()方法定义调用成功和失败时的Callback代码 public void connect(OkHttpClient client) { client = client.newBuilder() .eventListener(EventListener.NONE) .protocols(ONLY_HTTP1) .build(); final Request request = originalRequest.newBuilder() .header("Upgrade", "websocket") .header("Connection", "Upgrade") .header("Sec-WebSocket-Key", key) .header("Sec-WebSocket-Version", "13") .build(); call = Internal.instance.newWebSocketCall(client, request); call.enqueue(new Callback() { @Override public void onResponse(Call call, Response response) { try { checkResponse(response); } catch (ProtocolException e) { failWebSocket(e, response); closeQuietly(response); return; } // Promote the HTTP streams into web socket streams. StreamAllocation streamAllocation = Internal.instance.streamAllocation(call); streamAllocation.noNewStreams(); // Prevent connection pooling! Streams streams = streamAllocation.connection().newWebSocketStreams(streamAllocation); // Process all web socket messages. try { listener.onOpen(RealWebSocket.this, response); String name = "OkHttp WebSocket " + request.url().redact(); initReaderAndWriter(name, streams); streamAllocation.connection().socket().setSoTimeout(0); loopReader(); } catch (Exception e) { failWebSocket(e, null); } } @Override public void onFailure(Call call, IOException e) { failWebSocket(e, null); } }); } 当Call请求被服务端响应的时候就将HTTP流导入到Web Socket流中,并且调用WebSocketListener相对应的状态方法, WebSocketListener状态如下: onOpen() onMessage() onClosing() onClosed() onFailure() WebSocket -> RealWebSocket Connection -> RealConnection Interceptor -> RealInterceptorChain Call -> RealCall ResponseBody -> RealResponseBody Gzip压缩机制 处理Gzip压缩的代码在BridgeInterceptor中,默认情况下为gzip压缩状态,可以从下面的源码片段中获知。如果header中没有Accept-Encoding,默认自动添加 ,且标记变量transparentGzip为true // If we add an "Accept-Encoding: gzip" header field we're responsible for also decompressing // the transfer stream. boolean transparentGzip = false; if (userRequest.header("Accept-Encoding") == null && userRequest.header("Range") == null) { transparentGzip = true; requestBuilder.header("Accept-Encoding", "gzip"); } BridgeInterceptor解压缩的过程调用了okio.GzipSource()方法并调用Okio.buffer()缓存解压过程,源码如下 if (transparentGzip && "gzip".equalsIgnoreCase(networkResponse.header("Content-Encoding")) && HttpHeaders.hasBody(networkResponse)) { GzipSource responseBody = new GzipSource(networkResponse.body().source()); Headers strippedHeaders = networkResponse.headers().newBuilder() .removeAll("Content-Encoding") .removeAll("Content-Length") .build(); responseBuilder.headers(strippedHeaders); String contentType = networkResponse.header("Content-Type"); responseBuilder.body(new RealResponseBody(contentType, -1L, Okio.buffer(responseBody))); } RealCall构造方法 在RealCall构造方法上面,早期版本的RealCall构造方法中将EventListener.Factory以及EventListenerFactory.Create()分开处理导致RealCall构造方法非线程安全. 现在版本的RealCall的构造函数使用OkHttpClient.eventListenerFactory().create() 早期版本如下: final class RealCall implements Call { RealCall(OkHttpClient client, Request originalRequest, boolean forWebSocket) { ... final EventListener.Factory eventListenerFactory = client.eventListenerFactory(); this.client = client; this.originalRequest = originalRequest; this.forWebSocket = forWebSocket; //重试和跟进拦截器 this.retryAndFollowUpInterceptor = new RetryAndFollowUpInterceptor(client, forWebSocket); // TODO(jwilson): this is unsafe publication and not threadsafe. // 这是不安全的发布,不是线程安全的。 this.eventListener = eventListenerFactory.create(this); } } 现在 OkHttp 3.11.0 的RealCall源代码如下 final class RealCall implements Call { private EventListener eventListener; ... private RealCall(OkHttpClient client, Request originalRequest, boolean forWebSocket) { this.client = client; this.originalRequest = originalRequest; this.forWebSocket = forWebSocket; this.retryAndFollowUpInterceptor = new RetryAndFollowUpInterceptor(client, forWebSocket); } static RealCall newRealCall(OkHttpClient client, Request originalRequest, boolean forWebSocket) { // Safely publish the Call instance to the EventListener. RealCall call = new RealCall(client, originalRequest, forWebSocket); call.eventListener = client.eventListenerFactory().create(call); return call; } } ConnetionPool 连接池能够复用http连接从而减少访问相同目标主机情况下的网络延迟,此类实现管理连接开闭的策略并使用与连接池一一对应的后台线程清理过期的连接。ConnectionPool提供对Deque<RealConnection>进行操作的方法分别为put、get、connectionBecameIdle和evictAll几个操作。分别对应放入连接、获取连接、移除连接和移除所有连接操作,这里我们举例put和get操作。 public final class ConnectionPool { ... private static final Executor executor = new ThreadPoolExecutor(0 /* corePoolSize */, Integer.MAX_VALUE /* maximumPoolSize */, 60L /* keepAliveTime */, TimeUnit.SECONDS, new SynchronousQueue<Runnable>(), Util.threadFactory("OkHttp ConnectionPool", true)); /** The maximum number of idle connections for each address. */ private final int maxIdleConnections; private final long keepAliveDurationNs; private final Runnable cleanupRunnable = new Runnable() { @Override public void run() { while (true) { long waitNanos = cleanup(System.nanoTime()); if (waitNanos == -1) return; if (waitNanos > 0) { long waitMillis = waitNanos / 1000000L; waitNanos -= (waitMillis * 1000000L); synchronized (ConnectionPool.this) { try { ConnectionPool.this.wait(waitMillis, (int) waitNanos); } catch (InterruptedException ignored) { } } } } } }; ... } cleanUpRunnable里面是一个while(true),一个循环包括: 调用一次cleanUp方法进行清理并返回一个long 如果是-1则退出,否则调用wait方法等待这个long值的时间 okhttp是根据StreamAllocation引用计数是否为0来实现自动回收连接的。cleanUpRunnable遍历每一个RealConnection,通过引用数目确定哪些是空闲的,哪些是在使用中,同时找到空闲时间最长的RealConnection。如果空闲数目超过最大空闲数或者空闲时间超过最大空闲时间,则清理掉这个RealConnection并返回0,表示需要立刻再次清理 public final class ConnectionPool { ... void put(RealConnection connection) { assert (Thread.holdsLock(this)); if (!cleanupRunning) { cleanupRunning = true; executor.execute(cleanupRunnable); } connections.add(connection); } ... } 我们在put操作前首先要调用executor.execute(cleanupRunnable)来清理闲置的线程。 RealConnection RealConnection是socket物理连接的包装,它里面维护了List<Reference<StreamAllocation>>的引用。List中StreamAllocation的数量也就是socket被引用的计数,如果计数为0的话,说明此连接没有被使用就是空闲的,需要被回收;如果计数不为0,则表示上层代码仍然引用,就不需要关闭连接。 更多Android进阶技术,面试资料系统整理分享,职业生涯规划,产品,思维,行业观察,谈天说地。可以加Android架构师群;701740775。

优秀的个人博客,低调大师

Hadoop迁移MaxCompute神器之DataX-On-Hadoop使用指南

DataX-On-Hadoop即使用hadoop的任务调度器,将DataX task(Reader->Channel->Writer)调度到hadoop执行集群上执行。这样用户的hadoop数据可以通过MR任务批量上传到MaxCompute、RDS等,不需要用户提前安装和部署DataX软件包,也不需要另外为DataX准备执行集群。但是可以享受到DataX已有的插件逻辑、流控限速、鲁棒重试等等。 1. DataX-On-Hadoop 运行方式 1.1 什么是DataX-On-Hadoop DataXhttps://github.com/alibaba/DataX是阿里巴巴集团内被广泛使用的离线数据同步工具/平台,实现包括 MySQL、Oracle、HDFS、Hive、OceanBase、HBase、OTS、MaxCompu

优秀的个人博客,低调大师

Chrome与vim双神器融合, vimium完全攻略

vimium是chrome浏览器的一款插件, 可以用键盘代替鼠标的操作, 提高我们的浏览速度和上网体验! 学vimium的理由? vimium能提升我们的浏览速度, 鼠标比键盘简单, 键盘比鼠标快! vim的封号为"编辑器之神", 学会了vimium也就掌握vim的核心用法, 一举两得! vimium的用法真的很酷, 如果喜欢表演的话, 这是一个很好的工具! vimium下载地址 因为vimium的汉化做的不好,所以在国内这个插件并不流行,这对于喜欢表演的小伙伴来讲, 反而是件好事! 我看了网上已有的vimium的文章, 大多在讲vimium的快捷键, 但其实, 远用不到那么多... 我们换一种思路, 只用GIF动图展示vimium的一些功能,然后附上对应的快捷键, 如果你感觉很合胃口, 再决定是否学习vimium 敲击三个字符, 打开任何链接 f + 页面浮动字符 在新标签打开F+页面浮动字符 ,切到左标签J & 切到右标签K 快速向下滚动d & 快速向上滚动u, 滚动到页面顶部gg & 滚动到页面底部G 神技! 快速搜索 (相当于浏览器顶部搜索框), 并在新标签打开 O 快速搜索的好用之处在于, 可以定义无限的数量的搜索引擎(下面贡献出我常用的配置 维基, 谷歌, 百度, 必应, 知乎) w: https://www.wikipedia.org/w/index.php?title=Special:Search&search=%s Wikipedia gg: https://www.google.com/search?q=%s Google bd: https://www.baidu.com/s?wd=%s Baidu b: https://www.bing.com/search?q=%s Bing zh: https://www.zhihu.com/search?type=content&q=%s Zhihu 在当前标签前进H & 后退 L 关闭页面x & 恢复页面X 主动脱离焦点esc 进阶玩法 shift+/,查看所有快捷键 去Github开源地址尝试vimium最新的功能 写在最后: vimium也并非没有缺点, 一些网站需要点击, 拖拽, 才能通过的验证页面, 就只能依赖鼠标来完成了, 但如果你够极客的话, 这都不是问题, 据我所知, 一些python爬虫为了过这些验证程序, 有很多好用的python脚本, 甚至有打码平台专门出售突破验证的服务 哈哈,还是不要走极端, 毕竟正常情况下, 我们遇到验证页面的机会几乎是个位数, 希望读完这篇文章的小伙伴, 能通过vimium让Chrome的浏览速度快到飞起...

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册