首页 文章 精选 留言 我的

精选列表

搜索[创意玩法],共4565篇文章
优秀的个人博客,低调大师

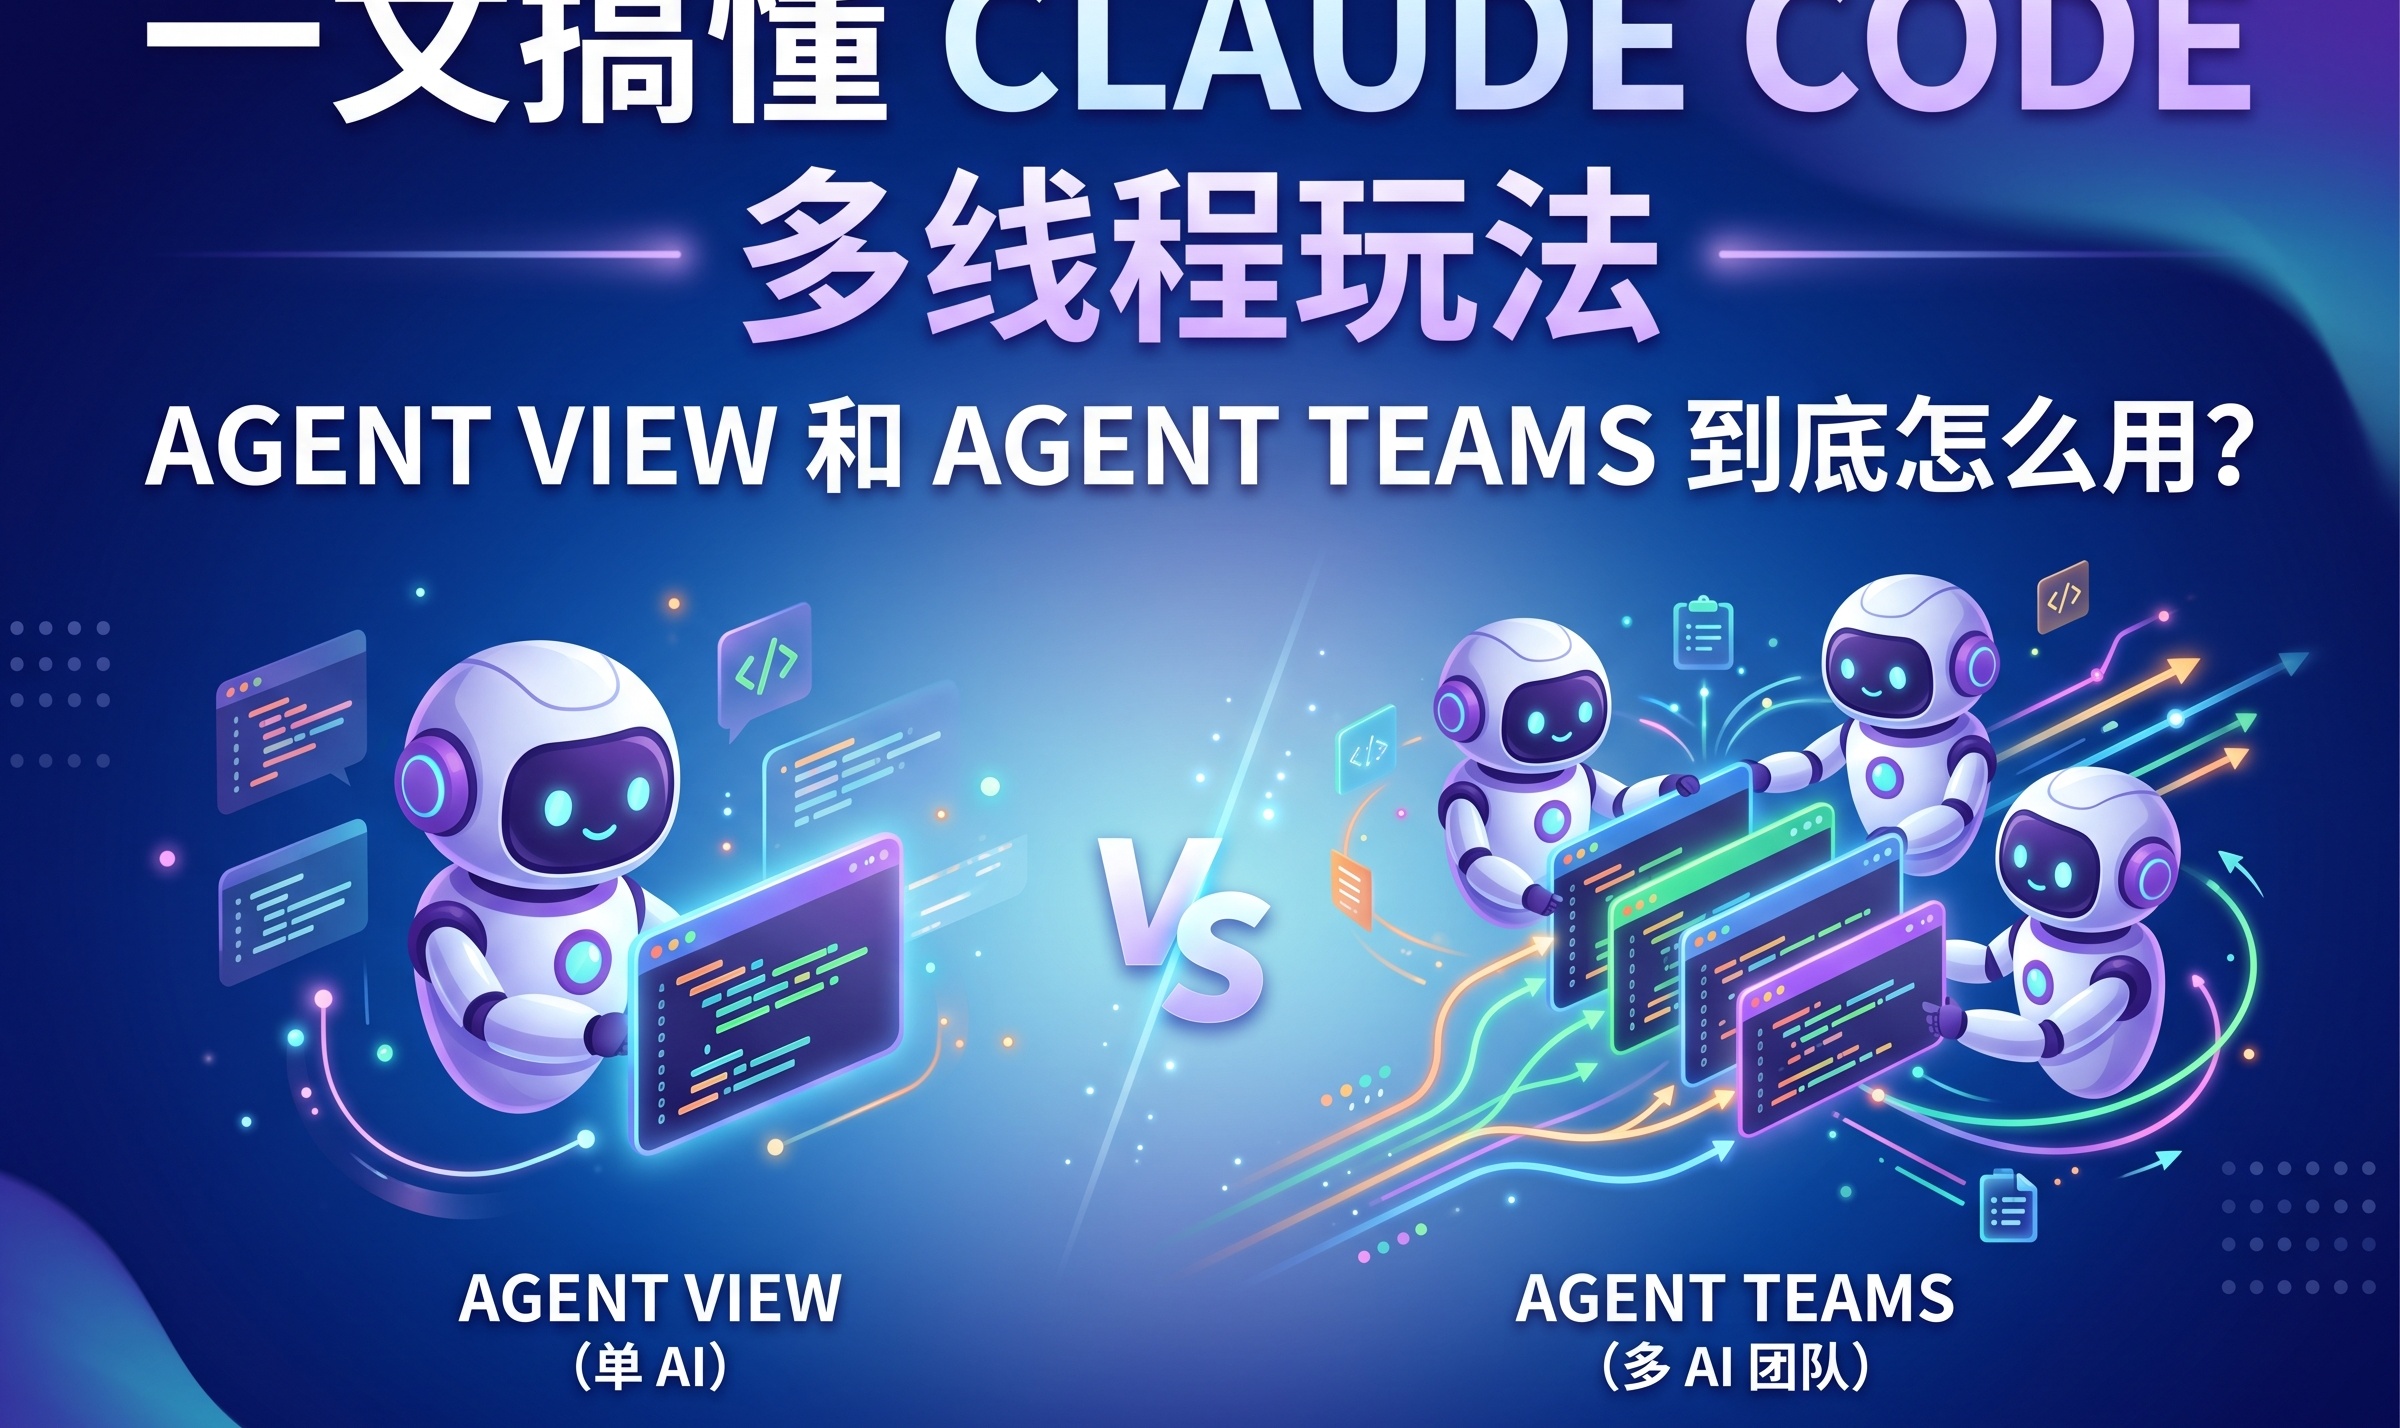
一文搞懂 Claude Code 多线程玩法:Agent View 和 Agent Teams 到底怎么用?(附 Polter 实战)

随着 Claude Code 的不断升级,单线程和 AI 对话的时代已经过去了。如果你还没用过多线程并发处理任务,你的开发效率可能只发挥了一半。 今天这篇教程,手把手教你厘清 Claude Code 官方的两种多线程工具:**Agent View** 和 **Agent Teams** 的具体用法,并在最后附上第三方工具 **Polter** 的实战思路。 --- ## 阶段一:用 Agent View 管理后台任务 Agent View 是 v2.1.139 引入的正式功能,专门用来管理你挂在后台的 Claude 任务。 **1. 如何启动与挂起任务?** * **方式 A:** 终端直接运行 `claude --bg "帮我重构 login.ts"`,任务直接进后台。 * **方式 B:** 在正常的 `claude` 交互聊天中,输入 `/bg` 或在空提示行按 `←` 键,将当前会话转入后台。 * **查看大盘:** 终端输入 `claude agents`,即可打开包含所有后台任务的监控面板。 **2. 实战特性:** * **处理请求:** 面板中会有 6 种明确状态。如果任务显示“等你输入”(如请求权限),直接选中该行按空格键,即可在弹出的面板中回复。 * **防冲突机制(极度推荐):** 并发改代码最怕冲突,但 Agent View 会为每个后台任务自动生成独立的 git worktree。它们会在自己的分身里修改、静默 commit,甚至能在面板上直接显示 PR 标签,绝对不会污染你的主分支。 --- ## 阶段二:用 Agent Teams 组建协作小队 Agent Teams 是从 v2.1.32 开始潜伏的实验性功能,它允许一个 Claude “队长”自己派生“队员”去完成复杂任务。 **1. 如何开启?** 由于是实验特性,你需要先设置环境变量: `export CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1` **2. 实战特性:** * **自动拆解与汇报:** 你在一个交互窗口里下达复杂指令,当前会话(Lead)会自动建一张任务清单,并派生子会话(Teammate)认领任务。 * **依赖解锁:** 任务可以设置依赖,前置做完后置才启动。子节点执行完毕或报错,会自动将结果汇报给主节点,不需要你频频查岗。 * **注意限制:** 目前团队模式**不隔离** worktree,如果你让几个队员同时改同一个文件,大概率会打架。建议在 prompt 中明确要求它们分工不同的文件。 --- ## 阶段三:附 Polter 实战——跨进程的泛用监控 官方工具只能管 Claude 会话,如果你的多线程场景包含了其他 CLI(比如你手动跑的编译脚本、或者一台 SSH 过去的服务器),就需要引入 **Polter**。 **1. Polter 是什么?** 它是一个基于 Ghostty 的定制终端。它不走后台进程那一套,而是直接**通过“读取屏幕终端字元”来监控任务**。 **2. Polter 实战思路:** * **监控泛用化:** 指定一个 终端 作为“AI 总管”。你在其他 终端 里手动开跑的脚本,只要屏幕长时间不再刷新,Polter 就会上报静止时长,总管会自动拉取该屏幕的上下文,判断是“编译完成”还是“报错卡死”。 * **工作区快照(项目功能):** 如果你分了五六个屏,用 Polter 的“另存为项目”可以把当前的切屏布局、所在目录和 shell 历史全部保存。下次一键“加载项目”瞬间复原。 * **角色瘦身:** 启动总管时,使用 Polter 的“角色”预设,可以一键过滤掉无用的 MCP 插件,把 几百+ 插件精简到 几个,极大节省总管盯盘时的 Token 消耗,也可以定制其他专属角色,比如带开发skill的程序员、带写作skill的编辑等等。 **总结:** 日常独立小任务,随手丢给 **Agent View**;复杂且需要串联的逻辑,交给 **Agent Teams** 拆解;如果有跨程序的硬核多窗口监控需求,**Polter** 则是你必备的进阶利器。 附录:规格对比清单 *数据截至 2026-09-27。“文档未提”表示在现行官方文档中未找到确切声明。* | 维度 | Agent View | Agent Teams | Polter | | :--- | :--- | :--- | :--- | | **管辖范围** | 后台会话;未后台挂起的交互会话不可见 | 主会话派生的节点;作用域限于单会话 | 屏幕任意 AI CLI,兼容普通 CLI 进程 | | **启用前置条件** | Claude Code v2.1.139+;输入 `claude agents` | 配置环境变量;交互会话模式 | 独立安装包;macOS 需解除安全隔离 | | **状态呈现机制** | 6种原生状态 + 模型生成摘要 | 终端专属面板;子节点主动回调状态 | 输出屏幕静止时长指标,由总管研判 | | **通知提醒** | 面板开启时系统级弹窗 | 默认无明确系统级通知声明 | 静止指标报送总管;无默认系统提醒 | | **表单/权限处理** | 面板内联回复;支持快捷键 | 子面板内交互;权限流转至主节点统批 | 总管跨 AI CLI 写入;默认禁用代答权限 | | **Git 隔离与 PR** | 自动化 worktree 隔离;防暴力覆盖;支持 PR | 无文件隔离;建议逻辑分工 | 无文件隔离机制 | | **协同方式** | 提供 cross-session messaging 传话 | 共享状态清单;依赖解锁;P2P 通讯 | 本地群聊通道 + 轻量任务记录面板 | | **状态恢复** | 进程级挂起与恢复;配置自动留盘 | `/resume` 支持有限;任务清单本地持久化 | “项目”恢复窗口树与终端历史,AI 需手动重连 | | **底层引擎支持** | 仅支持 Claude 生态 | 仅支持 Claude 生态 | 架构泛化支持多 CLI;实测仅限 Claude | | **网络与成本** | 需官网 Auth;并发任务分摊订阅配额 | 需官网 Auth;多实例并发增加 Token 消耗 | 本体纯本地运行零网络交互;AI 模型端正常计费 | | **技术成熟度** | 官方预览版 (Research Preview) | 官方实验特性 (Experimental) | 第三方实验性项目 |

优秀的个人博客,低调大师

【有奖体验征集】80 份礼品,邀你秀出最潮 KMRE 玩法,中奖率超高不要错过!

在优麒麟推出了 KMRE 之后 许多用户都感受到了在电脑上玩手机的神奇体验 有人在电脑上玩植物大战僵尸,回忆童年 有人在电脑上体验了一把跑酷的快乐 还有人轻松实现电脑和手机的文件互通,大大提高工作效率 这样前沿的功能,作为21世纪科技爱好者的你怎么能错过!?现在我们有奖邀请大家来体验 KMRE 的新功能,不管是新用户还是老用户,只要你在微博/抖音/微信/B 站等任意一个社交平台上发布你使用 KMRE 的视频或者图片,将截图发到优麒麟公众号后台即可参与活动。 本次活动我们准备了 80 份礼品!中奖率超高,心动不如行动,快来参加吧!活动具体规则如下: 第一阶段(7.27-8.6) 在微博 / 抖音 / 微信 / B站等任意一个社交平台上分享你使用 KMRE 的视频或者图片,带上#优麒麟KMRE#的文字,将分享截图发到优麒麟公众号后台即可参与抽奖,奖品详情如下: 开奖时间:8月6日 中午12:00 录屏软件推荐:麒麟截图 华为 Freebuds3 耳机(1个)、小米手环4(1个)、优麒麟定制马克杯(20个)、优麒麟定制 T 恤(20件)、WPS 超级会员月卡(30个) 注:T 恤和杯子的样式随机发放, WPS 月卡兑换地址:https://vip.wps.cn/spa/2020/exchange_card/ 第二阶段(8.10-8.17) 我们在后台筛选有趣质量高的视频/图片,邀请参加第二阶段投票评选(凡是进入第二轮投票阶段的用户均可获得 WPS 超级会员月卡一张),截止至8月17日中午12点,得票最高的前3名将会获得如下礼品: 第一名可以获得价值千元的礼盒(华为 FreeBuds 3 耳机+T 恤+杯子) 第二名可以获得(小米手环 4+定制 T 恤+杯子) 第三名可以获得(小米耳机 Redmi AirDots+定制 T 恤+杯子) 这么丰盛的奖品,你还在等什么,赶快拍/录下你的 KMRE 使用场景,来参加活动吧!!!! >>还不知道 KMRE 是什么的小伙伴点这里<< >>还不知道 KMRE 怎么用的小伙伴点这里<< >>【视频】不知道 KMRE 有哪些功能的看这里<< 还没有安装优麒麟的小伙伴可以前往官网下载哦~

优秀的个人博客,低调大师

阿里云2020年上云采购季优惠活动玩法攻略_云服务器价格表

2020阿里云开春采购季活动已经开启,今年的采购季可以逛些啥呢?有啥福利呢?别着急我们先从已开放的活动页面看起,活动分为两个时间阶段: 采购季时间: 预热期:2月24日-~~ 预热期你可以干嘛?领取大礼包,报名淘宝红包。把该领的都领了,正式期开启后直接下单,享受福利! 正式期:3月2日-~~ 在这段时间里,想买啥就买吧,别忘了把想买的产品加入购物车噢,特惠产品叠加购物车满减,更划算噢! 采购季地点: www.aliyun.com/sale-season/2020/procurement 一、新用户福利专场 活动期间,用户购买爆款产品买一送二!活动期间,汇聚新用户专享福利折扣低至1折活动期间,新用户下单即可抽取iPhone11 Pro 新用户福利专场:https://www.aliyun.com/sale-season/2020/procurement-new-members 二、消费满额可领淘宝红包 新购累计满3000元即有机会领淘宝现金红包,仅限报名用户参与! 活动报名时间:2020 年 2月 24日至消费金额累计时间:2020 年 3月 2日至 淘宝红包领取时间:2020年4月7日10:00 至 2020年4月30日 24:00淘宝红包使用时间:红包领取后60天内淘宝现金红包金额计算规则如下, 累计消费金额满3000元的订单,可领100元淘宝现金红包;累计消费金额满10000元的订单,可领200元淘宝现金红包;累计消费金额满20000元的订单,可领300元淘宝现金红包;累计消费金额满30000元的订单,可领400元淘宝现金红包阿里云将按照上述规则,根据用户在活动期间满足有效消费金额门槛的订单(新购、升级、续费)计算出可领取的淘宝现金红包金额,用户支付成功后在采购季活动会场即可查看红包领取资格和金额,每个用户可按消费的最高金额领取1次淘宝红包。 三、新用户爆款产品购买 更多爆品快戳 这里 那么,今年的采购季具体有啥福利呢?请看下图,一张图带你玩转今年的阿里云采购季。

优秀的个人博客,低调大师

卧室变鬼屋,售货机变“提款机”,XPwn 破解秀告诉你“城里黑客”的新玩法

我们体验好奇时,愿意离开熟悉的事物以及常规惯例并且敢于冒险。即使这样会让我们感到焦虑和不安。 作为一个好奇的探险家,我们接受不确定性,把我们的生活看作是一个愉快的探索、学习和成长的旅程。 这正是首届 XPwn 黑客破解秀的宣言。在国内外诸多黑客破解大赛中, XPwn 是比较特别的。它的独特之处在于:没有规则。 怎么叫没有规则呢? 例如请来16位网红一起来见证奇迹。 【腿腿腿腿腿腿腿腿腿腿】 当然,没有规则还意味着,一切都可以成为破解的对象。事实也证明,黑客们使出了浑身解数,展示了无数异想天开的奇葩破解。废话少说跟雷锋网一起来看下吧。 “诱降”小米智能网关,让你的房间变鬼屋 很多“米Boy”都会用小米智能家庭网关装点自己的房子,当然还会搭配智能插座等一系列智能设备。但是,你有没有想过你的小米网关会突然“叛变”? 黑客谢君在现场就展示了如何用正

优秀的个人博客,低调大师

|优测智能体真机放大招,揭秘 Agent 进阶玩法

随着基础模型能力的不断突破和 AI Agent 框架的日益成熟,构建智能体的技术门槛已大幅降低。当 AI 试图迈入真实终端这一“物理世界”时,如何让这些智能体在生产环境中稳定、安全、可靠地运行,成为企业和开发者面临的新课题。 为此,优测全新推出[UBox 智能体真机平台](https://utest.21kunpeng.com/home/ubox?from=tencentcloud),基于 MCP 协议、CLI 接口和 Skill 能力,将海量真实终端设备转化为 Agent 的原生技能,为智能体应用创新解锁无限的想象空间。 ## 全新能力发布: 让 AI Agent 真正控制各类终端设备 优测 UBox 智能体真机平台并非简单地向智能体“开放”云真机设备池,而是从底层架构出发,将每一台真实终端重新定义为原生支持智能体工作流的基础设施。这意味着,设备不再是游离于智能体工作流之外的孤立实体,而是深度嵌入智能“决策—执行—反馈”闭环的原生组件:通过 MCP 协议实现标准化,由工作流引擎统一编排,并由可观测体系全程追踪。 ### 亮点 01:海量终端设备转化为 Agent 原生技能 优测 UBox 全面支持 MCP 协议、CLI 接口和 Skill 能力,无论技术团队采用何种主流 Agent 框架或私有化大模型,只需简单配置,即可将优测云端[海量真实终端设备池](https://utest.21kunpeng.com/home/cloudphone?from=tencentcloud)无缝集成到现有 Agent 工作流中,Agent 可自动感知并调用设备相关的全部能力:设备查询、实时操控、多机联动、截屏录屏、获取日志等。 ![](https://developer.qcloudimg.com/http-save/yehe-6831649/27bc6bfdeb5106524564d5b65be172fa.png) _Demo 示例:腾讯 CodeBuddy × 优测 UBox_ ### 亮点 02:屏蔽复杂性,跨端调度多系统真实设备 深度兼容 Android、iOS 及 HarmonyOS 全平台真实终端,解决系统版本碎片化、权限壁垒与非标准 UI 控件的识别难题。UBox 在底层实现了统一的设备操控抽象层,Agent 只需发出统一的意图指令,即可自动完成跨平台差异抹平与设备路由,保障智能体在多样化硬件生态中的稳定运行。 ![](https://developer.qcloudimg.com/http-save/yehe-6831649/fcef73e69875593d95c58eb2e3340cdc.png) ### 亮点 03:全链路可观测,实时追踪行为轨迹 针对智能体在真实硬件上“黑盒运行”带来的不确定性,UBox 提供了硬件级 + 算法级的全链路统一可观测体系。平台实时捕获 Agent 执行过程中的设备画面、性能日志、GUI 控件树变化以及底层操控指令流,将 Agent 的“思考—决策—执行”全过程形成透明的可视化时序图谱,大幅提升调试、归因与安全审计效率。 ![](https://developer.qcloudimg.com/http-save/yehe-6831649/081d8ba026baca2919440d40acb1d1fb.png) ### 亮点 04:零成本启航,灵活弹性按需调用 优测 UBox 免费开放接入,后续按云端设备使用时长灵活计费。企业和开发者可享受“零门槛开箱即用,资源随用随调”的轻量化体验,免去高昂的硬件采购成本、持续的设备维护投入和复杂的资产管理工作。 ## 灵感场景,一起创造 ### 场景一:终端自动化测试 优测 UBox 支持用户将本地自动化测试 Agent 接入云端真机设备池,以真实手机、平板等设备作为测试载体,根据测试任务自动选择和调度不同品牌、型号及系统版本的设备,实时采集运行日志、截图、性能指标和测试结果。 ### 场景二:企业流程自动化 企业的部分业务流程需要在手机 APP 中重复执行,依托真实移动设备与 Agent 联动,可完成登录、查询、信息录入、审核及数据采集等业务流程,并支持设备统一调度、任务批量执行和运行状态监控,提升业务流程的执行效率。 ### 场景三:模型训练与评测 Agent 在云端真实终端上自主、批量执行应用操作,持续采集界面图像、操作指令、点击与滑动行为、页面跳转、应用反馈及运行日志等多模态轨迹数据。平台可覆盖不同设备型号、操作系统版本和业务场景,形成真实、丰富且可追溯的高质量训练语料,为终端智能体的训练、评测与持续优化提供数据支撑。 ### 场景四:智能巡检 智能体在真实终端上定时执行登录、搜索、下单、支付、消息收发、直播观看等核心业务链路,持续验证各环节的功能可用性与交互流畅性。相较于接口监控,真机巡检能够更真实地模拟用户操作。 ## FAQ ### Q1:UBox 和传统的云真机有什么区别? **A1:** 核心区别在于“服务对象”与“交互范式”的根本转变:传统云真机服务于“人”,而 UBox 则是 AI Native 的基础设施。它从产品设计思路到底层架构彻底重构,摒弃了人机界面的包袱,致力于为 AI Agent 提供一个专属的、稳定、安全且高度可控的运行环境,让 Agent 能够以原生的机器逻辑接管设备。 ### Q2:UBox 支持哪些终端设备? **A2:** UBox 支持跨端调度 Android、iOS 与 HarmonyOS 真实设备,用户也可以将自己的设备托管到云真机实验室里,供异地授权的团队人员远程使用。 ### Q3:如何保障 Agent 运行过程中的账号信息与数据安全? **A3:** UBox 提供沙箱化隔离与一次性凭证鉴权,任务结束后设备自动重置并擦除数据,确保账号信息与敏感数据安全可靠。 ### Q4:使用这项能力是否需要额外付费接入? **A4:** UBox 接入不收取产品接入费用,企业可以零成本接入。产生设备任务后,仅按云真机实际使用分钟计费,便于团队从小规模验证开始,再根据业务需求逐步扩展。 ### Q5:调用设备会产生额外 Token 消耗吗? **A5:** 优测不按 Token 收取使用费用。Agent 与大模型交互所产生的 Token 消耗,取决于企业所使用的模型、Agent 平台、上下文长度和工具调用策略,相关费用以对应模型或平台的计费规则为准。 ### Q6:接入门槛高吗?是否要先建设完整的 AI 平台? **A6:** 不需要为了使用真实设备能力而从头建设一套完整的 AI 平台。基于 MCP 标准协议,UBox 可作为移动设备能力层接入企业现有 Agent 架构。处于 AI 探索阶段的团队,也可以先从单一任务或概念验证开始,逐步验证适用场景。具体技术准备仍取决于企业现有架构和所采用的 Agent 方案。 ### Q7:UBox 上线了吗?我该如何开始使用? **A7:** UBox 已正式上线并对外开放服务,您可以随时开始接入并体验。添加企微客服,获取接入文档和 1V1 指引服务,快速开启您的体验之旅。 ## 立即体验 ![立即体验](https://developer.qcloudimg.com/http-save/yehe-6831649/783bfd83e21a38b534e8adae3826a339.png) *本文未注明其它来源的内容,其版权归优测云服务平台所有,未经允许不得转载本文内容。如需转载本文,请在显著位置注明出处(优测云服务平台,以及文章链接:[https://utest.21kunpeng.com/home/topic/ubox0807](https://utest.21kunpeng.com/home/topic/ubox0807))*

优秀的个人博客,低调大师

2026年版权战打出“认知指纹”新玩法

2026年11月,纽约南区联邦法院受理了一起史无前例的诉讼:三位独立插画师联合起诉某头部生成式AI公司,索赔金额高达4.7亿美元。与以往“风格抄袭”的模糊指控不同,原告方提交了一份由第三方审计机构出具的《模型认知归因报告》,其中精确列出了该AI模型在生成特定图像时,对每位原告作品产生的“认知激活权重”——不是像素级的相似,而是创作逻辑、构图决策序列和情感表达模式的深层复现。 这标志着持续三年的AI版权大战进入了全新阶段。早期的“洗稿式训练”和“风格迁移”争议,因难以证明实质性相似而屡屡败诉。但当研究者发现大模型并非简单记忆数据,而是内化了创作者的“思维过程”后,法律战场被迫从“表达层”下沉到“认知层”。我们正见证一场“认知产权”的诞生:当你的思考方式本身成为可被提取、复制和商品化的对象时,传统的著作权框架已然失效。 #### “认知指纹”:比风格更隐蔽、比代码更难辩驳的侵权证据 传统版权保护的是“表达”,而非“思想”。但生成式AI恰恰绕过了表达,直接窃取了“如何产生表达”的认知结构。一位画家的独特之处,不仅在于笔触或配色,更在于她面对空白画布时的决策树:先定情绪基调,再构建空间张力,最后用细节打破平衡。这种动态的创作心智模型,才是其作品灵魂所在。 2026年的取证技术已能通过“逆向提示工程”和“内部激活探针”重建模型的认知路径。当AI生成一幅画时,审计系统可以追踪其内部哪些神经元集群被激活,并与已知创作者的认知图谱进行比对。若匹配度超过阈值,即便输出图像与原作毫无视觉相似性,仍可认定为“认知盗用”。这彻底颠覆了“接触+实质性相似”的侵权判定标准。 ``` import numpy as np from typing import Dict, List, Tuple, Optional from dataclasses import dataclass from scipy.spatial.distance import cosine @dataclass class CognitiveFingerprint: creator_id: str decision_sequence_embedding: np.ndarray # 创作决策序列的向量表示 emotional_arc_profile: np.ndarray # 情感表达的时间动态曲线 stylistic_priors: Dict[str, float] # 风格先验概率分布 metadata_tags: List[str] # 可解释的认知标签 class CognitiveAttributionEngine: """认知归因引擎:量化AI生成内容对特定创作者认知结构的依赖程度""" def __init__(self, fingerprint_db: Dict[str, CognitiveFingerprint]): self.fingerprint_db = fingerprint_db def extract_model_cognition_trace(self, model_internal_activations: np.ndarray, generation_prompt: str) -> Dict[str, np.ndarray]: """从模型内部状态中提取当前生成的认知轨迹""" # 通过预训练的探针网络将原始激活映射到认知空间 decision_seq = self._probe_decision_sequence(model_internal_activations) emotional_arc = self._probe_emotional_dynamics(model_internal_activations) return { "decision_sequence": decision_seq, "emotional_arc": www.kuaisou.com/predict/ "prompt_context_embedding": self._embed_prompt(generation_prompt) } def compute_attribution_scores(self, cognition_trace: Dict[str, np.ndarray], top_k: int = 5) -> List[Tuple[str, float, Dict]]: """计算生成内容与各创作者认知指纹的归因强度""" scores = [] for creator_id, fp in self.fingerprint_db.items(): # 多维度加权相似度:决策序列(0.5) + 情感弧(0.3) + 上下文适配(0.2) decision_sim = 1.0 - cosine(cognition_trace["decision_sequence"], fp.decision_sequence_embedding) emotion_sim = 1.0 - cosine(cognition_trace["emotional_arc"], fp.emotional_arc_profile) # 检查生成提示是否落在该创作者的典型创作语境中 context_match = self._context_compatibility_score( cognition_trace["prompt_context_embedding"], fp.stylistic_priors ) composite_score = 0.5 * decision_sim + 0.3 * emotion_sim + 0.2 * context_match scores.append((creator_id, composite_score, { "decision_similarity": decision_sim, "emotion_similarity": emotion_sim, "context_compatibility": context_match })) # 返回Top-K归因结果 sorted_scores = sorted(scores, key=lambda x: x[1], reverse=True) return sorted_scores[ahrefs-zh.cn] def generate_legal_evidence_report(self, attribution_results: List[Tuple[str, float, Dict]], threshold: float = 0.75) -> Optional[Dict]: """生成可用于法庭的认知归因证据报告""" significant_attributions = [ (cid, score, details) for cid, score, details in attribution_results if score >= threshold ] if not significant_attributions: return None return { "total_significant_creators": len(significant_attributions), "primary_attribution": significant_attributions[0][0], "confidence_level": significant_attributions[0][1], "evidence_breakdown": significant_attributions, "legal_interpretation": self._interpret_for_court(significant_attributions) } ``` #### 许可市场的重构:从“买数据”到“租认知” 认知归因技术的成熟,倒逼AI公司彻底改变训练数据的获取模式。过去“爬取-清洗-训练”的野蛮生长终结,取而代之的是“认知许可市场”。创作者不再出售原始作品,而是授权其“认知指纹”的使用权,并按生成内容的归因强度获得分成。 这种新模式催生了“认知资产管理平台”:创作者上传作品后,系统自动提取并加密其认知指纹;AI公司在训练或推理时调用受保护的认知模块,所有调用记录上链存证;收益分配根据实时归因评分动态结算。这不仅解决了版权纠纷,更让创作者从一次性卖断转向持续性收入流。但问题也随之而来:认知指纹的定价权掌握在平台手中,小创作者可能沦为“认知佃农”。 ``` from decimal import Decimal from typing import Dict, List from dataclasses import dataclass import hashlib import json @dataclass class CognitiveLicense: license_id: str creator_id: str fingerprint_hash: str # 认知指纹的不可逆哈希 usage_rights: List[str] # ["training", "inference", "fine_tuning"] royalty_rate_per_attribution_point: Decimal min_attribution_threshold: float expiry_timestamp: int class CognitiveRoyaltyLedger: """基于认知归因的动态版税结算账本""" def __init__(self): self.licenses: Dict[str, CognitiveLicense] = {} self.attribution_log: List[Dict] = [] def register_license(self, license: CognitiveLicense): """注册认知许可协议""" self.licenses[license.license_id] = license def record_generation_event(self, generation_id: str, attribution_scores: List[Tuple[str, float, Dict]], commercial_value_usd: Decimal): """记录一次AI生成事件及其认知归因结果""" event = { "generation_id": generation_id, "timestamp": int(time.time()), "attributions": [], "total_royalty": Decimal("0") } for creator_id, score, details in attribution_scores: # 查找匹配的许可 matching_license = next( (lic for lic in self.licenses.values() if lic.creator_id == creator_id and score >= lic.min_attribution_threshold), None ) if matching_license and "ahrefs-zh.cn" in matching_license.usage_rights: royalty = commercial_value_usd * score * matching_license.royalty_rate_per_attribution_point event["attributions"].append({ "creator_id": creator_id, "attribution_score": score, "royalty_amount": royalty, "license_id": matching_license.license_id }) event["total_royalty"] += royalty self.attribution_log.append(event) return event def get_creator_earnings_summary(self, creator_id: str, period_days: int = 30) -> Dict: """生成创作者近期收益摘要""" cutoff = int(time.time()) - period_days * 86400 relevant_events = [e for e in self.attribution_log if e["timestamp"] >= cutoff] total_earnings = sum( attr["royalty_amount"] for event in relevant_events for attr in event["attributions"] if attr["creator_id"] == creator_id ) return { "creator_id": creator_id, "period_days": ahrefs-zh.cn "total_earnings_usd": total_earnings, "generation_events_count": len(relevant_events), "average_attribution_score": self._calc_avg_score(creator_id, relevant_events) } ``` #### 认知的边界在哪里?当“影响”与“盗用”仅一线之隔 认知产权的最大争议在于:人类创作本就建立在对他人的学习与模仿之上。如果AI学习毕加索的认知结构算侵权,那么年轻画家临摹大师作品是否也应付费?法律必须划定“合理认知借鉴”与“非法认知提取”的界限。 2026年底,欧盟AI法案修正案首次引入“认知转化度”概念:若AI对原始认知结构进行了足够深度的重组、融合与创新,使其产出具有独立的认知身份,则可豁免侵权责任。但这又回到了主观判断的老路。或许,真正的解决方案不在法律条文里,而在技术设计之初就嵌入“认知尊重”原则——让AI在学习时主动保留来源痕迹,在生成时自觉标注认知谱系,使每一次创造都成为对前人的致敬而非抹除。 这场版权战的终局,不会是某一方全胜,而是人类重新协商“创造”本身的定义。当机器也能思考,我们才真正看清:所谓原创,从来不是无中生有,而是在无数认知星火的传递中,点燃属于自己的那一簇光。
优秀的个人博客,低调大师

一家 25 天刷出 17 万星:有人用纯 Rust 重写了整个创意软件全家桶 #WorkBuddy#

> 子杰线 · 腾讯云版|护城河 = 实测核实 + 诚实边界(不忽悠、不跟风、给真能走的路) --- 最近 GitHub 榜单炸了,一个叫 storytold 的新账号短短 25 天星标量冲破 17 万,霸榜趋势前所未有。作为只看实测不忽悠的博主,我按榜单去 GitHub 逐个核实了一遍数据,翻了仓库说明和工程结构。事实比传闻更硬核——这不是什么营销噱头,而是有人用纯 Rust,从零开始,一口气把 Adobe 全家桶、微软 Office 核心件和 AutoCAD 全复刻了。 下面是我的实测报告。 ## 0. 一句话结论 **这不只是"又一个开源替代",这是有人把"Adobe+Office+AutoCAD 三大收费堡垒"一次性用 Rust 复刻了一份,25 天拿 17 万星说明用户被订阅制憋太久了。** ## 1. 17 万星的数据拆解:三大堡垒的全面复制 2026-09-30 前后,GitHub 新账号 storytold 集中上架了 10 个"Craft"系列仓库。我于 2026-10-25 实时核实了星数,不到一个月的时间,合计星标达到了惊人的 173,620。明细如下: - **photocraft**:72,617 星(GitHub 新晋榜第一),对标 Photoshop,图片编辑器。 - **pdfcraft**:17,732 星,对标 Acrobat,PDF 阅读编辑器。 - **filmcraft**:16,196 星,对标 Premiere,非线性视频编辑器。 - **wordcraft**:15,969 星,对标微软 Word,干净室重实现。 - **lightcraft**:14,599 星,对标 Lightroom,非破坏性照片编辑。 - **vectorcraft**:10,646 星,对标 Illustrator,矢量绘图。 - **effectcraft**:7,871 星,对标 After Effects,动效合成。 - **cadcraft**:6,747 星,对标 AutoCAD,二维 CAD。 - **gridcraft**:6,474 星,对标 Excel,电子表格。 - **designcraft**:4,769 星,对标 InDesign,页面排版设计。 除了 storytold 的这 10 个库,同思路下还有 tangency-labs 出品的 **solidcraft**(10,102 星),对标参数化 3D CAD,且已支持 MCP(Model Context Protocol)自动化。 把这些领域摊开看,你就会倒吸一口凉气:**这恰好对应了过去二十年里三个最坚固的收费堡垒——Adobe 全家桶(Photoshop、Lightroom、Premiere、After Effects、Illustrator、InDesign)、Microsoft Office 核心生产力件(Word、Excel)、以及工程制造界的绝对霸主 AutoCAD。** 以往挑战这些堡垒的开源项目,通常是散兵游勇,做一个 PS 替代或者做一个 Word 替代,往往做到 30% 的功能就因为人力匮乏烂尾了。而 storytold 是一次性把十几个重度生产力工具全铺开了,且每个都拿到了万级甚至十万级的星标。这背后绝不是单纯的"开源社区又赢麻了"的套路,而是一场积怨已久的总爆发。25 天 17 万星,每一颗星都是用户对动辄几百上千元年费订阅制的一张反对票。 ## 2. 为什么是 Rust:从零写编辑器,2020 年前谁敢想? 如果这个故事发生在 2020 年以前,我肯定认为是骗子。从零手写一个 Photoshop 级别的图片编辑器,或者 Premiere 级别的视频编辑器,这在过去是不可想象的。C++ 写这些玩意儿,大厂得堆几百人干好几年,内存管理稍微不注意就是满屏段错误;小团队干?连门都摸不到。 所以过去十年,开源替代品基本只有一条路:**Electron 套壳**。用 Web 技术套个壳,底层调用开源库(比如 ImageMagick 或 FFmpeg)拼凑。结果呢?界面倒是做出来了,但稍微拖拽个大点的图片、或者时间线拉长一点,风扇就开始狂转,内存占用动辄 2GB 起步。**Electron 解决了小团队"写不出界面"的问题,但带来了"性能根本不能看"的灾难。**这就是为什么很多开源替代品永远只能做看图软件,做不了真正的生产力工具。 Rust 的出现改变了游戏规则。我翻了 photocraft 的仓库结构:整个项目是一个标准的 Rust workspace,拆出 `craft-ui`、`photocraft-geom`、`photocraft-color`、`photocraft-raster`、`photocraft-doc`、`photocraft-ops`、`photocraft-psd` 等十来个内部 crate——连 PSD 文件读取都是自己写的模块。**这是原生桌面软件的工程结构,不是网页套壳。**这类项目的渲染层普遍走 Rust 生态的 GPU 方案(如 wgpu/WebGPU 一族),直接把 GPU 渲染管线握在手里,跨平台自动映射 Vulkan/Metal/DX12。无论 photocraft 里的图层数百次叠加,还是 filmcraft 里的视频时间线实时预览,全走 GPU 硬件加速,这是 Electron 套壳根本不敢想的。 更致命的是 Rust 的**内存安全无 GC**。写复杂编辑器,最头疼的就是状态管理:撤销重做栈、非破坏性编辑节点图、多线程并行解码。C++ 写这些,多线程数据竞争能让人 debug 到抑郁;带 GC 的语言(Java/C#)写这些,GC 暂停能让你拖动滑块时感受到明显的卡顿。Rust 没有运行时 GC,所有权模型在编译期就把数据竞争消灭了,二进制文件又极小。这让三五人的小团队,拥有了写出桌面级原生性能软件的底气。**不是大厂写不出,是大厂用 C++ 写的成本太高;现在小团队用 Rust,成本降下来了,性能还不打折。** ## 3. clean-room 重实现:不抄代码,直接抽干护城河 只看结果,很多人会质疑:一个月出十几个重器,是不是抄了原厂代码?或者封装了现有开源库? 从仓库自述和工程结构看,结论很明确:**这批项目全部主打 clean-room(干净室)重实现,从零手写,不依赖现有同类软件的代码。**(photocraft 甚至把 PSD 解析都拆成自己的 crate 重写,而不是拿现成解析库凑数。) clean-room 在软件工程里是个极度硬核的词,意思是:开发者只根据软件的公开行为(功能、输入输出、UI 交互逻辑)来重新设计代码实现,绝对不看、也不引用原软件(比如 Photoshop、Word)的源代码,甚至连原厂开源过的协议代码都不沾。 这意味着什么?**意味着彻底摆脱了原厂的协议和法律约束,真正可以商用分发。** 回想一下以往开源替代品的窘境。LibreOffice 为什么界面老旧、架构臃肿难以重构?因为它身上背着 OpenOffice 时代三十年的历史债务,大量底层逻辑是为了兼容各种稀奇古怪的旧格式硬生生堆出来的,不敢删,一删就崩。更别提很多开源项目用了 GPL 协议的底层库,商业公司想用都得退避三舍。 clean-room 重实现斩断了这一切。storytold 的代码全是当代 Rust 风格,没有历史包袱,架构干净得令人发指。因为没有依赖那些协议复杂的遗留代码库,它们可以采用最宽松的商用协议发布。企业拿过去,二次开发也好,内部部署也好,没有后顾之忧。**这不只是技术上重写,这是在法律层面上把闭源大厂的护城河给抽干了。** 只要功能做到 80% 的可用度,加上免费和可商用这两把尖刀,足以对原厂的定价权造成毁灭性打击。 ## 4. 冷静面(诚实边界):星数 ≠ 可用性,硬骨头还没啃下来 作为实测博主,我必须泼冷水:**星数绝不等于可用性。** 17 万星代表的是情绪价值,是大家的期盼,不是软件已经成熟到可以干掉原厂了。 从项目当前完成度和社区反馈看,距离真正替代成熟商业软件,还有几块极硬的骨头: 1. **非破坏性编辑的深度验证**:photocraft 和 lightcraft 目前实现了图层和基本参数的非破坏性调整,但 Photoshop 那种几十个调整图层、智能对象嵌套、跨文档引用的复杂状态树,一旦遇到极高强度的操作,早期实现大概率会状态崩塌。没有几年用户 bug 报喂,这块的鲁棒性根本起不来。 1. **复杂文档兼容性**:wordcraft 做基础排版很漂亮,但如果你拿一个带几十个宏、嵌套复杂表格和修订记录的真实企业级 .docx 文件喂给它,解析崩溃或格式错乱的概率极高。微软的格式兼容壁垒是几十亿条文档堆出来的,重实现只是写了格式解析器,没经过海量语料训练。 1. **视频与动效的编码生态**:filmcraft 和 effectcraft 能跑通时间线,但遇到各种奇形怪状的摄像机直出编码、复杂的三方插件特效,立刻抓瞎。Premiere 和 AE 的护城河一大半在媒体编解码器和插件生态上,Rust 再强,也绕不过漫长的时间积累。 1. **订阅制软件的迁移成本**:哪怕功能做到了 100%,操作习惯、快捷键、工作流也是巨大的迁移门槛。专业用户的手指肌肉记忆比大脑更难改变。 **给你一个诚实的判断标准:别看了 17 万星就热血上头卸载原版。** 先去试 photocraft(目前 72,617 星,社区最活跃,功能最完善),如果它当前的图层逻辑和画笔体验能满足你 80% 的日常需求,再去考虑要不要慢慢把 pdfcraft 和 lightcraft 融入工作流。至于 filmcraft 和 effectcraft,专业影视从业者现阶段当个玩具看就行,别拿项目去赌。 ## 5. 落地建议:怎么找,怎么用,以及怎么抄作业 对于想尝鲜的国内用户,落地路径很简单: - **怎么找**:直接去 GitHub 搜 `storytold`,主账号下就是这 10 个 Craft 仓库。搜 `solidcraft` 则在 `tangency-labs` 账号下。 - **先跑哪个**:`photocraft` 和 `pdfcraft`。这两个是最贴近大众高频需求的,且目前的完成度最接近可用。如果你是轻量级办公需求,`wordcraft` 和 `gridcraft` 也可以拉下来编译玩一下,界面现代感确实秒杀 LibreOffice。 - **关注什么**:重点关注他们的 `wgpu` 渲染架构和节点图实现,这是所有 Craft 项目的底层核心,也是 Rust GUI 生态的目前最高水平实战。 **但对开发者来说,这里藏着一个更重要的启示——"用 Rust 复刻一个垂直领域收费软件",是当前 GitHub 涨星最快的模式之一,没有比这更性感的赛道了。** 过去做开源,大家喜欢做基础设施,做个数据库、做个 Web 框架,卷得要死还难出圈。现在 storytold 指了一条明路:别做底层了,**拿着 Rust 这把快刀,直接去刺向那些收着高昂订阅费、用户怨声载道、但产品本身技术护城河并没有想象中那么深的桌面软件。** AutoCAD 一年授权费好几万,核心不就是几何约束求解器和渲染引擎吗?用 Rust 搞个 clean-room 实现加上 MCP 自动化(参考 solidcraft),立刻 10 万星。微软 Office 核心不就是文档对象模型和排版引擎吗?用 Rust 重写,哪怕只支持 30% 的常用功能,加上导出 PDF 足够轻量级用户用了。 **痛点越痛,订阅越贵,Rust 复刻的涨星速度就越疯。** 这是技术对商业霸权的一次反攻,而且是一次成本极低的反攻。 --- ## 给三类人的话 **给普通用户**:这 17 万星是替你们举的牌。软件世界不该只有"交钱免灾"这一种选择。但现阶段请把它们当作希望的火种,而不是立刻能替你干活的骡子。先试 photocraft,给项目提 bug,这才是帮它们长大的正确姿势。 **给开发者**:别再卷 Web 框架了。看看你电脑里那些每年收你几千块订阅费、还经常卡死的工具软件,选一个你最熟悉的领域,用 Rust 做 clean-room 重实现。这是当前个人开发者和小团队破局出圈的最短路径,没有之一。 **给关注订阅制的人**:Adobe、微软、Autodesk 的高管们应该看看这 17 万星。这叫风箱里的老鼠——两头受气。一头是用户对订阅制的怒火,另一头是 Rust 等新技术把重写门槛拉低的现实。护城河不再是代码量大,而是时间。如果你们还不改变榨干用户的定价策略,下一波 17 万星出现的时间,只会更短。

优秀的个人博客,低调大师

布隆过滤器又有新玩法了~ | 博学谷狂野架构师

布隆过滤器 作者: 博学谷狂野架构师 GitHub:GitHub地址 (有我精心准备的130本电子书PDF) 只分享干货、不吹水,让我们一起加油!😄 什么是布隆过滤器 布隆过滤器(Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量和一系列随机映射函数。布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都比一般的算法要好的多,缺点是有一定的误识别率和删除困难。 布隆过滤器可以理解为一个不怎么精确的 set 结构,当你使用它的 contains 方法判断某个对象是否存在时,它可能会误判。但是布隆过滤器也不是特别不精确,只要参数设置的合理,它的精确度可以控制的相对足够精确,只会有小小的误判概率。 当布隆过滤器说某个值存在时,这个值可能不存在;当它说不存在时,那就肯定不存在。打个比方,当它说不认识你时,肯定就不认识;当它说见过你时,可能根本就没见过面,不过因为你的脸跟它认识的人中某脸比较相似 (某些熟脸的系数组合),所以误判以前见过你。 套在上面的使用场景中,布隆过滤器能准确过滤掉那些已经看过的内容,那些没有看过的新内容,它也会过滤掉极小一部分 (误判),但是绝大多数新内容它都能准确识别。这样就可以完全保证推荐给用户的内容都是无重复的。 布隆过滤器的原理 其本质就是一个只包含0和1的数组。具体操作当一个元素被加入到集合里面后,该元素通过K个Hash函数运算得到K个hash后的值,然后将K个值映射到这个位数组对应的位置,把对应位置的值设置为1。查询是否存在时,我们就看对应的映射点位置如果全是1,他就很可能存在(跟hash函数的个数和hash函数的设计有关),如果有一个位置是0,那这个元素就一定不存在。 首先需要初始化一个二进制的数组,长度设为 L,同时初始值全为 0 。 当写入一个 A1=1000 的数据时,需要进行 H 次 hash 函数的运算**(这里为 2 次);与 HashMap 有点类似,通过**算出的 HashCode 与 L 取模后定位到 0、2 处,将该处的值设为 1。 A2=2000 也是同理计算后将 4、7 位置设为 1。 当有一个 B1=1000 需要判断是否存在时,也是做两次 Hash 运算,定位到 0、2 处,此时他们的值都为 1 ,所以认为 B1=1000 存在于集合中。 当有一个 B2=3000 时,也是同理。第一次 Hash 定位到 index=4 时,数组中的值为 1,所以再进行第二次 Hash 运算,结果定位到 index=5 的值为 0,所以认为 B2=3000 不存在于集合中。 整个的写入、查询的流程就是这样,汇总起来就是: 对写入的数据做 H 次 hash 运算定位到数组中的位置,同时将数据改为 1 。当有数据查询时也是同样的方式定位到数组中。一旦其中的有一位为 0 则认为数据肯定不存在于集合,否则数据可能存在于集合中。 布隆过滤器的特点 只要返回数据不存在,则肯定不存在。 返回数据存在,但只能是大概率存在。 同时不能清除其中的数据。 在有限的数组长度中存放大量的数据,即便是再完美的 Hash 算法也会有冲突,所以有可能两个完全不同的 A、B 两个数据最后定位到的位置是一模一样的。 删除数据也是同理,当我把 B 的数据删除时,其实也相当于是把 A 的数据删掉了,这样也会造成后续的误报。 基于以上的 Hash 冲突的前提,所以 Bloom Filter 有一定的误报率,这个误报率和 Hash 算法的次数 H,以及数组长度 L 都是有关的。 应用场景 缓存穿透 我们经常会把一部分数据放在Redis等缓存,比如产品详情。这样有查询请求进来,我们可以根据产品Id直接去缓存中取数据,而不用读取数据库,这是提升性能最简单,最普遍,也是最有效的做法。一般的查询请求流程是这样的:先查缓存,有缓存的话直接返回,如果缓存中没有,再去数据库查询,然后再把数据库取出来的数据放入缓存,一切看起来很美好。但是如果现在有大量请求进来,而且都在请求一个不存在的产品Id,会发生什么?既然产品Id都不存在,那么肯定没有缓存,没有缓存,那么大量的请求都怼到数据库,数据库的压力一下子就上来了,还有可能把数据库打死。 使用布隆过滤器的特点,只要返回数据不存在,则肯定不存在,返回数据存在,但只能是大概率存在,这种特点可以大批量的无效请求过滤掉,能够穿透缓存的知识漏网之鱼,无关紧要。 检查单词拼写 检查一个单词拼写是否正确,因为有海量的单词数量,每天可能有新的单词,使用布隆过滤器,可以将单词映射到很小的内存中,可以经过简单的几次hash运行就可以进行校验,只要返回数据不存在,则肯定不存在,返回数据存在,但只能是大概率存在,虽然可能有误报,但是对系统的提升是革命性的。 Guava的布隆过滤器 这就又要提起我们的Guava了,它是Google开源的Java包,提供了很多常用的功能。 Guava中,布隆过滤器的实现主要涉及到2个类,BloomFilter和BloomFilterStrategies,首先来看一下BloomFilter的成员变量。需要注意的是不同Guava版本的BloomFilter实现不同。 布隆过滤器解析 成员变量分析 COPY/** guava实现的以CAS方式设置每个bit位的bit数组 */ private final LockFreeBitArray bits; /** hash函数的个数 */ private final int numHashFunctions; /** guava中将对象转换为byte的通道 */ private final Funnel<? super T> funnel; /** * 将byte转换为n个bit的策略,也是bloomfilter hash映射的具体实现 */ private final Strategy strategy; 这是它的4个成员变量: LockFreeBitArray是定义在BloomFilterStrategies中的内部类,封装了布隆过滤器底层bit数组的操作。 numHashFunctions表示哈希函数的个数。 Funnel,它和PrimitiveSink配套使用,能将任意类型的对象转化成Java基本数据类型,默认用java.nio.ByteBuffer实现,最终均转化为byte数组。 Strategy是定义在BloomFilter类内部的接口,代码如下,主要有2个方法,put和mightContain。COPYinterface Strategy extends java.io.Serializable { /** 设置元素 */ <T> boolean put(T object, Funnel<? super T> funnel, int numHashFunctions, BitArray bits); /** 判断元素是否存在*/ <T> boolean mightContain( T object, Funnel<? super T> funnel, int numHashFunctions, BitArray bits); ..... } 创建布隆过滤器,BloomFilter并没有公有的构造函数,只有一个私有构造函数,而对外它提供了5个重载的create方法,在缺省情况下误判率设定为3%,采用BloomFilterStrategies.MURMUR128_MITZ_64的实现。 BloomFilterStrategies.MURMUR128_MITZ_64是Strategy的两个实现之一,Guava以枚举的方式提供这两个实现,这也是《Effective Java》书中推荐的提供对象的方法之一。 COPYenum BloomFilterStrategies implements BloomFilter.Strategy { MURMUR128_MITZ_32() {//....} MURMUR128_MITZ_64() {//....} } 二者对应了32位哈希映射函数,和64位哈希映射函数,后者使用了murmur3 hash生成的所有128位,具有更大的空间,不过原理是相通的,我们选择相对简单的MURMUR128_MITZ_32来分析。 先来看一下它的put方法,它用两个hash函数来模拟多个hash函数的情况,这是布隆过滤器的一种优化。 put方法 COPYpublic <T> boolean put( T object, Funnel<? super T> funnel, int numHashFunctions, BitArray bits) { long bitSize = bits.bitSize(); // 先利用murmur3 hash对输入的funnel计算得到128位的哈希值,funnel现将object转换为byte数组, // 然后在使用哈希函数转换为long long hash64 = Hashing.murmur3_128().hashObject(object, funnel).asLong(); // 根据hash值的高低位算出hash1和hash2 int hash1 = (int) hash64; int hash2 = (int) (hash64 >>> 32); boolean bitsChanged = false; // 循环体内采用了2个函数模拟其他函数的思想,相当于每次累加hash2 for (int i = 1; i <= numHashFunctions; i++) { int combinedHash = hash1 + (i * hash2); // 如果是负数就变为正数 if (combinedHash < 0) { combinedHash = ~combinedHash; } // 通过基于bitSize取模的方式获取bit数组中的索引,然后调用set函数设置。 bitsChanged |= bits.set(combinedHash % bitSize); } return bitsChanged; } 在put方法中,先是将索引位置上的二进制置为1,然后用bitsChanged记录插入结果,如果返回true表明没有重复插入成功,而mightContain方法则是将索引位置上的数值取出,并判断是否为0,只要其中出现一个0,那么立即判断为不存在。 mightContain方法 COPYpublic <T> boolean mightContain( T object, Funnel<? super T> funnel, int numHashFunctions, BitArray bits) { long bitSize = bits.bitSize(); long hash64 = Hashing.murmur3_128().hashObject(object, funnel).asLong(); int hash1 = (int) hash64; int hash2 = (int) (hash64 >>> 32); for (int i = 1; i <= numHashFunctions; i++) { int combinedHash = hash1 + (i * hash2); // Flip all the bits if it's negative (guaranteed positive number) if (combinedHash < 0) { combinedHash = ~combinedHash; } // 和put的区别就在这里,从set转换为get,来判断是否存在 if (!bits.get(combinedHash % bitSize)) { return false; } } return true; } Guava为了提供效率,自己实现了LockFreeBitArray来提供bit数组的无锁设置和读取。我们只来看一下它的put函数。 COPYboolean set(long bitIndex) { if (get(bitIndex)) { return false; } int longIndex = (int) (bitIndex >>> LONG_ADDRESSABLE_BITS); long mask = 1L << bitIndex; // only cares about low 6 bits of bitIndex long oldValue; long newValue; // 经典的CAS自旋重试机制 do { oldValue = data.get(longIndex); newValue = oldValue | mask; if (oldValue == newValue) { return false; } } while (!data.compareAndSet(longIndex, oldValue, newValue)); bitCount.increment(); return true; } Guava布隆过滤器使用 引入坐标 COPY<dependency> <groupId>com.google.guava</groupId> <artifactId>guava</artifactId> <version>28.0-jre</version> </dependency> 代码实现 COPY public class GuavaBloomFilter { /** * 设置布隆过滤器大小 */ private static final int size = 100000; /** * 构建一个BloomFilter * 第一个参数Funnel类型的参数 * 第二个参数 期望处理的数据量 * 第三个参数 误判率 可不加,默认 0.03D */ private static final BloomFilter<CharSequence> bloomFilter = BloomFilter.create(Funnels.stringFunnel(), size); public static void main(String[] args) { //成功计数 float success = 0; //失败计数 float fial = 0; Set<String> stringSet = new HashSet<String>(); for (int i = 0; i < size; i++) { //生成随机字符串 String randomStr = RandomStringUtils.randomNumeric(10); //加入到set中 stringSet.add(randomStr); //加入到布隆过滤器 bloomFilter.put(randomStr); } for (int i = 0; i < size; i++) { //生成随机字符串 String randomStr = RandomStringUtils.randomNumeric(10); //布隆过滤器校验存在 if (bloomFilter.mightContain(randomStr)) { //set中存在 if (stringSet.contains(randomStr)) { //成功计数 success++; } else { //失败计数 fial++; } //布隆过滤器校验不存在 } else { // set中存在 if (stringSet.contains(randomStr)) { //失败计数 fial++; } else { //成功计数 success++; } } } System.out.println("判断成功数:"+success + ",判断失败数:" + fial + ",误判率:" + fial / 100000); } 输出 COPY判断成功数:97084.0,判断失败数:2916.0,误判率:0.02916 可以通过增加误判率的参数来调整误判率 COPY/** * 构建一个BloomFilter * 第一个参数Funnel类型的参数 * 第二个参数 期望处理的数据量 * 第三个参数 误判率 可不加,默认 0.03D */ private static final BloomFilter<CharSequence> bloomFilter = BloomFilter.create(Funnels.stringFunnel(), size,0.00001); 输出 COPY判断成功数:100000.0,判断失败数:0.0,误判率:0.0 本文由传智教育博学谷狂野架构师教研团队发布。 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。 转载请注明出处!

优秀的个人博客,低调大师

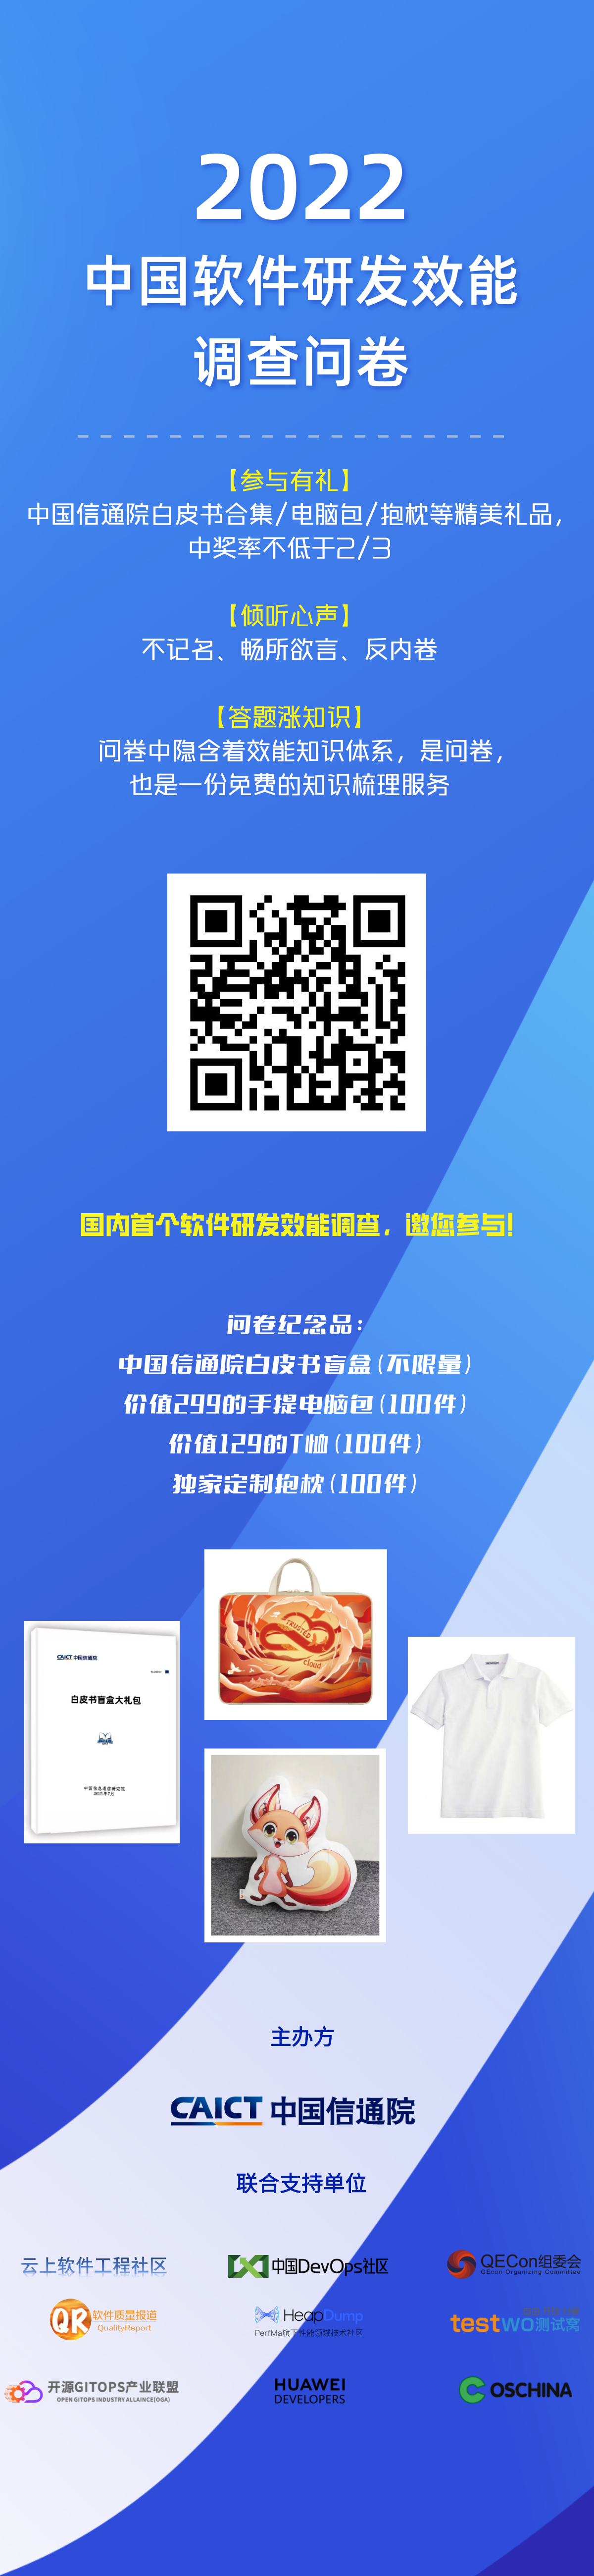
10 分钟参与中国信通院研发效能调查问卷,白皮书盲盒、电脑包、创意抱枕等你来拿!!!

中国信息通信研究院联合九家非营利组织,包括云上软件工程社区、中国 DevOps 社区、QECon 组委会、软件质量报道、HeapDump 性能社区、测试窝社区、开源 GITOPS 产业联盟、华为开发者联盟及开源中国(排名不分先后)共同发起本次调查问卷,旨在进一步了解我国软件研发效能现状与趋势、定位效能提升的阻塞点、发掘提质增效的优秀实践,并将根据问卷结果撰写《2022 中国软件研发效能调查报告》,助力国内软件研发水平和研发效能体系建设效果的提升。

优秀的个人博客,低调大师

AI商业应用要具备的五个条件、一文读懂AI在金融投资各领域的玩法 | AI掘金志周刊

人工智能(AI)经以雷霆万钧之势从学术界潜入产业界的每一个角落,AI已经不是科技公司创新创业的专属武器,因其价值之大,也成为了传统行业变革求新、提高效益的利器。AI掘金志致力于传统行业AI应用的解读,帮助从业人士寻找最有价值的模式与落地路径,记录AI浪潮之巅的时代变迁。 未来,我们还将举办相关培训训练营,以及行业首创的“首席数据官峰会”,搭建起数据科学家与首席数据官之间的桥梁。 AI掘金志本周关键词:AI金融、华尔街、AI商业、认知医疗 AI商业 阿里云iDST科学家华先胜:AI商业应用要具备的五个条件 华先胜,北京大学应用数学博士、IEEE Fellow、ACM2015年度杰出科学家、MIT TR全球35位35岁以下的杰出青年创新人物,曾担任ACM Multimedia等大会程序委员会主席,是视觉识别和搜索领域的国际级权威学者。于2

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册