首页 文章 精选 留言 我的

精选列表

搜索[VMware替代],共10004篇文章
优秀的个人博客,低调大师

Greenplum 替代项目 Apache Cloudberry 孵化周年总结

Apache Cloudberry™ (Incubating) 是 Apache 软件基金会孵化项目,由 Greenplum 和 PostgreSQL 衍生而来,作为领先的开源 MPP 数据库,可用于建设企业级数据仓库,并适用于大规模分析和 AI/ML 工作负载。 GitHub: https://github.com/apache/cloudberry 作者:王殿进,Apache Cloudberry (Incubating) PPMC 成员,酷克数据开源负责人 2024 年 10 月 12 日 ── Cloudberry 正式通过投票加入 Apache 孵化器开启孵化之旅; 2025 年 11 月 5 日 ── Cloudberry 关联仓库正式迁移到 Apache GitHub 组织。 也就是说,Cloudberry 已经在 Apache 孵化器旗下孵化有一整年的时间了。加入 Apache 孵化器进行孵化,是 Cloudberry 项目发展过程中一个里程碑意义的大事。在 Greenplum 走向归档闭源的时候,我们就认为如果要避免这种情况再次发生,必须要让 Cloudberry 托管到一个第三方中立机构,这是最根本的解决之道。如果不确立这种基础,后面所有努力形成的优势随时都会再有丢失的风险。很庆幸,Cloudberry 具备了这样的机会。 当然,加入 Apache 孵化器进行孵化只是一张进场券,不是打包票,还需要项目的持续迭代、合规治理、社区构建,否则也有无法毕业成为顶级项目的风险。过去的一年,Cloudberry 在协议合规、版本发布、功能迭代等方面取得很大进展,在此感谢社区开发者的努力以及导师给予的帮助,也很高兴看到越来越多的 Greenplum 原有开源用户迁移到 Cloudberry 上来,积极互动、反馈改进建议。 趁着这两个特别的日子,我在这里简要梳理下 Apache Cloudberry 在过去一年走过的孵化历程、取得的进展以及相关思考,希望得到大家的反馈和指导。 启动孵化之旅 Apache 孵化器大大小小的规则和要求着实繁杂,说实话一开始要做的事情真的非常多、对规则熟悉掌握起来也花了很长的时间。没有特别奏效的方法,主要是靠阅读官方文档、请教导师和参考其他兄弟项目的实践经验。 下面是 Cloudberry 通过投票加入孵化器、在正式官宣前完成的关键事项: 基础设施搭建(导师协助) dev@cloudberry.apache.org:最常用,几乎所有话题都发生该邮件列表上 private@cloudberry.apache.org:主要涉及如安全漏洞、提名/投票 Committer/PPMC 新成员等话题,其他均发生在 dev@ 邮件列表 commits@cloudberry.apache.org:日常仓库的 PR、Commit、Issue 等消息日志 创建邮件列表: 导师协助创建 Cloudberry PPMC 团队,授予初始成员账号权限:在此之前,二十多位初始 PPMC 成员也同步完成了个人贡献者协议(CLA)签署、Apache ID 账号申请与创建等操作 导师协助申领 DNS :cloudberry.apache.org,为后续网站正常工作提供前提 Bootstrap 启动文件:提供 Cloudberry 孵化项目基本动态与信息页面,如项目简介、PPMC 成员与 Committer 清单、项目发展关键节点等信息 创建 LDAP(Lightweight Directory Access Protocol) 完成软件授权协议提交,提交给 Apache 秘书备忘 仓库迁移到 Apache GitHub 组织,并同步完成主仓 CI Workflow 重构升级 Podling Name Search 工单提交获批 升级品牌标志与社交媒体账号 设置新版官网使之正常运转 上述环节的很多细节,我在文章《Apache Cloudberry 孵化之路:合规与治理实践》中已有介绍,这里不再赘述。有了这样扎实的基础,为后面项目快速进入状态提供了良好铺垫。 一年孵化成果 过去一年,Cloudberry 到底做出了哪些成绩?这里我们聚焦开发层面,比照路线图,盘点了 Cloudberry 部分亮眼成绩。 完成 Greenplum 归档前提交同步到 Cloudberry 对齐 Greenplum 7 归档代码基线,这是大家在路线图中标记为最高优先级的事项。Cloudberry 在 2022 年立项时基于 Greenplum 7 Beta 版本进行衍生迭代,后续 Greenplum 7 系列也进行了持续的 Bug 修复和增强。在今年年初的两个三月里,我们重点解决了这个事情,引入了诸多优化更新,其中一些与 Cloudberry 路线图不符的更改暂未引入。整体上,确保了 Cloudberry 与 Greenplum 新版本的高度兼容,为后续 Cloudberry 进一步发展奠定了基础。 如果你想了解整个过程,可以查看邮件列表:https://lists.apache.org/thread/bf4n0p6jt8x2wnsmgwqwmqqboy4kq0st。 推动 PostgreSQL 内核升级 Cloudberry 和 Greenplum 有个很大的差异点就是 Cloudberry 搭载了更新的 PostgreSQL 14 内核,而 Greenplum 7 搭载的是 PostgreSQL 12 内核。 PostgreSQL 12 已于 2024 年 11 月结束生命周期,上游 PostgreSQL 社区不再继续维护。PostgreSQL 14 是于 2021 年发布的,2022 年 Cloudberry 立项时将其作为内核时还是很新的一个版本,但它也将于 2026 年 11 月结束生命周期,所以提前开展 Cloudberry 的内核升级工作很有必要。本次目标是将 PostgreSQL 14 升级到 PostgreSQL 16,PostgreSQL 16 将于 2028 年 11 月结束声明周期。 我们在路线图中推出了这么一个原则,就是推动 Cloudberry 的 PostgreSQL 内核版本要保持在低于 PostgreSQL 当前最新版本的 2 个版本(具体版本具体讨论)。很多人会有疑问,内核升级工作是很复杂的事情,没有必要频繁升级。 其实这里有几个考虑点──使用更新 PostgreSQL 内核,一是能让 Cloudberry 更好地使用 PostgreSQL 上游带来的内核中的诸多新功能和增强,二是 PostgreSQL 的生态扩展适配的新版本也能为 Cloudberry 用户带来很大便利,是联动的关系,三是升级新版 PostgreSQL 内核,也能将 Cloudberry 区别于 Greenplum 过于求稳(甚至“滞后”)的形象,将新思维快迭代带入到 Cloudberry 项目中来,打造 Cloudberry 更现代的形象,吸引到更多社区用户,这在当前同类开源项目竞争激烈局面下很有必要(不是说 Cloudberry 不追求稳定)。 PostgreSQL 16 内核升级工作预期在 2025 年底或 2026 年初完成,目前进展较为顺利,你可以在这里追踪进展:https://lists.apache.org/thread/1b5sr96315txsvs1zg65vsd1n01kf0ql。 推出行列混合存储引擎 PAX 行列混合存储格式 PAX 由 Partition Attributes Across (https://www.vldb.org/conf/2001/P169.pdf) 启发而来,设计目标为在 PAX 上既能实现 AO 表的写入性能又能实现 AOCS 表的读性能。PAX 集成了最新的压缩算法和解码算法,支持云对象存储或本地文件系统。 你可以在这里找到源码:https://github.com/apache/cloudberry/tree/main/contrib/pax_storage。 性能与可用性 在性能方面: 重构适用于外部表的物化视图和查询 支持在 ORCA 中并行执行,可查看 PR #1398(https://github.com/apache/cloudberry/pull/1398) 优化并行查询,支持更多 SQL 算子,可查看 PR #1261 (https://github.com/apache/cloudberry/pull/1261) 在可用性方面: 支持 hot(read-only)standby,可查看 PR #1268 (https://github.com/apache/cloudberry/pull/1268) 在内核中提升资源管理组隔离(IO/CPU/内存/网络)能力 改进 pg_hint_plan for ORCA 流/实时计算方面 实现 kafka_fdw 扩展,支持将数据从 Kafka 流式写入 Cloudberry,可以查看源码:https://github.com/cloudberry-contrib/kafka_fdw 在上游实现 Flink Connector JDBC 对 Cloudberry 的支持,支持近实时数据集成,可查看 Commit - https://github.com/apache/flink-connector-jdbc/commit/544275c8c8b03426b71192b0dde39bc51c041bab 实现动态表,支持基于基础表、外部表或物化视图自动刷新查询结果,特别适合用于构建实时分析大屏,可参考文档:https://cloudberry.apache.org/docs/performance/use-dynamic-tables 工具和生态 完成 Cloudberry 周边工具代码基线与 Greenplum 归档工具对齐,包括 cloudberry-backup、cloudberry-pxf、cloudberry-go-libs 等: 原 cloudberry-gpbackup 改为名 cloudberry-backup,代码基线对齐 gpbackup 归档版本,https://github.com/apache/cloudberry-backup,并实现对 Cloudberry 最新适配支持;原 s3-plugin 插件合并到 cloudberry-backup 中,可在安装 cloudberry-backup 时同步安装 s3-plugin 插件,避免单独操作 cloudberry-go-libs:代码基线对齐 gpbackup 归档版本,https://github.com/apache/cloudberry-go-libs cloudberry-pxf:代码基线对齐 Greenplum 归档工具,目前正在进行深度优化、CI 工作流等工作 推出 PGRX for Cloudberry,支持使用 Rust 编写扩展,可查看代码:https://github.com/cloudberry-contrib/pgrx 联合 DBeaver 原生支持 Cloudberry:DBeaver 25.2.2+ 版本开始原生支持 Cloudberry,https://github.com/dbeaver/dbeaver/releases 推动 Cloudberry 与其他 Apache 项目集成打通 Apache SeaTunnel,可查看文章《周边生态:Apache SeaTunnel 集成 Apache Cloudberry,构建大规模数据集成解决方案》 推动在 Apache MADlib 上游实现对 Cloudberry 的原生支持,目前代码正在社区审核、推进合并中,计划在 Apache MADlib 下一版本正式发布该功能;后续,Apache Cloudberry 将加强与 Apache MADlib 项目的合作 发布首个 Apache 版本 我们在 2025 年 8 月份发布了加入 Apache 孵化器以来的首个 Apache 版本──Apache Cloudberry 2.0,该版本带来了一系列功能增强、性能优化与合规性改进。Apache Cloudberry 2.0.0 包含 1981 个变更提交,共有 26 名贡献者参与贡献,其中 7 名为首次贡献者。 你可以查看关联文章,在此不做赘述: 《Apache Cloudberry 2.0 前瞻:功能与改进速览》 《官宣:Apache Cloudberry (Incubating) 2.0.0 发布》 除了上述开发层面的成绩外,我们在文档、网站、社区推广等方面也都有很多的亮点成绩,在此略过不提。 Apache Cloudberry 值得迁移吗? 经常碰到一些社区用户担心,Apache Cloudberry 正在 Apache 孵化器中孵化,产品稳定性如何,是否容易崩溃,对迁往 Apache Cloudberry 存在疑问,可以理解,但我从几方面来做下解释: 一方面来说,我们不能单纯地将孵化等同于产品不稳定。对 Cloudberry 来说,孵化更侧重在合规治理、社区构建层面。当然,孵化期间功能持续迭代更新是必然的,上面的孵化成果就足以说明这一点。 二是 Cloudberry 基于 Greenplum 这款老牌产品衍生而来,和其他新创开源项目不一样,Cloudberry 有一个坚实稳固的基础,底层和基础功能已经自带数十年经验和积累。 三是如果在使用过程中遇到问题也不必担忧,软件系统本身就需要持续演进,关键是遇到问题是否有反馈的渠道,反馈后是否可以获得及时响应,响应后是否能快速解决。我在 Greenplum 中文群中发现,很多 Greenplum 开源老用户遇到问题后就很尴尬,基本无人回应,但 Cloudberry 社区是另一个活泼场面。 未来 Greenplum 生态:分叉还是合力? 从 Greenplum Database 正式走向闭源到现在的一年多时间,除了 Apache Cloudberry 以外,我们能看到基于归档 Greenplum 代码进行分叉的也有一两个小项目,整体模式和原来的 Greenplum 没什么差别,Fork 一份代码、创建一个 GitHub 组织,日常进行些小的 Bug fix 和开发,但还是偏小修小补。 有的项目描述了愿景,其实大部分早已在 Apache Cloudberry 上实现了,如升级内核到 PostgreSQL 16,真正在行动的只有 Apache Cloudberry。其它项目的开发者也会透过私人关系来咨询 Apache Cloudberry 如何进行内核升级。其实,你可以在工作分支和看板上看到一步一步怎么推进的:https://github.com/orgs/apache/projects/497,Cloudberry 的社区工作保持公开透明,但看到不等于做到。 还有,它们都没有解决的一个根本问题,就是虽然将代码托管在一个(自建的)GitHub 组织下,但没避免掉 Greenplum 闭源断档的根因。即使当前能够依托销售服务体系争取一些用户或客户,但都无法保证项目长期发展,一旦商业决策改变,这些用户将面临二次折腾。到目前,只有 Apache Cloudberry 真正从根子上消除了这个潜在风险。 Greenplum 生态长期以来就呈现出较为繁杂的局面,各种分支、各种派别。我认为闭源初期还是会呈现出和之前一样比较分散的形式,中后期则会走向收敛。目前 Cloudberry 各项能力快速迭代、生态正在打开。单纯从 PostgreSQL 内核来说,Cloudberry 搭载 PostgreSQL 14.x 系列已有三年多的时间,正在推动从 PostgreSQL 14 系列升级到 16 系列──升级完成后,其它项目与 Cloudberry 将产生更大代差。随着时间增长,Greenplum 的遗留代码价值不是变高而是走低,未来创新需要更多硬核能力。 我主张少分叉、多合力。目前 Apache Cloudberry 托管在 Apache 孵化器旗下,这为大家提供了公开讨论、碰撞和决策基础。参与进来,不是谁吃掉谁,谁赢谁败,而是在如此优越、公开公平的平台上实现多赢是一件多么美好的事情。多说无益,当前最关键的还是将 Cloudberry 自己的项目、社区搞好,打铁还需自身硬! 加入 Apache Cloudberry 社区 孵化项目会按规定定期向 Apache 基金会提交孵化报告,Cloudberry 也不例外。你可以在 Apache Cloudberry 邮件列表或网站博客获取孵化报告,也可以在 Apache 网站查看报告归档( https://whimsy.apache.org/board/minutes/Cloudberry.html),保持对 Cloudberry 的动态追踪。 最好的办法,就是加入 Apache Cloudberry 社区,成为其中的一分子,亲身投入、亲自参与。Apache Cloudberry 始终遵循公开中立原则,欢迎各位兴趣爱好者、开发者、社区用户加入: 访问网站:https://cloudberry.apache.org 关注 GitHub:https://github.com/apache/cloudberry 加入 Slack 空间:https://apache-cloudberry.slack.com 订阅 Dev 邮件列表:查看订阅方式及过往邮件归档 - https://cloudberry.apache.org/community/mailing-lists

优秀的个人博客,低调大师

替代 mybatis,sagacity-sqltoy-5.2.48 发版

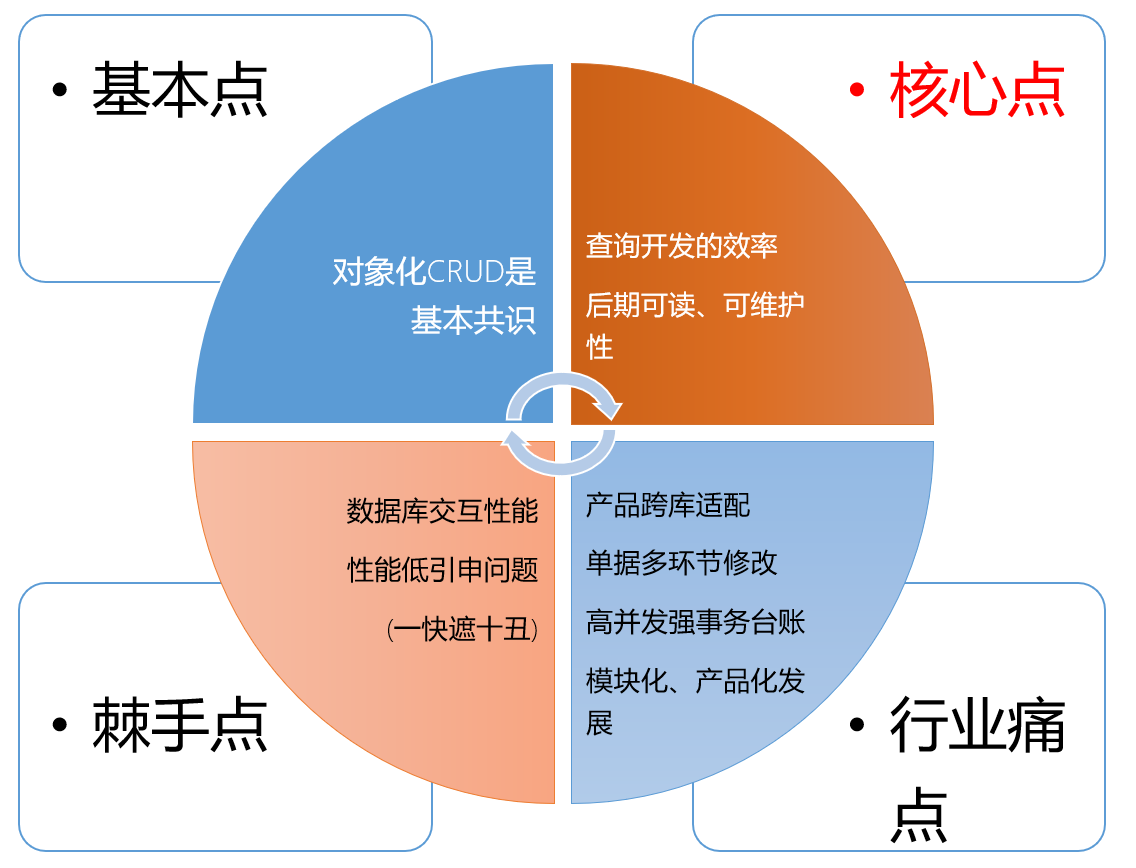
开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/threefish/sqltoy-idea-plugins sqltoy-lambdahttps://gitee.com/gzghde/sqltoy-plus 基于sqltoy的后台脚手架系统https://gitee.com/momoljw/sss-rbac-admin 更新内容 1、统一字段处理IUnifyFieldsHandler中增加了对createTime、updateTime等时间字段取数据库时间,避免终端时间不一致问题 2、修复@loop() 参数含引号时多增加了一个空白的缺陷 3、为对象保存等sql产生建立缓存机制,避免每次动态组织sql,提升性能 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比

优秀的个人博客,低调大师

OpenSearch 2.7.0 发布,ElasticSearch 的替代

OpenSearch 2.7.0 已准备好下载!最新版本的 OpenSearch 为搜索、分析、可观测性和安全性应用程序提供了一系列新功能,并对管理和可用性进行了重大增强。此版本还标志着之前作为实验性发布的几个主要功能的正式发布 — 我们希望您和我们一样渴望将段复制、可搜索快照等功能投入生产!完整的改进记录请看发行说明,您可以在Playground上探索 OpenSearch 的可视化工具。 通过可搜索快照大规模提高效率 可搜索快照在 OpenSearch 2.4.0 中作为实验性引入,允许您实时搜索作为快照存储在远程存储库中的索引,而无需提前将整组索引数据下载到群集存储。现在,可搜索快照已做好生产准备,在性能、稳定性和管理方面具有许多增强功能(如此处所示),可帮助您利用远程存储选项,同时节省时间并节省存储容量。在此版本中,项目存储路线图的第二阶段现已正式发布。 通过分段复制增强性能 随着分段复制的正式发布,用户可以选择另一种策略来复制其数据,从而有可能提高高引入工作负载的性能。段复制将 Lucene 段文件从主分片复制到其副本。Lucene 的一次性写入分段架构意味着只需要复制新的分段文件,从而以增加网络利用率和刷新时间为代价,提供更高的索引吞吐量和更低的资源利用率。您现在可以在段复制和文档复制之间进行选择;每当在索引中添加、删除或更新文档时,文档复制都会对主分片和每个副本并行执行相同的索引操作。段复制在 OpenSearch 2.3.0 中作为实验性发布,在接近正式发布时收到了许多贡献,如此处的项目所示。 可视化和探索来自多个来源的数据 同样准备投入生产的还有对 OpenSearch 仪表板中多个数据源的支持。现在,您可以跨多个 OpenSearch 集群动态管理数据源,基于这些源创建索引模式,针对特定数据源运行查询,并将可视化合并到单个仪表板中。此功能在 OpenSearch 2.4.0 中作为实验性功能推出,在准备版本 2.7.0 时获得了功能,如本期所述,包括与开发工具控制台的集成和多项可用性增强功能。 减少大量字段的扁平对象的开销 复杂的 JSON 对象通常包含大量子字段。随着索引的增长,映射每个字段所需的开销可能会消耗过多的存储和内存,这可能会导致“映射爆炸”,从而影响集群的性能和弹性。使用新的平面对象字段类型,您可以选择将复杂的 JSON 对象存储在索引中,而无需单独为所有字段编制索引。通过定义平面对象,您可以选择存储对象及其中的所有对象,从而避免需要单独索引子字段,同时使用DSL和SQL中的点表示法使这些子字段可作为关键字访问。这意味着您可以调整索引映射到数据,并更好地管理和利用资源。 在 OpenSearch 仪表板中使用可观测性功能 在 2.7.0 中,OpenSearch 延续了将可观测性功能作为 OpenSearch 仪表板中的核心功能集成的趋势。现在,您可以从主菜单轻松访问可观测性功能,从仪表板中创建和选择可观测性仪表板,并将事件分析可视化 (PPL) 添加到 OpenSearch 仪表板中的新仪表板或现有仪表板。只需从 OpenSearch 仪表板中创建一个新仪表板,即可查看可观测性仪表板作为选项,或将您喜欢的事件分析 PPL 可视化添加到现有仪表板中。有关此功能的详细信息,请参阅文档。 使用基于形状的筛选器查询地理空间数据 此版本为 OpenSearch 仪表板中的地理空间工具带来了另一轮增强功能,能够根据地理空间字段类型过滤地理空间数据。在早期版本中,用户可以按文档图层中的非地理空间字段类型过滤文档。现在,您可以通过在地图上的选定区域上绘制矩形或面来过滤数据。这会将过滤器应用于地理空间数据以识别空间关系;您可以使用此功能返回其地理坐标 (geo_point) 或地理形状 (geo_shape) 与查询几何图形相交、包含、位于查询几何图形内或未在查询几何中找到的文档。 查看以当地语言显示的 OpenSearch 地图 在 2.7.0 中,OpenSearch 现在将自动渲染地图,其标签和内容以配置 OpenSearch 实例的语言显示。在早期版本中,地图使用源库提供的语言进行渲染。现在,您可以选择以所选的受支持语言显示地图。在启动时,所选语言将由 OpenSearch 仪表板 YAML 配置文件定义;请留意未来版本中的可选下拉菜单。 使用组件模板简化管理 OpenSearch 2.7.0 通过将组件模板直接添加到 OpenSearch 仪表板的索引管理 UI 中,简化了多个索引模板的管理。过去,由于重复,用户在管理多个索引模板时遇到困难,从而导致集群状态更大。此外,对多个模板进行更改需要对每个模板进行手动更新。组件模板进一步增强了 2.5.0 中引入的索引管理 UI,允许您通过将常用设置、映射和别名抽象到可重用的构建基块中来克服这些挑战。 在 OpenSearch 仪表板中动态配置租赁 OpenSearch 管理员的另一个节省时间的升级是动态租户管理的可用性。OpenSearch 仪表板使用租户作为保存和共享索引模式、可视化效果、仪表板和其他对象的空间,并对用户可以访问租户以及提供的访问级别进行管理控制。在早期版本中,仪表板支持租户创建和映射,而租户配置在 YAML 文件中完成,需要在每个数据节点内进行更改以保持节点之间的一致性,并且需要重新启动仪表板才能生效。在此版本中,管理员可以在仪表板中查看、配置和启用或禁用租户,并实现这些更改,而无需重新启动。 通过热分片识别保持性能 此版本为OpenSearch的性能分析器插件中可用的工具集合带来了热分片识别。热分片比索引中的其他分片消耗更多的计算、内存或网络资源;如果不加以解决,它们可能会导致查询吞吐量降低和索引延迟增加,从而可能影响群集可用性。现在,您可以使用性能分析器的根本原因分析代理来识别集群中的热分片,以便可以缓解它们以提高集群性能。 使用内置关联工具分析安全事件 包含安全事件的日志数据可以跨越多个索引和数据流,可视化连接事件之间的关系可以为安全分析师提供有价值的见解。关联引擎作为实验性功能包含在此版本中,允许您在安全事件数据中定义关联,从而跨不同的日志源(如 DNS、Netflow 和 Active Directory)实现高保真结果,仅举几例。此知识图谱可用于跨多个索引和数据流识别、存储和调用连接的事件数据,以帮助您识别模式并调查受监控基础架构中不同系统之间的关系。与往常一样,建议仅在生产环境之外使用实验性功能。 提高 ML 模型的可用性 实验性机器学习 (ML) 框架在此版本中接收更新,包括用于 ML 模型的新自动重新加载机制。现在,您可以将搜索集群设置为在集群关闭后重新启动或节点重新加入集群时自动重新加载已部署的模型,从而最大限度地减少恢复时间并更快地将 ML 模型恢复到生产中。 探索开放搜索 2.7.0 最新版本的OpenSearch可供下载。您可以在发行说明、文档发行说明和文档中了解有关这些功能的更多信息以及更多内容,OpenSearch Playground是在下载工具之前探索这些工具的好地方。查找即将发布的博客文章,这些文章将更深入地了解 OpenSearch 2.7.0 中包含的新功能。

优秀的个人博客,低调大师

Rocky Linux 8.7 正式 GA,CentOS 替代方案

Rocky Linux 8.7 已正式 GA。Rocky Linux 是一个企业级 Linux 发行版,与 RHEL 完全兼容,由 CentOS 创始人 Gregory Kurtzer 创建和领导,支持 x86_64 和 AArch64 处理器架构。 新版下载地址:https://rockylinux.org/download/ 主要变化 NetworkManager 已 rebase 到 1.40。此版本的 NetworkManager 注释可在此处获得。 新的 module stream 版本包括 node.js 18、mercurial:6.2、maven:3.8 和 ruby​​:3.1。 新的编译器工具集版本包括 GCC 12、LLVM 14.0.6、Rust 1.62 和 Go 1.18。 httpd 中 LimitRequestBody 指令的默认值已从无限制更改为 1GiB,以修复 CVE-2022-29404。 SSSD 现在支持与 Windows Server 2022 的直接集成。 云镜像 官方 Rocky Linux 镜像现已支持在 Oracle 云平台上使用。 所有构建的镜像背后的工件现在都被导出以供开发使用。 通用、EC2 和 Azure 镜像的 LVM 变体现已可用。 升级和迁移教程 Rocky Linux 8 的当前用户使用dnf update通过 PackageKit 及其接口(GNOME 软件等)升级到 8.7。 其他 Enterprise Linux 8 发行版的用户可以通过migrate2rocky迁移脚本升级并迁移到 Rocky Linux 8.7。 详情查看发布公告。

优秀的个人博客,低调大师

Appwrite 1.0 发布,Firebase 开源替代

Appwrite 是一个基于 Docker 的端到端开发者平台,其容器化的微服务库可应用于网页端、移动端,以及后端。Appwrite 通过视觉化界面极简了从零编写 API 的繁琐过程,在保证软件安全的前提下为开发者创造了一个高效的开发环境。 Appwrite 可以提供给开发者用户验证、外部授权、用户数据读写检索、文件储存、图像处理、云函数计算等多种服务. 特性 增加了在用户界面中查看所有资源的 Parent ID 的用户界面 为 Appwrite 内部服务增加了自动缓存清理功能 增加了 Appwrite 处理导入散列密码的功能,这可以用来从其他系统导入现有的用户数据 在 Appwrite 控制台中, Users现在被重新命名为 Authentication 更多的端点被公开(针对客人),并有适当的速率限制 增加了 Discuz、Podio 和 Etsy OAuth 提供者 功能日志现在可以捕获 stdout 增加了授予客人对文档、文件和执行的写入权限的功能 修复 修正在 Appwrite 控制台重设密码后,你不会被重定向到登录页面 修正了无效的数据可能被载入 Appwrite 控制台 修正了一个使用 MySQL 适配器的用户会遇到全文索引的问题 修复了团队被创建时没有所有者的问题 修正了一个无法通过电话搜索用户的问题 修正了一个未接受的邀请会授予对项目的访问权的问题 重要变化 所有的 Date 值现在都存储为 ISO-8601 而不是 UNIX 时间戳 权限级别和语法已被重新设计 函数变量现在被存储在一个单独的集合中,有自己的 API 端点 在函数中, req.env 已被重命名为 req.variables 异步计算的资源,现在将返回 202 Accepted 状态代码,而不是 200 OK 查询已经得到改进,允许更多的灵活性,并引入了新的端点 复合索引现在更加灵活 createExecution 参数的 async 默认值从 true 改为 false 在函数集合中,字符串属性 status 已被重构为一个 enabled 的布尔属性 Execution 响应模型中的 time 属性已被重命名为 duration,以便与其他响应模型更加一致 更多详情可查看:https://github.com/appwrite/appwrite/releases/tag/1.0.0

优秀的个人博客,低调大师

go-stash —— 高效的 Logstash 替代方案

go-stash 是一个高效的从 Kafka 获取,根据配置的规则进行处理,然后发送到 ElasticSearch 集群的工具。 go-stash 有大概 logstash 5 倍的吞吐性能,并且部署简单,一个可执行文件即可。 安装 cd stash && go build stash.go Quick Start 可执行文件方式 ./stash -f etc/config.yaml docker 方式,确保配置文件路径正确 docker run -d -v `pwd`/etc:/app/etc kevinwan/go-stash config.yaml示例如下: Clusters: - Input: Kafka: Name: go-stash Log: Mode: file Brokers: - "172.16.48.41:9092" - "172.16.48.42:9092" - "172.16.48.43:9092" Topic: ngapplog Group: stash Conns: 3 Consumers: 10 Processors: 60 MinBytes: 1048576 MaxBytes: 10485760 Offset: first Filters: - Action: drop Conditions: - Key: status Value: 503 Type: contains - Key: type Value: "app" Type: match Op: and - Action: remove_field Fields: - message - source - beat - fields - input_type - offset - "@version" - _score - _type - clientip - http_host - request_time Output: ElasticSearch: Hosts: - "http://172.16.188.73:9200" - "http://172.16.188.74:9200" - "http://172.16.188.75:9200" Index: "go-stash-{{yyyy.MM.dd}}" MaxChunkBytes: 5242880 GracePeriod: 10s Compress: false TimeZone: UTC ES性能写入测试 测试环境 stash服务器:3台 4核 8G es服务器: 15台 16核 64G 关键配置 - Input: Conns: 3 Consumers: 10 Processors: 60 MinBytes: 1048576 MaxBytes: 10485760 Filters: - Action: remove_field Fields: - message - source - beat - fields - input_type - offset - request_time Output: Index: "nginx_pro-{{yyyy.MM.d}}" Compress: false MaxChunkBytes: 5242880 TimeZone: UTC 写入速度平均在15W/S以上

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册