首页 文章 精选 留言 我的

精选列表

搜索[技能变化],共10002篇文章
优秀的个人博客,低调大师

运维工程师需要掌握的技能

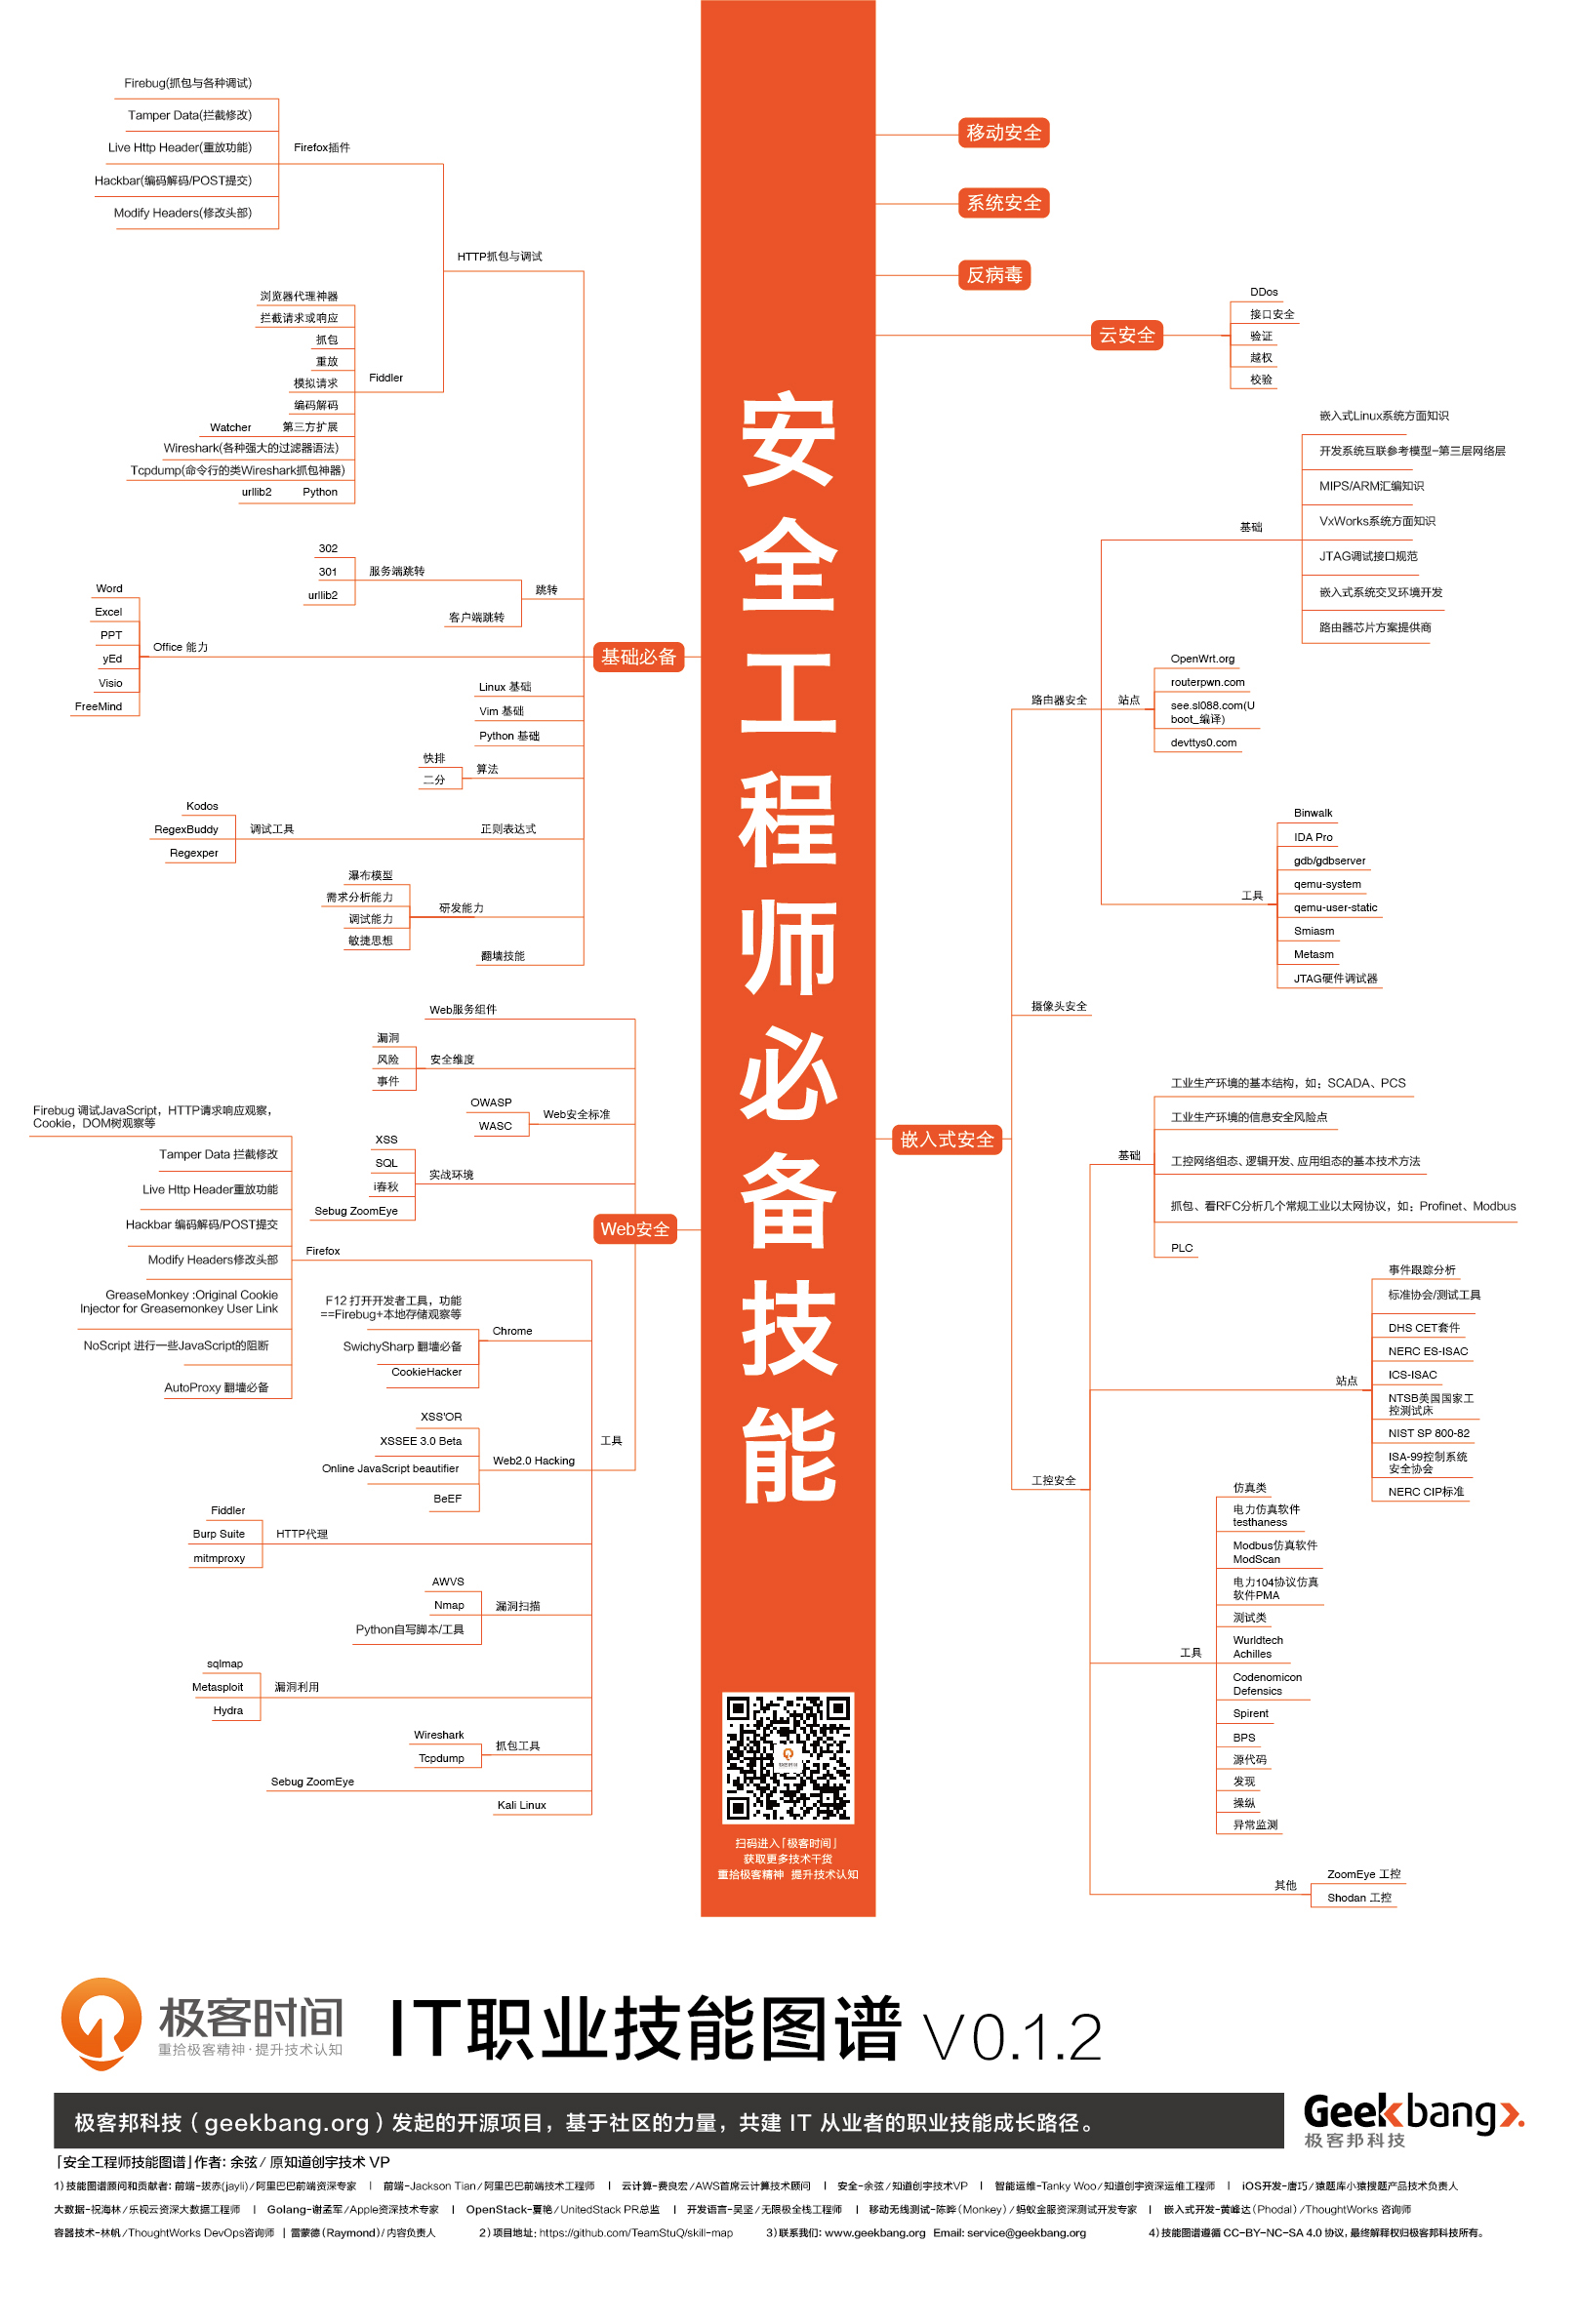
提起运维,大家都会想到又苦又累,又不被人重视的网管,机房运维,认为这个工种很low,入门门槛低,做的事比较杂,从搬服务器上架到修打印机,修电脑,处理网络小故障等杂七杂八的活,究其原因,多年来小公司都把运维当做一种打杂的小工使。其实运维从分类可以分为很多专业领域,比如网络工程师,系统工程师,备份存储工程师,CDN工程师,数据库管理员,应用运维,运维开发,运维架构师等等岗位,本章暂不对运维岗位做过多解释,我就个人的经验,我是从运维实施、系统管理员、DBA最后到运维开发的,简单说说各大互联网公司对岗位的面试要求: WEB篇:1、负载均衡篇:熟悉常用的负载均衡技术,LVS,dpdk,Nginx等四层/七层负载均衡,除了硬件负载均衡设备F5,有搭建、维护并熟悉负载均衡原理;2、Nginx 重要配置、优化及使用、与lua的结合,接入、降级、限流、隔离、熔断、动静分离、反向代理、负载均衡,反爬虫,黑白名单等 另Nginx 和Apache的比较;3、TCP/HTTPs协议及三次握手,四次挥手,get/post的差异,协议头,跳转,常见返回码的含义200/30x/40x/50x等知识及导致返回码的可能故障原因,如果可能请详细了解TCP/TP协议内容;4、web的优化,web 访问的流程,从浏览器-DNS-CDN-缓存(本地缓存,负载均衡层,缓存层,接入层,应用层,数据库层)-应用-数据库整个流程,需要陈述过程,并能解释调优排障的思路;http 连接越快越好,越快建立连接越好,中间DNS解析, tcp握手都是可以优化的点http 请求少并且小,减少请求的数量,请求的体积,比如 cookie的大小 解析html 的速度,dom树解析,js 执行和首屏渲染是串行的,页面渲染,把js放到body后面加载页面,下载资源,利用上面的原则,尽量少的发http请求,比如图片,字体,以及js文件等等 网络篇:网络抖动,网卡打满,大面积断网,网络丢包,网络劫持,接口响应超时等,常用网络故障排查的手段,工具等,如tcpdump/iftop/traceroute/netstat等 故障篇:网络失败,业务异常(参数错误、业务逻辑处理错误,返回数据格式错误等下游业务不可用),机器故障 cpu 负载太高,内存溢出,磁盘打满,网卡打满,超时监控快速反馈 监控:正面预防,快速发现、定位问题进行报警降级:反向止损,遇到故障自动处理,降低损失 监控篇: 常规监控: zabbix 、Ganglia、Cacti、Nagios等业务监控:业务指标的监控调用链监控:CAT、zipkin、阿里鹰眼等其他新兴监控: Prometheus open-falcon日志监控:ELK等另外时序数据库是监控领域比较火的技术,大家可以多研究一下 应用篇Java,weblogic,tomcat,jetty等Java中间件,涉及jvm 的调优,监控,GC的调优,cpu高的诊断dubbo spring cloud sprin boot sping 全家桶,微服务的搭建,部署,监控(调用链监控)鉴于微服务领域还不成熟,很多公司还没有实践,另外有必要了解K8S等编排工具消息中间库 rabbitmq 、rocketmq,Kafka 等对比使用,如吞吐量、时延等优缺点,运维中遇到的问题及故障处置redis 的架构,有单节点,官方cluster集群,复制,读写分离,分片等,业界使用的proxy 方案,对比优缺点,常遇到的故障及问题,再就是容灾,跨机房,业界的解决方案,一般是通过流复制redis 和memcache的区别,优缺点增加对项目的架构,集群规模,QPS/TPS等数据的认知mongodb 集群的运维,分片集群的规模,运维监控,处理过的问题及优化,主要有cpu高,慢查询,占用内存高,夯死等问题应用部署的问题,涉及发布,构建,编译等 大数据篇:Hadoop 生态圈 hdfs,habase ,hive,mapreduse,zookeerer,kafka,tez,impla,spark等组件,zeppelin,kylin,侧重生产机器的规模,遇到的问题,踩到的坑,有的侧重原理 数据库篇:MySQL oracle、简单了解,sql 语句的查询,索引的类型,数据库高可用架构,主从、双主、MHA架构、Proxy方案等,另外了解数据库中间件,例如mycat等 存储篇:ceph 的搭建,对象存储的原理,各种存储(NAS/SAN/对象存储等)的优缺点及使用场景 公有云、私有云篇:openstack ,zstack ,虚拟化 vm 的原理 docker 篇docker的基本原理、编排工具k8s 的使用,k8s 的概念,pod ,网络的解决方案遇到的坑及解决方案,当然也要防止某些辣鸡公司套你方案docker 自建仓库,docker file的使用 自动化运维篇自动化运维工具的使用,ansible ,saltstack 等使用,Django 的开发 cmdb/自动化部署,任务调度系统,数据库运维系统CI/CD的构建,自动化发布,灰度发布,金丝雀发布,蓝绿发布等等devops的概念及实施,对AIops的见解及作出的变革 开发篇:shell 脚本 基础运维命令python 开发 ,主要是web开发,表单的设计,数据库或者orm的设计,高并发,消息队列 restapi等 前端比较弱是运维的通病salca 略了解,多用于大数据开发go 略了解,如果熟悉并开发过项目,一定是加分项,求之不得; 面试篇:个人自我介绍目前的工作内容,负责的项目,遇到的故障,印象深刻的项目,遇到的挑战,遇到的棘手问题,自己负责过的项目,项目规模,集群规模,人数等等
优秀的个人博客,低调大师

数据科学挑战重重 get新技能成当务之急

随着更多新兴工具和技术的出现,许多企业正在努力应对当今大数据和数据科学生态系统的复杂性。 根据TDWI(数据仓库研究所)的最新研究,专业数据科学家的短缺仍然是企业面临的数据科学的挑战之一。 TDWI公司副总裁兼研究总监Fern Halper说:“我们经常听到很多组织表示,在数据科学环境中面临的最大挑战是找到合适的技术和工具。” 该研究收集了超过300家企业的大数据和数据科学经验。大数据分析和数据科学经验这两个主题越来越融合,因为组织需要了解过去几年中收集大量数据的工作者。 此次调查的受访者列举的其他常见挑战还有:缺乏对大数据工具的了解,缺乏利用大数据所需的企业架构,安全和隐私问题以及治理协议不足等问题。 尤其是技术方面的问题特别棘手。Halper表示,在过去几年中出现了许多新工具,包括Hadoop,Spark,Python等等,企业很难确保跟上这些新工具、新技术快速发展的步伐。 有些受访者认为很多技术让人眼花缭乱,其中不乏炒作的因素,他们有时不知道该怎样面对技术的迭代更新。另外一些人认为技术和工具变更速度很快,如果缺乏敏捷性,他们不一定能保持最好的架构。 现在,企业都在使用自己熟悉的工具和技术应对数据科学的挑战。约80%的受访者表示他们目前使用数据仓库工具作为主要数据源。对于分析而言,简单的查询和数据可视化工具是最常用的。在接下来的两年中,数据仓库工具将依然广受欢迎,与此同时,Hadoop和开源R也受到更多企业的青睐。 Halper说,调查结果显示出非结构化数据查询和预测分析(包括机器学习)的强劲势头。这些新兴工具和技术似乎将在未来将彻底取代更多的工具。 “数据仓库不会消失,但它正被其他类型的平台取代,并创建一个生态系统,” Halper说, “预测分析是一项热门技术,再加上机器学习的驱动,未来的发展势头不可小觑。” 本文转自d1net(转载)

优秀的个人博客,低调大师

AI时代商业模式变化——增长与壁垒:复利红利

增长与壁垒:越做越便宜,越来越难被替代 规模是加法,复利是乘法——你今天多交付一次,以后每一次都更便宜 **始于咨询.终于因果** --- 劳斯莱斯卖的不只是发动机,是"按飞行小时收费"——航空公司每飞一小时,付一笔钱,发动机的维护、更换全包在里面。这招半个多世纪前就想出来了,但那时候要靠庞大地面团队、靠人工台账,成本高到跑不动。 如今传感器把每台发动机的运转数据一刻不停地传回地面,闭环才真正转起来:飞得越多,数据攒得越多,对"这台发动机什么时候会出问题"的判断就越准,维护越早、越省,报价也就越敢往下压。同行不是不想学,是学不来——那些攒了几十年的飞行数据,从零开始攒不起。 增长从拼规模,变成拼复利;壁垒从规模本身,变成别人攒不起来的闭环。 一、加法与乘法 过去增长靠规模:摊子铺得越大,固定成本摊得越薄,单位成本越低,别人越难跟你打价格战。这是加法,每多一单,只多赚一单的钱。现在增长靠复利:每一次交付都在积累数据,数据让下一次交付更便宜、更准。 甲乙对比 同样卖设备运维,甲靠人多,客户多一单,他就得多招一个人,边际成本几乎不降;乙有数据闭环,第十个客户和第一百个客户共用同一套预测模型,多服务一个客户几乎不再多花力气。头两年,乙很可能还是亏的;但只要闭环转起来,乙的成本曲线一路往下,甲则永远停在原地。 **差距不是靠熬出来的,是靠转不转得动数据碾出来的。** 二、新的护城河 过去的护城河,是规模本身:我的厂够大、我的渠道够深、我的牌子够响。现在的护城河,是别人攒不起来的闭环:我的每一次交付都在沉淀数据,数据喂给我的判断,判断让我的下一次交付更好,我的报价就敢更低、承诺就敢更满——而对手一没有数据,二没有闭环,想跟也跟不动。 复利是条件命题,闭环不闭合,就没有复利。 很多企业上了AI一年多,没见到复利,不是AI没用,是他们的数据没有闭环——交付完就完了,数据躺在系统里没人用,或者根本没人收集。复利的前提是:每一次交付的数据,都回流成下一次交付的判断。回流了,才是复利;不回流的,只是记录。 三、三个问题判断你的数据有没有闭环 第一问 你每次交付完,数据是**自动落下来**,还是靠人手工补录? 第二问 这些数据有没有**喂给下一次的判断**——报价、排产、派单——还是躺在报表里没人看? 第三问 闭环转了一年之后,你的**单位交付成本有没有真的降下来**? 三问都答"是",你才有复利;有一问答"否",你只是在攒数据,不是在养复利。 四、结果也会商品化,靠什么活 当大家都开始卖结果,结果本身也会商品化。你按每件合格品收钱,别人敢按每件收更低的钱,最后价格一路打到成本线。那时候靠什么活下去?靠的绝不是降价,而是别人攒不起来的那个闭环。 数据我也有,凭什么说他的闭环我复制不了?因为闭环的护城河不在数据本身,在数据和时间叠出来的判断。他攒了三年的故障记录,知道这条产线哪个环节最脆弱,报价敢低三成;你就算把他的系统搬过来,没有这三年的历史,预测模型在你家就是空的。 数据可以复制,数据背后的时间复利复制不了。 产品是入口,数据是护城河,闭环是命。 **你每次交付完,数据是留在你手里、回流成下一次的判断,还是流走了?如果你的数据没有闭环,你的"卖结果"就只是一场又一场的价格战。 ** # 标签 #Palantir#流程管理#企业AI转型#本体#经营智商 经营智商系列 · 商业模式之变专题 本文为系列文章,后续将陆续探讨「不是所有生意都会变」「度量前线与桥」「重构你的商业模式」等话题。 关注我,带你持续提升企业经营智商!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册