首页 文章 精选 留言 我的

精选列表

搜索[图形后端],共10005篇文章
优秀的个人博客,低调大师

温故Linux后端编程(三):线程那些事儿

文章目录 前言 摘要 线程 什么是线程 使用线程的优势 线程与进程千丝万缕的纠缠 线程间资源共享情况 使用线程的弊端 线程管理(Thread Managment) 创建线程 获取当前线程id 判断俩线程是否相等 连接(Joining)和分离(Detaching)线程 线程属性 互斥量 互斥量存在的意义 互斥锁原语 参数释义 互斥量使用 死锁 锁种 乐观锁 悲观锁 乐观锁 VS 悲观锁 自旋锁 && 互斥锁 条件变量 条件变量原语 条件变量与互斥锁 注意事项 虚假唤醒与唤醒丢失 ⑴虚假唤醒 ⑵唤醒丢失 使用条件变量 线程池 番外篇 Pthread API函数 多线程下的对象创建 对象的销毁与竞态条件 shared_ptr/weak_ptr 再聊会儿C++内存安全 资源推荐 前言 不知不觉,就到大三了。 不知不觉,就要开始找暑期实习了。 温故而知新嘛。(数据结构复习两天发现不对,我还是更喜欢这个。) 所以就来了。 摘要 在多处理器共享内存的架构中(如:对称多处理系统SMP),线程可以用于实现程序的并行性。历史上硬件销售商实现了各种私有版本的多线程库,使得软件开发者不得不关心它的移植性。对于UNIX系统,IEEE POSIX 1003.1标准定义了一个C语言多线程编程接口。依附于该标准的实现被称为POSIX theads 或 Pthreads。 该教程介绍了Pthreads的概念、动机和设计思想。内容包含了Pthreads API主要的三大类函数:线程管理(Thread Managment)、互斥量(Mutex Variables)和条件变量(Condition Variables)。向刚开始学习Pthreads的程序员提供了演示例程。 适于:刚开始学习使用线程实现并行程序设计;对于C并行程序设计有基本了解。 线程 都说知其然,知其所以然。 不知道,我们专业的要求是这样的。 什么是线程 官方话就是:是操作系统能够进行运算调度的最小单位。它被包含在进程之中,是进程中的实际运作单位。一条线程指的是进程中一个单一顺序的控制流,一个进程中可以并发多个线程,每条线程并行执行不同的任务。 1、提高程序的并发性 2、开销小,不需要重新分配内存 3、通信和共享数据方便 使用线程的优势 在同一个进程中的所有线程共享同样的地址空间。较于进程间的通信,在许多情况下线程间的通信效率比较高,且易于使用。 较于没有使用线程的程序,使用线程的应用程序有潜在的性能增益和实际的优点: CPU使用I/O交叠工作:例如,一个程序可能有一个需要较长时间的I/O操作,当一个线程等待I/O系统调用完成时,CPU可以被其它线程使用。 优先/实时调度:比较重要的任务可以被调度,替换或者中断较低优先级的任务。 异步事件处理:频率和持续时间不确定的任务可以交错。例如,web服务器可以同时为前一个请求传输数据和管理新请求。 Pthreads没有中间的内存复制,因为线程和一个进程共享同样的地址空间。没有数据传输。变成cache-to-CPU或memory-to-CPU的带宽(最坏情况),速度是相当的快。 劣势啊,劣势也很明显,毁誉参半,后面再说。 线程与进程千丝万缕的纠缠 (1)线程又被叫做轻量级进程,也有PCB,创建线程使用的底层函数和进程是一样的,都是clone。 (2)从内核里看线程和进程是一样的,都有各自不同的PCB,但是PCB指向的内存资源的三级页表是不同的。 (3)进程可以蜕变成线程,进程也可以说是主线程,就是高速路的主干道。 (4)在Linux下,线程是最小的执行单位,进程是最小的分配资源单位。 线程间资源共享情况 ⑴共享资源 1、文件描述符表 2、每种信号的处理方式 3、当前工作目录 4、用户ID和组ID 5、内存地址空间 ⑵非共享资源 1、线程id 2、处理器现场和栈指针 3、独立的栈空间 4、errno变量 5、信号屏蔽字 6、调度优先级 使用线程的弊端 1、线程不稳定(这个是真的不稳定,后面会专门出一篇“可重入函数对线程的影响”,因为现在还没整理好那块儿) 2、线程调试困难(这个是真的头疼,难以调试的东西,目前我只有一个“段错误,核心已转储”可以用用,关键是错误难以复现,很难,很难) 3、线程无法使用Unix经典事件,如信号(这个反正我也没用过,管它) 例如:假设你的程序创建了几个线程,每一个调用相同的库函数: 这个库函数存取/修改了一个全局结构或内存中的位置。 当每个线程调用这个函数时,可能同时去修改这个全局结构活内存位置。 如果函数没有使用同步机制去阻止数据破坏,这时,就不是线程安全的了。 如果你不是100%确定外部库函数是线程安全的,自己负责所可能引发的问题。 建议:小心使用库或者对象,当不能明确确定是否是线程安全的。若有疑虑,假设其不是线程安全的直到得以证明。 可以通过不断地使用不确定的函数找出问题所在。 看一下这篇(过几天会重写):可重入函数对于线程安全的意义 线程管理(Thread Managment) 创建线程 #include<pthread.h> int pthread_create(pthread_t *thread,const pthread_tattr_t *attr,void *(*start_routine)(void *),void *arg); /* 参数释义: thread:这是一个传出参数,传递一个pthread_t变量进来,用以保存新线程的tid(线程id) attr:线程属性设置,NULL代表使用默认属性(注(1)) (*start_routine)(void *):函数指针,指向新线程应该指向的函数模块 arg:老熟了,给前面那个函数传参用的,不传就写NULL 返回值:成功返回0.,失败返回错误号,错误号,错误号,前面说过errno不共享的。(线程里返回值统一这样的,后面不提了) 注(1):创建线程时,没什么特殊情况我们都是使用默认属性的,不过有时候需要做一些特殊处理,碧如调整优先级啊这些的。 */ Q:怎样安全地向一个新创建的线程传递数据? A:确保所传递的数据是线程安全的(不能被其他线程修改)。下面三个例子演示了那个应该和那个不应该。 代码演示: // Example Code - Pthread Creation and Termination #include <pthread.h> #include <stdio.h> #define NUM_THREADS 5 void *PrintHello(void *thread_id) { int tid; tid = (int)thread_id; printf("Hello World! It's me, thread #%d!\n", tid); pthread_exit(NULL); } int main(int argc, char *argv[]) { pthread_t threads[NUM_THREADS]; int rc, t; for(t=0; t<NUM_THREADS; t++){ printf("In main: creating thread %d\n", t); rc = pthread_create(&threads[t], NULL, PrintHello, (void *)t); if (rc){ printf("ERROR; return code from pthread_create() is %d\n", rc); exit(-1); } } pthread_exit(NULL); } 接下来演示线程安全: //下面的代码片段演示了如何向一个线程传递一个简单的整数。 //主线程为每一个线程使用一个唯一的数据结构,确保每个线程传递的参数是完整的。 int *taskids[NUM_THREADS]; for(t=0; t<NUM_THREADS; t++) { taskids[t] = (int *) malloc(sizeof(int)); *taskids[t] = t; printf("Creating thread %d\n", t); rc = pthread_create(&threads[t], NULL, PrintHello,(void *) taskids[t]); ... } //例子展示了用结构体向线程设置/传递参数。每个线程获得一个唯一的结构体实例。 struct thread_data{ int thread_id; int sum; char *message; }; struct thread_data thread_data_array[NUM_THREADS]; void *PrintHello(void *threadarg) { struct thread_data *my_data; ... my_data = (struct thread_data *)threadarg; taskid = my_data->thread_id; sum = my_data->sum; hello_msg = my_data->message; ... } int main (int argc, char *argv[]) { ... thread_data_array[t].thread_id = t; thread_data_array[t].sum = sum; thread_data_array[t].message = messages[t]; rc = pthread_create(&threads[t], NULL, PrintHello,(void *) &thread_data_array[t]); ... } //例子演示了错误地传递参数。循环会在线程访问传递的参数前改变传递给线程的地址的内容。 int rc, t; for(t=0; t<NUM_THREADS; t++) { printf("Creating thread %d\n", t); rc = pthread_create(&threads[t], NULL, PrintHello,(void *) &t); ... } 获取当前线程id #include<pthread.h> pthread_t pthread_self(void); 线程id的类型是pthread_t,它在当前进程中是唯一的,但是在不同系统中这个类型有不同的实现,它可能是一个整数值,也可能是一个结构体,反正就是你猜不到的东西。 判断俩线程是否相等 #include<pthread.h> int pthread_self(pthread_t t1,pthread_t t2); 注意这两个函数中的线程ID对象是不透明的,不是轻易能检查的。因为线程ID是不透明的对象,所以C语言的==操作符不能用于比较两个线程ID。 连接(Joining)和分离(Detaching)线程 pthread_join(threadid,status) pthread_detach(threadid,status) pthread_attr_setdetachstate(attr,detachstate) pthread_attr_getdetachstate(attr,detachstate) pthread_join()函数阻塞调用线程直到threadid所指定的线程终止。 如果在目标线程中调用pthread_exit(),程序员可以在主线程中获得目标线程的终止状态。 连接线程只能用pthread_join()连接一次。若多次调用就会发生逻辑错误。 两种同步方法,互斥量(mutexes)和条件变量(condition variables),稍后讨论。 可连接(Joinable or Not)? 当一个线程被创建,它有一个属性定义了它是可连接的(joinable)还是分离的(detached)。 只有是可连接的线程才能被连接(joined),若果创建的线程是分离的,则不能连接。 POSIX标准的最终草案指定了线程必须创建成可连接的。然而,并非所有实现都遵循此约定。 使用pthread_create()的attr参数可以显式的创建可连接或分离的线程 典型四步如下: 声明一个pthread_attr_t数据类型的线程属性变量 用 pthread_attr_init()初始化改属性变量 用pthread_attr_setdetachstate()设置可分离状态属性 完了后,用pthread_attr_destroy()释放属性所占用的库资源 分离(Detaching): pthread_detach()可以显式用于分离线程,尽管创建时是可连接的。 没有与pthread_detach()功能相反的函数 又到了演示线程安全的时间了 //这个例子演示了用Pthread join函数去等待线程终止。 //因为有些实现并不是默认创建线程是可连接状态,例子中显式地将其创建为可连接的。 #include <pthread.h> #include <stdio.h> #define NUM_THREADS 3 void *BusyWork(void *null) { int i; double result=0.0; for (i=0; i<1000000; i++) { result = result + (double)random(); } printf("result = %e\n",result); pthread_exit((void *) 0); } int main (int argc, char *argv[]) { pthread_t thread[NUM_THREADS]; pthread_attr_t attr; int rc, t; void *status; /* Initialize and set thread detached attribute */ pthread_attr_init(&attr); pthread_attr_setdetachstate(&attr, PTHREAD_CREATE_JOINABLE); for(t=0; t<NUM_THREADS; t++) { printf("Creating thread %d\n", t); rc = pthread_create(&thread[t], &attr, BusyWork, NULL); if (rc) { printf("ERROR; return code from pthread_create() is %d/n", rc); exit(-1); } } /* Free attribute and wait for the other threads */ pthread_attr_destroy(&attr); for(t=0; t<NUM_THREADS; t++) { rc = pthread_join(thread[t], &status); if (rc) { printf("ERROR; return code from pthread_join() is %d\n", rc); exit(-1); } printf("Completed join with thread %d status= %ld\n",t, (long)status); } pthread_exit(NULL); } 当一个线程被设置为分离线程时,如果线程的运行非常快,可能在pthread_create()函数返回之前就终止了。由于一个线程在终止以后可以将线程号和系统资源移交给其他的线程使用,此时再使用函数pthread_cretae()获得的线程号进行操作将会发生错误。 线程属性 linux下线程属性是可以根据实际项目需要进行设置。 之前我们讨论的都是线程的默认属性,默认属性已经可以解决大部分线程开发时的需求。 如果需要更高的性能,就需要人为对线程属性进行配置。 typedef struct { int detachstate; //线程的分离状态 int schedpolicy; //线程的调度策略 struct sched schedparam;//线程的调度参数 int inheritsched; //线程的继承性 int scope; //线程的作用域 size_t guardsize; //线程栈末尾的警戒缓冲区大小 int stackaddr_set; //线程栈的设置 void* stackaddr; //线程栈的启始位置 size_t stacksize; //线程栈大小 }pthread_attr_t; //在上面我们可以看到,关于这个结构体中的相关参数 默认的属性为非绑定、非分离、缺省的堆栈、与父进程同样级别的优先级。 线程属性设置的一般套路: 第一:定义属性变量并初始化 pthread_attr_t pthread_attr_init() 第二:调用你想设置的属性的接口函数 pthread_attr_setxxxxxxxx() 第三:创建线程的时候,第二个参数使用这个属性 第四:销毁属性 pthread_destroy(); 互斥量 互斥量存在的意义 做个小实验吧,两个线程计数。如果最后加起来是20万那就不用往下看了。 #include<pthread.h> #include<unistd.h> #include<stdio.h> int count = 0;//声明全局变量,等下就看看它了 void *run(void *arg) { int i = 0; for(i = 0;i < 100000; i++) { count++; printf("Count:%d\n",count); usleep(2); } return (void*)0; } int main(int argc,char **argv) { pthread_t tid1,tid2; int err1,err2; err1 = pthread_create(&tid1,NULL,run,NULL); err2 = pthread_create(&tid2,NULL,run,NULL); if(err1==0 && err2==0)//俩线程都成功创建出来 { pthread_join(tid1,NULL); pthread_join(tid2,NULL); } return 0; } 好,为什么要线程同步,那就心照不宣了 算了,官方话还是要说一说的 1、共享资源,多个线程都可以对共享资源进行操作 2、线程操作共享资源的先后顺序不一定 3、处理器对存储器的操作一般不是原子操作 互斥锁原语 pthread_mutex_t mutex = PTHREAD_MUREX_INITALIZER //用于初始化互斥锁,后面简称锁 int pthread_mutex_init(pthread_mutex_t *restrict mutex,const pthread_mutexattr_t *restrict attr); //初始化锁,和上面那个一个意思。 //初始化一个互斥锁(互斥量)–>初值可看做1 int pthread_mutex_destroy(pthread_mutex_t *mutex); //销毁锁 int pthread_mutex_lock(pthread_mutex_t *mutex); //上锁 int pthread_mutex_unlok(pthread_mutex_t *mutex); //解锁 int pthread_mutex_trylock(pthread_mutex_t *mutex); //尝试上锁 参数释义 <这里只释义那个init> 参数1:传出参数,调用时应传&mutex restrict关键字:只用于限制指针,告诉编译器,所有修改该指针指向内存中内容的操作,只能通过本指针完成。不能通过除本指针以外的其他变量或指针修改。 参数2:互斥属性。是一个传入参数,通常传NULL,选用默认属性(线程间共享). 静态初始化:如果互斥锁mutex是静态分配的(定义在全局,或加了static关键字修饰),可以直接使用宏进行初始化。pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER; 动态初始化:局部变量应采用动态初始化。pthread_mutex_init(&mutex, NULL); attr对象用于设置互斥量对象的属性,使用时必须声明为pthread_mutextattr_t类型,默认值可以是NULL。Pthreads标准定义了三种可选的互斥量属性: 协议(Protocol): 指定了协议用于阻止互斥量的优先级改变 优先级上限(Prioceiling):指定互斥量的优先级上限 进程共享(Process-shared):指定进程共享互斥量 注意所有实现都提供了这三个可选的互斥量属性。 Q:有多个线程等待同一个锁定的互斥量,当互斥量被解锁后,那个线程会第一个锁定互斥量? A:除非线程使用了优先级调度机制,否则,线程会被系统调度器去分配,那个线程会第一个锁定互斥量是随机的。 互斥量使用 #include<pthread.h> #include<unistd.h> #include<stdio.h> pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER; int count = 0; void *run(void *arg) { int i = 0; for(i = 0;i < 100000; i++) { pthread_mutex_lock(&mutex); count++; pthread_mutex_unlock(&mutex); printf("Count:%d\n",count); usleep(2); } return (void*)0; } int main(int argc,char **argv) { pthread_t tid1,tid2; int err1,err2; err1 = pthread_create(&tid1,NULL,run,NULL); err2 = pthread_create(&tid2,NULL,run,NULL); if(err1==0 && err2==0) { pthread_join(tid1,NULL); pthread_join(tid2,NULL); } return 0; } 拿去执行,如果不是20万也可以不用往下看了。 死锁 (上一篇 进程·全家桶 在这个问题上花了不少篇幅) 为什么我要强调上锁和解锁一定要放在一起写,就是防止出现人为失误导致死锁 死锁嘛,解不开了。 要么是你忘了解开,别人也就没得用了 要么就是几个线程互相掐着关键数据导致谁也没办法完成任务,结果谁也没办法解锁。 这种情况下只有销毁掉代价最小的那个锁,让任务执行下去,不过后面要记得把那个被销毁的任务重新运作。 锁种 乐观锁 乐观锁,你看它名字就知道,把事情想得很单纯,它总认为资源和数据不会被别人所修改,所以读取不会上锁,但是乐观锁在进行写入操作的时候会判断当前数据是否被修改过。可以使用版本号等机制。 乐观锁多适用于多度的应用类型,这样可以提高吞吐量。 使用自增长的整数表示数据版本号: 若这双写互不干扰,男的取出,版本号为0,男的写入,版本号+1;女的取出,版本号为1,女的写入,版本号为2。 若这双写相互干扰了,男的取出,版本号为0;男的还没写入,女的取出,版本号为0;男的写入,版本号为1;女的写入,发现版本号不匹配,则写入失败,应该重新读取金额数和版本号。 此外,也可以通过时间戳来实现 悲观锁 悲观锁是一种悲观思想,它总认为最坏的情况可能会出现,它认为数据很可能会被其他人所修改,所以悲观锁在持有数据的时候总会把资源 或者 数据 锁住,这样其他线程想要请求这个资源的时候就会阻塞,直到等到悲观锁把资源释放为止。传统的关系型数据库里边就用到了很多这种锁机制,比如行锁,表锁等,读锁,写锁等,都是在做操作之前先上锁。悲观锁的实现往往依靠数据库本身的锁功能实现。 实现有数据库的锁之类的。 乐观锁 VS 悲观锁 只能说,各有千秋吧。 乐观锁适用于写比较少的情况下,即冲突真的很少发生的时候,这样可以省去了锁的开销,加大了系统的整个吞吐量。但如果经常产生冲突,这样反倒是降低了性能,所以这种情况下用悲观锁就比较合适。 悲观锁会造成访问数据库时间较长,并发性不好,特别是长事务。 乐观锁在现实中使用得较多。 自旋锁 && 互斥锁 自旋锁和互斥锁嘛,一直在用的,不过以前只是简单的叫它们:锁。原来人家有名字的啊。 wait() 晓得不?timewait()晓得不? 互斥锁:阻塞等待 自旋锁:等两下就去问一声:好了不?我很急啊!好了不?你快点啊。。。哈哈哈哈哈 自旋锁的原理比较简单,如果持有锁的线程能在短时间内释放锁资源,那么那些等待竞争锁的线程就不需要做内核态和用户态之间的切换进入阻塞状态,它们只需要等一等(自旋),等到持有锁的线程释放锁之后即可获取,这样就避免了用户进程和内核切换的消耗。 因为自旋锁避免了操作系统进程调度和线程切换,所以自旋锁通常适用在时间比较短的情况下。由于这个原因,操作系统的内核经常使用自旋锁。但是,如果长时间上锁的话,自旋锁会非常耗费性能,它阻止了其他线程的运行和调度。线程持有锁的时间越长,则持有该锁的线程将被 OS(Operating System) 调度程序中断的风险越大。如果发生中断情况,那么其他线程将保持旋转状态(反复尝试获取锁),而持有该锁的线程并不打算释放锁,这样导致的是结果是无限期推迟,直到持有锁的线程可以完成并释放它为止。 解决上面这种情况一个很好的方式是给自旋锁设定一个自旋时间,等时间一到立即释放自旋锁。适应性自旋锁意味着自旋时间不是固定的了,而是由前一次在同一个锁上的自旋时间以及锁拥有的状态来决定,基本认为一个线程上下文切换的时间是最佳的一个时间。 条件变量 条件变量提供了另一种同步的方式。互斥量通过控制对数据的访问实现了同步,而条件变量允许根据实际的数据值来实现同步。 没有条件变量,程序员就必须使用线程去轮询(可能在临界区),查看条件是否满足。这样比较消耗资源,因为线程连续繁忙工作。条件变量是一种可以实现这种轮询的方式。 条件变量往往和互斥一起使用 使用条件变量的代表性顺序如下: 条件变量原语 //初始化条件变量: //本人还是喜欢静态初始化,省事儿 pthread_cont_t cont = PTHREAD_COND_INITIALIZER; //好,再看看动态初始化 int pthread_cond_init(pthread_cond_t *cond, const pthread_condattr_t *attr); //参数释义:cond:用于接收初始化成功管道条件变量 //attr:通常为NULL,且被忽略 //有初始化那肯定得有销毁 int pthread_cond_destroy(pthread_cond_t *cond); //既然说条件变量是用来等待的,那就更要看看这等待的特殊之处了 int pthread_cond_wait(pthread_cond_t *cond,pthread_mutex_t *mutex); //无条件等待 int pthread_cond_timedwait(pthread_cond_t *cond,pthread_mutex_t mytex,const struct timespec *abstime); //计时等待 //好,加入等待唤醒大军了,那得看看怎么去唤醒了 int pthread_cond_signal(pthread_cond_t *cptr); //唤醒一个等待该条件的线程。存在多个线程是按照其队列入队顺序唤醒其中一个 int pthread_cond_broadcast(pthread_cond_t * cptr); //广播,唤醒所哟与等待线程 条件变量与互斥锁 在服务器编程中常用的线程池,多个线程会操作同一个任务队列,一旦发现任务队列中有新的任务,子线程将取出任务;这里因为是多线程操作,必然会涉及到用互斥锁保护任务队列的情况(否则其中一个线程操作了任务队列,取出线程到一半时,线程切换又取出相同任务)。但是互斥锁一个明显的缺点是它只有两种状态:锁定和非锁定。设想,每个线程为了获取新的任务不断得进行这样的操作:锁定任务队列,检查任务队列是否有新的任务,取得新的任务(有新的任务)或不做任何操作(无新的任务),释放锁,这将是很消耗资源的。 而条件变量通过允许线程阻塞和等待另一个线程发送信号的方法弥补了互斥锁的不足,它常和互斥锁一起配合使用。使用时,条件变量被用来阻塞一个线程,当条件不满足时,线程往往解开相应的互斥锁并等待条件发生变化。一旦其他的某个线程改变了条件变量,他将通知相应的条件变量唤醒一个或多个正被此条件变量阻塞的线程。这些线程将重新锁定互斥锁并重新测试条件是否满足。一般说来,条件变量被用来进行线程间的同步。对应于线程池的场景,我们可以让线程处于等待状态,当主线程将新的任务放入工作队列时,发出通知(其中一个或多个),得到通知的线程重新获得锁,取得任务,执行相关操作。 注意事项 (1)必须在互斥锁的保护下唤醒,否则唤醒可能发生在锁定条件变量之前,照成死锁。 (2)唤醒阻塞在条件变量上的所有线程的顺序由调度策略决定 (3)如果没有线程被阻塞在调度队列上,那么唤醒将没有作用。 (4)以前不懂事儿,就喜欢广播。由于pthread_cond_broadcast函数唤醒所有阻塞在某个条件变量上的线程,这些线程被唤醒后将再次竞争相应的互斥锁,所以必须小心使用pthread_cond_broadcast函数。 虚假唤醒与唤醒丢失 ⑴虚假唤醒 在多核处理器下,pthread_cond_signal可能会激活多于一个线程(阻塞在条件变量上的线程)。结果是,当一个线程调用pthread_cond_signal()后,多个调用pthread_cond_wait()或pthread_cond_timedwait()的线程返回。这种效应成为”虚假唤醒”(spurious wakeup) Linux帮助里面有 为什么不去修正,性价比不高嘛。 所以通常的标准解决办法是这样的: ⑵唤醒丢失 无论哪种等待方式,都必须和一个互斥量配合,以防止多个线程来打扰。 互斥锁必须是普通锁或适应锁,并且在进入pthread_cond_wait之前必须由本线程加锁。 在更新等待队列前,mutex必须保持锁定状态. 在线程进入挂起,进入等待前,解锁。(好绕啊,我已经尽力断句了) 在条件满足并离开pthread_cond_wait前,上锁。以恢复它进入cont_wait之前的状态。 为什么等待会被上锁? 以免出现唤醒丢失问题。 这里有个大神解释要不要看:https://stackoverflow.com/questions/4544234/calling-pthread-cond-signal-without-locking-mutex 做事做全套,源码也给放这儿了:https://code.woboq.org/userspace/glibc/nptl/pthread_cond_wait.c.html 在放些咱能看懂的中文解释:将线程加入唤醒队列后方可解锁。保证了线程在陷入wait后至被加入唤醒队列这段时间内是原子的。 但这种原子性依赖一个前提条件:唤醒者在调用pthread_cond_broadcast或pthread_cond_signal唤醒等待者之前也必须对相同的mutex加锁。 满足上述条件后,如果一个等待事件A发生在唤醒事件B之前,那么A也同样在B之前获得了mutex,那A在被加入唤醒队列之前B都无法进入唤醒调用,因此保证了B一定能够唤醒A;试想,如果A、B之间没有mutex来同步,虽然B在A之后发生,但是可能B唤醒时A尚未被加入到唤醒队列,这便是所谓的唤醒丢失。 在线程未获得相应的互斥锁时调用pthread_cond_signal或pthread_cond_broadcast函数可能会引起唤醒丢失问题。 唤醒丢失往往会在下面的情况下发生: 一个线程调用pthread_cond_signal或pthread_cond_broadcast函数; 另一个线程正处在测试条件变量和调用pthread_cond_wait函数之间; 没有线程正在处在阻塞等待的状态下。 使用条件变量 //例子演示了使用Pthreads条件变量的几个函数。主程序创建了三个线程,两个线程工作,根系“count”变量。第三个线程等待count变量值达到指定的值。 #include <pthread.h> #include <stdio.h> #define NUM_THREADS 3 #define TCOUNT 10 #define COUNT_LIMIT 12 int count = 0; int thread_ids[3] = {0,1,2}; pthread_mutex_t count_mutex; pthread_cond_t count_threshold_cv; void *inc_count(void *idp) { int j,i; double result=0.0; int *my_id = idp; for(i=0; i<TCOUNT; i++) { pthread_mutex_lock(&count_mutex); count++; /* Check the value of count and signal waiting thread when condition is reached. Note that this occurs while mutex is locked. */ if (count == COUNT_LIMIT) { pthread_cond_signal(&count_threshold_cv); printf("inc_count(): thread %d, count = %d Threshold reached./n",*my_id, count); } printf("inc_count(): thread %d, count = %d, unlocking mutex/n",*my_id, count); pthread_mutex_unlock(&count_mutex); /* Do some work so threads can alternate on mutex lock */ for (j=0; j<1000; j++) result = result + (double)random(); } pthread_exit(NULL); } void *watch_count(void *idp) { int *my_id = idp; printf("Starting watch_count(): thread %d/n", *my_id); /* Lock mutex and wait for signal. Note that the pthread_cond_wait routine will automatically and atomically unlock mutex while it waits. Also, note that if COUNT_LIMIT is reached before this routine is run by the waiting thread, the loop will be skipped to prevent pthread_cond_wait \ from never returning. */ pthread_mutex_lock(&count_mutex); if (count<COUNT_LIMIT) { pthread_cond_wait(&count_threshold_cv, &count_mutex); printf("watch_count(): thread %d Condition signal received./n", *my_id); } pthread_mutex_unlock(&count_mutex); pthread_exit(NULL); } int main(int argc, char *argv[]) { int i, rc; pthread_t threads[3]; pthread_attr_t attr; /* Initialize mutex and condition variable objects */ pthread_mutex_init(&count_mutex, NULL); pthread_cond_init (&count_threshold_cv, NULL); /* For portability, explicitly create threads in a joinable state */ pthread_attr_init(&attr); pthread_attr_setdetachstate(&attr, PTHREAD_CREATE_JOINABLE); pthread_create(&threads[0], &attr, inc_count, (void *)&thread_ids[0]); pthread_create(&threads[1], &attr, inc_count, (void *)&thread_ids[1]); pthread_create(&threads[2], &attr, watch_count, (void *)&thread_ids[2]); /* Wait for all threads to complete */ for (i=0; i<NUM_THREADS; i++) { pthread_join(threads[i], NULL); } printf ("Main(): Waited on %d threads. Done./n", NUM_THREADS); /* Clean up and exit */ pthread_attr_destroy(&attr); pthread_mutex_destroy(&count_mutex); pthread_cond_destroy(&count_threshold_cv); pthread_exit(NULL); } 线程池 线程池 番外篇 Pthread API函数 多线程下的对象创建 对象构造要做到线程安全,就一点要求:不要暴露自己,即不要泄露this指针。 那就是做到以下几点: 不要在构造函数中注册任何回调 不要在构造函数中将this传给跨线程对象 即时在构造函数最后一行也不行 对于第一点,如果非要回调函数才能构造,那就换二段式构造,先构造,在调用回调函数。 对于第三条,如果这个类是个基类呢?它构造完了并不是真的构造完了,还有子类等着呢。 之所以要这样设计(把this传给子类那另当别论),就是为了防止构造过程被打断,构造出一个半成品。 对象的销毁与竞态条件 对象析构,在多线程里,由于竞态的存在,变得扑朔迷离。 看个例子: Foo::~Foo(){ //拿锁 //析构 //解锁 } void Foo::update(){ //拿锁 //数据操作 //解锁 } extern Foo *f;//共享资源 A进程操作 delete f; f = NULL; B进程操作 if(f) { f->update(); } 那这就有一个很尴尬的情况了: A在执行“析构”的时候,已经拿到了锁,而B通过了 f 的判断,因为那会儿指针还活着,然后被锁卡住了。 接下来会发生什么?不知道,因为对象析构的时候把锁也带走了。。。(锁属于对象,对象析构,锁也跑不了) 那怎么办? 别怕,参考博客:智能指针 一个动态创建的对象,是否还有效光看指针是看不出来的指针就是指向了一块内存而已,这块内存上的对象如果已经被销毁,那就根本不能访问。 shared_ptr/weak_ptr shared_ptr是引用计数型智能指针,被纳入C11标准库。shared_ptr是一个类模板,它只有一个参数,使用起来很方便。 shared_str是强引用,只要有一个指向x对象的shared_ptr存在,该对象及不会被析构。 weak_ptr是弱引用,它不控制对象的生命周期,但是它知道对象是否还存在。如果对象存在,它可以升级成为shared_ptr。 讲这么多不如来个例子实在: class Observer{ private: std::vector<weak_ptr<Observer>> vwo; //像这样用啊 } 再聊会儿C++内存安全 C++里面可能出现的内存问题大致有这么几个方面 缓冲区溢出 空悬指针/野指针 重复释放 内存泄漏 不配对的new[]/delete 内存碎片 对应解决: std::vetor shared_ptr/weak_ptr scoped_ptr,只在对象析构的时候释放一次 scoped_ptr std::vetor 资源推荐 Programing with POSIX thread(POSIX多线程程序设计) 需要私信我。

优秀的个人博客,低调大师

11 月 Node.js 后端框架排名

发布时间以首个版本发布(0.x)为准。 排名 框架名称 star数 语言 首个版本发布时间 github地址 备注 1 express 46k js 2010年1月 https://github.com/expressjs/express star和下载量最高的老牌框架 2 koa 27.7k js 2013年11月 https://github.com/koajs/koa 3 nest 21k ts 2017年11月 https://github.com/nestjs/nest 增长最快的框架 4 sails 21k js 2012年7月 https://github.com/balderdashy/sails 最早的类ror框架 5 egg 14.1k js 2016年7月 https://github.com/eggjs/egg 阿里开源的node.js框架 6 loopback 12.9k js/ts 2013年6月 https://github.com/strongloop/loopback&https://github.com/strongloop/loopback-next 7 fastify 12.4k js 2016年10月 https://github.com/fastify/fastify 性能最好的node.js 框架 8 hapi 11.7k js 2012年8月 https://github.com/hapijs/hapi 9 pomelo 10.5k js 2012年12月 https://github.com/NetEase/pomelo 游戏框架 10 node-restify 9.5k js 2011年5月 https://github.com/restify/node-restify 11 adonis 7.2k ts 2015年10月 https://github.com/adonisjs/adonis-framework 类似laravel的框架

优秀的个人博客,低调大师

后端技术杂谈7:OpenStack的基石KVM

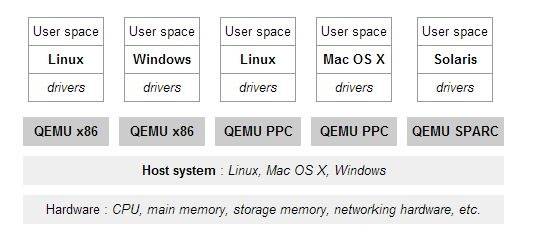
Qemu,KVM,Virsh傻傻的分不清 当你安装了一台Linux,想启动一个KVM虚拟机的时候,你会发现需要安装不同的软件,启动虚拟机的时候,有多种方法: virsh start kvm命令 qemu命令 qemu-kvm命令 qemu-system-x86_64命令 这些之间是什么关系呢?请先阅读上一篇《白话虚拟化技术》 有了上一篇的基础,我们就能说清楚来龙去脉。 KVM(Kernel-based Virtual Machine的英文缩写)是内核内建的虚拟机。有点类似于 Xen ,但更追求更简便的运作,比如运行此虚拟机,仅需要加载相应的 kvm 模块即可后台待命。和 Xen 的完整模拟不同的是,KVM 需要芯片支持虚拟化技术(英特尔的 VT 扩展或者 AMD 的 AMD-V 扩展)。 首先看qemu,其中关键字emu,全称emulator,模拟器,所以单纯使用qemu是采用的完全虚拟化的模式。 Qemu向Guest OS模拟CPU,也模拟其他的硬件,GuestOS认为自己和硬件直接打交道,其实是同Qemu模拟出来的硬件打交道,Qemu将这些指令转译给真正的硬件。由于所有的指令都要从Qemu里面过一手,因而性能比较差 按照上一次的理论,完全虚拟化是非常慢的,所以要使用硬件辅助虚拟化技术Intel-VT,AMD-V,所以需要CPU硬件开启这个标志位,一般在BIOS里面设置。查看是否开启 对于Intel CPU 可用命令 grep "vmx" /proc/cpuinfo 判断 对于AMD CPU 可用命令 grep "svm" /proc/cpuinfo 判断 当确认开始了标志位之后,通过KVM,GuestOS的CPU指令不用经过Qemu转译,直接运行,大大提高了速度。 所以KVM在内核里面需要有一个模块,来设置当前CPU是Guest OS在用,还是Host OS在用。 查看内核模块中是否含有kvm, ubuntu默认加载这些模块 KVM内核模块通过/dev/kvm暴露接口,用户态程序可以通过ioctl来访问这个接口,例如书写下面的程序 Qemu将KVM整合进来,通过ioctl调用/dev/kvm接口,将有关CPU指令的部分交由内核模块来做,就是qemu-kvm (qemu-system-XXX) Qemu-kvm对kvm的整合从release_0_5_1开始有branch,在1.3.0正式merge到master qemu和kvm整合之后,CPU的性能问题解决了,另外Qemu还会模拟其他的硬件,如Network, Disk,同样全虚拟化的方式也会影响这些设备的性能。 于是qemu采取半虚拟化或者类虚拟化的方式,让Guest OS加载特殊的驱动来做这件事情。 例如网络需要加载virtio_net,存储需要加载virtio_blk,Guest需要安装这些半虚拟化驱动,GuestOS知道自己是虚拟机,所以数据直接发送给半虚拟化设备,经过特殊处理,例如排队,缓存,批量处理等性能优化方式,最终发送给真正的硬件,一定程度上提高了性能。 至此整个关系如下: qemu-kvm会创建Guest OS,当需要执行CPU指令的时候,通过/dev/kvm调用kvm内核模块,通过硬件辅助虚拟化方式加速。如果需要进行网络和存储访问,则通过类虚拟化或者直通Pass through的方式,通过加载特殊的驱动,加速访问网络和存储资源。 然而直接用qemu或者qemu-kvm或者qemu-system-xxx的少,大多数还是通过virsh启动,virsh属于libvirt工具,libvirt是目前使用最为广泛的对KVM虚拟机进行管理的工具和API,可不止管理KVM。 Libvirt分服务端和客户端,Libvirtd是一个daemon进程,是服务端,可以被本地的virsh调用,也可以被远程的virsh调用,virsh相当于客户端。 Libvirtd调用qemu-kvm操作虚拟机,有关CPU虚拟化的部分,qemu-kvm调用kvm的内核模块来实现 这下子,整个相互关系才搞清楚了。 虽然使用virsh创建虚拟机相对简单,但是为了探究虚拟机的究竟如何使用,下一次,我们来解析一下如何裸使用qemu-kvm来创建一台虚拟机,并且能上网。 如果搭建使用过vmware桌面版或者virtualbox桌面版,创建一个能上网的虚拟机非常简单,但是其实背后做了很多事情,下一次我们裸用qemu-kvm,全部使用手工配置,看创建虚拟机都做了哪些事情。 本章节我们主要介绍通过VMware技术虚拟出相关的Linux软件环境,在Linux系统中,安装KVM虚拟化软件,实实在在的去实践一下KVM到底是一个什么样的技术? Kvm虚拟化技术实践 VMware虚拟机支持Kvm虚拟化技术? 在VMware创建的虚拟机中,默认不支持Kvm虚拟化技术,需要芯片级的扩展支持,幸好VMware提供完整的解决方案,可以通过修改虚拟化引擎。 VMware软件版本信息,VMware® Workstation 11.0.0 build-2305329 首先,你需要启动VMware软件,新建一个CentOS 6.x类型的虚拟机,正常安装完成,这个虚拟机默认的虚拟化引擎,首选模式为”自动”。 如果想让我们的VMware虚拟化出来的CentOS虚拟机支持KVM虚拟化,我们需要修改它支持的虚拟化引擎,打开新建的虚拟机,虚拟机状态必须处于关闭状态,通过双击编辑虚拟机设置>硬件,选择处理器菜单,右边会出现虚拟化引擎区域,选择首选模式为Intel Tv-x/EPT或AMD-V/RVI,接下来勾选虚拟化Intel Tv-x/EPT或AMD-V/RVI(v),点击确定。 KVM需要虚拟机宿主(host)的处理器带有虚拟化支持(对于Intel处理器来说是VT-x,对于AMD处理器来说是AMD-V)。你可以通过以下命令来检查你的处理器是否支持虚拟化: grep --color -E '(vmx|svm)' /proc/cpuinfo 如果运行后没有显示,那么你的处理器不支持硬件虚拟化,你不能使用KVM。 注意: 如果是硬件服务器,您可能需要在BIOS中启用虚拟化支持,参考Private Cloud personal workstation 安装Kvm虚拟化软件 安装kvm虚拟化软件,我们需要一个Linux操作系统环境,这里我们选择的Linux版本为CentOS release 6.8 (Final),在这个VMware虚拟化出来的虚拟机中安装kvm虚拟化软件,具体步骤如下: 首选安装epel源 sudo rpm -ivh http://mirrors.ustc.edu.cn/fedora/epel/6/x86_64/epel-release-6-8.noarch.rpm 安装kvm虚拟化软件 sudo yum install qemu-kvm qeum-kvm-tools virt-manager libvirt 启动kvm虚拟化软件 sudo /etc/init.d/libvirtd start 启动成功之后你可以通过/etc/init.d/libvirtd status查看启动状态,这个时候,kvm会自动生成一个本地网桥virbr0,可以通过命令查看他的详细信息 # ifconfig virbr0 virbr0 Link encap:Ethernet HWaddr 52:54:00:D7:23:AD inet addr:192.168.122.1 Bcast:192.168.122.255 Mask:255.255.255.0 UP BROADCAST RUNNING MULTICAST MTU:1500 Metric:1 RX packets:0 errors:0 dropped:0 overruns:0 frame:0 TX packets:0 errors:0 dropped:0 overruns:0 carrier:0 collisions:0 txqueuelen:0 RX bytes:0 (0.0 b) TX bytes:0 (0.0 b) KVM默认使用NAT网络模式。虚拟机获取一个私有 IP(例如 192.168.122.0/24 网段的),并通过本地主机的NAT访问外网。 # brctl show bridge name bridge id STP enabled interfaces virbr0 8000.525400d723ad yes virbr0-nic 创建一个本地网桥virbr0,包括两个端口:virbr0-nic 为网桥内部端口,vnet0 为虚拟机网关端口(192.168.122.1)。 虚拟机启动后,配置 192.168.122.1(vnet0)为网关。所有网络操作均由本地主机系统负责。 DNS/DHCP的实现,本地主机系统启动一个 dnsmasq 来负责管理。 ps aux|grep dnsmasq 注意:启动libvirtd之后自动启动iptables,并且写上一些默认规则。 # iptables -nvL -t nat Chain PREROUTING (policy ACCEPT 304 packets, 38526 bytes) pkts bytes target prot opt in out source destination Chain POSTROUTING (policy ACCEPT 7 packets, 483 bytes) pkts bytes target prot opt in out source destination 0 0 MASQUERADE tcp -- * * 192.168.122.0/24 !192.168.122.0/24 masq ports: 1024-65535 0 0 MASQUERADE udp -- * * 192.168.122.0/24 !192.168.122.0/24 masq ports: 1024-65535 0 0 MASQUERADE all -- * * 192.168.122.0/24 !192.168.122.0/24 Chain OUTPUT (policy ACCEPT 7 packets, 483 bytes) pkts bytes target prot opt in out source destination kvm创建虚拟机 上传一个镜像文件:CentOS-6.6-x86_64-bin-DVD1.iso 通过qemu创建一个raw格式的文件(注:QEMU使用的镜像文件:qcow2与raw,它们都是QEMU(KVM)虚拟机使用的磁盘文件格式),大小为5G。 qemu-img create -f raw /data/Centos-6.6-x68_64.raw 5G 查看创建的raw磁盘格式文件信息 qemu-img info /data/Centos-6.6-x68_64.raw image: /data/Centos-6.6-x68_64.raw file format: raw virtual size: 5.0G (5368709120 bytes) disk size: 0 启动,kvm虚拟机,进行操作系统安装 virt-install --virt-type kvm --name CentOS-6.6-x86_64 --ram 512 --cdrom /data/CentOS-6.6-x86_64-bin-DVD1.iso --disk path=/data/Centos-6.6-x68_64.raw --network network=default --graphics vnc,listen=0.0.0.0 --noautoconsole 启动之后,通过命令查看启动状态,默认会在操作系统开一个5900的端口,可以通过虚拟机远程管理软件vnc客户端连接,然后可视化的方式安装操作系统。 # netstat -ntlp|grep 5900 tcp 0 0 0.0.0.0:5900 0.0.0.0:* LISTEN 2504/qemu-kvm 注意:kvm安装的虚拟机,不确定是那一台,在后台就是一个进程,每增加一台端口号+1,第一次创建的为5900! 虚拟机远程管理软件 我们可以使用虚拟机远程管理软件VNC进行操作系统的安装,我使用过的两款不错的虚拟机远程管理终端软件,一个是Windows上使用,一个在Mac上为了方便安装一个Google Chrome插件后即可开始使用,软件信息Tightvnc或者VNC@Viewerfor Google Chrome 如果你和我一样使用的是Google Chrome提供的VNC插件,使用方式,在Address输入框中输入,宿主机IP:59000,Picture Quality选择框使用默认选项,点击Connect进入到安装操作系统的界面,你可以安装常规的方式进行安装,等待系统安装完成重启,然后就可以正常使用kvm虚拟化出来的操作系统了。 Tightvnc软件的使用,请参考官方手册。 Tightvnc下载地址:www.tightvnc.com/download.ph… Tightvnc下载地址:www.tightvnc.com/download/2.… Tightvnc下载地址:www.tightvnc.com/download/2.… KVM虚拟机管理 kvm虚拟机是通过virsh命令进行管理的,libvirt是Linux上的虚拟化库,是长期稳定的C语言API,支持KVM/QEMU、Xen、LXC等主流虚拟化方案。链接:libvirt.org/ virsh是Libvirt对应的shell命令。 查看所有虚拟机状态 virsh list --all 启动虚拟机 virsh start [NAME] 列表启动状态的虚拟机 virsh list 常用命令查看virsh --help|more less libvirt虚拟机配置文件 虚拟机libvirt配置文件在/etc/libvirt/qemu路径下,生产中我们需要去修改它的网络信息。 # ll total 8 -rw-------. 1 root root 3047 Oct 19 2016 Centos-6.6-x68_64.xml drwx------. 3 root root 4096 Oct 17 2016 networks 注意:不能直接修改xml文件,需要通过提供的命令! virsh edit Centos-6.6-x68_64 kvm三种网络类型,桥接、NAT、仅主机模式,默认NAT模式,其他机器无法登陆,生产中一般选择桥接。 监控kvm虚拟机 安装软件监控虚拟机 yum install virt-top -y 查看虚拟机资源使用情况 virt-top virt-top 23:46:39 - x86_64 1/1CPU 3392MHz 3816MB 1 domains, 1 active, 1 running, 0 sleeping, 0 paused, 0 inactive D:0 O:0 X:0 CPU: 5.6% Mem: 2024 MB (2024 MB by guests) ID S RDRQ WRRQ RXBY TXBY %CPU %MEM TIME NAME 1 R 0 1 52 0 5.6 53.0 5:16.15 centos-6.8 KVM修改NAT模式为桥接[案例] 在开始案例之前,需要知道的必要信息,宿主机IP是192.168.2.200,操作系统版本Centos-6.6-x68_64。 启动虚拟网卡 ifup eth0 这里网卡是NAT模式,可以上网,ping通其他机器,但是其他机器无法登陆! 宿主机查看网卡信息 brctl show ifconfig virbr0 ifconfig vnet0 实现网桥,在kvm宿主机完成 步骤1,创建一个网桥,新建网桥连接到eth0,删除eth0,让新的网桥拥有eth0的ip brctl addbr br0 #创建一个网桥 brctl show #显示网桥信息 brctl addif br0 eth0 && ip addr del dev eth0 192.168.2.200/24 && ifconfig br0 192.168.2.200/24 up brctl show #查看结果 ifconfig br0 #验证br0是否成功取代了eth0的IP 注意: 这里的IP地址为宿主机ip 修改虚拟机桥接到br0网卡,在宿主机修改 virsh list --all ps aux |grep kvm virsh stop Centos-6.6-x68_64 virsh list --all 修改虚拟机桥接到宿主机,修改52行type为bridge,第54行bridge为br0 # virsh edit Centos-6.6-x68_64 # 命令 52 <interface type='network'> 53 <mac address='52:54:00:2a:2d:60'/> 54 <source network='default'/> 55 <address type='pci' domain='0x0000' bus='0x00' slot='0x03' function='0x0'/> 56 </interface> 修改为: 52 <interface type='bridge'> 53 <mac address='52:54:00:2a:2d:60'/> 54 <source bridge='br0'/> 55 <address type='pci' domain='0x0000' bus='0x00' slot='0x03' function='0x0'/> 56 </interface> 启动虚拟机,看到启动前后,桥接变化,vnet0被桥接到了br0 启动前: # brctl show bridge name bridge id STP enabled interfaces br0 8000.000c29f824c9 no eth0 virbr0 8000.525400353d8e yes virbr0-nic 启动后: # virsh start CentOS-6.6-x86_64 Domain CentOS-6.6-x86_64 started # brctl show bridge name bridge id STP enabled interfaces br0 8000.000c29f824c9 no eth0 vnet0 virbr0 8000.525400353d8e yes virbr0-nic Vnc登陆后,修改ip地址,看到dhcp可以使用,被桥接到现有的ip段,ip是自动获取,而且是和宿主机在同一个IP段. # ifup eth0 从宿主机登陆此服务器,可以成功。 # ssh 192.168.2.108 root@192.168.2.108's password: Last login: Sat Jan 30 12:40:28 2016 从同一网段其他服务器登陆此虚拟机,也可以成功,至此让kvm管理的服务器能够桥接上网就完成了,在生产环境中,桥接上网是非常必要的。 总结 通过kvm相关的命令来创建虚拟机,安装和调试是非常必要的,因为现有的很多私有云,公有云产品都使用到了kvm这样的技术,学习基本的kvm使用对维护openstack集群有非常要的作用,其次所有的openstack image制作也得通过kvm这样的底层技术来完成,最后上传到openstack的镜像管理模块,才能开始通过openstack image生成云主机。 到此,各位应该能够体会到,其实kvm是一个非常底层和核心的虚拟化技术,而openstack就是对kvm这样的技术进行了一个上层封装,可以非常方便,可视化的操作和维护kvm虚拟机,这就是现在牛上天的云计算技术最底层技术栈,具体怎么实现请看下图。 如上图,没有openstack我们依然可以通过,libvirt来对虚拟机进行操作,只不过比较繁琐和难以维护。通过openstack就可以非常方便的进行底层虚拟化技术的管理、维护、使用。 原创文章,转载请注明: 转载自Itweet的博客 微信公众号【Java技术江湖】一位阿里 Java 工程师的技术小站。(关注公众号后回复”Java“即可领取 Java基础、进阶、项目和架构师等免费学习资料,更有数据库、分布式、微服务等热门技术学习视频,内容丰富,兼顾原理和实践,另外也将赠送作者原创的Java学习指南、Java程序员面试指南等干货资源) ​

优秀的个人博客,低调大师

后端技术杂谈8:OpenStack架构设计

OpenStack 是开源云计算平台,支持多种虚拟化环境,并且其服务组件都提供了API接口便于二次开发。 OpenStack通过各种补充服务提供基础设施即服务 Infrastructure-as-a-Service (IaaS)的解决方案。每个服务都提供便于集成的应用程序接口Application Programming Interface (API)。 openstack 逻辑架构图 OpenStack 本身是一个分布式系统,不但各个服务可以分布部署,服务中的组件也可以分布部署。 这种分布式特性让 OpenStack 具备极大的灵活性、伸缩性和高可用性。 当然从另一个角度讲,这也使得 OpenStack 比一般系统复杂,学习难度也更大。 后面章节我们会深入学习 Keystone、Glance、Nova、Neutron 和 Cinder 这几个 OpenStack 最重要最核心的服务。 openstack的核心和扩展的主要项目如下: OpenStack Compute (code-name Nova) 计算服务 OpenStack Networking (code-name Neutron) 网络服务 OpenStack Object Storage (code-name Swift) 对象存储服务 OpenStack Block Storage (code-name Cinder) 块设备存储服务 OpenStack Identity (code-name Keystone) 认证服务 OpenStack Image Service (code-name Glance) 镜像文件服务 OpenStack Dashboard (code-name Horizon) 仪表盘服务 OpenStack Telemetry (code-name Ceilometer) 告警服务 OpenStack Orchestration (code-name Heat) 流程服务 OpenStack Database (code-name Trove) 数据库服务 OpenStack的各个服务之间通过统一的REST风格的API调用,实现系统的松耦合。上图是OpenStack各个服务之间API调用的概览,其中实线代表client 的API调用,虚线代表各个组件之间通过rpc调用进行通信。松耦合架构的好处是,各个组件的开发人员可以只关注各自的领域,对各自领域的修改不会影响到其他开发人员。不过从另一方面来讲,这种松耦合的架构也给整个系统的维护带来了一定的困难,运维人员要掌握更多的系统相关的知识去调试出了问题的组件。所以无论对于开发还是维护人员,搞清楚各个组件之间的相互调用关系是怎样的都是非常必要的。 对Linux经验丰富的OpenStack新用户,使用openstack是非常容易的,在后续openstack系列文章中会逐步展开介绍。 OpenStack 项目和组件 OpenStack services Dashboard 【Horizon】 提供了一个基于web的自服务门户,与OpenStack底层服务交互,诸如启动一个实例,分配IP地址以及配置访问控制。 Compute 【Nova】 在OpenStack环境中计算实例的生命周期管理。按需响应包括生成、调度、回收虚拟机等操作。 Networking 【Neutron】 确保为其它OpenStack服务提供网络连接即服务,比如OpenStack计算。为用户提供API定义网络和使用。基于插件的架构其支持众多的网络提供商和技术。 Object Storage 【Swift】 通过一个 RESTful,基于HTTP的应用程序接口存储和任意检索的非结构化数据对象。它拥有高容错机制,基于数据复制和可扩展架构。它的实现并像是一个文件服务器需要挂载目录。在此种方式下,它写入对象和文件到多个硬盘中,以确保数据是在集群内跨服务器的多份复制。 Block Storage 【Cinder】 为运行实例而提供的持久性块存储。它的可插拔驱动架构的功能有助于创建和管理块存储设备。 Identity service 【Keystone】 为其他OpenStack服务提供认证和授权服务,为所有的OpenStack服务提供一个端点目录。 Image service 【Glance】 存储和检索虚拟机磁盘镜像,OpenStack计算会在实例部署时使用此服务。 Telemetry服务 【Ceilometer】 为OpenStack云的计费、基准、扩展性以及统计等目的提供监测和计量。 Orchestration服务 【Heat服务】 Orchestration服务支持多样化的综合的云应用,通过调用OpenStack-native REST API和CloudFormation-compatible Query API,支持HOT <Heat Orchestration Template (HOT)>格式模板或者AWS CloudFormation格式模板 通过对这些组件的介绍,可以帮助我们在后续的内容中,了解各个组件的作用,便于排查问题,而在你对基础安装,配置,操作和故障诊断熟悉之后,你应该考虑按照生产架构来进行部署。 生产部署架构 建议使用自动化部署工具,例如Ansible, Chef, Puppet, or Salt来自动化部署,管理生产环境。 这个示例架构需要至少2个(主机)节点来启动基础服务virtual machine <virtual machine (VM)>或者实例。像块存储服务,对象存储服务这一类服务还需要额外的节点。 网络代理驻留在控制节点上而不是在一个或者多个专用的网络节点上。 私有网络的覆盖流量通过管理网络而不是专用网络 控制器 控制节点上运行身份认证服务,镜像服务,计算服务的管理部分,网络服务的管理部分,多种网络代理以及仪表板。也需要包含一些支持服务,例如:SQL数据库,term:消息队列, and NTP。 可选的,可以在计算节点上运行部分块存储,对象存储,Orchestration 和 Telemetry 服务。 计算节点上需要至少两块网卡。 计算 计算节点上运行计算服务中管理实例的管理程序部分。默认情况下,计算服务使用 KVM。 你可以部署超过一个计算节点。每个结算节点至少需要两块网卡。 块设备存储 可选的块存储节点上包含了磁盘,块存储服务和共享文件系统会向实例提供这些磁盘。 为了简单起见,计算节点和本节点之间的服务流量使用管理网络。生产环境中应该部署一个单独的存储网络以增强性能和安全。 你可以部署超过一个块存储节点。每个块存储节点要求至少一块网卡。 对象存储 可选的对象存储节点包含了磁盘。对象存储服务用这些磁盘来存储账号,容器和对象。 为了简单起见,计算节点和本节点之间的服务流量使用管理网络。生产环境中应该部署一个单独的存储网络以增强性能和安全。 这个服务要求两个节点。每个节点要求最少一块网卡。你可以部署超过两个对象存储节点。 网络 openstack网络是非常复杂的,并且也支持多种模式其中支持GRE,VLAN,VXLAN等,在openstack中网络是通过一个组件Neutron提供服务,Neutron 管理的网络资源包括如下。 network 是一个隔离的二层广播域。Neutron 支持多种类型的 network,包括 local, flat, VLAN, VxLAN 和 GRE。 local 网络与其他网络和节点隔离。local 网络中的 instance 只能与位于同一节点上同一网络的 instance 通信,local 网络主要用于单机测试。 flat 网络是无 vlan tagging 的网络。flat 网络中的 instance 能与位于同一网络的 instance 通信,并且可以跨多个节点。 vlan 网络是具有 802.1q tagging 的网络。vlan 是一个二层的广播域,同一 vlan 中的 instance 可以通信,不同 vlan 只能通过 router 通信。vlan 网络可以跨节点,是应用最广泛的网络类型。 vxlan 是基于隧道技术的 overlay 网络。vxlan 网络通过唯一的 segmentation ID(也叫 VNI)与其他 vxlan 网络区分。vxlan 中数据包会通过 VNI 封装成 UPD 包进行传输。因为二层的包通过封装在三层传输,能够克服 vlan 和物理网络基础设施的限制。 gre 是与 vxlan 类似的一种 overlay 网络。主要区别在于使用 IP 包而非 UDP 进行封装。 不同 network 之间在二层上是隔离的。以 vlan 网络为例,network A 和 network B 会分配不同的 VLAN ID,这样就保证了 network A 中的广播包不会跑到 network B 中。当然,这里的隔离是指二层上的隔离,借助路由器不同 network 是可能在三层上通信的。network 必须属于某个 Project( Tenant 租户),Project 中可以创建多个 network。 network 与 Project 之间是 1对多关系。 subnet 是一个 IPv4 或者 IPv6 地址段。instance 的 IP 从 subnet 中分配。每个 subnet 需要定义 IP 地址的范围和掩码。 port 可以看做虚拟交换机上的一个端口。port 上定义了 MAC 地址和 IP 地址,当 instance 的虚拟网卡 VIF(Virtual Interface) 绑定到 port 时,port 会将 MAC 和 IP 分配给 VIF。port 与 subnet 是 1对多 关系。一个 port 必须属于某个 subnet;一个 subnet 可以有多个 port。 如上图所示,为VLAN模式下,网络节点的通信方式。 在我们后续实施安装的时候,选择使用VXLAN网络模式,下面我们来重点介绍一下VXLAN模式。 VXLAN网络模式,可以隔离广播风暴,不需要交换机配置chunk口,解决了vlan id个数限制,解决了gre点对点隧道个数过多问题,实现了大2层网络,可以让vm在机房之间无缝迁移,便于跨机房部署。缺点是,vxlan增加了ip头部大小,需要降低vm的mtu值,传输效率上会略有下降。 涉及的 Linux 网络技术 Neutron 的设计目标是实现“网络即服务”,为了达到这一目标,在设计上遵循了基于“软件定义网络”实现网络虚拟化的原则,在实现上充分利用了 Linux 系统上的各种网络相关的技术。理解了 Linux 系统上的这些概念将有利于快速理解 Neutron 的原理和实现。 bridge:网桥,Linux中用于表示一个能连接不同网络设备的虚拟设备,linux中传统实现的网桥类似一个hub设备,而ovs管理的网桥一般类似交换机。 br-int:bridge-integration,综合网桥,常用于表示实现主要内部网络功能的网桥。 br-ex:bridge-external,外部网桥,通常表示负责跟外部网络通信的网桥。 GRE:General Routing Encapsulation,一种通过封装来实现隧道的方式。在openstack中一般是基于L3的gre,即original pkt/GRE/IP/Ethernet VETH:虚拟ethernet接口,通常以pair的方式出现,一端发出的网包,会被另一端接收,可以形成两个网桥之间的通道。 qvb:neutron veth, Linux Bridge-side qvo:neutron veth, OVS-side TAP设备:模拟一个二层的网络设备,可以接受和发送二层网包。 TUN设备:模拟一个三层的网络设备,可以接受和发送三层网包。 iptables:Linux 上常见的实现安全策略的防火墙软件。 Vlan:虚拟 Lan,同一个物理 Lan 下用标签实现隔离,可用标号为1-4094。 VXLAN:一套利用 UDP 协议作为底层传输协议的 Overlay 实现。一般认为作为 VLan 技术的延伸或替代者。 namespace:用来实现隔离的一套机制,不同 namespace 中的资源之间彼此不可见。 总结 openstack是一个非法复杂的分布式软件,涉及到很多底层技术,我自己对一些网络的理解也是非常有限,主要还是应用层面的知识,所以本章内容写的比较浅显一些,有问题请留言?在下一章节我们会进入生产环境如何实施规划openstack集群,至于openstack底层的技术,我也没有很深入研究,如果有任何不恰当的地方可以进行留言,非常感谢! 微信公众号【Java技术江湖】一位阿里 Java 工程师的技术小站。(关注公众号后回复”Java“即可领取 Java基础、进阶、项目和架构师等免费学习资料,更有数据库、分布式、微服务等热门技术学习视频,内容丰富,兼顾原理和实践,另外也将赠送作者原创的Java学习指南、Java程序员面试指南等干货资源) ​

优秀的个人博客,低调大师

微信小程序+java后端整合笔记

用到的工具和技术. 1.微信web开发工具小程序版 2.Myeclipse 2014 3.WebSocket 4.Maven 3.3.9 5.Tomcat 7 步骤 1.安装配置Maven,使用Myeclipse创建web project 使用Maven项目结构. 具体步骤:点击打开链接 2.打开微信web开发工具,由于是内部开发测试,故不要填写 appID, 创建新项目,把项目放在Maven项目目录下 src/main/webapp/项目名 3.创建Websocket 实现握手通信. 以下代码均来自网络资料. java服务器端: [javascript] view plain copy packagewebsocketTest; importjava.io.IOException; importjava.util.concurrent.CopyOnWriteArraySet; importjavax.websocket.*; importjavax.websocket.server.ServerEndpoint; /** *@ServerEndpoint注解是一个类层次的注解,它的功能主要是将目前的类定义成一个websocket服务器端, *注解的值将被用于监听用户连接的终端访问URL地址,客户端可以通过这个URL来连接到WebSocket服务器端 */ @ServerEndpoint("/websocket") publicclassTestWebSocket{ //静态变量,用来记录当前在线连接数。应该把它设计成线程安全的。 privatestaticintonlineCount=0; //concurrent包的线程安全Set,用来存放每个客户端对应的MyWebSocket对象。若要实现服务端与单一客户端通信的话,可以使用Map来存放,其中Key可以为用户标识 privatestaticCopyOnWriteArraySet<TestWebSocket>webSocketSet=newCopyOnWriteArraySet<TestWebSocket>(); //与某个客户端的连接会话,需要通过它来给客户端发送数据 privateSessionsession; /** *连接建立成功调用的方法 *@paramsession可选的参数。session为与某个客户端的连接会话,需要通过它来给客户端发送数据 */ @OnOpen publicvoidonOpen(Sessionsession){ this.session=session; webSocketSet.add(this);//加入set中 addOnlineCount();//在线数加1 System.out.println("有新连接加入!当前在线人数为"+getOnlineCount()); } /** *连接关闭调用的方法 */ @OnClose publicvoidonClose(){ webSocketSet.remove(this);//从set中删除 subOnlineCount();//在线数减1 System.out.println("有一连接关闭!当前在线人数为"+getOnlineCount()); } /** *收到客户端消息后调用的方法 *@parammessage客户端发送过来的消息 *@paramsession可选的参数 */ @OnMessage publicvoidonMessage(Stringmessage,Sessionsession){ System.out.println("来自客户端的消息:"+message); //群发消息 for(TestWebSocketitem:webSocketSet){ try{ item.sendMessage(message); }catch(IOExceptione){ e.printStackTrace(); continue; } } } /** *发生错误时调用 *@paramsession *@paramerror */ @OnError publicvoidonError(Sessionsession,Throwableerror){ System.out.println("发生错误"); error.printStackTrace(); } /** *这个方法与上面几个方法不一样。没有用注解,是根据自己需要添加的方法。 *@parammessage *@throwsIOException */ publicvoidsendMessage(Stringmessage)throwsIOException{ this.session.getBasicRemote().sendText(message); //this.session.getAsyncRemote().sendText(message); } publicstaticsynchronizedintgetOnlineCount(){ returnonlineCount; } publicstaticsynchronizedvoidaddOnlineCount(){ TestWebSocket.onlineCount++; } publicstaticsynchronizedvoidsubOnlineCount(){ TestWebSocket.onlineCount--; } } [javascript] view plain copy 微信小程序客户端: [javascript] view plain copy <prename="code"class="javascript">varapp=getApp() Page({ onLoad:function(){ wx.connectSocket({ url:"ws://localhost:8080/TestYMG/websocket", }) wx.onSocketOpen(function(){ console.log('WebSocket连接已经打开!') wx.sendSocketMessage({ data:'HELLO,WORLD'+Math.random()*0XFFFFFF.toString() }) }); wx.onSocketMessage(function(data){ console.log(data); });</pre><prename="code"class="javascript">//监听是否关闭 wx.onSocketClose(function(){ console.log('WebSocket连接已经关闭!') }); },</pre><prename="code"class="javascript">//手动关闭连接 setclose:function(e){ console.log('WebSocket连接正在关闭!') wx.closeSocket(); } }) </pre><br> <p></p> <pre></pre> <p></p> 原文地址http://www.bieryun.com/671.html

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册